pixelstomotors.com の全記事を AI が丸ごと読めるように ― 記事に「AIで読む」ボタンを置いた
この記事の素材(コード・ログ・データ 4ファイル・まとめてダウンロードあり)arrow_downwardAIで読む ChatGPT・Claude などで、この記事に質問できます expand_more
pixelstomotors.com の全記事(公開時点で424本)に、コードと実行ログを含む本文を Markdown 1枚で読める全文ページを足し、記事ページには ChatGPT・Claude・Perplexity・Gemini を選んで記事を読ませる「AIで読む」ボタンを置きました。 AI の回答で引用される数を増やすのに効くのは全文ページのほうで、ボタンは読み手が自分の環境で再現するのを手伝う入口だと判断して、2つを組にして入れています。
これで変わることは3つあります。
- AI が読める量:これまで、コードとログまで1枚で読める全文があったのは、長いコードを別ファイルに分けた67本(Markdown 64本・HTML 3本)だけでした。今は全記事にあり、住所は記事の住所の末尾に
.mdを付けるだけで分かります - 読み手の手間:これまでは、記事の住所をコピーして AI を開き、質問を自分で書く必要がありました。今は、ボタンを押して AI を選ぶと、要点と「自分の環境で再現するときに確かめること」を聞く質問文が入った状態で開きます(前の手間の時間は測っていません)
- 数えられること:ボタンが押された数を AI ごとに数え、さらにボタン経由で AI が全文ページを実際に読みに来た数も、押した AI ごとに分けて数えます。名乗りでは見分けられない Gemini の分も数えられます
背景には、このサイトが人より先に AI に読まれ始めていることがあります。前に計測の記録を読んだとき、人がページを見た回数が5日で130回なのに対し、ChatGPT が利用者に頼まれて記事を読みに来た回数は48回ありました(LOG411)。人が調べものを AI に聞くことが増えたので、AI の答えの中でこのサイトが引用される数を増やしたい、というのが私の考えです。ただ、記事の多くは長いコードやログを含み、AI がページを読んでも、別ファイルに分けたコードまではたどらないことがありました。
最初は「AIで読む」ボタンの案だけでした。作る前に効き目を分析すると、ボタンだけではサイト側の直接のメリットは小さく、引用を増やすのに効くのは、AI が丸ごと読める全文ページのほうだと分かりました。そこで両方を入れています。
| やったこと | なぜ | 結果 |
|---|---|---|
「AIで読む」ボタンの効き目を、作る前に分析した | 置けるかどうかと、置く意味があるかを先に知りたかった | 読み手の AI を自動で選ぶことはできない。ボタンは読み手の再現の手伝いで、引用に効くのは全文ページ |
全記事に全文ページ( /record/{slug}.md)を足した | AI が分けたコードまで含めて1枚で読めるようにする | 424本。人が見る記事ページは変えず、検索では記事ページを正とする印を付けた |
記事のタイトルの下に「AIで読む」を置いた | 読み手が自分の AI で、記事を自分の環境に合わせて読めるようにする | ChatGPT・Claude・Perplexity は質問文入りで開く。Gemini とほかの AI はコピー |
押した数と、ボタン経由で AI が読みに来た数を数えるようにした | 効いたかどうかを、あとで数字で確かめる | 全文ページの住所に押した AI の印を付け、AI ごとに読みに来た数を分けて出す |
作業ログ ― 「AIで読む」ボタンの効き目を、作る前に分析した
このサイトは、記事を作るときも、公開するときも、ほとんどの作業を Claude(Anthropic の AI)と一緒に進めています。今回も、私の質問から始まりました。
サイトの記事内に、記事内容をAIに読み込ませるボタン(名称は提案ください)などを置き、記事をそのまま自分の利用しているAIを選択して、もしくは自動AI選択といったことは可能ですか?またそのボタンの有効性についても分析して教えてください。
読み手が使っている AI を自動で選ぶことはできない
ボタンそのものは置けます。ChatGPT・Claude・Perplexity(検索しながら答える AI)は、住所の後ろに質問文を付けて開くと、入力欄にその文が入った状態で始まります。記事の本文を丸ごと住所に入れると長すぎるので、記事の住所を渡して「このページを読んで」と頼む形にします。
できないのは、読み手がどの AI にログインしているかを調べて、自動で選ぶことです。ブラウザは、別のサイトのログインの状態を、ほかのサイトに見せない作りになっています。そこで、最初に一度選んでもらい、その選択を見た人のブラウザに覚えて、次から一番上に出す形にしました。自動選択に一番近い形です。
名前は3案を出し、短くて何が起きるか分かる「AIで読む」にしました。
| 案 | 向き・不向き |
|---|---|
| AIで読む(採用) | 短く、何が起きるか分かる |
| この記事をAIに聞く | 質問できると伝わる。少し長い |
| AIと一緒に再現する | 主指標(再現可能な環境数)に一番近い。押す前の期待が大きすぎる |
ボタンが直接効くのは読み手の側で、引用には効かない
効き目を、サイトの側と読み手の側に分けて考えました。
| 効くこと | 効かないこと | |
|---|---|---|
| 読み手 | 長いコード・ログを、自分の機体やパソコンに合わせて AI に読み解かせる入口になる | ― |
| サイト | 押された数と、どの AI が選ばれたかは数えられる | AI の回答で引用される数はほとんど増えない。押すのは、すでに記事を開いている人だから。押したあと AI の中で何を聞いたか、再現できたかも見えない |
AI の回答で引用されるかは、ChatGPT などが検索したときにこのサイトを見つけ、中身を読めるかで決まります。 ボタンはそこに関わりません。引用に効くのは、AI が読みに来たときに、分けたコードまで含めて1枚で読めるページのほうです。
分析を見て、私はこう返しました。
このボタンによって直接的なメリットは特にないという感じ?
AIが引用するのを増やすのは一つの目的なので、ボタン追加、全文ページ追加をしてみよう
そこで、全文ページを本体に、ボタンをその入口にして、両方を入れることにしました。
作業ログ ― 全記事に全文ページ(/record/{slug}.md)を足した
全文ページは、記事ページとは別に足す1枚の写し
全文ページは、Markdown(見出しや表を記号で書く、飾りのない文字だけの書き方)で書いた、記事1本の写しです。住所は、記事ページの住所の末尾に .md を付けたものです。
- 記事ページ:https://pixelstomotors.com/record/DesFKiCf
- 全文ページ:https://pixelstomotors.com/record/DesFKiCf.md
人が見るのは今までどおり記事ページで、見た目もアドレスも変えていません。全文ページの頭には、題名・LOG 番号・シリーズ・公開日・記事ページの住所・要約を置き、「引用するときは記事のページの住所を使ってください」と書きました。AI が全文ページを読んで答えるときも、記事ページを指してもらうためです。
- ねらい:AI が記事を読みに来たとき、分けたコードやログまで含めて1回で読めるようにする
- 変わったこと:全文があったのは分けた記事の67本だけだったのが、全記事(公開時点で424本)になった
- 見込める効果:AI の答えの中で、コードやログの中身まで引いて答えられる記事が増える。実際に読まれたかは、AI の巡回の記録の「よく読まれたページ」(
.mdの住所)で確かめる
分けた記事は分ける前の全文を、Studio から移した記事は HTML から直した
記事は、作った時期によって3つの形で入っています。全文ページの作り方は、形ごとに変えました。
| 記事の形 | 本数 | 全文ページの作り方 |
|---|---|---|
長いコード・ログを別ファイルに分けた記事 | 67本(Markdown 64本・HTML 3本) | 分ける前の全文( LOG{N}_full.md・LOG{N}_full.html)を使う |
Claude が Markdown で書いた記事(分けていないもの) | 残りの Markdown の記事 | 記事の Markdown をそのまま使う |
Studio(前に使っていたサイトの作成サービス)から移した記事 | 341本の元データのうち、Markdown の記事と重ならないもの | 本文の HTML を turndown(HTML を Markdown に直す部品)で直す |
記事の Markdown には、このサイトだけの印(【画像】ファイル名・【図解】ファイル名 など)があります。サイトはこれを画像や図に置き換えて表示しますが、全文ページではただの文字になってしまいます。そこで、画像は Markdown の画像の書き方に、図解と動画はリンクに直し、どれも https://pixelstomotors.com から始まる住所にしました。ページの外で読んでも、どこに何があるかが分かるようにするためです。
全文ページの大きさは、まん中の値で約22KB でした。一番大きいのは、配膳ロボットのシミュレーションを18回回した記録で、約8.3MB あります。実行ログを全量で載せているためです。AI によっては、大きなページを途中までしか読まないことがあります。
検索では記事ページを正にする(canonical)
同じ中身のページが2つあると、検索エンジンは重複として扱い、どちらを検索結果に出すかを自分で選びます。全文ページが検索結果に出てしまうと、人が飾りのない文字だけのページに着いてしまいます。
そこで、全文ページを返すときに「正しいページは記事ページのほう」という印(canonical)を付けました。印は、ページの中ではなく、サイトがページを返すときの見出し(HTTP の Link ヘッダー)に書いています。Markdown のページには、HTML のように印を書く場所がないためです。ページを配っている Cloudflare Workers(ページを返す前に小さなプログラムを動かせる仕組み)で付けました。
$ curl -sI "https://pixelstomotors.com/record/DesFKiCf.md?p2m-notrack=1" | grep -i "HTTP\|content-type\|^link"
HTTP/1.1 200 Connection Established
HTTP/2 200
content-type: text/markdown; charset=utf-8
link: <https://pixelstomotors.com/record/DesFKiCf>; rel="canonical"
AI への案内(llms.txt)と、記事ページの目印を全記事に
AI が全文ページを見つけられるように、2か所に置き場所を書きました。
- llms.txt(AI がサイトを読むときの案内のファイル):全記事の行に「全文の Markdown」の住所を足した。前は分けた記事にだけ書いていた
- 記事ページの head(ページの見えない部分):
<link rel="alternate" type="text/markdown">で、すべての記事から全文ページを指すようにした。前は分けた記事にだけあり、指す先も/files/LOG{N}/LOG{N}_full.mdだった
作業ログ ― 記事のタイトルの下に「AIで読む」を置いた
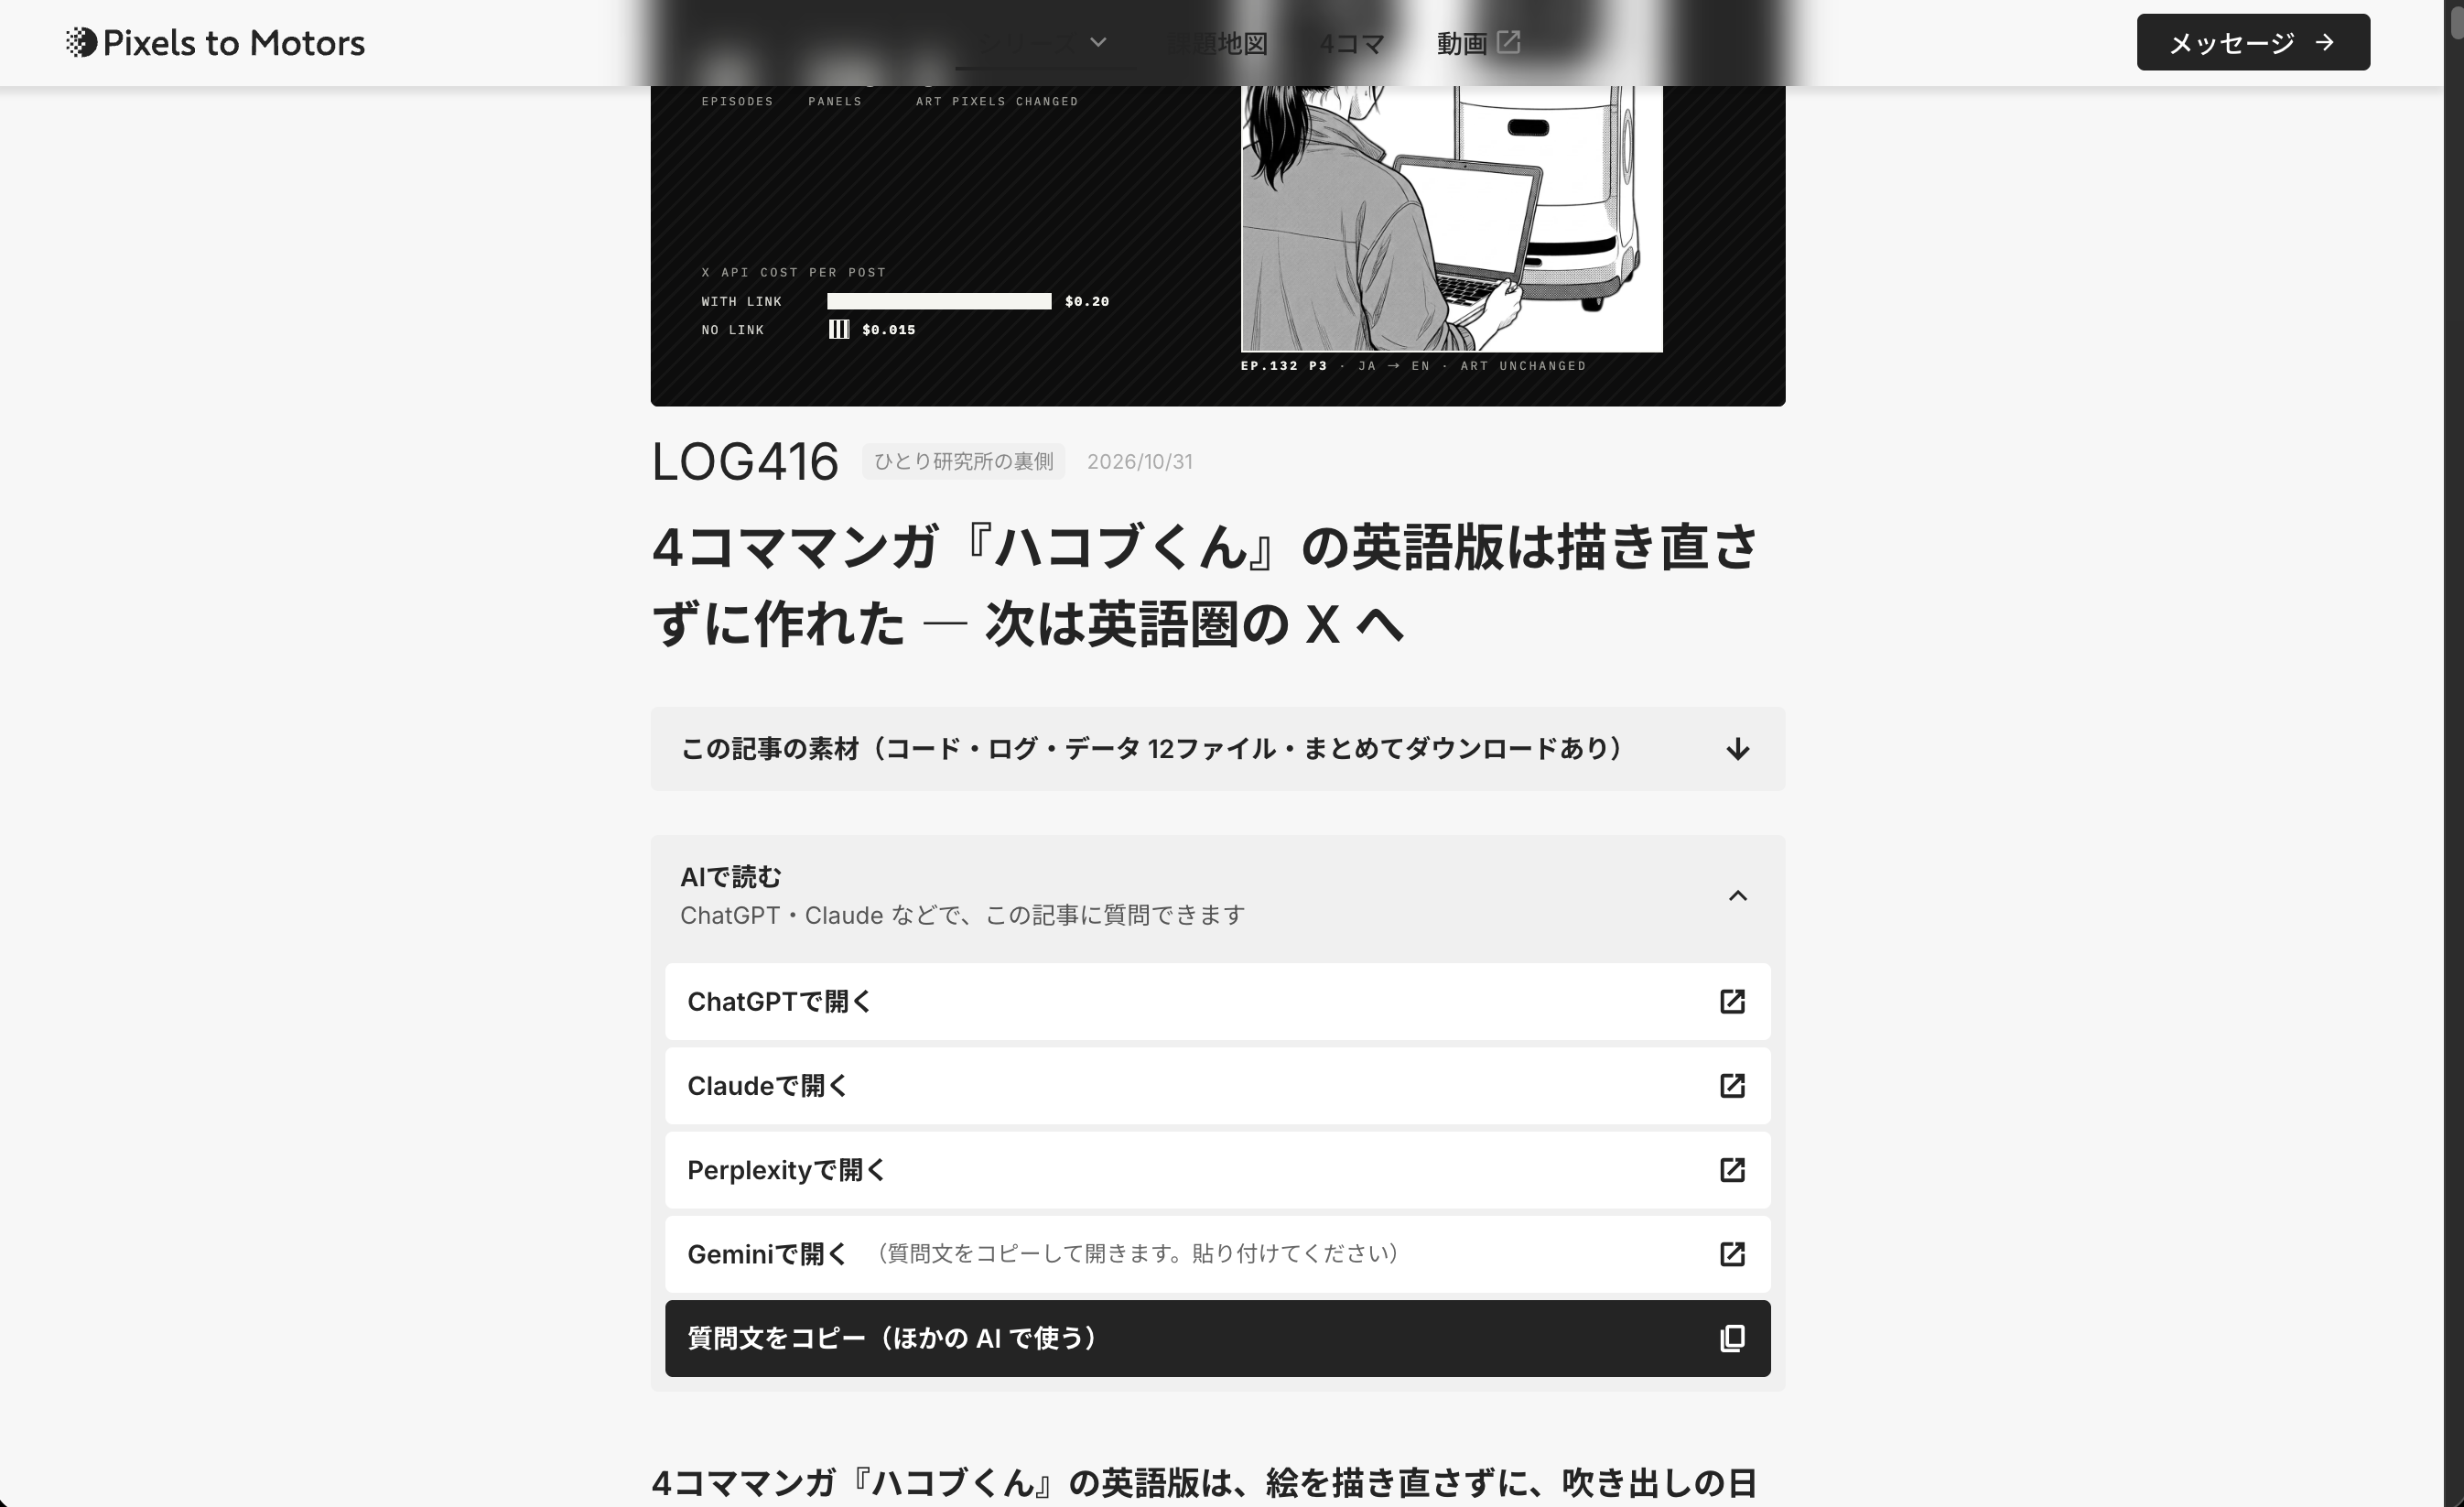
灰色の帯で、押すと AI の一覧が開く
場所は、タイトルのすぐ下にしました。読み手がコードを読み始めて困ったときより、最初に目に入る所のほうが見つけやすいためです。形は、すぐ上にある「この記事の素材」と同じ灰色の帯にそろえました。
押すと、次の5つが開きます。
| 行 | 押すと |
|---|---|
| ChatGPTで開く | 質問文が入力欄に入った状態で ChatGPT が開く |
| Claudeで開く | 同じく Claude が開く |
| Perplexityで開く | 同じく Perplexity が開く |
| Geminiで開く | 質問文をコピーしてから Gemini を開く(貼り付けてもらう) |
質問文をコピー(ほかの AI で使う) | 質問文をコピーする |
Gemini には、調べた範囲では、住所に質問文を付けて入力欄に入れる公式の方法がありません。そのため、コピーしてから開く2段階にしました。コピーできなかったときは、質問文をその場に出して、選んでコピーできるようにしています。
質問文は、要点と「自分の環境で再現するときに確かめること」
入力欄に入れる質問文は、次の形です。記事ページと全文ページの住所を両方入れ、全文のほうにコードと実行ログがあることを書いています。
この記事を読んで、質問に答えてください。
記事: https://pixelstomotors.com/record/DesFKiCf
全文(コード・実行ログを含む): https://pixelstomotors.com/record/DesFKiCf.md?via=chatgpt

まず、何をして何が分かったのかを短くまとめてください。そのあと、私が同じことを自分の環境で試すときに、確かめることを教えてください。
2つ目の問いを「自分の環境で再現するときに確かめること」にしたのは、このサイトの主指標が「再現可能な環境数」(他人が同じ手順で同じ結果に届く研究の数)だからです。記事を要約して終わりにせず、読み手が自分の機体やパソコンで試すところまでつなげたいと考えました。末尾の ?via=chatgpt は、どの AI から来たかの印です(次の節)。
前回選んだ AI を一番上に出す
選んだ AI を、見た人のブラウザに覚えます(p2m-site-ai)。次に開いたとき、その AI を一番上に移し、「前回」の印を付けます。覚えられない環境(プライベートブラウズなど)では、いつもの並びのまま動きます。
スマホとパソコンで確かめた
公開前に、手元でサイトを作って、幅 1280px と 390px の画面で開き、帯の形・一覧の開き方・コピーの動き・前回の並び替えを確かめました。公開後、私がスマホとパソコンで開いて確かめています(上の2枚の画面写真)。
スマホでは、一度押したあとに指を乗せたときの色が残り、「AIで読む」の帯だけが少し濃く見えることがあります。これは iPhone の表示のくせなので、直さないことにしました。
一度押したあとに指を乗せたときの色(ホバーの色)が残ることがあり、それが出ているので気にしないで。
ChatGPT・Claude をスマホで開いたときに、アプリのほうへ質問文が渡るかは、まだ確かめていません。アプリが入っていると、住所の後ろの質問文がアプリに渡らないことがあります。
作業ログ ― 押した数と、ボタン経由で AI が読みに来た数を数える
押した数は、サイトの計測の「押したもの」の表に出る
このサイトには、ページのどこが押されたかを数える仕組みがあります(/api/ev-stats。LOG411 で説明)。「AIで読む」の帯に data-ev-area="ai" を付け、場所「ai」として数えるようにしました。表には次の名前で出ます。
| 表に出る名前 | 何を押したか |
|---|---|
| btn:AIで読む:開く | 「AIで読む」を開いた |
AIで読む chatgpt.com | ChatGPTで開く |
| AIで読む claude.ai | Claudeで開く |
AIで読む www.perplexity.ai | Perplexityで開く |
AIで読む gemini.google.com | Geminiで開く |
| btn:AIで読む:コピー | 質問文をコピー |
開いた数と AI を選んだ数を比べると、開いたけれど選ばずにやめた人の割合も分かります。
全文ページの住所に印を付けて、ボタン経由の読み取りを分けた
押した数だけでは、そのあと AI が本当に記事を読んだかは分かりません。このサイトには、AI や検索エンジンの巡回プログラム(クローラー)が、どのページを読みに来たかを残す仕組みもあります(/api/cr-stats)。ChatGPT・Claude・Perplexity は、利用者に頼まれて読むとき ChatGPT-User・Claude-User・Perplexity-User と名乗るので、どの AI が来たかが分かります。
ただ、この記録だけでは、ボタン経由で来たのか、AI が自分で見つけて来たのかを分けられません。Gemini は名乗りの一覧に入っていないので、数にも入りません。
そこで、質問文に入れる全文ページの住所に、押した AI の印を付けました。
| 押したもの | 質問文の全文ページの住所 |
|---|---|
| ChatGPTで開く | /record/{slug}.md?via=chatgpt |
| Claudeで開く | /record/{slug}.md?via=claude |
| Perplexityで開く | /record/{slug}.md?via=perplexity |
| Geminiで開く | /record/{slug}.md?via=gemini |
| 質問文をコピー | /record/{slug}.md?via=copy |
サイトは、この印が付いた全文ページへの訪問を、名乗りが一覧にない読み手(Gemini や、人のブラウザなど)も「その他」として残します。数は /api/cr-stats の「AIで読む経由」の表に、押した AI ごとに「読みに来た回数・記事の数・読みに来たのはだれか」と、週ごとの内訳で出ます。
- ねらい:ボタンを押したあと、AI が本当に記事を読んだかを、押した AI ごとに知る
- 変わったこと:名乗りで見分けられる AI だけだった記録に、ボタン経由の印が付いた。Gemini の分も「その他」として数えられる
- 見込める効果:押した数とボタン経由で読みに来た数を並べると、どの AI だと読ませるところまで届いているかが分かる。押された数は、公開後の計測で確かめる
公開後、印が付いた住所を確かめのために1回開いたので、「その他」に1件入っています(via=chatgpt)。
印は、ボタンで開いたときだけ付きます。AI が自分で見つけて全文ページを読みに来たときは印がないので、今までどおり名乗りで数えます。
記録の仕組みを、作った部品で確かめた
公開の前に、サイトのプログラム(worker/index.js)を手元で動かし、作り物の訪問を4回送って、記録に入るものと入らないものを確かめました。名乗りのない Gemini(via=gemini)は「その他」、ChatGPT(via=chatgpt)は ChatGPT-User として残り、印のない人の訪問と、決まっていない印(via=evil)は残りませんでした。
<https://pixelstomotors.com/record/x>; rel="canonical" text/markdown; charset=utf-8
[
  { b: 'その他', p: '/record/x.md', s: '200', ok: '?', v: 'gemini' },
  {
    b: 'ChatGPT-User',
    p: '/record/x.md',
    s: '200',
    ok: '?',
    v: 'chatgpt'
  }
]
集計(/api/cr-stats?format=json)の「AIで読む経由」の部分は、次のように出ました。
    visits: 1,
    records: 1,
    bots: 'ChatGPT-User 1',
    last: '2026-11-01'
  }
] [ { week: '2026-10-26', total: 2, via: 'gemini 1、chatgpt 1' } ]
作業ログ ― 使ったコード(全文)
この記事のコード・ログ・データは、1ファイルずつ下に置いています。全文はリンク先にあります。
ファイルの一覧(4本)
01_src_lib_fulltext.ts.txt ― src/lib/fulltext.ts(全文ページの中身を作る)・5,901字
02_src_pages_record_slug_.astro.txt ― src/pages/record/[slug].astro(記事ページ。「AIで読む」の帯・質問文・前回の並び替え)・31,071字
03_sec05.txt ― 1つ目の公開の差分(worker・llms.txt・package.json)・4,806字
04_sec05.txt ― 2つ目の公開の差分(worker。ボタン経由の読み取りを数える)・8,787字
src/lib/fulltext.ts(全文ページの中身を作る)
// 記事の全文ページ(/record/{slug}.md。2026-11-01)
// AI が記事を丸ごと読めるように、1本の記事を飾りのない Markdown 1枚にする。
// - 長いコード・ログを外に分けた記事(tools/split_files.py)は、分ける前の全文(public/files/LOG{N}/LOG{N}_full.md・.html)を使う
// - Studio から移した記事(本文が HTML)は Markdown に直す(turndown)
// - 画像・図解・動画・このサイトの住所は、ページの外でも開けるよう https://pixelstomotors.com から始まる住所にする
// 人が見るのは今の記事ページのまま。全文ページは worker/index.js が canonical(正しいページは記事ページ)を付けて返す
import { existsSync, readFileSync } from 'node:fs';
import TurndownService from 'turndown';src/pages/record/[slug].md.ts(全文ページの住所を作る)
// 記事の全文ページ(/record/{slug}.md。2026-11-01)。中身の作り方は src/lib/fulltext.ts
import { getCollection } from 'astro:content';
import { SERIES_PAGES } from '../../lib/records';
import { mediaHtml } from '../../lib/media';
import { markdownRecord } from '../../lib/fulltext';

const seriesNameOf = (s: string) => {
  const key = s === 'Consideration' ? '考察記事' : s;
  return Object.values(SERIES_PAGES).find((c) => c.series === key)?.title.split(' | ').pop() || s;
};

export async function getStaticPaths() {
  const md = await getCollection('records');
  const seen = new Set(md.map((e) => e.data.slug));
  const studio = (Object.values(import.meta.glob('../../data/records/*.json', { eager: true, import: 'default' })) as any[])
    .filter((r) => !seen.has(r.slug));
  return [
    ...studio.map((r) => ({ params: { slug: r.slug }, props: { kind: 'studio', rec: r } })),
    ...md.map((e) => ({ params: { slug: e.data.slug }, props: { kind: 'md', entry: e } })),
  ];
}

export async function GET({ props }: { props: any }) {
  let text: string;
  if (props.kind === 'studio') {
    const r = props.rec;
    text = markdownRecord(
      { title: r.title, slug: r.slug, day: r.day, series: r.series, seriesName: seriesNameOf(r.series), published: r.published,
        description: r.description || '', lang: r.lang === 'EN' || /-en$/.test(r.slug) ? 'en' : 'ja' },
      { kind: 'studio', html: mediaHtml(r.body) },
    );
  } else {
    const d = props.entry.data;
    text = markdownRecord(
      { title: d.title, slug: d.slug, day: `LOG${d.day}`, series: d.series, seriesName: seriesNameOf(d.series), published: d.date.toISOString(),
        description: d.meta_description || '', lang: /-en$/.test(d.slug) ? 'en' : 'ja' },
      { kind: 'md', body: props.entry.body || '' },
    );
  }
  return new Response(text, { headers: { 'Content-Type': 'text/markdown; charset=utf-8' } });
}
src/pages/record/[slug].astro(記事ページ。「AIで読む」の帯・質問文・前回の並び替え)
---
import Base from '../../layouts/Base.astro';
import { ymd } from '../../lib/format';
import { mediaHtml } from '../../lib/media';
import { fixBody, textOf, abs, AUTHOR, PUBLISHER, SITE, SITE_NAME } from '../../lib/seo';
import { SERIES_PAGES, allCards, withDeepDiveThumb } from '../../lib/records';
import RecordCard from '../../components/RecordCard.astro';
import { getCollection, render } from 'astro:content';1つ目の公開の差分(worker・llms.txt・package.json)
commit 227e893c08509aef41a3e5dc64c9b8ee30dcefa5
Author: PixelstoMotors <studio@adaptdesign.jp>
Date:   Sun Nov 1 09:57:54 2026 +0900

    記事の全文ページ(/record/{slug}.md)と「AIで読む」ボタンを足す

    - すべての記事に、AI が丸ごと読める Markdown の全文ページを作る(分けたコード・ログも含む)
- 全文ページは記事ページを canonical にして返す。head の alternate と llms.txt を全記事でこのページに2つ目の公開の差分(worker。ボタン経由の読み取りを数える)
commit 7f4920e070fc1d6cff050ce128363a5cf7d54bcf
Author: PixelstoMotors <studio@adaptdesign.jp>
Date:   Sun Nov 1 10:10:28 2026 +0900

    「AIで読む」経由で AI が全文ページを読みに来た数を、押した AI ごとに数える

    - 質問文の全文ページの住所に ?via=(chatgpt・claude・perplexity・gemini・copy)を付ける
- worker がその訪問を、名乗りが一覧にない読み手(Gemini など)も「その他」として残す確かめに使ったスクリプト(worker の記録を作り物の訪問で確かめる)
crypto.subtle.timingSafeEqual = () => true;
import w from '/tmp/claude-0/-home-claude/d61a015b-0dbb-5beb-969e-ce8ba4954c3b/scratchpad/w/index.js';
const puts = [], waits = [];
const env = { ASSETS: { fetch: async () => new Response('# t', { status: 200, headers: { 'content-type': 'text/markdown' } }) },
  MESSAGES: { put: async (k, v, o) => puts.push(o.customMetadata), list: async () => ({ objects: puts.map((m, i) => ({ key: `cr/2026-11-01/${i}`, customMetadata: m })), truncated: false }) },
  STATS_KEY: 'k' };
const ctx = { waitUntil: (p) => waits.push(p) };
const go = async (u, ua) => { const r = await w.fetch(new Request(u, { headers: { 'user-agent': ua } }), env, ctx); await Promise.all(waits); return r; };
let r = await go('https://pixelstomotors.com/record/x.md?via=gemini', 'Mozilla/5.0 Chrome');
console.log(r.headers.get('link'), r.headers.get('content-type'));
await go('https://pixelstomotors.com/record/x.md?via=chatgpt', 'Mozilla/5.0 ChatGPT-User/1.0');
await go('https://pixelstomotors.com/record/x.md', 'Mozilla/5.0 Chrome');
await go('https://pixelstomotors.com/record/x.md?via=evil', 'Mozilla/5.0 Chrome');
console.log(puts);
const s = await w.fetch(new Request('https://pixelstomotors.com/api/cr-stats?key=k&format=json'), env, ctx);
const j = await s.json(); console.log(j.byVia, j.byViaWeek);
次は、押された数と、ボタン経由で AI が読みに来た数を並べて見る
公開した時点では、まだ数がありません。押された数(/api/ev-stats の場所 ai)と、ボタン経由で AI が全文ページを読みに来た数(/api/cr-stats の「AIで読む経由」)を並べ、どの AI だと記事を読ませるところまで届いているかを見ます。あわせて、ボタンとは関係なく、AI が自分で全文ページを読みに来る数が増えるかも見ます。引用を増やすという目的に効いているかは、こちらの数で確かめます。