
フィジカルAI研究室を作る Log#33 | アームの成否判定を Google の Gemini Decision 1 に任せられるか
この記事の素材(コード・ログ・データ 3ファイル・まとめてダウンロードあり)arrow_downwardAIで読む ChatGPT・Claude などで、この記事に質問できます expand_more
Google の判断専用モデル Gemini Decision 1 は、小型ロボットアーム mechArm 270 がブロックを箱に入れたかどうかを、上カメラの1枚の画像から、正解のある56本すべてで見分けられた(答えの値を0.39で区切った場合)。一方で、ブロックを爪の奥まで深くつかめたか、爪がブロックの上に乗ってしまったか、といった細かい形はほとんど見分けられなかった。 2026年11月11日に出たばかりのこのモデルを、実機の記録56本で試しました。
試したことで、次のことが分かりました。
- 成功・失敗の判定は任せられそう:「箱に入ったか」は56本中56本、「持ち上がったか」は56本中54本が人の判定と合った。今は Claude に画像を2枚見せて文章で判定させているが、その置き換えの候補になる
- 細かい形の判定は任せられない:「浅いつかみ」はほとんどの本を「やや浅い」と答え、「爪がブロックに乗った」と「人の手が写っている」は全部を「いいえ」と答えた。こちらは今までどおり、画素を数えて測る自前の道具(grasp_depth.py)を使う
- 速さと費用:1回の問い合わせは中央値0.96秒(手元の Mac から画像を送って答えが返るまで)。56本・168回で入力は12万5,664トークン、有料なら約0.013ドル(約2円)。今回は無料枠なので0円
この回は、X で見かけた tatsuki さんの投稿で「判断するだけの AI」が出たと知ったのがきっかけです。Google の発表 によると、Gemini Decision 1 は文章を書かず、こちらが用意した選択肢に確率を付けて返すだけのモデルで、1回に最大1,000問をまとめて聞けます。ロボットの研究で使うなら、「つかめたか」「箱に入ったか」のような決まった問いに、速く安く答えてくれる道具になるかもしれない。そこで、すでに人が判定を付けてあるお手本の記録で、どこまで当たるかを測りました。
| やったこと | なぜ | 結果 |
|---|---|---|
正解の付いたお手本56本から、上カメラのコマを1本3枚ずつ切り出した | 同じ画像で、人の判定と比べるため | 閉じて1秒後・閉じて3秒後・最後のコマの168枚 |
5つの問いを作り、依頼箱で Mac から Gemini Decision 1 に聞いた | 「入ったか」のような結果と、「深さ」のような形の両方を試すため | 168回すべて通った。エラー0件 |
正解と比べ、答えの値が「はい」と「いいえ」でどれだけ分かれるかを見た | 0.5で切った一致の数だけだと、偏った答えでも高く見えるため | 箱に入った・持ち上がったは分かれた。深さ・爪が乗った・手は分かれなかった |
数字はすべて、記録(results.csv)から計算した値です。今の Claude の判定と比べてどちらが良いかは、まだ測っていません。
GPU を買うか借りるかの判断は、Runpod で実際に借りて学習させた費用をもとに、別のページにまとめています。
導入比較ガイドロボットAIの学習用GPU、買うか借りるか実際に借りて学習させた費用と、損益分岐の計算機で決められますarrow_forward作業ログ ― Gemini Decision 1 に mechArm 270 のお手本56本を判定させるまで
ここから下は作業の記録です。コードと出力は全量で載せます。
この回で何度も出てくる言葉を先に言い換えておきます。
- お手本:ロボット用の AI(Physical Intelligence の π0.5)に学ばせるために、人が教えた動きを mechArm 270 に再生させて撮った記録。1本が「ブロックをつかんで箱に入れる」1回分
- 浅いつかみ:爪を閉じて1秒後に、ブロックが爪先の印から24ピクセル(約9mm)より先にはみ出している状態。持ち上げで落としやすいので、学習のお手本から外している
- 爪がブロックに乗った:爪が開いたままブロックの上に降りてしまい、横から挟めなかった回
- 依頼箱:Claude Code への依頼を iCloud のフォルダに置くと、Mac の見張り役が自動で Claude Code に渡し、報告を書き戻す仕組み
Gemini Decision 1 は、選択肢に確率を付けて返すだけの Google のモデル
Gemini Decision 1 は、Google DeepMind が2026年11月11日に出した、判断だけをするモデルです。Gemini Decisions API(Google AI Studio の鍵で使える入口)から呼びます。ふつうの AI のように答えの文章を1語ずつ作るのではなく、こちらが決めた選択肢を一度の計算で採点し、確率を返します。
| 言葉 | この回での意味 |
|---|---|
| noul(はい/いいえ) | 「はい」である確率を 0.01〜0.99 で返す問い。この回の「箱に入ったか」など4つ |
| score(段階の採点) | 0 から始まる段階に確率を付け、その平均を返す問い。この回の「深さ」(0=深い・1=やや浅い・2=浅い) |
| choice(選択) | 2〜255 の選択肢から1つを選ぶ問い。この回は使っていない |
自信の値(confidence) | いちばん確率の高い答えの確率。はい/いいえなら、0.9 は「はい」か「いいえ」に強く寄っている |
| 区切り | 「この値以上ならはい」とみなす線。0.5 が素直な区切りだが、問いごとに決め直してよい |
Google の発表では、1回の問い合わせは通信込みで150〜250ミリ秒、入力100万トークンあたり0.10ドルで、答えの側(出力)には料金がかかりません。無料枠もあり、無料枠で送ったデータは Google の製品の改善に使われます。この回は無料枠で試しました。
このプロジェクトでは、mechArm 270 の上カメラの画像を見て「つかめたか」「箱に入ったか」を判定する所に使えるかを試します。今はこの判定を、Claude(Sonnet)に動く前と後の画像2枚を見せ、理由の文章つきで答えさせています(実機の台帳 pick_place_ledger_v3.csv の pick_reason の列)。
正解のある56本を選び、上カメラのコマを3枚ずつ切り出した
この記事のコード・ログ・データは、1ファイルずつ下に置いています。全文はリンク先にあります。
ファイルの一覧(3本)
01_manifest.csv ― manifest.csv(56本の正解とコマのパス)・11,029字
02_decision_eval.py.txt ― decision_eval.py(Gemini Decision 1 に問い、正解と比べる)・5,584字
03_results.csv ― results.csv(Gemini Decision 1 の答え。56本×問い5つの280行)・32,489字
正解には、2026年11月9日に深いお手本を撮った2回(LOG463 の研究室 Log#25・LOG479 の Log#26)の記録を使いました。この2回は、人が1本ずつ「つかめたか・箱に入ったか」を判定し、外した理由(浅い・爪がブロックに乗った)も表に残しています。深さは grasp_depth.py が画素で測った値です。
| 正解の種類 | 本数(56本のうち) | 正解の元 |
|---|---|---|
| 浅いつかみ | 17 | grasp_depth.py(閉じて1秒後 24px 超) |
| 爪がブロックに乗った | 8 | 人が付けた外した理由 |
| 人の手が写っている疑い | 3 | grasp_depth.py(閉じる前のコマで肌の色を拾った) |
| 持ち上がらなかった | 6 | 人の判定(pick) |
| 箱に入らなかった | 6 | 人の判定(place) |
コマは問いに合わせて3枚にしました。深さ・爪・手は閉じて1秒後のコマ(grasp_depth.py が測ったのと同じコマ)、持ち上がったかは閉じて3秒後、箱に入ったかは最後のコマです。画像は元の1920×1080 を 1280×720 に縮めて送りました。
prep.py(正解の表 manifest.csv とコマ168枚を作る)
Mac の KIOXIA の lab/Log33/ で動かしました。元の記録(runs/)は読むだけです。
import csv,sys,os,cv2,bisect
D=os.path.expanduser("~/mnt/KIOXIA/r2r2r-data")
gd={}
for f in [D+"/lab/Log25/grasp_depth.csv","gd_log26.csv"]:
    for r in csv.DictReader(open(f)): gd[r["run"]]=r
rows=[]
for f,log in [(D+"/lab/Log25/runs_table.csv","Log25"),(D+"/lab/Log26/runs_table.csv","Log26")]:
    for r in csv.DictReader(open(f)): rows.append((log,r))
os.makedirs("img",exist_ok=True); out=[]
for log,r in rows:
    run=r["run"]; g=gd[run]; rd=f"{D}/runs/run_pick_place/{run}/recording"
    ts=[float(x["capture_ts"]) for x in csv.DictReader(open(rd+"/top_frame_log.csv"))]
    tc=float(g["t_close"]) if g["t_close"] else None
    cap=cv2.VideoCapture(rd+"/top.mp4"); n=int(cap.get(7))
    def grab(i,name):
        i=max(0,min(i,n-1)); cap.set(1,i); ok,fr=cap.read()
        if not ok: return ""
        fr=cv2.resize(fr,(1280,720)); p=f"img/{run}_{name}.jpg"; cv2.imwrite(p,fr,[cv2.IMWRITE_JPEG_QUALITY,90]); return p
    fa=int(g["frame_after"]) if g["frame_after"] else None
    lift=bisect.bisect_left(ts,tc+3.0) if tc else None
    out.append(dict(log=log,run=run,position=r["position"],human_pick=r["pick"],human_place=r["place"],
      after_px=g["after_px"],shallow=g["shallow"],hand_suspect=g["hand_suspect"],use=r["use"],reason=r["reason"],
      claw_on_block="爪がブロック" in r["reason"],
      img_after=grab(fa,"after") if fa is not None else "", img_lift=grab(lift,"lift") if lift else "", img_end=grab(n-1,"end")))
w=csv.DictWriter(open("manifest.csv","w"),fieldnames=list(out[0])); w.writeheader(); w.writerows(out)
print(len(out), sum(1 for o in out if o["img_after"]))
manifest.csv(56本の正解とコマのパス)
log,run,position,human_pick,human_place,after_px,shallow,hand_suspect,use,reason,claw_on_block,img_after,img_lift,img_end
Log25,run_0001_20261109_093045,1,yes,yes,43.4,True,False,外す,浅い (閉じて 1.0 秒後 43.4px > 24px) / 教え直す前の記録,False,img/run_0001_20261109_093045_after.jpg,img/run_0001_20261109_093045_lift.jpg,img/run_0001_20261109_093045_end.jpg
Log25,run_0001_20261109_094839,1,yes,yes,16.2,False,False,使う,,False,img/run_0001_20261109_094839_after.jpg,img/run_0001_20261109_094839_lift.jpg,img/run_0001_20261109_094839_end.jpg
Log25,run_0001_20261109_095308,1,yes,yes,19.6,False,False,使う,,False,img/run_0001_20261109_095308_after.jpg,img/run_0001_20261109_095308_lift.jpg,img/run_0001_20261109_095308_end.jpg
Log25,run_0001_20261109_095452,1,yes,yes,29.2,True,False,外す,浅い (閉じて 1.0 秒後 29.2px > 24px),False,img/run_0001_20261109_095452_after.jpg,img/run_0001_20261109_095452_lift.jpg,img/run_0001_20261109_095452_end.jpg
Log25,run_0001_20261109_095630,1,yes,yes,26.0,True,False,外す,浅い (閉じて 1.0 秒後 26.0px > 24px),False,img/run_0001_20261109_095630_after.jpg,img/run_0001_20261109_095630_lift.jpg,img/run_0001_20261109_095630_end.jpg
Log25,run_0001_20261109_095810,1,yes,yes,11.2,False,False,使う,,False,img/run_0001_20261109_095810_after.jpg,img/run_0001_20261109_095810_lift.jpg,img/run_0001_20261109_095810_end.jpg
Log25,run_0001_20261109_095948,1,yes,yes,19.5,False,False,使う,,False,img/run_0001_20261109_095948_after.jpg,img/run_0001_20261109_095948_lift.jpg,img/run_0001_20261109_095948_end.jpg5つの問いを作り、依頼箱で Mac から聞いた
問いは英語で書きました(Gemini Decisions API の例が英語で、問いの文がそのまま判定に使われるため)。どの問いにも、写っているものの説明を1行付けています。
| 問い(記録の名前) | 見るコマ | 型 | 問いの中身 |
|---|---|---|---|
| depth | 閉じて1秒後 | 段階の採点 | ブロックは爪の奥まで入っているか(深い・やや浅い・浅い) |
| claw_on_block | 閉じて1秒後 | はい/いいえ | 爪がブロックの横ではなく上に乗っているか |
| hand | 閉じて1秒後 | はい/いいえ | 人の手や指が写っているか |
| picked | 閉じて3秒後 | はい/いいえ | ブロックが爪の間にあり、マットから持ち上がっているか |
| placed | 最後のコマ | はい/いいえ | ブロックが白い箱の中にあるか |
鍵は、マンガの絵を作るときに使っている Google AI Studio の鍵(KIOXIA の gemini_api_key.txt)をそのまま使いました。Decisions API は同じ Gemini API の入口なので、新しく鍵を作る必要はありませんでした。
この作業場所(Claude のクラウドの作業環境)からは Google の API に届かなかったので、問い合わせは依頼箱で Mac の Claude Code に回してもらいました。
decision_eval.py(Gemini Decision 1 に問い、正解と比べる)
#!/usr/bin/env python3
"""decision_eval.py — Gemini Decision 1 が mechArm のお手本をどこまで正しく判定できるかを測る (読むだけ).

正解: lab/Log25・Log26 の runs_table.csv (人の判定 pick/place・外した理由) と grasp_depth.py の結果 (浅い=閉じて1秒後 24px 超・手の疑い).
入力: manifest.csv (prep.py が作る. 1本につき上カメラのコマ3枚: 閉じて1秒後 after / 閉じて3秒後 lift / 最後のコマ end)
鍵:   /Volumes/KIOXIA/gemini_api_key.txt
  python3 decision_eval.py run  [--limit N] [--resolution low|medium|high]   # API を呼んで results.csv に書く
python3 decision_eval.py score # results.csv と正解を比べて score.md に書く依頼160 の依頼文(20261113_160_GeminiDecision1でお手本の判定を正解と比べる.md)
依頼の文と、記録の置き場所の名前は Log32 のままです。あとで、研究室の Log#32 は LOG492 ですでに使っていたと分かり、置き場所を lab/Log33/ に移しました。
---
作業フォルダ: /Users/shimazueiichi/r2r2r-scripts
上限時間: 40
---
# Gemini Decision 1 で mechArm のお手本の判定を正解と比べる(研究室 Log32・LOG497)

Google の Gemini Decisions API(gemini-decision-1)に、お手本のコマを問い、人の判定・grasp_depth.py の結果と比べる。**読むだけの比べ。実機は動かさない。r2r2r-scripts のファイルは変えない。**

準備は Claude(チャット)が済ませた:
- `/Volumes/KIOXIA/r2r2r-data/lab/Log32/` に manifest.csv(56本・正解つき)、img/(168枚)、code/decision_eval.py・code/prep.py、gd_log26.csv
- 鍵は `/Volumes/KIOXIA/gemini_api_key.txt`(マンガと同じ鍵。表示しない・どこにも写さない)。無料枠で行う(エイイチの決め 2026-11-13)

## 手順

1. `cd /Volumes/KIOXIA/r2r2r-data/lab/Log32`(KIOXIA がつながっていなければ止めて報告)
2. まず3本だけ試す:`python3 code/decision_eval.py run --limit 3`
   - HTTP 400/403/404 などで通らなければ、そこで止める。エラーの本文(鍵は除く)を報告に写す。直し方を推測で試し続けない(入口の URL・入力の形の直しは1回だけ試してよい。そのときは何を変えたかを報告に書く)
3. 通ったら全部:`python3 code/decision_eval.py run`(56本×3枚=168回。1回ごとに 0.4 秒あける)
4. `python3 code/decision_eval.py score` で score.md を作る
5. 実行の記録として `run_log.txt` に、実行した日時・コマンド・ERR の行の数を書く

## 報告に入れること
- score.md の中身をそのまま
- ERR があった数と、その理由の例
- 1回の時間の中央値・入力トークンの合計
- 決めてほしいこと(なければ「なし」)

## 守ること
- 書いてよいのは `lab/Log32/` の中の results.csv・score.md・run_log.txt だけ。ほかの記録(runs/・datasets/)は読むだけ
- 鍵の中身をログ・報告・ファイルに出さない
- git の操作はしない
依頼160 の報告(結果/20261113_160_GeminiDecision1でお手本の判定を正解と比べる_20261113_0040.md)
# 結果:20261113_160_GeminiDecision1でお手本の判定を正解と比べる

- 状態:完了
- 始めた時刻:2026-11-13 00:40
- 終わった時刻:2026-11-13 00:45(5分)
- 作業フォルダ:/Users/shimazueiichi/r2r2r-scripts
- この続きを Claude Code で話すとき:作業フォルダで `claude --resume 461d38fb-51f9-4fe1-8480-4d2c76afbc1f`

## Claude Code の報告

**やったこと**
- KIOXIA は接続されていました。`/Volumes/KIOXIA/r2r2r-data/lab/Log32` で、まず `run --limit 3` を試しました。9回とも通ったので、続けて `run`(56本×3枚=168回)を全部実行しました。そのあと `score` で score.md を作り、run_log.txt に実行の日時・コマンド・ERR の行の数を書きました。
- 入口の URL や入力の形は直していません。実機は動かしていません。git の操作もしていません。
- 鍵の中身は、ログ・報告・ファイルのどこにも出していません。

**結果**
score.md の中身(そのまま):

# Gemini Decision 1 の判定と正解の比べ

| 問い | 本数 | 正解が「はい」 | 一致 | 見逃し | 誤り | 自信0.8以上の一致 | 自信0.8未満の本数 |
|---|---|---|---|---|---|---|---|
| depth | 56 | 17 | 27 | 0 | 29 | 0/0 | 56 |
| claw_on_block | 56 | 8 | 48 | 8 | 0 | 0/1 | 55 |
| hand | 56 | 3 | 53 | 3 | 0 | 53/56 | 0 |
| picked | 56 | 50 | 54 | 0 | 2 | 18/18 | 38 |
| placed | 56 | 50 | 53 | 3 | 0 | 24/24 | 32 |

1回の依頼の時間 (通信込み): 中央値 0.96 秒 / 最大 2.52 秒
入力トークン: 1回あたり中央値 916 / 合計 228256 (費用の目安 $0.0228)

- **ERR の数**:0(3本の試しも全部の実行も、168回すべて通りました)。
- **1回の時間の中央値**:0.96 秒。
- **入力トークンの合計**:1回の依頼ごとに数えると 125,664 です。
  - score.md の「合計 228256」は、1回の依頼に入っている問いの数だけ同じトークンを足し直した値です。after のコマは3問なので3倍に数えられ、多く出ています。score.md は decision_eval.py が出すまま残し、run_log.txt にこの違いを書きました。
- **値の幅**:一致の数だけでは見えないので書いておきます。
  - claw_on_block の値は 0.20〜0.41、hand は 0.06〜0.13 でした。どちらも一度も「はい」になっていません。一致が多いのは、正解に「いいえ」が多いからです。
  - depth の値は 0.90〜1.48 で、56本中46本を「浅い」と答えています。区切りは 1.0 で、誤りの29本はこれが原因です。
  - picked と placed は、自信 0.8 以上の答えだけを見ると全部当たっていました(18/18、24/24)。

**変えたファイル**
- `/Volumes/KIOXIA/r2r2r-data/lab/Log32/results.csv`(新しく作成。280行)
- `/Volumes/KIOXIA/r2r2r-data/lab/Log32/score.md`(新しく作成)
- `/Volumes/KIOXIA/r2r2r-data/lab/Log32/run_log.txt`(新しく作成)
- r2r2r-scripts のファイルは変えていません。いつも作る作業の記録(logs/)も、今回は書いてよい場所が決まっていたので作っていません。

**決めてほしいこと**
1. depth の「浅い」の区切りを 1.0 のままにするかどうか。今の区切りだと、ほとんどが「浅い」になります。
2. score.md のトークン合計の数え方を、1回の依頼ごとに直すかどうか。直すには decision_eval.py を変える必要があり、今回の範囲の外なので変えていません。
run_log.txt(実行の記録)
Gemini Decision 1 お手本の判定の比べ (依頼 160・Log32) 実行の記録

2026-11-13 00:40:46  python3 code/decision_eval.py run --limit 3   -> 9 回すべて ok / ERR 0 行 (この results.csv は次の全部の実行で上書き)
2026-11-13 00:41:18  python3 code/decision_eval.py run              -> 168 回すべて ok / ERR 0 行 / 終了 00:45:19 (終了コード 0)
2026-11-13 00:45 頃  python3 code/decision_eval.py score            -> score.md を作成

ERR の行の数: 0
results.csv: 280 行 (見出しを除く. 56 本 x 問い 5 つ)
1 回の依頼の時間 (通信込み) の中央値: 0.96 秒
入力トークンの合計 (1 回の依頼ごとに数えた値): 125664
  ※ score.md の「合計 228256」は 1 回の依頼の中の問いの数だけ同じトークンを重ねて足した値 (after は 3 問なので 3 倍)
解像度: medium
番号の付け直し: 2026-11-13 07:12 に lab/Log32 から lab/Log33 へ移した(研究室の Log#32 は LOG492 で使っていたため。エイイチの決め)
score.md(decision_eval.py score の出力)
# Gemini Decision 1 の判定と正解の比べ

| 問い | 本数 | 正解が「はい」 | 一致 | 見逃し | 誤り | 自信0.8以上の一致 | 自信0.8未満の本数 |
|---|---|---|---|---|---|---|---|
| depth | 56 | 17 | 27 | 0 | 29 | 0/0 | 56 |
| claw_on_block | 56 | 8 | 48 | 8 | 0 | 0/1 | 55 |
| hand | 56 | 3 | 53 | 3 | 0 | 53/56 | 0 |
| picked | 56 | 50 | 54 | 0 | 2 | 18/18 | 38 |
| placed | 56 | 50 | 53 | 3 | 0 | 24/24 | 32 |

1回の依頼の時間 (通信込み): 中央値 0.96 秒 / 最大 2.52 秒
入力トークン: 1回あたり中央値 916 / 合計 228256 (費用の目安 $0.0228)
score.md の入力トークンの合計(228,256)は、1回の問い合わせに入っている問いの数だけ、同じ画像のトークンを重ねて足していました。閉じて1秒後のコマは3問をまとめて1回で聞いているので3倍に数えています。1回ごとに数え直すと125,664です(Claude Code が報告で気づいて書き添えた)。
results.csv(Gemini Decision 1 の答え。56本×問い5つの280行)
run,image,question,value,probabilities,confidence,latency_s,input_tokens,resolution
run_0001_20261109_093045,after,hand,0.07825768639650402,"""""",0.921742313603496,0.801,916,medium
run_0001_20261109_093045,after,claw_on_block,0.34722401849086054,"""""",0.6527759815091394,0.801,916,medium
run_0001_20261109_093045,after,depth,1.484278681760648,"{""2"": 0.6009309944115484, ""1"": 0.28241669293755106, ""0"": 0.11665231265090062}",0.6009309944115484,0.801,916,medium
run_0001_20261109_093045,lift,picked,0.80335932549735,"""""",0.80335932549735,0.711,667,medium
run_0001_20261109_093045,end,placed,0.7828334951626438,"""""",0.7828334951626438,0.706,661,medium
run_0001_20261109_094839,after,depth,1.2999504879618984,"{""0"": 0.17842460629738316, ""2"": 0.47837509425928165, ""1"": 0.3432002994433352}",0.47837509425928165,0.624,916,medium
run_0001_20261109_094839,after,hand,0.11374083289454251,"""""",0.8862591671054575,0.624,916,medium0.5 で切った一致の数だけでは、偏った答えを見落とす
score.md では「人の手」が56本中53本、「爪がブロックに乗った」が48本と、一致が多く見えます。ところが報告にあるとおり、この2つは1本も「はい」と答えていませんでした。正解の多くが「いいえ」なので、全部「いいえ」と答えるだけで一致が多くなります。
そこで、区切りを決めずに、正解が「はい」の本と「いいえ」の本で答えの値がどれだけ分かれているかを見ました。AUC は、「はい」の本を1つ、「いいえ」の本を1つ選んだとき、「はい」の本のほうが高い値をもらっている割合です。1.0 なら完全に分かれ、0.5 なら見分けがついていません。
analyze.py(正解の「はい」と「いいえ」で答えの値を分けて並べる)
#!/usr/bin/env python3
"""analyze.py — results.csv(Gemini Decision 1 の答え)を、正解で「はい」と「いいえ」に分けて並べる(読むだけ).

score.md は 0.5(深さは 1.0)で切った一致の数だけを出す. ここでは区切りを決めずに,
(1) 正解が「はい」の本と「いいえ」の本で、答えの値がどれだけ分かれているか(並べ替えの当たり=AUC。1.0 で完全に分かれる・0.5 で見分けがない)
(2) 値の幅
(3) 区切りを動かしたときに一致がいちばん多くなる区切りと、その一致の数
(4) 0.5 で切って外れた本
を問いごとに出す. 入力トークンは 1 回の依頼ごとに数え直す(score.md の合計は問いの数だけ重ねて足していた).
  python3 code/analyze.py > analysis.txt
"""
import csv, statistics as st

man = {r["run"]: r for r in csv.DictReader(open("manifest.csv"))}
res = {}
for r in csv.DictReader(open("results.csv")):
    res[(r["run"], r["question"])] = r
TRUTH = {
    "depth": ("浅いつかみ(閉じて1秒後に爪先から24px超)", lambda m: m["shallow"] == "True"),
    "claw_on_block": ("爪がブロックに乗った", lambda m: m["claw_on_block"] == "True"),
    "hand": ("人の手が写っている(手の疑い)", lambda m: m["hand_suspect"] == "True"),
    "picked": ("持ち上がった(人の判定 pick=yes)", lambda m: m["human_pick"] == "yes"),
    "placed": ("箱に入った(人の判定 place=yes)", lambda m: m["human_place"] == "yes"),
}

def auc(pos, neg):
    return sum((p > n) + 0.5 * (p == n) for p in pos for n in neg) / (len(pos) * len(neg))

for q, (name, f) in TRUTH.items():
    rows = [(float(res[(k, q)]["value"]), f(m), k, m) for k, m in man.items() if (k, q) in res]
    pos = sorted(v for v, t, _, _ in rows if t); neg = sorted(v for v, t, _, _ in rows if not t)
    cut0 = 1.0 if q == "depth" else 0.5
    best = max(((sum((v >= c) == t for v, t, _, _ in rows), c) for c in sorted({v for v, *_ in rows})), key=lambda x: x[0])
    print(f"== {q}:{name}")
    print(f"  本数 {len(rows)}(はい {len(pos)}・いいえ {len(neg)})  AUC {auc(pos, neg):.3f}")
    print(f"  はいの値   : 最小 {pos[0]:.3f} / 中央 {st.median(pos):.3f} / 最大 {pos[-1]:.3f}")
    print(f"  いいえの値 : 最小 {neg[0]:.3f} / 中央 {st.median(neg):.3f} / 最大 {neg[-1]:.3f}")
    print(f"  {cut0} で切った一致 {sum((v >= cut0) == t for v, t, _, _ in rows)}/{len(rows)}   一致がいちばん多い区切り {best[1]:.3f} 以上を「はい」→ {best[0]}/{len(rows)}")
    for v, t, k, m in sorted(rows):
        if (v >= cut0) != t and q in ("picked", "placed"):
            print(f"    外れ {k}  正解 {'はい' if t else 'いいえ'}  値 {v:.3f}  理由欄「{m['reason']}」")
    print()

lat = {}; tok = {}
for r in res.values():
    key = (r["run"], r["image"])
    lat[key] = float(r["latency_s"]); tok[key] = int(r["input_tokens"] or 0)
print(f"依頼の回数 {len(lat)}  時間の中央値 {st.median(lat.values()):.2f} 秒  最小 {min(lat.values()):.2f}  最大 {max(lat.values()):.2f}")
for img in ("after", "lift", "end"):
    t = [v for (k, i), v in tok.items() if i == img]
    print(f"  {img}: 入力トークン 1回 {int(st.median(t))}({len(t)} 回)")
s = sum(tok.values())
print(f"入力トークンの合計(1回の依頼ごと) {s}  費用の目安 ${s/1e6*0.10:.4f}(無料枠なので実際は0)")
analysis.txt(analyze.py の出力)
== depth:浅いつかみ(閉じて1秒後に爪先から24px超)
  本数 56(はい 17・いいえ 39)  AUC 0.724
  はいの値   : 最小 1.021 / 中央 1.181 / 最大 1.484
  いいえの値 : 最小 0.904 / 中央 1.076 / 最大 1.372
  1.0 で切った一致 27/56   一致がいちばん多い区切り 1.445 以上を「はい」→ 41/56

== claw_on_block:爪がブロックに乗った
  本数 56(はい 8・いいえ 48)  AUC 0.534
  はいの値   : 最小 0.198 / 中央 0.334 / 最大 0.403
  いいえの値 : 最小 0.236 / 中央 0.305 / 最大 0.410
  0.5 で切った一致 48/56   一致がいちばん多い区切り 0.403 以上を「はい」→ 48/56

== hand:人の手が写っている(手の疑い)
  本数 56(はい 3・いいえ 53)  AUC 0.774
  はいの値   : 最小 0.093 / 中央 0.111 / 最大 0.118
  いいえの値 : 最小 0.063 / 中央 0.089 / 最大 0.132
  0.5 で切った一致 53/56   一致がいちばん多い区切り 0.132 以上を「はい」→ 52/56

== picked:持ち上がった(人の判定 pick=yes)
  本数 56(はい 50・いいえ 6)  AUC 0.947
  はいの値   : 最小 0.515 / 中央 0.748 / 最大 0.879
  いいえの値 : 最小 0.140 / 中央 0.290 / 最大 0.677
  0.5 で切った一致 54/56   一致がいちばん多い区切り 0.515 以上を「はい」→ 54/56
    外れ run_0001_20261109_102715  正解 いいえ  値 0.608  理由欄「爪がブロックに乗った (PICK の区間 8.5 秒)」
    外れ run_0001_20261109_125607  正解 いいえ  値 0.677  理由欄「爪がブロックに乗った (PICK の区間 6.66 秒)」

== placed:箱に入った(人の判定 place=yes)
  本数 56(はい 50・いいえ 6)  AUC 1.000
  はいの値   : 最小 0.395 / 中央 0.781 / 最大 0.877
  いいえの値 : 最小 0.125 / 中央 0.132 / 最大 0.159
  0.5 で切った一致 53/56   一致がいちばん多い区切り 0.395 以上を「はい」→ 56/56
    外れ run_0001_20261109_124117  正解 はい  値 0.395  理由欄「」
    外れ run_0001_20261109_130723  正解 はい  値 0.404  理由欄「」
    外れ run_0001_20261109_101434  正解 はい  値 0.421  理由欄「爪がブロックに乗った (PICK の区間 7.9 秒)」

依頼の回数 168  時間の中央値 0.96 秒  最小 0.61  最大 2.52
  after: 入力トークン 1回 916(56 回)
  lift: 入力トークン 1回 667(56 回)
  end: 入力トークン 1回 661(56 回)
入力トークンの合計(1回の依頼ごと) 125664  費用の目安 $0.0126(無料枠なので実際は0)
| 問い | AUC | いちばん合う区切りでの一致 | 読み取れること |
|---|---|---|---|
| 箱に入った | 1.000 | 0.395 以上で 56/56 | 「はい」は 0.40〜0.88、「いいえ」は 0.13〜0.16。きれいに分かれた |
| 持ち上がった | 0.947 | 0.515 以上で 54/56 | 外れの2本は、どちらも爪がブロックに乗っていた回 |
| 浅いつかみ | 0.724 | 1.445 以上で 41/56 | 「浅い」17本の値はやや高いが、「深い」と重なる。いちばん合う区切りは、ほぼ全部を「深い」とする所 |
| 人の手 | 0.774 | 0.132 以上で 52/56 | 値は 0.06〜0.13。「はい」は3本だけで判断できない |
| 爪がブロックに乗った | 0.534 | 0.403 以上で 48/56 | 「はい」の8本が「いいえ」の中に混ざる。見分けがついていない |
結果の判定(箱に入ったか・持ち上がったか)は使えて、つかみ方の細かい形の判定は使えない。 区切りは0.5のままではなく、問いごとに決める必要があります。「箱に入った」は「はい」の本でも値が0.40〜0.88で、0.5 で切ると3本を見逃しました。
ねらい・変わったこと・見込める効果(成功・失敗の判定)
- ねらい:お手本や実機推論の1本ごとの「つかめたか・箱に入ったか」の判定を、決まった問いで速く安く出す
- 変わったこと:「箱に入った」は区切り0.39で56本すべて、「持ち上がった」は54本が人の判定と合った。1回の問い合わせは中央値0.96秒
- 見込める効果:今の Claude の文章での判定と並べて同じくらい当たるなら、台帳の判定をこちらに替えられる見込み(今の判定と同じ画像での比べはまだしていない)
箱に入ったかは見分け、爪が乗ったかは真上のカメラでは見えていない
答えの値が高かった本と低かった本の画像を並べると、何が見えていて何が見えていないかが分かります。
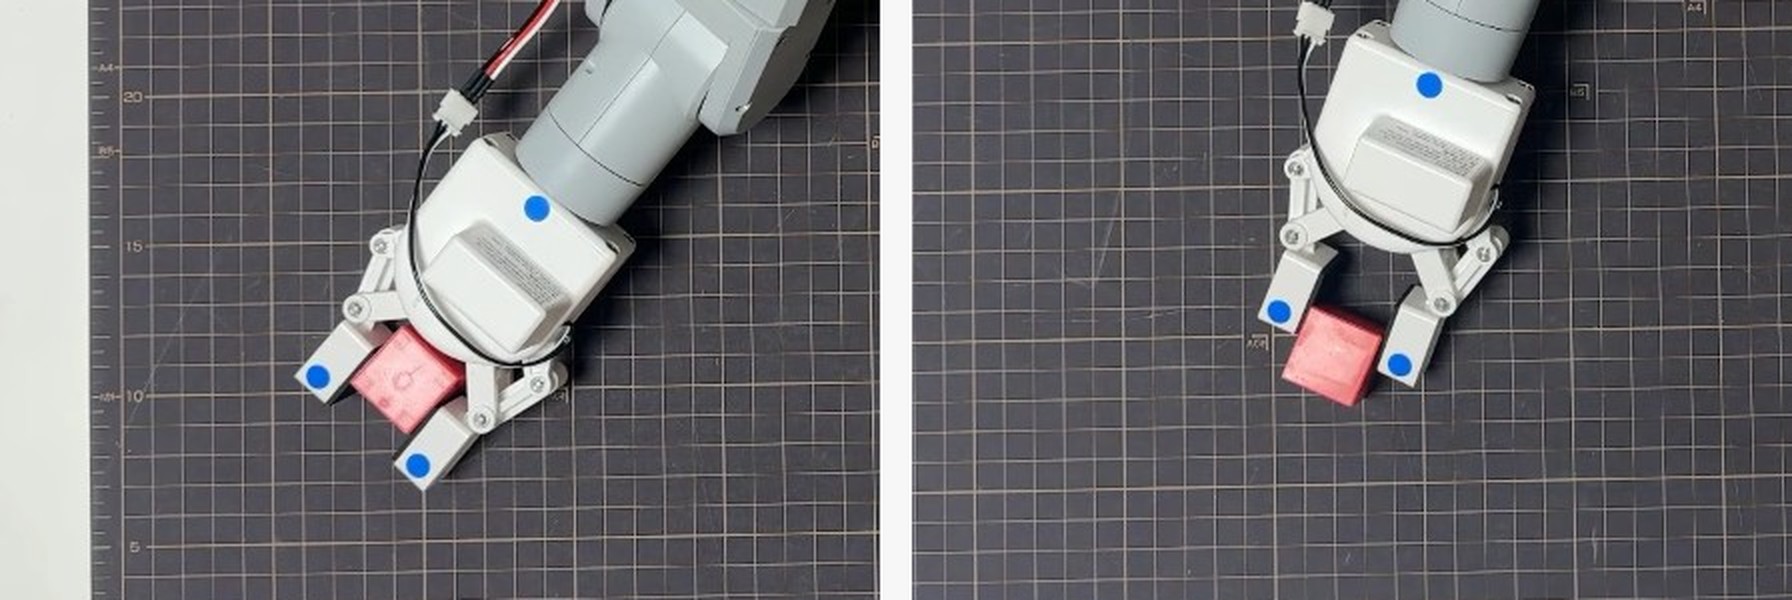
人が見ると、右のほうがブロックが爪先から出ているのは分かります。それでも答えの値の差は0.16しかありませんでした。画像全体(1280×720)のうち、爪のまわりは1割にも満たない広さです。
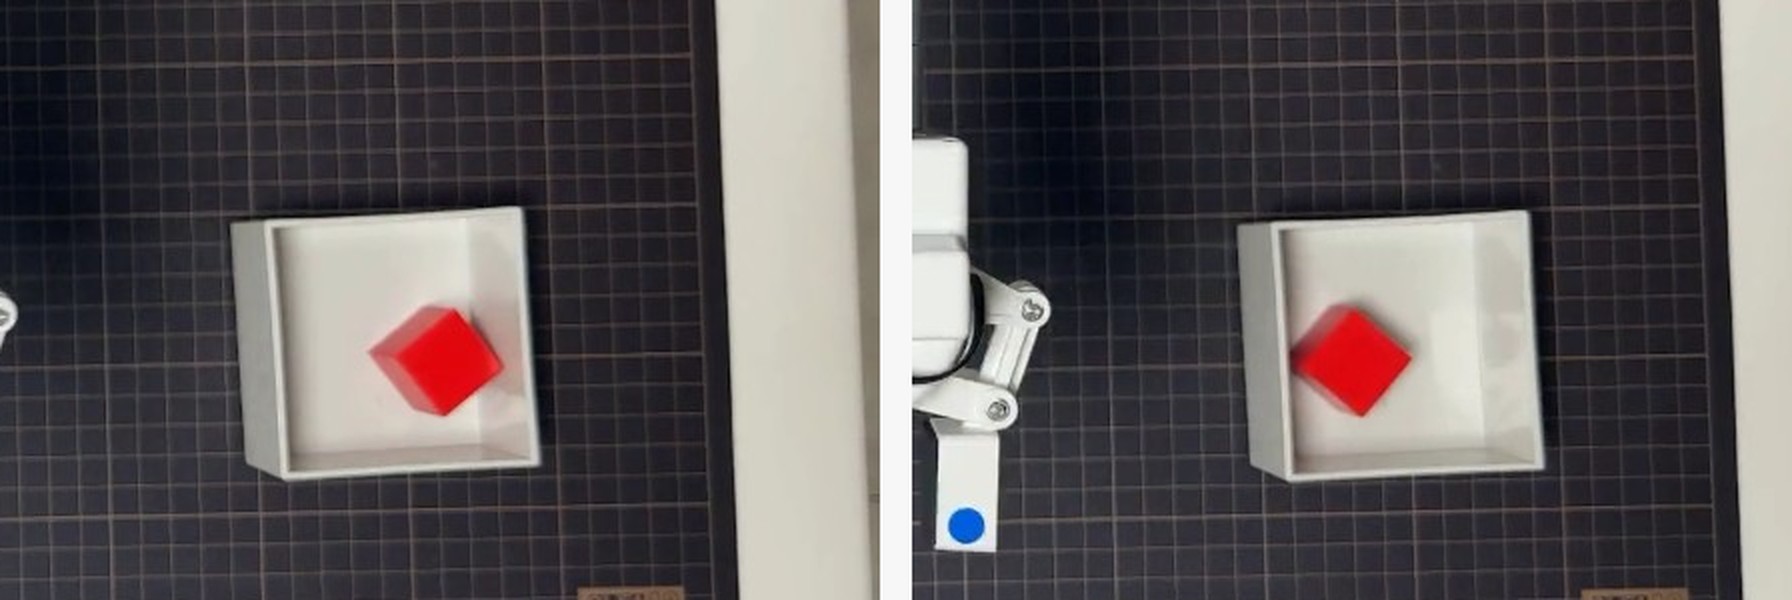
右も箱の中にブロックがあります。ブロックが箱の左の壁に寄っていて、爪の先が箱の近くにある分、値が下がったのかもしれません(確かめてはいない)。それでも「いいえ」の本(0.13〜0.16)よりは十分に高いので、区切りを0.39にすれば分けられます。
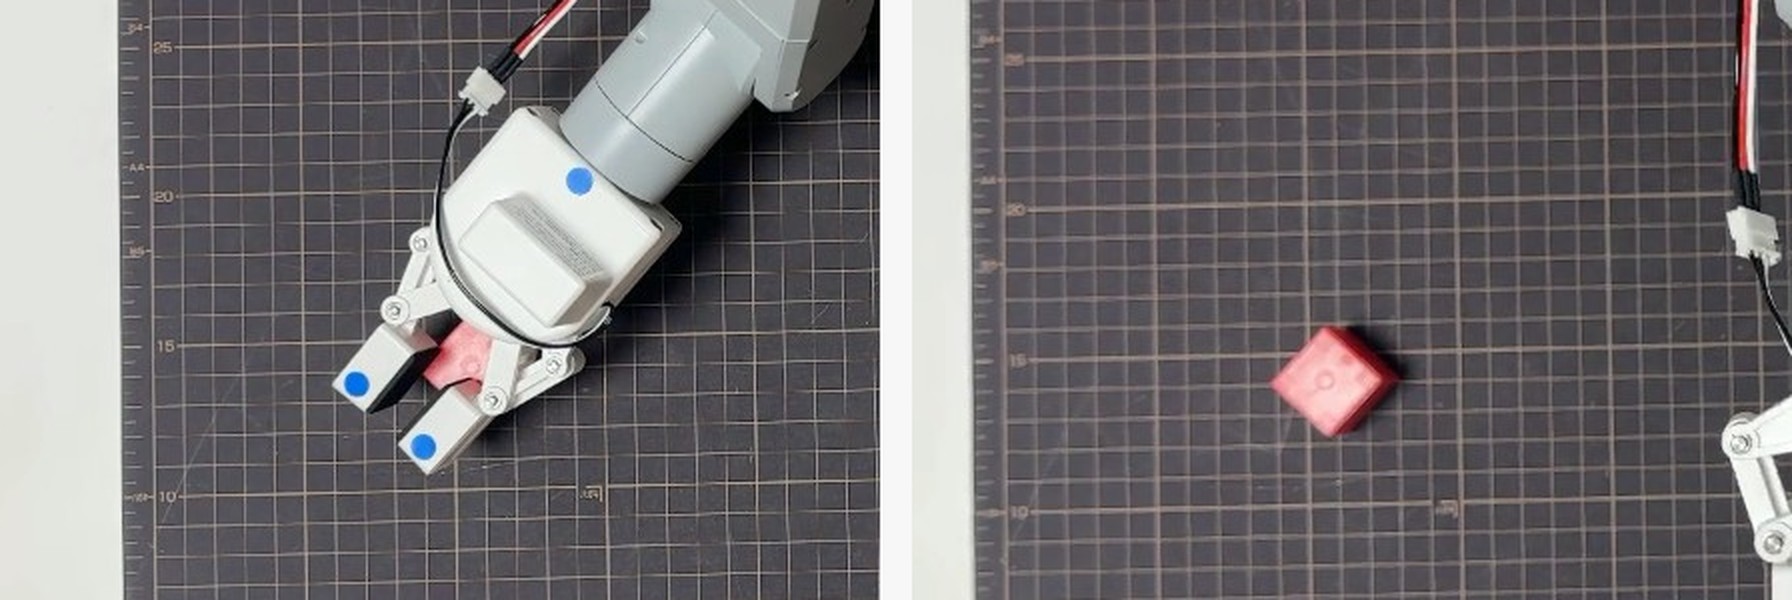
持ち上がったかの外れ2本は、この形でした。真上のカメラでは、ブロックが爪に挟まれて持ち上がっているのか、爪の下にあるだけなのかを区別できません。人が判定したときは、動画で前後の動きを見ていました。1枚の画像で高さを聞くのは、問いのほうに無理があります。
手元の Mac から1回0.96秒、168回で約2円
Google の発表の150〜250ミリ秒に対して、記録では中央値0.96秒、最大2.52秒でした。この時間は、Mac で画像を読み、base64 にして送り、答えが返ってくるまでのすべてを含みます(Google の窓口までの通信と、約170KB の画像を送る時間が入っています)。発表の値と同じ条件では測っていません。
入力トークンは、閉じて1秒後のコマ(3問)が1回916、ほかのコマ(1問)が661〜667でした。問いを増やしても、画像の分は1回にしか数えられません。168回で125,664トークン、有料の値段なら約0.013ドルです。
試すのにかかった時間は、依頼箱で全部を回すのが5分(00:40〜00:45)でした。
次は、今の Claude の判定と同じ画像で並べる
この回で分かったのは、Gemini Decision 1 が人の判定とどれだけ合うかまでです。台帳の判定を替えるかどうかは、今の Claude(Sonnet)の判定と同じ画像で並べてから決めます。
- 結果の判定(箱に入った・持ち上がった):Claude の判定と、当たりの数・時間・費用を並べる
- 持ち上がったか:真上の1枚では高さが見えないので、横のカメラのコマも一緒に送る形を試す
- 細かい形(深さ・爪が乗った):爪のまわりだけを切り抜き、解像度を上げて送れば分かれるかを試す。分かれなければ、今の grasp_depth.py を使い続ける
出典
- Google「Gemini Decisions API: Fast, calibrated multimodal decisions」(2026-11-11)https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- Flavio Copes「How to use the Gemini Decisions API」 https://flaviocopes.com/gemini-decisions-api/
- SiliconANGLE「Google enters decision model market with Gemini Decisions API」(2026-11-11)https://siliconangle.com/2026/11/11/google-enters-the-decision-model-market-with-gemini-decisions-api/