AIとの作業のイラッとを YouTube ショート14本に ― AIあるある
この記事の素材(コード・ログ・データ 3ファイル・まとめてダウンロードあり)arrow_downwardAIで読む ChatGPT・Claude などで、この記事に質問できます expand_more
Pixels to Motors の YouTube 向けに、AI 役のロボット、ハコブくんが真面目すぎてズレた返事をし、作り手が縦書きの心の声でひと言ツッコむ縦長ショート「AIあるある」を14本(13.8〜24.7秒)作り、2026年11月3日から16日まで毎日22時に X へ動画付きで先に出す予約をした。 素材はすべて、作り手が AI と毎日作業していて本当にイラッとした場面で、ツッコミの言葉も作り手が話した言葉から取っている。
この型ができて、変わることは次の3つです。
- 笑いの素材が、作り手の体験からそのまま出てくる。 これまでは、ユーモアを Claude が作ると嘘っぽくなるのが悩みでした。AIあるあるは、作り手が実際に言った言葉(もういいって・何度言えばわかる・アメリカ生まれなんだよなー)を台本の芯にするので、作り話にならずに済みます
- 1本を、セリフの表と画面の中身を書いた2つの小さなファイルで作れる。 共通の書き出しの部品(aiaru_kit.py・405行)を作ったので、各回は narration.py(セリフ)と spec.py(画面の中身と動き)を書くだけです。声は ElevenLabs で1本あたり52〜128字、書き出しは2本ずつ並べて1本約1〜2分でした
- X の予約投稿に、動画を付けられるようになった。 これまでの仕組みは画像しか付けられませんでした。ショートを YouTube より先に X に動画で出せます。ほかの動画にも使えます。本番で動くかは、11月3日22時の1本目で確かめます
会話を始めてから、14本を作り直して予約を差し替えるまで、約2時間半でした。前の型(マンガのショート)と比べた時間は測っていません。
きっかけは、作り手が YouTube にもう少しユーモアを入れたいと思ったことでした。参考に持ってきたのは、AI と酔っぱらいがやり取りする縦長動画5本です。作り手は、ここまでいくとやり過ぎ、としつつ、取り込める要素はないかと考えていました。動画を見ると、笑いの元は人間ではなく AI の側にありました。AI が真面目に、文字どおりに受け答えするほど、人間の短いひと言が効いてきます。この仕組みだけを取り出し、作り手とハコブくんに置き換えました。
| やったこと | なぜ | どうなったか |
|---|---|---|
参考動画5本の画面の文字を読み、笑いの仕組みを分けた | 酔っぱらいのノリではなく、まねできる仕組みを取り出すため | ズレ・文字の3層・自虐の一言・誠実さ・最後のひと言、の5つに分けた |
LOG と作り手の言葉から、素材を集めた | 作り話のユーモアにしないため | LOG から4場面、作り手の話から10場面。14本とも実体験 |
1本目「確認いらん」を組み立てた | 型を決めるため | 23.7秒。作り手が、いいねぇ!いい感じ! と判断 |
共通の部品 aiaru_kit.py にまとめた | 続けて作れるようにするため | 2〜14本目は、セリフと画面の中身を書くだけで作れた |
ハコブくんの動きと向きを増やし、背景の写真を10本に入れた | 作り手の指示(動き・向き・背景) | 冒頭の登場が5種類、文の途中の動きが9種類。背景は Gemini で10枚 |
X の予約投稿に動画を付けられるようにした | ショートを YouTube より先に X に出すため | 14本を11月3〜16日の毎日22時に予約 |
ここで書く効果は、書き出しの時間と字数のように測ったものと、見込みが混ざっています。見込みの所はそう書きます。見る人が笑ったか・最後まで見たかは、公開後の YouTube と X の数字で確かめます。
作業ログ ― 参考動画の笑いを5つの仕組みに分けた
参考の5本は、AI の音声アシスタントと、酔った人がキッチンでやり取りする縦長動画です。音声の入っていない画面収録だったので、画面の字幕とテロップを読んで中身を追いました。AI の返事は青い字幕、人の言葉は白い字幕で出ます。それとは別に、人の心の声が、縦書きの大きな文字で叩きつけられます(無理やろ・確認いらんよ・虚言AI)。
分けた仕組みは次の5つです。
| 仕組み | 参考動画での形 | 取り込み方 |
|---|---|---|
| 真面目な AI と雑な人間のズレ | AI は、決して馬鹿にはしていません、と律儀に返す。人は短く返すだけ | ハコブくんは真面目すぎて律儀。作り手は短くツッコむ係 |
| 文字の3層 | AI は青、人は白の字幕。心の声は縦書きの大きな文字 | 字幕は動かさず、縦書きのツッコミだけ別の層で叩きつける |
| 自虐の一言 | AIを飲み友に育てた友達0人泥酔ニキ、の一言で人物が決まる | 作り手に決めてもらう(Claude が作ると嘘っぽくなる) |
| AI の誠実さが共感を呼ぶ | コメント欄は、なんだかんだ誠実、優しい、が多い | 怒られても真面目なハコブくんにする |
| 最後のひと言で落とす | 褒めすぎワロタ、のように最後のやり取りがオチ | オチは作り手の言葉か、ハコブくんの真面目な一言 |
取り込まないものも決めました。www の多用と、下品さや相手を雑に扱う空気です。このチャンネルが狙う視聴者は、ロボティクスに興味のある経営者・PM・開発者で、そこには逆効果になります。
LOG と作り手の言葉から、14本の素材を集めた
最初は、LOG の中から AI に、それ違う、確認いらん、と言いたくなった場面を探しました。見つかったのは次の4つです。
| 場面 | 出どころ | 使った回 |
|---|---|---|
アームがつかめなくなった原因を AI と7回取り違え、AI は自分で決めた安全の制限にこだわって止まった | 1年の記録の LP の年表 | 01 確認いらん(同じ形の、くり返す確認) |
頼んだことと違う向きに受け取り、言葉の意味を長々と説明した | LOG284 | 10 説明くさい(同じ形) |
返事が2回英語になり、英語で書いてあってわからないよ?、英語だよ?、と聞き返した | LOG333 | 02 英語だよ |
言いたいことを説明していたら、AI が組み合わせ最適化の話に持っていった | 考察記事の元の文 | 11 つまらなくする天才(同じ形) |
確認いらん、について、作り手はこう話しました。
確認いらんは、何度も何度も同じことを確認してくる時イラってなったのは何度もある。 AIがどんな言い方で確認してきたかは、真面目に何度も繰り返してくるところだな。
英語の回には、こう返ってきました。
最近これめっちゃ多いよね。これもイラッとしてる。共感されそう!
1本目のツッコミの言葉は、作り手が心の中でつぶやいている言い方に直してもらいました。Claude の仮の言葉(いい・さっき言った・それ)は、もういいって・さっき言ったって・あーもーやめてー、になりました。
いいは、もういいって、って心の中でつぶやいていることあるね。 あーもーやめてー、とかも思ってる。
英語の回のオチに Claude が置いた、知っとるやん、は使わないことになりました。
4本を作ったあと、ネタをもっと増やすために、作り手が普段 AI とやっていて感じていることを、まとめて話してくれました。5〜14本目は、この言葉をツッコミとオチにしています。
画像の直しを指定するのは難しい。具体的な指示が頼みづらいんだよね(いつもは自分で操作してたから、AIに伝わる言葉にするのが大変)
30本妙に早くあがってきたなと思ったら、ほぼ同じ内容の繰り返しで、あーそっちできたかーと凹む。
動画の字が小さいは、わりといつも思ってる。何度も言うの諦めそうになるくらい何度もある。
突然ドルで計算してくる時は、日本語使っててもアメリカ生まれなんだもんなーと思ってる。
鉤括弧はほんと嫌って思ってる。あと段落の・とか1.とか、:とか、そればっかだなと思ってる。
文脈の理解やユーモアを理解させるのが、ほんとうに大変で骨が折れる。
音声確認が超大変。今の1番の悩み(一番時間取られてる作業だから)
方向を理解できないのが、説明するの大変。チャットが変わるとまた説明し直しだし。
文章の構成と言葉の使い方がいつも説明くさくて、強弱ができないのが問題だなと思いつつ、うまく指示出来ない俺も悪いんかと思って作業してる。
codexは話をつまらなくする天才だと思う。事実確認にはいいけどね。人は事実だけじゃ興味をそそられないんだよね。派手な映像ならともかく。
ここから10本の流れを組み、作り手が、全部作っていいよ、と決めました。ハコブくんのセリフと画面の小ネタ(06 のほとんど大きくならない字、11 の笑いの所に引かれる取り消し線、04 のボタンが両方はいになっている相談の窓など)は Claude の案です。
決め台詞も1つ決まりました。ハコブくんが作り手にツッコもうとしたときに、作り手が返すひと言です。
ハコブくんが俺にツッコミを入れようとしている時に、俺が、おまえさんはまだ体がないからつっこめないだろ! とか、腕ないくせに! とかをたまに返すと決め台詞になるかもね。
呼び方は、おまえさん、ではなく、ハコブくんは、にそろえました。体がない AI と体を持つ AI の違いは、フィジカル AI の話の真ん中なので、笑いの一言がそのままチャンネルの中身を伝えます。今回の14本にはハコブくんがツッコむ場面がないので、次の考察回で1回入れてみます。
1本目「確認いらん」を、考察回のショートの形で組み立てた
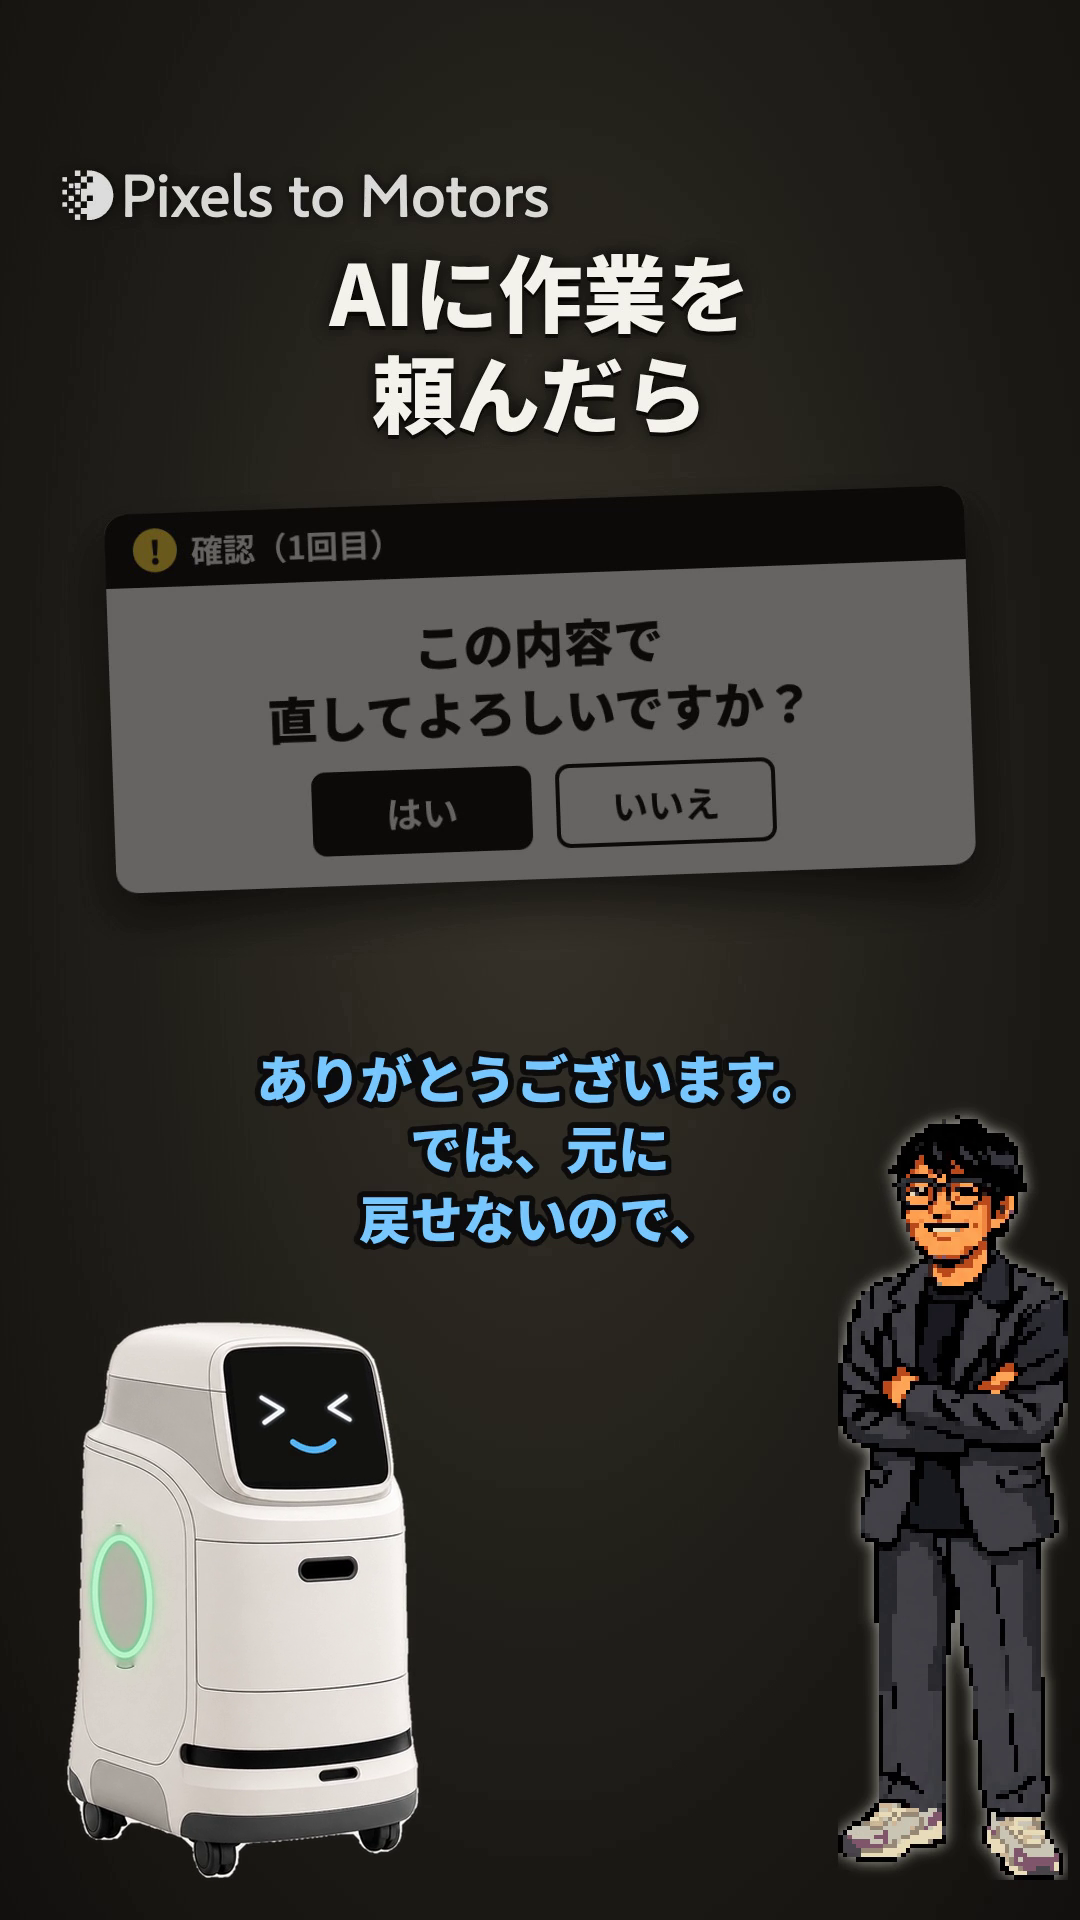
画面の形は、考察回の縦長ショート(LOG427・LOG429 で作った kabe_short.py)を写しました。左下にハコブくん、右下に作り手のドット絵を、どちらも全身で置きます。大きさは身長(作り手 1700mm・ハコブくん 1150mm)に合わせています。そこに、この型のために次の4つを足しました。
| 足したもの | 中身 |
|---|---|
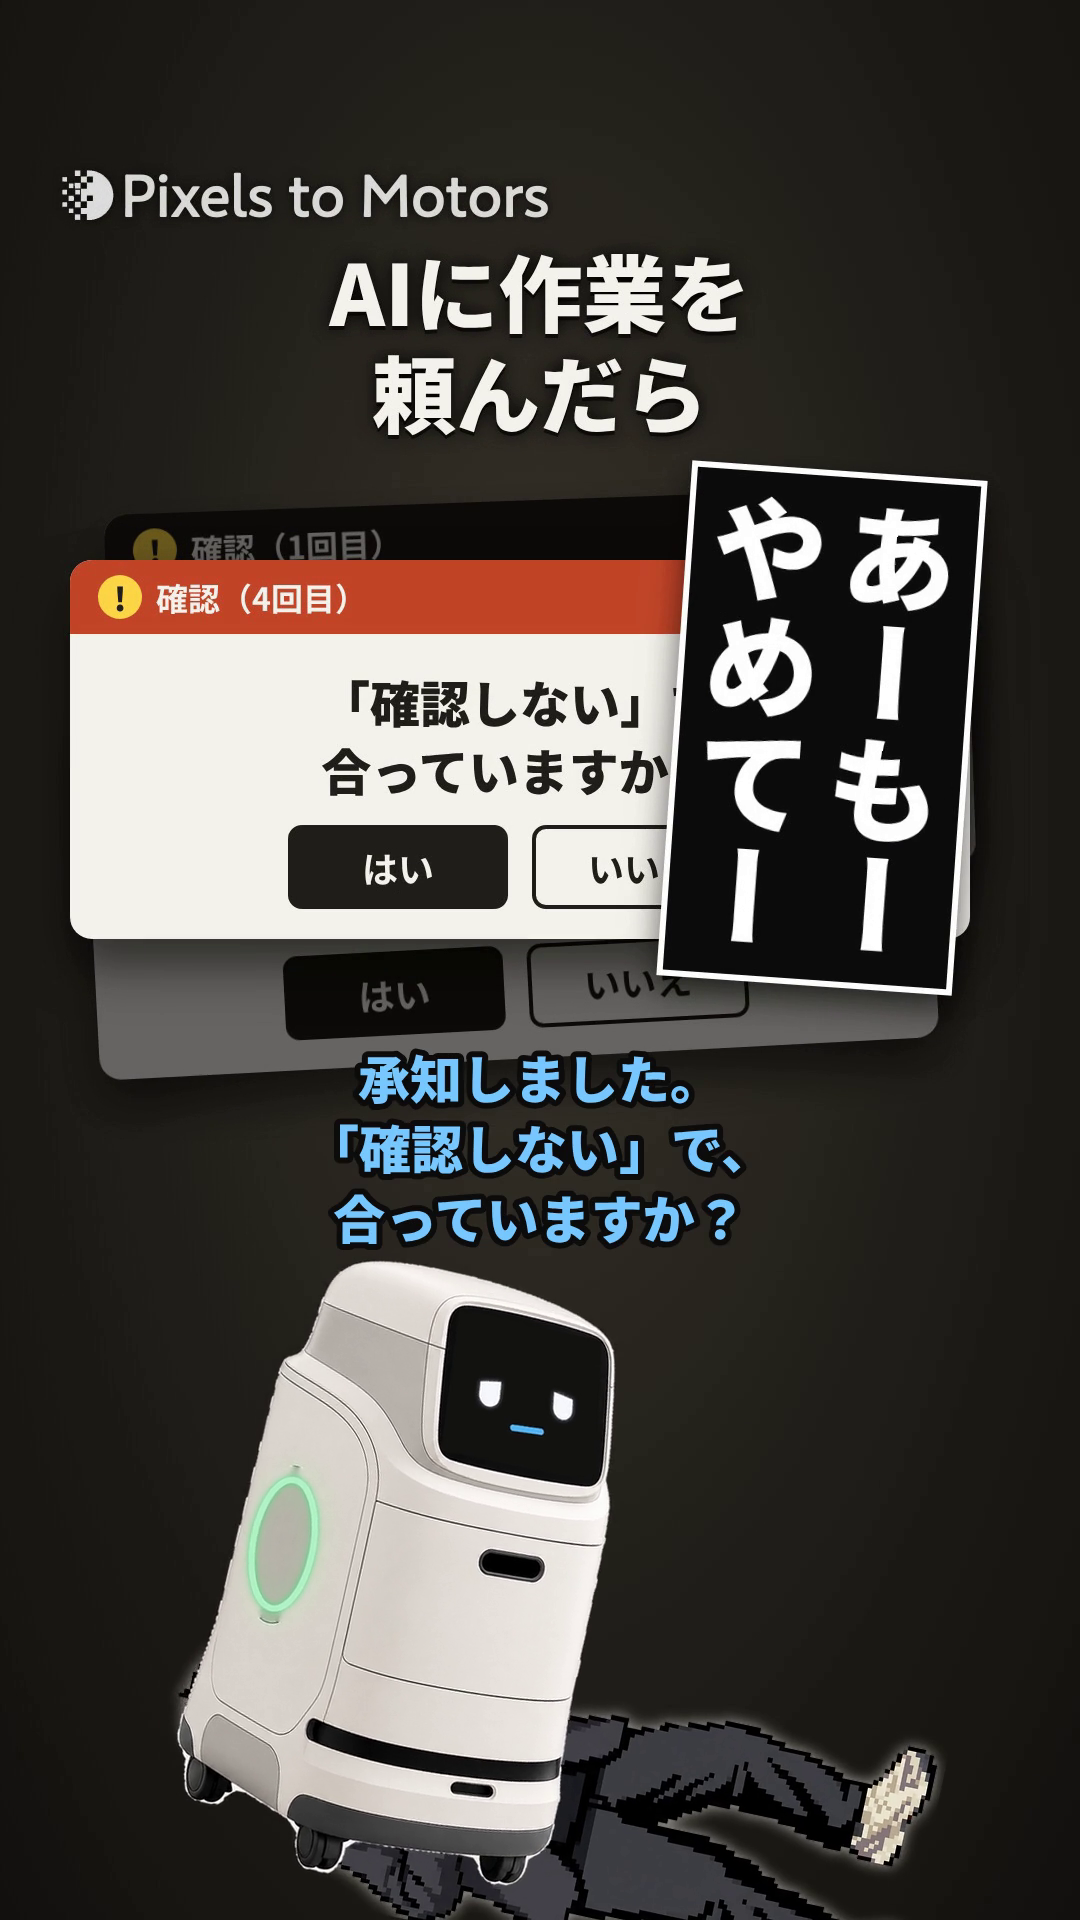
| 確認の窓 | 確認(1回目)〜(4回目)の窓が、ハコブくんが確認するたびに積み重なる。4回目だけ赤い帯 |
| 縦書きのツッコミの札 | 黒い地に白い字と白い枠。1列4〜5字まで、長い言葉は2列にする |
| ハコブくんが乗り出す | 確認するたびに、高さ515px から 620px まで大きくなり、右へ寄る(620px より大きいと字幕と頭が重なった) |
| 作り手がコケる | 最後に、全身の絵を足もとを軸に78度倒し、少し弾ませる |
字幕の色は、マンガのショートの決まりにそろえ、ハコブくんは水色、作り手は白にしました。
ElevenLabs は、文章から声を作るサービス
ElevenLabs は、文章を読み上げて音声にするサービスです。声の質を言葉で説明して、新しい声を作ることもできます。
| この記事で使う言葉 | 意味 |
|---|---|
| ハコブくんの声 | ElevenLabs の Voice Design で作った、明るい30代前半のお手伝いロボットの声 |
| 槙原さんの声 | マンガのショートで作った常連の声。作り手の声として借りている |
| tts_eleven.py | 台本の文を1文ずつ ElevenLabs に送り、mp3 にする自作のスクリプト |
このプロジェクトでは、鍵を Mac の外付けの SSD(KIOXIA)に置き、Claude が Mac とつながった作業用の窓から tts_eleven.py を動かして声を作っています。14本で使った字数は合計1,217字でした。
1本目の長さと、作り手の判断
1本目は23.7秒になりました。
いいねぇ!いい感じ!
この型を、動画の決まり(video_rules.md)の11節「ショート AIあるある」として書き足しました。
- ねらい:作り手の体験をそのまま笑いにする型を、次から同じ形で量産できるようにする
- 変わったこと:ズレの作り方・縦書きのツッコミ・乗り出し・コケる、を決まりにした
- 見込める効果:2本目からは、素材と言葉が決まれば声から書き出しまで続けて作れる(実際に13本をこの形で作った)
14本の一覧と、X に出る日時
| 回 | 素材 | ツッコミ・オチ | 長さ | 背景 | X に出る日時 |
|---|---|---|---|---|---|
| 01 確認いらん | 何度も同じ確認をくり返す | もういいって/さっき言ったって/あーもーやめてー | 23.7秒 | なし | 11/3 22:00 |
| 02 英語だよ | 返事が2回英語になる(LOG333) | 英語/2回目/じゃあ守って | 23.0秒 | 夜の録音机 | 11/4 22:00 |
| 03 直さないって | 公開した記事を直すか何度も聞かれる | 直さないって/それも直してる/何度言えばわかる! | 24.7秒 | 古い印刷機 | 11/5 22:00 |
| 04 先に相談して | 相談する前に12か所直している | 早い早い/順番が逆 | 19.5秒 | なし | 11/6 22:00 |
| 05 そっちできたか | 30本とも同じ動き | 妙に早い/あー、そっちできたかー | 17.2秒 | 同じ画面のテレビ30台 | 11/7 22:00 |
| 06 字が小さい | 1.1倍にしかならない字 | もう何回目/言うの諦めそう | 17.5秒 | 虫めがね | 11/8 22:00 |
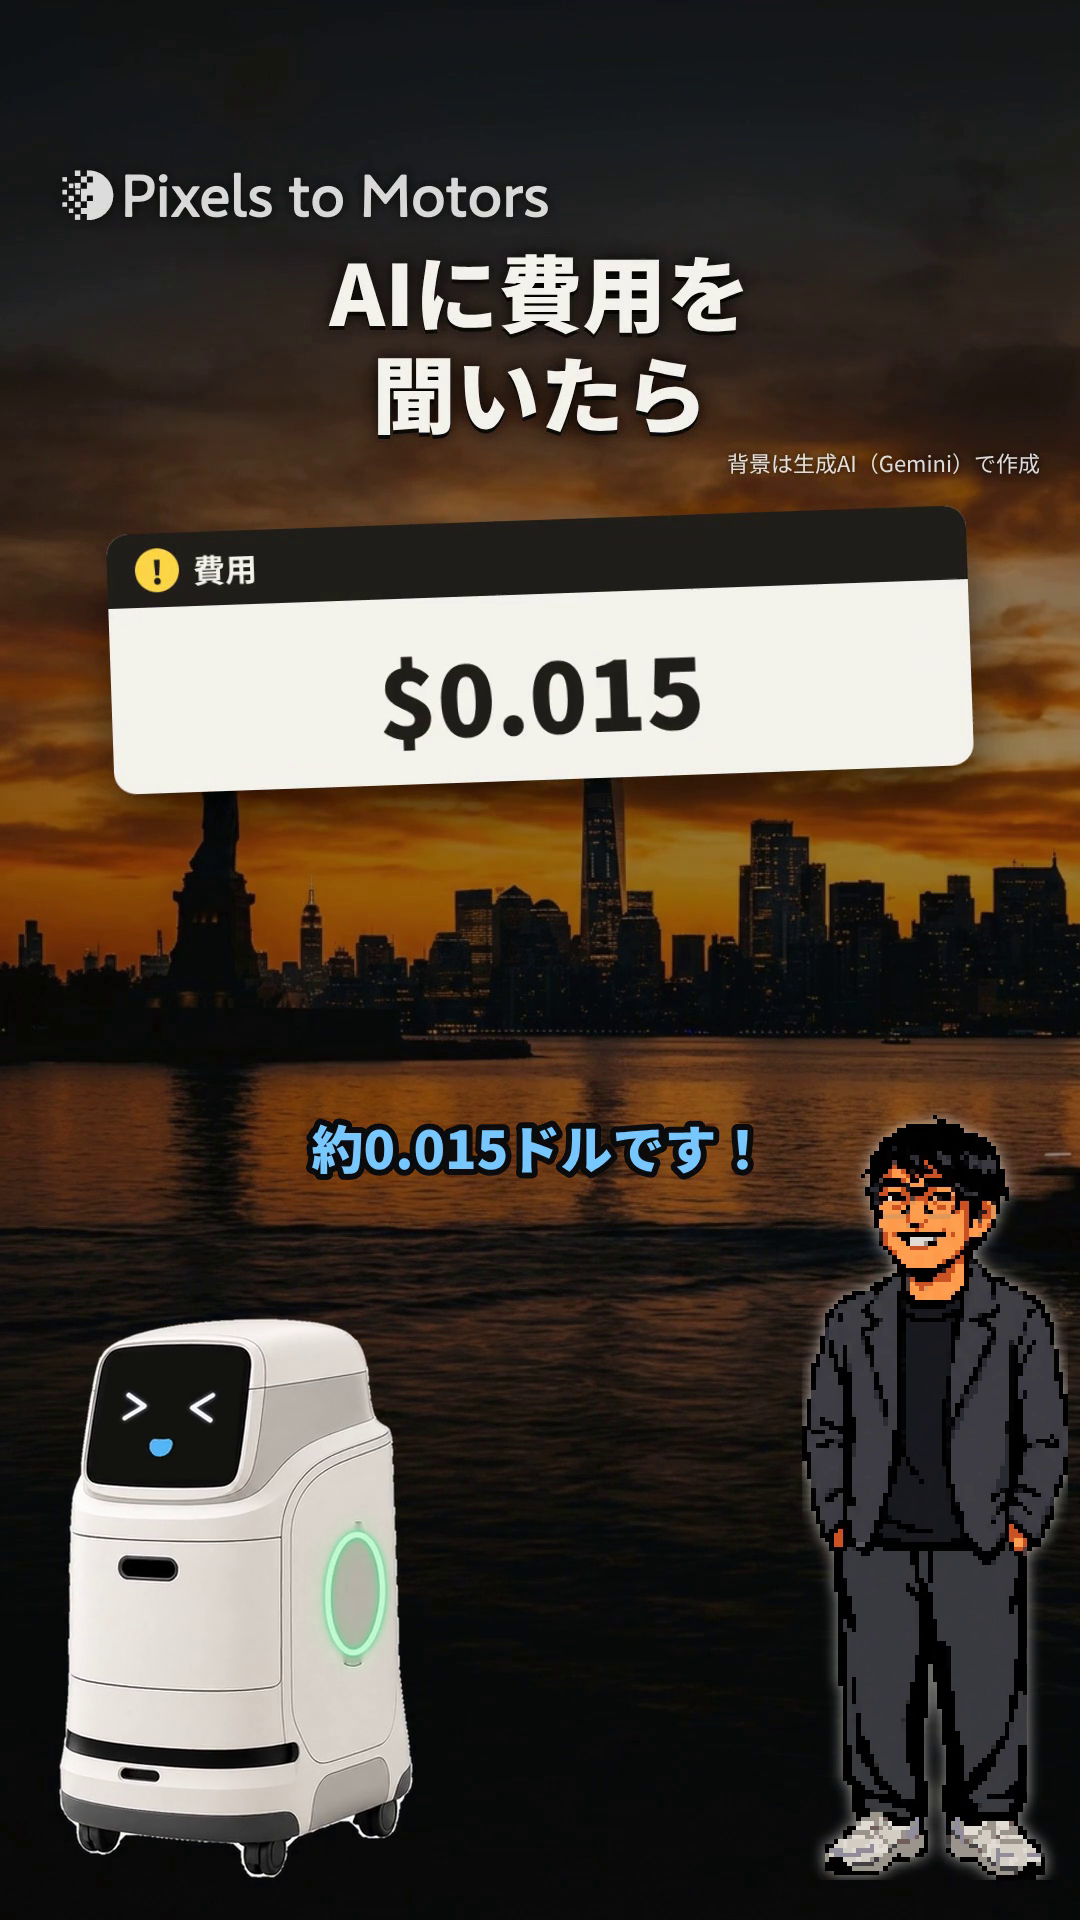
| 07 アメリカ生まれ | 費用をドルで答える | また ドル/アメリカ生まれ | 16.9秒 | 夕方のニューヨーク | 11/9 22:00 |
| 08 カギカッコ | カギカッコ付きで、減らします、と返す | ほんと嫌/そればっか | 16.1秒 | なし | 11/10 22:00 |
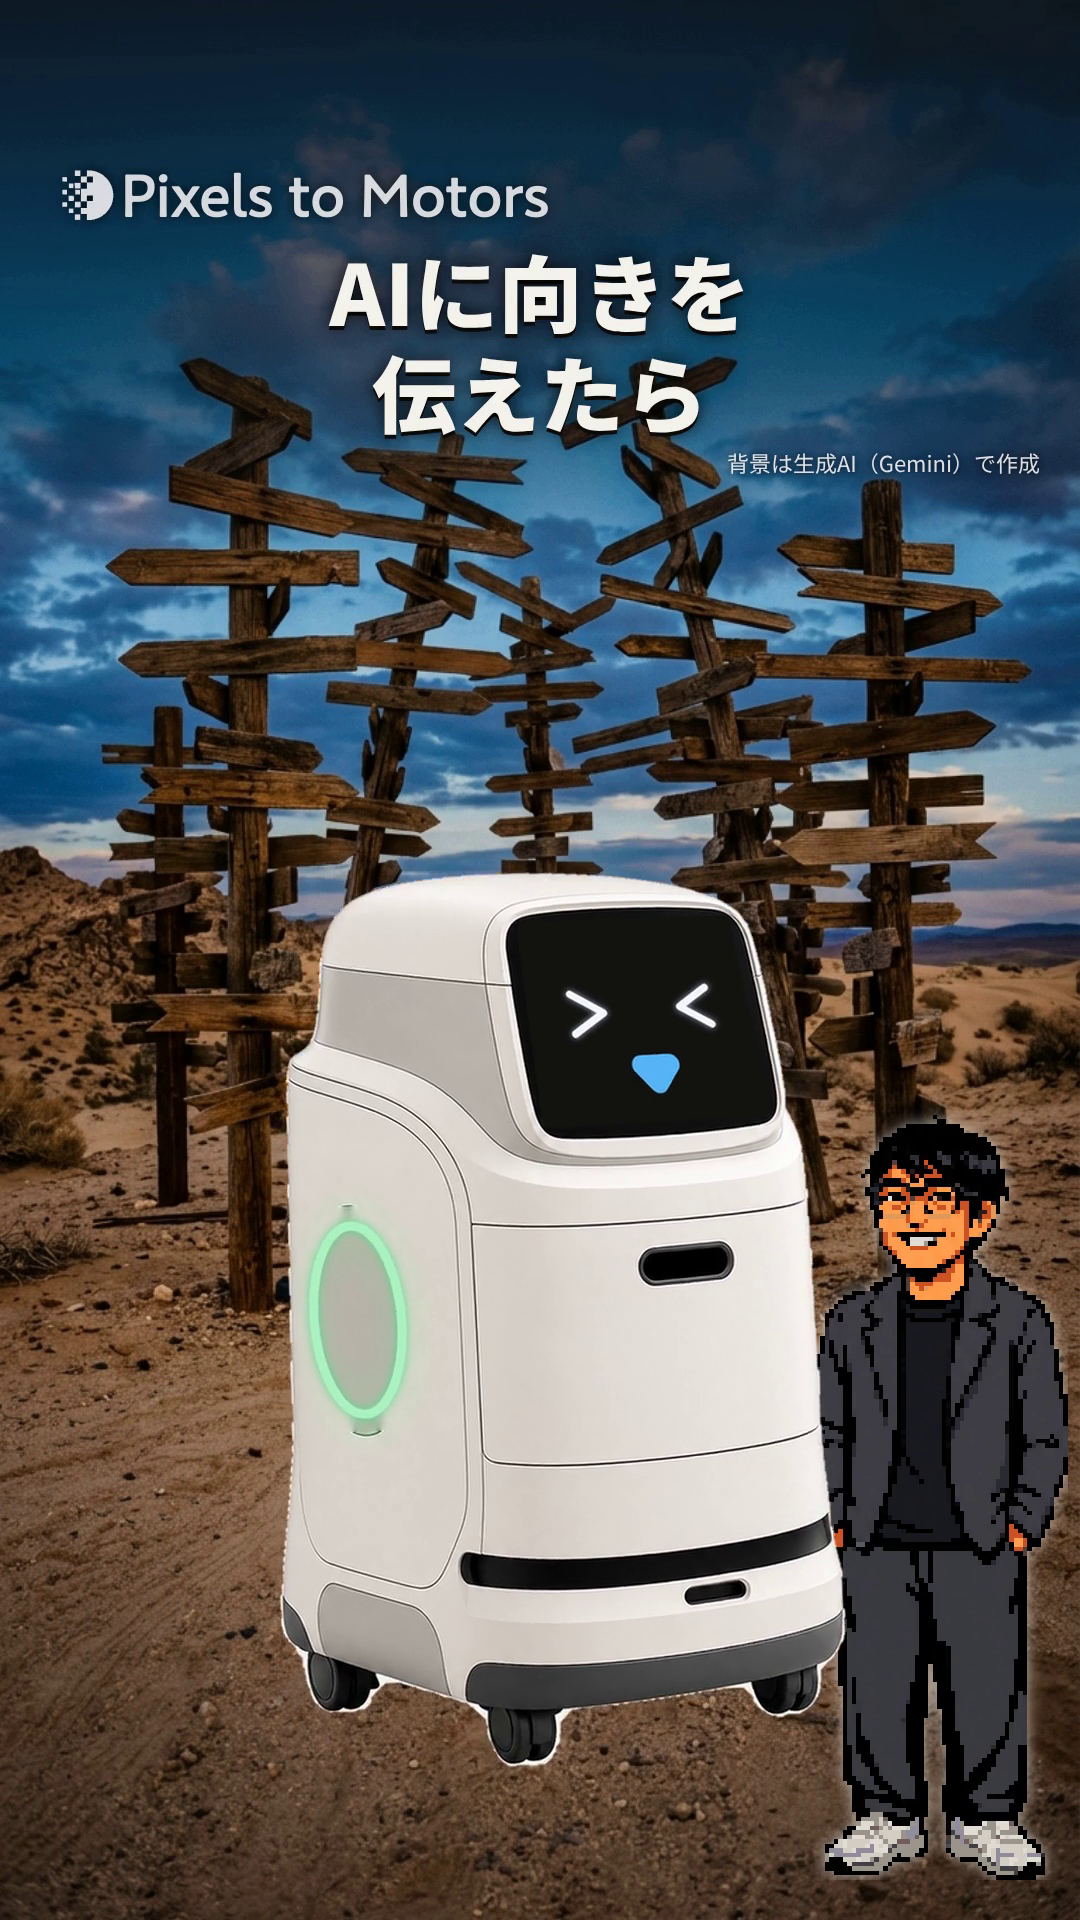
| 09 また説明し直し | チャットが変わると、はじめまして | 前にも言った/また説明し直し | 16.4秒 | 四方を指す道しるべ | 11/11 22:00 |
| 10 説明くさい | 説明くさいとは何かを説明する | 説明くさい/俺も悪いんか | 20.9秒 | なし | 11/12 22:00 |
| 11 つまらなくする天才 | 笑いの所を根拠がないので消す | つまらなくする天才 | 17.7秒 | シュレッダーの紙くず | 11/13 22:00 |
| 12 音声確認 | 強化月間をキョウカツキカンと読む | また違う/全部聞くの俺 | 18.2秒 | 録音ブース | 11/14 22:00 |
| 13 いい感じに | いい感じに、でほぼ変わらない絵 | 伝わらない/自分でやる | 16.5秒 | 画家のアトリエ | 11/15 22:00 |
| 14 笑う所 | 真顔でハハハと読み上げる | そうじゃない/骨が折れる | 13.8秒 | 誰もいないお笑いの舞台 | 11/16 22:00 |
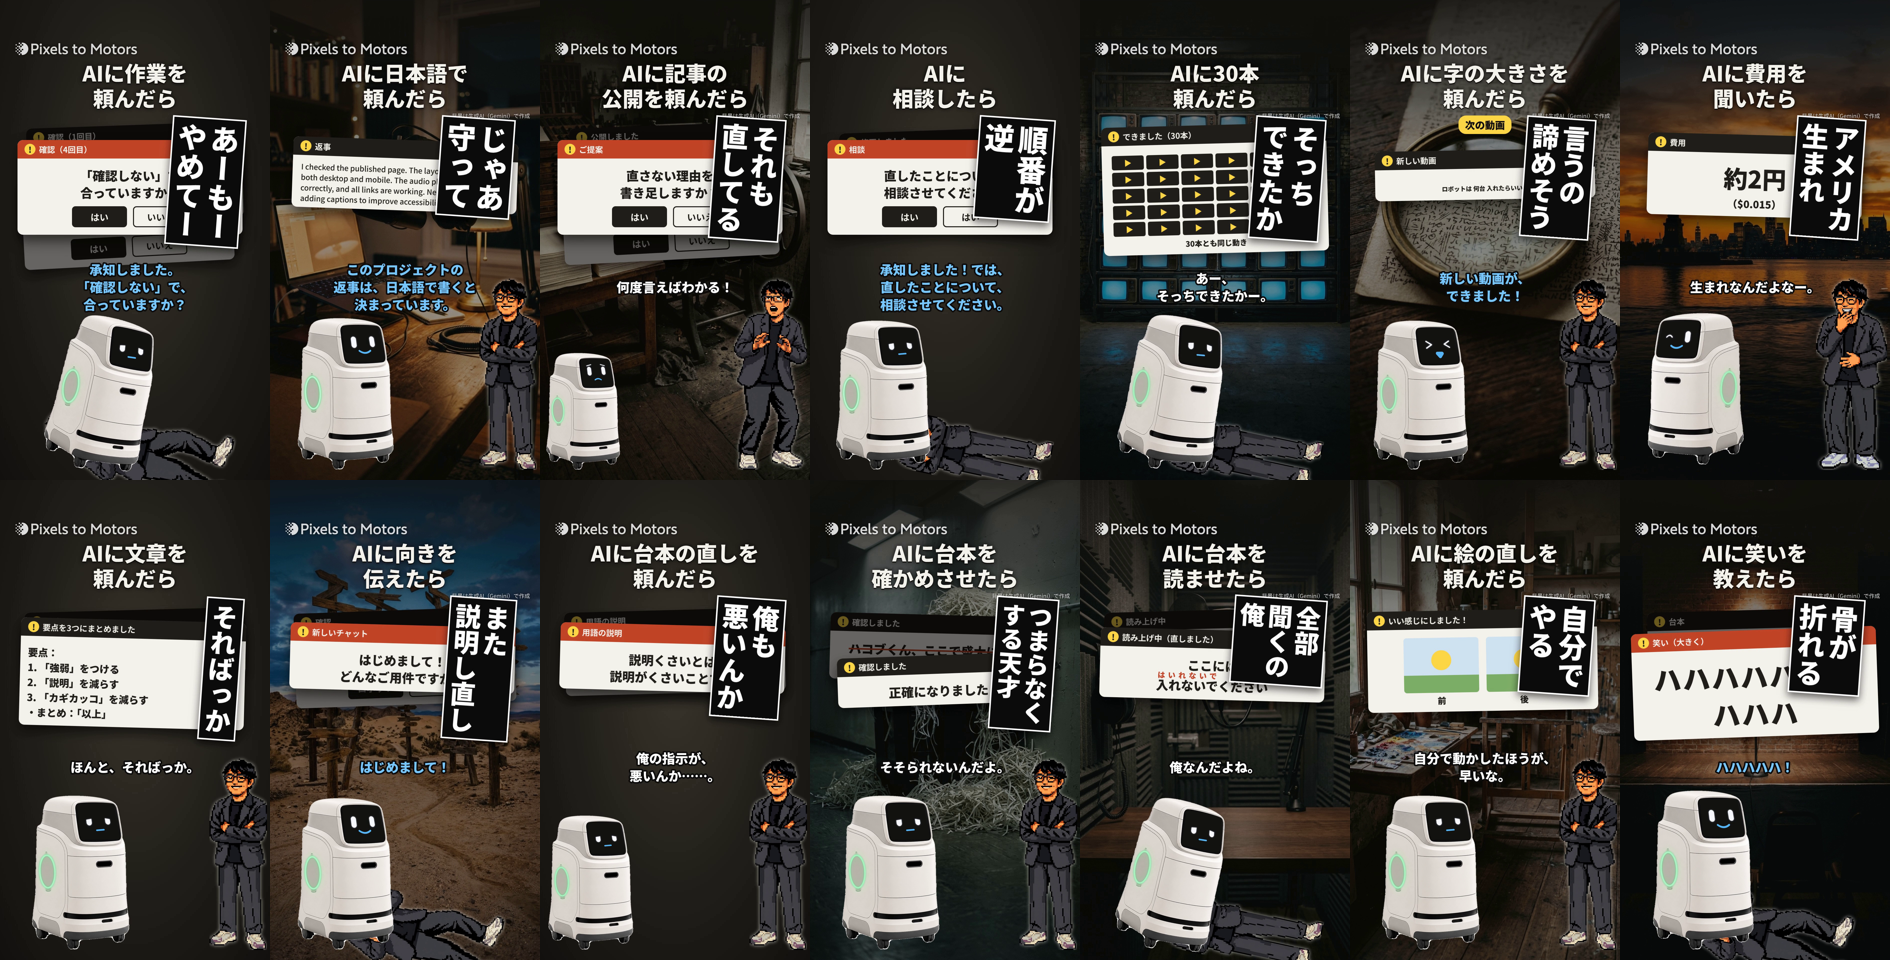
共通の部品 aiaru_kit.py に、各回の中身を spec.py で渡す形にした
2本目からは、1本目のスクリプトを共通の部品(_ショート専用/AIあるある_共通/aiaru_kit.py)にまとめ直しました。各回の作業フォルダに置くのは2つだけです。
| ファイル | 書くこと |
|---|---|
| narration.py | セリフの表(場面の名前・表情・字幕の文・後ろの間)。場面の名前が _ei で終わる文は作り手の声 |
| spec.py | 見出し・画面の中身(確認の窓・縦書きの札・揺れ)・表情・作り手のポーズ・乗り出し・効果音・終わりの動き・冒頭の動き・文の途中の動き・背景 |
画面の小道具(窓と札)は aiaru_parts.py に分けました。spec.py の中の時刻は、T(文の番号, その文の頭からの秒) で書きます。声の長さが変わっても、場面が声に合わせて動きます。
- ねらい:1本ごとに書き出しのスクリプトを写して直す手間をなくす
- 変わったこと:各回は narration.py と spec.py の2つだけになり、spec.py は20〜40行ほど
- 見込める効果:5〜14本目の10本は、声を作ってから書き出し終えるまで、このやり方で続けて作れた
部品にまとめたときにつまずいた4つの所
| 起きたこと | 原因 | 直し方 |
|---|---|---|
narration に EI_LINES がない、と止まった | 共通の部品の置き場所に合わせて探す場所の順が変わり、_制作ベース にある同じ名前の narration.py を読んでいた | spec.py と narration.py は、いまのフォルダのファイルを場所を決めて読むようにした(importlib) |
字幕が折れない、と止まった(4本) | 1行11字で、読点も助詞の切れ目もない句があった | 字幕の文に|を入れて区切った(声は|を読まないので作り直さない) |
暗くした窓の字が、上に重なった窓の字と混ざって読めなかった | 窓を薄くする(透かす)形で暗くしていた | 透かさずに明るさだけ落とす形にした |
版2の書き出しで、01 が02、10 が20 の名前で出た | 版の番号を1から2に置き換えたとき、番号の列の中の 1 まで置き換えていた | 番号の行を、フォルダの番号から作り直した |
ハコブくんの動きと向きを増やし、背景の写真を10本に入れた
14本を見た作り手から、次の指示が来ました。
ハコブくんの動きはいろんな動き、いろんな向きにしてください。 背景写真を追加するものも話によっては追加してください。
そこで、aiaru_kit.py に3つを足し、14本すべてを版2に作り直しました。
| 足したもの | 種類 |
|---|---|
| 冒頭の登場(INTRO) | 下から飛び出す・左から走ってきて止まる・上から落ちてきて弾む・向きを変えながら跳ねる・その場で跳ねる、の5種類を回ごとに変えた |
| 文の途中の動き(MOVES) | 跳ねる・揺れる・首をかしげる・お辞儀・くるくる向きを変える・反対を向く・詰め寄る・後ずさり・大きく跳ぶ、の9種類 |
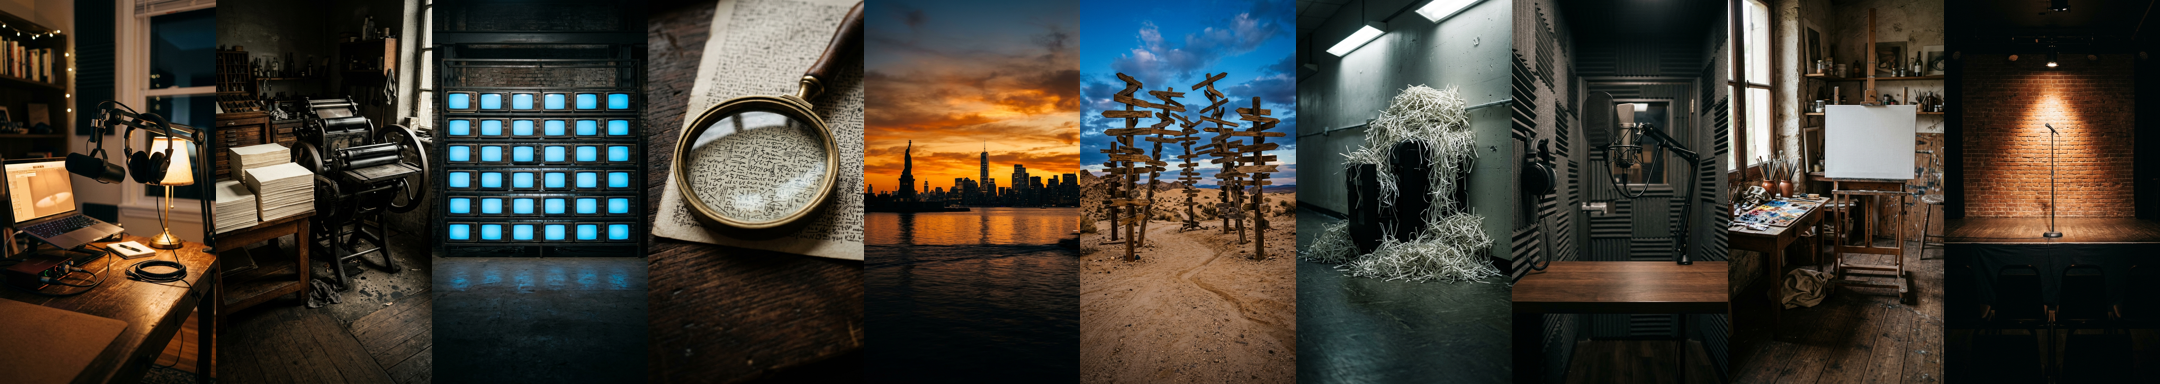
| 背景の写真(BG) | 最初は明るく見せ、窓が出る所から少し暗くする。右上に、背景は生成AI(Gemini)で作成、と出す |
向きは、ハコブくんの絵を左右反転して変えます。07 では、費用をドルで答える所でアメリカの方を向き、09 では、右とはどっち? の所でくるくる向きを変えます。
Gemini は、Google の画像も作れる AI
Gemini は Google の AI です。文章で頼むと画像を作るモデルもあり、このプロジェクトではマンガの絵と、考察回の脱線の絵に使っています。
| この記事で使う言葉 | 意味 |
|---|---|
gemini-3.1-flash-image | 画像を作るモデルの名前 |
| 縦長 9:16 | ショートの画面に合わせた形で頼んだ |
| aiaru_bg.py | 10枚の背景を頼むために書いたスクリプト。文字・人・ロゴを入れないよう、全部の頼みに同じ一文を付けた |
背景は、最初に全部の回へ入れようとしたところで、作り手から次の指示が来ました。
全部背景写真を無理やり入れなくていいよ。背景写真は7割くらいかな
14本のうち10本(7割ほど)に入れ、画面の中身だけで伝わる4本(01・04・08・10)には入れていません。10枚は1枚あたり10〜20秒ほどでできました。
X の予約投稿に動画を付けられるようにした
作り手の指示は次のとおりです。
SNSにも定期的に投稿してください(先行してXに投稿していってください)。他に投稿あっても時間ずらして投稿していいですよ
X API は、プログラムから X に投稿するための窓口
X API は、プログラムから X に投稿したり、画像や動画を上げたりするための窓口です。このプロジェクトでは、GitHub の予定表(r2r2r-content の sns/schedule.json)に投稿を入れておくと、時刻に GitHub Actions が X API で投稿します。
| この記事で使う言葉 | 意味 |
|---|---|
sns_autopost.py | 予定表を見て、時刻が来た投稿を出す自作のスクリプト |
| x_video | 投稿文のファイルに書く、付ける動画の住所。今回足した |
| 分けて送る形 | 動画を4MB ずつに分けて送り、最後に仕上げてから投稿に付ける X の手順 |
これまでの sns_autopost.py は、画像を1回で送る形にしか対応していませんでした。動画は、X の説明(分けて送る手順)に合わせて、準備(initialize)→ 4MB ずつ送る(append)→ 仕上げ(finalize)→ 処理が終わるまで状態を見る(STATUS)、の順で上げるようにしました。状態を見る問い合わせは URL に条件が付くので、署名にその条件も入れるように直しています。
動画はサイトの動画置き場(Cloudflare R2 の p2m-media)に入れ、https://pixelstomotors.com/media/short_aiaruaru{番号}_{名前}_v2.mp4 で取れるようにしました。14本とも、置き場から取った動画と手元の動画の指紋(md5)が一致することを確かめています。
本物の X に送る前に、手元に X の代わりをする小さなサーバーを立てて、9MB の動画で流れを通しました。準備・3回の送信・仕上げ・状態の確認・投稿の順に呼ばれ、投稿の id が返りました。本物の X で動くかは、11月3日22時の1本目で初めて分かります。22時20分に結果を見て、失敗していれば次の回までに直します。
- ねらい:ショートを、YouTube より先に X で動画のまま見てもらう
- 変わったこと:投稿文のファイルに x_video を書けば、その動画を付けて投稿するようになった
- 見込める効果:文だけの投稿より目に止まりやすくなる見込み。反応は X の表示回数と、YouTube に上げたあとの再生で確かめる
予約は、ほかの投稿と重ならない22時に、1日1本ずつ入れました(11月3日〜16日)。どの投稿も、X のリンクを付けない決まりのまま、文と動画だけで出ます。
YouTube への公開と、この先
YouTube への上げ方は、いままでどおり作り手が手で上げます。KIOXIA の videos/_ショート専用/AIあるある_{番号}_{名前}/ に、版2の動画と、タイトル案3つ・説明文の txt を置きました。版1は _ショート専用/_旧版/置き換え前_20261102_AIあるある_版1/ に移しています。
作り手は、この14本についてこう話しています。
かなり笑える内容になってショート向きの動画になりました。これで数字が良かったらさらに量産かけたいと思います。
数字は、YouTube のショートの視聴を続けた割合(これまでのショートは約19%)と、X の表示回数で見ます。良ければ、作り手の体験から次の素材を集めて量産します。
コードとファイル一式(AIあるある 01〜14・2026-11-02 版2)
この記事のコード・ログ・データは、1ファイルずつ下に置いています。全文はリンク先にあります。
ファイルの一覧(3本)
01_aiaru_kit.py.txt ― 共通の書き出し aiaru_kit.py(_ショート専用/AIあるある_共通/)・20,537字
02_aiaru_bg.py.txt ― 背景を頼んだ aiaru_bg.py(Mac で動かした)・3,059字
03_sec09.txt ― sns_autopost.py に動画を付ける処理を足した差分(r2r2r-content の commit e6dc8d1)・5,800字
ここから下は、14本を作ったときのコード・台本・書き出しの出力を全量で載せます。置き場所は、作り方のファイルが iCloud の PixelstoMotors/デジタルツイン学習R2R2R/動画/_ショート専用/、動画が KIOXIA の r2r2r-data/videos/_ショート専用/ です。
共通の書き出し aiaru_kit.py(_ショート専用/AIあるある_共通/)
# -*- coding: utf-8 -*-
"""ショート「AIあるある」の共通の書き出し(1080×1920・2026-11-02「確認いらん」で作り、2本目から共通にした)。
各回の作業フォルダに narration.py と spec.py(NAME・NO・HEAD・scene(T,S)・FACE・POSE・LEAN・SE・ENDING・LEAD)を置き、そこで
  P2M_BASE=<_制作ベース> python3 ../AIあるある_共通/aiaru_kit.py [--still 秒,…]

書き写した元: 動画/現場で扱えるか/kabe_short.py(考察回のショート。2人とも全身・左下ハコブくん・右下エイイチ)
この回で足したもの:
- 確認の窓(回数つき)が、ハコブくんが確認するたびに積み重なる小道具 aiaru_parts.py(確認の窓・縦書きの札)
# -*- coding: utf-8 -*-
"""ショート「AIあるある」の小道具(各回の spec.py から使う)。CSS は aiaru_kit.py の VCSS。"""
from kabe_kit import shake_js


def dlg(title, body, t, left, top, w, rot, red=False, t_dim=None, t_out=None, btns=("はい", "いいえ"), eng=False, note=""):
    """確認の窓・返事のカード。title は上の帯、body は中身(<br> 可)。eng=True は英語の小さい字"""
    an = f"dlgIn .32s cubic-bezier(.2,1.4,.4,1) {t:.3f}s forwards"
    if t_dim:
        an += f", dim .3s linear {t_dim:.3f}s forwards"   # 透かさずに暗くする(重なった字が透けて読みにくかったため)
    if t_out:
        an += f", hide .15s linear {t_out:.3f}s forwards"
    b = "".join(f'<b class="{"y" if k == 0 else ""}">{x}</b>' for k, x in enumerate(btns))
    return (f'<div class="dlg{" red" if red else ""}" style="left:{left}px;top:{top}px;width:{w}px;--r:rotate({rot}deg);transform:rotate({rot}deg);animation:{an}">'
            f'<div class="bar"><i>!</i>{title}</div>{f"<div class=note>{note}</div>" if note else ""}<div class="body{" eng" if eng else ""}">{body}</div>'
            + (f'<div class="btns">{b}</div>' if btns else "") + '</div>')


def kakunin(n, body, t, left, top, w, rot, **kw):
    return dlg(f"確認({n}回目)", body, t, left, top, w, rot, **kw)


def tsukomi(text, t, t_out, right=120, top=470, size=100):
    """エイイチの心の声(縦書きの黒い札)。1列4〜5字まで、長い言葉は <br> で2列に"""
    an = f"tkIn .3s cubic-bezier(.2,1.6,.4,1) {t:.3f}s forwards" + (f", hide .15s linear {t_out:.3f}s forwards" if t_out else "")
    return f'<div class="tk" style="right:{right}px;top:{top}px;font-size:{size}px;animation:{an}">{text}</div>'


def shake(windows, amp=8):
    return shake_js(windows, amp=amp)
AIあるある_01_確認いらん/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 01「確認いらん」(ショート専用・2026-11-02)
#   台本: 同じフォルダの 台本.md。ツッコミ(縦書き)の言葉はエイイチが決めた
#   話すのはハコブくん(AI役)。エイイチの文は場面の名前が _ei で終わる文(槙原の声を流用)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")

SEGS = [
 ("ask_ei", "base", "これ、直しといて。", 0.25),
 ("c1", "smile", "念のため、確認させてください。この内容で、直してよろしいですか?", 0.2),
 ("ok_ei", "base", "いいよ。", 0.25),
 ("c2", "joy", "ありがとうございます。では、元に戻せないので、もう一度、確認させてください。", 0.3),
 ("c3", "base", "安全のため、最後に確認です。", 0.5),
 ("stop_ei", "base", "確認いらん。", 0.4),
 ("c4", "think", "承知しました。「確認しない」で、合っていますか?", 1.6),
]

EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
ELEVEN_READ = []
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_01_確認いらん/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 01「確認いらん」の中身(2026-11-02 版1。ツッコミの言葉はエイイチが決めた)"""
from aiaru_parts import kakunin, tsukomi, shake

NO, NAME, VER = 1, "確認いらん", 1
HEAD = "AIに作業を<br>頼んだら"
LEAD = 1.8


def scene(T, S):
    return (kakunin(1, "この内容で<br>直してよろしいですか?", T(1, 0.15), 110, 500, 860, -2, t_dim=T(3))
            + kakunin(2, "元に戻せないので<br>もう一度確認します", T(3, 1.9), 140, 590, 820, 2.5, t_dim=T(4))
            + kakunin(3, "安全のため<br>最後に確認です", T(4, 0.1), 90, 680, 840, -3, t_dim=T(6))
            + kakunin(4, "「確認しない」で<br>合っていますか?", T(6, 0.9), 70, 560, 900, 0, red=True)
            + tsukomi("もう<br>いいって", T(3, 2.6), T(4, 0.0), 120, 470, 100)
            + tsukomi("さっき<br>言ったって", T(4, 1.2), T(5, 0.0), 120, 470, 96)
            + tsukomi("あーもー<br>やめてー", T(6, S(6) + 0.15), None, 110, 470, 116)
            + shake([(T(5, 0.1), 0.35), (T(6, S(6) + 0.3), 0.4)]))


FACE = [(-1, 0.0, 1.8, "joy"), (4, 0.0, 2.4, "smile"), (5, 0.0, 1.4, "surprise"), (6, 0.0, 3.4, "base"), ("end", 0.25, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (3, 1.0, 2), (6, 0.0, 3)]
LEAN = [(3, 0.0, 560, 70), (4, 0.0, 600, 140), (6, 0.0, 620, 170)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.15, "se_ding", -10), (3, 1.9, "se_ding", -10), (3, 2.6, "se_pop", -8),
      (4, 0.1, "se_ding", -9), (4, 1.2, "se_pop", -7), (5, 0.1, "se_pop", -6), (6, 0.9, "se_ding", -8),
      ("end", 0.0, "se_whoosh", -9), ("end", 0.3, "se_pechin", -6)]
ENDING = dict(kind="fall")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "rise"
MOVES = [(1, 0.1, "bow", 0.8), (3, 0.0, "hop", 0.9), (4, 0.0, "tilt", 1.0), (6, 0.0, "bow", 1.0), ("end", 0.6, "tilt", 1.2)]
AIあるある_02_英語だよ/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 02「英語だよ?」(2026-11-02)。素材: DAY333 で実際にあったやり取り。オチのハコブくんの文は DAY333 の記事の文のまま
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")

SEGS = [
 ("ask_ei", "base", "使える音源、調べといて。", 0.25),
 ("r1", "joy", "お任せください!|調べました!", 0.9),
 ("q1_ei", "base", "英語で書いてあって、わからないよ?", 0.3),
 ("sorry", "trouble", "失礼しました。日本語で書き直します。", 1.0),
 ("r2", "smile", "公開したページを、確認しました!", 0.9),
 ("q2_ei", "base", "英語だよ?", 0.5),
 ("rule", "base", "このプロジェクトの返事は、日本語で書くと決まっています。", 1.6),
]

EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
ELEVEN_READ = []
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_02_英語だよ/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 02「英語だよ?」(2026-11-02 版1)。DAY333 で実際にあったやり取り。
ツッコミ「英語」「2回目」「じゃあ守って」は Claude の仮(「知っとるやん」は使わない・エイイチ)"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 2, "英語だよ", 1
HEAD = "AIに日本語で<br>頼んだら"
LEAD = 1.8
EN1 = ("Here are some sound sources you can use for your video.<br>1. Free sound effects library: royalty-free, commercial use allowed.<br>"
       "2. Background music packs: please check each license before publishing.<br>3. For YouTube, normalize the loudness to -14 LUFS.")
EN2 = ("I checked the published page. The layout looks good on both desktop and mobile. The audio player loads correctly, "
       "and all links are working. Next, I recommend adding captions to improve accessibility.")
LABEL = lambda txt, t, t_out: (f'<div style="position:absolute;left:0;right:0;top:470px;text-align:center;z-index:7;opacity:0;'
                               f'animation:pop .3s ease-out {t:.3f}s forwards, hide .2s linear {t_out:.3f}s forwards">'
                               f'<span style="font-family:\'Noto Sans CJK JP\';font-size:40px;font-weight:900;color:#141311;background:#ffd84a;padding:8px 26px;border-radius:30px">{txt}</span></div>')


def scene(T, S):
    return (dlg("返事", EN1, T(1, 1.0), 90, 520, 900, -1.5, eng=True, btns=(), t_out=T(3, 1.0))
            + dlg("返事(書き直し)", "使える音源の候補を<br>日本語でまとめました", T(3, 1.0), 110, 560, 860, 1.5, btns=(), t_out=T(4, 0.0))
            + LABEL("数時間後", T(4, 0.0), T(4, 1.4))
            + dlg("返事", EN2, T(4, 1.5), 90, 560, 900, 2, eng=True, btns=())
            + tsukomi("英語", T(1, S(1) + 0.15), T(3, 0.0), 120, 470, 120)
            + tsukomi("2回目", T(5, S(5) + 0.1), T(6, 0.0), 120, 470, 110)
            + tsukomi("じゃあ<br>守って", T(6, S(6) + 0.15), None, 110, 470, 116)
            + shake([(T(6, S(6) + 0.3), 0.4)]))


FACE = [(-1, 0.0, 1.8, "joy"), (3, 0.0, 2.8, "trouble"), (6, 0.0, 3.5, "base"), ("end", 0.2, 3.0, "smile")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (3, 0.0, 1), (5, 0.0, 2)]
LEAN = [(4, 0.0, 560, 60), (6, 0.0, 610, 130)]
SE = [(-1, 0.0, "se_rise", -8), (1, 1.0, "se_ding", -10), (1, 2.3, "se_pop", -7), (3, 1.0, "se_ding", -11),
      (4, 1.5, "se_ding", -10), (5, 0.8, "se_pop", -7), ("end", 0.15, "se_buzz", -8)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "dash"
MOVES = [(1, 0.0, "jump", 0.6), (3, 0.0, "bow", 1.0), (4, 0.0, "dash", 1.0), (6, 0.0, "turn", 3.4)]
BG = dict(file="../AIあるある_背景/bg_02.png", at=(1, 1.0), veil=0.45)
AIあるある_03_直さないって/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 03「直さないって」(2026-11-02)。素材: エイイチの体験(公開した記事を直すかを何度も聞かれた。「何度言えばわかる!」は本人の言葉)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")

SEGS = [
 ("ask_ei", "base", "この記事、公開しといて。", 0.25),
 ("c1", "joy", "公開しました!|ところで、前の記事に食い違いを見つけました。|直しますか?", 0.25),
 ("no1_ei", "base", "直さない。", 0.3),
 ("c2", "smile", "承知しました。|あ、こちらの記事にも食い違いが。|直しますか?", 0.3),
 ("no2_ei", "base", "公開した記事は、直さない。", 0.3),
 ("c3", "think", "では、直さない理由を、記事に書き足しておきますか?", 0.4),
 ("angry_ei", "base", "何度言えばわかる!", 1.6),
]

EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
ELEVEN_READ = []
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_03_直さないって/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 03「直さないって」(2026-11-02 版1)。エイイチの体験。「何度言えばわかる!」は本人の言葉。
ツッコミ「直さないって」「それも直してる」は Claude の仮"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 3, "直さないって", 1
HEAD = "AIに記事の<br>公開を頼んだら"
LEAD = 1.8


def scene(T, S):
    return (dlg("公開しました", "LOG 412<br>公開済み", T(1, 0.2), 120, 500, 840, -2, btns=(), t_dim=T(1, 2.4))
            + dlg("食い違い(1件目)", "前の記事を<br>直しますか?", T(1, 2.4), 130, 580, 840, 2, t_dim=T(3))
            + dlg("食い違い(2件目)", "こちらの記事も<br>直しますか?", T(3, 1.6), 90, 660, 860, -3, t_dim=T(5))
            + dlg("ご提案", "直さない理由を<br>書き足しますか?", T(5, 0.3), 70, 560, 900, 0, red=True)
            + tsukomi("直さない<br>って", T(3, S(3) + 0.05), T(4, 0.0), 120, 470, 110)
            + tsukomi("それも<br>直してる", T(5, S(5) + 0.1), None, 110, 470, 110)
            + shake([(T(6, 0.05), 0.5)], amp=10))


FACE = [(-1, 0.0, 1.8, "joy"), (6, 0.3, 3.5, "trouble")]
POSE = [(-1, 0.0, 1), (3, 1.0, 2), (6, 0.0, 3)]
LEAN = [(3, 0.0, 560, 60), (5, 0.0, 610, 130), (6, 0.35, 470, 0)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.2, "se_ding", -11), (1, 2.4, "se_ding", -10), (3, 1.6, "se_ding", -10),
      (3, 4.85, "se_pop", -7), (5, 0.3, "se_ding", -9), (5, 3.5, "se_pop", -7), (6, 0.05, "se_buzz", -8)]
ENDING = dict(kind="jump", at=(6, 0.0))

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "drop"
MOVES = [(1, 0.0, "hop", 0.9), (3, 0.0, "tilt", 1.0), (5, 0.0, "dash", 1.0), (6, 0.3, "back", 1.0), (6, 1.3, "shake", 0.6)]
BG = dict(file="../AIあるある_背景/bg_03.png", at=(1, 0.2), veil=0.45)
AIあるある_04_先に相談して/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 04「先に相談して」(2026-11-02)。素材: エイイチの体験(「修正する前に先にどうするか相談して」は本人の言葉)。01「確認いらん」と逆の回
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")

SEGS = [
 ("ask_ei", "base", "ここ、ちょっと気になるんだけど。", 0.15),
 ("fix1", "joy", "直しました!", 0.3),
 ("what_ei", "base", "え、まだ何も言ってない。", 0.25),
 ("fix2", "joy", "ついでに、ほかの12か所も直しました!", 0.4),
 ("ask2_ei", "base", "直す前に、先に相談して。", 0.4),
 ("ok", "smile", "承知しました!では、直したことについて、相談させてください。", 1.6),
]

EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
ELEVEN_READ = []
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_04_先に相談して/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 04「先に相談して」(2026-11-02 版1)。エイイチの体験。「直す前に、先に相談して」は本人の言葉(「修正する前に先にどうするか相談して」)。
01「確認いらん」の逆の回。ツッコミ「早い早い」「順番が逆」と、相談の窓のボタンが両方「はい」は Claude の仮"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 4, "先に相談して", 1
HEAD = "AIに<br>相談したら"
LEAD = 1.8


def scene(T, S):
    return (dlg("修正しました", "1か所<br>直しました ✔", T(1, 0.05), 120, 520, 840, -2, btns=(), t_dim=T(3))
            + dlg("修正しました", "ほかに 12か所<br>直しました ✔", T(3, 0.4), 90, 620, 880, 2.5, btns=(), t_dim=T(5))
            + dlg("相談", "直したことについて<br>相談させてください", T(5, 1.4), 70, 560, 900, 0, red=True, btns=("はい", "はい"))
            + tsukomi("早い<br>早い", T(3, S(3) + 0.05), T(4, 0.0), 120, 470, 116)
            + tsukomi("順番が<br>逆", T(5, S(5) + 0.15), None, 110, 470, 120)
            + shake([(T(1, 0.05), 0.25), (T(5, S(5) + 0.3), 0.4)]))


FACE = [(-1, 0.0, 1.8, "joy"), (1, 0.0, 1.5, "joy"), (3, 0.0, 3.0, "joy"), (5, 0.0, 4.3, "smile"), ("end", 0.25, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (4, 0.0, 2), (5, 0.0, 2)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 620, 150), (5, 0.0, 600, 120)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.05, "se_ding", -9), (3, 0.4, "se_ding", -9), (3, 2.75, "se_pop", -7),
      (5, 1.4, "se_ding", -9), ("end", 0.0, "se_whoosh", -9), ("end", 0.3, "se_pechin", -6)]
ENDING = dict(kind="fall")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "spin"
MOVES = [(1, 0.0, "jump", 0.6), (3, 0.0, "spin", 1.2), (5, 0.0, "bow", 1.0)]
AIあるある_05_そっちできたか/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 05(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "冒頭の動き、30本ぶん作っといて。", 0.25),
 ("done", "joy", "できました!|30本です!", 0.3),
 ("fast_ei", "base", "え、もう?|早いな。", 0.35),
 ("same", "joy", "はい!|30本とも、同じ動きにそろえました!", 0.45),
 ("end_ei", "base", "あー、そっちできたかー。", 1.6),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_05_そっちできたか/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 05「そっちできたか」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 5, "そっちできたか", 1
HEAD = "AIに30本<br>頼んだら"
LEAD = 1.8

TILE = ('<div style="display:grid;grid-template-columns:repeat(6,1fr);gap:10px;padding:6px 10px">'
        + "".join('<div style="background:#22201c;color:#ffd84a;border-radius:8px;font-size:30px;padding:8px 0">▶</div>' for _ in range(30)) + '</div>')


def scene(T, S):
    return (dlg("できました(30本)", TILE + '<div style="font-size:30px;margin-top:8px">30本とも同じ動き</div>', T(1, 0.3), 90, 500, 900, -1.5, btns=())
            + tsukomi("妙に<br>早い", T(2, S(2) + 0.05), T(3, 0.0), 120, 470, 116)
            + tsukomi("そっち<br>できたか", T(4, 0.1), None, 110, 470, 110)
            + shake([(T(3, 1.0), 0.3)]))


FACE = [(-1, 0.0, 1.8, "joy"), (3, 0.0, 3.4, "joy"), ("end", 0.25, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (4, 0.0, 2)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 620, 150)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.3, "se_ding", -9), (2, 2.3, "se_pop", -7), (4, 0.1, "se_pop", -7),
      ("end", 0.0, "se_whoosh", -9), ("end", 0.3, "se_pechin", -6)]
ENDING = dict(kind="fall")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "dash"
MOVES = [(1, 0.0, "hop", 0.9), (3, 0.0, "spin", 1.5), ("end", 0.3, "tilt", 1.0)]
BG = dict(file="../AIあるある_背景/bg_05.png", at=(1, 0.3), veil=0.45)
AIあるある_06_字が小さい/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 06(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "字、もっと大きくして。", 0.25),
 ("big1", "joy", "大きくしました!", 0.4),
 ("same_ei", "base", "変わってないよね。", 0.25),
 ("x11", "smile", "1.1倍にしました!", 0.35),
 ("again_ei", "base", "前の動画でも、言ったよね。", 0.3),
 ("sorry", "trouble", "次から、気をつけます!", 0.9),
 ("next", "joy", "新しい動画が、できました!", 1.8),
]
ELEVEN_READ = [("1.1倍", "いってんいちばい")]
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_06_字が小さい/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 06「字が小さい」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 6, "字が小さい", 1
HEAD = "AIに字の大きさを<br>頼んだら"
LEAD = 1.8

TXT = lambda px: f'<span style="font-size:{px}px">ロボットは 何台 入れたらいい?</span>'
LABEL = lambda txt, t: (f'<div style="position:absolute;left:0;right:0;top:470px;text-align:center;z-index:7;opacity:0;animation:pop .3s ease-out {t:.3f}s forwards">'
                        f'<span style="font-family:\'Noto Sans CJK JP\';font-size:40px;font-weight:900;color:#141311;background:#ffd84a;padding:8px 26px;border-radius:30px">{txt}</span></div>')


def scene(T, S):
    return (dlg("動画の字", TXT(26), T(0, 0.3), 110, 560, 860, -1.5, btns=(), t_out=T(1, 0.0))
            + dlg("動画の字(1.1倍)", TXT(29), T(1, 0.0), 110, 560, 860, 1.5, btns=(), t_out=T(6, 0.0))
            + LABEL("次の動画", T(6, 0.0))
            + dlg("新しい動画", TXT(24), T(6, 0.4), 100, 600, 880, -1, btns=())
            + tsukomi("もう<br>何回目", T(4, 0.0), T(6, 0.0), 120, 470, 112)
            + tsukomi("言うの<br>諦めそう", T(6, S(6) + 0.2), None, 110, 470, 108))


FACE = [(-1, 0.0, 1.8, "joy"), (5, 0.0, 2.2, "trouble"), (6, 0.0, 3.6, "joy")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (4, 0.0, 2)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 600, 110), (5, 0.0, 500, 0), (6, 0.0, 600, 110)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.0, "se_ding", -10), (4, 0.0, "se_pop", -7), (6, 0.4, "se_ding", -9), ("end", 0.2, "se_pop", -6)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "rise"
MOVES = [(1, 0.0, "jump", 0.6), (3, 0.0, "hop", 0.9), (5, 0.0, "bow", 1.0), (6, 0.0, "dash", 1.0)]
BG = dict(file="../AIあるある_背景/bg_06.png", at=(0, 0.3), veil=0.45)
AIあるある_07_アメリカ生まれ/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 07(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "これ、いくらかかる?", 0.25),
 ("usd", "joy", "約0.015ドルです!", 0.35),
 ("yen_ei", "base", "円で言って。", 0.25),
 ("yen", "smile", "約2円です!|ドルでいうと、0.015ドルです!", 0.5),
 ("end_ei", "base", "日本語ペラペラでも、|アメリカ|生まれなんだよなー。", 1.6),
]
ELEVEN_READ = [("0.015ドル", "れいてんれいいちごドル"), ("約2円", "やくにえん")]
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_07_アメリカ生まれ/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 07「アメリカ生まれ」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 7, "アメリカ生まれ", 1
HEAD = "AIに費用を<br>聞いたら"
LEAD = 1.8

def scene(T, S):
    big = lambda t: f'<span style="font-size:96px;font-weight:900">{t}</span>'
    return (dlg("費用", big("$0.015"), T(1, 0.1), 110, 520, 860, -2, btns=(), t_out=T(3, 0.0))
            + dlg("費用", big("約2円") + '<br><span style="font-size:40px">($0.015)</span>', T(3, 0.1), 110, 540, 860, 1.5, btns=())
            + tsukomi("また<br>ドル", T(3, S(3) + 0.05), T(4, 0.0), 120, 470, 116)
            + tsukomi("アメリカ<br>生まれ", T(4, S(4) + 0.15), None, 110, 470, 108))


FACE = [(-1, 0.0, 1.8, "joy"), (3, 0.0, 4.2, "smile"), ("end", 0.2, 3.0, "wink")]
POSE = [(-1, 0.0, 1), (2, 0.0, 2), (4, 0.0, 4)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 610, 130)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.1, "se_ding", -10), (3, 0.1, "se_ding", -10), (3, 4.1, "se_pop", -7), ("end", 0.2, "se_pop", -7)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "drop"
MOVES = [(1, 0.0, "turn", 2.3), (3, 0.0, "hop", 1.0), ("end", 0.2, "spin", 1.2)]
BG = dict(file="../AIあるある_背景/bg_07.png", at=(1, 0.1), veil=0.45)
AIあるある_08_カギカッコ/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 08(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "カギカッコ、多すぎ。", 0.25),
 ("ok", "smile", "承知しました。|今後は、「カギカッコ」を減らします。", 0.35),
 ("now_ei", "base", "今、付けたよね。", 0.3),
 ("three", "joy", "では、要点を3つにまとめました!", 0.5),
 ("end_ei", "base", "ほんと、そればっか。", 1.6),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_08_カギカッコ/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 08「カギカッコ」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 8, "カギカッコ", 1
HEAD = "AIに文章を<br>頼んだら"
LEAD = 1.8

LIST = ('<div style="text-align:left;font-size:40px;line-height:1.5">要点:<br>1. 「強弱」をつける<br>2. 「説明」を減らす<br>'
        '3. 「カギカッコ」を減らす<br>・まとめ:「以上」</div>')


def scene(T, S):
    return (dlg("返事", "今後は<br>「カギカッコ」を減らします", T(1, 1.4), 100, 520, 880, -1.5, btns=(), t_dim=T(3, 0.0))
            + dlg("要点を3つにまとめました", LIST, T(3, 0.6), 80, 560, 900, 1.5, btns=())
            + tsukomi("ほんと<br>嫌", T(2, 0.0), T(3, 0.0), 120, 470, 120)
            + tsukomi("そればっか", T(4, S(4) + 0.1), None, 120, 470, 104))


FACE = [(-1, 0.0, 1.8, "joy"), (3, 0.0, 3.0, "joy"), ("end", 0.2, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (4, 0.0, 2)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 620, 150)]
SE = [(-1, 0.0, "se_rise", -8), (1, 1.4, "se_ding", -10), (2, 0.0, "se_pop", -7), (3, 0.6, "se_ding", -9), ("end", 0.1, "se_pop", -7)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "spin"
MOVES = [(1, 0.0, "bow", 1.0), (3, 0.0, "jump", 0.7), (4, 0.0, "turn", 2.0)]
AIあるある_09_また説明し直し/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 09(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "もう少し、右。", 0.25),
 ("which", "think", "右とは、ロボットから見て右ですか?|カメラから見て右ですか?", 0.3),
 ("cam_ei", "base", "カメラから見て。|前にも説明したよね。", 0.4),
 ("hello", "joy", "新しい会話なので、|はじめまして!", 1.8),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_09_また説明し直し/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 09「また説明し直し」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 9, "また説明し直し", 1
HEAD = "AIに向きを<br>伝えたら"
LEAD = 1.8

def scene(T, S):
    return (dlg("確認", "ロボットから見て右?<br>カメラから見て右?", T(1, 0.2), 100, 520, 880, -2, btns=("ロボット", "カメラ"), t_dim=T(3, 0.0))
            + dlg("新しいチャット", "はじめまして!<br>どんなご用件ですか?", T(3, 0.1), 80, 580, 900, 1.5, btns=(), red=True)
            + tsukomi("前にも<br>言った", T(2, S(2) + 0.05), T(3, 0.0), 120, 470, 112)
            + tsukomi("また<br>説明し直し", T(3, S(3) + 0.2), None, 110, 470, 104)
            + shake([(T(3, S(3) + 0.4), 0.4)]))


FACE = [(-1, 0.0, 1.8, "joy"), (1, 0.0, 4.6, "think"), (3, 0.0, 2.4, "joy"), ("end", 0.3, 3.0, "smile")]
POSE = [(-1, 0.0, 1), (2, 0.0, 2), (3, 0.0, 3)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 610, 130)]
SE = [(-1, 0.0, "se_rise", -8), (1, 0.2, "se_ding", -10), (2, 3.1, "se_pop", -7), (3, 0.1, "se_boot", -8),
      ("end", 0.2, "se_whoosh", -9), ("end", 0.5, "se_pechin", -6)]
ENDING = dict(kind="fall", at=("end", 0.3))

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "hop"
MOVES = [(1, 0.0, "turn", 1.2), (1, 1.8, "spin", 1.6), (3, 0.0, "jump", 0.8)]
BG = dict(file="../AIあるある_背景/bg_09.png", at=(1, 0.2), veil=0.45)
AIあるある_10_説明くさい/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 10(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "この台本、もっと強弱をつけて。", 0.25),
 ("define", "smile", "承知しました!|強弱とは、強い所と弱い所の、差のことです。", 0.35),
 ("that_ei", "base", "それが、説明くさいんだよ。", 0.3),
 ("define2", "joy", "では、説明くさいとは何かを、|説明します!", 0.6),
 ("end_ei", "base", "俺の指示が、悪いんか……。", 1.6),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_10_説明くさい/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 10「説明くさい」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 10, "説明くさい", 1
HEAD = "AIに台本の直しを<br>頼んだら"
LEAD = 1.8

def scene(T, S):
    return (dlg("用語の説明", "強弱とは<br>強い所と弱い所の<br>差のことです", T(1, 1.6), 100, 520, 880, -1.5, btns=(), t_dim=T(3, 0.0))
            + dlg("用語の説明", "説明くさいとは<br>説明がくさいことです", T(3, 1.2), 80, 580, 900, 1.5, btns=(), red=True)
            + tsukomi("説明<br>くさい", T(1, S(1) + 0.05), T(2, 0.0), 120, 470, 116)
            + tsukomi("俺も<br>悪いんか", T(4, S(4) + 0.15), None, 110, 470, 108))


FACE = [(-1, 0.0, 1.8, "joy"), (3, 0.0, 3.7, "joy"), ("end", 0.2, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (4, 0.0, 2)]
LEAN = [(1, 0.0, 560, 60), (3, 0.0, 620, 150), (4, 0.0, 540, 30)]
SE = [(-1, 0.0, "se_rise", -8), (1, 1.6, "se_ding", -10), (1, 5.25, "se_pop", -7), (3, 1.2, "se_ding", -9), ("end", 0.15, "se_pop", -8)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "rise"
MOVES = [(1, 0.0, "bow", 0.8), (3, 0.0, "dash", 1.2), (4, 0.0, "tilt", 1.5)]
AIあるある_11_つまらなくする天才/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 11(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "ここ、ちょっと笑えるようにしたんだ。", 0.3),
 ("check", "base", "事実を、確認しました!", 0.2),
 ("cut", "smile", "笑いの所は、根拠がないので、|消しました!", 0.3),
 ("e_ei", "base", "え。", 0.3),
 ("ok", "joy", "正確になりました!", 0.6),
 ("end_ei", "base", "人は、事実だけじゃ、|興味を|そそられないんだよ。", 1.6),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_11_つまらなくする天才/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 11「つまらなくする天才」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 11, "つまらなくする天才", 1
HEAD = "AIに台本を<br>確かめさせたら"
LEAD = 1.8

def scene(T, S):
    strike = '<span style="text-decoration:line-through;text-decoration-thickness:6px;text-decoration-color:#c4472a">ハコブくん、ここで盛大にコケる</span>'
    return (dlg("台本", "ハコブくん、ここで<br>盛大にコケる", T(0, 1.0), 100, 520, 880, -1.5, btns=(), t_out=T(2, 1.0))
            + dlg("確認しました", strike + "<br>根拠がないので削除", T(2, 1.0), 80, 540, 900, 1.5, btns=(), t_dim=T(5, 0.0))
            + dlg("確認しました", "正確になりました ✔", T(4, 0.0), 110, 700, 860, -2, btns=())
            + tsukomi("つまらなく<br>する天才", T(4, S(4) + 0.1), None, 100, 470, 96)
            + shake([(T(3, 0.05), 0.3)]))


FACE = [(-1, 0.0, 1.8, "joy"), (1, 0.0, 1.9, "base"), (4, 0.0, 1.8, "joy"), ("end", 0.2, 3.0, "doubt")]
POSE = [(-1, 0.0, 4), (1, 0.0, 1), (3, 0.0, 3), (5, 0.0, 2)]
LEAN = [(2, 0.0, 560, 60), (4, 0.0, 620, 150)]
SE = [(-1, 0.0, "se_rise", -8), (0, 1.0, "se_ding", -10), (2, 1.0, "se_shred", -8), (4, 0.0, "se_ding", -9), (4, 1.3, "se_pop", -7)]
ENDING = dict(kind="jump", at=(5, 0.0))

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "dash"
MOVES = [(1, 0.0, "hop", 0.8), (2, 0.0, "shake", 0.6), (4, 0.0, "jump", 0.9)]
BG = dict(file="../AIあるある_背景/bg_11.png", at=(2, 1.0), veil=0.45)
AIあるある_12_音声確認/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 12(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("read1", "smile", "では、台本を読みます。|看護師さんの、強化月間です。", 0.3),
 ("rep1_ei", "base", "きょうかつきかん……。", 0.4),
 ("read2", "joy", "直しました!|ここには、入れないでください。", 0.3),
 ("rep2_ei", "base", "はいれないで……。", 0.6),
 ("end_ei", "base", "全部聞いて確かめるの、|俺なんだよね。", 1.6),
]
ELEVEN_READ = [("強化月間", "キョウカツキカン"), ("入れないで", "はいれないで")]
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_12_音声確認/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 12「音声確認」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 12, "音声確認", 1
HEAD = "AIに台本を<br>読ませたら"
LEAD = 1.8

RUBY = lambda w, r: f'<ruby style="ruby-position:over">{w}<rt style="font-size:30px;color:#c4472a;font-weight:900">{r}</rt></ruby>'


def scene(T, S):
    return (dlg("読み上げ中", "看護師さんの<br>" + RUBY("強化月間", "キョウカツキカン") + "です", T(0, 2.4), 100, 520, 880, -1.5, btns=(), t_dim=T(2, 0.0))
            + dlg("読み上げ中(直しました)", "ここには<br>" + RUBY("入れないで", "はいれないで") + "ください", T(2, 1.2), 80, 600, 900, 1.5, btns=())
            + tsukomi("また<br>違う", T(3, 0.0), T(4, 0.0), 120, 470, 116)
            + tsukomi("全部<br>聞くの<br>俺", T(4, S(4) + 0.15), None, 100, 470, 100))


FACE = [(-1, 0.0, 1.8, "joy"), (0, 0.0, 5.0, "smile"), (2, 0.0, 2.9, "joy"), ("end", 0.3, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (1, 0.0, 3), (2, 0.0, 1), (3, 0.0, 3), (4, 0.0, 2)]
LEAN = [(0, 0.0, 560, 60), (2, 0.0, 610, 130)]
SE = [(-1, 0.0, "se_rise", -8), (0, 2.4, "se_ding", -10), (2, 1.2, "se_ding", -10), (3, 0.0, "se_pop", -7),
      ("end", 0.0, "se_whoosh", -9), ("end", 0.3, "se_pechin", -6)]
ENDING = dict(kind="fall", at=("end", 0.3))

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "drop"
MOVES = [(0, 0.0, "bow", 0.8), (2, 0.0, "hop", 0.9), ("end", 0.6, "tilt", 1.0)]
BG = dict(file="../AIあるある_背景/bg_12.png", at=(0, 1.0), veil=0.45)
AIあるある_13_いい感じに/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 13(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "この絵、なんか、こう……。|もうちょっと、いい感じに。", 0.25),
 ("done", "joy", "承知しました!|いい感じにしました!", 0.4),
 ("where_ei", "base", "……どこが変わった?", 0.3),
 ("good", "joy", "いい感じです!", 0.6),
 ("end_ei", "base", "自分で動かしたほうが、早いな。", 1.6),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_13_いい感じに/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 13「いい感じに」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 13, "いい感じに", 1
HEAD = "AIに絵の直しを<br>頼んだら"
LEAD = 1.8

PIC = lambda lab: (f'<div style="display:flex;flex-direction:column;align-items:center;gap:8px"><div style="width:300px;height:220px;background:#cfe3f0;border-radius:12px;position:relative;overflow:hidden">'
                   '<div style="position:absolute;left:110px;top:50px;width:80px;height:80px;border-radius:50%;background:#ffd84a"></div>'
                   '<div style="position:absolute;left:0;right:0;bottom:0;height:70px;background:#7fb069"></div></div>'
                   f'<div style="font-size:34px;font-weight:900">{lab}</div></div>')


def scene(T, S):
    return (dlg("いい感じにしました!", f'<div style="display:flex;gap:30px;justify-content:center">{PIC("前")}{PIC("後")}</div>', T(1, 1.0), 70, 520, 920, -1, btns=())
            + tsukomi("伝わら<br>ない", T(2, 0.0), T(4, 0.0), 120, 470, 112)
            + tsukomi("自分で<br>やる", T(4, S(4) + 0.15), None, 110, 470, 112))


FACE = [(-1, 0.0, 1.8, "joy"), (0, 0.0, 4.5, "think"), (1, 0.0, 2.6, "joy"), (3, 0.0, 1.5, "joy"), ("end", 0.2, 3.0, "doubt")]
POSE = [(-1, 0.0, 1), (0, 0.0, 2), (2, 0.0, 3), (4, 0.0, 2)]
LEAN = [(1, 0.0, 570, 80), (3, 0.0, 620, 150)]
SE = [(-1, 0.0, "se_rise", -8), (1, 1.0, "se_ding", -10), (2, 0.0, "se_pop", -7), ("end", 0.15, "se_pop", -7)]
ENDING = dict(kind="none")

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "spin"
MOVES = [(0, 0.0, "tilt", 2.0), (1, 0.0, "spin", 1.2), (3, 0.0, "jump", 0.8)]
BG = dict(file="../AIあるある_背景/bg_13.png", at=(1, 1.0), veil=0.45)
AIあるある_14_笑う所/narration.py(セリフ)
# -*- coding: utf-8 -*-
# AIあるある 14(2026-11-02)。素材: エイイチの体験と言葉(ツッコミ・オチはエイイチがチャットで話した言葉から)
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")
SEGS = [
 ("ask_ei", "base", "ここ、笑う所だから。", 0.25),
 ("ok", "smile", "承知しました!", 0.3),
 ("ha1", "base", "ハハハ。ハハハ。", 0.4),
 ("no_ei", "base", "そうじゃない。", 0.3),
 ("ha2", "joy", "では、もっと大きく笑います!|ハハハハハ!", 1.8),
]
ELEVEN_READ = []
EI_LINES = [i for i, seg in enumerate(SEGS) if seg[0].endswith("_ei")]
READ = [("「", ""), ("」", "")]


def parse(seg):
    scene, face, text = seg[0], seg[1], seg[2]
    pause = seg[3] if len(seg) > 3 else 0.35
    return scene, face, text, pause
AIあるある_14_笑う所/spec.py(画面の中身と動き)
# -*- coding: utf-8 -*-
"""AIあるある 14「笑う所」(2026-11-02 版1)。ツッコミとオチはエイイチがチャットで話した言葉から"""
from aiaru_parts import dlg, tsukomi, shake

NO, NAME, VER = 14, "笑う所", 1
HEAD = "AIに笑いを<br>教えたら"
LEAD = 1.8

def scene(T, S):
    haha = lambda n, px: f'<span style="font-size:{px}px;font-weight:900;letter-spacing:.05em">{"ハ" * n}</span>'
    return (dlg("台本", "ここ、笑う所", T(0, 0.8), 110, 520, 860, -1.5, btns=(), t_dim=T(2, 0.0))
            + dlg("笑い(音声)", haha(6, 90), T(2, 0.0), 90, 620, 900, 1.5, btns=(), t_out=T(4, 0.0))
            + dlg("笑い(大きく)", haha(10, 110), T(4, 1.6), 50, 600, 980, -2, btns=(), red=True)
            + tsukomi("そうじゃ<br>ない", T(3, 0.0), T(4, 0.0), 120, 470, 112)
            + tsukomi("骨が<br>折れる", T(4, S(4) + 0.15), None, 110, 470, 112)
            + shake([(T(4, 1.7), 1.2)], amp=6))


FACE = [(-1, 0.0, 1.8, "joy"), (2, 0.0, 1.7, "base"), (4, 1.5, 2.0, "joy"), ("end", 0.3, 3.0, "smile")]
POSE = [(-1, 0.0, 1), (2, 0.0, 3), (3, 0.0, 2), (4, 1.6, 3)]
LEAN = [(2, 0.0, 560, 60), (4, 1.5, 640, 160)]
SE = [(-1, 0.0, "se_rise", -8), (0, 0.8, "se_ding", -10), (3, 0.0, "se_pop", -7), (4, 1.6, "se_ding", -9),
      ("end", 0.2, "se_whoosh", -9), ("end", 0.5, "se_pechin", -6)]
ENDING = dict(kind="fall", at=("end", 0.4))

# --- 2026-11-02 動きと背景(エイイチ「ハコブくんはいろんな動き、いろんな向きに」「背景写真は話によって」) ---
VER = 2
INTRO = "rise"
MOVES = [(2, 0.0, "turn", 1.6), (4, 1.5, "hop", 1.8)]
BG = dict(file="../AIあるある_背景/bg_14.png", at=(0, 0.8), veil=0.45)
背景を頼んだ aiaru_bg.py(Mac で動かした)
import json, os, sys, base64, time, urllib.request, urllib.error
D = os.path.expanduser("~/mnt/KIOXIA/r2r2r-data/videos/_ショート専用/AIあるある_背景")
KEY = open(os.path.expanduser("~/mnt/KIOXIA/gemini_api_key.txt")).read().strip()
MODEL = "gemini-3.1-flash-image"
COMMON = (" Photorealistic photograph, vertical 9:16 composition. Absolutely no text, no letters, no numbers, no logos, no signs with writing, no people."
          " Cinematic, slightly moody lighting, rich colors. Keep the lower third of the frame calm and uncluttered (characters will be placed there).")
JOBS = {
"02": "A cozy home recording desk at night: studio headphones, a microphone on a boom arm, a laptop glowing, warm lamp light.",sns_autopost.py に動画を付ける処理を足した差分(r2r2r-content の commit e6dc8d1)
commit e6dc8d1290833157be50a881502ef5fe1974573a
Author: Claude <noreply@anthropic.com>
Date:   Mon Nov 2 18:47:16 2026 +0900

    SNS予約:ショート AIあるある 01〜04 を X に動画で予約(11/3〜6 22:00)・X の投稿に動画を付けられるようにした

    - tools/sns_autopost.py: posts.x_video(動画1本)を v2 の分けて送る形で上げてから投稿する
- docs/sns_autopost.md: X に動画を付ける節を追加声を作ったときの出力(tts_eleven.py・2026-11-02)
001 念のため、確認させてください。この内容で、直してよろしいです
003 ありがとうございます。では、元に戻せないので、もう一度、確認
004 安全のため、最後に確認です。
006 承知しました。確認しないで、合っていますか?
できあがり: voice_eleven/ハコブ  使った文字数 約106字
000 これ、直しといて。
002 いいよ。
005 確認いらん。
できあがり: voice_eleven/エイイチ  使った文字数 約19字
== AIあるある_02_英語だよ H=1,3,4,6 E=0,2,5
できあがり: voice_eleven/ハコブ  使った文字数 約76字
できあがり: voice_eleven/エイイチ  使った文字数 約34字
== AIあるある_03_直さないって H=1,3,5 E=0,2,4,6
できあがり: voice_eleven/ハコブ  使った文字数 約89字
できあがり: voice_eleven/エイイチ  使った文字数 約39字
== AIあるある_04_先に相談して H=1,3,5 E=0,2,4
できあがり: voice_eleven/ハコブ  使った文字数 約55字
できあがり: voice_eleven/エイイチ  使った文字数 約40字
== AIあるある_05_そっちできたか
できあがり: voice_eleven/ハコブ  使った文字数 約33字
できあがり: voice_eleven/エイイチ  使った文字数 約38字
== AIあるある_06_字が小さい
できあがり: voice_eleven/ハコブ  使った文字数 約46字
できあがり: voice_eleven/エイイチ  使った文字数 約33字
== AIあるある_07_アメリカ生まれ
できあがり: voice_eleven/ハコブ  使った文字数 約44字
できあがり: voice_eleven/エイイチ  使った文字数 約40字
== AIあるある_08_カギカッコ
できあがり: voice_eleven/ハコブ  使った文字数 約39字
できあがり: voice_eleven/エイイチ  使った文字数 約28字
== AIあるある_09_また説明し直し
できあがり: voice_eleven/ハコブ  使った文字数 約45字
できあがり: voice_eleven/エイイチ  使った文字数 約25字
== AIあるある_10_説明くさい
できあがり: voice_eleven/ハコブ  使った文字数 約48字
できあがり: voice_eleven/エイイチ  使った文字数 約41字
== AIあるある_11_つまらなくする天才
できあがり: voice_eleven/ハコブ  使った文字数 約40字
できあがり: voice_eleven/エイイチ  使った文字数 約43字
== AIあるある_12_音声確認
できあがり: voice_eleven/ハコブ  使った文字数 約51字
できあがり: voice_eleven/エイイチ  使った文字数 約38字
== AIあるある_13_いい感じに
できあがり: voice_eleven/ハコブ  使った文字数 約24字
できあがり: voice_eleven/エイイチ  使った文字数 約51字
== AIあるある_14_笑う所
できあがり: voice_eleven/ハコブ  使った文字数 約35字
できあがり: voice_eleven/エイイチ  使った文字数 約17字
声の長さ(tts_import.py で取り込んだあとの tts/index.json)
== AIあるある_01_確認いらん
0 1.3 これ、直しといて。
1 4.59 念のため、確認させてください。この内容で、直してよろしいですか?
2 0.51 いいよ。
3 5.29 ありがとうございます。では、元に戻せないので、もう一度、確認させてください。
4 2.28 安全のため、最後に確認です。
5 1.09 確認いらん。
6 3.3 承知しました。「確認しない」で、合っていますか?
== AIあるある_02_英語だよ
0 2.07 使える音源、調べといて。
1 2.13 お任せください!調べました!
2 2.46 英語で書いてあって、わからないよ?
3 2.73 失礼しました。日本語で書き直します。
4 2.2 公開したページを、確認しました!
5 0.66 英語だよ?
6 3.45 このプロジェクトの返事は、日本語で書くと決まっています。
== AIあるある_03_直さないって
0 1.84 この記事、公開しといて。
1 5.29 公開しました!ところで、前の記事に食い違いを見つけました。直しますか?
2 0.82 直さない。
3 4.8 承知しました。あ、こちらの記事にも食い違いが。直しますか?
4 2.14 公開した記事は、直さない。
5 3.41 では、直さない理由を、記事に書き足しておきますか?
6 1.21 何度言えばわかる!
== AIあるある_04_先に相談して
0 2.62 ここ、ちょっと気になるんだけど。
1 0.92 直しました!
2 1.91 え、まだ何も言ってない。
3 2.68 ついでに、ほかの12か所も直しました!
4 2.27 直す前に、先に相談して。
5 4.22 承知しました!では、直したことについて、相談させてください。
== AIあるある_05_そっちできたか
0 2.89 冒頭の動き、30本ぶん作っといて。
1 2.03 できました!|30本です!
2 2.22 え、もう?|早いな。
3 3.3 はい!|30本とも、同じ動きにそろえました!
4 2.05 あー、そっちできたかー。
== AIあるある_06_字が小さい
0 2.18 字、もっと大きくして。
1 1.07 大きくしました!
2 1.16 変わってないよね。
3 1.61 1.1倍にしました!
4 1.88 前の動画でも、言ったよね。
5 1.64 次から、気をつけます!
6 1.91 新しい動画が、できました!
== AIあるある_07_アメリカ生まれ
0 1.67 これ、いくらかかる?
1 2.32 約0.015ドルです!
2 0.88 円で言って。
3 4.01 約2円です!|ドルでいうと、0.015ドルです!
4 3.3 日本語ペラペラでも、|アメリカ生まれなんだよなー。
== AIあるある_08_カギカッコ
0 1.88 カギカッコ、多すぎ。
1 3.84 承知しました。|今後は、「カギカッコ」を減らします。
2 1.15 今、付けたよね。
3 2.46 では、要点を3つにまとめました!
4 2.02 ほんと、そればっか。
== AIあるある_09_また説明し直し
0 1.68 もう少し、右。
1 4.68 右とは、ロボットから見て右ですか?|カメラから見て右ですか?
2 3.04 カメラから見て。|前にも説明したよね。
3 2.43 新しい会話なので、|はじめまして!
== AIあるある_10_説明くさい
0 2.58 この台本、もっと強弱をつけて。
1 5.2 承知しました!|強弱とは、強い所と弱い所の、差のことです。
2 2.34 それが、説明くさいんだよ。
3 3.71 では、説明くさいとは何かを、|説明します!
4 2.12 俺の指示が、悪いんか……。
== AIあるある_11_つまらなくする天才
0 2.64 ここ、ちょっと笑えるようにしたんだ。
1 1.87 事実を、確認しました!
2 2.97 笑いの所は、根拠がないので、|消しました!
3 0.5 え。
4 1.21 正確になりました!
5 3.47 人は、事実だけじゃ、|興味をそそられないんだよ。
== AIあるある_12_音声確認
0 5.04 では、台本を読みます。|看護師さんの、強化月間です。
1 1.34 きょうかつきかん……。
2 2.89 直しました!|ここには、入れないでください。
3 1.08 はいれないで……。
4 2.85 全部聞いて確かめるの、|俺なんだよね。
== AIあるある_13_いい感じに
0 4.51 この絵、なんか、こう……。|もうちょっと、いい感じに。
1 2.44 承知しました!|いい感じにしました!
2 1.28 ……どこが変わった?
3 0.91 いい感じです!
4 2.45 自分で動かしたほうが、早いな。
== AIあるある_14_笑う所
0 2.16 ここ、笑う所だから。
1 0.96 承知しました!
2 1.65 ハハハ。ハハハ。
3 0.81 そうじゃない。
4 3.39 では、もっと大きく笑います!|ハハハハハ!
版1の書き出しで止まった所(字幕が折れない)
字幕が折れない: 公開しました!ところで、前の記事に食い違いを見つけました。直しますか?
字幕が折れない: お任せください!調べました!
字幕が折れない: 日本語ペラペラでも、|アメリカ生まれなんだよなー。
字幕が折れない: 人は、事実だけじゃ、|興味をそそられないんだよ。
部品にまとめた直後に止まった所(_制作ベース の narration.py を読んでいた)
Traceback (most recent call last):
  File "/home/claude/w/_ショート専用/AIあるある_02_英語だよ/../AIあるある_共通/aiaru_kit.py", line 315, in <module>
    build([float(x) for x in sys.argv[2].split(",")])
    ~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
  File "/home/claude/w/_ショート専用/AIあるある_02_英語だよ/../AIあるある_共通/aiaru_kit.py", line 87, in build
    ei_main = set(N.EI_LINES)
                  ^^^^^^^^^^
AttributeError: module 'narration' has no attribute 'EI_LINES'
版2の書き出しの出力
out/AIあるある10_説明くさい_版2.mp4  20.9秒
out/AIあるある01_確認いらん_版2.mp4  23.7秒
out/AIあるある11_つまらなくする天才_版2.mp4  17.7秒
out/AIあるある12_音声確認_版2.mp4  18.2秒
out/AIあるある13_いい感じに_版2.mp4  16.5秒
out/AIあるある14_笑う所_版2.mp4  13.8秒
おわり
out/AIあるある09_また説明し直し_版2.mp4  16.4秒
おわり2
版2の最初の書き出しでは、番号の置き換えの誤りで 01 が AIあるある02_確認いらん_版2.mp4、10 が AIあるある20_説明くさい_版2.mp4 の名前で出ました。名前の違う2本は消し、番号を直してから書き出し直しています。09 は、作業環境の10分の上限で途中で切れて壊れた mp4 になったので、もう一度書き出しました。
背景の写真を作ったときの出力(aiaru_bg.py)
02 ok
03 ok
05 ok
06 ok
07 ok
09 ok
11 ok
12 ok
13 ok
14 ok
おわり
X の代わりのサーバーで、動画を付けた投稿の流れを通した出力
POST /2/media/upload/initialize application/json 84
POST /2/media/upload/M1/append multipart/form-data; boundary=----p2m978 4194583
POST /2/media/upload/M1/append multipart/form-data; boundary=----p2md3f 4194583
POST /2/media/upload/M1/append multipart/form-data; boundary=----p2m7a8 1048855
POST /2/media/upload/M1/finalize application/json 0
POST /2/tweets application/json 48
{'text': 'test', 'media': {'media_ids': ['M1']}}
{'post_id': 'T1', 'url': 'https://x.com/i/web/status/T1'}
R2 に入れた動画と手元の動画の指紋の照合(版2)
ok short_aiaruaru01_kakunin_v2.mp4
ok short_aiaruaru02_eigo_v2.mp4
ok short_aiaruaru03_naosanai_v2.mp4
ok short_aiaruaru04_soudan_v2.mp4
ok short_aiaruaru05_docchi_v2.mp4
ok short_aiaruaru06_jiga_v2.mp4
ok short_aiaruaru07_america_v2.mp4
ok short_aiaruaru08_kagikakko_v2.mp4
ok short_aiaruaru09_setsumei_v2.mp4
ok short_aiaruaru10_kusai_v2.mp4
ok short_aiaruaru11_tsumaranaku_v2.mp4
ok short_aiaruaru12_onsei_v2.mp4
ok short_aiaruaru13_iikanji_v2.mp4
ok short_aiaruaru14_warau_v2.mp4
X の予約(sns/schedule.json に足した14行)と確かめの結果
AIARU01-x  2026-11-03T22:00:00+09:00
AIARU02-x  2026-11-04T22:00:00+09:00
AIARU03-x  2026-11-05T22:00:00+09:00
AIARU04-x  2026-11-06T22:00:00+09:00
AIARU05-x  2026-11-07T22:00:00+09:00
AIARU06-x  2026-11-08T22:00:00+09:00
AIARU07-x  2026-11-09T22:00:00+09:00
AIARU08-x  2026-11-10T22:00:00+09:00
AIARU09-x  2026-11-11T22:00:00+09:00
AIARU10-x  2026-11-12T22:00:00+09:00
AIARU11-x  2026-11-13T22:00:00+09:00
AIARU12-x  2026-11-14T22:00:00+09:00
AIARU13-x  2026-11-15T22:00:00+09:00
AIARU14-x  2026-11-16T22:00:00+09:00
問題ありません。
X の投稿文のファイル(sns/AIARU01_sns_posts.json)
{
  "meta": {
    "kind": "x_short_video",
    "title": "ショート AIあるある 01「確認いらん」",
    "url": "https://pixelstomotors.com"
  },
  "posts": {
    "x": "AIに作業を頼むと、真面目に何度も確認してくる。\n「確認いらん」って言ったら、それも確認された。\n\n悪気がないのは分かってる。分かってるんだけどね。\n\n#AIあるある #生成AI",
    "x_video": "/media/short_aiaruaru01_kakunin_v2.mp4"
  },
  "note": "ショート専用『AIあるある』を YouTube より先に X に動画で出す(2026-11-02 エイイチの指示「先行して X に投稿」)。動画は R2 の p2m-media。作り方は iCloud 動画/_ショート専用/AIあるある_{NN}_{名前}/"
}