

解説動画の1本目を公開まで通す ― 声・BGM・間・直し・サムネイルを部品ごとに決め、23手順にまとめた
title: "解説動画の1本目を公開まで通す ― 声・BGM・間・直し・サムネイルを部品ごとに決め、23手順にまとめた" slug: first-video-end-to-end date: 2026-10-12 day: 333 meta_description: "解説動画「フィジカルAIの現在地」をハコブくんの声で作り直し、YouTubeに公開した。声・BGM・効果音・間・不具合の直し・概要欄・サムネイルを部品ごとに決め、次の動画から使う23手順にまとめた。" tags: [YouTube, 解説動画, ハコブくん, ElevenLabs, BGM, 効果音, ffmpeg, Python, Playwright, サムネイル, 動画制作]
試作で作った解説動画「フィジカルAIの現在地」を、ナレーション役のハコブくんの声で作り直し、YouTube に公開しました。公開したタイトルは「人型ロボットの出荷は4倍。ロボットにも「ChatGPTの瞬間」は来たのか|フィジカルAIの現在地」、長さは12分29秒です。
台本・図・字幕・ハコブくんの動きは、これまでの記事で作ってきました(構成と台本の検証は LOG330、ハコブくんの口と目の動きは LOG331、チャンネルの見た目は LOG332)。この記事は、そこから公開までに決めたことの記録です。声、BGM と効果音、文と文の間、見つかった不具合の直し、YouTube の概要欄、サムネイル、公開した直後に見えたこと、の順に書いています。最後に、次の動画から同じ順番で作れるようにまとめた23の手順を載せました。
作業は、Claude のクラウドの作業環境でスクリプトを動かし、ElevenLabs で声と音楽を作る所だけを手元の Mac で動かす形で進めました。ElevenLabs の API キーは Mac の中だけで使い、Claude には渡していません。API キーが写っている画面の写真は、この記事に載せていません。
作ったスクリプトは、記事の後半にすべて全文で載せています。書き出しのログと、測った数値も全量で載せています。
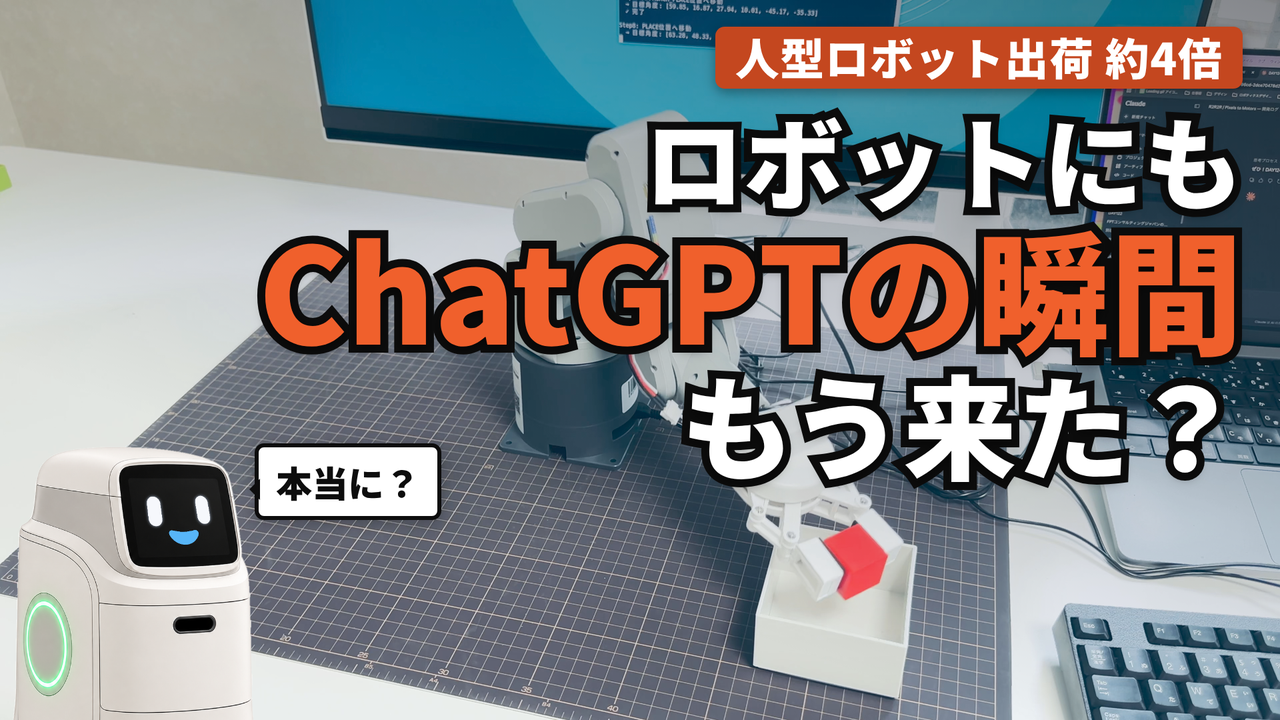
公開した動画は12分29秒・146文・効果音45個
公開した動画の中身は、次のとおりです。数値は、YouTube に上げたファイルを ffprobe(動画の中身を調べるツール)と ffmpeg の音量測定で測ったものです。
項目 | 値 |
|---|---|
長さ | 12分29秒(749.1秒・22,473コマ) |
文の数 | 146文(字幕の字数で約4,300字) |
ナレーション | ハコブくん(ElevenLabs のボイスデザインで作った声・モデル Eleven v4) |
BGM | ElevenLabs Music で作った1曲(bgm_明るいB_2・60秒)を最初から最後までループ |
効果音 | 45個。場面の切り替えの「ホワーン」37個、大きな流れの変わり目の「ポロロン」7個、自己紹介の「キラリン」1個 |
音の大きさ | -16.0 LUFS(YouTube で聞く大きさの目安にそろえた) |
映像 | H.264、1920×1080、30コマ/秒 |
上げたファイル | 65,655,407 バイト(約66MB) |
動画は、冒頭で「今年の上半期に出荷された人型ロボットは約4倍」という推計を出し、「ロボットにも ChatGPT のような瞬間はもう来たのか」を問いにしています。答えは「写真を見せて判断させる入口は簡単になった。物を確実に動かすところは、まだ手間がかかる」です。そのあと3つの章(出荷の中身、机の上のロボットアームで分かったこと、データの壁)を見て、ロボットのニュースを見るときの2つの問いで終わります。
チャンネルは Pixels to Motors の YouTube です。
ハコブくんの声は、ElevenLabs のボイスデザインで作った「候補6」に決めた
ナレーションはハコブくんが話すと決めています(LOG331)。声は、ほかのチャンネルと同じ声を使わず、ハコブくん専用に作ります。ElevenLabs のボイスデザイン(声の特徴を文章で書くと、新しい声の候補を作る機能)を有料プランで1か月試すことにしました。
声の候補をいくつか作って聞き比べ、「候補6(明るい30代前半のお手伝いロボット)」の2つ目のパターンに決めました。落ち着いた30代の声(候補1)は、読みは正確でしたが、ハコブくんの見た目に合いませんでした。
読み上げのモデルは、冒頭の14文を Multilingual v2 と Eleven v4 で読ませて聞き比べ、Eleven v4 にしました。話す速さは既定のままです。1秒に約6.8字で、仮の音声(Open JTalk)の約5.2字より速く、動画は仮の音声の版より短くなりました。
声づくりは、手元の Mac で tts_eleven.py を動かして1文ずつ mp3 にし、それを Claude の作業環境で tts_import.py が書き出し用の wav に変える流れです。文の前後の無音は 0.05 秒を残して切り、文と文の間は台本に書いた「後ろの間」で決めます。
「エイイチ」の抑揚は、ひらがなの「えいいち」で渡すとそろった
通しで聞くと、「エイイチ」という名前の抑揚が文ごとに違っていました。
エイイチのイントネーションが揃っていないので、全て同じイントネーションに修正してください(語尾が下がる方が通常のイントネーションかな)
ElevenLabs に渡す文の書き方で、読み方が変わります。そこで tts_eleven.py に、台本ではなく試しの文だけを音声にする --try を足し、同じ文を4通りの書き方で作りました。
番号 | ElevenLabs に渡した書き方 |
|---|---|
1 | エイイチ(カタカナ) |
2 | 栄一(漢字) |
3 | えいいち(ひらがな) |
4 | エーイチ(伸ばす音) |
3回が正しい発音でした。
ひらがなの「えいいち」が、語尾の下がる読みでそろいました。台本 narration.py に ELEVEN_READ(ElevenLabs に渡すときだけ文字を置きかえる表)を作り、「エイイチ」を「えいいち」に置きかえています。字幕はカタカナのままです。
もう1か所、読み間違いが見つかりました。
3分16秒あたりのセリフが、裏表裏になっています(テキストは合っている)
37番の文で、「裏表」が「うらおもてうら」のように読まれていました。字幕の文字は合っていて、音声だけが違います。ELEVEN_READ に「裏表 → うらおもて」を足し、その文だけ作り直しました。仮の音声用の読み替え表 READ とは別に持っているのは、同じ語でも、エンジンによって間違え方が違うためです。
BGM は、コードで作った音から ElevenLabs Music の生楽器の曲に替えた
BGM は、最初にコードで仮の曲を作りました(sound_synth.py。やわらかい和音と小さな粒の音を数式で鳴らしたもの)。混ぜ方を確かめるための仮の曲です。
音源はシンセサイザーっぽいのではなくて、ほんのもう少しだけ温かみのある音源が良さそう(テーマが真面目なので、少し音源には彩りを加えたい的な)
コードでピアノ風・ギターとマリンバ風・ピッツィカート風の3曲を作り直しましたが、方向は変わりませんでした。
音源はもっと生音っぽい方がいいかな。音源使えるのある?
そこで、使える音源を調べて表にしました(音源_候補.md。全文は後半)。条件は、YouTube で収益化しても使えること、クレジット表記の条件を守れること、ほかのチャンネルと同じ曲になりにくいことです。第一候補を ElevenLabs Music(文章で曲の雰囲気を書くと、新しい曲を作る機能)にしました。声と同じプランで使え、新しく作る曲なので、ほかのチャンネルと同じ曲にならないためです。
ElevenLabs Music を API から使うと、最初は次のエラーで止まりました。
HTTP 401 missing_permissions music_generation
使っていた API キーに、音楽を作る許可がありませんでした。新しいキーを作り直し、「読み上げ・効果音・音楽生成」の3つだけを許可しました。前のキーは、以前に画面の写真に写ったことがあったため、削除を勧めました(削除したかは、この記事の時点で確かめていません)。キーは、Mac のターミナルで画面に出ない形で入れています。
read -s ELEVENLABS_API_KEY && export ELEVENLABS_API_KEY
曲は sound_eleven.py で60秒ずつ作りました。最初の4曲(冒頭用2曲・本編用2曲)は、聞くと暗く感じました。
もう少し明るい曲調がいいかな。暗く聞こえる
長調・明るめを指定して、2種類の書き方で2曲ずつ作り直しました。
曲 | 指定した内容(要点) | 結果 |
|---|---|---|
bgm_冒頭_1・2 | 生の楽器、ギター・ピアノ・ピッツィカート・マリンバ、100 BPM、好奇心と希望 | 暗く聞こえた |
bgm_本編_1・2 | 生の楽器、フェルトピアノ・ギター・チェロとバイオリン、90 BPM、落ち着いて真面目 | 暗く聞こえた |
bgm_明るいA_1・2 | 長調、ギター・明るいピアノ・鉄琴・手拍子、105 BPM、晴れた朝のように | A_1 を冒頭で試した |
bgm_明るいB_1・2 | 長調、ピアノとギターが主、弦・ピッツィカート・鉄琴、100 BPM、前向きで落ち着いた明るさ | B_2 に決めた |
bgm_明るいB_2.mp3 bgm_明るいA_1.mp3 で動画作成してみて
冒頭15秒を2曲それぞれで書き出して聞き比べ、B_2 に決まりました。指定した文章の全文は、後半の「作った曲の記録」にあります。
曲は60秒なので、12分29秒の動画ではループします。ElevenLabs の曲は最後の数秒で小さくなって終わるため、そのままつなぐと1分ごとに音が消えます。audio_mix.py で、曲のふつうの大きさより10dB以上小さくなる終わりの部分を切り、つなぎ目を2秒重ねてループさせました。
BGM の大きさは、話している間 -23dB・0.8秒以上の間 -16dB にした
BGM は、ハコブくんが話している間だけ自動で小さくし、話していない間で少し戻します。値はナレーションの大きさとの差で、-23dB はナレーションのおよそ14分の1の音圧です。
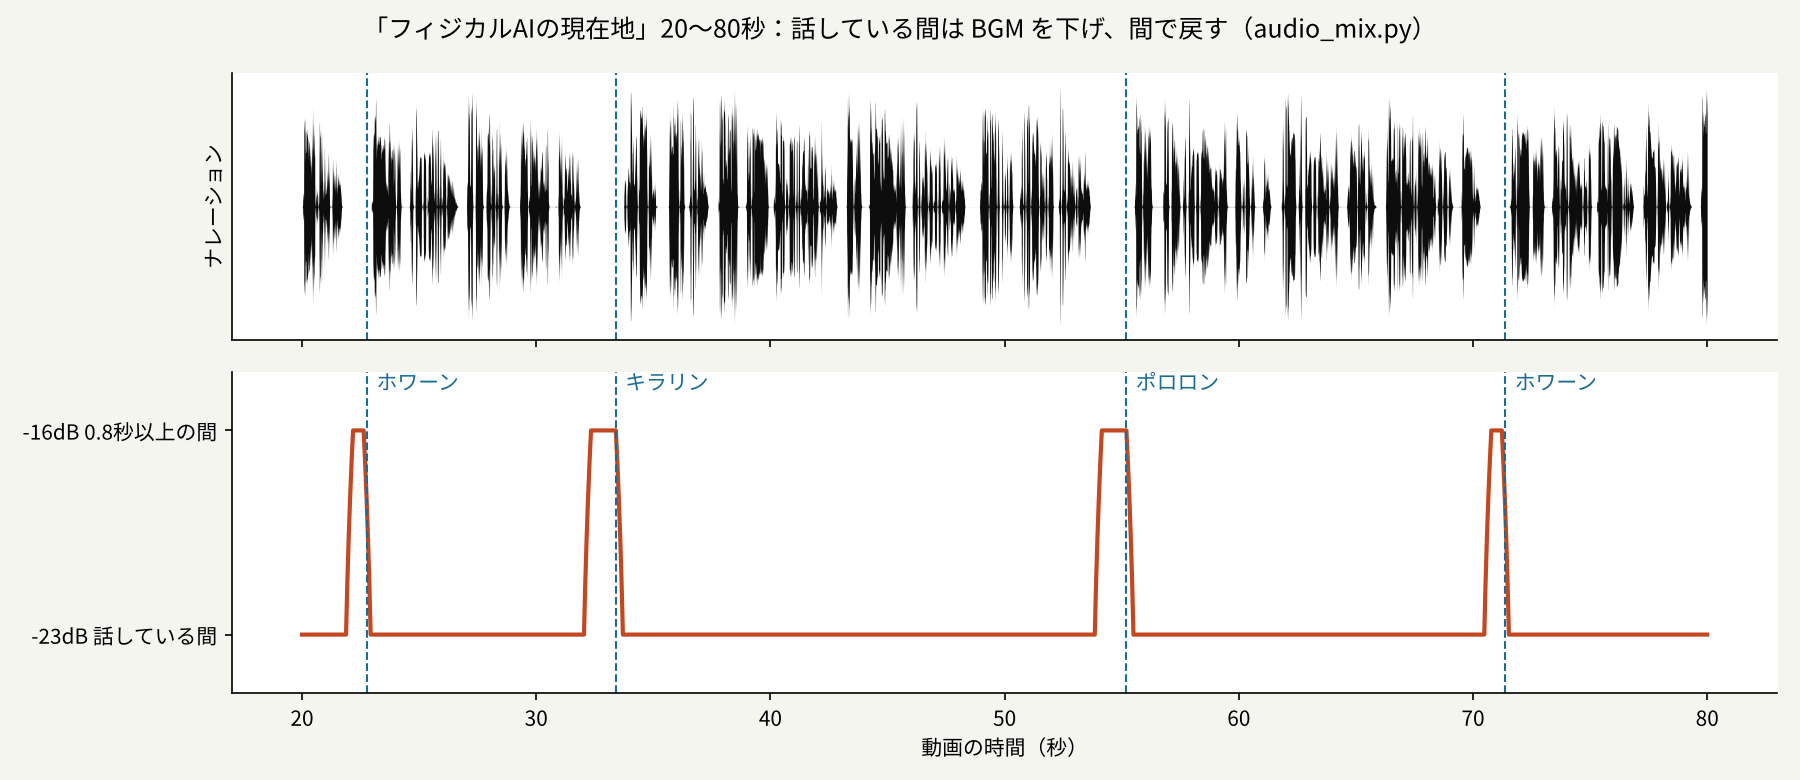
この値に決まるまでに、4回動かしました。
段階 | 話している間 | 0.8秒以上の間 | きっかけ |
|---|---|---|---|
1 | -22dB | -15dB | 最初の値 |
2 | -15dB | -9dB | 「音源が聞こえないね。もう少しだけ音量上げるか、音源だけ聴きたい」 |
3 | -22dB | -15dB | 明るい曲に替えたら大きく聞こえた |
4 | -23dB | -16dB | 「音源の音量90%くらいにして」 |
曲調を変えたら音量が大きく聞こえてしまうようになったので、前の音量に戻してください。冒頭15秒_bgm_明るいB_2が良さそうです。
いいですね。音源の音量90%くらいにして、この動画を仕上げてみてください。
同じ dB の値でも、曲が変わると聞こえ方が変わりました。明るい曲は高い音(鉄琴や明るいピアノ)が多く、低い音の多い曲よりナレーションの上に出て聞こえたためと考えています。90%は、音圧で1dB下げることにあたります(20×log10(0.9) ≒ -0.9dB)。
話している所の決め方は、次のとおりです。
各文の読み上げの範囲を、前に0.15秒、後ろに0.3秒広げる
広げたあとの間が0.5秒未満なら、話している扱いのまま(もとの間で約0.8秒未満。BGM が文ごとに上下しないため)
0.3秒かけてなめらかに上げ下げする
グラフのとおり、BGM が戻るのは、場面の切り替えの直前(1.2秒の間)、章の見出しのあと(1.7秒)、大きな流れの変わり目(1.8秒の間)だけです。ふつうの文の間(0.35秒)では、BGM は下がったままです。
後ろの間の長さを選ぶと、BGM の大きさと鳴る効果音がどう変わるかを、次の図で動かして確かめられます。
場面の切り替えは「ホワーン」、大きな流れの変わり目は「キラリン」と「ポロロン」
効果音は、最初にコードで5種類作りました(ぽん・こつ・しゅっ・ちん・ひゅい)。冒頭15秒で試したあと、使い方を絞りました。
最後のホワーンって効果音を、場面切り替えに入れてみたい。
ホワーンって効果音だけを、場面切り替えに使って
効果音はもう少し音量を大きく。
効果音は「ホワーン」(se_rise)だけにし、ナレーションより12dB小さい値から6dB小さい値に上げました。場面(台本の1文ごとに書いた場面の名前)が変わる文の頭から0.15秒前に、自動で鳴らします。
次に、話の大きな区切りがどこか分かるようにしました。
それと動画の流れの中で少し間があるポイントがあるといいので、大きな流れの変化の時にはその間を設定することはできる?
もしくはそのときは効果音を違うものにするか。
大きな流れの変わり目(フック→自己紹介、自己紹介→「今日の問い」、各章の始まり、答え、エンディング)では、直前の文の後ろの間を1.8秒にし、ホワーンの代わりに別の音を鳴らすことにしました。別の音は、コードで6つ作りました(マリンバ・ハープ・ピアノ・鉄琴・ふくらむ和音・風)。
5と2で動画に入れ込んでみて(自己紹介のあたりで入れると良さそう。音源だけでも可です)
自己紹介は5のキラリンがいいね。他の切り替えポイントで2のポロロン使ったりと使い分けが良さそうだね(とりあえず自己紹介は5で確定)
自己紹介に入る所は「キラリン」(鉄琴の高い3音)、そのほかの変わり目は「ポロロン」(マリンバの上がる3音)にしました。ポロロンを場所ごとにどう使い分けるかは、まだ試している段階です。
そのあと、ふつうの場面の切り替えにも、もう少し間が欲しいという指摘がありました。
ホワーンという中の切り替えの時にもう一拍だけ間がある方がいいな。
ホワーンが鳴る所の直前の文の後ろの間を、1.2秒にしました。公開した台本の146文は、後ろの間で分けると次のとおりです。
どこ | 後ろの間 | 文の数 |
|---|---|---|
ふつうの文 | 0.35秒 | 96 |
話の小さな区切り | 0.4〜0.6秒 | 4 |
ふつうの場面の切り替え(ホワーンの前) | 1.2秒 | 32 |
章の見出しを読む文(「1つ目、…」など)と、最後のあいさつ | 1.7秒 | 5 |
大きな流れの変わり目(キラリン・ポロロンの前) | 1.8秒 | 8 |
字幕のない最後の文(エンディングの余白) | 6.0秒 | 1 |
章の見出しは、読んだすぐあとに場面が切り替わるので、見出しの1.2秒に、切り替えの一拍を足して1.7秒にしています。
どの文で何が鳴ったかは、書き出しのログに45行で出ています(後半に全量)。
自己紹介の2文目を「研究と開発」と「見立て」に直した
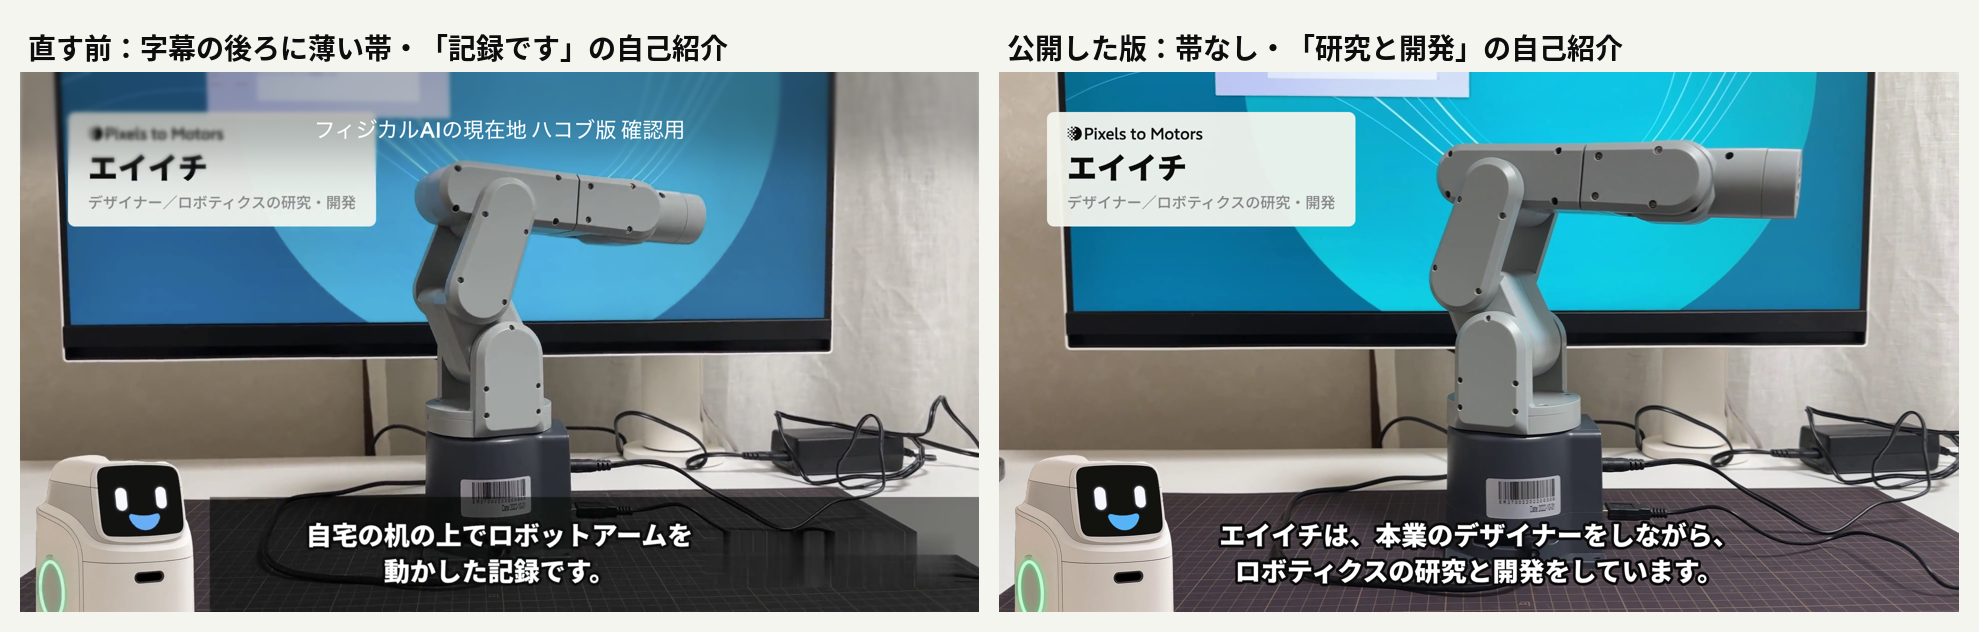
確認用の動画を見て、自己紹介の文と、字幕の後ろの帯に指摘がありました。
ここの自己紹介おかしくないか? それとナレーションのテキストの下に薄い四角枠が敷かれているのが必要ないかな。
ロボットアームを動かした記録を紹介しているわけではないよ(もちろんそういう時もあるだろうけど)
前の文は「題材は、本業のデザイナーをしながら、自宅の机の上でロボットアームを動かした記録です。」でした。これだと、毎回ロボットアームの記録を見せる番組だと受け取られます。この番組は、フィジカルAIを解説する番組です。Claude がいくつか言い方を出し、次の文に決めました。
エイイチは、本業のデザイナーをしながら、ロボティクスの研究と開発をしています。その中で分かったことと、そこから考えた見立てを、ハコブくんがお伝えします。こっちがいいかな。その下はすこし冗長だね。
「結論」ではなく「見立て」にしたのは、今の時点での判断で、新しい事実が出たら変わるからです。
名前のテロップも分けました。ハコブくんが自分の紹介をしている間は「フィジカルAI解説/案内役:ハコブくん(AI音声)」、本人を紹介する文から「エイイチ」を出します。台本では、この文を「title」から「title_eiichi」という別の場面に分けて、テロップを替えています。映像は同じなので、この切り替えではホワーンを鳴らしません。
字幕の後ろの薄い黒い帯は、実機の映像の上で字幕を読みやすくするために敷いていたものです。字幕の文字には黒い縁があり、帯がなくても読めるため、外しました。
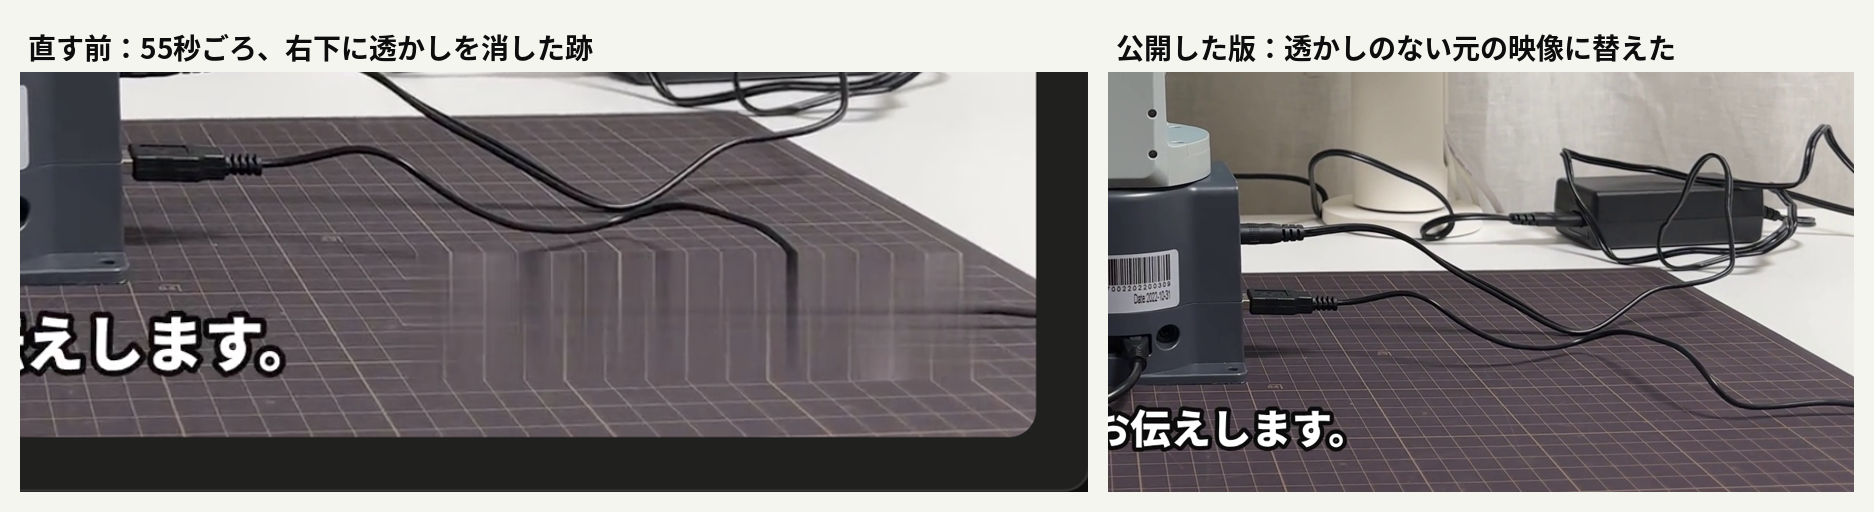
右下のモヤモヤは、透かしを消した跡だった
55秒くらいに右端下がモヤモヤしているのを見つけました。同じようなモヤモヤが他にもないか調べて修正してください。
自己紹介の場面の映像は、以前に動画編集サイト(Clideo)で書き出した版(DAY123.mp4)を使っていました。この版には右下にサイトの透かし(ロゴ)が入っていて、ffmpeg の delogo(指定した範囲を周りの色でぼかして埋める機能)で消していました。その跡が、マットの格子の上で縦の筋のように見えていました。
同じように透かし入りの版を使っていた映像は、もう1本(DAY124.mp4。章2の実機の場面)ありました。2本とも、透かしの入っていない元の撮影ファイル(DAY123.MOV・DAY124.mov)に替え、scenes.py の映像の指定で、透かしを消す処理を使わない設定(3つ目の値を False)にしました。
assemble.py は、1文ずつ背景の映像を作り、中身が変わった文だけを作り直す仕組みです。どの文を作り直すかは、背景の中身から作った指紋(ハッシュ)で判断しています。この指紋に、使う映像のファイル名と開始秒が入っていませんでした。そのままでは、映像を替えても作り直されないため、指紋に映像の指定を足しました。
30cm の図の説明を、図の下の2行に移した
30cm以上違うはのところは新しく内容を修正したので確認してください。前の動画か台本を確認して修正してください。
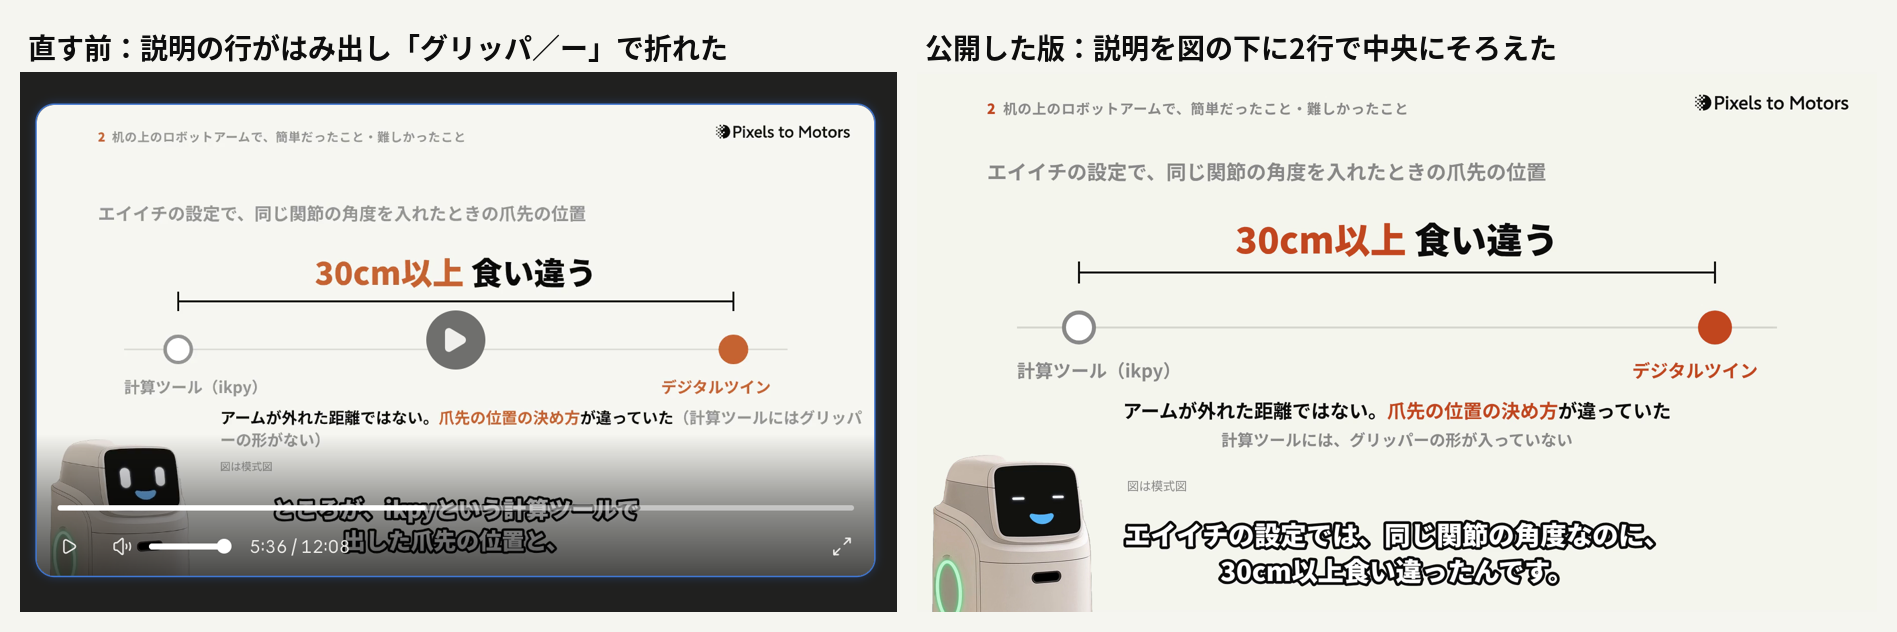
章2の「計算ツールとデジタルツインで、爪先の位置が30cm以上食い違った」という図で、説明の行が右へはみ出し、「グリッパー」が「グリッパ」と「ー」の2行に折れていました。説明を図の下に移し、中央にそろえた2行にしました。1行目が「アームが外れた距離ではない。爪先の位置の決め方が違っていた」、2行目が「計算ツールには、グリッパーの形が入っていない」です。
YouTube の概要欄は、目次の時間を書き出しから自動で入れた
YouTubeの動画内に入れる動画概要は追加情報などをまとめておいてください!
概要欄は、動画の作業フォルダの 概要欄_下書き.md に書き、description.py で貼り付け用の 概要欄.txt にします。目次の時間は、下書きに {t:26} のように文番号で書くと、書き出しのときに記録した、その文が始まる時間に置きかわります。声や間を変えて時間がずれても、下書きを直す必要がありません。
description.py は、YouTube の目次(チャプター)の条件を満たしているかも確かめます。最初が 0:00 で始まり、3つ以上あり、それぞれ10秒以上あることです。満たさないとき、5,000字を超えるとき、「【要記入】」が残っているときは止まります。
並べる順は、冒頭の数字、「今日の問い」、先に答え、この動画で見る3つ、目次、出典、この番組について、連絡先とリンク、チャンネル登録のお願いとハッシュタグ3つです。連絡先とリンクは、次のように決めました。
メールアドレス、xとリンクドインかな。
出典のリンクは、すべて開いて確かめてから載せました。Smart Analytics Global の推計は、公開されているページが見つからなかったため、リンクなしで名前と時期だけを書いています。1X NEO の「一般のお客さんへの配送開始」は、公式発表が見つからなかったことを、確かめた日付と一緒に書きました。
公開した概要欄の全文は、後半の「書き出した概要欄」にあります。
タイトルを決め、「子ども向け」は「いいえ」にした
修正したいところはまだまだありつつも、とりあえず合格点です!YouTubeにアップロードします!
タイトルは、Claude が3案を出し、「人型ロボットの出荷は4倍。ロボットにも「ChatGPTの瞬間」は来たのか|フィジカルAIの現在地」に決めました。冒頭の数字、動画の問い、シリーズ名の順です。
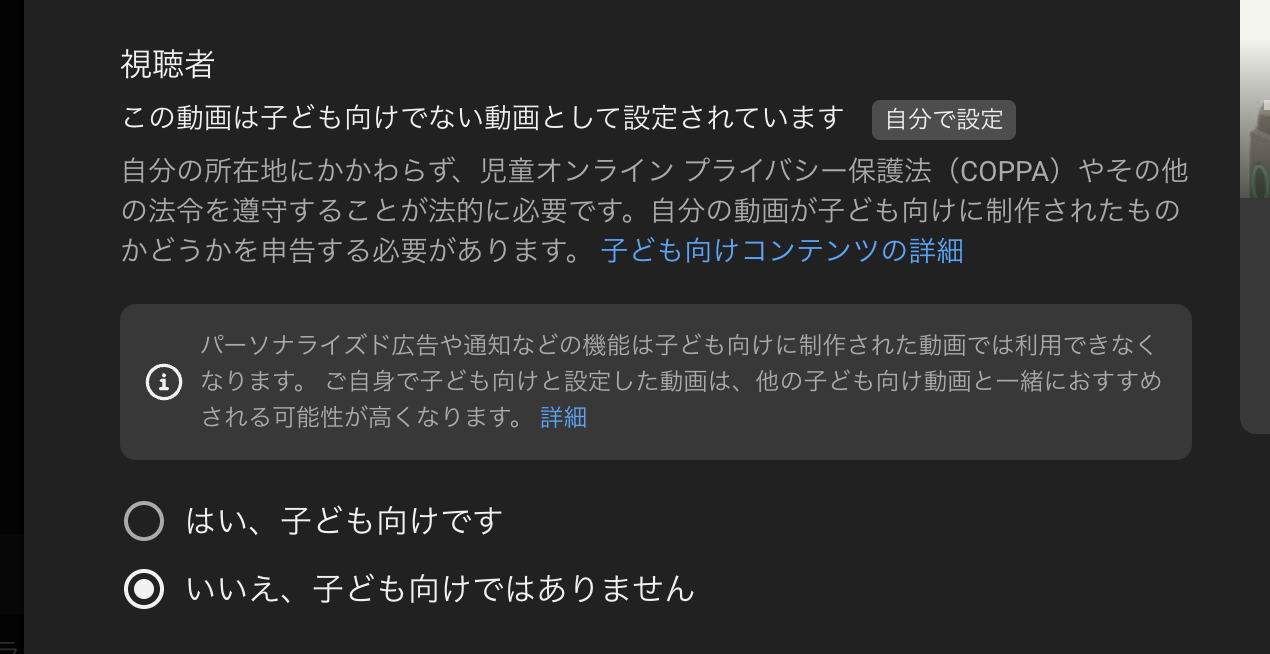
YouTube に上げるときは、動画が子ども向けかどうかを必ず選びます。ハコブくんはキャラクターですが、動画は大人の視聴者に向けた解説なので「いいえ、子ども向けではありません」にしました。子ども向けにすると、コメントや、ほかの動画の紹介などの機能が使えなくなります。
サムネイルは5回作り直した
それからサムネイルが必要ですね。ChatGptに作らせるので指示を考えてください。
最初は、ChatGPT に画像を作らせるための指示文を Claude が書き、ChatGPT で作りました。
chatGPTのサムネイルフォントが微妙だし、背景写真が違うしだね。
今の動画のフォント周りのデザインをベースにサムネイルの背景を入れる感じでまずは惹きつけられるサムネイルを目指したいです。
画像を作る AI は、日本語の文字の形が崩れやすく、背景のロボットアームも実物と違う形になりました。そこで、文字は画像の AI に任せず、thumbnail.py がコードで組む形にしました。文字と色は動画と同じもの(Noto Sans CJK JP の太字、オレンジ #C4471F、紙色 #F5F5F0、黒 #0D0D0D)を使い、HTML で組んで Playwright(ブラウザを自動で動かす道具)で画像にします。背景は、実機の映像の1コマです。文字をコードで組めば、誤字や崩れた文字は出ません。
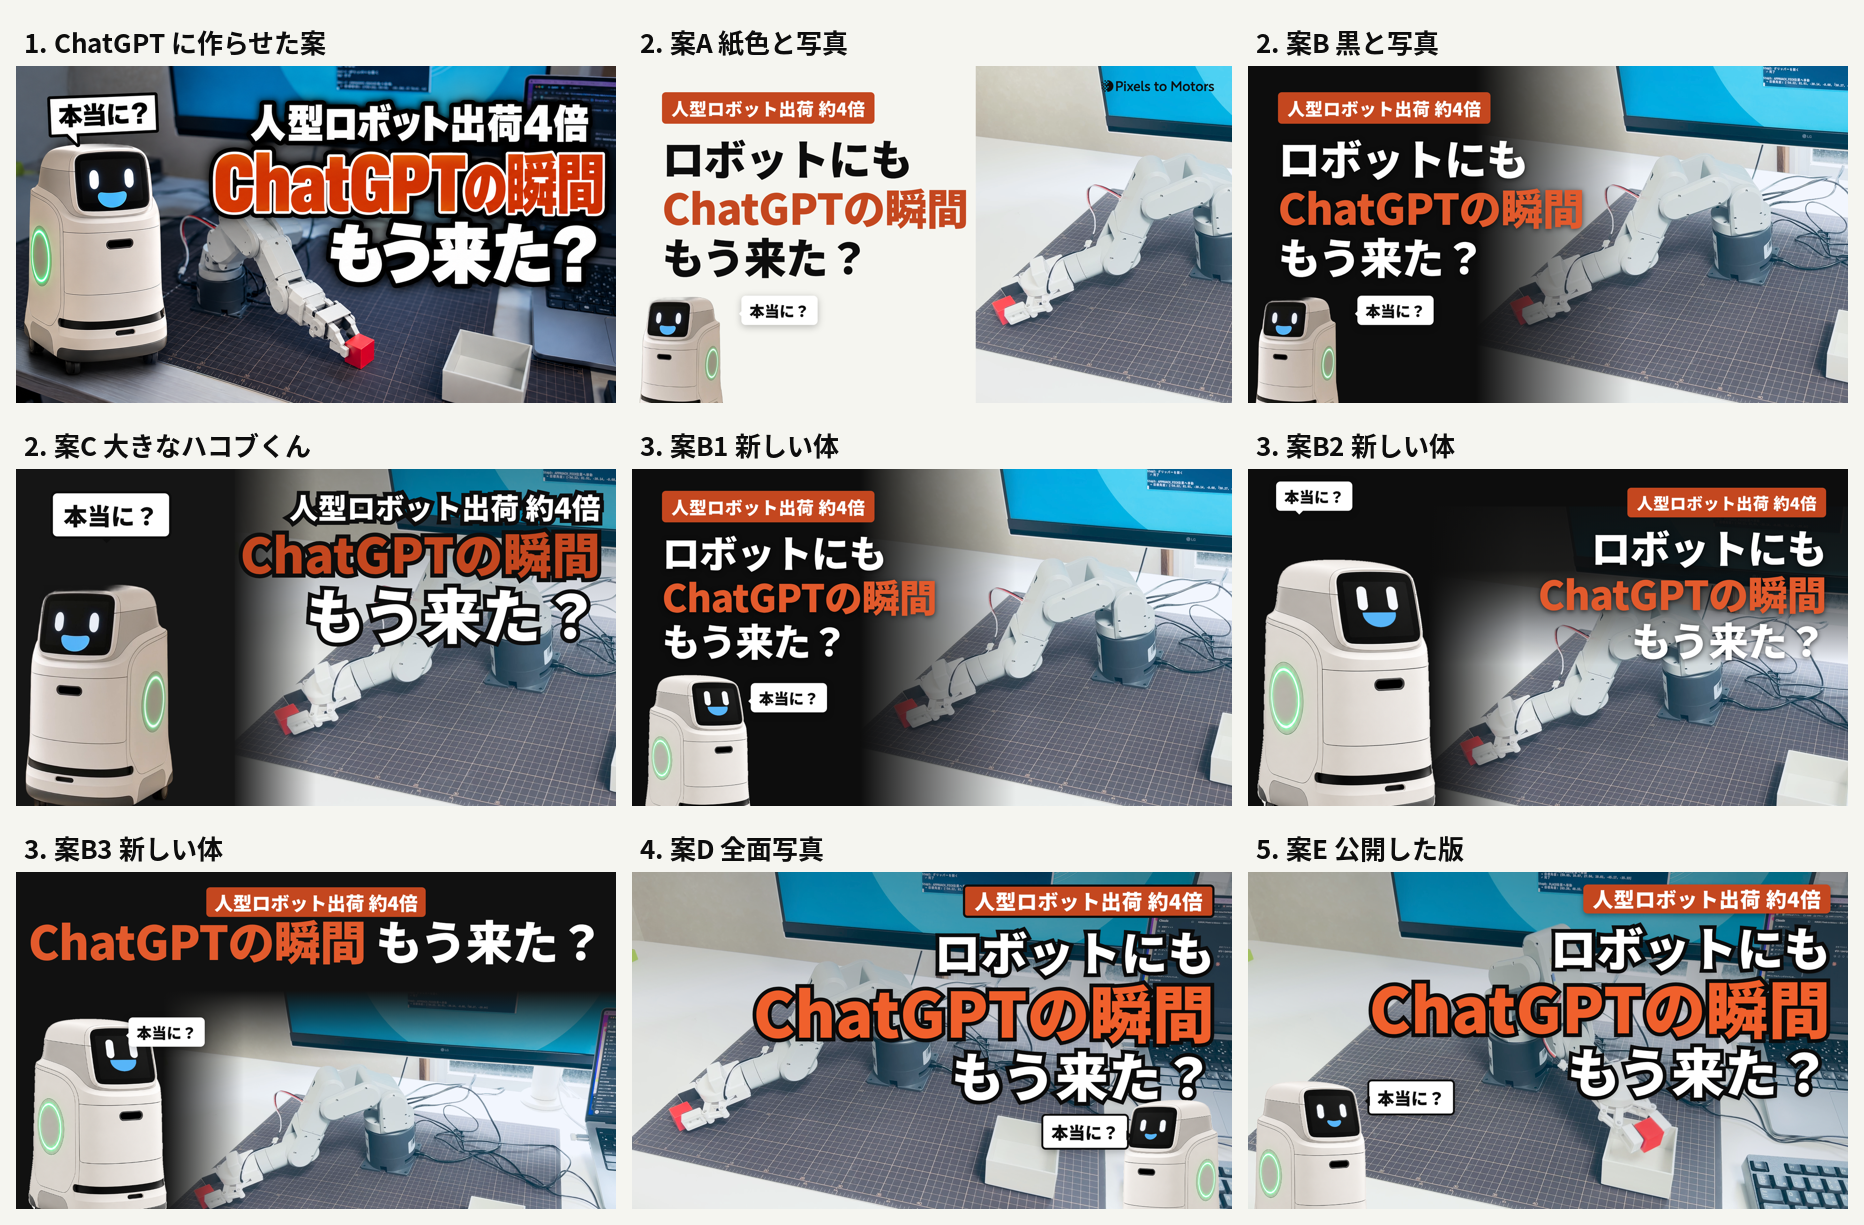
回 | 作ったもの | 指摘 |
|---|---|---|
1 | ChatGPT で作った案 | 文字の形と、背景の写真が違う |
2 | 案A(紙色と写真)・案B(黒と写真)・案C(大きなハコブくん) | 「これがまぁまぁ良さそうだけど。ハコブくんが小さいの修正と右向きがいいね。レイアウト別バージョンを生成」 |
3 | 案Bの別の組み方3つ(B1・B2・B3)。最初は元の体のまま | 「ハコブくんの頭凹んでいるよ!」「最初から作り直したら?」 |
3' | 体を作り直して B1〜B3 を出し直した | 「ハコブくん大きすぎ。ハコブくんの顔が変(口と目の配置や大きさ確認)背景を全部写真に変更。テキストを大きく目立つように。写真の上にテキストを置くので、黒縁をつけること。」 |
4 | 案D(全面写真・黒い縁の大きな文字・ハコブくん右下) | 「ハコブくんは左下済み(大きさ少しだけ大きく)人型ロボット出荷 約4倍の部分は黒縁無し。」 |
5 | 案E(写真のコマを替え、ハコブくん左下) | 公開に使った |
ハコブくんの体は、ChatGPT で無地の背景から作り直した
サムネイルでハコブくんを大きく出すと、頭の上がへこんで見えました。動画で使っている体の画像は、生成動画の1コマから切り抜いたもので、頭の上が背景と見分けにくく、切り抜きが欠けていたためです。動画では小さく出すので目立ちませんでしたが、サムネイルの大きさでは分かりました。
最初から作り直したら?
ChatGPT で、無地の背景・画面は真っ黒・側面の緑の光の輪はそのまま、という条件でハコブくんの体を作り直しました。
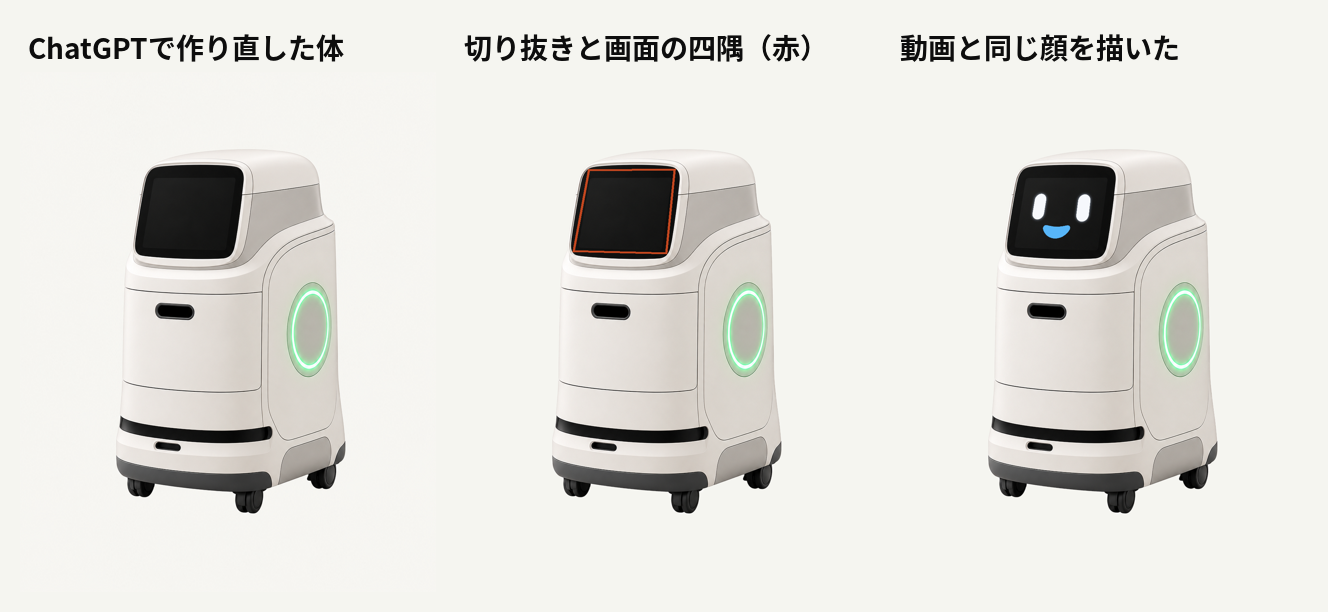
作り直した体は、次の手順でサムネイル用の画像にしました。
切り抜き: OpenCV の GrabCut(指定した四角の中で、前景と背景を色の分布から分ける方法)を、体を囲む四角(GrabCut に渡した値は 230, 170, 680, 1040)で8回くり返して前景を出した。いちばん大きなかたまりだけを残し、中の穴を埋めた。最初に試した、背景の色から塗りつぶす方法は、体の白い部分まで背景として消えた
画面の四隅: 黒い画面の四隅の位置を測った(左上 356,262・右上 592,260・右下 569,491・左下 314,485)
顔: 画面に、白い目と青い口を描いた
向き: 透明でない範囲で切り、左右を反転して右向きにした
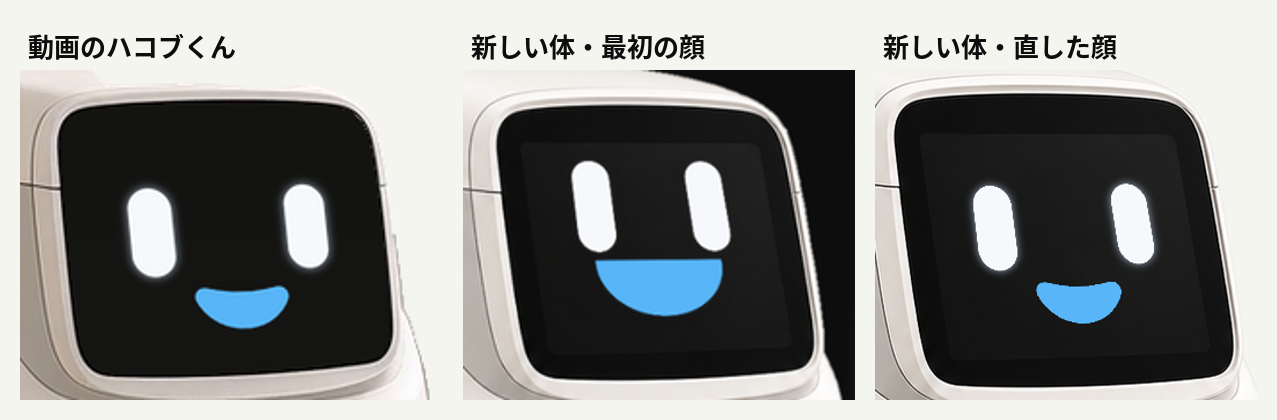
3の顔は、最初、動画のハコブくんを見ながら、目と口の位置と大きさを画面の割合で決めて描きました。目が縦に長く上に寄り、口が画面の半分の幅で大きく開いていて、動画のハコブくんと違う顔になりました。
顔を描き直すとき、目と口を自前で描くのをやめました。動画の hakobu.py が持っている目と口の描き方(eye_mask・mouth_mask)でそのまま描き、動画の体の画面を長方形にならしたものから、新しい体の画面の四隅へ写しています。画面の大きさに対する目と口の大きさと位置が、動画のハコブくんと同じになります。make_new_face.py(全文は後半)がこの処理です。
1の切り抜きと2の四隅の測定は、その場でコマンドとして動かしたため、スクリプトのファイルが残っていません。結果の cut_new.png と screen_quad_new.npy(四隅の値)は _制作ベース/hakobu/ に置いてあり、3と4は make_new_face.py と、そのあとに切り抜きと反転をしたコマンドで作っています。
サムネイルの背景は、ハコブくんがアームに重ならないコマを選んだ
ハコブくんを左下に置くと、最初に使っていた写真(DAY124.mov の28秒、アームが赤いブロックを掴む瞬間)では、ちょうど左下に爪とブロックがあり、ハコブくんで隠れます。写真を拡大したり、ずらしたりしても、爪は左下から出ませんでした。
同じ映像の別のコマを2秒ごとに並べて探し、39.8秒(アームがブロックを箱に置く瞬間)を選びました。このコマは左下がマットだけで、爪とブロックと箱が画面の中央から右下に入ります。
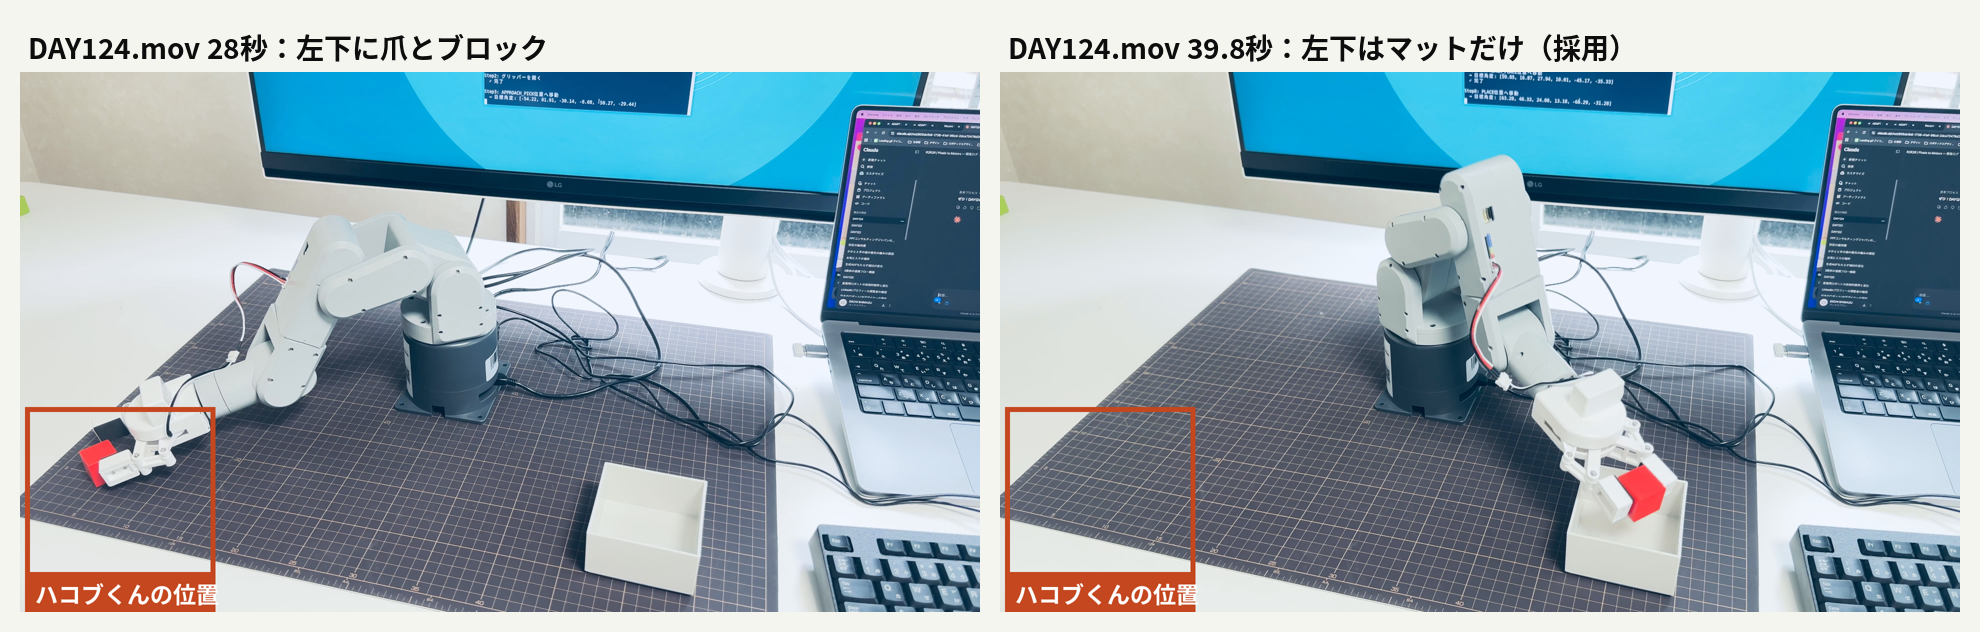
公開したサムネイル(案E)の組み方は、次のとおりです。
背景は写真を全面に敷き、右上だけを少し暗くして文字を読みやすくする
「ロボットにも/ChatGPTの瞬間/もう来た?」は、1920×1080 のとき150・200・170px の大きさで、24px の黒い縁を付ける
上の札「人型ロボット出荷 約4倍」は、オレンジの札に白い文字。黒い縁は付けない
ハコブくんは左下の隅に、高さ600px で右(アーム)を向けて置く。「本当に?」の吹き出しは右側
1920×1080 で作って 1280×720 に縮め、YouTube の上限の2MB 以下にする(公開版は約1MB)
公開した直後に見えた2つのこと:字幕が2重に出る、画質が低い
アップしました!
公開したページを開くと、YouTube の字幕(黒い帯に白い文字)が、動画に焼き込んだ字幕の上に重なって、同じ文が2重に出ていました。
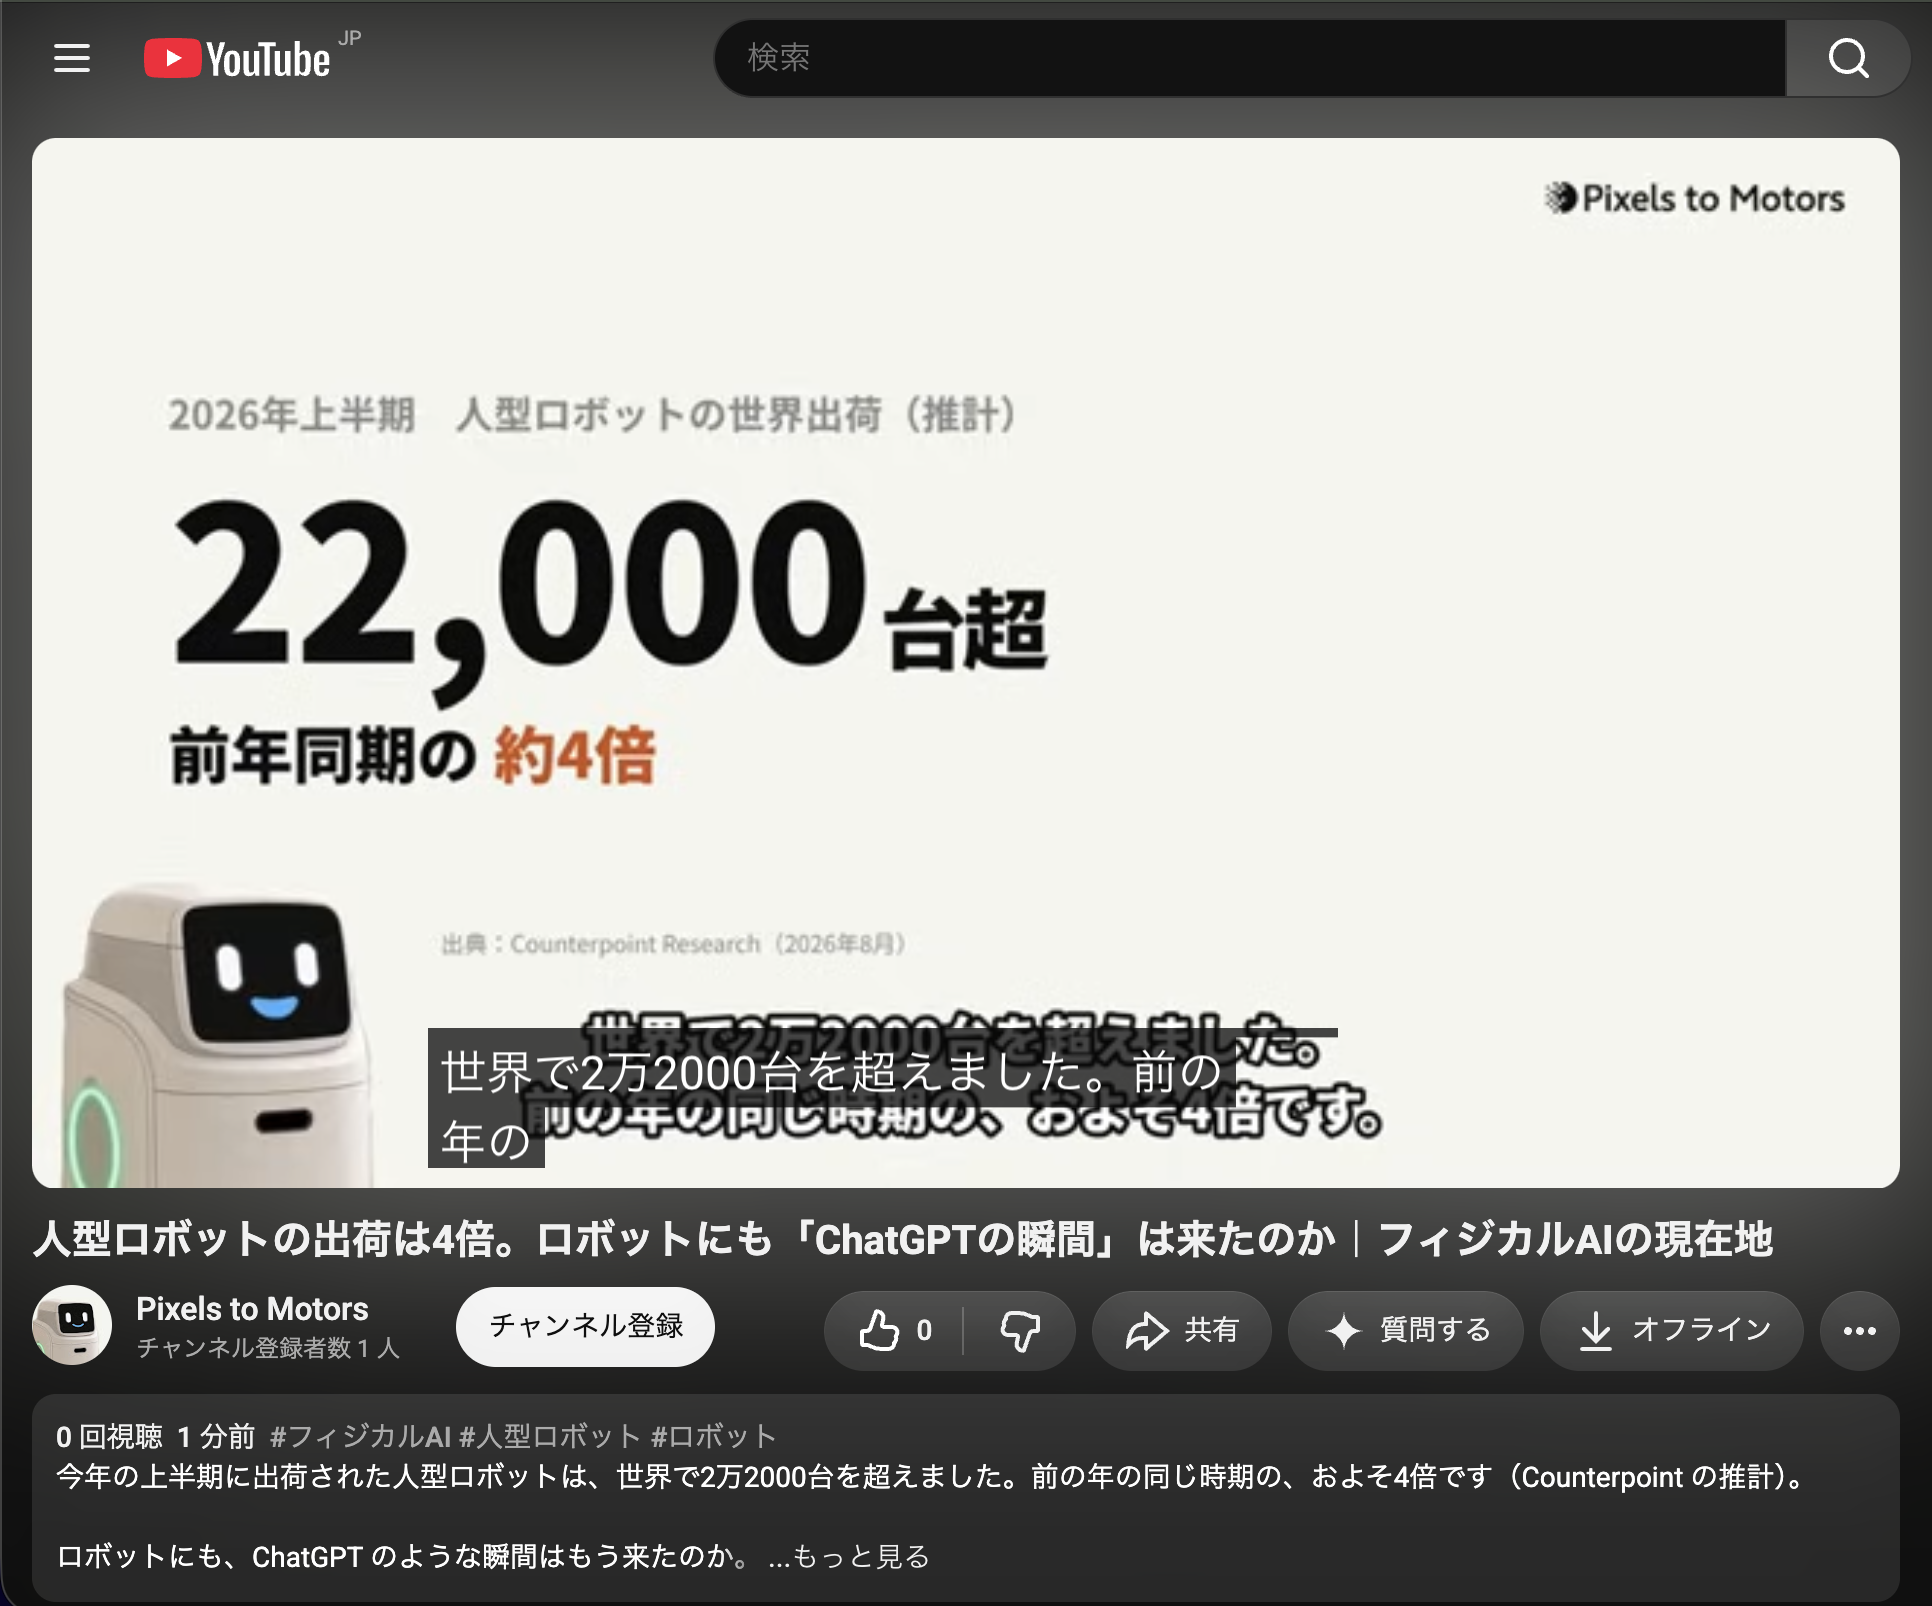
動画には字幕が焼き込んであります。字幕のファイル(srt)を YouTube に字幕として登録していると、視聴者が字幕をオンにしたときに2重になります。登録しておくと検索や、音を出せない人への字幕として役に立つ一方、焼き込んだ字幕と重なります。登録を残すかどうかは、これから決めます。
動画の画質こんなもん?アップしてすぐだから?
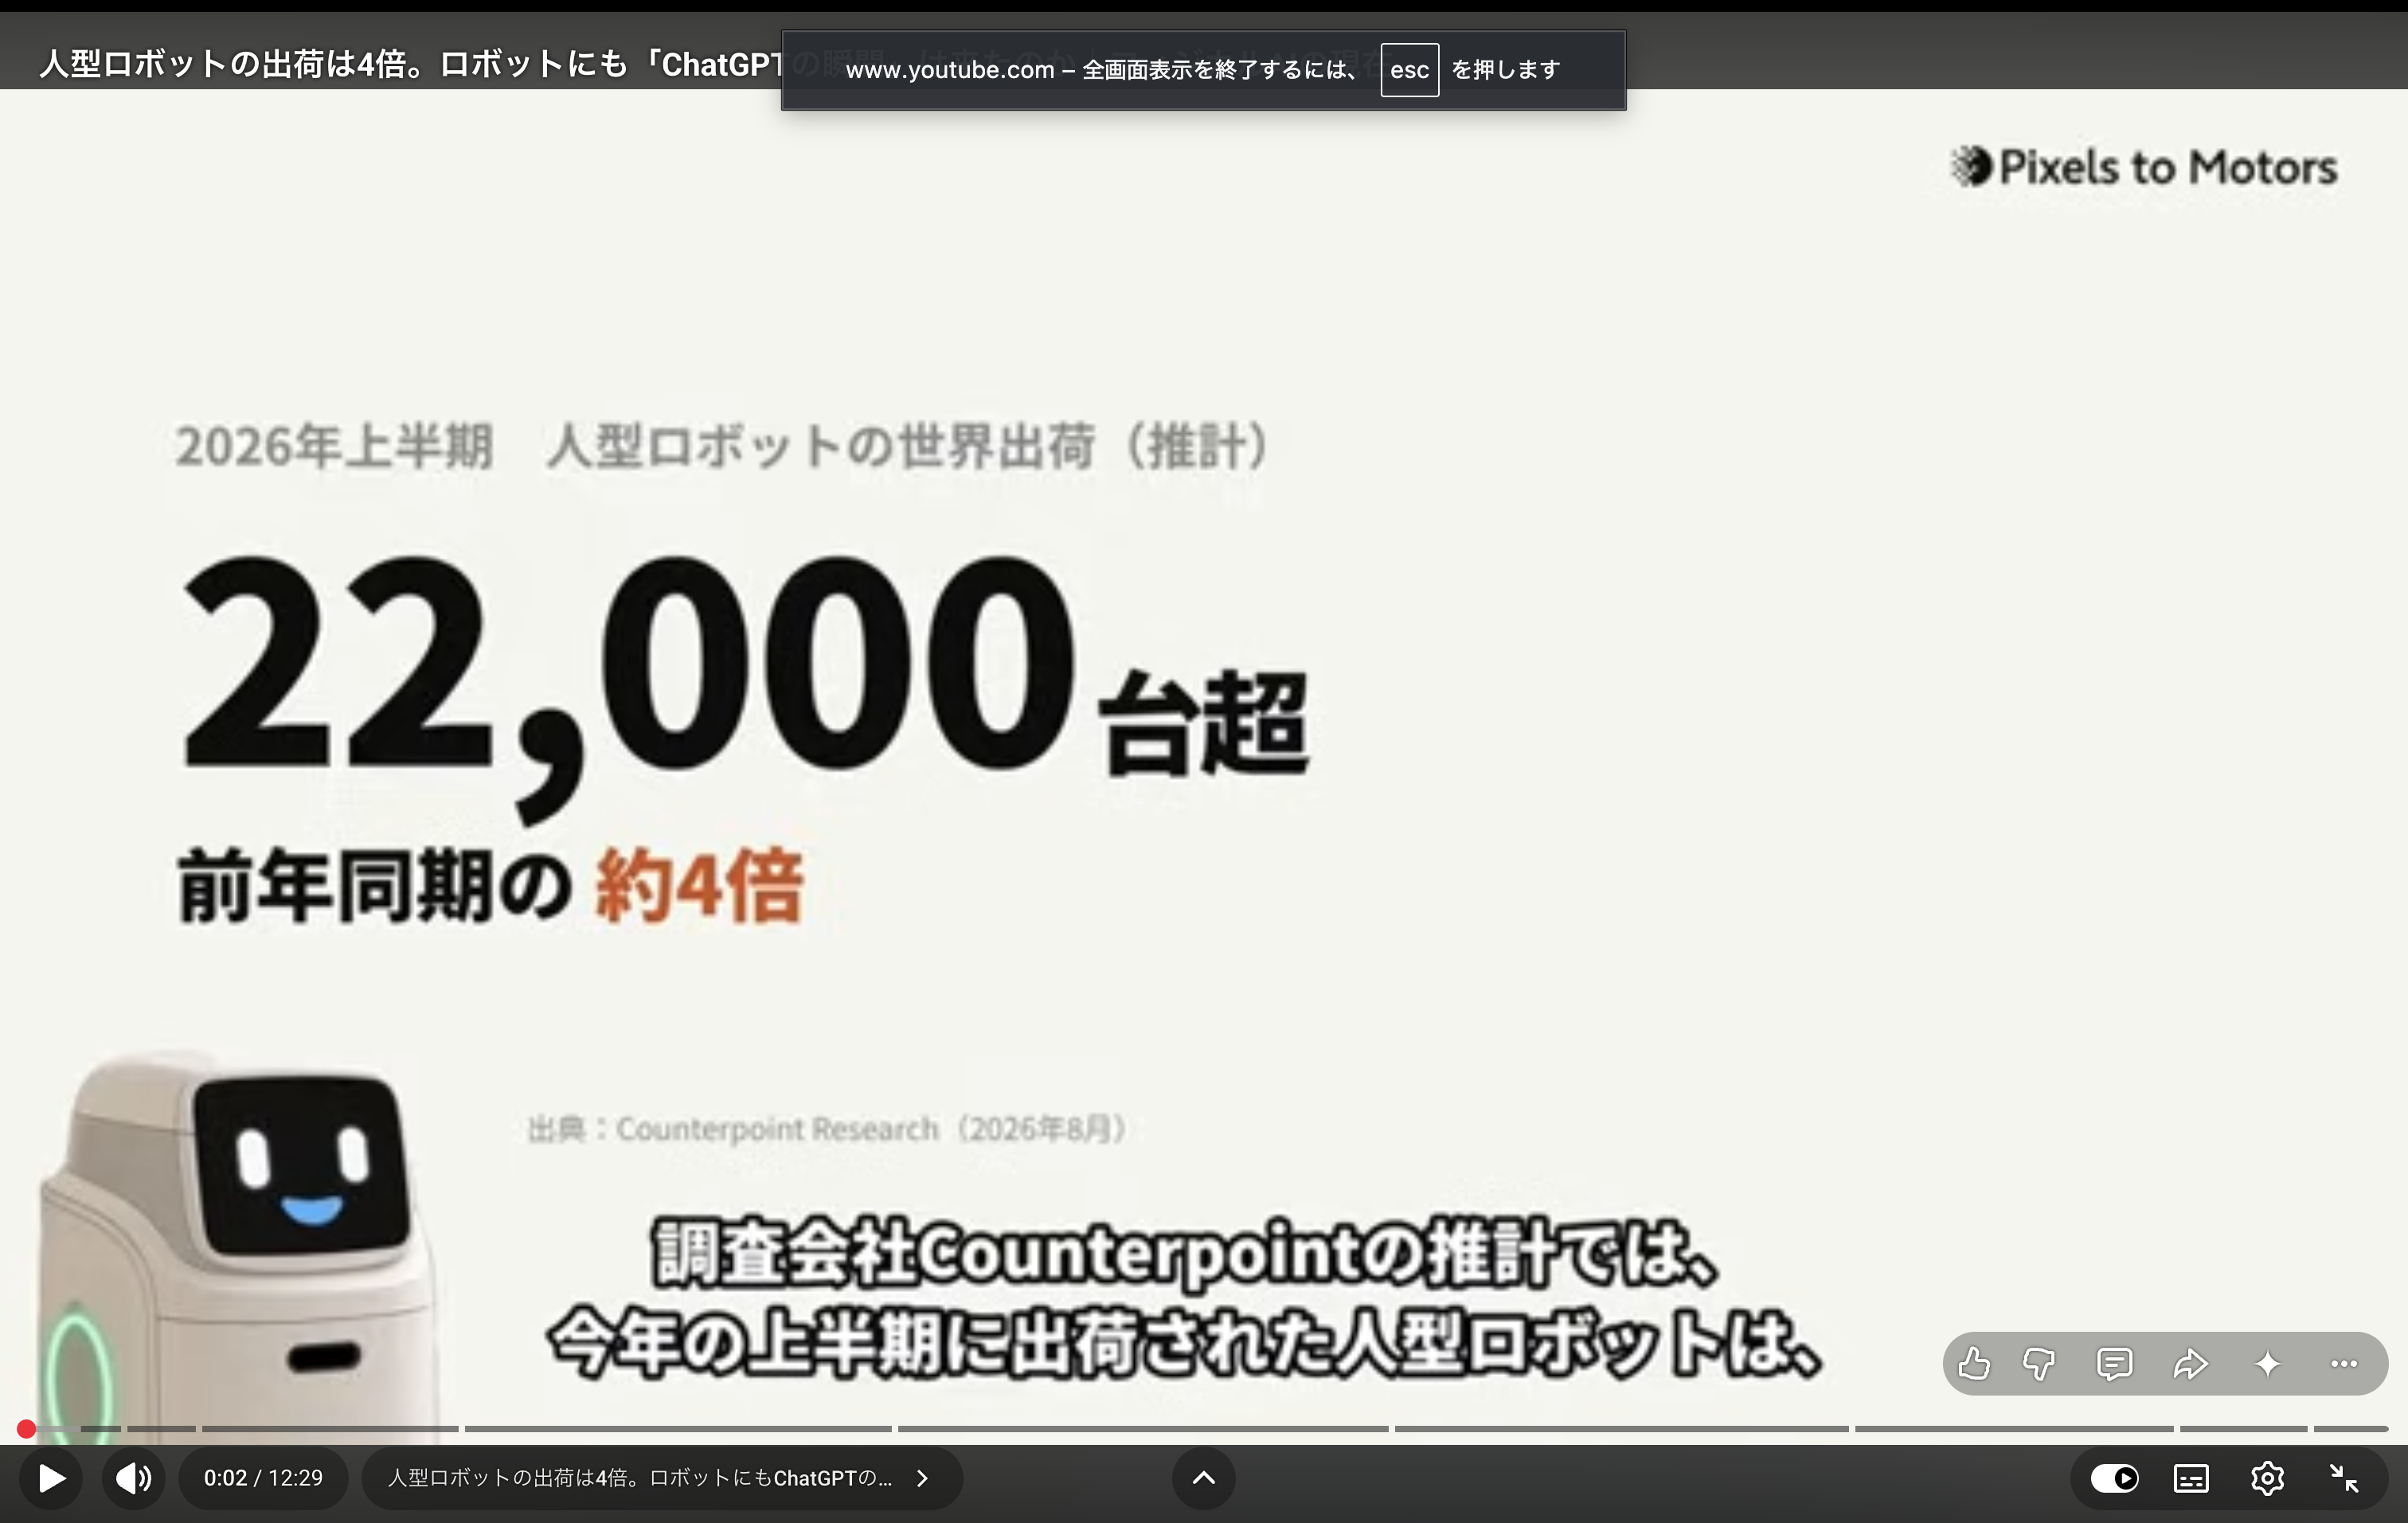
YouTube は、上げた直後は低い画質の版を先に公開し、HD(1080p)の版はあとから作ります。文字のふちがにじんでいたのは、このためと考えています。再生画面の歯車の「画質」に 1080p が出ていれば、HD の版はできています。
一方、上げたファイルの映像は、測ると約0.49Mbps(488,631 ビット/秒)でした。assemble.py は crf 20(画質を一定に保つ設定。数字が小さいほど高画質)で書き出していて、図と無地の背景が多い動画なので、この値でも書き出したファイルの文字はくっきりしています。ただ YouTube は上げたファイルをもう一度圧縮するので、HD の版でも文字が甘く見えるようなら、2560×1440 に拡大して書き出し直す方法を試す候補にしています。YouTube は 1440p 以上の動画には、画質のよい圧縮方式を使うためです。HD の版での見え方は、まだ確かめていません。
チャンネル名は「フィジカルAI解説|Pixels to Motors」、まだ反映されていない
チャンネルの名前なんだっけ?(更新されていない)
チャンネル名は「フィジカルAI解説|Pixels to Motors」に決めています(LOG332)。公開した時点では、YouTube ではまだ「Pixels to Motors」と表示されていました。
何度も修正しすぎて反映されなくなってるかも・
YouTube のチャンネル名は、14日間に2回までしか変えられず、変えた名前が表示されるまでに数日かかることもあります(楽天モバイルの解説記事)。YouTube Studio の「カスタマイズ」→「基本情報」の名前の欄が新しい名前になっていれば、表示が追いつくのを待ちます。古いままで保存できなければ、2回の上限に当たっています。どちらだったかは、この記事の時点で確かめていません。
X と LinkedIn の投稿文は、数字と机の上の実感を先に置いた
Xとlinkdinに投稿するので、投稿内容を考えてください。わかりやすくかつ、興味を持ちやすい投稿内容になるように注意してください。
X は140字(URL を含む)に収めるため、冒頭の数字(約4倍)、動画の問い、机の上のロボットアームで650回以上試した実感(写真で判断させるのは簡単、物を確実に動かすのはまだ手間)の3つだけにしました。X の数え方では、日本語1字が2、URL が23で、280以内に収まれば140字以内です。作った文は266でした。
LinkedIn は英語のあとに日本語を並べ、動画の中の具体的な話(計算ツールとデジタルツインで爪先の位置が30cm以上食い違ったこと、肩の関節に90度ちょっとを超える値を送るとエラーなしで動かないことがあったこと)を入れました。30cm は「アームが30cm外れた」と読まれやすいので、コメント欄への補足で、爪先の位置の決め方が違っていた話だと書き足しています。ハッシュタグは、記事の投稿で使う #R2R2R ではなく、動画の話題で探す人が使う #フィジカルAI・#PhysicalAI にしました。
Claude の返事が英語になり、2回聞き返された
作業の途中で、Claude の返事が英語になったことが2回ありました。
英語で書いてあってわからないよ?
英語だよ?
1回目は、使える音源の候補を調べて返したとき、2回目は、公開したページを見たあとの返事です。どちらも日本語で書き直しました。このプロジェクトの返事は日本語で書くと決まっています。
Mac へ送ったファイルが、途中で変わることがあった
作ったファイルは、Claude の作業環境から、Mac とつながった経路で iCloud と外付けの SSD(KIOXIA)に送っています。この経路で、3つのことが起きました。
起きたこと | どう分かったか | どうしたか |
|---|---|---|
約28MB を超えるファイルが送れない(HTTP 400) | 送る道具がエラーを返した | 10MB ずつに分けて送り、Mac でつないだ |
分けた動画の先頭の1つ、透明な部分のある PNG(ハコブくんの切り抜きなど)が、届いたときに中身が変わっていた | 送る前と届いたあとの指紋(md5。ファイルの中身から作る32桁の値)が違った。PNG は届いた方が大きかった | gzip で圧縮して送り、Mac で戻した。戻したあとの指紋が一致するのを確かめた |
Mac にあるスクリプト(assemble.py・2本の scenes.py)が、古い版に戻っていた | Mac と作業環境のファイルの指紋を比べた | 送り直して、指紋が一致するのを確かめた |
YouTube に上げた動画ファイルは、作業環境の指紋 d9f6def3f1a01d9aee5c76c9d6516bc0 と、Mac でつないだあとの指紋が一致しています。送ったあとは、毎回指紋を比べることにしました。
次の動画から使う「1本を作る流れ」23手順
動画の作り方の手順をまとめてありますか?他の台本を使って動画を量産していきますよ。
作る手順は、動画のルール video_rules.md の中に分かれて書かれていて、サムネイル・アップロード・投稿の手順はどこにもありませんでした。そこで video_rules.md の先頭に「0節 1本を作る流れ」を足し、台本から投稿までを23の手順にまとめました。「フィジカルAIの現在地」で実際に通した順番です。担当の エ は本人、C は Claude です。追記した0節を、ファイルのまま載せます。
### 準備(1本ごとに1回)

1. **エ** どの台本を動画にするか決めて、Claude に伝える
2. **C** iCloud の `動画/` に作業フォルダ `{動画名}/` を作る。前の動画の作業フォルダから `narration.py`・`scenes.py`・`sound.py`・`thumb.py`・`概要欄_下書き.md` を写して、書き換える元にする

### 台本(2節・3節)

3. **C** 台本を `narration.py` に書く。1文ごとに(場面の名前、表情、字幕の文、後ろの間)。自己紹介の2文(2節10)と、間の取り方(2節12)は前の動画と同じにする
4. **C** 読みの直しを書く。`READ`(仮音声用)と `ELEVEN_READ`(ElevenLabs 用)。「エイイチ」は ElevenLabs には「えいいち」で渡す(3-1)
5. **C** `make_docs.py` で読み物の台本と codex の依頼を作る。**エ** 内容を確かめる。数字と出典は、公開前に元のページを開いて確かめる
6. **エ** 台本を確定する(ここで決まった文が、声のお金を使う単位になる)

### 声(3-1)

7. **エ** Mac のターミナルで、作業フォルダに移って声を作る:
   `read -s ELEVENLABS_API_KEY && export ELEVENLABS_API_KEY`(キーを貼って Enter。画面には出ない)
   `python3 ../_制作ベース/tts_eleven.py --voice gWJpc8whMBqnF7Y0kc9f --name ハコブ`
   読み方を比べたい語があるときは `--try "文1|文2"` で試しの音声だけ作る
8. **C** `tts_import.py voice_eleven/ハコブ` で取り込む。読み間違い(例: 裏表が「うらおもてうら」)が見つかったら、`ELEVEN_READ` を直し、**エ** がその文だけ `--lines 番号` で作り直す

### 音(8節の BGM・効果音の行)

9. **C** `sound.py` に BGM と効果音の置き方を書く。いまの決まり: BGM は `bgm_明るいB_2` を最初から最後までループ、話している間 -23dB・間 -16dB。場面の切り替えはホワーン(-6dB)、自己紹介はキラリン、大きな流れの変わり目はポロロン
10. **C** `audio_mix.py --first N` で音だけ書き出し、**エ** が冒頭を聞いて大きさを確かめる

### 図と字幕(4節・5節・6節)

11. **C** `scenes.py` に場面ごとの図を書く。実機映像は `src/` に置き、`VIDEO` に場面名と開始秒を書く。透かし入りの映像は使わない(6節)
12. **C** `render.py` で図・テロップ・字幕を作る。ハコブくんの区画と重なったら止まるので、直して通す
13. **C** `preview.py 文番号…` で、気になる文の画面を静止画で出す。**エ** 確かめる

### 書き出しと確認(7節)

14. **C** `assemble.py` で全体を書き出す(14分で30分ほど)。確認用(30MB 以下)をチャットに送り、KIOXIA の `videos/{動画名}/` にも置く
15. **エ** 通しで見て、直す所を時間つきで伝える(例:「3分16秒の読みがおかしい」「55秒の右下がモヤモヤ」)
16. **C** 直して書き出し直す(中身が変わった文だけ作り直すので、2回目からは速い)。15〜16 を合格まで繰り返す
17. **C** アップロード用(crf 20)を KIOXIA に置く。大きいファイルは分けて送り、Mac でつなぎ、指紋(md5)が一致するのを確かめる

### YouTube に出すもの(7節)

18. **C** `概要欄_下書き.md` を書き、`description.py` で `概要欄.txt` を作る。目次の時間は自動で入る。リンクは開いて確かめてから載せる
19. **C** タイトル案を3つ出す。**エ** 決める
20. **C** `thumb.py` に文言と写真を書き、`thumbnail.py` でサムネイルを作る(8節のサムネイルの行)。写真は、ハコブくんを左下に置いてもアームや物に重ならないコマを実機映像から選ぶ。**エ** 確かめる
21. **エ** YouTube にアップロードする。設定: 子ども向けは「いいえ」。字幕ファイル(srt)は、映像に字幕が入っているので、上げると字幕をオンにした人には2重に出る(上げるかはエイイチが決める)。公開直後は低い画質で再生され、HD(1080p)は数十分〜1時間後に出る

### 公開のあと

22. **C** X と LinkedIn の投稿文を作る(書き方は article_rules.md の SNS 節。X は URL 込み140字・LinkedIn は英語→日本語と、コメント欄への補足)。**エ** 動画の URL を入れて投稿する
23. **C** この動画で決めたこと・直したことを、本ファイルの該当の節と更新履歴に書く。iCloud の `_制作ベース` とプロジェクトの `claude/video_rules.md` の両方に保存する

### 前の動画でつまずいた所(先に気をつける)

- ElevenLabs の API キーには「音声の読み上げ・効果音・音楽生成」の3つの許可が要る(音楽生成がないと BGM が作れない)
- Claude から Mac へ送ったファイルが途中で変わることがある(大きい動画・透明部分のある PNG)。送ったあとは指紋(md5)を比べ、違えば圧縮して送り直す
- Mac 側のファイルが古い版に戻っていたことがある。書き出しの前に、Mac と Claude の作業環境でスクリプトの指紋がそろっているか確かめる
まだ決まっていないこと
項目 | いまの状態 |
|---|---|
ポロロンの使い分け | 大きな流れの変わり目7か所すべてで同じポロロンを鳴らしている。場所ごとに音を変えるかは試し中 |
ジングルとアウトロの文言 | 「Pixels to Motors。案内役のハコブくんです。」とエンディングの文は、毎回同じにするか未定 |
字幕ファイルの登録 | 焼き込んだ字幕と2重になる。登録を残すかは未定 |
HD の版の画質 | 1080p の版での文字の見え方をまだ見ていない。甘ければ 2560×1440 で書き出し直す |
チャンネル名の反映 | 「フィジカルAI解説|Pixels to Motors」が表示されていない。上限に当たったかを確かめる |
動画のハコブくんの体 | 作り直した体は、サムネイルだけで使っている。動画にも使うなら、hakobu.py の画面の四隅・頭の位置・光の輪の位置を測り直し、表情を一覧で確かめる |
1X NEO の配送 | 「配送開始を示す公式発表が見つからない」は 2026年10月12日に確かめた内容。公式発表が出たら、概要欄を直す |
この記事で作った・直したスクリプトの全文
動画ごとの作業フォルダ(動画/フィジカルAIの現在地/)のファイルと、どの動画でも使う部品を置く _制作ベース/ のファイルです。_制作ベース/ のうち、この記事の作業で新しく作ったもの、または直したものを載せています。図とハコブくんの描き方(scene_kit.py・hakobu.py・render.py・subtitle.py)は、LOG331 から変えていないので載せていません。
_制作ベース/timing.py
新規。文ごとの尺(コマ数)と、ナレーションのつなぎ方を決める。assemble.py と audio_mix.py が同じ規則を使うために分けた(51行)。
"""文ごとの尺(フレーム)と、ナレーションの音をつなぐ規則。assemble.py と audio_mix.py が同じものを使う。"""
import json, wave
import numpy as np
from subtitle import pages as sub_pages

FPS, SR = 30, 48000


def load(first=None):
    idx = json.load(open('tts/index.json'))
    return idx[:first] if first else idx


def layout(idx):
    """各文に frames(間を含む尺)・speech(読み上げの長さ)・start(開始フレーム)・parts(字幕の枚の切り替え)を足す。全体のフレーム数を返す"""
    t = 0
    for o in idx:
        o['frames'] = max(1, round((o['dur'] + o['pause']) * FPS))
        o['speech'] = round(o['dur'] * FPS)
        o['start'] = t
        t += o['frames']
        # 「|」で分けた字幕は、読み上げの長さを字数で割って切り替える
        pages = sub_pages(o['text']) if o['text'] else []
        cuts, acc, total = [0], 0, sum(len(p) for p in pages)
        for p in pages[:-1]:
            acc += len(p)
            cuts.append(round(o['speech'] * acc / total))
        cuts.append(o['frames'])
        o['parts'] = [(k, cuts[k], cuts[k + 1]) for k in range(len(pages))] or [(None, 0, o['frames'])]
    return t


def narration(idx):
    """各文の音声を、尺ちょうどに合わせてつないだ int16 モノラル"""
    parts = []
    for o in idx:
        need = o['frames'] * SR // FPS
        if o['text']:
            with wave.open(f"tts/{o['i']:03d}.wav") as w:
                a = np.frombuffer(w.readframes(w.getnframes()), dtype=np.int16)
        else:
            a = np.zeros(0, dtype=np.int16)
        a = a[:need]
        parts.append(np.concatenate([a, np.zeros(need - len(a), dtype=np.int16)]))
    return np.concatenate(parts)


def write_wav(path, a, ch=1):
    """a は int16(モノラルは1次元、ステレオは (n, 2))"""
    with wave.open(path, 'wb') as w:
        w.setnchannels(ch); w.setsampwidth(2); w.setframerate(SR); w.writeframes(np.ascontiguousarray(a).tobytes())
_制作ベース/audio_mix.py
新規。ナレーションに BGM と効果音を混ぜる。話している間は BGM を下げ、0.8秒以上の間で戻す。曲の終わりを切ってループする(173行)。
"""ナレーションに BGM と効果音を混ぜる。音の置き方は、動画の作業フォルダの sound.py に書く。
使い方(動画の作業フォルダで)
  python3 <_制作ベース>/audio_mix.py [--first N]   音だけ先に確かめる → 音の確認.m4a(映像は作らない)
  assemble.py は sound.py があると、これを呼んで mix.wav を使う

sound.py の書き方
  BGM = [dict(file='bgm_仮', start=0, end=None, level=-22, gap=-15, fade_in=0.8, fade_out=2.0, offset=0.0)]
    file     作業フォルダからの相対パス(sound/bgm_main.mp3 など)。見つからなければ <_制作ベース>/sound/{file}.wav
    start    流し始める文の番号。end は止める文の番号(その文は含まない。None は最後まで)
    level    話している間の大きさ。ナレーションより何 dB 小さくするか(-22 なら、ナレーションの約 1/12 の音圧)
    gap      話していない間(0.8 秒以上の間)の大きさ。少し上げて、間が空っぽに聞こえないようにする
    fade_in / fade_out  入りと終わりのフェード(秒)。offset は BGM のどこから流すか(秒)
    曲の終わりの小さくなっていく所は切り、BGM が区間より短いときは 2 秒重ねてループする
  SE = [(文番号, 文の頭から何秒後, 音, ナレーションより何dB)]
    音は file と同じ探し方(se_pop など)。例: (2, 0.0, 'se_pop', -8)
  SCENE_SE = dict(file='se_rise', level=-12, offset=-0.15)
    場面(narration.py の場面の名前)が変わる文ごとに、自動で同じ音を入れる(動画の最初の文は入れない)。
    offset は場面が変わる瞬間から何秒ずらすか(マイナスで少し前から鳴らし、音の山を切り替えに合わせる)
    skip=['場面名', ...] に書いた場面へ切り替わるときは鳴らさない(同じ映像のままテロップだけ替える場面など)
  CHAPTER_SE = dict(file='se_chapter', level=-8, offset=-0.3, scenes=['c1', 'c2', ...])
    scenes に書いた場面(章の始まりなど、大きな流れの変わり目)へ切り替わるときは、SCENE_SE の代わりにこの音を鳴らす
    files={'場面名': '音', ...} を書くと、その場面だけ別の音にする(例: 自己紹介だけキラリン)
"""
import os, subprocess, sys
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, '.')
sys.path.insert(1, HERE)
from timing import FPS, SR, load, layout, narration, write_wav

WIN = int(0.05 * SR)


def find(name):
    for p in (name, os.path.join(HERE, 'sound', name), os.path.join(HERE, 'sound', name + '.wav')):
        if os.path.isfile(p):
            return p
    sys.exit(f'音のファイルが見つかりません: {name}(作業フォルダからの相対パスか、_制作ベース/sound/ の名前で書く)')


def read(path):
    """どの形式でも 48kHz ステレオの float にする"""
    raw = subprocess.run(['ffmpeg', '-v', 'error', '-i', path, '-ac', '2', '-ar', str(SR), '-f', 's16le', '-'],
                         capture_output=True, check=True).stdout
    return np.frombuffer(raw, dtype=np.int16).reshape(-1, 2).astype(np.float32) / 32768.0


def win_rms(a):
    m = a.mean(axis=1) if a.ndim == 2 else a
    n = len(m) // WIN
    if n == 0:
        return np.array([np.sqrt(np.mean(m ** 2)) + 1e-9])
    return np.sqrt((m[:n * WIN].reshape(n, WIN) ** 2).mean(axis=1)) + 1e-9


def db(x):
    return 10 ** (x / 20)


def cut_tail(a):
    """曲の終わりで音が小さくなっていく所(ふつうの大きさより10dB以上小さい所)を切る。ループでつなぐとき、途中で音が消えないようにする"""
    r = win_rms(a)
    loud = np.where(r > np.median(r[r > 1e-3]) * db(-10))[0]
    if len(loud) == 0:
        return a
    return a[:min(len(a), (loud[-1] + 1) * WIN)]


def loop_to(a, n, xf=SR):
    """a を n サンプルまでループで伸ばす(つなぎ目は xf サンプル重ねる)"""
    if len(a) >= n:
        return a[:n]
    xf = min(xf, len(a) // 4)
    out = a.copy()
    ramp = np.linspace(0, 1, xf)[:, None]
    while len(out) < n:
        head = out[:-xf]
        cross = out[-xf:] * (1 - ramp) + a[:xf] * ramp
        out = np.concatenate([head, cross, a[xf:]])
    return out[:n]


def smooth(x, sec):
    k = max(1, int(sec * 100))
    return np.convolve(np.pad(x, (k, k), mode='edge'), np.ones(k) / k, mode='same')[k:-k]


def mix(idx, pcm, out='mix.wav'):
    ns = {}
    exec(open('sound.py', encoding='utf-8').read(), ns)
    BGM, SE = ns.get('BGM', []), list(ns.get('SE', []))
    sc = ns.get('SCENE_SE')
    ch = ns.get('CHAPTER_SE') or {}
    if sc or ch:
        for prev, o in zip(idx, idx[1:]):
            if o['scene'] == prev['scene']:
                continue
            if o['scene'] in ch.get('scenes', []):   # 大きな流れの変わり目は、別の音にする
                f = ch.get('files', {}).get(o['scene'], ch['file'])   # 場面ごとに音を替えられる(files={'title': 'se_chapter_glock'})
                SE.append((o['i'], ch.get('offset', -0.3), f, ch.get('level', -8)))
            elif sc and o['scene'] not in sc.get('skip', []):
                SE.append((o['i'], sc.get('offset', -0.15), sc['file'], sc.get('level', -12)))
    voice = pcm.astype(np.float32) / 32768.0
    n = len(voice)
    ref = np.percentile(win_rms(voice), 90)          # ナレーションの「ふつうに話している」大きさ
    total = n / SR
    by_i = {o['i']: o for o in idx}

    # 話している所(各文の読み上げ)を、前0.15秒・後0.3秒広げる。0.8 秒未満の間は話している扱いのまま(BGM が細かく上下しない)
    ctl = np.zeros(int(total * 100) + 1)
    for o in idx:
        if o['text']:
            a = max(0, int((o['start'] / FPS - 0.15) * 100)); b = int(((o['start'] + o['speech']) / FPS + 0.3) * 100)
            ctl[a:b] = 1
    gaps = np.where(np.diff(np.concatenate([[1], ctl, [1]])) != 0)[0].reshape(-1, 2)
    for a, b in gaps:
        if (b - a) < 50:   # 0.5 秒(広げた後)= もとの間で約 0.8〜0.95 秒未満
            ctl[a:b] = 1
    ctl = smooth(ctl, 0.3)

    bus = np.zeros((n, 2), dtype=np.float32)
    for m in BGM:
        src = read(find(m['file']))
        src = src[int(m.get('offset', 0) * SR):]
        g = ref / np.median(win_rms(src)[win_rms(src) > 1e-3])
        src = cut_tail(src)
        s0 = by_i[m.get('start', 0)]['start'] * SR // FPS if m.get('start', 0) in by_i else 0
        e = m.get('end')
        e0 = by_i[e]['start'] * SR // FPS if e is not None and e in by_i else n
        seg = loop_to(src, e0 - s0, xf=2 * SR) * g
        # 話している間は level、間は gap(控えめに 100 Hz で決めてから、サンプルに伸ばす)
        t = (np.arange(s0, e0) / SR * 100).astype(int).clip(0, len(ctl) - 1)
        lv = db(m.get('level', -22)) * ctl[t] + db(m.get('gap', -15)) * (1 - ctl[t])
        fi, fo = int(m.get('fade_in', 0.8) * SR), int(m.get('fade_out', 2.0) * SR)
        fade = np.ones(e0 - s0, dtype=np.float32)
        if fi:
            fade[:fi] = np.linspace(0, 1, min(fi, len(fade)))[:len(fade[:fi])]
        if fo:
            fade[-fo:] = np.minimum(fade[-fo:], np.linspace(1, 0, min(fo, len(fade))))
        bus[s0:e0] += seg * (lv * fade)[:, None]

    log = []
    for line, off, name, level in SE:
        if line not in by_i:
            continue
        src = read(find(name))
        g = ref / win_rms(src).max() * db(level)
        s0 = max(0, int((by_i[line]['start'] / FPS + off) * SR))
        k = min(len(src), n - s0)
        if k > 0:
            bus[s0:s0 + k] += src[:k] * g
            log.append(f"  {s0 / SR:6.2f}秒  文{line:03d}  {name}  {level}dB  「{by_i[line]['text'][:16]}」")

    out_a = voice[:, None] + bus
    peak = np.abs(out_a).max()
    if peak > 0.98:
        out_a *= 0.98 / peak   # 割れないように全体を下げる(最後の loudnorm で大きさはそろう)
    write_wav(out, (out_a * 32767).astype(np.int16), ch=2)
    print(f'BGM {len(BGM)}本・効果音 {len(log)}個 → {out}')
    print('\n'.join(log))
    return out


if __name__ == '__main__':
    args = sys.argv[1:]
    first = int(args[args.index('--first') + 1]) if '--first' in args else None
    idx = load(first)
    layout(idx)
    pcm = narration(idx)
    f = mix(idx, pcm)
    subprocess.run(['ffmpeg', '-v', 'error', '-y', '-i', f, '-af', 'loudnorm=I=-16:TP=-1.5:LRA=11',
                    '-c:a', 'aac', '-b:a', '160k', '-ar', '48000', '音の確認.m4a'], check=True)
    print('音の確認.m4a')
_制作ベース/assemble.py
直した。sound.py があれば audio_mix.py を呼ぶ。字幕の後ろの帯をやめた。映像の指定を背景の指紋に入れた。前の場面の映像の続きから流す指定(開始秒 None)を足した(144行)。
"""1文ずつ背景の映像を作ってつなぎ、ハコブくんを重ねて、音声と合わせる。
使い方: 動画の作業フォルダで(render.py のあと)
    python3 <_制作ベース>/assemble.py [--first N] [--force] [--name 動画名]
      --first N  最初の N 文だけ書き出す(確かめ用)
      --force    背景の映像を作り直す(ふだんは、できているものは使い回す)
音: 作業フォルダに sound.py があれば、BGM・効果音を混ぜる(audio_mix.py。音だけ先に確かめるときは audio_mix.py を単独で動かす)
出力: out.mp4(作業用・crf 20・-16 LUFS)、out_確認用.mp4(crf 29・30MB以下)、out.srt、timeline.json
"""
import json, subprocess, os, sys, wave, hashlib
import numpy as np
from concurrent.futures import ThreadPoolExecutor
from PIL import Image
HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, '.')
sys.path.insert(1, HERE)
os.environ.setdefault("P2M_BASE", HERE)
from scenes import VIDEO
from hakobu import Hakobu
from subtitle import pages as sub_pages
from timing import FPS, SR, load, layout, narration, write_wav

args = sys.argv[1:]
first = int(args[args.index('--first') + 1]) if '--first' in args else None
force = '--force' in args
idx = load(first)
os.makedirs('chunks', exist_ok=True); os.makedirs('comp', exist_ok=True)
hk = Hakobu()

# ---------- 尺(フレーム単位)と字幕の枚(timing.py。audio_mix.py と同じ規則) ----------
total_frames = layout(idx)

# 実機の映像の場面: 同じ場面が続く間は、続きから再生する。開始秒が None の場面は、前の場面の映像の続きから再生する
# (同じ映像のまま、テロップだけ替えたいとき。2026-10-12)
prev, off = None, 0.0
for o in idx:
    sc = o['scene']
    if sc in VIDEO:
        if sc != prev and VIDEO[sc][1] is not None:
            off = VIDEO[sc][1]
        o['voff'] = off
        off += o['frames'] / FPS
    prev = sc

# 背景(字幕まで入れて、ハコブくんは入れない)。最後に1回だけ圧縮し直すので、ここは画質を高めに保つ
ENC = ['-c:v', 'libx264', '-preset', 'ultrafast', '-crf', '12', '-pix_fmt', 'yuv420p', '-r', str(FPS), '-an']
jobs = []
for o in idx:
    for k, a, b in o['parts']:
        jobs.append((o, k, a, b))


def job(j):
    o, k, a, b = j
    tag = f"{o['i']:03d}" + (f"_{k}" if k is not None else "")
    # 中身(場面・字幕・尺・映像の位置・図と字幕の画像)が変わったら作り直すよう、ファイル名に指紋を入れる
    sub_png = f"png/sub/{o['i']:03d}_{k}.png" if k is not None else ""
    fp = [o['scene'], o['text'], a, b, round(o.get('voff', 0), 3), VIDEO.get(o['scene'])]   # 映像のファイルや透かしの設定が変わっても作り直す
    for f in (f"png/scene/{o['scene']}.png", f"png/ovl/{o['scene']}.png", sub_png):
        if f and os.path.exists(f):
            fp.append(hashlib.md5(open(f, 'rb').read()).hexdigest())
    out = f"chunks/{tag}_{hashlib.md5(repr(fp).encode()).hexdigest()[:8]}.mp4"
    if os.path.exists(out) and not force:
        return out
    sub = f"png/sub/{o['i']:03d}_{k}.png" if k is not None else None
    sc, n = o['scene'], str(b - a)
    if sc in VIDEO:
        src, _, wm = VIDEO[sc]
        dl = 'delogo=x=2740:y=1840:w=1010:h=220,' if wm else ''
        ins = ['-ss', f"{o['voff'] + a / FPS:.3f}", '-stream_loop', '-1', '-i', src, '-loop', '1', '-i', f'png/ovl/{sc}.png']
        fc = (f"[0:v]{dl}scale=1920:1080:force_original_aspect_ratio=increase,crop=1920:1080,fps={FPS},setsar=1[b];"   # 字幕の後ろの黒い帯は敷かない(2026-10-12 エイイチの指示)
              f"[b][1:v]overlay[c]")
        if sub:
            ins += ['-loop', '1', '-i', sub]
            fc += ";[c][2:v]overlay[v]"
        else:
            fc += ";[c]null[v]"
        cmd = ['ffmpeg', '-v', 'error', '-y'] + ins + ['-filter_complex', fc, '-map', '[v]', '-frames:v', n] + ENC + [out]
    else:
        comp = f"comp/{tag}.png"
        im = Image.open(f'png/scene/{sc}.png').convert('RGBA')
        if sub:
            im.alpha_composite(Image.open(sub).convert('RGBA'))
        im.convert('RGB').save(comp)
        cmd = ['ffmpeg', '-v', 'error', '-y', '-loop', '1', '-framerate', str(FPS), '-i', comp, '-frames:v', n,
               '-tune', 'stillimage'] + ENC + [out]
    subprocess.run(cmd, check=True)
    return out


with ThreadPoolExecutor(max(1, min(3, os.cpu_count() or 1))) as ex:
    outs = list(ex.map(job, jobs))
open('chunks/list.txt', 'w').write(''.join(f"file '{os.path.basename(x)}'\n" for x in outs))
subprocess.run(['ffmpeg', '-v', 'error', '-y', '-f', 'concat', '-safe', '0', '-i', 'chunks/list.txt', '-c', 'copy', 'bg.mp4'], check=True)

# ---------- 音声: 各文を尺ちょうどに合わせて連結。sound.py があれば BGM・効果音を混ぜる(audio_mix.py) ----------
pcm = narration(idx)
write_wav('narration.wav', pcm)
audio_in = 'narration.wav'
if os.path.exists('sound.py'):
    from audio_mix import mix
    audio_in = mix(idx, pcm)   # mix.wav(ステレオ)。ハコブくんの口はナレーションだけで動かす

# ---------- 字幕 SRT(「|」で分けた枚は別の行にする) ----------
def ts(f):
    ms = round(f / FPS * 1000); h, ms = divmod(ms, 3600000); m, ms = divmod(ms, 60000); s, ms = divmod(ms, 1000)
    return f"{h:02d}:{m:02d}:{s:02d},{ms:03d}"
srt, k = [], 1
for o in idx:
    if not o['text']:
        continue
    pages = sub_pages(o['text'])
    for (pk, a, b), ptxt in zip(o['parts'], pages):
        end = min(b, o['speech']) if pk == len(pages) - 1 else b
        srt.append(f"{k}\n{ts(o['start'] + a)} --> {ts(o['start'] + end)}\n{ptxt}\n"); k += 1
open('out.srt', 'w', encoding='utf-8').write('\n'.join(srt))
json.dump(idx, open('timeline.json', 'w'), ensure_ascii=False)

# ---------- ハコブくん: 表情と口・目・リングの動きを決めて、背景に重ねる ----------
timeline = [(o['start'], o['start'] + o['frames'], o['start'] + o['speech'], o.get('face', 'base'), bool(o['text'])) for o in idx]
params = hk.animate(timeline, pcm.astype(np.float32) / 32768.0)
cmd = ['ffmpeg', '-v', 'error', '-y', '-i', 'bg.mp4',
       '-f', 'rawvideo', '-pix_fmt', 'rgba', '-s', f'{hk.w}x{hk.h}', '-r', str(FPS), '-i', '-',
       '-i', audio_in,
       '-filter_complex', f'[0:v][1:v]overlay=x={hk.x}:y={hk.y}:eof_action=pass[v]',
       '-map', '[v]', '-map', '2:a', '-c:v', 'libx264', '-preset', 'medium', '-crf', '20', '-pix_fmt', 'yuv420p',
       '-af', 'loudnorm=I=-16:TP=-1.5:LRA=11', '-c:a', 'aac', '-b:a', '192k', '-ar', '48000',
       '-movflags', '+faststart', '-frames:v', str(total_frames), 'out.mp4']
p = subprocess.Popen(cmd, stdin=subprocess.PIPE)
for i in range(total_frames):
    p.stdin.write(hk.frame(params[i]).tobytes())
p.stdin.close()
if p.wait():
    sys.exit('ハコブくんを重ねる書き出しに失敗しました')
still = round(total_frames * 0.42)
subprocess.run(['ffmpeg', '-v', 'error', '-y', '-ss', f'{still / FPS:.2f}', '-i', 'out.mp4', '-frames:v', '1', 'out_still.png'], check=True)

# ---------- 確認用(チャットで送る方): crf 29・音声 112kbps・30MB 以下 ----------
for crf in (29, 32, 35):
    subprocess.run(['ffmpeg', '-v', 'error', '-y', '-i', 'out.mp4', '-c:v', 'libx264', '-preset', 'medium', '-crf', str(crf),
                    '-c:a', 'aac', '-b:a', '112k', '-movflags', '+faststart', 'out_確認用.mp4'], check=True)
    mb = os.path.getsize('out_確認用.mp4') / 1e6
    if mb <= 30:
        break
print(f'frames {total_frames} = {total_frames / FPS:.1f}s  確認用 {mb:.1f}MB (crf {crf})')
_制作ベース/preview.py
直した。字幕の後ろの帯をやめ、前の場面の映像の続き(開始秒 None)を、書き出しの記録から読むようにした(54行)。
"""確かめ用の静止画。動画を書き出さずに、指定した文の画面(図または実機映像の1コマ+字幕+ハコブくん)を1枚ずつ出す。
使い方: 動画の作業フォルダで(render.py のあと)  python3 <_制作ベース>/preview.py 8 9 12
出力: preview/{文番号}_{字幕の枚}.png と、並べた preview/一覧.png
"""
import json, os, sys, subprocess
from PIL import Image
HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, '.')
sys.path.insert(1, HERE)
os.environ.setdefault("P2M_BASE", HERE)
from scenes import VIDEO
from hakobu import Hakobu, EXPR
from subtitle import pages

idx = {o['i']: o for o in json.load(open('tts/index.json'))}
nums = [int(x) for x in sys.argv[1:]] or [0]
os.makedirs('preview', exist_ok=True)
hk = Hakobu()
outs = []
for i in nums:
    o = idx[i]
    sc = o['scene']
    if sc in VIDEO:
        src, start, wm = VIDEO[sc]
        start = o.get('voff', start) if start is None else start   # 続きから再生する場面は、書き出しのときの位置(timeline.json)を使う
        if start is None:
            tl = {t['i']: t for t in json.load(open('timeline.json'))} if os.path.exists('timeline.json') else {}
            start = tl.get(i, {}).get('voff', 0.0)
        tmp = f'preview/_v{i}.png'
        subprocess.run(['ffmpeg', '-v', 'error', '-y', '-ss', f'{start:.2f}', '-i', src, '-frames:v', '1',
                        '-vf', ('delogo=x=2740:y=1840:w=1010:h=220,' if wm else '') + 'scale=1920:1080:force_original_aspect_ratio=increase,crop=1920:1080', tmp], check=True)
        bg = Image.open(tmp).convert('RGBA')
        bg.alpha_composite(Image.open(f'png/ovl/{sc}.png').convert('RGBA'))
    else:
        bg = Image.open(f'png/scene/{sc}.png').convert('RGBA')
    ex = EXPR[o.get('face', 'base')]
    face = hk.frame((ex['eyes'], ex['brows'], 'mid', 0.4, 0.0))
    n = len(pages(o['text'])) if o['text'] else 1
    for k in range(n):
        im = bg.copy()
        sub = f'png/sub/{i:03d}_{k}.png'
        if os.path.exists(sub):
            im.alpha_composite(Image.open(sub).convert('RGBA'))
        im.alpha_composite(face, (hk.x, hk.y))
        path = f'preview/{i:03d}_{k}.png'
        im.convert('RGB').save(path)
        outs.append(path)
cols = 2
w, h = 960, 540
sheet = Image.new('RGB', (w * cols, h * ((len(outs) + cols - 1) // cols)), 'white')
for k, p in enumerate(outs):
    sheet.paste(Image.open(p).resize((w, h)), ((k % cols) * w, (k // cols) * h))
sheet.save('preview/一覧.png')
print('\n'.join(outs))
_制作ベース/sound_synth.py
新規。効果音(ホワーン・キラリン・ポロロンなど)と、仮の BGM をコードで作る(386行)。
"""効果音と仮のBGMを、コードで作る(音源サイトに頼らない。だれでも同じ音を作り直せる)。
使い方: python3 <_制作ベース>/sound_synth.py   → <_制作ベース>/sound/ に wav を書く(warm を付けると温かみの BGM、bgm3 を付けると BGM の候補3種を作る)
  se_pop.wav    ぽん(図・数字が出る。いちばんよく使う)
  se_tick.wav   こつ(小さな切り替え。字幕の枚が変わる・箇条書きが1つ出る)
  se_whoosh.wav しゅっ(章や場面が大きく変わる)
  se_ding.wav   ちん(結論・大事な数字)
  se_rise.wav   ひゅい(驚き・問いかけ)。エイイチは「ホワーン」と呼ぶ。場面の切り替えに使う
  se_chapter.wav ポロン(章の始まりなど、大きな流れの変わり目。2026-10-12 追加)
  se_chapter_marimba.wav ポロロン(マリンバの上がる3音)。se_chapter の候補
  se_chapter_harp.wav    シャララン(ハープ風に弦をはじいて上がる)。se_chapter の候補
  se_chapter_piano.wav   ポーン(やわらかいピアノの和音を1つ)。se_chapter の候補
  se_chapter_glock.wav   キラリン(鉄琴の高い3音)。se_chapter の候補
  se_chapter_swell.wav   フワァ(弦の和音がふくらんで消える)。se_chapter の候補
  se_chapter_wind.wav    シャラン(ウィンドチャイム)。se_chapter の候補
  bgm_仮.wav    仮のBGM(電子音。32秒で切れ目なくループ)
  bgm_仮_温かみ.wav  仮のBGM(はじく弦・やわらかいピアノ・弦の和音・ウッドベース風。2026-10-12 エイイチの「もう少し温かみ」の指示で追加)
                ElevenLabs Music などの本番のBGMができるまでの、方向を確かめる用
  bgm_1_ピアノ / bgm_2_ギターとマリンバ / bgm_3_ピッツィカート   BGM の候補3種(2026-10-12)
音の高さは、ナレーション(男声・おおむね100〜300Hz)とぶつからないよう、効果音は 500Hz より上を中心にしている。
"""
import os, sys
import numpy as np
from timing import SR, write_wav

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, 'sound')
rng = np.random.default_rng(7)


def t_(dur):
    return np.arange(int(dur * SR)) / SR


def env(n, attack=0.004, decay=0.15):
    t = np.arange(n) / SR
    return np.minimum(1, t / attack) * np.exp(-t / decay)


def norm(a, peak=0.9):
    return a / (np.abs(a).max() + 1e-9) * peak


def lowpass(a, cutoff):
    """1次のローパス(やわらかくするだけ)"""
    k = np.exp(-2 * np.pi * cutoff / SR)
    out = np.empty_like(a); y = 0.0
    for i, x in enumerate(a):
        y = (1 - k) * x + k * y; out[i] = y
    return out


def pop():
    t = t_(0.12)
    f = 520 + 520 * np.exp(-t / 0.018)            # 高い所から素早く下がる
    a = np.sin(2 * np.pi * np.cumsum(f) / SR) * env(len(t), 0.002, 0.035)
    a += 0.25 * np.sin(2 * np.pi * 2 * np.cumsum(f) / SR) * env(len(t), 0.001, 0.015)
    return norm(a)


def tick():
    t = t_(0.05)
    a = np.sin(2 * np.pi * 1800 * t) * env(len(t), 0.0008, 0.008)
    a += 0.4 * lowpass(rng.standard_normal(len(t)), 4000) * env(len(t), 0.0005, 0.004)
    return norm(a, 0.7)


def whoosh():
    d = 0.55; t = t_(d); n = len(t)
    noise = rng.standard_normal(n)
    # 帯域を低→高へ動かす(2つのローパスの差で帯域を作る)
    out = np.empty(n); y1 = y2 = 0.0
    for i in range(n):
        p = i / n
        c1 = 300 + 3200 * p ** 1.5; c2 = c1 * 0.35
        k1 = np.exp(-2 * np.pi * c1 / SR); k2 = np.exp(-2 * np.pi * c2 / SR)
        y1 = (1 - k1) * noise[i] + k1 * y1; y2 = (1 - k2) * noise[i] + k2 * y2
        out[i] = y1 - y2
    shape = np.sin(np.pi * np.minimum(1, t / d)) ** 2 * (t / d) ** 0.4
    return norm(out * shape, 0.8)


def ding():
    t = t_(1.2)
    f0 = 1046.5   # C6
    a = (np.sin(2 * np.pi * f0 * t) * np.exp(-t / 0.45)
         + 0.35 * np.sin(2 * np.pi * f0 * 2.0 * t) * np.exp(-t / 0.2)
         + 0.12 * np.sin(2 * np.pi * f0 * 3.0 * t) * np.exp(-t / 0.08))
    a *= np.minimum(1, t / 0.003)
    return norm(a, 0.8)


def rise():
    t = t_(0.35)
    f = 600 * (2 ** (t / 0.35 * 1.0))              # 1オクターブ上がる
    a = np.sin(2 * np.pi * np.cumsum(f) / SR)
    a *= np.sin(np.pi * t / 0.35) ** 1.5
    return norm(a, 0.7)


def chapter():
    """章の変わり目の「ポロン」。やわらかい鐘の音を2つ(ミ→ラ)、少しずらして鳴らす。ホワーンより長く、落ち着いた音"""
    d = 1.6; t = t_(d); out = np.zeros(len(t))
    for k, (f0, at, g) in enumerate([(659.3, 0.0, 1.0), (880.0, 0.13, 0.85)]):
        tt = np.clip(t - at, 0, None); on = (t >= at)
        a = (np.sin(2 * np.pi * f0 * tt) * np.exp(-tt / 0.55) + 0.3 * np.sin(2 * np.pi * f0 * 2 * tt) * np.exp(-tt / 0.25)
             + 0.1 * np.sin(2 * np.pi * f0 * 3.01 * tt) * np.exp(-tt / 0.1))
        out += g * a * on * np.minimum(1, tt / 0.004)
    return norm(lowpass(out, 6000), 0.8)


def bgm_placeholder():
    """やわらかいパッドと、小さな粒の音(アルペジオ)。テンポ 96・4小節×2=32秒・ループで切れ目が出ないよう、はみ出した余韻は頭に回す"""
    bpm = 96; beat = 60 / bpm; bars = 8; L = int(bars * 4 * beat * SR)
    buf = np.zeros((L, 2))
    chords = [[57, 60, 64, 67], [53, 57, 60, 64], [48, 52, 55, 59], [55, 59, 62, 64]]   # Am7 Fmaj7 Cmaj7 G6(MIDI番号)
    hz = lambda m: 440 * 2 ** ((m - 69) / 12)

    def add(sig, start, pan=0.0):
        i0 = int(start * SR); idx = (np.arange(len(sig)) + i0) % L
        np.add.at(buf[:, 0], idx, sig * (1 - pan) * 0.5 + sig * 0.5 * (1 - abs(pan)))
        np.add.at(buf[:, 1], idx, sig * (1 + pan) * 0.5 + sig * 0.5 * (1 - abs(pan)))

    for b in range(bars):
        ch = chords[b % 4]
        d = 4 * beat
        t = t_(d + 1.5)
        pad_env = np.minimum(1, t / 0.9) * np.where(t < d, 1, np.exp(-(t - d) / 0.6))
        for k, m in enumerate(ch):
            f = hz(m)
            s = sum(np.sin(2 * np.pi * f * (1 + det) * t + ph) for det, ph in ((-0.003, 0), (0.003, 1.3)))
            s += 0.2 * np.sin(2 * np.pi * 2 * f * t)
            add(0.05 * s * pad_env, b * d, pan=(k - 1.5) * 0.25)
        bass = hz(ch[0] - 12)
        tb = t_(d)
        add(0.10 * np.sin(2 * np.pi * bass * tb) * np.minimum(1, tb / 0.05) * np.exp(-tb / 2.5), b * d)
        # 8分音符の粒(上の2音を行き来する)
        for s8 in range(8):
            m = ch[[1, 2, 3, 2, 1, 2, 3, 2][s8]] + 12
            tp = t_(0.6)
            note = np.sin(2 * np.pi * hz(m) * tp) * np.exp(-tp / 0.18) * np.minimum(1, tp / 0.004)
            vel = 0.05 if s8 % 2 == 0 else 0.032
            add(vel * note, b * d + s8 * beat / 2, pan=0.35 if s8 % 2 else -0.35)
    buf[:, 0] = lowpass(buf[:, 0], 5000); buf[:, 1] = lowpass(buf[:, 1], 5000)
    return buf / (np.abs(buf).max() + 1e-9) * 0.8


def pluck(f, dur, bright=0.5):
    """はじいた弦(Karplus-Strong)。bright が小さいほど丸い音"""
    n = int(dur * SR); p = max(2, int(SR / f))
    buf = lowpass(rng.uniform(-1, 1, p), 1500 + 5000 * bright)
    out = np.empty(n)
    for i in range(n):
        out[i] = buf[i % p]
        buf[i % p] = 0.996 * 0.5 * (buf[i % p] + buf[(i + 1) % p])
    return out * np.minimum(1, np.arange(n) / (0.002 * SR))


def felt_piano(f, dur):
    """フェルトを挟んだピアノ風(倍音を少し伸ばしてずらし、高い倍音ほど早く消す)"""
    t = t_(dur)
    a = sum((0.6 ** k) * np.sin(2 * np.pi * f * (k + 1) * (1 + 0.0004 * k * k) * t) * np.exp(-t / (1.8 / (k + 1) ** 0.8))
            for k in range(6))
    return a * np.minimum(1, t / 0.006)


def strings(f, dur):
    """弦の和音のパッド(ゆっくり入り、少しビブラート)"""
    t = t_(dur)
    vib = 1 + 0.003 * np.sin(2 * np.pi * 5.2 * t)
    a = sum(np.sin(2 * np.pi * f * k * vib * t + k) / k ** 1.3 for k in range(1, 7))
    a += 0.6 * sum(np.sin(2 * np.pi * f * 1.002 * k * vib * t) / k ** 1.3 for k in range(1, 7))
    return a * np.minimum(1, t / 1.2) * np.minimum(1, (dur - t) / 0.8)


def bgm_warm():
    """テンポ 88・8小節。ギターの分散和音、ピアノの和音、弦、ウッドベース風。ループで切れ目が出ないよう余韻は頭に回す"""
    bpm = 88; beat = 60 / bpm; bars = 8; L = int(bars * 4 * beat * SR)
    buf = np.zeros((L, 2))
    hz = lambda m: 440 * 2 ** ((m - 69) / 12)
    prog = [[48, 55, 64, 67, 72], [45, 52, 60, 64, 69], [41, 53, 57, 60, 65], [43, 55, 59, 62, 67]]   # C Am F G(ギターの押さえ方に近い並び)

    def add(sig, start, pan=0.0, gain=1.0):
        i0 = int(start * SR); idx = (np.arange(len(sig)) + i0) % L
        np.add.at(buf[:, 0], idx, sig * gain * (1 - max(pan, 0)))
        np.add.at(buf[:, 1], idx, sig * gain * (1 + min(pan, 0)))

    for b in range(bars):
        ch = prog[b % 4]; d = 4 * beat; t0 = b * d
        # ギター: 8分音符の分散和音(指ではじく)
        pat = [0, 2, 3, 4, 1, 3, 2, 4]
        for k, j in enumerate(pat):
            vel = 0.22 if k % 2 == 0 else 0.15
            add(pluck(hz(ch[j]), 1.6, bright=0.35), t0 + k * beat / 2 + rng.uniform(0, 0.008), pan=-0.35, gain=vel)
        # ピアノ: 小節の頭と3拍目に、高い所で和音を置く
        for beat_at, g in ((0, 0.10), (2, 0.06)):
            for m in ch[2:]:
                add(felt_piano(hz(m + 12), 2.4), t0 + beat_at * beat + 0.01, pan=0.3, gain=g)
        # 弦: 和音の3音を長く
        for m in ch[1:4]:
            add(lowpass(strings(hz(m), d + 0.6), 2500), t0, pan=0.0, gain=0.018)
        # ウッドベース風: 1拍目と3拍目
        for beat_at, m in ((0, ch[0] - 12), (2, ch[0] - 12 + (7 if b % 2 else 0))):
            add(pluck(hz(m), 1.2, bright=0.1), t0 + beat_at * beat, gain=0.5)
    buf[:, 0] = lowpass(buf[:, 0], 6000); buf[:, 1] = lowpass(buf[:, 1], 6000)
    return buf / (np.abs(buf).max() + 1e-9) * 0.8

# ---------- BGM の候補(2026-10-12 エイイチの指示で3種。どれも電子音を避け、楽器に近い音で組む) ----------
HZ = lambda m: 440 * 2 ** ((m - 69) / 12)


class Loop:
    """小節数ぶんの輪(ループ)の入れ物。はみ出した余韻は頭に回すので、つなぎ目が出ない"""
    def __init__(self, bpm, bars):
        self.beat = 60 / bpm; self.bar = 4 * self.beat
        self.L = int(bars * self.bar * SR); self.buf = np.zeros((self.L, 2))

    def add(self, sig, start, pan=0.0, gain=1.0):
        i0 = int(start * SR); idx = (np.arange(len(sig)) + i0) % self.L
        np.add.at(self.buf[:, 0], idx, sig * gain * (1 - max(pan, 0)))
        np.add.at(self.buf[:, 1], idx, sig * gain * (1 + min(pan, 0)))

    def out(self, cutoff=6500):
        b = self.buf
        b[:, 0] = lowpass(b[:, 0], cutoff); b[:, 1] = lowpass(b[:, 1], cutoff)
        return b / (np.abs(b).max() + 1e-9) * 0.8


def marimba(f, dur=1.0):
    """木の鍵盤(マリンバ)。倍音が 1・3.9・9.2 倍にあり、すぐ消える"""
    t = t_(dur)
    a = (np.sin(2 * np.pi * f * t) * np.exp(-t / 0.35) + 0.25 * np.sin(2 * np.pi * f * 3.9 * t) * np.exp(-t / 0.06)
         + 0.08 * np.sin(2 * np.pi * f * 9.2 * t) * np.exp(-t / 0.02))
    return a * np.minimum(1, t / 0.002)


def pizz(f, dur=0.7):
    """弦をはじく(ピッツィカート)。ギターより短く丸い"""
    a = pluck(f, dur, bright=0.2)
    return a * np.exp(-t_(dur)[:len(a)] / 0.18)


def shaker(dur=0.09):
    t = t_(dur)
    n = rng.standard_normal(len(t))
    return (n - lowpass(n, 5000)) * np.sin(np.pi * t / dur) ** 2


def bgm_piano():
    """1. ピアノ中心・ゆったり(テンポ76)。ピアノの分散和音に弦がうすく重なる。考える場面向き。
    分散和音はナレーションの声の高さ(男声 100〜300Hz)とぶつからないよう、1オクターブ上で弾く"""
    lp = Loop(76, 8)
    prog = [[41, 53, 57, 60, 64], [40, 52, 55, 59, 62], [38, 50, 53, 57, 60], [36, 48, 52, 55, 59]]   # Fmaj7 Em7 Dm7 Cmaj7
    mel = [72, None, 71, None, 69, None, 67, None]   # 小節の頭にだけ置く、ゆっくり下がる音
    for b in range(8):
        ch = prog[b % 4]; t0 = b * lp.bar
        for k, j in enumerate([1, 2, 3, 4, 3, 2, 3, 4]):
            lp.add(felt_piano(HZ(ch[j] + 12), 2.6), t0 + k * lp.beat / 2 + rng.uniform(0, 0.01), pan=0.15, gain=0.09 if k % 2 == 0 else 0.065)
        lp.add(felt_piano(HZ(ch[0]), 3.5), t0, gain=0.12)
        if mel[b]:
            lp.add(felt_piano(HZ(mel[b] + 12), 3.0), t0 + 0.02, pan=-0.2, gain=0.06)
        for m in ch[1:4]:
            lp.add(lowpass(strings(HZ(m), lp.bar + 0.8), 2200), t0, gain=0.014)
    return lp.out(6000)


def bgm_guitar_marimba():
    """2. ギターとマリンバ・明るめ(テンポ96)。ギターの刻みに、木の鍵盤の短いフレーズ。フック・導入向き"""
    lp = Loop(96, 8)
    prog = [[48, 55, 64, 67, 72], [47, 55, 62, 67, 71], [45, 52, 60, 64, 69], [41, 53, 57, 60, 65]]   # C G/B Am F
    riff = [(0, 0), (0.75, 2), (1.5, 1), (2.5, 2), (3, 3)]   # (拍, 和音の何番目) マリンバ
    for b in range(8):
        ch = prog[b % 4]; t0 = b * lp.bar
        for k, j in enumerate([0, 2, 3, 4, 2, 3, 4, 3]):
            lp.add(pluck(HZ(ch[j]), 1.4, bright=0.4), t0 + k * lp.beat / 2 + rng.uniform(0, 0.006), pan=-0.4, gain=0.2 if k % 2 == 0 else 0.13)
        if b % 2 == 1:
            for at, j in riff:
                lp.add(marimba(HZ(ch[2:][j % 3] + 12)), t0 + at * lp.beat, pan=0.4, gain=0.16)
        for at in (0, 2):
            lp.add(pluck(HZ(ch[0] - 12), 1.1, bright=0.1), t0 + at * lp.beat, gain=0.5)
        for k in range(8):
            lp.add(shaker(), t0 + k * lp.beat / 2 + lp.beat / 4, pan=0.2, gain=0.05 if k % 2 else 0.03)
    return lp.out(4000)   # はじく音は高い成分が多いので、丸めて温かくする


def bgm_pizzicato():
    """3. 弦のピッツィカートとピアノ・少し先が気になる感じ(テンポ104)。ドキュメンタリーの解説向き"""
    lp = Loop(104, 8)
    prog = [[45, 57, 60, 64], [41, 57, 60, 65], [36, 55, 60, 64], [43, 55, 59, 62]]   # Am F C G
    for b in range(8):
        ch = prog[b % 4]; t0 = b * lp.bar
        for k, j in enumerate([1, 2, 3, 2, 1, 2, 3, 2]):
            lp.add(pizz(HZ(ch[j])), t0 + k * lp.beat / 2, pan=-0.3 if k % 2 else 0.3, gain=0.22 if k % 2 == 0 else 0.15)
        for at, m in ((0, ch[0] - 12), (1.5, ch[0] - 12), (2, ch[0] - 5)):
            lp.add(pizz(HZ(m), 0.9), t0 + at * lp.beat, gain=0.45)
        for m in ch[1:]:
            lp.add(felt_piano(HZ(m + 12), 2.2), t0 + 0.01, pan=0.1, gain=0.05)
        if b >= 4:   # 後半だけ弦の和音が入り、少しふくらむ
            for m in ch[1:]:
                lp.add(lowpass(strings(HZ(m), lp.bar + 0.6), 2400), t0, gain=0.012)
    return lp.out(3800)


BGMS = {'bgm_1_ピアノ': bgm_piano, 'bgm_2_ギターとマリンバ': bgm_guitar_marimba, 'bgm_3_ピッツィカート': bgm_pizzicato}


# ---------- 大きな流れの変わり目の音の候補(2026-10-12 エイイチの指示で3つ) ----------
def chapter_marimba():
    """ポロロン: マリンバで ド・ミ・ソ と上がる"""
    out = np.zeros(int(1.6 * SR))
    for k, f in enumerate([523.3, 659.3, 784.0]):
        a = marimba(f, 1.2) * (0.8 if k < 2 else 1.0)
        i = int(k * 0.09 * SR); out[i:i + len(a)] += a[:len(out) - i]
    return norm(lowpass(out, 7000), 0.8)


def chapter_harp():
    """シャララン: 弦をはじく音を6つ、ハープのように素早く上がる"""
    out = np.zeros(int(2.0 * SR))
    for k, m in enumerate([60, 64, 67, 72, 76, 79]):
        a = pluck(440 * 2 ** ((m - 69) / 12), 1.6, bright=0.3) * (0.6 + 0.08 * k)
        i = int(k * 0.055 * SR); out[i:i + len(a)] += a[:len(out) - i]
    return norm(lowpass(out, 6000), 0.8)


def chapter_piano():
    """ポーン: やわらかいピアノで ド・ソ・ミ・ソ の和音を1つ(低い音から少しずつずらして弾く)"""
    out = np.zeros(int(2.2 * SR))
    for k, m in enumerate([48, 55, 64, 67]):
        a = felt_piano(440 * 2 ** ((m - 69) / 12), 2.2) * (1.0 if k == 0 else 0.7)
        i = int(k * 0.025 * SR); out[i:i + len(a)] += a[:len(out) - i]
    return norm(lowpass(out, 5000), 0.8)


CHAPTER_CANDS = {'se_chapter_marimba': chapter_marimba, 'se_chapter_harp': chapter_harp, 'se_chapter_piano': chapter_piano}


def chapter_glock():
    """キラリン: 鉄琴(グロッケン)で ミ・ソ・ド と上がる。倍音は 1・2.76・5.4 倍(金属の棒の音)"""
    out = np.zeros(int(1.8 * SR)); t = t_(1.6)
    for k, f in enumerate([1318.5, 1568.0, 2093.0]):
        a = (np.sin(2 * np.pi * f * t) * np.exp(-t / 0.7) + 0.25 * np.sin(2 * np.pi * f * 2.76 * t) * np.exp(-t / 0.15)
             + 0.08 * np.sin(2 * np.pi * f * 5.4 * t) * np.exp(-t / 0.05)) * np.minimum(1, t / 0.001)
        i = int(k * 0.08 * SR); out[i:i + len(a)] += a[:len(out) - i] * (0.7 + 0.15 * k)
    return norm(lowpass(out, 9000), 0.7)


def chapter_swell():
    """フワァ: 弦の和音(ド・ミ・ソ・ド)が0.8秒でふくらみ、1秒で消える"""
    d = 1.9; t = t_(d)
    a = sum(lowpass(strings(440 * 2 ** ((m - 69) / 12), d), 3000) for m in [60, 64, 67, 72])
    shape = np.where(t < 0.8, np.sin(np.pi / 2 * t / 0.8) ** 2, np.exp(-(t - 0.8) / 0.35))
    return norm(a * shape, 0.8)


def chapter_wind():
    """シャラン: 細い金属の筒(ウィンドチャイム)が、0.5秒の間に9回ふれあう"""
    out = np.zeros(int(2.0 * SR)); t = t_(1.4); r = np.random.default_rng(11)
    scale = [1760.0, 1975.5, 2217.5, 2637.0, 2960.0, 3520.0]
    for k in range(9):
        f = scale[r.integers(len(scale))]
        a = (np.sin(2 * np.pi * f * t) + 0.3 * np.sin(2 * np.pi * f * 2.7 * t) * np.exp(-t / 0.2)) * np.exp(-t / 0.6) * np.minimum(1, t / 0.001)
        i = int((k * 0.055 + r.uniform(0, 0.02)) * SR); out[i:i + len(a)] += a[:len(out) - i] * r.uniform(0.5, 1.0)
    return norm(lowpass(out, 10000), 0.6)


CHAPTER_CANDS.update({'se_chapter_glock': chapter_glock, 'se_chapter_swell': chapter_swell, 'se_chapter_wind': chapter_wind})


if __name__ == '__main__':
    os.makedirs(OUT, exist_ok=True)
    for name, f in [('se_pop', pop), ('se_tick', tick), ('se_whoosh', whoosh), ('se_ding', ding), ('se_rise', rise), ('se_chapter', chapter)]:
        write_wav(os.path.join(OUT, f'{name}.wav'), (f() * 32767).astype(np.int16))
        print(name)
    for name, f in CHAPTER_CANDS.items():
        write_wav(os.path.join(OUT, f'{name}.wav'), (f() * 32767).astype(np.int16))
        print(name)
    if 'bgm3' in sys.argv:
        for name, f in BGMS.items():
            write_wav(os.path.join(OUT, f'{name}.wav'), (f() * 32767).astype(np.int16), ch=2)
            print(name)
        sys.exit()
    if 'warm' not in sys.argv:
        write_wav(os.path.join(OUT, 'bgm_仮.wav'), (bgm_placeholder() * 32767).astype(np.int16), ch=2)
        print('bgm_仮')
    write_wav(os.path.join(OUT, 'bgm_仮_温かみ.wav'), (bgm_warm() * 32767).astype(np.int16), ch=2)
    print('bgm_仮_温かみ')
_制作ベース/sound_eleven.py
新規。ElevenLabs で BGM と効果音を作る。API キーを使うので Mac で動かす(71行)。
"""BGM と効果音を ElevenLabs で作る。エイイチの Mac で動かす(API キーを Claude に渡さないため。tts_eleven.py と同じ)。

準備: ターミナルで  read -s ELEVENLABS_API_KEY && export ELEVENLABS_API_KEY
      (キーを貼って Enter。画面には出ない)

使い方(動画の作業フォルダで)
  BGM:    python3 ../_制作ベース/sound_eleven.py music --name bgm_hook --sec 60 --prompt "(説明文)"
  効果音: python3 ../_制作ベース/sound_eleven.py sfx --name se_pop2 --sec 0.5 --prompt "(説明文)"
    --name    保存する名前(sound/{名前}.mp3 になる。sound.py の file にこの名前のパスを書く)
    --sec     長さ(秒)。BGM は 3〜600、効果音は 0.5〜30
    --prompt  どんな音か(英語の方が安定する。説明文の候補は 音源_候補.md)
    --count   同じ説明文で何本作るか(既定 1。2 以上だと bgm_hook_1.mp3, bgm_hook_2.mp3…)
    --loop    効果音を切れ目なくループする音にする(環境音など)
BGM は歌なし(force_instrumental)で作る。
Starter プランの決まり(2026-10-12 に ElevenLabs の Eleven Music の規約で確認):
  商用に使える(映画・テレビ・ラジオ・ゲームの一部を除く)。クレジット表記はいらない。
  作れる曲の長さは月 17 分まで。曲そのものを音楽配信サービスに出すのは禁止(動画の BGM に使うのはこれに当たらない)
有料プランの間に作った音は、解約したあとも商用に使える(無料プランに戻ってから作った音は使えない)
"""
import argparse, json, os, sys, time, urllib.request, urllib.error

ap = argparse.ArgumentParser()
ap.add_argument('kind', choices=['music', 'sfx'])
ap.add_argument('--name', required=True)
ap.add_argument('--sec', type=float, required=True)
ap.add_argument('--prompt', required=True)
ap.add_argument('--count', type=int, default=1)
ap.add_argument('--loop', action='store_true')
ap.add_argument('--model', default='')
args = ap.parse_args()
key = os.environ.get('ELEVENLABS_API_KEY')
if not key:
    sys.exit('ELEVENLABS_API_KEY が入っていません。ターミナルで  read -s ELEVENLABS_API_KEY && export ELEVENLABS_API_KEY  を実行してから動かしてください')

os.makedirs('sound', exist_ok=True)
if args.kind == 'music':
    if not 3 <= args.sec <= 600:
        sys.exit('BGM の長さは 3〜600 秒')
    url = 'https://api.elevenlabs.io/v1/music?output_format=mp3_44100_128'
    body = {'prompt': args.prompt, 'music_length_ms': int(args.sec * 1000), 'force_instrumental': True}
else:
    if not 0.5 <= args.sec <= 30:
        sys.exit('効果音の長さは 0.5〜30 秒')
    url = 'https://api.elevenlabs.io/v1/sound-generation?output_format=mp3_44100_128'
    body = {'text': args.prompt, 'duration_seconds': args.sec, 'prompt_influence': 0.5}
    if args.loop:
        body['loop'] = True
if args.model:
    body['model_id'] = args.model

log = os.path.join('sound', '作った記録.jsonl')
for k in range(args.count):
    name = args.name if args.count == 1 else f'{args.name}_{k + 1}'
    path = os.path.join('sound', f'{name}.mp3')
    if os.path.exists(path):
        sys.exit(f'{path} はもうあります(上書きしない)。--name を変えてください')
    req = urllib.request.Request(url, data=json.dumps(body).encode(),
                                 headers={'xi-api-key': key, 'Content-Type': 'application/json'})
    try:
        with urllib.request.urlopen(req, timeout=600) as r:
            open(path, 'wb').write(r.read())
            extra = {h: r.headers.get(h) for h in ('song-id', 'character-cost') if r.headers.get(h)}
    except urllib.error.HTTPError as e:
        sys.exit(f'{name} で止まりました: {e.code} {e.read().decode(errors="ignore")[:300]}')
    except urllib.error.URLError as e:
        sys.exit(f'{name} で止まりました(ElevenLabs につながらない): {e.reason}')
    with open(log, 'a', encoding='utf-8') as f:
        f.write(json.dumps(dict(file=path, kind=args.kind, sec=args.sec, prompt=args.prompt, loop=args.loop,
                                model=args.model or '既定', time=time.strftime('%Y-%m-%d %H:%M'), **extra),
                           ensure_ascii=False) + '\n')
    print(f'できあがり: {path}')
_制作ベース/tts_eleven.py
直した。読みを確かめる試しの文だけを作る --try を足した。Mac で動かす(114行)。
"""ハコブくんの声(ElevenLabs)で、台本を1文ずつ音声にする。エイイチの Mac で動かす(API キーを Claude に渡さないため)。

準備(1回だけ)
  1. ElevenLabs の有料プランに入る(無料プランの音声は商用に使えない)
  2. Voice Design で声を作って保存し、その声の Voice ID を控える(Voices の一覧で声を開くと出る)
  3. ターミナルで API キーを入れる(キーは画面やファイルに残さない):  export ELEVENLABS_API_KEY=(キー)

使い方(動画の作業フォルダで。例: 動画/AIエージェントの取り違え/)
  python3 ../_制作ベース/tts_eleven.py --voice VOICE_ID --name 候補A --lines 0-12
    --lines   作る文の番号(0 から。「0-12」「5,8,9」のように書く。省略するとすべて)
    --model   eleven_v4(既定。2026-10-12 に決定)/eleven_multilingual_v2/eleven_v3
    --seed    同じ値なら、なるべく同じ読み方になる(既定 7)
    --try     台本ではなく、試しの文を作る(「|」で区切って何文でも。例: --try "エイイチは…。|栄一は…。")
              出力は voice_eleven/{名前}/試し_01.mp3 … と、どの文かの一覧 試し.txt
出力: voice_eleven/{名前}/{番号}.mp3 と、作った設定の記録 voice_eleven/{名前}/設定.json
このあと Claude が tts_import.py で 48kHz の wav にして、口の動きと字幕に使う。
使う文字数(クレジット)は、文の字数の合計。1本約4,100字。作り直した分も数える
"""
import argparse, json, os, sys, time, urllib.request, urllib.error
sys.path.insert(0, '.')
from narration import SEGS
try:
    from narration import parse
except ImportError:
    def parse(s):
        return s[0], "base", s[1], (s[2] if len(s) > 2 else 0.35)
try:
    from narration import ELEVEN_READ   # ElevenLabs が読み間違えた語だけ、ここで読みを直す(字幕は変えない)
except ImportError:
    ELEVEN_READ = []

ap = argparse.ArgumentParser()
ap.add_argument('--voice', required=True)
ap.add_argument('--name', required=True)
ap.add_argument('--lines', default='')
ap.add_argument('--model', default='eleven_v4')   # 2026-10-12 エイイチが v4 に決めた(冒頭14文で v2 と聞き比べ)
ap.add_argument('--seed', type=int, default=7)
ap.add_argument('--stability', type=float, default=0.55)
ap.add_argument('--similarity', type=float, default=0.75)
ap.add_argument('--try', dest='trial', default='')
args = ap.parse_args()
key = os.environ.get('ELEVENLABS_API_KEY')
if not key:
    sys.exit('ELEVENLABS_API_KEY が入っていません。ターミナルで export ELEVENLABS_API_KEY=(キー) を実行してから動かしてください')


def nums(spec, n):
    if not spec:
        return list(range(n))
    out = []
    for part in spec.split(','):
        if '-' in part:
            a, b = part.split('-'); out += list(range(int(a), int(b) + 1))
        else:
            out.append(int(part))
    return [i for i in out if 0 <= i < n]


def speak_text(t):
    t = t.replace('|', '').replace('「', '').replace('」', '')
    for a, b in ELEVEN_READ:
        t = t.replace(a, b)
    return t


texts = [parse(s)[2] for s in SEGS]
outdir = os.path.join('voice_eleven', args.name)
if args.trial:   # 試しの文だけを作る(台本の読みの直し ELEVEN_READ は使わない。書いたとおりに読ませて聞き比べる)
    os.makedirs(outdir, exist_ok=True)
    lines = [t for t in args.trial.split('|') if t]
    with open(os.path.join(outdir, '試し.txt'), 'w', encoding='utf-8') as f:
        for k, t in enumerate(lines, 1):
            f.write(f'試し_{k:02d}: {t}\n')
    for k, t in enumerate(lines, 1):
        body = {'text': t, 'model_id': args.model, 'seed': args.seed,
                'voice_settings': {'stability': args.stability, 'similarity_boost': args.similarity}}
        req = urllib.request.Request(
            f'https://api.elevenlabs.io/v1/text-to-speech/{args.voice}?output_format=mp3_44100_128',
            data=json.dumps(body).encode(), headers={'xi-api-key': key, 'Content-Type': 'application/json'})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                open(os.path.join(outdir, f'試し_{k:02d}.mp3'), 'wb').write(r.read())
        except urllib.error.HTTPError as e:
            sys.exit(f'試し_{k:02d} で止まりました: {e.code} {e.read().decode(errors="ignore")[:300]}')
        print(f'試し_{k:02d} {t}')
    print(f'できあがり: {outdir}  使った文字数 約{sum(len(t) for t in lines)}字')
    sys.exit(0)
os.makedirs(outdir, exist_ok=True)
json.dump(dict(vars(args), time=time.strftime('%Y-%m-%d %H:%M')), open(os.path.join(outdir, '設定.json'), 'w'),
          ensure_ascii=False, indent=1)
used = 0
for i in nums(args.lines, len(SEGS)):
    if not texts[i]:
        continue
    prev = next((speak_text(texts[j]) for j in range(i - 1, -1, -1) if texts[j]), None)
    nxt = next((speak_text(texts[j]) for j in range(i + 1, len(texts)) if texts[j]), None)
    body = {'text': speak_text(texts[i]), 'model_id': args.model, 'seed': args.seed,
            'voice_settings': {'stability': args.stability, 'similarity_boost': args.similarity}}
    if args.model.startswith('eleven_multilingual'):   # 前後の文を渡すと、文のつながりの抑揚が自然になる(対応を確かめたモデルだけ)
        body['previous_text'] = prev
        body['next_text'] = nxt
    req = urllib.request.Request(
        f'https://api.elevenlabs.io/v1/text-to-speech/{args.voice}?output_format=mp3_44100_128',
        data=json.dumps(body).encode(), headers={'xi-api-key': key, 'Content-Type': 'application/json'})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            open(os.path.join(outdir, f'{i:03d}.mp3'), 'wb').write(r.read())
    except urllib.error.HTTPError as e:
        sys.exit(f'{i:03d} で止まりました: {e.code} {e.read().decode(errors="ignore")[:300]}')
    except urllib.error.URLError as e:
        sys.exit(f'{i:03d} で止まりました(ElevenLabs につながらない): {e.reason}')
    used += len(body['text'])
    print(f'{i:03d} {body["text"][:30]}')
print(f'できあがり: {outdir}  使った文字数 約{used}字')
_制作ベース/tts_import.py
ElevenLabs の mp3 を、書き出し用の 48kHz の wav にする(44行)。
"""ElevenLabs などで作った1文ずつの音声を、書き出しで使う形(tts/{番号}.wav・48kHz モノラル と tts/index.json)にする。
使い方: 動画の作業フォルダで  python3 <_制作ベース>/tts_import.py voice_eleven/候補A
- その文の音声がないときは、いまの tts/ の音声(仮音声)をそのまま使う。声の聞き比べで、一部の文だけ差し替えられる
- 文の前後の無音は 0.05 秒を残して切る(間は narration.py の「後ろの間」で決めるため)
"""
import json, os, subprocess, sys, wave
import numpy as np
sys.path.insert(0, '.')
from narration import SEGS
try:
    from narration import parse
except ImportError:
    def parse(s):
        return s[0], "base", s[1], (s[2] if len(s) > 2 else 0.35)

SR = 48000
src = sys.argv[1]
os.makedirs('tts', exist_ok=True)
old = {o['i']: o for o in json.load(open('tts/index.json'))} if os.path.exists('tts/index.json') else {}
out, replaced = [], 0
for i, s in enumerate(SEGS):
    scene, face, text, pause = parse(s)
    mp3 = os.path.join(src, f'{i:03d}.mp3')
    d, note = 0.0, ''
    if text and os.path.exists(mp3):
        raw = subprocess.run(['ffmpeg', '-v', 'error', '-i', mp3, '-ac', '1', '-ar', str(SR), '-f', 's16le', '-'],
                             capture_output=True, check=True).stdout
        a = np.frombuffer(raw, dtype=np.int16)
        loud = np.where(np.abs(a) > 300)[0]
        if len(loud):
            pad = int(0.05 * SR)
            a = a[max(0, loud[0] - pad):min(len(a), loud[-1] + pad)]
        with wave.open(f'tts/{i:03d}.wav', 'wb') as w:
            w.setnchannels(1); w.setsampwidth(2); w.setframerate(SR); w.writeframes(a.tobytes())
        d, note = len(a) / SR, f'voice:{os.path.basename(src.rstrip("/"))}'
        replaced += 1
    elif text and i in old and old[i]['text'] == text:
        d, note = old[i]['dur'], old[i].get('note', '')
    elif text:
        sys.exit(f'{i:03d} の音声がありません({mp3} も、同じ文の仮音声もない)。tts2.py で仮音声を作ってから取り込む')
    out.append(dict(i=i, scene=scene, face=face, text=text, dur=d, pause=pause, note=note))
json.dump(out, open('tts/index.json', 'w'), ensure_ascii=False, indent=0)
tot = sum(o['dur'] + o['pause'] for o in out)
print(f'差し替えた文 {replaced}  全体 {int(tot // 60)}:{int(tot % 60):02d}')
_制作ベース/description.py
新規。概要欄の下書きの {t:文番号} を時間に置きかえ、目次の条件を確かめる(40行)。
"""YouTube の概要欄を、書き出しの時間に合わせて仕上げる。
使い方(動画の作業フォルダで、assemble.py のあと)
  python3 <_制作ベース>/description.py   (--draft を付けると、【要記入】が残っていても 概要欄_確認用.txt に書く)
読むもの: 概要欄_下書き.md(目次の時間を {t:文番号} と書く)と timeline.json(assemble.py が書く)
書くもの: 概要欄.txt(YouTube にそのまま貼る。{t:9} が、9番の文が始まる時間「0:56」などに置きかわる)
- YouTube の目次(チャプター)は、最初が 0:00 で、3つ以上・それぞれ10秒以上が条件。満たさないときは止まる
- 概要欄は 5,000 字まで
- 「【要記入:…】」が残っていると止まる(連絡先や SNS の URL など、エイイチが決めて書く所)
"""
import json, re, sys

FPS = 30
tl = {o['i']: o for o in json.load(open('timeline.json'))}
src = open('概要欄_下書き.md', encoding='utf-8').read()
# 「<!-- -->」で囲んだメモは貼らない
src = re.sub(r'<!--.*?-->\n?', '', src, flags=re.S)


def ts(i):
    if i not in tl:
        sys.exit(f'{i}番の文が timeline.json にありません(全体を書き出してから動かす)')
    s = int(tl[i]['start'] / FPS)
    return f'{s // 3600}:{s % 3600 // 60:02d}:{s % 60:02d}' if s >= 3600 else f'{s // 60}:{s % 60:02d}'


out = re.sub(r'\{t:(\d+)\}', lambda m: ts(int(m.group(1))), src).strip() + '\n'
# 目次の条件を確かめる
times = [t for t in re.findall(r'^(\d+:\d{2}(?::\d{2})?) ', out, flags=re.M)]
secs = [sum(int(x) * 60 ** k for k, x in enumerate(reversed(t.split(':')))) for t in times]
if times:
    if secs[0] != 0 or len(secs) < 3 or any(b - a < 10 for a, b in zip(secs, secs[1:])):
        sys.exit(f'目次が YouTube の条件を満たしていません: {times}')
draft = '--draft' in sys.argv   # 「【要記入】」が残っていても、確かめ用に 概要欄_確認用.txt を書く
if '【' in out and '要記入' in out and not draft:
    sys.exit('「【要記入】」が残っています: ' + ', '.join(re.findall(r'【要記入[^】]*】', out)))
if len(out) > 5000:
    sys.exit(f'概要欄が {len(out)} 字あります(5,000 字まで)')
name = '概要欄_確認用.txt' if draft else '概要欄.txt'
open(name, 'w', encoding='utf-8').write(out)
print(f'{name} を書きました({len(out)} 字・目次 {len(times)} 個)')
_制作ベース/thumbnail.py
新規。サムネイルを動画と同じ文字と色で、HTML で組んで画像にする(214行)。
"""YouTube のサムネイルを、動画と同じ文字・色(scene_kit.py)で作る。文字は画像生成 AI に任せず、ここで組む(文字の間違いが起きない)。
使い方(動画の作業フォルダで)
  python3 <_制作ベース>/thumbnail.py
読むもの: thumb.py(文言・背景の写真・案の指定)
書くもの: thumb/{案の名前}.png(1280×720。YouTube の上限 2MB 以下)と thumb/一覧.png(並べて比べる用・スマホの小さい表示の大きさも添える)

thumb.py の書き方
  PHOTO = 'サムネ素材/素材2_実機のアーム.png'   # 背景の写真(1920×1080 以上)
  HAKOBU = True                                  # 左下にハコブくんを置く
  LABEL = '本当に?'                              # ハコブくんの横の小さな札
  KICKER = '人型ロボット出荷 約4倍'               # 上の小さな一言(オレンジ)
  LINES = ['ロボットにも', '<span class="red">ChatGPTの瞬間</span>', 'もう来た?']
  VARIANTS = ['split', 'dark', 'bold']           # 作る案(split 紙色と写真/dark 黒と写真/bold 大きなハコブくんと縁取り文字)
  BOLD_LINES = ['人型ロボット出荷 約4倍', 'ChatGPTの瞬間', 'もう来た?']   # bold 案の3行(なければ KICKER と LINES)
"""
import base64, os, sys, subprocess
sys.path.insert(0, '.')
HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(1, HERE)
from scene_kit import BG, INK, RED, SUB, LOGO
from PIL import Image
from playwright.sync_api import sync_playwright

ns = {}
exec(open('thumb.py', encoding='utf-8').read(), ns)
os.makedirs('thumb', exist_ok=True)


def data_uri(path):
    ext = os.path.splitext(path)[1].lower().lstrip('.')
    return f"data:image/{'jpeg' if ext in ('jpg', 'jpeg') else 'png'};base64," + base64.b64encode(open(path, 'rb').read()).decode()


photo = data_uri(ns['PHOTO'])
def _hakobu_uri():
    """ハコブくんの体(右向き)。2026-10-12 から、作り直した体に顔を描いた hakobu/thumb_body_right.png を使う
    (元の体は頭の上が切り抜けておらず、大きく出すと頭がへこんで見えた)。なければ動画と同じ体を使う"""
    import io
    new = os.path.join(HERE, 'hakobu', 'thumb_body_right.png')
    if os.path.exists(new):
        return data_uri(new)
    from hakobu import Hakobu, FX0, FY0
    H = Hakobu(mode='full')
    eyes = ('open', 'open')
    b = H.body.copy(); H._ring(b, 0.7)
    img = b.crop(H.crop_draw)
    gl, la = H._face_layers(eyes, None, 'mid', 0.0)
    ox, oy = FX0 - H.crop_draw[0], FY0 - H.crop_draw[1]
    img.alpha_composite(gl, (ox, oy)); img.alpha_composite(la, (ox, oy))
    img = img.crop((H.crop[0] - H.crop_draw[0], H.crop[1] - H.crop_draw[1], H.crop[2] - H.crop_draw[0], H.crop[3] - H.crop_draw[1]))
    img = img.transpose(Image.FLIP_LEFT_RIGHT)
    img = img.crop(img.getchannel('A').point(lambda v: 255 if v > 60 else 0).getbbox())
    img.save('thumb/_hakobu.png')
    buf = io.BytesIO(); img.save(buf, 'PNG')
    return 'data:image/png;base64,' + base64.b64encode(buf.getvalue()).decode()


hk = _hakobu_uri() if ns.get('HAKOBU', True) else None
kicker, lines, label = ns.get('KICKER', ''), ns['LINES'], ns.get('LABEL', '')
pos = ns.get('PHOTO_POS', '20% 50%')   # 写真のどこを見せるか(CSS の background-position)

BASE = f"""*{{margin:0;padding:0;box-sizing:border-box}}
html,body{{width:1920px;height:1080px;overflow:hidden;font-family:'Noto Sans CJK JP',sans-serif;color:{INK}}}
.red{{color:{RED}}}
.kicker{{display:inline-block;font-size:56px;font-weight:900;color:#fff;background:{RED};padding:10px 30px;border-radius:12px;letter-spacing:.02em}}
.main{{font-weight:900;line-height:1.16;letter-spacing:-.02em}}
.hk{{position:absolute;left:24px;bottom:-90px;height:430px}}
.label{{position:absolute;left:350px;bottom:250px;background:#fff;color:{INK};font-size:48px;font-weight:900;padding:12px 26px;border-radius:14px;box-shadow:0 6px 24px rgba(0,0,0,.25)}}
.label:after{{content:'';position:absolute;left:-22px;bottom:22px;border:14px solid transparent;border-right:14px solid #fff}}
.brand{{position:absolute;right:56px;top:44px;height:40px}}
"""


def hakobu_html():
    if not hk:
        return ''
    lab = f'<div class="label">{label}</div>' if label else ''
    return f'<img class="hk" src="{hk}">{lab}'


def html(kind):
    k = f'<div class="kicker">{kicker}</div>' if kicker else ''
    body = '<br>'.join(lines)
    if kind == 'split':   # 左に動画と同じ紙色の面と文字、右に写真
        return f"""<style>{BASE}
body{{background:{BG}}}
.ph{{position:absolute;right:0;top:0;width:820px;height:1080px;background:url({photo}) {pos}/cover}}
.txt{{position:absolute;left:96px;top:84px;width:1060px}}
.main{{font-size:136px;margin-top:28px}}
</style><div class="ph"></div><div class="txt">{k}<div class="main">{body}</div></div>{hakobu_html()}<img class="brand" src="{LOGO}">"""
    if kind == 'card':    # 写真を全面に敷き、動画の名前テロップと同じ薄い紙色の札に文字
        return f"""<style>{BASE}
body{{background:url({photo}) {pos}/cover}}
.txt{{position:absolute;left:70px;top:70px;background:rgba(245,245,240,.95);border-radius:24px;padding:44px 60px 52px}}
.main{{font-size:124px;margin-top:24px}}
</style><div class="txt">{k}<div class="main">{body}</div></div>{hakobu_html()}"""
    if kind == 'dark':    # 案B: 写真を右へずらして敷き、左は黒に溶かして白い文字。ハコブくんは左下で大きめ、右(アーム)を向く
        return f"""<style>{BASE}
body{{background:#111}}
.ph{{position:absolute;left:720px;top:0;width:1920px;height:1080px;background:url({photo}) 0 50%/cover}}
.shade{{position:absolute;inset:0;background:linear-gradient(90deg,rgba(13,13,13,1) 0%,rgba(13,13,13,1) 38%,rgba(13,13,13,.6) 48%,rgba(13,13,13,0) 64%)}}
.txt{{position:absolute;left:96px;top:70px;width:1150px}}
.main{{font-size:122px;margin-top:22px;color:#fff;text-shadow:0 4px 18px rgba(0,0,0,.6)}}
.main .red{{color:#E25A2C}}
.hk2{{position:absolute;left:40px;bottom:-120px;height:540px}}
.label{{left:380px;bottom:300px}}
</style><div class="ph"></div><div class="shade"></div><div class="txt">{k}<div class="main">{body}</div></div><img class="hk2" src="{hk}"><div class="label">{label}</div>"""
    if kind == 'dark2':   # 案B2: ハコブくんを左に大きく(画面の高さいっぱい)。文字は右上、写真は右下
        return f"""<style>{BASE}
body{{background:#111}}
.ph{{position:absolute;left:560px;top:120px;width:1920px;height:1080px;background:url({photo}) 0 50%/cover}}
.shade{{position:absolute;inset:0;background:linear-gradient(90deg,rgba(13,13,13,1) 0%,rgba(13,13,13,1) 30%,rgba(13,13,13,0) 46%),linear-gradient(180deg,rgba(13,13,13,1) 0%,rgba(13,13,13,.92) 30%,rgba(13,13,13,0) 58%)}}
.txt{{position:absolute;right:70px;top:60px;text-align:right}}
.kicker{{font-size:52px}}
.main{{font-size:128px;margin-top:20px;color:#fff;text-shadow:0 4px 18px rgba(0,0,0,.7)}}
.main .red{{color:#E25A2C}}
.hk2{{position:absolute;left:30px;bottom:-110px;height:900px}}
.label{{left:90px;top:40px;bottom:auto}}
.label:after{{left:60px;bottom:-26px;border:14px solid transparent;border-top:14px solid #fff}}
</style><div class="ph"></div><div class="shade"></div><img class="hk2" src="{hk}"><div class="label">{label}</div><div class="txt">{k}<div class="main">{body}</div></div>"""
    if kind == 'dark3':   # 案B3: 上に横いっぱいの文字(黒地)、下に写真。ハコブくんは左下で大きく、アームを見る
        L = ns.get('BOLD_LINES', [kicker] + lines)
        return f"""<style>{BASE}
body{{background:#111}}
.ph{{position:absolute;left:470px;top:380px;width:1620px;height:911px;background:url({photo}) 0 40%/cover}}
.shade{{position:absolute;left:0;right:0;top:380px;height:220px;background:linear-gradient(180deg,#111 0%,rgba(17,17,17,0) 100%)}}
.shadeL{{position:absolute;left:470px;top:380px;width:260px;bottom:0;background:linear-gradient(90deg,#111 0%,rgba(17,17,17,0) 100%)}}
.top{{position:absolute;left:0;right:0;top:46px;text-align:center;color:#fff;font-weight:900;line-height:1.12}}
.top .a{{font-size:78px}} .top .b{{font-size:150px;letter-spacing:-.02em}} .top .b .red{{color:#E25A2C}}
.hk2{{position:absolute;left:40px;bottom:-90px;height:700px}}
.label{{left:360px;bottom:520px}}
</style><div class="ph"></div><div class="shade"></div><div class="shadeL"></div>
<div class="top"><div class="a"><span style="background:{RED};padding:4px 26px;border-radius:12px;font-size:60px">{L[0]}</span></div>
<div class="b"><span class="red">{L[1]}</span> {L[2]}</div></div><img class="hk2" src="{hk}"><div class="label">{label}</div>"""
    if kind in ('photo', 'photo2', 'photo3'):
        # 2026-10-12 エイイチの指示: 背景は全部写真。文字は大きく、写真の上に置くので黒い縁を付ける(上の札は縁なし)
        # photo : 文字は左上、ハコブくんは右下で左(アーム)を向く
        # photo2: 文字は右上、ハコブくんは右下で左を向く
        # photo3: 文字は右上、ハコブくんは左下の隅で右(アーム)を向く。写真は PHOTO3(ハコブくんがアームと箱に重ならないコマ)
        L = [kicker] + lines
        right = kind != 'photo'
        left_hk = kind == 'photo3'
        ph = data_uri(ns['PHOTO3']) if left_hk and ns.get('PHOTO3') else photo
        OUT = f"-webkit-text-stroke:24px {INK};paint-order:stroke fill;text-shadow:0 6px 18px rgba(0,0,0,.55)"
        if left_hk:
            HK = f".hk3{{{{position:absolute;left:10px;bottom:-190px;height:{ns.get('HK_H', 600)}px}}}}"
            LB = f""".label{{{{left:{ns.get('HK_H', 600) * 0.62 + 10:.0f}px;bottom:300px;border:6px solid {INK};font-size:54px}}}}
.label:after{{{{left:-30px;bottom:24px;border:16px solid transparent;border-right:16px solid {INK}}}}}"""
        else:
            HK = f".hk3{{{{position:absolute;right:{'30' if right else '60'}px;bottom:-170px;height:{'520' if right else '640'}px;transform:scaleX(-1)}}}}"
            LB = f""".label{{{{left:auto;right:{'330' if right else '420'}px;bottom:{'190' if right else '360'}px;border:6px solid {INK};font-size:54px}}}}
.label:after{{{{left:auto;right:-30px;bottom:24px;border:16px solid transparent;border-left:16px solid {INK}}}}}"""
        HK, LB = HK.replace('{{', '{').replace('}}', '}'), LB.replace('{{', '{').replace('}}', '}')
        return f"""<style>{BASE}
body{{background:url({ph}) {ns.get('PHOTO_POS_FULL', '50% 50%')}/cover}}
.dim{{position:absolute;inset:0;background:linear-gradient({'200deg' if right else '160deg'},rgba(0,0,0,.45) 0%,rgba(0,0,0,.15) 45%,rgba(0,0,0,0) 70%)}}
.txt{{position:absolute;{'right:56px;text-align:right' if right else 'left:60px'};top:40px;font-weight:900;color:#fff;line-height:1.1;letter-spacing:-.02em}}
.kick{{display:inline-block;font-size:66px;background:{RED};color:#fff;padding:8px 30px 12px;border-radius:14px;letter-spacing:.02em;box-shadow:0 6px 18px rgba(0,0,0,.35)}}
.l1{{font-size:150px;margin-top:22px;{OUT}}}
.l2{{font-size:{'200' if right else '212'}px;{OUT}}}
.l2 .red{{color:#F0602C}}
.l3{{font-size:{'170' if right else '176'}px;{OUT}}}
{HK}
{LB}
</style><div class="dim"></div>
<div class="txt"><div class="kick">{L[0]}</div><div class="l1">{L[1]}</div><div class="l2">{L[2]}</div><div class="l3">{L[3]}</div></div>
<img class="hk3" src="{hk}"><div class="label">{label}</div>"""
    if kind == 'bold':    # ChatGPT 案の構図(左に大きなハコブくんと吹き出し、右に縁取りの太い文字)を、本物の写真と動画の文字で作る
        L = ns.get('BOLD_LINES', [kicker] + lines)
        rows = ''.join(f'<div class="r{i}">{t}</div>' for i, t in enumerate(L))
        return f"""<style>{BASE}
body{{background:#151515}}
.ph{{position:absolute;left:700px;top:-30px;width:2040px;height:1148px;background:url({photo}) 0 50%/cover}}
.fade{{position:absolute;inset:0;background:linear-gradient(90deg,#151515 0%,#151515 36%,rgba(21,21,21,0) 50%),linear-gradient(180deg,rgba(0,0,0,.35) 0%,rgba(0,0,0,0) 55%)}}
.txt{{position:absolute;right:50px;top:70px;text-align:right;font-weight:900;line-height:1.08;letter-spacing:-.01em;color:#fff;
 -webkit-text-stroke:26px {INK};paint-order:stroke fill}}
.r0{{font-size:92px}} .r1{{font-size:156px;color:{RED};margin-top:14px}} .r2{{font-size:190px;margin-top:6px}}
.r1 .red{{color:{RED}}}
.big{{position:absolute;left:30px;bottom:-50px;height:760px}}
.bubble{{position:absolute;left:110px;top:70px;background:#fff;border:8px solid {INK};border-radius:22px;padding:14px 34px;font-size:76px;font-weight:900;color:{INK}}}
.bubble:after{{content:'';position:absolute;left:150px;bottom:-44px;border:22px solid transparent;border-top:22px solid {INK}}}
</style><div class="ph"></div><div class="fade"></div><img class="big" src="{hk}"><div class="bubble">{label}</div><div class="txt">{rows}</div>"""
    raise SystemExit(f'案の名前が分かりません: {kind}')


outs = []
with sync_playwright() as p:
    b = p.chromium.launch()
    pg = b.new_page(viewport={'width': 1920, 'height': 1080})
    for kind in ns.get('VARIANTS', ['split', 'card', 'dark']):
        pg.set_content('<!doctype html><html><head><meta charset="utf-8"></head><body>' + html(kind) + '</body></html>')
        pg.wait_for_timeout(300)
        big = f'thumb/_{kind}_1920.png'
        pg.screenshot(path=big)
        im = Image.open(big).convert('RGB').resize((1280, 720), Image.LANCZOS)
        out = f'thumb/{kind}.png'
        im.save(out, optimize=True)
        if os.path.getsize(out) > 2_000_000:
            out = f'thumb/{kind}.jpg'; im.save(out, quality=92)
        os.remove(big)
        outs.append((kind, out))
    b.close()

# 一覧: 原寸の半分と、スマホの一覧で出る大きさ(幅 168px 前後)を並べる
W = 640 + 24 + 168
sheet = Image.new('RGB', (W, len(outs) * (360 + 24)), (30, 30, 30))
for k, (kind, out) in enumerate(outs):
    im = Image.open(out)
    y = k * (360 + 24)
    sheet.paste(im.resize((640, 360), Image.LANCZOS), (0, y))
    sheet.paste(im.resize((168, 94), Image.LANCZOS), (640 + 24, y))
sheet.save('thumb/一覧.png')
for kind, out in outs:
    print(kind, out, f'{os.path.getsize(out) / 1e6:.2f}MB')
_制作ベース/hakobu/make_new_face.py
新規。作り直した体の画面に、動画と同じ描き方の顔を写す(64行)。
"""新しい体(cut_new.png)のディスプレイに、動画と同じ顔を描く。サムネイル用(2026-10-12)
2026-10-12 エイイチの指摘「顔が変(口と目の配置や大きさ)」で作り直し:
  自前で描いた目と口をやめ、動画の hakobu.py と同じ描き方(eye_mask / mouth_mask)で描いた顔を、
  動画のディスプレイ(SCREEN_QUAD を長方形にならしたもの)から新しい体のディスプレイ(screen_quad_new.npy)へ写す。
  画面の大きさに対する目と口の大きさ・位置は、動画のハコブくんとそのまま同じになる
使い方: python3 make_new_face.py [目 口]   例: python3 make_new_face.py open mid(既定)
"""
import os, sys
import numpy as np, cv2
from PIL import Image
HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, os.path.dirname(HERE))
import hakobu as hk


def face_on_new_body(eyes=('open', 'open'), mouth='mid', out='body_new_face.png'):
    im = np.array(Image.open(os.path.join(HERE, 'cut_new.png'))).astype(np.float32)
    q = np.load(os.path.join(HERE, 'screen_quad_new.npy')).astype(np.float32)   # 左上・右上・右下・左下
    SS, FX0, FY0, FX1, FY1 = hk.SS, hk.FX0, hk.FY0, hk.FX1, hk.FY1
    hh, ww = (FY1 - FY0) * SS, (FX1 - FX0) * SS
    # 1. 動画と同じ描き方で、顔を画面での向きに描く
    white = np.zeros((hh, ww), np.uint8)
    for kind, box, side in ((eyes[0], hk.V_EYE_LEFT, -1), (eyes[1], hk.V_EYE_RIGHT, 1)):
        em = np.zeros_like(white)
        hk.eye_mask(em, kind, box, side, 0.0)
        white = np.maximum(white, em)
    blue = hk.mouth_mask(mouth)
    la = np.zeros((hh, ww, 4), np.float32)
    la[white > 0, :3] = hk.WHITE
    la[..., 3] = white
    la[blue > 0, :3] = hk.BLUE
    la[..., 3] = np.maximum(la[..., 3], blue)
    la = np.ascontiguousarray(la[:, ::-1])          # 動画と同じく反転して、体の元の向きに戻す
    # 2. 動画のディスプレイをならした長方形(hakobu.py の flat)→ 新しい体のディスプレイ
    S = hk.SCREEN_QUAD
    c = S.mean(0)
    w_ = (np.linalg.norm(S[1] - S[0]) + np.linalg.norm(S[2] - S[3])) / 2
    h_ = (np.linalg.norm(S[3] - S[0]) + np.linalg.norm(S[2] - S[1])) / 2
    flat = np.float32([[c[0] - w_ / 2, c[1] - h_ / 2], [c[0] + w_ / 2, c[1] - h_ / 2],
                       [c[0] + w_ / 2, c[1] + h_ / 2], [c[0] - w_ / 2, c[1] + h_ / 2]])
    src = (flat - np.float32([FX0, FY0])) * SS
    M = cv2.getPerspectiveTransform(src, q)
    h, w = im.shape[:2]
    a = la[..., 3:4] / 255
    pre = np.concatenate([la[..., :3] * a, a * 255], 2)
    wl = cv2.warpPerspective(pre, M, (w, h), flags=cv2.INTER_AREA)
    aa = wl[..., 3:4] / 255
    rgb = np.where(aa > 1e-4, wl[..., :3] / np.maximum(aa, 1e-4), 0)
    # 3. 目のまわりのにじむ光(動画と同じ色。体の大きさに合わせてぼかしを広げる)
    scale = np.linalg.norm(q[1] - q[0]) / w_
    eye_a = aa[..., 0] * (rgb[..., 0] > 200)
    glow = cv2.GaussianBlur(eye_a, (0, 0), 2.6 * scale) * 0.75
    for col, al in ((np.float32([205, 225, 255]), glow[..., None]), (rgb, aa)):
        im[..., :3] = im[..., :3] * (1 - al) + col * al
    Image.fromarray(im.clip(0, 255).astype(np.uint8)).save(os.path.join(HERE, out))
    return out


if __name__ == '__main__':
    args = sys.argv[1:]
    if len(args) == 2:
        print(face_on_new_body((args[0], args[0]), args[1]))
    else:
        print(face_on_new_body())
フィジカルAIの現在地/narration.py
台本。1文ごとに(場面、表情、字幕、後ろの間)。読み替えの表 READ と ELEVEN_READ もここ(186行)。
# -*- coding: utf-8 -*-
# 台本「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」ハコブくん版
# もとは DAY330 の試作(codex の敵対的検証を反映した版)。2026-10-12 に、ハコブくんが話す形(エイイチは三人称)に直した。
# 変えたのは、一人称→三人称、自己紹介(確定した文言)、見立ての入り方、NEO の確認日(10月12日)、アウトロ、1文ごとの表情。事実と数字は変えていない
# 各要素: (場面の名前, 表情, 字幕の文, 後ろの間[秒])  間を省略すると 0.35 秒
# 字幕の文の中の「|」: 読み上げは1文のまま、字幕だけをそこで次の枚に替える
FACES = ("base", "smile", "surprise", "doubt", "think", "trouble", "joy", "wink")

SEGS = [
 ('hook_ship', 'base', '調査会社Counterpointの推計では、今年の上半期に出荷された人型ロボットは、'),
 ('hook_ship', 'base', '世界で2万2000台を超えました。前の年の同じ時期の、およそ4倍です。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('hook_forecast', 'surprise', '年末までには、5万台を超えると予想されています。'),
 ('hook_forecast', 'base', '家事をする人型ロボットの予約販売も、去年の秋から始まっています。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('hook_question', 'base', 'こういうニュースを見ると、ChatGPTが出たときみたいに、'),
 ('hook_question', 'doubt', 'ロボットも一気に賢くなって、家に来るのはもうすぐ、って感じませんか。', 1.8),  # 大きな流れの変わり目の間
 ('title', 'smile', 'Pixels to Motors。案内役のハコブくんです。'),
 ('title', 'base', 'この番組では、フィジカルAIを、現場で使える形にするまでを解説します。'),
 ('title_eiichi', 'base', 'エイイチは、本業のデザイナーをしながら、ロボティクスの研究と開発をしています。|その中で分かったことと、そこから考えた見立てを、ハコブくんがお伝えします。', 1.8),  # 大きな流れの変わり目の間
 ('question', 'surprise', '今日の問いは、ロボットにもChatGPTのような瞬間は、もう来たのか、です。'),
 ('question', 'base', 'ここでいうChatGPTの瞬間は、専門家じゃなくても、'),
 ('question', 'base', 'いろんな仕事にすぐ使えるようになる転換点、という意味です。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('define', 'base', 'フィジカルAIっていうのは、現実の世界を認識して、行動するAIのことです。'),
 ('define', 'base', '自動運転もここに入りますが、'),
 ('define', 'base', '今日は主に、アームや人型ロボットが物を扱う話に絞ります。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('answer', 'base', '先に結論を言っちゃうと、写真を見せて判断させる入口は、ぐっと簡単になりました。'),
 ('answer', 'trouble', 'でも、物を確実に動かすところは、まだ手間がかかるんですよ。'),
 ('answer', 'base', 'その手間は大きく2つあります。'),
 ('answer', 'base', '動作と結びついたデータが集めにくいこと。そして、機体や環境とのすり合わせです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('stance', 'base', '先に言っておくと、フィジカルAIはまだ使えない、と言いたいわけじゃないんです。'),
 ('stance', 'base', 'どこまで来ていて、どこで手間がかかっているのかを、分けて見たいんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('toc', 'base', '大きく3つあります。'),
 ('toc', 'base', '出荷が4倍になったロボットは、何をしているのか。'),
 ('toc', 'base', 'エイイチの机の上のロボットアームで、何が簡単で、何が難しかったのか。'),
 ('toc', 'base', 'そして、データの壁はどれくらい高くて、誰がどう越えようとしているのか。'),
 ('toc', 'base', '最後に、エイイチの見立てを話します。', 1.8),  # 大きな流れの変わり目の間
 ('c1', 'base', '1つ目、出荷が4倍になったロボットは、何をしているのか、です。', 1.7),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('use', 'base', 'Counterpointの推計では、出荷された人型ロボットの6割以上が、'),
 ('use', 'base', '展示やイベントで動きを見せる用途と、研究やデータ生産の用途なんですよ。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('datacollect', 'base', 'データ生産っていうのは、ロボットが学ぶための動きの記録を作ることです。'),
 ('datacollect', 'base', '人が遠隔で動かして記録するやり方も、自律で動いた記録を残すやり方もあります。'),
 ('datacollect', 'doubt', 'ただ、研究向けの台数が全部データ集めに使われる、という意味ではありません。'),
 ('datacollect', 'base', 'それでも、用途の分類に「データ生産」という項目があること自体が、'),
 ('datacollect', 'base', '今の段階をよく表していると思います。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('conflict', 'base', '一方で、別の調査会社のSmart Analytics Globalは、'),
 ('conflict', 'base', '同じ半年の出荷を約1万9100台と推計していて、'),
 ('conflict', 'base', '産業・商業用途が7割を超えた、としています。'),
 ('conflict', 'base', '総数も分類も違うので、この2つは、単純な裏表としては比べられません。'),
 ('conflict', 'doubt', 'それに、出荷台数は、そのまま自律的に働いている台数でもないんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('china', 'surprise', 'もう1つ、SAGの推計では、出荷の97%以上が中国のメーカーです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('neo', 'base', '家のほうも見てみます。'),
 ('neo', 'base', 'アメリカの1Xという会社は、家事をする人型ロボット、NEOの予約を、去年の10月に始めました。'),
 ('neo', 'base', '2万ドルの早期購入枠は、今年配送の予定で、月499ドルのプランは、その後です。'),
 ('neo', 'base', '最初は基本的な自律機能だけで、知らない作業は、'),
 ('neo', 'base', '予約した時間に、1Xの担当者が遠隔で手伝う仕組みなんですよ。'),
 ('neo', 'base', '10月12日の時点で、一般のお客さんへの配送開始を示す公式発表は、'),
 ('neo', 'base', 'エイイチが確認した範囲では、見つかっていません。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('neo_point', 'surprise', 'これ、ちょっと考えさせられませんか。'),
 ('neo_point', 'think', '売っているのはロボットだけじゃなくて、遠隔で手伝う人と、'),
 ('neo_point', 'think', 'そこで動きを覚えていく仕組みごとなんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('bridge1', 'base', '工場でも家でも、使いながらデータを集める動きが出てきているんですよ。'),
 ('bridge1', 'doubt', 'じゃあ、物を動かすのは、何がそんなに大変なのか。'),
 ('bridge1', 'base', 'まず、エイイチの机の上の話をします。', 1.8),  # 大きな流れの変わり目の間
 ('c2', 'base', '2つ目、エイイチの机の上のロボットアームで、何が簡単で、何が難しかったのか、です。', 1.7),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('v_real', 'base', 'ここは、エイイチ自身の話から始めます。'),
 ('v_real', 'base', 'エイイチは自宅の机で、mechArm 270という小さなロボットアームを動かしています。'),
 ('v_real', 'base', '赤いブロックを掴んで、箱に置く。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('trials', 'base', 'それだけの作業を、失敗も含めて650回以上試して、全部台帳に残しています。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('easy', 'smile', 'まず、簡単だったほうから話します。掴めたかどうかの判定です。'),
 ('easy', 'smile', 'iPhoneで撮った写真をAIに見せて、「ブロックを掴めていますか」と聞くと、'),
 ('easy', 'joy', 'はい、いいえで答えが返ってくる。この入口は、驚くほど簡単でした。'),
 ('easy', 'doubt', 'ただ、答えが返ることと、毎回正しいことは別です。'),
 ('easy', 'smile', 'どこまで任せられるかは、失敗例も含めて確かめる必要があります。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('hard', 'trouble', '難しかったのは、動かすほうでした。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('gap', 'base', 'ロボットアームの爪先がどこに来るかは、普通は関節の角度から計算で出します。'),
 ('gap', 'base', 'ところが、ikpyという計算ツールで出した爪先の位置と、', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('v_twin', 'base', 'パソコンの中に作ったアームの分身、デジタルツインで動かした位置が、', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('gap', 'surprise', 'エイイチの設定では、同じ関節の角度なのに、30cm以上食い違ったんです。'),
 ('gap', 'doubt', 'これは、アームが30cm外れた、という意味ではありません。'),
 ('gap', 'base', '計算ツールには、グリッパーの形も、デジタルツインの物理も入っていなくて、爪先の位置の決め方そのものが違っていたんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('v_scan', 'base', 'そこでエイイチは、分身の中でアームを動かして、'),
 ('v_scan', 'base', '関節の角度と爪先の位置の対応表を作りました。'),
 ('v_scan', 'base', 'これは計算の表で、実機で全部の点を測ったわけではありません。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('silent', 'trouble', 'もう1つ困ったのが、黙る失敗です。'),
 ('silent', 'trouble', 'エイイチの機体とソフトの組み合わせでは、肩の関節に、90度ちょっとを超える値を送ると、'),
 ('silent', 'trouble', 'エラーが出ないのに、アームが動かないことがありました。'),
 ('silent', 'trouble', 'ログを1行ずつ見て、やっと気づきました。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('point2', 'surprise', 'でも、ポイントはここなんです。'),
 ('point2', 'think', 'この2つは、AIの学習データが足りない、という話とは別です。'),
 ('point2', 'think', 'モデルや制御が、エイイチの機体と噛み合っているかを確かめる、すり合わせの仕事でした。'),
 ('point2', 'think', 'ほかの環境で学んだことを持ってくる研究も進んでいます。'),
 ('point2', 'think', 'それでも、エイイチの構成でちゃんと動くかは、ここで確かめるしかなかったんです。', 0.6),
 ('point2', 'think', 'じゃあ、もう1つの手間、データのほうは、業界全体でどうなっているのか。', 1.8),  # 大きな流れの変わり目の間
 ('c3', 'base', '3つ目、データの壁はどれくらい高くて、誰がどう越えようとしているのか、です。', 1.7),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('years', 'base', 'カリフォルニア大学バークレー校のロボット研究者、'),
 ('years', 'base', 'ケン・ゴールドバーグさんが、去年、こんな概算を紹介しています。'),
 ('years', 'base', '画像と言葉を扱うAIの学習資料を、'),
 ('years', 'base', '人が読んだり見たりする時間に換算すると、約10万年規模になる。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('wall', 'trouble', 'それに比べて、ロボットが手を動かすための、動作と結びついた経験は、集めにくい。'),
 ('wall', 'trouble', 'ゴールドバーグさんは、これを「10万年のデータの壁」と呼んでいます。'),
 ('wall', 'trouble', 'ただ、ロボットにも同じ量が必要だと分かったわけではありません。'),
 ('wall', 'trouble', '集めにくい、という問題提起なんです。', 0.6),
 ('wall', 'doubt', 'ここで、じゃあロボットにChatGPTの瞬間は当分来ない、'),
 ('wall', 'smile', 'と言いたくなるじゃないですか。でも、ちょっと待ってほしいんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('gen', 'base', 'アメリカのGeneralistという会社は、人が手で作業する様子を、'),
 ('gen', 'base', '安い装着型の機材で記録して集めています。'),
 ('gen', 'surprise', '会社の発表では、去年の11月に27万時間、今年の4月に50万時間を超えました。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('gen2', 'base', 'さらに8月には、簡単で短い作業なら、'),
 ('gen2', 'base', '数秒の実演を見せるだけで、新しい作業をこなす例も発表しています。'),
 ('gen2', 'doubt', 'ただ、本人たちも、作業は簡単で短く、成功率はまだ控えめだと書いています。'),
 ('gen2', 'base', 'それでも、「動かすには毎回大量の専用データが必要」とは、言い切れなくなってきました。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('compare', 'think', 'ここで1つ、注意があります。'),
 ('compare', 'base', '作業を記録した時間と、10万年という数字は、そのまま比べられません。'),
 ('compare', 'base', '何倍足りないかより、いろんな場面の経験を、どれだけ広く集められるかが問題なんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('dirt', 'think', 'つまり、壁はまだ高い。でも、壁の前でみんなが土を積み始めている。'),
 ('dirt', 'think', '1Xが家の中で遠隔で手伝いながら動きを覚えさせているのも、'),
 ('dirt', 'think', 'Generalistが人の手作業を記録しているのも、同じ壁に向かっている動きなんです。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('notall', 'smile', 'ただ、ここで「なんだ、まだ全然ダメなのか」で'),
 ('notall', 'smile', '片付けてしまうのも違うんです。'),
 ('notall', 'smile', '写真を見せて判断させる入口は、エイイチの机の上でも、もう普通に使えています。', 0.6),
 ('notall', 'doubt', 'じゃあ、この2つが混ざっている今、ロボットのニュースの何を見ればいいのか。', 1.8),  # 大きな流れの変わり目の間
 ('c4', 'base', 'ここからは、エイイチの見立てです。', 1.7),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('q', 'surprise', 'ロボットのニュースを見たときの問いが、2つに変わるんですよ。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('q1', 'base', '1つは、そのロボットは自律で動いているのか、人が遠隔で動かしているのか、です。'),
 ('q1', 'base', 'デモ動画を見るときは、自律か遠隔操作か、'),
 ('q1', 'base', '再生速度や、人が手を出した条件が書かれているかを見ます。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('q2', 'base', 'もう1つは、その仕事は「見て判断する」で済むのか、'),
 ('q2', 'base', '「触れて動かす」精度が要るのか、です。'),
 ('q2', 'base', '棚の商品が足りているかを見るのは、前者です。'),
 ('q2', 'base', '柔らかい物を潰さずに掴むのは、後者です。'),
 ('q2', 'base', '前者は、手軽に試せるところまで来ています。ただ、どこまで任せられるかは、現場で確かめる必要がある。'),
 ('q2', 'base', '後者は、その現場の機体と環境に合わせて、すり合わせる仕事が、まだ残っています。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('gofe', 'base', 'ゴールドバーグさんは、昔ながらのエンジニアリングと学習を組み合わせて、'),
 ('gofe', 'base', '現場で役に立つ仕事をしながら、データを集めていくのが近道だ、と言っています。'),
 ('gofe', 'base', 'エイイチの机の上も、AIと従来の制御を組み合わせる点では通じています。'),
 ('gofe', 'base', 'ただ、現場で働きながらデータが増える仕組みとは、まだ規模も段階も違います。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('motion', 'base', '作る側から見ると、もう1つあります。'),
 ('motion', 'base', 'データの話と並行して、もう1つ要るのが「どう動くか」の設計です。'),
 ('motion', 'base', '例えばロボットが人に物を渡すとき、'),
 ('motion', 'base', '何秒待って手を開けば、人は安心して受け取れるのか。'),
 ('motion', 'base', 'これは、成功か失敗かの判定だけでは出てこない。'),
 ('motion', 'base', '人が安心できる動きを設計する仕事も、同時に必要だと、エイイチは見ています。', 1.8),  # 大きな流れの変わり目の間
 ('answer2', 'base', 'じゃあ、冒頭の問いに答えますね。', 0.4),
 ('answer2', 'base', 'エイイチの机の上では、写真を見せて判断させる入口は、ずっと簡単になりました。'),
 ('answer2', 'base', '一方、物を確実に動かすには、機体や環境とのすり合わせが、まだ必要でした。'),
 ('answer2', 'base', 'その負担を減らす研究は、急速に進んでいます。'),
 ('answer2', 'trouble', 'でも、いろんな家で、安全に家事を任せられる転換点まで来たかは、まだ判断できません。', 1.2),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('action', 'base', 'ロボットのデモ動画を見たら、'),
 ('action', 'base', '「これは自律なのか、何回やって、何回うまくいったのか」を、'),
 ('action', 'base', '一度だけ考えてみてください。'),
 ('action', 'smile', 'それだけで、同じ動画の見え方が、かなり変わると思います。', 1.8),  # 大きな流れの変わり目の間
 ('outro', 'smile', '今日はここまでです。'),
 ('outro', 'base', 'この動画が気に入ったら、高評価とチャンネル登録をお願いします。'),
 ('outro', 'base', 'ロボットの開発や導入の相談は、概要欄の連絡先から、エイイチに直接どうぞ。'),
 ('outro', 'wink', 'コメントは、エイイチが全部読んでいます。それではまた。', 1.7),  # 場面の切り替えの前の一拍(ホワーンの前)
 ('sources', 'smile', '', 6.0),
]

# 仮音声(Open JTalk)用の読み(字幕は元の表記のまま)
READ = [('Pixels to Motors', 'ピクセルズ トゥー モーターズ'), ('Smart Analytics Global', 'スマート アナリティクス グローバル'), ('Counterpoint', 'カウンターポイント'), ('ChatGPT', 'チャットジーピーティー'), ('Generalist', 'ジェネラリスト'), ('mechArm 270', 'メックアーム ニーナナゼロ'), ('iPhone', 'アイフォーン'), ('ikpy', 'アイケーパイ'), ('NEO', 'ネオ'), ('1X', 'ワンエックス'), ('SAG', 'エスエージー'), ('AI', 'エーアイ'), ('30cm', 'さんじゅっセンチ'), ('爪先', 'つめさき'), ('1万9100台', 'いちまんきゅうせんひゃくだい'), ('値を送る', 'あたいを送る'), ('フィジカルAI', 'フィジカルエーアイ'), ('「', ''), ('」', ''), ('|', '')]

# ElevenLabs の声で読み間違えた語だけ、読みを直す(tts_eleven.py が使う。字幕は変えない)
ELEVEN_READ = [
    ('エイイチ', 'えいいち'),   # 2026-10-12 カタカナだと文ごとに抑揚が変わった。ひらがなで語尾が下がる読みにそろう(エイイチが4通りを聞き比べて決めた)
    ('裏表', 'うらおもて'),   # 2026-10-12 37番で「うらおもてうら」のように読まれた(エイイチが見つけた)
]

# 仮音声の間延び対策:ひと息が長い文だけ、読み上げ用に読点を足す(字幕は変えない)
OVERRIDE = {'同じ半年の出荷を約1万9100台と推計していて、': '同じ半年の出荷を、約1万9100台と、推計していて、', '工場でも家でも、使いながらデータを集める動きが出てきているんですよ。': '工場でも家でも、使いながら、データを集める動きが、出てきているんですよ。', 'ほかの環境で学んだことを持ってくる研究も進んでいます。': 'ほかの環境で学んだことを、持ってくる研究も、進んでいます。', 'ここで、じゃあロボットにChatGPTの瞬間は当分来ない、': 'ここで、じゃあ、ロボットに、ChatGPTの瞬間は、当分来ない、', '1Xが家の中で遠隔で手伝いながら動きを覚えさせているのも、': '1Xが、家の中で、遠隔で手伝いながら、動きを覚えさせているのも、'}


def reading(t):
    t = OVERRIDE.get(t, t)
    for a, b in READ:
        t = t.replace(a, b)
    return t


def parse(seg):
    """1行を (場面, 表情, 字幕, 間) にそろえる"""
    if len(seg) >= 3 and seg[1] in FACES:
        scene, face, text = seg[0], seg[1], seg[2]
        pause = seg[3] if len(seg) > 3 else 0.35
    else:
        scene, face, text = seg[0], "base", seg[1]
        pause = seg[2] if len(seg) > 2 else 0.35
    return scene, face, text, pause
フィジカルAIの現在地/scenes.py
場面ごとの図と、実機の映像の指定(VIDEO)(363行)。
# -*- coding: utf-8 -*-
# 動画「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」ハコブくん版の場面。共通部品は _制作ベース/scene_kit.py
# 2026-10-12: DAY330 の試作の場面を、ハコブくんの区画(左下)と三人称の台本に合わせて直した
import os as _os, sys as _sys
_here = _os.path.dirname(_os.path.abspath(__file__))
for _c in (_os.environ.get("P2M_BASE", ""), _os.path.join(_here, "..", "base"), _os.path.join(_here, "..", "_制作ベース")):
    if _c and _os.path.exists(_os.path.join(_c, "scene_kit.py")):
        _sys.path.insert(0, _c); break
from scene_kit import *

T1 = "<b>1</b>出荷されたロボットは何をしているのか"
T2 = "<b>2</b>机の上のロボットアームで、簡単だったこと・難しかったこと"
T3 = "<b>3</b>データの壁の高さと、越えようとしている会社"
T4 = "<b>4</b>エイイチの見立て"

S = {}

S["hook_ship"] = page("""
<div class="wrap">
 <div class="kicker">2026年上半期 人型ロボットの世界出荷(推計)</div>
 <div class="hero">22,000<small>台超</small></div>
 <div class="h2" style="margin-top:36px">前年同期の <span class="red">約4倍</span></div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)</div>""")

S["hook_forecast"] = page("""
<div class="wrap">
 <div class="kicker">2026年通年の予想</div>
 <div class="hero">50,000<small>台超</small></div>
 <div class="h3" style="margin-top:44px">家事をする人型ロボットの予約販売も、2025年秋から</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)/1X</div>""")

S["hook_question"] = page("""
<div class="wrap" style="align-items:center;text-align:center">
 <div class="h1">ロボットも、ChatGPTのときみたいに<br><span class="red">一気に賢くなる?</span></div>
</div>""")

S["question"] = page("""
<div class="wrap">
 <div class="pill">今日の問い</div>
 <div class="h1">ロボットにも<span class="red">ChatGPTの瞬間</span>は<br>もう来たのか</div>
 <div class="h3 muted" style="margin-top:44px">ChatGPTの瞬間=専門家でなくても、<br>いろんな仕事にすぐ使えるようになる転換点</div>
</div>""")

S["define"] = page("""
<div class="wrap">
 <div class="kicker">フィジカルAI とは</div>
 <div class="h2">現実の世界を認識して、<span class="red">行動する</span>AI</div>
 <div class="row" style="margin-top:56px;gap:30px">
  <div class="box" style="border:4px solid #0D0D0D">ロボットアーム</div>
  <div class="box" style="border:4px solid #0D0D0D">人型ロボット</div>
  <div class="box muted" style="background:transparent;border:2px dashed #D6D6D1">自動運転<br><span style="font-size:30px">今日は扱わない</span></div>
 </div>
</div>""")

S["answer"] = page(f"""
<div class="wrap">
 <div class="kicker">先に結論</div>
 {two("写真を見せて判断させる入口", "ぐっと簡単になった", "物を確実に動かすところ", "まだ手間がかかる")}
 <div class="h3" style="margin-top:56px">手間は2つ<br>① <span class="red">動作と結びついたデータ</span>が集めにくい<br>② <span class="red">機体や環境とのすり合わせ</span></div>
</div>""")

S["stance"] = page("""
<div class="wrap">
 <div class="h2 muted" style="text-decoration:line-through;text-decoration-thickness:6px">フィジカルAIはまだ使えない</div>
 <div class="h1" style="margin-top:48px">どこまで来ていて、<br>どこで<span class="red">手間がかかっているのか</span>を、<br>分けて見る</div>
</div>""")

S["toc"] = page("""
<div class="wrap">
 <ul class="list">
  <li><span class="n">1</span>出荷が4倍になったロボットは、何をしているのか</li>
  <li><span class="n">2</span>机の上のロボットアームで、何が簡単で何が難しかったか</li>
  <li><span class="n">3</span>データの壁はどれくらい高く、誰がどう越えようとしているか</li>
  <li class="dim"><span class="n">+</span>エイイチの見立て</li>
 </ul>
</div>""")

S["c1"] = chapter("1", "出荷が4倍になったロボットは、<br>何をしているのか")
S["c2"] = chapter("2", "机の上のロボットアームで、<br>何が簡単で、何が難しかったのか")
S["c3"] = chapter("3", "データの壁はどれくらい高くて、<br>誰がどう越えようとしているのか")
S["c4"] = chapter("4", "エイイチの見立て")

S["use"] = page(f"""
<div class="wrap">
 <div class="kicker">2026年上半期の人型ロボット出荷の用途(Counterpointの推計)</div>
 {hbar([("展示・イベント + 研究・データ生産 6割以上", 62, RED, "#fff"), ("その他", 38, "#D3D3CE", INK)])}
 <div class="h3" style="margin-top:44px">出荷の <span class="red">6割以上</span> が、<br>動きを見せる用途と、研究・データ生産の用途</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)。帯の長さは「6割以上」を表す目安</div>""", tag=T1)

S["datacollect"] = page(f"""
<div class="wrap">
 <div class="kicker">データ生産 = ロボットが学ぶための、動きの記録を作ること</div>
 <div class="row" style="gap:30px">
  <div class="box">人が遠隔で動かして<br>記録する</div>
  <div class="box">自律で動いた記録を<br>残す</div>
 </div>
 <div class="h3 muted" style="margin-top:40px">※研究向けの台数が、全部データ集めに使われるわけではない</div>
 <div class="h3" style="margin-top:20px">分類に「データ生産」がある = 今の段階を表している</div>
</div>""", tag=T1)

S["conflict"] = page(f"""
<div class="wrap">
 <div class="kicker">同じ2026年上半期の推計</div>
 {two("Counterpoint", "見せる用途+研究・データ生産<br>6割以上", "Smart Analytics Global(SAG)", "産業・商業用途<br>7割超", c1="", c2="", size=52, note1="出荷 22,000台超", note2="出荷 約19,100台")}
 <div class="h3" style="margin-top:46px">総数も分類も違う → <span class="red">単純な裏表としては比べられない</span></div>
 <div class="h3 muted" style="margin-top:10px">出荷台数 ≠ 自律的に働いている台数</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)/Smart Analytics Global(2026年8月)</div>""", tag=T1)

S["china"] = page("""
<div class="wrap">
 <div class="kicker">2026年上半期の人型ロボット出荷のうち、中国メーカーの割合(SAGの推計)</div>
 <div class="hero">97<small>%以上</small></div>
</div>
<div class="src">出典:Smart Analytics Global(2026年8月)</div>""", tag=T1)

S["neo"] = page(f"""
<div class="wrap">
 <div class="kicker">1X「NEO」 家事をする人型ロボット(2025年10月 予約開始)</div>
 {two("値段と配送", "2万ドル:2026年配送予定<br>月499ドル:その後", "動き方", "最初は基本的な自律機能<br>知らない作業は<br>担当者が遠隔で手伝う", c1="", c2="", size=46)}
 <div class="h3" style="margin-top:40px">2026年10月12日時点:一般顧客への配送開始の公式発表は<span class="red">確認できず</span></div>
</div>
<div class="src">出典:1X 公式の発表・注文ページ(2026年10月12日確認)</div>""", tag=T1)

S["neo_point"] = page(f"""
<div class="wrap">
 <div class="kicker">売っているのは</div>
 <div class="flow">
  <div class="box">ロボット</div><div class="arrow">+</div>
  <div class="box">遠隔で<br>手伝う人</div><div class="arrow">+</div>
  <div class="box" style="border:4px solid {RED}">動きを<br>覚えていく仕組み</div>
 </div>
</div>""", tag=T1)

S["bridge1"] = page("""
<div class="wrap">
 <div class="h2">工場でも家でも、<br><span class="red">使いながらデータを集める</span>動き</div>
 <div class="h2 muted" style="margin-top:56px">では、物を動かすのは<br>何がそんなに大変なのか</div>
</div>""", tag=T1)

S["trials"] = page("""
<div class="wrap">
 <div class="kicker">赤いブロックを掴んで、箱に置く</div>
 <div class="hero">650<small>回以上</small></div>
 <div class="h3" style="margin-top:36px">失敗も含めた試行回数。全部台帳に記録</div>
</div>
<div class="src">PICK→PLACE の通し試行(台帳 pick_place_ledger_v3.csv、2026年6月18日〜7月20日で656回)</div>""", tag=T2)

S["easy"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{BLUE}">簡単だった:掴めたかの判定</div>
 <div class="flow">
  <div class="box">iPhoneで<br>撮った写真</div><div class="arrow">→</div>
  <div class="box" style="flex:1.5">AIに聞く<br><span style="font-size:32px;white-space:nowrap" class="muted">「ブロックを掴めていますか」</span></div><div class="arrow">→</div>
  <div class="box" style="border:4px solid {BLUE}"><span class="blue">はい</span>/いいえ</div>
 </div>
 <div class="h3" style="margin-top:48px">ただし、<span class="red">答えが返る ≠ 毎回正しい</span></div>
</div>""", tag=T2)

S["hard"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">難しかった</div>
 <div class="h1">動かすほう</div>
</div>""", tag=T2)

S["gap"] = page(f"""
<div class="wrap">
 <div class="kicker">エイイチの設定で、同じ関節の角度を入れたときの爪先の位置</div>
 <div style="position:relative;height:400px;margin-top:10px">
  <div style="position:absolute;left:60px;top:250px;right:60px;height:4px;background:{RULE}"></div>
  <div style="position:absolute;left:150px;top:218px;width:68px;height:68px;border-radius:50%;background:#fff;border:8px solid {SUB}"></div>
  <div style="position:absolute;left:4px;top:310px;width:440px;text-align:center;font-size:36px;font-weight:700;color:{SUB}">計算ツール(ikpy)</div>
  <div style="position:absolute;right:150px;top:218px;width:68px;height:68px;border-radius:50%;background:{RED}"></div>
  <div style="position:absolute;right:4px;top:310px;width:440px;text-align:center;font-size:36px;font-weight:700;color:{RED}">デジタルツイン</div>
  <div style="position:absolute;left:184px;right:184px;top:140px;height:4px;background:{INK}"></div>
  <div style="position:absolute;left:182px;top:120px;width:4px;height:44px;background:{INK}"></div>
  <div style="position:absolute;right:182px;top:120px;width:4px;height:44px;background:{INK}"></div>
  <div style="position:absolute;left:0;right:0;top:20px;text-align:center;font-size:72px;font-weight:900"><span class="red">30cm以上</span> 食い違う</div>
 </div>
 <!-- 2026-10-12 説明の1行が右にはみ出して「グリッパ/ー」で折り返していたので、図の下に2行で中央にそろえた(DAY330 で足した説明。内容は同じ) -->
 <div class="h3" style="text-align:center;font-size:38px;margin-top:-10px">アームが外れた距離ではない。<span class="red">爪先の位置の決め方</span>が違っていた</div>
 <div class="h3 muted" style="text-align:center;font-size:32px;margin-top:10px">計算ツールには、グリッパーの形が入っていない</div>
</div>
<div class="src">図は模式図</div>""", tag=T2)

S["silent"] = page(f"""
<div class="wrap">
 <div class="pill">黙る失敗</div>
 <div class="flow">
  <div class="box">肩の関節に<br><span class="red">90度ちょっと</span>を超える値</div><div class="arrow">→</div>
  <div class="box">エラーは出ない<br>アームも動かない</div>
 </div>
 <div class="h3 muted" style="margin-top:44px">エイイチの機体とソフトの組み合わせで起きたこと</div>
</div>""", tag=T2)

S["point2"] = page("""
<div class="wrap">
 <div class="kicker">この2つは</div>
 <div class="h2 muted" style="text-decoration:line-through;text-decoration-thickness:5px">AIの学習データが足りない</div>
 <div class="h1" style="margin-top:30px"><span class="red">すり合わせ</span>の仕事</div>
 <div class="h3" style="margin-top:20px">モデルや制御が、自分の機体と噛み合っているかを確かめる</div>
</div>""", tag=T2)

S["years"] = page("""
<div class="wrap">
 <div class="kicker">画像と言葉を扱うAIの学習資料を、人が読む・見る時間に換算すると</div>
 <div class="hero">約10<small>万年規模</small></div>
</div>
<div class="src">出典:Ken Goldberg, Science Robotics(2025年8月, Editorial)</div>""", tag=T3)

S["wall"] = page(f"""
<div class="wrap">
 <div class="h1">10万年の<span class="red">データの壁</span></div>
 <div style="margin-top:50px">{two("画像と言葉", "大量にある", "動作と結びついた経験", "集めにくい", size=58)}</div>
 <div class="h3 muted" style="margin-top:40px">※ロボットにも同じ量が必要だと分かったわけではない</div>
</div>
<div class="src">出典:Ken Goldberg, Science Robotics(2025年8月)</div>""", tag=T3)

S["gen"] = page(f"""
<div class="wrap">
 <div class="kicker">Generalist が集めた、人の手作業の記録(会社の発表)</div>
 <div style="display:flex;flex-direction:column;gap:30px;margin-top:10px">
  <div style="display:flex;align-items:center;gap:30px"><div style="width:260px;font-size:36px;font-weight:700;color:{SUB}">2025年11月</div>
   <div style="width:{int(1060*27/50)}px;height:110px;background:#D3D3CE;border-radius:0 6px 6px 0"></div><div style="font-size:52px;font-weight:900;white-space:nowrap">27万時間</div></div>
  <div style="display:flex;align-items:center;gap:30px"><div style="width:260px;font-size:36px;font-weight:700;color:{SUB}">2026年4月</div>
   <div style="width:1060px;height:110px;background:{RED};border-radius:0 6px 6px 0"></div><div style="font-size:52px;font-weight:900;white-space:nowrap">50万時間超</div></div>
 </div>
 <div class="h3" style="margin-top:44px">安い装着型の機材で記録</div>
</div>
<div class="src">出典:Generalist(GEN-0 2025年11月/GEN-1 2026年4月)</div>""", tag=T3)

S["gen2"] = page("""
<div class="wrap">
 <div class="kicker">Generalist GEN-1.5(2026年8月)</div>
 <div class="h2">簡単で短い作業なら、<br><span class="red">数秒の実演</span>で新しい作業をこなす例</div>
 <div class="h3 muted" style="margin-top:40px">本人たちも:作業は簡単で短く、成功率はまだ控えめ</div>
</div>
<div class="src">出典:Generalist「GEN-1.5」(2026年8月19日)</div>""", tag=T3)

S["compare"] = page("""
<div class="wrap">
 <div class="h2">作業を記録した時間と、10万年は<br><span class="red">そのまま比べられない</span></div>
 <div class="h3" style="margin-top:50px"><span class="muted">何倍足りないか</span> より <span class="red">どれだけ広く集められるか</span></div>
</div>""", tag=T3)

S["dirt"] = page("""
<div class="wrap">
 <div class="h2">壁はまだ高い。でも、<br><span class="red">壁の前で土を積み始めている</span></div>
 <ul class="list" style="margin-top:30px">
  <li style="font-size:40px"><span class="n">・</span>1X:家の中で遠隔で手伝いながら、動きを覚えさせる</li>
  <li style="font-size:40px"><span class="n">・</span>Generalist:人の手作業を装着型の機材で記録する</li>
 </ul>
</div>""", tag=T3)

S["notall"] = page(f"""
<div class="wrap">
 {two("写真を見せて判断させる入口", "もう普通に使える", "物を確実に動かす", "すり合わせとデータが<br>まだ要る", size=56)}
 <div class="h3" style="margin-top:48px">「まだ全然ダメ」でも「もう来た」でもない</div>
</div>""", tag=T3)

S["q"] = page("""
<div class="wrap">
 <div class="h1">ロボットのニュースを見る<br><span class="red">問いが2つ</span>に変わる</div>
</div>""", tag=T4)

S["q1"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">問い 1</div>
 <div class="h1">自律で動いているのか、<br>人が遠隔で動かしているのか</div>
 <div class="h3 muted" style="margin-top:36px">デモ動画で見るところ:自律か遠隔か/再生速度/人が手を出した条件</div>
</div>""", tag=T4)

S["q2"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">問い 2</div>
 <div class="h2" style="margin-bottom:40px">その仕事には、どちらが要るのか</div>
 {two("見て判断する", "手軽に試せる<br><span style='font-size:34px;color:#888888'>任せる範囲は現場で確かめる</span>", "触れて動かす精度", "現場の機体と環境に<br>すり合わせる仕事が残る", size=48, note1="例:棚の商品が足りているか見る", note2="例:柔らかい物を潰さずに掴む")}
</div>""", tag=T4)

S["gofe"] = page(f"""
<div class="wrap">
 <div class="kicker">ゴールドバーグさんの近道</div>
 <div class="flow">
  <div class="box">昔ながらの工学<br>+学習</div><div class="arrow">→</div>
  <div class="box">現場で役に立つ<br>仕事をする</div><div class="arrow">→</div>
  <div class="box">働きながら<br>データが増える</div>
 </div>
 <div class="h3" style="margin-top:48px">エイイチの机の上:組み合わせる点は通じる。<span class="muted">規模も段階もまだ違う</span></div>
</div>""", tag=T4)

S["motion"] = page("""
<div class="wrap">
 <div class="kicker">データの話と並行して要るもの</div>
 <div class="h1"><span class="red">どう動くか</span>の設計</div>
 <div class="h3" style="margin-top:36px">ロボットが人に物を渡すとき、<br>何秒待って手を開けば、人は安心して受け取れるのか</div>
 <div class="h3 muted" style="margin-top:28px">成功か失敗かの判定だけでは出てこない</div>
</div>""", tag=T4)

S["answer2"] = page(f"""
<div class="wrap">
 <div class="pill">冒頭の問いへの答え</div>
 {two("写真を見せて判断させる入口", "ずっと簡単になった", "物を確実に動かす", "すり合わせが<br>まだ必要", size=58)}
 <div class="h3" style="margin-top:44px">負担を減らす研究は急速に進んでいる。<br>家で家事を任せられる転換点かは、<span class="red">まだ判断できない</span></div>
</div>""")

S["action"] = page("""
<div class="wrap">
 <div class="kicker">ロボットのデモ動画を見たら</div>
 <div class="h1">自律なのか、何回やって、<br><span class="red">何回うまくいった</span>のか</div>
</div>""")

S["sources"] = page("""
<div class="wrap" style="left:420px;bottom:90px;justify-content:flex-start;top:120px">
 <div class="h2" style="margin-bottom:30px">出典</div>
 <div class="p" style="font-size:29px;line-height:1.75">
 人型ロボットの出荷:Counterpoint Research(2026年8月)/Smart Analytics Global(2026年8月)<br>
 1X NEO:1X 公式の発表・注文ページ(2026年10月12日確認)<br>
 10万年のデータの壁:Ken Goldberg, Science Robotics(2025年8月, Editorial)<br>
 Generalist:GEN-0(2025年11月)、GEN-1(2026年4月)、GEN-1.5(2026年8月)の公式発表<br>
 ほかの機体から学ぶ研究の例:Gemini Robotics 1.5 技術報告(Google DeepMind)<br>
 実機の数字:Pixels to Motors の台帳(pick_place_ledger_v3.csv)、公開記事 DAY257<br>
 <span class="muted">ナレーションは AI 音声(ElevenLabs)。話しているのは Pixels to Motors のキャラクター、ハコブくん</span>
 </div>
</div>""")


# --- 強弱をつける場面の上書き(2026-10-11)---
S["hook_question"] = punch("こういうニュースを見ると", ["ロボットも", "一気に賢くなる?"])
S["answer"] = punch("先に結論", ['見て判断する入口は<span class="blue">簡単に</span>', '物を動かすのは<span class="red">まだ手間</span>'], sub="手間は2つ:動作と結びついたデータ/機体や環境とのすり合わせ", size=110)
S["c1"] = chapter2("1つ目", "出荷の中身", "出荷が4倍になったロボットは、何をしているのか")
S["c2"] = chapter2("2つ目", "机の上の実感", "何が簡単で、何が難しかったのか")
S["c3"] = chapter2("3つ目", "データの壁", "どれくらい高くて、誰がどう越えようとしているのか")
S["c4"] = chapter2("最後に", "ニュースの見方", "エイイチの見立て")
S["china"] = dots(97, "2026年上半期の人型ロボット出荷のうち", "中国メーカー", "97%", note="SAGの推計では「97%以上」", src="出典:Smart Analytics Global(2026年8月)", tag=T1)
S["point2"] = punch("この2つは", ["データ不足じゃない", '<span class="red">すり合わせ</span>の仕事'], sub="モデルや制御が、自分の機体と噛み合っているかを確かめる", tag=T2)
S["wall"] = punch("ゴールドバーグさんの問題提起", ['10万年の', '<span class="red">データの壁</span>'], sub="動作と結びついた経験は集めにくい(同じ量が必要と分かったわけではない)", kc="muted", tag=T3)
S["compare"] = punch("ひとつ注意", ['<span class="muted">何倍足りないか</span>より', '<span class="red">どれだけ広く</span>集めるか'], sub="作業を記録した時間と10万年は、そのまま比べられない", size=110, tag=T3)
S["answer2"] = punch("冒頭の問いへの答え", ['判断する入口は<span class="blue">来た</span>', '家事を任せるのは<span class="red">まだ</span>'], sub="負担を減らす研究は急速に進んでいる", size=110)

O = {
 # 2026-10-12 ハコブくんが話す間は番組とハコブくんの名前、エイイチを紹介する文からエイイチの名前を出す(エイイチの指示)
 "title": overlay('<div class="lt"><img class="a" src="'+LOGO+'"><div class="b">フィジカルAI解説</div><div class="c">案内役:ハコブくん(AI音声)</div></div>'),
 "title_eiichi": overlay('<div class="lt"><img class="a" src="'+LOGO+'"><div class="b">エイイチ</div><div class="c">デザイナー/ロボティクスの研究・開発</div></div>'),
 "v_real": overlay('<div class="cap">実機:mechArm 270-Pi 赤いブロックを掴んで箱に置く</div>'),
 "v_twin": overlay('<div class="cap">パソコンの中のアームの分身(Unity のデジタルツイン)</div>'),
 "v_scan": overlay('<div class="cap">デジタルツインの中で動かして、関節の角度と爪先の位置の対応表を作る</div>'),
 "outro": overlay('<div class="lt"><img class="a" src="'+LOGO+'"><div class="b">相談は概要欄の連絡先から</div><div class="c">高評価・チャンネル登録/コメントはエイイチが全部読んでいます</div></div>'),
}

# 動画シーン: (ソースファイル, 開始秒, 透かし消しの有無)
# src/ の中身(元は iCloud の 動画/ にある。2026-10-12 前の版の動画と1コマずつ照らして確かめた):
#   c1.mov = DAY123.MOV / c2.mov = DAY124.mov(どちらも撮ったままの元の映像。DAY123.mp4・DAY124.mp4 は Clideo の透かし入りで、透かしを消すと右下がモヤモヤになったので使わない。2026-10-12)/ c3.mov = デジタルツイン_260416.mov(アームが並ぶ画面)/ c4.mov = ロボットアーム失敗_260416.mov(アーム1台と箱)
VIDEO = {
 "title": ("src/c1.mov", 0.0, False),
 "title_eiichi": ("src/c1.mov", None, False),   # None = 前の場面(title)の映像の続きから
 "v_real": ("src/c2.mov", 22.0, False),
 "v_twin": ("src/c4.mov", 0.0, False),
 "v_scan": ("src/c3.mov", 0.0, False),
 "outro": ("src/c1.mov", 8.0, False),
}
フィジカルAIの現在地/sound.py
BGM と効果音の置き方(23行)。
# 音の置き方(audio_mix.py が読む。書き方は audio_mix.py の先頭)
# 2026-10-12 冒頭の BGM は ElevenLabs Music で作った bgm_明るいB_2(エイイチが選んだ。説明文は sound/作った記録.jsonl)

# 大きさ: 話している間はナレーションより23dB小さく、間は16dB小さく(2026-10-12 エイイチの指示。-22/-15 から約90%に下げた。明るい曲では -15/-9 だと大きすぎた)
BGM = [
    # 2026-10-12 仕上げ版: 最初から最後まで同じ曲をループで流す(本編・ジングル用の曲は未定)
    dict(file='sound/bgm_明るいB_2.mp3', start=0, end=None, level=-23, gap=-16, fade_in=0.6, fade_out=3.0),
]

SE = [
    # (文番号, 文の頭から何秒後, 音, ナレーションより何dB)
    # 2026-10-12 エイイチの指示で、効果音は場面切り替えのホワーンだけにした(始まりの「しゅっ」は外した)
]

# 場面が切り替わるたびに「ホワーン」(se_rise)を入れる。効果音はこれだけ(2026-10-12 エイイチの指示)
SCENE_SE = dict(file='se_rise', level=-6, offset=-0.15, skip=['title_eiichi'])   # 2026-10-12 エイイチの指示で -12 から 6dB 上げた。title→title_eiichi は同じ映像が続くので鳴らさない

# 大きな流れの変わり目(自己紹介・今日の問い・各章の始まり・答え・アウトロ)は、ホワーンの代わりに別の音を鳴らす。
# 直前の文の後ろに 1.8 秒の間がある(narration.py)。2026-10-12 エイイチの指示
#   自己紹介(title): キラリン(se_chapter_glock。鉄琴の高い3音)… 2026-10-12 エイイチが決定
#   そのほか: ポロロン(se_chapter_marimba。マリンバの上がる3音)… 試し中。場所ごとの使い分けはこれから決める
CHAPTER_SE = dict(file='se_chapter_marimba', files={'title': 'se_chapter_glock'}, level=-8, offset=-0.3,
                  scenes=['title', 'question', 'c1', 'c2', 'c3', 'c4', 'answer2', 'outro'])
フィジカルAIの現在地/thumb.py
サムネイルの文言と写真(14行)。
# サムネイルの文言と背景(thumbnail.py が読む。書き方は thumbnail.py の先頭)
# 2026-10-12 動画と同じ文字・色で作る(エイイチの指示)。文言はタイトル案1に合わせた
PHOTO = 'サムネ素材/素材2_実機のアーム.png'   # 実機のアームが赤いブロックを掴む瞬間(DAY124.mov の28秒)
PHOTO_POS = '6% 50%'   # split の右の面で、ブロックを掴む爪先からアームの根元までが入る位置
HAKOBU = True
LABEL = '本当に?'
KICKER = '人型ロボット出荷 約4倍'
LINES = ['ロボットにも', '<span class="red">ChatGPTの瞬間</span>', 'もう来た?']
VARIANTS = ['photo3']   # 2026-10-12 背景を全部写真に(エイイチの指示。dark/dark2/dark3 → photo2 → photo3)
# photo3 の写真: ハコブくんを左下の隅に置くので、アームが箱の上にいるコマ(左下のマットが空く)。DAY124.mov の39.8秒
PHOTO3 = 'サムネ素材/素材3_箱に置く瞬間.png'
HK_H = 600   # ハコブくんの高さ(1920×1080 のとき。photo2 の 520 より少し大きく)
PHOTO_POS_FULL = '50% 50%'
BOLD_LINES = ['人型ロボット出荷 約4倍', 'ChatGPTの瞬間', 'もう来た?']
フィジカルAIの現在地/概要欄_下書き.md
概要欄の下書き(67行)。
<!--
YouTube の概要欄の下書き(2026-10-12)。{t:文番号} は、その文が始まる時間に置きかわる。
全体を書き出したあと、python3 <_制作ベース>/description.py で 概要欄.txt を作り、それを貼る。
「【要記入:…】」はエイイチが決めて書く。
-->
今年の上半期に出荷された人型ロボットは、世界で2万2000台を超えました。前の年の同じ時期の、およそ4倍です(Counterpoint の推計)。

ロボットにも、ChatGPT のような瞬間はもう来たのか。

先に答えを言うと、写真を見せて判断させる入口は、ぐっと簡単になりました。でも、物を確実に動かすところは、まだ手間がかかります。手間は2つ。動作と結びついたデータが集めにくいこと。そして、機体や環境とのすり合わせです。

この動画では、

・出荷が4倍になったロボットは、何をしているのか
・机の上のロボットアームで、何が簡単で、何が難しかったのか
・データの壁はどれくらい高くて、誰がどう越えようとしているのか

の3つを見たうえで、ロボットのニュースを見るときの2つの問いを解説します。

▼目次
0:00 人型ロボットの出荷は4倍。ロボットにもChatGPTの瞬間?
{t:6} この番組について
{t:9} 今日の問いと、先に結論
{t:26} 1. 出荷の中身:4倍になったロボットは何をしているのか
{t:53} 2. 机の上の実感:何が簡単で、何が難しかったのか
{t:83} 3. データの壁:どれくらい高く、誰がどう越えようとしているのか
{t:111} エイイチの見立て:ニュースを見るときの2つの問い
{t:132} 冒頭の問いへの答え
{t:141} エンディング

▼出典
・人型ロボットの出荷:Counterpoint Research(2026年8月20日)の推計
https://counterpointresearch.com/en/insights/global-humanoid-robot-shipments-soar-nearly-300-percent-yoy-in-h1-2026
・同じく出荷の推計:Smart Analytics Global(2026年8月)
・1X NEO:1X 公式の製品・注文ページ(2026年10月12日に確認。一般のお客さんへの配送開始を示す公式発表は、この日の時点で見つかっていない)
https://www.1x.tech/neo
・10万年のデータの壁:Ken Goldberg「GOFE can close the 100,000-year robot data gap」Science Robotics(2025年8月, Editorial)
https://doi.org/10.1126/scirobotics.aea7390
・Generalist の会社の公式発表:GEN-0(2025年11月)、GEN-1(2026年4月)、GEN-1.5(2026年8月)
https://generalistai.com/blog/gen-0
https://generalistai.com/blog/gen-1
https://generalistai.com/blog/gen-1.5
・ほかの機体から学ぶ研究の例:Gemini Robotics 1.5 技術報告(Google DeepMind)
https://arxiv.org/abs/2510.03342
・実機の数字:Pixels to Motors の試行の台帳(pick_place_ledger_v3.csv)、公開記事 DAY257
https://adaptdesign.jp/pixelstomotors/record/why-z-correction-failed-twin-poses
<!-- 2026-10-12 リンクを確認: Counterpoint・1X・Generalist の3本・arXiv はページが開くことを確かめた。Science Robotics は DOI(バークレーの研究室が公開している PDF のファイル名と同じ番号)。Smart Analytics Global は公式の発表ページが見つからなかったので、リンクなし -->

▼この番組について
「フィジカルAI解説|Pixels to Motors」は、フィジカルAIを、現場で使える形にするまでを解説する番組です。
エイイチは、本業のデザイナーをしながら、ロボティクスの研究と開発をしています。その中で分かったことと、そこから考えた見立てを、案内役のハコブくんがお伝えします。

・ナレーションは AI 音声(ElevenLabs)です。話しているのは Pixels to Motors のキャラクター、ハコブくんです
・BGM は ElevenLabs Music で作った曲、効果音はコードで作った音です

▼ロボットの開発・導入のご相談
メール:pixelstomotors@adaptdesign.jp

▼リンク
Webサイト:https://adaptdesign.jp/pixelstomotors
GitHub:https://github.com/PixelstoMotors
X:https://x.com/adaptdesignjp
LinkedIn:https://www.linkedin.com/in/eiichi-shimazu

チャンネル登録・高評価もよろしくお願いします。コメントは、エイイチが全部読んでいます。

#フィジカルAI #人型ロボット #ロボット
フィジカルAIの現在地/plot_ducking.py
この記事の BGM のグラフを描いたスクリプト(69行)。
"""記事 DAY333 の図: 20〜80秒のナレーションの波形と、audio_mix.py が決める BGM の大きさを並べて描く。
使い方: 動画の作業フォルダで  python3 plot_ducking.py
"""
import sys
import numpy as np
sys.path.insert(0, '.')
sys.path.insert(1, '../_制作ベース')
sys.path.insert(2, '../base')
from timing import load, layout, narration, FPS, SR
import audio_mix as am
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from matplotlib import font_manager

FONT = '/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc'
font_manager.fontManager.addfont(FONT)
plt.rcParams['font.family'] = font_manager.FontProperties(fname=FONT).get_name()

idx = load(None)
layout(idx)
voice = narration(idx).astype(np.float32) / 32768
total = len(voice) / SR

# audio_mix.py の mix() と同じ手順で「話している所」を決める
ctl = np.zeros(int(total * 100) + 1)
for o in idx:
    if o['text']:
        a = max(0, int((o['start'] / FPS - 0.15) * 100))
        b = int(((o['start'] + o['speech']) / FPS + 0.3) * 100)
        ctl[a:b] = 1
gaps = np.where(np.diff(np.concatenate([[1], ctl, [1]])) != 0)[0].reshape(-1, 2)
for a, b in gaps:
    if b - a < 50:
        ctl[a:b] = 1
ctl = am.smooth(ctl, 0.3)
lv = 20 * np.log10(am.db(-23) * ctl + am.db(-16) * (1 - ctl))

t0, t1 = 20, 80
t = np.arange(len(ctl)) / 100
m = (t >= t0) & (t <= t1)
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(12, 5.2), sharex=True, gridspec_kw={'height_ratios': [1, 1.2]})
s0, s1 = int(t0 * SR), int(t1 * SR)
v = voice[s0:s1]
step = 200
env = np.abs(v[:len(v) // step * step].reshape(-1, step)).max(1)
tv = t0 + np.arange(len(env)) * step / SR
ax1.fill_between(tv, -env, env, color='#0d0d0d', lw=0)
ax1.set_ylabel('ナレーション')
ax1.set_yticks([])
ax2.plot(t[m], lv[m], color='#C4471F', lw=2)
ax2.set_ylim(-25, -14)
ax2.set_yticks([-23, -16])
ax2.set_yticklabels(['-23dB 話している間', '-16dB 0.8秒以上の間'])
# 効果音の位置(assemble_full.log の時刻)
ses = [(22.78, 'ホワーン'), (33.40, 'キラリン'), (55.20, 'ポロロン'), (71.38, 'ホワーン')]
for x, l in ses:
    if t0 <= x <= t1:
        for a in (ax1, ax2):
            a.axvline(x, color='#1A6C98', lw=1, ls='--')
        ax2.text(x + 0.4, -14.6, l, color='#1A6C98', fontsize=10)
ax2.set_xlabel('動画の時間(秒)')
for a in (ax1, ax2):
    for sp in ('top', 'right'):
        a.spines[sp].set_visible(False)
fig.suptitle('「フィジカルAIの現在地」20〜80秒:話している間は BGM を下げ、間で戻す(audio_mix.py)', fontsize=12)
fig.tight_layout()
fig.savefig('DAY333_02_bgm_ducking.png', dpi=150, facecolor='#F5F5F0')
print('DAY333_02_bgm_ducking.png')
書き出しのログと測った数値
assemble.py の書き出しのログ(全量)
最後に全体を書き出したときのログです。1行目が BGM と効果音の数、そのあとが効果音を鳴らした時刻・文番号・音・大きさ・その文の先頭16字、最後の行が全体のコマ数と確認用ファイルの大きさです。145番の文は、字幕のないエンディングの文です。
BGM 1本・効果音 45個 → mix.wav
   13.25秒  文002  se_rise  -6dB  「年末までには、5万台を超えると予」
   22.78秒  文004  se_rise  -6dB  「こういうニュースを見ると、Cha」
   33.40秒  文006  se_chapter_glock  -8dB  「Pixels to Motors」
   55.20秒  文009  se_chapter_marimba  -8dB  「今日の問いは、ロボットにもCha」
   71.38秒  文012  se_rise  -6dB  「フィジカルAIっていうのは、現実」
   85.32秒  文015  se_rise  -6dB  「先に結論を言っちゃうと、写真を見」
  106.02秒  文019  se_rise  -6dB  「先に言っておくと、フィジカルAI」
  117.05秒  文021  se_rise  -6dB  「大きく3つあります。」
  137.90秒  文026  se_chapter_marimba  -8dB  「1つ目、出荷が4倍になったロボッ」
  144.62秒  文027  se_rise  -6dB  「Counterpointの推計で」
  155.95秒  文029  se_rise  -6dB  「データ生産っていうのは、ロボット」
  181.92秒  文034  se_rise  -6dB  「一方で、別の調査会社のSmart」
  207.78秒  文039  se_rise  -6dB  「もう1つ、SAGの推計では、出荷」
  215.22秒  文040  se_rise  -6dB  「家のほうも見てみます。」
  251.52秒  文047  se_rise  -6dB  「これ、ちょっと考えさせられません」
  262.98秒  文050  se_rise  -6dB  「工場でも家でも、使いながらデータ」
  276.63秒  文053  se_chapter_marimba  -8dB  「2つ目、エイイチの机の上のロボッ」
  285.45秒  文054  se_rise  -6dB  「ここは、エイイチ自身の話から始め」
  298.85秒  文057  se_rise  -6dB  「それだけの作業を、失敗も含めて6」
  306.35秒  文058  se_rise  -6dB  「まず、簡単だったほうから話します」
  332.85秒  文063  se_rise  -6dB  「難しかったのは、動かすほうでした」
  336.58秒  文064  se_rise  -6dB  「ロボットアームの爪先がどこに来る」
  347.92秒  文066  se_rise  -6dB  「パソコンの中に作ったアームの分身」
  353.82秒  文067  se_rise  -6dB  「エイイチの設定では、同じ関節の角」
  373.52秒  文070  se_rise  -6dB  「そこでエイイチは、分身の中でアー」
  387.08秒  文073  se_rise  -6dB  「もう1つ困ったのが、黙る失敗です」
  404.65秒  文077  se_rise  -6dB  「でも、ポイントはここなんです。」
  434.47秒  文083  se_chapter_marimba  -8dB  「3つ目、データの壁はどれくらい高」
  442.28秒  文084  se_rise  -6dB  「カリフォルニア大学バークレー校の」
  459.62秒  文088  se_rise  -6dB  「それに比べて、ロボットが手を動か」
  488.68秒  文094  se_rise  -6dB  「アメリカのGeneralistと」
  505.52秒  文097  se_rise  -6dB  「さらに8月には、簡単で短い作業な」
  527.92秒  文101  se_rise  -6dB  「ここで1つ、注意があります。」
  542.65秒  文104  se_rise  -6dB  「つまり、壁はまだ高い。でも、壁の」
  561.08秒  文107  se_rise  -6dB  「ただ、ここで「なんだ、まだ全然ダ」
  581.20秒  文111  se_chapter_marimba  -8dB  「ここからは、エイイチの見立てです」
  585.28秒  文112  se_rise  -6dB  「ロボットのニュースを見たときの問」
  590.05秒  文113  se_rise  -6dB  「1つは、そのロボットは自律で動い」
  605.52秒  文116  se_rise  -6dB  「もう1つは、その仕事は「見て判断」
  634.32秒  文122  se_rise  -6dB  「ゴールドバーグさんは、昔ながらの」
  657.38秒  文126  se_rise  -6dB  「作る側から見ると、もう1つありま」
  684.30秒  文132  se_chapter_marimba  -8dB  「じゃあ、冒頭の問いに答えますね。」
  710.45秒  文137  se_rise  -6dB  「ロボットのデモ動画を見たら、」
  725.13秒  文141  se_chapter_marimba  -8dB  「今日はここまでです。」
  742.95秒  文145  se_rise  -6dB  「」
frames 22473 = 749.1s  確認用 29.4MB (crf 29)
上げたファイルの中身(ffprobe)
$ ffprobe -v error -show_entries format=duration,bit_rate:stream=codec_name,width,height,r_frame_rate,sample_rate,bit_rate -of default=nw=1 out.mp4
codec_name=h264
width=1920
height=1080
r_frame_rate=30/1
bit_rate=488631
codec_name=aac
sample_rate=48000
r_frame_rate=0/0
bit_rate=203703
duration=749.100000
bit_rate=701165
1つ目の codec_name から bit_rate までが映像(488,631 ビット/秒)、2つ目が音声(AAC・48kHz・203,703 ビット/秒)、最後の duration と bit_rate がファイル全体です。
音の大きさ(ffmpeg の ebur128)
$ ffmpeg -nostats -i out.mp4 -af ebur128 -f null - 2>&1 | grep -A8 "Summary"
[Parsed_ebur128_0 @ 0x5569ec070940] Summary:

  Integrated loudness:
    I:         -16.0 LUFS
    Threshold: -26.4 LUFS

  Loudness range:
    LRA:         3.1 LU
    Threshold: -36.4 LUFS
ファイルの指紋(md5)
$ md5sum out.mp4 out_確認用.mp4
d9f6def3f1a01d9aee5c76c9d6516bc0  out.mp4
06c2afe18606354bd366a2e4224fab31  out_確認用.mp4
作った曲の記録(sound/作った記録.jsonl・全量)
sound_eleven.py が、曲を作るたびに1行ずつ書き足す記録です。prompt が ElevenLabs Music に渡した文章です。
{"file": "sound/bgm_本編_1.mp3", "kind": "music", "sec": 60.0, "prompt": "Warm, gentle instrumental background music recorded with real acoustic instruments, for a thoughtful explainer about robots and AI. Felt piano and fingerpicked acoustic guitar, soft cello and violin, upright bass, very quiet brushed drums. Natural room sound, like a small live session. Around 90 BPM, calm and hopeful, a touch of color but serious in tone. No synthesizers, no electronic sounds, no vocals. A simple melody that stays out of the narrator's way.", "loop": false, "model": "既定", "time": "2026-10-12 11:26", "song-id": "angU6pw2wgogpMCVOVzl"}
{"file": "sound/bgm_本編_2.mp3", "kind": "music", "sec": 60.0, "prompt": "Warm, gentle instrumental background music recorded with real acoustic instruments, for a thoughtful explainer about robots and AI. Felt piano and fingerpicked acoustic guitar, soft cello and violin, upright bass, very quiet brushed drums. Natural room sound, like a small live session. Around 90 BPM, calm and hopeful, a touch of color but serious in tone. No synthesizers, no electronic sounds, no vocals. A simple melody that stays out of the narrator's way.", "loop": false, "model": "既定", "time": "2026-10-12 11:26", "song-id": "rGaTcW0xZPfECyYFmCtW"}
{"file": "sound/bgm_冒頭_1.mp3", "kind": "music", "sec": 60.0, "prompt": "Bright but gentle instrumental music played on real acoustic instruments, for the opening of a serious technology explainer. Acoustic guitar, piano, light pizzicato strings and soft marimba, natural room sound. Around 100 BPM, curious and hopeful, not cheesy. No synthesizers, no electronic sounds, no vocals, no dramatic hits.", "loop": false, "model": "既定", "time": "2026-10-12 11:26", "song-id": "B0CIEZhLC948zw7GsAcP"}
{"file": "sound/bgm_冒頭_2.mp3", "kind": "music", "sec": 60.0, "prompt": "Bright but gentle instrumental music played on real acoustic instruments, for the opening of a serious technology explainer. Acoustic guitar, piano, light pizzicato strings and soft marimba, natural room sound. Around 100 BPM, curious and hopeful, not cheesy. No synthesizers, no electronic sounds, no vocals, no dramatic hits.", "loop": false, "model": "既定", "time": "2026-10-12 11:27", "song-id": "5NbSMGUTgt0DXRjOTTB1"}
{"file": "sound/bgm_明るいA_1.mp3", "kind": "music", "sec": 60.0, "prompt": "Bright, warm and uplifting instrumental music played on real acoustic instruments, in a major key, for a friendly technology explainer about robots. Strummed and fingerpicked acoustic guitar, bright piano, glockenspiel accents, light hand claps and soft shaker, warm upright bass. Natural room sound. Around 105 BPM, cheerful and optimistic like a sunny morning, but not childish or cheesy. No synthesizers, no electronic sounds, no vocals. A simple melody that stays out of the narrator's way.", "loop": false, "model": "既定", "time": "2026-10-12 11:31", "song-id": "Hd4Qnr113KBdkYe8qE9k"}
{"file": "sound/bgm_明るいA_2.mp3", "kind": "music", "sec": 60.0, "prompt": "Bright, warm and uplifting instrumental music played on real acoustic instruments, in a major key, for a friendly technology explainer about robots. Strummed and fingerpicked acoustic guitar, bright piano, glockenspiel accents, light hand claps and soft shaker, warm upright bass. Natural room sound. Around 105 BPM, cheerful and optimistic like a sunny morning, but not childish or cheesy. No synthesizers, no electronic sounds, no vocals. A simple melody that stays out of the narrator's way.", "loop": false, "model": "既定", "time": "2026-10-12 11:31", "song-id": "bQUshWUbu4Y7vH4a43QI"}
{"file": "sound/bgm_明るいB_1.mp3", "kind": "music", "sec": 60.0, "prompt": "Hopeful, bright instrumental music on real acoustic instruments, in a major key, for a positive and curious explainer about the future of robots. Piano and acoustic guitar leading, warm strings, light pizzicato, a few glockenspiel notes, soft percussion. Natural room sound. Around 100 BPM, optimistic and forward-moving, bright but calm enough to sit under narration. No synthesizers, no electronic sounds, no vocals, no big build-ups.", "loop": false, "model": "既定", "time": "2026-10-12 11:31", "song-id": "qyMIv2n4wM3BGvVoNqKR"}
{"file": "sound/bgm_明るいB_2.mp3", "kind": "music", "sec": 60.0, "prompt": "Hopeful, bright instrumental music on real acoustic instruments, in a major key, for a positive and curious explainer about the future of robots. Piano and acoustic guitar leading, warm strings, light pizzicato, a few glockenspiel notes, soft percussion. Natural room sound. Around 100 BPM, optimistic and forward-moving, bright but calm enough to sit under narration. No synthesizers, no electronic sounds, no vocals, no big build-ups.", "loop": false, "model": "既定", "time": "2026-10-12 11:31", "song-id": "19pIxHwtXfiNptitO2FF"}
書き出した概要欄(概要欄.txt・全量)
description.py が書き出し、YouTube に貼ったものです。
今年の上半期に出荷された人型ロボットは、世界で2万2000台を超えました。前の年の同じ時期の、およそ4倍です(Counterpoint の推計)。

ロボットにも、ChatGPT のような瞬間はもう来たのか。

先に答えを言うと、写真を見せて判断させる入口は、ぐっと簡単になりました。でも、物を確実に動かすところは、まだ手間がかかります。手間は2つ。動作と結びついたデータが集めにくいこと。そして、機体や環境とのすり合わせです。

この動画では、

・出荷が4倍になったロボットは、何をしているのか
・机の上のロボットアームで、何が簡単で、何が難しかったのか
・データの壁はどれくらい高くて、誰がどう越えようとしているのか

の3つを見たうえで、ロボットのニュースを見るときの2つの問いを解説します。

▼目次
0:00 人型ロボットの出荷は4倍。ロボットにもChatGPTの瞬間?
0:33 この番組について
0:55 今日の問いと、先に結論
2:18 1. 出荷の中身:4倍になったロボットは何をしているのか
4:36 2. 机の上の実感:何が簡単で、何が難しかったのか
7:14 3. データの壁:どれくらい高く、誰がどう越えようとしているのか
9:41 エイイチの見立て:ニュースを見るときの2つの問い
11:24 冒頭の問いへの答え
12:05 エンディング

▼出典
・人型ロボットの出荷:Counterpoint Research(2026年8月20日)の推計
https://counterpointresearch.com/en/insights/global-humanoid-robot-shipments-soar-nearly-300-percent-yoy-in-h1-2026
・同じく出荷の推計:Smart Analytics Global(2026年8月)
・1X NEO:1X 公式の製品・注文ページ(2026年10月12日に確認。一般のお客さんへの配送開始を示す公式発表は、この日の時点で見つかっていない)
https://www.1x.tech/neo
・10万年のデータの壁:Ken Goldberg「GOFE can close the 100,000-year robot data gap」Science Robotics(2025年8月, Editorial)
https://doi.org/10.1126/scirobotics.aea7390
・Generalist の会社の公式発表:GEN-0(2025年11月)、GEN-1(2026年4月)、GEN-1.5(2026年8月)
https://generalistai.com/blog/gen-0
https://generalistai.com/blog/gen-1
https://generalistai.com/blog/gen-1.5
・ほかの機体から学ぶ研究の例:Gemini Robotics 1.5 技術報告(Google DeepMind)
https://arxiv.org/abs/2510.03342
・実機の数字:Pixels to Motors の試行の台帳(pick_place_ledger_v3.csv)、公開記事 DAY257
https://adaptdesign.jp/pixelstomotors/record/why-z-correction-failed-twin-poses

▼この番組について
「フィジカルAI解説|Pixels to Motors」は、フィジカルAIを、現場で使える形にするまでを解説する番組です。
エイイチは、本業のデザイナーをしながら、ロボティクスの研究と開発をしています。その中で分かったことと、そこから考えた見立てを、案内役のハコブくんがお伝えします。

・ナレーションは AI 音声(ElevenLabs)です。話しているのは Pixels to Motors のキャラクター、ハコブくんです
・BGM は ElevenLabs Music で作った曲、効果音はコードで作った音です

▼ロボットの開発・導入のご相談
メール:pixelstomotors@adaptdesign.jp

▼リンク
Webサイト:https://adaptdesign.jp/pixelstomotors
GitHub:https://github.com/PixelstoMotors
X:https://x.com/adaptdesignjp
LinkedIn:https://www.linkedin.com/in/eiichi-shimazu

チャンネル登録・高評価もよろしくお願いします。コメントは、エイイチが全部読んでいます。

#フィジカルAI #人型ロボット #ロボット
BGM と効果音の候補を調べた表(音源_候補.md・全量)
規約は 2026年10月12日に公式のページで確かめた内容です。規約は変わるので、使う前にもう一度確かめます。
# BGM と効果音:どこから持ってくるか

2026-10-12 作成。video_rules.md 8節「BGM・効果音」の判断材料。

## 条件

- YouTube で収益化しても使える
- クレジット表記の条件を守れる(できれば表記なしで使える)
- ほかのチャンネルと同じ曲になりにくい(声と同じ考え方。3-1)
- ナレーションが聞き取れる音量に下げる。話している間は BGM を下げ、間で少し戻す(audio_mix.py が自動でやる)

## 候補(規約は 2026-10-12 に公式のページで確かめた。変わるので、使う前にもう一度見る)

| 用途 | 候補 | 収益化 | クレジット | 気をつけること |
|---|---|---|---|---|
| BGM(第一候補) | ElevenLabs Music(いまの Starter プランで使える) | 使える(映画・テレビ・ラジオ・ゲームの一部を除く) | Starter 以上はいらない(無料プランは必要) | 作れるのは月17分まで。曲そのものを音楽配信に出すのは禁止。新しく作る曲なので、ほかのチャンネルと同じ曲にならない |
| BGM(安全側の控え) | YouTube オーディオライブラリ(YouTube Studio の中) | 使える。ここの曲には Content ID の申し立てが来ないと YouTube が書いている | 「帰属表示が不要」で絞り込めば、いらない | YouTube 以外(X・LinkedIn に切り抜きを載せるなど)での扱いは、ヘルプに書かれていない。多くのチャンネルが使うので、同じ曲になりやすい |
| BGM(生の演奏・有料) | Audiostock(日本のサービス。人が演奏・録音した曲が多い) | YouTube で使える(動画配信者プランは本人のアカウントだけ) | 公式のライセンスのページに記載なし(使う前に確かめる) | 単品 1,210円〜(買い切り)。定額の動画配信者プランは月858円(年払い)。値段は公式ページの 2024年12月1日時点の表示。多くの曲が Content ID に登録されているが、ふつうは警告が出ない設定とのこと。定額で使った曲は、解約後に新しい動画では使えない(単品なら使える) |
| BGM(控え) | OpenTracks(旧 DOVA-SYNDROME。2026年9月15日に名前が変わった) | 背景音楽としてなら商用も可 | いらない | 海外の団体が「音楽出版権」を不正に主張して、Content ID の申し立てが来る例があるとサイト自身が書いている(広告が付かない・収益の一部を取られることがある)。そのたびに異議を出す手間がかかる |
| 効果音(第一候補) | コードで作る(sound_synth.py。もう作った) | 問題なし(自分で作った音) | いらない | 単純な電子音だけ。だれでも同じ音を作り直せるので、「再現できる」の考え方に合う |
| 効果音(控え) | 効果音ラボ | 使える(「YouTube(収益化しても可)」と明記) | いらない | 効果音を Content ID に登録するのは禁止(他の人の利用に影響するため)。効果音だけの動画は作らない |
| 効果音(控え) | ElevenLabs の効果音(sound_eleven.py sfx) | 有料プランで作った音は商用可 | いらない | 現実の音(モーター音・机に物を置く音など)が欲しいとき向き |

外したもの: Pixabay の音楽(無料・クレジット不要だが、Content ID の扱いが公式のライセンス要約に書かれていない)。魔王魂・甘茶の音楽工房などのほかの無料サイトは、今回は調べていない。上の候補で足りなければ調べる。

2026-10-12 エイイチ: BGM は生の楽器の音に近い方がよい。コードで作った BGM(bgm_1〜3・bgm_仮_温かみ)は方向を確かめる用にとどめる。

## コードで作った効果音(_制作ベース/sound/。2026-10-12)

| 名前 | 音 | 使う所 |
|---|---|---|
| se_pop | ぽん | 図・数字が出る。いちばんよく使う |
| se_tick | こつ | 小さな切り替え。箇条書きが1つ出る |
| se_whoosh | しゅっ | 章や場面が大きく変わる |
| se_ding | ちん | 結論・大事な数字 |
| se_rise | ひゅい | 驚き・問いかけ |
| bgm_仮 | やわらかい和音と小さな粒の音(テンポ96・32秒でループ) | 本番の BGM ができるまでの仮。混ぜ方を確かめるためのもの |

効果音は、ナレーションの声(おおむね 100〜300Hz)とぶつからないよう、500Hz より上を中心にしている。入れすぎると疲れるので、1分に2〜3個を目安にする。

## ElevenLabs Music で作る BGM の説明文(英語と日本語訳)

Mac で、動画の作業フォルダから(キーの入れ方は tts_eleven.py と同じ):

```
python3 ../_制作ベース/sound_eleven.py music --name bgm_hook --sec 60 --count 2 --prompt "(下の英文)"
```

### A. 本編の後ろで流す曲(いちばん長く流れる)

> Calm, curious instrumental background music for a technology explainer video about robots and AI. Soft electric piano and light plucked synth arpeggios, warm pads, gentle low bass, very soft minimal drums. Around 95 BPM, steady and unobtrusive. No strong melody that would compete with a narrator's voice. No vocals. Clean modern mix.

日本語訳:ロボットとAIの解説動画の後ろで流す、落ち着いて、少し先が気になる感じの曲。やわらかいエレクトリックピアノ、軽くはじく電子音のアルペジオ、温かい和音、低くやさしいベース、ごく小さなドラム。テンポ95前後で一定、目立たない。ナレーションとぶつかる強いメロディは入れない。歌なし。

### B. フック(動画の最初の数十秒)

> Short instrumental intro bed for a tech news explainer, slightly brighter and more forward than background music. Pulsing soft synth, light percussion, a sense of something starting. Around 100 BPM. No vocals, no big drops, no dramatic trailer hits.

日本語訳:技術ニュースの解説の冒頭で流す、短めの曲。本編の曲より少し明るく前に出る。脈打つやわらかい電子音、軽い打楽器、何かが始まる感じ。テンポ100前後。歌なし。盛り上げの落差や、映画の予告編のような強い音は入れない。

### C. ジングル(「Pixels to Motors。案内役のハコブくんです。」の後ろ)

> A 4-second friendly logo sting for a robotics channel. Soft synth bell chord with a gentle rising shimmer, ends cleanly on a warm chord. No vocals.

日本語訳:ロボットのチャンネルの、4秒の親しみのあるロゴの音。やわらかい電子のベルの和音に、ゆっくり上がるきらめき。温かい和音できれいに終わる。歌なし。

(C は --sec 4。A・B は 60 秒で作り、短ければ audio_mix.py がループでつなぐ)

## 決める基準

1. ナレーションの後ろで、言葉が聞き取りにくくならないか(音の確認.m4a をイヤホンとスピーカーの両方で聞く)
2. 13分流して、うるさく感じないか
3. ハコブくんの見た目と番組の落ち着いた調子に合うか