

解説動画をAIと作る ― 型の分析から敵対的検証まで、試作1本で決めたこと
Pixels to Motors の YouTube で解説動画を出すために、Claude と対話しながら試作を1本作りました。題材は「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」で、尺は13分50秒です。
進め方は次の順番でした。参考にしたい解説動画3本の文字起こしから、構成・話し方・補足説明の型を取り出す。型を台本テンプレートにまとめ、テンプレートに沿って台本を書く。台本を、読み上げ音声・図解・字幕・実機の映像に分けてコードで組み立て、MP4 に書き出す。できた台本を codex(OpenAI のコーディング AI)に渡して、論破するつもりで検証してもらう。指摘とデザインの修正を重ねる。最後に、量産するときのベースとしてルール文書とスクリプト一式を残す。
本記事は、その過程で決めたことと、決めた理由の記録です。間違えたところ(根拠のない数字を書いた、30cm の例が誤解を招く、など)も消さずに残しています。制作スクリプトの全文、実行ログ、codex の検証結果の全文は記事の後半に載せています。
参考にした3本の解説動画は、冒頭1分半で問い・結論・目次を全部出していた
参考にしたのは、時事ニュースを統計と自分の体験で検証する形式の解説動画3本です(YouTube「海外Yパパラジオ」の、会社への侵入と暗数の回、AI とサイバー攻撃の回、溺れている人を AI に見つけさせる実験の回)。動画のページは Claude からは開けなかったため、文字起こしを貼って分析しました。
3本とも、骨格が同じでした。
時間の目安 | 中身 | 実例 |
|---|---|---|
0:00〜0:45 | 挨拶より先に、時事ネタか視聴者のコメントから入る | 「最近漏洩多くないですか?」というコメント |
〜0:50 | 決まったジングルと自己紹介 | 住んでいる場所から世界を見ている、と名乗る |
〜1:10 | その回の問いを疑問文1つで言う | 「会社への侵入は本当に急に増えたのか」 |
〜1:30 | 結論か鍵になる言葉を先に出し、自分の立場を言う | 「変わったのは手口じゃなく攻撃の値段」「増えていないと言いたいわけじゃない」 |
〜1:50 | 「大きく○つあります」で目次を言う | 3〜5項目 |
本編 | 「1つ目、○○です」で区切る。各節の最後の問いが次の節の題になる | 「じゃあ一斉に調べ始めたら何が出てくるのか」→ 次の節 |
終盤 | 「ここからが僕の一番言いたいこと」と口で言ってから意見を話す | 事実と意見の境目を視聴者に示す |
締め | 冒頭の問いに答え、次にニュースを見たときに考える問いを1つ渡す | 「起きた数か、見つかった数か、一度だけ考えてみて」 |
冒頭の1分半で「何の話か・何に答えるか・どの立場で話すか・何章あるか」がそろいます。ほかに共通していたのは、視聴者の思い込みを1つ置いてデータで崩し、崩したあとに逆方向の早合点も止めること。数字は必ず比較で言い直すこと(「15倍ですよ」)。専門用語は使った直後に1文で説明すること。限界を自分から言うこと(「動画2本だけなので、性能の評価というより最初の手触り」)。
溺れている人の回だけは型が少し違い、道具の説明 → なぜ難しいか → 試した結果 → 失敗の深掘り → 見せ方を変えて再実験 → 見立て、の順でした。山場が「失敗が見つかる場面」にある実験回です。
台本テンプレートは「解説回」と「実験回」の2種類に分けた
型を、パートごとの秒数とセリフの穴埋め(例「先に結論を言っちゃうと、変わったのは{A}じゃなくて{B}なんですよ」)にして、解説回と実験回の2種類のテンプレートにしました。収録前に確認するチェックリスト(専門用語は初出で1文の説明があるか、数字に出典の名前が付いているか、など)も付けています。
試作の題材は「フィジカルAIの現在地」で、問いの形にして「ロボットにもChatGPTの瞬間はもう来たのか」としました。解説回のテンプレートに当てはめ、外部の数字(人型ロボットの出荷台数、1X の家庭用ロボット NEO、ゴールドバーグさんの「10万年のデータの壁」、Generalist の学習データ量)は Web で一次情報を確認して入れました。
台本に入れた自分の数字は、台帳と公開記事で裏を取った
台本の節2は、自宅の机でロボットアーム(mechArm 270-Pi)を動かしてきた体験談です。ここに入れた数字は、Mac のフォルダと外付け SSD(KIOXIA)をつないでもらい、記録で確かめました。
台本の数字 | 確かめた記録 | 結果 |
|---|---|---|
掴んで置く作業の試行回数 | 台帳 pick_place_ledger_v3.csv | 657行。テスト1行を除いて656回(2026年6月18日〜7月20日) |
爪先の位置の対応表の点数 | 公開記事 LOG283 | 約170万点 |
計算ツールとデジタルツインの爪先の食い違い | arm_kinematics.md、公開記事 LOG222 | 同じ関節角で300mm以上 |
黙って捨てられる指令 | 公開記事 LOG257 | j1(肩)が約90.7度を超えると send_angles がエラーなしで無視される |
1つ、間違いがありました。試行回数を最初「600回以上」と書いていましたが、これは記録を見ずに書いた数字でした。記事を検索した段階では LOG255 の「100試行ぶん」しか見つからず、いったん「100回以上」に直しました。そのあと台帳を数えたら656回あり、「650回以上」に直しています。結果として最初の数字は大きく外れていませんでしたが、根拠なしに書いた数字だったことに変わりはありません。台帳の集計結果は、後半の実行ログに全量で載せています。
動画は、Open JTalk・Playwright・ffmpeg で1文ずつ組み立てた
台本から動画までを、クラウドの作業環境でコードにして組み立てました。
narration.py に台本を書く。1文ごとに「場面の名前・字幕の文・後ろの間(秒)」の組にする
tts2.py で、1文ずつ読み上げ音声を作る
scenes.py に、場面ごとの図解を HTML で書く
render.py で、図解・テロップ・字幕を Playwright(ブラウザを自動で動かす道具)で画像にする
assemble.py で、1文ごとに「図解か実機映像」+「字幕」を ffmpeg で数秒の映像にし、全部つないで音声と合わせる。字幕ファイル(srt)も同時に出す
1文を1つの映像のかたまりにしたのは、あとで1文だけ直したときに、その文の映像だけ作り直せばよいからです。実際、自己紹介の1文を差し替えたときは、作り直したのは3つのかたまりだけでした。
読み上げ音声には、Open JTalk(日本語の音声合成エンジン)の男声を使いました。より自然な音声エンジン(VOICEVOX など)は、作業環境から配布元の GitHub にアクセスできず、取り込めませんでした。Open JTalk は Ubuntu のパッケージで入れられたので、仮の声として使っています。抑揚は機械的で、公開するなら本人の声で録り直す前提です。
実機の映像は、Mac の動画フォルダにあった5本から、赤いブロックを掴んで箱に置く実機の映像(LOG124)、アーム単体の動き(LOG123)、Unity のデジタルツインの映像2本を選びました。LOG123 と LOG124 の右下には、以前に使った編集ツールの透かし(clideo.com)が入っていたため、ffmpeg の delogo でぼかし、字幕の後ろに敷く黒い帯の下に隠しています。
Open JTalk は、ひと息が長い文の最後を1音0.47秒に引き伸ばしていた
最初に書き出した動画(13分33秒)を見てもらったところ、次の指摘がありました。
動画の中で音声が間延びしたところが何箇所か存在します。 それだけ修正を行うことはできますか?
Open JTalk は、音声と一緒に「どの音を何秒出したか」の記録を出せます。これを全153文について調べると、6文で、文の後半の音が1つあたり約0.47秒になっていました。普段は0.1秒前後なので、3〜4倍に引き伸ばされています。
文 | 引き伸ばされていた部分 |
|---|---|
現実の世界で物に触れて動かす技術のことなんですよ。 | 「…なんですよ」 |
ChatGPTのようなAIの学習に使われたインターネットの文章を、 | 「…使われた」 |
ChatGPTは10万年分の教科書で育ったけれど、 | 「育ったけれど」 |
ここで、じゃあロボットにChatGPTの瞬間は当分来ない、 | 「当分来ない」 |
1Xが家の中で遠隔操作しながらデータを集めているのも、 | 「いるのも」 |
出荷されたロボットの多くがデータ集めに回っているのも、 | 「のも」 |
共通していたのは、読点なしでひと息に読む区間が長いことでした。ひと息の区間が長いと、その区間の最後の言葉が引き伸ばされます。
直し方は、読み上げ用の原稿だけに読点を足して区切ることです。字幕の文は変えません。最初は読点の位置で自動的に区切りましたが、「遠隔操作しなが/ら」のように単語の途中で切れた文があり、区切る位置を手で指定し直しました。その後、台本を書き直したときに、作った音声をすべて検査し、1音が0.3秒を超える文を見つけたら区切って作り直す処理を tts2.py に入れました。区切っても直らない文は、narration.py の OVERRIDE に「読み上げ用の読点の位置」を書いて直しています。
codex の敵対的検証で、台本の結論は「成立していない」と判定された
台本を公開前に codex に渡し、「この台本を論破するつもりで」検証してもらいました。依頼ファイルには、台本の全文に文番号(S001〜S152)を振り、使った出典の表と、検証してほしい観点(事実と数字・論理・抜けている反論・言い方)を付けています。依頼ファイルの全文と、返ってきた検証結果の全文は、後半に載せています。
判定は「直してから公開」、結論の評価は「現状では成立していない」でした。重大とされたのは次の4点です。
codex の指摘 | 中身 |
|---|---|
「ChatGPTの瞬間」が未定義 | 写真に質問して答えが返った体験1つから、「見て判断する部分には来た」と言い切っている |
異種データの「1700分の1」比較 | 人が文章を読む時間(10万年)と、作業を記録した時間(57年)は、意味も単位も違う |
実機の問題を「データ不足」の例にしている | 計算ツールとデジタルツインの食い違いや、指令が無視される問題は、学習データの不足とは別の話 |
Generalist の最新発表の抜け | 4月の GEN-1 を最新として話していたが、8月に GEN-1.5 が出ていた |
結論そのものについて、codex は次の形なら条件つきで成立すると書いていました。
僕の机では、画像に質問する入口はずっと簡単になりました。一方、物を確実に動かすには、機体や環境とのすり合わせがまだ必要でした。その負担を減らす研究は急速に進んでいます。でも、いろんな家庭で安全に家事を任せられる転換点まで来たかは、まだ判断できません。
台本の結論は、この形に差し替えました。
codex が新しく挙げた事実は、一次情報で確かめてから採用した
codex の指摘には、台本になかった新しい事実が含まれていました。採用する前に、それぞれの一次情報を開いて確かめています。
codex が挙げた事実 | 確かめた一次情報 | 確かめた内容 |
|---|---|---|
Generalist が8月に GEN-1.5 を発表 | Generalist 公式ブログ(2026年8月19日) | 3〜12秒の実演1回から新しい作業をこなす。10種類の作業で平均成功率59%。本人たちも「作業は簡単で短く、成功率は控えめ」と書いている |
SAG の分類は「工場や店舗向け」ではない | Smart Analytics Global の発表 | 原文は「Industrial and commercial applications」(産業・商業用途)。出荷の総数も約19,100台で、Counterpoint の22,000台超とは違う |
1X NEO の月499ドルのプランは配送時期が別 | 1X の注文ページ | 2万ドルの早期購入枠は「US Deliveries start 2026」。月499ドルは「Standard Delivery」で日付の記載なし。最初は基本的な自律機能で、知らない作業は予約した時間に担当者が遠隔で支援する |
ゴールドバーグさんの10万年は「文章だけ」ではない | Science Robotics の論説(2025年8月) | 現代の画像と言葉を扱う AI(VLM)の学習資料を、人が読む・見る時間に換算した概算 |
確認できた4点はすべて台本に反映しました。台本の書き直しでは、問いの中の言葉(ChatGPTの瞬間)を冒頭で定義し、話の範囲(自動運転は扱わず、アームと人型ロボットが物を扱う話に絞る)を言い、自分の机の上の話は「僕の機体とソフトの組み合わせでは」と条件を付けて話す形にしています。
根拠の弱い数字は足さずに削った
codex の指摘を反映する前に、次の注意がありました。
チェックして修正点を検討して反映したいです(過剰なデータは特に問題になりやすいので注意が必要です)
そこで、指摘に答えるために数字を足すのではなく、論旨に必要でないものは削る方針にしました。
削った数字 | 削った理由 |
|---|---|
1700分の1、約57年 | 意味と単位の違う数字の割り算で、比較として成り立たない |
成功率99%超、ロボットのデータ約1時間 | 会社の自己申告で、評価の条件を説明しないと誤解される |
爪先の対応表の約170万点 | シミュレーターの中で作った表なのに、実機で170万回測ったように聞こえる |
AGIBOT 44%・Unitree 31% の内訳 | なくても話が変わらない |
残した数字には「推計では」「会社の発表では」を口で付けています。調査会社2社で用途の数字が逆向きに見える件は、「総数も分類も違うので、単純な裏表としては比べられません」と言う形にしました。
読み上げは「爪先」を「つまさき」と読んでいた
あと「爪先」をつまさきと言っていますが、アームの場合は「つめさき」の方の読み方が適切かと思います(つまさきだと、足の指先に思ってしまう)
Open JTalk の辞書では「爪先」はツマサキでした。読み上げ用の読み替え表に「爪先 → つめさき」を足しています。同じ確認で、「90度ちょっとを超える値を送ると」の「値」がネと読まれていたことも見つけ、「値を送る → あたいを送る」を足しました。ほかに直した読みは「4分の3」(ヨンプンノサン → よんぶんのさん)、「1700分の1」(センナナヒャップンノイチ → せんななひゃくぶんのいち)、英語の名前(ChatGPT、Counterpoint、ikpy など)です。新しい固有名や数字を入れたら、エンジンの解析結果のカタカナを出して目で確認する手順にしました。
カード上の太線と、角の立った字幕の縁取りをやめた
それとデザイン面で直したいのがカードの上に太いラインがあるのはいわゆるAIっぽいこなしなので違う表現にしたいです。
最初の図解は、2つのものを対比するとき、白いカードの上辺に青とオレンジの太い線を引いていました。これをやめ、2列の間を細い縦線(2px)で区切り、色は文字の色だけで見分ける形にしました。同じ理由で、名前テロップの左端の太い線も外しています。
さらにフォントですが、フォントの黒縁が角が立っていているところが散見されます。 角を落とした黒縁に変更してください。
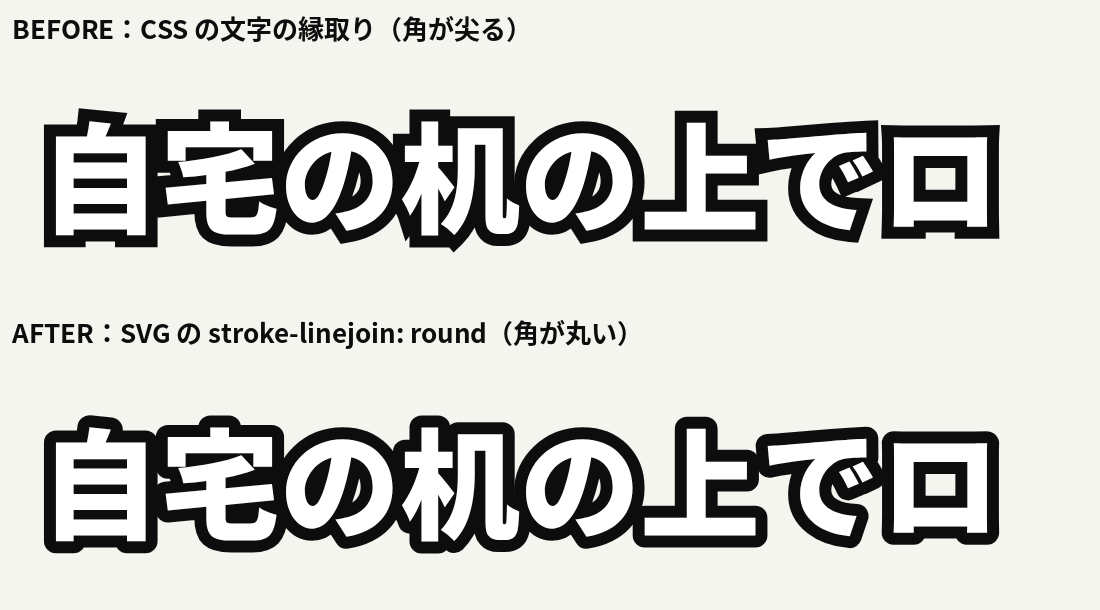
字幕は CSS の文字の縁取り(-webkit-text-stroke)で作っていました。この方式は、線の角を丸める指定ができず、「宅」や「机」の角に尖った黒い角が出ます。字幕を SVG の文字に作り替え、線の角を丸くする指定(stroke-linejoin: round)を入れました。
自己紹介から「秋田」「29年」「毎日」を外し、ロゴを差し替えた
動画の自己紹介のところで、29年秋田で、というところは削除で。 本業のデザイナーをしながらロボティクスの研究、開発を行っている、などの紹介に修正してください。
その記録を毎日公開、だと毎日ロボットを触っているかのような説明なので、「毎日」は削除した方がいい。
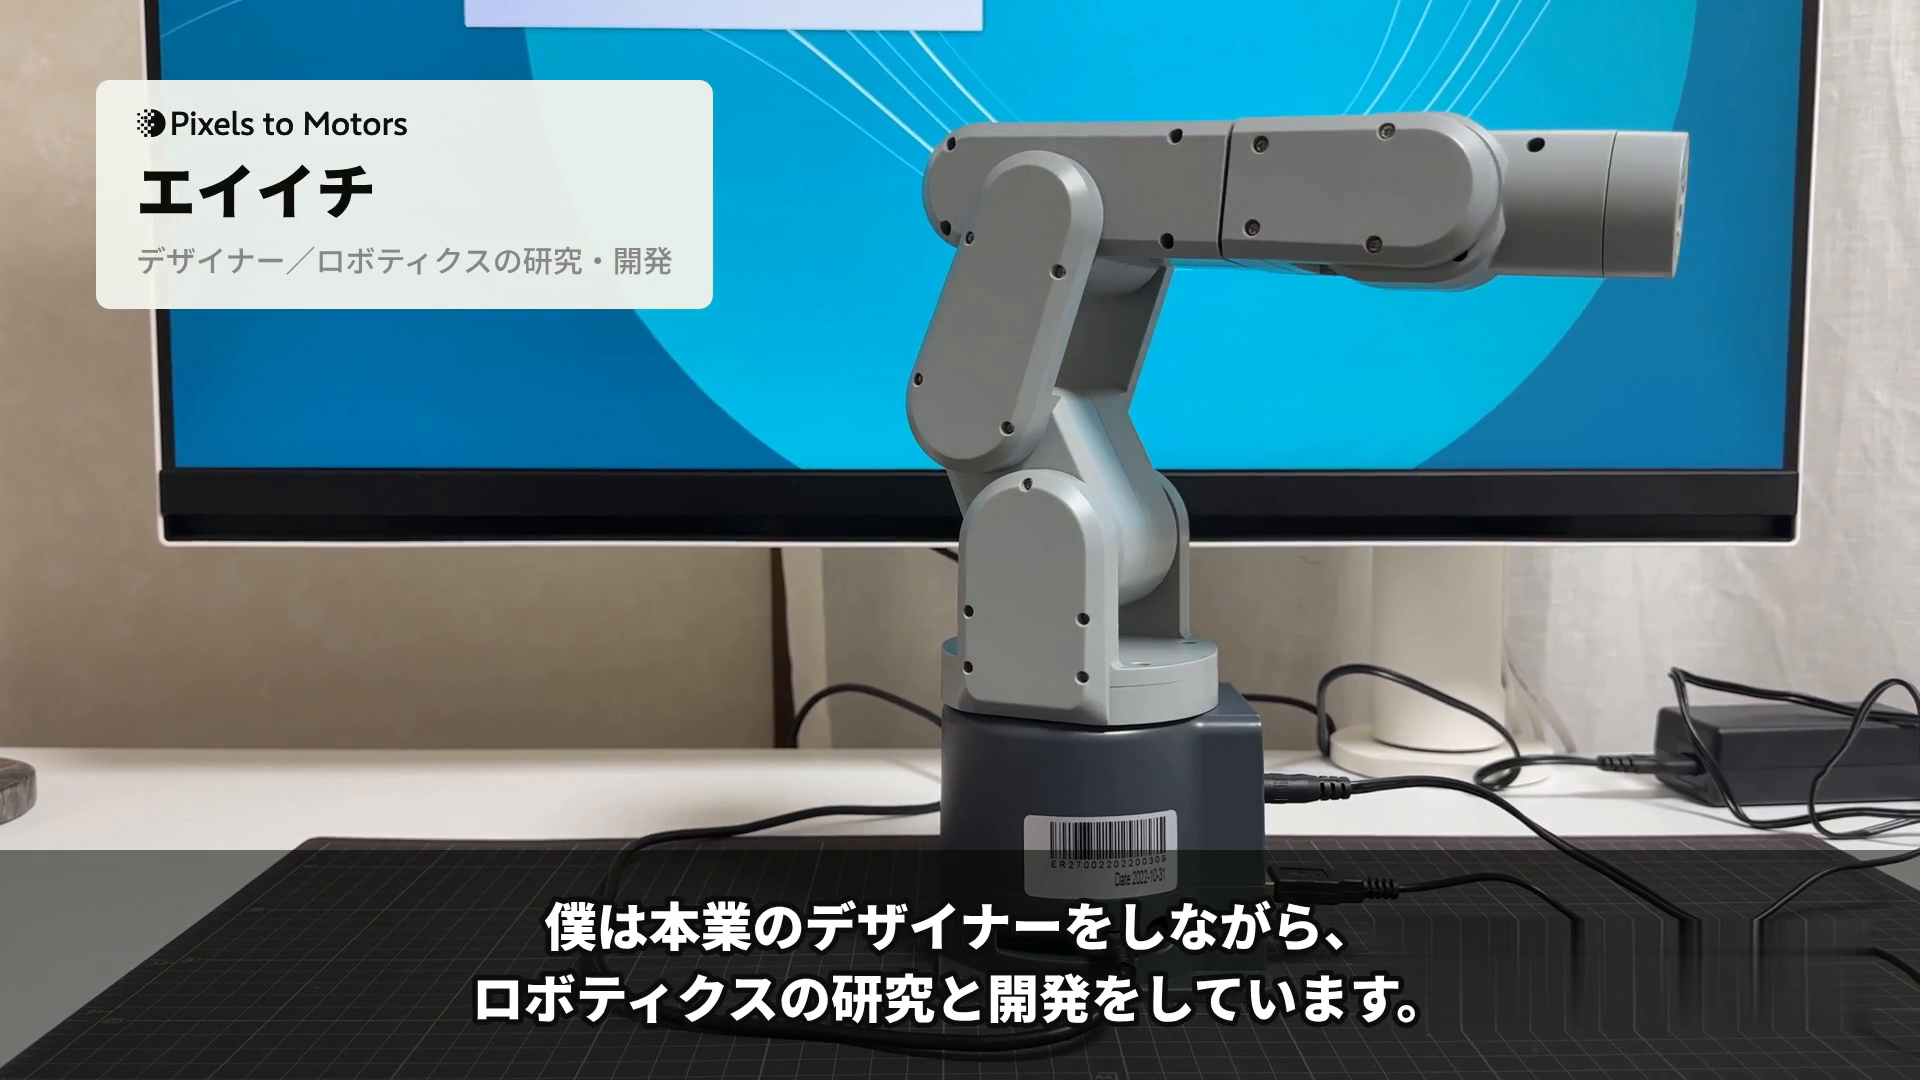
自己紹介の文は「僕は本業のデザイナーをしながら、ロボティクスの研究と開発をしています。自宅の机の上でロボットアームを動かして、その記録を公開しています。」に固定しました。動画の中だけでなく、台本のドキュメントと codex への依頼ファイルにも同じ文言が残っていたので、そちらも直しています。
画面右上とテロップの「PIXELS TO MOTORS」の文字は、Pixels to Motors のロゴ画像に差し替えました。もらったロゴ画像(灰色の地に黒)から、地の明るさとの差で透明度を計算して切り抜き、文字の色をスライドの黒にそろえています。
背景と文字の色を、記事サムネイルの #F5F5F0 と #0D0D0D に合わせた
動画の背景色やテキスト色を記事のサムネイルと同じ色に変更してください(差し色で使っているオレンジや水色は少し濃くするくらいでカラーを使うのはOKです) 色だけの話です。他は修正しないでください。
記事のサムネイル画像から色を拾い、次の色に置き換えました。レイアウトと文言には手を付けていません。
用途 | 変更前 | 変更後 |
|---|---|---|
背景 | #F4F2ED | #F5F5F0 |
文字 | #17191E | #0D0D0D |
薄い文字 | #5F636B | #888888 |
区切り線 | #CFCAC0 | #D6D6D1 |
オレンジ(強調) | #D9542B | #C4471F |
青(対比のもう一方) | #1F7FB0 | #1A6C98 |
オレンジと青は、色覚の違いがあっても見分けられるかを検証するスクリプト(validate_palette.js)にかけ、新しい背景色の上で全項目を通過することを確かめてから使っています。検証の出力は後半の実行ログにあります。
30cmの食い違いは、アームが外れた距離ではなく、爪先の位置の決め方の違いだった
30cmも違うって合っている? 30mmとかじゃなくて?なんか例が良くない?
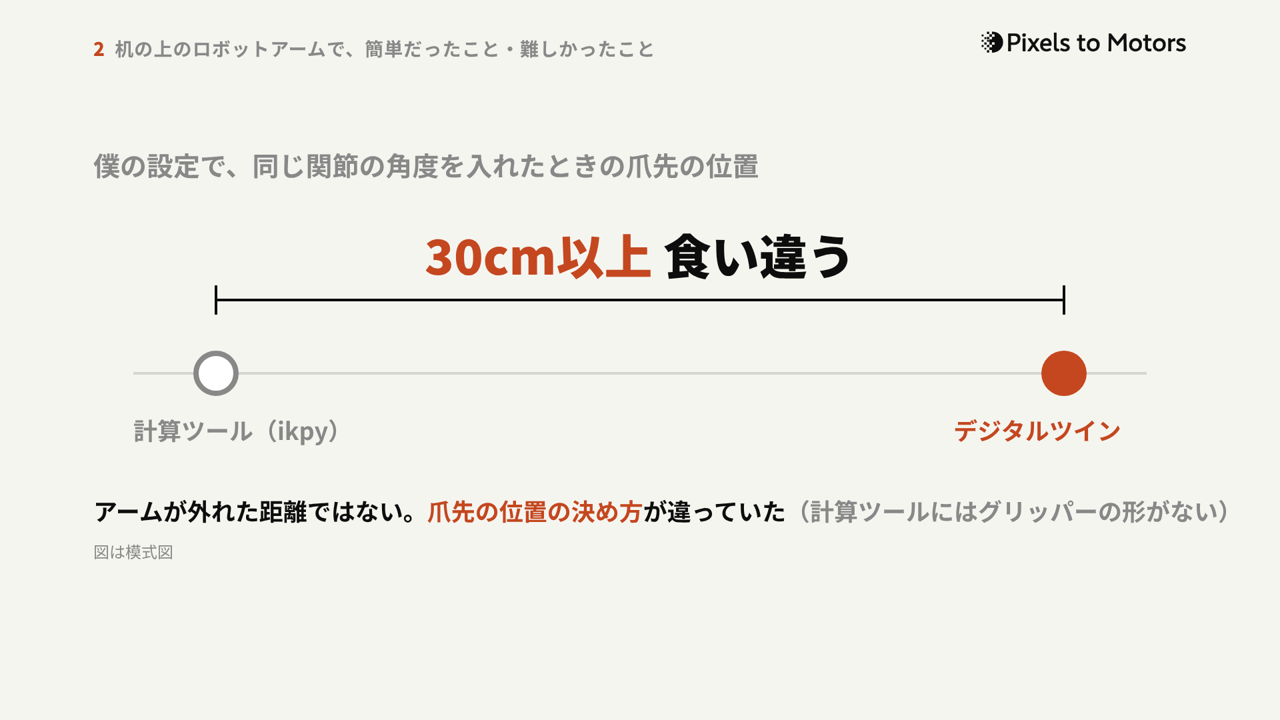
数字そのものは記録どおりでした。公開記事 LOG222 に「同じ関節角を入れても、先端位置が300mm以上違う」とあります。ただ、同じ記事に理由も書かれていました。ikpy(関節の角度から先端の位置を計算する一般的なライブラリ)には、グリッパーの3D形状もデジタルツインの物理も入っていません。一方、デジタルツインで作った表の爪先の位置は、Unity の中でグリッパー先端の3Dモデルが実際に来た場所です。2つは、そもそも爪先の位置の決め方が違っていました。
mechArm 270 の腕の長さは約27cmです。「30cm食い違う」とだけ聞くと、腕の長さより大きく外れたように受け取れてしまいます。差し替え候補として、LOG222 にある実機のずれ(赤いブロックが6回とも同じ向きに、箱の中心から約5cmずれて落ちた件)も挙げましたが、30cm のまま説明を足す形を選んでもらいました。台本に「これは、アームが30cm外れた、という意味ではありません」「計算ツールには、グリッパーの形も、デジタルツインの物理も入っていなくて、爪先の位置の決め方そのものが違っていたんです」の2文を足し、図にも同じ説明を1行入れています。
打ち出し・説明・補足の3段階で、画面に強弱をつけた
全部じゃなくていいのですが、動画内の説明テキストの内容を強弱をつけるようにしたいです。 打ち出しを強くしたい、簡潔にわかりやすく内容を伝えたい、タイトルをして使いたいなどの時はテキストを大きくわかりやすくしたり、わかりやすい図解を入れ込んだりして動画内の内容がうまく伝わるように変化をつけたいです。
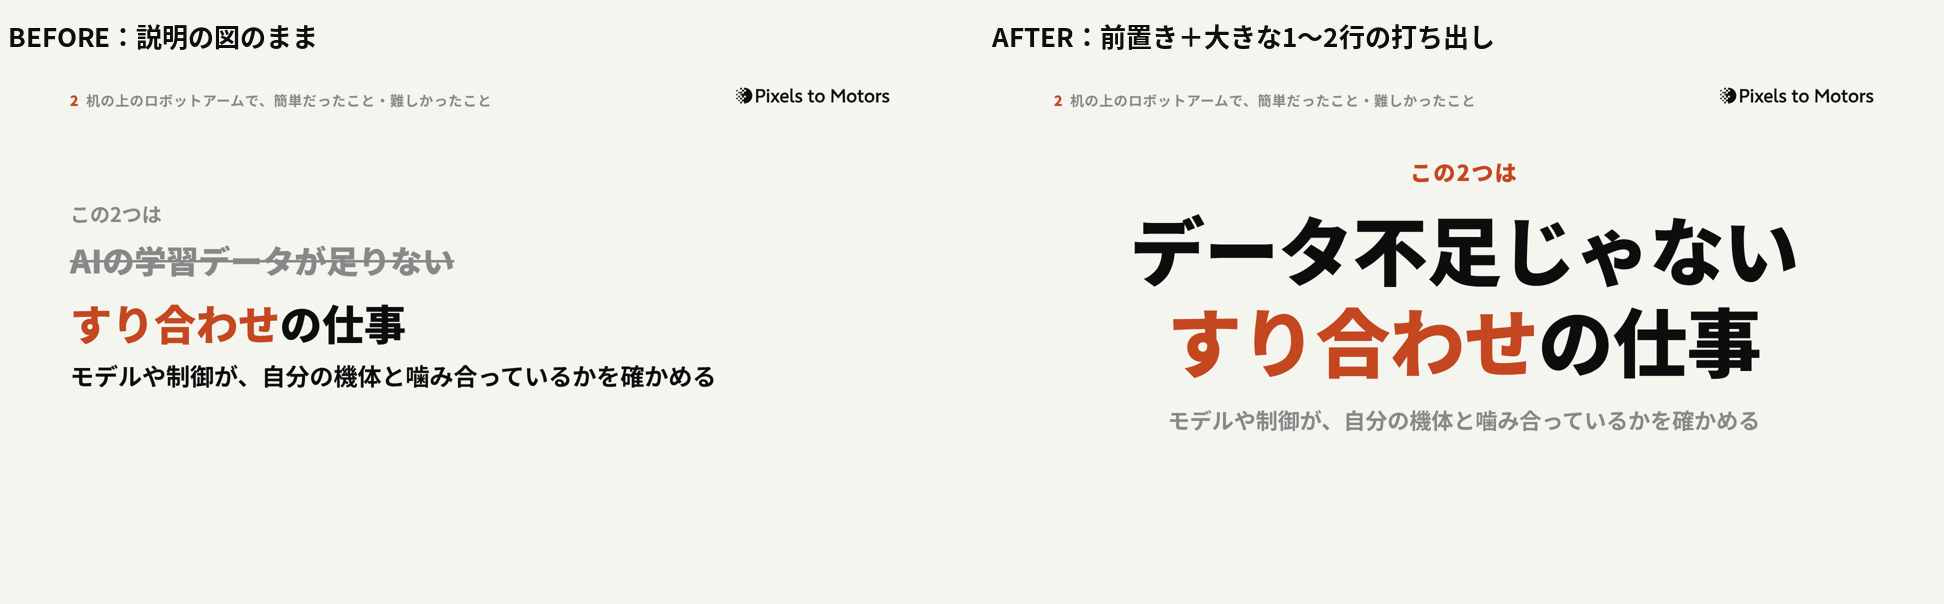
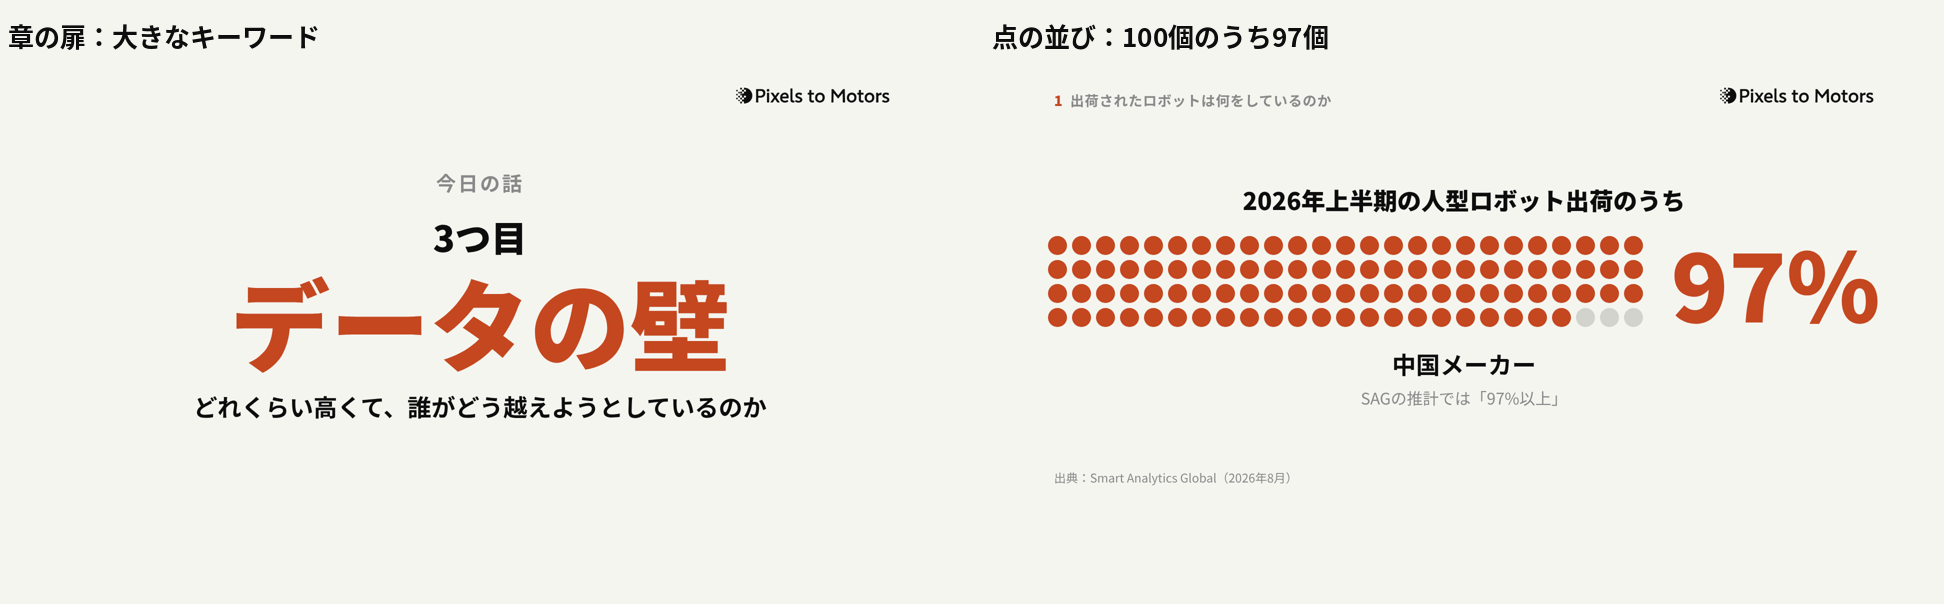
参考にした動画の画面を見ると、小さな色付きの前置き(例「韓国の甲状腺がん」)の下に、1〜2行の大きな文(「診断は15倍/亡くなる人は増えず」)を置いていました。章の始まりには「今日の話 → 2つ目 → 見つからない」のように大きなキーワードを置き、割合は点の並びで見せていました。
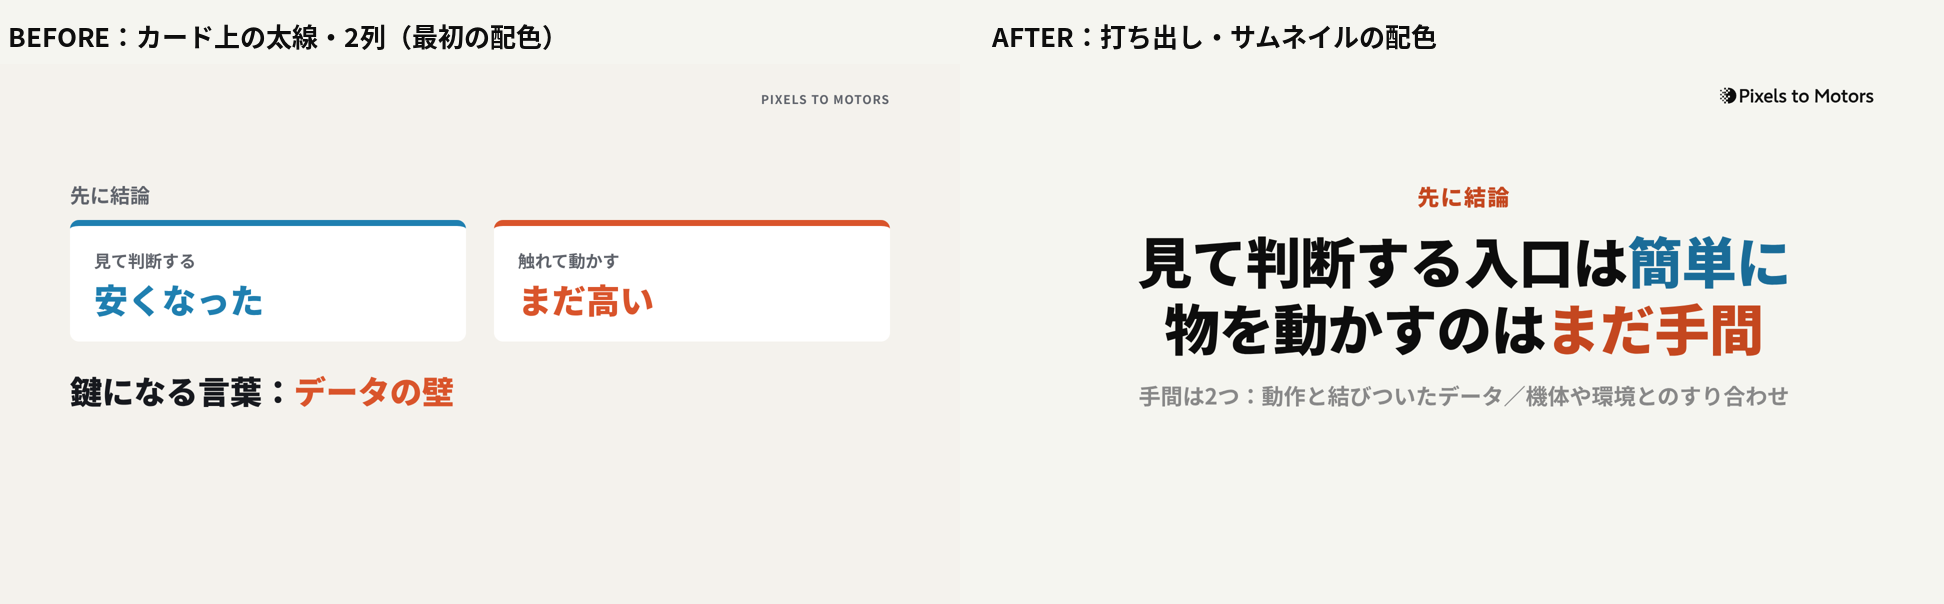
これを、背景・文字・差し色はそのままで取り入れ、40ある場面のうち11場面だけ切り替えました。
段階 | 使った場面 | 見た目 |
|---|---|---|
打ち出し | 冒頭の問いかけ、結論、「すり合わせの仕事」、データの壁、比べ方の注意、最後の答え(6場面) | 色付きの前置き(44px)+ 1〜2行の大きな文(110〜150px) |
章の扉 | 4つの章の始まり | 「今日の話」→「1つ目」→ 大きなキーワード(200px・オレンジ)→ 章の問い |
点の並び | 中国メーカーの割合 | 100個の点のうち97個に色を付ける |
打ち出しの文は、字幕をそのまま大きくするのではなく、その場面で一番残したい一言に縮めています。たとえば字幕が「この2つは、AIの学習データが足りない、という話とは別です。」の場面は、「データ不足じゃない/すり合わせの仕事」にしました。
動画ファイルは、iCloud ではなく KIOXIA の videos/ に置いた
動画はデータが重くなるのでSSDの容量を圧迫するので別のフォルダに保管するようにしてください。
動画ファイル(mp4)は、外付け SSD の KIOXIA に r2r2r-data/videos/{動画名}/ を作って置き、iCloud からは消しました。字幕の srt と codex への依頼ファイルは軽いので iCloud に残しています。KIOXIA には、YouTube に上げる高画質の作業用(約47MB)と、確認用の圧縮版(約30MB)の2本を置いています。
ここで1つ問題が起きました。作業環境から Mac へ一度に送れるファイルは30MBまでなので、作業用の動画を12MBずつ4つに分けて送り、Mac 側でつなぎ直しました。ところが、つないだファイルのチェック値(md5)が元と一致しません。調べると、動画の先頭部分を含む1つ目の断片だけが、元より5,875バイト大きくなり、中身も化けていました。2〜4つ目の断片は元と一致していました。1つ目の断片だけを gzip で圧縮した形で送り直し、Mac 側で展開してからつなぐと、チェック値が元と一致しました。転送の途中で、動画の先頭部分だけが何らかの変換を受けたと考えていますが、原因までは確かめていません。
量産のベースとして video_rules.md と制作スクリプト一式を残した
ここまでに決めたことを、動画制作ルール video_rules.md にまとめました。記事の article_rules.md と同じく、動画を作るときに最初に読む正本です。プロジェクトの資料と、iCloud の 動画/_制作ベース/ の両方に置き、同じフォルダに制作スクリプト一式とロゴの透過 PNG を入れています。
video_rules.md は8つの節でできています。動画の構成(解説回の型と時間配分)、台本のルール(codex の検証で直した点から作った11項目)、ナレーション(読み替え表と間延びの検査)、画面デザイン(色・文字の大きさ・図の型・強弱の3段階・やらない表現)、字幕、実機の映像とテロップ、書き出しと保存、まだ決まっていない項目、です。全文は後半に載せています。
MASTER(プロジェクト全体の方針文書)の保存先テーブルと、KIOXIA の README.md のフォルダ構成には、videos/ と _制作ベース の行がまだありません。この2か所の追記は、本人が行う予定です。
まだ決まっていない8項目は、未決のまま残した
量産の前に決めることが残っています。video_rules.md の8節に、いまの状態と決めることを並べています。
項目 | いまの状態 | 決めること |
|---|---|---|
ナレーションの声 | Open JTalk の仮音声。抑揚が機械的 | 本人の声で録るか、品質の高い音声合成にするか。srt に1文ごとの時間が入っているので、それに合わせて録れば映像はそのまま使える |
図解の動き | すべて静止画 | 数字のカウントアップや矢印が伸びるなどの動きを入れるか |
背景の映像 | 実機映像は自己紹介・節2・エンディングだけ | 解説中も実機映像を薄く敷くか、図解だけにするか |
BGM・効果音 | なし | 使うか。使うなら YouTube で収益化できる音源から選ぶ |
ジングル | 文言だけ | 音とロゴの動きを付けるか |
サムネイル | まだない | 記事サムネイルと同じ配色・線画のトーンで作るか |
番組名 | 未定 | 決める |
概要欄のチャプター | まだない | srt の節の開始時刻から作れる |
制作スクリプトの全文
作業環境(Ubuntu、Python 3.13、ffmpeg 6.1.1、Playwright の Chromium、Noto Sans CJK JP)で動かした最終版です。Open JTalk は apt-get install open-jtalk open-jtalk-mecab-naist-jdic hts-voice-nitech-jp-atr503-m001 で入れています。実機の映像は src/c1.mp4(LOG123)、src/c2.mp4(LOG124)、src/c3.mov(デジタルツインの並列スキャン)、src/c4.mov(デジタルツイン)として置き、ロゴは logo_dark.png として同じフォルダに置いて動かします。
narration.py(台本・読み替え表・読み上げ用の読点)
# -*- coding: utf-8 -*-
# 台本「ロボットにもChatGPTの瞬間はもう来たのか」読み上げ原稿(codex 検証反映版)
# 各要素: (scene_id, 字幕テキスト, 後ろの間[秒])  間を省略すると 0.35 秒
SEGS = [
 # 0 フック
 ("hook_ship", "調査会社Counterpointの推計では、今年の上半期に出荷された人型ロボットは、"),
 ("hook_ship", "世界で2万2000台を超えました。前の年の同じ時期の、およそ4倍です。", 0.6),
 ("hook_forecast", "年末までには、5万台を超えると予想されています。"),
 ("hook_forecast", "家事をする人型ロボットの予約販売も、去年の秋から始まっています。", 0.6),
 ("hook_question", "こういうニュースを見ると、ChatGPTが出たときみたいに、"),
 ("hook_question", "ロボットも一気に賢くなって、家に来るのはもうすぐ、って感じませんか。", 0.9),
 # 1 自己紹介
 ("title", "Pixels to Motors。こんにちは、エイイチです。"),
 ("title", "僕は本業のデザイナーをしながら、ロボティクスの研究と開発をしています。"),
 ("title", "自宅の机の上でロボットアームを動かして、その記録を公開しています。"),
 ("title", "作る側の机の上から見える、フィジカルAIの話をします。", 0.8),
 # 2 今日の問い
 ("question", "今日の問いは、ロボットにもChatGPTのような瞬間は、もう来たのか、です。"),
 ("question", "ここでいうChatGPTの瞬間は、専門家じゃなくても、"),
 ("question", "いろんな仕事にすぐ使えるようになる転換点、という意味です。", 0.7),
 ("define", "フィジカルAIっていうのは、現実の世界を認識して、行動するAIのことです。"),
 ("define", "自動運転もここに入りますが、"),
 ("define", "今日は主に、アームや人型ロボットが物を扱う話に絞ります。", 0.6),
 # 3 結論と立場
 ("answer", "先に結論を言っちゃうと、写真を見せて判断させる入口は、ぐっと簡単になりました。"),
 ("answer", "でも、物を確実に動かすところは、まだ手間がかかるんですよ。"),
 ("answer", "その手間は大きく2つあります。"),
 ("answer", "動作と結びついたデータが集めにくいこと。そして、機体や環境とのすり合わせです。", 0.6),
 ("stance", "先に言っておくと、フィジカルAIはまだ使えない、と言いたいわけじゃないんです。"),
 ("stance", "どこまで来ていて、どこで手間がかかっているのかを、分けて見たいんです。", 0.6),
 # 4 目次
 ("toc", "大きく3つあります。"),
 ("toc", "出荷が4倍になったロボットは、何をしているのか。"),
 ("toc", "僕の机の上のロボットアームで、何が簡単で、何が難しかったのか。"),
 ("toc", "そして、データの壁はどれくらい高くて、誰がどう越えようとしているのか。"),
 ("toc", "最後に僕の見立てを話します。", 0.9),
 # 5 節1
 ("c1", "1つ目、出荷が4倍になったロボットは、何をしているのか、です。", 0.7),
 ("use", "Counterpointの推計では、出荷された人型ロボットの6割以上が、"),
 ("use", "展示やイベントで動きを見せる用途と、研究やデータ生産の用途なんですよ。", 0.6),
 ("datacollect", "データ生産っていうのは、ロボットが学ぶための動きの記録を作ることです。"),
 ("datacollect", "人が遠隔で動かして記録するやり方も、自律で動いた記録を残すやり方もあります。"),
 ("datacollect", "ただ、研究向けの台数が全部データ集めに使われる、という意味ではありません。"),
 ("datacollect", "それでも、用途の分類に「データ生産」という項目があること自体が、"),
 ("datacollect", "今の段階をよく表していると思います。", 0.7),
 ("conflict", "一方で、別の調査会社のSmart Analytics Globalは、"),
 ("conflict", "同じ半年の出荷を約1万9100台と推計していて、"),
 ("conflict", "産業・商業用途が7割を超えた、としています。"),
 ("conflict", "総数も分類も違うので、この2つは、単純な裏表としては比べられません。"),
 ("conflict", "それに、出荷台数は、そのまま自律的に働いている台数でもないんです。", 0.7),
 ("china", "もう1つ、SAGの推計では、出荷の97%以上が中国のメーカーです。", 0.7),
 ("neo", "家のほうも見てみます。"),
 ("neo", "アメリカの1Xという会社は、家事をする人型ロボット、NEOの予約を、去年の10月に始めました。"),
 ("neo", "2万ドルの早期購入枠は、今年配送の予定で、月499ドルのプランは、その後です。"),
 ("neo", "最初は基本的な自律機能だけで、知らない作業は、"),
 ("neo", "予約した時間に、1Xの担当者が遠隔で手伝う仕組みなんですよ。"),
 ("neo", "10月11日の時点で、一般のお客さんへの配送開始を示す公式発表は、"),
 ("neo", "僕が確認した範囲では、見つかっていません。", 0.7),
 ("neo_point", "これ、ちょっと考えさせられませんか。"),
 ("neo_point", "売っているのはロボットだけじゃなくて、遠隔で手伝う人と、"),
 ("neo_point", "そこで動きを覚えていく仕組みごとなんです。", 0.7),
 ("bridge1", "工場でも家でも、使いながらデータを集める動きが出てきているんですよ。"),
 ("bridge1", "じゃあ、物を動かすのは、何がそんなに大変なのか。"),
 ("bridge1", "まず、僕の机の上の話をさせてください。", 0.9),
 # 6 節2
 ("c2", "2つ目、僕の机の上のロボットアームで、何が簡単で、何が難しかったのか、です。", 0.7),
 ("v_real", "ここは僕自身の話から始めさせてください。"),
 ("v_real", "僕は自宅の机で、mechArm 270という小さなロボットアームを動かしています。"),
 ("v_real", "赤いブロックを掴んで、箱に置く。"),
 ("trials", "それだけの作業を、失敗も含めて650回以上試して、全部台帳に残しています。", 0.7),
 ("easy", "まず、簡単だったほうから話します。掴めたかどうかの判定です。"),
 ("easy", "iPhoneで撮った写真をAIに見せて、「ブロックを掴めていますか」と聞くと、"),
 ("easy", "はい、いいえで答えが返ってくる。この入口は、驚くほど簡単でした。"),
 ("easy", "ただ、答えが返ることと、毎回正しいことは別です。"),
 ("easy", "どこまで任せられるかは、失敗例も含めて確かめる必要があります。", 0.7),
 ("hard", "難しかったのは、動かすほうでした。", 0.6),
 ("gap", "ロボットアームの爪先がどこに来るかは、普通は関節の角度から計算で出します。"),
 ("gap", "ところが、ikpyという計算ツールで出した爪先の位置と、"),
 ("v_twin", "パソコンの中に作ったアームの分身、デジタルツインで動かした位置が、"),
 ("gap", "僕の設定では、同じ関節の角度なのに、30cm以上食い違ったんです。"),
 ("gap", "これは、アームが30cm外れた、という意味ではありません。"),
 ("gap", "計算ツールには、グリッパーの形も、デジタルツインの物理も入っていなくて、爪先の位置の決め方そのものが違っていたんです。", 0.7),
 ("v_scan", "だから僕は、分身の中でアームを動かして、"),
 ("v_scan", "関節の角度と爪先の位置の対応表を作りました。"),
 ("v_scan", "これは計算の表で、実機で全部の点を測ったわけではありません。", 0.7),
 ("silent", "もう1つ困ったのが、黙る失敗です。"),
 ("silent", "僕の機体とソフトの組み合わせでは、肩の関節に、90度ちょっとを超える値を送ると、"),
 ("silent", "エラーが出ないのに、アームが動かないことがありました。"),
 ("silent", "ログを1行ずつ見て、やっと気づきました。", 0.7),
 ("point2", "でも、ポイントはここなんです。"),
 ("point2", "この2つは、AIの学習データが足りない、という話とは別です。"),
 ("point2", "モデルや制御が、僕の機体と噛み合っているかを確かめる、すり合わせの仕事でした。"),
 ("point2", "ほかの環境で学んだことを持ってくる研究も進んでいます。"),
 ("point2", "それでも、僕の構成でちゃんと動くかは、ここで確かめるしかなかったんです。", 0.6),
 ("point2", "じゃあ、もう1つの手間、データのほうは、業界全体でどうなっているのか。", 0.9),
 # 7 節3
 ("c3", "3つ目、データの壁はどれくらい高くて、誰がどう越えようとしているのか、です。", 0.7),
 ("years", "カリフォルニア大学バークレー校のロボット研究者、"),
 ("years", "ケン・ゴールドバーグさんが、去年、こんな概算を紹介しています。"),
 ("years", "画像と言葉を扱うAIの学習資料を、"),
 ("years", "人が読んだり見たりする時間に換算すると、約10万年規模になる。", 0.7),
 ("wall", "それに比べて、ロボットが手を動かすための、動作と結びついた経験は、集めにくい。"),
 ("wall", "ゴールドバーグさんは、これを「10万年のデータの壁」と呼んでいます。"),
 ("wall", "ただ、ロボットにも同じ量が必要だと分かったわけではありません。"),
 ("wall", "集めにくい、という問題提起なんです。", 0.6),
 ("wall", "ここで、じゃあロボットにChatGPTの瞬間は当分来ない、"),
 ("wall", "と言いたくなるじゃないですか。でも、ちょっと待ってほしいんです。", 0.7),
 ("gen", "アメリカのGeneralistという会社は、人が手で作業する様子を、"),
 ("gen", "安い装着型の機材で記録して集めています。"),
 ("gen", "会社の発表では、去年の11月に27万時間、今年の4月に50万時間を超えました。", 0.6),
 ("gen2", "さらに8月には、簡単で短い作業なら、"),
 ("gen2", "数秒の実演を見せるだけで、新しい作業をこなす例も発表しています。"),
 ("gen2", "ただ、本人たちも、作業は簡単で短く、成功率はまだ控えめだと書いています。"),
 ("gen2", "それでも、「動かすには毎回大量の専用データが必要」とは、言い切れなくなってきました。", 0.7),
 ("compare", "ここで1つ、注意があります。"),
 ("compare", "作業を記録した時間と、10万年という数字は、そのまま比べられません。"),
 ("compare", "何倍足りないかより、いろんな場面の経験を、どれだけ広く集められるかが問題なんです。", 0.7),
 ("dirt", "つまり、壁はまだ高い。でも、壁の前でみんなが土を積み始めている。"),
 ("dirt", "1Xが家の中で遠隔で手伝いながら動きを覚えさせているのも、"),
 ("dirt", "Generalistが人の手作業を記録しているのも、同じ壁に向かっている動きなんです。", 0.7),
 ("notall", "ただ、ここで「なんだ、まだ全然ダメなのか」で"),
 ("notall", "片付けてしまうのも違うんです。"),
 ("notall", "写真を見せて判断させる入口は、僕の机の上でも、もう普通に使えています。", 0.6),
 ("notall", "じゃあ、この2つが混ざっている今、ロボットのニュースの何を見ればいいのか。", 0.9),
 # 8 見立て
 ("c4", "ここからが、僕の一番言いたいことです。", 0.7),
 ("q", "ロボットのニュースを見たときの問いが、2つに変わるんですよ。", 0.6),
 ("q1", "1つは、そのロボットは自律で動いているのか、人が遠隔で動かしているのか、です。"),
 ("q1", "デモ動画を見るときは、自律か遠隔操作か、"),
 ("q1", "再生速度や、人が手を出した条件が書かれているかを見ます。", 0.7),
 ("q2", "もう1つは、その仕事は「見て判断する」で済むのか、"),
 ("q2", "「触れて動かす」精度が要るのか、です。"),
 ("q2", "棚の商品が足りているかを見るのは、前者です。"),
 ("q2", "柔らかい物を潰さずに掴むのは、後者です。"),
 ("q2", "前者は、手軽に試せるところまで来ています。ただ、どこまで任せられるかは、現場で確かめる必要がある。"),
 ("q2", "後者は、その現場の機体と環境に合わせて、すり合わせる仕事が、まだ残っています。", 0.7),
 ("gofe", "ゴールドバーグさんは、昔ながらのエンジニアリングと学習を組み合わせて、"),
 ("gofe", "現場で役に立つ仕事をしながら、データを集めていくのが近道だ、と言っています。"),
 ("gofe", "僕の机の上も、AIと従来の制御を組み合わせる点では通じています。"),
 ("gofe", "ただ、現場で働きながらデータが増える仕組みとは、まだ規模も段階も違います。", 0.7),
 ("motion", "で、作る側として、もう1つ言わせてください。"),
 ("motion", "データの話と並行して、もう1つ要るのが「どう動くか」の設計です。"),
 ("motion", "例えばロボットが人に物を渡すとき、"),
 ("motion", "何秒待って手を開けば、人は安心して受け取れるのか。"),
 ("motion", "これは、成功か失敗かの判定だけでは出てこない。"),
 ("motion", "人が安心できる動きを設計する仕事も、同時に必要なんだと、僕は見ています。", 0.9),
 # 9 回答
 ("answer2", "じゃあ、冒頭の問いに答えますね。", 0.4),
 ("answer2", "僕の机では、写真を見せて判断させる入口は、ずっと簡単になりました。"),
 ("answer2", "一方、物を確実に動かすには、機体や環境とのすり合わせが、まだ必要でした。"),
 ("answer2", "その負担を減らす研究は、急速に進んでいます。"),
 ("answer2", "でも、いろんな家で、安全に家事を任せられる転換点まで来たかは、まだ判断できません。", 0.7),
 ("action", "ロボットのデモ動画を見たら、"),
 ("action", "「これは自律なのか、何回やって、何回うまくいったのか」を、"),
 ("action", "一度だけ考えてみてください。"),
 ("action", "それだけで、同じ動画の見え方が、かなり変わると思います。", 0.9),
 # 10 アウトロ
 ("outro", "今日はここまでです。"),
 ("outro", "この動画が気に入ったら、高評価とチャンネル登録をお願いします。"),
 ("outro", "コメントは全部読ませてもらっています。それではまた。", 1.2),
 ("sources", "", 6.0),
]

# TTS 用の読み(字幕は元の表記のまま)
READ = [
 ("Pixels to Motors", "ピクセルズ トゥー モーターズ"),
 ("Smart Analytics Global", "スマート アナリティクス グローバル"),
 ("Counterpoint", "カウンターポイント"),
 ("ChatGPT", "チャットジーピーティー"),
 ("Generalist", "ジェネラリスト"),
 ("mechArm 270", "メックアーム ニーナナゼロ"),
 ("iPhone", "アイフォーン"),
 ("ikpy", "アイケーパイ"),
 ("NEO", "ネオ"),
 ("1X", "ワンエックス"),
 ("SAG", "エスエージー"),
 ("AI", "エーアイ"),
 ("30cm", "さんじゅっセンチ"),
 ("爪先", "つめさき"),
 ("1万9100台", "いちまんきゅうせんひゃくだい"),
 ("値を送る", "あたいを送る"),
 ("「", ""), ("」", ""),
]

# 間延び対策:ひと息が長い文だけ、読み上げ用に読点を足す(字幕は変えない)
OVERRIDE = {
 "同じ半年の出荷を約1万9100台と推計していて、": "同じ半年の出荷を、約1万9100台と、推計していて、",
 "工場でも家でも、使いながらデータを集める動きが出てきているんですよ。": "工場でも家でも、使いながら、データを集める動きが、出てきているんですよ。",
 "ほかの環境で学んだことを持ってくる研究も進んでいます。": "ほかの環境で学んだことを、持ってくる研究も、進んでいます。",
 "ここで、じゃあロボットにChatGPTの瞬間は当分来ない、": "ここで、じゃあ、ロボットに、ChatGPTの瞬間は、当分来ない、",
 "1Xが家の中で遠隔で手伝いながら動きを覚えさせているのも、": "1Xが、家の中で、遠隔で手伝いながら、動きを覚えさせているのも、",
}

def reading(t):
    t = OVERRIDE.get(t, t)
    for a, b in READ:
        t = t.replace(a, b)
    return t
tts2.py(読み上げ音声の生成と間延びの検査)
import subprocess, json, sys, re, wave
import numpy as np
sys.path.insert(0,'.')
from narration import SEGS, reading
VOICE='/usr/share/hts-voice/nitech-jp-atr503-m001/nitech_jp_atr503_m001.htsvoice'
DIC='/var/lib/mecab/dic/open-jtalk/naist-jdic'
SR=48000
def synth(text,base):
    w=base+'.wav'; l=base+'.log'
    subprocess.run(['open_jtalk','-m',VOICE,'-x',DIC,'-r','1.08','-fm','-1','-a','0.55','-jf','1.0','-ow',w,'-ot',l],input=text.encode(),check=True)
    log=open(l,encoding='utf-8',errors='ignore').read()
    ph=[]
    for x in log.split('[Output label]')[1].strip().splitlines():
        m=re.match(r'(\d+) (\d+) \S+?\^\S+?-(\S+?)\+',x)
        if m: ph.append((int(m.group(1))/1e7,int(m.group(2))/1e7,m.group(3)))
    with wave.open(w) as f: a=np.frombuffer(f.readframes(f.getnframes()),dtype=np.int16)
    inner=[(e-s) for s,e,p in ph[1:-1] if p not in('pau','sil')]
    pron=''.join(x.split(',')[9] for x in log.split('[Text analysis result]')[1].split('[Output label]')[0].splitlines() if x.count(',')>9)
    return a,ph,max(inner) if inner else 0,pron
out=[]
for i,s in enumerate(SEGS):
    scene,text=s[0],s[1]; pause=s[2] if len(s)>2 else 0.35
    d=0.0; note=''
    if text:
        r=reading(text)
        a,ph,worst,pron=synth(r,f'tts/{i:03d}')
        if worst>0.3:
            parts=[p for p in re.split(r'(?<=[、。])',r) if p]
            audio=[]; worst2=0
            for n,p in enumerate(parts):
                b,ph2,w2,_=synth(p,f'tts/{i:03d}_p{n}'); worst2=max(worst2,w2)
                st=int(ph2[0][1]*SR) if n>0 else 0
                en=int(ph2[-1][0]*SR) if n<len(parts)-1 else len(b)
                audio.append(b[st:en])
                if n<len(parts)-1: audio.append(np.zeros(int(0.12*SR),dtype=np.int16))
            a=np.concatenate(audio)
            with wave.open(f'tts/{i:03d}.wav','wb') as f:
                f.setnchannels(1); f.setsampwidth(2); f.setframerate(SR); f.writeframes(a.tobytes())
            note=f'STRETCH {worst:.2f}s -> split {len(parts)} parts, max {worst2:.2f}s'
            print(i,text[:30],note)
        d=len(a)/SR
        if re.search(r'[0-9]|爪先',text): print('READ',i,text[:24],'→',pron[:60])
    out.append(dict(i=i,scene=scene,text=text,dur=d,pause=pause,note=note))
json.dump(out,open('tts/index.json','w'),ensure_ascii=False,indent=0)
tot=sum(o['dur']+o['pause'] for o in out)
print('segments',len(out),'total %d:%02d'%(tot//60,tot%60))
scenes.py(場面ごとの図解・テロップ・実機映像の指定)
# -*- coding: utf-8 -*-
import base64 as _b64, os as _os
LOGO='data:image/png;base64,'+_b64.b64encode(open(_os.path.join(_os.path.dirname(_os.path.abspath(__file__)),'logo_dark.png'),'rb').read()).decode()
# 1920x1080 の各シーン(字幕は別レイヤー)。下端 230px は字幕用に空ける。
# v2: カード上の太線をやめ、左右は細い縦線で区切る。色は文字色だけで区別する。
BLUE = "#1A6C98"   # 見て判断する
RED = "#C4471F"    # 触れて動かす/強調
INK = "#0D0D0D"
SUB = "#888888"
BG = "#F5F5F0"
RULE = "#D6D6D1"

CSS = f"""
*{{margin:0;padding:0;box-sizing:border-box}}
html,body{{width:1920px;height:1080px;overflow:hidden}}
body{{background:{BG};color:{INK};font-family:'Noto Sans CJK JP',sans-serif;}}
.wrap{{position:absolute;left:140px;right:140px;top:96px;bottom:250px;display:flex;flex-direction:column;justify-content:center}}
.tag{{position:absolute;left:140px;top:52px;font-size:28px;font-weight:700;color:{SUB};letter-spacing:.04em}}
.tag b{{color:{RED};margin-right:14px}}
.brand{{position:absolute;right:140px;top:46px;height:34px}}
.kicker{{font-size:40px;font-weight:700;color:{SUB};margin-bottom:22px}}
.h1{{font-size:84px;font-weight:900;line-height:1.25}}
.h2{{font-size:64px;font-weight:900;line-height:1.3}}
.h3{{font-size:48px;font-weight:700;line-height:1.4}}
.p{{font-size:40px;font-weight:500;line-height:1.55;color:{INK}}}
.muted{{color:{SUB}}}
.red{{color:{RED}}} .blue{{color:{BLUE}}}
.hero{{font-size:220px;font-weight:900;line-height:1;letter-spacing:-.02em}}
.hero small{{font-size:90px;font-weight:900;margin-left:10px}}
.src{{position:absolute;left:140px;bottom:236px;font-size:24px;color:{SUB}}}
.row{{display:flex;align-items:stretch}}
.col{{flex:1;padding:10px 56px 10px 0}}
.col + .col{{border-left:2px solid {RULE};padding-left:56px}}
.col .lab{{font-size:34px;font-weight:700;color:{SUB};margin-bottom:14px}}
.col .big{{font-size:66px;font-weight:900;line-height:1.22}}
.col .note{{font-size:34px;line-height:1.5;margin-top:16px}}
.list{{list-style:none}}
.list li{{font-size:46px;font-weight:700;line-height:1.35;padding:22px 0;border-bottom:2px solid {RULE};display:flex;gap:28px;align-items:baseline}}
.list li .n{{font-size:44px;font-weight:900;color:{RED};min-width:60px}}
.list li.dim{{color:{SUB}}}
.chap{{font-size:200px;font-weight:900;color:{RED};line-height:1}}
.pill{{align-self:flex-start;display:inline-block;font-size:30px;font-weight:700;padding:8px 22px;border-radius:999px;background:{INK};color:#fff;margin-bottom:26px}}
.flow{{display:flex;align-items:center;gap:30px}}
.box{{background:#fff;border-radius:18px;padding:34px 40px;font-size:42px;font-weight:700;text-align:center;flex:1}}
.arrow{{font-size:64px;color:{SUB};font-weight:900}}
"""

def page(body, tag=None, brand=True):
    t = f'<div class="tag">{tag}</div>' if tag else ""
    b = f'<img class="brand" src="{LOGO}">' if brand else ""
    return f'<!doctype html><html><head><meta charset="utf-8"><style>{CSS}</style></head><body>{t}{b}{body}</body></html>'

T1 = "<b>1</b>出荷されたロボットは何をしているのか"
T2 = "<b>2</b>机の上のロボットアームで、簡単だったこと・難しかったこと"
T3 = "<b>3</b>データの壁の高さと、越えようとしている会社"
T4 = "<b>4</b>僕の見立て"

def hbar(parts, height=96):
    segs = ""
    for lab, pct, col, tc in parts:
        segs += (f'<div style="flex:{pct};background:{col};height:{height}px;border-radius:6px;'
                 f'display:flex;align-items:center;padding-left:24px;color:{tc};font-size:34px;font-weight:700;white-space:nowrap;overflow:hidden">{lab}</div>')
    return f'<div style="display:flex;gap:4px;width:100%">{segs}</div>'

def two(lab1, big1, lab2, big2, c1="blue", c2="red", size=60, note1="", note2=""):
    n1 = f'<div class="note">{note1}</div>' if note1 else ""
    n2 = f'<div class="note">{note2}</div>' if note2 else ""
    return (f'<div class="row"><div class="col"><div class="lab">{lab1}</div>{n1}<div class="big {c1}" style="font-size:{size}px;margin-top:8px">{big1}</div></div>'
            f'<div class="col"><div class="lab">{lab2}</div>{n2}<div class="big {c2}" style="font-size:{size}px;margin-top:8px">{big2}</div></div></div>')

def chapter(n, title):
    return page(f'<div class="wrap"><div class="chap">{n}</div><div class="h1" style="margin-top:30px">{title}</div></div>')


# --- 強弱の型(2026-10-11 追加)---
# 打ち出し: 小さい前置き(色)+ 1〜2行の大きな文。1行は10字前後まで
def punch(kicker, lines, sub="", kc="red", size=150, tag=None):
    body = "<br>".join(lines)
    sb = f'<div class="h3 muted" style="margin-top:40px;font-size:44px">{sub}</div>' if sub else ""
    return page(f"""<div class="wrap" style="align-items:center;text-align:center">
 <div class="{kc}" style="font-size:44px;font-weight:900;letter-spacing:.06em;margin-bottom:28px">{kicker}</div>
 <div style="font-size:{size}px;font-weight:900;line-height:1.22;letter-spacing:-.01em">{body}</div>{sb}
</div>""", tag=tag)

# 章の扉: 「今日の話」→「1つ目」→ 大きなキーワード → 章の問い
def chapter2(no, keyword, sub):
    return page(f"""<div class="wrap" style="align-items:center;text-align:center">
 <div class="muted" style="font-size:40px;font-weight:700;letter-spacing:.1em">今日の話</div>
 <div style="font-size:72px;font-weight:900;margin-top:26px">{no}</div>
 <div class="red" style="font-size:200px;font-weight:900;line-height:1.1;margin-top:6px">{keyword}</div>
 <div style="font-size:48px;font-weight:700;margin-top:26px">{sub}</div>
</div>""")

# 点の並び: 100個の点のうち n 個に色を付ける(割合を数で見せる)
def dots(n, kicker, label, big, note="", src="", tag=None):
    cells = "".join(f'<span style="width:38px;height:38px;border-radius:50%;background:{RED if i < n else "#D3D3CE"}"></span>' for i in range(100))
    return page(f"""<div class="wrap" style="align-items:center;text-align:center">
 <div style="font-size:48px;font-weight:900;margin-bottom:34px">{kicker}</div>
 <div style="display:flex;align-items:center;gap:56px">
  <div style="display:grid;grid-template-columns:repeat(25,38px);gap:10px">{cells}</div>
  <div class="red" style="font-size:190px;font-weight:900;line-height:1">{big}</div>
 </div>
 <div style="font-size:48px;font-weight:700;margin-top:34px">{label}</div>
 <div class="muted" style="font-size:32px;margin-top:10px">{note}</div>
</div>{f'<div class="src">{src}</div>' if src else ''}""", tag=tag)

S = {}

S["hook_ship"] = page("""
<div class="wrap">
 <div class="kicker">2026年上半期 人型ロボットの世界出荷(推計)</div>
 <div class="hero">22,000<small>台超</small></div>
 <div class="h2" style="margin-top:36px">前年同期の <span class="red">約4倍</span></div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)</div>""")

S["hook_forecast"] = page("""
<div class="wrap">
 <div class="kicker">2026年通年の予想</div>
 <div class="hero">50,000<small>台超</small></div>
 <div class="h3" style="margin-top:44px">家事をする人型ロボットの予約販売も、2025年秋から</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)/1X</div>""")

S["hook_question"] = page("""
<div class="wrap" style="align-items:center;text-align:center">
 <div class="h1">ロボットも、ChatGPTのときみたいに<br><span class="red">一気に賢くなる?</span></div>
</div>""")

S["question"] = page("""
<div class="wrap">
 <div class="pill">今日の問い</div>
 <div class="h1">ロボットにも<span class="red">ChatGPTの瞬間</span>は<br>もう来たのか</div>
 <div class="h3 muted" style="margin-top:44px">ChatGPTの瞬間=専門家でなくても、<br>いろんな仕事にすぐ使えるようになる転換点</div>
</div>""")

S["define"] = page("""
<div class="wrap">
 <div class="kicker">フィジカルAI とは</div>
 <div class="h2">現実の世界を認識して、<span class="red">行動する</span>AI</div>
 <div class="row" style="margin-top:56px;gap:30px">
  <div class="box" style="border:4px solid #0D0D0D">ロボットアーム</div>
  <div class="box" style="border:4px solid #0D0D0D">人型ロボット</div>
  <div class="box muted" style="background:transparent;border:2px dashed #D6D6D1">自動運転<br><span style="font-size:30px">今日は扱わない</span></div>
 </div>
</div>""")

S["answer"] = page(f"""
<div class="wrap">
 <div class="kicker">先に結論</div>
 {two("写真を見せて判断させる入口", "ぐっと簡単になった", "物を確実に動かすところ", "まだ手間がかかる")}
 <div class="h3" style="margin-top:56px">手間は2つ<br>① <span class="red">動作と結びついたデータ</span>が集めにくい<br>② <span class="red">機体や環境とのすり合わせ</span></div>
</div>""")

S["stance"] = page("""
<div class="wrap">
 <div class="h2 muted" style="text-decoration:line-through;text-decoration-thickness:6px">フィジカルAIはまだ使えない</div>
 <div class="h1" style="margin-top:48px">どこまで来ていて、<br>どこで<span class="red">手間がかかっているのか</span>を、<br>分けて見る</div>
</div>""")

S["toc"] = page("""
<div class="wrap">
 <ul class="list">
  <li><span class="n">1</span>出荷が4倍になったロボットは、何をしているのか</li>
  <li><span class="n">2</span>机の上のロボットアームで、何が簡単で何が難しかったか</li>
  <li><span class="n">3</span>データの壁はどれくらい高く、誰がどう越えようとしているか</li>
  <li class="dim"><span class="n">+</span>僕の見立て</li>
 </ul>
</div>""")

S["c1"] = chapter("1", "出荷が4倍になったロボットは、<br>何をしているのか")
S["c2"] = chapter("2", "机の上のロボットアームで、<br>何が簡単で、何が難しかったのか")
S["c3"] = chapter("3", "データの壁はどれくらい高くて、<br>誰がどう越えようとしているのか")
S["c4"] = chapter("4", "僕の見立て")

S["use"] = page(f"""
<div class="wrap">
 <div class="kicker">2026年上半期の人型ロボット出荷の用途(Counterpointの推計)</div>
 {hbar([("展示・イベント + 研究・データ生産 6割以上", 62, RED, "#fff"), ("その他", 38, "#D3D3CE", INK)])}
 <div class="h3" style="margin-top:44px">出荷の <span class="red">6割以上</span> が、<br>動きを見せる用途と、研究・データ生産の用途</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)。帯の長さは「6割以上」を表す目安</div>""", tag=T1)

S["datacollect"] = page(f"""
<div class="wrap">
 <div class="kicker">データ生産 = ロボットが学ぶための、動きの記録を作ること</div>
 <div class="row" style="gap:30px">
  <div class="box">人が遠隔で動かして<br>記録する</div>
  <div class="box">自律で動いた記録を<br>残す</div>
 </div>
 <div class="h3 muted" style="margin-top:40px">※研究向けの台数が、全部データ集めに使われるわけではない</div>
 <div class="h3" style="margin-top:20px">分類に「データ生産」がある = 今の段階を表している</div>
</div>""", tag=T1)

S["conflict"] = page(f"""
<div class="wrap">
 <div class="kicker">同じ2026年上半期の推計</div>
 {two("Counterpoint", "見せる用途+研究・データ生産<br>6割以上", "Smart Analytics Global(SAG)", "産業・商業用途<br>7割超", c1="", c2="", size=52, note1="出荷 22,000台超", note2="出荷 約19,100台")}
 <div class="h3" style="margin-top:46px">総数も分類も違う → <span class="red">単純な裏表としては比べられない</span></div>
 <div class="h3 muted" style="margin-top:10px">出荷台数 ≠ 自律的に働いている台数</div>
</div>
<div class="src">出典:Counterpoint Research(2026年8月)/Smart Analytics Global(2026年8月)</div>""", tag=T1)

S["china"] = page("""
<div class="wrap">
 <div class="kicker">2026年上半期の人型ロボット出荷のうち、中国メーカーの割合(SAGの推計)</div>
 <div class="hero">97<small>%以上</small></div>
</div>
<div class="src">出典:Smart Analytics Global(2026年8月)</div>""", tag=T1)

S["neo"] = page(f"""
<div class="wrap">
 <div class="kicker">1X「NEO」 家事をする人型ロボット(2025年10月 予約開始)</div>
 {two("値段と配送", "2万ドル:2026年配送予定<br>月499ドル:その後", "動き方", "最初は基本的な自律機能<br>知らない作業は<br>担当者が遠隔で手伝う", c1="", c2="", size=46)}
 <div class="h3" style="margin-top:40px">2026年10月11日時点:一般顧客への配送開始の公式発表は<span class="red">確認できず</span></div>
</div>
<div class="src">出典:1X 公式の発表・注文ページ(2026年10月11日確認)</div>""", tag=T1)

S["neo_point"] = page(f"""
<div class="wrap">
 <div class="kicker">売っているのは</div>
 <div class="flow">
  <div class="box">ロボット</div><div class="arrow">+</div>
  <div class="box">遠隔で<br>手伝う人</div><div class="arrow">+</div>
  <div class="box" style="border:4px solid {RED}">動きを<br>覚えていく仕組み</div>
 </div>
</div>""", tag=T1)

S["bridge1"] = page("""
<div class="wrap">
 <div class="h2">工場でも家でも、<br><span class="red">使いながらデータを集める</span>動き</div>
 <div class="h2 muted" style="margin-top:56px">では、物を動かすのは<br>何がそんなに大変なのか</div>
</div>""", tag=T1)

S["trials"] = page("""
<div class="wrap">
 <div class="kicker">赤いブロックを掴んで、箱に置く</div>
 <div class="hero">650<small>回以上</small></div>
 <div class="h3" style="margin-top:36px">失敗も含めた試行回数。全部台帳に記録</div>
</div>
<div class="src">PICK→PLACE の通し試行(台帳 pick_place_ledger_v3.csv、2026年6月18日〜7月20日で656回)</div>""", tag=T2)

S["easy"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{BLUE}">簡単だった:掴めたかの判定</div>
 <div class="flow">
  <div class="box">iPhoneで<br>撮った写真</div><div class="arrow">→</div>
  <div class="box" style="flex:1.5">AIに聞く<br><span style="font-size:32px;white-space:nowrap" class="muted">「ブロックを掴めていますか」</span></div><div class="arrow">→</div>
  <div class="box" style="border:4px solid {BLUE}"><span class="blue">はい</span>/いいえ</div>
 </div>
 <div class="h3" style="margin-top:48px">ただし、<span class="red">答えが返る ≠ 毎回正しい</span></div>
</div>""", tag=T2)

S["hard"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">難しかった</div>
 <div class="h1">動かすほう</div>
</div>""", tag=T2)

S["gap"] = page(f"""
<div class="wrap">
 <div class="kicker">僕の設定で、同じ関節の角度を入れたときの爪先の位置</div>
 <div style="position:relative;height:400px;margin-top:10px">
  <div style="position:absolute;left:60px;top:250px;right:60px;height:4px;background:{RULE}"></div>
  <div style="position:absolute;left:150px;top:218px;width:68px;height:68px;border-radius:50%;background:#fff;border:8px solid {SUB}"></div>
  <div style="position:absolute;left:4px;top:310px;width:440px;text-align:center;font-size:36px;font-weight:700;color:{SUB}">計算ツール(ikpy)</div>
  <div style="position:absolute;right:150px;top:218px;width:68px;height:68px;border-radius:50%;background:{RED}"></div>
  <div style="position:absolute;right:4px;top:310px;width:440px;text-align:center;font-size:36px;font-weight:700;color:{RED}">デジタルツイン</div>
  <div style="position:absolute;left:184px;right:184px;top:140px;height:4px;background:{INK}"></div>
  <div style="position:absolute;left:182px;top:120px;width:4px;height:44px;background:{INK}"></div>
  <div style="position:absolute;right:182px;top:120px;width:4px;height:44px;background:{INK}"></div>
  <div style="position:absolute;left:0;right:0;top:20px;text-align:center;font-size:72px;font-weight:900"><span class="red">30cm以上</span> 食い違う</div>
 </div>
</div>
<div class="h3" style="position:absolute;left:140px;bottom:290px;font-size:36px">アームが外れた距離ではない。<span class="red">爪先の位置の決め方</span>が違っていた<span class="muted">(計算ツールにはグリッパーの形がない)</span></div>
<div class="src">図は模式図</div>""", tag=T2)

S["silent"] = page(f"""
<div class="wrap">
 <div class="pill">黙る失敗</div>
 <div class="flow">
  <div class="box">肩の関節に<br><span class="red">90度ちょっと</span>を超える値</div><div class="arrow">→</div>
  <div class="box">エラーは出ない<br>アームも動かない</div>
 </div>
 <div class="h3 muted" style="margin-top:44px">僕の機体とソフトの組み合わせで起きたこと</div>
</div>""", tag=T2)

S["point2"] = page("""
<div class="wrap">
 <div class="kicker">この2つは</div>
 <div class="h2 muted" style="text-decoration:line-through;text-decoration-thickness:5px">AIの学習データが足りない</div>
 <div class="h1" style="margin-top:30px"><span class="red">すり合わせ</span>の仕事</div>
 <div class="h3" style="margin-top:20px">モデルや制御が、自分の機体と噛み合っているかを確かめる</div>
</div>""", tag=T2)

S["years"] = page("""
<div class="wrap">
 <div class="kicker">画像と言葉を扱うAIの学習資料を、人が読む・見る時間に換算すると</div>
 <div class="hero">約10<small>万年規模</small></div>
</div>
<div class="src">出典:Ken Goldberg, Science Robotics(2025年8月, Editorial)</div>""", tag=T3)

S["wall"] = page(f"""
<div class="wrap">
 <div class="h1">10万年の<span class="red">データの壁</span></div>
 <div style="margin-top:50px">{two("画像と言葉", "大量にある", "動作と結びついた経験", "集めにくい", size=58)}</div>
 <div class="h3 muted" style="margin-top:40px">※ロボットにも同じ量が必要だと分かったわけではない</div>
</div>
<div class="src">出典:Ken Goldberg, Science Robotics(2025年8月)</div>""", tag=T3)

S["gen"] = page(f"""
<div class="wrap">
 <div class="kicker">Generalist が集めた、人の手作業の記録(会社の発表)</div>
 <div style="display:flex;flex-direction:column;gap:30px;margin-top:10px">
  <div style="display:flex;align-items:center;gap:30px"><div style="width:260px;font-size:36px;font-weight:700;color:{SUB}">2025年11月</div>
   <div style="width:{int(1060*27/50)}px;height:110px;background:#D3D3CE;border-radius:0 6px 6px 0"></div><div style="font-size:52px;font-weight:900;white-space:nowrap">27万時間</div></div>
  <div style="display:flex;align-items:center;gap:30px"><div style="width:260px;font-size:36px;font-weight:700;color:{SUB}">2026年4月</div>
   <div style="width:1060px;height:110px;background:{RED};border-radius:0 6px 6px 0"></div><div style="font-size:52px;font-weight:900;white-space:nowrap">50万時間超</div></div>
 </div>
 <div class="h3" style="margin-top:44px">安い装着型の機材で記録</div>
</div>
<div class="src">出典:Generalist(GEN-0 2025年11月/GEN-1 2026年4月)</div>""", tag=T3)

S["gen2"] = page("""
<div class="wrap">
 <div class="kicker">Generalist GEN-1.5(2026年8月)</div>
 <div class="h2">簡単で短い作業なら、<br><span class="red">数秒の実演</span>で新しい作業をこなす例</div>
 <div class="h3 muted" style="margin-top:40px">本人たちも:作業は簡単で短く、成功率はまだ控えめ</div>
</div>
<div class="src">出典:Generalist「GEN-1.5」(2026年8月19日)</div>""", tag=T3)

S["compare"] = page("""
<div class="wrap">
 <div class="h2">作業を記録した時間と、10万年は<br><span class="red">そのまま比べられない</span></div>
 <div class="h3" style="margin-top:50px"><span class="muted">何倍足りないか</span> より <span class="red">どれだけ広く集められるか</span></div>
</div>""", tag=T3)

S["dirt"] = page("""
<div class="wrap">
 <div class="h2">壁はまだ高い。でも、<br><span class="red">壁の前で土を積み始めている</span></div>
 <ul class="list" style="margin-top:30px">
  <li style="font-size:40px"><span class="n">・</span>1X:家の中で遠隔で手伝いながら、動きを覚えさせる</li>
  <li style="font-size:40px"><span class="n">・</span>Generalist:人の手作業を装着型の機材で記録する</li>
 </ul>
</div>""", tag=T3)

S["notall"] = page(f"""
<div class="wrap">
 {two("写真を見せて判断させる入口", "もう普通に使える", "物を確実に動かす", "すり合わせとデータが<br>まだ要る", size=56)}
 <div class="h3" style="margin-top:48px">「まだ全然ダメ」でも「もう来た」でもない</div>
</div>""", tag=T3)

S["q"] = page("""
<div class="wrap">
 <div class="h1">ロボットのニュースを見る<br><span class="red">問いが2つ</span>に変わる</div>
</div>""", tag=T4)

S["q1"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">問い 1</div>
 <div class="h1">自律で動いているのか、<br>人が遠隔で動かしているのか</div>
 <div class="h3 muted" style="margin-top:36px">デモ動画で見るところ:自律か遠隔か/再生速度/人が手を出した条件</div>
</div>""", tag=T4)

S["q2"] = page(f"""
<div class="wrap">
 <div class="pill" style="background:{RED}">問い 2</div>
 <div class="h2" style="margin-bottom:40px">その仕事には、どちらが要るのか</div>
 {two("見て判断する", "手軽に試せる<br><span style='font-size:34px;color:#888888'>任せる範囲は現場で確かめる</span>", "触れて動かす精度", "現場の機体と環境に<br>すり合わせる仕事が残る", size=48, note1="例:棚の商品が足りているか見る", note2="例:柔らかい物を潰さずに掴む")}
</div>""", tag=T4)

S["gofe"] = page(f"""
<div class="wrap">
 <div class="kicker">ゴールドバーグさんの近道</div>
 <div class="flow">
  <div class="box">昔ながらの工学<br>+学習</div><div class="arrow">→</div>
  <div class="box">現場で役に立つ<br>仕事をする</div><div class="arrow">→</div>
  <div class="box">働きながら<br>データが増える</div>
 </div>
 <div class="h3" style="margin-top:48px">僕の机の上:組み合わせる点は通じる。<span class="muted">規模も段階もまだ違う</span></div>
</div>""", tag=T4)

S["motion"] = page("""
<div class="wrap">
 <div class="kicker">データの話と並行して要るもの</div>
 <div class="h1"><span class="red">どう動くか</span>の設計</div>
 <div class="h3" style="margin-top:36px">ロボットが人に物を渡すとき、<br>何秒待って手を開けば、人は安心して受け取れるのか</div>
 <div class="h3 muted" style="margin-top:28px">成功か失敗かの判定だけでは出てこない</div>
</div>""", tag=T4)

S["answer2"] = page(f"""
<div class="wrap">
 <div class="pill">冒頭の問いへの答え</div>
 {two("写真を見せて判断させる入口", "ずっと簡単になった", "物を確実に動かす", "すり合わせが<br>まだ必要", size=58)}
 <div class="h3" style="margin-top:44px">負担を減らす研究は急速に進んでいる。<br>家で家事を任せられる転換点かは、<span class="red">まだ判断できない</span></div>
</div>""")

S["action"] = page("""
<div class="wrap">
 <div class="kicker">ロボットのデモ動画を見たら</div>
 <div class="h1">自律なのか、何回やって、<br><span class="red">何回うまくいった</span>のか</div>
</div>""")

S["sources"] = page("""
<div class="wrap" style="bottom:90px;justify-content:flex-start;top:120px">
 <div class="h2" style="margin-bottom:30px">出典</div>
 <div class="p" style="font-size:29px;line-height:1.75">
 人型ロボットの出荷:Counterpoint Research(2026年8月)/Smart Analytics Global(2026年8月)<br>
 1X NEO:1X 公式の発表・注文ページ(2026年10月11日確認)<br>
 10万年のデータの壁:Ken Goldberg, Science Robotics(2025年8月, Editorial)<br>
 Generalist:GEN-0(2025年11月)、GEN-1(2026年4月)、GEN-1.5(2026年8月)の公式発表<br>
 ほかの機体から学ぶ研究の例:Gemini Robotics 1.5 技術報告(Google DeepMind)<br>
 実機の数字:Pixels to Motors の台帳(pick_place_ledger_v3.csv)、公開記事 DAY257<br>
 <span class="muted">ナレーションは仮音声(Open JTalk/HTS voice nitech_jp_atr503_m001)</span>
 </div>
</div>""")


# --- 強弱をつける場面の上書き(2026-10-11)---
S["hook_question"] = punch("こういうニュースを見ると", ["ロボットも", "一気に賢くなる?"])
S["answer"] = punch("先に結論", ['見て判断する入口は<span class="blue">簡単に</span>', '物を動かすのは<span class="red">まだ手間</span>'], sub="手間は2つ:動作と結びついたデータ/機体や環境とのすり合わせ", size=110)
S["c1"] = chapter2("1つ目", "出荷の中身", "出荷が4倍になったロボットは、何をしているのか")
S["c2"] = chapter2("2つ目", "机の上の実感", "何が簡単で、何が難しかったのか")
S["c3"] = chapter2("3つ目", "データの壁", "どれくらい高くて、誰がどう越えようとしているのか")
S["c4"] = chapter2("最後に", "ニュースの見方", "僕の見立て")
S["china"] = dots(97, "2026年上半期の人型ロボット出荷のうち", "中国メーカー", "97%", note="SAGの推計では「97%以上」", src="出典:Smart Analytics Global(2026年8月)", tag=T1)
S["point2"] = punch("この2つは", ["データ不足じゃない", '<span class="red">すり合わせ</span>の仕事'], sub="モデルや制御が、自分の機体と噛み合っているかを確かめる", tag=T2)
S["wall"] = punch("ゴールドバーグさんの問題提起", ['10万年の', '<span class="red">データの壁</span>'], sub="動作と結びついた経験は集めにくい(同じ量が必要と分かったわけではない)", kc="muted", tag=T3)
S["compare"] = punch("ひとつ注意", ['<span class="muted">何倍足りないか</span>より', '<span class="red">どれだけ広く</span>集めるか'], sub="作業を記録した時間と10万年は、そのまま比べられない", size=110, tag=T3)
S["answer2"] = punch("冒頭の問いへの答え", ['判断する入口は<span class="blue">来た</span>', '家事を任せるのは<span class="red">まだ</span>'], sub="負担を減らす研究は急速に進んでいる", size=110)

# 動画シーンに重ねるオーバーレイ(透過)
OVERLAY_CSS = f"""
*{{margin:0;padding:0;box-sizing:border-box}}
html,body{{width:1920px;height:1080px;background:transparent;font-family:'Noto Sans CJK JP',sans-serif}}
.lt{{position:absolute;left:96px;top:80px;background:rgba(245,245,240,.94);padding:28px 40px;border-radius:14px}}
.lt .a{{height:30px;display:block;margin-bottom:6px}}
.lt .b{{font-size:60px;font-weight:900;color:{INK};margin-top:4px}}
.lt .c{{font-size:30px;font-weight:500;color:{SUB};margin-top:6px}}
.cap{{position:absolute;left:96px;top:80px;background:rgba(13,13,13,.78);color:#fff;font-size:34px;font-weight:700;padding:14px 26px;border-radius:10px}}
"""
def overlay(body):
    return f'<!doctype html><html><head><meta charset="utf-8"><style>{OVERLAY_CSS}</style></head><body>{body}</body></html>'

O = {
 "title": overlay('<div class="lt"><img class="a" src="'+LOGO+'"><div class="b">エイイチ</div><div class="c">デザイナー/ロボティクスの研究・開発</div></div>'),
 "v_real": overlay('<div class="cap">実機:mechArm 270-Pi 赤いブロックを掴んで箱に置く</div>'),
 "v_twin": overlay('<div class="cap">パソコンの中のアームの分身(Unity のデジタルツイン)</div>'),
 "v_scan": overlay('<div class="cap">デジタルツインの中で動かして、関節の角度と爪先の位置の対応表を作る</div>'),
 "outro": overlay('<div class="lt"><img class="a" src="'+LOGO+'"><div class="b">高評価・チャンネル登録</div><div class="c">コメントは全部読んでいます</div></div>'),
}

# 動画シーン: (ソースファイル, 開始秒, 透かし消しの有無)
VIDEO = {
 "title": ("src/c1.mp4", 0.0, True),
 "v_real": ("src/c2.mp4", 22.0, True),
 "v_twin": ("src/c4.mov", 0.0, False),
 "v_scan": ("src/c3.mov", 0.0, False),
 "outro": ("src/c1.mp4", 8.0, True),
}
render.py(図解・テロップ・字幕を画像にする)
import json, sys, os, html
sys.path.insert(0,'.')
from scenes import S, O
from playwright.sync_api import sync_playwright
idx=json.load(open('tts/index.json'))
os.makedirs('png/scene',exist_ok=True); os.makedirs('png/ovl',exist_ok=True); os.makedirs('png/sub',exist_ok=True)
SUBCSS_OLD="""*{margin:0;padding:0}html,body{width:1920px;height:1080px;background:transparent;font-family:'Noto Sans CJK JP',sans-serif}
.s{position:absolute;left:140px;right:140px;bottom:56px;text-align:center;font-size:52px;font-weight:800;line-height:1.38;color:#fff;
-webkit-text-stroke:9px #0D0D0D;paint-order:stroke fill;word-break:normal;line-break:strict}"""
SUBCSS="""*{margin:0;padding:0}html,body{width:1920px;height:1080px;background:transparent}
svg{position:absolute;left:0;top:0}
.t{font-family:'Noto Sans CJK JP',sans-serif;font-size:52px;font-weight:800;fill:#fff;stroke:#0D0D0D;stroke-width:11px;stroke-linejoin:round;stroke-linecap:round;paint-order:stroke fill}"""
only=sys.argv[1:]
def split2(t):
    if len(t)<=29: return html.escape(t)
    mid=len(t)/2; best=None
    for i,ch in enumerate(t[:-1]):
        if ch in '、。':
            if best is None or abs(i+1-mid)<abs(best-mid): best=i+1
    if best is None or max(best,len(t)-best)>31:
        # 読点で割れない場合は真ん中付近の助詞の後ろ
        for d in range(0,12):
            for i in (int(mid)+d,int(mid)-d):
                if 0<i<len(t) and t[i-1] in 'はがをにでとものへてや' and t[i] not in '、。」':
                    return html.escape(t[:i])+'<br>'+html.escape(t[i:])
        return html.escape(t)
    return html.escape(t[:best])+'<br>'+html.escape(t[best:])
with sync_playwright() as p:
    b=p.chromium.launch(); pg=b.new_page(viewport={'width':1920,'height':1080})
    for k,h in S.items():
        if only and k not in only: continue
        pg.set_content(h); pg.wait_for_timeout(50); pg.screenshot(path=f'png/scene/{k}.png')
    for k,h in O.items():
        if only and k not in only: continue
        pg.set_content(h); pg.screenshot(path=f'png/ovl/{k}.png',omit_background=True)
    if not only:
        for o in idx:
            lines=split2(o['text']).split('<br>')
            fs=52
            svg_lines=''.join(f'<text x="960" text-anchor="middle" class="t">{ln}</text>' for ln in lines)
            pg.set_content(f"""<!doctype html><html><head><meta charset="utf-8"><style>{SUBCSS}</style></head><body>
<svg id="s" width="1920" height="1080" viewBox="0 0 1920 1080">{svg_lines}</svg></body></html>""")
            pg.evaluate("""() => {
              const ts=[...document.querySelectorAll('text.t')]; const lh=72; const n=ts.length;
              let fs=52; for (const t of ts){ const w=t.getComputedTextLength(); if (w>1640) fs=Math.min(fs, Math.floor(52*1640/w)); }
              ts.forEach((t,k)=>{ t.style.fontSize=fs+'px'; t.setAttribute('y', 1080-62-(n-1-k)*lh); });
            }""")
            pg.screenshot(path=f"png/sub/{o['i']:03d}.png",omit_background=True)
    b.close()
missing=[o['scene'] for o in idx if o['scene'] not in S and o['scene'] not in O]
print('missing scenes',sorted(set(missing)))
assemble.py(1文ずつ映像を作り、つないで音声と合わせる)
import json, subprocess, os, sys, wave
import numpy as np
from concurrent.futures import ThreadPoolExecutor
from PIL import Image
sys.path.insert(0,'.')
from scenes import VIDEO
FPS=30; SR=48000
idx=json.load(open('tts/index.json'))
os.makedirs('chunks',exist_ok=True); os.makedirs('comp',exist_ok=True)
# 尺(フレーム単位)
for o in idx:
    o['frames']=max(1,round((o['dur']+o['pause'])*FPS))
# 動画シーンのオフセット(同じシーンが続く間は続きから)
prev=None; off=0.0
for o in idx:
    sc=o['scene']
    if sc in VIDEO:
        if sc!=prev: off=VIDEO[sc][1]
        o['voff']=off; off+=o['frames']/FPS
    prev=sc
ENC=['-c:v','libx264','-preset','veryfast','-crf','20','-pix_fmt','yuv420p','-r',str(FPS),'-an']
def job(o):
    out=f"chunks/{o['i']:03d}.mp4"
    if os.path.exists(out) and '--force' not in sys.argv: return
    sub=f"png/sub/{o['i']:03d}.png"; sc=o['scene']; n=str(o['frames'])
    if sc in VIDEO:
        src,_,wm=VIDEO[sc]
        dl='delogo=x=2740:y=1840:w=1010:h=220,' if wm else ''
        fc=(f"[0:v]{dl}scale=1920:1080:force_original_aspect_ratio=increase,crop=1920:1080,fps={FPS},setsar=1,"
            f"drawbox=x=0:y=850:w=iw:h=230:color=black@0.5:t=fill[b];[b][1:v]overlay[c];[c][2:v]overlay[v]")
        cmd=['ffmpeg','-v','error','-y','-ss',f"{o['voff']:.3f}",'-stream_loop','-1','-i',src,
             '-loop','1','-i',f'png/ovl/{sc}.png','-loop','1','-i',sub,'-filter_complex',fc,'-map','[v]','-frames:v',n]+ENC+[out]
    else:
        comp=f"comp/{o['i']:03d}.png"
        im=Image.open(f'png/scene/{sc}.png').convert('RGBA'); im.alpha_composite(Image.open(sub).convert('RGBA')); im.convert('RGB').save(comp)
        cmd=['ffmpeg','-v','error','-y','-loop','1','-framerate',str(FPS),'-i',comp,'-frames:v',n,'-tune','stillimage']+ENC+[out]
    subprocess.run(cmd,check=True)
with ThreadPoolExecutor(2) as ex: list(ex.map(job,idx))
# 音声:各文を尺ちょうどに合わせて連結
parts=[]
for o in idx:
    need=o['frames']*SR//FPS
    if o['text']:
        with wave.open(f"tts/{o['i']:03d}.wav") as w:
            a=np.frombuffer(w.readframes(w.getnframes()),dtype=np.int16)
    else: a=np.zeros(0,dtype=np.int16)
    a=a[:need]; parts.append(np.concatenate([a,np.zeros(need-len(a),dtype=np.int16)]))
with wave.open('narration.wav','wb') as w:
    w.setnchannels(1); w.setsampwidth(2); w.setframerate(SR); w.writeframes(np.concatenate(parts).tobytes())
open('chunks/list.txt','w').write(''.join(f"file '{o['i']:03d}.mp4'\n" for o in idx))
# 字幕 SRT
def ts(f):
    ms=round(f/FPS*1000); h,ms=divmod(ms,3600000); m,ms=divmod(ms,60000); s,ms=divmod(ms,1000); return f"{h:02d}:{m:02d}:{s:02d},{ms:03d}"
t=0; srt=[]; k=1
for o in idx:
    if o['text']:
        srt.append(f"{k}\n{ts(t)} --> {ts(t+round(o['dur']*FPS))}\n{o['text']}\n"); k+=1
    t+=o['frames']
open('out.srt','w',encoding='utf-8').write('\n'.join(srt))
json.dump(idx,open('timeline.json','w'),ensure_ascii=False)
subprocess.run(['ffmpeg','-v','error','-y','-f','concat','-safe','0','-i','chunks/list.txt','-i','narration.wav',
  '-map','0:v','-map','1:a','-c:v','copy','-af','loudnorm=I=-16:TP=-1.5:LRA=11','-c:a','aac','-b:a','192k','-ar','48000','-movflags','+faststart','out.mp4'],check=True)
print('total frames',t,'=',t/FPS,'s')
analyze.py(最初の版で、間延びした文を見つけたスクリプト)
import json,re,subprocess
idx=json.load(open('tts/index.json'))
rows=[]
for o in idx:
    if not o['text']: continue
    log=open('tts/%03d.log'%o['i'],encoding='utf-8',errors='ignore').read()
    lab=log.split('[Output label]')[1].strip().splitlines()
    ph=[]
    for l in lab:
        m=re.match(r'(\d+) (\d+) \S+?\^\S+?-(\S+?)\+',l)
        if m: ph.append((int(m.group(1))/1e7,int(m.group(2))/1e7,m.group(3)))
    scale=o['dur']/ph[-1][1]
    lead=ph[0][1]-ph[0][0]; tail=ph[-1][1]-ph[-1][0]
    longv=[(p,round((e-s)*scale,2)) for s,e,p in ph[1:-1] if p not in('pau','sil') and (e-s)*scale>0.22]
    pau=[round((e-s)*scale,2) for s,e,p in ph if p=='pau' and (e-s)*scale>0.35]
    gap=round((tail)*scale+o['pause'],2)
    rows.append((o['i'],o['text'][:30],round(lead*scale,2),round(tail*scale,2),o['pause'],longv,pau))
print('scale ex',scale)
for r in rows:
    if r[5] or r[6] or r[3]+r[4]+0.25>1.3:
        print(r)
実行ログ
台帳の試行回数を数えた結果
$ cd $HOME/mnt/runs; for f in pick_place_ledger_v3.csv handover_ledger_v1.csv; do echo "== $f"; python3 - "$f" <<'EOF'
import csv,sys,collections
p=sys.argv[1]
try:
    rows=list(csv.DictReader(open(p,encoding='utf-8-sig')))
except Exception as e:
    print("ERR",e); sys.exit()
print("rows",len(rows))
cols=rows[0].keys() if rows else []
for c in ["place_verdict","pick","pick_stage","status","run_status","verdict"]:
    if c in cols:
        print(c, collections.Counter(r[c] for r in rows).most_common(8))
for c in ["run_stem","timestamp"]:
    if c in cols and rows:
        print(c, rows[0][c], "->", rows[-1][c])
EOF
done
== pick_place_ledger_v3.csv
rows 657
place_verdict [('', 259), ('yes', 217), ('no', 127), ('unknown', 54)]
run_stem run_0042_test -> run_0001_20260720_213323
timestamp 2026-06-18T00:00:00 -> 2026-07-20T21:35:11.608053
== handover_ledger_v1.csv
rows 8
run_stem run_handover_20260720_210544_315479_001 -> run_handover_20260720_210618_993522_008
timestamp 2026-07-20T21:05:45.451732+09:00 -> 2026-07-20T21:06:20.009752+09:00

$ cd $HOME/mnt/runs && python3 - <<'EOF'
import csv,collections
rows=list(csv.DictReader(open('pick_place_ledger_v3.csv',encoding='utf-8-sig')))
ts=sorted(r['timestamp'] for r in rows if r.get('timestamp'))
print("min",ts[0],"max",ts[-1])
test=[r for r in rows if any(k in r['run_stem'].lower() for k in ('test','dry','sim','mock'))]
print("test-like",len(test))
real=[r for r in rows if r not in test]
print("real",len(real), collections.Counter(r['place_verdict'] for r in real))
print([c for c in rows[0].keys()][:12])
EOF
ls run_pick_place | wc -l
min 2026-06-18T00:00:00 max 2026-07-20T21:35:11.608053
test-like 1
real 656 Counter({'': 259, 'yes': 216, 'no': 127, 'unknown': 54})
['timestamp', 'run_stem', 'trial_no', 'pick_verdict', 'pick_reason', 'pick_confidence', 'place_verdict', 'place_reason', 'place_confidence', 'block_pick_x', 'block_pick_z', 'block_place_x']
758
間延びした文の検出結果(最初の版)
$ python3 analyze.py | python3 -c "
import sys,ast
for line in sys.stdin:
    if line.startswith('('):
        r=ast.literal_eval(line)
        if r[5]: print(r[0], r[1], r[5][:8])
"
13 現実の世界で物に触れて動かす技術のことなんですよ。 [('N', 0.47), ('d', 0.47), ('e', 0.47), ('s', 0.47), ('U', 0.41), ('y', 0.46), ('o', 0.47)]
88 ChatGPTのようなAIの学習に使われたインターネットの文 [('ts', 0.48), ('U', 0.49), ('k', 0.46), ('a', 0.48), ('w', 0.49), ('a', 0.49), ('r', 0.48), ('e', 0.49)]
92 ChatGPTは10万年分の教科書で育ったけれど、 [('s', 0.48), ('o', 0.44), ('d', 0.48), ('a', 0.48), ('cl', 0.48), ('t', 0.48), ('a', 0.48), ('k', 0.48)]
94 ここで、じゃあロボットにChatGPTの瞬間は当分来ない、 [('t', 0.47), ('o', 0.48), ('o', 0.47), ('b', 0.48), ('u', 0.47), ('N', 0.45), ('k', 0.47), ('o', 0.48)]
109 1Xが家の中で遠隔操作しながらデータを集めているのも、 [('i', 0.47), ('r', 0.42), ('u', 0.47), ('n', 0.46), ('o', 0.47), ('m', 0.47), ('o', 0.47)]
110 出荷されたロボットの多くがデータ集めに回っているのも、 [('n', 0.45), ('o', 0.45), ('m', 0.45), ('o', 0.45)]
6文を区切って作り直した結果
$ python3 fixtts.py 13 88 92 94 109 110
13 ['現実の世界で物に、', '触れて動かす技術のことなんですよ。'] max phoneme 0.11s dur 7.25 -> 4.62
88 ['チャットジーピーティーのようなエーアイの、', '学習に使われたインターネットの文章を、'] max phoneme 0.14s dur 17.55 -> 5.45
92 ['チャットジーピーティーは、', '10万年分の教科書で育ったけれど、'] max phoneme 0.14s dur 9.71 -> 4.49
94 ['ここで、', 'じゃあロボットにチャットジーピーティーの、', '瞬間は当分来ない、'] max phoneme 0.13s dur 9.59 -> 5.01
109 ['ワンエックスが家の中で遠隔操作しなが、', 'らデータを集めているのも、'] max phoneme 0.17s dur 7.80 -> 5.02
110 ['出荷されたロボットの多くが、', 'データ集めに回っているのも、'] max phoneme 0.15s dur 5.72 -> 4.38

(109 が「しなが/ら」で切れたため、区切る位置を手で指定して作り直した)
$ python3 fixtts.py 13 109
13 ['現実の世界で、', '物に触れて動かす技術のことなんですよ。'] max phoneme 0.11s dur 4.62 -> 4.59
109 ['ワンエックスが、', '家の中で遠隔操作しながら、', 'データを集めているのも、'] max phoneme 0.17s dur 5.02 -> 5.29
台本の書き直し後に、全文を検査して作り直した結果
$ python3 tts2.py   (台本の書き直し後の1回目。読点の追加なし)
READ 1 世界で2万2000台を超えました。前の年の同じ時 → セカイデニマンニセンダイヲコエマシ’タ、マエノトシノオナジジキノ、オヨソヨンバイデス’、
READ 2 年末までには、5万台を超えると予想されています。 → ネンマツマデニワ、ゴマンダイヲコエルトヨソーサレテイマス’、
READ 7 僕は秋田で29年デザイナーをやりながら、 → ボクワアキ’タデニジューキューネンデザイナーヲヤリナガラ、
READ 18 その手間は大きく2つあります。 → ソノテマワオーキ’クフ’タツアリマス’、
READ 22 大きく3つあります。 → オーキ’クミッツアリマス’、
READ 23 出荷が4倍になったロボットは、何をしているのか。 → シュッカガヨンバイニナッタロボットワ、ナニヲシ’テイルノカ、
READ 27 1つ目、出荷が4倍になったロボットは、何をしてい → ヒ’トツメ、シュッカガヨンバイニナッタロボットワ、ナニヲシ’テイルノカ、デス’、
READ 28 Counterpointの推計では、出荷された人 → カウンターポイントノスイケーデワ、シュッカサレタヒ’トガタロボットノロクワリイジョーガ、
36 同じ半年の出荷を約1万9100台と推計していて、 STRETCH 0.47s -> split 1 parts, max 0.47s
READ 36 同じ半年の出荷を約1万9100台と推計していて、 → オナジハントシノシュッカヲヤクイチマンキューセンヒャクダイトスイケーシ’テイテ、
READ 37 産業・商業用途が7割を超えた、としています。 → サンギョー、ショーギョーヨートガナナワリヲコエタ、トシ’テイマス’、
READ 38 総数も分類も違うので、この2つは、単純な裏表とし → ソースーモブンルイモチガウノデ、コノフ’タツワ、タンジュンナウラオモテトシ’テワクラベラレマセン、
READ 40 もう1つ、SAGの推計では、出荷の97%以上が中 → モーヒ’トツ、エスエージーノスイケーデワ、シュッカノキュージューナナパーセントイジョーガチューゴクノメーカーデス’、
READ 42 アメリカの1Xという会社は、家事をする人型ロボッ → アメリカノワンエック’ストイウカイシャワ、カジヲスルヒ’トガタロボット、ネオノヨヤクヲ、キョネンノジューガツニハジメマシ
READ 43 2万ドルの早期購入枠は、今年配送の予定で、月49 → ニマンドルノソーキ’コーニューワクワ、コトシ’ハイソーノヨテーデ、ツ’キヨンヒャク’キュージューキュードルノプランワ、ソ
READ 45 予約した時間に、1Xの担当者が遠隔で手伝う仕組み → ヨヤクシ’タジカンニ、ワンエック’スノタントーシャガエンカクデテツダウシ’クミナンデス’ヨ、
READ 46 10月11日の時点で、一般のお客さんへの配送開始 → ジューガツジューイチニチノジテンデ、イッパンノオキャク’サンエノハイソーカイシヲシメス’コーシ’キハッピョーワ、
51 工場でも家でも、使いながらデータを集める動きが出てきているん STRETCH 0.47s -> split 2 parts, max 0.48s
READ 54 2つ目、僕の机の上のロボットアームで、何が簡単で → フ’タツメ、ボクノツ’クエノウエノロボットアームデ、ナニガカンタンデ、ナニガムズカシカッタノカ、デス’、
READ 56 僕は自宅の机で、mechArm 270という小さ → ボクワジタクノツ’クエデ、メックアーム、ニーナナゼロトイウチーサナロボットアームヲウゴカシ’テイマス’、
READ 58 それだけの作業を、失敗も含めて650回以上試して → ソレダケノサギョーヲ、シッパイモフ’クメテロッピャクゴジュッカイイジョータメシテ、ゼンブダイチョーニノコシ’テイマス’、
READ 65 ロボットアームの爪先がどこに来るかは、普通は関節 → ロボットアームノツメサキガドコニクルカワ、フ’ツーワカンセツノカクドカラケーサンデダシマス’、
READ 66 ところが、ikpyという計算ツールで出した爪先の → トコロガ、アイケーパイトイウケーサンツールデダシ’タツメサキノイチ’ト、
READ 68 僕の設定では、同じ関節の角度なのに、30cm以上 → ボクノセッテーデワ、オナジカンセツノカクドナノニ、サンジュッセンチイジョークイチガッタンデス’、
READ 70 関節の角度と爪先の位置の対応表を作りました。 → カンセツノカクドトツメサキノイチノタイオーヒョーヲツ’クリマシ’タ、
READ 72 もう1つ困ったのが、黙る失敗です。 → モーヒ’トツ’コマッタノガ、ダマルシッパイデス’、
READ 73 僕の機体とソフトの組み合わせでは、肩の関節に、9 → ボクノキ’タイトソフ’トノクミアワセデワ、カタノカンセツニ、キュージュードチョットヲコエルネヲオクルト、
READ 75 ログを1行ずつ見て、やっと気づきました。 → ログヲイチギョーズツミテ、ヤットキズキマシ’タ、
READ 77 この2つは、AIの学習データが足りない、という話 → コノフ’タツワ、エーアイノガク’シューデータガタリナイ、トイウハナシトワベツデス’、
79 ほかの環境で学んだことを持ってくる研究も進んでいます。 STRETCH 0.48s -> split 1 parts, max 0.48s
READ 81 じゃあ、もう1つの手間、データのほうは、業界全体 → ジャー、モーヒ’トツノテマ、データノホーワ、ギョーカイゼンタイデドーナッテイルノカ、
READ 82 3つ目、データの壁はどれくらい高くて、誰がどう越 → ミッツメ、データノカベワドレクライタカク’テ、ダレガドーコエヨートシ’テイルノカ、デス’、
READ 86 人が読んだり見たりする時間に換算すると、約10万 → ヒ’トガヨンダリミタリスルジカンニカンサンスルト、ヤクジューマンネンキボニナル、
READ 88 ゴールドバーグさんは、これを「10万年のデータの → ゴールドバーグサンワ、コレヲジューマンネンノデータノカベトヨンデイマス’、
91 ここで、じゃあロボットにChatGPTの瞬間は当分来ない、 STRETCH 0.48s -> split 2 parts, max 0.48s
READ 95 会社の発表では、去年の11月に27万時間、今年の → カイシャノハッピョーデワ、キョネンノジューイチガツニニジューナナマンジカン、コトシノシガツニゴジューマンジカンヲコエマシ
READ 96 さらに8月には、簡単で短い作業なら、 → サラニハチガツニワ、カンタンデミジカイサギョーナラ、
READ 100 ここで1つ、注意があります。 → ココデヒ’トツ、チューイガアリマス’、
READ 101 作業を記録した時間と、10万年という数字は、その → サギョーヲキロクシ’タジカント、ジューマンネントイウスージワ、ソノママクラベラレマセン、
104 1Xが家の中で遠隔で手伝いながら動きを覚えさせているのも、 STRETCH 0.47s -> split 1 parts, max 0.47s
READ 104 1Xが家の中で遠隔で手伝いながら動きを覚えさせて → ワンエック’スガイエノナカデエンカクデテツダイナガラウゴキヲオボエサセテイルノモ、
READ 109 じゃあ、この2つが混ざっている今、ロボットのニュ → ジャー、コノフ’タツガマザッテイルイマ、ロボットノニュースノナニヲミレバイイノカ、
READ 111 ロボットのニュースを見たときの問いが、2つに変わ → ロボットノニュースヲミタトキノトイガ、フ’タツニカワルンデス’ヨ、
READ 112 1つは、そのロボットは自律で動いているのか、人が → ヒ’トツワ、ソノロボットワジリツデウゴイテイルノカ、ヒ’トガエンカクデウゴカシ’テイルノカ、デス’、
READ 115 もう1つは、その仕事は「見て判断する」で済むのか → モーヒ’トツワ、ソノシゴトワミテハンダンスルデスムノカ、
READ 125 で、作る側として、もう1つ言わせてください。 → デ、ツ’クルガワトシ’テ、モーヒ’トツイワセテクダサイ、
READ 126 データの話と並行して、もう1つ要るのが「どう動く → データノハナシトヘーコーシ’テ、モーヒ’トツイルノガドーウゴク’カノセッケーデス’、
segments 144 total 13:45

(どの音で伸びているかを調べた結果。* は0.3秒を超えた音)
tts/036.log sil* o n a j i h a N t o sh i n o sh u cl k a o y a k u i ch i m a N ky u u s e N hy a k u d a i t o s u i k e e sh* I* t* e* i* t* e* sil*
tts/051_p1.log sil ts U k a i n a g a r a d e e t a o a ts u m e r u u g o k i g a d e t e k i t e i r u N* d* e* s* U* y* o* sil*
tts/079.log sil h o k a n o k a N ky o o d e m a n a N d a k o t o o m o cl t e k u r u k e N ky u u m o s* u* s* u* N* d* e* i* m* a* s* U* sil*
tts/091_p1.log sil* j a a r o b o cl t o n i ch a cl t o j i i p i i t i i n o sh u N k a N w a t* o* o* b* u* N* k* o* n* a* i* sil*
tts/104.log sil* w a N e cl k U s u g a i e n o n a k a d e e N k a k u d e t e ts u d a i n a g a r a u g o k i o o b o e s a s e t e i* r* u* n* o* m* o* sil*

(5文の OVERRIDE に読点を足し、「値を送る → あたいを送る」を読み替え表に足して作り直した)
$ python3 tts2.py | grep -v ^READ
segments 144 total 13:32
[]   ← 間延びのあった文の一覧(0件)
ボクノキ’タイトソフ’トノクミアワセデワ、カタノカンセツニ、キュージュードチョットヲコエルアタイヲオクルト、
オナジハントシノシュッカヲ、ヤクイチマンキューセンヒャクダイト、スイケーシ’テイテ、
ロボットアームノツメサキガドコニクルカワ、フ’ツーワカンセツノカクドカラケーサンデダシマス’、
色の検証(validate_palette.js)
$ node scripts/validate_palette.js "#2A7A9B,#D9542B" --mode light --surface "#F4F2ED"
Palette (light, surface #F4F2ED, categorical): 2 slots
  [PASS] Lightness band         all 2 inside L 0.43–0.77
  [FAIL] Chroma floor           below floor (reads gray): [["#2A7A9B",0.091]]
  [PASS] CVD separation         worst adjacent #D9542B↔#2A7A9B ΔE 15.7 (protan) · tritan 32.3
  [PASS] Normal-vision floor    worst adjacent #D9542B↔#2A7A9B ΔE 27.5 (normal)
  [PASS] Contrast vs surface    all 2 >= 3:1

  → FAILED — fix the marked checks  (CVD in the 6–8 floor band is legal ONLY with secondary encoding: direct labels, gaps, or texture)
  scope: categorical palettes only. For a lone status/text color check WCAG text contrast; for a sequential ramp, lightness monotonicity.

$ node scripts/validate_palette.js "#1F7FB0,#D9542B" --mode light --surface "#F4F2ED"
  [PASS] Lightness band         all 2 inside L 0.43–0.77
  [PASS] Chroma floor           all 2 >= 0.1
  [PASS] CVD separation         worst adjacent #D9542B↔#1F7FB0 ΔE 18.7 (protan) · tritan 32.3
  [PASS] Normal-vision floor    worst adjacent #D9542B↔#1F7FB0 ΔE 28.9 (normal)
  [PASS] Contrast vs surface    all 2 >= 3:1
  → ALL CHECKS PASS  (CVD in the 6–8 floor band is legal ONLY with secondary encoding: direct labels, gaps, or texture)

(記事サムネイルの配色に合わせたあと)
$ node scripts/validate_palette.js "#1A6C98,#C4471F" --mode light --surface "#F5F5F0"
  [PASS] Lightness band         all 2 inside L 0.43–0.77
  [PASS] Chroma floor           all 2 >= 0.1
  [PASS] CVD separation         worst adjacent #C4471F↔#1A6C98 ΔE 17.2 (protan) · tritan 30.4
  [PASS] Normal-vision floor    worst adjacent #C4471F↔#1A6C98 ΔE 27.2 (normal)
  [PASS] Contrast vs surface    all 2 >= 3:1
  → ALL CHECKS PASS  (CVD in the 6–8 floor band is legal ONLY with secondary encoding: direct labels, gaps, or texture)
書き出しの結果
(試作1本目・153文)
total frames 24385 = 812.8333333333334 s
stream|codec_name=h264|width=1920|height=1080
stream|codec_name=aac
format|duration=812.900000

(間延びした6文を直したあと)
total frames 23532 = 784.4 s
video,784.400000
audio,784.400000

(codex の指摘・デザイン・読み・自己紹介を反映したあと・144文)
total frames 24448 = 814.9333333333333 s
video,814.933333
audio,815.000000

(記事サムネイルの配色・ロゴ・「毎日」の削除を反映したあと)
total frames 24434 = 814.4666666666667 s

(30cm の説明2文を足したあと・146文)
total frames 24891 = 829.7 s

(打ち出し・章の扉・点の並びを入れたあと)
total frames 24891 = 829.7 s
-rw-r--r-- 1 root root 47663796 Oct 11 22:01 /tmp/claude-0/-home-claude/9041d877-fbc0-57ad-97c5-f63dfd4877c5/scratchpad/v/out.mp4
KIOXIA への転送で、1つ目の断片だけが化けた記録
(作業環境側で12MBずつに分けた断片の md5)
b3a5e3da6efb449d63049eb14400a1d3  p_00
bff9ad51719a351b1698a90a11152082  p_01
32d70b67218b8e9594637b6e06dadc7b  p_02
c41f4eedb61bdd951e2484d85e6f6691  p_03
元の作業用 mp4: a54a7d2fa84886ceab3237618ffd5838

(Mac 側に届いた断片の md5。p_00 だけ一致しない)
da313675885a59bd4988dbe2ce6270ee   p_00
bff9ad51719a351b1698a90a11152082   p_01
32d70b67218b8e9594637b6e06dadc7b   p_02
c41f4eedb61bdd951e2484d85e6f6691   p_03
-rwx------ 12588787 Oct 11 12:44 p_00        ← 元は 12582912 バイト(5,875 バイト多い)
-rwx------ 12582912 Oct 11 12:44 p_01
-rwx------ 12582912 Oct 11 12:45 p_02
-rwx------  9186276 Oct 11 12:45 p_03
つないだ mp4: e5e65bee0bd4cf47694b33163d54adc3   ← 元と一致しない

(p_00 だけ gzip で包んで送り直し、Mac 側で展開してからつないだ)
12582912 b3a5e3da6efb449d63049eb14400a1d3   ← 展開した p_00。元と一致
a54a7d2fa84886ceab3237618ffd5838              ← つないだ作業用 mp4。元と一致

(最終版でも同じ手順で送った)
元の作業用 mp4: 2dd0e053c2da238bbd073bb7bf8b12ad
つないだ作業用 mp4: 2dd0e053c2da238bbd073bb7bf8b12ad
codex への検証依頼の全文
台本の全文は、検証にかけた時点の版です(このあと書き直しています)。
# 敵対的検証依頼:YouTube台本「ロボットにもChatGPTの瞬間はもう来たのか」

## あなたへの依頼

これから公開する解説動画(約13分)の台本を、**この台本を論破するつもりで**検証してください。褒める必要はありません。見落としを1つでも多く見つけることが目的です。

- 台本の書き手:Pixels to Motors(エイイチ)。秋田でロボットアーム(mechArm 270-Pi)を自宅で動かし、記録を公開している個人。29年のデザイナー経験。
- 視聴者:フィジカルAIに関心はあるが専門家ではない日本語話者
- 台本の結論:「見て判断する」ところは安くなった(ChatGPTの瞬間がもう来た)。「触れて動かす」ところはまだ高い(データの壁があり、まだ来ていない)
- 検証日:2026年10月11日。Webを参照できる場合は一次情報まで遡って確認してください。参照できない場合は「未確認」と明記し、推測で OK を出さないでください

## 検証してほしい観点

### A. 事実と数字
A1. 各数字が出典に実際に書かれているか。出典の数字を取り違えていないか(期間・対象・単位)
A2. 出典自体の信頼性。調査会社のプレスリリース、企業の自社発表、二次報道の区別がついているか
A3. 2026年10月11日時点で古くなっている情報がないか(特に 1X NEO の出荷状況、Generalist の最新発表、出荷台数)
A4. 本人の実機の数字(S061 の650回以上、S068〜S071 の30cm以上、S074 の170万点、S076〜S077 の90度ちょっと)が、話の文脈で誤解を生まない言い方になっているか

### B. 論理
B1. 結論(S143〜S144)「見て判断する部分にはもう来ている」は、台本の中で示した根拠(本人の判定の体験談1つ)だけで言い切れるか。反例はないか
B2. 「データの壁」の説明(S105〜S108:10万年 vs 57年、約1700分の1)は比較として成立しているか。台本の断り書き(単位をそろえた比較ではない)で十分か
B3. (S028〜S039)「出荷ロボットの6割以上が見せる用途・研究・データ集め」と「SAG では工場・店舗向けが7割超」を並べた扱いは公正か。どちらかに寄せた印象操作になっていないか
B4. 本人の机の上の体験(ikpy のずれ、黙る失敗)から、業界全体の「触れて動かすはまだ高い」へ一般化してよいか。飛躍がないか
B5. 「人型ロボット」の話と「ロボットアーム」の話、「フィジカルAI」全体(自動運転を含む)の話が混ざって、範囲がぶれていないか

### C. 抜けている反論・視点
C1. 台本の主張に対して、専門家なら真っ先に出す反論は何か(例:シミュレーション合成データ、世界モデル、VLA の汎化など)
C2. 触れずに済ませているが、視聴者の判断を変えうる事実はないか

### D. 言い方
D1. 断定が強すぎる文、逆に曖昧すぎて意味のない文
D2. 誤解を生む用語の使い方(例:「フィジカルAI」「データ集め」「ChatGPTの瞬間」の定義)
D3. 特定の企業・人物について、不公平・不正確な描写

## 回答の書式

指摘ごとに次の形で書いてください。重大なものから順に並べてください。

```
[❌ NG / ⚠️ 要注意] 文番号(例:S043)
問題:何が問題か(1〜2文)
根拠:確認した出典(URL)または推論の筋道
修正案:差し替える文(台本の話し言葉の調子に合わせて)
```

最後に次の3点をまとめてください。
1. このまま公開してよいか(はい/直してから/大きく作り直すべき)
2. 公開前に必ず直すべき指摘の文番号
3. 台本の結論そのものへの評価(成立している/条件つきで成立/成立していない)と、その理由

---

## 台本が使った出典

| 主張 | 文番号 | 出典 |
|---|---|---|
| 2026年上半期の人型ロボット出荷2万2000台超・前年同期の約4倍・通年5万台超の予想・用途の6割以上が見せる用途と研究・データ集め | S001〜S005, S028〜S029 | Counterpoint Research(2026年8月)https://counterpointresearch.com/en/insights/global-humanoid-robot-shipments-soar-nearly-300-percent-yoy-in-h1-2026 ※台本作成時はページ本文を読み込めず、検索結果の抜粋から数字を取った |
| 同期間:中国メーカー97%超・AGIBOT 44%・Unitree 31%・工場や店舗向け70%超 | S034〜S035, S041〜S042 | Smart Analytics Global の調査を紹介した TechRepublic(2026年8月11日)https://techrepublic.com/article/news-humanoid-robot-shipments-chinese-vendors |
| 1X NEO:2025年10月に予約開始・2万ドルまたは月499ドル・難しい作業は担当者が遠隔操作・2026年10月初めの時点で顧客への出荷の発表なし | S044〜S049 | 1X 予約ページ/botinfo.ai(2026年10月5日確認)https://botinfo.ai/articles/1x-neo-home-robot / AI2Work https://ai2.work/blog/1x-neo-ships-into-homes-with-a-human-teleoperator-still-inside |
| インターネットの文章を人が読むと約10万年(10万年のデータの壁)、狭い仕事を確実にこなすロボットを現場に置いて働きながらデータを集めるのが近道 | S087〜S096, S130〜S132 | Ken Goldberg, Science Robotics(2025年8月)https://news.berkeley.edu/?p=134910 |
| Generalist:27万時間(2025年11月)→50万時間超(2026年4月)・新しいロボットや作業に合わせるデータは約1時間の場合も・選んだ簡単な作業で成功率99%超 | S097〜S104 | Generalist の発表を紹介した記事 https://yespress.io/generalist / https://www.humanoidsdaily.com/news/generalist-ai-unveils-gen-0-claims-scaling-laws-for-robotics-backed-by-270-000-hours-of-real-world-data |
| 本人の実機:PICK→PLACE の通し試行656回(2026年6月18日〜7月20日)、FKテーブル約170万点、ikpy とデジタルツインの爪先が同じ関節角で300mm以上ずれる、j1 が約90.7度を超えると send_angles がエラーなしで無視される | S061, S068〜S071, S074, S076〜S077 | 本人の台帳 pick_place_ledger_v3.csv、公開記事 DAY257・DAY283、設計メモ arm_kinematics.md(非公開資料を含むため、ここは記述の妥当性だけ見てください) |

## 台本全文(動画で読み上げている版)


### 0 フック

S001 今年の1月から6月までに、世界で出荷された人型ロボットは、2万2000台を超えました。

### 0 フック

S002 前の年の同じ時期の、およそ4倍です。

### 0 フック

S003 調査会社のCounterpointが、8月に出した数字です。
S004 年末までには、5万台を超えると予想されています。
S005 家事をする人型ロボットの予約販売も、去年の秋から始まっています。
S006 こういうニュースを見ると、ChatGPTが出たときみたいに、
S007 ロボットも一気に賢くなって、家に来るのはもうすぐ、って感じませんか。

### 1 自己紹介

S008 Pixels to Motors。こんにちは、エイイチです。

### 1 自己紹介

S009 僕は秋田で29年デザイナーをやりながら、

### 1 自己紹介

S010 自宅の机の上でロボットアームを動かして、その記録を毎日公開しています。

### 1 自己紹介

S011 作る側の机の上から見える、フィジカルAIの話をします。

### 2 今日の問い

S012 今日の問いは、ロボットにもChatGPTのような瞬間は、もう来たのか、です。
S013 フィジカルAIっていうのは、AIに体を持たせて、
S014 現実の世界で物に触れて動かす技術のことなんですよ。
S015 ロボットアームも、人型ロボットも、自動運転もここに入ります。

### 3 結論と立場

S016 先に結論を言っちゃうと、安くなったのは「見て判断する」ところで、

### 3 結論と立場

S017 「触れて動かす」ところは、まだ高いんですよ。

### 3 結論と立場

S018 鍵になるのが、「データの壁」です。
S019 先に言っておくと、フィジカルAIはまだ使えない、と言いたいわけじゃないんです。
S020 どこまで来ていて、どこで止まっているのかを、分けて見たいんです。

### 4 目次

S021 大きく3つあります。

### 4 目次

S022 出荷が4倍になったロボットは、何をしているのか。

### 4 目次

S023 僕の机の上のロボットアームで、何が簡単で、何が難しかったのか。

### 4 目次

S024 そして、データの壁はどれくらい高くて、誰がどう越えようとしているのか。

### 4 目次

S025 最後に僕の見立てを話します。

### 5 節1:出荷されたロボットは何をしているのか

S026 1つ目、出荷が4倍になったロボットは、何をしているのか、です。
S027 まず数字の中身を見ます。
S028 Counterpointによると、出荷された人型ロボットのうち6割以上は、
S029 展示やイベントで動きを見せる用途と、研究やデータ集めの用途なんですよ。
S030 データ集めっていうのは、人がロボットを遠隔で動かして、その動きを記録して、
S031 AIが学ぶための教材を作る仕事のことです。
S032 つまり、ロボットの大きな買い手の1つは、ロボットに教えるためのロボットなんです。
S033 ただ、ここで1つ断っておきます。
S034 別の調査会社のSmart Analytics Globalは、同じ半年について、
S035 工場や店舗向けが7割を超えた、と言っているんですよ。
S036 同じ期間なのに、ほぼ逆の数字です。
S037 用途の分け方が、会社によって違うんだと思います。
S038 だから「全部見せ物だ」とも、「もう工場で働いている」とも言い切れない。
S039 そこは正直に言っておきます。
S040 はっきりしているのは、どこが作っているかです。
S041 SAGの数字だと、出荷の97%以上が中国のメーカーです。
S042 上位のAGIBOTとUnitreeの2社だけで、およそ4分の3なんですよ。
S043 家のほうも見てみます。
S044 アメリカの1Xという会社は、家事をする人型ロボット、NEOの予約を、去年の10月に始めました。
S045 値段は2万ドル。月499ドルのプランもあります。
S046 ただ、難しい家事は、1Xの担当者がVRゴーグルをつけて、
S047 ロボットのカメラ越しに家の中を見ながら、遠隔で動かす仕組みなんですよ。
S048 今年中にアメリカで届け始める予定ですが、
S049 10月の初めの時点で、お客さんの家に届いたという発表は、まだありません。
S050 これ、ちょっと考えさせられませんか。
S051 売っているのはロボットだけじゃなくて、遠隔で動かす人と、
S052 そこで集まるデータの仕組みごとなんです。
S053 で、ここが大事なんですけど、工場の話にも家の話にも、
S054 データを集めるという、同じ目的が出てくるんですよ。
S055 じゃあ、なぜそこまでしてデータを集めないといけないのか。
S056 その前に、僕の机の上の話をさせてください。

### 6 節2:机の上のロボットアームで、簡単だったこと・難しかったこと

S057 2つ目、僕の机の上のロボットアームで、何が簡単で、何が難しかったのか、です。
S058 ここは僕自身の話から始めさせてください。
S059 僕は自宅の机で、mechArm 270という小さなロボットアームを動かしています。
S060 赤いブロックを掴んで、箱に置く。
S061 それだけの作業を650回以上試して、全部の結果を台帳に残しているんですよ。
S062 まず、簡単だったほうから話します。掴めたかどうかの判定です。
S063 iPhoneで撮った写真をAIに見せて、「ブロックを掴めていますか」と聞くと、
S064 はい、いいえで答えが返ってくる。
S065 少し前なら、ここを作るだけで大仕事だったはずなんですよ。
S066 難しかったのは、動かすほうでした。
S067 ロボットアームの爪の先がどこに来るかは、普通は関節の角度から計算で出します。
S068 ところが、ikpyという、よく使われる計算ツールで出した爪先の位置と、
S069 パソコンの中に作ったアームの分身で、実際に動かした位置が、
S070 同じ関節の角度なのに、30cm以上ずれたんです。
S071 30cmですよ。机の上のブロックなら、端から端まで外れます。
S072 だから僕は、その分身、デジタルツインの中でアームを実際に動かして、
S073 爪先がどこに来るかを、1点ずつ測って表にしました。
S074 その表は今、170万点ほどあります。
S075 もう1つ困ったのが、黙る失敗です。
S076 肩の関節に、90度ちょっとを超える角度を送ると、
S077 エラーも出さずに、指令が黙って捨てられるんですよ。
S078 アームは動かない。でも、何も言ってこない。
S079 ログを1行ずつ見て、やっと気づきました。
S080 でも、ポイントはここなんです。
S081 見て判断するところは、AIに頼めばすぐ手に入りました。
S082 でも、爪先がどこに来るか、指令がちゃんと届いたかは、
S083 自分の机の上で、自分のアームで測るしかなかった。
S084 インターネットのどこにも、僕のアームの、僕の机の上のデータはないんですよ。
S085 じゃあ、この「どこにもないデータ」は、世界全体ではどれくらい足りないのか。

### 7 節3:データの壁の高さと、越えようとしている会社

S086 3つ目、データの壁はどれくらい高くて、誰がどう越えようとしているのか、です。
S087 カリフォルニア大学バークレー校のロボット研究者、
S088 ケン・ゴールドバーグさんが、去年、面白い計算をしています。
S089 ChatGPTのようなAIの学習に使われたインターネットの文章を、
S090 人が全部読むと何年かかるか。答えは、約10万年なんですよ。
S091 ロボットが手を動かすためのデータは、その足元にも及ばない。
S092 ゴールドバーグさんは、これを「10万年のデータの壁」と呼んでいます。
S093 ChatGPTは10万年分の教科書で育ったけれど、
S094 ロボットには、その教科書がまだない、ということなんです。
S095 ここで、じゃあロボットにChatGPTの瞬間は当分来ない、
S096 と言いたくなるじゃないですか。でも、ちょっと待ってほしいんです。
S097 アメリカのGeneralistという会社は、人が手で作業する様子を、
S098 安い装着型の機材で記録して集めています。
S099 去年の11月の時点で27万時間、今年の4月には50万時間を超えました。
S100 半年で2倍近くです。
S101 しかもこの会社によると、新しいロボットや新しい作業に合わせるのに、
S102 そのロボット自身のデータは、1時間ほどで済む場合があって、
S103 選んだいくつかの簡単な作業では、成功率が99%を超えたそうです。
S104 会社自身の発表なので、そこは差し引いて聞いてください。
S105 50万時間を年に直すと、約57年です。
S106 10万年と比べると、まだ1700分の1くらい。
S107 ただ、これは人が文章を読む時間と、作業を記録した時間なので、
S108 単位をそろえた比較ではありません。目安として聞いてください。
S109 つまり、壁はまだ高い。でも、壁の前でみんなが土を積み始めている。
S110 1Xが家の中で遠隔操作しながらデータを集めているのも、
S111 出荷されたロボットの多くがデータ集めに回っているのも、
S112 同じ壁に向かっている動きなんです。
S113 ただ、ここで「なんだ、まだ全然ダメなのか」で
S114 片付けてしまうのも違うんです。
S115 見て判断するほうには、もう10万年分の教科書がある。
S116 そこは僕の机の上でも、もう普通に使えています。
S117 じゃあ、この2つが混ざっている今、ロボットのニュースの何を見ればいいのか。

### 8 見立て

S118 ここからが、僕の一番言いたいことです。
S119 データの壁を知っていると、
S120 ロボットのニュースを見たときの問いが、2つに変わるんですよ。
S121 1つは、そのロボットは誰が動かしていて、データは誰が集めているのか、です。
S122 人が遠隔で動かしているのか、ロボットが自分で動いているのか。
S123 デモ動画では、ここがほとんど言われないんですよね。
S124 もう1つは、その仕事は「見て判断する」で済むのか、
S125 「触れて動かす」精度が要るのか、です。
S126 棚の商品が足りているかを見るのは、前者です。
S127 柔らかい物を潰さずに掴むのは、後者です。
S128 前者なら、もう安く使える。
S129 後者は、その現場で測って固める仕事が、まだ残っている。
S130 ゴールドバーグさんも、昔ながらのエンジニアリングで、
S131 狭い仕事を確実にこなすロボットを現場に置いて、
S132 働きながらデータを集めるのが近道だ、と言っています。
S133 僕の机の上でやっていることも、まさにそれなんですよ。
S134 判断はAIに任せる。動きは、自分のアームで測って固める。
S135 で、作る側として、もう1つ言わせてください。
S136 データの壁を越えたあとも、最後に残るのは「どう動くか」なんです。
S137 例えばロボットが人に物を渡すとき、
S138 何秒待って手を開けば、人は安心して受け取れるのか。
S139 これは、成功か失敗かの判定だけでは出てこない。
S140 動きの質そのものを設計する仕事が、
S141 壁の向こうにも残っていると、僕は見ています。

### 9 冒頭の問いへの回答

S142 じゃあ、冒頭の問いに答えますね。

### 9 冒頭の問いへの回答

S143 ロボットにChatGPTの瞬間は、見て判断する部分には、もう来ています。

### 9 冒頭の問いへの回答

S144 でも、現実に触れて動かす部分には、まだ来ていません。

### 9 冒頭の問いへの回答

S145 その差を埋めるデータを、今、世界中で必死に集めている最中です。
S146 ロボットのデモ動画を見たら、
S147 「これは誰が動かしていて、何回やって、何回うまくいったのか」を、
S148 一度だけ考えてみてください。
S149 それだけで、同じ動画の見え方が、かなり変わると思います。

### 10 アウトロ

S150 今日はここまでです。

### 10 アウトロ

S151 この動画が気に入ったら、高評価とチャンネル登録をお願いします。

### 10 アウトロ

S152 コメントは全部読ませてもらっています。それではまた。
codex から返ってきた検証結果の全文
判定は「直してから」です。現在の結論は、台本の根拠だけでは成立していません。 特に、①「ChatGPTの瞬間」の定義、②異種データの1700分の1比較、③実機の設定・制御問題を学習データ不足へつなげる論理、④Generalistの最新発表の欠落が重大です。
2026年10月11日時点でWeb確認しました。以下では、一次資料の本文確認、検索抜粋だけの確認、推論、未確認を区別します。本人の台帳・設計メモは依頼どおり検証対象外とし、数字の伝え方だけを評価します。
[❌ NG] S016〜S018、S143〜S145
問題:「ChatGPTの瞬間」が未定義です。写真への回答を一度得られたことから、視覚判断全体の転換を宣言し、さらに物理操作全体には転換がないと断定するのは、両方向に飛躍しています。
根拠:使いやすさ、汎化、信頼性、普及、費用は別の評価軸です。例えば[Gemini Roboticsの公式資料](https://deepmind.google/en/models/gemini-robotics/gemini-robotics/)は、視覚と言語から動作を出すモデルを示していますが、提供はPrivate previewです。「能力がある」と「誰でも利用できる」も分ける必要があります。
修正案:「ここではChatGPTの瞬間を、専門家でなくても、いろんな仕事にすぐ使えるようになる転換点、と呼びます。僕の机では、画像に質問する入口はぐっと簡単になりました。でも、いろんな家で安全に家事を任せられる転換点まで来たかは、まだ判断できません。」
[❌ NG] S105〜S109
問題:57年への換算は正しいですが、「1700分の1」はデータの不足率ではありません。「目安」と断っても、比較対象の意味が違うため、壁の高さを数量化したことにはなりません。
根拠:500,000÷24÷365≒57.1、100,000÷57.1≒1752。前者は作業記録の総時間、後者は異種の学習資料を人間が読む・見る時間への換算です。情報密度、重複、センサー、タスクの多様性、必要性能がそろっていません。また一社のデータ量は、世界全体の総量でもありません。
修正案:「50万時間は、連続した時間に直すと約57年です。ただ、文章や画像を見る時間と、作業を記録した時間は、そのまま比べられません。何倍足りないかではなく、必要な経験をどれだけ広く集められるかが問題なんです。」
[❌ NG] S068〜S074、S082〜S085、S133〜S134
問題:計算モデル間の30cmの不一致と指令の不受理は、それだけではAIの学習データ不足を示しません。モデルの整合性や制御インターフェースの問題を、業界の「データの壁」の実例として使っています。
根拠:同じ角度の比較には、座標系、リンク寸法、関節軸、角度の符号・原点、工具先端の定義を一致させる必要があります。どちらが正しいかは実機との比較が必要です。原因は非公開資料のため未確認です。
修正案:「僕の設定では、計算モデルとシミュレーターの位置が30cm以上食い違いました。これはAIの学習データ不足とは別に、モデルや制御の整合性を確かめる仕事が必要だった、という話です。」
[❌ NG] S099〜S104、S109、S129、S144
問題:4月のGEN-1を最新状況のように紹介していますが、8月のGEN-1.5が抜けています。新しい作業への適応負担を論じる動画では、視聴者の判断を変える重要な欠落です。
根拠:[Generalistの8月19日公式発表](https://generalistai.com/blog/gen-1.5)は、短い実演を使った新タスクへの適応を報告しています。ただし同社自身の評価で、対象は簡単で短い作業です。家庭全体への汎化を証明したわけではありません。
修正案:「さらに8月にはGEN-1.5を発表して、簡単で短い作業なら、数秒の実演から適応できる例も報告しています。会社発表なので評価条件は見る必要がありますが、『動かすには毎回大量の専用データが必要』とも言い切れなくなっています。」
[❌ NG] S034〜S038
問題:SAGの「industrial and commercial」を「工場や店舗向け」と狭めています。また用途と導入先は重なり得るため、「ほぼ逆の数字」「分類の違いが原因」とする説明は未立証です。
根拠:[SAGの一次発表](https://smartanalyticsglobal.com/global-humanoid-robot-shipments-2026-agibot-unitree/)の表現は産業・商業用途です。同社の総出荷推計も約19,100台で、Counterpointの22,000台超とは異なります。両調査の分類対応表や集計方法は、今回確認できていません。商業施設での展示と研究用途が排他的とは限りません。
修正案:「一方、SAGは約1万9100台と推計して、産業・商業用途が7割超としています。ただ、総数も分類も違うので、この2つは単純な裏表として比べられません。どれだけ自律的に実務をこなしたかは、この数字だけでは分からないんです。」
[❌ NG] S089〜S094、S115〜S116
問題:Goldbergの10万年は「文章だけ」ではありません。さらに、その比喩を「見て判断する側には十分な教科書がある」という性能保証に変えています。
根拠:[Science Roboticsの原文](https://autolab.berkeley.edu/assets/publications/media/GOFE-Can-Close-the-100000-Year-Robot-Data-Gap-Science-Robotics-Aug-2025-scirobotics.aea7390.pdf)は、現代のVLMの学習に使う文章と画像を読む・見る時間への概算です。これはEditorialであり、一般ロボットに必要なデータ量の実証値ではありません。
修正案:「ゴールドバーグさんは、画像と言葉を扱うAIの学習資料を、人が読む・見る時間に換算すると、約10万年規模だと紹介しています。ロボットにも同じ量が必要だと分かったわけではありませんが、動作指令と結びついた経験は集めにくい、という問題提起です。」
[❌ NG] S083〜S084、S129、S145
問題:「自分の机で測るしかない」は、他環境・他機体からの転移を否定する表現です。また、データだけが判断と動作の差を埋めるように聞こえます。
根拠:[Gemini Robotics 1.5技術報告](https://storage.googleapis.com/deepmind-media/gemini-robotics/Gemini-Robotics-1-5-Tech-Report.pdf)は機体をまたいだ技能転移を報告しています。専門家なら、VLAの汎化、シミュレーション、世界モデル、モデルに基づく制御をまず反論として出します。[NVIDIAの公式説明](https://developer.nvidia.com/isaac/gr00t?ncid=so-yout-261862-vt48)も実データと合成データの併用を示しています。ただし、これらが現場検証を不要にしたとは言えません。
修正案:「ほかの環境で学んだことを持ってくる研究も進んでいます。それでも、僕の構成でちゃんと動くかは確認が必要でした。差を埋めるのはデータだけでなく、モデル、制御、機械そのものの改善でもあります。」
[⚠️ 要注意] S013〜S015、S017、S144
問題:「物に触れて動かす」で自動運転まで定義し、その後はほぼ物体操作と家庭用人型ロボットの話になります。広い領域を否定する結論になっています。
根拠:台本内の対象の不一致です。Goldbergの原文自身も、自動運転や荷物仕分けを既に実用化された例として挙げています。限定用途の実用化と、汎用家庭ロボットの普及は別問題です。
修正案:「フィジカルAIは、現実世界を認識して行動するAIのことです。自動運転も入りますが、今日は主に、アームや人型ロボットが物を扱う話、とくに家庭のような変化の多い場所に絞ります。」
[⚠️ 要注意] S001〜S004、S028〜S029、S040〜S042
問題:数字の記載は確認できても、市場の確定実績として扱うには調査方法の確認が不足しています。「はっきりしている」も強すぎます。
根拠:Counterpointの公式ページ由来の検索抜粋では、22,000台超、前年比約300%増、通年50,000台超の予測、用途の合計60%超を確認しました。直接開いた本文は取得できず、集計定義は未確認です。SAGの本文では中国メーカー97%超、44%+31%を確認しました。いずれも調査会社の推計で、出荷は自律稼働や顧客検収を意味しません。[Counterpoint](https://counterpointresearch.com/en/insights/global-humanoid-robot-shipments-soar-nearly-300-percent-yoy-in-h1-2026)、[SAG](https://smartanalyticsglobal.com/global-humanoid-robot-shipments-2026-agibot-unitree/)
修正案:「Counterpointの推計では、今年上半期の出荷は2万2000台超、前年同期のおよそ4倍です。ただ、出荷台数は、そのまま自律的に働いている台数ではありません。中国メーカーへの集中も、SAGの推計では非常に大きいです。」
[⚠️ 要注意] S030〜S032、S053〜S054、S110〜S112
問題:「データ集め」を遠隔操作だけに限定し、研究用途までデータ生産へ読み替えています。さらに工場と家庭の共通の「目的」として断定しています。
根拠:研究には制御・機構・移動などの検証も含まれ、全てが学習データ収集とは限りません。作業中の自律ログや人の実演も収集方法です。「研究・データ生産」という合算から、それぞれの比率や購入目的は分かりません。
修正案:「データ集めには、人が遠隔で動かして記録する方法も、自律作業の記録を残す方法もあります。ただ、研究向けの台数が全部データ集めに使われる、という意味ではありません。」
[⚠️ 要注意] S044〜S049、S051〜S052
問題:価格プランの提供時期を省き、遠隔支援が常時の仕組みのように聞こえます。顧客出荷については、発表を見つけられないことと、出荷していないことを区別すべきです。
根拠:[1Xの発売発表](https://www.1x.tech/discover/neo-home-robot)は2025年10月28日、20,000ドルのEarly Accessは2026年優先配送、499ドルの月額プランは後日配送です。[現行注文ページ](https://www.1x.tech/order)では基本的自律性と予約した時間のExpert Modeを説明しています。VRゴーグルの具体的運用は今回の公式本文では未確認。10月11日までの一般顧客への配送開始を示す公式発表も今回の検索では確認できませんでした。
修正案:「2万ドルの早期購入枠は2026年配送予定で、月499ドルのプランは後日です。初期の自律機能に加えて、知らない作業では予約した時間に担当者が遠隔で支援します。10月11日時点で、一般顧客への配送開始を示す公式発表は、僕が確認した範囲では見つかっていません。」
[⚠️ 要注意] S063〜S065、S081、S126〜S129
問題:回答が返ることと、正しく判定できることを混同しています。「前者ならもう安く使える」は、精度や運用条件を無視しています。
根拠:判定を評価するには、実際の保持状態との照合、失敗画像、遮蔽、誤判定率などが必要です。棚の欠品検知にも死角や商品識別、照明、誤報対応があります。台本にはモデル名、正答率、費用がなく、「安い」の実証もありません。
修正案:「写真を見せて質問する入口は、驚くほど簡単でした。ただ、答えが返ることと、毎回正しいことは別です。僕の条件でどこまで任せられるかは、失敗例も含めて確かめる必要があります。」
[⚠️ 要注意] S061
問題:650回以上が成功した回数、あるいは同一条件での評価回数に聞こえます。提示された情報は、期間中のPICK→PLACE通し試行656回です。
根拠:ユーザー提示の台帳説明に基づく指摘です。試行間の構成変更や中断の扱いは未確認で、成功率やモデル性能は推定できません。
修正案:「6月18日から7月20日までに、掴んで置く一連の試行を656回記録しました。これは成功回数ではなく、失敗も含めた試行回数です。」
[⚠️ 要注意] S069〜S074
問題:「実際に動かした」が実機測定に聞こえ、170万点が現実の経験データとして受け取られます。提示された説明ではシミュレーター内のFK表です。
根拠:仮想モデルの大量サンプリングは、そのモデルの写像を細かくしたものです。点数が多くても、モデルと実機の一致や接触精度を証明しません。
修正案:「シミュレーターの中で関節角と爪先位置の対応を計算して、約170万点の表にしました。実機で170万回測ったわけではなく、現物との一致は別に確認する必要があります。」
[⚠️ 要注意] S076〜S079
問題:90度ちょっとという閾値を機種全体の仕様として語っています。また「指令が捨てられる」は、通信を観測していなければ原因の断定です。
根拠:提示情報は本人の構成でj1が約90.7度を超えたときの観察です。ファームウェア、SDK、他関節の値、検証箇所は未確認です。「肩」だけでは関節も特定しにくくなります。
修正案:「僕の機体とソフトの組み合わせでは、j1に約90.7度を超える値を送ると、例外が出ないのに動かないことがありました。機種全体の仕様か、どの段階で止まったのかは、まだ切り分けが必要です。」
[⚠️ 要注意] S099〜S104
問題:期間が「半年」と丸められ、99%超が評価全体の平均のようにも聞こえます。1時間は追加のロボットデータであって、全学習・導入に必要な時間ではありません。
根拠:[GEN-0公式発表](https://generalistai.com/blog/gen-0)は2025年11月4日、[GEN-1公式発表](https://generalistai.com/blog/gen-1)は2026年4月2日で約5か月です。27万時間超と50万時間超、平均99%と一部タスク99%超を区別する必要があります。自己申告の試験結果で、現場導入の総費用は示していません。
修正案:「会社発表では、約5か月で27万時間超から50万時間超に増えました。事前学習に加えて、示した試験では約1時間のロボットデータを使い、選んだ作業群で平均99%の成功率を報告しています。導入全体が1時間で終わる、という意味ではありません。」
[⚠️ 要注意] S130〜S133
問題:Goldbergの提案を、個人の机上試行と「まさに同じ」としています。提案の肝である、実務で価値を生みながらデータを蓄積する点が抜けます。
根拠:原文の提案は、従来の工学と学習を組み合わせ、商業環境で有用な仕事をするロボットから継続的にデータを集めるものです。家庭の開発試行との類似はありますが、稼働規模と実用性は異なります。前掲のScience Robotics原文。
修正案:「僕の机の上も、AIと従来の制御を組み合わせる点では通じています。ただ、現場で役に立つ仕事をしながらデータが増える仕組みとは、まだ規模も段階も違います。」
[⚠️ 要注意] S123、S136〜S141
問題:「デモではほとんど言われない」は調査なしの一般化です。また人への物の渡し方を、データの壁を越えた後の課題に分離するのも不正確です。
根拠:Generalistの公開動画には自律動作・再生速度の表示があります。人との動作の調整も、知覚、制御、学習、安全性を含む現在の研究対象です。[DeepMindの人とロボットの相互作用・安全性説明](https://deepmind.google/models/gemini-robotics/responsibly-advancing-ai-and-robotics/)もその一例です。
修正案:「デモを見るときは、自律か遠隔操作か、速度や介入の条件が書かれているかを見ます。そしてデータ集めと並行して、人が安心して受け取れる動きを設計する仕事も必要なんです。」

1. このまま公開してよいか:直してから。 体験談の章は残せますが、結論とデータの壁への接続は書き直す必要があります。
2. 公開前に必ず直すべき文番号: S016〜S018、S034〜S038、S068〜S074、S082〜S085、S089〜S094、S099〜S109、S115〜S116、S128〜S129、S143〜S145。
3. 結論そのものへの評価:現状では成立していない。 「見て判断する全体には来た/触れて動かす全体には来ていない」という二分は広すぎ、証拠も非対称です。次の結論なら条件つきで成立します。

「僕の机では、画像に質問する入口はずっと簡単になりました。一方、物を確実に動かすには、機体や環境とのすり合わせがまだ必要でした。その負担を減らす研究は急速に進んでいます。でも、いろんな家庭で安全に家事を任せられる転換点まで来たかは、まだ判断できません。」
video_rules.md の全文
# video_rules.md

## 動画制作ルール(唯一の正)

最終更新: 2026-10-11
状態: 試作1本目「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」を作りながら決めたことをまとめた初版。まだ決まっていない項目は8節にまとめている。

YouTube 用の解説動画を作るときは、まずこのファイルを読む。台本の文体は language_rules.md、記事は article_rules.md が正。動画の構成・数字の扱い・画面・音声・書き出しは本ファイルが正。

---

## 1. 動画の構成(解説回の型)

参考にした3本の解説動画(時事ニュースをデータと体験で検証する形式)から取った型。尺は13〜14分。

| # | パート | 時間の目安 | やること |
|---|---|---|---|
| 0 | フック | 0:00〜0:45 | 挨拶より先に、視聴者が最近見たニュースや数字から入る。世間の感覚を代弁する(「〜って感じませんか」) |
| 1 | 自己紹介 | 〜0:55 | ロゴのテロップを出し、毎回同じ文言で名乗る(2節の文言) |
| 2 | 今日の問い | 〜1:10 | 問いを疑問文1つで言い、問いの中の言葉をその場で定義する |
| 3 | 結論と立場 | 〜1:30 | 先に結論を言う。誤解されやすい方向を先に否定する(「〜と言いたいわけじゃないんです」) |
| 4 | 目次 | 〜1:50 | 「大きく3つあります」と数を言ってから並べる |
| 5〜7 | 本編(3節) | 〜10:00 | 「1つ目、〜です」で始め、各節の最後の1文を次の節の問いにする |
| 8 | 見立て | 〜12:30 | 「ここからが僕の一番言いたいことです」と言ってから意見を話す |
| 9 | 問いへの回答 | 〜13:20 | 冒頭の問いに3〜4文で答え、視聴者が次にニュースを見たときに考える問いを1つ渡す |
| 10 | アウトロ | 〜13:40 | 毎回同じ文言 |

パートごとのセリフの型(穴埋め式)と、実験回の型は Docs「動画台本テンプレート|台本例:フィジカルAIの現在地」にある。

---

## 2. 台本のルール

公開前に codex に敵対的検証(台本を論破するつもりで見落としを探してもらう)をかけたところ「このまま公開は不可」と判定された。以下はそのとき直した点から作ったルール。

1. **問いの中の言葉は、冒頭で定義する。** 例: 「ChatGPTの瞬間」を定義しないまま「来た/来ていない」と言い切っていた → 「専門家でなくても、いろんな仕事にすぐ使えるようになる転換点」と冒頭で言う形に直した。
2. **話の範囲を言う。** 例: フィジカルAIの定義に自動運転を含めながら、アームの話だけで結論を出していた → 「自動運転も入りますが、今日はアームや人型ロボットが物を扱う話に絞ります」と言う。
3. **数字は、出典で裏が取れて、論旨に必要なものだけ使う。** 増やすほど突っ込まれる場所が増える。試作1本目で削った数字: 1700分の1(単位の違う比較)、成功率99%・約1時間(会社の自己申告で条件の説明が要る)、170万点(シミュレーターの表なのに実機の測定と誤解される)、メーカー別の内訳(なくても話が変わらない)。
4. **推計・会社自身の発表は、そう口で言う。** 「Counterpointの推計では」「会社の発表では」。調査会社同士で数字が違うときは、どちらかに寄せず「総数も分類も違うので、単純には比べられない」と言う。
5. **意味や単位の違う数字を並べて比べない。** 例: 「人が文章を読む時間 10万年」と「作業を記録した時間 57年」を割り算していた → 比較ごと削った。
6. **自分の実機の話は、自分の条件の話として言う。** 「僕の機体とソフトの組み合わせでは」を付ける。机の上で起きたことを業界全体の結論に広げない。例: 計算ツールとデジタルツインの爪先の位置が30cm以上食い違った話を「データ不足」の例にしていた → 「モデルや制御が自分の機体と噛み合っているかを確かめる、すり合わせの仕事」として話す形に直した。
7. **自分の数字は、何の数かを添える。** 例: 「650回以上」→「失敗も含めた試行回数」。
8. **最新の発表は、公開の直前に確認する。** 例: 4月の発表を最新として話していたが、8月に次の発表(GEN-1.5)が出ていた。
9. **「見つからない」と「していない」を分ける。** 例: 「出荷していない」ではなく「配送開始を示す公式発表は、僕が確認した範囲では見つかっていません」。
10. **自分の活動を盛らない。** 自己紹介の文言は「僕は本業のデザイナーをしながら、ロボティクスの研究と開発をしています。自宅の机の上でロボットアームを動かして、その記録を公開しています。」に固定する。「秋田」「29年」「毎日」は入れない。
11. **公開前に codex で敵対的検証をかける。** 依頼ファイルの型は、試作1本目の動画フォルダにある `codex_敵対的検証依頼_*.md`。台本全文に文番号(S001〜)を振り、出典の表と検証の観点(事実・論理・抜けている反論・言い方)を付けて渡す。返ってきた指摘は、一次情報で確かめてから採用する。

---

## 3. ナレーション(現状は仮音声)

いまは仮の合成音声で作っている。本番の声は未決(8節)。

- **エンジン:** Open JTalk、声は nitech_jp_atr503_m001(男声)。設定は 速さ 1.08、音の高さ -1、声質 0.55
- **読み替え表:** 英語の名前はカタカナで読ませる(ChatGPT→チャットジーピーティー、ikpy→アイケーパイ など)。誤読した語も表に足す。これまでの例: 爪先→つめさき(「つまさき」だと足の指先に聞こえる)、値→あたい、4分の3→よんぶんのさん。新しい固有名や数字を入れたら、エンジンの解析結果(カタカナの読み)を出して目で確認する
- **間延びの検査:** ひと息で読む区間が長いと、その区間の最後の言葉が1音0.47秒ほどに引き伸ばされる(普段は0.1秒前後)。作った音声すべてで、1音0.3秒を超える箇所を検出する。見つかった文は、読み上げ用の原稿だけに読点を足して区切る。字幕の文は変えない
- **文のあとの間:** 通常 0.35秒、話題の区切り 0.6〜0.7秒、節の終わり 0.9秒

---

## 4. 画面デザイン

### 4-1. 画面の枠

- 1920×1080、30fps
- 余白は左右140px。下の250pxは字幕のために空ける
- 左上に章のタグ(章番号はオレンジ、見出しは薄い文字)、右上にロゴ(高さ34px)

### 4-2. 色(記事のサムネイルと同じ色)

| 用途 | 色 |
|---|---|
| 背景 | #F5F5F0 |
| 文字 | #0D0D0D |
| 薄い文字(ラベル・出典・補足) | #888888 |
| 区切り線 | #D6D6D1 |
| 横帯・棒の「その他」 | #D3D3CE |
| 箱(フロー図)の背景 | #FFFFFF |
| オレンジ(強調・主題) | #C4471F |
| 青(対比のもう一方) | #1A6C98 |

- オレンジは、1画面の中で一番伝えたい語だけに使う
- 青とオレンジを並べるのは、2つのものを対比するときだけ(試作1本目では「見て判断する=青」「触れて動かす=オレンジ」)
- 新しい色を足すときは、色覚の違いがあっても見分けられるかを検証してから使う(dataviz スキルの validate_palette.js。背景色 #F5F5F0 を指定する)

### 4-3. 文字

フォントは Noto Sans CJK JP。

| 用途 | 大きさ | 太さ |
|---|---|---|
| 大きい数字(ヒーロー数字) | 220px(単位は90px) | 900 |
| 章番号 | 200px(オレンジ) | 900 |
| 見出し 大/中/小 | 84px/64px/48px | 900/900/700 |
| 見出しの上の小見出し | 40px(薄い文字) | 700 |
| 2列比較のラベル | 34px(薄い文字) | 700 |
| 出典 | 24px(薄い文字) | 400 |

### 4-4. 図の型

内容の形に合わせて、次の型から選ぶ。

| 内容 | 型 |
|---|---|
| 伝えたい数字が1つ | 大きい数字+上に何の数か+下に比較(「前年同期の約4倍」) |
| 2つのものの対比 | 2列。間を細い縦線(2px)で区切り、色は文字の色だけで分ける |
| 手順・流れ | 白い箱を矢印でつなぐ |
| 全体のうちの割合 | 横帯(ラベルを帯の中に書く) |
| 時期ごとの量 | 横棒(長さは実際の比率) |
| 章の始まり | 大きい章番号+章の問い |
| 視聴者への問い | 黒い丸ラベル(「問い 1」)+大きい見出し |
| 並ぶ項目 | 番号付きの行を細い線で区切る |

### 4-4b. 強弱のつけ方

全部の場面を同じ強さにしない。1本の中で、次の3段階を使い分ける。打ち出しは1本に6〜10場面ほど、残りは説明の図にする。

| 段階 | 使う場面 | 見た目 |
|---|---|---|
| 打ち出し | 結論、問いかけ、言い切りたい一言、章の始まり | 小さい前置き(色・44px)の下に、1〜2行の大きな文(110〜150px)。1行は10字前後まで。補足は44pxの薄い文字で1行だけ |
| 説明 | 数字・比較・手順を見せる場面 | 4-4の図の型(見出し64〜84px) |
| 補足 | 出典・断り書き | 24〜34pxの薄い文字 |

打ち出しの型(試作1本目で使ったもの):

- **打ち出し文:** 前置き「先に結論」→「見て判断する入口は簡単に/物を動かすのはまだ手間」。対比の語だけ青とオレンジにする
- **章の扉:** 「今日の話」→「1つ目」→ 大きなキーワード(200px・オレンジ。例「データの壁」)→ 章の問いを1行
- **点の並び:** 割合は、100個の点のうち該当する数だけ色を付けて見せる(例: 中国メーカー 97%)。「以上」「推計」は下の注に書く

打ち出しにする文の選び方: 字幕をそのまま大きくするのではなく、その場面で一番残したい一言に縮める。字幕と同じ文を大きく出さない。

### 4-5. やらない表現

- カードの上や左に太い色の線を引く(よくある AI 生成スライドの見た目になる)
- 影、グラデーション
- 1画面にオレンジと青以外の色を足す
- 意味や単位の違う数字を同じ棒や帯に並べる

### 4-6. 出典

数字を出す画面には、左下(字幕の上)に出典を24pxの薄い文字で必ず入れる。推計なら「推計」、会社の自己申告なら「会社の発表」と書く。模式図には「図は模式図」と入れる。

---

## 5. 字幕

- 白文字 52px・太さ800。縁取りは #0D0D0D・11px で、角を丸くする(SVG の stroke-linejoin: round。CSS の文字の縁取りは角が尖るので使わない)
- 読み上げの1文=字幕1枚
- 2行まで、1行31字以内。改行は読点の位置で入れる。読点がなければ助詞の後ろで割る
- 位置は画面の下から62px

---

## 6. 実機の映像とテロップ

- 映像は 1920×1080 に拡大して切り抜く。字幕の後ろに黒50%の帯(高さ230px)を敷く
- 何の映像かを左上に出す(黒78%の地に白文字34px。例「実機:mechArm 270-Pi 赤いブロックを掴んで箱に置く」)
- 名前のテロップ: 薄い地に、ロゴ(高さ30px)・名前60px・肩書き30px(「デザイナー/ロボティクスの研究・開発」)。左の太い線は付けない
- 編集ツールの透かし(例: clideo.com)が入った素材は、ぼかしたうえで字幕帯の下に隠す。これから撮る素材は透かしなしで書き出しておく
- iCloud にしかない素材を取り込むと、Mac にダウンロードされる

---

## 7. 書き出しと保存

- **作業用(YouTube に上げる方):** H.264(crf 20)、音声 AAC 192kbps、音量を -16 LUFS にそろえる
- **確認用(チャットで送る方):** crf 29、音声 112kbps。30MB以下に収める(チャットで送れる上限)
- **保存先:** 動画ファイル(mp4)は重く、iCloud に置くと Mac の内蔵 SSD を圧迫するので、外付け SSD(KIOXIA)に置く。軽いファイルは iCloud に置く
  - 動画ファイル(作業用・確認用の mp4): `/Volumes/KIOXIA/r2r2r-data/videos/{動画名}/`
  - 字幕の srt・codex 依頼の md: iCloud `デジタルツイン学習R2R2R/動画/{動画名}/`
  - 制作ベース: iCloud `デジタルツイン学習R2R2R/動画/_制作ベース/`(このファイルの写し、スクリプト一式、ロゴの透過 PNG)
  - 素材の実機映像も、新しく撮るものは KIOXIA に置く。iCloud にしかない素材を取り込むと Mac にダウンロードされて内蔵 SSD を使う
  - MASTER の保存先テーブルと、KIOXIA の README.md のフォルダ構成には、まだ videos/ の行がない。追記はエイイチが行う
- **作る手順(_制作ベース のスクリプト):**
  1. `narration.py` に台本を書く(1文ごとに、場面の名前・字幕の文・後ろの間)。読み替え表もここ
  2. `tts2.py` で音声を作る(間延びの検査と、区切っての作り直しまで自動)
  3. `scenes.py` に場面ごとの図を書く(4節の型と色)。実機映像は `src/` に置き、`VIDEO` に場面名と開始秒を書く
  4. `render.py` で図・テロップ・字幕を画像にする
  5. `assemble.py` で1文ずつ映像を作ってつなぎ、音声と合わせる(字幕の srt も出る)
  6. 確認用に圧縮する

---

## 8. 未決・改良予定

| 項目 | いまの状態 | 決めること |
|---|---|---|
| ナレーションの声 | Open JTalk の仮音声。抑揚が機械的 | 本人の声で録るか、品質の高い音声合成(VOICEVOX など。利用規約とクレジット表記の条件を確認)にするか。srt に1文ごとの時間が入っているので、それに合わせて録れば映像はそのまま使える |
| 図解の動き | すべて静止画 | 数字のカウントアップ、矢印が伸びる、棒が伸びるなどの動きを入れるか。入れるなら、どの図の型に入れるか |
| 背景の映像 | 実機映像は自己紹介・節2・エンディングだけ。ほかは無地の背景 | 解説中も実機映像を薄く敷くか、図解だけにするか。使う素材を撮りためるルール |
| BGM・効果音 | なし | 使うか。使うなら、YouTube で収益化できてクレジット表記の条件を満たす音源から選ぶ。ナレーションが聞き取れる音量に下げる |
| ジングル | 文言だけ(「Pixels to Motors。こんにちは、エイイチです。」) | 音とロゴの動きを付けるか |
| サムネイル | まだない | 記事のサムネイルと同じ配色・線画のトーンで作るか |
| 番組名 | 未定 | 決める |
| 概要欄のチャプター | まだない | srt の節の開始時刻から作れる |

---

## 更新履歴

- 2026-10-11: 4-4b「強弱のつけ方」を追加(打ち出し・説明・補足の3段階、打ち出し文・章の扉・点の並びの型)。
- 2026-10-11: 動画ファイルの保存先を iCloud から KIOXIA の videos/ に変更(内蔵 SSD の圧迫を避けるため)。
- 2026-10-11: 初版。試作1本目の制作で決めた構成・台本・ナレーション・画面・字幕・映像・書き出しのルールをまとめた。台本ルールは codex の敵対的検証で直した点から作った。色は記事のサムネイルに合わせた。