

解説動画のナレーションをハコブくんに任せる ― 口と目と光をコードで動かし、文字が重ならない区画を決めた
Pixels to Motors の YouTube 解説動画について、続きの作業を Claude と対話しながら進めました。前回(解説動画をAIと作る ― 型の分析から敵対的検証まで、試作1本で決めたこと)で試作1本と制作ルールができたので、今回は「何を話すか」と「誰が話すか」を決めています。
やったことは4つです。サイトの記事から、ロボティクスに関心のある経営者・PM・マネージャー・開発者に向けた動画の企画を5本立てる。ナレーションの声と、BGM・効果音の候補を、公式の利用条件で比べる。ナレーションを本人の声ではなく、Pixels to Motors のキャラクターのハコブくん(病院で物を運ぶロボット)にすると決める。ハコブくんを画面の左下に置き、口・目・側面の光をコードで動かす試作を作る。
試作は、フィードバックを受けて十数回作り直しました。口の形、目の動き、側面の光り方、頭の上の切り抜き、顔の傾き、置く大きさを、ひとつずつ直しています。本記事は、その過程で決めたことと、決めた理由の記録です。間違えた直し方(凸包で頭を埋めた、角の点で傾きを測った、など)も消さずに残しました。試作スクリプトの全文と実行ログは記事の後半に載せています。
動画の企画5本は、見た人が「この人に何を頼めるか」が分かる話を選んだ
動画の目的は、見た人から仕事の相談や依頼をもらうことです。そこで、個人の体験談よりも、見る人が自分の会社やチームの判断に使える話を優先しました。サイトの記事を読み直し、経営者・PM・開発者に向けて5本の企画を立てています。
選ぶときの基準は、自分の机の上で実測した話が入っていることです。業界の解説だけなら、ほかの人にも作れます。実測の数字が入っていると、この人に頼むと何をしてくれるのかが見る人に伝わります。
公開する順 | 企画 | 冒頭の一言 | 元にした記事 | 見た人に伝わること |
|---|---|---|---|---|
1 | AIエージェントにロボットのコードを書かせたら、原因を7回取り違えた | テストは53件、全部通った。実機に出したら、アームの動きは前と何も変わっていなかった | LOG294、LOG273、LOG275、LOG170 | AIで書く・別のAIでレビューする・実機で小さく通す、という手順を組める |
2 | フィジカルAIの研究環境は、買う前に借りて測る | GPUメモリは34,399MiB使われているように見えた。実際に使っていたのは8,486MiBだった | LOG326、LOG327 | 本格導入の前の小さな検証(PoC)を、安く速く回せる |
3 | フィジカルAIの導入は、ロボットを買う前の「仕事の切り出し」で止まっている | 清掃ロボットの管理画面に出る4項目は、故障を調べるためではなく、契約どおり掃除したことを示す請求書だった | LOG306、LOG314、LOG286 | 導入前に、どの仕事をロボットに渡し、何を人に残すかを分けられる |
4 | ロボットの「成功」を何で数えるか ― 完走したのに、ブロックを掴めていなかった | アームは最後まで止まらずに動き切った。でも、ブロックは掴めていなかった | LOG246、LOG248、LOG268、LOG220 | 評価の指標と、成否を記録する仕組みを設計できる |
5 | ロボット企業の勝ち方は3つに分かれる ― 汎用モデル、環境の作り込み、用途の固定 | 「人型ロボット40万台」と報じられたトヨタの計画は、既存の産業用ロボット40万台の頭脳を入れ替える計画だった | LOG315、LOG282、LOG277、LOG329、LOG291 | 業界の動きを構造で整理し、相手の会社の選択肢に落とせる |
公開する順は、自分の実測が中心の2本(AIエージェントの回、借りて測る回)を先にしました。ほかの人には作れない動画だからです。仕事の切り出しの回は、相談や契約にいちばん直接つながる企画ですが、実績の動画を2本見せてから出す方が説得力が出ると考えて3本目に置きました。
企画を立てる途中で、注意が要る点も3つ見つかりました。2本目は、速度やメモリの数字を必ず GPU の型番(NVIDIA A40)と組で言う。4本目は「安全装置を外した実験」の話が入るので、実験の条件(速さ、周りに人がいたか、止める手段)を言わないと、安全を軽く見ているように聞こえる。5本目は自分の実測がない回なので、会社の自己申告の数字は「会社の発表では」と言い、最後に自分の机の上で同じ判断をした場面を1つ入れる。
ナレーション・BGM・効果音は、2026年10月11日時点の公式の条件で比べた
音声は映像と別に作る前提なので、ナレーションの声、BGM、効果音の候補を、それぞれの公式ページの利用条件で確かめました。料金や条件は変わるので、表は2026年10月11日に確認した時点のものです。
ナレーションの候補は3つでした。
方法 | 条件(確認した時点) | 経営者向けの動画に合うか |
|---|---|---|
本人の声で録る | 字幕ファイルに1文ごとの時間が入っているので、それに合わせて録れば映像はそのまま使える | 仕事の相談は人を見て決まるので、最初はこれを勧めた |
ElevenLabs で声を複製する | Creator プランは月11ドルの表示(初月の割引の表記あり)。商用ライセンス付きで、本格的な声の複製(Professional Voice Cloning)が1つ作れる | 録る時間が取れない回の代わりになる |
VOICEVOX | 商用・非商用を問わず無料。VOICEVOX を使ったことが分かるクレジットの表記が必要で、キャラクターごとの規約にも従う | キャラクターの声は娯楽系の解説動画の印象が強く、相談先として見てもらいにくい |
BGM と効果音は次の候補です。
用途 | サービス | 条件(確認した時点) |
|---|---|---|
BGM・効果音 | YouTube オーディオライブラリ | 収益化している動画で使え、権利者からの著作権の申し立て(Content ID)が来ない。YouTube が著作権上安全と認めているのはここの音源だけ。Creative Commons の曲は概要欄にクレジットが要る |
BGM | DOVA-SYNDROME | 無料、商用OK、クレジット不要。作曲者ごとに別の条件がある場合はそちらが優先。音楽が主役の動画やリミックスは禁止 |
BGM・効果音 | Epidemic Sound | 有料。使用料の追加払いはない。広告に使うには Pro 以上のプランが要る |
効果音 | 効果音ラボ | 無料、商用OK、YouTube の収益化OK、クレジット不要。効果音だけを流す動画は再配布として禁止 |
効果音は、自分のロボットアームのサーボが回る音やグリッパーが閉じる音を録って、章の扉の音にする案も出しました。権利の心配がなく、このチャンネルにしかない音になります。入れる場所は、動画のルールで「打ち出し」と決めている場面(1本に6〜10場面)だけにしぼります。
ナレーションは、本人の声でも声の複製でもなく、ハコブくんに決めた
声の候補を並べたあと、ナレーションをハコブくんにしたいという相談がありました。
音声はハコブくんをナレーションキャラにしようと思いますが、自分の声の複製とどちらが良いですか?(自分の声は別に良いとは思わない。声が通らない)
ハコブくんの方が良い、と答えました。理由は3つです。声の複製は元の声の性質をそのまま写すので、声が通らないのが不満なら、複製しても通らない声を毎回使うことになります。ハコブくんはすでに Pixels to Motors の4コママンガに出ているキャラクターで、開発ログ(day_log)の発信戦略にも「実機展開以降、ハコブくんをR2R2Rの概念解説役として再登場させる」と書いてありました。もう1つは、本人の実機の話を「エイイチの机の上では、こうなりました」と三人称で言えることです。動画のルールにある「自分の実機の話は、自分の条件の話として言う」が、言い方だけで自然に守れます。
ただ、目的が仕事の相談をもらうことなので、キャラクターの後ろで本人が見えなくなると効果が落ちます。そこで次の3つを必ず入れると決めました。
自己紹介の場面で、本人の名前のテロップと実機の映像を出す
意見を話す節は「ここからはエイイチの見立てです」と言ってから入る(意見が誰のものかをはっきりさせる)
概要欄にプロフィールと連絡先を置き、「ナレーションは AI 音声です」と書く
声は、ほかのチャンネルと同じ声(VOICEVOX のキャラクターの声など)を使わず、ハコブくん専用の声にします。「ハコブくん=有名なキャラクターの声のロボット」と聞かれないようにするためです。作り方の候補は2つで、ElevenLabs の Voice Design(文章で声の特徴を書くと新しい声を作る機能)か、声優に頼んで作ってもらうかです。Voice Design は、日本語での出来と、作った声を商用で使う条件が公式の説明に書かれていなかったので、試して確かめる必要があります。話し方は、高すぎない声でゆっくり丁寧に、経営者が13分聞いて疲れないことを基準にしました。
ハコブくんは画面の左下に置き、生成した10秒の動画の1コマから体を切り抜いた
置き方のイメージとして、参考にしている解説動画(前回、型を分析した3本のうち、会社への侵入と暗数の回)の画面が共有されました。画面の左下でサングラスの猫のキャラクターがマイクの前で話していて、字幕は猫の右側から始まっています。
画面の左端にこのような形で話しているハコブくんを追加するイメージです。
あわせて、病室にいるハコブくんの生成動画(10秒)が共有されました。最初に考えたのは、この動画をそのまま左下で繰り返し流す方法ですが、やめました。動画の中の口は声と関係なく開閉するので、話していない間も口が動きます。10秒の動画を13分繰り返すと、同じ動きの繰り返しだと気づかれます。背景の病室を毎フレーム切り抜くと、縁が揺れます。
そこで、体は動画の1コマを切り抜いた静止画にし、顔だけをコードで描く方法にしました。ハコブくんの顔はディスプレイなので、画面の中の目と口を描き替えれば話しているように見せられます。
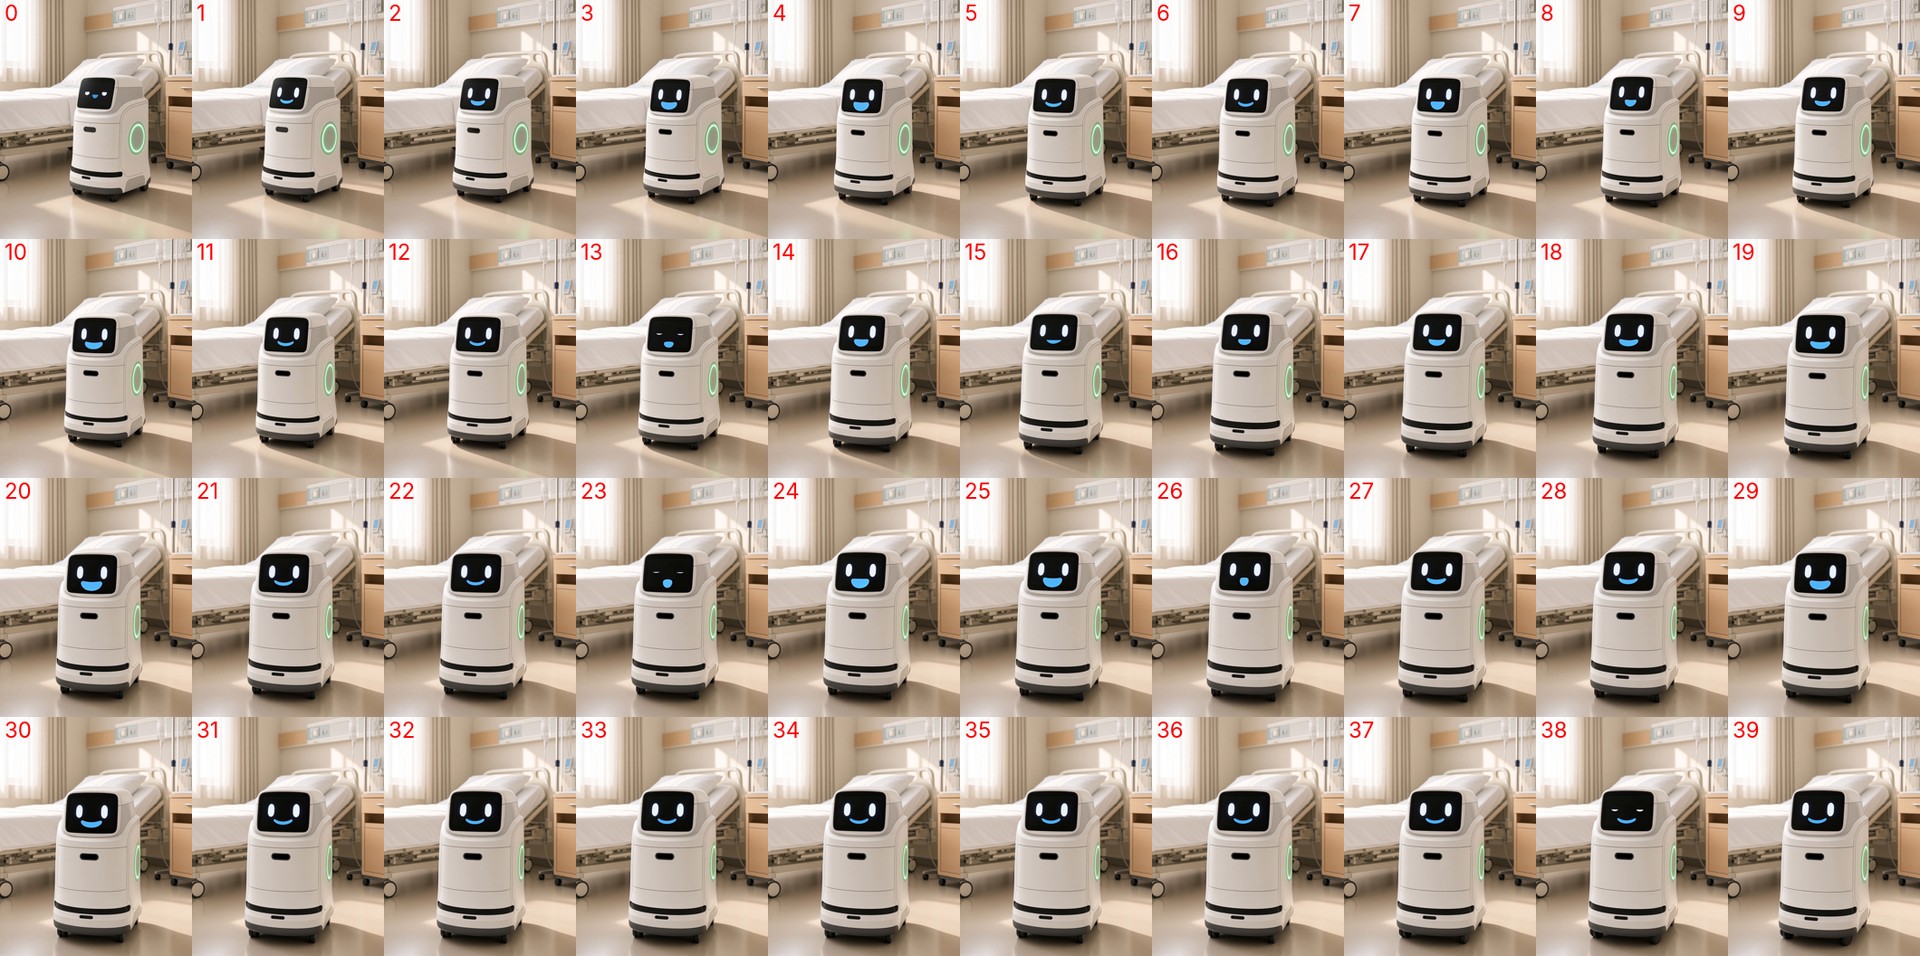
動画は 848×1056 ピクセル・24fps・10.04秒でした。1秒に4枚ずつ、40枚のコマを取り出して並べ、全身と側面の緑のリングが見えている5枚目を選んでいます。背景の切り抜きには rembg(画像から人や物の背景を消すライブラリ)の isnet-general-use というモデルを使いました。
顔の目と口は、元の絵を消してコードで描き直した
切り抜いた体のディスプレイを測り、元の目と口の位置と色を取りました(測定の全量は記事後半の実行ログにあります)。ディスプレイは横183×縦151ピクセル、元の口の色は #57B5F8 の水色です。元の目と口はディスプレイごと黒(#131311)で塗りつぶし、その上に同じ位置で目と口を描きます。
口はナレーションの音量に合わせて動かします。音声を1フレーム(1/30秒)ずつ区切って音量を測り、大きいほど口を大きく開く形にしました。最初の試作は、目が白い楕円、口が「閉じた笑顔/小さく開く/大きく開く」の3段階で、体は左を向いたままでした。
【画像】DAY331_03_first_prototype_faces.png
体の向きは、すぐに直しが入りました。
ハコブくんは右向きがいいですね。
左下に置くと、右を向けば画面の中央(図と字幕の側)を向くことになります。体の画像を左右反転して右向きにしました。
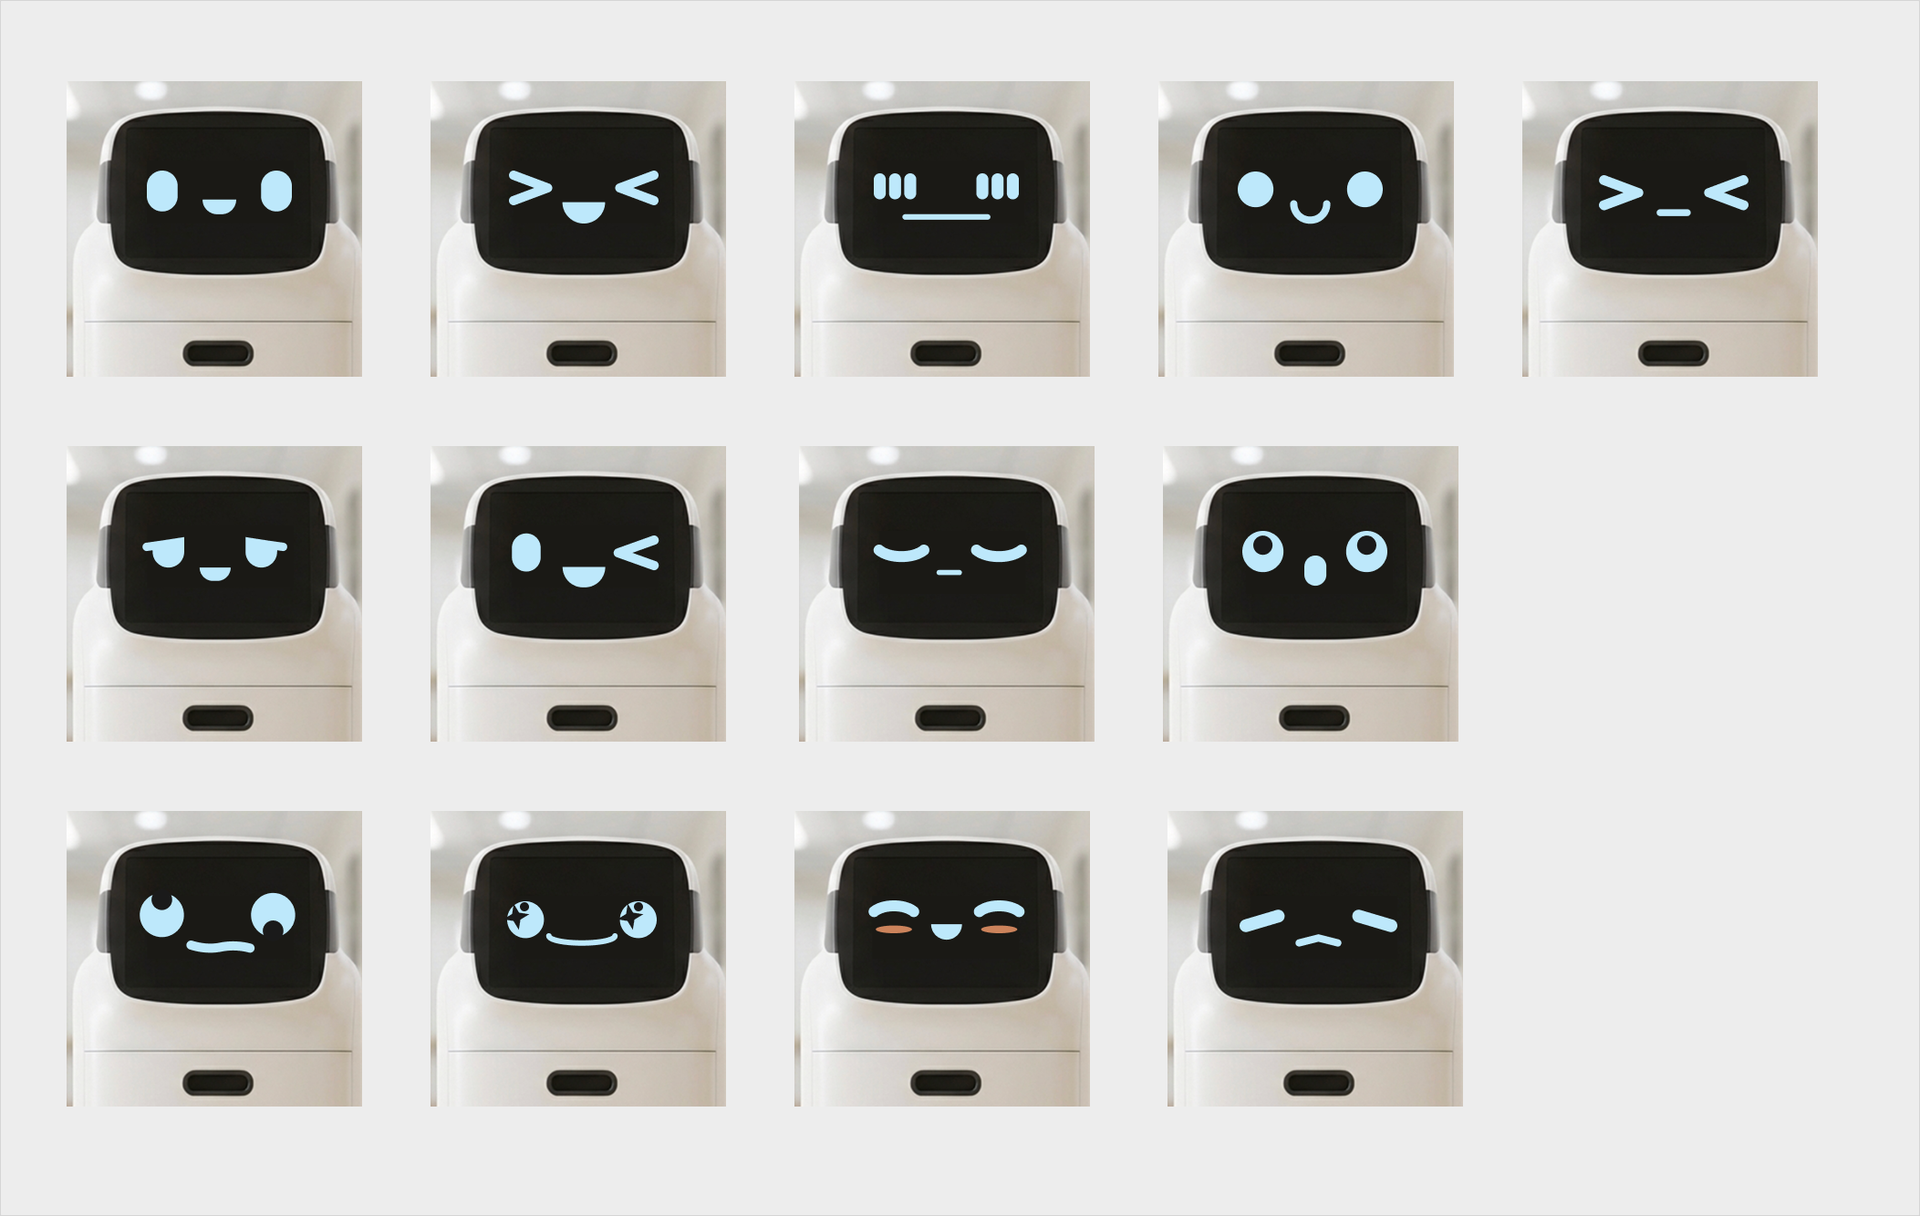
ここで1つ間違えています。その少し前に13種類の表情のイメージ(表情集)が共有されていて、表情集の顔は目も口も同じ薄い水色でした。右向きに直すときに、目と口を両方その水色(#BDE8FB)に変えてしまいました。
色は目は白、口は水色のままでいいですよ
表情集は形の参考で、色は元の動画のままでよかった、ということです。目を白、口を元の水色に戻しました。
口は音量で4段階に切り替え、1回に1段階ずつしか動かさない
最初の口は、閉じた口からいきなり大きい口に変わることがあり、角も立っていました。
口はもっと柔らかさを出すために角を丸くした方がいいですね(小さい口を途中に入れたりすると動きが出てより良いです)
口の形を4段階にしました。閉じた口は両端が丸い太い弧、小さい口は上が少し広く下が丸い形、中と大は角を丸めた三日月形です。角は、4倍の大きさで形を描いてから、半径5〜6ピクセル相当の丸で角を削っています(モルフォロジーのオープン処理。小さな丸が入り込めない角だけが削れる)。
切り替え方も変えました。音量から決めた段階に向かって、1回に1段階ずつしか動かしません。閉じた口から大きい口へ行くときは、必ず小と中を通ります。
次の指摘は速さでした。
口の動きや目の動きをもう気持ちだけゆっくりに動かしたほうがいいね(今は早すぎる。話し方も早すぎなのかもだけど)
口の形を変えるのを、毎フレーム(1秒に30回)から2フレームごと(1秒に15回)にしました。仮の音声の話す速さも1.08倍から1.0倍に落としています。
項目 | 最初 | 最後 |
|---|---|---|
口の段階 | 3段階(閉じる・小・大) | 4段階(閉じる・小・中・大) |
口の切り替え | 毎フレーム、段階を飛ばしてよい | 2フレームごと、1回に1段階 |
口の角 | 尖っている | 半径5〜6ピクセル相当で丸める |
仮の音声の速さ | 1.08倍 | 1.0倍 |
問いかけの文のあとの口 | 「o」の口 | 小さく開いた口のまま止める |
目は2.8秒の周期で上下し、口より0.1秒遅れて上がる
目が少し上下しているように描写すると表情がイキイキして見えます。
目に3つの動きを足しました。1つ目は、ゆっくりした上下の揺れです。最初は1.9秒の周期でしたが、速すぎるという指摘のあと2.8秒に延ばしました。2つ目は、口が大きく開くほど目が少し上がる動きです。口と同時に動くと機械的に見えるので、口より3フレーム(0.1秒)遅れて上がるようにしています。3つ目は、文の頭で目が0.3秒だけ小さく跳ねる動きです。
まばたきも、最初は3.2秒ごとの一定間隔でしたが、2〜4.5秒の間でばらつかせ、文を言い終わった直後にも1回入れました。
側面のリングは、元の絵を消して楕円を描き直し、顔と別の周期で光らせた
側面の緑のリングは、最初は元の絵の画素を明るくしていただけでした。
側面の光っている部分をもっと丁寧に描写(光方が汚く見える)
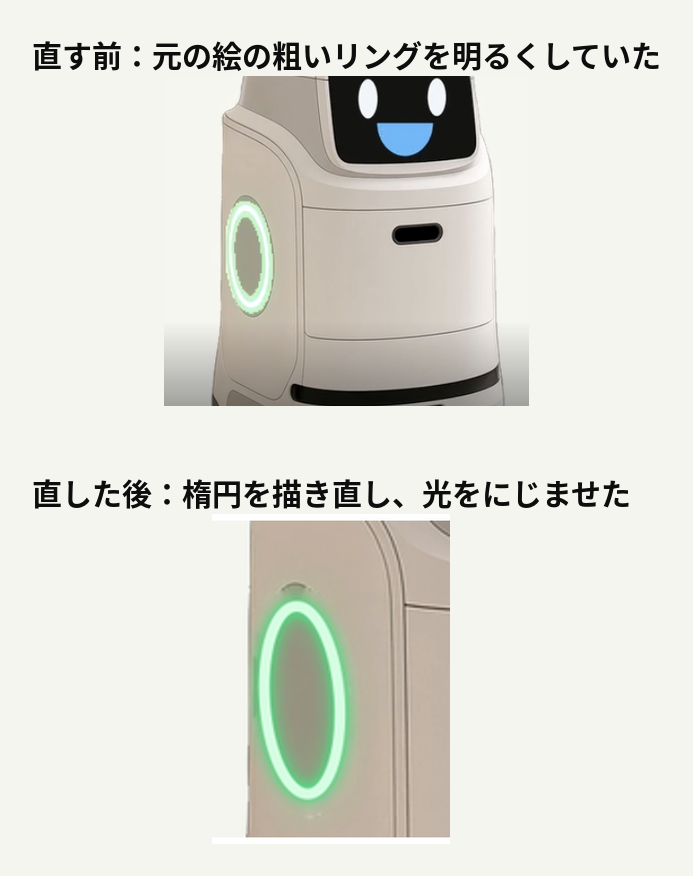
元の絵のリングは、生成動画を縮小した画像なので画素が粗く、明るくすると粗さが目立ちます。リングの画素に楕円を当てはめて位置と大きさを測り、元のリングはまわりの色で塗りつぶして消しました(OpenCV の inpaint。消したい範囲を、まわりの画素から推測した色で埋める処理)。その上に、4倍の大きさで描いた楕円を縮めて置き、ぼかした光を重ねています。光は体の外には出しません。
次の指摘は、光と表情が一緒に動いていることでした。
側面の光と表情の動きが同じタイミングで繰り返しているので、ずらしたり、合わせたりして躍動感(生命感)を出すと良さそう
普段はずらし、要所だけそろえる動きにしました。リングは、声に0.2秒遅れて明るくなり、話し終わったあとはゆっくり暗くなります(つくときは速く、消えるときは遅い)。話していない間も、息をするように少し明滅します。この明滅の周期は3.7秒で、目の揺れ(2.8秒)と周期を変えてあるので、目とリングが同じ組み合わせで繰り返しません。そろえるのは、文の頭と、口を大きく開いた瞬間だけです。
側面の光は強く光時と、弱く光ときを混ぜ込むと良さそう(ランダム性があるといい)
ばらつきを4か所に入れました。
声への反応の強さを、文ごとに変える(強い文と弱い文が混ざる)
口を大きく開いた瞬間の光り方を毎回変え、3回に1回ほどは光らない
息をするような明滅の強さを、ゆっくり不規則に変える
話していない間も、ときどき弱くまたたく
ばらつきは乱数の種を7に固定して作っているので、同じスクリプトを何度動かしても同じ光り方になります。
目はカプセル形にし、顔はディスプレイの辺に直線を当てはめて傾けた
目の形は、元の動画の顔に合わせる指示がありました。
目のデザインはこれに合わせて欲しい。
元の動画の目は、楕円ではなく、上下の端が半円になった縦長のカプセル形で、まわりに白い光がにじんでいます。カプセル形に変え、光のにじみを足しました。にじみはディスプレイの中だけに収めています。
続けて、傾きの指摘がありました。
目は顔のディスプレイに合わせて少しだけ斜めにすると良さそう
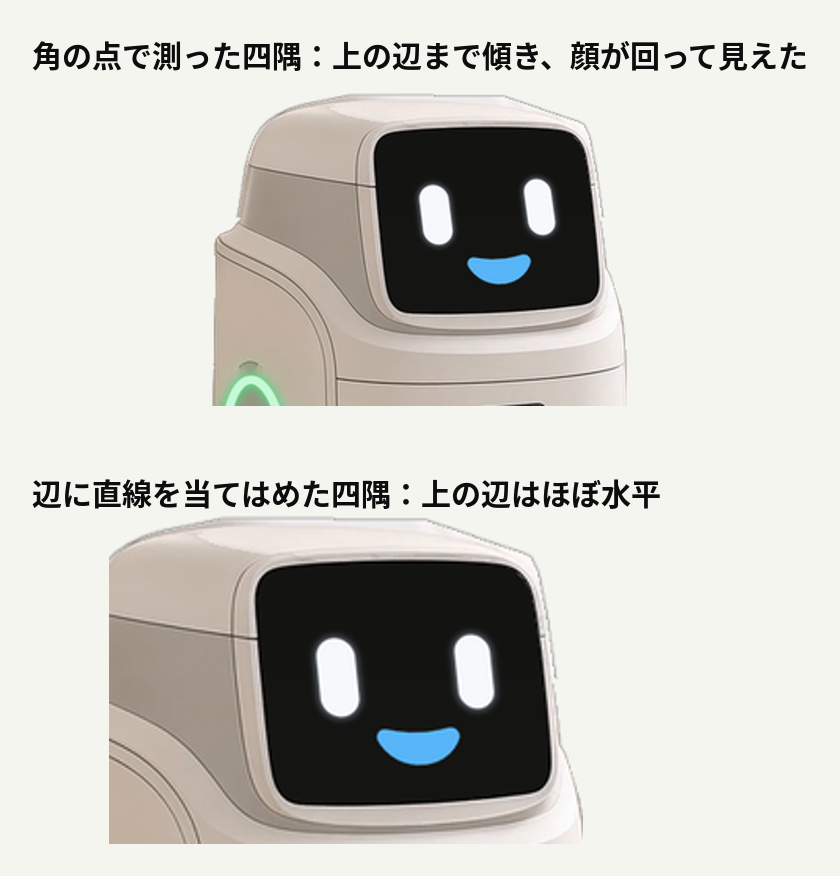
ハコブくんは斜め前から見た構図なので、ディスプレイも少し傾いて見えます。まっすぐ描いた顔を、ディスプレイの四隅に合わせて射影変換(四角形を別の四角形にはめ込む変形)しました。最初は、ディスプレイの輪郭を4つの角の点に近似して四隅を取りましたが、合いませんでした。
ちょっと目と口の描写が顔のディスプレいと合ってないね。微妙な差だけど。
ディスプレイは角が丸いので、角の点を直接取ると、丸みに引っぱられて位置がずれます。最初の四隅だと上の辺まで傾いていて、顔が回って見えていました。上下左右の辺の、まっすぐな中央4割の点にそれぞれ直線を当てはめ、直線どうしの交点を角にしました。測り直すと、上の辺は0.18度でほぼ水平、左右の辺は約6度(5.97度と5.67度)、下の辺は2.16度傾いていました。
目と口の間隔も2回、ごく少しだけ直しています。
ほんの少しだけだけど、目と口が近い方がデザインが近くなるね(ごくごく少しだけ)
目と口の位置がほんの少しだけ上に(本当に少しだけ)
1回目は、目を2ピクセル下げ、口を1.5ピクセル上げて、間を3.5ピクセル詰めました。2回目は、間隔を保ったまま両方を1.5ピクセル上げています(どちらも元の画像の大きさでのピクセル数で、動画上ではその約8割の動きです)。スクリプトでは EYE_SHIFT = 0.5 と MOUTH_SHIFT = -3.0 の2つの数字で調整できます。
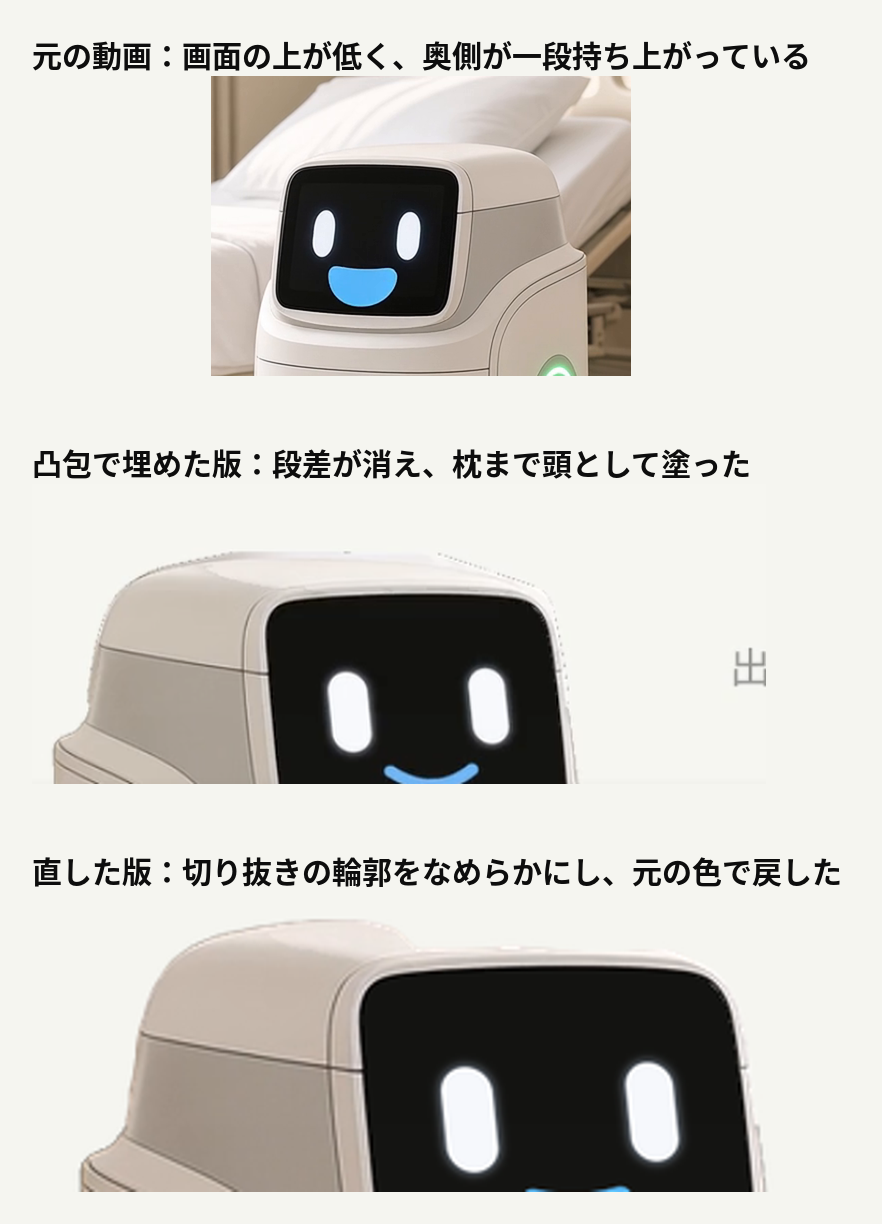
頭の上は、凸包で埋めると奥の段差が消えて枕まで塗っていた
頭の上は、3回直しています。元の動画では、ハコブくんの白い頭が後ろの白い枕と重なっていて、切り抜くと頭の上が薄く欠けます。
あとサンプルの頭の上が切れてしまっているのを修正してください。
1回目は、欠けた部分を含めた頭の輪郭の凸包(輪郭の外側に輪ゴムをかけたような、へこみのない形)で埋めました。
頭の描写をもっと綺麗に処理して(元のデザイン見直してください)
2回目は、凸包の角を大きく丸めてなめらかにしました。
まだ頭の処理が汚いです。
ここで、欠けた部分を下の色から塗り延ばす案を出しましたが、実行する前に止められました。
元の動画があるから見直してください!
元の動画の40枚のコマを並べ、そのうち8枚で頭の上を拡大すると、ハコブくんの頭は、画面のすぐ上の縁が低く、奥側がもう一段持ち上がった形をしていました。凸包は、この段差を直線で結んでしまいます。結んだ内側には後ろの枕が入っていたので、枕まで頭として塗り、形が崩れて汚く見えていました。
3回目は、凸包をやめました。切り抜きがはっきり頭と判断した範囲(透明度を表すアルファ値が60以上)をそのまま輪郭に使い、縁のギザギザだけを、4倍に拡大してぼかしてから切り直す方法でなめらかにしています。輪郭の内側は頭そのものなので、色は元のコマの画素で戻しました。縁の半透明の画素も元の色で戻したので、2回目まで出ていた暗い点線も消えています。
ハコブくんの区画に字幕や図が重なったら、書き出す前に止める
左下にキャラクターを置くと、字幕や図とぶつかります。試作を作る前に、置き方の決め事が必要だという話になりました。
左端の顔の部分にテキストがかからないように設定しておくことが必要ですね。
ハコブくんの「区画」を決め、そこには何も重ねないことにしました。区画は、実際に置いたハコブくんの体の範囲に余白20ピクセルを足した四角です。動画のルールで決めていた画面の作りとは、次の点が変わります。
項目 | もとの決まり | ハコブくんを置いたあと |
|---|---|---|
ハコブくんの区画 | なし | 左下の x=0〜380、y=746〜1080(上半身版) |
字幕の位置 | 画面の中央、1行31字まで | 区画の右側(x=400〜1780)の中央、1行26字まで |
出典の位置 | 左端から140ピクセル | 左端から420ピクセル |
図の範囲 | 左右140ピクセルの余白 | 左右140ピクセルのまま。区画に重なる場面は自動で止める |
ロゴの位置 | 右から140ピクセル、上から46ピクセル | 右から56ピクセル、上から44ピクセル |
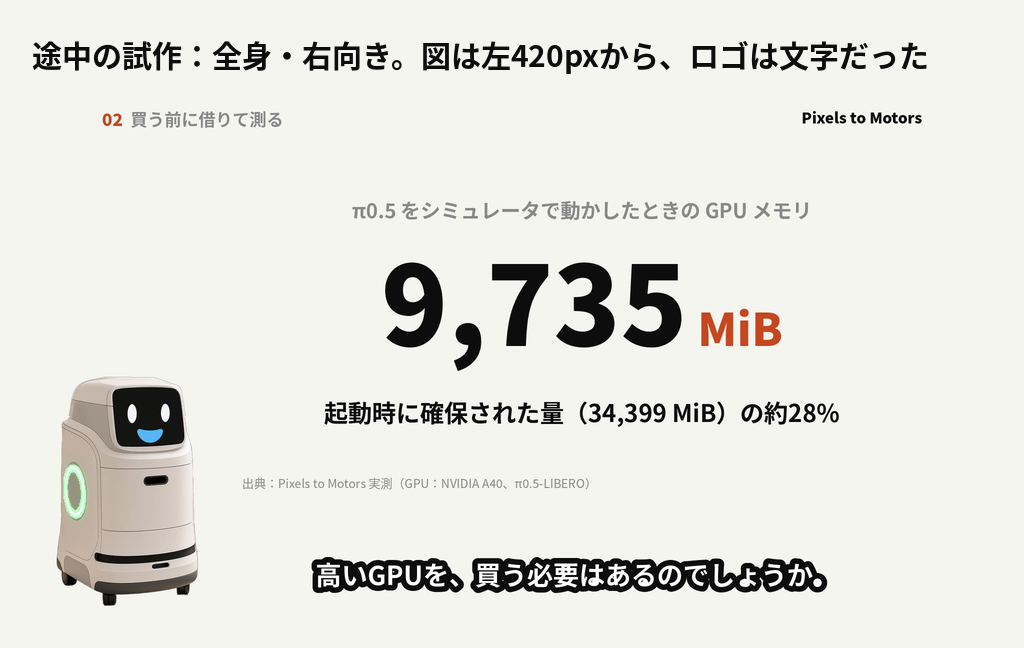
ロゴは、途中まで試作が「Pixels to Motors」の文字を自分で描いていました。
それと動画のデザインルールを確認して欲しい(どこかにデータがある。ロゴも修正)
iCloud の制作ベースのフォルダを開くと、本番は scenes.py(場面ごとの図の HTML と CSS)、render.py(字幕の画像)、logo_dark.png(ロゴの画像)で画面を作っていました。試作が自前で描いていた部分は、章のタグの書き方や、大きい数字の単位の色も本番と違っていたので、図と字幕は本番の scenes.py をそのまま読み込んで描く形に作り直しています。そのあと、ロゴの位置に指摘がありました。
右上のロゴはもっと端に寄せたほうがいいね。パディング取りすぎ。
重なりの確かめ方は、目で見るのをやめ、書き出しの前の自動の確認にしました。図と字幕はブラウザ(Playwright で動かす Chromium)で描いているので、描いたあとに、見出し・数字・出典・ロゴ・字幕の1行ずつの位置を、ブラウザから実際の四角として取り出します(getBoundingClientRect)。その四角がハコブくんの区画と1ピクセルでも重なったら、どの要素がどこで重なったかを出して、書き出しを止めます。
図の範囲をどうするかは、2つの案から選んでもらいました。図の左端を420ピクセルに寄せたままにするか、本番どおり140ピクセルにして場面ごとの自動の確認に任せるかです。
場面ごとに自動の重なり確認に任せて広げる
上半身版では、12個の要素すべてが区画に重なりませんでした。同じ場面を全身版で書き出すと、区画が高い位置(y=580)から始まるので、「起動時に確保された量の 約28%」の見出しが重なり、書き出しが止まりました。要素の四角で判定しているので、文字が短くても段落の幅いっぱいが判定の対象になります。止まった場面は、図を区画より上に収めるか、左端を420ピクセルに寄せて作り直します。
全身版より上半身版の方が、図を読む邪魔をしなかった
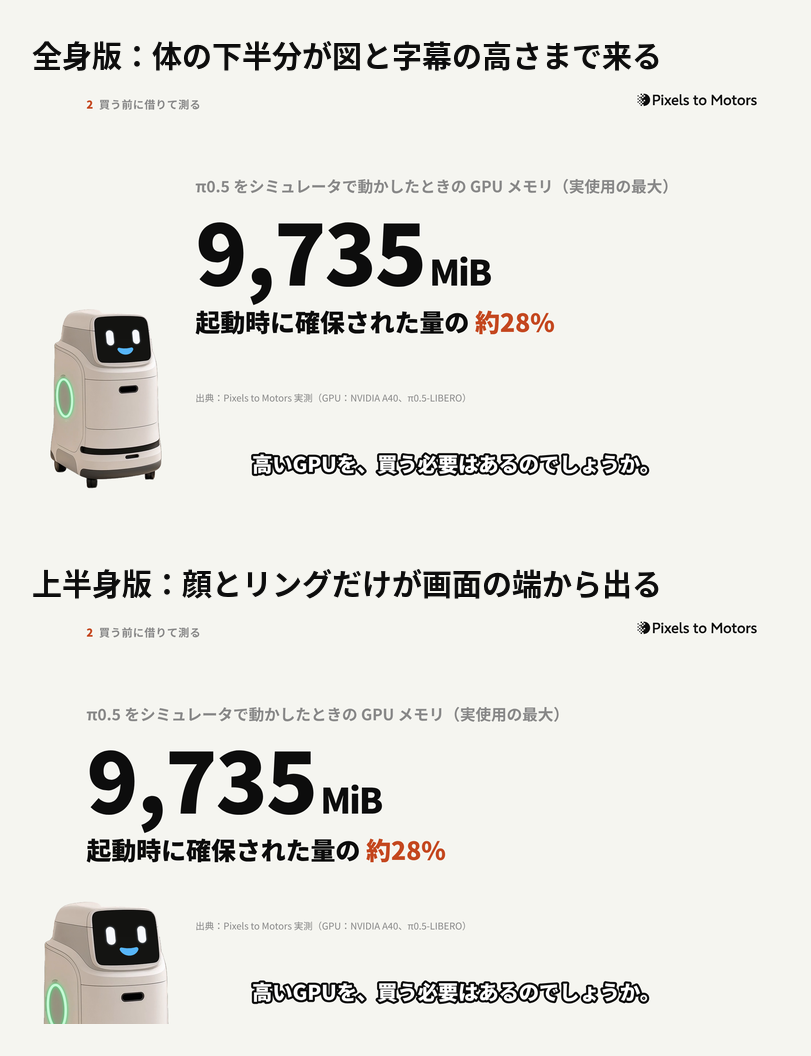
側面のリングを直すときに、全身版と上半身版の2つを作るように言われ、両方を書き出しました。全身版は高さ460ピクセルで体全体を、上半身版は幅340ピクセルで引き出しの取っ手の下あたりまでを置き、画面の下端に接しています。
上半身のデザインがいいですね。全身は少し邪魔しているように見えます。
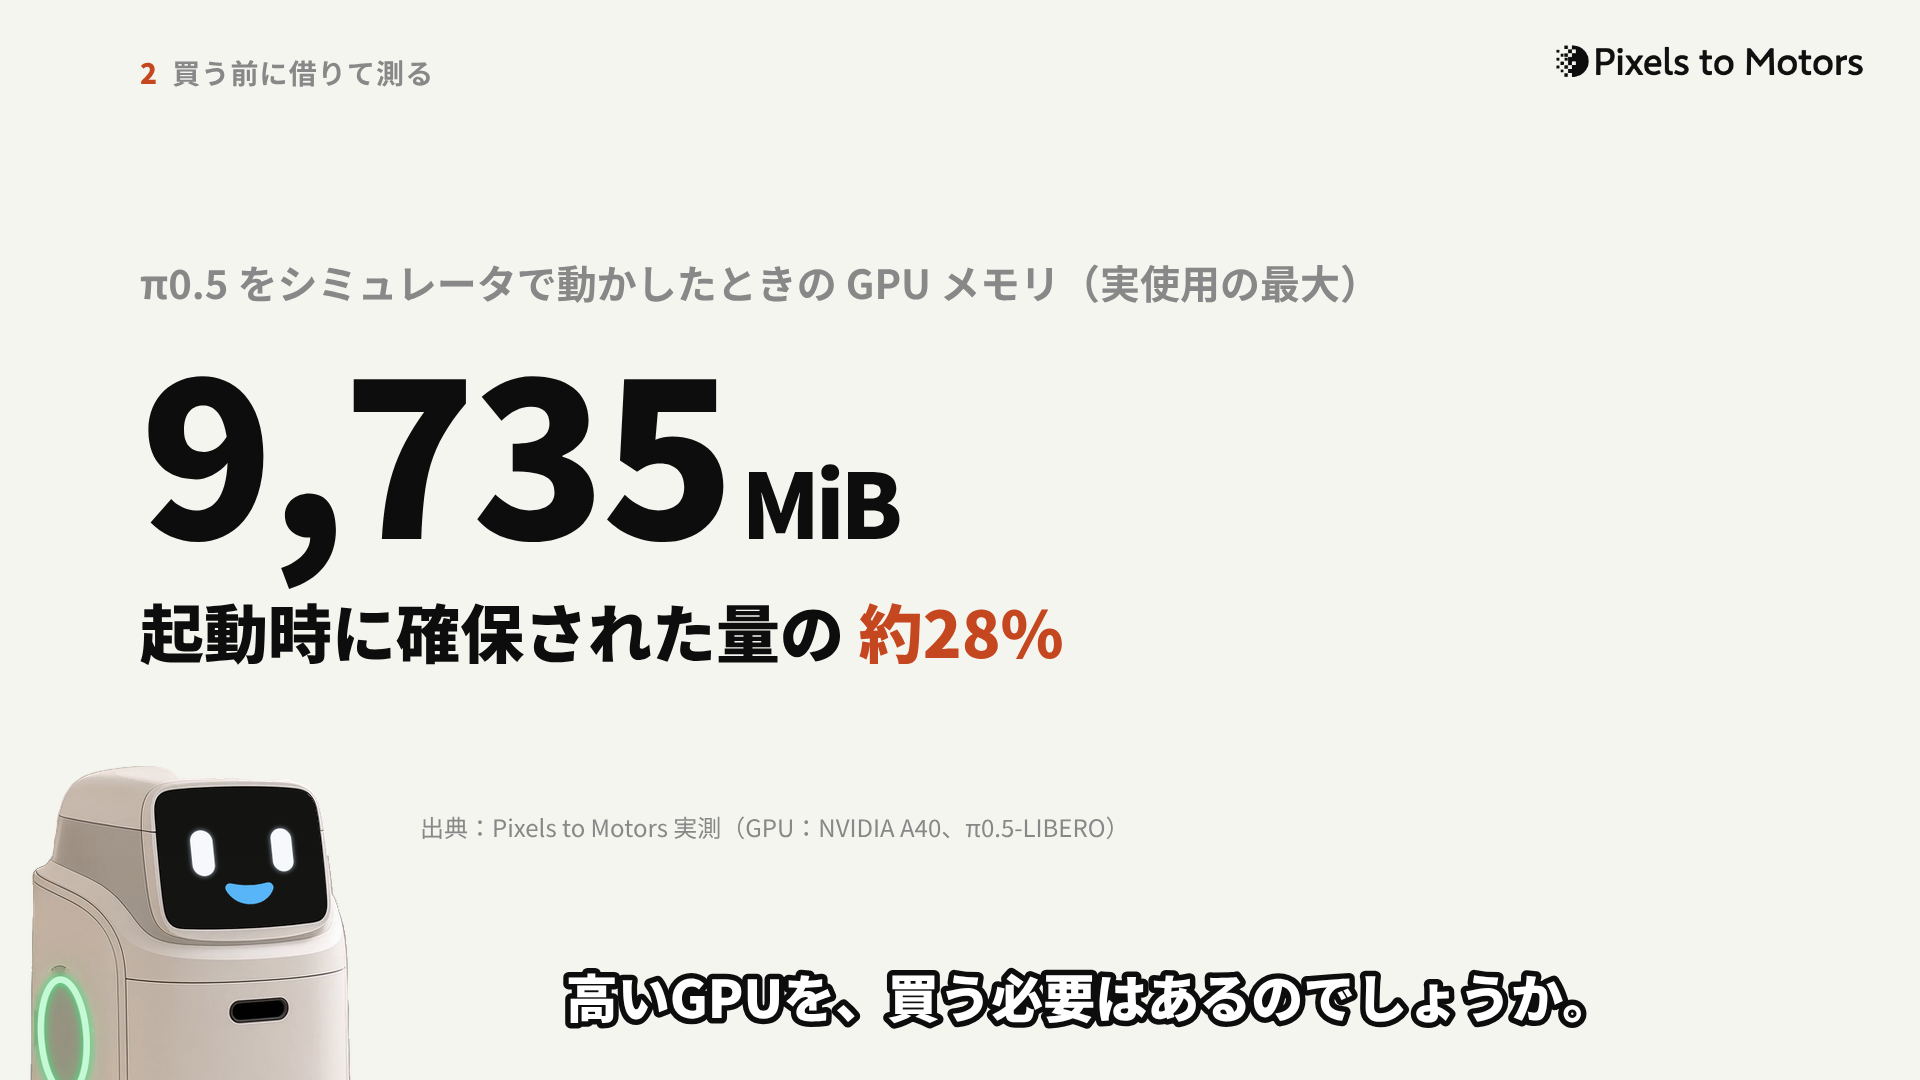
全身版は、体の下半分(引き出しや車輪)が図と字幕の高さまで伸びていて、視線がそちらに引っぱられます。上半身版は、顔と側面のリングだけが画面の端から出ているので、図を読む邪魔をしません。上半身版を基本にしました。
最後の画面はこの形です。
決めたことは video_rules.md に3-1節と4-7節として書き足した
ここまで決めたことは、動画制作のルール(video_rules.md)に書き足しました。ルールの文書はプロジェクトの文書と、iCloud の制作ベースのフォルダに同じ内容の写しがあるので、両方を同じ内容に更新しています。
節 | 書き足したこと |
|---|---|
3-1(新設) | ナレーションはハコブくんが話す。本人を見せる3つの決まり。概要欄に AI 音声と書く。ほかのチャンネルと同じ声を使わない |
3-2 | 仮の音声の速さを1.08倍から1.0倍に下げた |
4-1 | ハコブくんの区画(左下・上半身・右向き)。図の範囲は140ピクセルのまま、場面ごとの自動の確認に任せる。ロゴの位置 |
4-2・4-5 | ハコブくんの体と顔の色(目の白・口の水色・リングの緑)は、「オレンジと青以外の色を足さない」の対象外。影は付けない |
4-6 | 出典の左端を420ピクセルに移す |
4-7(新設) | 体の作り方(頭の上の直し方を含む)、顔の描き方、口・目・まばたき・リングの動きの数値、表情の付け方と使い分けの目安 |
5 | 字幕は1行26字まで、区画の右側の中央にそろえる |
1・2 | 台本の一人称「僕」を、本人の名前の三人称に言い換える。自己紹介の固定の文言をハコブくんが話す形にする |
8 | ハコブくんの声、体の画像、本番のスクリプトへの組み込み、表情の使い分けを未決として追加 |
表情は、目と頬を1文ごとに台本で指定し、口は話している間はどの表情でも音量で動かす、という決まりにしました。表情集の「_」の口のまま話すと、声と口が合わなくなるからです。使い分けの目安は次の表で、経営者向けの動画なので1本で使う表情は6つ前後にとどめます。
表情 | 使う場面 |
|---|---|
丸い目+開いた口 | 基本。説明の文はほぼこれ |
丸い目+小さな笑み | 間、聞き手に戻るところ |
驚いた目+「o」の口 | 動画の冒頭の問い、意外な数字が出るところ |
ジト目 | 「本当にそうでしょうか」と反論を出すところ |
目を閉じる | 「まとめると」、考えている間 |
困り眉 | 失敗や限界の話 |
>▽< | 結論が言えたところ、うまくいった実験 |
「III_III」 | 計算中・データを読み込んでいる場面 |
ウインク、キラキラ目、照れ、>_<、目が泳ぐ | アウトロや軽い一言だけ |
自己紹介の固定の文言は、もとの一人称の文をハコブくんが話す形に言い換え、「この番組は、本業のデザイナーをしながらロボティクスの研究と開発をしているエイイチが、自宅の机の上でロボットアームを動かした記録をもとにしています。」としました。この文言でよいかは、本人の確認待ちです。
ファイルの置き場所は次のとおりです。
ファイル | 置き場所 |
|---|---|
video_rules.md | iCloud |
試作のスクリプトと入力の画像 | iCloud |
試作の動画(mp4) |
|
まだ決まっていないのは、ハコブくんの声・体の画像・本番への組み込み・表情の4つ
項目 | いまの状態 | 決めること |
|---|---|---|
ハコブくんの声 | Open JTalk の仮の男声 | ElevenLabs の Voice Design で作るか、声優に頼んで作るか |
体の画像 | 生成動画の1コマを切り抜き、頭の上とリングを直して使っている | 同じ構図で、無地の背景・リングなしの画像を生成し直すか。生成し直せば、頭の上とリングの直しが要らなくなる |
本番のスクリプトへの組み込み | 試作のスクリプトで、動きと配置を確かめた段階 | render.py と assemble.py に組み込む。台本(narration.py)に「表情」の欄を足す。表情集の顔をコードで描く。scenes.py のロゴの位置を直す(いまは試作の中で上書きしているだけ) |
表情の使い分け | 目安の表だけ | 1本作って、使う表情と場面を確定する |
試作は体を描いてから左右反転しているので、ウインクのように左右で形が違う表情は、このままだと左右が逆になります。本番では、体だけを先に反転し、顔は向きどおりに描く順番にします。
この4項目のうち3つは、この記事の作業のあとで決まりました。本番への組み込みは hakobu.py として済み、声は ElevenLabs の Voice Design を1か月試すことに、体の画像はいまのまま使うことになっています。字幕の位置も、そのあと画面の中央にそろえる形に変わりました。経緯は video_rules.md の更新履歴にあります。
試作スクリプトの全文
使ったもの: Python 3.13.16、opencv-python 5.0.0、Pillow 12.3.0、numpy 2.5.3、pyopenjtalk 0.4.1、rembg 2.0.85(onnxruntime 1.29.0)、playwright 1.56.0(Chromium)、ffmpeg 6.1.1。フォントは Noto Sans CJK JP。
試作は Claude の作業環境(クラウドの Linux)で動かしました。Mac で動かすときは、hakobu_試作/ を作業フォルダにして実行します。render_static.py は、1つ上の _制作ベース/ にある本番の scenes.py と logo_dark.png を読み込みます。
準備のコマンド(コマの取り出しと、体の切り抜き)
元の生成動画は、共有されたときのファイル名が文字化けしていたため、hakobu_試作/source_hakobu_hospital.mp4 という名前で保存し直しています。
# 動画の情報を見る
ffprobe -v error -show_entries format=duration:stream=codec_type,width,height,r_frame_rate -of compact source_hakobu_hospital.mp4

# 1秒に4枚ずつ、40枚のコマを取り出す
mkdir -p full
ffmpeg -v error -y -i source_hakobu_hospital.mp4 -vf "fps=4" full/g_%02d.png

# 40枚に番号を振って並べる(コマを選ぶため)
ffmpeg -v error -y -i full/g_%02d.png -vf "scale=212:-1,drawtext=text='%{n}':x=5:y=5:fontsize=24:fontcolor=red,tile=10x4" sheet.png

# rembg と、関連するライブラリを入れる
pip install --break-system-packages pyopenjtalk rembg onnxruntime
# 5枚目のコマから背景を消す(cut_raw.png)
from rembg import remove, new_session
from PIL import Image
im = Image.open('full/g_05.png').convert('RGB')
out = remove(im, session=new_session('isnet-general-use'))
out.save('cut_raw.png'); print(out.size, out.getbbox())
measure_face.py(ディスプレイ・目・口・リングを測る)
"""ハコブくんの顔のディスプレイを測る(make_demo.py に書いた座標の出どころ)
入力: cut_raw.png(元の動画の5コマ目を rembg の isnet-general-use で切り抜いた画像)
出力: ディスプレイ・目・口・リング・体の範囲、口の色、ディスプレイの四隅
"""
import numpy as np, cv2
from PIL import Image

raw = np.array(Image.open("cut_raw.png").convert("RGBA"))
rgb = raw[..., :3].astype(int)
a = raw[..., 3]
lum = rgb.mean(2)

# 1. ディスプレイ(黒い画面):顔のあたりで一番大きい暗い領域
y0, y1, x0, x1 = 330, 520, 300, 530
dark = np.zeros(lum.shape, np.uint8)
dark[y0:y1, x0:x1] = (lum[y0:y1, x0:x1] < 75)
n, lab, st, _ = cv2.connectedComponentsWithStats(dark)
k = 1 + np.argmax(st[1:, 4])
scr = (lab == k).astype(np.uint8)
print("ディスプレイの外接矩形 (x, y, 幅, 高さ):", st[k][:4].tolist())

# 2. 元の目(白)と口(水色)
reg = rgb[y0:y1, x0:x1]
rl = reg.mean(2)
white = (rl > 200) & (reg.std(2) < 25)
blue = (reg[..., 2] > 180) & (reg[..., 0] < 150)
for name, m in [("白", white), ("水色", blue)]:
    n2, lab2, st2, _ = cv2.connectedComponentsWithStats(m.astype(np.uint8))
    for j in range(1, n2):
        if st2[j, 4] > 80:
            x, y, w, h, area = st2[j].tolist()
            print(f"{name}の領域: x={x + x0} y={y + y0} 幅={w} 高さ={h} 面積={area}")
print("口の色(中央値 RGB):", np.median(reg[blue], 0).astype(int).tolist())

# 3. 側面の緑のリングと、体全体の範囲
ring = (rgb[..., 1] > 150) & (rgb[..., 1] - rgb[..., 0] > 40) & (rgb[..., 1] - rgb[..., 2] > 20)
ys, xs = np.where(ring)
print("リングの範囲:", xs.min(), ys.min(), xs.max(), ys.max(), "画素数", len(xs))
ys, xs = np.where(a > 128)
print("体の範囲:", xs.min(), ys.min(), xs.max(), ys.max())

# 4. 頭の上の切り抜きの濃さ(行ごとに、アルファが一定以上の画素の数)
print("頭の上の行ごとの画素数(アルファ>200 / >60 / >10):")
for y in range(320, 360, 4):
    row = a[y, 300:650]
    print(f"  y={y}: {(row > 200).sum()} / {(row > 60).sum()} / {(row > 10).sum()}")

# 5. ディスプレイの四隅
#    角が丸いので角の点は直接取らない。上下左右の辺の、まっすぐな中央4割の点に直線を当てはめ、交点を角にする
c = max(cv2.findContours(scr, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_NONE)[0], key=cv2.contourArea)
c = c.reshape(-1, 2).astype(np.float32)
bx, by, bw, bh = cv2.boundingRect(c.astype(np.int32))
cx, cy = bx + bw / 2, by + bh / 2
sides = {
    "上": c[(c[:, 1] < cy - bh * 0.3) & (np.abs(c[:, 0] - cx) < bw * 0.2)],
    "下": c[(c[:, 1] > cy + bh * 0.3) & (np.abs(c[:, 0] - cx) < bw * 0.2)],
    "左": c[(c[:, 0] < cx - bw * 0.3) & (np.abs(c[:, 1] - cy) < bh * 0.2)],
    "右": c[(c[:, 0] > cx + bw * 0.3) & (np.abs(c[:, 1] - cy) < bh * 0.2)],
}
lines = {}
for nm, p in sides.items():
    vx, vy, px, py = cv2.fitLine(p, cv2.DIST_L2, 0, 0.01, 0.01).ravel()
    lines[nm] = (np.array([px, py]), np.array([vx, vy]))
    ang = np.degrees(np.arctan2(vy, vx))
    if nm in ("左", "右"):
        ang = 90 - abs(ang)  # 縦の辺は、垂直からの傾き
    print(f"{nm}の辺: 点 {len(p)} 個、傾き {ang:.2f}°")


def cross(s1, s2):
    (p1, d1), (p2, d2) = lines[s1], lines[s2]
    t = np.linalg.solve(np.array([d1, -d2]).T, p2 - p1)
    return p1 + t[0] * d1


quad = [cross("上", "左"), cross("上", "右"), cross("下", "右"), cross("下", "左")]
print("ディスプレイの四隅(左上・右上・右下・左下):", [[round(float(v), 1) for v in q] for q in quad])

# 参考: 角の点をそのまま取った場合(最初に使って、傾きを読み違えた方法)
hull = cv2.convexHull(c.astype(np.int32))
for eps in np.linspace(2, 30, 57):
    ap = cv2.approxPolyDP(hull, eps, True)
    if len(ap) == 4:
        print(f"参考・角の点を直接取った四隅(eps={eps}):", ap.reshape(-1, 2).tolist())
        break
make_demo.py(体の加工・顔の描画・口と目とリングの動き・重なりの確認・書き出し)
"""ハコブくん ナレーション試作(13秒ほど)
使い方: python3 make_demo.py upper   (上半身・基本) / python3 make_demo.py full (全身)
       python3 make_demo.py upper --dump  (口・目・まばたき・リングの時間の値だけを timing.json に書き出して終わる)
入力: cut_raw.png(元の動画の5コマ目を rembg で切り抜いた画像)、full/g_05.png(元の動画の5コマ目そのもの)
必要なもの: pyopenjtalk(仮音声)、playwright と Chromium(図と字幕)、opencv-python、numpy、Pillow、ffmpeg
- 動画の1コマから切り抜いた体に、画面の顔をコードで描く
- 仮の音声(Open JTalk)の音量で口を4段階に切り替え、目・まばたき・側面のリングを動かす
- ハコブくんの区画に文字が重なっていないかを自動で確認する
"""
import subprocess, sys
import numpy as np, cv2, pyopenjtalk
from PIL import Image, ImageDraw, ImageFont, ImageEnhance

W, H, FPS = 1920, 1080, 30
SR = 48000
BG = (245, 245, 240)
INK = (13, 13, 13)
GRAY = (136, 136, 136)
ORANGE = (196, 71, 31)
FONT_JP = "/usr/share/fonts/opentype/noto/NotoSansCJK-Bold.ttc"
FONT_BLACK = "/usr/share/fonts/opentype/noto/NotoSansCJK-Black.ttc"
FONT_REG = "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc"

# ハコブくんの区画(ここには何も重ねない)
ZONE = (0, 600, 380, 1080)
SUB_X0, SUB_X1 = 400, 1780
FIG_X0 = 420


def font(path, size):
    return ImageFont.truetype(path, size, index=0)  # index 0 = JP


# ---------- 1. 体の切り抜きを整える ----------
raw = np.array(Image.open("cut_raw.png").convert("RGBA"))
alpha = raw[..., 3].copy()
alpha[alpha < 60] = 0
n, lab, st, _ = cv2.connectedComponentsWithStats((alpha > 0).astype(np.uint8))
keep = 1 + np.argmax(st[1:, 4])
alpha[lab != keep] = 0
# 頭の上:白い頭が白い枕と重なっていて、切り抜きが薄く欠けている。
# 元の動画のコマを見ると、頭の上の輪郭は「画面の上の手前側の縁(低い)→ 奥の角で持ち上がる → 奥の縁(高い)→ 右の角で丸く下がる」形。
# 凸包で埋めるとこの段差が直線になり、枕まで頭に含めてしまう(汚れの原因)。
# そこで、切り抜きがはっきり頭と判断した範囲(アルファ60以上)をそのまま輪郭に使い、ギザギザだけをなめらかにする。
a_soft = np.array(Image.open("cut_raw.png"))[..., 3]
HEAD_Y1 = 425  # 肩の段差より上だけを対象にする
head = (a_soft > 60).astype(np.uint8)
head[HEAD_Y1:] = 0
head[:, :300] = 0
n_h, lab_h, st_h, _ = cv2.connectedComponentsWithStats(head)
head = (lab_h == 1 + np.argmax(st_h[1:, 4])).astype(np.uint8)
cnts, _ = cv2.findContours(head, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_NONE)
head = np.zeros_like(head)
cv2.drawContours(head, cnts, -1, 1, -1)  # 穴を埋める
# 4倍に拡大 → ぼかして0.5で切り直す(ギザギザを曲線に) → 小さく角を丸める → 元の大きさへ
_S = 4
_big = cv2.resize(head.astype(np.float32) * 255, None, fx=_S, fy=_S, interpolation=cv2.INTER_LINEAR)
_pad = 20 * _S
_bigp = cv2.copyMakeBorder(_big, 0, _pad, 0, 0, cv2.BORDER_REPLICATE)  # 下の切れ目が丸まらないように下へ延ばす
_bigp = cv2.GaussianBlur(_bigp, (0, 0), 2.5 * _S)
_bigp = ((_bigp > 127) * 255).astype(np.uint8)
_k = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (2 * 4 * _S + 1, 2 * 4 * _S + 1))
_bigp = cv2.morphologyEx(_bigp, cv2.MORPH_OPEN, _k)[: _big.shape[0]].astype(np.float32)
hull_soft = cv2.resize(_bigp, (head.shape[1], head.shape[0]), interpolation=cv2.INTER_AREA)  # 縁は自然な中間値
hull_mask = (hull_soft > 127).astype(np.uint8)
hull_soft[HEAD_Y1 - 3:] = 0
alpha = np.maximum(alpha, hull_soft.astype(np.uint8))
alpha[: HEAD_Y1 - 20] = hull_soft[: HEAD_Y1 - 20].astype(np.uint8)  # 頭の上はこの輪郭だけで描く
# 輪郭の内側は頭そのものなので、色は元のコマの画素をそのまま使う(切り抜きで暗くなった部分を戻す)
orig_rgb = np.array(Image.open("full/g_05.png").convert("RGB"))
restore = (hull_soft > 0) & (a_soft < 245)  # 縁の半透明の画素も含める(暗い点線が出ないように)
restore[HEAD_Y1:] = False
raw[restore, :3] = orig_rgb[restore]
raw[..., 3] = alpha

# 画面(黒いディスプレイ)の領域を見つけて、元の目と口を消す
rgb = raw[..., :3].astype(int)
lum = rgb.mean(2)
y0, y1, x0, x1 = 330, 520, 300, 530
dark = np.zeros(lum.shape, np.uint8)
dark[y0:y1, x0:x1] = (lum[y0:y1, x0:x1] < 75)
n, lab, st, _ = cv2.connectedComponentsWithStats(dark)
k = 1 + np.argmax(st[1:, 4])
scr = (lab == k).astype(np.uint8)
cnts, _ = cv2.findContours(scr, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_NONE)
screen_mask = np.zeros_like(scr)
cv2.drawContours(screen_mask, cnts, -1, 1, -1)
screen_mask = cv2.erode(screen_mask, np.ones((3, 3), np.uint8), 1)
SCREEN_COLOR = (19, 19, 17)
raw[screen_mask == 1, :3] = SCREEN_COLOR

# 横の緑のリング
# 元のリングは画素が粗いので、一度消して、楕円をコードで描き直す
g = raw[..., :3].astype(int)
ring_core = (g[..., 1] > 150) & (g[..., 1] - g[..., 0] > 40) & (g[..., 1] - g[..., 2] > 20)
ring_core &= ~(screen_mask.astype(bool))
ys, xs = np.where(ring_core)
RING = cv2.fitEllipse(np.stack([xs, ys], 1).astype(np.float32))  # ((cx,cy),(長径,短径),角度)
(rcx, rcy), (rw, rh), rang = RING
perim = np.pi * (3 * (rw + rh) / 2 - np.sqrt((3 * rw / 2 + rh / 2) * (rw / 2 + 3 * rh / 2)))
RING_T = max(3.5, min(7.0, ring_core.sum() / perim))  # リングの太さ(px)
# 緑がにじんでいる範囲ごと塗り直して消す
halo = ((g[..., 1] - g[..., 0] > 15) & (g[..., 1] - g[..., 2] > 5)) | ring_core
halo = cv2.dilate(halo.astype(np.uint8), np.ones((7, 7), np.uint8), 1)
halo[: int(rcy - rh / 2 - 15)] = 0
halo[int(rcy + rh / 2 + 15):] = 0
halo[:, : int(rcx - rw / 2 - 15)] = 0
halo[:, int(rcx + rw / 2 + 15):] = 0
bgr = cv2.cvtColor(raw[..., :3].copy(), cv2.COLOR_RGB2BGR)
bgr = cv2.inpaint(bgr, halo, 7, cv2.INPAINT_TELEA)
raw[..., :3] = cv2.cvtColor(bgr, cv2.COLOR_BGR2RGB)


def draw_ring(img, on):
    """リングを4倍の解像度で描き、にじむ光を重ねる"""
    m = 30
    bx0, by0 = int(rcx - rw / 2 - m), int(rcy - rh / 2 - m)
    bw, bh = int(rw + 2 * m), int(rh + 2 * m)
    big = np.zeros((bh * SS, bw * SS), np.uint8)
    cv2.ellipse(big, ((int((rcx - bx0) * SS), int((rcy - by0) * SS)),
                      (int(rw * SS), int(rh * SS)), rang),
                255, int(RING_T * SS), cv2.LINE_AA)
    core = cv2.resize(big, (bw, bh), interpolation=cv2.INTER_AREA).astype(np.float32) / 255
    on = float(on)  # 0(話していない)〜1(話している)
    glow = cv2.GaussianBlur(core, (0, 0), 3.5 + 1.5 * on)
    glow = np.clip(glow * (1.4 + 0.8 * on), 0, 1)
    region = np.array(img.crop((bx0, by0, bx0 + bw, by0 + bh))).astype(np.float32)
    a = region[..., 3:4] / 255
    rgb = region[..., :3]
    glow_col = np.array([70, 225, 130], np.float32)
    core_col = np.array([160, 240, 185], np.float32) * (1 - on) + np.array([215, 255, 228], np.float32) * on
    gk = (glow * (0.45 + 0.3 * on))[..., None] * a  # 体の外には光を出さない
    rgb = rgb * (1 - gk) + glow_col * gk
    ck = core[..., None] * a
    rgb = rgb * (1 - ck) + core_col * ck
    region[..., :3] = rgb
    img.paste(Image.fromarray(region.astype(np.uint8)), (bx0, by0))


base_body = Image.fromarray(raw)
body_bbox = base_body.getbbox()

# ---------- 2. 顔を描く(元の位置を実測した座標) ----------
EYE_L = (362, 395, 384, 441)
EYE_R = (446, 396, 469, 444)
MOUTH = (378, 450, 446, 490)
EYE_SHIFT = 0.5     # 目の上下位置(元画像の px。+で下)。顔全体を1.5px上げた
MOUTH_SHIFT = -3.0  # 口の上下位置(目と口の間は 3.5px 詰めたまま)
BLUE = (87, 181, 248)    # 口の水色(元の動画の色 #57B5F8)
WHITE = (246, 248, 252)  # 目の白
SS = 4  # 4倍で描いて縮める(縁をなめらかにする)


FX0, FY0, FX1, FY1 = 320, 370, 520, 500  # 顔を描く範囲(元画像の座標)


def _pts(xs, ys):
    return np.stack([(np.asarray(xs) - FX0) * SS, (np.asarray(ys) - FY0) * SS], 1).astype(np.int32)


def mouth_mask(kind):
    """口の形を4倍の解像度で作り、角を丸めて返す(0/255 の配列)"""
    w, h = (FX1 - FX0) * SS, (FY1 - FY0) * SS
    m = np.zeros((h, w), np.uint8)
    cx = (MOUTH[0] + MOUTH[2]) / 2
    top = MOUTH[1] + 2 + MOUTH_SHIFT
    t = np.linspace(0, 1, 60)
    if kind in ("mid", "large"):
        # 三日月形:上の辺はゆるく下がり、下の辺は深い弧
        hw, depth, sag, rr = (34, 38, 7, 6) if kind == "large" else (27, 25, 5, 5)
        xs = cx - hw + 2 * hw * t
        y_top = top + sag * (1 - (2 * t - 1) ** 2)
        y_bot = top + depth * np.sqrt(np.clip(1 - (2 * t - 1) ** 2, 0, 1))
        poly = np.concatenate([_pts(xs, y_top), _pts(xs[::-1], y_bot[::-1])])
        cv2.fillPoly(m, [poly], 255)
    elif kind == "small":
        # 小さく開いた口:上が少し広く、下が丸い
        hw, rr = 14, 6
        xs = cx - hw + 2 * hw * t
        y_top = top + 4 + 2 * (1 - (2 * t - 1) ** 2)
        ang = np.linspace(0, np.pi, 60)
        bx = cx + hw * np.cos(ang)
        by = top + 12 + 13 * np.sin(ang)
        poly = np.concatenate([_pts(xs, y_top), _pts(bx, by)])
        cv2.fillPoly(m, [poly], 255)
    elif kind == "closed":
        # 閉じた笑顔:太さのある弧、両端は丸い
        hw, sag, thick = 25, 9, 7
        for tt in np.linspace(0, 1, 200):
            x = cx - hw + 2 * hw * tt
            y = top + 7 + sag * (1 - (2 * tt - 1) ** 2)
            p = _pts([x], [y])[0]
            cv2.circle(m, (int(p[0]), int(p[1])), int(thick / 2 * SS), 255, -1)
        return m
    k = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (2 * rr * SS + 1, 2 * rr * SS + 1))
    return cv2.morphologyEx(m, cv2.MORPH_OPEN, k)  # 角を丸める


MOUTH_CACHE = {}

# ディスプレイの四隅:画面の上下左右の辺のまっすぐな部分(角の丸みを除いた中央4割)に直線を当てはめ、
# その交点を角とした(角の丸みに引っぱられないように)。上の辺はほぼ水平(0.2°)、左右の辺は約6°傾いている
SCREEN_QUAD = np.float32([[336.8, 348.8], [510.2, 349.3], [495.1, 501.2], [321.5, 494.6]])  # 左上・右上・右下・左下
_c = SCREEN_QUAD.mean(0)
_w = (np.linalg.norm(SCREEN_QUAD[1] - SCREEN_QUAD[0]) + np.linalg.norm(SCREEN_QUAD[2] - SCREEN_QUAD[3])) / 2
_h = (np.linalg.norm(SCREEN_QUAD[3] - SCREEN_QUAD[0]) + np.linalg.norm(SCREEN_QUAD[2] - SCREEN_QUAD[1])) / 2
FLAT_RECT = np.float32([[_c[0] - _w / 2, _c[1] - _h / 2], [_c[0] + _w / 2, _c[1] - _h / 2],
                        [_c[0] + _w / 2, _c[1] + _h / 2], [_c[0] - _w / 2, _c[1] + _h / 2]])
TILT = 1.0  # 1.0 = ディスプレイと同じだけ傾ける。0.5 なら半分
_quad = FLAT_RECT + TILT * (SCREEN_QUAD - FLAT_RECT)
_to_layer = lambda p: (p - np.float32([FX0, FY0])) * SS
H_FACE = cv2.getPerspectiveTransform(_to_layer(FLAT_RECT), _to_layer(_quad))


def warp_to_screen(la):
    h, w = la.shape[:2]
    a = la[..., 3:4].astype(np.float32) / 255
    pre = np.concatenate([la[..., :3].astype(np.float32) * a, a * 255], 2)  # 縁が黒ずまないよう乗算済みで変形
    out = cv2.warpPerspective(pre, H_FACE, (w, h), flags=cv2.INTER_LINEAR)
    aa = out[..., 3:4] / 255
    rgb = np.where(aa > 1e-4, out[..., :3] / np.maximum(aa, 1e-4), 0)
    return np.concatenate([np.clip(rgb, 0, 255), out[..., 3:4]], 2).astype(np.uint8)


def draw_face(img, mouth, eyes_closed, eye_dy=0.0):
    fx0, fy0, fx1, fy1 = FX0, FY0, FX1, FY1
    layer = Image.new("RGBA", ((fx1 - fx0) * SS, (fy1 - fy0) * SS), (0, 0, 0, 0))
    d = ImageDraw.Draw(layer)

    def r(b):
        return [(b[0] - fx0) * SS, (b[1] - fy0) * SS, (b[2] - fx0) * SS, (b[3] - fy0) * SS]

    for e in (EYE_L, EYE_R):
        e = (e[0], e[1] + eye_dy + EYE_SHIFT, e[2], e[3] + eye_dy + EYE_SHIFT)  # 目だけ少し上下させる
        if eyes_closed:
            cy = (e[1] + e[3]) / 2
            d.rounded_rectangle(r((e[0] - 1, cy - 2.5, e[2] + 1, cy + 2.5)), radius=2.5 * SS, fill=WHITE)
        else:
            # 縦長のカプセル形(上下の端が半円)
            w = e[2] - e[0]
            d.rounded_rectangle(r(e), radius=w / 2 * SS, fill=WHITE)
    if mouth not in MOUTH_CACHE:
        MOUTH_CACHE[mouth] = mouth_mask(mouth)
    la = np.array(layer)
    mm = MOUTH_CACHE[mouth] > 0
    la[mm, :3] = BLUE
    la[mm, 3] = 255
    # 顔ごとディスプレイの傾きに合わせて斜めにする(まっすぐ描いた顔を、画面の四隅へ射影する)
    la = warp_to_screen(la)
    layer = Image.fromarray(la)
    layer = layer.resize((fx1 - fx0, fy1 - fy0), Image.LANCZOS)
    # 画面の外にはみ出さないよう、画面の形で切る
    m = Image.fromarray((screen_mask[fy0:fy1, fx0:fx1] * 255).astype(np.uint8))
    la = np.array(layer)
    inside = (np.array(m) > 0)
    la[..., 3] = (la[..., 3].astype(int) * inside).astype(np.uint8)
    # 目のまわりのにじむ光(画面の中だけ)
    eye_a = la[..., 3].astype(np.float32) / 255 * (la[..., 0] > 200)
    glow = cv2.GaussianBlur(eye_a, (0, 0), 2.6) * 0.75 * inside
    glow_layer = np.zeros_like(la)
    glow_layer[..., :3] = (205, 225, 255)
    glow_layer[..., 3] = np.clip(glow * 255, 0, 255).astype(np.uint8)
    img.alpha_composite(Image.fromarray(glow_layer), (fx0, fy0))
    img.alpha_composite(Image.fromarray(la), (fx0, fy0))


MODE = sys.argv[1] if len(sys.argv) > 1 else "upper"  # upper=上半身(基本) / full=全身
if MODE == "full":
    CROP = body_bbox
    ROBOT_H = 460
    scale = ROBOT_H / (CROP[3] - CROP[1])
    ROBOT_W = round((CROP[2] - CROP[0]) * scale)
    ROBOT_Y = ZONE[3] - 20 - ROBOT_H
else:
    # 上半身:引き出しの取っ手の下あたりで切り、画面の下端に接して置く
    CROP = (body_bbox[0], body_bbox[1], body_bbox[2], 660)
    ROBOT_W = 340
    scale = ROBOT_W / (CROP[2] - CROP[0])
    ROBOT_H = round((CROP[3] - CROP[1]) * scale)
    ROBOT_Y = H - ROBOT_H
ROBOT_X = (ZONE[0] + ZONE[2]) // 2 - ROBOT_W // 2
# ハコブくんの区画は、実際に置いた体の範囲+余白20pxで決める(上半身版は全身版より低い位置から始まる)
ZONE = (0, ROBOT_Y - 20, ROBOT_X + ROBOT_W + 20, H)
cache = {}


def robot(mouth, eyes_closed, ring_on, eye_dy=0.0):
    key = (mouth, eyes_closed, ring_on, eye_dy)
    if key not in cache:
        img = base_body.copy()
        draw_ring(img, ring_on)
        draw_face(img, mouth, eyes_closed, eye_dy)
        img = img.crop(CROP).resize((ROBOT_W, ROBOT_H), Image.LANCZOS)
        img = img.transpose(Image.FLIP_LEFT_RIGHT)  # 右向き(画面の中央を向く)
        cache[key] = img
    return cache[key]


# ---------- 3. 仮の音声 ----------
SCRIPT = [
    # (字幕, 読み上げ用, 後ろの間[秒], 間の顔)
    ("ハコブくんです。", "ハコブくんです。", 0.35, "closed"),
    ("高いGPUを、買う必要はあるのでしょうか。",
     "たかいジーピーユーを、買う必要は、あるのでしょうか。", 0.7, "o"),
    ("エイイチが借りて測ると、\n使ったメモリは約3割でした。",
     "エイイチが借りて測ると、使ったメモリは、約3割でした。", 0.6, "closed"),
]

audio = []
timeline = []  # (開始フレーム, 終了フレーム, 字幕, 間の顔, 発話終了フレーム)
t = 0
for sub, read, gap, gap_face in SCRIPT:
    x, sr = pyopenjtalk.tts(read, speed=1.0, half_tone=-1.0)  # 1.08 → 1.0 に落とした
    assert sr == SR
    x = x / 32768.0
    seg = np.concatenate([x, np.zeros(int(gap * SR))])
    f_start = round(t * FPS)
    f_speech_end = round((t + len(x) / SR) * FPS)
    t += len(seg) / SR
    f_end = round(t * FPS)
    audio.append(seg)
    timeline.append((f_start, f_end, sub, gap_face, f_speech_end))
audio = np.concatenate([np.zeros(int(0.3 * SR)), np.concatenate(audio)])
lead = round(0.3 * FPS)
timeline = [(a + lead, b + lead, s, gf, e + lead) for a, b, s, gf, e in timeline]
total_frames = timeline[-1][1] + round(0.3 * FPS)
audio = np.concatenate([audio, np.zeros(max(0, int(total_frames / FPS * SR) - len(audio)))])
peak = np.abs(audio).max()
audio = audio / peak * 0.8
import wave
with wave.open("narration.wav", "wb") as wf:
    wf.setnchannels(1); wf.setsampwidth(2); wf.setframerate(SR)
    wf.writeframes((audio * 32767).astype(np.int16).tobytes())

# 音量 → 口の4段階(閉じる/小/中/大)
MOUTHS = ["closed", "small", "mid", "large"]
hop = SR // FPS
rms = np.array([np.sqrt(np.mean(audio[i * hop:(i + 1) * hop] ** 2)) if i * hop < len(audio) else 0
                for i in range(total_frames)])
ref = np.percentile(rms[rms > 0.01], 90)
lvl = rms / ref
lvl_s = np.convolve(lvl, np.ones(3) / 3, mode="same")  # 音量を少しならす
target = np.digitize(lvl_s, [0.15, 0.35, 0.65])  # 0..3
# ちらつき防止: 1フレームだけの変化は前に合わせる
for i in range(1, total_frames - 1):
    if target[i] != target[i - 1] and target[i] != target[i + 1]:
        target[i] = target[i - 1]
# 1フレームに1段階ずつしか変えない → 閉じる→大 の間に必ず小・中が入る
step = np.zeros(total_frames, int)
MOUTH_HOLD = 2  # 口は2フレームごと(毎秒15回)にだけ変える
for i in range(total_frames):
    prev = step[i - 1] if i else 0
    if i % MOUTH_HOLD == 0:
        step[i] = prev + int(np.clip(target[i] - prev, -1, 1))
    else:
        step[i] = prev
mouth_seq = [MOUTHS[s] for s in step]
# 間の顔(問いかけのあとは小さく開いた口のまま止める)
for a, b, s, gf, e in timeline:
    for i in range(e + 2, b):
        if gf == "o":
            mouth_seq[i] = "small"
# 目の上下:ゆっくりした揺れ + 口が開くほど少し上がる(元画像の px。0.25px 刻みにまとめる)
tt = np.arange(total_frames) / FPS
rng = np.random.default_rng(7)
starts = [a for a, b, s, gf, e in timeline]
ends = [e for a, b, s, gf, e in timeline]

# ---- 目:ゆっくりした揺れ + 口に少し遅れて上がる + 文の頭で小さく跳ねる ----
lift = np.convolve(step / 3.0, np.ones(11) / 11, mode="same")
lift = np.concatenate([np.zeros(3), lift[:-3]])  # 口より3フレーム(0.1秒)遅れて動く
hop = np.zeros(total_frames)
for a in starts:  # 文の頭:目がぴょこっと上がって戻る(0.3秒)
    n = np.arange(9)
    hop[a:a + 9] += np.sin(np.pi * n / 8)[: len(hop[a:a + 9])]
eye_dy = 1.6 * np.sin(2 * np.pi * tt / 2.8) - 2.6 * lift - 2.0 * hop
eye_dy = np.round(eye_dy * 4) / 4

# ---- まばたき:間隔をばらつかせ、文の終わりの直後にも入れる ----
blink = np.zeros(total_frames, bool)
t_b = 1.2
while t_b * FPS < total_frames:
    blink[int(t_b * FPS):int(t_b * FPS) + 4] = True
    t_b += rng.uniform(2.0, 4.5)
for e in ends:
    if not blink[max(0, e - FPS):e + 8].any():
        blink[e + 4:e + 8] = True

# ---- 側面の光:顔とは別の周期で息をするように明滅し、声には少し遅れて追いかける ----
# 息をするような明滅。強さそのものもゆっくり不規則に変わる
noise = np.convolve(rng.normal(0, 1, total_frames + 90), np.ones(90) / 90, mode="valid")[:total_frames]
noise = (noise - noise.min()) / (noise.max() - noise.min() + 1e-9)  # 0〜1 のゆっくりした揺らぎ
breath = (0.5 + 0.5 * np.sin(2 * np.pi * tt / 3.7 + 1.3)) * (0.4 + 0.9 * noise)  # 目の揺れ(2.8秒)と周期をずらす
talk = (lvl_s > 0.15).astype(float)
env = np.zeros(total_frames)
for i in range(1, total_frames):  # 立ち上がりは速く、消えるのはゆっくり
    k = 0.30 if talk[i] > env[i - 1] else 0.05
    env[i] = env[i - 1] + k * (talk[i] - env[i - 1])
env = np.concatenate([np.zeros(6), env[:-6]])  # 声より0.2秒遅れて光る
gain = np.full(total_frames, 0.5)
for a, b, s_, gf, e in timeline:  # 文ごとに、声への反応の強さを変える(強い文・弱い文が混ざる)
    gain[a:b] = rng.uniform(0.3, 0.75)
gain = np.convolve(gain, np.ones(15) / 15, mode="same")
pulse = np.zeros(total_frames)


def add_pulse(i, amp, tau):
    n = np.arange(min(int(tau * 3), total_frames - i))
    pulse[i:i + len(n)] = np.maximum(pulse[i:i + len(n)], amp * np.exp(-n / tau))


last = -999
for i in range(total_frames):
    # 文の頭と、大きく口を開いた瞬間:顔とそろえて光る。強さは毎回ばらつき、ときどき光らない
    if i in starts:
        add_pulse(i, rng.uniform(0.25, 0.45), 5); last = i
    elif step[i] == 3 and i - last > 15:
        if rng.random() < 0.7:
            add_pulse(i, rng.uniform(0.08, 0.4), rng.uniform(3, 7))
        last = i
# 話していないときも、ときどき弱くまたたく
t_tw = rng.uniform(1.0, 2.5)
while t_tw * FPS < total_frames:
    add_pulse(int(t_tw * FPS), rng.uniform(0.06, 0.18), rng.uniform(4, 9))
    t_tw += rng.uniform(1.5, 4.0)
ring_lv = np.clip(0.10 + 0.2 * breath + gain * env + pulse, 0, 1)
ring_lv = np.round(ring_lv * 20) / 20

if "--dump" in sys.argv:  # 図解用に、時間の値だけを書き出して終わる
    import json
    json.dump({"fps": FPS, "frames": int(total_frames),
               "voice": np.round(np.clip(lvl_s, 0, 1.5), 3).tolist(),
               "mouth": [int(v) for v in step], "eye_dy": eye_dy.tolist(),
               "blink": [int(b) for b in blink], "ring": ring_lv.tolist(),
               "sentences": [[int(a), int(e)] for a, b, s, gf, e in timeline]},
              open("timing.json", "w"))
    print("timing.json に書き出しました")
    sys.exit(0)

# ---------- 4. 画面の文字と図(本番と同じ HTML/CSS で描く) ----------
import json
subprocess.run([sys.executable, "render_static.py", json.dumps([s for a, b, s, gf, e in timeline], ensure_ascii=False)], check=True)
static = Image.open("png/static.png").convert("RGB")
sub_layers = {s: Image.open(f"png/sub_{k}.png").convert("RGBA") for k, (a, b, s, gf, e) in enumerate(timeline)}
boxes = json.load(open("png/boxes.json"))

# ---------- 5. 重なりの自動確認 ----------
def overlap(b1, b2):
    return not (b1[2] <= b2[0] or b2[2] <= b1[0] or b1[3] <= b2[1] or b2[3] <= b1[1])

bad = [(nm, bb) for nm, bb in boxes if overlap(bb, ZONE)]
print("ハコブくんの区画:", ZONE, " 体の位置:", (ROBOT_X, ROBOT_Y, ROBOT_X + ROBOT_W, ROBOT_Y + ROBOT_H))
if bad:
    for nm, bb in bad:
        print("  重なり:", nm, bb)
    sys.exit("区画に重なる要素があるため中止しました")
print(f"重なり確認: 文字・図・ロゴ {len(boxes)} 個、区画との重なり 0 件")

# ---------- 6. 書き出し ----------
cmd = ["ffmpeg", "-v", "error", "-y", "-f", "rawvideo", "-pix_fmt", "rgb24", "-s", f"{W}x{H}",
       "-r", str(FPS), "-i", "-", "-i", "narration.wav", "-c:v", "libx264", "-crf", "20",
       "-pix_fmt", "yuv420p", "-c:a", "aac", "-b:a", "192k", "-shortest", f"hakobu_demo_{MODE}.mp4"]
p = subprocess.Popen(cmd, stdin=subprocess.PIPE)
cur_sub = None
for i in range(total_frames):
    frame = static.copy().convert("RGBA")
    for a, b, s, gf, e in timeline:
        if a <= i < b:
            frame.alpha_composite(sub_layers[s])
    frame.alpha_composite(robot(mouth_seq[i], bool(blink[i]), float(ring_lv[i]), float(eye_dy[i])), (ROBOT_X, ROBOT_Y))
    if i == round(total_frames * 0.42):
        frame.convert("RGB").save(f"hakobu_demo_{MODE}_still.png")
    p.stdin.write(frame.convert("RGB").tobytes())
p.stdin.close(); p.wait()
print("frames", total_frames, "seconds", round(total_frames / FPS, 2))
render_static.py(図と字幕を本番の scenes.py で描き、要素の位置を測る)
"""図と字幕を、本番(_制作ベース の scenes.py / render.py)と同じ HTML/CSS で描く。
ハコブくんを左下に置くために本番から変えた点:
  - 図の範囲(.wrap)は本番と同じ左端 140px のまま。ハコブくんの区画に重なる場面は、書き出し前の自動確認で止める
  - 出典(.src)の左端 140px → 420px
  - 字幕の中央 960px → 1090px、1行の最大幅 1640px → 1380px(1行26字まで)
  - ロゴ(.brand)を右端に寄せる:右 140px → 56px、上 46px → 44px
各要素の位置は getBoundingClientRect で測り、png/boxes.json に書き出す(重なり確認用)。
"""
import sys, os, json, html
# 本番の scenes.py と logo_dark.png を読む。_制作ベース/hakobu_試作/ に置いたときは1つ上の _制作ベース を、
# それ以外の場所では base/ に置いた写しを使う
_here = os.path.dirname(os.path.abspath(__file__))
_parent = os.path.dirname(_here)
sys.path.insert(0, _parent if os.path.exists(os.path.join(_parent, "scenes.py")) else os.path.join(_here, "base"))
import scenes
from playwright.sync_api import sync_playwright

subs = json.loads(sys.argv[1])
os.makedirs("png", exist_ok=True)

HAKOBU_CSS = """
.src{left:420px !important}
.brand{right:56px !important;top:44px !important}
"""
scenes.CSS = scenes.CSS + HAKOBU_CSS

scene = scenes.page("""
<div class="wrap">
 <div class="kicker">π0.5 をシミュレータで動かしたときの GPU メモリ(実使用の最大)</div>
 <div class="hero">9,735<small>MiB</small></div>
 <div class="h2" style="margin-top:36px">起動時に確保された量の <span class="red">約28%</span></div>
</div>
<div class="src">出典:Pixels to Motors 実測(GPU:NVIDIA A40、π0.5-LIBERO)</div>""",
    tag="<b>2</b>買う前に借りて測る")

SUBCSS = """*{margin:0;padding:0}html,body{width:1920px;height:1080px;background:transparent}
svg{position:absolute;left:0;top:0}
.t{font-family:'Noto Sans CJK JP',sans-serif;font-size:52px;font-weight:800;fill:#fff;stroke:#0D0D0D;stroke-width:11px;stroke-linejoin:round;stroke-linecap:round;paint-order:stroke fill}"""
SUB_CX, SUB_MAXW = 1090, 1380

MEASURE = """() => [...document.querySelectorAll('.tag,.brand,.kicker,.hero,.h1,.h2,.h3,.src,.wrap *')]
  .filter(e => e.getBoundingClientRect().width > 0)
  .map(e => { const r = e.getBoundingClientRect();
              return [e.className || e.tagName, [r.left, r.top, r.right, r.bottom]]; })"""

boxes = []
with sync_playwright() as p:
    b = p.chromium.launch()
    pg = b.new_page(viewport={"width": 1920, "height": 1080})
    pg.set_content(scene)
    pg.wait_for_timeout(100)
    pg.screenshot(path="png/static.png")
    boxes += [[f"図:{n}", r] for n, r in pg.evaluate(MEASURE)]
    for k, s in enumerate(subs):
        lines = s.split("\n")
        assert all(len(ln) <= 26 for ln in lines), s
        svg_lines = "".join(f'<text x="{SUB_CX}" text-anchor="middle" class="t">{html.escape(ln)}</text>' for ln in lines)
        pg.set_content(f"""<!doctype html><html><head><meta charset="utf-8"><style>{SUBCSS}</style></head><body>
<svg id="s" width="1920" height="1080" viewBox="0 0 1920 1080">{svg_lines}</svg></body></html>""")
        rects = pg.evaluate(f"""() => {{
          const ts=[...document.querySelectorAll('text.t')]; const lh=72; const n=ts.length;
          let fs=52; for (const t of ts){{ const w=t.getComputedTextLength(); if (w>{SUB_MAXW}) fs=Math.min(fs, Math.floor(52*{SUB_MAXW}/w)); }}
          ts.forEach((t,k)=>{{ t.style.fontSize=fs+'px'; t.setAttribute('y', 1080-62-(n-1-k)*lh); }});
          return ts.map(t => {{ const r=t.getBoundingClientRect(); return [r.left-6, r.top-6, r.right+6, r.bottom+6]; }});
        }}""")
        boxes += [[f"字幕{k}-{j}", r] for j, r in enumerate(rects)]
        pg.screenshot(path=f"png/sub_{k}.png", omit_background=True)
    b.close()
json.dump(boxes, open("png/boxes.json", "w"), ensure_ascii=False)
edit_rules.py(video_rules.md に書き足したスクリプト)
ルールの文書は、文章を打ち直すと途中が抜けることがあるので、置き換える文が文書の中にちょうど1か所あることを確かめてから置き換えるスクリプトで書き足しました。このスクリプトを動かしたあと、試作のフォルダの説明の1行だけを、次の sed で置き換えています。
"""video_rules.md にハコブくんのナレーションで決めたことを書き足す(置換は1か所ずつ一致を確かめる)"""
import sys

src, dst = sys.argv[1], sys.argv[2]
s = open(src, encoding="utf-8").read()


def rep(old, new):
    global s
    assert s.count(old) == 1, f"一致が1か所ではない: {old[:40]}"
    s = s.replace(old, new)


# --- 冒頭 ---
rep("最終更新: 2026-10-11\n状態: 試作1本目「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」を作りながら決めたことをまとめた初版。まだ決まっていない項目は8節にまとめている。",
    "最終更新: 2026-10-12\n状態: 試作1本目「ロボットにもChatGPTの瞬間はもう来たのか(フィジカルAIの現在地)」を作りながら決めたことをまとめた初版に、ナレーションをハコブくんにする決定(2026-10-12)を足した版。まだ決まっていない項目は8節にまとめている。")

# --- 1節 ---
rep("| 1 | 自己紹介 | 〜0:55 | ロゴのテロップを出し、毎回同じ文言で名乗る(2節の文言) |",
    "| 1 | 自己紹介 | 〜0:55 | ロゴと、エイイチの名前のテロップを出す。ハコブくんが毎回同じ文言で番組とエイイチを紹介する(2節の文言) |")
rep("| 8 | 見立て | 〜12:30 | 「ここからが僕の一番言いたいことです」と言ってから意見を話す |",
    "| 8 | 見立て | 〜12:30 | 「ここからはエイイチの見立てです」と言ってから意見を話す(意見が誰のものかをはっきりさせる) |")
rep("| 自分の立ち位置を明かす | 3 結論と立場、または本編1節の頭 | 「僕自身、仕事で使っていて、今回は得をする側なんです」「僕は〜否定派じゃないです。技術としては本物」 |",
    "| 自分の立ち位置を明かす | 3 結論と立場、または本編1節の頭 | 「僕自身、仕事で使っていて、今回は得をする側なんです」「僕は〜否定派じゃないです。技術としては本物」。このチャンネルではハコブくんが話すので「エイイチ自身、〜」と言い換える |")
rep("数字の言い方は5本とも同じだった。",
    "台本はすべてハコブくんが話す前提で書く。エイイチの体験と意見は「エイイチは」「エイイチの机の上では」と三人称で言う。\n\n数字の言い方は5本とも同じだった。")

# --- 2節 ---
rep("「僕の機体とソフトの組み合わせでは」を付ける。", "「エイイチの機体とソフトの組み合わせでは」を付ける。")
rep("「配送開始を示す公式発表は、僕が確認した範囲では見つかっていません」",
    "「配送開始を示す公式発表は、エイイチが確認した範囲では見つかっていません」")
rep("自己紹介の文言は「僕は本業のデザイナーをしながら、ロボティクスの研究と開発をしています。自宅の机の上でロボットアームを動かして、その記録を公開しています。」に固定する。「秋田」「29年」「毎日」は入れない。",
    "自己紹介の文言は、ハコブくんが話す形の「この番組は、本業のデザイナーをしながらロボティクスの研究と開発をしているエイイチが、自宅の机の上でロボットアームを動かした記録をもとにしています。」に固定する(2026-10-12 に、それまでの一人称の文言を言い換えた。文言を変えるときはエイイチが決める)。「秋田」「29年」「毎日」は入れない。")

# --- 3節 ---
rep("""## 3. ナレーション(現状は仮音声)

いまは仮の合成音声で作っている。本番の声は未決(8節)。

- **エンジン:** Open JTalk、声は nitech_jp_atr503_m001(男声)。設定は 速さ 1.08、音の高さ -1、声質 0.55""",
"""## 3. ナレーション(ハコブくん・声は仮音声)

### 3-1. ナレーションはハコブくんが話す(2026-10-12 決定)

- ナレーションは、Pixels to Motors のキャラクターのハコブくん(病院で物を運ぶロボット)が担当する。エイイチ本人の声と、本人の声の複製は使わない(本人の声が通らないため。複製しても声の性質はそのまま写る)
- 動画の目的は、見た人から仕事の相談や声がけをもらうこと。キャラクターの後ろで本人が見えなくならないよう、次の3つを必ず入れる
  - 自己紹介の場面で、エイイチの名前のテロップと実機の映像を出す
  - 見立ての節は「ここからはエイイチの見立てです」と言ってから入る
  - 概要欄にプロフィールと連絡先を置く
- 概要欄に「ナレーションは AI 音声です」と書く
- 声は、他のチャンネルと同じ声(VOICEVOX のキャラクターの声など)を使わず、ハコブくん専用の声にする。「ハコブくん=有名キャラクターの声のロボット」と聞かれないようにするため。候補は8節
- 高すぎない声で、ゆっくり丁寧に話す。経営者が13分聞いて疲れないことを基準にする。キャラクターらしい決まった語尾は本編で使わない(使うならジングルと最初の一言だけ)

### 3-2. 仮音声の設定(ハコブくんの声が決まるまで)

- **エンジン:** Open JTalk、声は nitech_jp_atr503_m001(男声)。設定は 速さ 1.0(2026-10-12 に 1.08 から下げた。ハコブくんの口の動きと合わせると速すぎたため)、音の高さ -1、声質 0.55""")

# --- 4-1 ---
rep("""- 余白は左右140px。下の250pxは字幕のために空ける
- 左上に章のタグ(章番号はオレンジ、見出しは薄い文字)、右上にロゴ(高さ34px)""",
"""- 余白は左右140px。下の250pxは字幕のために空ける
- 左上に章のタグ(章番号はオレンジ、見出しは薄い文字。左端から140px)、右上にロゴ(高さ34px。右端から56px、上端から44px。2026-10-12 に右140px・上46pxから端へ寄せた)
- **ハコブくんの区画:** 左下に、ハコブくんの上半身を右向きで置く(全身より図の邪魔にならないため、上半身を基本にする)。体は幅340pxで x=20〜360px、画面の下端に接して置く(上端は y=766px)。区画は体の範囲に余白20pxを足した x=0〜380px、y=746〜1080px。この区画には字幕・図・出典・テロップを重ねない。体の画像を差し替えたら、区画は置いた体の範囲から計算し直す(スクリプトが自動で計算する)
- **図の範囲:** 左右140pxのまま使う。ハコブくんの区画に重なるかどうかは、場面ごとに書き出しの前に自動で確かめる。図・文字の位置はブラウザで描いたときの実際の位置を測り、区画と1pxでも重なった場面は、場面の名前を出して書き出しを止める。止まった場面は、図を区画より上に収めるか、左端を420pxに寄せて作り直す""")

# --- 4-2 ---
rep("- 新しい色を足すときは、色覚の違いがあっても見分けられるかを検証してから使う(dataviz スキルの validate_palette.js。背景色 #F5F5F0 を指定する)",
    "- 新しい色を足すときは、色覚の違いがあっても見分けられるかを検証してから使う(dataviz スキルの validate_palette.js。背景色 #F5F5F0 を指定する)\n- ハコブくんの体と顔の色(目の白 #F6F8FC、口の水色 #57B5F8、側面のリングの緑)は、この表と4-5の「オレンジと青以外の色を足さない」の対象外。図や文字には使わない")

# --- 4-5 ---
rep("- 影、グラデーション\n", "- 影、グラデーション(ハコブくんにも影は付けない。目のまわりのにじむ光と側面のリングの光は、ハコブくん自身が光っている表現なので例外)\n")

# --- 4-6 と 4-7 ---
rep("数字を出す画面には、左下(字幕の上)に出典を24pxの薄い文字で必ず入れる。",
    "数字を出す画面には、字幕の上に出典を24pxの薄い文字で必ず入れる。位置は左端から420px(左下のハコブくんの区画を避ける。もとは140px)。")
rep("""模式図には「図は模式図」と入れる。

---""", """模式図には「図は模式図」と入れる。

### 4-7. ハコブくんの描き方と動き

試作(2026-10-12、`_制作ベース/hakobu_試作/`)で決めた作り方。数値はスクリプトの先頭近くにまとめてある。

**体**
- 元の動画(ハコブくんが病室にいる生成動画)の1コマから体を切り抜き、左右反転して右向きにする(画面の中央を向く)
- 頭の上は、後ろの白い枕と重なっていて切り抜きが欠ける。元の動画では、頭の上は「画面の上の縁が低く、奥側がもう一段持ち上がった」形をしている。切り抜きがはっきり頭と判断した範囲を輪郭に使い、縁のギザギザだけをなめらかにする。色は元のコマの画素で戻す(欠けた部分を直線や凸包で埋めると、奥の段差が消えて枕まで頭として塗ってしまう)
- 側面の緑のリングは、元の絵の画素が粗いので一度消し、楕円をコードで描き直す

**顔(すべてコードで描く)**
- 目: 白(#F6F8FC)の縦長のカプセル形(上下の端が半円)。まわりに白い光が少しにじむ。光は画面の外に出さない
- 口: 水色(#57B5F8)。閉じた口(両端が丸い太い弧)・小(上が広く下が丸い形)・中・大(角の丸い三日月形)の4段階
- 顔は、ディスプレイの四隅に合わせて射影し、ディスプレイと同じ傾きで描く。四隅は、上下左右の辺のまっすぐな部分にそれぞれ直線を当てはめた交点で決める(角が丸いので、角の点を直接取ると傾きを読み違える)
- 本番では、体だけを先に反転し、顔は向きどおりに描く(試作は顔を描いてから体ごと反転している。左右で形が違う表情が逆になるため)

**動き**
- 口: ナレーションの音量で4段階を選ぶ。口の形は2フレームごと(毎秒15回)に、1段階ずつしか変えない。閉じた口と大きい口の間に、必ず小と中がはさまる
- 目: 2.8秒の周期でゆっくり上下する。口が開くと0.1秒遅れて少し上がる。文の頭で、0.3秒だけ小さく跳ねる
- まばたき: 2〜4.5秒の間でばらつかせる。文を言い終わった直後にも1回入れる
- 側面のリング: 顔とは別の3.7秒の周期で、息をするように明滅する(明滅の強さもゆっくり不規則に変える)。声には0.2秒遅れて明るくなり、話し終わるとゆっくり暗くなる。声への反応の強さは文ごとに変える。文の頭と、大きく口を開いた瞬間だけは顔とそろえて強く光る(大きく口を開いたときは、3回に1回ほど光らない)。話していない間も、ときどき弱くまたたく

**表情**
- 1文ごとに、台本で表情を指定する(narration.py の1文の行に「表情」の欄を足す)
- 目と頬は表情で決める。口は、話している間はどの表情でも音量で動かし、話していない間だけその表情の口に戻す(「_」の口のまま話すと、声と口が合わなくなるため)
- 使い分けの目安(1本作って確定する。8節)

| 表情 | 使う場面 |
|---|---|
| 丸い目+開いた口 | 基本。説明の文はほぼこれ |
| 丸い目+小さな笑み | 間、聞き手に戻るところ |
| 驚いた目+「o」の口 | 今日の問い、意外な数字が出るところ |
| ジト目 | 「本当にそうでしょうか」と反論を出すところ |
| 目を閉じる | 「まとめると」、考えている間 |
| 困り眉 | 失敗や限界の話 |
| >▽< | 結論が言えたところ、うまくいった実験 |
| 「III_III」 | 計算中・データを読み込んでいる場面 |
| ウインク、キラキラ目、照れ、>_<、目が泳ぐ | アウトロや軽い一言だけ |

経営者向けの動画なので、1本で使う表情は上の6つ前後にとどめる。

---""")

# --- 5節 ---
rep("- 2行まで、1行31字以内。改行は読点の位置で入れる。読点がなければ助詞の後ろで割る\n- 位置は画面の下から62px",
    "- 2行まで、1行26字以内(ハコブくんの区画を避けるため。もとは31字)。改行は読点の位置で入れる。読点がなければ助詞の後ろで割る\n- 位置は画面の下から62px。横はハコブくんの区画の右側(x=400〜1780px)の中央(x=1090px)にそろえ、1行の幅は1380pxまで")

# --- 6節 ---
rep("- 映像は 1920×1080 に拡大して切り抜く。字幕の後ろに黒50%の帯(高さ230px)を敷く",
    "- 映像は 1920×1080 に拡大して切り抜く。字幕の後ろに黒50%の帯(高さ230px)を敷く。帯はハコブくんの区画の右(x=380px から右)だけに敷く")
rep("- 名前のテロップ: 薄い地に、ロゴ(高さ30px)・名前60px・肩書き30px(「デザイナー/ロボティクスの研究・開発」)。左の太い線は付けない",
    "- 名前のテロップ: 薄い地に、ロゴ(高さ30px)・名前60px・肩書き30px(「デザイナー/ロボティクスの研究・開発」)。左の太い線は付けない。ハコブくんの区画の外に置く")

# --- 7節 ---
rep("""  5. `assemble.py` で1文ずつ映像を作ってつなぎ、音声と合わせる(字幕の srt も出る)
  6. 確認用に圧縮する""",
"""  5. `assemble.py` で1文ずつ映像を作ってつなぎ、音声と合わせる(字幕の srt も出る)
  6. 確認用に圧縮する
- **ハコブくんの試作(`_制作ベース/hakobu_試作/`):** `python3 make_demo.py upper`(全身版は `full`)で、体の切り抜き・顔の描画・口と目とリングの動き・区画との重なり確認・書き出しまでを行う。図と字幕は `render_static.py` が本番の `scenes.py` を読み込んで描く(`base/` に scenes.py と logo_dark.png の写しを置く)。本番の render.py・assemble.py への組み込みはまだ(8節)""")

# --- 8節 ---
rep("| ナレーションの声 | Open JTalk の仮音声。抑揚が機械的 | 本人の声で録るか、品質の高い音声合成(VOICEVOX など。利用規約とクレジット表記の条件を確認)にするか。srt に1文ごとの時間が入っているので、それに合わせて録れば映像はそのまま使える |",
    "| ハコブくんの声 | ナレーションはハコブくんに決定(3-1)。声は Open JTalk の仮音声 | ハコブくん専用の声を、ElevenLabs の Voice Design(文章で声の特徴を書くと新しい声を作る機能。日本語の出来と、作った声を商用で使う条件は試して確かめる)で作るか、声優に依頼して作るか(毎回読んでもらうか、本人の同意を取って声を複製する。声の権利が一番はっきりする) |\n| ハコブくんの体の画像 | 生成動画の1コマを切り抜き、頭の上とリングを修整して使っている | 同じ構図(斜め・右向き)で、無地の背景・リングなしの画像を生成し直すか。生成し直せば頭とリングの修整が要らなくなる |\n| ハコブくんの本番組み込み | 試作(`hakobu_試作/`)で動きと配置を確認した段階 | render.py・assemble.py に組み込む。narration.py に「表情」の欄を足す。表情集の顔をコードで描く |\n| 表情の使い分け | 4-7の目安の表のみ | 1本作って、使う表情と場面を確定する |")
rep("| ジングル | 文言だけ(「Pixels to Motors。こんにちは、エイイチです。」) | 音とロゴの動きを付けるか |",
    "| ジングル | 文言だけ(「Pixels to Motors。こんにちは、エイイチです。」) | ハコブくんが話す形の文言に言い換える。音とロゴの動きを付けるか |")

# --- 更新履歴 ---
rep("## 更新履歴\n\n",
    "## 更新履歴\n\n- 2026-10-12: ナレーションをハコブくんにする決定を反映。3-1(ハコブくんが話す・本人を見せる3つの決まり・AI音声の明記・専用の声)と4-7(ハコブくんの描き方と動き・表情)を新設。4-1 にハコブくんの区画(左下・上半身・右向き)と、図の範囲を140pxのまま場面ごとの自動の重なり確認に任せる決まりを追加。ロゴを右56px・上44pxへ寄せた。字幕を1行26字・中央x=1090pxへ、出典を左420pxへ移した。ハコブくんの色を4-2・4-5の対象外にした。台本の一人称(僕)をエイイチの三人称に言い換え、自己紹介の固定文言をハコブくんが話す形にした。仮音声の速さを1.08から1.0に下げた。8節にハコブくんの声・体の画像・本番組み込み・表情の使い分けを追加。\n")

open(dst, "w", encoding="utf-8").write(s)
print("ok", len(s))
sed -i 's#図と字幕は `render_static.py` が本番の `scenes.py` を読み込んで描く(`base/` に scenes.py と logo_dark.png の写しを置く)。#図と字幕は `render_static.py` が本番の `scenes.py` と `logo_dark.png`(1つ上の `_制作ベース` にあるもの)を読み込んで描く。入力の画像(`cut_raw.png`・`full/g_05.png`)も同じフォルダに置いてある。#' rules/video_rules.md実行ログ
元の生成動画の情報(ffprobe)
stream|codec_type=video|width=848|height=1056|r_frame_rate=24/1
stream|codec_type=audio|r_frame_rate=0/0
stream|codec_type=video|width=848|height=1056|r_frame_rate=90000/1
format|duration=10.041667
ディスプレイ・目・口・リングの測定(measure_face.py)
ディスプレイの外接矩形 (x, y, 幅, 高さ): [325, 349, 183, 151]
白の領域: x=482 y=344 幅=29 高さ=52 面積=172
白の領域: x=362 y=395 幅=22 高さ=46 面積=799
白の領域: x=305 y=396 幅=170 高さ=124 面積=2301
白の領域: x=446 y=396 幅=23 高さ=48 面積=885
水色の領域: x=378 y=450 幅=68 高さ=40 面積=2115
口の色(中央値 RGB): [87, 181, 248]
リングの範囲: 576 548 629 681 画素数 1793
体の範囲: 291 328 648 904
頭の上の行ごとの画素数(アルファ>200 / >60 / >10):
  y=320: 0 / 0 / 0
  y=324: 0 / 0 / 36
  y=328: 0 / 42 / 151
  y=332: 33 / 77 / 183
  y=336: 56 / 95 / 212
  y=340: 70 / 167 / 232
  y=344: 198 / 237 / 249
  y=348: 240 / 250 / 261
  y=352: 251 / 257 / 264
  y=356: 258 / 264 / 270
上の辺: 点 74 個、傾き 0.18°
下の辺: 点 74 個、傾き 2.16°
左の辺: 点 60 個、傾き 5.97°
右の辺: 点 61 個、傾き 5.67°
ディスプレイの四隅(左上・右上・右下・左下): [[336.8, 348.8], [510.2, 349.3], [495.1, 501.2], [321.5, 494.6]]
参考・角の点を直接取った四隅(eps=9.0): [[504, 360], [488, 496], [327, 485], [346, 354]]
上半身版の書き出し(python3 make_demo.py upper)
ハコブくんの区画: (0, 746, 380, 1080)  体の位置: (20, 766, 360, 1080)
重なり確認: 文字・図・ロゴ 12 個、区画との重なり 0 件
frames 398 seconds 13.27
終了コード: 0
全身版の書き出しが、重なりの確認で止まった記録(python3 make_demo.py full)
ハコブくんの区画: (0, 580, 353, 1080)  体の位置: (47, 600, 333, 1060)
  重なり: 図:h2 [140, 589.40625, 1780, 672.59375]
区画に重なる要素があるため中止しました
終了コード: 1
書き出した上半身版の動画の情報(ffprobe)
stream|codec_name=h264|width=1920|height=1080|r_frame_rate=30/1
stream|codec_name=aac|sample_rate=48000|r_frame_rate=0/0
format|duration=13.266667|size=530991
図解用に時間の値を書き出した記録(python3 make_demo.py upper --dump)
timing.json に書き出しました
フレーム数 398 / 文ごとの開始と発話終了のフレーム [[9, 51], [62, 195], [216, 371]] / リングの明るさの範囲 0.15 〜 1.0 / まばたきのフレーム数 24