

フィジカルAI研究室を作る Log#2 | Physical Intelligenceπ0.5を借りたGPUで動かし、Macから指示を届けるまで
Log#1 では、Physical AI が学習できる環境を自宅にゼロから作り、誰でも同じ環境を作り直せる形で公開すると決めました。この回は、その環境で初めてロボット用の AI モデルを実際に動かした記録です。
動かしたのは、米国の Physical Intelligence 社が公開している π0.5(パイ・ゼロ・ゴ)です。カメラの画像と「フォークを持ち上げて」のような言葉の指示を受け取り、ロボットアームの次の動きを数値で返すモデルです。このモデルは NVIDIA の GPU を積んだ Linux マシンでしか動かないため、手元の Mac では動かせません。そこで、クラウドの GPU マシン(Runpod の NVIDIA A40)を時間単位で借りて π0.5 を起動し、Mac から画像と指示を送って、π0.5 が返す動きの数値を受け取るところまでを通しました。
結果は、π0.5 そのものの計算が1回あたり平均97ms、Mac から送って結果が返ってくるまでの往復が平均391msでした。借りていた時間は約35分で、費用は0.34ドルです。
公式の手順どおりに進めると、2箇所で止まりました。1つは、公式のテスト用プログラムが表示用ライブラリの読み込みを1行書き忘れていて、最後の結果表示で落ちること。もう1つは、π0.5 の最初の1回の計算に時間がかかる間に、Mac 側のプログラムが「相手が応答しない」と判断して接続を切ってしまうことです。どちらも1行の修正で直りました。この記事では、その2箇所を含めて、つまずいた箇所と実行ログをすべて残します。
なお、この回で π0.5 に送った画像はランダムな色の点の集まりです。返ってきた動きの数値にロボットとしての意味はありません。測れたのは、計算にかかる時間と、Mac からクラウドの GPU まで指示が届いて返ってくる仕組みが通しで動くことの2つです。
π0.5 は Physical Intelligence が公開しているロボット用の基盤モデル
Physical Intelligence は2024年に設立された、サンフランシスコのスタートアップです。特定のロボットや特定の作業に限らず、どのロボットにも載せられる汎用の「脳」にあたる AI モデルを作ることを目標にしています。
この会社のモデルは VLA(Vision Language Action)と呼ばれる種類です。カメラの画像(Vision)と言葉の指示(Language)を受け取り、ロボットの関節をどう動かすか(Action)を出力します。2024年10月に最初の π0、2025年4月に π0.5、2025年11月に強化学習で成功率を上げた π*0.6、2026年4月に、教えていない作業でも言葉で指示すればこなせることを示した π0.7 を発表しています。
このうち、重みとコードが公開されているのは π0・π0-FAST・π0.5 の3つです。GitHub の openpi というリポジトリにまとまっていて、ライセンスは Apache-2.0 です(π0.5 の内部で Google の Gemma という言語モデルを使っているため、Gemma のライセンスファイルも同梱されています)。π*0.6 と π0.7 は公開されていません。
openpi で手に入るモデルは2種類あります。1つは、1万時間以上のロボットのデータで学習した「ベースモデル」で、自分のロボットのデータで追加学習(微調整)するときの出発点になります。もう1つは、特定のロボット向けにすでに追加学習を済ませたモデルです。この回で使ったのは後者の π0.5-DROID で、DROID という公開データセット(Franka 社の7軸アームで集めた卓上作業のデータ)で追加学習されています。
公式の README も、π0 はもともと自社のロボット向けに作ったもので、他のロボットで同じように動くとは限らないと書いています。どのロボットに挿しても動く脳ではなく、自分の機体で使うには、自分でデータを集めて追加学習することが前提です。
openpi は NVIDIA GPU と Ubuntu 22.04 が前提で、Mac では推論できない
openpi の README には、動かすのに必要な GPU が書かれています。
用途 | 必要な GPU メモリ | README が挙げる GPU の例 |
|---|---|---|
推論(学習済みモデルに動きを出させる) | 8GB 以上 | RTX 4090 |
微調整(LoRA:モデルの一部だけを学習し直す方法) | 22.5GB 以上 | RTX 4090 |
微調整(全体を学習し直す) | 70GB 以上 | A100(80GB)/ H100 |
動作確認は Ubuntu 22.04 でだけ行われていて、他の OS はサポートしていないと書かれています。Mac には NVIDIA の GPU がないので、コードを手元に置いて読むことはできても、π0.5 に計算をさせることはできません。
一方で、π0.5 に画像を送って結果を受け取る側のプログラム(openpi-client)は、GPU を使わない小さなパッケージとして分かれています。必要なのは numpy・msgpack・websockets など5つのライブラリだけです。ここに目を付けて、計算はクラウドの GPU、指示を出すのは Mac、という分け方にしました。
Mac への git clone は SSH 鍵がなくて止まり、HTTPS で通った
最初に、README の手順どおりに Mac で openpi を取得しようとしました。README の clone コマンドは git@github.com: で始まる形式で、これは GitHub に SSH 鍵を登録している人向けの書き方です。この時点の Mac には SSH 鍵がなかったので、取得の段階で止まり、後に続くコマンドもすべて失敗しました。
実行したコマンドと出力です。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-content % git clone --recurse-submodules git@github.com:Physical-Intelligence/openpi.git
cd openpi
GIT_LFS_SKIP_SMUDGE=1 uv sync
GIT_LFS_SKIP_SMUDGE=1 uv pip install -e .
Cloning into 'openpi'...
git@github.com: Permission denied (publickey).
fatal: Could not read from remote repository.

Please make sure you have the correct access rights
and the repository exists.
cd: no such file or directory: openpi
error: No `pyproject.toml` found in current directory or any parent directory
error: No virtual environment found; run `uv venv` to create an environment, or pass `--system` to install into a non-virtual environment
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-content %
https:// で始まる形式に変えると、鍵がなくても取得できます。サブモジュール(openpi が中で使っている別のリポジトリ。ALOHA と LIBERO の2つ)も一緒に取得されました。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-content % git clone --recurse-submodules https://github.com/Physical-Intelligence/openpi.git
cd openpi
Cloning into 'openpi'...
remote: Enumerating objects: 1667, done.
remote: Total 1667 (delta 0), reused 0 (delta 0), pack-reused 1667 (from 1)
Receiving objects: 100% (1667/1667), 24.71 MiB | 3.49 MiB/s, done.
Resolving deltas: 100% (882/882), done.
Submodule 'third_party/aloha' (https://github.com/Physical-Intelligence/aloha.git) registered for path 'third_party/aloha'
Submodule 'third_party/libero' (https://github.com/Lifelong-Robot-Learning/LIBERO.git) registered for path 'third_party/libero'
Cloning into '/Users/shimazueiichi/r2r2r-content/openpi/third_party/aloha'...
remote: Enumerating objects: 259, done.
remote: Counting objects: 100% (91/91), done.
remote: Compressing objects: 100% (67/67), done.
remote: Total 259 (delta 43), reused 55 (delta 20), pack-reused 168 (from 1)
Receiving objects: 100% (259/259), 42.74 MiB | 3.28 MiB/s, done.
Resolving deltas: 100% (120/120), done.
Cloning into '/Users/shimazueiichi/r2r2r-content/openpi/third_party/libero'...
remote: Enumerating objects: 1788, done.
remote: Total 1788 (delta 0), reused 0 (delta 0), pack-reused 1788 (from 1)
Receiving objects: 100% (1788/1788), 316.00 MiB | 3.40 MiB/s, done.
Resolving deltas: 100% (746/746), done.
Submodule path 'third_party/aloha': checked out 'd1dc83afd89ded4379851257fe5d85632d31d5ec'
Submodule path 'third_party/libero': checked out 'f78abd68ee283de9f9be3c8f7e2a9ad60246e95c'
(base) shimazueiichi@shimadzueiichinoMacBook-Pro openpi %
Mac 側では、この後の uv sync(GPU 用のライブラリ一式のインストール)は実行していません。Mac に入れるのは、後で出てくる openpi-client だけです。
推論はクラウドの GPU、指示を出すのは Mac、という分担にした
openpi には、π0.5 を「ポリシーサーバー」として起動する仕組みがあります。サーバーは GPU マシンの上で π0.5 を読み込み、ポート8000番で待ち受けます。ロボット側のプログラムは、カメラの画像・関節の角度・言葉の指示をひとまとめにしてサーバーへ送り、サーバーは π0.5 が出した動きの数値を返します。この通信には WebSocket(一度つないだら切らずに、何度でもやり取りできる通信方式)を使っています。
README はこの分け方を「リモート推論」と呼んでいて、利点として、ロボットから離れた場所の強い GPU を使えることと、ロボット側の環境と π0.5 側の環境を分けておけることを挙げています。
この回の構成は次のとおりです。
[Runpod の GPU マシン(A40)]  π0.5-DROID を読み込んだサーバー(ポート8000)
        ↑↓  SSH トンネル(Mac の localhost:8000 を、GPU マシンの localhost:8000 につなぐ)
[Mac]  openpi-client のテスト用プログラム(GPU 不要)
SSH トンネルは、SSH の接続の中に別の通信を通す機能です。こうすると、GPU マシンのポート8000番をインターネットに公開しなくても、Mac から localhost:8000 に送るだけでサーバーに届きます。
テスト用プログラムは openpi に入っている examples/simple_client/main.py です。ロボットの代わりに、ランダムな値で作った画像(224×224ピクセル、2枚)・関節角度7つ・グリッパーの開き具合1つと、do something という指示文をサーバーに送り、1回ごとの時間を測って最後に表にします。
Claude の作業環境で、モデル抜きのダミーサーバーに Mac 側のプログラムを先につないだ
クラウドの GPU を借りる前に、Mac 側の手順に問題がないかを確かめておくことにしました。お金がかかるのは GPU マシンを借りている時間なので、GPU がなくても確かめられることは先に済ませておきたかったからです。
確認には Claude の作業環境(Anthropic のクラウド上の Linux)を使いました。この環境にも GPU はなく、π0.5 の重みの配布元にも接続できませんでした。確認したときの出力です。
$ nvidia-smi 2>&1 | head -5; echo "---"; nproc; free -g | head -2; df -h . | tail -1; echo "---"; uname -a; cat /etc/os-release | head -2; echo "---"; which uv; curl -sS -m 10 -o /dev/null -w "%{http_code}\n" https://storage.googleapis.com/openpi-assets/ 2>&1; curl -sS -m 10 -o /dev/null -w "%{http_code}\n" https://github.com 2>&1
/bin/bash: line 1: nvidia-smi: command not found
---
2
               total        used        free      shared  buff/cache   available
Mem:               7           0           7           0           0           7
/dev/vda        252G   14G   31G  31% /
---
Linux vm 6.18.44-fc-v114 #1 SMP PREEMPT_DYNAMIC @0 x86_64 x86_64 x86_64 GNU/Linux
PRETTY_NAME="Ubuntu 24.04.5 LTS"
NAME="Ubuntu"
---
/root/.local/bin/uv
curl: (56) CONNECT tunnel failed, response 403
000
400
そこで、openpi の本物のサーバーのコード(src/openpi/serving/websocket_policy_server.py)はそのまま使い、π0.5 の代わりに「ランダムな動き(15ステップ×8つの値)を返すだけのダミー」を入れたサーバーを作りました。通信の手順は本物と同じなので、Mac 側のプログラムがサーバーとやり取りできるかは、π0.5 なしで確かめられます。
ダミーサーバーの全文です。
# Dummy policy server: same websocket server code as openpi, but no model (returns random actions).
import importlib.util, logging, sys, numpy as np
spec = importlib.util.spec_from_file_location("wps", sys.argv[1])
wps = importlib.util.module_from_spec(spec); spec.loader.exec_module(wps)
class DummyPolicy:
    def infer(self, obs):
        return {"actions": np.random.rand(15, 8).astype(np.float32)}
logging.basicConfig(level=logging.INFO)
wps.WebsocketPolicyServer(DummyPolicy(), port=8000, metadata={"note": "dummy"}).serve_forever()
Mac 側と同じ準備(Python 3.11 の仮想環境を作り、openpi-client とテスト用プログラムに必要なライブラリを入れる)をしてから、ダミーサーバーを起動し、公式のテスト用プログラムをそのまま実行しました。
$ python examples/simple_client/main.py --env DROID --host localhost --num-steps 10
INFO:root:Waiting for server at ws://localhost:8000...
INFO:__main__:Server metadata: {'note': 'dummy'}

Running policy:   0%|          | 0/10 [00:00<?, ?it/s]
Running policy: 100%|██████████| 10/10 [00:00<00:00, 659.90it/s]
Traceback (most recent call last):
  File "/tmp/claude-0/-home-claude/f01fcaf8-f860-5484-a2cb-c21daac823a9/scratchpad/openpi/examples/simple_client/main.py", line 187, in <module>
    main(tyro.cli(Args))
  File "/tmp/claude-0/-home-claude/f01fcaf8-f860-5484-a2cb-c21daac823a9/scratchpad/openpi/examples/simple_client/main.py", line 147, in main
    timing_recorder.print_all_stats()
  File "/tmp/claude-0/-home-claude/f01fcaf8-f860-5484-a2cb-c21daac823a9/scratchpad/openpi/examples/simple_client/main.py", line 73, in print_all_stats
    table = rich.table.Table(
            ^^^^^^^^^^
AttributeError: module 'rich' has no attribute 'table'
接続、10回分の送受信、時間の記録までは動きました。ところが、最後に結果の表を出すところで AttributeError: module 'rich' has no attribute 'table' が出て止まりました。
修正1:公式のテスト用プログラム main.py は rich.table を読み込んでいない
main.py は、結果の表を rich という表示用ライブラリで描いています。コードの中では rich.table.Table(...) と rich.console.Console(...) を使っていますが、ファイルの冒頭では import rich しか書かれていません。
Python では、import rich だけでは rich.table や rich.console という中の部品は読み込まれません。他のどこかで先に読み込まれていればたまたま動きますが、このとき入った rich(15.0.0)ではそうならず、表を描く直前で落ちました。
直し方は、冒頭に2行足すことです。次のコマンドで、import rich の行のすぐ後に2行を追加します。
perl -pi -e 's/^import rich$/import rich\nimport rich.console\nimport rich.table/' examples/simple_client/main.py修正前と修正後の差分です。
10a11,12
> import rich.console
> import rich.table
修正したテスト用プログラムをダミーサーバーに対して実行すると、表まで出ました。
$ python mock/main_fixed.py --env DROID --host localhost --num-steps 10
INFO:root:Waiting for server at ws://localhost:8000...
INFO:__main__:Server metadata: {'note': 'dummy'}

Running policy:   0%|          | 0/10 [00:00<?, ?it/s]
Running policy: 100%|██████████| 10/10 [00:00<00:00, 597.74it/s]
                            Timing Statistics
┏━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━┳━━━━━┳━━━━━┳━━━━━┳━━━━━┳━━━━━┳━━━━━┳━━━━━┓
┃ Metric               ┃ Mean ┃ Std ┃ P25 ┃ P50 ┃ P75 ┃ P90 ┃ P95 ┃ P99 ┃
┡━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━╇━━━━━╇━━━━━╇━━━━━╇━━━━━╇━━━━━╇━━━━━╇━━━━━┩
│ client_infer_ms      │  1.7 │ 0.2 │ 1.6 │ 1.7 │ 1.7 │ 1.8 │ 1.9 │ 2.1 │
│ server_infer_ms      │  0.0 │ 0.0 │ 0.0 │ 0.0 │ 0.0 │ 0.0 │ 0.0 │ 0.0 │
│ server_prev_total_ms │  1.9 │ 0.8 │ 1.6 │ 1.7 │ 1.8 │ 2.3 │ 3.3 │ 4.1 │
└──────────────────────┴──────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┘
このときのダミーサーバー側のログです。1回目(修正前)と2回目(修正後)の2回、接続して切れたことが記録されています。
INFO:websockets.server:server listening on 0.0.0.0:8000
INFO:websockets.server:connection open
INFO:wps:Connection from ('127.0.0.1', 54722) opened
INFO:websockets.server:connection closed
INFO:wps:Connection from ('127.0.0.1', 54722) closed
INFO:websockets.server:connection open
INFO:wps:Connection from ('127.0.0.1', 54724) opened
INFO:websockets.server:connection closed
INFO:wps:Connection from ('127.0.0.1', 54724) closed
この時点で、Mac 側の手順に残っている問題は π0.5 を実際に動かさないと分からないものだけになりました。修正後の main.py の全文は、この記事の最後の「再現手順」の前に載せています。
GPU は Runpod の A40(時給0.59ドル)を借りた
クラウドで GPU を時間単位で貸すサービスはたくさんあります。2026年10月10日時点の比較サイト(GetDeploying)で、RTX 4090 を1枚・使った時間だけ払う条件の最安値は次のとおりでした。
サービス | RTX 4090 1枚の時給(最安の構成) | 備考 |
|---|---|---|
Novita | 0.33ドル | |
Salad | 0.33ドル | |
RunPod(Community Cloud) | 0.34ドル | 個人や小さな事業者が貸し出す GPU |
GPU.ai | 0.34ドル | |
Vast.ai | 0.38ドル | 2枚構成の価格。個人が貸し出す GPU の市場 |
RunPod(Secure Cloud) | 0.89ドル | データセンターの GPU |
Runpod を選んだのは、価格が安い側にあることに加えて、GPU とテンプレート(あらかじめ OS とライブラリが入った起動イメージ)を選ぶだけで、SSH でログインできる Ubuntu のマシンが数分で立ち上がるからです。支払いはクレジットカードで先に入金し、使った分を差し引く方式です。
ただ、アカウントを作って Pod(Runpod での GPU マシンの単位)を作ろうとすると、最初に出てきた GPU の選択画面には RTX 4090 が0.89ドル(Secure Cloud の価格)で並んでいて、A40 が0.59ドルでした。
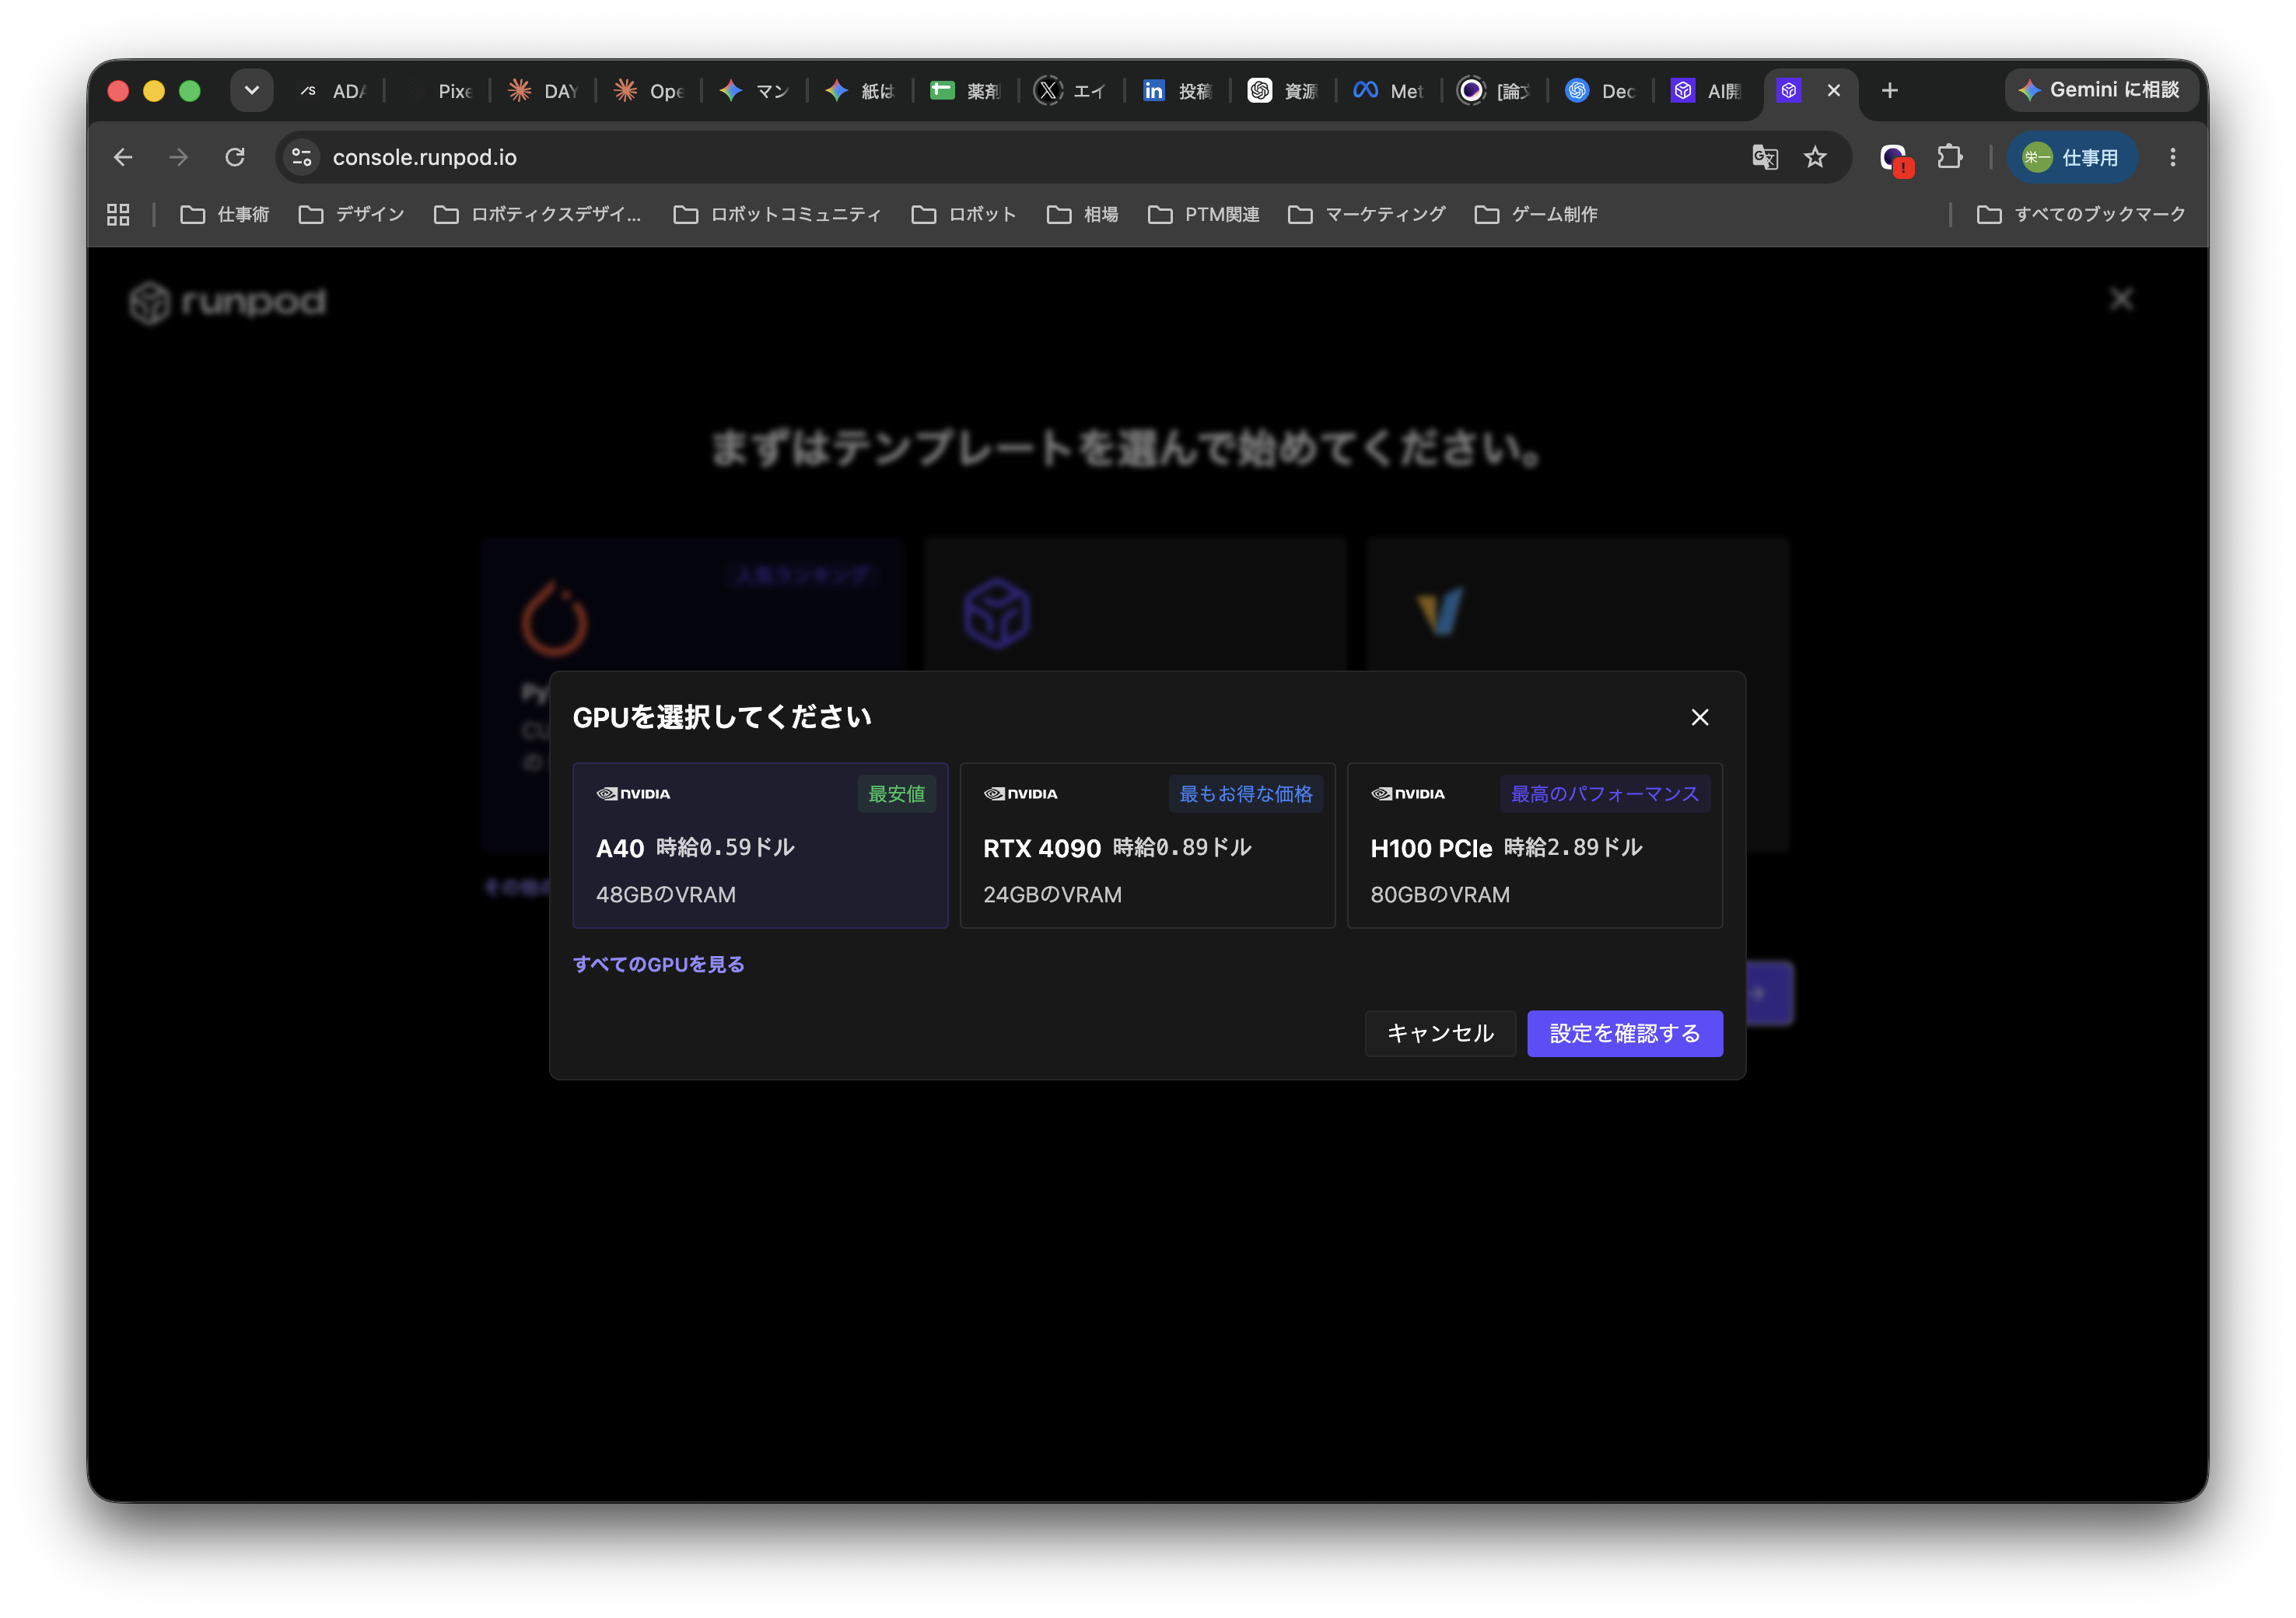
A40 は RTX 4090 より1世代古い、データセンター向けの GPU です。GPU のメモリは48GB で、推論に必要な8GB を大きく超えています。この画面の中では A40 が一番安かったので、A40 を選びました。README が例に挙げている RTX 4090 とは条件が違うので、この回の数値は「A40 で測った値」として扱います。
なお、Runpod のアカウントを作った直後に「AI エージェントを Runpod にオンボーディングする」という画面が出ます。これは Claude Code などのコーディング用 AI に、Runpod のマシンを作ったり消したりできる権限を渡す設定です。設定すると、AI が自分の判断で課金されるマシンを立ち上げられる状態になります。この回は1回試すだけなので、「今はスキップ」を選んで手で操作しました。
Runpod の入金は Chrome で決済画面が開かず、Safari で通った
Runpod は入金した残高から使った分を差し引く方式で、最低入金額は10ドルです。入金画面では150ドル・200ドル・250ドル・500ドルのボタンが並んでいて、それ以外の額は「他の」を選んで入力します。今回のテストで必要な額は2ドルもあれば足りる見込みでしたが、最低額の10ドルを入れました。
1つ目のつまずきは、金額の欄に「10」と打ったつもりが「1」しか入っていなかったことです。日本語入力のまま数字を打つと、確定前の文字が消えることがあります。欄の下に「最低クレジット額は10ドルです」と出て、「チェックアウトに進む」が押せない状態のままでした。英数入力に切り替えて打ち直すと、エラーは消えました。
2つ目は、金額が正しく入っても、Chrome では「チェックアウトに進む」を押した後の決済画面が開かなかったことです。Chrome の拡張機能のうち、サイトへのアクセスを止める機能を持つもの(BlockSite)が、そのページで1件ブロックしたことを示す表示を出していたので、これを疑いました。ただ、拡張機能をオフにして確かめる前に Safari に切り替えたところ、そのまま決済が通ったので、Chrome で開かなかった原因は特定していません。入金は Runpod のアカウントに反映されるので、残りの操作は Chrome に戻って続けました。
SSH 鍵は zsh でコメント付きのまま打つと作れない
Runpod の Pod には、SSH でログインして操作します。SSH 鍵は「秘密鍵」と「公開鍵」の組で、公開鍵を Runpod に登録しておくと、Pod を作ったときに自動で組み込まれ、手元の秘密鍵でログインできるようになります。鍵は Pod を作る瞬間に組み込まれるので、Pod を作る前に登録しておく必要があります。
鍵を作るコマンドを、# 質問はすべてEnterでOK という説明を行の後ろに付けたまま実行したところ、失敗しました。
Last login: Sat Oct 10 08:09:29 on ttys000
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ %    ssh-keygen -t ed25519      # 質問はすべてEnterでOK
   cat ~/.ssh/id_ed25519.pub
Too many arguments.
usage: ssh-keygen [-q] [-a rounds] [-b bits] [-C comment] [-f output_keyfile]
                  [-m format] [-N new_passphrase] [-O option]
                  [-t ecdsa | ecdsa-sk | ed25519 | ed25519-sk | rsa]
                  [-w provider] [-Z cipher]
       ssh-keygen -p [-a rounds] [-f keyfile] [-m format] [-N new_passphrase]
                   [-P old_passphrase] [-Z cipher]
       ssh-keygen -i [-f input_keyfile] [-m key_format]
       ssh-keygen -e [-f input_keyfile] [-m key_format]
       ssh-keygen -y [-f input_keyfile]
       ssh-keygen -c [-a rounds] [-C comment] [-f keyfile] [-P passphrase]
       ssh-keygen -l [-v] [-E fingerprint_hash] [-f input_keyfile]
       ssh-keygen -B [-f input_keyfile]
       ssh-keygen -D pkcs11
       ssh-keygen -F hostname [-lv] [-f known_hosts_file]
       ssh-keygen -H [-f known_hosts_file]
       ssh-keygen -K [-a rounds] [-w provider]
       ssh-keygen -R hostname [-f known_hosts_file]
       ssh-keygen -r hostname [-g] [-f input_keyfile]
       ssh-keygen -M generate [-O option] output_file
       ssh-keygen -M screen [-f input_file] [-O option] output_file
       ssh-keygen -I certificate_identity -s ca_key [-hU] [-D pkcs11_provider]
                  [-n principals] [-O option] [-V validity_interval]
                  [-z serial_number] file ...
       ssh-keygen -L [-f input_keyfile]
       ssh-keygen -A [-a rounds] [-f prefix_path]
       ssh-keygen -k -f krl_file [-u] [-s ca_public] [-z version_number]
                  file ...
       ssh-keygen -Q [-l] -f krl_file [file ...]
       ssh-keygen -Y find-principals -s signature_file -f allowed_signers_file
       ssh-keygen -Y match-principals -I signer_identity -f allowed_signers_file
       ssh-keygen -Y check-novalidate -n namespace -s signature_file
       ssh-keygen -Y sign -f key_file -n namespace file [-O option] ...
       ssh-keygen -Y verify -f allowed_signers_file -I signer_identity
                  -n namespace -s signature_file [-r krl_file] [-O option]
cat: /Users/shimazueiichi/.ssh/id_ed25519.pub: No such file or directory
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ %
Mac のターミナルが使っている zsh は、初期設定のまま手で打ったコマンドでは、行の途中の # 以降をコメントとして無視しません。そのため「質問はすべてEnterでOK」までがコマンドの続きとして ssh-keygen に渡され、「引数が多すぎる」と言われて鍵が作られませんでした。
コメントを付けずに1行ずつ実行すると作れます。
ssh-keygen -t ed25519
cat ~/.ssh/id_ed25519.pub
1行目を実行すると、保存場所・パスフレーズ・パスフレーズの確認の3つを聞かれます。この回では3つとも Enter だけで進めました。2行目で表示される ssh-ed25519 AAAA... で始まる1行が公開鍵です。これを Runpod の左メニューの「資格」(Credentials)→「SSH公開鍵」タブ →「SSHキーを追加する」に貼り付けて保存しました。末尾に .pub が付かないほうのファイル(~/.ssh/id_ed25519)は秘密鍵なので、Mac の外には出しません。
Runpod には「秘密」(Secrets)という似た名前の画面もありますが、こちらは API キーなどを Pod に渡すための場所で、SSH 鍵を登録する場所ではありません。
Pod はテンプレート PyTorch 2.8.0・A40・コンテナディスク 80GB で起動した
Pod の作成画面で選んだ設定です。
項目 | 選んだもの |
|---|---|
テンプレート | Runpod Pytorch 2.8.0( |
GPU | A40 × 1(48GB VRAM・メモリ 50GB・9 vCPU) |
料金の種類 | On-Demand(使った時間だけ払う) |
コンテナディスク | 80GB(初期値 30GB から変更) |
永続ストレージ | 追加しない |
テンプレートに入っている PyTorch のバージョンは気にしなくて構いません。openpi は uv sync を実行したときに、必要なライブラリ(CUDA 一式を含む)を自分で別に入れるからです。テンプレートに求めるのは、NVIDIA のドライバと SSH が使える Ubuntu であることだけです。なお、このテンプレートは Ubuntu 24.04 で、README が動作確認したとしている 22.04 とは違いますが、この回の範囲(インストール・モデルの読み込み・推論)では問題は出ませんでした。
コンテナディスクは、Pod を消すと一緒に消える作業用のディスクです。Python の環境と π0.5 のモデル(ダウンロードしたファイルが11.6GB)を置くので、余裕を持たせて80GB にしました。80GB にしても料金は1時間あたり約0.01ドル増えるだけです。
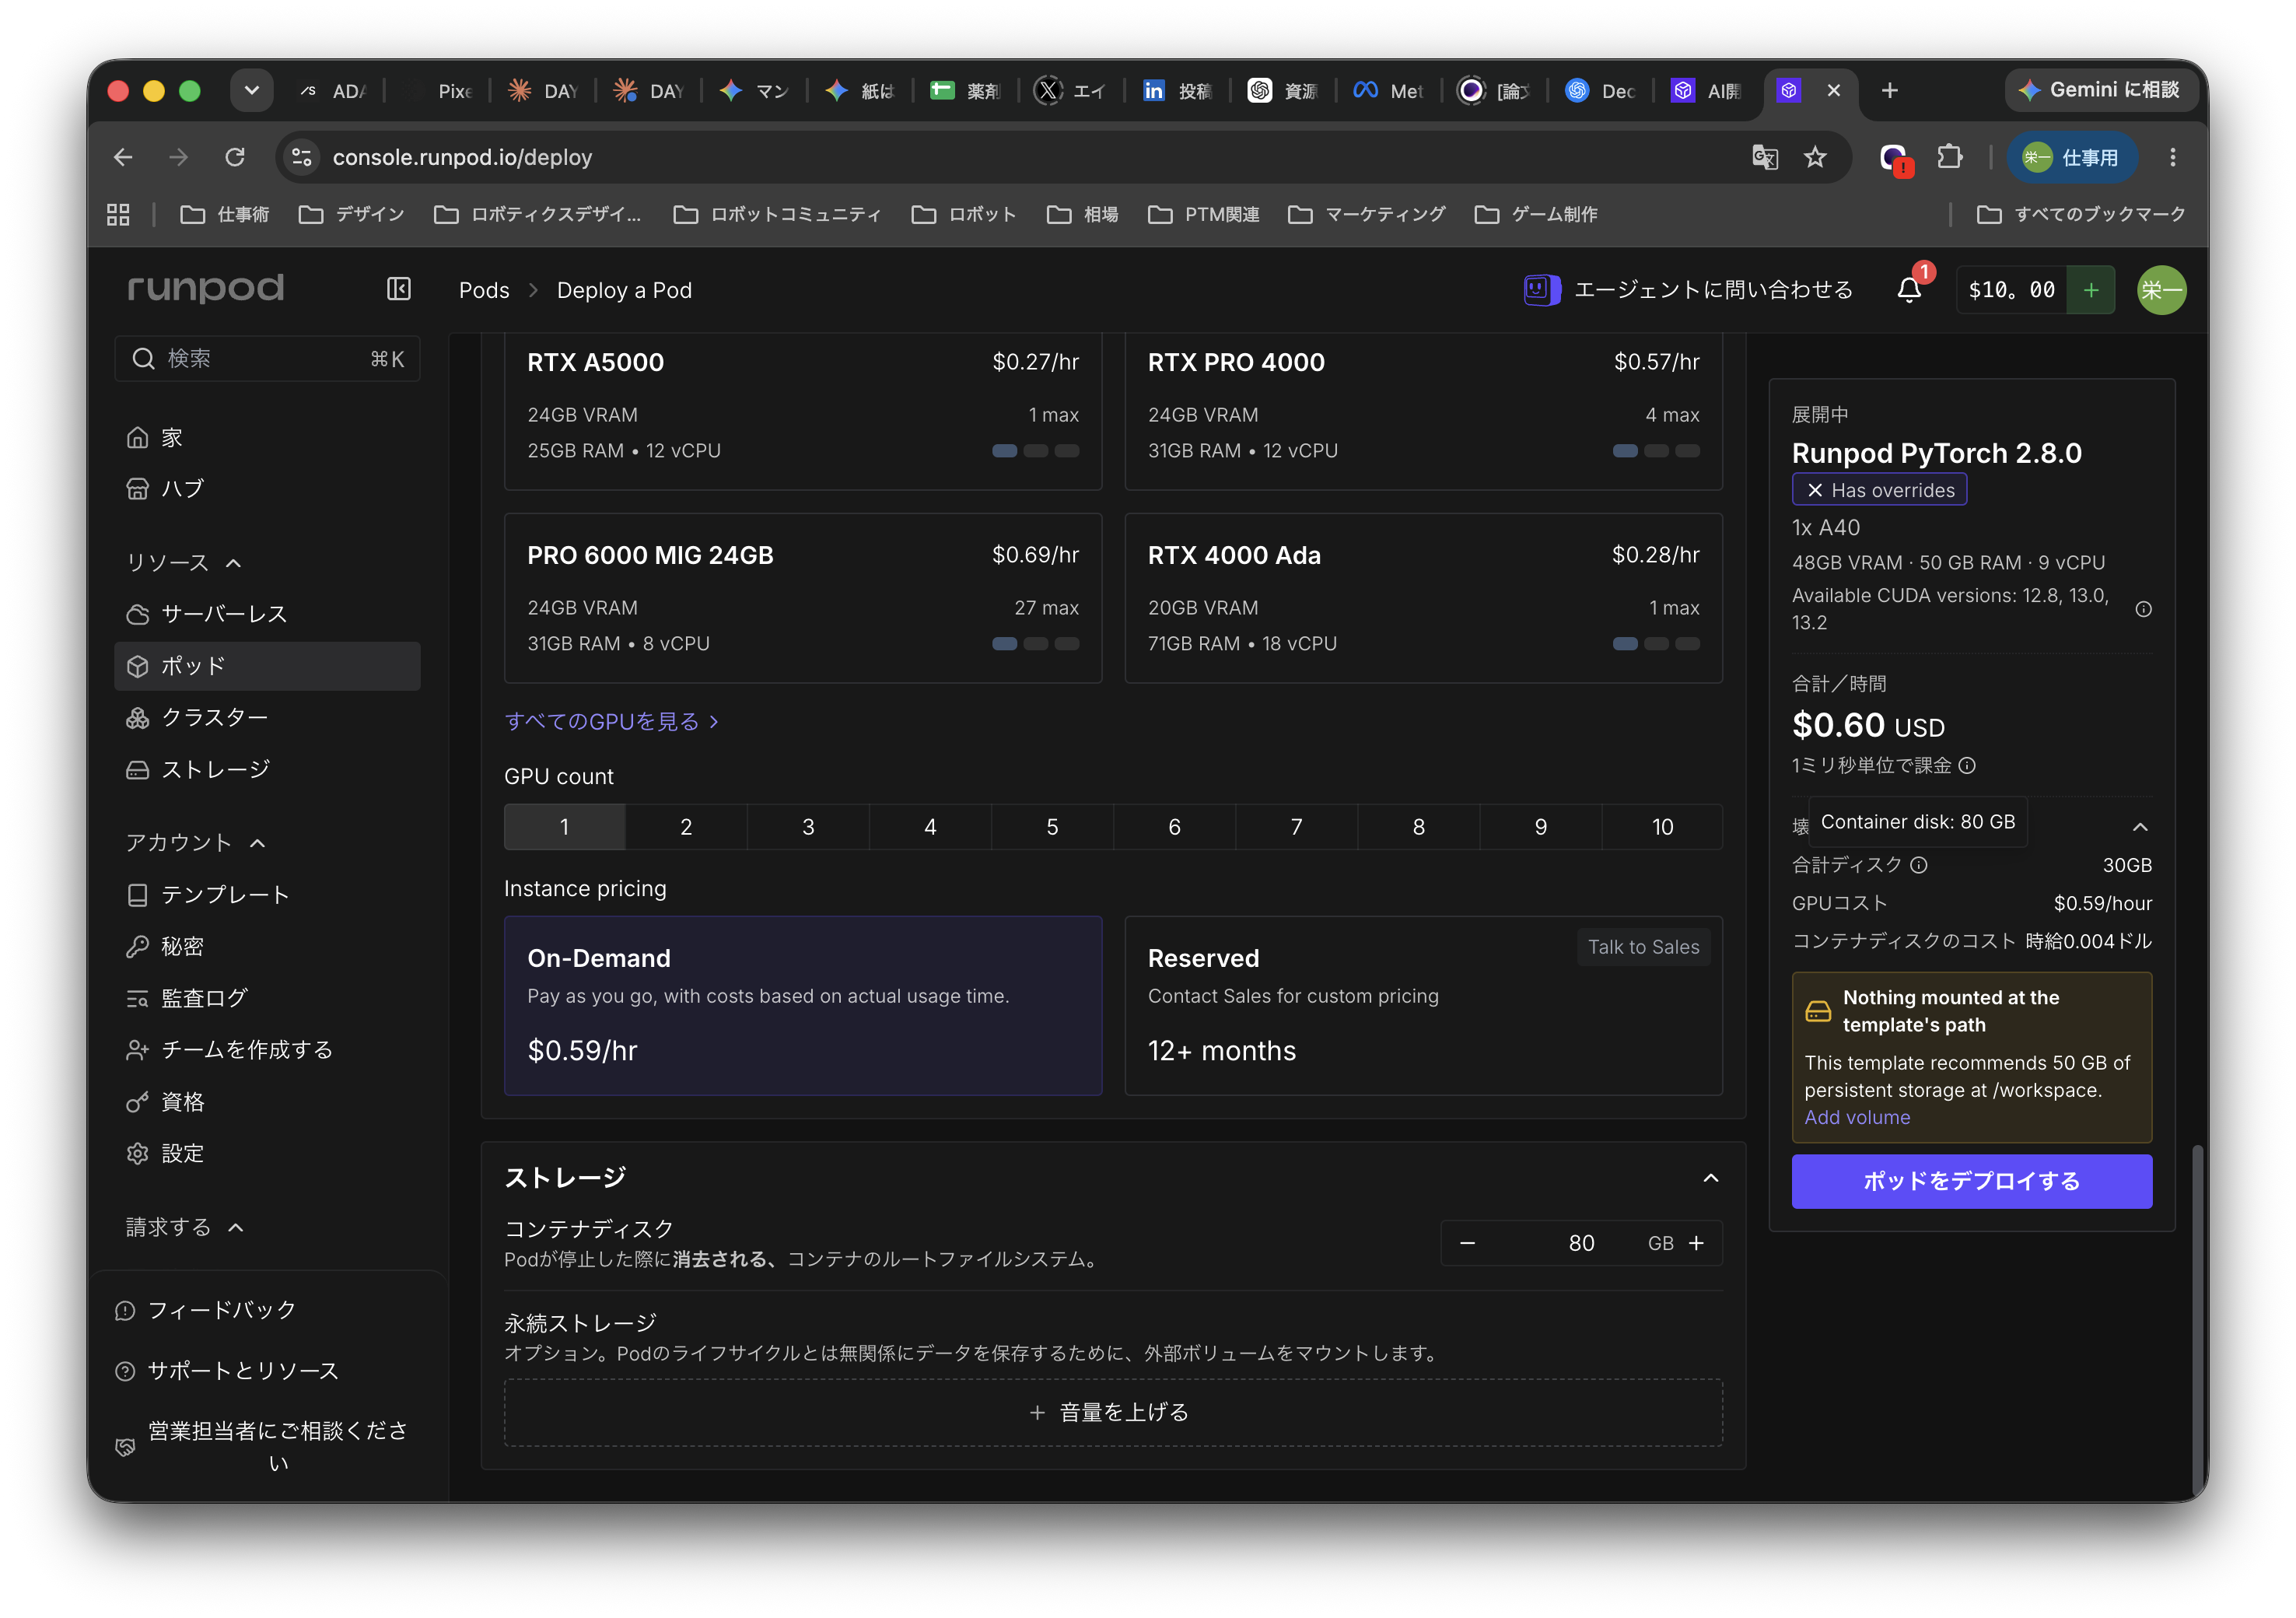
設定を変えると、右側の欄に「Has overrides」(初期設定から変更あり)と「Container disk: 80 GB」が出て、時給の合計が0.59ドルから0.60ドルに上がりました。ただ、同じ欄の「合計ディスク」は30GB のまま表示が変わりませんでした。表示が更新されていないだけと判断して、そのまま起動しました。
作成画面の右側に「Nothing mounted at the template's path(このテンプレートは /workspace に 50GB の永続ストレージを推奨)」という黄色い警告も出ていました。永続ストレージは Pod を止めても中身が残る代わりに、止めている間も料金がかかります。1回試すだけなので、追加していません。
Pod が起動すると、接続方法の画面に SSH のコマンドが2種類出ます。1つは ssh.runpod.io を経由するもので、画面に「SCP と SFTP は非対応」と書かれています。もう1つは「SSH over exposed TCP」で、Pod の IP アドレスとポートに直接つなぎます。後で SSH トンネル(ポート転送)を使うので、直接つなぐほうを使いました。
Runpod 上で openpi を入れ、π0.5-DROID のサーバーを起動した
以下、記事に載せるログでは、Pod の IP アドレスを <POD_IP>、SSH のポート番号を <SSH_PORT>、Mac 側の回線の IP アドレスを <MAC_IP> に置き換えています。Pod の IP アドレスとポートは Pod を作るたびに変わる値で、この回の Pod はすでに削除しています。
Mac から Pod に SSH で入り、次のコマンドを1行ずつ実行しました。
ssh root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
df -h /
nvidia-smi
git clone --recurse-submodules https://github.com/Physical-Intelligence/openpi.git
cd openpi
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
GIT_LFS_SKIP_SMUDGE=1 uv sync
GIT_LFS_SKIP_SMUDGE=1 uv pip install -e .
初めて Pod に入るときは、接続先を信頼するかを yes/no で聞かれるので yes と答えます。df -h / はディスクの容量、nvidia-smi は GPU の状態を確かめるコマンドですが、この2つの出力は記録を残していません。curl ... | sh の行は、Python の環境を管理するツール uv を入れるコマンドです。GIT_LFS_SKIP_SMUDGE=1 は、openpi が依存している LeRobot を取得するために README が付けるよう指示しているものです。
uv sync は数分かかります。画面に残っていたインストールの最後の部分です(それより前の出力は画面の外に流れて、記録が残っていません)。
 + scipy==1.15.3
 + sentencepiece==0.2.0
 + sentry-sdk==2.29.1
 + setproctitle==1.3.6
 + setuptools==80.9.0
 + shtab==1.7.2
 + simplejson==3.20.1
 + six==1.17.0
 + smmap==5.0.2
 + soupsieve==2.7
 + stack-data==0.6.3
 + sympy==1.14.0
 + tensorstore==0.1.74
 + termcolor==3.1.0
 + tokenizers==0.21.1
 + toml==0.10.2
 + toolz==1.0.0
 + torch==2.7.1
 + torchcodec==0.4.0
 + torchvision==0.22.1
 + tornado==6.5.1
 + tqdm==4.67.1
 + tqdm-loggable==0.2
 + traitlets==5.14.3
 + transformers==4.53.2
 + treescope==0.1.9
 + triton==3.3.1
 + typeguard==4.4.2
 + typing-extensions==4.13.2
 + typing-inspect==0.9.0
 + typing-inspection==0.4.1
 + tyro==0.9.22
 + tzdata==2025.2
 + urllib3==2.4.0
 + virtualenv==20.31.2
 + wadler-lindig==0.1.6
 + wandb==0.19.11
 + wcwidth==0.2.13
 + websockets==15.0.1
 + werkzeug==3.1.3
 + widgetsnbextension==4.0.14
 + wrapt==1.14.1
 + xxhash==3.5.0
 + yarl==1.20.0
 + zarr==3.0.8
 + zipp==3.22.0
Resolved 202 packages in 827ms
      Built openpi @ file:///root/openpi
Prepared 1 package in 315ms
Uninstalled 1 package in 1ms
Installed 1 package in 4ms
 ~ openpi==0.1.0 (from file:///root/openpi)
root@3afa4e5ec440:~/openpi#
最後の行で、プロンプトが root@3afa4e5ec440:~/openpi# に戻っています。止まっているように見えましたが、これはインストールが終わって次のコマンドを待っている状態です。
SSH はしばらく操作しないと切れるので ServerAliveInterval を付けた
インストールが終わった画面のまましばらく置いていたところ、SSH の接続が切れていました。そのことに気づかずにサーバーを起動するコマンドを打ったので、コマンドは Pod ではなく Mac の上で実行され、ファイルが見つからないというエラーになりました。
root@3afa4e5ec440:~/openpi# Read from remote host <POD_IP>: Operation timed out
Connection to <POD_IP> closed.
client_loop: send disconnect: Broken pipe
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % uv run scripts/serve_policy.py --env DROID
error: Failed to spawn: scripts/serve_policy.py
  cause: No such file or directory (os error 2)
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ %
プロンプトが root@... なら Pod の中、(base) shimazueiichi@... なら Mac です。コマンドを打つ前に、どちらにいるかを毎回確かめる必要があります。
Pod 側にインストールしたものは消えていなかったので、SSH をつなぎ直して続きから進めました。つなぎ直すときは、-o ServerAliveInterval=30 を付けました。30秒ごとに「接続はまだ生きている」という合図を送る設定で、何も操作しない時間があっても接続が切れにくくなります。
ssh -o ServerAliveInterval=30 root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
cd ~/openpi
source $HOME/.local/bin/env
uv run scripts/serve_policy.py --env DROID
--env DROID を付けると、π0.5-DROID(gs://openpi-assets/checkpoints/pi05_droid)を読み込んでサーバーを起動します。初回はモデルのダウンロードから始まります。サーバーのログです。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % ssh -o ServerAliveInterval=30 root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
Welcome to Ubuntu 24.04.3 LTS (GNU/Linux 6.8.0-136-generic x86_64)

 * Documentation:  https://help.ubuntu.com
 * Management:     https://landscape.canonical.com
 * Support:        https://ubuntu.com/pro

This system has been minimized by removing packages and content that are
not required on a system that users do not log into.

To restore this content, you can run the 'unminimize' command.
Last login: Sun Oct 11 00:22:30 2026 from <MAC_IP>
 _____                           _
|  __ \                         | |
| |__) |   _ _ __  _ __   ___   __| |
|  _  / | | | '_ \| '_ \ / _ \ / _` |
| | \ \ |_| | | | | |_) | (_) | (_| |
|_|  \_\__,_|_| |_| .__/ \___/ \__,_|
                  | |
                  |_|
For detailed documentation and guides, please visit:
https://docs.runpod.io/ and https://blog.runpod.io/


root@3afa4e5ec440:/# cd ~/openpi
root@3afa4e5ec440:~/openpi# source $HOME/.local/bin/env
root@3afa4e5ec440:~/openpi# uv run scripts/serve_policy.py --env DROID
INFO:openpi.shared.download:Downloading gs://openpi-assets/checkpoints/pi05_droid to /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid
WARNING:openpi.shared.download:gsutil not found, falling back to gcsfs. This may fail if GCP credentials are not configured correctly.
100%|██████████████████████████████████████████████████████████████████| 11.6G/11.6G [01:15<00:00, 165MiB/s]
INFO:root:Loading model...
INFO:2026-10-11 00:35:19,660:jax._src.xla_bridge:925: Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:jax._src.xla_bridge:Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:2026-10-11 00:35:19,664:jax._src.xla_bridge:925: Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:jax._src.xla_bridge:Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:absl:orbax-checkpoint version: 0.11.13
INFO:absl:Created BasePyTreeCheckpointHandler: use_ocdbt=True, use_zarr3=False, pytree_metadata_options=PyTreeMetadataOptions(support_rich_types=False), array_metadata_store=<orbax.checkpoint._src.metadata.array_metadata_store.Store object at 0x773897c7a810>
INFO:absl:Restoring checkpoint from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/params.
INFO:absl:[thread=MainThread] Failed to get flag value for EXPERIMENTAL_ORBAX_USE_DISTRIBUTED_PROCESS_ID.
INFO:absl:[process=0] /jax/checkpoint/read/bytes_per_sec: 843.4 MiB/s (total bytes: 6.2 GiB) (time elapsed: 7 seconds) (per-host)
INFO:absl:Finished restoring checkpoint in 7.58 seconds from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/params.
INFO:root:Norm stats not found in /root/openpi/assets/pi05_droid/droid, skipping.
INFO:openpi.shared.download:Downloading gs://big_vision/paligemma_tokenizer.model to /root/.cache/openpi/big_vision/paligemma_tokenizer.model
100%|█████████████████████████████████████████████████████████████████| 4.07M/4.07M [00:01<00:00, 4.26MiB/s]
INFO:root:Loaded norm stats from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/assets/droid
INFO:root:Creating server (host: 3afa4e5ec440, ip: 172.20.0.2)
INFO:websockets.server:server listening on 0.0.0.0:8000
途中に出ている Unable to initialize backend 'rocm' と Unable to initialize backend 'tpu' は、AMD 製の GPU と Google の TPU(どちらも今回は使わない計算装置)が見つからなかったという通知で、エラーではありません。モデル本体の11.6GB のダウンロードに1分15秒、GPU への読み込み(6.2GiB)に7.58秒かかりました。
最後の server listening on 0.0.0.0:8000 が、π0.5 の読み込みが終わり、ポート8000番で接続を待っている状態を示しています。ここでログは止まり、プロンプトには戻りません。これが正常に起動した状態です。
修正2:最初の推論の間に、Mac 側が20秒の確認で接続を切った
サーバーを動かすウィンドウとは別に、Mac で SSH トンネルを張るウィンドウを開こうとしたところ、ターミナルのメニューが開いたまま閉じなくなりました。ターミナルごと強制終了(⌥+⌘+Esc)して、Pod 側のサーバーも止まった状態からやり直しました。
やり直すときは、サーバーの起動と SSH トンネルを1本の SSH 接続でまとめました。-L 8000:localhost:8000 が、Mac の8000番を Pod の8000番につなぐ指定です。これで必要なウィンドウは2つ(Pod でサーバーを動かすものと、Mac でテスト用プログラムを動かすもの)になります。
ssh -o ServerAliveInterval=30 -L 8000:localhost:8000 root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
cd ~/openpi
source $HOME/.local/bin/env
uv run scripts/serve_policy.py --env DROID
Mac 側の準備は次のとおりです。テスト用プログラムを動かす専用の Python 3.11 の環境を openpi のフォルダの中に作り、openpi-client とテスト用プログラムが使うライブラリを入れ、修正1を当てます。
cd ~/r2r2r-content/openpi
uv venv -p 3.11 .venv-client
source .venv-client/bin/activate
uv pip install -e packages/openpi-client -r examples/simple_client/requirements.in
perl -pi -e 's/^import rich$/import rich\nimport rich.console\nimport rich.table/' examples/simple_client/main.py
requirements.in に書かれているのは、numpy>=1.22.4,<2.0.0・rich・tqdm・tyro・polars の5つです。
この状態で、Mac からテスト用プログラムを実行しました。--host localhost で SSH トンネルの入口を指定しています。
Last login: Sun Oct 11 09:49:34 on ttys000
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % cd ~/r2r2r-content/openpi
source .venv-client/bin/activate
python examples/simple_client/main.py --env DROID --host localhost --num-steps 20
INFO:root:Waiting for server at ws://localhost:8000...
INFO:__main__:Server metadata: {}
TimeoutError: timed out while closing connection

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "/Users/shimazueiichi/r2r2r-content/openpi/examples/simple_client/main.py", line 189, in <module>
    main(tyro.cli(Args))
  File "/Users/shimazueiichi/r2r2r-content/openpi/examples/simple_client/main.py", line 136, in main
    policy.infer(obs_fn())
  File "/Users/shimazueiichi/r2r2r-content/openpi/packages/openpi-client/src/openpi_client/websocket_client_policy.py", line 50, in infer
    response = self._ws.recv()
               ^^^^^^^^^^^^^^^
  File "/Users/shimazueiichi/r2r2r-content/openpi/.venv-client/lib/python3.11/site-packages/websockets/sync/connection.py", line 342, in recv
    raise self.protocol.close_exc from self.recv_exc
websockets.exceptions.ConnectionClosedError: sent 1011 (internal error) keepalive ping timeout; no close frame received
ERROR:websockets.client:keepalive ping failed
TimeoutError: timed out while closing connection

The above exception was the direct cause of the following exception:

Traceback (most recent call last):
  File "/Users/shimazueiichi/r2r2r-content/openpi/.venv-client/lib/python3.11/site-packages/websockets/sync/connection.py", line 819, in keepalive
    with self.send_context():
  File "/Users/shimazueiichi/.local/share/uv/python/cpython-3.11.15-macos-aarch64-none/lib/python3.11/contextlib.py", line 144, in __exit__
    next(self.gen)
  File "/Users/shimazueiichi/r2r2r-content/openpi/.venv-client/lib/python3.11/site-packages/websockets/sync/connection.py", line 1068, in send_context
    raise self.protocol.close_exc from self.recv_exc
websockets.exceptions.ConnectionClosedError: sent 1011 (internal error) keepalive ping timeout; no close frame received
(.venv-client) (base) shimazueiichi@shimadzueiichinoMacBook-Pro openpi %
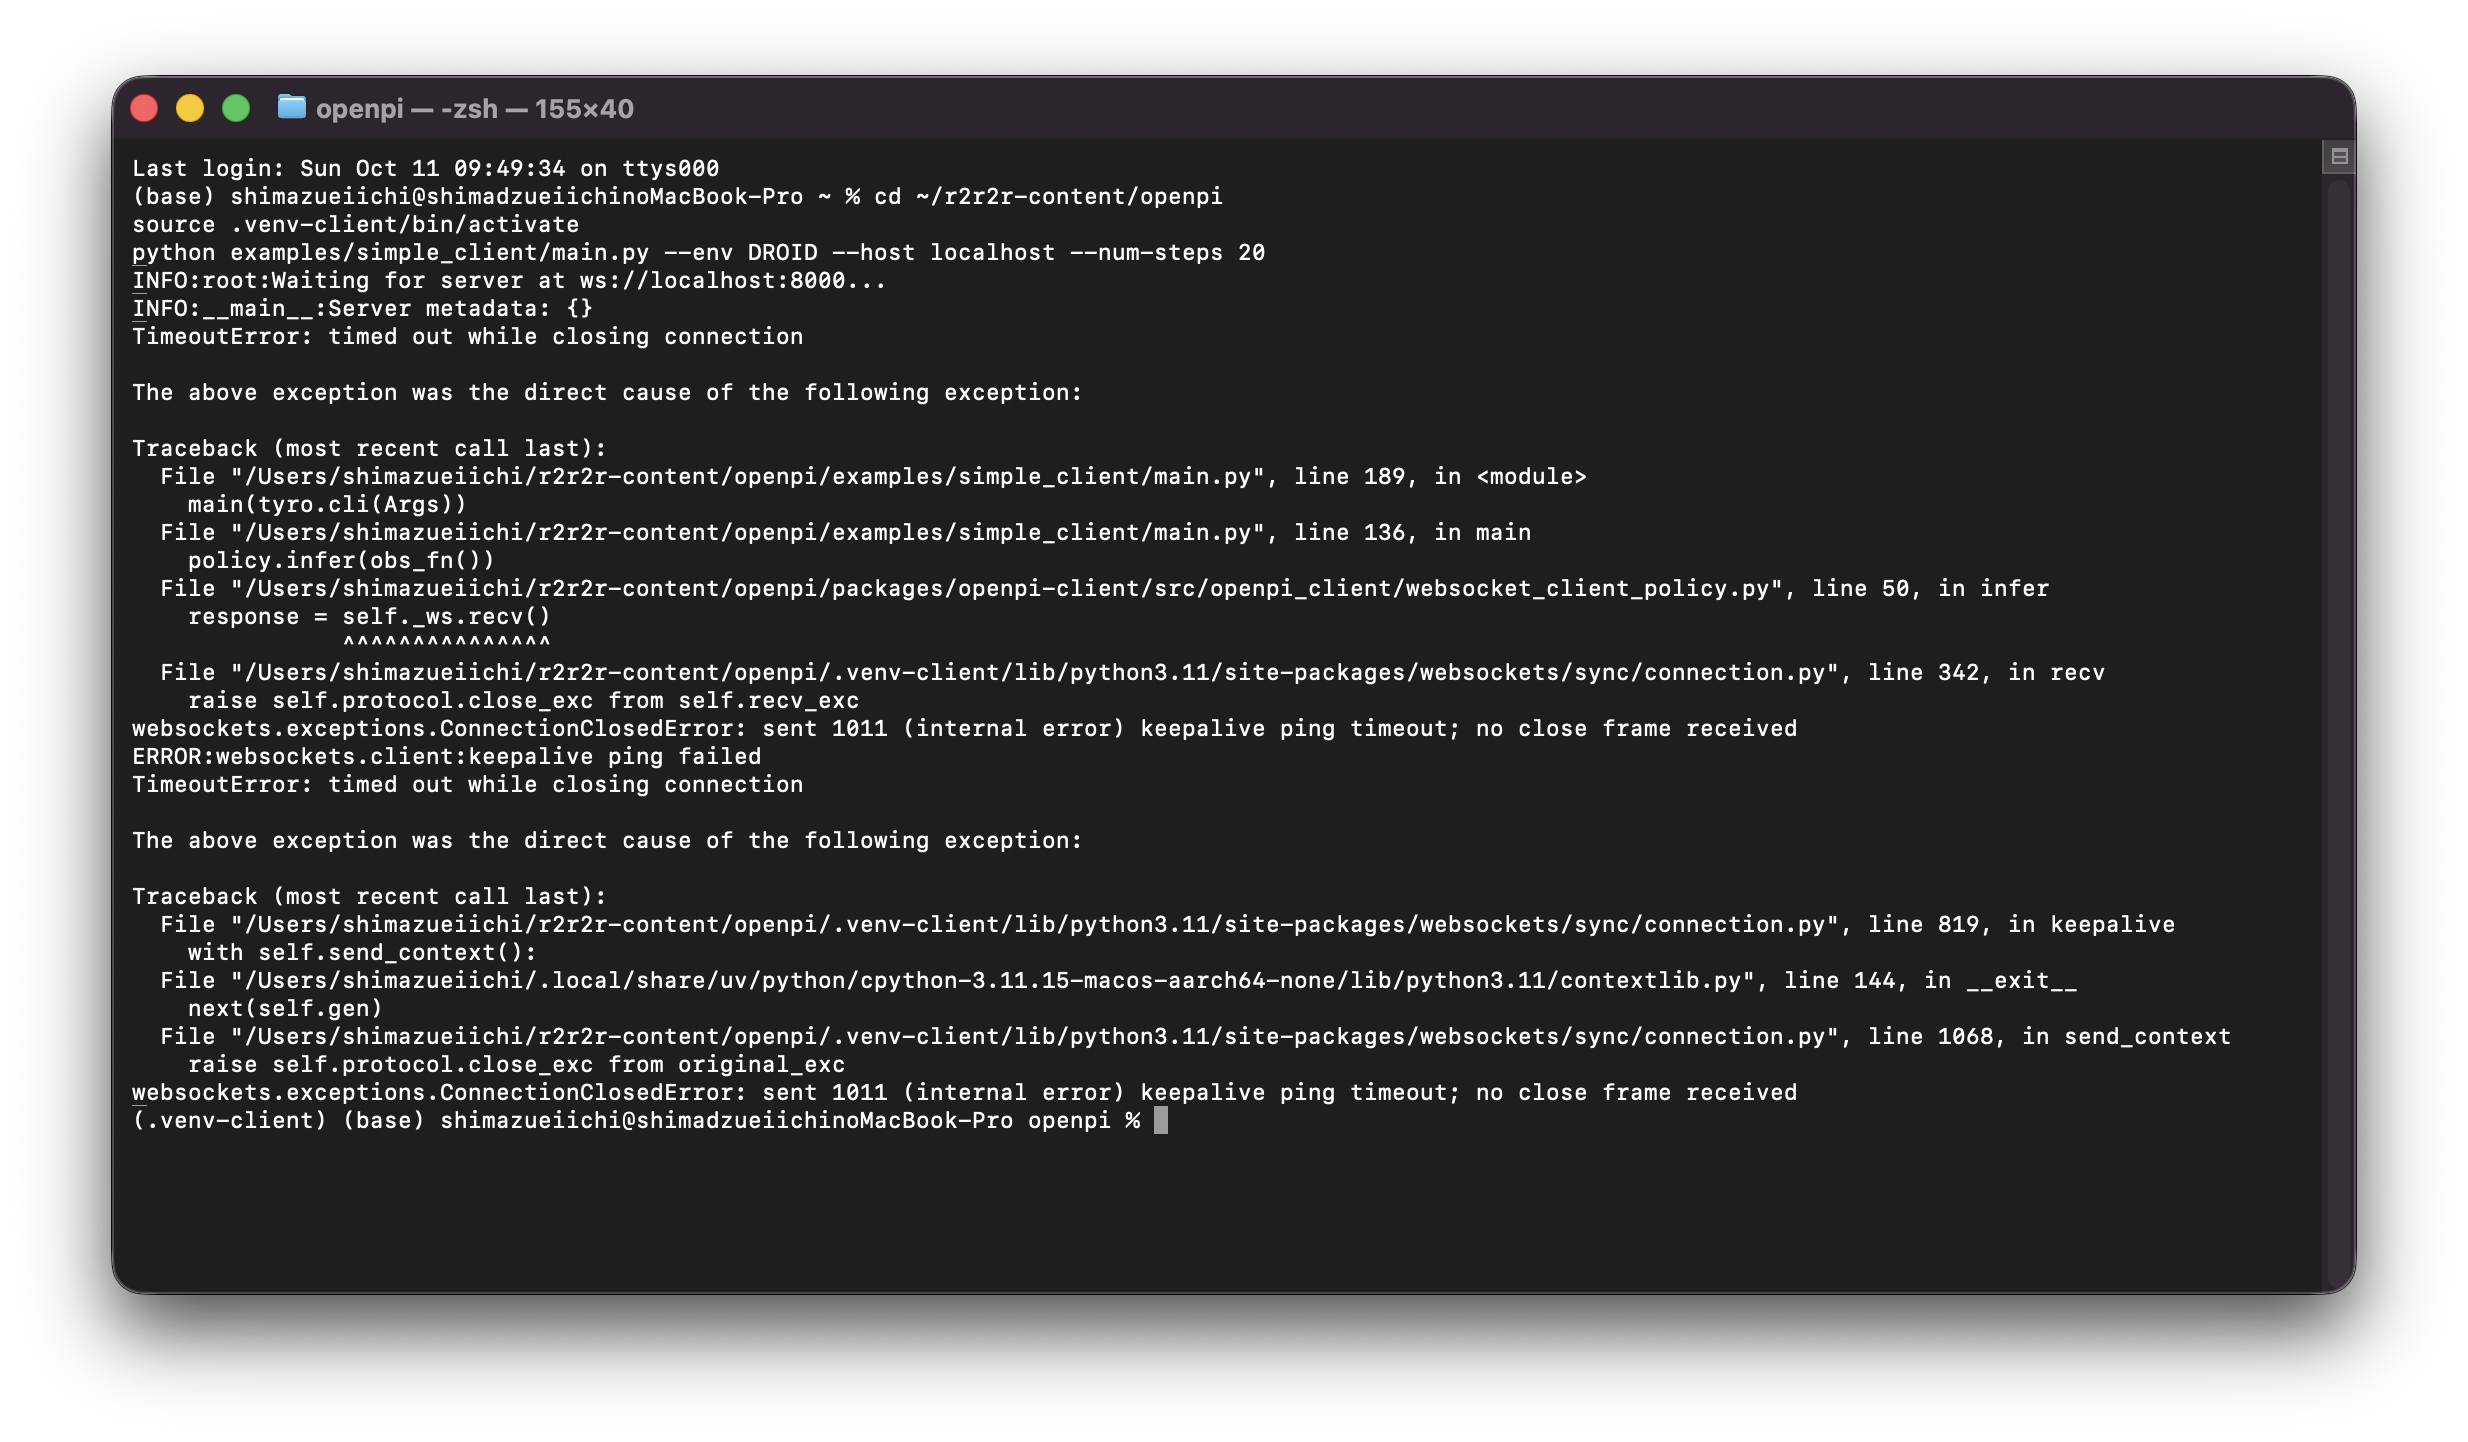
Server metadata: {} が出ているので、Mac から SSH トンネルを通って Pod のサーバーまでは届いています。その後しばらく何も出ず、keepalive ping timeout で接続が切れました。
このときの Pod 側のサーバーのログです。
Last login: Sun Oct 11 09:16:12 on ttys000
Restored session: 2026年 10月11日 日曜日 09時48分32秒 JST
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % ssh -o ServerAliveInterval=30 -L 8000:localhost:8000 root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
Welcome to Ubuntu 24.04.3 LTS (GNU/Linux 6.8.0-136-generic x86_64)

 * Documentation:  https://help.ubuntu.com
 * Management:     https://landscape.canonical.com
 * Support:        https://ubuntu.com/pro

This system has been minimized by removing packages and content that are
not required on a system that users do not log into.

To restore this content, you can run the 'unminimize' command.
Last login: Sun Oct 11 00:32:53 2026 from <MAC_IP>
 _____                           _
|  __ \                         | |
| |__) |   _ _ __  _ __   ___   __| |
|  _  / | | | '_ \| '_ \ / _ \ / _` |
| | \ \ |_| | | | | |_) | (_) | (_| |
|_|  \_\__,_|_| |_| .__/ \___/ \__,_|
                  | |
                  |_|
For detailed documentation and guides, please visit:
https://docs.runpod.io/ and https://blog.runpod.io/


root@3afa4e5ec440:/# cd ~/openpi
source $HOME/.local/bin/env
uv run scripts/serve_policy.py --env DROID
INFO:root:Loading model...
INFO:2026-10-11 00:50:05,096:jax._src.xla_bridge:925: Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:jax._src.xla_bridge:Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:2026-10-11 00:50:05,097:jax._src.xla_bridge:925: Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:jax._src.xla_bridge:Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:absl:orbax-checkpoint version: 0.11.13
INFO:absl:Created BasePyTreeCheckpointHandler: use_ocdbt=True, use_zarr3=False, pytree_metadata_options=PyTreeMetadataOptions(support_rich_types=False), array_metadata_store=<orbax.checkpoint._src.metadata.array_metadata_store.Store object at 0x7454c5001010>
INFO:absl:Restoring checkpoint from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/params.
INFO:absl:[thread=MainThread] Failed to get flag value for EXPERIMENTAL_ORBAX_USE_DISTRIBUTED_PROCESS_ID.
INFO:absl:[process=0] /jax/checkpoint/read/bytes_per_sec: 802.3 MiB/s (total bytes: 6.2 GiB) (time elapsed: 7 seconds) (per-host)
INFO:absl:Finished restoring checkpoint in 7.97 seconds from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/params.
INFO:root:Norm stats not found in /root/openpi/assets/pi05_droid/droid, skipping.
INFO:root:Loaded norm stats from /root/.cache/openpi/openpi-assets/checkpoints/pi05_droid/assets/droid
INFO:root:Creating server (host: 3afa4e5ec440, ip: 172.20.0.2)
INFO:websockets.server:server listening on 0.0.0.0:8000
INFO:websockets.server:connection open
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 39484) opened
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 39484) closed
サーバー側にはエラーがなく、接続が開いて閉じたことだけが記録されています。
原因は、π0.5 の最初の1回の計算と、通信ライブラリ websockets の初期設定の組み合わせでした。
π0.5 は JAX という計算ライブラリで動いていて、最初の1回だけ、モデルを GPU で実行できる形に変換する処理(コンパイル)が走ります。この回では、その時間は測っていません
openpi のサーバーは、π0.5 の計算をしている間、通信の処理を止めて計算を待つ作りになっています(
websocket_policy_server.pyの中で、self._policy.infer(obs)を通信の処理と同じ流れの中で呼んでいる)Mac 側の openpi-client が使う websockets は、初期設定で20秒ごとに「生きているか」という確認の合図(ping)を送り、20秒以内に返事(pong)がなければ接続を切ります(この初期値は、Claude の作業環境に入った websockets 17.2 で
ping_interval=20・ping_timeout=20と確認した値です)コンパイルの間、サーバーは ping に返事ができません。返事がないので、Mac 側が
1011 (internal error) keepalive ping timeoutで接続を切りました
openpi-client のコードを読むと、websockets で接続するところ(websockets.sync.client.connect(...))では、この ping の設定を変えずに初期値のまま使っています。サーバーが同じ GPU マシンや同じ建物の中にあっても、最初のコンパイルが ping の待ち時間より長ければ同じことが起きるはずです。
直し方は、Mac 側の openpi-client が接続するときに ping_interval=None を渡して、この確認をしないようにすることです。次のコマンドで、接続の行に1語追加します。
perl -pi -e 's/compression=None, max_size=None,/compression=None, max_size=None, ping_interval=None,/' packages/openpi-client/src/openpi_client/websocket_client_policy.py修正前と修正後の差分です。
38c38
<                     self._uri, compression=None, max_size=None, additional_headers=headers
---
>                     self._uri, compression=None, max_size=None, ping_interval=None, additional_headers=headers
確認をしないということは、サーバーが本当に止まってしまったときにも、Mac 側は返事を待ち続けるということです。テスト用の修正としてはこれで足りますが、実際のロボットで使うときは、ping_timeout を最初のコンパイルより長くする、あるいはサーバーを起動した直後に1回だけ計算を空回しして、コンパイルを済ませてから受け付けを始める、といった別の方法を考える必要があります。
修正後の websocket_client_policy.py の全文です。
import logging
import time
from typing import Dict, Optional, Tuple

from typing_extensions import override
import websockets.sync.client

from openpi_client import base_policy as _base_policy
from openpi_client import msgpack_numpy


class WebsocketClientPolicy(_base_policy.BasePolicy):
    """Implements the Policy interface by communicating with a server over websocket.

    See WebsocketPolicyServer for a corresponding server implementation.
    """

    def __init__(self, host: str = "0.0.0.0", port: Optional[int] = None, api_key: Optional[str] = None) -> None:
        if host.startswith("ws"):
            self._uri = host
        else:
            self._uri = f"ws://{host}"
        if port is not None:
            self._uri += f":{port}"
        self._packer = msgpack_numpy.Packer()
        self._api_key = api_key
        self._ws, self._server_metadata = self._wait_for_server()

    def get_server_metadata(self) -> Dict:
        return self._server_metadata

    def _wait_for_server(self) -> Tuple[websockets.sync.client.ClientConnection, Dict]:
        logging.info(f"Waiting for server at {self._uri}...")
        while True:
            try:
                headers = {"Authorization": f"Api-Key {self._api_key}"} if self._api_key else None
                conn = websockets.sync.client.connect(
                    self._uri, compression=None, max_size=None, ping_interval=None, additional_headers=headers
                )
                metadata = msgpack_numpy.unpackb(conn.recv())
                return conn, metadata
            except ConnectionRefusedError:
                logging.info("Still waiting for server...")
                time.sleep(5)

    @override
    def infer(self, obs: Dict) -> Dict:  # noqa: UP006
        data = self._packer.pack(obs)
        self._ws.send(data)
        response = self._ws.recv()
        if isinstance(response, str):
            # we're expecting bytes; if the server sends a string, it's an error.
            raise RuntimeError(f"Error in inference server:\n{response}")
        return msgpack_numpy.unpackb(response)

    @override
    def reset(self) -> None:
        pass
π0.5 の推論は A40 で平均97ms、Mac との往復は平均391ms
修正2を当てて、もう一度テスト用プログラムを実行しました。
(.venv-client) (base) shimazueiichi@shimadzueiichinoMacBook-Pro openpi % perl -pi -e 's/compression=None, max_size=None,/compression=None, max_size=None, ping_interval=None,/' packages/openpi-client/src/openpi_client/websocket_client_policy.py
python examples/simple_client/main.py --env DROID --host localhost --num-steps 20
INFO:root:Waiting for server at ws://localhost:8000...
INFO:__main__:Server metadata: {}
Running policy: 100%|████████████████████████████████████████████████████████████████████| 20/20 [00:07<00:00,  2.55it/s]
                              Timing Statistics
┏━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━┳━━━━━━┳━━━━━━━┳━━━━━━━┳━━━━━━━┳━━━━━━━┳━━━━━━━┳━━━━━━━┓
┃ Metric               ┃  Mean ┃  Std ┃   P25 ┃   P50 ┃   P75 ┃   P90 ┃   P95 ┃   P99 ┃
┡━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━╇━━━━━━╇━━━━━━━╇━━━━━━━╇━━━━━━━╇━━━━━━━╇━━━━━━━╇━━━━━━━┩
│ client_infer_ms      │ 390.7 │ 29.6 │ 374.9 │ 377.7 │ 390.6 │ 436.8 │ 448.4 │ 464.5 │
│ policy_infer_ms      │  97.1 │  0.4 │  97.0 │  97.0 │  97.1 │  97.4 │  97.9 │  98.2 │
│ server_infer_ms      │ 155.4 │  5.5 │ 153.8 │ 156.0 │ 157.1 │ 159.7 │ 160.3 │ 168.4 │
│ server_prev_total_ms │ 392.8 │ 29.5 │ 374.9 │ 377.7 │ 413.0 │ 430.3 │ 442.8 │ 465.7 │
└──────────────────────┴───────┴──────┴───────┴───────┴───────┴───────┴───────┴───────┘
(.venv-client) (base) shimazueiichi@shimadzueiichinoMacBook-Pro openpi %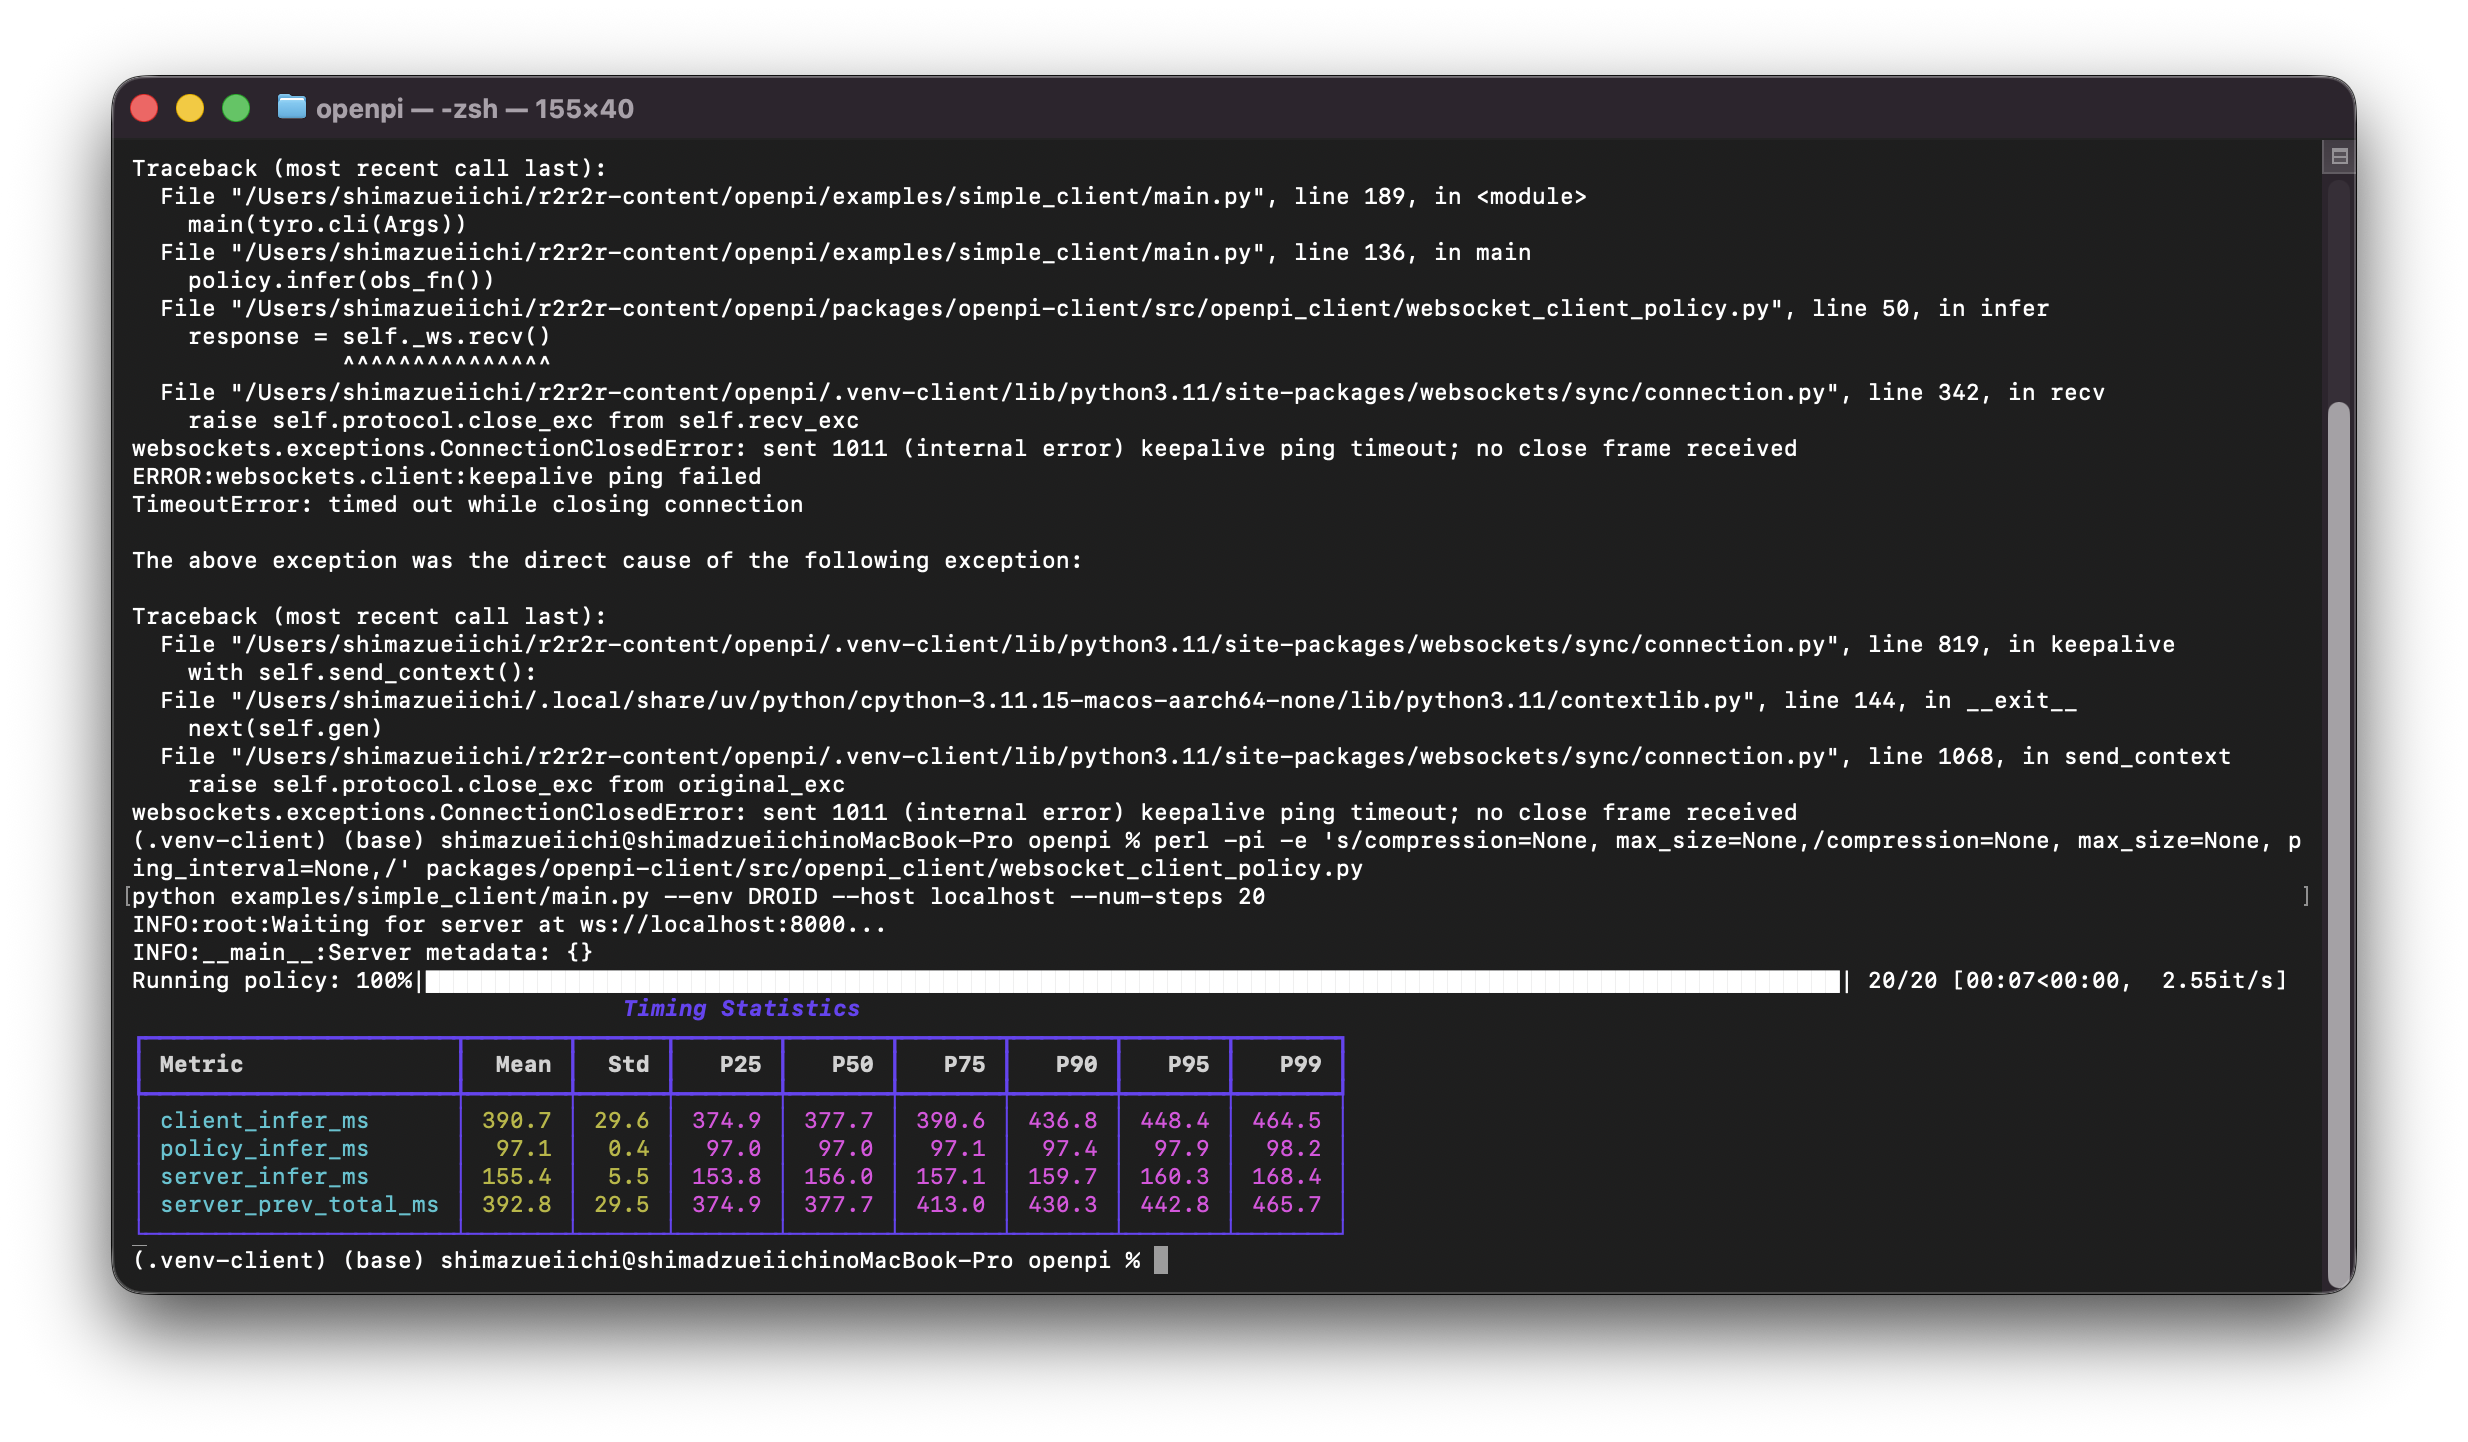
最初の2回はウォームアップ(計測に入れない空回し)で、その後の20回を計測しています。20回は7秒で終わりました。JAX のコンパイル結果はサーバーのプロセスの中に残るので、サーバーを再起動していないこの2回目の実行では、コンパイルの待ちは発生していないと考えています。
表の4つの行は、それぞれ別の区間を測っています。
行 | 測っている区間 | 平均 | ばらつき(標準偏差) |
|---|---|---|---|
policy_infer_ms | π0.5 そのものが動きを計算する時間 | 97.1ms | 0.4ms |
server_infer_ms | 上の計算に、画像の前処理や数値の正規化(値の大きさを揃える処理)を足した、サーバーの中の時間 | 155.4ms | 5.5ms |
client_infer_ms | Mac が送ってから、結果が Mac に返ってくるまでの往復の時間 | 390.7ms | 29.6ms |
server_prev_total_ms | サーバーが次のデータを待ち始めてから、結果を送り終えるまで。待っている時間を含むので、Mac との1往復とほぼ同じ長さになる(1つ前の回の値) | 392.8ms | 29.5ms |
π0.5 本体の計算は約0.1秒で、20回のばらつきは0.4ms しかありません。往復の391ms のうち、サーバーの中で使っている155ms を引いた残りの約236ms は、Mac と Pod の間の通信(SSH トンネルを通る区間)と、2枚の画像を含むデータの送り出し・受け取りにかかった時間です。この区間の内訳は分けて測っていません。Pod がどの国のデータセンターにあったかも記録していないので、秋田からの距離がどれだけ効いているかは分かりません。
実際のロボットにつなぐときには、この往復の時間が問題になります。π0.5 は、1回の計算で1ステップ分ではなく、数ステップ分の動きをまとめて返します(action chunk と呼ばれる仕組み)。ロボットは返ってきた動きを順に実行しながら、その間に次の計算を頼めるので、往復に時間がかかっても動きが止まりにくい作りになっています。どれくらいの往復時間まで動きが止まらずに済むかは、ロボットの1ステップの長さと、何ステップ分を実行してから次を頼むかで決まります。これはこの回では試していません。
この数値の扱いには、3つの前提があります。
GPU は A40 です。README が例に挙げる RTX 4090 では、別の値になるはずです
送った画像はランダムな点の集まりで、指示文も
do somethingです。実際のカメラの画像で計算時間が変わるかは確かめていません計測は20回だけです
Pod は「停止」のあとに「終了」して、かかった費用は0.34ドル
計測が終わったら、Pod のサーバーを Ctrl+C で止め、Runpod の Pod の一覧から Pod を消しました。
Pod の行の右端の「⋮」を押したときのメニューには、「ロックポッド」「編集ポッド」「テンプレートとして…」「Podを再起動します」「ポッドをリセット」「ストップポッド」の6つが並んでいて、削除にあたる項目がありませんでした。
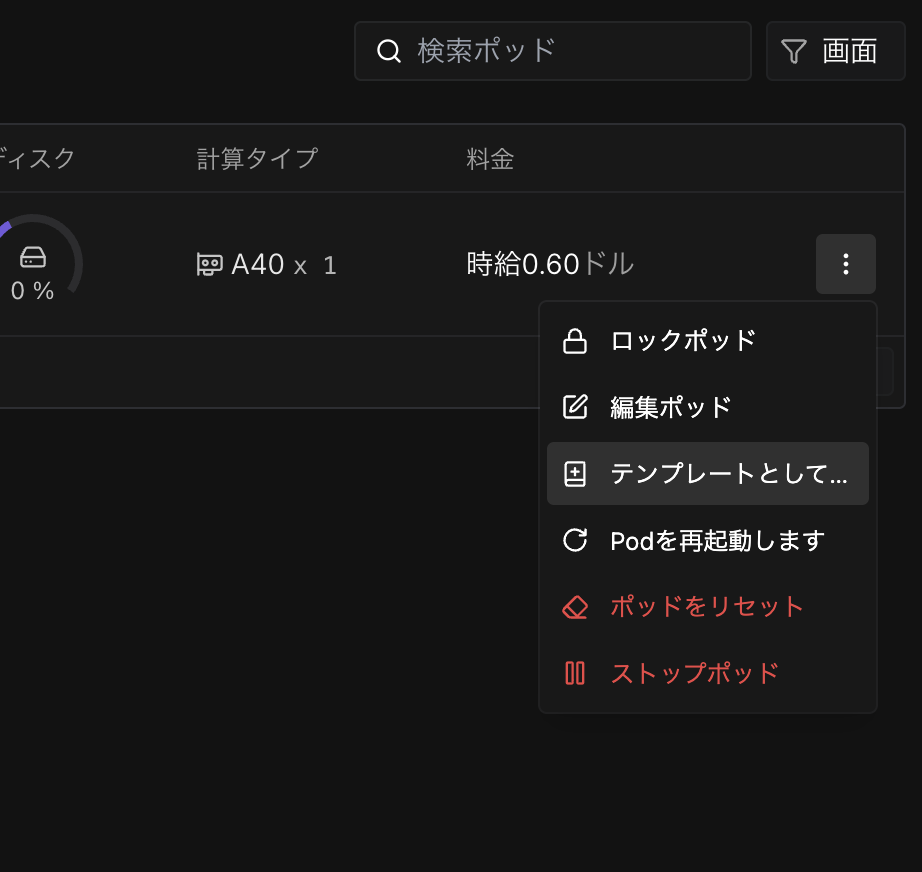
先に「ストップポッド」で止めると、同じメニューに Pod を終了(削除)する項目が出てきます。止めただけの状態では、GPU の料金は止まっても、ディスクの料金はかかり続けます。そのため、止めた後に必ず終了まで進めます。なお、「ポッドをリセット」は削除ではなく、中身を初期化して起動し直す操作です。
終了した後、Pod の作成画面に戻ると、右側の欄に「$0.01 USD」と出ていました。これは次に作る Pod の見積もり(直前の設定のディスク80GB の分)で、Pod を作らない限り課金はされません。課金が止まっているかは、Pod の一覧が空になっているかで確かめられます。
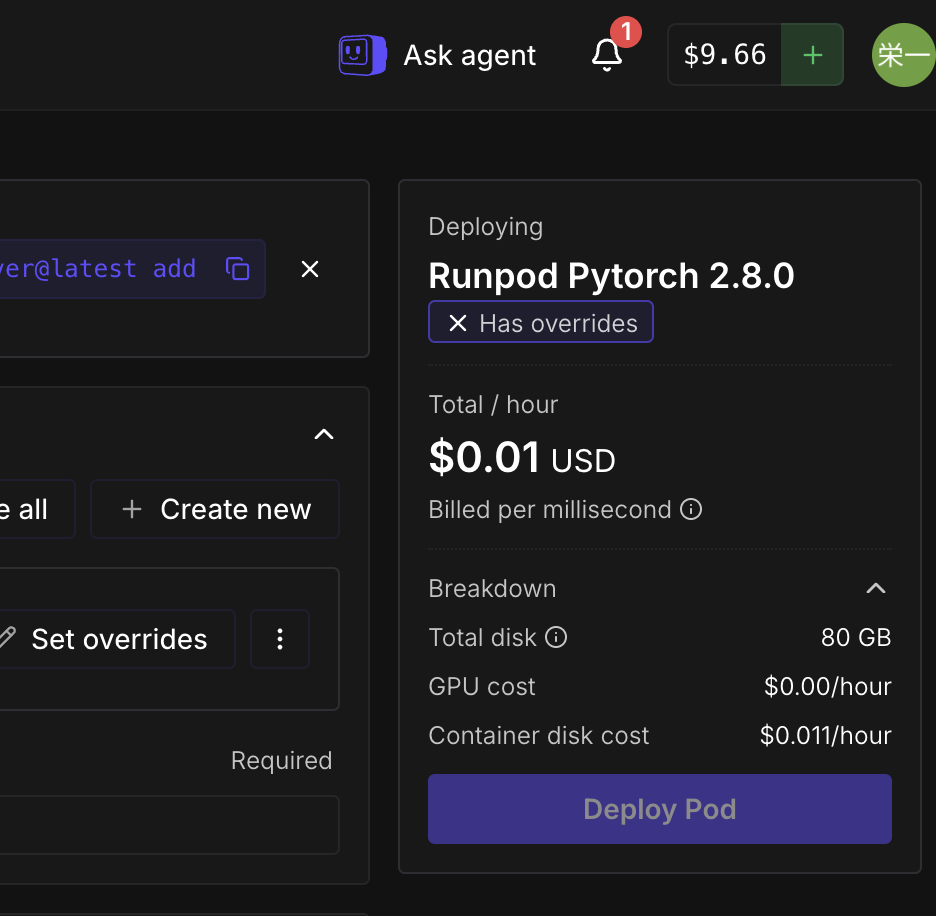
残高は10.00ドルから9.66ドルに減っていました。Pod を起動していたのは約35分で、かかった費用は0.34ドルです。
自宅のワークステーション選びに使える数字と、まだ測っていない数字
Log#1 で決めた設備投資の方針は、初期構築は用途が動く最小構成で組み、迷ったら下のグレードを買うこと、増強は実測したボトルネックがあるときだけにすることでした。この回の目的の1つは、自宅のマシンを買う前に、借りた GPU で実際に動かして数字を取ることでした。
この回で取れた数字です。
項目 | 値 | どこで分かったか |
|---|---|---|
π0.5-DROID のダウンロードサイズ | 11.6GB | サーバーのログ |
GPU に読み込んだモデルの大きさ | 6.2GiB | サーバーのログ |
モデルの読み込み時間(A40) | 7.58秒 / 7.97秒 | サーバーのログ(2回起動した分) |
π0.5 の推論時間(A40) | 平均97.1ms | テスト用プログラムの表 |
サーバー内の処理時間(A40) | 平均155.4ms | テスト用プログラムの表 |
Mac との往復(SSH トンネル経由) | 平均390.7ms | テスト用プログラムの表 |
費用 | 約35分で0.34ドル | Runpod の残高 |
まだ測っていない数字もあります。推論しているときに GPU のメモリを実際にどれだけ使っているかは見ていません。README の「8GB 以上」が A40 の上でどうだったかを確かめるには、推論している間に Pod の中で nvidia-smi を実行して、メモリの使用量を記録する必要があります。最初の1回のコンパイルにかかった時間も測っていません。自宅の GPU のメモリをどれだけにするかを決めるには、この2つを次の機会に取っておく必要があります。
修正後のテスト用プログラム main.py の全文
修正1を当てた後の examples/simple_client/main.py です。変更したのは11行目と12行目の2行だけです。
import dataclasses
import enum
import logging
import pathlib
import time

import numpy as np
from openpi_client import websocket_client_policy as _websocket_client_policy
import polars as pl
import rich
import rich.console
import rich.table
import tqdm
import tyro

logger = logging.getLogger(__name__)


class EnvMode(enum.Enum):
    """Supported environments."""

    ALOHA = "aloha"
    ALOHA_SIM = "aloha_sim"
    DROID = "droid"
    LIBERO = "libero"


@dataclasses.dataclass
class Args:
    """Command line arguments."""

    # Host and port to connect to the server.
    host: str = "0.0.0.0"
    # Port to connect to the server. If None, the server will use the default port.
    port: int | None = 8000
    # API key to use for the server.
    api_key: str | None = None
    # Number of steps to run the policy for.
    num_steps: int = 20
    # Path to save the timings to a parquet file. (e.g., timing.parquet)
    timing_file: pathlib.Path | None = None
    # Environment to run the policy in.
    env: EnvMode = EnvMode.ALOHA_SIM


class TimingRecorder:
    """Records timing measurements for different keys."""

    def __init__(self) -> None:
        self._timings: dict[str, list[float]] = {}

    def record(self, key: str, time_ms: float) -> None:
        """Record a timing measurement for the given key."""
        if key not in self._timings:
            self._timings[key] = []
        self._timings[key].append(time_ms)

    def get_stats(self, key: str) -> dict[str, float]:
        """Get statistics for the given key."""
        times = self._timings[key]
        return {
            "mean": float(np.mean(times)),
            "std": float(np.std(times)),
            "p25": float(np.quantile(times, 0.25)),
            "p50": float(np.quantile(times, 0.50)),
            "p75": float(np.quantile(times, 0.75)),
            "p90": float(np.quantile(times, 0.90)),
            "p95": float(np.quantile(times, 0.95)),
            "p99": float(np.quantile(times, 0.99)),
        }

    def print_all_stats(self) -> None:
        """Print statistics for all keys in a concise format."""

        table = rich.table.Table(
            title="[bold blue]Timing Statistics[/bold blue]",
            show_header=True,
            header_style="bold white",
            border_style="blue",
            title_justify="center",
        )

        # Add metric column with custom styling
        table.add_column("Metric", style="cyan", justify="left", no_wrap=True)

        # Add statistical columns with consistent styling
        stat_columns = [
            ("Mean", "yellow", "mean"),
            ("Std", "yellow", "std"),
            ("P25", "magenta", "p25"),
            ("P50", "magenta", "p50"),
            ("P75", "magenta", "p75"),
            ("P90", "magenta", "p90"),
            ("P95", "magenta", "p95"),
            ("P99", "magenta", "p99"),
        ]

        for name, style, _ in stat_columns:
            table.add_column(name, justify="right", style=style, no_wrap=True)

        # Add rows for each metric with formatted values
        for key in sorted(self._timings.keys()):
            stats = self.get_stats(key)
            values = [f"{stats[key]:.1f}" for _, _, key in stat_columns]
            table.add_row(key, *values)

        # Print with custom console settings
        console = rich.console.Console(width=None, highlight=True)
        console.print(table)

    def write_parquet(self, path: pathlib.Path) -> None:
        """Save the timings to a parquet file."""
        logger.info(f"Writing timings to {path}")
        frame = pl.DataFrame(self._timings)
        path.parent.mkdir(parents=True, exist_ok=True)
        frame.write_parquet(path)


def main(args: Args) -> None:
    obs_fn = {
        EnvMode.ALOHA: _random_observation_aloha,
        EnvMode.ALOHA_SIM: _random_observation_aloha,
        EnvMode.DROID: _random_observation_droid,
        EnvMode.LIBERO: _random_observation_libero,
    }[args.env]

    policy = _websocket_client_policy.WebsocketClientPolicy(
        host=args.host,
        port=args.port,
        api_key=args.api_key,
    )
    logger.info(f"Server metadata: {policy.get_server_metadata()}")

    # Send a few observations to make sure the model is loaded.
    for _ in range(2):
        policy.infer(obs_fn())

    timing_recorder = TimingRecorder()

    for _ in tqdm.trange(args.num_steps, desc="Running policy"):
        inference_start = time.time()
        action = policy.infer(obs_fn())
        timing_recorder.record("client_infer_ms", 1000 * (time.time() - inference_start))
        for key, value in action.get("server_timing", {}).items():
            timing_recorder.record(f"server_{key}", value)
        for key, value in action.get("policy_timing", {}).items():
            timing_recorder.record(f"policy_{key}", value)

    timing_recorder.print_all_stats()

    if args.timing_file is not None:
        timing_recorder.write_parquet(args.timing_file)


def _random_observation_aloha() -> dict:
    return {
        "state": np.ones((14,)),
        "images": {
            "cam_high": np.random.randint(256, size=(3, 224, 224), dtype=np.uint8),
            "cam_low": np.random.randint(256, size=(3, 224, 224), dtype=np.uint8),
            "cam_left_wrist": np.random.randint(256, size=(3, 224, 224), dtype=np.uint8),
            "cam_right_wrist": np.random.randint(256, size=(3, 224, 224), dtype=np.uint8),
        },
        "prompt": "do something",
    }


def _random_observation_droid() -> dict:
    return {
        "observation/exterior_image_1_left": np.random.randint(256, size=(224, 224, 3), dtype=np.uint8),
        "observation/wrist_image_left": np.random.randint(256, size=(224, 224, 3), dtype=np.uint8),
        "observation/joint_position": np.random.rand(7),
        "observation/gripper_position": np.random.rand(1),
        "prompt": "do something",
    }


def _random_observation_libero() -> dict:
    return {
        "observation/state": np.random.rand(8),
        "observation/image": np.random.randint(256, size=(224, 224, 3), dtype=np.uint8),
        "observation/wrist_image": np.random.randint(256, size=(224, 224, 3), dtype=np.uint8),
        "prompt": "do something",
    }


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO)
    main(tyro.cli(Args))
再現手順(2026年10月11日時点の openpi の main)
この回の手順を、つまずいた箇所を直した形でまとめます。openpi のコードは、記事を書いた時点の main を使っています(Claude の作業環境で確認した commit は 215abfb217dbac7d5f1273282331b9b1866c0479、2026年8月24日)。
Mac 側(1回だけ)
git clone --recurse-submodules https://github.com/Physical-Intelligence/openpi.git
cd openpi
uv venv -p 3.11 .venv-client
source .venv-client/bin/activate
uv pip install -e packages/openpi-client -r examples/simple_client/requirements.in
perl -pi -e 's/^import rich$/import rich\nimport rich.console\nimport rich.table/' examples/simple_client/main.py
perl -pi -e 's/compression=None, max_size=None,/compression=None, max_size=None, ping_interval=None,/' packages/openpi-client/src/openpi_client/websocket_client_policy.py
ssh-keygen -t ed25519
cat ~/.ssh/id_ed25519.pub
Runpod 側(ブラウザで)
10ドル以上を入金する(Chrome で決済画面が開かない場合は別のブラウザで)
「資格」→「SSH公開鍵」に、Mac で表示した公開鍵の1行を登録する
Pod を作る:テンプレート Runpod Pytorch 2.8.0、GPU A40 × 1、On-Demand、コンテナディスク 80GB
接続方法の画面で「SSH over exposed TCP」の IP アドレスとポートを確かめる
Mac のウィンドウ1(Pod でサーバーを動かす。SSH トンネルも兼ねる)
ssh -o ServerAliveInterval=30 -L 8000:localhost:8000 root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
git clone --recurse-submodules https://github.com/Physical-Intelligence/openpi.git
cd openpi
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
GIT_LFS_SKIP_SMUDGE=1 uv sync
GIT_LFS_SKIP_SMUDGE=1 uv pip install -e .
uv run scripts/serve_policy.py --env DROID
server listening on 0.0.0.0:8000 が出たら、このウィンドウはそのままにしておきます。
Mac のウィンドウ2(テストを実行する)
cd openpi
source .venv-client/bin/activate
python examples/simple_client/main.py --env DROID --host localhost --num-steps 20
終わったら、ウィンドウ1で Ctrl+C を押してサーバーを止め、Runpod で Pod を「ストップポッド」→ 終了の順に操作して、Pod の一覧から消えたことを確かめます。
次は LIBERO のシミュレータで π0.5 にタスクをさせて動画に残す
この回は、意味のない画像を送って計算時間を測っただけなので、π0.5 が指示どおりに物を動かす場面はまだ見ていません。
openpi には、LIBERO というシミュレータで π0.5 を試す例が入っています。LIBERO は、物理シミュレータの中の台所やリビングの机の上で、Franka Panda(7軸のアーム)に「ボウルを皿の上に置く」「引き出しを開ける」といった作業をさせ、成功したかを自動で判定する試験問題集です。2023年にテキサス大学オースティン校などの研究者が公開し、130のタスクが4つの問題集に分かれています。シミュレータは俯瞰カメラと手首カメラの画像を π0.5 に送り、π0.5 が返した動きのうち最初の5ステップだけを実行して、また画像を撮り直す、という流れを繰り返します。1回ごとの試行は、成功か失敗かの名前が付いた動画ファイルとして保存されます。
openpi の README には、LIBERO 向けに追加学習した π0.5 が4つの問題集の平均で96.85% 成功したと載っています。次の回では、この回と同じ Runpod の Pod の上で、サーバーとシミュレータの両方を動かし、タスクごとに1〜2回の試行を動画に残す予定です。README が推奨する Docker は Runpod の Pod の中では使えないことが多いので、README の「Docker なし」の手順で進めることになります。