MicroFactory と大規模事前学習 ― 賢さをモデルに積むか、環境を作り込むか
MicroFactory については、すでに中身を二度分解している。精度がモデルではなく人間とロボットの変換比で作られていること、ロボットを専用ワークステーションに閉じ込めて環境を固定する設計であること。内側から見れば、あの仕組みは環境の作り込みで不確実性を殺す装置だった。
今回は視点を外に向ける。MicroFactory は、いったい何の対極にあるのか。きっかけになったのは同じ一本のスレッドで、そこには MicroFactory の内部設計とは別の、もっと大きな対比が写っていた。彼らが暗に拒否している路線、つまり大規模な事前学習に賭けるやり方との違いだ。この二つを地図の上に並べ、それぞれ今何ができるのか、汎用型が現場でまともに動くまであとどれだけの距離があるのかを測り、その地図の上に自分の座標を置く。二度の分解で内側は見えた。残っていたのは、その外側だった。実装のログではなく、考えが動いた記録として残す。
名前のない分野
— このスレッドは、そもそも何を主張しているのか。
出発点にあるのは、大規模な基盤モデルではなく、小さなタスク専用データからの純粋な模倣学習を再評価しよう、という主張だった。MicroFactory の Igor Kulakov は、この立ち位置には名前すらない、と切り出す。彼の言い分の骨は、これが実質的にプログラミングと同じ性質を持つ、というものだ。正しく作れば信頼性が高く、予測可能で、修正やデバッグが容易になる。唯一の違いは、真実の源がコードではなく小さなデータセットであること。そしてそれはコンパイルされるのではなく、ビジョンエンコーダとトランスフォーマーで接着されている、と。
彼が持ち出したたとえが印象的だった。Claude Code が、長年の実運用で鍛えられた大量の本番コードなしにいきなり現れるとは考えにくい。ロボットのモデルも同じで、実データという土台なしには生まれない、と。学習を魔法ではなく、コードに相当する資産の蓄積として捉える見方だ。この枠組みでは、モデルの賢さは事前学習の巨大さではなく、集めたデータの質と、それを接着する構造から来る。
このスレッドが面白いのは、その主張に研究者たちが技術的なツッコミを重ねていく点だった。Scott Reed は、多様な事前学習なしで単一タスクを模倣しているだけなのか、と問う。この一言が、次の論点、つまり「事前学習なし」が本当にゼロなのか、という核心を引き出すことになる。経済性の話も具体的だった。産業アーム二本にカメラ、マニピュレーションキット、ローカル推論用GPUを一箱にまとめて、現在の価格は二万五千ドル。タスク一つあたり十分から十五分が出発点で、まさにこうした作業のために作った、と。頭脳を汎用に賢くするのではなく、箱を安く現場に置く。この経済性が、後で見る自律レベルの下側を支える現実的な足場になる。
どんな作業を一つのセルに求めているのかも、やりとりから具体的に見えた。部品をトレイに置く、シリンジで接着剤を出す、POGOピンでPCBに書き込む、USB-Cに挿す、外観検査する、完成品を箱に入れて箱にラベルを貼る。一台の中でこれだけの異なる操作をこなす想定だ。二万五千ドルという価格は、この多工程を一つの箱に畳み込んだうえでの数字になる。汎用の頭脳が一つあれば何でもできる、という方向ではなく、限られた工程を確実に閉じる箱を安く作る、という方向。名前のない分野、と本人が呼んだのは、派手な汎用性の物語からこぼれ落ちる、この地味だが動く領域のことだった。
「事前学習なし」はゼロではない
— 大規模な事前学習を行わない、というのは実際どのくらいの話なのか。
核心は、その「事前学習なし」が実はゼロではない、という点にある。汎化のために事前学習済みのビジョンエンコーダは使っている、と本人も認めている。つまり「なし」と言っているのは、事前学習のある層だけだ。
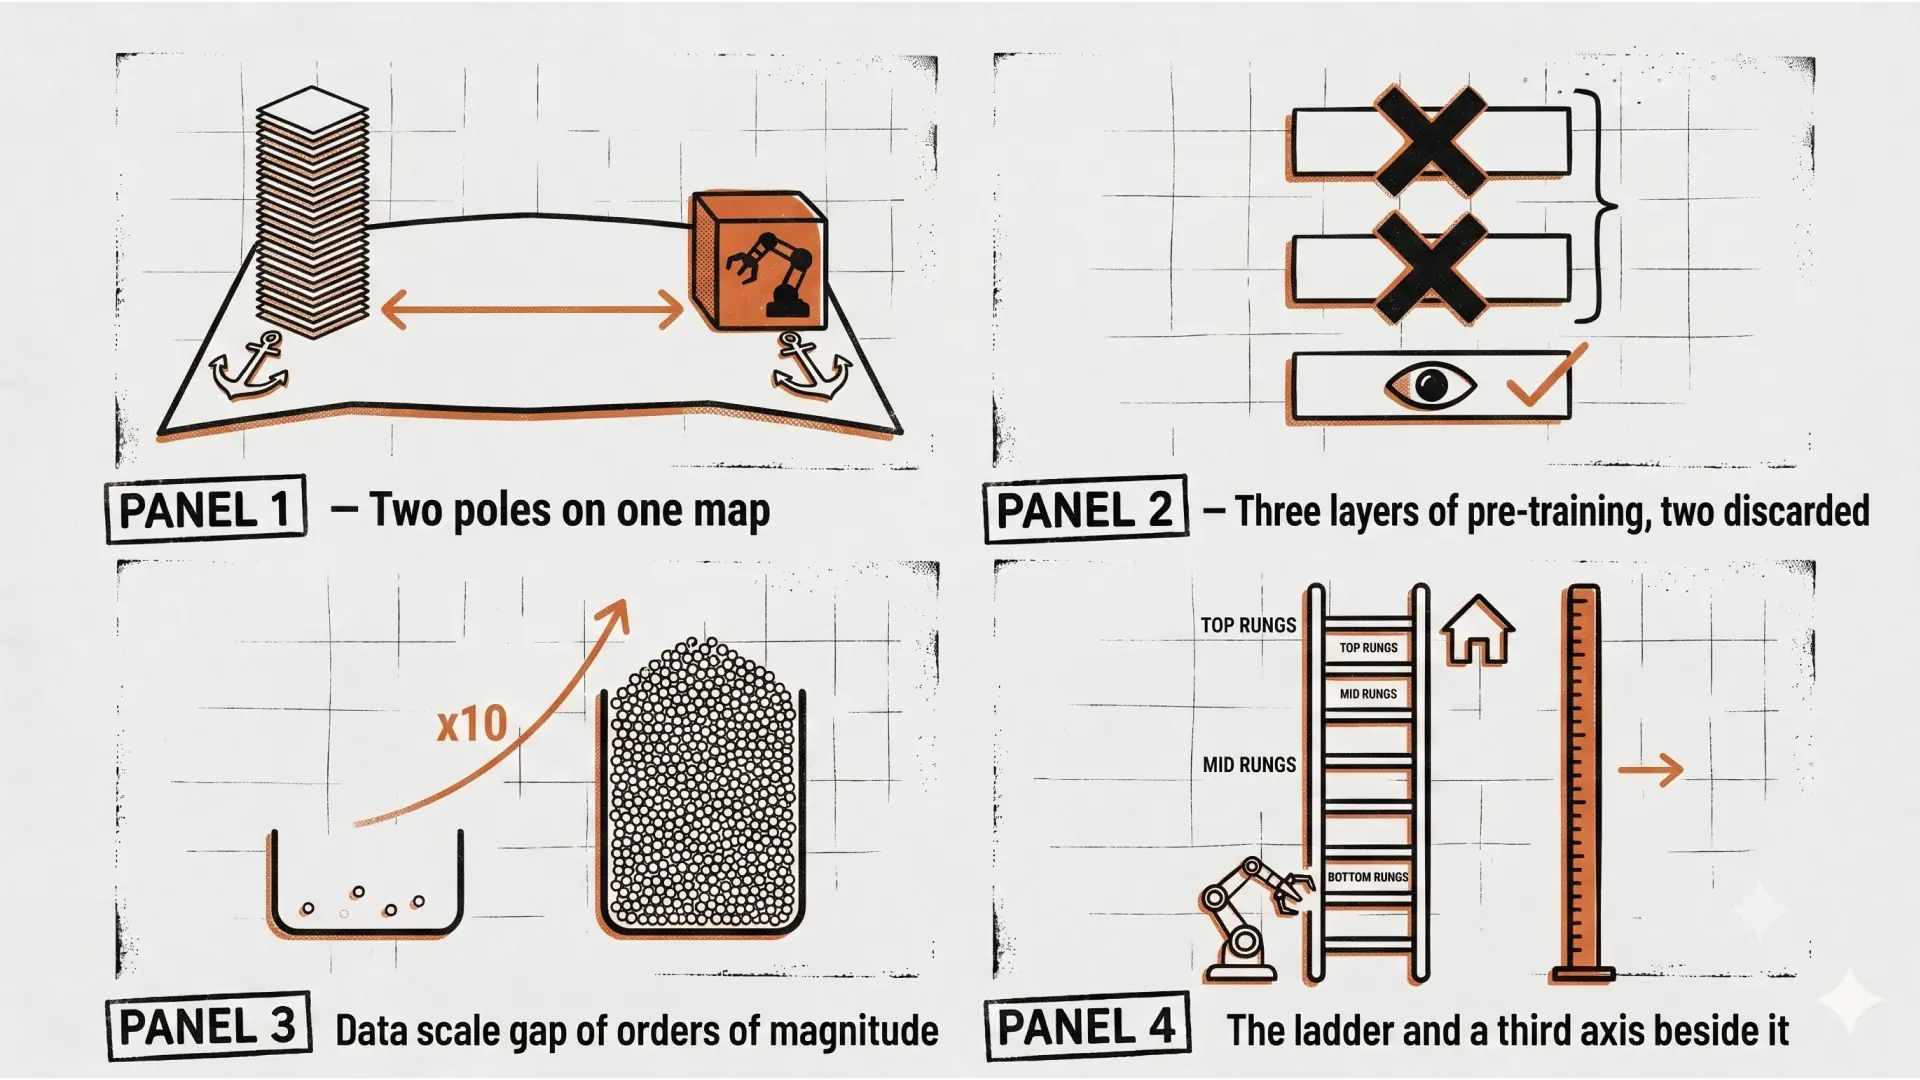
ここを分解すると全体がクリアになる。ロボット学習の事前学習は、本来三つの階層に分かれている。第一の層は視覚バックボーンの事前学習で、ImageNet や DINOv2、SigLIP、CLIP で画像表現を学ぶ層だ。RT-1 の頃から視覚は ImageNet 事前学習済みのエンコーダを使うのが標準だった。第二の層はロボット行動の横断事前学習で、複数タスク・複数ロボットの実機データで方策そのものを事前学習する層。第三の層はネット規模のVLM意味事前学習で、RT-2 や π0 のように、Web画像と言語で学んだVLMの上に行動を載せる層だ。
小データ側が残しているのは第一だけで、第二と第三を捨てている。真実の源をコードではなく小さなデータセットにする、という比喩はこの意味になる。ここが、内部設計を分解していたときには見えなかった座標だ。環境をどう固定するかは MicroFactory の内側の話だったが、事前学習のどの層を使ってどの層を捨てるかは、外の大きな地図の上での立ち位置を決める。
— では、どのくらいの規模差になるのか。
具体的な数字で両極を並べると、桁がまるで違う。決め打ちできない区間だけを担う小データ側の学習は、単一タスクあたり数十から数百のデモで足りる。Action Chunking with Transformers は五十から二百程度のデモで成立し、単純なピック・アンド・プレースなら二十から三十でも動く。Diffusion Policy はもう少し要って百から五百、VLAのファインチューニングなら二十から五十という報告もある。素の behavior cloning が数千のデモを要するところを、ここまで圧縮できる。
一方、大規模事前学習側の代表格である Open X-Embodiment は、百万を超える実機軌跡を、二十二のエンボディメント、五百二十七のスキル、六十のデータセットにまたがって束ねている。OpenVLA 系がその一部を使って学習するときでも、二千二百五十万フレーム規模になる。つまり軌跡数でおおよそ三桁から四桁の差がある。
小データ模倣(MicroFactory側) | 大規模事前学習側 | |
|---|---|---|
データ量 | 一タスクあたり数十〜数百デモ | 百万+軌跡 |
代表値 | ACTは五十デモ程度で成立 | Open X-Embodimentは百万超・二十二エンボディメント |
収集時間 | テレオペ数十分〜数時間 | OpenVLA系の学習で約二千二百五十万フレーム |
対象 | 一ロボット・一タスク | 二十一機関・五百二十七スキルを横断 |
ここで大事なのは、なぜ視覚エンコーダだけは捨てないのか、という点だ。オレンジ色の結束バンドを照明オーグメンテーションなしで学習しても頑健に動く、というデモが示すのは、行動方策が賢いからではなく、DINO や CLIP 級の視覚特徴がすでに照明や見た目のばらつきに強いからだ。第一の層を残すことでタスク内の見た目のズレを吸収し、第二と第三の層を捨てることでタスクをまたぐ汎化を諦める。これがトレードオフの実体になる。
第二と第三の層が何を与えるのかは、一つの例で見える。コーヒーマグを百のデモで掴めるようになったモデルは、そのままでは魔法瓶を掴めない。デモの中に、魔法瓶という視覚カテゴリと、掴める円筒という操作カテゴリを結ぶものが何もないからだ。ネット規模で学んだVLMは、ロボットを一度も動かしたことがなくても、膨大な画像とテキストからその結びつきを知っている。第三の層はこの意味の橋を、第二の層は複数ロボット・複数タスクにまたがる行動の共通表現を与える。小データ側はこの二つを持たないぶん、掴める物体も置ける場所も、集めたデモの範囲に閉じる。閉じているからこそ確実で、閉じているからこそ汎化しない。
冒頭の Claude Code のたとえは、この三層のどこに賭けるかの話でもあった。彼が言いたいのは、賢さの源を第二・第三の巨大な事前学習に置くのではなく、第一の視覚の土台の上に、質のよい小さなデータを載せて接着する、という設計だ。コードの代わりにデータが真実の源になる、という比喩はここに戻ってくる。大量の事前学習で賢くするのではなく、少量でも筋のよいデータを、既にある視覚表現の上で組み上げる。名前がないのは、この配分が主流の物語の外にあるからだった。
賢さをどこに置くか
— 大規模事前学習型と MicroFactory 型の違いを、一枚で捉えると。
大規模事前学習型、たとえば Physical Intelligence の π0 系や Google の RT-2 系と、MicroFactory のやり方は、賢さをどこに置くかが正反対だ。前者は巨大なモデルの中に、後者は物理環境の作り込みの中に賢さを置く。後者の中身、つまり環境の固定と入力の設計は、これまでの分解回で内側からたどった。ここで見たいのは、その作り込みが「何の代わり」になっているのか、という対比のほうだ。
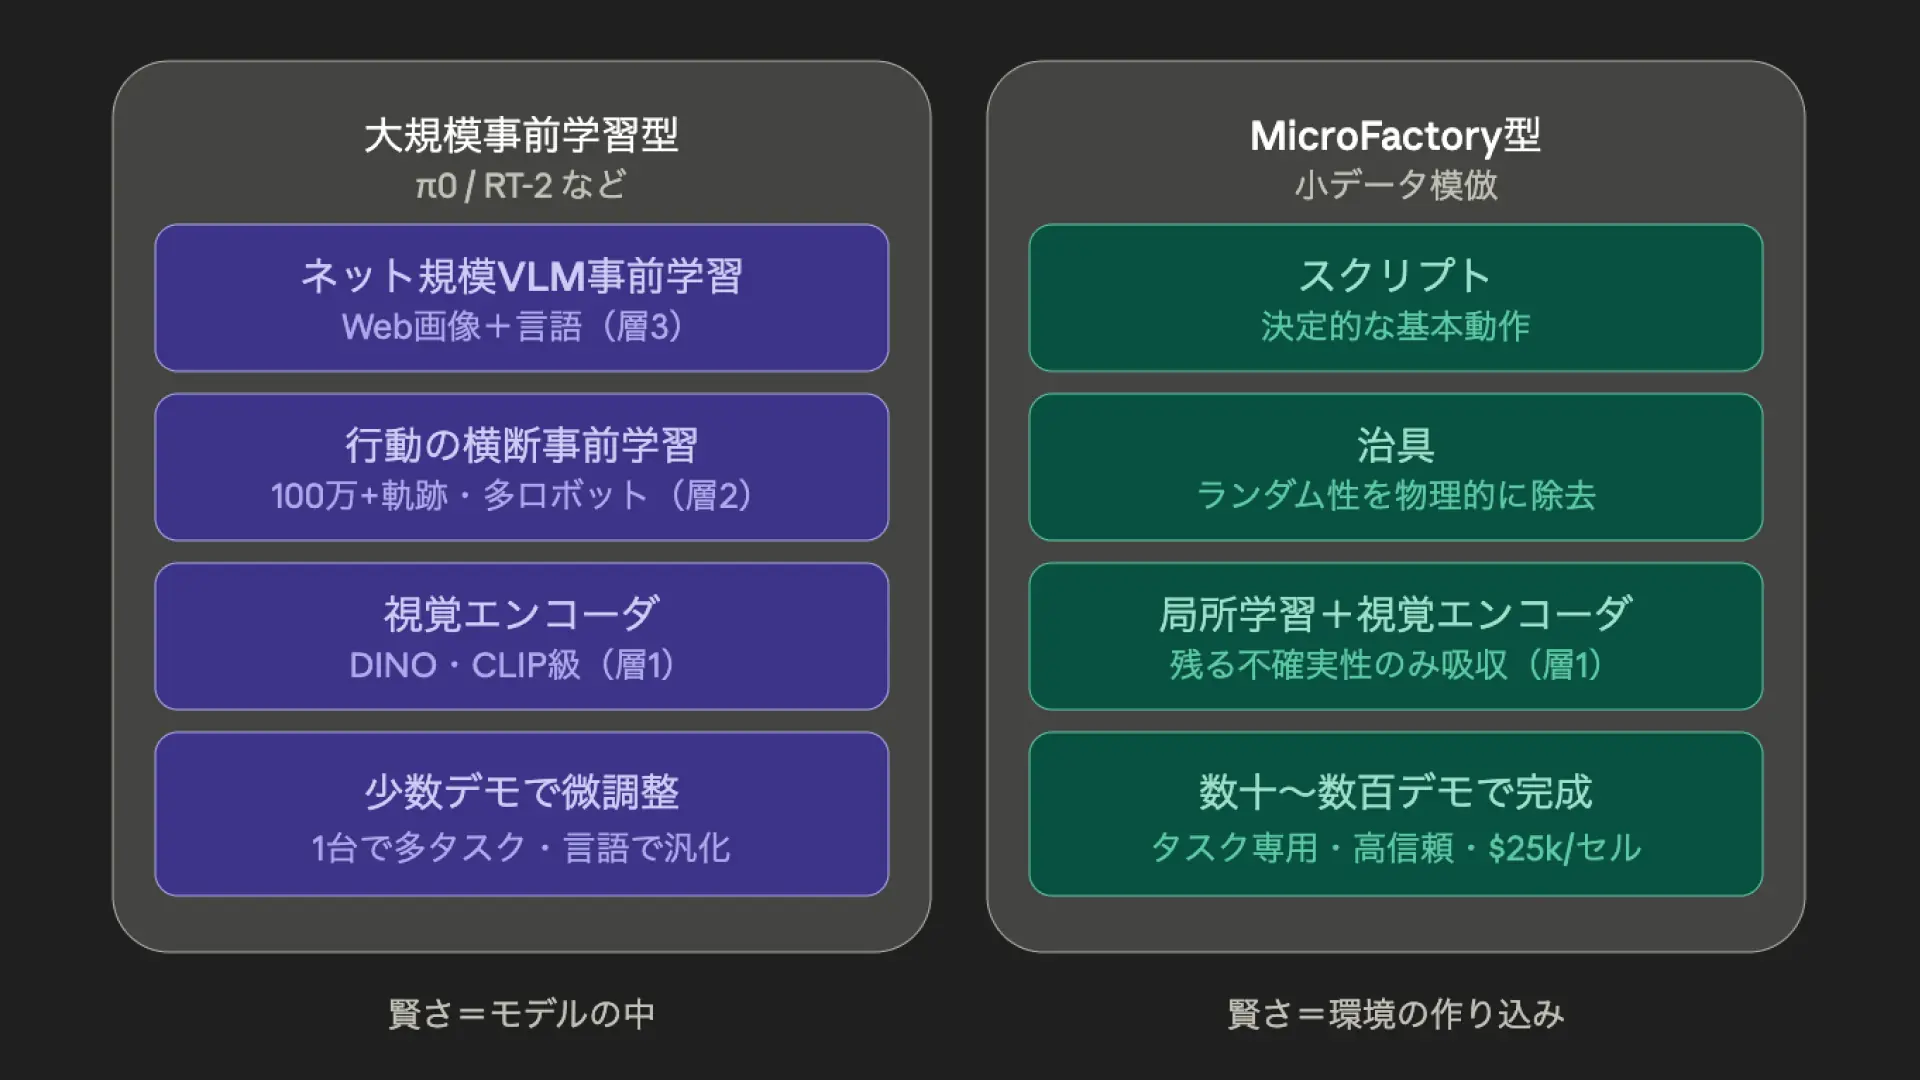
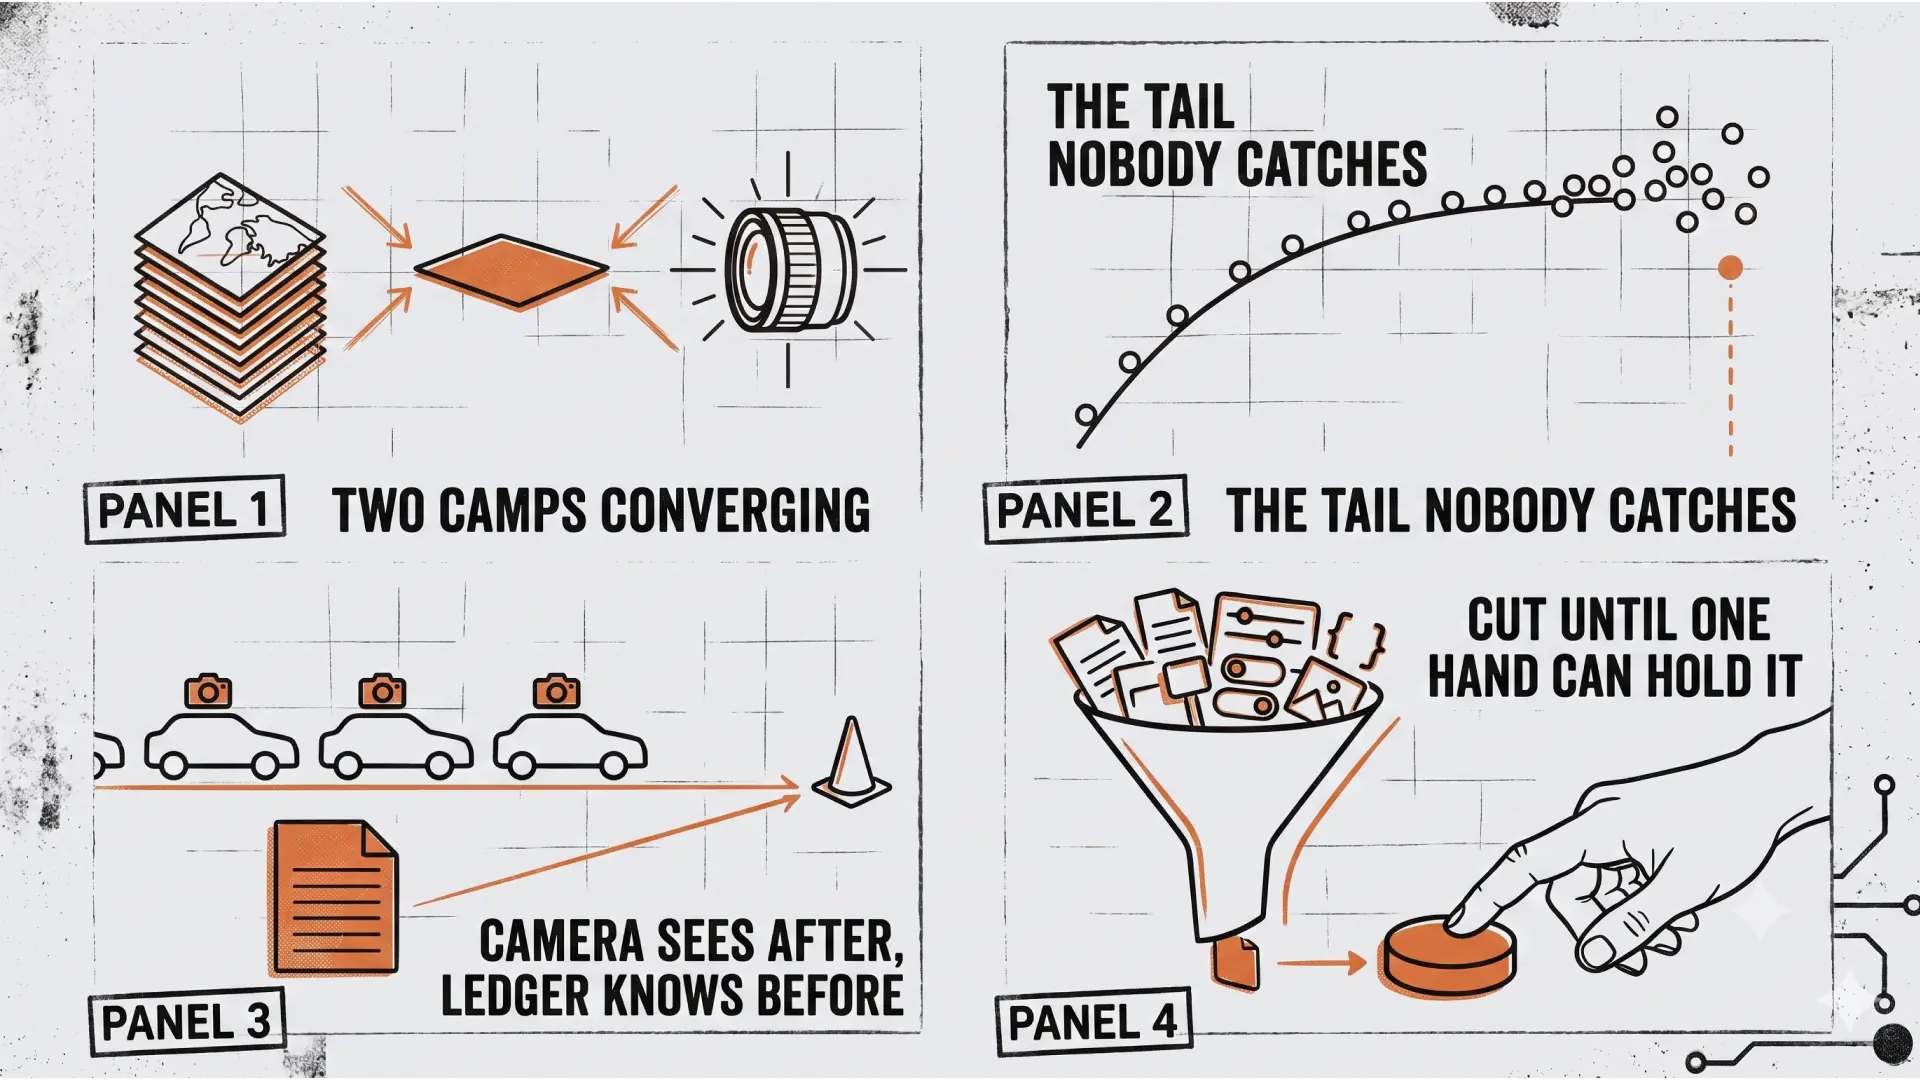
二つのスタックは積み方が逆になっている。左は下から上へ事前学習を積み上げて賢さをモデル内部に蓄え、最後に少数デモで微調整する。右は環境を作り込んで不確実性を物理的に削り、残ったところだけ薄く学習を乗せる。同じ不確実性を減らす仕事を、左はデータで、右は環境で解いている。内部設計の回では右の列の中身だけを見ていたが、こうして左と並べると、右の作り込みは「大規模データを集めずに済ませるための代替手段」だったと分かる。
決定的な違いを軸で整理すると三つになる。ひとつ、汎化の方向が違う。大規模事前学習型はタスクをまたぐ汎化を狙う。ネット規模のVLMを土台にするので、見たことのない物体でも言語で指示すれば拾える可能性がある。MicroFactory 型は逆で、汎化を捨てて一タスクを確実にやる。信頼性が高く、予測可能でデバッグしやすいというのは、汎化を諦めた見返りだ。ふたつ、コストと設置形態が違う。大規模型は巨大データと学習計算が前提で、モデル開発そのものが重い。MicroFactory 型は一セル二万五千ドルで、産業アーム二本とカメラとGPUを箱にまとめて現場に置ける。前者は賢い頭脳を配り、後者は専用ラインを配るビジネスだ。みっつ、残った不確実性の飲ませ方が違う。大規模型は不確実性をモデルに全部飲ませようとする。MicroFactory 型は環境でまず殺し、殺しきれない分だけを局所学習に回す。だから MicroFactory の学習方策は薄くて済み、少数デモで完成する。
この三つの違いは、失敗の起き方にも表れる。大規模型は分布の外に出た瞬間に脆くなる。訓練で見た軌跡を丸暗記している面があり、状況が少しズレると誤り、その誤りが次の観測をさらに分布の外へ押し出して連鎖する。誤りから復帰する仕組みを、まだほとんど持っていない。MicroFactory 型は、そもそも分布の外に出ないように環境を先に狭めてあるので、この連鎖が起きにくい。代わりに、狭めた範囲の外のことは何もできない。前者は広く浅く危うく、後者は狭く深く堅い。どちらが良いかではなく、どちらの性質が要る現場か、という問いになる。
この対比で見落としてはいけないのは、二つが排他ではないことだ。左の大規模事前学習型が成熟して視覚・行動の土台が安価に手に入るようになれば、右の MicroFactory 型はその土台を第一の層として取り込み、環境の作り込みをさらに減らせる。内部設計の回で見た「作り込みの重さ」は固定ではなく、左の型の進歩とともに軽くなっていく変数だった。
いま、それぞれに何ができるのか
— そもそもできることが根本的に違いそうだが、現時点で洗い出せるか。
両者の能力を分ける軸は、結局二本に集約される。未知への対応力、つまり環境や物体やタスクが変わったときの強さと、特定タスクの確実性、つまり同じことを何度も外さず速くやる力だ。大規模事前学習型は前者に、MicroFactory 型は後者に振り切っている。現時点の実力で洗い出す。
大規模事前学習型だけが今できることは三つある。ひとつ、見たことのない環境での動作。π0.5 は訓練に含まれない新しいキッチンや寝室でも片付けタスクをこなせる。ただし目的は新スキルや高い器用さではなく、あくまで新しい設定への汎化で、一発では成功しないことも多い。ふたつ、言語での指示と未知物体への対応。左の棚の赤いドライバーを取って、のような自然言語コマンドで動く。ネット規模のVLMを土台にしているので、訓練データにない物体でも意味を推測できる。みっつ、意味的な多段推論。π0.5 は次に何をすべきかという高レベルの意味推論と低レベルの動作予測を両方行う。散らかった部屋を片付けるような、状況を見て手順を組み立てる長尺タスクに向く。
MicroFactory 型だけが今できること、あるいは圧倒的に得意なことも三つある。ひとつ、量産レベルの信頼性と再現性。決め打ちできる部分はスクリプト、位置は環境の作り込みで固定するので、同じ動作を外さず繰り返せる。逆に大規模型はここが弱点で、模倣学習ベースのVLAは軌跡を丸暗記しがちで、訓練分布から少しズレると失敗し、一度の失敗が連鎖して全体が崩れる。産業ラインに置けるのは現状こちらだ。ふたつ、高精度・高器用度の特定作業。ネジ締めや微小部品の挿入のような精密作業を、決め打ちと専用化で担保できる。π0.5 は明示的に高い器用さは目標ではないと言っており、精度が要る単一タスクではこちらが上になる。みっつ、低コストで現場に置ける。一セル二万五千ドルで納品でき、巨大モデルの開発・データ収集という重い前段が要らない。
両方できるが、やり方が違うことを表にすると輪郭が出る。
できること | 大規模事前学習型 | MicroFactory型 |
|---|---|---|
長尺の多段タスク | 意味推論で手順を組む | 手順を人がスクリプトで組む |
新タスクの立ち上げ | 再プロンプト+少数デモ | 環境の作り込み+テレオペ収集 |
ばらつきへの対応 | モデルが飲む | 環境で殺し、残りだけ学習 |
誤りからの復帰 | 弱いが萌芽あり | スクリプト範囲外は不可 |
現時点での正直な限界は両者共通してある。大規模型の汎化も過大評価は禁物で、VLAは変動の大きい環境・新物体・照明変化に依然弱く、性能が最も出るのは倉庫や研究室のような半構造化された環境だ。つまりどんな家でも完璧ではなく、馴染みのある構造なら新場所でもそこそこ、という水準になる。いっぽう MicroFactory 型は、作り込みで殺しきれない不確実性、たとえば変形するケーブルのようなものが残り、そこは薄い学習に頼らざるを得ず、作り込みという手作業のコストが常に残る。
具体的な現場で想像すると差が見える。毎日違う家庭に入って、その日初めて見る食卓を片付けるなら、環境を先に固定できないので大規模型しか選べない。逆に、同じ部品を同じ向きで一日に何千個も組み立てるなら、汎化はむしろ邪魔で、狭く固めた MicroFactory 型のほうが速く確実だ。前者は環境が毎回変わることが前提、後者は環境を変えないことが前提。この前提の違いが、そのまま二つの型の境界線になる。この洗い出しで見えるのは、両者が競合ではなく用途で棲み分けていることだ。どちらが勝つかではなく、どの現場をどちらが取るか、という地図になる。
自律レベルと、汎用型が現場に届くまでの距離
— 大規模型の汎化が現場でまともに動くには、どのくらいの学習が必要と考えられているのか。
自動運転車のようにレベル分けのような基準があると理解しやすそう
自動運転の SAE レベルにあたる枠組みは、ロボット側でも複数提案されている。BCG や SemiAnalysis が出している五段階から六段階の分類が代表的で、考え方は自動運転とよく似ている。この枠組みが便利なのは、二つの型を同じ物差しの上に並べ直せることだ。内部設計の分解では見えなかった、業界全体の中での高さが測れる。
枠組みは提案者によって細部が違うが、輪郭は重なる。L0は数十年前から工場を回してきた固定・ティーチングの産業自動化。L1からL2は、知覚を使って半構造化された環境で柔軟に扱う段階で、倉庫や研究室ではすでに実用に入っている。L3は器用な操作、つまり接触が多く、変形する物や向きの定まらない物を、知覚と運動と力を協調させて扱う段階。ここが今のフロンティアで、一つの機体・一つの訓練設定に強く依存するという但し書きが付く。L4は力と重さの理解が要る繊細なタスク、たとえばネジを正しいねじ山に沿って締める、ポケットの中の携帯を探り当てるといった作業と、高レベルの目標から手順を自分で並べるワークフロー計画。L5が、あらゆる環境とタスクをこなす完全自律で、ここには因果推論という未解決の課題が残るとされる。
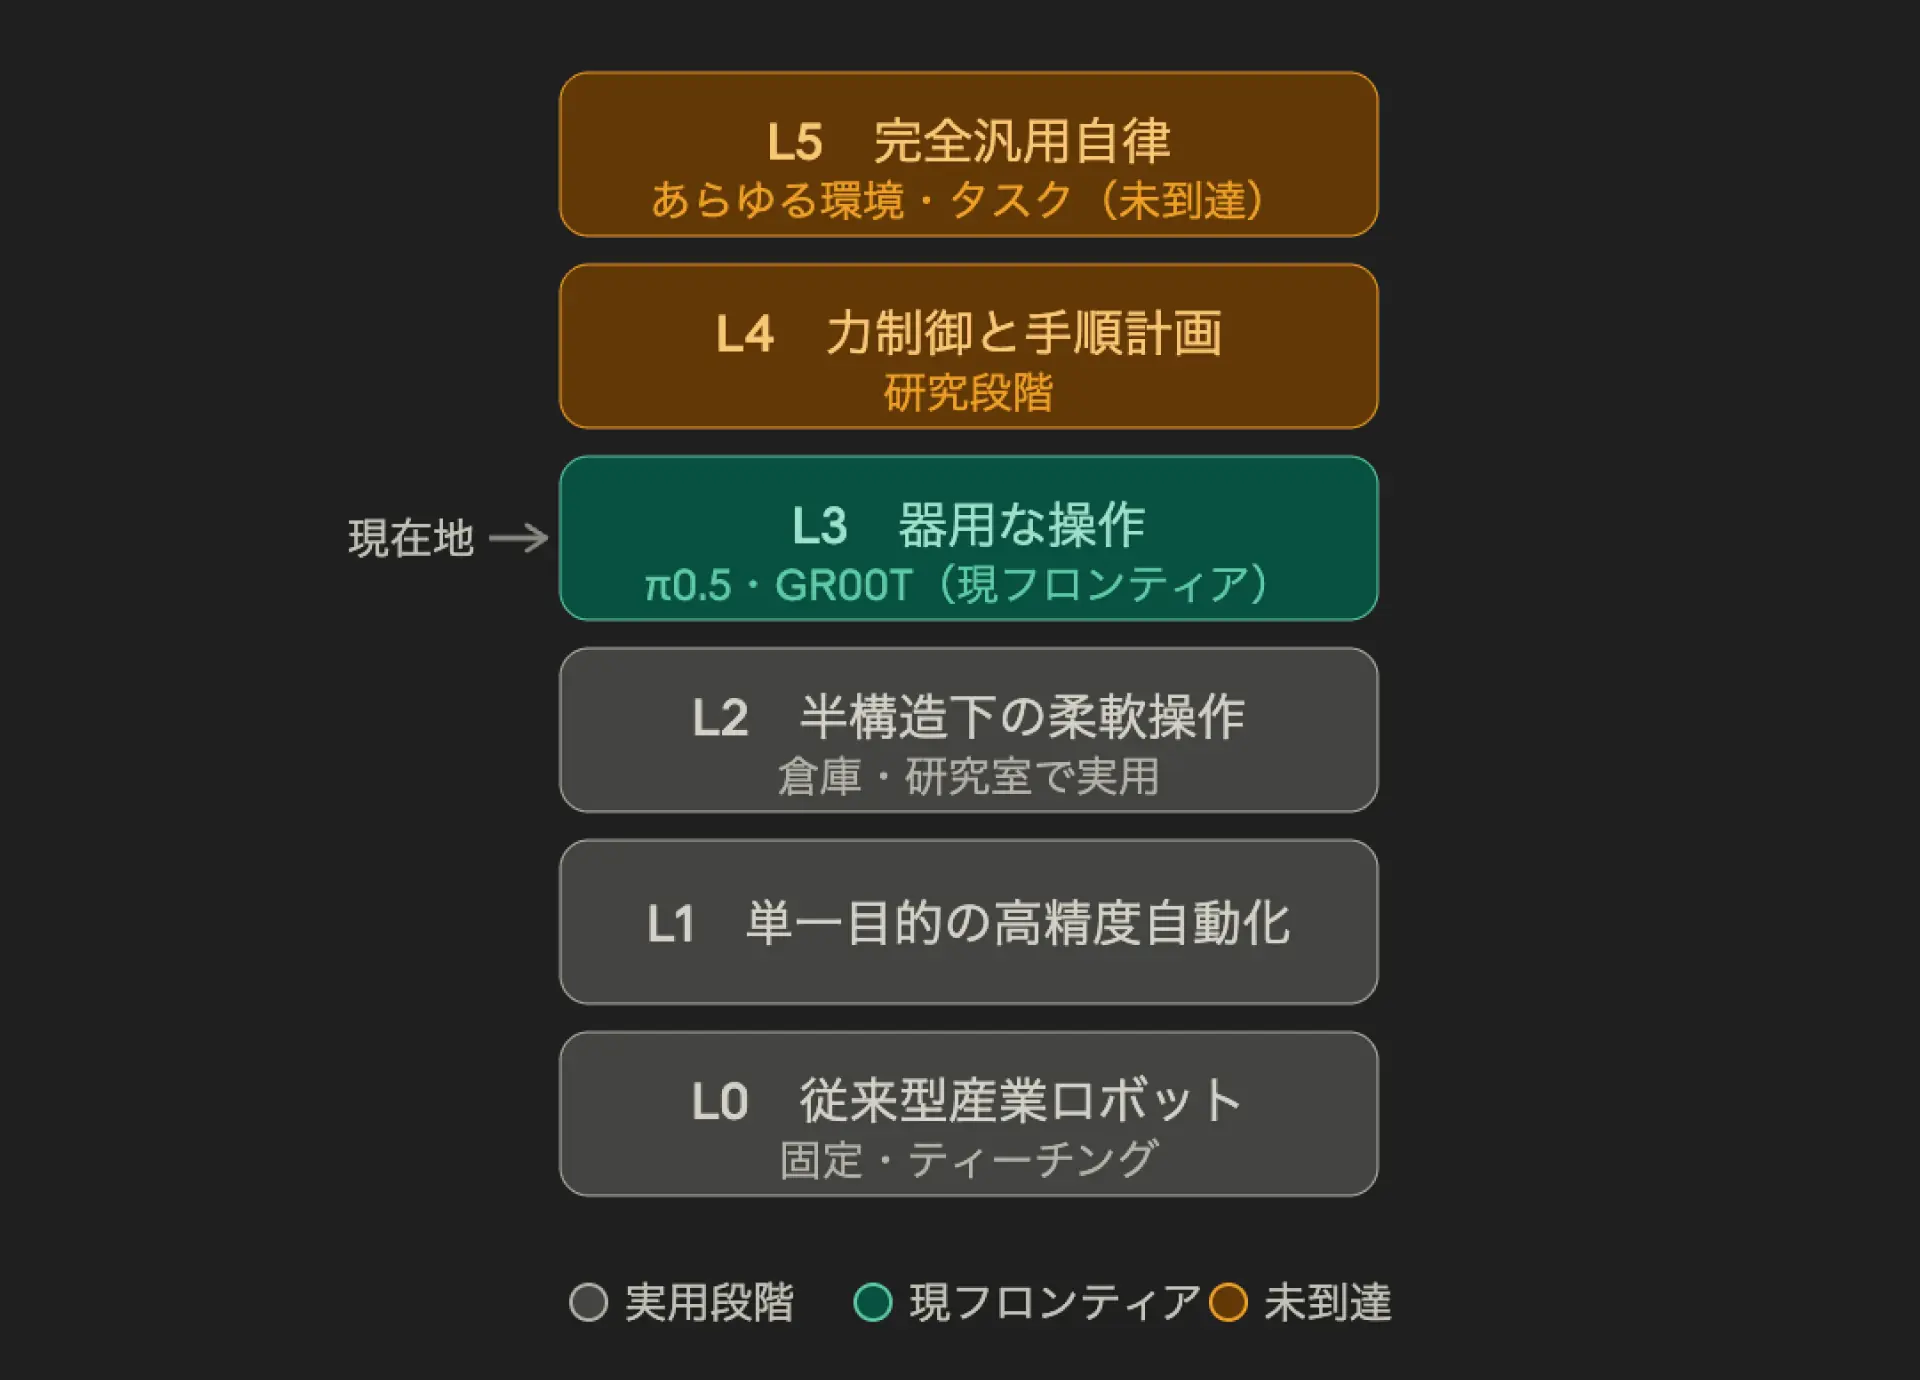
自動運転と同じで、レベルが上がるほど必要データが指数的に増えるのがこの分野の共通見解だ。認識率を高く保って現場で回る、に必要な量を、今わかっている数字で埋める。
今の最前線である L3 がどれだけ食べているかを見ると、π0.5 は約百種類の環境から集めたロボット実演とWebと他ロボットのデータで、初めての家でも片付けができる段階に到達した。オープンな Open X-Embodiment で百万軌跡、二十二エンボディメント。GR00T のような基盤モデルも同規模の混合データだ。これで届くのが、半構造化環境なら新しい場所でもそこそこ動く、ただし一発では失敗も多く、誤りから復帰できない、という L3 の実力になる。
L4以上、つまり現場で信頼できる水準に何が要るかがここでの本題になる。二〇二五年末に Generalist AI が公開した GEN-0 は、約二十七万時間の実世界操作データ、数千の家・倉庫・職場から収集したものを使って学習し、しかもスケーリング則を実測している。彼らの推定では、たとえば衣類ハンドリングのような複雑なタスク族で狙った性能に届くには約十億軌跡が要る、という桁を出している。別の試算でも、一スキルを新環境・新物体へちゃんと汎化させるにはタスクあたり三十二の環境と物体の組み合わせが必要で、単一スキルの約二千五百倍のデータが要るとされる。つまり現在の最大級データセットから、さらに二桁から三桁上、というのが現場実用ラインの見積もりになる。
レベル | 状態 | 必要データの目安 |
|---|---|---|
L3(現在地) | 新環境でそこそこ | 百万軌跡+Web事前学習 |
L4(力制御・手順) | 研究段階 | 数億〜十億軌跡クラス |
L5(完全汎用) | 未到達 | 桁が読めない/因果推論が別途必要 |
GEN-0 の実測が示したのは、データ量から性能をあらかじめ予測できるという点だ。言語モデルで確立した、計算とデータを増やせば性能が読める通りに上がるというスケーリング則が、ロボット操作にも当てはまり始めている。つまり、あと何倍のデータでどの水準に届くかを、事前に見積もれるようになった。これは同時に、その何倍が現実に集められるのか、という問いを突きつける。十億軌跡を物理的に集めるには、何千台もの機体を何年も動かし続ける必要がある。
なぜ自動運転より難しいと言われるのか。決定的な違いはデータの出所にある。言語モデルはネットから兆単位のトークンをタダで集められるが、ロボットの操作データは物理的に手を動かして集めるしかなく、合成では同じ質が出ない。GR00T の論文はこれをデータの島々と呼び、ロボット版のインターネットが存在しないことを最大の壁に挙げている。各社はこの壁を、人間の作業動画やシミュレーションで合成したデータで埋めようとしている。GR00T は実機軌跡に人間動画と合成データを混ぜて学習する二系統の構成を取る。それでも、実際にロボットの身体で物理接触を経た軌跡の代わりにはなりきらない。言語のように自己教師ありで無限に増やせる素材が、この領域にはまだ無い。自動運転が L2 から L3 で長く足踏みしている、ラスト一マイルが指数的に重い構図が、操作ロボットではデータ収集コストの形でさらにきつく出る。
この距離の見積もりは、いつ何に賭けるかを分ける。汎用型が現場実用に届くのを待って設計するなら、二桁三桁のデータが集まるまで動けない。届く前提を外して、今ある部品で体験を成立させるなら、待つ必要はない。二つの型のどちらを選ぶかは技術の優劣ではなく、どの時間軸で何を成立させたいか、という判断になる。そしてその間は、L0 から L2 の、環境の作り込みと薄い学習で確実にこなす MicroFactory 型が、産業現場では合理的であり続ける。二度の分解回で見た作り込みの重さは、この距離がある限り、無駄ではなく合理として残る。
立ち位置
全体像が見えて、今いる自分の立ち位置と世界のレベルがはっきりとクリアになった
大規模事前学習型は自律レベルの上、L3からL5を目指してデータを積み上げる。MicroFactory 型は下、L0からL2を環境の作り込みで固める。二つは競合ではなく、レベル軸の上下で役割を分けている。そしてこのプロジェクトが立っているのは、そのどちらとも少しズレた場所だ。量産精度も汎化も第一の目的にせず、動く体験を最速で成立させる。精度はあとから解決できるという設計思想は、レベルを競う軸そのものの外側に立っている。上を目指すのでも下を固めるのでもなく、まず人が触れて動く一点を作る、という別の目的がそこにある。
内部を二度分解しても出てこなかったのは、この外の座標だった。MicroFactory を内側から見ると環境固定の装置だが、外の地図に置くと、それは大規模事前学習の対極にある一つの極でしかない。そしてその二極が張る平面の、さらに横に、体験の成立を測る別の軸が引ける。iPhoneとUnityだけでロボットが物を掴む動作を個人が作る、という問いは、精度でも汎化でもなく、その第三の軸の上で意味を持つ。
この座標は、勝ち負けの話ではない。大規模型が上を取り、MicroFactory 型が下を固め、その二つが業界の高さ方向を分け合っている。そこに割り込んで同じ梯子を登ろうとすれば、データでも資本でも敵わない。だが、体験が成立しているかどうかという問いは、その梯子のどの段でも、まだ誰も専有していない。動きの質、共存の安全感、意図の読みやすさ。これらは精度や汎化の数字とは別の物差しで測られる。人と並んで働くロボットが、次に何をするか読めること。動きが速すぎず、危うさを感じさせないこと。学習しやすい身体の設計。こうした質は、成功率何パーセントという一つの数字には畳み込めない。梯子の上と下で競われているのは到達精度と汎化率で、この物差しはそこには載っていない。梯子を登るのではなく、梯子の横に自分の物差しを立てること。それが、二極の地図を描き終えて見えた結論だった。
大規模型が上を、MicroFactory型が下を取り合う自律レベルの梯子の、その横に、体験の成立を測る第三の軸を引くこと。それがこのプロジェクトの座標だった。