MicroFactory を分解する ― ロボットを専用ワークステーションに閉じ込めて環境を固定する設計
手作業を自動化する汎用ロボットを、卓上サイズの「工場」として売っている会社がある。MicroFactory。2本の産業用アームを、外の環境から切り離した透明な作業ブースに収め、コードではなく人間のデモンストレーションで動きを教える。Founders, Inc. のインタビュー動画で、創業者のIgorが自分でペダルを踏み、テレオペのハンドルで基板にコネクタを挿し込んでみせている。ヒューマノイドを作らず、囲われたワークステーションに振り切ったこの構成を分解していくと、「変動を一点に集める」という一本の設計原則が見えてくる。この記事は、その分解の記録になる。
MicroFactory はロボットをワークステーションごと囲って環境を固定する
公式サイトの製品紹介に、囲われているが透明なワークステーションとして提供する、という一節がある。ここに最初に引っかかった。
— なぜ、わざわざロボットを箱に閉じ込めるのか。
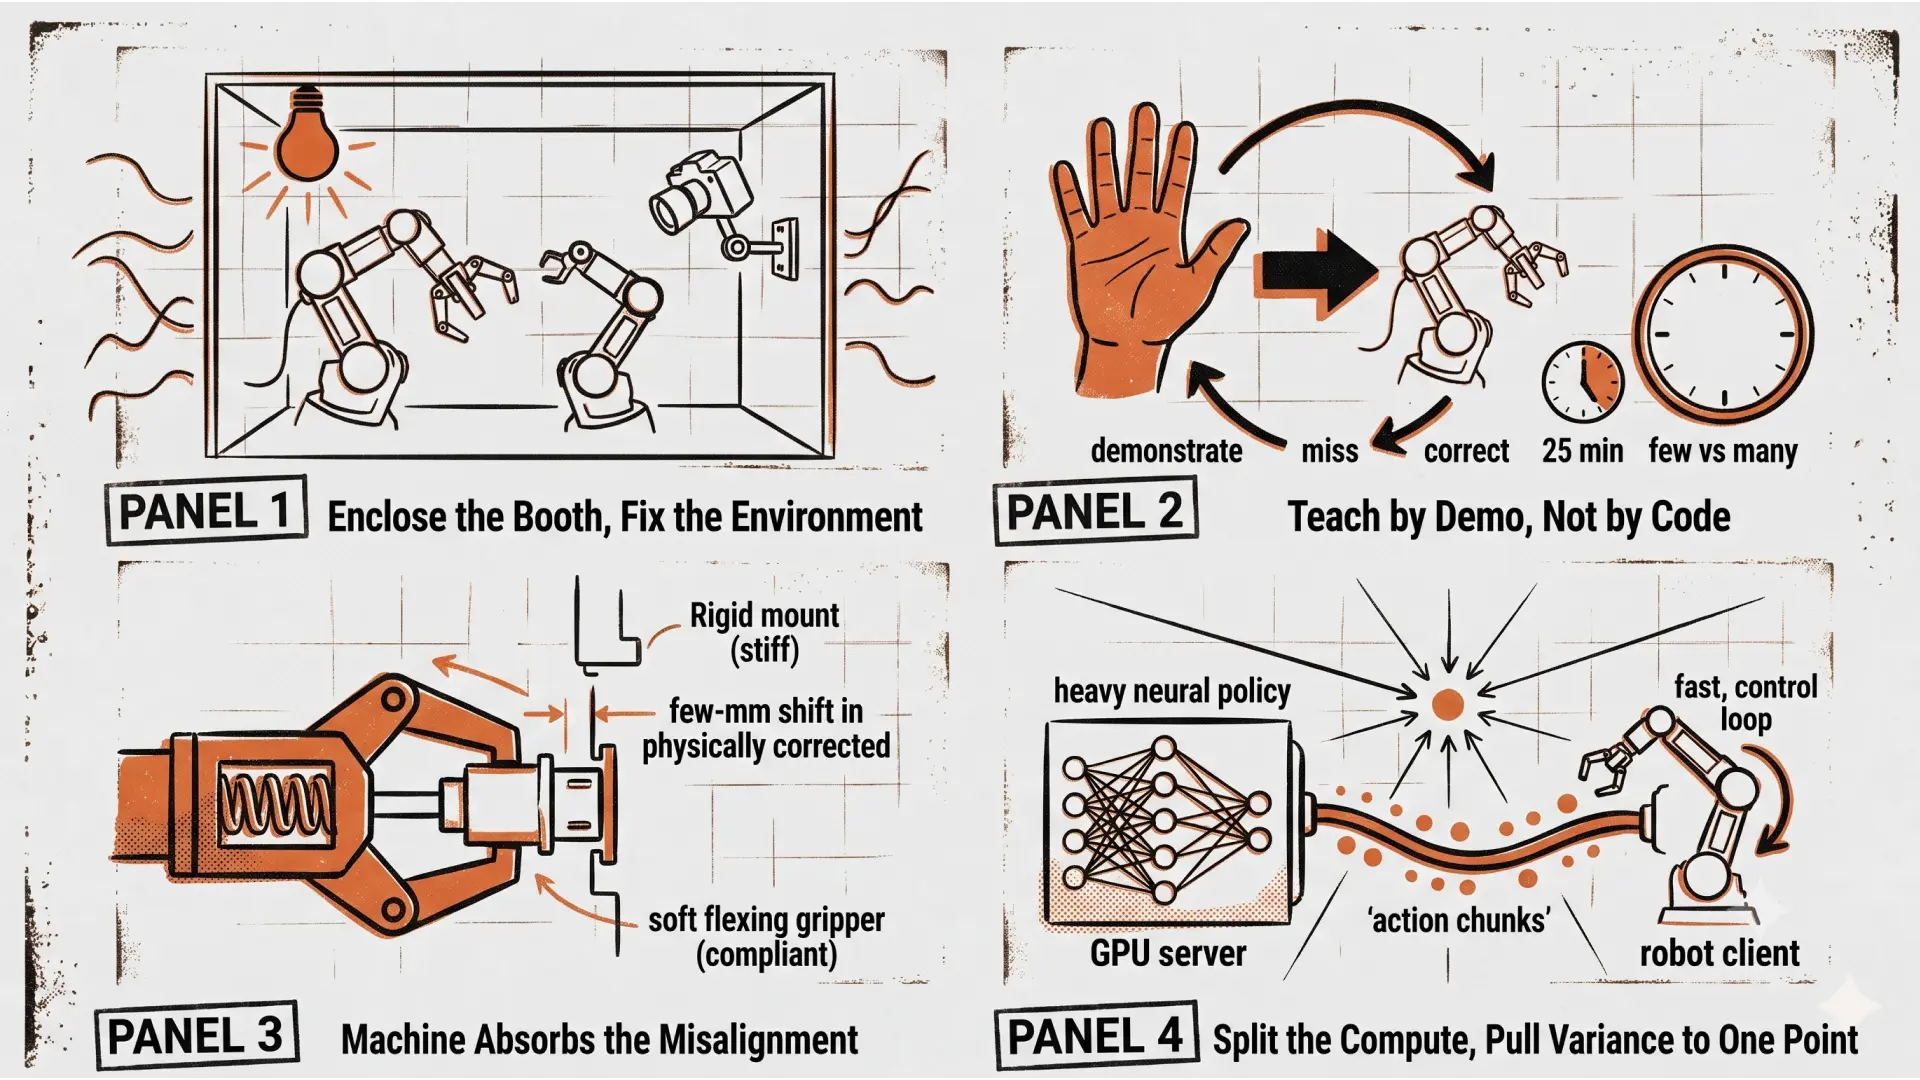
ロボットは環境が変わるたびにキャリブレーションが要る。そのコストは小さくない。照明が変わる、カメラの位置がずれる、それだけで同じ命令が別の結果を生む。MicroFactory はその変動を、専用の作業ブースで囲って光とカメラ位置を固定することで、何かがモデルに届く前に消している。彼ら自身も、この設計によって照明とカメラ位置が安定し、学習が容易になり、データの転用性が上がり、家庭でも職場でも物理的に安全になる、と説明している。
ここで言葉にしておきたい原則がある。ロバストなロボットは、変動を消しているのではなく、変動を一点に集めている。照明・カメラ位置・座標基準・駆動再現性・推論周期──試行のたびに暴れうる変動源を、どこか一つの管理点に引き込んで固定し、そこから先だけを学習と制御に渡す。散らばると、どこでズレたか言えなくなる。MicroFactory はその管理点を、物理の作業ブースに置いた。ブースは見た目こそ地味だが、彼らの設計思想の中心にある。
AIモデル Loop Model 1 は、少ないデモで多くのタスクをこなす
ブースが環境を固めるとして、モデル側は何をしているのか。MicroFactoryの頭脳が、彼らが「Loop Model 1」と呼ぶ独自のハイブリッドAIモデルだ。結束バンド挿入タスクにおいて、Physical Intelligence の「Pi06 + RLT」に対しデータ単位あたり20倍のスループットを達成した、と主張している。重要なのは「データ単位あたり」という限定で、絶対性能ではなくデータ効率での比較を前面に出している。彼らの比較では、学習データ25分・成功率95〜100%、対する Pi06+RLT が学習データ5〜10時間・成功率85〜90%、という数字が並ぶ。
設計思想は「コードのように信頼でき・予測でき・編集できる一方、物理世界のランダム性も扱える」という一節に凝縮されている。運用は3ステップのループになっている。ばらつきのある部分だけをテレオペで見せ、高レベルの動きは一貫させて最終位置合わせはモデルに任せる。外したらロボットを戻して微修正し、モデルがその調整から学ぶ。数回で安定したら、アトミックな操作をループに連結する。そしてこのモデルはタスク非依存で、同じ原則でどんな操作でも訓練できる。だからこそ結束バンド挿入という1タスクの数字を、そのまま多様な業務への対応力の証明として提示できる。
— この「データ効率20倍」は、どこから出てくるのか。
ここから先はアーキテクチャの公開情報ではなく、既知研究に照らした読みになる。オープンループの定型動作と視覚運動方策を組み合わせる発想は、学界で Hybrid-Diffusion と呼ばれる系譜に近い。決定論的に書ける部分はルーチンで固め、ばらつきのある最終位置合わせだけを学習方策に任せる分業だ。もしこの読みが正しければ、データ効率の出どころも説明がつく。直線移動のような本来決定論的な部分まで模倣学習し直せばデータを食うが、ばらつき部分だけに学習を集中させれば、25分のデモでも成立しうる。
コンプライアンス・グリッパーが、位置ズレを機械で吸収する
MicroFactoryのキットには、精密作業用のコンプライアンス内蔵グリッパーと、粗動作用のコンプライアンス付きマウントの二段構えが入っている。これは偶然ではなく、ハイブリッド方策の必然だ。
学習方策は最終位置合わせに数mmの残差を残す。それをゼロにするのをモデルに要求すると、途端にデータ効率が落ちる。そこで機械側に逃げ(コンプライアンス)を持たせ、残差を物理的に吸収させる。挿入時に少しズレていても、受動的なバネやたわみが位置を修正してくれる。動画でIgorが「非常に正確である必要がある」と言いつつコネクタを挿せていたのは、モデルの精度ではなくハードのコンプライアンスが最後を詰めているからだ。粗動作用マウントと精密用グリッパーで剛性を段階分けしているのも、大きな移動は固く速く、最終接触だけ柔らかく、という切り分けになる。コンプライアンスは精度を機械で買う典型で、モデルを賢くする代わりに、機械が寛容になっている。
MicroFactory が攻めているのは「動作設計の工数」だ
MicroFactory の三点セット「環境をブースで固定 → タスク非依存モデルにデモで教える → 失敗を人が微修正して学習ループを回す」は、突き詰めれば動作設計の工数への攻撃だ。
従来の産業用自動化では、ある機体で作った動作は別の機体では作り直しになり、その作り直しこそがSIerの工数の正体だった。MicroFactory はそれを、コードを書かせず・デモで教えさせ・外れたら微修正させることで削っている。専門のエンジニアがいなくても新しいタスクを立ち上げられる。しかもモデルがタスク非依存だから、基板組み立て・はんだ付け・ケーブル配線から食品加工まで、同じブースに別のデモを見せるだけで移れる。「業務ごとに専用機を作る」のではなく「同じ箱に別の手本を見せる」。彼らが多様な業務に対応できると言えるのは、この構造があるからだ。
— なぜ電子機器の組み立てから始めたのか。
電子機器を組み立てられれば、最初のユースケースとして自分自身のコピーを組み立てられる。Igorが掲げる長期テーマは「自己複製するロボットを作る」ことで、電子機器から始めたのは、ロボットが他のロボットも作れて、完全自動の生産ラインの基盤になるからだと説明している。工数削減の先に、生産そのものの自動増殖を見ている。
ローカル推論は、GPUサーバとロボット制御クライアントに分ける
ここからはブースの物理仕様ではなく、計算機側の話になる。完成型のスペックに「local inference」と書かれているが、この一語の裏には、この種のハイブリッド方策は一台のPCでは快適に回らない、という事情がある。性質の違う2つの計算機に分けることになる。GPUマシン上でニューラル方策を動かす層と、ロボット本体を制御して観測を送る層だ。オープンソースのロボット学習基盤 LeRobot の設計がまさにこの2層で、前者を Policy Server、後者を Robot Client と呼び、gRPC で結んで観測をストリームし、アクションのチャンクを受け取る。
なぜ分けるか。方策推論は重くて遅い一方、制御ループは高頻度・低ジッタで回す必要がある。同じプロセスに同居させると、重い推論が走るたびに制御ループがつっかえる。だから低遅延で回すクライアント側と、重い推論を引き受けるGPUサーバ側を物理的に分離する。MicroFactory が local inference を作業ブースにバンドルして売っているのは、要するにこのGPUサーバ側を同梱している、ということだ。
分離しただけでは推論待ちのラグは消えない。本命が、非同期推論とアクションチャンクの組み合わせになる。方策が一度に複数ステップ分のアクション列を予測し、ロボットがそのチャンクを実行している間に、サーバは次のチャンクを計算しておく。こうすると推論を待って止まる時間が消え、遅いモデルでも滑らかに動く。ロボットの低レベル制御はハードリアルタイムで典型的には5ms周期でコマンドを要求するが、方策は20ms周期程度で指令を出せばよく、1周期落としても即フォルトにはならない。この速い層と遅い層の周期差を、チャンクとバッファが吸収している。
必要な GPU は、モデルのVRAMでほぼ決まる
必要なGPUは、どのクラスの方策を載せるかでほぼ一意に決まる。実測の目安として、代表的なVLA(Vision-Language-Action)モデル Pi0(30億パラメータ)は推論時に約14GBのVRAMを占有し、軽量な SmolVLA は約2GBで済む。整理すると次のようになる。
VLA級の重いモデルを載せるなら、24GBクラスの消費者向けGPU(4090級)があると余裕がある
ACT や SmolVLA のような軽量方策なら、もっと控えめなGPUでも回る
Loop Model 1 の実サイズは非公開だが、「25分のデモで立ち上がる・データ効率で20倍」という主張からすると、巨大VLAをフル推論しているというより、比較的軽量な方策とルーチンの組み合わせに寄っている可能性が高い
推論レイテンシの感覚も持っておくと設計が楽だ。RTX 3090 Ti で、最も重いタスクでも10ステップのアクションチャンク1つを約0.24秒、軽いタスクなら0.1秒未満で出せるという報告がある。データセンターGPUが要るのは学習側であって、推論側は消費者向けのハイエンド1枚で成立する領域だ。
見落とされがちだが、快適さを殺すのはたいていGPUではない。複数のグローバルシャッターカメラを30fpsで同時に食うと、USBコントローラの帯域とCPUのデコード負荷が効いてくる。ここが足りないとフレーム落ちが起き、推論の入力が歯抜けになる。そしてテレオペのデモ収録は、多カメラ映像と同期した関節状態を連続書き込みする作業で、Loop Model 1 のデータ効率は少数デモの質に全面依存する以上、収録中のドロップは致命的だ。速いNVMe SSDと十分な空き容量を、収録の前に確保しておく必要がある。
ローカル推論には Linux + NVIDIA GPU が要る
重い推論側は、実務的に Linux(Ubuntu)と NVIDIA ドライバと CUDA と PyTorch が前提になる。LeRobot や VLA のエコシステムはCUDA前提で整備されていて、Pi0 のローカル推論はGPUが無いと重すぎ・CPUでは遅すぎと報告されている。Apple Silicon の Mac は、この用途のエコシステムがCUDA一択に近いため、ポリシーサーバとしては素直ではない。テレオペ・収録・アームとカメラの制御を担うクライアント側は Mac や小型計算機で務まるが、推論を回すサーバは NVIDIA GPU を積んだ Ubuntu マシンに寄せることになる。
2台に分けるなら、その間は有線LANで結ぶ。gRPC で観測とアクションをストリームする以上、Wi-Fi のジッタは制御ループのジッタに直結する。MicroFactory が有利なのはここで、彼らは同一筐体内・ローカル推論でネットワーク往復のジッタを排し、実行周期を固定している。「local inference」というスペックの一語は、単に推論をローカルで回すという意味を超えて、制御ループの周期をブースの中で閉じて安定させる、という設計判断を表している。
MicroFactory が示したのは、変動を一点に集める設計だった
分解して見えてきたのは、一貫した一つの態度だ。環境変動は消せない。だから消そうとするのではなく、一点に集めて固定する。照明とカメラは作業ブースに、決定論的な動きはルーチンに、最終位置合わせの残差はコンプライアンスに、推論の周期はローカルの筐体に。それぞれの変動を、それぞれの管理点へ寄せている。散らばらせない、という規律が全体を貫いている。
Loop Model 1 の「データ単位あたり20倍」も、コンプライアンス・グリッパーも、local inference も、別々の工夫に見えて、根は同じだ。固定できるものを先に固定し、残った不確かさだけを学習と機械に回す。ヒューマノイドを避けて作業ブースに振り切った選択も、この態度の延長線上にある。
変動は消すものではなく、一点に集めるもの。MicroFactory の設計は、その原則を物理の箱として形にしたものだった。