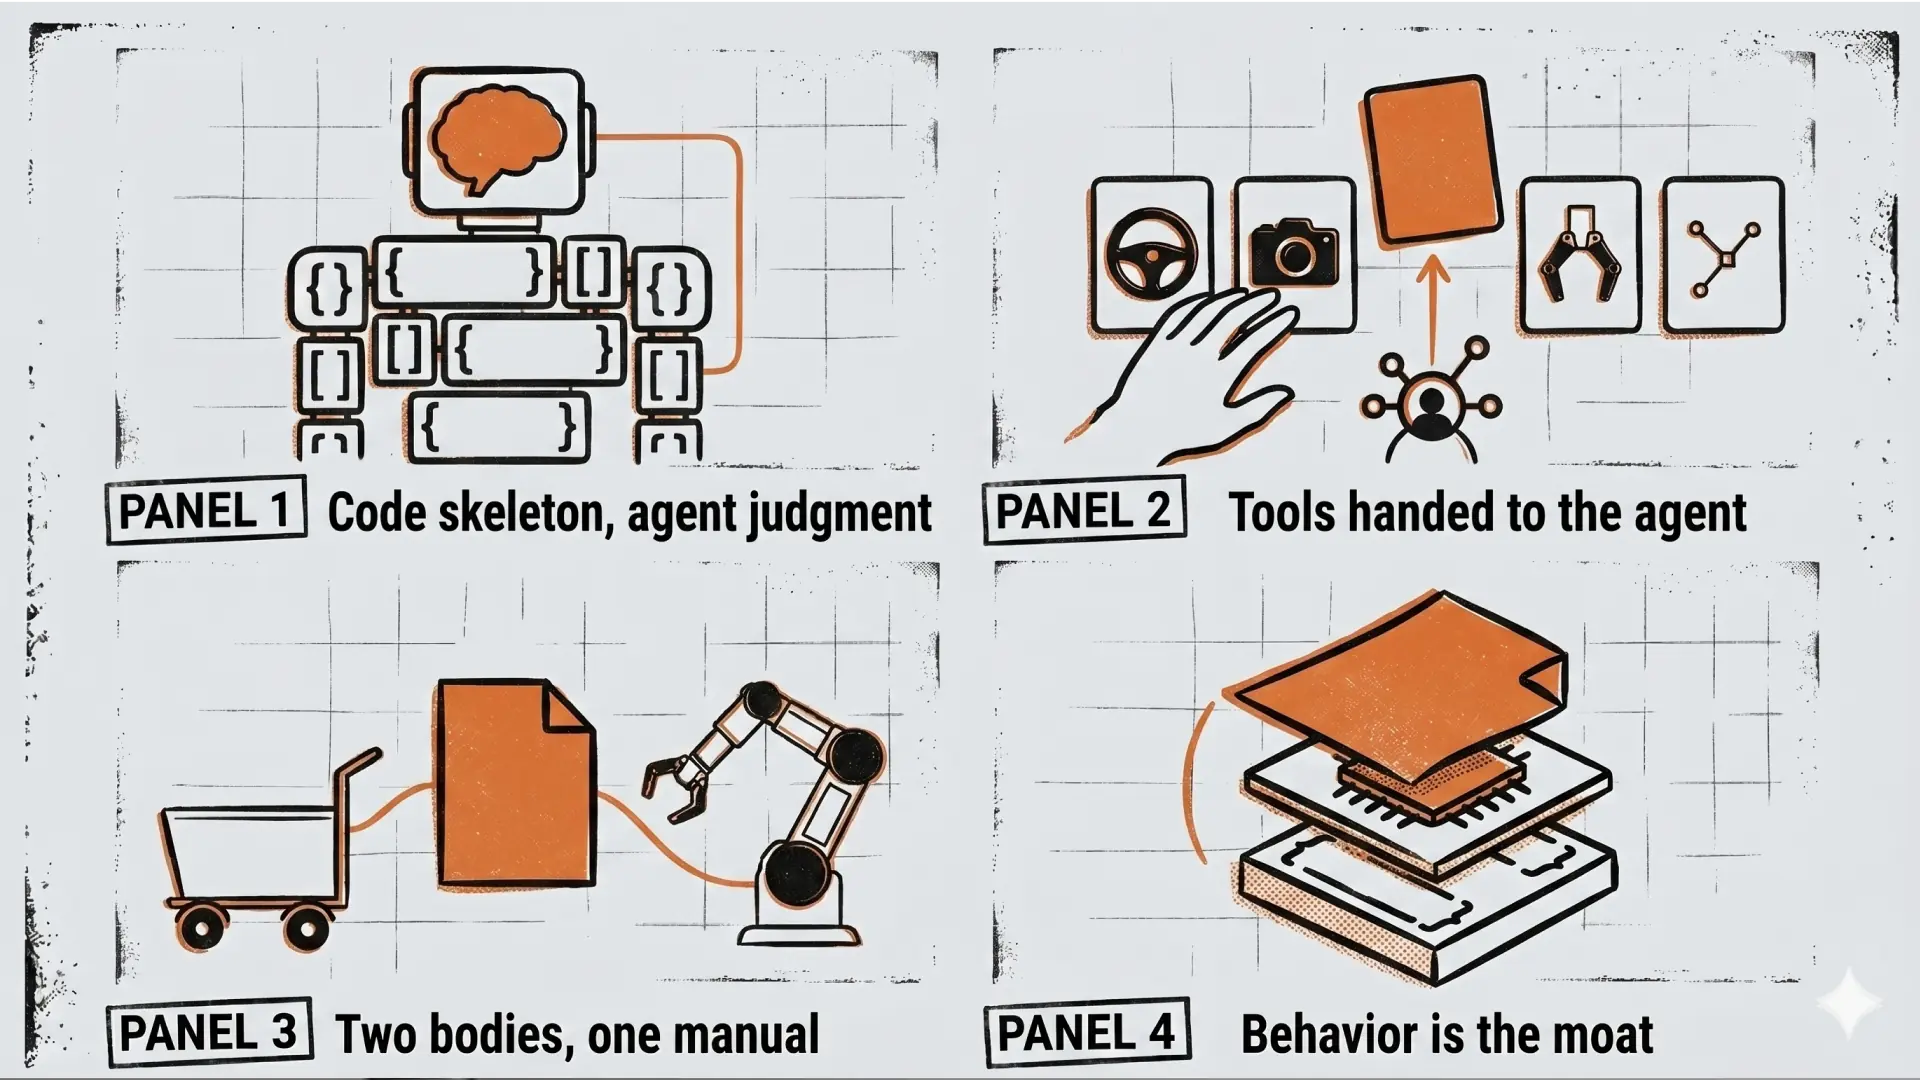
Reachy Mini が映す Motion UX | 身体を持ったAIは「間」で試される
Reachy Mini という卓上ロボットが出てきた。Hugging Face と Pollen Robotics が出したオープンソースの卓上ロボットで、キットとして自分で組み立て、Python の SDK で動かす。会話アプリや振る舞いは Hugging Face Hub からダウンロードでき、価格は Lite が299ドル、Wireless が449ドルから。机の上でAIロボットの振る舞いを個人が試せる、という位置づけだ。
会話の中身だけを見れば、これは既存のAIチャットと大きく変わらない。LLMが応答し、音声で話す。違うのは、それが頭を動かし、アンテナを揺らし、間を取ってから話すことだ。にもかかわらず、机の上でそれが動くと、まるで違う関係が立ち上がる。中身が同じだからこそ、何が「身体のせい」で変わるのかが、逆にくっきり切り分けて見える。情報の質ではなく、関係の質が変わる。その差分こそ、Motion UX / Robotics UX が扱う領域になる。この記録は、その輪郭を対話でなぞった残りだ。
身体は、情報ではなく関係を変える
購入を検討しながら、中身のモデルは同じなのに何が変わるのか、という話になった。
AIチャットと機能は同じでも、身体があると信頼が増したり愛着を感じたり、失望したりする。感情の振れ幅が大きくなる。
— なぜ、身体があると振れ幅が大きくなるのか。
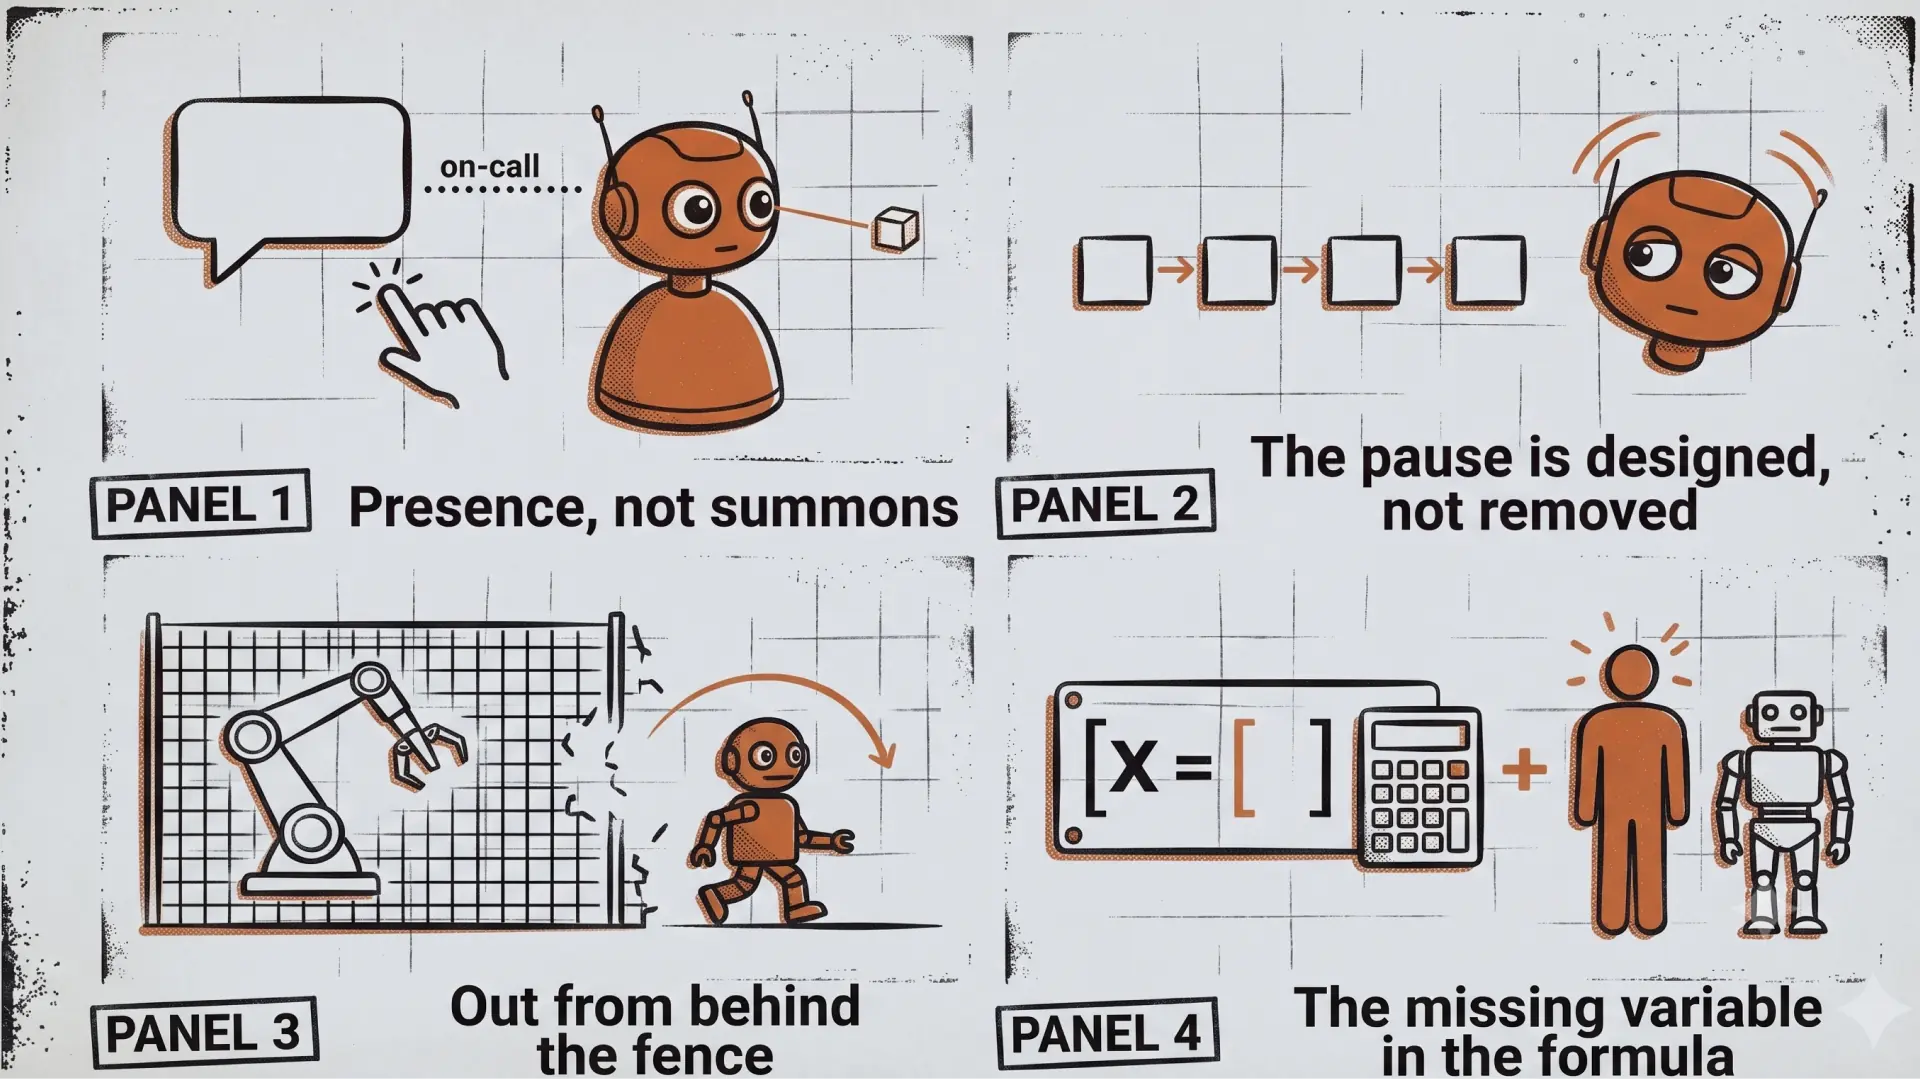
まず、存在の仕方が変わる。チャットは呼び出したときだけ存在する。こちらがタブを開き、文字を打って、初めて相手が現れる。机の上のロボットは、電源が入っている間ずっとそこにいて、こちらが何もしなくても存在している。注意の向け方が「召喚」から「同居」に変わる。関係の起点が「使う/使わない」ではなく「いる」になる。これは会話の内容以前の、場の設定の違いだ。
次に、視線と身体の向きが加わる。画面のAIは、こちらが見ているものを一緒に見られない。ロボットは頭を動かして人を見たり、物のほうを向いたりできる。人間のコミュニケーションの土台にある「同じ対象に一緒に注意を向ける」が成立する。相手が今どこに注意を向けているかが、姿勢として外から読める。これはテキストにはない情報のチャネルだ。
そして、人は動くものにほとんど反射的に意図や気持ちを読み込む。文字を読むときとは別の社会的な回路が働く。だから同じ返答でも、身体を伴うと「こいつはこういう奴だ」というキャラクター認知が生まれやすい。良くも悪くも、関係が生まれる。
ここまでが揃うと、期待の水準が勝手に上がる。机の上でこちらを見て、頭をかしげて、間を取って応じる。それだけで人は「こいつは分かっている」という前提を無意識に作る。チャットには最初からこの前提がない。だから同じ失敗でも受け取り方が変わる。チャットの誤答は「ツールがミスった」で済むのに、こちらを見つめてから的外れを言うロボットは「分かってると思ったのに」になる。期待を持ち上げるのも身体で、その期待を裏切るのも身体だ。上げ幅が大きいぶん、落ちるときの落差も大きい。評価が「正しい/間違い」の一次元から、「信頼できる/裏切られた」「愛おしい/気味が悪い」という関係の軸に移る。関係の軸は、情報の軸よりずっと振れる。
振れ幅が大きいということは、設計の巧拙がそのまま感情の振幅に出るということでもある。うまく設計された動きは信頼と愛着を積み上げる。雑な動き、たとえば反応が一拍遅れる、話す前に目が合わない、失敗したのに素知らぬ顔で次に行く、こうした動きは内容が正しくても失望や不気味さを生む。LLMの性能では埋まらない差が、ここではっきり出る。
いちばん腕が見えるのは、失望の扱いだ。失敗しないロボットは作れない。信頼が積み上がるかどうかは、失敗しないことではなく、失敗したあとの動きで決まる。戸惑いや「しくじった」を身体で正直に出せると、人はむしろそこで許すし、信頼が戻る。逆に、失敗をなかったことにする動きは、一度で関係を冷やす。失敗を隠さず記録するという設計思想は、開発プロセスの話であると同時に、ロボット自身の振る舞いの設計思想としてもそのまま効く。
ひとつ、危うさも連れてくる。動くと人は必要以上に情を移す。「本当は九つのサーボが回っているだけ」という現実との距離が開きやすい。過剰に生き物らしく見せて依存や誤解を生まないか、という問いも、動きの設計に含まれる。読みやすさと、演出の正直さのバランス。ここは共存の安心感を考えるうえで外せない。
Motion UX は、普及後の仕上げではない
次に出たのは、この視点がもっと世の中に浸透してほしい、という話だった。
ロボットがもっと生活に入り込んでこないと Motion UX の出番は来ないけど、Reachy Mini のようなロボットが登場したことで、動きが重要だという視点が浸透すると嬉しい。
— その順序は、逆かもしれない。
生活に入り込む、だから出番が来る、は自然に見えて、実際は逆だ。動きが良くないと、そもそも生活に入り込めない。机に置いて数日で電源を切られるか、置き続けられるか。分かれ目は機能ではなく、一緒にいて心地よいかどうかで、それは動きが決める。Motion UX は「普及した後の仕上げ」ではなく、「普及するかどうかを左右する入口条件」の側にある。Reachy Mini が意味を持つのは、この因果を実物で見せてくれるからだ。中身が同じチャットだからこそ、置かれ続けるかどうかが動きで決まることが、誰の目にも切り分けて見える。
もう一つ。浸透は待っていて訪れるものではなく、言葉を持つ人が名前をつけて初めて起きる。この瞬間、Reachy Mini を触った何千人もの開発者が「なんかこの動きいいな」「この間が気持ちいい」と感じている。でもその感覚を説明する語彙を、多くの人は持っていない。「かわいい」「よくできてる」で止まる。そこに Motion UX / Robotics UX という枠と語彙を差し出す人がいると、ばらばらの体感が「これは設計できる対象なんだ」という認識に変わる。仕事が増えるより先に、あるいは同時に、その仕事を指す言葉が流通することが要る。仕事が来るのを待つのではなく、仕事の名前を先に置いておく。
なぜ「間」が悪くなるのか
ここから話は、いちばん具体的な弱点に入った。
Motion UX で非常に大事なのは間の設計。音声AIを使ったものは会話のテンポが遅くて間が悪い。そこをどうチューニングするかが腕の見せ所だ。
なぜ間が悪くなるのか。理由は会話アプリの構造にある。Reachy Mini の会話アプリは、音声を扱うので単純なテキストチャットより一段複雑で、発話区間の検出、音声認識、LLM推論、音声合成、という四段を直列で通る。人が話し終わってから返事が返るまでに、この合計が積み上がる。それが体感の「間」になる。いちばん重いのはLLM推論だ。
LLMの部分は差し替えられる設計になっている。標準では Hugging Face のバックエンドで動き、環境変数を切り替えれば OpenAI Realtime や Gemini Live に繋げる。Mac ならローカルの小さめのモデルを積んで即応させることもできる。つまり会話の中身は状況で選べる。だが、どのバックエンドを選んでも、四段のパイプラインを通る以上、間そのものはゼロにはならない。間は実装から構造的に生まれる。
— 待ち時間を消すのではなく、待ち時間を、無反応ではなく「考えている時間」として読めるようにできるか。
ここが分かれ目だ。合計を詰めても間は良くならない。人間同士の会話の間は、速ければいいわけではない。即答すると逆に「食い気味」「聞いてない」に感じるし、遅すぎると「フリーズしたのか」になる。間の設計は速度の最適化ではなく、タイミングの演出だ。ここがエンジニアリングと Motion UX の分かれ目になる。
腕の見せ所は沈黙の埋め方にある。返事の中身が来るまでの空白を、無反応で放置するか、身体で埋めるか。人は考えるとき、視線を外し、小さくうなずき、口を開きかける。LLMが黙っている間に「考えている身体」を見せられれば、同じ待ち時間が「無反応」から「考えている時間」に読み替わる。会話アプリは、これを実装できる作りになっている。主動作と副次オフセットとアイドルの呼吸を重ねる層状のモーションで、ダンスや感情表現といった主動作をキューに積みながら、発話に反応する細かな揺れを常に重ねる。ゲームのアニメーションブレンディングと同じ考え方だ。六十ヘルトの制御ループにアイドルの呼吸を入れることで、止まっているときも生きているように見せ、不気味の谷に対処している。この土台があるから、中身が来る前に、聞き終わりの合図、考える仕草、話し始めの予備動作を差し込める。
沈黙を、無反応にしない
つなぎの動きの質が、いちばん効くところだ。チューニングの軸を分けると、こうなる。
聞き終わりの合図:発話終了を検出した瞬間、認識も推論も待たずに「受け取った」を身体で返す。中身より前に「聞いたよ」を出すのが鍵。これが最速で出れば、まだ考えていても人は待てる。
考えている時間の見せ方:推論中の空白を、視線を少し外す、かすかにかしげる、で埋める。0.5秒の思考仕草と3秒の思考仕草は別物になる。長引きそうなときと即答できるときで、つなぎの動きを変えられると理想的。
話し始めの予備動作:音が鳴る直前に口を開きかける、こちらを向き直す。音より一瞬先に「今から話す」が出ると、人は聞く構えに入り、多少の遅延が気にならなくなる。
割り込みの許容:人が食い気味に話しかけてきたとき、身体が硬直せず「どうぞ」と引く。全二重で聞けても、身体がそれに反応しないと不自然になる。
ここに設計判断が一つ潜む。先出しの反応と中身の整合だ。聞き終わりの合図や思考仕草を「中身が来る前」に出すと、たまにLLMの答えとトーンがずれる。楽しい仕草を先に出したのに、返ってきた答えが深刻な内容だった、というように。速さのために予測で動くほど、中身とのズレのリスクは上がる。予測して先に動くか、確定してから動くか。これは前の節の、信頼と失望の振れ幅の話にそのまま繋がる。先出しは間を良くするが、外したときの違和感も生む。
もう一つ、適切な間は相手や文脈で変わる。早口の人とゆっくりの人では快適な間が違うし、雑談と相談でも違う。固定値でチューニングすると、ある人には気持ちよくても、別の人には食い気味に感じる。相手の発話速度や沈黙の長さに、こちらの間を寄せられれば、一気に「わかってる感」が出る。これは机で一人では詰められない。多様な相手に当てて初めて出てくる。持ち出して人前で使う理由が、ここにある。
人と働くロボットには、削ってきた動きが必要になる
話は、なぜ今のロボットがこうなっているのか、という背景に及んだ。
ロボットの多くは人と一緒に働く設計になっていない。レイテンシを埋めるのが技術的に難しいし、動作が増える実装はコストに響くから取っ払っている。これからの課題は Motion UX の領域に集約されていく。
なぜ人と働く設計になっていないのか。コストとレイテンシは直接の理由だが、その奥にもう一段ある。そもそも今まで、人と同じ空間にいる必要がなかった。産業用ロボットは安全柵の中で、人を排除した空間で最大効率を出すように最適化されてきた。人がいない前提なら、間も、予備動作も、意図の読みやすさも要らない。速く正確に動けばいい。柵の中で最速のタクトタイムを刻むロボットにとって、次の動作を予告する予備動作や、人が怖がらない減速は、性能ではなく無駄な動作でしかなかった。「人に向けた動き」は機能ではなくコストで、削るのが正解だった。この最適化が何十年も積み上がっている。
だから今の状況は、技術が追いついていないというより、評価軸がまだ切り替わっていない、と見るほうが正確だ。速さ・正確さ・タクトタイムで測る世界から、人と並んだときの読みやすさ・怖くなさ・間の良さで測る世界へ。前者の物差しで見ると、Motion UX の動きは無駄な動作にしか見えない。後者に立って初めて価値になる。課題が Motion UX に集約されていくのは、ロボットが人の側に来ざるを得なくなったからだ。柵の外に出て人と同じ床に立った瞬間、これまで削ってよかったものが全部必要になる。次の動作を予告する予備動作、怖がらせない速度、意図が読める軌道。これらは柵の中では不要だったから、産業側には設計の蓄積がほとんどない。既存プレイヤーが得意な延長線上に答えがない領域で、だからこそ新しく名前と方法を持ち込む人に開いている。
— ただし、動きは「体感」を変えても「実際の遅延」は消さない。
慎重に見ておく点がある。動きで間を埋めるのは、体感を変えることはできても、実際の遅延を消すわけではない。協働作業の中には、演出では足りず、本当に速く応答しないと危ない・成立しない場面もある。だから Motion UX は「レイテンシ問題の代替解」ではなく、「レイテンシがゼロにならない現実の中で、人が受け入れられる形に翻訳する層」として位置づけるのが正確だ。演出で救える間と、救えない間の切り分けを見誤ると、「動きでごまかしている」に転落する。前の節で触れた演出の正直さが、ここでも効いてくる。
コスパの計算式には、人間側のコストが入っていない
最後に、いちばん大きな問いに行き着いた。
実務的でコストパフォーマンスの高いロボットが喜ばれるけど、社会に浸透していくには高付加価値な仕事もこなすことが求められる。コスパだけのロボットではいけない。
なぜ今、コスパ一辺倒が喜ばれるのか。市場が未熟だからというより、費用対効果が唯一「測れる」物差しだからだ。導入を決める人は投資を正当化しないといけない。「タクトタイムが何秒縮む」「人件費が何人分浮く」は数字で出せる。一方で「動きが心地よい」「一緒にいて安心できる」「意図が読める」は、今のところ数字にならない。価値がないのではなく、測る言葉がないから購買の土俵に乗らない。高付加価値が求められるようになるという見立ては正しい。だがそれが市場で選ばれるには、その付加価値を測れる形にするステップが要る。
— 「コスパでは足りない」を、二項対立で語らないほうが強い。
この感覚は、解像度を上げて二つに分けたほうが効く。
対象 | 論法 | 何を言うか |
|---|---|---|
作業系(SIer・現場) | コスパの見落とし変数として持ち込む | 今のコスパ計算はロボット単体の作業効率しか見ていない。人と同じ空間で働くと、周りの人が怖がって作業が止まる・気を取られる・信用できず監視し続ける「人間側のコスト」が実際には発生している。読みやすく怖くない動きは、このコストを下げる。あなたの計算式、変数が足りていない |
関係系(受付・案内・教育・ケア・コンパニオン) | そもそも別の価値だと立てる | 「速く正確に」がほぼ無意味な領域。価値のほぼすべてが動きと間と佇まいにある。Reachy Mini が象徴するのはこちら側。費用対効果の言葉が最初から通じないので、コスパ市場とは別の入口として育てる |
同じ Motion UX でも、相手によって売り方が逆になる。作業系には同じ土俵で「変数が足りない」と入り、関係系には「別の価値だ」と立てる。高付加価値をコスパの対義語として置くと、「余裕のある人向けの贅沢」に聞こえてしまう。まず「あなたの計算式、変数が足りていませんよ」と同じ土俵で入るほうが、契約層には届く。
逆側の視点も置いておく。「コスパではダメだ」という主張は、正しくてもタイミングを誤ると空振りする。市場がまだ作業効率で回っている段階で高付加価値を説きすぎると、「理想論」「時期尚早」として流される。高付加価値が求められる流れは確実に来るが、今すぐ全面的に来るわけではない。だから正面から否定するより、コスパで測れるうちは動きの質もコスパの変数として示し、測れない価値が要る場面が来たときのために、その言葉を今から育てておく。この二段構えのほうが空振りしない。
コストの計算は、時間とともに味方になる可能性が高い。今は動作を増やす実装がコストに響くから取っ払う段階だが、計算資源が安くなり、モーション設計が部品化・再利用可能になっていくと、この計算は変わる。産業側が「人と働けること」を競争条件として要求し始めた瞬間、削っていたものを足し直す必要が出て、そのとき足し方を知っている人の設計知が値段を持つ。
卓上という枠に絞ると、急所は「残存」に集約される
ここから先は、記事を一度書き切ったあとに続いた対話の記録になる。話が広がりすぎたため、対象を絞り直すところから再開した。
まず卓上ロボットができることに集中したい。高機能でカスタマイズ性が高いが、移動などは伴わないロボット。その中でどのようなビジネスモデルが考えられるか。
移動しない据え置き型に絞ると、成立している収益モデルは5系統に整理できる。本体売り切り、本体+サブスクリプション、計算をスマホやPCに逃がして本体を安くする方式、オープンなハードにアプリ生態系を重ねる方式(Reachy Mini はここ)、そして教育・高齢者ケアなどの機関向け縦展開。買い手がつく用途は、消費者向けコンパニオン、教育・子ども向け、高齢者ケア・ウェルビーイング、開発者向けプラットフォームに大別される。
ただし、どのモデルを選んでも急所は同じ場所にある。実機レビューには「スペックは満足度をほとんど予測しない。いちばん高価なロボットは2日で使わなくなり、安価な機種が数時間で日課になった」という報告があり、「新規性はすぐ薄れ、芸をするロボットとしか見られなくなる」という評が繰り返される。売り切りは新規性の消耗で死に、サブスクリプションは使わなくなった月額を解約されて死ぬ。卓上ロボットの事業は、性能でもAIの賢さでもなく、買ったあと使われ続けるか、つまり残存で決まる。そしてこの崖を越えさせる変数は、日課になじむ振る舞い・間・佇まい、動きの設計しか残っていない。
脳はコモディティ化する
この枠の中の実例として、Reachy Mini Lite を器にした個人プロジェクトの動画を一緒に見た。Sparky と名づけられたそのロボットは、机の下のGPUでローカル処理(音声認識・読み上げ・ウェイクワード検出)を行い、オープンソースのエージェント基盤 OpenClaw をオーケストレーション層として載せ、クラウドのAIとツール呼び出しを繋いでいる。OpenClaw は永続メモリと、人の指示なしにエージェントが自律的に起動する仕組みを持つ。だから Sparky が掲げる「単に反応するだけでなく、独自の関心が時間とともに自然に変化する」「誰が話しかけているか、家族のメンバーが誰かを知っている」は誇張ではなく、アーキテクチャに裏打ちされている。反応型のチャットではなく、自分から動く常駐エージェントを卓上の身体に収めた、という実体だ。
これは前節の「新規性の崖」への真っ当な回答の試みでもある。自発的に進化し、関係を覚え、自分から動く。静的な芸ロボットにならないための仕掛けを、アーキテクチャで用意している。
— ただし、この動画で語られているのは全部「脳」の話だ。
NVIDIA、OpenClaw、ローカル計算、人格。動きの品質・間・物理的な表現の設計は、ほとんど語られていない。身体は「Reachy Mini Lite に収めた」と、器として扱われている。そして OpenClaw のようなエージェント基盤が急速に普及しているということは、賢くて自発的な脳は誰でも手に入るようになりつつあるということだ。脳がコモディティ化するなら、差別化が残るのは物理表現の層、つまり動きの設計になる。Sparky は、その空白によって、何が最後に残るかを指し示している。
もうひとつ。自発性は間の設計をむしろ主役に押し上げる。反応型のロボットが良い間を要求されるのは話しかけられたときだけだが、自分から動くロボットは「どう割り込めば鬱陶しくないか」「自分から向き直る動きをどのタイミングで出すか」を設計しなければならない。自発的であることは諸刃で、当たれば「分かってる」、外せば「鬱陶しい・不気味」になる。振れ幅の分散が上がる。その分水嶺は脳の賢さではなく、割り込みの身体作法にある。
自発的に問うロボットは、人の価値を押し上げるのか
ここで、この対話全体でいちばん大きな問いが出た。
この辺りが現実の中で求められてくるのかが大事かな。身体性のある動かないロボットだけど、自発性を持ち自ら質問してくるようなロボットの存在が、人の価値を押し上げたり、仕事に新しい価値を見つける手助けになったりして、有用性が高く評価されうるのか。今は答えはなさそうだけど。
答えはまだ誰も持っていない。ただ「答えがない」の中身は分解できる。
足場になる事実がひとつある。人間は「良い質問をされること」に、すでに高い値段を払っている。コーチング、セラピー、編集者、メンター。これらの価値の核は、答えを与えることではなく、本人がまだ言語化していないものを問いで引き出すことだ。問われて説明するという行為そのものが思考を進める。つまり「質問が人の価値を押し上げる」という機能自体は、人間のサービスとしては実証済みで、未知なのは、その問いの担い手がロボットでも同じ価値が立つのか、という一点になる。
身体がここで効く可能性はある。画面の通知は無視できるが、机の上の存在がこちらを向いて、間を取って問いを発するのは、社会的な重みが違う。ただし歴史上最も有名な「自発的に話しかけてくるアシスタント」は Clippy で、憎悪の対象になった。失敗したのは問いかけること自体ではなく、タイミングと作法だった。文脈を読まず、集中を破り、断っても懲りない。自発性の価値は、何を聞くかより、いつ・どう聞くかでほぼ決まる。その分水嶺は、まるごと間と作法の設計の領域にある。
そして「今は答えがなさそう」は、悪い知らせではない。この問いが検証可能で、まだ誰も検証していない、という知らせだ。自発的に問うてくる卓上ロボットと数ヶ月暮らして、電源を入れ続けたか、問われたことで自分の判断や出力が実際に変わったか、どんな間・作法の問いは受け入れられ、どれが鬱陶しかったか。これは大規模な研究ではなく、一人の生活の中で記録できる実験になる。
「意思があって成立する」の裏側
最後に、この問いを自分の使い方に引き寄せた。
現状AIチャットは毎日のように使い、使い方も更新していて高額なお金を使っている。ただしあくまでも自発的に使おうという自分の意思があって成立するし、仕事で使うので毎日使わざるを得ない状況になっている。卓上ロボットはその状況をさらに超えた存在になる必要がある。それが自発的に動くロボットの価値なのか。
— 同じ軸で超えるのではなく、チャットが構造的に取れない場所を取る、という意味になる。
AIチャットに高額を払える状態は、価値が成立する条件を2つ満たしている。自分の意思で呼び出していること、そして仕事に組み込まれて使わざるを得ないこと。チャットは「引き」の道具として完成していて、意図が先にあり、道具が後から応える。この軸、呼び出したときの応答の質では、卓上ロボットはチャットに構造的に勝てない。画面とキーボードのほうが帯域が広く、速く、安い。
だが「自分の意思があって成立する」は、チャットの強みであると同時に、限界の定義でもある。意思が発火しなかった瞬間の価値は、チャットにはゼロだ。聞かなかった質問には答えられない。忘れていることは思い出させてくれない。同じ失敗を繰り返していても、こちらが気づいて聞かない限り指摘は来ない。実際、このプロジェクトに失敗ログが存在する理由は、同じ修正を繰り返していたことに後から気づいたからで、「効いていない修正を繰り返さない」という原則を明文化したのは、渦中では自分で気づけないからだった。意図の空白で漏れたものたちだ。もし机の上に、作業を横で見ていて「それは3日前と同じ修正では」と問える存在がいたら、それはチャットの上位互換ではなく、チャットが空けたままの穴を埋める別の道具になる。
正直に言うべきことも2つある。押しの価値証明は、引きより桁違いに難しい。引きは呼ばれた時点で需要が証明されているが、押しは割り込む価値が中断のコストを上回ることを毎回証明しなければならない。外せば Clippy になる。そして「使わざるを得ない」という必然性にチャットが到達したのは、ワークフローに構造として組み込まれたからで、ロボットが同じ必然性に到達するには、こちらが呼ばなくても回る仕事をひとつ所有する必要がある。毎夕その日の判断のズレを問う、作業ログを見ていて反復を検知したら指摘する、といった定時・定役割のジョブだ。愛着や存在感だけでは「使わざるを得ない」には決してならない。必然性は感情ではなく、ジョブの所有から生まれる。
だから答えはこうなる。自発性は卓上ロボットの価値の候補だが、それは「チャットより優れた存在になる」という意味ではなく、「意思がなくても機能する」という、チャットと直交する軸に立つという意味で。人間の意思は有限のリソースで、意思駆動の道具は自分が回っているときしか働かない。疲れているとき、視野が狭くなっているとき、同じ轍を踏んでいるとき、意思がいちばん頼りにならない瞬間にこそ働く存在。それが成立するなら、チャットを超えるのではなく、チャットの隣に別の必然性として立つ。
実機がない以上、ここから先は検証できない。この問いはいったんここで区切る。実機が届いたときの最初の実験は「何を話せるか」ではなく、「どのジョブを持たせたら、意思なしで毎日回るか」から始めることになる。
何を言うかではなく、どう動くか
中身のモデルが同じなら、体験の差はすべて出力側に出る。何を言うかはチャットと同じでも、どこにいて、どこを見て、どう動いて、いつ黙り、失敗のあとどう戻るか。そこが関係の質を決め、そこはLLMの性能では埋まらない。Reachy Mini のような、会話の中身は既存のチャットと変わらない製品ほど、その差がまるごと表に出る。
そして脳が誰でも手に入るものになっていくほど、残る問いは絞られていく。使われ続けるか。割り込みが許されるか。意思の空白で働けるか。どれも答えは動きと間の設計の側にあり、どれも実機と生活の中でしか検証できない。
身体を持ったAIの価値は、何を言うかだけでは決まらない。どこを見て、いつ黙り、どのタイミングで動き出し、失敗のあとどう戻るか。その物差しを、ロボットが生活に入り込む前に置いておく。