MicroFactory の入力設計 ― 精度はモデルではなく、人間とロボットの変換比で作られていた
同じ会社を二度分解することになった。一度目は公式サイトの製品情報から、作業ブースとコンプライアンス・グリッパーとローカル推論を読んだ。二度目はチュートリアル動画の字幕から読んだ。同じ製品なのに、出てきたものがまるで違った。しかも二度目は、読み違いを三回した。訂正を消さずに残す。考えが動いた過程のほうが、結論より使えることがある。
分解の対象は MicroFactory のチュートリアル動画と、Founders, Inc. によるインタビュー動画。どちらも本人が喋っている映像で、公式サイトには書かれていないことが、口頭ではぽろぽろ出てくる。
リーダーアームは関節角をそのまま写していない
最初の読み違いから書く。テレオペのハンドルを見て、こう書いた。フォロワーと同一関節構成の縮小アームだから、関節角をそのまま関節角に写している。逆運動学もパスプランニングも要らない。座標系の話が一切出てこないのはそのためだ、と。
インタビュー動画の字幕が、これを壊した。彼はコネクタを基板に挿す作業を見せながら、こう言う。
0.5ミリずれただけでも、すべてが壊れてしまう。
そして手にしたハンドルを大きく振って、
通常、このタスクは実行できません。あまりにもランダムすぎるし、制約がなさすぎる。
続けて、
このように動かすと、精度が低すぎるんです。
そのあと数字が出た。
5進むと、ロボットは1だけ進みます。
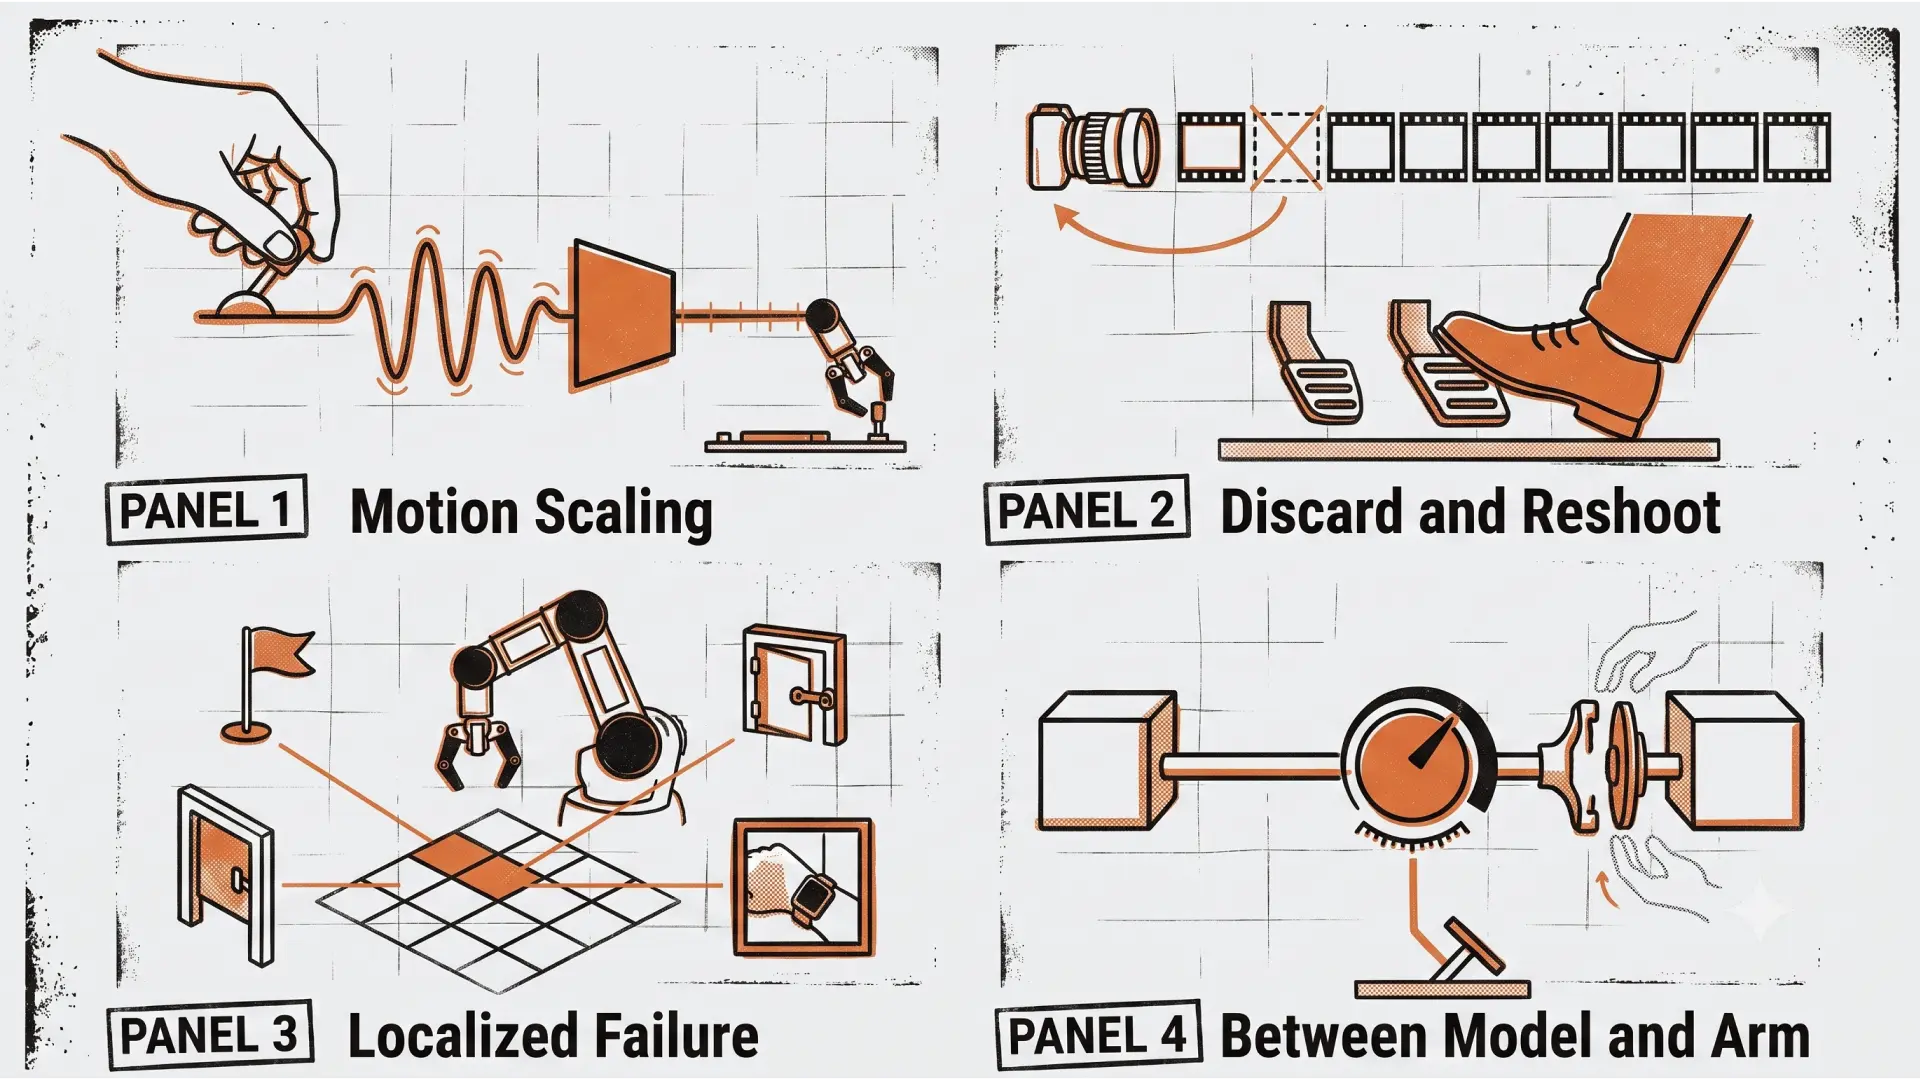
モーションスケーリング 5:1。人間が5mm動かすと、ロボットは1mm動く。関節角の直写ではない。直写すれば、人間の手の震えがそのまま先端に乗る。0.5mm 公差の挿入には、原理的に届かない。
— なぜこれを、精度の問題ではなく「制約がなさすぎる」と表現したのか。
言い換えが的確だった。自由度が高すぎるから精度が出ない、という捉え方をしている。手を自由に動かせる状態のまま高精度を要求するのではなく、動かせる範囲を縮めることで精度を作っている。ゲインを下げるのではなく、入力の解像度を上げていると言ってもいい。人間の手の分解能はそのままに、ロボット側の1ステップを細かくすれば、同じ手の震えでも先端の振幅は1/5になる。
つまり精度の出どころは、モデルでもアームでもない。人間の身体とロボットの身体のあいだに置かれた変換比だ。ここは完全にインターフェースの設計領域で、機械学習の話ではない。創業者の Igor と Viktor がゲーム開発出身だと知って、腑に落ちた。スティックの感度カーブとデッドゾーンを何年も触ってきた人間が、その発想をロボットの教示に持ち込んでいる。
足元のペダルが、汚いデータをその場で捨てている
二つ目に見落としていたのが、床にあった。
カーペットの上に置かれた三連のフットスイッチ。それぞれにテープが貼ってあり、黄色に R、赤に X、緑にチェックマーク。手書きだ。彼はこう言う。
便宜上、ペダルをいくつか用意
教示中、両手はリーダーアームで塞がっている。だから録画の開始・破棄・確定を足でやる。当たり前の解に見えるが、これが効いている位置が本質的だ。
チュートリアル動画のほうで、失敗したときの対処が語られていた。
サンプルが15個しかなく、例えばロボットがこの場所からボードをつかめない場合、このサンプルを削除して再記録すれば良いでしょう。もう一度「Train」ボタンを押せば、うまくいくはずです。
二つ目の読み違いはここだった。字幕が途中で切れた状態で読んだとき、「その場所のサンプルを15個足す」と読んだ。実際は逆で、15はデータセット全体のエピソード数、処方は追加ではなく置換だった。悪いエピソードを1つ消して、撮り直す。
意味がかなり変わる。データが足りないのではなく、汚れている、という診断になる。ロボットがその場所から掴めないのは、そこを撮ったときの人間の動きが良くなかったからだ。
— なぜ「足す」では直らないのか。
15個のうち1個が悪いとする。消さずに良いものを5個足せば、悪い比率は 1/15 から 1/20 に薄まる。薄まるだけで、消えない。しかも薄めるのに5回撮る必要がある。1個消せば 14/14 が良いデータになる。
さらに悪いことに、この種の誤りは特定の場所に固まる。左奥から掴むときだけ躊躇した、といった形で。その場所のデータは全体で1つか2つしかない。全体を薄めても、その場所の分布は汚れたままになる。だから「その場所を、消して、撮り直す」の一択になる。
そしてペダルが効いている位置が、ここで見えてくる。削除はWeb UIの操作ではなく、教示のその場、失敗した直後の足踏みだ。汚いデータが、そもそもデータセットに入らない。後から探して消すのではなく、記録した本人が数秒後に判断する。これは下手だった、と最も正確に判断できる瞬間に、最も安いコストの操作を割り当てている。
質問が来た。
汚いデータというのは、使うのに適切ではないデータを削除することによって学習や修正の速度向上や精度向上に役立つという意味ですか?
半分そうで、半分は分けて考えたほうがいい。汚さには二種類ある。
種類 | 中身 | 消して直るか |
|---|---|---|
ノイズ | 手ぶれ、同期のズレ、タイムスタンプの乱れ | 消しても直らない。記録系の設計が原因 |
誤り | その教示自体が良くない解き方をしている | 消すしかない。模倣学習は教示を無条件に正解として受け取る |
模倣学習には「これは下手なデモだ」と判断する機構がない。誤りは、消さないと消えない。
効いているのは学習の計算時間ではない。エピソードが1つ減っても学習は数十秒しか速くならない。効いているのは人間のデバッグサイクルのほうだ。悪い1つを特定して消せば、次の学習一回で直る。特定できなければ、闇雲に足して薄まるのを待つことになる。
ただし消しすぎてもいけない。同じタスクに複数の正解があること自体は悪ではない。上から掴むと横から掴むが両方あるのは多峰性で、Diffusion Policy はそれを表現するために選ばれている。掴もうとして一度ズレたのは誤りだ。見た目には区別がつかない。判断できるのは、そのエピソードの結末を知っている人間だけになる。だから削除ボタンは人間の手元、正確には足元にある。
VLA を使わないとは、彼は言っていない
三つ目の訂正。これは自分の側の問題として書いておく。
字幕を読んで、こう書いた。MicroFactory は VLA を使わないと明言しており、業界の潮流への意識的な逆張りだ、と。指摘を受けて確認した。彼が言ったのは、こうだ。
私たちはそのタスクを実行するために基礎モデルを使用していません。それはプログラミングに近いものですが、コードの代わりに動きを使うんです。プログラミングなので、うまくいかないことはあまりないんです。
基礎モデルを使っていない、であって、VLA を使わない、ではない。VLA という語は最後まで出てこない。そして彼が対比しているのは基盤モデルではなく、従来のルールベースだった。
認識や動作を別々にプログラムし、ロボットがあらゆる状況にどのように反応するかをプログラムする必要がありました。考えられるケースは数百万にも及ぶため、それらをすべて手動でプログラミングするのは全く理にかなっていません。しかし、それは自動的に行うことができます。
批判の相手は産業用ロボットのティーチングであって、基盤モデルではない。基盤モデルは「使わない選択」として一言添えられただけだった。
— なぜ物語を足してしまったのか。
分析の骨格は字幕から直接読める部分に立っていた。故障の局所化、予測可能性、少データ。そこに「業界に逆らっている」という筋書きを重ねたのは、記事にしやすいからだ。読める事実と、読める事実から作った物語を、同じ調子で書いてしまった。
同じ理由で、工程を Pick / Transport / Insert に分けて各出口に判定点を置く図も描いた。あれは MicroFactory の説明ではなく、こちらが提案した設計だ。彼が言ったのは「これらの小さなモデルを連結することで、完全な操作を実現できます」の一文だけで、工程分割の証拠は今のところない。図に彼らの名前を貼るべきではなかった。
構成図を、読み違いの版と訂正後の版で並べる
分解の途中で、MicroFactory の構成を四層の図にした。物理と入力、学習、実行、そして失敗の局所化。映像で確認できたものを実線、推定を破線にして描いた。
その図に、三つの読み違いがそのまま入っていた。リーダーアームの欄には関節角をそのまま写す、と書いてあった。最下段には落ちた場所にサンプル15個を足して記録へ戻る、と書いてあった。実行層には工程ごとに分割、と断定が書いてあった。破線と実線を分けて誠実に描いたつもりの図が、破線ではない場所で三箇所間違えていた。
図は消さずに残す。ただし切り替えられるようにした。訂正前と訂正後を行き来すると、三つの箱だけが反転する。
— 三箇所しか変わらないのに、なぜ全体の意味が変わるのか。
変わった箱の位置が悪かった。三つとも、物理とAIのあいだ、人間が触る層に並んでいる。リーダーアームの変換比、ペダルによる破棄、工程の切り方。ここを読み違えたまま図を見ると、上から下へ流れる普通の学習パイプラインにしか見えない。データを集め、学習し、推論する。どこにでもある構成になる。
訂正後の図で残るものは違う。人間の身体とロボットの身体のあいだに変換比があり、教示のその場に破棄の操作がある。この二段が抜けていると、彼らが作ったものは学習パイプラインを製品化した会社になる。入っていると、人間の入力を設計した会社になる。
破線を引く場所を丁寧に選んでも、実線の中身を読み違えれば図は嘘をつく。推定であることを表示する仕組みは持っていたのに、確認したつもりの部分に検証がなかった。
故障の局所化とは、ロボットが謝れるようにすること
読み違いを剥がしたあとに残ったものが、たぶん本体だ。彼はモデルの性能を誇っていない。誇っているのはこれだった。
モデルが予測可能で信頼性が高く、ブラックボックスではありません。
そして失敗を、損失関数ではなく物理空間の言葉で語る。この場所から掴めない、と。原因を場所として記述でき、処方が一意に決まる。消して、学習し直す。
故障の局所化とは、原因がわかることではない。原因がわかったあとに、打つ手が一意に決まることだ。照明が悪いと分かっても直し方がなければ、局所化していない。
これを成立させるには三つ要る。ロボットが謝るための三点セットと言い換えてもいい。
何をしようとしていたか(工程の名前)
どこまでできたか(工程の出口での判定)
何を見ていたか(観測の保全)
産業用ロボットは1と2を持っていた。座標とセンサがある。持っていなかったのが3で、学習ベースになって初めて必要になり、しかも本質的にインターフェースの問題になった。推論中の画面に wrist と aux の映像が並んでいるのは、進捗表示ではなく証拠保全だ。
— 3が要るのはなぜか。
模倣学習の失敗は大きく二つに分かれる。観測が学習時の分布の外に出た場合と、分布内なのに行動を誤った場合だ。前者はデータを足せば直る。後者は足しても直りにくい。この二つは処方が真逆で、切り分けるには失敗した瞬間にモデルが見ていた画像そのものを見るしかない。撮っていない角度だったのか、撮ったはずの画なのか。ここが見えないシステムは、いくらデータを足しても直らないことがある。
台帳は、すでに判定点として設計されていた
ここから R2R2R の側の話になる。
確かに今csvで台帳管理している部分の、わかりやすく確認できるUIに変更するだけでもかなり価値があるよね。
その通りで、ただし正確には「変更する」ではなく「台帳の上に読み取り専用の面を載せる」になる。CSVは正本のまま触らない。UIは読むだけ。書き込むのは実機だけ。この境界を先に決めておかないと、UIから補正値を書きたくなった瞬間に台帳の追記ガードと衝突する。
そして価値の出どころは、見やすくなることではない。見やすいCSVビューアは世の中にある。ここで価値が出るのは、列がすでに判定点として設計されているからだ。
corr_cell_keyが失敗の場所を持つtip_block_dist_mmが到達の可否を持つheld_after_liftが保持の可否を持つevidence_sourceが根拠画像へのポインタを持つ
この四つが揃っているから、「左奥のセルで、到達はしているが保持に失敗している。画像を見ると爪先がブロックの角に当たっている」という一文が組み立てられる。普通のログビューアでこれができないのは、UIが悪いからではなく、スキーマにこの四つが揃っていないからだ。
MicroFactory がボタン一つでやっていることを、こちらは列で表現している。あとは、その列を人間が指差せる面を作るだけになる。
速いループと遅いループを、混ぜない
ただし、次の言葉には一段の切り分けが要る。
csvデータをシステムの中でどう活用するかを設計することで、素早く動きに反映できるからね。
素早く動きに反映するループと、台帳のループは、別の回路として置いたほうがいい。
ループ | 入力 | 出力 | 誰が回すか |
|---|---|---|---|
速い | 直前の残差 | 次試行の狙い | コード(補正記憶) |
遅い | 台帳の集計 | データを足す・消す・コードを直す | 人間 |
台帳を読んで自動で動きを変えるコードを書いた瞬間、台帳は記録から制御入力に変わる。1行の書き間違いがアームの動きを変える。列の追加のたびに実機挙動が変わる。LOG274 の列追加事故は補正記憶マップが履歴を失っただけで済んだが、台帳が制御入力になっていたら実機が変な場所を狙い始めていた。
補正記憶が直せるのは、オフセットだけだ。同じセルで毎回2mm右にズレる、は直せる。直せないのは、そのセルに到達すらできていない場合、到達しているのに掴めない場合、掴んでいるのに持ち上げで落とす場合。これらは補正量をいくら積分しても収束しない。
台帳の役割は、動きを速くすることではない。速いループを止めるべきタイミングを人間に教えることだ。だからUIが答えるべき問いは一つに絞れる。いま起きている失敗は、補正記憶で直るものか、直らないものか。同じセルで補正を10回入れても残差が下がっていないことが一目で見えれば、それはループを抜けろの可視化になる。
そしてここに、MicroFactory にはたぶんない機能が生まれる。彼らの手は「消して撮り直す」の一手だ。こちらには補正記憶という別の手がある。手が二つある以上、どちらを打つかを選ぶ画面が要る。彼らのUIを写しても、そこは出てこない。
時刻は、一つの値ではない
入力設計とデータの掃除が効くとして、その手前にもう一段ある。
チュートリアル動画で、彼は推論についてこう説明していた。ロボットは1秒間に約30枚の写真を取得し、AIモデルが注目すべき特徴を自動的に選択する、と。軽く流される一文だが、実装するとここに決定が積まれている。
30Hz で1行を記録するとき、その行の中には別々の時計が複数いる。
何の時刻か | 誰が刻むか |
|---|---|
上カメラの露光 | カメラのセンサ |
上カメラのフレーム到着 | ホスト側のキャプチャ |
手首カメラのフレーム到着 | 別のカメラ |
関節角の読み取り完了 | シリアルのポーリング |
指令の送出 | 制御ループ |
行の基準時刻 | 記録ループ |
最後の一つだけをCSVに書くのが普通のやり方で、それをやると上の差は永久に復元できない。導出値だけ残すと、元が作れない。台帳で tip_block_dx_mm と dz_mm を別列で持ち、dist_mm も持っているのと同じ発想が、記録側にも要る。
遅延が一定なら、モデルは「少し過去を見て未来を出す関数」を学ぶ。一貫していれば学習できる。遅延がばらつくと、同じ画像に違う行動がラベル付けされる。教師データ内の矛盾になり、学習は矛盾を平均で埋める。結果として動きが鈍る。速く動く区間ほど平均化が効くので、微細な接触動作ほど劣化する。ジッタは精度を下げるのではなく、行動を臆病にする。
ばらつきのある10msより、一定の30msのほうが扱いやすい。ただしこれが成り立つのは記録の話であって、視覚サーボの閉ループでは遅延の大きさそのものが位相遅れになる。記録と制御で、最適化の向きが逆になる。
一定にする実装は、速くすることではない。遅い側に合わせて待つ。各センサは独立に最新値を保持し続け、記録ループが固定周期で目を覚まして、その瞬間の最新値を一行にする。そして各値の取得時刻を、切り出し時刻とは別に残す。dt を後から検算できないログでは、ジッタを測れない。測る手段が先、推論は後、がそのまま当たる。
アームのビビりを、グリッパーの強度で隠さない
入力側の話をしていて、実機の側から言葉が返ってきた。
ロボットアームのビビりはとても問題だと感じているので、これらを無くすだけでも効果が高そうに感じます。
そして、
実際のアームがビビらない状況をどう設計するかが大事です。それはグリッパーの強度を上げるのか、アームの動きの質を上げるのかなどは一つづつ解決することが必要です。
順序は正しい。ただしスケーリングでは消えないビビりがあるので、そこは切り分けたい。
発生源 | 症状 | 5:1 で消えるか |
|---|---|---|
人間の手の震え | 教示中にリーダーが微振動 | 消える。振幅が1/5になる |
制御系のハンチング | 目標に近づくと行き過ぎて戻る | 消えない。ゲインと遅延の問題 |
学習したポリシーの震え | 推論中に細かく前後する | 消えない。教示データ由来 |
mechArm の視覚サーボで MAX_DELTA_DEG = 5.0 を置いているのは二番目への対処で、スケーリングとは無関係だ。SO-101 のテレオペで手が震えるのは一番目にあたる。三番目が厄介で、教示に震えが入っていればポリシーは震えを学習する。推論時に震えるのはモデルのせいではなく教示のせいになる。
つまり 5:1 の効き方は「ロボットが震えなくなる」ではない。震えていないデータが撮れる、震えないポリシーが学習される、という間接経路だ。効果は大きいが、一段遅れて現れる。
そのうえで、グリッパーの強度は原因側ではない。ビビりの結果を耐える話だ。ここを先に上げると、ビビっていても掴めてしまう。症状が消えて、原因が残る。同じ修正を繰り返して改善しないループの、典型的な入口になる。
— では何から手を付けるか。
ビビりを数字にすることから始まる。手首カメラの映像を、静止指令中に撮って、ブロックの角の座標が何mm揺れるかを測る。追加ハードは要らない。数字が出れば、以後の変更は揺れが減ったかで判定できる。減らない変更は、原因を外している。
そして順序は症状で決まる。静止しているのに揺れるなら機構のガタと剛性で、制御は無関係。移動中だけ揺れるなら指令の階段。目標に近づくと揺れるなら制御。この三つは同時に起きていても、支配的なものから消せる。機構・制御・軌道の三層は、どれも金がかからない。精度は後から金で解決できる、の前段に、金をかけずに解決できる層がある。
精度は、モデルとアームのあいだにある
分解して残ったものを並べると、こうなる。
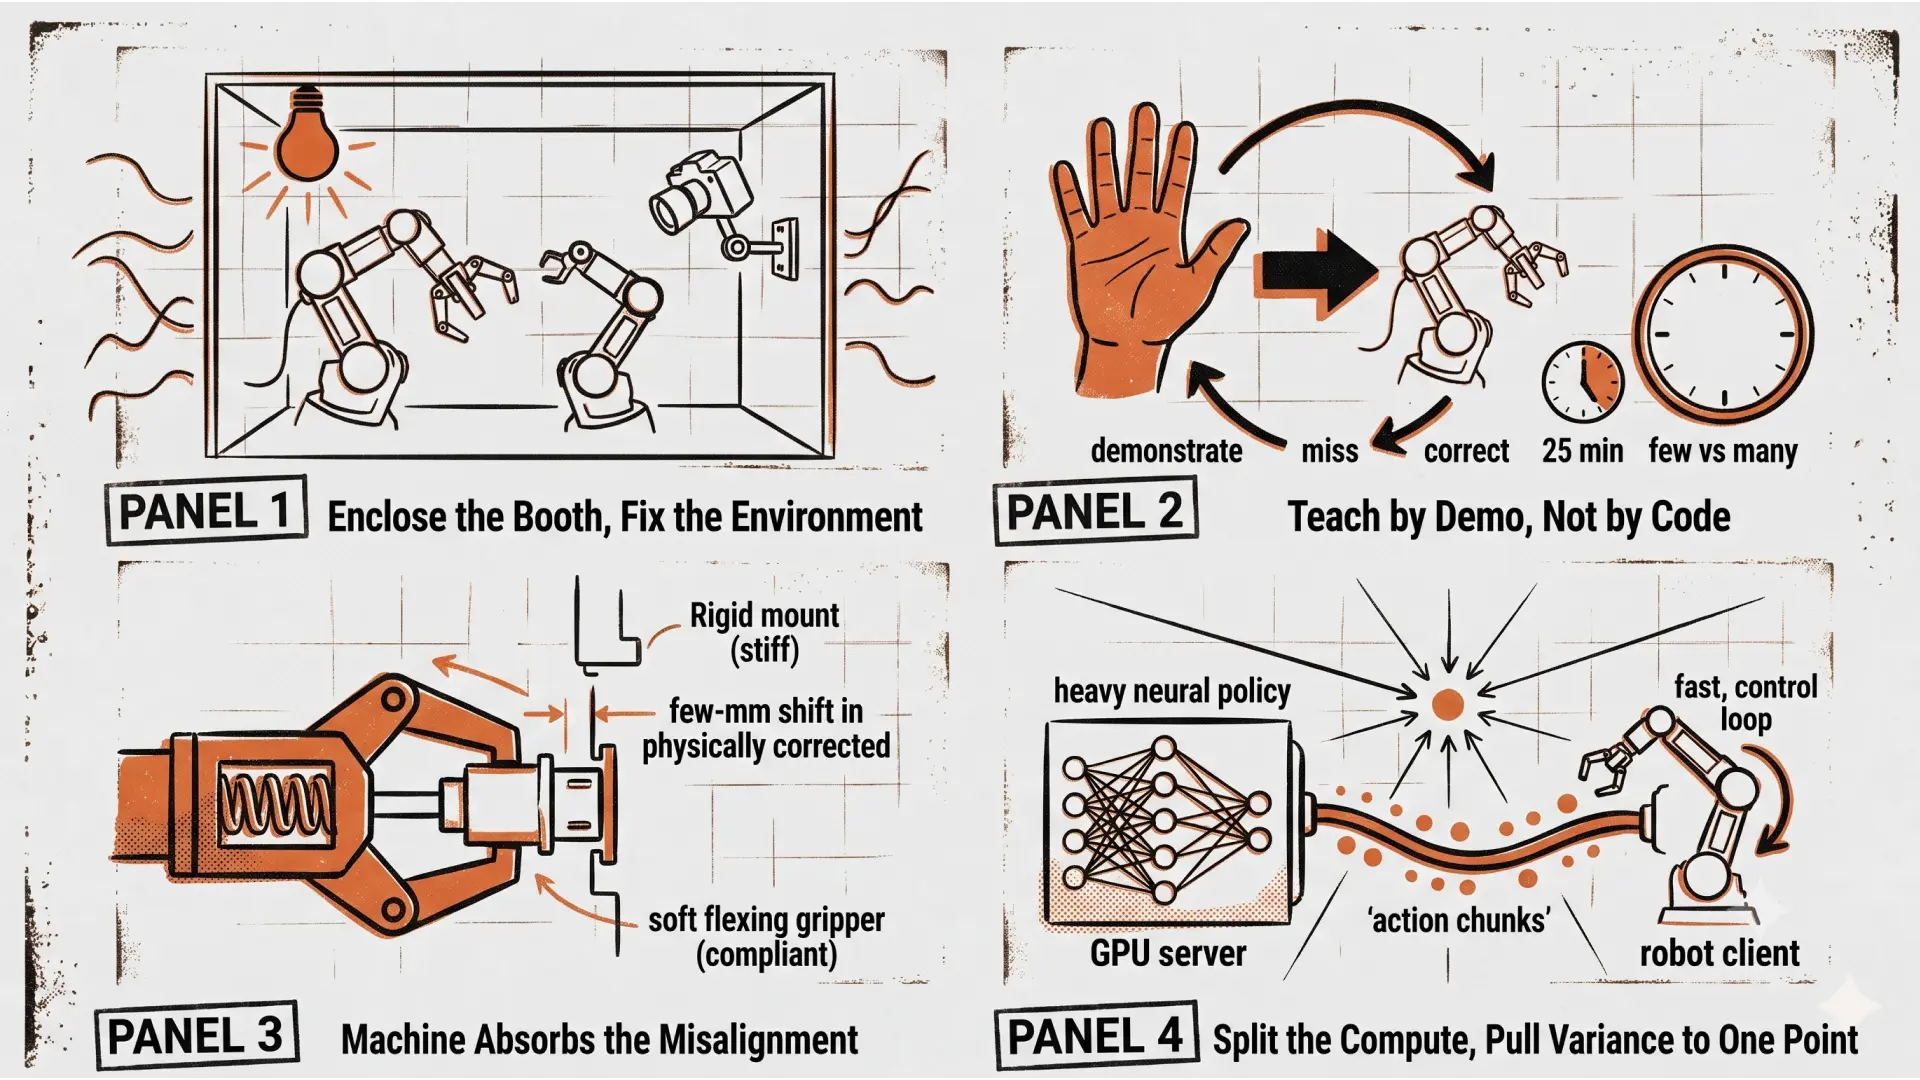
物理は光学定盤と治具で骨格を固定する。入力はモーションスケーリングで人間の震えを1/5にする。判断はペダルで、汚いデータをその場で捨てる。学習は少数の綺麗なデータから一般化する。
真ん中の二つが、公式サイトを読んでいたときには見えなかった部分だ。そしてこの二つは、どちらもAIの設計ではなくインターフェースの設計になっている。コードの代わりに動きを使う、と彼は言った。その動きの品質を作っていたのは、変換比とペダルという二つの入力設計だった。
SO-101 のリーダー・フォロワーは 1:1 で動く。ブロックを掴むだけなら足りる。接触の伴う作業に進んだ瞬間に足りなくなる。変換比を可変にするのは、コードで数行だ。粗く動かすときは 1:1、接触の直前で 5:1 に落とす。ペダルで切り替える。可動域を使い切ったらクラッチで追従を切り、手を戻して再開する。マウスを持ち上げて置き直すのと同じ操作が、テレオペにも要る。
三度の読み違いを経て、最初に手を付けるべきものが入れ替わった。失敗診断ビューではなく、入力の仕様書のほうが先に来る。何を固定し何を振るか、変換比をいくつにするか、ペダルに何を割り当てるか、押さなければ破棄にするか。撮り直しは、撮る前に防げる。
人間の身体とロボットの身体のあいだにある変換比を、どう設計すれば良い動作データが取れるか。この問いに実測で答えた人は、まだいない。