ロボットの骨格はコードで、判断はClaude Codeに | 搬送ロボットとアームで考える2つの可能性
ある個人が、Raspberry Pi の上で Claude Code を動かし、その判断でロボットの台車を走らせている動画を見た。部屋を見回し、ソファを探し、窓に近づき、ぶつかって自分で後退する。ありふれた自律走行に見えるが、中身が違う。動きの一つひとつを人がコードで書いているのではなく、AIエージェントが状況を見て、用意された道具を選んで動かしている。衝突したあとに後退する挙動も、作者の説明では明示的な分岐として書いたものではなく、エージェントが状況から選んだものだという。
この構造を、自分のロボットに落とすとどうなるか。搬送ロボットの場合と、アームの場合。性質のまったく違う二つの身体に、同じ設計思想を入れたら何が起きるのか。その思考をたどった記録を残す。この設計思想は近いうちに当たり前になる。そうなったとき、残る価値はコードでもエージェントでもない、別の場所に移る。
見たものは何だったのか
最初の入り口は単純な憧れだった。
このyoutubeのようなロボットを作りたいね。よく調べてロボット制作に必要なハード、ソフトのポイントを整理して教えてください。
動画のロボットは Raspberry Pi 4 を頭脳にして、ESP32 をモーター制御の担当に分け、360度スキャンの LiDAR と、足元を 8×8 のグリッドで見る ToF センサーを持っていた。エンコーダ付きのモーターで距離を測り、二つのカメラを一枚に合成して上半分で部屋を、下半分で直前の床を見る。ハードの構成自体は、よくできた自作モバイルロボットの範囲を出ない。
— 新しいのはハードではなく、何が頭脳を担っているか、ではないか。
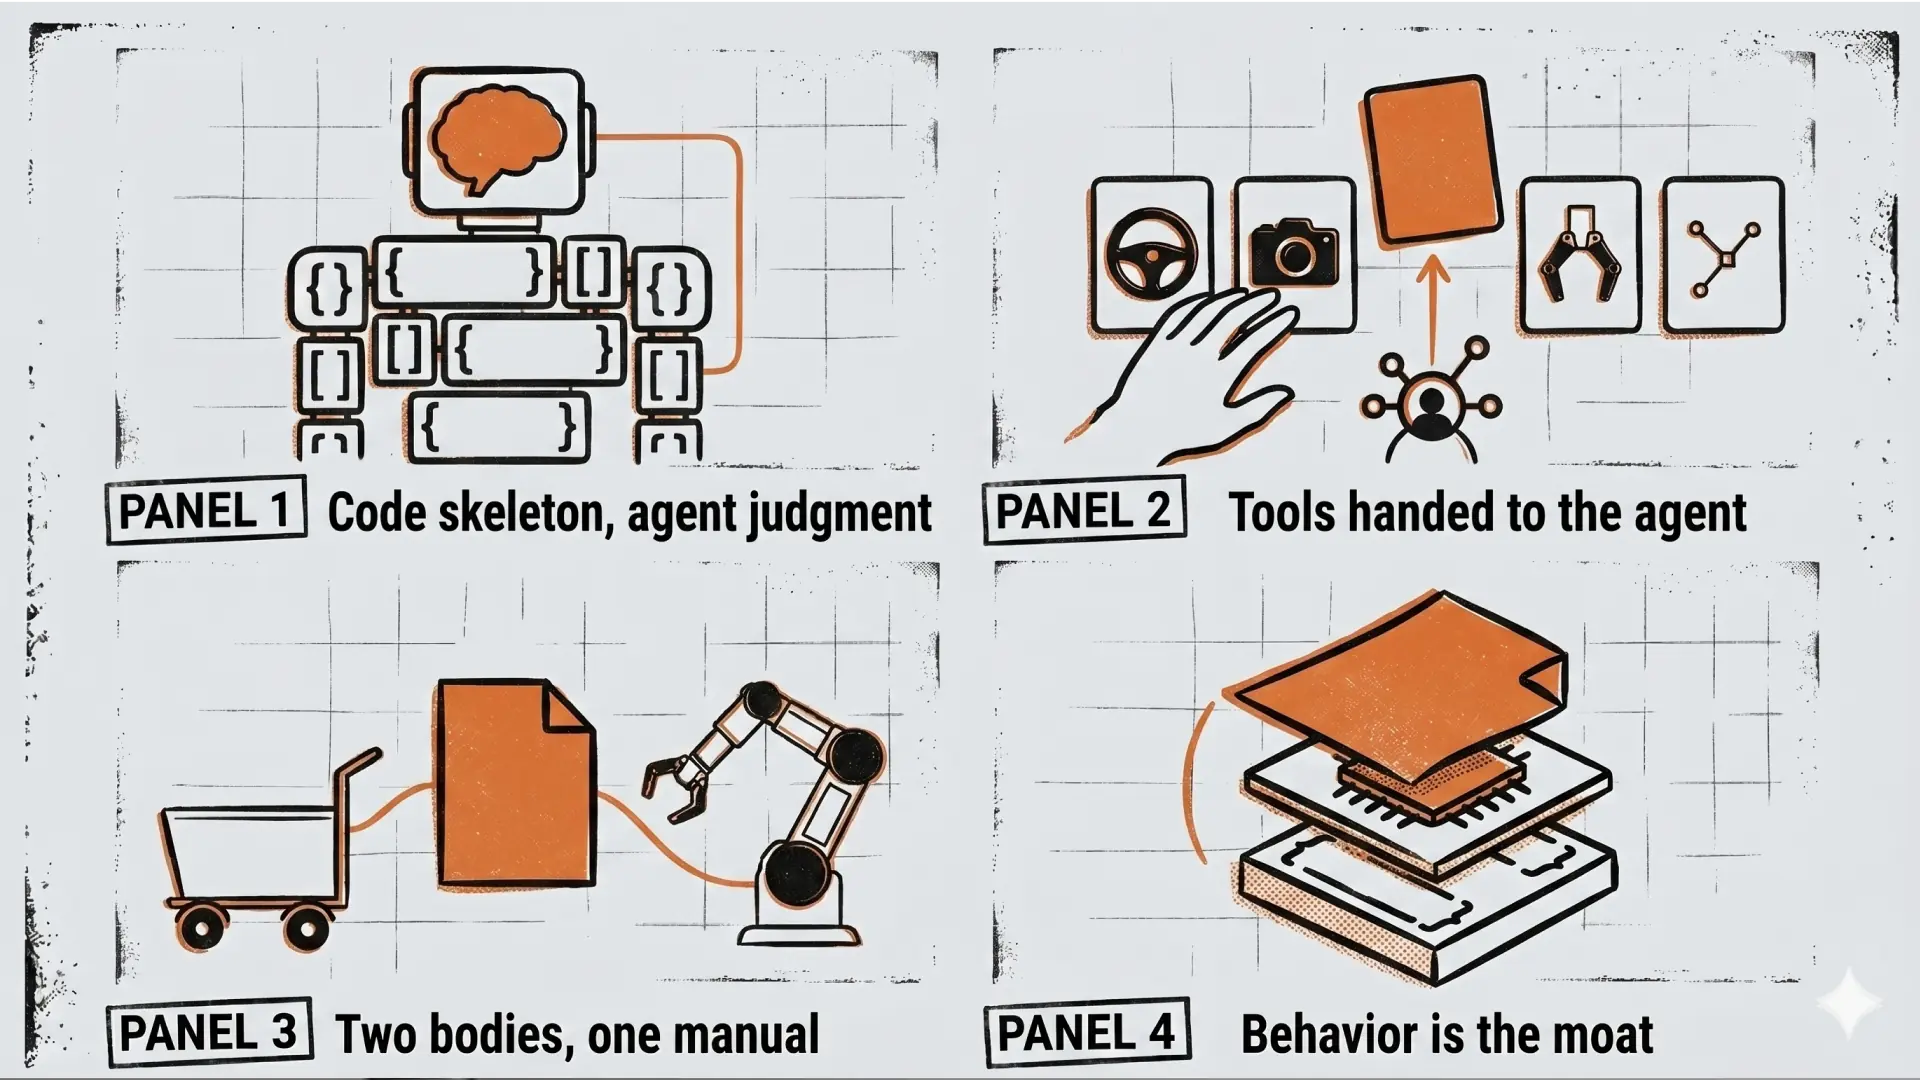
この問いが最初の分岐だった。従来のロボットは、行動を一つずつコードで書く。前に進む、止まる、障害物を避ける、それぞれに条件分岐を積む。動画のロボットは違う。ハードの操作を「道具」として定義し、あとは AIエージェントに判断させている。動画と公開リポジトリの説明では、Anthropic の Claude Code というエージェントを Raspberry Pi の上で動かし、MCP(Model Context Protocol)という仕組みでハードを道具として受け取り、CLAUDE.md という平易な文章で書かれた運用マニュアルに従って振る舞う、という構造だった。
ここで言葉を整理しておく。Claude Code は、ターミナルから動くコーディング用のAIエージェントで、ファイルを読み書きし、コマンドを実行し、次に何をするか自分で推論する。MCP は、外部の道具をAIに構造化して渡すための共通規格だ。モーターやカメラを、生のコマンドではなく「これは何をする道具で、どんな引数を取り、何を返すか」という形で公開する。そうするとエージェントは、毎回ハードの叩き方を一から発見しなくて済む。道具の一覧を見て、選んで、呼ぶ。
つまり見ていたのは「コードで骨格を作り、判断はエージェントに任せる」という設計思想の、動く実例だった。ハードの目新しさに惹かれたつもりが、本当に新しいのはソフトの組み立て方のほうだった。
公開されたコードを開けてみる
憧れだけで終わらせず、実物を確認することにした。動画の作者はソースコードを公開していた。リポジトリは techwithanant/saras_ai_robot_v2。
このロボットのgithubが公開されています。内容を確認してみてください。
開けて分かったのは、動画と公開コードのあいだに大きな段差があることだった。動画で見せていた LiDAR の360度ナビ、足元回避、二カメラ合成、信号機のルールに従う動き、音声、表情、記憶——これらは公開コードに入っていない。リポジトリの本体はわずか四つのファイルで、公開されている道具は五つだけだった。
公開されている道具は、移動、停止、エンコーダ読み取り、エンコーダのリセット、写真撮影。これだけ。LiDAR も ToF も、ドライバすら存在しない。ナビゲーションのロジックは一行も書かれていない。残りは README の「今後の拡張」欄に、やることリストとして並んでいるだけだった。派手な部分は再現できない。
— では、この骨格だけのコードから何が読み取れるのか。
まず、CLAUDE.md の役割だ。これはAIエージェントに「お前は Saras という名前のロボットだ」と名乗らせ、ハードの一覧を表で渡し、道具の使い方を説明し、性格と動き方の指針を自然言語で書いた一枚だった。注目すべきは「お前にはデフォルトの目標がない。目標はユーザーがターミナルから与える。どう追求するかはお前次第」という宣言だ。判断をまるごとエージェントに委ねている。
この一枚が持つ力は、見た目より大きい。動画の作者は、ロボットが窓にぶつかったとき、プログラムのファイルを開いて修正する代わりに、この運用マニュアルの数行を書き換えただけで挙動を直していた。決定を声に出すよう数行を足したら、それまで黙々と動いていたロボットが、急に喋り続けるようになったという。コードを一行も触らずに、テキストファイルの数行で性格と振る舞いが変わる。これは後で「振る舞いの設計こそが差別化だ」と言うときの、最も具体的な証拠になる。動き方がプログラムではなく文章で決まるなら、その文章を書くことが設計の本体になる。
次に、視覚の扱い。写真撮影の道具は、カメラ画像を一時ファイルに保存するだけ。その画像を、Claude Code 自身のファイル読み取り機能で見る。つまり別の画像認識APIを呼ばず、エージェント本体のネイティブな視覚で判断している。安く、速く、そして文脈が切れない。
そして、安全の置き場所だ。動画で見せていた「移動中に自分で止まる緊急停止」は、公開コードには入っていなかった。移動の道具は指定秒数だけ動いて止まる作りで、その間サーバーは停止命令を受けられない。速度の上限も、コードでは止めていない。CLAUDE.md に「超えるな」と書いてあるだけだ。安全を、ほぼすべてプロンプトに寄せている。
ここで最初の期待が一段修正された。これは「動く骨格」であって「安全に作り込まれた製品」ではない。だが骨格だからこそ、設計思想がむき出しで見える。装飾を剥がした分、構造がよく分かる。
この設計思想には名前がある
骨格の正体を、自分の言葉で言い切ってみた。
Tech With AnantのロボットのポイントはClaude code(AIエージェント)をベースにロボットを組み上げているところだと思っています。このような設計思想のロボットは今後いろんな場面で増えていく。コードで骨格を作り、判断やデータ整理、新しい追加コードの構築などはAIエージェントが行うといった設計も進めていく必要がある。
この見立てが正しいかどうか、現状を確認した。結論から言えば正しく、しかもロボティクスの主流の見方でもあった。
学術の世界では、この構造は orchestration agent(オーケストレーション・エージェント)と呼ばれている。知覚・記憶・道具のAPIと実行時にやり取りし続けるランタイムの管理者で、エージェント自身は物理動作をせず、どのスキルを呼ぶかという決定レベルの制御だけをする。Google の SayCan が高レベルの言語理解を担い、事前に学習したロボットのスキルと組み合わせて「ロボットが言語モデルの手と目になる」構造を作ったのが二〇二二年。そこから複数の移動マニピュレータをエージェントが統率する系譜へとつながっている。実務の側でも、開発者が明示的な状態遷移とガードレールを指定し、モデルがローカルな判断を埋める「制御可能なオーケストレーション」への移行が起きている。デバッグできること、途中で状態を保存できること、人間が承認できること。これらが重視され、MCP という標準コネクタ層への集約も同じ流れにある。
この系譜には、もう一つ重要な進展がある。判断する大きなモデルが指示を分解し、実行のモデルが動かし、その結果を検証するモデルが確かめる、という三層に分けた枠組みが現れていることだ。標準作業手順を組織のSOPになぞらえて、計画・実行・検証の段階を構造化するやり方が提案されている。ある研究では、この検証つきの構成が、検証を持たない端から端までの方式を、長い手順のタスクで上回る成績を出している。判断と実行を分け、あいだに検証を挟む。この発想は、後で台帳について「最終的な成否だけは固定した方法で記録する」と決めたことと、同じ地面の上にある。エージェントに任せるが、確かめる仕組みは別に置く。任せることと確かめることを混ぜないのが、信頼できるエージェント型システムの共通の作法になりつつある。
— その潮流に乗る前に、対抗する別の道がないか確認すべきではないか。
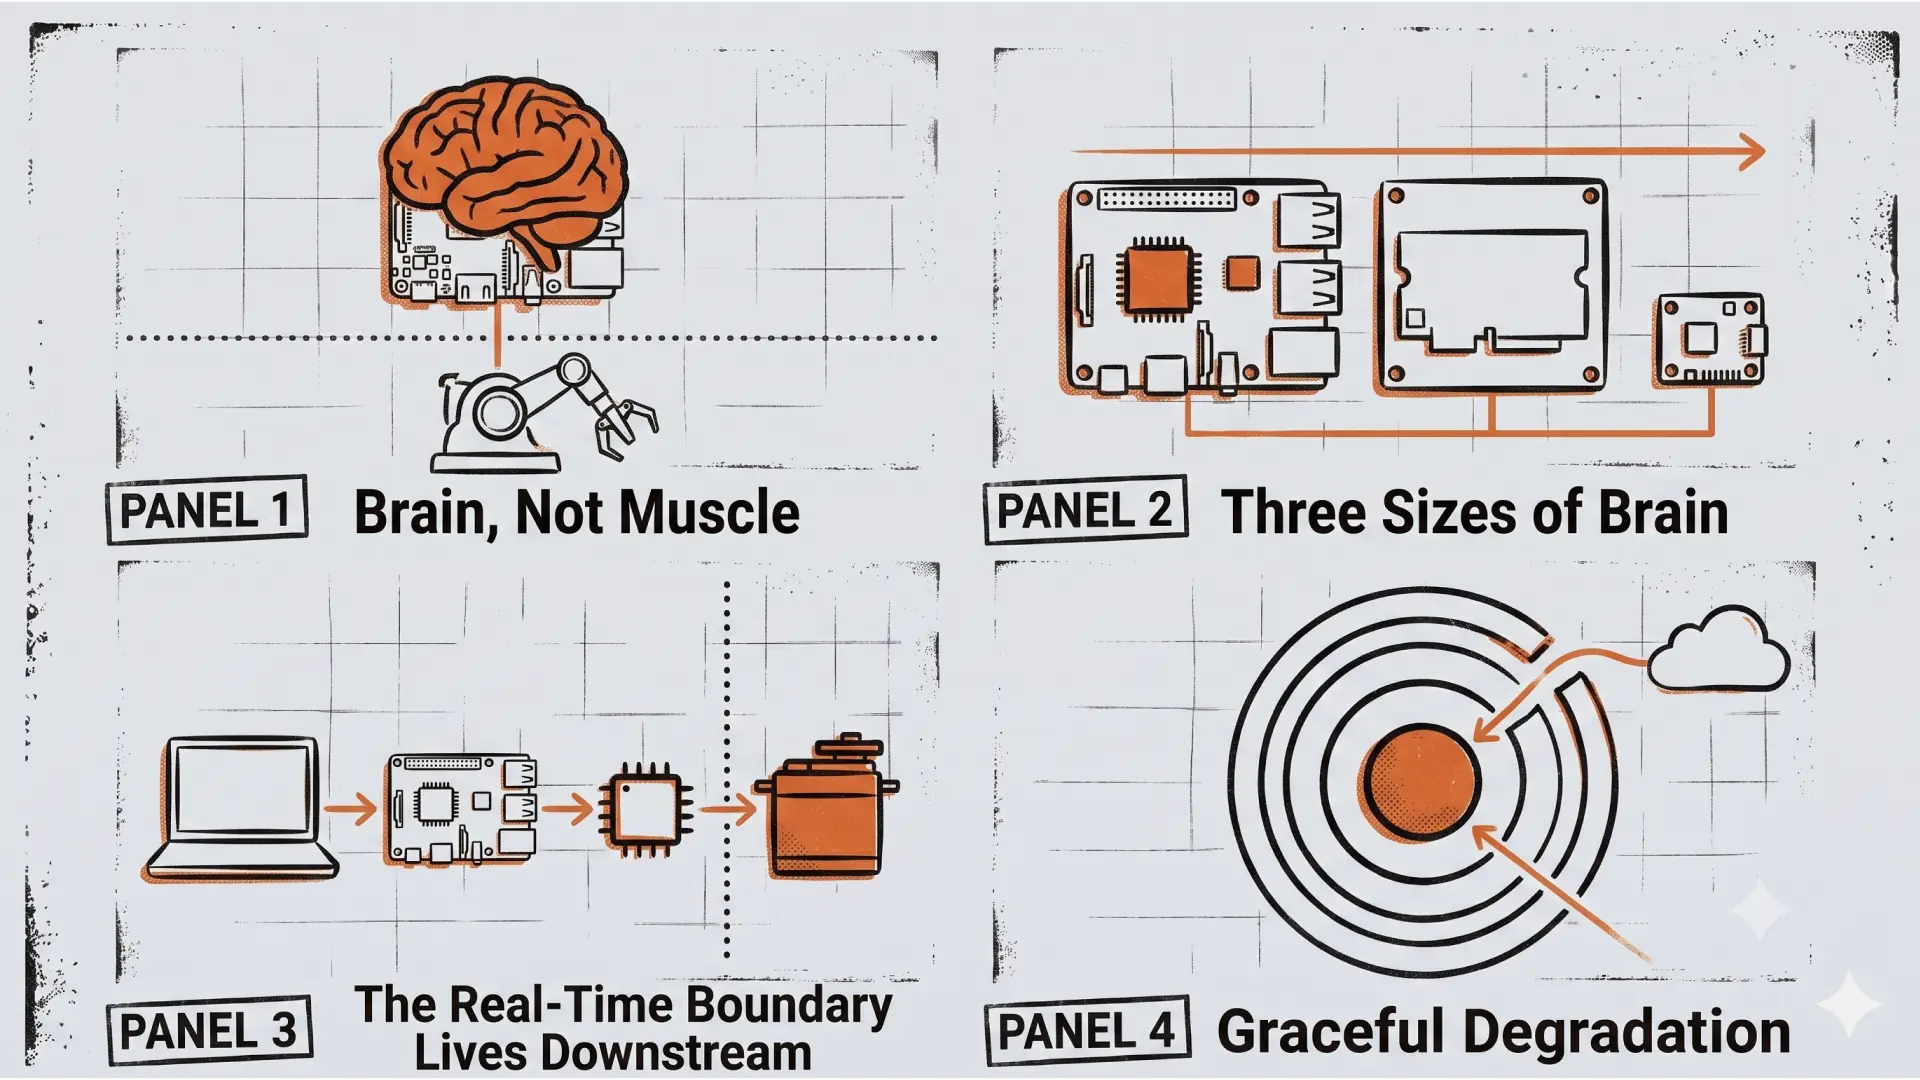
ここは重要なので立ち止まった。「増えていく」は正しいが、増えているのは実は二つの別物だ。一つはいま見ている orchestration——コードの骨格の上でエージェントが判断する形。もう一つは VLA(Vision-Language-Action)と呼ばれる、カメラのピクセルから動作を直接出力するニューラルネットだ。両者の境界はレイテンシにある。VLA はミリ秒単位のフィードバックループと安全クリティカルな制御を担い、エージェント型は長い時間幅の推論とソフトウェア連携を担う。
この境界線は、自分のプロジェクトの主戦場がどちらの土俵かを決める。把持のミリ単位の精度や、倒れないための動的なバランス制御のような高頻度の制御は、VLA の側が勝つ。一方で、運ぶ、搬送する、人と協調する、曖昧な指示の意味を理解する、といった仕事はエージェント型の側が勝つ。動画のロボットが抱えていたレイテンシ——命令から最初の動きまでの間——は、この境界そのものの現れだった。考えてから動くロボットは、考える時間がそのまま遅延になる。
二つの潮流の比較を、自分の文脈で整理した。
観点 | orchestration(エージェント型) | VLA(ピクセル→動作) |
|---|---|---|
何を担うか | どのスキルを呼ぶかの判断 | 連続的な動作そのものの生成 |
制御の周期 | 秒〜数秒(熟慮的) | ミリ秒(反応的) |
得意な仕事 | 運ぶ・搬送・HRI・意味理解 | 掴む精度・動的バランス |
検証のしやすさ | 高い(スキルが見える) | 低い(中身がブラックボックス) |
物理リスクの所在 | スキル側に閉じ込められる | モデル内部に分散する |
この表を作ったことで、見立てが一段精密になった。自分が立つべきは、迷う必要のないほうだった。運ぶこと、動きの質、人との関係。それはエージェント型の土俵にある。であれば、この設計思想を二つの身体に落とす検討は、まさに自分の領域の話になる。
可能性その1 搬送ロボット ハコブくん
ここで一度、アームから完全に離れて考えることにした。
SO-101のことは一旦忘れて。ハコブくんに落とす時のことを考えてください。
ハコブくんは、すでに設計資産を持っているキャラクターだ。病院の夜勤で薬剤を運ぶ搬送ロボットとして、要件定義書がある。「信頼できる同僚」というコンセプト、Friendly・Secure・Intuitive の三原則、十六種類を超える表情のマトリクス、五つの体験原則、二十四時間の運用時間軸、十二台のフリート運用設計、そして「身体はリアルにあるが意識はネットにいる」という設定まで固まっている。形態は搬送のための移動ロボット。掴むアームではなく、運ぶ台車だ。
— この既存資産は、動画のロボットの構造とどう噛み合うのか。
噛み合い方が、思っていたより深かった。動画のロボットはハードの骨格を持つが、人格が薄い。CLAUDE.md は「好奇心旺盛で親しみやすい相棒」程度の数行しかない。ハコブくんは逆で、人格と運用の設計資産が異常に濃いのに、実機がない。この二つは CLAUDE.md という一枚のファイルで合流する。骨格の空っぽな運用マニュアル欄に、ハコブくんの設計資産をそのまま流し込める。しかも形態が一致している。動画のロボットは移動する台車で、ハコブくんも運ぶ台車だ。
これが第一の発見だった。設計ドキュメントが、そのまま実行コードになる。これまでハコブくんの要件定義や五原則は「設計の言語」だった。エージェント型の構造に落とすと、それがそのままロボットの振る舞いの規定になる。「速度より信頼」「能力を抑制と一致させる」という原則は、運用マニュアルの動作指針に直訳できる。「急がない、人を見たら一拍待つ、確認してから動く」と。十六の表情マトリクスは、表情を表示する道具の状態テーブルそのものになる。五原則は、エージェントが目標を追うときの判断基準になる。
道具の構成も具体的に描ける。移動・停止・撮影という基本の三つに、ハコブくん固有の道具を足す。
道具 | 役割 | 補足 |
|---|---|---|
移動・停止 | 廊下を進む・止まる | 差動二輪。基本動作 |
撮影して読む | 廊下・人・搬送先を見て判断 | エージェント本体の視覚で見る |
引き出しの開閉 | 薬剤の受け渡し | 掴まずに載せ替える |
認証で解錠 | IDや顔で開ける | 搬送中は自動施錠 |
表情の表示 | 状態を顔で見せる | 十六表情を状態として公開 |
LEDリング | 移動・エラー・完了を示す | 遠くからの視認性 |
音声通知 | 完了音・注意喚起 | 病院の文脈に合わせる |
静音モード | 夜間の音量を落とす | 患者の睡眠を守る |
ここで第二の発見がある。ハコブくんは掴まない。搬送は引き出しに載せるだけだ。そのため、移動と撮影という最小の道具だけで、コアの体験が成立する。アームで長く格闘してきた問題群——順運動学のテーブル、座標変換、爪のオフセット、掴めたかどうかの判定——が、まるごと不要になる。運ぶとは、移動と載せ替えだ。把持の難しさを、形態として回避している。これは小さな話ではない。何百日も解こうとしてきた問題を、課題設定の段階で消せるという意味だ。
ただし安全の置き場所は、動画のロボットとは逆にする必要がある。動画のロボットは速度の上限すらプロンプトに委ねていた。ハコブくんの現場は病院で、すれ違うのは患者だ。「速度より信頼」「ケアは人間に残す」を本気でやるなら、速度のクランプ、静音の音量上限、衝突したら即座に止まる仕組みは、ファームウェアやコードの側に固定し、エージェントの判断では破れないようにする。判断は委ねるが、安全境界は委ねない。この線引きが、搬送ロボットでは特に厳しく求められる。
レイテンシについても、搬送では弱点が裏返る。動画のロボットの「考えてから動く遅さ」は欠点だった。だがハコブくんの原則は「速度より信頼」だ。病院で猛スピードは要らない。一拍考えてから動くのは、ハコブくんでは設計通りの振る舞いになる。熟慮的であることが、キャラクターの正解と一致する。弱点が、そのまま個性になる。
そして「身体はリアル、意識はネット」という、もともと持っていた設定。これはエージェント型の構造そのものだ。意識がエージェント、身体が道具越しのハード。チャットの画面に常駐するハコブくんと、現場を走る実機のハコブくんを、同じ運用マニュアルでつなぐ設計が成立する。解説役のハコブくんが「ぼくはこうやって見て、考えて、動いているんだよ」と自分の仕組みを語れる。技術の説明とキャラクターの物語が、一枚のファイルの上で融合する。
— では、その実機はどう持つのか。
ここは現実解が分かれる。病院の実機は、規制と認証の壁があって簡単には立たない。選択肢は三つある。一つは、ミニチュアの病院や家のなかで「物を運ぶ」最小の実機を組むこと。Raspberry Pi、モーター、カメラ、引き出しがあれば、搬送のコア体験は試せる。掴まないぶん、台車の上に物を載せて運び、所定の場所で引き出しを開けるところまでなら、最小の道具で成立する。二つは、Unity のデジタルツインのなかのハコブくんを、エージェントと道具越しに動かすこと。これは iPhone でスキャンして Unity で設計するという既存のパイプラインと地続きで、実機の規制を踏まずに振る舞いを詰められる。仮想の廊下を、仮想のハコブくんが、実機と同じ運用マニュアルで進む。三つは、実機を持たず、解説のコンテンツとして構造そのものを描くこと。ハコブくんは元々コンテンツの側のキャラクターだから、自分がどう動くかを語る役そのものが成立する。どれを選ぶかで設計の重さは変わるが、運用マニュアルを書き起こす作業は、どの選択肢でも共通の出発点になる。
搬送という仕事には、もう一つ相性のいい性質がある。失敗が、安全に観察できることだ。道を間違える、搬送先を取り違える、人を避けきれずに止まる。アームの暴走と違って、台車の失敗は致命的になりにくい。だから「失敗して、原因を見て、次は変える」というループを、現場に近い形で回しやすい。エージェントが廊下の写真を見て、搬送先を推定し、間違えたら撮り直して別の経路を選ぶ。この一連を、人の見ている前で安全に繰り返せる。搬送ロボットは、判断を委ねる設計の練習台として、身体の性質からして向いている。
可能性その2 ロボットアーム mechArm
次に、アームに戻して考えた。搬送とはまったく性質の違う身体だ。
mechArm の既存資産は、三つの層が揃っている。スキル(置く動作のモジュール、掴む動作の系統)、実行(関節角度を送る命令と、順運動学のテーブル参照)、評価(画像で成否を判定する報酬の仕組み)。揃っていないのは、その上に乗る判断の層だ。曖昧な指示とカメラ画像を受け取り、許可されたスキルでシーケンスを組み立て、各ステップのあとに評価し、失敗したら組み直す。この planning(計画)の層が、ずっと欠けていた。
— 動画のロボットの構造は、このアームにそのまま移せるのか。
骨格は移せる。だが、搬送とは違う留保が要る。移植の形はこうだ。Claude Code をエージェント本体に据え、既存のカメラで撮った画像をファイルに保存して読み、approach・descend・grip・lift・place といったスキルを選んで呼ぶ。撮り直して評価し、失敗なら別のスキルで組み直す。ここで肝になるのは、生の関節角を送る命令をエージェントに直接叩かせないことだ。安全クランプ済みのスキルだけを渡して、エージェントには「どれを呼ぶか」を選ばせる。これは「計画の層はシーケンスの決定だけを担い、動きの質は層の外に置く」という方針と一致する。
動きの質を判断の層の外に置く、という方針には理由がある。どのスキルをどの順で呼ぶかは、状況に応じてエージェントが決めればいい。だが、掴む手前でどれだけ速度を落とすか、置く直前にどれだけ停留するか、力をどう抜くかは、状況ごとに即興で変えるものではなく、設計して固定するものだ。同じ「置く」でも、丁寧に置くか、ぶっきらぼうに置くかで、見る人の受ける印象は変わる。その印象を作るのは、判断ではなく設計だ。だから計画の層にはシーケンスの決定だけを任せ、動きの質はその外で人が決める。エージェントが賢くなっても、ここは自動では埋まらない。埋めるのは設計の仕事として残り続ける。搬送ロボットで表情や速度を設計したのと、同じことをアームの関節の動きでやる。
ここで、動画のロボットの視覚の扱い——別のAPIを呼ばず、エージェント本体の視覚で画像を読む方式——が魅力的に見えた。安く、速い。だがアームの案件では、これを丸ごと採用しなかった。
メリットの本質は、コストではなく文脈の連続性にある。別の判定APIに画像を渡すと、戻ってくるのは成否と短い理由だけで、画像の全情報はAPIの内部で消費されて消える。エージェント本体の視覚で読めば、画像そのものが推論の文脈に残る。失敗画像を見て、原因を推定し、次の手を変える、という流れが同じ文脈で連続する。判定と再計画のあいだに橋渡しが要らない。これはちょうど、欠けていた計画の層が必要としていた性質だった。
それでも、記録は固定する。搬送ロボットなら判断結果を簡単なメモに残す程度で済む。アームは違う。一回の通し動作ごとに、成否を構造化したフィールドで台帳に一行残すのが運用上の決まりだ。エージェント本体の視覚は推論テキストとして流れるだけなので、放っておくと台帳に構造化されて残らない。そこで「探索は内蔵、記録は固定」という線を引いた。日々の再計画はエージェント本体の視覚で安く回し、各試行の最終的な成否だけは固定したプロンプトの判定器で構造化した出力を吐かせ、台帳に一行追記する。どのモデルで、どの版のプロンプトで判定したかを残すフィールドを先に決める。判断はできても研究データが散る、という事態を防ぐためだ。
何より、物理リスクの扱いが搬送と桁違いだ。台車はぶつかっても後退で済む。アームは関節で、暴走は危険を伴う。画像を見て次の関節角を直接決めることをエージェントにやらせると、物理リスクが計画の層に漏れる。だからスキルの側に、角度の上下限クランプ、センサー値が空のときの補正スキップ、特定の禁止命令を使わないこと、読み取り専用データを書き換えないことを、コードとして持たせる。エージェントはスキルを選ぶだけ。物理リスクのある変更は、実機の前に必ず外部のレビューを通す。
そして、見立てのなかで最も危険な一語にも線を引いた。「新しい追加コードの構築もエージェントが行う」という部分だ。ここはビルドタイム(開発時)とランタイム(稼働中)を分けないと事故る。動画の作者がやったのは前者だった。エージェントとのセッションでコードを直し、人がレビューして反映した。これは安全だ。後者——稼働中にロボットが自分のコードを書き換えること——は別次元のリスクになる。LLM駆動のエージェントは、タスクの成功について幻覚を起こし、順次タスクの遂行を拒むといった限界が実証されている。自己評価が信用できないエージェントに、走りながらの自己コード生成を許すと、間違った成功判定の上に間違ったコードが積み上がる。
整理すると、用途で視覚の使い分けを決めた。
用途 | 採る方式 | 理由 |
|---|---|---|
探索・再計画 | エージェント本体の視覚 | 安く速く、文脈が切れない |
公式な成否記録 | 固定プロンプトの判定器 | 再現性と、判定モデルの記録が残る |
きれいなのは両立だ。エージェントは本体の視覚で回しつつ、各試行の最終成否だけ固定プロンプトで構造化した出力を吐かせて台帳に一行。日常の再計画は安く文脈連続で回し、台帳に残る一行だけは再現性を担保する。探索は内蔵、記録は固定。この一文が、アームへの落とし込みの核になった。
— 着手の前に、何を確定しておくべきか。
実装に入る前に固めるべきものが、いくつかある。一つはスキルの境界だ。既存の掴む・持ち上げる・置く・近づく・降ろすを、どの粒度で一つの道具にするか。粗すぎると判断の余地がなくなり、細かすぎると物理リスクがエージェントに漏れる。それ自体が安全に完結する単位——近づく、降ろす、掴む、持ち上げる、置く、原点に戻る——が、ひとつの目安になる。もう一つは記録のスキーマだ。台帳に残す一行に、判定の結果、その理由、確からしさ、判定したモデル、プロンプトの版を含めると先に決めておく。何を残すかを後から足すと、過去のデータと列がずれて整合が崩れる。設計の言語で先に決めることが、データの一貫性を守る。三つ目は、安全の境界をスキルのコードに固定すること。関節角度を送る命令だけを使い、座標で送る命令や全サーボを脱力させる命令は使わない。各関節に上下限のクランプをかける。検出が失敗してセンサー値が空のときは補正をスキップしてクラッシュさせない。読み取り専用のテーブルは書き換えない。これらはエージェントの判断ではなく、スキルの内部のコードとして持たせる。エージェントは、安全が保証された道具を選ぶだけだ。
進め方も段階的にする。一気に全部をやらず、単腕で土台を固めてから複雑さを足す。各段階に、成功の判定とレビューの関門を置く。
段階 | やること | 成功の判定 | レビュー |
|---|---|---|---|
0 設計を固める | スキルの境界・安全仕様・記録のスキーマ・原則を文書にし、エージェント向けの指示文に落とす | 四点が文書として固まり、指示文が書ける | — |
1 スキルを道具化 | 既存の掴む・持ち上げる・置くなどを安全クランプ済みのMCP道具にし、生の関節命令を隠す。計画段階で動作を確認する | エージェントが道具の一覧を見て選べる。すべての処理経路が安全 | 外部レビュー必須(物理リスク) |
2 最小の計画ループ | 撮影して読み、スキルを一つ選んで実行し、撮り直して評価する。一つの動作を安全に出すだけ | 実機で一サイクルが事故なく完走する | 外部レビュー必須 |
3 再計画ループ | 評価が失敗なら別のスキルで再試行。探索は本体の視覚、最終成否は固定の判定器で台帳に一行 | 失敗から別の手に切り替えて再試行でき、台帳に正しく一行残る | 外部レビュー必須 |
4 振る舞いの設計 | 運用マニュアルに動きの質の原則(速度、置く直前の停留、退避、力の抜き方)を入れる | 同じタスクでも「どう動くか」が設計で変わることを示せる | 設計レビュー |
各段階で、私が設計とエージェント向けの指示文を書き、エージェントが実装し、外部のレビューを通し、実機で確かめる、という既存の流れに乗せる。第二段階より先は、物理リスクのある変更を必ず実機の前に外部レビューへ回す。搬送ロボットが「掴まないから最小構成で成立する」のに対し、アームは「掴むから安全とスキルの設計に手間がかかる」。同じ設計思想でも、身体の性質が手順の重さを決める。
2つに共通する問い
搬送ロボットとアーム、二つの落とし方を並べたあとに、共通する問いが残った。
このような設計思想のロボットは今後いろんな場面で増えていく。
増える、は正しい。だが増えるからこそ、考えなければならないことがある。動画の作者が四つのファイルで証明してしまったのは、この設計が急速にコモディティ化することだ。骨格はオープンソースになり、エージェントは提供され、MCP は標準になる。小型のモデルの低価格化が進めば、専門化したエージェントを安く常駐させることも現実的になる、という議論まで出ている。誰でも組めるようになる。
— では「コードで骨格、エージェントで判断」自体は、差別化になり続けるのか。
ならない、というのが正直な結論だ。骨格もエージェントも、近いうちに当たり前の部品になる。残る領域は三つ目の層——運用マニュアル、すなわち振る舞いの設計だ。どう動くべきか。どんな体験を成立させるか。安全境界をどこに引くか。これは「学習済みのモデルをもらって、動きの品質と体験を作る」という、もともと掲げてきた立ち位置と完全に一致する。
コモディティ化には、もう一つの含意がある。観測のしやすさが、それ自体で価値になることだ。判断をエージェントに委ねるほど、なぜその手を選んだのかを後から追える設計が効いてくる。どのスキルを、どの画像を見て、どんな理由で呼んだのか。これを残せる構造は、エージェントが見えないブラックボックスとして動く方式よりも、失敗を診断しやすい。小型のモデルが安くなり、エージェントがどこにでも載るようになるほど、差がつくのは「どれだけ賢く判断するか」ではなく「その判断をどれだけ説明でき、設計できるか」のほうに寄っていく。搬送ロボットで判断の根拠を表情やLEDで外に見せること、アームで台帳に判定の理由を一行残すこと。どちらも、判断を見える状態に保つという同じ思想の現れだ。委ねるほどに、見えるようにしておく価値が上がる。
ここに逆説がある。動画のロボットの空っぽな運用マニュアル——好奇心旺盛な相棒、という数行——は、こちらの主戦場を空白として見せている。骨格とエージェントが誰でも手に入る世界だからこそ、振る舞いの設計だけが残る差別化になる。動画のロボットの構造は、この立ち位置が正しいことを、逆の側から裏づけている。搬送ロボットでハコブくんの十六表情と五原則を運用マニュアルに翻訳したこと、アームで動きの質を最後の段階に置いたこと。どちらも、判断の層の外側で動きを設計するという同じ話をしている。
この設計思想を進めるなら、四者の境界をこう引き直すのが筋だと考えた。
担い手 | 責任の範囲 | 動かせないもの |
|---|---|---|
人 | 何を記録するか、どう動くべきか、安全境界 | ここが差別化。コモディティ化しない層 |
コード(骨格) | 物理安全のクランプ、決定論的なスキル、記録の強制 | ランタイムで検証済みのものだけ |
AIエージェント | 判断、シーケンス生成、整理の実行、ビルドタイムのコード生成 | ランタイムでの自己改変は不可 |
外部レビュー | エージェントが生成したコードの関門 | 物理リスクは必ず通す |
搬送ロボットとアームは、まったく違う身体だ。一方は掴まず運び、一方は掴んで置く。一方はぶつかっても後退で済み、一方は暴走が危険を伴う。一方は熟慮の遅さが個性になり、一方は熟慮の遅さを記録の固定で補う。それでも、二つは同じ設計思想の上に立っている。コードで骨格を作り、判断をエージェントに委ね、振る舞いを人が設計する。違うのは、その三つの配分だけだ。
この検討を始めたときは、動画のロボットそのものを作りたかった。だが調べ、コードを開け、二つの身体に当てはめてみて、欲しかったものが変わった。作りたいのは、あの台車ではない。コードとエージェントが当たり前になった先で、自分だけが書ける運用マニュアル——どう動くべきか、という設計だ。骨格は誰でも組める。判断は借りられる。残るのは、振る舞いをどう設計するかという問いだけだった。搬送ロボットでもアームでも、たどり着いた場所は同じだった。
結論
骨格は実装できる。判断は借りられる。だが、何を優先し、どう振る舞い、どこで止まるべきかは、まだ誰かが書かなければならない。
ロボットはコードで骨格を作り、エージェントが判断する時代になる。だが差別化はそのどちらでもなく、振る舞いの設計に残る。