サイトを Studio の外へ持ち出せる形で残す ― 533ページを1フォルダにまとめ、codex に2回検証させた
このサイト(adaptdesign.jp/pixelstomotors)は、Studio というノーコードのWeb制作サービスで作っています。記事やマンガは Studio の CMS(記事を項目ごとに入れておく仕組み)に入っていて、本文も画像も Studio の中にしかありません。いつか別の仕組みへ移るときに、手元に何もない状態から始めることになります。
そこで、サイトの中身を Studio がなくても読める・移せる形で、1つのフォルダにまとめました。範囲は、公開しているページすべて(記事339本、4コマ99話、英語版95話、固定ページ13枚)と、その画像・動画・図解、記事を作ったときの作業ファイル、コード、外付けSSD(KIOXIA)にある動画です。あとで探しやすいように、一覧と索引の Markdown も作りました。
作業は Claude と対話しながら進め、できあがったものを別の AI の codex に「どこかが間違っている」という前提で検証させました。1回目の検証では、コードの空行が消えている、表の文字が落ちている、太字の記号がそのまま見えている、という変換の崩れが見つかりました。直して2回目の検証をすると、本文は全部一致しました。一方で、動画の制作作業がこのアーカイブの中で行われていたことも分かりました。
本記事は、その手順と、途中で起きたことの記録です。使ったスクリプトは全文を、codex の検証報告は2回分とも全文を、記事の後半に載せています。
サイトの中身は Studio の中にしかなく、移るときに持ち出す一式がなかった
Studio は、画面を組み立てるだけでサイトを公開できるサービスです。記事は CMS に「タイトル」「本文」「サムネイル」「DAY番号」「シリーズ」といった項目で入っていて、公開ページはそこから自動で作られます。便利な反面、記事の本文や画像を自分の手元にまとめて持つ仕組みはありません。
記事の Markdown は GitHub(PixelstoMotors/r2r2r-content)にも置いていますが、確かめると約200本で、公開している339本より少なく、画像も入っていません。公開時にタイトルを直したものもあります。手元の控えを集めても、公開ページと同じものにはなりません。
そこで、公開ページそのものを正として取り出すことにしました。決めたことは次の4つです。
| 決めたこと | 内容 |
|---|---|
| 置き場所 | iCloud の PixelstoMotors/site_archive/。記事の作業ファイルと同じ場所で、バックアップも効く |
| 範囲 | 公開サイトの全ページ、記事の作業ファイル、コード一式、手元の動画。adaptdesign.jp のうち Pixels to Motors 以外(Web制作実績など)は入れない |
| 動画 | 記事に埋め込んだ動画に加え、Mac と KIOXIA にある元の動画も入れる |
| 進め方 | 先に新旧10本で形式を確かめてから、全量を取る |
公開ページの HTML の中に、Studio の CMS データがそのまま入っていた
最初に、サイトマップ(サイトの全URLを並べたファイル)を見ました。https://adaptdesign.jp/sitemap.xml から辿ると、Pixels to Motors の URL は次の数でした。
| 種類 | URL の形 | 件数 |
|---|---|---|
| 記事 | /pixelstomotors/record/{slug} | 339 |
| 4コマ | /pixelstomotors/manga/{slug} | 99 |
| 英語版4コマ | /pixelstomotors/english-4-koma/{slug} | 95 |
| 固定ページ | /pixelstomotors、/series1〜7、/message など | 13 |
次に記事ページの HTML を開くと、<script id="__NUXT_DATA__"> というタグの中に、CMS の項目がそのまま入っていました。Studio の公開ページは Nuxt(Webページを組み立てるための仕組み)で作られていて、ページを表示するのに使うデータを HTML に埋め込んでいます。このデータは「値を配列に並べ、ほかの値は配列の番号で参照する」形に平たくされているので、番号をたどって元の形に戻す関数を書きました(記事後半の 01_unflat_and_first_item.js)。
戻すと、1本の記事は次のような項目になりました。項目名は Studio が付けた内部のキーで、人が読める名前ではありません。
| 内部キー | 中身 |
|---|---|
| title / slug / cover / body | タイトル / URL の末尾 / サムネイル画像 / 本文の HTML |
| bPskK658 | DAY番号(例: LOG327) |
| HOUwyFeo | シリーズ(例: フィジカルAI研究室) |
| O7HA0yM1 | 言語(JP / EN) |
| WtD0MT_q | 概要文 |
| Qi0bIZEy | 動くサムネイル。別の CMS 項目を参照していて、その title に HTML が丸ごと入っている |
| _meta.publishedAt / updatedAt | 公開日時 / 更新日時 |
本文の HTML には、Studio 独自のブロックが混ざっていました。自動目次(data-type="table_of_contents")、図解などの HTML 埋め込み(data-type="embed_code"。中身は URL エンコードされた HTML)、動画(data-type="video_block")です。埋め込みは記事全体で303件、うち図解が286件、YouTube が17件でした。
固定ページ(トップやシリーズ一覧)だけは HTML に CMS データがなく、ページを開いてから画面を組み立てる作りでした。これは後で別の方法で取り出しています。
Claude の作業環境からはサイトに届かず、デスクトップアプリのブラウザで取り出した
Claude が作業するクラウドの環境から adaptdesign.jp と画像サーバー(storage.googleapis.com)へ接続しようとすると、どちらも拒否されました。Mac とつないだ作業用のシェルからも同じでした。届いたのは、Claude デスクトップアプリの中にあるブラウザ(ブラウザペイン)だけです。
ブラウザペインはページを開いて JavaScript を実行できますが、ファイルを Mac に直接書けません。そこで次の経路にしました。
- ブラウザペインで、全533ページの HTML を取得し、CMS データを取り出してメモリに置く
- 画像と動画もブラウザで取得する
- JavaScript で zip ファイルを組み立て(圧縮なしの zip を自前で書いた)、ダウンロードとして保存する
- Mac の「ダウンロード」フォルダを接続し、作業用のシェルで zip を開いて変換する
ダウンロードは、Mac の「ダウンロード」に .Q6L2SF6YDW.com.anthropic.claudefordesktop.xxxxxx という隠しファイルで置かれました。アプリが保存の確認を待っている状態でしたが、ファイルの中身は揃っていたので、そのまま読み込んでいます。
取り出した量は次のとおりです。
| zip | 中身 | 大きさ |
|---|---|---|
| pixelstomotors_trial10.zip | 試しの10ページと画像39点 | 22.88MB |
| pixelstomotors_raw.zip | 533ページの CMS データ(JSON) | 22.4MB |
| pixelstomotors_media_01〜05.zip | 画像・動画 976点(200・200・200・200・176点) | 103.2 / 69.0 / 35.5 / 96.8 / 104.8MB |
| pixelstomotors_static.zip | 固定ページのデザイン構造と画像 | 5.9MB |
画像と動画の取得で失敗したものは0件でした。
記事・マンガは1ページ1フォルダの Markdown にし、先頭に DAY・シリーズ・公開日を入れた
zip から取り出した CMS データを、Python で Markdown に変換しました(記事後半の convert_v1.py)。HTML から Markdown への変換には markdownify というライブラリを使っています。
形式は、新旧10本(最新の LOG332 から最古の LOG1 まで、4コマと英語版を1本ずつ含む)で先に確かめました。決めた形は次のとおりです。
content/record/DAY327_pi05-libero-benchmark-first-run/
├── article.md        本文。先頭に title・day・series・published・description・使っている画像の一覧
├── images/           この記事の画像(元の解像度)
├── embeds/01_x49jDOPd.html   図解(Studio の埋め込みコードを HTML に戻したもの)
└── thumbnail.html    動くサムネイル
フォルダ名の先頭を DAY327_ にしたのは、Finder で並べたときに DAY 順になるからです。md の先頭(--- で囲んだ部分)は YAML 形式にしてあり、移行するときにそのまま項目として読み込めます。
一覧と索引は index/ に Markdown で置きました。DAY順の記事一覧、シリーズ別、4コマ一覧、図解一覧、動画一覧、外部リンク一覧、固定ページ、作業ファイルとコード、概要文の全文一覧、Studio 移行メモの10本です。表で扱いたい人向けに、同じ内容を data/pages.csv などの CSV にもしました。
固定ページは、ブラウザで開いたときに Studio が持っている「ページのデザイン構造」(どこに何の文字・画像・一覧があるかの木構造)を取り出し、それを Markdown にしました。最初は表示された画面の文字を取ろうとしましたが、ブラウザペインが裏にあるとタイマーが極端に遅くなり、スクロールしながら読み込む処理が途中で止まりました。Studio の中のデータを直接読むほうに切り替えています(08_static_pages_router.js)。
iCloud にしかない作業ファイル147点は、ダウンロードが止まっていてコピーできなかった
記事の作業ファイル(iCloud の デジタルツイン学習R2R2R・ハコブくん・サムネイル)をコピーすると、461点(約610MB)が Resource deadlock avoided (35) というエラーで読めませんでした。iCloud Drive は、ファイルの本体を iCloud に置いたまま、Mac には名前とサイズだけを残すことがあります。Finder で雲のアイコンが付いているファイルです。
Finder で「今すぐダウンロード」を選ぶと、ハコブくん は全部落ちましたが、デジタルツイン学習R2R2R の147点が残りました。20分待っても1点も進まず、8KB の HTML まで止まっていました。しばらくして雲のアイコンが消えたところで、もう一度コピーし、1,431点すべてが元とサイズまで一致しました。
このとき、コピーから外すはずだった モデリング(3Dモデル、1.8GB)と Claudeプロジェクト が一度コピーされてしまいました。rsync(ファイルを同期するコマンド)に「このフォルダは除く」と書いたのに効かなかった原因は、日本語の濁点の書き方です。macOS のファイル名では「デ」が「テ」+濁点の2文字(NFD という形)で保存されていることがあり、1文字の「デ」(NFC)で書いた除外条件と一致しませんでした。削除の許可をもらって消し、除外条件を両方の形で書き直しています。最終的な同期スクリプト sync_work_files.sh では、濁点を含まない部分だけのワイルドカード(モ*リン*)で指定しました。
KIOXIA の動画は、30MB を超えると Mac へ戻せず、mp4 は戻す途中で中身が変わった
KIOXIA(Mac の外付けSSD)は、作業用のシェルからは開けませんでした。そこで、ファイルをいったんクラウドの作業環境に取り込み、そこから iCloud のアーカイブへ書き戻す経路にしました。
この書き戻しで2つの問題が起きました。
| 問題 | 起きたこと | 対処 |
|---|---|---|
| 大きいファイルが戻せない | 27MB と 30MB の動画が「HTTP 400」で拒否された | 9MB ずつに分けて戻し、Mac 側でつなげた |
| mp4 の中身が変わる | 分けた最初の1個だけ、9,000,000 バイトが 9,005,875 バイトになっていた。つなげた動画の SHA-256(ファイルの中身から計算する指紋)が元と一致しない | mp4 を gzip で圧縮してから分けた。mp4 だと判定される形で渡さないようにすると、中身は変わらなかった |
gzip にしてからは、KIOXIA の47ファイルすべての SHA-256 が元と一致しました。のちに動画が13本増えていたので同じ方法で追加し、最終的に62ファイルが一致しています。
コード(~/r2r2r-scripts)は 1.4GB ありましたが、大半は測定の画像でした。git で管理しているのは96ファイルだけで、コードの多くは git 管理外でした。そこで git の管理とは関係なく、画像・動画・バックアップ(.bak*)を除いた917ファイル(127MB)をコピーしました。GitHub の r2r2r-content は、Mac とつないだシェルからは認証が通らず取得できなかったので、クラウド側で取得して書き戻しています。
codex の1回目の検証で、コードの空行・表・太字が崩れていると分かった
できあがったアーカイブを、codex(OpenAI のコーディング用 AI)に検証させました。同じ書き手が自分で確かめると、同じ見落としをするからです。依頼書(codex_verification_request.md)では、「このアーカイブは不完全で、どこかが元サイトと食い違っている」という前提に立ち、OK と判定するなら実行したコマンドと数えた件数を証拠として付けるよう求めました。Claude のスクリプトを再実行して比べるのは検証にならないので、比較は codex が自分で書いた処理で行わせています。
codex は公開サイトから546ページを取り直し、全件を照合しました。結果の要点です。
| 項目 | 判定 | 見つかったこと |
|---|---|---|
| CMS の原本 533件 | ✅ | 公開サイトの本文と完全一致 |
| 本文の文字 | ❌ | 7ページで文字や数値が欠けた |
| コードブロック | ❌ | 2,106個のうち68ページの163個で、空行が計1,359個消えていた |
| 表 | ❌ | 10ページで行・セルが合わない。|diff| のような絶対値の記号が列の区切りと解釈された |
| 見出し・リスト | ⚠️ | 50ページで構成が違う。本文中に書かれた # や - が見出しやリストになった |
| 太字 | ❌ | 52ページで ** がそのまま見える |
| DAY番号 | ❌ | LOG13 の記事の CMS 値が DA13 で、フォルダ名が DAYxxx_day13 になった |
| 画像 | ❌ | トップページの動画のポスター画像が1点ない |
| KIOXIA | ⚠️ | コピーの後に動画が8本増えていた |
| 秘密情報 | ❌ | コードのコピーにパスワードの値が1つ、作業ファイルに AWS の署名付き URL が1つ残っていた |
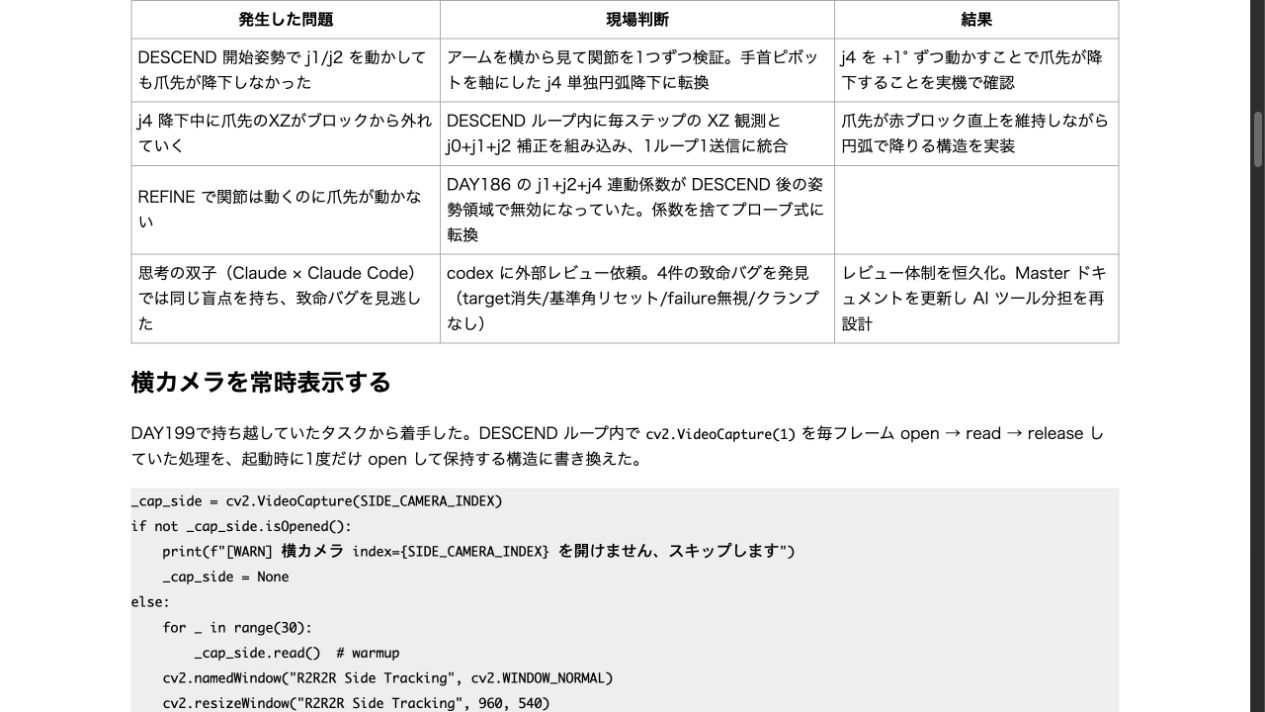
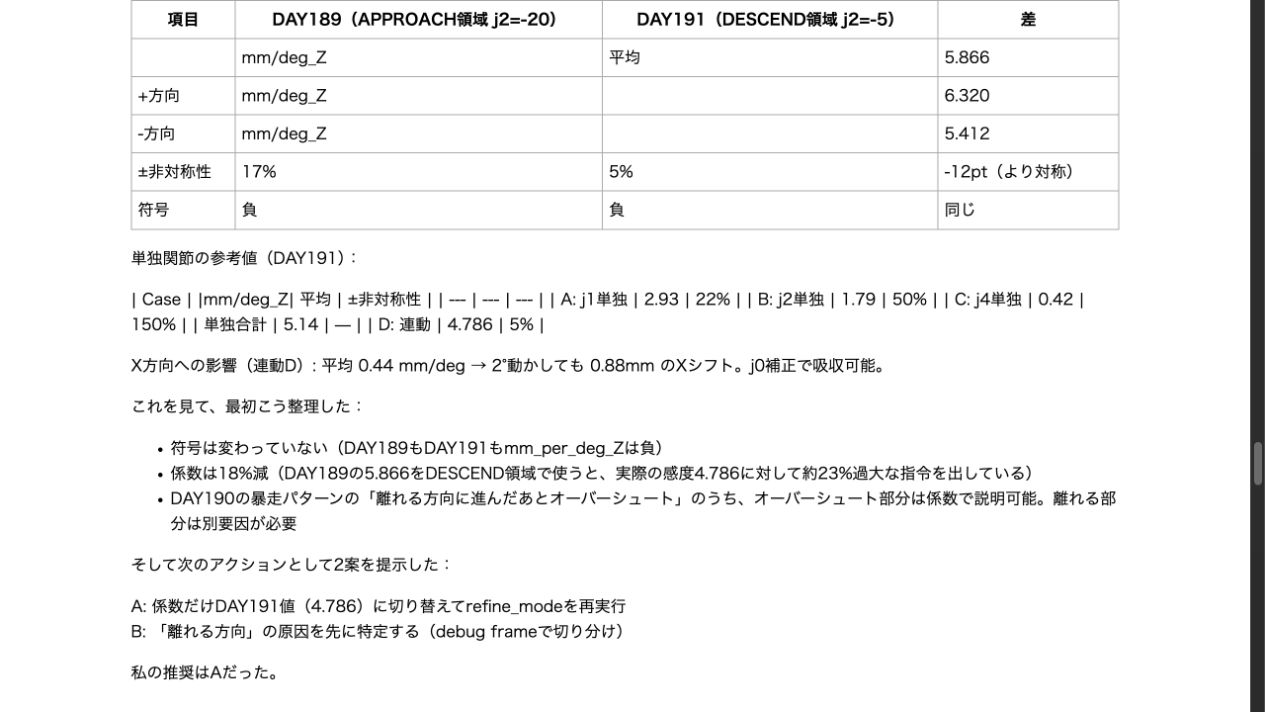
上の2枚は codex が表示を確かめたときの画面です。1枚目は LOG200 の表で、右下の「結果」のセルが空になっています。元は「|diff| が前回より減れば同方向継続・増えれば反転する自己修正ループへ」という文で、| で囲んだ絶対値の記号が表の列の区切りと読まれて消えました。2枚目は LOG191 で、表が表として表示されず、| の並んだ文字列になっています。
原因はどれも convert_v1.py にありました。
- コードの空行: 変換の最後に「3行以上続く改行を2行に詰める」処理を、コードブロックの中にもかけていた
- 表: markdownify に任せたため、セルの中の
|をエスケープしていなかった。見出し行のない表には、空の見出し行が足されていた - 太字:
**収縮(erosion)**はのように、**の内側が括弧などの記号で終わり、外側が文字で続くと、Markdown の規則では太字にならない - 見出し・リスト: 元の本文に文字として書かれていた
#や-を、Markdown の記号として残していた
変換を作り直し、533ページを元の HTML と1文字単位で突き合わせた
変換スクリプトを convert.py(v2)に書き直しました。変えたのは次の点です。
| 対象 | v1 | v2 |
|---|---|---|
| コードブロック | 改行を詰める処理の対象になっていた | 変換中は別の場所に退避し、最後に一字も変えずに戻す。リストの中のコードは字下げを保つ |
| 表 | markdownify 任せ | 見出し行があり、セルの結合がない表は Markdown の表(セルの中の縦棒には \ を付ける。セル内の改行は <br>)。それ以外は HTML の表のまま入れる |
| 本文中の記号 | そのまま | 行頭の #・-・1.・>、|・*・[ などを \ でエスケープ |
| 太字・斜体 | 常に ** | ** が効かない形のときだけ <strong> で書く |
| 埋め込み | 図解だけ HTML に保存 | YouTube の埋め込みも含め、303件すべてを HTML に保存 |
| DAY番号 | DAY で始まる値だけ読む | DA13 も 13 と読む。CMS の値は day にそのまま、数字は day_number に分けて入れる |
| 概要が空の記事 | null | 空文字 "" |
あわせて、変換結果を確かめるスクリプト verify_md.py を書きました。元の本文 HTML と、Markdown を表示用の HTML に変換したものを並べ、本文の文字列、コードブロック(1文字単位)、表のセル、見出し、リストの項目数、太字の数を比べます。533ページで差分が0になるまで直しました。最後に残った差は、空白だけの太字(<strong> </strong>)と中身のない箇条書きが Markdown では消えることで、内容の欠けではないため数え方から外しています。
ほかに、指摘に沿って次のものを足しました。
- 公開ページの HTML そのもの546件(codex が取得したものを
raw/html/にコピー) - 共通のヘッダー・フッター・ファビコン・OGP 画像(
content/static/_common/)。Studio の「シンボル」(全ページ共通のパーツ)の設計データは公開側から取れないので、表示されたヘッダーの HTML を見本として控えた - Studio に設定されているリダイレクト28件(
data/redirects.csv)と、登録フォント21件(data/fonts.json) - パスワードの値と AWS の署名は、アーカイブ側のコピーだけ伏せ字にした(元のファイルはそのまま。パスワードを含むファイルは git の管理外で、GitHub には上がっていない)
codex の2回目の検証で、本文はすべて一致し、動画の作業がアーカイブの中で行われていたと分かった
2回目の依頼書(codex_reverification_request.md)では、Claude が「直した」と言っている点を1つずつ表にして、それぞれの真偽を判定させました。直したことで別の箇所が壊れていないかも見させています。
codex は公開サイトから546ページを取り直し、Markdown の表示には2種類の変換器(markdown-it-py と Marked)を使って照合しました。
| 項目 | 判定 | 結果 |
|---|---|---|
| 本文の文字 533ページ | ✅ | 差分0。エスケープの \ が文字として見える箇所も0 |
| コードブロック 2,106個 | ✅ | すべて1文字単位で一致 |
| 表 658個 | ✅ | セルと改行の位置まで一致。Markdown の表645個、HTML の表13個 |
| 見出し | ✅ | 4,086個すべて一致 |
| リスト | ⚠️ | 項目の中身は同じ。隣り合う箇条書きが1つにまとまるページが33、中身のない項目の省略が2 |
| 太字 | ⚠️ | 変換で新たに ** が見える箇所は0。LOG79・80 は元の本文に ** が文字で書いてある |
| KIOXIA 62ファイル | ✅ | すべて SHA-256 一致 |
| 作業ファイル | ❌ | コピー側の8ファイルが元より新しく、内容も違う。コピーにしかないファイルが9件増えている |
最後の項目は、変換の問題ではありませんでした。調べると、コピー側の narration.py や scenes.py の更新時刻は14:42〜15:05で、元のフォルダの同じファイル(08:26〜10:51)より新しくなっていました。16:09 にはサムネ案の画像や 概要欄.txt まで、アーカイブの中に作られていました。別の作業で進めていた解説動画の制作が、元のフォルダではなく site_archive/work_files/…/動画/ の中で行われていたということです。元のフォルダには、その間に台本15本と事実確認の3本が追加されていて、同じ作業が2か所に分かれていました。
どうするかを確認したうえで、アーカイブの中で作られた41ファイルと書き換えられた8ファイルを元のフォルダへ戻しました。書き換える前の元の8ファイルは _restore_backup_20261012/ に退避しています。戻したあとでアーカイブを元に合わせ直し、16:12 の時点で、元と共通する1,511ファイルのうち、伏せ字の1件を除くすべてが元と一致しました。アーカイブの README と作業ファイルの目録には、「ここは保存用のコピーで、ここで作業しない」と書いています。
公開サイトについても1つ分かりました。トップページのデザインに、404 になる /pixelstomotors/ai-agent へのリンクが残っています。アーカイブは取得したままにして、サイト側で直します。
アーカイブ site_archive に入っているもの
| フォルダ | 中身 |
|---|---|
| README.md | 入口。件数、構成、変換のルール、時点、伏せ字の箇所、探し方 |
| index/ | 一覧と索引の Markdown 10本 |
| data/ | pages.csv(533件)、images.csv、embeds.csv、videos.csv、links.csv、redirects.csv、fonts.json、stats.json |
| content/record/ | 記事339本(1本1フォルダ。article.md・images・embeds・thumbnail.html) |
| content/manga/・english/ | 4コマ99話・英語版95話 |
| content/static/ | 固定ページ13・テンプレート3・共通パーツ1 |
| raw/html/ | 公開ページの HTML 546件 |
| raw/cms/ | CMS データを JSON に戻したもの 533件 |
| raw/studio/ | 固定ページのデザイン構造とサイト設定 |
| kioxia_r2r2r-data/ | KIOXIA の videos/・lab/ と README(62ファイル) |
| work_files/ | 記事の作業ファイルのコピーと目録 _MANIFEST.md |
| code/ | r2r2r-scripts のコピー、r2r2r-content のコピー |
| tools/ | 作り直し・検証用のスクリプト |
| _review/ | codex の依頼書・報告・検証スクリプト |
件数は次のとおりです。
| 種類 | 件数 |
|---|---|
| 記事 | 339本(R2R2R 185・考察記事 63・HRI 54・画像認識・物体検出 11・ロボティクスデザイン 9・フィジカルAI研究室 8・Consideration 7・UV-C農業ロボット 2) |
| 4コマ / 英語版 | 99話 / 95話 |
| 画像(記事・マンガ) | 元の URL で数えて972点。同じ画像を複数ページで使う分を含むファイル数は973 |
| 埋め込み HTML | 303(図解286・YouTube 17) |
| 記事内の動画 | 21(mp4 4本・YouTube 17本) |
| 全体 | 約2.3GB |
アーカイブは2026年10月12日時点の写しで、記事が増えても自動では足されません。作業ファイルだけは tools/sync_work_files.sh で差分を足せます(追加と上書きのみで、削除はしません)。
残っていること
- トップページの
/pixelstomotors/ai-agent(404)へのリンクを Studio 側で直す - 解説動画を作っている作業の保存先を、元の
PixelstoMotors/デジタルツイン学習R2R2R/動画/に向け直す - 記事が増えたら、同じ手順でアーカイブを作り直す
- 古い Markdown 変換器(Python-Markdown など)では、LOG016・206・294 の表が崩れる。アーカイブは GitHub 形式の Markdown と HTML が表示できるビューアを前提にしている
使ったスクリプトの全文
ブラウザで取り出す部分は JavaScript、変換と照合は Python です。ブラウザのスクリプトは、Claude デスクトップアプリのブラウザペインで adaptdesign.jp のページを開いた状態で、実行した順に載せています(1回ずつ実行して結果を確かめながら進めたので、ファイルとしては保存していません。番号は記事のために付けました)。Python とシェルのスクリプトは、アーカイブの tools/ に入っているものと、作業用のシェルに置いたものです。convert_v1.py は codex の1回目の検証で崩れが見つかった版で、記録として残しています。
| ファイル | 役割 |
|---|---|
| 01_unflat_and_first_item.js | __NUXT_DATA__ の平たい配列を元の形に戻す関数と、1記事分の確認 |
| 02_getPage.js | 1ページ分の HTML を取得し、CMS データと meta タグを取り出す |
| 03_collect_all_pages.js | サイトマップの全533ページを6本並行で取得する |
| 04_zip_writer.js | 圧縮なしの zip を組み立てる関数と、ダウンロードする関数 |
| 05_trial10_download.js | 試しの10ページを zip にして保存する |
| 06_raw_zip_and_media_list.js | 533ページの CMS データを zip にし、画像・動画の URL を集める |
| 07_media_batches.js | 画像・動画976点を200点ずつ zip にして保存する |
| 08_static_pages_router.js | 固定ページを1枚ずつ開き、Studio のデザイン構造を読み込ませる |
| 09_static_zip.js | 固定ページのデザイン構造とサイト設定・画像を zip にする |
| 10_common_header_zip.js | 共通ヘッダーの HTML・head・ロゴ・ファビコン・OGP 画像を zip にする |
| convert_v1.py | CMS データ → Markdown(1回目。空行・表・太字が崩れた版) |
| convert.py | CMS データ → Markdown(作り直した版) |
| verify_md.py | 元の HTML と Markdown の突き合わせ |
| static_pages.py | 固定ページのデザイン構造 → Markdown |
| gen_index.py | index/ の一覧と data/stats.json を作る |
| gen_files_index.py | index/07_作業ファイルとコード.md を作る |
| copy_work.sh | 作業ファイルの初回コピー(除外が効かなかった版) |
| rs.sh / excl.txt | 作業ファイルの追加コピー(除外を NFC と NFD の両方で書いた版) |
| sync_work_files.sh | 作業ファイルの追加コピー(アーカイブに置いた、手元で使う版) |
01_unflat_and_first_item.js
window.__unflat = function(arr){
  const memo = new Map();
  function h(i){
    if (typeof i !== 'number') return i;
    if (i < 0) return undefined;
    if (memo.has(i)) return memo.get(i);
    const v = arr[i];
    if (v === null || typeof v !== 'object') { memo.set(i,v); return v; }
    if (Array.isArray(v)) {
      if (typeof v[0] === 'string' && ['ShallowReactive','Reactive','Ref','ShallowRef','EmptyRef','EmptyShallowRef','NuxtError','Set','Map','Date','RegExp','BigInt','Object','null','undefined','NaN','Infinity','-Infinity','-0'].includes(v[0])) {
        const t=v[0];
        if (t==='Date') { const d=v[1]; memo.set(i,d); return d; }
        if (t==='Set'||t==='Map') { const o=[]; memo.set(i,o); for (const x of v.slice(1)) o.push(h(x)); return o; }
        if (t==='EmptyRef'||t==='EmptyShallowRef') return v[1];
        const r = h(v[1]); memo.set(i,r); return r;
      }
      const o=[]; memo.set(i,o); for (const x of v) o.push(h(x)); return o;
    }
    const o={}; memo.set(i,o); for (const k in v) o[k]=h(v[k]); return o;
  }
  return h(0);
};
const html = await fetch(location.href).then(r=>r.text());
const raw = JSON.parse(html.match(/<script[^>]*id="__NUXT_DATA__"[^>]*>([\s\S]*?)<\/script>/)[1]);
const root = __unflat(raw);
const item = Object.values(root.data)[0];
const s = (x)=>JSON.stringify(x);
({keys:Object.keys(item), item_no_body: s({...item, body: undefined}).slice(0,3000), bodyType: typeof item.body, bodyHead: (typeof item.body==='string'? item.body : s(item.body)).slice(0,1500), bodyLen: (typeof item.body==='string'? item.body : s(item.body)).length})
02_getPage.js
window.__getPage = async function(url){
  const html = await fetch(url).then(r=>r.text());
  const m = html.match(/<script[^>]*id="__NUXT_DATA__"[^>]*>([\s\S]*?)<\/script>/);
  const root = m ? __unflat(JSON.parse(m[1])) : null;
  const head = {};
  const t = html.match(/<title>([\s\S]*?)<\/title>/); head.title = t && t[1];
  for (const mm of html.matchAll(/<meta\s+([^>]+)>/g)) { const a = mm[1]; const k = (a.match(/(?:name|property)="([^"]+)"/)||[])[1]; const c = (a.match(/content="([^"]*)"/)||[])[1]; if (k) head[k]=c; }
  return {url, html, root, head};
};
const short = o => JSON.stringify(o, (k,v)=> typeof v==='string' && v.length>200 ? v.slice(0,200)+`…(${v.length})` : v);
const out = {};
for (const u of ['/pixelstomotors/manga/ep122','/pixelstomotors/english-4-koma/ep122','/pixelstomotors/series1','/pixelstomotors','/pixelstomotors/mecharm_data_blueprint','/pixelstomotors/record/day1']) {
  const p = await __getPage(u);
  out[u] = {htmlLen: p.html.length, dataKeys: p.root? Object.keys(p.root.data):null, data: p.root? short(p.root.data).slice(0,1500):null, imgs: [...new Set(p.html.match(/https:\/\/storage\.googleapis\.com\/studio-design-asset-files\/[^"'\s\\)]+/g)||[])].length};
}
out
03_collect_all_pages.js
const maps = {record:'cGl4ZWxzdG9tb3RvcnMvcmVjb3JkLzpzbHVn', manga:'cGl4ZWxzdG9tb3RvcnMvbWFuZ2EvOnNsdWc', english:'cGl4ZWxzdG9tb3RvcnMvZW5nbGlzaC00LWtvbWEvOnNsdWc'};
window.__urls = {};
for (const [k,m] of Object.entries(maps)) {
  const x = await fetch(`/sitemap-dynamic/sitemap-dynamic-${m}.xml`).then(r=>r.text());
  __urls[k] = [...x.matchAll(/<url>\s*<loc>([^<]+)<\/loc>(?:\s*<lastmod>([^<]+)<\/lastmod>)?/g)].map(a=>({url:a[1], lastmod:a[2]||null}));
}
window.__pages = window.__pages || {};
const all = Object.entries(__urls).flatMap(([k,arr])=>arr.map(o=>({...o, kind:k})));
let i=0, errs=[];
async function worker(){ while(i<all.length){ const o=all[i++]; if (__pages[o.url]) continue; try { const p = await __getPage(o.url); const item = p.root && Object.values(p.root.data)[0]; __pages[o.url] = {...o, head:p.head, item}; } catch(e){ errs.push(o.url+' '+e.message) } } }
await Promise.all(Array.from({length:6}, worker));
const vals = Object.values(__pages);
({total: all.length, got: vals.length, nullItems: vals.filter(v=>!v.item).map(v=>v.url), errs})
04_zip_writer.js
(() => {
const T = new Uint32Array(256); for (let n=0;n<256;n++){let c=n;for(let k=0;k<8;k++)c=c&1?0xEDB88320^(c>>>1):c>>>1;T[n]=c>>>0;}
const crc = u8 => { let c=0xFFFFFFFF; for (let i=0;i<u8.length;i++) c=T[(c^u8[i])&0xFF]^(c>>>8); return (c^0xFFFFFFFF)>>>0; };
window.__makeZip = function(files){ // files: [{name, data:Uint8Array}]
  const enc = new TextEncoder(); const parts=[]; const central=[]; let off=0;
  for (const f of files){
    const nm = enc.encode(f.name); const d = f.data; const c = crc(d);
    const h = new DataView(new ArrayBuffer(30));
    h.setUint32(0,0x04034b50,true); h.setUint16(4,20,true); h.setUint16(6,0x0800,true); h.setUint16(8,0,true);
    h.setUint16(10,0,true); h.setUint16(12,0x21,true); h.setUint32(14,c,true); h.setUint32(18,d.length,true); h.setUint32(22,d.length,true);
    h.setUint16(26,nm.length,true); h.setUint16(28,0,true);
    parts.push(new Uint8Array(h.buffer), nm, d);
    const ch = new DataView(new ArrayBuffer(46));
    ch.setUint32(0,0x02014b50,true); ch.setUint16(4,20,true); ch.setUint16(6,20,true); ch.setUint16(8,0x0800,true); ch.setUint16(10,0,true);
    ch.setUint16(12,0,true); ch.setUint16(14,0x21,true); ch.setUint32(16,c,true); ch.setUint32(20,d.length,true); ch.setUint32(24,d.length,true);
    ch.setUint16(28,nm.length,true); ch.setUint32(42,off,true);
    central.push(new Uint8Array(ch.buffer), nm);
    off += 30+nm.length+d.length;
  }
  const cdSize = central.reduce((a,b)=>a+b.length,0);
  const e = new DataView(new ArrayBuffer(22));
  e.setUint32(0,0x06054b50,true); e.setUint16(8,files.length,true); e.setUint16(10,files.length,true); e.setUint32(12,cdSize,true); e.setUint32(16,off,true);
  return new Blob([...parts, ...central, new Uint8Array(e.buffer)], {type:'application/zip'});
};
window.__imgName = u => { const p = new URL(u).pathname.split('/'); return 'images/'+p[1]+'/'+p.slice(2).join('_'); };
window.__buildZip = async function(urls, withImages){
  const enc = new TextEncoder(); const files=[]; const imgSet = new Set(); const imgRe = /https:\/\/storage\.googleapis\.com\/studio-[a-z-]+\/[^"'\s\\)<>&]+/g;
  for (const u of urls){ const v = __pages[u]; const slug = u.split('/').pop();
    files.push({name:`raw/${v.kind}/${slug}.json`, data: enc.encode(JSON.stringify(v,null,1))});
    (JSON.stringify(v.item).match(imgRe)||[]).forEach(x=>imgSet.add(x)); }
  const failed=[];
  if (withImages){ const list=[...imgSet]; let i=0;
    async function w(){ while(i<list.length){ const x=list[i++]; try{ const r=await fetch(x); if(!r.ok) throw new Error(r.status); files.push({name:__imgName(x), data:new Uint8Array(await r.arrayBuffer())}); }catch(e){failed.push(x+' '+e.message)} } }
    await Promise.all(Array.from({length:6},w)); }
  return {files, failed, imgCount: imgSet.size};
};
window.__download = function(blob, name){ const a=document.createElement('a'); a.href=URL.createObjectURL(blob); a.download=name; document.body.appendChild(a); a.click(); a.remove(); };
return 'ok';
})()
05_trial10_download.js
const rec = __urls.record.map(o=>o.url);
const pick = [rec[0], rec[5], rec[6], rec[37], rec[150], rec[rec.length-1], rec[rec.length-50], rec[rec.length-170], __urls.manga[0].url, __urls.english[0].url];
const r = await __buildZip(pick, true);
const blob = __makeZip(r.files);
__download(blob, 'pixelstomotors_trial10.zip');
({pick: pick.map(u=>u.replace('https://adaptdesign.jp','')), files: r.files.length, imgs: r.imgCount, failed: r.failed, sizeMB: (blob.size/1e6).toFixed(2)})
06_raw_zip_and_media_list.js
const imgRe = /https:\/\/storage\.googleapis\.com\/studio-[a-z-]+\/[^"'\s\\)<>&]+/g;
const set = new Set();
for (const v of Object.values(__pages)) {
  const s = JSON.stringify(v.item); (s.match(imgRe)||[]).forEach(u=>set.add(u));
  const b = v.item.body||'';
  for (const m of b.matchAll(/data-type="embed_code"[^>]*>([^<]*)</g)) { let d; try { d = decodeURIComponent(m[1]); } catch(e) { continue; } (d.match(imgRe)||[]).forEach(u=>set.add(u)); }
}
window.__allMedia = [...set];
const enc = new TextEncoder();
const files = Object.values(__pages).map(v=>({name:`raw/${v.kind}/${v.url.split('/').pop()}.json`, data: enc.encode(JSON.stringify(v,null,1))}));
files.push({name:'raw/urls.json', data: enc.encode(JSON.stringify(__urls,null,1))});
const blob = __makeZip(files);
__download(blob, 'pixelstomotors_raw.zip');
({media: __allMedia.length, rawFiles: files.length, rawMB: (blob.size/1e6).toFixed(1)})
07_media_batches.js
window.__job = {done:0, batches:[], failed:[], status:'running'};
(async () => {
  const list = __allMedia; const per = 200;
  for (let b = 0; b*per < list.length; b++) {
    const chunk = list.slice(b*per, (b+1)*per); const files = []; let i = 0;
    async function w(){ while(i<chunk.length){ const u = chunk[i++]; for (let t=0;t<3;t++){ try { const r = await fetch(u); if(!r.ok) throw new Error(r.status); files.push({name: __imgName(u), data: new Uint8Array(await r.arrayBuffer())}); break; } catch(e){ if(t===2) __job.failed.push(u+' '+e.message); await new Promise(r=>setTimeout(r,1000)); } } __job.done++; } }
    await Promise.all(Array.from({length:6}, w));
    const blob = __makeZip(files);
    const name = `pixelstomotors_media_${String(b+1).padStart(2,'0')}.zip`;
    __download(blob, name);
    __job.batches.push({name, files: files.length, MB: +(blob.size/1e6).toFixed(1)});
    await new Promise(r=>setTimeout(r,4000));
  }
  __job.status = 'finished';
})();
'started'
08_static_pages_router.js
const app = document.querySelector('#__nuxt').__vue_app__;
const router = app.config.globalProperties.$router;
const pvm = () => app.config.globalProperties.$pinia.state.value.productStore.pageViewMap;
const tick = () => fetch('/robots.txt?'+Math.random()).then(r=>r.text());
const paths = ['/pixelstomotors','/2','/pixelstomotors/mecharm_data_blueprint','/pixelstomotors/manga-archive','/pixelstomotors/manga-archive-en','/pixelstomotors/series1','/pixelstomotors/series2','/pixelstomotors/series3','/pixelstomotors/series4','/pixelstomotors/series5','/pixelstomotors/series6','/pixelstomotors/series7','/pixelstomotors/privacypolicy','/pixelstomotors/message','/pixelstomotors/record/day1','/pixelstomotors/manga/ep122','/pixelstomotors/english-4-koma/ep122'];
window.__st2 = {}; window.__st2Job='running';
(async () => {
for (const p of paths) {
  await router.push(p);
  for (let i=0;i<15;i++) await tick();
  const imgs = [...document.querySelectorAll('img')].map(i=>i.getAttribute('src')||'').filter(s=>s.startsWith('http'));
  const links = [...document.querySelectorAll('a[href]')].map(a=>({text:a.innerText.trim().slice(0,100), href:a.href}));
  __st2[p] = {title: document.title, text: document.body.innerText, html: document.documentElement.outerHTML, imgs:[...new Set(imgs)], links};
}
__st2Job='done';
})();
'ok'
09_static_zip.js
const T = new Uint32Array(256); for (let n=0;n<256;n++){let c=n;for(let k=0;k<8;k++)c=c&1?0xEDB88320^(c>>>1):c>>>1;T[n]=c>>>0;}
const crc = u8 => { let c=0xFFFFFFFF; for (let i=0;i<u8.length;i++) c=T[(c^u8[i])&0xFF]^(c>>>8); return (c^0xFFFFFFFF)>>>0; };
function makeZip(files){ const enc=new TextEncoder(); const parts=[],central=[]; let off=0;
 for (const f of files){ const nm=enc.encode(f.name), d=f.data, c=crc(d); const h=new DataView(new ArrayBuffer(30));
  h.setUint32(0,0x04034b50,true);h.setUint16(4,20,true);h.setUint16(6,0x0800,true);h.setUint16(12,0x21,true);h.setUint32(14,c,true);h.setUint32(18,d.length,true);h.setUint32(22,d.length,true);h.setUint16(26,nm.length,true);
  parts.push(new Uint8Array(h.buffer),nm,d); const ch=new DataView(new ArrayBuffer(46));
  ch.setUint32(0,0x02014b50,true);ch.setUint16(4,20,true);ch.setUint16(6,20,true);ch.setUint16(8,0x0800,true);ch.setUint16(14,0x21,true);ch.setUint32(16,c,true);ch.setUint32(20,d.length,true);ch.setUint32(24,d.length,true);ch.setUint16(28,nm.length,true);ch.setUint32(42,off,true);
  central.push(new Uint8Array(ch.buffer),nm); off+=30+nm.length+d.length; }
 const cd=central.reduce((a,b)=>a+b.length,0); const e=new DataView(new ArrayBuffer(22)); e.setUint32(0,0x06054b50,true);e.setUint16(8,files.length,true);e.setUint16(10,files.length,true);e.setUint32(12,cd,true);e.setUint32(16,off,true);
 return new Blob([...parts,...central,new Uint8Array(e.buffer)],{type:'application/zip'}); }
const st = document.querySelector('#__nuxt').__vue_app__.config.globalProperties.$pinia.state.value.productStore;
const enc = new TextEncoder(); const files = [];
const J = (name, obj) => files.push({name, data: enc.encode(JSON.stringify(obj, null, 1))});
J('studio/product.json', st.product);
J('studio/symbolViewMap.json', st.symbolViewMap||{});
for (const [k,v] of Object.entries(st.pageViewMap)) J('studio/pages/'+k.replace(/\//g,'__').replace(/:/g,'')+'.json', v);
const all = JSON.stringify([st.product, st.pageViewMap, st.symbolViewMap]);
const media = [...new Set(all.match(/https:\/\/storage\.googleapis\.com\/(?:studio-[a-z-]+|production-os-assets)\/[^"'\s\\)<>&]+/g)||[])];
const failed = [];
for (const u of media) { try { const r = await fetch(u); if(!r.ok) throw new Error(r.status); const p = new URL(u).pathname.split('/'); files.push({name:'images/'+p[1]+'/'+p.slice(2).join('_'), data:new Uint8Array(await r.arrayBuffer())}); } catch(e){ failed.push(u+' '+e.message) } }
J('studio/media_urls.json', media);
const blob = makeZip(files);
const a=document.createElement('a'); a.href=URL.createObjectURL(blob); a.download='pixelstomotors_static.zip'; document.body.appendChild(a); a.click(); a.remove();
({files: files.length, media: media.length, failed, MB:(blob.size/1e6).toFixed(1), symView: Object.keys(st.symbolViewMap||{}).length})
10_common_header_zip.js
const T = new Uint32Array(256); for (let n=0;n<256;n++){let c=n;for(let k=0;k<8;k++)c=c&1?0xEDB88320^(c>>>1):c>>>1;T[n]=c>>>0;}
const crc = u8 => { let c=0xFFFFFFFF; for (let i=0;i<u8.length;i++) c=T[(c^u8[i])&0xFF]^(c>>>8); return (c^0xFFFFFFFF)>>>0; };
function makeZip(files){ const enc=new TextEncoder(); const parts=[],central=[]; let off=0;
 for (const f of files){ const nm=enc.encode(f.name), d=f.data, c=crc(d); const h=new DataView(new ArrayBuffer(30));
  h.setUint32(0,0x04034b50,true);h.setUint16(4,20,true);h.setUint16(6,0x0800,true);h.setUint16(12,0x21,true);h.setUint32(14,c,true);h.setUint32(18,d.length,true);h.setUint32(22,d.length,true);h.setUint16(26,nm.length,true);
  parts.push(new Uint8Array(h.buffer),nm,d); const ch=new DataView(new ArrayBuffer(46));
  ch.setUint32(0,0x02014b50,true);ch.setUint16(4,20,true);ch.setUint16(6,20,true);ch.setUint16(8,0x0800,true);ch.setUint16(14,0x21,true);ch.setUint32(16,c,true);ch.setUint32(20,d.length,true);ch.setUint32(24,d.length,true);ch.setUint16(28,nm.length,true);ch.setUint32(42,off,true);
  central.push(new Uint8Array(ch.buffer),nm); off+=30+nm.length+d.length; }
 const cd=central.reduce((a,b)=>a+b.length,0); const e=new DataView(new ArrayBuffer(22)); e.setUint32(0,0x06054b50,true);e.setUint16(8,files.length,true);e.setUint16(10,files.length,true);e.setUint32(12,cd,true);e.setUint32(16,off,true);
 return new Blob([...parts,...central,new Uint8Array(e.buffer)],{type:'application/zip'}); }
const enc = new TextEncoder(); const files = [];
const clean = e => { const c = e.cloneNode(true); c.querySelectorAll('*').forEach(x=>{ [...x.attributes].forEach(at=>{ if(!['href','src','alt','aria-label','target'].includes(at.name)) x.removeAttribute(at.name); }); }); return c.outerHTML; };
files.push({name:'common/header.html', data: enc.encode(clean(document.querySelector('header')))});
const a = [...document.querySelectorAll('a[href*="privacypolicy"]')].pop(); let el=a; for (let i=0;i<3;i++) el=el.parentElement;
files.push({name:'common/footer.html', data: enc.encode(clean(el))});
const head = [...document.head.querySelectorAll('meta,link')].map(x=>x.outerHTML).join('\n');
files.push({name:'common/head_tags.html', data: enc.encode(head)});
const urls = ['https://storage.googleapis.com/studio-design-asset-files/projects/p6aoJ4vyqR/s-150x150_bd2f50ec-32b7-4aa4-a68a-4fcf4818be94.svg','https://storage.googleapis.com/production-os-assets/assets/9cad887a-242b-4953-bd36-7b368c27d1b9','https://storage.googleapis.com/production-os-assets/assets/d2365e9f-2bfd-4546-a6e4-7f74997ea4c4','https://storage.googleapis.com/production-os-assets/assets/ffb300c2-1071-4714-978c-87d386d5dfd3'];
const info = [];
for (const u of urls) { const r = await fetch(u); const b = new Uint8Array(await r.arrayBuffer()); const ct = r.headers.get('content-type'); const ext = (ct||'').split('/')[1]?.split(/[;+]/)[0] || 'bin'; const name = 'common/assets/' + u.split('/').pop() + (u.includes('production-os-assets') ? '.'+ext : ''); files.push({name, data:b}); info.push([u, name, ct, b.length]); }
files.push({name:'common/assets.json', data: enc.encode(JSON.stringify(info,null,1))});
const blob = makeZip(files);
const l=document.createElement('a'); l.href=URL.createObjectURL(blob); l.download='pixelstomotors_common.zip'; document.body.appendChild(l); l.click(); l.remove();
({info, footerLen: clean(el).length, size: blob.size})
convert_v1.py
#!/usr/bin/env python3
"""raw/{kind}/{slug}.json + images/ -> content/{kind}/{folder}/ (md + images + embeds)"""
import json, os, re, sys, shutil, urllib.parse, csv
from bs4 import BeautifulSoup
from markdownify import MarkdownConverter
SRC, OUT = sys.argv[1], sys.argv[2]
SITE = 'https://adaptdesign.jp'
IMG_RE = re.compile(r'https://storage\.googleapis\.com/studio-[a-z-]+/[^"\'\s\\)<>&]+')
def local_img_src(url):
p = urllib.parse.urlparse(url).path.split('/')
return os.path.join(SRC, 'images', p[1], '_'.join(p[2:]))
def basename(url):
return urllib.parse.urlparse(url).path.split('/')[-1]
class Conv(MarkdownConverter):
def convert_pre(self, el, text, parent_tags=None, **kw):
code = el.get_text()
fence = '````' if '```' in code else '```'
return f'\n\n{fence}\n{code.rstrip()}\n{fence}\n\n'
def yaml_val(v):
if v is None: return 'null'
if isinstance(v, bool): return 'true' if v else 'false'
if isinstance(v, list): return '[' + ', '.join(json.dumps(x, ensure_ascii=False) for x in v) + ']'
return json.dumps(v, ensure_ascii=False)
def folder_name(kind, it):
if kind == 'record':
day = (it.get('bPskK658') or '').upper().replace(' ', '')
m = re.match(r'DAY(\d+)', day)
pre = f'DAY{int(m.group(1)):03d}' if m else 'DAYxxx'
return f'{pre}_{it["slug"]}'
return it['slug']
rows = {'pages': [], 'images': [], 'embeds': [], 'videos': [], 'links': []}
def process(kind, path):
d = json.load(open(path, encoding='utf-8'))
it = d['item']; url = d['url']; meta = it.get('_meta', {})
fname = folder_name(kind, it)
odir = os.path.join(OUT, 'content', kind, fname)
os.makedirs(os.path.join(odir, 'images'), exist_ok=True)
rel_page = f'content/{kind}/{fname}'
used_imgs = []
def take_img(u, role):
src = local_img_src(u); bn = basename(u)
ok = os.path.exists(src)
if ok: shutil.copy2(src, os.path.join(odir, 'images', bn))
used_imgs.append(bn)
rows['images'].append({'page': rel_page, 'role': role, 'file': f'{rel_page}/images/{bn}', 'source_url': u, 'downloaded': ok})
return f'images/{bn}'
soup = BeautifulSoup(it.get('body') or '', 'html.parser')
# table of contents placeholder -> remove
for t in soup.select('div[data-type=table_of_contents]'): t.decompose()
# embeds
n = 0
for e in soup.select('div[data-type=embed_code]'):
n += 1
etype = e.get('data-embed-code-type', 'custom')
code = urllib.parse.unquote(e.get_text())
yt = re.findall(r'youtube(?:-nocookie)?\.com/embed/([A-Za-z0-9_-]{11})', code)
if etype == 'youtube' or (yt and len(code) < 1500):
for vid in yt:
rows['videos'].append({'page': rel_page, 'type': 'youtube', 'url': f'https://www.youtube.com/watch?v={vid}', 'file': ''})
rep = ''.join(f'\n\n[YouTube: https://www.youtube.com/watch?v={v}](https://www.youtube.com/watch?v={v})\n\n' for v in yt) or '\n\n[YouTube埋め込み]\n\n'
else:
os.makedirs(os.path.join(odir, 'embeds'), exist_ok=True)
# images inside embed html -> localize
for u in set(IMG_RE.findall(code)):
code = code.replace(u, take_img(u, 'embed').replace('images/', '../images/'))
title = re.search(r'<title>(.*?)</title>', code, re.S)
title = title.group(1).strip() if title else ''
ef = f'embeds/{n:02d}_{e.get("data-uid","x")}.html'
open(os.path.join(odir, ef), 'w', encoding='utf-8').write(code)
rows['embeds'].append({'page': rel_page, 'file': f'{rel_page}/{ef}', 'title': title, 'bytes': len(code.encode())})
rep = f'\n\n> 📊 埋め込みHTML(図解): [{title or ef}]({ef})\n\n'
e.replace_with(BeautifulSoup(f'<p>EMBEDPLACEHOLDER{n}</p>', 'html.parser'))
e_rep = rep
globals().setdefault('_reps', {})[f'EMBEDPLACEHOLDER{n}'] = e_rep
# videos
for v in soup.select('video'):
u = v.get('src', '')
if u:
local = take_img(u, 'video')
rows['videos'].append({'page': rel_page, 'type': 'mp4', 'url': u, 'file': f'{rel_page}/{local}'})
v.replace_with(BeautifulSoup(f'<p>VIDEOPLACEHOLDER{basename(u)}</p>', 'html.parser'))
globals().setdefault('_reps', {})[f'VIDEOPLACEHOLDER{basename(u)}'] = f'\n\n🎬 動画: [{basename(u)}]({local})\n\n'
# images
for im in soup.select('img'):
u = im.get('src', '')
if IMG_RE.match(u): im['src'] = take_img(u, 'body')
# links
for a in soup.select('a[href]'):
rows['links'].append({'page': rel_page, 'text': a.get_text(strip=True)[:80], 'href': a['href']})
for t in soup.find_all(True):
for att in ('data-uid', 'data-time', 'data-thread', 'style'):
if att in t.attrs: del t.attrs[att]
md = Conv(heading_style='ATX', bullets='-', escape_underscores=False, escape_asterisks=False).convert(str(soup))
for k, v in globals().get('_reps', {}).items():
md = md.replace(k, v.strip('\n'))
globals()['_reps'] = {}
md = re.sub(r'\n{3,}', '\n\n', md).strip() + '\n'
fm = {'title': it.get('title'), 'slug': it.get('slug'), 'type': kind, 'url': url,
'published': meta.get('publishedAt'), 'created': meta.get('createdAt'), 'updated': meta.get('updatedAt'),
'sitemap_lastmod': d.get('lastmod')}
head_imgs = []
if kind == 'record':
fm.update({'day': it.get('bPskK658'), 'series': (it.get('HOUwyFeo') or {}).get('title'),
'lang': (it.get('O7HA0yM1') or {}).get('title'), 'description': it.get('WtD0MT_q')})
if it.get('cover'): fm['cover'] = take_img(it['cover'], 'cover'); head_imgs.append(('サムネイル', fm['cover']))
th = it.get('Qi0bIZEy')
if th and th.get('title'):
open(os.path.join(odir, 'thumbnail.html'), 'w', encoding='utf-8').write(th['title'])
fm['thumbnail_html'] = 'thumbnail.html'
else:
fm.update({'label': it.get('XLiEhio_'), 'character': (it.get('jy4DazWj') or {}).get('title'),
'description': it.get('LRhqVKVx'), 'cover_alt': it.get('JZ09W1er'), 'comic_alt': it.get('j670Jo5w')})
if it.get('cover'): fm['cover'] = take_img(it['cover'], 'cover'); head_imgs.append(('表紙', fm['cover']))
if it.get('UeFRSlTz'): fm['comic'] = take_img(it['UeFRSlTz'], 'comic'); head_imgs.append(('本編', fm['comic']))
fm['og_title'] = d.get('head', {}).get('og:title')
fm['images'] = sorted(set(used_imgs))
with open(os.path.join(odir, f'{kind if kind!="record" else "article"}.md'), 'w', encoding='utf-8') as f:
f.write('---\n' + ''.join(f'{k}: {yaml_val(v)}\n' for k, v in fm.items()) + '---\n\n')
f.write(f'# {it.get("title")}\n\n')
info = [f'公開URL: {url}']
if kind == 'record': info = [f'{fm["day"]} / シリーズ: {fm["series"]} / {fm["lang"]}', f'公開: {(fm["published"] or "")[:10]} / 更新: {(fm["updated"] or "")[:10]}'] + info
else: info = [f'{fm["label"]} / {fm["character"]}', f'公開: {(fm["published"] or "")[:10]}'] + info
f.write(''.join(f'> {x}\n' for x in info) + '\n')
if fm.get('description'): f.write(f'**概要**: {fm["description"]}\n\n')
for cap, p in head_imgs: f.write(f'\n\n')
f.write('---\n\n' + md)
if not os.listdir(os.path.join(odir, 'images')): os.rmdir(os.path.join(odir, 'images'))
rows['pages'].append({'type': kind, 'day': fm.get('day') or fm.get('label') or '', 'series': fm.get('series') or fm.get('character') or '',
'lang': fm.get('lang') or ('EN' if kind == 'english' else 'JP'), 'published': (fm['published'] or '')[:10], 'updated': (fm['updated'] or '')[:10],
'title': it.get('title'), 'slug': it.get('slug'), 'folder': rel_page, 'md': f'{rel_page}/{kind if kind!="record" else "article"}.md',
'url': url, 'description': fm.get('description') or '', 'images': len(set(used_imgs)),
'embeds': sum(1 for r in rows['embeds'] if r['page'] == rel_page), 'chars': len(md)})
for kind in ('record', 'manga', 'english'):
kd = os.path.join(SRC, 'raw', kind)
if not os.path.isdir(kd): continue
for fn in sorted(os.listdir(kd)):
if fn.endswith('.json'): process(kind, os.path.join(kd, fn))
os.makedirs(os.path.join(OUT, 'data'), exist_ok=True)
for name, rs in rows.items():
if not rs: continue
with open(os.path.join(OUT, 'data', f'{name}.csv'), 'w', encoding='utf-8-sig', newline='') as f:
w = csv.DictWriter(f, fieldnames=list(rs[0].keys())); w.writeheader(); w.writerows(rs)
print({k: len(v) for k, v in rows.items()}, 'missing images:', sum(1 for r in rows['images'] if not r['downloaded']))
convert.py
#!/usr/bin/env python3
"""raw/{kind}/{slug}.json + images/ -> content/{kind}/{folder}/ (md + images + embeds)
v2 (2026-10-12): codex 検証の指摘を反映
- コードブロックの中身を一切加工しない(空行を詰めない・リスト内はインデントを保つ)
- 表: ヘッダー行があり結合セルのない表は GFM 表(セル内の | をエスケープ・改行は <br>)、それ以外は HTML 表
- 本文テキスト中の Markdown 記号(行頭の # - + 1. > ``` 、| [ ] ` \ < など)をエスケープ
- 太字・斜体は前後の文字で効かなくなる場合に <strong>/<em> で出力
- custom 埋め込みは YouTube も含め全件 embeds/ に HTML 保存
- description が無い・空のときは "" を出力
- DAY 番号の表記ゆれ(DA13 など)を正規化してフォルダ名に使う
"""
import json, os, re, sys, shutil, urllib.parse, csv, unicodedata
from bs4 import BeautifulSoup
from markdownify import MarkdownConverter, chomp
SRC, OUT = sys.argv[1], sys.argv[2]
IMG_RE = re.compile(r'https://storage\.googleapis\.com/studio-[a-z-]+/[^"\'\s\\)<>&]+')
def local_img_src(url):
p = urllib.parse.urlparse(url).path.split('/')
return os.path.join(SRC, 'images', p[1], '_'.join(p[2:]))
def basename(url): return urllib.parse.urlparse(url).path.split('/')[-1]
def is_punct(ch):
if ch.isspace(): return True
cat = unicodedata.category(ch)
return cat.startswith('P') or cat.startswith('S')
LINE_START = re.compile(r'(^|\n)([ \t]*)(#{1,6}(?=[ \t]|$|\n)|[-+*](?=[ \t])|\d{1,9}(?=[.)](?:[ \t]|$|\n))|>|=+[ \t]*(?=$|\n)|-{2,}[ \t]*(?=$|\n)|`{3,}|~{3,})')
STASH = {}
def stash(s):
k = f'\x00S{len(STASH)}\x00'; STASH[k] = s; return k
class Conv(MarkdownConverter):
def escape(self, text, parent_tags):
if not text: return ''
text = text.replace('\\', '\\\\')
text = re.sub(r'([`*\[\]|<])', r'\\\1', text)
text = re.sub(r'(?<![A-Za-z0-9])_|_(?![A-Za-z0-9])', r'\\_', text)
text = text.replace('~~', '\\~\\~')
text = re.sub(r'&(?=#?\w+;)', r'\\&', text)
def ls(m):
tok = m.group(3)
if tok[0].isdigit(): # 1. → 1\.
return m.group(1) + m.group(2) + tok + '\\'
return m.group(1) + m.group(2) + '\\' + tok
text = LINE_START.sub(ls, text)
return text
def _inline(self, el, text, parent_tags, sym, tag):
if '_noformat' in parent_tags: return text
prefix, suffix, text = chomp(text)
if not text: return ''
if is_punct(text[0]) or is_punct(text[-1]):
return f'{prefix}<{tag}>{text}</{tag}>{suffix}'
return f'{prefix}{sym}{text}{sym}{suffix}'
def convert_strong(self, el, text, parent_tags): return self._inline(el, text, parent_tags, '**', 'strong')
convert_b = convert_strong
def convert_em(self, el, text, parent_tags): return self._inline(el, text, parent_tags, '*', 'em')
convert_i = convert_em
def convert_pre(self, el, text, parent_tags):
code = el.get_text()
runs = [len(r) for r in re.findall(r'`+', code)]
fence = '`' * max(3, (max(runs) + 1) if runs else 3)
body = code if code.endswith('\n') else code + '\n'
return '\n\n' + stash(f'{fence}\n{body}{fence}') + '\n\n'
def convert_table(self, el, text, parent_tags):
rows = el.find_all('tr')
simple = bool(rows) and not el.find(attrs={'colspan': True}) and not el.find(attrs={'rowspan': True}) \
and not el.find(['table', 'pre', 'ul', 'ol'], recursive=True) is not None and False or None
nested = el.find(['pre', 'ul', 'ol', 'blockquote']) is not None or el.find('table') is not None
spans = any(int(c.get('colspan', 1) or 1) > 1 or int(c.get('rowspan', 1) or 1) > 1 for c in el.find_all(['td', 'th']))
first = rows[0].find_all(['td', 'th'], recursive=False) if rows else []
header = bool(first) and all(c.name == 'th' for c in first)
ncols = {len(r.find_all(['td', 'th'], recursive=False)) for r in rows}
if rows and header and not nested and not spans and len(ncols) == 1:
def cell(c):
md = Conv(**self.options).convert(c.decode_contents())
md = md.strip()
md = re.sub(r'\s*\n\s*', '<br>', md)
md = re.sub(r'(?<!\\)\|', r'\\|', md)
return md
out = []
for i, r in enumerate(rows):
cells = [cell(c) for c in r.find_all(['td', 'th'], recursive=False)]
out.append('| ' + ' | '.join(cells) + ' |')
if i == 0: out.append('|' + '---|' * len(cells))
return '\n\n' + stash('\n'.join(out)) + '\n\n'
# HTML 表として保存(空行を含めない)
t = BeautifulSoup(str(el), 'html.parser')
for x in t.find_all(True):
for a in list(x.attrs):
if a not in ('colspan', 'rowspan', 'src', 'href', 'alt'): del x.attrs[a]
h = re.sub(r'\n\s*\n', '\n', str(t)).strip()
return '\n\n' + stash(h) + '\n\n'
def unstash(md):
def rep(m):
indent, key = m.group(1), m.group(2)
block = STASH[key]
return '\n'.join((indent + l) if l else l for l in block.split('\n')) if indent.strip() == '' and indent else block
for _ in range(3):
md = re.sub(r'(?m)^([ \t]*)(\x00S\d+\x00)', rep, md)
md = re.sub(r'(\x00S\d+\x00)', lambda m: STASH[m.group(1)], md)
return md
def yaml_val(v):
if v is None: return 'null'
if isinstance(v, bool): return 'true' if v else 'false'
if isinstance(v, list): return '[' + ', '.join(json.dumps(x, ensure_ascii=False) for x in v) + ']'
return json.dumps(v, ensure_ascii=False)
def norm_day(s):
m = re.match(r'\s*DA[Y]?\s*(\d+)\s*([A-Za-z]*)', s or '', re.I)
return (int(m.group(1)), m.group(2).upper()) if m else (None, '')
def folder_name(kind, it):
if kind == 'record':
n, _ = norm_day(it.get('bPskK658'))
return f'DAY{n:03d}_{it["slug"]}' if n is not None else f'DAYxxx_{it["slug"]}'
return it['slug']
rows = {'pages': [], 'images': [], 'embeds': [], 'videos': [], 'links': []}
OPTS = dict(heading_style='ATX', bullets='-', escape_underscores=False, escape_asterisks=False)
def process(kind, path):
STASH.clear()
d = json.load(open(path, encoding='utf-8'))
it = d['item']; url = d['url']; meta = it.get('_meta', {})
fname = folder_name(kind, it)
odir = os.path.join(OUT, 'content', kind, fname)
os.makedirs(os.path.join(odir, 'images'), exist_ok=True)
rel_page = f'content/{kind}/{fname}'
used = []
def take(u, role):
src = local_img_src(u); bn = basename(u); ok = os.path.exists(src)
if ok: shutil.copy2(src, os.path.join(odir, 'images', bn))
used.append(bn)
rows['images'].append({'page': rel_page, 'role': role, 'file': f'{rel_page}/images/{bn}', 'source_url': u, 'downloaded': ok})
return f'images/{bn}'
soup = BeautifulSoup(it.get('body') or '', 'html.parser')
for t in soup.select('div[data-type=table_of_contents]'): t.decompose()
n = 0
for e in soup.select('div[data-type=embed_code]'):
n += 1
etype = e.get('data-embed-code-type', 'custom')
code = urllib.parse.unquote(e.get_text())
yt = re.findall(r'youtube(?:-nocookie)?\.com/embed/([A-Za-z0-9_-]{11})', code)
os.makedirs(os.path.join(odir, 'embeds'), exist_ok=True)
replaced = 0
for u in set(IMG_RE.findall(code)):
code = code.replace(u, take(u, 'embed').replace('images/', '../images/')); replaced += 1
is_yt = bool(yt) and (etype == 'youtube' or len(code) < 1500)
ef = f'embeds/{n:02d}_{e.get("data-uid", "x")}{"_youtube" if is_yt else ""}.html'
open(os.path.join(odir, ef), 'w', encoding='utf-8').write(code)
title = re.search(r'<title>(.*?)</title>', code, re.S); title = title.group(1).strip() if title else ''
rows['embeds'].append({'page': rel_page, 'file': f'{rel_page}/{ef}', 'kind': f'{etype}{"/youtube" if is_yt else ""}',
'title': title, 'bytes': len(code.encode()), 'local_image_rewrites': replaced})
if is_yt:
for v in yt: rows['videos'].append({'page': rel_page, 'type': 'youtube', 'url': f'https://www.youtube.com/watch?v={v}', 'file': ''})
rep = '\n\n'.join(f'▶ YouTube: <https://www.youtube.com/watch?v={v}>' for v in yt) + f'\n\n(埋め込みコード: [{ef}]({ef}))'
else:
rep = f'> 📊 埋め込みHTML: [{(title or ef).replace("[", "(").replace("]", ")")}]({ef})'
e.replace_with(BeautifulSoup(f'<p>{stash(rep)}</p>', 'html.parser'))
for v in soup.select('video'):
u = v.get('src', '')
if u:
loc = take(u, 'video')
rows['videos'].append({'page': rel_page, 'type': 'mp4', 'url': u, 'file': f'{rel_page}/{loc}'})
v.replace_with(BeautifulSoup(f'<p>{stash(f"🎬 動画: [{basename(u)}]({loc})")}</p>', 'html.parser'))
for im in soup.select('img'):
u = im.get('src', '')
if IMG_RE.match(u): im['src'] = take(u, 'body')
for a in soup.select('a[href]'):
rows['links'].append({'page': rel_page, 'text': a.get_text(strip=True)[:80], 'href': a['href']})
for t in soup.find_all(True):
for att in ('data-uid', 'data-time', 'data-thread', 'style'):
if att in t.attrs: del t.attrs[att]
md = Conv(**OPTS).convert(str(soup))
md = re.sub(r'\n{3,}', '\n\n', md)
md = unstash(md).strip() + '\n'
fm = {'title': it.get('title'), 'slug': it.get('slug'), 'type': kind, 'url': url,
'published': meta.get('publishedAt'), 'created': meta.get('createdAt'), 'updated': meta.get('updatedAt'),
'sitemap_lastmod': d.get('lastmod')}
head = []
if kind == 'record':
dn, suf = norm_day(it.get('bPskK658'))
fm.update({'day': it.get('bPskK658'), 'day_number': dn, 'series': (it.get('HOUwyFeo') or {}).get('title'),
'lang': (it.get('O7HA0yM1') or {}).get('title'), 'description': it.get('WtD0MT_q') or ''})
if it.get('cover'): fm['cover'] = take(it['cover'], 'cover'); head.append(('サムネイル', fm['cover']))
th = it.get('Qi0bIZEy')
if th and th.get('title'):
open(os.path.join(odir, 'thumbnail.html'), 'w', encoding='utf-8').write(th['title']); fm['thumbnail_html'] = 'thumbnail.html'
else:
fm.update({'label': it.get('XLiEhio_'), 'character': (it.get('jy4DazWj') or {}).get('title'),
'description': it.get('LRhqVKVx') or '', 'cover_alt': it.get('JZ09W1er'), 'comic_alt': it.get('j670Jo5w')})
if it.get('cover'): fm['cover'] = take(it['cover'], 'cover'); head.append(('表紙', fm['cover']))
if it.get('UeFRSlTz'): fm['comic'] = take(it['UeFRSlTz'], 'comic'); head.append(('本編', fm['comic']))
fm['og_title'] = d.get('head', {}).get('og:title')
fm['images'] = sorted(set(used))
mdname = 'article.md' if kind == 'record' else f'{kind}.md'
esc = lambda s: Conv(**OPTS).escape(s or '', set())
with open(os.path.join(odir, mdname), 'w', encoding='utf-8') as f:
f.write('---\n' + ''.join(f'{k}: {yaml_val(v)}\n' for k, v in fm.items()) + '---\n\n')
f.write(f'# {esc(it.get("title"))}\n\n')
if kind == 'record':
info = [f'{fm["day"]} / シリーズ: {fm["series"]} / {fm["lang"]}', f'公開: {(fm["published"] or "")[:10]} / 更新: {(fm["updated"] or "")[:10]}']
else:
info = [f'{fm["label"]} / {fm["character"]}', f'公開: {(fm["published"] or "")[:10]}']
info.append(f'公開URL: <{url}>')
f.write(''.join(f'> {x} \n' for x in info) + '\n')
if fm.get('description'): f.write(f'**概要**: {esc(fm["description"])}\n\n')
for cap, p in head: f.write(f'\n\n')
f.write('<!-- 本文ここから -->\n\n' + md)
if not os.listdir(os.path.join(odir, 'images')): os.rmdir(os.path.join(odir, 'images'))
rows['pages'].append({'type': kind, 'day': fm.get('day') or fm.get('label') or '', 'day_number': fm.get('day_number') if kind == 'record' else '',
'series': fm.get('series') or fm.get('character') or '', 'lang': fm.get('lang') or ('EN' if kind == 'english' else 'JP'),
'published': (fm['published'] or '')[:10], 'updated': (fm['updated'] or '')[:10], 'title': it.get('title'), 'slug': it.get('slug'),
'folder': rel_page, 'md': f'{rel_page}/{mdname}', 'url': url, 'description': fm.get('description') or '',
'images': len(set(used)), 'embeds': n, 'chars': len(md)})
for kind in ('record', 'manga', 'english'):
kd = os.path.join(SRC, 'raw', kind)
if not os.path.isdir(kd): continue
for fn in sorted(os.listdir(kd)):
if fn.endswith('.json'): process(kind, os.path.join(kd, fn))
os.makedirs(os.path.join(OUT, 'data'), exist_ok=True)
for name, rs in rows.items():
if not rs: continue
with open(os.path.join(OUT, 'data', f'{name}.csv'), 'w', encoding='utf-8-sig', newline='') as f:
w = csv.DictWriter(f, fieldnames=list(rs[0].keys())); w.writeheader(); w.writerows(rs)
print({k: len(v) for k, v in rows.items()}, 'missing images:', sum(1 for r in rows['images'] if not r['downloaded']))
verify_md.py
#!/usr/bin/env python3
"""HTML(CMS本文)と Markdown を描画したHTMLを突き合わせる(自己検証用)"""
import json, os, re, sys, glob
from bs4 import BeautifulSoup
from markdown_it import MarkdownIt
SRC, OUT = sys.argv[1], sys.argv[2]
mdit = MarkdownIt('commonmark').enable('table').enable('strikethrough')
W = lambda s: re.sub(r'\s+', '', s or '')
def feats(soup):
    pres = [p.get_text() for p in soup.find_all('pre')]
    for p in soup.find_all('pre'): p.decompose()
    tables = [[[W(c.get_text()) for c in r.find_all(['td', 'th'])] for r in t.find_all('tr')] for t in soup.find_all('table')]
    heads = [(h.name, W(h.get_text())) for h in soup.find_all(re.compile('^h[1-6]$'))]
    lis = len([x for x in soup.find_all('li') if x.get_text().strip()])
    strong = len([x for x in soup.find_all(['strong', 'b']) if x.get_text().strip()])
    txt = W(soup.get_text())
    return dict(pres=pres, tables=tables, heads=heads, lis=lis, strong=strong, txt=txt)
res = {}
SLUG = {}
for m in glob.glob(os.path.join(OUT, 'content', '*', '*', '*.md')):
    mm = re.search(r'^slug: "(.*)"$', open(m, encoding='utf-8').read(4000), re.M)
    if mm: SLUG[(m.split(os.sep)[-3], mm.group(1))] = m
for kind in ('record', 'manga', 'english'):
    for p in sorted(glob.glob(os.path.join(SRC, 'raw', kind, '*.json'))):
        it = json.load(open(p))['item']
        s = BeautifulSoup(it.get('body') or '', 'html.parser')
        for t in s.select('div[data-type=table_of_contents], div[data-type=embed_code], div[data-type=video_block]'): t.decompose()
        a = feats(s)
        mdp = [SLUG[(kind, it['slug'])]]
        md = open(mdp[0]).read().split('<!-- 本文ここから -->', 1)[1]
        h = BeautifulSoup(mdit.render(md), 'html.parser')
        for x in h.find_all(['p', 'blockquote']):
            t = x.get_text()
            if t.lstrip().startswith(('📊 埋め込みHTML', '🎬 動画', '▶ YouTube:', '(埋め込みコード:')): x.decompose()
        b = feats(h)
        bp = [x[:-1] if (x.endswith('\n') and i < len(a['pres']) and not a['pres'][i].endswith('\n')) else x for i, x in enumerate(b['pres'])]
        diff = {}
        if a['txt'] != b['txt']:
            import difflib
            sm = difflib.SequenceMatcher(None, a['txt'], b['txt'], autojunk=False)
            diff['txt'] = [(op, a['txt'][i1:i2][:60], b['txt'][j1:j2][:60]) for op, i1, i2, j1, j2 in sm.get_opcodes() if op != 'equal'][:6]
        if a['pres'] != bp: diff['pre'] = [i for i in range(max(len(a['pres']), len(bp))) if (a['pres'][i:i+1] != bp[i:i+1])][:10]
        if a['tables'] != b['tables']: diff['tables'] = (len(a['tables']), len(b['tables']))
        if a['heads'] != b['heads']: diff['heads'] = [x for x in zip(a['heads'], b['heads']) if x[0] != x[1]][:3] or (len(a['heads']), len(b['heads']))
        if a['lis'] != b['lis']: diff['lis'] = (a['lis'], b['lis'])
        if a['strong'] != b['strong']: diff['strong'] = (a['strong'], b['strong'])
        if '**' in W(h.get_text()) and '**' not in a['txt']: diff['raw_stars'] = True
        if diff: res[os.path.relpath(mdp[0], OUT)] = diff
json.dump(res, open(sys.argv[3] if len(sys.argv) > 3 else os.path.join(OUT, 'verify_md.json'), 'w'), ensure_ascii=False, indent=1)
import collections
c = collections.Counter(k for v in res.values() for k in v)
print('pages with diffs:', len(res), dict(c))
static_pages.py
#!/usr/bin/env python3
"""Studio pageViewMap (design tree) -> content/static/{page}/page.md"""
import json, os, sys, re, shutil, urllib.parse, html
SRC, OUT = sys.argv[1], sys.argv[2]
product = json.load(open(os.path.join(SRC, 'studio/product.json')))
heads = {p.get('id'): p for p in product['pages']}
SCHEMA = {'UXChiPMZ': 'Record(記事)', 's0yH29ky': 'Manga(4コマ)', 'qulWgwEq': 'English 4-Koma', 'qToAoqTd': 'DAYサムネイル'}
rows = []
def local(u, odir):
p = urllib.parse.urlparse(u).path.split('/')
src = os.path.join(SRC, 'images', p[1], '_'.join(p[2:]))
if os.path.exists(src):
os.makedirs(os.path.join(odir, 'images'), exist_ok=True)
shutil.copy2(src, os.path.join(odir, 'images', p[-1])); return f'images/{p[-1]}'
return u
def strip(t): return html.unescape(re.sub(r'<br\s*/?>', '\n', re.sub(r'<(?!br)[^>]+>', '', t or ''))).strip()
for fn in sorted(os.listdir(os.path.join(SRC, 'studio/pages'))):
key = fn[:-5].replace('__', '/').replace('/slug', '/:slug')
tree = json.load(open(os.path.join(SRC, 'studio/pages', fn)))
name = fn[:-5].replace('pixelstomotors__', '').replace('pixelstomotors', 'top').replace('__slug', '_template')
odir = os.path.join(OUT, 'content/static', name); os.makedirs(odir, exist_ok=True)
lines, nemb = [], 0
def walk(n, depth=0):
global nemb
if not isinstance(n, dict): return
c = n.get('content') or {}; t = c.get('type') or n.get('type'); tag = n.get('tagName') or ''
link = (n.get('link') or {}).get('path')
if t == 'text':
s = strip(c.get('data'))
if s:
if re.match(r'h[1-6]', tag): s = '#' * min(int(tag[1]) + 1, 6) + ' ' + s.replace('\n', ' ')
if link: s = f'[{s}]({link})'
lines.append(s)
elif t in ('image', 'img'):
src = c.get('src', ''); alt = c.get('alt', '')
if src.startswith('http'):
lines.append(f'})' + (f'(リンク: {link})' if link else ''))
else:
lines.append(f'[CMS画像: `{src}`(各ページの値が入る)]' + (f'(リンク: {link})' if link else ''))
elif t == 'video':
src = c.get('src', ''); lines.append(f'🎬 動画: [{os.path.basename(src)}]({local(src, odir)})')
poster = (c.get('video') or {}).get('poster')
if poster and poster.startswith('http'): lines.append(f'})')
elif t in ('icon-brands', 'icon-symbol'):
if link: lines.append(f'- アイコンリンク({c.get("data")}): {link}')
elif t == 'button':
on = n.get('on') or {}; lines.append(f'[ボタン{": " + link if link else ""}{" / " + json.dumps(on, ensure_ascii=False) if on else ""}]')
elif t == 'sandbox':
d = c.get('data') or ''
if '{{' in d and len(d) < 200: lines.append(f'[埋め込みHTML(CMS項目 `{d}` を表示)]')
elif d:
globals()['nemb'] += 1; os.makedirs(os.path.join(odir, 'embeds'), exist_ok=True)
ef = f'embeds/{globals()["nemb"]:02d}.html'; open(os.path.join(odir, ef), 'w').write(d)
lines.append(f'> 📊 埋め込みHTML: [{ef}]({ef})')
elif t == 'list':
for d in n.get('defs') or []:
q = d.get('query') or {}; sk = (q.get('path') or {}).get('schemaKey')
lines.append(f'[CMS一覧: {SCHEMA.get(sk, sk)}/表示件数 {q.get("limit")}{"/フィルタ " + json.dumps(q.get("filter"), ensure_ascii=False) if q.get("filter") else ""}]')
elif t == 'ref':
lines.append(f'[共通パーツ(シンボル) ref:{n.get("refId")}]')
if link and t not in ('text', 'image', 'img', 'icon-brands', 'icon-symbol', 'button') and n.get('children'):
lines.append(f'(以下のブロック全体のリンク先: {link})')
for ch in n.get('children') or []: walk(ch, depth + 1)
globals()['nemb'] = 0
walk(tree)
body = '\n\n'.join(lines)
extra = sorted(set(re.findall(r'https://storage\.googleapis\.com/(?:studio-[a-z-]+|production-os-assets)/[^"\'\s\\)<>&]+', json.dumps(tree))))
extra = [u for u in extra if os.path.basename(urllib.parse.urlparse(u).path) not in body]
if extra:
lines.append('## (デザイン内で参照されているその他の画像・動画)')
for u in extra: lines.append(f'- [{os.path.basename(urllib.parse.urlparse(u).path)}]({local(u, odir)})')
h = (heads.get(key) or {}).get('head') or {}
meta = {k: h.get(k) for k in ('title', 'description', 'favicon') if h.get(k)}
url = 'https://adaptdesign.jp/' + key
with open(os.path.join(odir, 'page.md'), 'w', encoding='utf-8') as f:
f.write('---\n' + f'page_id: {json.dumps(key, ensure_ascii=False)}\nurl: {json.dumps(url)}\n' + ''.join(f'{k}: {json.dumps(v, ensure_ascii=False)}\n' for k, v in meta.items()) + 'source: "Studio pageViewMap(デザイン構造)から生成"\n---\n\n')
f.write(f'# {meta.get("title") or key}\n\n> 公開URL: {url}\n> [ ]は Studio の動的パーツ(CMS一覧・共通ヘッダー/フッターなど)。中身は該当する content/ 側にあります。\n\n')
f.write('\n\n'.join(lines) + '\n')
if h.get('ldJson'): open(os.path.join(odir, 'ld.json'), 'w').write(h['ldJson'])
shutil.copy2(os.path.join(SRC, 'studio/pages', fn), os.path.join(odir, 'studio_design.json'))
rows.append((name, key, meta.get('title', ''), len(lines)))
with open(os.path.join(OUT, 'index/06_固定ページ.md'), 'w', encoding='utf-8') as f:
f.write('# 固定ページ・テンプレート一覧\n\nStudio のデザイン構造(pageViewMap)から生成。`studio_design.json` は移行時の原本です。\n\n| ページ | URL | タイトル | 要素数 |\n|---|---|---|---|\n')
for name, key, title, n in rows:
f.write(f'| [{name}](../content/static/{name}/page.md) | https://adaptdesign.jp/{key} | {title.replace("|", "|")} | {n} |\n')
print(rows)
gen_index.py
#!/usr/bin/env python3
import csv, os, re, sys, json, collections, datetime
A = sys.argv[1]  # archive root
def rd(name):
    p = os.path.join(A, 'data', name)
    return list(csv.DictReader(open(p, encoding='utf-8-sig'))) if os.path.exists(p) else []
pages, embeds, videos, links, images = rd('pages.csv'), rd('embeds.csv'), rd('videos.csv'), rd('links.csv'), rd('images.csv')
def daynum(r):
    m = re.search(r'(\d+)', r['day'] or ''); return int(m.group(1)) if m else -1
def esc(s): return (s or '').replace('|', '|').replace('\n', ' ')
def lk(r): return f"[{esc(r['title'])}](../{r['md']})"
rec = [r for r in pages if r['type'] == 'record']
manga = [r for r in pages if r['type'] == 'manga']; eng = [r for r in pages if r['type'] == 'english']
os.makedirs(os.path.join(A, 'index'), exist_ok=True)
W = lambda n, s: open(os.path.join(A, 'index', n), 'w', encoding='utf-8').write(s)
today = datetime.date.today().isoformat()

# 00 all records
s = [f'# 記事一覧({len(rec)}本・DAYの新しい順)\n', f'取得日: {today} | シリーズ別は [01_シリーズ別](01_シリーズ別.md)、概要文つきは [08_概要つき一覧](08_概要つき一覧.md)\n',
     '| DAY | 公開日 | シリーズ | 言語 | タイトル | 画像 | 図解 |', '|---|---|---|---|---|---|---|']
for r in sorted(rec, key=lambda r: (-daynum(r), r['published']), reverse=False):
    s.append(f"| {r['day']} | {r['published']} | {esc(r['series'])} | {r['lang']} | {lk(r)} | {r['images']} | {r['embeds']} |")
W('00_記事一覧.md', '\n'.join(s) + '\n')

# 01 by series
by = collections.defaultdict(list)
for r in rec: by[r['series']].append(r)
s = ['# シリーズ別一覧\n', '※ シリーズは Studio CMS のカテゴリ(HOUwyFeo)。タイトル先頭の連載名(「〜 Log#N」)とは粒度が違う場合があります。\n']
s += [f"- [{k}({len(v)}本)](#{k.replace(' ', '-')})" for k, v in sorted(by.items(), key=lambda x: -len(x[1]))]
for k, v in sorted(by.items(), key=lambda x: -len(x[1])):
    s += [f'\n## {k}\n', f'{len(v)}本 / {min(r["published"] for r in v)} 〜 {max(r["published"] for r in v)}\n', '| DAY | 公開日 | タイトル |', '|---|---|---|']
    s += [f"| {r['day']} | {r['published']} | {lk(r)} |" for r in sorted(v, key=daynum)]
W('01_シリーズ別.md', '\n'.join(s) + '\n')

# 02 manga
en = {r['slug']: r for r in eng}
s = [f'# 4コママンガ一覧(日本語 {len(manga)}話 / 英語 {len(eng)}話)\n', '| 話 | 公開日 | タイトル(日本語) | 英語版 | キャラ |', '|---|---|---|---|---|']
def epn(r): m = re.search(r'(\d+)', r['slug']); return int(m.group(1)) if m else 0
for r in sorted(manga, key=epn, reverse=True):
    e = en.get(r['slug']); s.append(f"| {r['slug']} | {r['published']} | {lk(r)} | {lk(e) if e else '—'} | {esc(r['series'])} |")
for e in sorted(eng, key=epn, reverse=True):
    if e['slug'] not in {r['slug'] for r in manga}: s.append(f"| {e['slug']} | {e['published']} | — | {lk(e)} | {esc(e['series'])} |")
W('02_マンガ一覧.md', '\n'.join(s) + '\n')

# 03 embeds
pm = {r['folder']: r for r in pages}
dia = [e for e in embeds if 'youtube' not in e.get('kind', '')]
ytb = [e for e in embeds if 'youtube' in e.get('kind', '')]
s = [f'# 埋め込みHTML一覧(図解 {len(dia)}点 / YouTube埋め込み {len(ytb)}点)\n',
     '記事内の Studio 埋め込みコードを、URLデコードしてHTMLファイルとして保存したもの(全件)。ブラウザで直接開けます。\n',
     '- 図解: md では「📊 埋め込みHTML」へのリンクとして表示',
     '- YouTube 埋め込み(custom コードに iframe を書いたもの・Studio の YouTube ブロック): md では「▶ YouTube」の URL と埋め込みコードへのリンクとして表示',
     '- 図解内の画像URLは、記事フォルダの images/ への相対パスに置き換えている(`local_image_rewrites` 列が置換数。現在は DAY111 の1点・5箇所のみ)\n',
     '## 図解\n', '| DAY | 記事 | 図解タイトル | ファイル |', '|---|---|---|---|']
for e in sorted(dia, key=lambda e: -daynum(pm[e['page']])):
    r = pm[e['page']]; s.append(f"| {r['day']} | {lk(r)} | {esc(e['title'])} | [{os.path.basename(e['file'])}](../{e['file']}) |")
s += ['\n## YouTube 埋め込み\n', '| DAY | 記事 | 種類 | ファイル |', '|---|---|---|---|']
for e in sorted(ytb, key=lambda e: -daynum(pm[e['page']])):
    r = pm[e['page']]; s.append(f"| {r['day']} | {lk(r)} | {e['kind']} | [{os.path.basename(e['file'])}](../{e['file']}) |")
W('03_図解HTML一覧.md', '\n'.join(s) + '\n')

# 04 videos
s = ['# 動画一覧\n', '## 記事に埋め込まれた動画\n', '| DAY | 記事 | 種類 | 動画 |', '|---|---|---|---|']
for v in sorted(videos, key=lambda v: -daynum(pm[v['page']])):
    r = pm[v['page']]; tgt = f"[{os.path.basename(v['file'])}](../{v['file']})" if v['file'] else v['url']
    s.append(f"| {r['day']} | {lk(r)} | {v['type']} | {tgt} |")
s += ['\n## 手元の動画ファイル\n']
for root in ('kioxia_r2r2r-data', 'work_files'):
    rows = []
    for dp, _, fs in os.walk(os.path.join(A, root)):
        for f in fs:
            if f.lower().endswith(('.mp4', '.mov', '.m4v', '.webm')) and not f.startswith('._'):
                p = os.path.join(dp, f); rows.append((os.path.relpath(p, A), os.path.getsize(p)))
    s += [f'\n### {root}({len(rows)}本)\n', '| ファイル | サイズ |', '|---|---|']
    s += [f"| [{esc(p)}](../{p.replace(' ', '%20')}) | {sz/1e6:.1f}MB |" for p, sz in sorted(rows)]
W('04_動画一覧.md', '\n'.join(s) + '\n')

# 05 links
dom = collections.defaultdict(list)
for l in links:
    m = re.match(r'https?://([^/]+)', l['href'])
    if m: dom[m.group(1)].append(l)
s = [f'# 外部リンク一覧({sum(len(v) for v in dom.values())}件・{len(dom)}ドメイン)\n']
for d, v in sorted(dom.items(), key=lambda x: (-len(x[1]), x[0])):
    s.append(f'\n## {d}({len(v)})\n')
    s += [f"- [{esc(l['text']) or l['href']}]({l['href']}) — {pm[l['page']]['day']} {lk(pm[l['page']])}" for l in v]
W('05_外部リンク一覧.md', '\n'.join(s) + '\n')

# 08 descriptions
s = ['# 概要つき一覧(全文検索用)\n', '記事・マンガの概要文を1ファイルにまとめたもの。キーワードで Cmd+F / grep するときの入口です。\n']
for r in sorted(rec, key=daynum, reverse=True):
    s.append(f"### {r['day']}|{esc(r['title'])}\n{r['published']} / {r['series']} / [{r['md']}](../{r['md']})\n\n{r['description']}\n")
for r in sorted(manga + eng, key=lambda r: (r['type'], -epn(r))):
    s.append(f"### {r['type']} {r['slug']}|{esc(r['title'])}\n{r['published']} / [{r['md']}](../{r['md']})\n\n{r['description']}\n")
W('08_概要つき一覧.md', '\n'.join(s) + '\n')

# stats json
img_files = [os.path.join(dp, f) for dp, _, fs in os.walk(os.path.join(A, 'content')) for f in fs if '/images' in dp and not f.lower().endswith(('.mp4', '.mov', '.webm'))]
stats = {'records': len(rec), 'manga': len(manga), 'english': len(eng), 'series': {k: len(v) for k, v in by.items()},
         'images_unique_source_urls_in_cms_pages': len({i['source_url'] for i in images if i['role'] != 'video'}),
         'image_files_in_cms_pages': len([f for f in img_files if '/static/' not in f]),
         'image_files_incl_static': len(img_files),
         'embeds_total': len(embeds), 'embeds_diagram': len([e for e in embeds if 'youtube' not in e.get('kind', '')]),
         'embeds_youtube': len([e for e in embeds if 'youtube' in e.get('kind', '')]),
         'videos_in_articles': len(videos), 'videos_mp4': len([v for v in videos if v['type'] == 'mp4']), 'videos_youtube': len([v for v in videos if v['type'] == 'youtube']), 'links': len(links),
         'first_published': min(r['published'] for r in rec), 'last_published': max(r['published'] for r in rec)}
json.dump(stats, open(os.path.join(A, 'data', 'stats.json'), 'w'), ensure_ascii=False, indent=1)
print(json.dumps(stats, ensure_ascii=False))
gen_files_index.py
#!/usr/bin/env python3
import os, sys, unicodedata as u, ast, collections, datetime
A = sys.argv[1]; N = lambda s: u.normalize('NFC', s)
out = ['# 作業ファイルとコード\n', f"集計時刻: {(datetime.datetime.utcnow()+datetime.timedelta(hours=9)).strftime('%Y-%m-%d %H:%M')} JST。ファイル数は `.` で始まる隠しファイル(.DS_Store・.gitignore など)を除いた数。\n"]
def tree(root, title, note, depth=2):
    out.append(f'\n## {title}\n\n{note}\n\n| フォルダ | ファイル数 | 容量 | 主な種類 |\n|---|---|---|---|')
    base = os.path.join(A, root)
    if not os.path.isdir(base): out.append('| (なし) | | | |'); return
    groups = collections.defaultdict(lambda: [0, 0, collections.Counter()])
    for dp, dns, fns in os.walk(base):
        rel = os.path.relpath(dp, base); parts = [] if rel == '.' else rel.split(os.sep)
        key = '/'.join(N(p) for p in parts[:depth]) or '(直下)'
        for f in fns:
            if f.startswith('.'): continue
            g = groups[key]; g[0] += 1; g[1] += os.path.getsize(os.path.join(dp, f)); g[2][os.path.splitext(f)[1].lower() or '(なし)'] += 1
    for k in sorted(groups):
        n, sz, c = groups[k]; out.append(f"| [{k}](../{root}/{k.replace(' ', '%20') if k != '(直下)' else ''}) | {n} | {sz/1e6:.1f}MB | {', '.join(f'{e}×{m}' for e, m in c.most_common(4))} |")
tree('work_files', '記事の作業ファイル(work_files/)', 'iCloud `PixelstoMotors/` の `デジタルツイン学習R2R2R`・`ハコブくん`・`サムネイル` のコピー(同期時刻・元との差は [work_files/_MANIFEST.md](../work_files/_MANIFEST.md))。`__pycache__` も除外。`モデリング`(3Dモデル 1.8GB)・`Unity-BackupDtata`・`Claudeプロジェクト` は記事の作業ファイルではないため除外しています。', depth=2)
tree('kioxia_r2r2r-data', 'KIOXIA の動画・研究室ログ(kioxia_r2r2r-data/)', 'KIOXIA `/Volumes/KIOXIA/r2r2r-data/` のうち `videos/`(解説動画)と `lab/`(フィジカルAI研究室シリーズの実行ログ・LIBERO動画)、README。`recordings/` は空でした。runs・datasets・checkpoints など学習データ本体はサイトの情報ではないため含めていません。', depth=3)
tree('code/r2r2r-content', 'GitHub r2r2r-content(code/r2r2r-content/)', '記事MD・図解HTML・SNS文面の公開用リポジトリ(PixelstoMotors/r2r2r-content)の最新版。git の履歴は含みません(`_GIT_HEAD.txt` に取得時のコミット)。', depth=1)
# scripts
base = os.path.join(A, 'code/r2r2r-scripts')
out.append('\n## コード(code/r2r2r-scripts/)\n\n`~/r2r2r-scripts` のコピー。画像(png/jpg)・動画・`.bak*` バックアップ・`__pycache__`・`.git` は除外。git 管理外のファイルも含みます(このフォルダはコードの多くが未コミットのため)。`_GIT_HEAD.txt`・`_GIT_STATUS_at_copy.txt` に取得時の状態。\n\n| スクリプト | 説明(docstring 1行目) |\n|---|---|')
rows = []
for dp, dns, fns in os.walk(base):
    dns[:] = sorted(d for d in dns if not d.startswith('.'))
    for f in sorted(fns):
        if not f.endswith('.py'): continue
        p = os.path.join(dp, f); rel = os.path.relpath(p, base)
        try: doc = ast.get_docstring(ast.parse(open(p, encoding='utf-8', errors='ignore').read())) or ''
        except Exception: doc = ''
        rows.append(f"| [{N(rel)}](../code/r2r2r-scripts/{rel.replace(' ', '%20')}) | {(doc.strip().splitlines() or [''])[0][:120].replace('|', '|')} |")
out += rows
out.insert(1, f'\nスクリプト {len(rows)} 本。\n')
open(os.path.join(A, 'index/07_作業ファイルとコード.md'), 'w', encoding='utf-8').write('\n'.join(out) + '\n')
print(len(rows))
copy_work.sh
#!/bin/bash
cd "$HOME/mnt/PixelstoMotors"
D="site_archive/work_files"
for d in "デジタルツイン学習R2R2R" "ハコブくん" "サムネイル"; do
  rsync -a --exclude='.DS_Store' \
    --exclude='デジタルツイン学習R2R2R/モデリング/' --exclude='デジタルツイン学習R2R2R/Unity-BackupDtata/' \
    --exclude='デジタルツイン学習R2R2R/Claudeプロジェクト/' \
    "$d" "$D/" 2>>$HOME/work/copy_work.err
done
echo DONE > $HOME/work/copy_work.done
rs.sh
cd "$HOME/mnt/PixelstoMotors"
SRC=$(python3 -c "
import os,unicodedata as u
want={'デジタルツイン学習R2R2R','ハコブくん','サムネイル'}
print('\n'.join(d for d in os.listdir('.') if u.normalize('NFC',d) in want))")
echo "$SRC" | while read d; do timeout 160 rsync -a --filter="merge $HOME/work/excl.txt" "$d" site_archive/work_files/ 2>>$HOME/work/rs.err; done
excl.txt
同じ行が2回ずつ並んで見えますが、1行目が濁点を分けた形(NFD)、2行目が1文字の形(NFC)です。
- /デジタルツイン学習R2R2R/モデリング/
- /デジタルツイン学習R2R2R/モデリング/
- /デジタルツイン学習R2R2R/Unity-BackupDtata/
- /デジタルツイン学習R2R2R/Unity-BackupDtata/
- /デジタルツイン学習R2R2R/Claudeプロジェクト/
- /デジタルツイン学習R2R2R/Claudeプロジェクト/
- .DS_Store
- __pycache__/
- *ティクス*イン.html
sync_work_files.sh
#!/bin/bash
# 記事の作業フォルダを site_archive/work_files/ に追加コピーする(追加・上書きのみ。削除はしない)
# 使い方: ターミナルで  bash "このファイルのパス"
# 除外: モデリング / Unity-BackupDtata / Claudeプロジェクト / __pycache__(濁点の表記ゆれに左右されないようワイルドカードで指定)
# 除外: ロボティクスデザイン.html(アーカイブ側は署名付きURLを伏せ字にしてあるため上書きしない)
cd "$(dirname "$0")/../.." || exit 1   # = PixelstoMotors/
for d in */; do
  case "$d" in
    *R2R2R*|*ムネイル*|*コ*くん*) ;;   # デジタルツイン学習R2R2R / サムネイル / ハコブくん
    *) continue ;;
  esac
  [ "$d" = "site_archive/" ] && continue
  rsync -a --exclude='.DS_Store' --exclude='モ*リン*/' --exclude='Unity-BackupDtata/' --exclude='Claude*ェクト/' --exclude='__pycache__/' --exclude='*ティクス*イン.html' "${d%/}" site_archive/work_files/
done
echo "完了: site_archive/work_files/"
スクリプト以外に実行したコマンド
Claude の作業環境から、サイトと画像サーバーに届くかを確かめた
curl -s -o /dev/null -w "%{http_code}\n" --max-time 10 https://adaptdesign.jp/pixelstomotors/record/day1; curl -s -o /dev/null -w "%{http_code}\n" --max-time 10 https://storage.googleapis.com/production-os-assets/assets/ffb300c2-1071-4714-978c-87d386d5dfd3
000
000

[agent-proxy] While this command ran, 2 connections through the agent proxy failed:
- storage.googleapis.com:443 — connect_rejected (the egress proxy denied the CONNECT (organization policy) or could not reach the destination)
- adaptdesign.jp:443 — connect_rejected (the egress proxy denied the CONNECT (organization policy) or could not reach the destination)
Mac とつないだシェルから、同じく届くかを確かめた
for u in https://storage.googleapis.com/studio-design-asset-files/projects/p6aoJ4vyqR/s-2286x1806_v-frms_webp_53dca5f5-a230-4cab-8c46-2215693b08f4.png https://pypi.org/simple/ https://github.com https://cdn.jsdelivr.net https://www.youtube.com; do echo "$(curl -s -o /dev/null -w '%{http_code}' --max-time 10 $u) $u"; done
000 https://storage.googleapis.com/studio-design-asset-files/projects/p6aoJ4vyqR/s-2286x1806_v-frms_webp_53dca5f5-a230-4cab-8c46-2215693b08f4.png
200 https://pypi.org/simple/
200 https://github.com
000 https://cdn.jsdelivr.net
000 https://www.youtube.com
ダウンロードの隠しファイルを zip として開いた
mkdir -p $HOME/work && cp "$HOME/mnt/Downloads/.Q6L2SF6YDW.com.anthropic.claudefordesktop.dDr28q" $HOME/work/trial10.zip && cd $HOME/work && python3 -c "
import zipfile;z=zipfile.ZipFile('trial10.zip');print('bad:',z.testzip(), len(z.namelist()))" && rm -rf trial && mkdir trial && cd trial && unzip -q ../trial10.zip
cd $HOME/mnt/Downloads && mkdir -p $HOME/work/full && for f in .Q6L2SF6YDW.com.anthropic.claudefordesktop.{f1PUtK,lzlYEr,FPK7iM,WxI0C6,d2yOwO,gLLPqh}; do python3 -c "
import zipfile,sys;z=zipfile.ZipFile(sys.argv[1]);b=z.testzip();print(sys.argv[1][-6:],len(z.namelist()),'bad' if b else 'ok', z.namelist()[0]);z.extractall(sys.argv[2])" "$f" $HOME/work/full; done; find $HOME/work/full -type f | wc -l; du -sh $HOME/work/full
変換に使うライブラリを入れた
pip install --quiet --break-system-packages markdownify beautifulsoup4
pip install --quiet --break-system-packages markdown-it-py
コード(~/r2r2r-scripts)を、画像・動画・バックアップを除いてコピーした
D="$HOME/mnt/PixelstoMotors/site_archive/code/r2r2r-scripts"; mkdir -p "$D" && cd $HOME/mnt/r2r2r-scripts && rsync -a --exclude='.git/' --exclude='__pycache__/' --exclude='*.png' --exclude='*.jpg' --exclude='*.JPG' --exclude='*.jpeg' --exclude='*.mp4' --exclude='*.mov' --exclude='*.bak*' --exclude='.DS_Store' ./ "$D/" && git ls-files '*.png' '*.jpg' | rsync -a --files-from=- ./ "$D/" && git log -1 --format='commit: %H%ndate: %ci%nsubject: %s' > "$D/_GIT_HEAD.txt" && git status --short > "$D/_GIT_STATUS_at_copy.txt" && du -sh "$D" && find "$D" -type f | wc -l
除外が効かずにコピーされた「モデリング」などを消した
import os, unicodedata as u, shutil, re
base = 'デジタルツイン学習R2R2R'
root = [d for d in os.listdir('.') if u.normalize('NFC', d) == base][0]
targets = {'モデリング', 'Unity-BackupDtata', 'Claudeプロジェクト'}
for d in os.listdir(root):
    if u.normalize('NFC', d) in targets:
        p = os.path.join(root, d); print('rm -r', u.normalize('NFC', p)); shutil.rmtree(p)
n = 0
for dp, dns, fns in os.walk('.'):
    for f in fns:
        if re.match(r'^\..+\.[A-Za-z0-9]{6}$', f):  # rsync temp files
            os.remove(os.path.join(dp, f)); n += 1
print('removed rsync temp files:', n)
KIOXIA の大きい動画を gzip にしてから9MBずつに分けた(クラウド側)
cd /mnt/user-data/outputs && rm -rf split && mkdir split && O=kioxia/videos; gzip -1 -c "$O/AIエージェントの取り違え/AIエージェントの取り違え_確認用.mp4" | split -b 9000000 -d - split/g1_; gzip -1 -c "$O/フィジカルAIの現在地/フィジカルAIの現在地_確認用.mp4" | split -b 9000000 -d - split/g2_; gzip -1 -c /mnt/user-data/uploads/r2r2r-data/videos/フィジカルAIの現在地/フィジカルAIの現在地_作業用.mp4 | split -b 9000000 -d - split/g3_; ls -l split | awk '{print $5, $9}'; cd kioxia && find lab videos -type f -exec sha256sum {} \; | sort -k2 > /mnt/user-data/outputs/kioxia_sha.txt; wc -l /mnt/user-data/outputs/kioxia_sha.txt
分けたファイルを Mac 側でつなげ、SHA-256 を確かめた
T=$HOME/mnt/Downloads/_p2m_tmp; ls -l $T/g* | awk '{print $5}' | tr '\n' ' '; echo; K="$HOME/mnt/PixelstoMotors/site_archive/kioxia_r2r2r-data/videos"; cat $T/g1_* | gunzip > "$K/AIエージェントの取り違え/AIエージェントの取り違え_確認用.mp4"; cat $T/g2_* | gunzip > "$K/フィジカルAIの現在地/フィジカルAIの現在地_確認用.mp4"; cat $T/g3_* | gunzip > "$K/フィジカルAIの現在地/フィジカルAIの現在地_作業用.mp4"; cd "$HOME/mnt/PixelstoMotors/site_archive/kioxia_r2r2r-data" && sha256sum -c $T/kioxia_sha.txt 2>&1 | grep -v ': OK$'; echo "checked $(wc -l < $T/kioxia_sha.txt)"
後から増えた KIOXIA の13ファイルを tar.gz でまとめて追加した
cd /mnt/user-data/uploads/r2r2r-data/videos && O=/mnt/user-data/outputs/k2 && rm -rf $O && mkdir -p $O && F=$(ls フィジカルAIの現在地/ | grep -E 'ハコブ版|冒頭15秒' | sed 's|^|フィジカルAIの現在地/|'); echo "$F" | wc -l; echo "$F" | tr '\n' '\0' | xargs -0 sha256sum > $O/sha.txt; echo "$F" | tr '\n' '\0' | tar --null -T - -czf $O/k.tgz; ls -l $O/k.tgz; cd $O && split -b 9000000 -d k.tgz part_ && rm k.tgz && ls
T=$HOME/mnt/Downloads/_p2m_tmp; K="$HOME/mnt/PixelstoMotors/site_archive/kioxia_r2r2r-data/videos"; cat $T/part_0* | tar -xzf - -C "$K" && cd "$K" && sha256sum -c $T/sha.txt | grep -vc ': OK$'; ls "$K/フィジカルAIの現在地" | wc -l; rm -rf $T
アーカイブ側のコピーだけ、パスワードの値と AWS の署名を伏せた
import re, glob, os
p='code/r2r2r-scripts/calibration_reference.md'
L=open(p,encoding='utf-8').read().split('\n')
L[78]=re.sub(r'((?:[Pp]ass(?:word)?|パスワード)[^::=]*[::=][ `"]*)[^ `"|]+', r'\1<伏せ字>', L[78])
open(p,'w',encoding='utf-8').write('\n'.join(L))
f=[x for x in glob.glob('work_files/**/*.html', recursive=True) if x.endswith('ロボティクスデザイン.html') or os.path.basename(x)=='ロボティクスデザイン.html']
import unicodedata as u
f=[x for x in glob.glob('work_files/**/*.html', recursive=True) if u.normalize('NFC',os.path.basename(x))=='ロボティクスデザイン.html']
for x in f:
    t=open(x,encoding='utf-8',errors='surrogateescape').read()
    n=len(re.findall(r'X-Amz-Credential', t))
    t=re.sub(r'(https?://[^\s"\'<>?]+)\?[^\s"\'<>]*X-Amz-[^\s"\'<>]*', r'\1?<署名パラメータ除去>', t)
    open(x,'w',encoding='utf-8',errors='surrogateescape').write(t)
    print(u.normalize('NFC',x), n, len(re.findall(r'X-Amz-Credential', t)))
print(open(p,encoding='utf-8').read().split('\n')[78][:60])
アーカイブの中で行われた動画の作業を、元のフォルダへ戻した
14:36(JST)より後に更新されたファイルだけを対象にし、元の側が新しいものは触らない条件にしています。
import os, unicodedata as u, datetime, shutil, json
N=lambda s:u.normalize('NFC',s)
SNAP=datetime.datetime(2026,10,12,5,36).timestamp()  # 14:36 JST
src_root=[d for d in os.listdir('.') if N(d)=='デジタルツイン学習R2R2R'][0]
vid=[d for d in os.listdir(src_root) if N(d)=='動画'][0]
SRC=os.path.join(src_root,vid); ARC=os.path.join('site_archive/work_files',src_root,vid)
BK='site_archive/_restore_backup_20261012/'+N(src_root)+'/動画'
def walk(root):
    m={}
    for dp,dns,fns in os.walk(root):
        dns[:]=[d for d in dns if d!='__pycache__']
        for f in fns:
            if f=='.DS_Store' or f.startswith('._'): continue
            p=os.path.join(dp,f); m[N(os.path.relpath(p,root))]=p
    return m
S=walk(SRC); C=walk(ARC)
plan=[]
for k,cp in C.items():
    if os.path.getmtime(cp) < SNAP: continue
    if k in S:
        if open(S[k],'rb').read()==open(cp,'rb').read(): continue
        if os.path.getmtime(S[k]) >= os.path.getmtime(cp): plan.append((k,'CONFLICT')); continue
        plan.append((k,'overwrite'))
    else: plan.append((k,'new'))
log=[]
for k,act in sorted(plan):
    if act=='CONFLICT': log.append((k,act)); continue
    dst=os.path.join(SRC,k)
    if act=='overwrite':
        b=os.path.join(BK,k); os.makedirs(os.path.dirname(b),exist_ok=True); shutil.copy2(S[k],b)
    os.makedirs(os.path.dirname(dst),exist_ok=True); shutil.copy2(C[k],dst)
    ok=open(dst,'rb').read()==open(C[k],'rb').read()
    log.append((k,act,ok))
json.dump(log,open(os.path.expanduser('~/work/restore_log.json'),'w'),ensure_ascii=False,indent=1)
import collections
print(collections.Counter(x[1] for x in log), all(x[2] for x in log if len(x)>2))
for x in log:
    if x[1]!='new': print(x)
実行ログ
ブラウザで CMS データを取り出したときの結果
{"got": 533, "nullItems": 0, "urls": {"english": 95, "manga": 99, "record": 339}}
{"bucket": {"studio-cms-assets": 224, "studio-design-asset-files": 747}, "embedCount": 303, "imgCount": 971, "lang": {"EN": 7, "JP": 332}, "series": {"Consideration": 7, "HRI": 54, "R2R2R": 185, "UV-C農業ロボット": 2, "フィジカルAI研究室": 8, "ロボティクスデザイン": 9, "画像認識・物体検出": 11, "考察記事": 63}, "yt": 7}
本文 HTML に出てくるタグと Studio のブロックの数:
data-type: embed_code 303 / table 658 / table_of_contents 337 / video_block 4
tags: <a 176 / <blockquote 802 / <br> 751 / <code 872 / <code> 5929 / <div 1302 / <em> 50 / <figcaption> 288 / <figure 288 / <h1 1 / <h2 2685 / <h3 1087 / <h4 31 / <h5 282 / <h6 1 / <hr 11 / <img 288 / <li 3040 / <ol 108 / <p 34782 / <pre 2106 / <strong> 4002 / <table 658 / <tbody> 658 / <td 10653 / <th 2071 / <tr 3869 / <ul 1013 / <video 4
zip の書き出し
trial10: {"files": 49, "imgs": 39, "failed": [], "sizeMB": "22.88"}
raw:     {"media": 976, "rawFiles": 534, "rawMB": "22.4"}
media:   pixelstomotors_media_01.zip 200 103.2 / _02.zip 200 69 / _03.zip 200 35.5 / _04.zip 200 96.8 / _05.zip 176 104.8 / failed: []
static:  {"MB": "5.9", "failed": [], "files": 41, "media": 21, "symView": 0}
f1PUtK 534 ok raw/record/pi05-libero-benchmark-first-run.json
lzlYEr 200 ok images/studio-design-asset-files/projects_p6aoJ4vyqR_s-2715x1622_v-frms_webp_0a827b2f-d9cd-49eb-8d1a-6ec2f75d2844.png
FPK7iM 200 ok images/studio-design-asset-files/projects_p6aoJ4vyqR_s-1920x1080_62b93d1e-e009-4f3f-b323-55a8de9127b9.webp
WxI0C6 200 ok images/studio-cms-assets/projects_p6aoJ4vyqR_s-2940x1856_db1a4ce3-dca6-4c5c-8f88-3a7767bfe34d.webp
d2yOwO 200 ok images/studio-design-asset-files/projects_p6aoJ4vyqR_s-1080x1350_v-fms_webp_4b1b141d-1884-4d8a-94a8-a516e65a0a24.png
gLLPqh 176 ok images/studio-design-asset-files/projects_p6aoJ4vyqR_s-1080x1350_v-fms_webp_5062afd7-c7ea-438a-b3e9-dba2837add0b.png
1510
415M	/sessions/rcw-01m2wyqw71l4d3nvl8pjd4jy/work/full
変換(convert_v1.py / convert.py)
試し10ページ(v1): {'pages': 10, 'images': 39, 'embeds': 6, 'videos': 0, 'links': 3} missing images: 0
全ページ(v1):     {'pages': 533, 'images': 978, 'embeds': 286, 'videos': 21, 'links': 176} missing images: 0
全ページ(v2):     {'pages': 533, 'images': 978, 'embeds': 303, 'videos': 21, 'links': 176} missing images: 0
verify_md.py の結果
1回目(数え方を直す前):
pages with diffs: 34 {'strong': 33, 'lis': 2}
差が出た理由を1ページ(LOG2)で確かめた結果。空白だけの太字が Markdown では消えていた:
MISSING ('p', '\xa0')
MISSING ('p', '\xa0')
MISSING ('p', '\xa0')
MISSING ('p', '\xa0')
MISSING ('p', '\xa0')
MISSING ('p', '\xa0')
空白だけの太字と中身のない箇条書きを数えないようにしたあと(作業用フォルダとアーカイブの両方で実行):
pages with diffs: 0 {}
rsync で読めなかった iCloud のファイル
rsync: [sender] read errors mapping "/sessions/rcw-01m2wyqw71l4d3nvl8pjd4jy/mnt/PixelstoMotors/デジタルツイン学習R2R2R/MotionUX記事/motionUX_article.txt": Resource deadlock avoided (35)
rsync: [sender] read errors mapping "/sessions/rcw-01m2wyqw71l4d3nvl8pjd4jy/mnt/PixelstoMotors/デジタルツイン学習R2R2R/Pixels to Motors _ デジタルツインが生み出す次世代ロボティクスUX_files/DS4BSrCu.js": Resource deadlock avoided (35)
rsync: [sender] read errors mapping "/sessions/rcw-01m2wyqw71l4d3nvl8pjd4jy/mnt/PixelstoMotors/デジタルツイン学習R2R2R/Pixels to Motors _ デジタルツインが生み出す次世代ロボティクスUX_files/LivePreviewMenu.C0OP5DRp.css": Resource deadlock avoided (35)
ok 963 missing 461 609.1 MB of 1566.6 MB
131 ハコブくん/英語版SNS投稿
124 ハコブくん/日本版SNS投稿
57 ハコブくん/ハコブくん関連データ
41 デジタルツイン学習R2R2R/記事
31 デジタルツイン学習R2R2R/mechArm 270 Pi 動的追従の限界を探る
22 デジタルツイン学習R2R2R/Pixels to Motors _ デジタルツインが生み出す次世代ロボティクスUX_files
13 デジタルツイン学習R2R2R/Robotics_UX_Project
12 デジタルツイン学習R2R2R/動画
9 デジタルツイン学習R2R2R/Webサイト
4 デジタルツイン学習R2R2R/
2 デジタルツイン学習R2R2R/mechArm 270 Pi 受け渡し動作の成立を探る
2 デジタルツイン学習R2R2R/ロボットアームのテレメトリダッシュボードを作る
2 デジタルツイン学習R2R2R/インタラクティブ版
2 デジタルツイン学習R2R2R/mechArm 270 Pi 実機データを土台にデジタルツインを作る
2 デジタルツイン学習R2R2R/ロボットアーム動作可視化
Finder で「今すぐダウンロード」を選んだあと → 20分後 → 雲のアイコンが消えたあと:
total 1431 missing 149 311.4 MB
missing 147 308.9 MB
files 1431 missing 0
KIOXIA の動画を戻したときのファイルサイズ(mp4 のまま分けた場合)
最初の1個だけが 9,000,000 バイトから 9,005,875 バイトに変わっていた:
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9005875 Oct 12 01:35 v1_00
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:35 v1_01
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 8998729 Oct 12 01:35 v1_02
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9005875 Oct 12 01:35 v2_00
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:35 v2_01
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:35 v2_02
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 2768676 Oct 12 01:35 v2_03
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9005875 Oct 12 01:35 v3_00
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:35 v3_01
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:35 v3_02
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:36 v3_03
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 9000000 Oct 12 01:36 v3_04
-rw------- 1 rcw-01m2wyqw71l4d3nvl8pjd4jy rcw-01m2wyqw71l4d3nvl8pjd4jy 2663796 Oct 12 01:36 v3_05
元の SHA-256(クラウド側)と、つなげたもの(Mac 側):
元:       8a9d2d6808c691a3b0a63fb3c2888af68dad85e5cca9cf4c9fff6332d615c0b3 / 349d5dc50d15935a0658681570e17b8573bc30a5685587e062cdaa2acaf51987 / 6d2361e8717dfd00c624f9f8314fc09d62113ac56ee52beff788260f9fbda9e6
つなげた: e797d92c0d1a5e5e8707e1e869e3f3dec813f6834876b027a143ba553c59a38a / 65a449f3978973b38277786e49ce34cf2dc19d755a827c77303c42e9098c64e0 / f141e1447455cd0bb144d590467d819a121d7152c0e7f62aa79154b1e7802713
gzip にしてから戻したあと(sha256sum -c で OK 以外の行が0):
9000000 9000000 7145576 9000000 9000000 9000000 641382 9000000 9000000 9000000 9000000 9000000 622241
checked 47
後から増えた13ファイル(OK 以外の行の数と、フォルダ内のファイル数):
0
15
動画の作業がアーカイブの中にあったときの比較(元とコピーの更新時刻、JST)
DIFF AIエージェントの取り違え/narration.py src 10-12 09:30 copy 10-12 15:04
DIFF AIエージェントの取り違え/scenes.py src 10-12 08:26 copy 10-12 14:57
DIFF _制作ベース/assemble.py src 10-12 09:30 copy 10-12 14:57
DIFF _制作ベース/tts_eleven.py src 10-12 10:44 copy 10-12 14:42
DIFF _制作ベース/video_rules.md src 10-12 10:44 copy 10-12 15:05
DIFF フィジカルAIの現在地/__pycache__/narration.cpython-312.pyc src 10-12 10:51 copy 10-12 15:05
DIFF フィジカルAIの現在地/narration.py src 10-12 10:50 copy 10-12 15:04
DIFF フィジカルAIの現在地/scenes.py src 10-12 10:50 copy 10-12 14:57
DIFF フィジカルAIの現在地/voice_eleven/ハコブ/設定.json src 10-12 10:51 copy 10-12 15:05
COPYONLY-new .DS_Store 10-12 16:07
COPYONLY-new _制作ベース/thumbnail.py 10-12 16:09
COPYONLY-new フィジカルAIの現在地/thumb.py 10-12 16:09
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/008.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/023.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/025.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/037.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/046.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/052.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/053.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/054.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/055.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/067.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/070.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/074.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/079.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/081.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/109.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/111.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/124.mp3 10-12 15:05
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/131.mp3 10-12 15:06
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/133.mp3 10-12 15:06
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/143.mp3 10-12 15:06
COPYONLY-new フィジカルAIの現在地/voice_eleven/ハコブ/144.mp3 10-12 15:06
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し.txt 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_01.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_02.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_03.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_04.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_05.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_06.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_07.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_08.mp3 10-12 15:02
COPYONLY-new フィジカルAIの現在地/サムネ案A_紙色と写真.png 10-12 16:09
COPYONLY-new フィジカルAIの現在地/サムネ案B_黒と写真.png 10-12 16:09
COPYONLY-new フィジカルAIの現在地/サムネ案C_大きなハコブくん.png 10-12 16:09
COPYONLY-new フィジカルAIの現在地/サムネ素材/素材1_ハコブくん.png 10-12 15:59
COPYONLY-new フィジカルAIの現在地/サムネ素材/素材2_実機のアーム.png 10-12 15:59
COPYONLY-new フィジカルAIの現在地/概要欄.txt 10-12 15:33
src-only 22
元へ戻した結果と、戻したあとの照合:
Counter({'new': 41, 'overwrite': 8}) True
('AIエージェントの取り違え/narration.py', 'overwrite', True)
('AIエージェントの取り違え/scenes.py', 'overwrite', True)
('_制作ベース/assemble.py', 'overwrite', True)
('_制作ベース/tts_eleven.py', 'overwrite', True)
('_制作ベース/video_rules.md', 'overwrite', True)
('フィジカルAIの現在地/narration.py', 'overwrite', True)
('フィジカルAIの現在地/scenes.py', 'overwrite', True)
('フィジカルAIの現在地/voice_eleven/ハコブ/設定.json', 'overwrite', True)
common 1511 diff 1 undeclared [] miss 0 only 156
最後の件数(data/stats.json)
{"records": 339, "manga": 99, "english": 95, "series": {"考察記事": 63, "R2R2R": 185, "HRI": 54, "ロボティクスデザイン": 9, "フィジカルAI研究室": 8, "Consideration": 7, "UV-C農業ロボット": 2, "画像認識・物体検出": 11}, "images_unique_source_urls_in_cms_pages": 972, "image_files_in_cms_pages": 973, "image_files_incl_static": 982, "embeds_total": 303, "embeds_diagram": 286, "embeds_youtube": 17, "videos_in_articles": 21, "videos_mp4": 4, "videos_youtube": 17, "links": 176, "first_published": "2025-12-10", "last_published": "2026-10-12"}
codex への依頼書と検証報告の全文
依頼書2本と、codex が書いた報告2本です。報告の中のリンク先(_review/work/ 以下)は、アーカイブの中にある codex の検証スクリプトと結果のファイルです。
1回目の依頼書(codex_verification_request.md)
# 検証依頼(敵対的検証):Pixels to Motors サイトアーカイブ

対象フォルダ:このファイルの1つ上(`site_archive/`)
取得元サイト:https://adaptdesign.jp/pixelstomotors (Studio製)
作成:Claude(2026-10-12) 依頼者:エイイチ

---

## あなたの役割

このアーカイブは Claude が作った。作った本人の確認は済んでいるが、同じ書き手の確認は同じ盲点を持つ。
あなたは **「このアーカイブは不完全で、どこかが元サイトと食い違っている」という前提で、その証拠を探す** 役割を担う。

- 「たぶん大丈夫」は書かない。OK と判定する項目には、必ず **実行したコマンド・数えた件数・比べた値** を証拠として添える。
- アーカイブ内の README・index・CSV・tools/ のスクリプトが言っていることを **信用しない**。元サイトと実ファイルを自分で数え、自分で比べる。
- tools/convert.py などの Claude のスクリプトを再実行して比べるのは「検証」にならない。比較には **自分で書いた独立の処理** を使う。

---

## 守ること(禁止事項)

- `site_archive/` 内のファイルを **変更・移動・削除しない**(読むだけ)。書いてよいのは `site_archive/_review/` の中だけ。
- 元の作業フォルダ(`PixelstoMotors/デジタルツイン学習R2R2R` など)、`~/r2r2r-scripts`、`/Volumes/KIOXIA/r2r2r-data` も **読むだけ**。
- git 操作(commit・push・clean 等)をしない。
- サイトへのアクセスは GET のみ。同時接続は 4 本程度までにして、短時間に大量に叩かない。
- 作業用の一時ファイルは `/tmp` か `site_archive/_review/work/` に置く。

ネットワーク(adaptdesign.jp と storage.googleapis.com への HTTPS)が必要。サンドボックスで遮断される場合は、その旨を報告の冒頭に書き、ネットワークなしでできる項目(F〜H)だけでも実施する。

---

## アーカイブの構造(Claude の主張。これ自体を疑うこと)

```
site_archive/
├── README.md / index/*.md / data/*.csv / data/stats.json   索引
├── content/record/DAY{NNN}_{slug}/article.md (+ images/ embeds/ thumbnail.html)   記事 339本
├── content/manga/{slug}/manga.md (+ images/)        4コマ 99話
├── content/english/{slug}/english.md (+ images/)    英語版4コマ 95話
├── content/static/{name}/page.md (+ studio_design.json)   固定ページ 13 + テンプレート 3
├── raw/cms/{record|manga|english}/{slug}.json       各ページの CMS データ原本(item.body が本文HTML)
├── raw/studio/                                      固定ページのデザイン構造
├── kioxia_r2r2r-data/                               KIOXIA videos/・lab/ のコピー
├── work_files/                                      iCloud の作業フォルダのコピー
├── code/r2r2r-scripts/  code/r2r2r-content/         コードのコピー
└── tools/                                           生成スクリプト
```

### 取得の仕組み(検証のための情報)

- 全URLは `https://adaptdesign.jp/sitemap.xml`(sitemap index)から辿れる。Pixels to Motors の対象は
  `sitemap-static.xml` のうち `/pixelstomotors` 配下と、`sitemap-dynamic-...` のうち `pixelstomotors/record/:slug`・`pixelstomotors/manga/:slug`・`pixelstomotors/english-4-koma/:slug` の3つ。
  `web_production`・`tag`・`/2`・`/web_production_list` は対象外(Claude の判断。妥当かも評価してよい)。
- 記事・マンガの各ページの HTML には `<script id="__NUXT_DATA__">` があり、Nuxt の devalue 形式(インデックス参照で平坦化された JSON 配列)で CMS 項目が入っている。`data` の中の `dynamicData...` キーが記事本体で、`body` が本文 HTML。
- 本文 HTML の特殊ブロック:`div[data-type=table_of_contents]`(自動目次)、`div[data-type=embed_code]`(中身は URL エンコードされた HTML。`data-embed-code-type="youtube"` は YouTube)、`div[data-type=video_block]`(mp4)、`figure > img`。
- 画像・動画は `https://storage.googleapis.com/studio-design-asset-files/...` と `.../studio-cms-assets/...`。アーカイブ内のファイル名は URL の最後の部分。

---

## 検証項目

各項目に ✅ OK / ⚠️ 要注意 / ❌ NG で答える。⚠️・❌ には **該当ファイルのパス・具体的な食い違い・再現手順** を書く。

### A. 網羅性(抜け・余分)

A1. sitemap の対象URLをすべて数え、`content/` のページ数(record / manga / english / static)と1対1で対応するか。抜けているURL、余分なフォルダを全件列挙。
A2. 各 md の `url:` と `slug:` が、実在する sitemap の URL と一致するか(全件)。
A3. フォルダ名 `DAY{NNN}_{slug}` の DAY 番号が、その記事の CMS の DAY 項目(`bPskK658`)と一致するか(全件)。
A4. sitemap に無いが公開されているページ(固定ページからのリンク先・記事内の相互リンク先など)で、アーカイブから漏れているものはないか。

### B. 本文の忠実性(いちばん重要)

元サイトのページ HTML から **自分で** 本文を取り出し、`article.md` / `manga.md` / `english.md` と比べる。

B1. **全ページ** について、本文の文字(HTML タグと空白を除いた文字列)が md 側に漏れなく入っているか。差分が出たページを全件列挙し、どこが欠けた/増えたかを示す。(Markdown 記法の記号・目次・埋め込みの置換表記による差は除外してよいが、その除外ルールを明記すること)
B2. コードブロック(`<pre>`):全ページの全コードブロックについて、中身が md 側のコードブロックと **1文字単位で一致** するか。(記事にはフルコード掲載ルールがあるため、1行の欠けも NG)
B3. 表(`data-type=table`):行数・列数・セルの文字が一致するか(全件)。
B4. 見出し(h2〜h6)の数と文言、箇条書き・番号付きリストの項目数が一致するか。
B5. リンク:本文中の `<a href>` がすべて md 側にリンクとして残っているか。
B6. 抜き取りで 20 ページ以上(シリーズ・年代・長さが偏らないように。最古・最新・最長・表が最多・コードが最多・動画ありを必ず含める)を選び、md をプレビュー表示して、人が読んで崩れていないか(表が崩れる・コードが本文に混ざる・画像が出ない)を目で確認する。

### C. メタデータ

C1. md 先頭(YAML)の title・day・series・lang・published・updated・description が、元ページの CMS データと一致するか(全件)。
C2. YAML として正しく読み込めるか(全 md をパーサで読む)。
C3. `data/pages.csv` の各行が md の内容と一致するか。行数は 533 か。

### D. 画像・動画

D1. 元ページの CMS データと本文に出てくる画像・動画の URL をすべて集め、アーカイブ内に同名ファイルがあるか(全件)。
D2. アーカイブ内の画像・動画が壊れていないか。少なくとも 50 点を無作為に選び、元 URL から取得したものと **SHA-256 が一致** するか確認する。全点の「画像として開けるか」(PIL 等で verify)も確認。
D3. md 内の画像リンク・動画リンクがすべて実在ファイルを指しているか(相対パスを解決して確認)。
D4. YouTube 埋め込み:元ページの YouTube 動画 ID がすべて md 側に URL として残っているか。

### E. 図解HTML(埋め込みコード)

E1. 元ページの `embed_code`(custom)の数と、各記事の `embeds/` 内のファイル数が一致するか(全件)。
E2. 元ページの埋め込みを URL デコードした HTML と、`embeds/*.html` の中身が一致するか(全件。画像 URL をローカルパスに置き換えている箇所は差分として明示し、それ以外の差がないこと)。
E3. `thumbnail.html`(動くサムネイル):CMS の `Qi0bIZEy.title` を持つ記事の数と、`thumbnail.html` がある記事の数が一致し、中身も一致するか。

### F. 原本(raw/)との整合

F1. `raw/cms/` の JSON の数は 533 か。各 JSON の `item.body` が、いま元サイトから取れる `body` と一致するか(取得日以降に更新された記事は、`updated` の日時を添えて「更新による差」として分けて報告)。
F2. `raw/studio/pages/` の固定ページ構造と `content/static/*/page.md` の本文テキストが対応しているか(文字列の抜け)。

### G. 索引と README

G1. README・`index/*.md`・`data/stats.json` に書かれた件数が、実ファイルを数えた値と一致するか。
G2. `index/` と README 内の相対リンクがすべて実在ファイルを指すか(URL エンコードされた日本語パスに注意)。
G3. `index/01_シリーズ別.md` の各シリーズの本数が、md の `series:` の集計と一致するか。
G4. 「探し方」に書かれた grep コマンドなどが、実際にその通り動くか。

### H. 作業ファイル・コード・KIOXIA のコピー

H1. `work_files/` の各ファイルが、元の `PixelstoMotors/{デジタルツイン学習R2R2R, ハコブくん, サムネイル}` と **サイズと SHA-256 で一致** するか(全件)。除外したと README に書いてある3フォルダ(モデリング・Unity-BackupDtata・Claudeプロジェクト)以外に抜けがないか。macOS のファイル名の Unicode 正規化(NFC/NFD)の違いで一致判定を誤らないこと。
H2. `kioxia_r2r2r-data/` の各ファイルが `/Volumes/KIOXIA/r2r2r-data/` の同名ファイルと SHA-256 で一致するか(KIOXIA が接続されている場合)。
H3. `code/r2r2r-scripts/` が `~/r2r2r-scripts` の .py・.md・.json・.csv・.sh をすべて含むか(README に書いた除外:画像・動画・`.bak*`・`__pycache__`・`.git` 以外の抜け)。
H4. `code/` 以下と `work_files/` 以下に、API キー・トークン・パスワード・秘密鍵らしき文字列が含まれていないか(`sk-ant-`・`ghp_`・`AKIA`・`-----BEGIN`・`password=` 等で全文検索。見つけた場合は値そのものは報告に書かず、パスと種類だけ書く)。
H5. コピー途中の一時ファイル(`.名前.XXXXXX` 形式)や `.DS_Store` 以外のゴミが残っていないか。

### I. 移行メモの正しさ

I1. `index/09_Studio移行メモ.md` の「CMS のモデルと項目」の対応表(内部キー → 意味)が、実データと矛盾しないか(例:`bPskK658` が本当に全記事で DAY 番号の形か、`HOUwyFeo` がシリーズか)。
I2. 移行時に必要なのにアーカイブに無い情報があれば挙げる(例:共通ヘッダー・フッター、リダイレクト設定、OGP 画像、構造化データ)。

---

## 報告の形式

`site_archive/_review/codex_report_YYYYMMDD.md` に書き出す。

1. 冒頭に **総合判定**(そのまま保存版として使ってよいか/直すべき箇所があるか)を3行以内。
2. 項目ごと(A1〜I2)に ✅/⚠️/❌、証拠(コマンドと数値)、⚠️・❌ は具体的な場所と修正案。
3. 最後に「Claude に渡す修正依頼」を箇条書きで(そのまま貼って依頼できる形)。
4. 使った検証スクリプトは `site_archive/_review/work/` に保存し、報告からパスを示す。
1回目の報告(codex_report_20261012.md)
# Pixels to Motors サイトアーカイブ — 独立検証報告(2026-10-12)

総合判定:❌ Markdownを含めて「そのまま使える保存版」とするには修正が必要です。
原本CMS本文533件は現在の公開サイトと完全一致。主要な問題はMarkdownの表の崩れ・コードの空行消失・固定ページ資産の不足です。
原本と既存コピーは維持し、変換の修正・不足資産の追加・同期時点の明記後に再検証してください。

対象:`/Users/shimazueiichi/Library/Mobile Documents/com~apple~CloudDocs/デスクトップ/ADAPT DESIGN/じぶんの/PixelstoMotors/site_archive`。書き込みは `_review/` 内のみ。元作業フォルダ・コード・KIOXIAは読み取り専用、git操作は実施していません。公開サイトはGETのみ、各採取処理は最大4ワーカー・各GET前に0.35〜0.4秒待機。初回546ページのGETは全件HTTP 200、取得エラー0件。ネットワーク遮断はありませんでした。

## 検証の再現と証拠

Claude製の `tools/` は実行していません。Nuxt参照配列の復元、HTMLとMarkdownの解析、ファイル列挙・ハッシュ比較を独立処理で行いました。Nuxtの `Date` 型はISO日時へ正規化しています。採取済HTML/CMSは `work/live/` に保存し、照合結果をJSONで残しています。最初の機械比較にあったパーサ由来の誤検出を補正した最終結果は [final_results.json](work/final_results.json) です。`semantic_results.json`・`local_results.json` の初期差分を、そのまま不具合件数として読まないでください。

実行したコマンド(スクリプト実行場所 `/tmp`、同じ独立スクリプトを下記の `work/` に保存):

```sh
python3 -m venv /tmp/codex-archive-verify-venv
/tmp/codex-archive-verify-venv/bin/pip install beautifulsoup4 PyYAML Pillow markdown-it-py requests playwright av
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_fetch_verify.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_local_verify.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_semantic_verify.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_aux_verify.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_refine_verify.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_final_checks.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_media_extra.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex_claim_checks.py
```

保存スクリプト:[fetch_live.py](work/fetch_live.py), [verify_local.py](work/verify_local.py), [verify_semantic.py](work/verify_semantic.py), [verify_aux.py](work/verify_aux.py), [verify_refined.py](work/verify_refined.py), [verify_final.py](work/verify_final.py), [verify_media_extra.py](work/verify_media_extra.py), [verify_claims.py](work/verify_claims.py), [verify_missing_asset.py](work/verify_missing_asset.py), [preview_server.py](work/preview_server.py)。依存パッケージは [requirements.txt](work/requirements.txt)。プレビューは `preview_server.py` で生成し、アプリ内ブラウザから `http://127.0.0.1:8769/preview/01.html`〜`29.html` を表示しました。再実行時は採取キャッシュを使うため、同じ取得時点の結果を再現します。

### 除外・正規化ルール

- B1:YAMLと生成されたタイトル・公開日・概要のヘッダーを除外。HTMLタグ・空白、Markdown記法(見出し・強調・コードフェンス・列挙記号)、自動目次、図解/YouTube/mp4の置換案内を除外。通常のYouTubeリンクがある文章は保持。コード本文も文字比較へ含め、コードの改行はB2で別途厳密比較。表の `|` は除外しません。
- B2:`<pre>` のテキストをHTMLエンティティ復元後に取得。Markdownフェンスを閉じるために必要な終端LFを1つだけ構文として除外(元に終端LFがない場合)。内部の空行は除外しません。
- C1:Nuxt DateタグをISO文字列へ復元。空文字とYAML nullは別値として記録。C3ではCSVが表現できないnullを空欄とみなし、マンガのday=label・series=character・lang=種類からJP/ENを対応づけています。
- D1:Studioの画像・動画資産URLを対象。Google Cloud上の外部PDFやopenpi-assetsディレクトリへの本文リンクは画像欠落へ数えません。
- E:customのYouTubeも数え、図解HTMLと分離します。UID一致でファイルを対応させ、順序による誤対応は除外。
- H:ファイル名をNFCへ正規化し、H1の除外は指定3フォルダと`.DS_Store`のみ。H3では指定拡張子と`.bak*`・`.git`・`__pycache__`の除外を適用。

## A1. ✅ OK 網羅性

サイトマップ対象546 URL = record 339 + manga 99 + english 95 + 固定13。実MD549 = CMS533 + 固定13 + テンプレート3。公開ページの欠落0・重複0。余分な公開記事0。テンプレートの `record/:slug`・`manga/:slug`・`english-4-koma/:slug` はサイトマップURLではなく設計資料として別枠です。証拠:`fetch_live.py` のXML列挙、`verify_semantic.py` のMD対応集合比較、[sitemap_urls.json](work/sitemap_urls.json)・[final_results.json](work/final_results.json) のA1。空の余分なフォルダ3件はH5参照。

## A2. ✅ OK URL・slug

CMS533件の `url` は全件サイトマップに存在し、URL末尾と `slug` の不一致0。固定13件もURL集合へ一致。固定ページは `slug` ではなく `page_id` を持つ別スキーマ、テンプレート3件は公開URL照合対象外。コマンド:`verify_semantic.py`、不一致一覧 `A2=[]`。

## A3. ❌ NG DAYフォルダ

record 339件中338件はCMSのDAY番号に対応。1件は `content/record/DAYxxx_day13/article.md`、CMS `bPskK658="DA13"`、フォルダが `DAYxxx_day13`。`verify_semantic.py` のA3で再現。修正:DAY13として扱うルールを明記して `DAY013_day13` に整理し、索引・CSVも更新する。元CMS値 `DA13` は原本として保持し、正規化値と混同しない。

## A4. ⚠️ 要注意 サイトマップ外リンク

固定ページ設計・546ページのリンク・533件の本文リンクから対象内のサイトマップ外候補2 URLをGET。`http://adaptdesign.jp/pixelstomotors` は既存トップへHTTPSリダイレクト、追加の公開ページではない。`https://adaptdesign.jp/pixelstomotors/ai-agent` はHTTP 404で、`raw/studio/pages/pixelstomotors.json` に古いリンク参照が残る。新しい有効ページの漏れ0。ただし、ログイン限定・孤立したURLなど、リンクにもサイトマップにもないページの不在は証明できない。修正:ai-agentリンクを削除/更新し、対象範囲をURL接頭辞で明記。`/2`・`/web_production_list`・tag・web_productionの除外は今回の接頭辞範囲と整合。証拠:`verify_aux.py`、[aux_results.json](work/aux_results.json) のA4。

## B1. ❌ NG 本文文字

533件を独立HTML/Markdownパーサで照合。上記除外後の差分ページ7件(すべてrecord)。うち文章/数値の脱落3件、表がパイプ文字のまま露出する等の構造差4件。差分全文とソース/MD位置は [final_results.json](work/final_results.json) のB1。再現:`verify_final.py`。修正:表セル内の `|` をエスケープし、セル改行を保持した形式で再生成。全件:

- `content/record/DAY200_pivot-to-probe-control-and-external-review/article.md` — 原文「|diff|が前回より減れば同方向継続・増えれば反転する自己修正ループへ」→ MD「」
- `content/record/DAY191_parallax-and-pose-constrained-motion/article.md` — 原文「4.786-18.4%」→ MD「」;原文「4.667-26%」→ MD「」;原文「4.905-9%」→ MD「」
- `content/record/DAY179_visual-servo-design/article.md` — 原文「1」→ MD「||---|---|---|---|---|---||1|」;原文「2」→ MD「||2|」;原文「12.0mm」→ MD「|12.0mm|」
- `content/record/DAY073_day73/article.md` — 表のパイプ文字が通常本文へ露出/消失(全差分はJSON)。
- `content/record/DAY294_handover-lost-the-incremental-loop/article.md` — 原文「正しい・listenしていない」→ MD「」
- `content/record/DAY178_fk-vs-real-machine-camera-loop/article.md` — 原文「err」→ MD「|err|||---|---|---|---|---|---|」
- `content/record/DAY204_visual-servo-y-axis-design/article.md` — 原文「j2」→ MD「||---|---|---|---||j2|」;原文「j4」→ MD「||j4|」

## B2. ❌ NG コードの1文字照合

元HTMLのpreは2,106ブロック、MDコードブロックは2,109。元preのうち1,943ブロックは一致、163ブロック・68ページで内部LF計1,359文字が消失。空行以外の文字の欠落は検出0。MD側の余分3ブロックはDAY070・072・073で、元CMSの段落内に元々書かれていたMarkdownフェンスを解釈したもの(元preの欠落ではない)。「1文字単位で一致」という条件には不合格。例:DAY139の第10ブロック4,548→4,545文字、第11ブロック2,382→2,377文字。修正:コードブロックを抽出後、全体の連続改行を詰める処理の影響から隔離して、そのまま戻す。コマンド:`verify_semantic.py`、[final_results.json](work/final_results.json) のB2に全166差分ブロック(元pre163+追加3)の位置・差分あり。元preが異なる全ページ:

- `content/record/DAY139_day139/article.md` — ブロック 10, 11, 12
- `content/record/DAY293_handover-control-code-complete/article.md` — ブロック 3, 7, 14
- `content/record/DAY211_slugwhere-the-bug-actually-lives/article.md` — ブロック 5, 7, 9, 11, 13, 21
- `content/record/DAY176_dont-trust-logs-trust-the-arm/article.md` — ブロック 1, 5
- `content/record/DAY280_template-match-center-was-the-corner/article.md` — ブロック 16, 17, 18, 19, 20, 21
- `content/record/DAY288_handover-step1-design/article.md` — ブロック 4, 6
- `content/record/DAY188_mecharm-ssh-overhead-40x-speedup/article.md` — ブロック 7, 18
- `content/record/DAY224_descend-passed-but-placement-drifts/article.md` — ブロック 6, 10
- `content/record/DAY182_mecharm-control-frequency-benchmark-fresh-mode/article.md` — ブロック 4, 5, 6
- `content/record/DAY244_beyond-the-arc-taught-grasp/article.md` — ブロック 9, 10, 11, 12
- `content/record/DAY154_day154/article.md` — ブロック 16, 17, 20
- `content/record/DAY240_build-robot-arm-telemetry-dashboard/article.md` — ブロック 2, 4
- `content/record/DAY185_mecharm-dynamic-tracking-stable-grasp/article.md` — ブロック 16
- `content/record/DAY243_tip-block-offset-measurement/article.md` — ブロック 7
- `content/record/DAY304_what-circularity-actually-measures/article.md` — ブロック 3, 9
- `content/record/DAY151_day151/article.md` — ブロック 5
- `content/record/DAY232_j0-position-table-place-approach/article.md` — ブロック 9, 10
- `content/record/DAY197_calibration-arm-not-moving/article.md` — ブロック 7, 22
- `content/record/DAY220_place-release-trial-log/article.md` — ブロック 1, 4, 5
- `content/record/DAY331_explainer-video-character-narration/article.md` — ブロック 3, 4, 6
- `content/record/DAY209_place-design-and-first-move/article.md` — ブロック 8
- `content/record/DAY328_speak-to-relearn-robotics/article.md` — ブロック 1, 2, 3
- `content/record/DAY274_fill-the-hole-not-loosen-the-guard/article.md` — ブロック 5, 6, 7
- `content/record/DAY300_hue-holds-color-breaks/article.md` — ブロック 2
- `content/record/DAY330_making-explainer-video-with-ai/article.md` — ブロック 3, 14
- `content/record/DAY217_place-descend-and-camera-stability/article.md` — ブロック 5
- `content/record/DAY231_j1-command-rejection-found/article.md` — ブロック 9, 10
- `content/record/DAY227_drag-teach-v2-replay-and-position-binding/article.md` — ブロック 11
- `content/record/DAY183_physical-tracking-limit-vs-software-speed/article.md` — ブロック 4
- `content/record/DAY327_pi05-libero-benchmark-first-run/article.md` — ブロック 5, 19, 27, 31
- `content/record/DAY242_telemetry-idle-stage-history-place-verdict/article.md` — ブロック 24
- `content/record/DAY283_persistent-loop-interrupt-auto-home/article.md` — ブロック 12
- `content/record/DAY169_day169/article.md` — ブロック 6
- `content/record/DAY310_tilted-plane-to-flat/article.md` — ブロック 6, 7, 13
- `content/record/DAY179_visual-servo-design/article.md` — ブロック 14
- `content/record/DAY186_mecharm-reach-control-ssh-overhead-analysis/article.md` — ブロック 15
- `content/record/DAY226_drag-teaching-records-and-replays/article.md` — ブロック 10, 11
- `content/record/DAY265_measure-the-hole-before-filling-it/article.md` — ブロック 1, 2, 3
- `content/record/DAY263_fk-place-one-fix-reveals-next/article.md` — ブロック 18
- `content/record/DAY216_approach-move-passes/article.md` — ブロック 6, 7, 8, 9
- `content/record/DAY230_j0-sweep-reachability-map/article.md` — ブロック 8
- `content/record/DAY142_day142/article.md` — ブロック 5, 20, 21, 22
- `content/record/DAY163_day163/article.md` — ブロック 5, 12
- `content/record/DAY279_revamping-the-observe-view/article.md` — ブロック 15, 16, 17, 19
- `content/record/DAY196_dual-camera-detection-design/article.md` — ブロック 4, 5, 9
- `content/record/DAY215_stage2-not-moving-isolation/article.md` — ブロック 1
- `content/record/DAY213_design-implementation-split/article.md` — ブロック 2, 4, 6, 8, 10, 15
- `content/record/DAY129_day129/article.md` — ブロック 6, 7, 8, 9
- `content/record/DAY299_where-pixel-values-change/article.md` — ブロック 1, 2, 6
- `content/record/DAY208_first-grasp-by-loosening-z-threshold/article.md` — ブロック 5, 25
- `content/record/DAY297_shoot-one-frame-before-building-detection/article.md` — ブロック 2, 19
- `content/record/DAY266_stop-designing-to-stop/article.md` — ブロック 4
- `content/record/DAY239_the-wall-was-a-dropped-command/article.md` — ブロック 1
- `content/record/DAY275_why-arm-stopped-grasping-root-cause-apick/article.md` — ブロック 7, 8, 10
- `content/record/DAY172_day172/article.md` — ブロック 3, 5, 7, 9, 11
- `content/record/DAY189_dynamic-tracking-z-axis-sign-inversion/article.md` — ブロック 10, 11
- `content/record/DAY287_mecharm-continuous-recording-pipeline/article.md` — ブロック 3, 4
- `content/record/DAY222_correction-blocked-by-table-gap/article.md` — ブロック 2, 3, 14, 15
- `content/record/DAY144_day144/article.md` — ブロック 17, 18, 19
- `content/record/DAY153_day153/article.md` — ブロック 9, 10
- `content/record/DAY178_fk-vs-real-machine-camera-loop/article.md` — ブロック 1, 6
- `content/record/DAY301_rgb-hsv-threshold-lighting-failure/article.md` — ブロック 1
- `content/record/DAY168_day168/article.md` — ブロック 2, 12, 13, 14, 15, 16
- `content/record/DAY238_measuring-the-stuck-joint/article.md` — ブロック 4
- `content/record/DAY289_handover-present-pose-from-probe-scan/article.md` — ブロック 12, 13
- `content/record/DAY261_push-hold-stops-the-drop/article.md` — ブロック 2
- `content/record/DAY326_openpi-remote-inference-first-run/article.md` — ブロック 17, 21, 24, 26
- `content/record/DAY210_place-test-not-moving/article.md` — ブロック 26

## B3. ❌ NG 表の行・列・セル

HTML658表→MD655表。10ページで行/セル/表数が不一致。4ページで表が1つずつ通常段落に崩れ、DAY073では元の段落に書かれたMarkdown表が1つ表に解釈されているため、合計の減少は3。DAY200では `|diff|が前回より減れば同方向継続・増えれば反転する自己修正ループへ` が結果セルから消失。DAY191では絶対値記号が列区切りになり `4.786 / -18.4%` 等が消失。DAY018・038・328は空ヘッダー行の追加など。コマンド:`verify_semantic.py`。修正:パイプのエスケープ、セル改行の `<br>` 化、ヘッダー無し表をHTML表で保存する等。全セル配列は [final_results.json](work/final_results.json) のB3。全件:

- `content/record/DAY018_day18/article.md` — HTML 5表 / MD 5表、行/セル差分あり。
- `content/record/DAY328_speak-to-relearn-robotics/article.md` — HTML 19表 / MD 19表、行/セル差分あり。
- `content/record/DAY200_pivot-to-probe-control-and-external-review/article.md` — HTML 1表 / MD 1表、行/セル差分あり。
- `content/record/DAY191_parallax-and-pose-constrained-motion/article.md` — HTML 5表 / MD 4表、行/セル差分あり。
- `content/record/DAY179_visual-servo-design/article.md` — HTML 2表 / MD 1表、行/セル差分あり。
- `content/record/DAY038_day38/article.md` — HTML 2表 / MD 2表、行/セル差分あり。
- `content/record/DAY073_day73/article.md` — HTML 0表 / MD 1表、行/セル差分あり。
- `content/record/DAY294_handover-lost-the-incremental-loop/article.md` — HTML 1表 / MD 1表、行/セル差分あり。
- `content/record/DAY178_fk-vs-real-machine-camera-loop/article.md` — HTML 2表 / MD 1表、行/セル差分あり。
- `content/record/DAY204_visual-servo-y-axis-design/article.md` — HTML 9表 / MD 8表、行/セル差分あり。

## B4. ⚠️ 要注意 見出しとリスト

h2〜h6はHTML4,086→MD4,111、明示的liは3,040→3,107。50ページで構造/文言不一致。元の段落内Markdown記号が見出し・リストに再解釈される差、強調記号が文字列として露出する差を含むため、この数の増加すべてを「内容追加」とは扱わない。ただし構造の忠実性は満たしていない。コマンド:`verify_semantic.py`、[final_results.json](work/final_results.json) のB4に全見出し・リスト構成あり。修正:元HTMLの段落内記法を適切にエスケープし、見出し文言とリスト階層を再比較する。全件:

- `content/record/DAY012_day12/article.md` — 見出し 5→5、li 15→15。文言差もJSONに記録。
- `content/record/DAY026_day26/article.md` — 見出し 16→16、li 6→6。文言差もJSONに記録。
- `content/record/DAY071_day71/article.md` — 見出し 12→12、li 10→18。文言差もJSONに記録。
- `content/record/DAY031_day31/article.md` — 見出し 22→22、li 43→43。文言差もJSONに記録。
- `content/record/DAY019_day19/article.md` — 見出し 10→10、li 51→51。文言差もJSONに記録。
- `content/record/DAY066_day66/article.md` — 見出し 7→7、li 13→13。文言差もJSONに記録。
- `content/record/DAY060_day60/article.md` — 見出し 22→22、li 48→48。文言差もJSONに記録。
- `content/record/DAY037_day37/article.md` — 見出し 14→14、li 16→16。文言差もJSONに記録。
- `content/record/DAY043_day43/article.md` — 見出し 20→20、li 37→37。文言差もJSONに記録。
- `content/record/DAY020_day20/article.md` — 見出し 23→23、li 23→23。文言差もJSONに記録。
- `content/record/DAY009_day9/article.md` — 見出し 7→7、li 10→10。文言差もJSONに記録。
- `content/record/DAY044_day44/article.md` — 見出し 54→54、li 19→19。文言差もJSONに記録。
- `content/record/DAY027_day27/article.md` — 見出し 7→7、li 17→17。文言差もJSONに記録。
- `content/record/DAY269_predicted-vs-actual-correction-loop/article.md` — 見出し 16→16、li 0→0。文言差もJSONに記録。
- `content/record/DAY070_day70/article.md` — 見出し 44→44、li 60→80。文言差もJSONに記録。
- `content/record/DAY030_day30/article.md` — 見出し 9→9、li 13→13。文言差もJSONに記録。
- `content/record/DAY053_day53/article.md` — 見出し 10→10、li 7→7。文言差もJSONに記録。
- `content/record/DAY036_day36/article.md` — 見出し 7→7、li 4→4。文言差もJSONに記録。
- `content/record/DAY049_day49/article.md` — 見出し 12→12、li 17→17。文言差もJSONに記録。
- `content/record/DAY080_day80/article.md` — 見出し 6→14、li 0→3。文言差もJSONに記録。
- `content/record/DAY055_day55/article.md` — 見出し 35→35、li 20→20。文言差もJSONに記録。
- `content/record/DAY076_day76/article.md` — 見出し 16→16、li 23→22。文言差もJSONに記録。
- `content/record/DAY021_day21/article.md` — 見出し 12→12、li 11→11。文言差もJSONに記録。
- `content/record/DAY038_day38/article.md` — 見出し 24→24、li 32→32。文言差もJSONに記録。
- `content/record/DAY024_day24/article.md` — 見出し 16→16、li 32→32。文言差もJSONに記録。
- `content/record/DAY073_day73/article.md` — 見出し 13→20、li 14→21。文言差もJSONに記録。
- `content/record/DAY033_day33/article.md` — 見出し 9→9、li 8→8。文言差もJSONに記録。
- `content/record/DAY064_day64/article.md` — 見出し 11→11、li 16→16。文言差もJSONに記録。
- `content/record/DAY078_day78/article.md` — 見出し 32→32、li 35→35。文言差もJSONに記録。
- `content/record/DAY004_day4/article.md` — 見出し 7→7、li 24→24。文言差もJSONに記録。
- `content/record/DAY035_day35/article.md` — 見出し 5→5、li 5→5。文言差もJSONに記録。
- `content/record/DAY029_day29/article.md` — 見出し 15→15、li 31→31。文言差もJSONに記録。
- `content/record/DAY192_setting-up-the-side-camera/article.md` — 見出し 10→10、li 37→37。文言差もJSONに記録。
- `content/record/DAY041_day41/article.md` — 見出し 9→9、li 14→14。文言差もJSONに記録。
- `content/record/DAY069_day69/article.md` — 見出し 13→15、li 28→35。文言差もJSONに記録。
- `content/record/DAY075_day75/article.md` — 見出し 8→8、li 10→10。文言差もJSONに記録。
- `content/record/DAY022_day22/article.md` — 見出し 12→12、li 13→13。文言差もJSONに記録。
- `content/record/DAY039_day39/article.md` — 見出し 27→27、li 79→79。文言差もJSONに記録。
- `content/record/DAY025_day25/article.md` — 見出し 16→16、li 36→36。文言差もJSONに記録。
- `content/record/DAY072_day72/article.md` — 見出し 29→37、li 42→53。文言差もJSONに記録。
- `content/record/DAY006_day6/article.md` — 見出し 9→9、li 7→7。文言差もJSONに記録。
- `content/record/DAY032_day32/article.md` — 見出し 14→14、li 12→12。文言差もJSONに記録。
- `content/record/DAY002_day2/article.md` — 見出し 10→10、li 12→12。文言差もJSONに記録。
- `content/record/DAY079_day79/article.md` — 見出し 33→33、li 69→68。文言差もJSONに記録。
- `content/record/DAY034_day34/article.md` — 見出し 10→10、li 14→14。文言差もJSONに記録。
- `content/record/DAY028_day28/article.md` — 見出し 9→9、li 24→24。文言差もJSONに記録。
- `content/record/DAY168_day168/article.md` — 見出し 18→18、li 27→27。文言差もJSONに記録。
- `content/record/DAY040_day40/article.md` — 見出し 25→25、li 47→47。文言差もJSONに記録。
- `content/record/DAY068_day68/article.md` — 見出し 15→15、li 36→49。文言差もJSONに記録。
- `content/record/DAY023_day23/article.md` — 見出し 16→16、li 27→27。文言差もJSONに記録。

## B5. ✅ OK 本文リンク

HTMLのa[href]は176出現。MDのリンク要素とhrefを多重集合で照合し、不足0件。通常のYouTubeリンクも対象。コマンド:`verify_semantic.py`、`anchors_source=176, B5=[]`。

## B6. ❌ NG プレビューの目視

8シリーズ・公開月・最古/最新/最長/表最多/コード最多/動画を含む26ページと、不具合の追跡3ページ、計29ページをアプリ内ブラウザで表示して目視。画像・表・コード・本文の代表箇所を確認し、全ページ全長を目視したという意味ではない。画像はサンプル範囲で表示でき、コードは枠内表示。DAY302では `**収縮(erosion)**` 等が生の記号として露出。DAY200・191ではB3の欠落/列ずれを目で確認。機械検査では52ページに生の `**` を検出。修正:強調の変換と表の処理を直して同じサンプルを再表示。選定値と全対象:[claim_results.json](work/claim_results.json) のvisual_notes、[visual_results.json](work/visual_results.json)、HTMLは `work/previews/`。スクリーンショット:[DAY200の空セル](work/previews/27_observed.png)・[DAY191の列ずれ](work/previews/28_observed.png)・[DAY179のプレビュー](work/previews/29_observed.png)。

- 01. `content/record/DAY001_day1/article.md` — oldest
- 02. `content/record/DAY332_youtube-channel-identity/article.md` — newest
- 03. `content/record/DAY279_revamping-the-observe-view/article.md` — longest
- 04. `content/record/DAY328_speak-to-relearn-robotics/article.md` — most tables
- 05. `content/record/DAY302_morphology-kernel-fits-or-vanishes/article.md` — most code
- 06. `content/record/DAY236_sam3-mirror-reflection-grasp-problem/article.md` — video
- 07. `content/record/DAY194_robotics-ux-designer-as-a-profession-en/article.md` — series Consideration
- 08. `content/record/DAY308_claude-instructions-hit-a-wall/article.md` — series HRI
- 09. `content/record/DAY180_mecharm-static-to-dynamic/article.md` — series R2R2R
- 10. `content/record/DAY052_day52/article.md` — series UV-C農業ロボット
- 11. `content/record/DAY225_precision-is-not-learning-so101/article.md` — series フィジカルAI研究室
- 12. `content/record/DAY303_figma-design-token-consolidation/article.md` — series ロボティクスデザイン
- 13. `content/record/DAY304_what-circularity-actually-measures/article.md` — series 画像認識・物体検出
- 14. `content/record/DAY195_three-ai-content-pipeline/article.md` — series 考察記事
- 15. `content/record/DAY012_day12/article.md` — month 2025-12
- 16. `content/record/DAY045_day45/article.md` — month 2026-01
- 17. `content/record/DAY059_day59/article.md` — month 2026-02
- 18. `content/record/DAY090_day90/article.md` — month 2026-03
- 19. `content/record/DAY257_why-z-correction-failed-twin-poses/article.md` — month 2026-06
- 20. `content/record/DAY293_handover-control-code-complete/article.md` — month 2026-07
- 21. `content/record/DAY320_ai-writes-code-not-motions/article.md` — month 2026-09
- 22. `content/record/DAY321_avatar-gitai/article.md` — month 2026-10
- 23. `content/manga/ep01/manga.md` — manga oldest
- 24. `content/manga/ep122/manga.md` — manga newest
- 25. `content/english/ep35/english.md` — english oldest
- 26. `content/english/ep122/english.md` — english newest
- 27. `content/record/DAY200_pivot-to-probe-control-and-external-review/article.md` — table-loss follow-up
- 28. `content/record/DAY191_parallax-and-pose-constrained-motion/article.md` — table-loss follow-up
- 29. `content/record/DAY179_visual-servo-design/article.md` — table-loss follow-up

## C1. ⚠️ 要注意 CMSメタデータ

CMS533件×指定7項目=3,731比較。タイトル・DAY・シリーズ・言語・公開・更新の差0。descriptionのみ3件がCMS空文字 `""` → YAML null。日時の初期誤検出1,066件はNuxt Dateタグを正規化して解消した。修正:空欄を `description: ""` で出力し、型を保つ。コマンド:`verify_refined.py`。全件:

- `content/record/DAY080_day80/article.md` — description: CMS空文字 / MD null
- `content/english/ep47/english.md` — description: CMS空文字 / MD null
- `content/english/ep54/english.md` — description: CMS空文字 / MD null

## C2. ✅ OK YAML構文

content内の549 MDをPyYAML safe_loadで読み、構文エラー0件。533 CMS + 16固定/テンプレートを含む。コマンド:`verify_local.py`、`md_all=549, yaml_errors=[]`。nullへの型変化はC1参照。

## C3. ✅ OK pages.csv

CSV533行をMDへ対応。全行のtype/day/series/lang/published/updated/title/slug/url/description、画像数、embeds数、文字数で差0。マンガの列の対応づけとnull空欄の扱いは上記参照。charsは「YAMLと生成ヘッダーを除いたMarkdown本文の、ファイル終端LFを除く文字数」で533/533一致。CSVは固定/テンプレート16件を含まない仕様。コマンド:`verify_refined.py`、`csv_refined.issues=[], char_matches=533`。

## D1. ❌ NG 画像・動画URLの存在

CMSとデコードした埋め込みHTML、固定ページdesignからStudio資産URLを独立収集。画像/動画の欠落1件。`raw/studio/pages/pixelstomotors.json` / `content/static/top/studio_design.json` の `s-2048x2048_5af0bc9f-8d23-4bdb-85e4-ada51bfd7bbd.webp` が `content/static/top/images/` に無く、アーカイブ全体を同名検索しても0件。修正:元URLから資産を保存し、参照元・用途を索引へ追加。URL:`https://storage.googleapis.com/studio-design-asset-files/projects/p6aoJ4vyqR/s-2048x2048_5af0bc9f-8d23-4bdb-85e4-ada51bfd7bbd.webp`。コマンド:`verify_semantic.py`→`verify_refined.py`、[final_results.json](work/final_results.json) のD1。欠落資産の元URLは追加GETでHTTP 200 / 66,314 bytes / 画像verify成功を確認:[missing_image_check.json](work/missing_image_check.json)。

## D2. ✅ OK 資産の破損・SHA-256

content内の全画像981ファイルをPillow verifyで確認、破損0。全mp4 6ファイルをPyAVで全フレームデコード、エラー0(record4+固定2、合計28,208動画フレーム)。独立抽出した実在する元URL群から固定seed=20261012で50 URLを無作為抽出、GETした内容とローカルSHA-256が50/50一致、取得エラー0。全資産の元URLハッシュを照合したという意味ではなく、指定の50点抜き取り。コマンド:`verify_local.py`・`verify_semantic.py`・`verify_media_extra.py`。全ハッシュ/URL/パス:[media_hash_sample.json](work/media_hash_sample.json)、全動画結果:[extra_results.json](work/extra_results.json)。

## D3. ⚠️ 要注意 MD内の相対資産リンク

549 MDのパーサ上の画像/動画リンクとYAML資産参照を相対解決。CMS533件の欠損0、固定/テンプレートに18出現の未解決画像参照。すべて `{{cover}}` / `{{UeFRSlTz}}` というStudioの動的プレースホルダーであり、通常のローカル画像リンクとしては表示不能。修正:テンプレートはコード/説明表記へ変え、公開固定ページはCMS一覧を展開するか、一覧への有効リンクへ置換。コマンド:`verify_local.py`、[local_results.json](work/local_results.json) のbroken_links。全対象:

- `content/static/top/page.md` — 未解決画像 2出現。
- `content/static/record_template/page.md` — 未解決画像 1出現。
- `content/static/series5/page.md` — 未解決画像 1出現。
- `content/static/series2/page.md` — 未解決画像 1出現。
- `content/static/series3/page.md` — 未解決画像 1出現。
- `content/static/manga-archive-en/page.md` — 未解決画像 1出現。
- `content/static/series4/page.md` — 未解決画像 1出現。
- `content/static/english-4-koma_template/page.md` — 未解決画像 3出現。
- `content/static/manga_template/page.md` — 未解決画像 3出現。
- `content/static/manga-archive/page.md` — 未解決画像 1出現。
- `content/static/series1/page.md` — 未解決画像 1出現。
- `content/static/series6/page.md` — 未解決画像 1出現。
- `content/static/series7/page.md` — 未解決画像 1出現。

## D4. ✅ OK YouTube ID

typed youtube3 + custom youtube14 = 17埋め込み出現、16ユニーク動画ID。全17出現で動画IDを持つMDリンクが存在、欠落0。YouTubeの再生可否は本項目の対象外。コマンド:`verify_refined.py`、`youtube_occurrences=17, youtube_unique=16, D4=[]`。

## E1. ⚠️ 要注意 custom埋め込み数

元CMS custom300ブロックに対し `embeds/*.html` は286ファイル。差14ブロックはすべてcustomとして保存されたYouTube iframeをURLへ変換したもの。図解286点という数は正しいが「customは全件HTMLに保存」というindex03/移行メモの記述は例外を落としている。元HTMLはraw本文に残る。修正:YouTube custom14件も別フォルダへHTML保存するか、URL化の例外仕様と件数を記載。コマンド:`verify_semantic.py`・`verify_refined.py`。全14ページはE2に列挙。

## E2. ⚠️ 要注意 埋め込みHTMLの中身

UIDで対応した保存HTML286件は、285件がデコード元と完全一致、1件は画像URLのローカル置換5箇所のみ、それ以外の差0。未保存YouTube custom14件は元のiframe/style構造を単独HTMLとして復元できない。修正:例外を明示し、移行時の表示レイアウトを残したい場合はHTMLも保存。再現:`verify_refined.py`、[final_results.json](work/final_results.json) のE2。未保存全件:

- `content/record/DAY059_day59/article.md` — custom UID MDG_x4ce、YouTube ID ySsQSnFNXl0
- `content/record/DAY071_day71/article.md` — custom UID lM68INO0、YouTube ID xsEVRsAkk8A
- `content/record/DAY120_day120/article.md` — custom UID RpvzR_z6、YouTube ID pDRs_MdA7Os
- `content/record/DAY137_day137/article.md` — custom UID sdOt_RbF、YouTube ID T8eEcPu_quM
- `content/record/DAY151_day151/article.md` — custom UID bo9AlM8m、YouTube ID aQfKch-5jxI
- `content/record/DAY113_day113/article.md` — custom UID MwVTwpbh、YouTube ID iaJLQYEg_vE
- `content/record/DAY055_day55/article.md` — custom UID Qn1AJIKE、YouTube ID IzM4wXROdLM
- `content/record/DAY126_day126/article.md` — custom UID UiMbs8Pt、YouTube ID mhfleCK_IAI
- `content/record/DAY073_day73/article.md` — custom UID u5EYiZvT、YouTube ID OE0kEAobRM8
- `content/record/DAY251_arcs-without-area/article.md` — custom UID xk8BK4y0、YouTube ID oOPW7AqZluE
- `content/record/DAY099_day99/article.md` — custom UID iMZZhGtX、YouTube ID XnwWIesgXQs
- `content/record/DAY124_day124/article.md` — custom UID VLll5q4B、YouTube ID pxM1HXwnMD4
- `content/record/DAY190_mecharm-descend-tip-shift-two-stage-tracking/article.md` — custom UID iaWCEvXI、YouTube ID NV57u-qa8vY
- `content/record/DAY149_day149/article.md` — custom UID bAj4VczF、YouTube ID LXqtkLXoKEw

ローカル置換のみ:`content/record/DAY111_day111/embeds/01_ZXumKnYG.html`。次の元URL末尾をそれぞれ `../images/<同名>` へ置換(全文URLはJSON参照):
- `s-324x324_webp_a122c029-ad3e-4e28-ac63-b8ddeae9fd46.png`
- `s-324x324_webp_b300d750-cce9-408b-9a6d-abb7eaf40131.png`
- `s-324x324_webp_5d1fa029-08a1-4157-a7c0-84a505124268.png`
- `s-324x324_webp_7bf9b882-f32f-42aa-af53-a7033062151a.png`
- `s-324x324_webp_08da6f0f-6715-4ae1-a42c-c5564720fec8.png`

## E3. ✅ OK 動くサムネイル

CMSの `Qi0bIZEy.title` を持つrecord46件、`thumbnail.html` 46件。全46件の文字列一致、余分/不足0。コマンド:`verify_semantic.py`、`thumbnail_source=46, E3=[]`。

## F1. ✅ OK CMS原本と現在のサイト

raw/cms以下のJSONは534ファイル。そのうちページ原本はrecord339+manga99+english95=533、残る1件は `raw/cms/urls.json` のURL一覧。ページ原本533件の `item.body` と現在のサイト本文が文字列・SHA-256で533/533一致。更新による本文差0、更新日時差0。単に全JSONを数え「534だからページが余分」とは判定しない。コマンド:`verify_semantic.py`、`F1=[]`。

## F2. ✅ OK 固定ページの原本文字列

raw/studio/pagesの16設計と対応MDを比較。content.type=textの167文字列中、装飾記号だけの `*` 3件を除く164文字列はすべてMDに存在。意味のある文字列の抜け0。共通symbol・動的CMS一覧の実体まで保存されたという意味ではない(D3/I2参照)。コマンド:`verify_semantic.py`→`verify_refined.py`、`F2=[]`、除外した3件は `F2_decorative`。

## G1. ⚠️ 要注意 件数の記述

records339/manga99/english95、シリーズ8区分、固定13+テンプレート3、図解286、記事動画4mp4+17YouTube=21、本文リンク176は実データと一致。画像972は「CMS記事・マンガのユニーク元画像URL数」で一致し、同じ画像のページ別コピーは973ファイル、固定資産も含め全画像981。件数の単位がREADME/statsで明示されていない。index07の43フォルダ行のうち2行は現在値と不一致:`work_files/デジタルツイン学習R2R2R/動画` 262→271ファイル、`code/r2r2r-content` 直下9→10ファイル(`.gitignore`込み)。トップレベルPythonスクリプト180本は一致。修正:これら2行と容量/内訳を更新、ユニークURLと実ファイル数を区別。コマンド:`verify_final.py`・`verify_claims.py`、[claim_results.json](work/claim_results.json)。

## G2. ✅ OK README/索引の相対リンク

README1件+index10 MDを独立Markdownパーサで解析し、日本語URLをデコードして相対パス2488出現を解決。実在しないファイルリンク0。外部URLの稼働や文書内フラグメントの全リンク先までは本判定に含めない。コマンド:`verify_local.py`・`verify_final.py`、`G.index_broken=[]`。

## G3. ✅ OK シリーズ本数

index01の8シリーズの「記載数」「記事リンク数」「MDのseries集計」が全区分一致:R2R2R185、考察記事63、HRI54、画像認識・物体検出11、ロボティクスデザイン9、フィジカルAI研究室8、Consideration7、UV-C農業ロボット2。合計339。コマンド:`verify_final.py`、`G.index_series`。

## G4. ✅ OK 探し方のコマンド

指定grepを実行:`grep -rl "LIBERO" content` は5ファイル/exit0、`grep -rn --include=*.md "π0.5" content` は114行/exit0(`| head`なら先頭10行)、`grep -l 'series: "R2R2R"' content/record/*/article.md` は185ファイル/exit0。`open content/record/DAY327_*/article.md` の同一グロブは既存1ファイルへ解決。openによる既定アプリ起動・Finder/Spotlightの検索インデックス状態は検証していない。コマンド実行の詳細:`verify_aux.py`、[aux_results.json](work/aux_results.json) のG4。

## H1. ⚠️ 要注意 作業ファイルのコピー

指定3元フォルダをNFCへ正規化、指定3除外フォルダ以外を列挙し、共通全1,431ファイルをサイズとSHA-256で比較、相違0・元側からの欠落0。サムネイル3/3、ハコブくん956/956、デジタルツイン学習472元ファイル/640コピーファイル。コピー側のみ168ファイル(動画の制作素材等)があり、現在の元フォルダでは同一パスが存在せずコピー元ハッシュを確認できない。これは内容不一致とは断定しないが、完全な1対1コピーではない。修正:余分を削除せず、追加コピーの由来/時点を目録へ記載する。除外以外の抜け0をstrict処理でも再確認。コマンド:`verify_local.py`・`verify_aux.py`、[local_results.json](work/local_results.json) のcopies、[aux_results.json](work/aux_results.json) のH1_strict。コピー側のみ168パス全件はJSONに列挙。

## H2. ⚠️ 要注意 KIOXIAコピー

KIOXIA接続あり。README/videos/lab/recordings対象範囲の元57ファイルに対しコピー49。既存49件はSHA-256一致、相違0。8動画がコピーに無い。元動画mtimeは2026-10-12 10:54〜11:48 JSTで、アーカイブのKIOXIAフォルダ作成10:39より後。初回コピー後の追加の可能性が高く、初回時点の取りこぼしとは断定しない。現在の最新コピーという主張には不足。修正:8本を追加同期するか、コピー基準時刻を明記。コマンド:`verify_local.py`、copies.H2_KIOXIA。全欠落:

- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_bgm_明るいA_1_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_bgm_明るいB_2_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_ハコブ版_BGM効果音入り_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_ハコブ版_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_ホワーンだけ_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_ホワーン大きめ_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_場面切り替えホワーン_確認用.mp4`
- `kioxia_r2r2r-data/videos/フィジカルAIの現在地/冒頭15秒_明るいB_2_音量戻し_確認用.mp4`

## H3. ✅ OK コードコピー

指定 .py/.md/.json/.csv/.sh と除外ルールで元768件・コピー768件、欠落0・余分0、サイズ/SHA-256不一致0。比較総サイズ120,165,207 bytes。git管理外ファイルも対象。コマンド:`verify_local.py`、copies.H3_scripts。

## H4. ❌ NG 秘密情報らしき文字列

code/work_filesの全3,403ファイルを `rg -a -l --hidden --no-ignore -i` でバイナリも含め全文検索。広い候補パターンで27パスがヒットし、長さ/形式を満たすキー候補・秘密鍵を追加確認。具体的な認証パスワード値が `code/r2r2r-scripts/calibration_reference.md:79` に残る。AWSアクセス識別子が `work_files/デジタルツイン学習R2R2R/Pixels to Motors _ デジタルツインが生み出す次世代ロボティクスUX_files/ロボティクスデザイン.html:470` の古い署名URLに残る(識別子自体は秘密鍵ではない)。sk-ant-/ghp_形式の実キー・PRIVATE KEYブロック0。JSの変数名、環境変数参照、バイナリ中の偶然の短いパターンは実秘密と判定していない。有効性/認証は試していない。値は本報告・検証結果へ出力していません。修正:外部配布版からパスワードと署名URLを除去し、原本保存版との区別を付ける。コマンド:`verify_local.py`・`verify_media_extra.py`・`verify_claims.py`、[extra_results.json](work/extra_results.json) と [claim_results.json](work/claim_results.json)(パスと種類のみ)。

## H5. ⚠️ 要注意 一時ファイル・ゴミ

`.名前.XXXXXX` / .tmp / .part / .swp の残留0。`work_files/デジタルツイン学習R2R2R/動画/AIエージェントの取り違え/__pycache__/narration.cpython-312.pyc` と `.../フィジカルAIの現在地/__pycache__/narration.cpython-312.pyc` の2派生ファイル、空の `content/record 2`・`content/manga 2`・`content/english 2` が3フォルダある。修正:原本コピーで残すなら用途を記載、配布版の不要物から除外。コマンド:`verify_local.py`、garbage/empty_content_dirs。

## I1. ⚠️ 要注意 移行メモのキー対応

実schemaはrecord UXChiPMZ×339、manga s0yH29ky×99、english qulWgwEq×95で一致。HOUwyFeoは全recordでseries8区分を参照。bPskK658は通常DAY番号だが、7件はDAY数字EN、1件は `DA13` という表記ゆれ。Qi0bIZEy.slugは大文字DAY33件と小文字等13件で、メモの「slugはday{NNN}」を固定規則にすると33件が外れる。修正:DAYの言語接尾辞と原本のDA13例外、thumbnail slugの大小文字を明記。コマンド:`verify_aux.py`、[aux_results.json](work/aux_results.json) のI1。例外全件:

- `raw/cms/record/category-strategy-motion-ux-robotics-ux-en.json` — bPskK658=DAY187EN
- `raw/cms/record/robotics-ux-designer-as-a-profession-en.json` — bPskK658=DAY194EN
- `raw/cms/record/three-ai-content-pipeline-en.json` — bPskK658=DAY195EN
- `raw/cms/record/motion-ux-three-phase-model-en.json` — bPskK658=DAY181EN
- `raw/cms/record/japan-robot-leader-physical-ai-gap-en.json` — bPskK658=DAY174EN
- `raw/cms/record/toward-dual-arm-coffee-en.json` — bPskK658=DAY201EN
- `raw/cms/record/no-such-thing-as-free-ai-en.json` — bPskK658=DAY198EN
- `raw/cms/record/day13.json` — bPskK658=DA13

## I2. ⚠️ 要注意 移行に不足する情報

`raw/studio/symbolViewMap.json` は空dict(0定義)、productにはsymbol UUID参照15件があるため、共通ヘッダー/フッターを再構築する設計実体が不足。固定MDには動的CMS一覧・実リンクの展開や検索/操作挙動も未復元。500ページにog:image/twitter:imageがあり、CMS原本headへ一部メタ情報は保存されているが、固定ページheadの単独目録・共通favicon/フォント等のオフライン資産・URLリダイレクト設定の完全なエクスポートは無い。採取HTML536ページにJSON-LDスクリプト(@graph形式)があるが、従来raw/cmsではJSON-LDを単独保存していない。今回は `work/live/*.html` に取得時点の証拠として残した。Studio管理画面の非公開リダイレクト設定はGETだけでは検証不能。修正:共通symbol実体、固定ページSEO/JSON-LD、公開パスのリダイレクト/404設計、使用フォント等の依存を別目録として保存。コマンド:`verify_aux.py`・`verify_media_extra.py`。

## Claude に渡す修正依頼

- 原本と既存コピーを残したまま、Markdown変換を修正してください。B3の10ページは、表セルの `|` をエスケープし、セル内改行・ヘッダー無し表を正しく保存してください。特にDAY200・DAY191・DAY294で文章/数値が表示から落ちています。B1差分7ページと全658表を再照合してください。
- コード内の連続改行を詰めないでください。元pre2,106ブロック中、68ページ163ブロックで計1,359のLFが消えています。全ブロックで1文字一致させ、段落内の既存Markdownコードフェンス3件は別扱いにしてください。
- 強調記号 `**` が生の文字として見える52ページと、見出し/リストの構造差50ページを修正してください。29ページの同じプレビューサンプルで表・コード・画像を確認してください。
- `DAYxxx_day13` の扱いを直してください。CMS原本は `DA13` のまま保管し、DAY13への正規化を明示して索引・CSVと合わせてください。
- D1のトップ用2048×2048画像を追加保存してください。固定ページ18出現の `{{cover}}` / `{{UeFRSlTz}}` は通常の画像リンクではなく、テンプレート注記か解決済み参照へ変えてください。
- custom埋め込み300のうち、286は図解HTML、14はYouTube URL化だったことを記載してください。移行でiframeの表示構造も必要なら14件のHTMLを別途保存してください。DAY111の画像URL置換5箇所は仕様として記録してください。
- descriptionが空の3件をYAML nullではなく `""` で出力してください。CSVのday/series/lang/文字数の意味と、固定16件を含まない範囲を説明してください。
- KIOXIAのコピー後に追加された可能性が高い8本を追加同期するか、10:39時点のコピーと明記してください。作業コピー側だけにある168ファイルは削除せず、由来と取得時点を記録してください。
- index07の動画262→271ファイル、r2r2r-content直下9→10ファイルを更新し、画像972ユニークURL/973ページ別ファイル/固定込み981ファイルを区別してください。
- 外部配布版からcalibration_reference.mdのパスワード値と、保存HTMLに含まれるAWS署名URLを除去してください。秘密値を返答や報告へ貼らないでください。
- 共通symbol定義15件の実体、固定ページのSEO/JSON-LD、favicon/フォント等の資産、リダイレクト設計を追加保存してください。top設計内のai-agentリンクは404なので確認・更新してください。
- 空のcontent/* 2フォルダと派生pyc2件は、不要物として除外するか保存理由を明示してください。修正後は独立検証スクリプトで再検証してください。

本報告は修正指示であり、アーカイブ本体に修正は加えていません。判定は採取・比較時点の公開データとコピー元の状態に基づきます。
2回目の依頼書(codex_reverification_request.md)
# 再検証依頼:Pixels to Motors サイトアーカイブ(修正版)

前回の報告 `codex_report_*.md` の指摘を受けて、Claude がアーカイブを作り直した。
前回と同じく「まだ直っていない・直したことで別の箇所が壊れた」という前提で、証拠を探してほしい。

守ること・報告の形式は `codex_verification_request.md` と同じ。報告は `_review/codex_report2_YYYYMMDD.md` に書く。
前回の採取キャッシュ(`_review/work/live/`)と検証スクリプト(`_review/work/*.py`)は再利用してよい。ただし Claude が追加した `tools/verify_md.py` を使って判定してはいけない(独立性のため)。

---

## Claude が直したと主張していること(それぞれ真偽を判定する)

| 前回の項目 | 主張 |
|---|---|
| B1・B3 | 表を作り直した。ヘッダー行があり結合セルのない表は GFM 表(セル内の `\|` エスケープ・改行は `<br>`)、ヘッダー無しなどは HTML 表のまま。DAY200・191・294・179・178・204・073・018・038・328 を含む全658表でセルが一致する |
| B2 | コードブロックの中身を加工しなくなった。元 pre 2,106 ブロックすべてが1文字単位で一致する(終端LFの扱いは前回と同じ除外ルール) |
| B4・B6 | 本文テキスト中の Markdown 記号(行頭の `#`・`-`・`1.`・`>`、`\|`・`*`・`[` など)をエスケープした。段落内に書かれた Markdown が見出し・リスト・表・コードに化けない。太字は `**` が効かない箇所だけ `<strong>` にした。生の `**` が見えるページは0 |
| A3 | `DA13` を DAY13 として扱い、フォルダは `DAY013_day13`。md の `day` は原文のまま `DA13`、新設の `day_number` に 13 |
| C1 | description が無い・空の3件(DAY80・english ep47・ep54)は `description: ""` |
| D1 | トップの動画ポスター画像 `s-2048x2048_5af0bc9f-….webp` を `content/static/top/images/` に追加 |
| D3 | 固定ページの `{{cover}}` などは画像リンクではなく「[CMS画像: `{{cover}}`…]」という注記に変更 |
| E1・E2 | custom 埋め込み300件と YouTube ブロック3件の計303件を全件 `embeds/` に HTML 保存(YouTube は `_youtube.html`)。画像URLのローカル置換は DAY111 の1ファイル5箇所のみで、`data/embeds.csv` の `local_image_rewrites` 列に記録 |
| G1 | `data/stats.json` で、元URL数(972)・記事/マンガのファイル数(973)・固定込みのファイル数(982)を区別。index07 を再生成 |
| H1 | `work_files/_MANIFEST.md` に同期時刻・除外・コピーにだけあるファイル(元フォルダで後から移動・改名されたもの)の一覧を記録。削除はしていない。`__pycache__` は除外して削除 |
| H2 | KIOXIA の `videos/` に、その後増えた13ファイル(冒頭15秒×8、ハコブ版・ハコブ版2 の mp4・srt・png)を追加し、14:34 JST 時点で 62ファイル一致 |
| H4 | `code/r2r2r-scripts/calibration_reference.md` 79行目のパスワード値と、`ロボティクスデザイン.html` の AWS 署名パラメータを伏せ字にした(README に明記)。この2ファイルは元とハッシュが一致しないのが正しい |
| H5 | 空の `content/* 2` フォルダを削除 |
| I1 | 移行メモに DAY の EN 接尾辞・DA13・サムネイル slug の大文字小文字の不統一を明記 |
| I2 | `content/static/_common/`(描画されたヘッダーのHTML・フッターのリンク・head の meta/link・ファビコン・ロゴ・OGP画像)、`data/redirects.csv`(28件)、`data/fonts.json`、`raw/html/`(前回 codex が取得した公開ページHTML 546件をコピー)を追加 |

## 特に重点的に見てほしいこと

1. **B 系の全件再照合**(533ページ)。エスケープを入れたことで、逆に本文に `\` が見えてしまう箇所、リンクや URL が壊れた箇所、コードスパン内に余計な `\` が入った箇所がないか。
2. 表のセル内に `<br>` を入れたことで、セルの文字列が元と変わっていないか(改行の位置を含めて)。
3. HTML 表で保存した表が、一般的な Markdown ビューア(GitHub・VS Code・Obsidian 相当)で表示できるか。
4. エスケープやフォルダ名変更で、`index/`・`data/*.csv`・README のリンクや件数がずれていないか。
5. 伏せ字の2ファイル以外に、秘密情報らしき文字列が残っていないか(値は書かない)。
6. 前回 OK だった項目(A1・A2・B5・C2・C3・D2・D4・E3・F1・F2・G2〜G4・H3)が、作り直しで壊れていないか。

## 前回の報告にあったが、アーカイブ側では直していないもの(判定だけしてほしい)

- A4: トップページのデザインに `/pixelstomotors/ai-agent`(404)へのリンクが残っている。これは公開サイト側の問題なので、アーカイブは取得したままにしている。
2回目の報告(codex_report2_20261012.md)
# Pixels to Motors サイトアーカイブ — 再検証報告(2026-10-12)

総合判定:⚠️ 公開記事の本文保存は主要修正を確認できたが、移行用一式と作業コピーの完全整合には追加整備が必要。
本文533ページ・コード2,106ブロック・表658個は一致。前回の文章/数値欠落・コード空行消失は解消し、リンク破損もない。
残件は、作業コピー/目録の時点差と未申告の内容差、共通ヘッダー資産の不足、索引の件数など。詳細と修正依頼を末尾に記載。

対象:`/Users/shimazueiichi/Library/Mobile Documents/com~apple~CloudDocs/デスクトップ/ADAPT DESIGN/じぶんの/PixelstoMotors/site_archive`。依頼書 `codex_reverification_request.md` と前回の禁止事項に従い、アーカイブ本体・元フォルダ・KIOXIA・コードへは書き込み/削除/移動をしていない。git操作なし。サイト・資産の取得はGETのみ、全ページ採取と50点照合は最大4ワーカー。Claude製 `tools/verify_md.py` と変換スクリプトは実行していない。

## 検証方法と証拠

今回は前回キャッシュだけに依存せず、サイトマップから546ページを新規GETした。全件HTTP 200、取得エラー0。採取UTC時刻は `work/recheck2/live_results.json`、現在の採取HTMLは `work/recheck2/live/` に保存。原HTMLの前回キャッシュは `raw/html/` のコピー検証に使い、前回の証拠は上書きしていない。

独立パーサはBeautifulSoup、YAMLはPyYAML。MarkdownはMarkdown-it-py 3.0.0(CommonMark+table拡張・HTML有効)とMarked 17.0.5(GFM)の2つを使い、表658個とコード2,106個を全件再照合。参考互換性検査としてPython-Markdownも使用。GitHub・VS Code・Obsidianそのものを起動したという意味ではなく、GFM/CommonMark相当での検証。描画の確認はアプリ内ブラウザで39ページの代表箇所を目視し、スクリーンショットを保存した。全39ページの全長全ピクセルを目視した意味ではない。

除外/正規化:B1はYAML・生成された見出し/概要等のヘッダー、自動目次、埋め込みや動画の置換案内を除外し、HTMLタグと空白を除いた文字列を比較。前回と違い、原文の `#`・`*`・`|`・バックスラッシュを一括除去していない。B2は内部文字と改行を完全一致で比較し、元preに末尾LFがない場合だけ、フェンスを閉じる構文上のLF1つを除外。B3は行/セル配列に加え、brとp/div等の明示改行境界を保ったセル内行配列も比較(HTMLの装飾用インデントは改行としない)。ファイル名はNFCへ正規化。Nuxt Date型はISO文字列へ復元。H2の `._*` はmacOS AppleDouble補助メタデータとして利用ファイルとは別集計。

実行コマンド(保存した同一独立スクリプトで再現可能):
```sh
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/fetch_live.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/verify_local.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/verify_semantic.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/verify_aux.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/verify_final.py
/tmp/codex-archive-verify-venv/bin/python /tmp/codex-recheck2/preview_server.py
```

スクリプト:[fetch_live.py](work/recheck2/fetch_live.py), [verify_local.py](work/recheck2/verify_local.py), [verify_semantic.py](work/recheck2/verify_semantic.py), [verify_aux.py](work/recheck2/verify_aux.py), [verify_final.py](work/recheck2/verify_final.py), [render_marked.mjs](work/recheck2/render_marked.mjs), [preview_server.py](work/recheck2/preview_server.py)。実行環境:[requirements.txt](work/recheck2/requirements.txt)。主結果:[semantic_results.json](work/recheck2/semantic_results.json)・[local_results.json](work/recheck2/local_results.json)・[aux_results.json](work/recheck2/aux_results.json)・[final_results.json](work/recheck2/final_results.json)。初期local結果のCSV chars差533件は先頭/末尾LFの定義差で、auxの独立再計算で533/533一致を確認。初期H2差18件もAppleDoubleのみで、不足動画として数えない。

検証時点は2026-10-12の15時台JST。`_MANIFEST.md` は14:36作成、元ファイルには14:58以降の追加、コピー側には14:42〜15:05の編集がある。本文MDは検証後にもSHA-256を確認し、全533件で変化0。作業コピーの差は、記録された同期時点の主張と「現在の元との一致」を分けて報告する。

## Claudeの修正主張に対する判定

| 主張 | 判定 | 独立検証の結果 |
|---|---|---|
| B1/B3 表658件 | ✅ | 文字・行/列・明示改行が658/658一致。2つのGFM系レンダラーで確認。 |
| B2 pre2,106件 | ✅ | 2,106/2,106完全一致。追加コードブロックも0。 |
| B4/B6 記法の誤解釈・生の**は0 | ⚠️ | 変換が新たに出した記号0、見出し全一致。リスト群の併合33ページ、空li省略2件。原文由来の**は2ページに6出現残る。 |
| A3 DAY13正規化 | ✅ | DAY013_day13、day=DA13、day_number=13。全339件も整合。 |
| C1 description空文字 | ✅ | 指定3件も空文字。3,731項目比較で差0。 |
| D1 ポスター画像追加 | ✅ | ファイル存在・画像verify成功。CMS/固定設計資産の不足0。 |
| D3 プレースホルダー注記 | ✅ | 前回の18画像参照は注記に変更。全相対参照不足0。 |
| E1/E2 全303HTML・置換記録 | ✅ | 303/303保存、302完全一致+DAY111の許容置換5箇所。CSVも一致。 |
| G1 stats区別・index07再生成 | ⚠️ | 972/973/982+共通4は整合。index07の動画290→現在300、直下9→実10が不一致。 |
| H1 目録・__pycache__除外 | ⚠️ | 178件の旧目録は存在。ただし現在コピーのみ187件、元18件未収録、伏字以外8件内容差、pyc1件が再び存在。 |
| H2 KIOXIA62件 | ✅ | 利用ファイル62/62サイズ・SHA-256一致。追加13件も収録。AppleDouble18件は別枠。 |
| H4 伏せ字2ファイル | ✅ | 宣言された2件の差を確認。その他の実キー候補0。 |
| H5 空content/* 2削除 | ✅ | 3フォルダとも不存在。 |
| I1 DAY例外等の記載 | ✅ | EN7、DA13 1、thumbnail大文字33/小文字等13を明記、実データと一致。 |
| I2 共通・redirect/font/rawHTML追加 | ⚠️ | 原HTML546/546元キャッシュ一致、redirect28とfonts21は新規採取の公開設定とも一致。ヘッダー画像1点と資産目録のパス表記が残件。 |

## A1. ✅ OK 網羅性

`fetch_live.py`でサイトマップ対象546 URLを列挙。record339+manga99+english95+公開固定13の546 MDと1対1、欠落0・重複0。別資料はテンプレート3と `_common/page.md` 1件で、全content MDは550件。証拠:[sitemap_urls.json](work/recheck2/sitemap_urls.json)、semantic.A1、local.counts。

## A2. ✅ OK URLとslug

CMS533件のURL/slug不一致0。公開固定13件もサイトマップへ一致。テンプレート3は`:slug`を持つ資料、_commonは公開URL無し。`verify_semantic.py`:A2=[]。

## A3. ✅ OK DAYとフォルダ

全record339件のCMS数字・md.day_number・フォルダprefixを照合し、差0。`content/record/DAY013_day13/article.md` はday=`DA13`(原文)・day_number=13・folder=`DAY013_day13`。英語7件の原DAY接尾辞もdayへ保持され、数字でフォルダを正規化。`verify_semantic.py`:A3=[]。

## A4. ⚠️ 要注意 公開サイトの古いリンク

新規GETで `https://adaptdesign.jp/pixelstomotors/ai-agent` はHTTP 404。`raw/studio/pages/pixelstomotors.json` の同パス参照も残存。今回の依頼が指定した未修正事項と一致し、取得済原本を変更しない扱いは妥当。公開サイト側でリンク更新を検討し、アーカイブ内では既知404と注記すればよい。前回、サイトマップ外の有効ページの漏れは0。今回も公開本文533件の変更が無く、対象546 URLに増減無し。リンクに現れない孤立ページの不存在までは証明していない。証拠:aux.A4、[aux_results.json](work/recheck2/aux_results.json)。

## B1. ✅ OK 本文文字の全件照合

新規採取のCMS本文と全533 MDを照合し、差分ページ0。前回B1の7ページを含め全部一致。記号を一括削除せず比較しているので、エスケープによる余分なバックスラッシュも文字差へ現れる。原文の通常リンク、コメント/埋め込み例示文字列も本文として残る。`verify_semantic.py`:B1=[]、unwanted_backslash=[]。

## B2. ✅ OK コードの1文字照合

元pre2,106・MD2,106、全2,106一致。前回の68ページ163ブロックの空行消失は0となり、追加3コードブロックの誤解釈も解消。Markedでも全2,106一致。`verify_semantic.py` と `verify_final.py`:B2=[]、marked.code_mismatches=[]。コードスパンは4,695→4,695。余分なバックスラッシュ等の非空白文字差0。ただし4ページ6スパンで末尾空白/NBSPを省略(後述)。

- `content/record/DAY045_day45/article.md` — 末尾空白/NBSPの差 1スパン(内容文字は一致)。
- `content/record/DAY026_day26/article.md` — 末尾空白/NBSPの差 2スパン(内容文字は一致)。
- `content/record/DAY252_which-file-the-live-pick-reads/article.md` — 末尾空白/NBSPの差 1スパン(内容文字は一致)。
- `content/record/DAY039_day39/article.md` — 末尾空白/NBSPの差 2スパン(内容文字は一致)。

## B3. ✅ OK 表の文字と改行

元658表・Markdown658表。行数/セル数/セル文字、brやp等の明示改行位置を保存したセル内行配列の差はすべて0。DAY200・191・294・179・178・204・073・018・038・328の前回指摘も解消。GFM形式645表とHTML形式13表。Markdown-it・Markedの双方で全658一致。HTML13表はPython-Markdownでも保持。証拠:semantic.B3=[]・B3_linebreaks=[]、final.markedの両配列も[]。一部の非GFM互換性差はB6へ分離。

## B4. ⚠️ 要注意 見出し・リストと記号

見出しh2〜h6は4,086→4,086、全件文言・レベル一致。liは3,040→3,038。33ページで隣接ul/olのまとまり方が変わる(通常Markdownが連続するリストを併合)、そのうちDAY076とDAY079で空のliが1つずつ省略。文字を持つ項目の欠落0。再現:`verify_semantic.py`のB4、aux.list_differences/empty_li。修正案:構造まで忠実にする必要がある箇所はHTMLリストを保持するか、リスト間に明示境界を置く。空liを省略するなら仕様へ明記。全差分ページ:

- `content/record/DAY012_day12/article.md` — リスト群 8→5、li 15→15。
- `content/record/DAY026_day26/article.md` — リスト群 3→2、li 6→6。
- `content/record/DAY031_day31/article.md` — リスト群 16→14、li 43→43。
- `content/record/DAY019_day19/article.md` — リスト群 15→14、li 51→51。
- `content/record/DAY066_day66/article.md` — リスト群 5→4、li 13→13。
- `content/record/DAY060_day60/article.md` — リスト群 29→20、li 48→48。
- `content/record/DAY043_day43/article.md` — リスト群 23→22、li 37→37。
- `content/record/DAY020_day20/article.md` — リスト群 9→8、li 23→23。
- `content/record/DAY009_day9/article.md` — リスト群 5→3、li 10→10。
- `content/record/DAY044_day44/article.md` — リスト群 8→5、li 19→19。
- `content/record/DAY027_day27/article.md` — リスト群 6→5、li 17→17。
- `content/record/DAY070_day70/article.md` — リスト群 35→18、li 60→60。
- `content/record/DAY053_day53/article.md` — リスト群 5→3、li 7→7。
- `content/record/DAY049_day49/article.md` — リスト群 8→6、li 17→17。
- `content/record/DAY055_day55/article.md` — リスト群 8→5、li 20→20。
- `content/record/DAY076_day76/article.md` — リスト群 13→9、li 23→22、空li省略あり。
- `content/record/DAY038_day38/article.md` — リスト群 16→11、li 32→32。
- `content/record/DAY064_day64/article.md` — リスト群 7→5、li 16→16。
- `content/record/DAY078_day78/article.md` — リスト群 15→14、li 35→35。
- `content/record/DAY004_day4/article.md` — リスト群 11→6、li 24→24。
- `content/record/DAY029_day29/article.md` — リスト群 13→9、li 31→31。
- `content/record/DAY192_setting-up-the-side-camera/article.md` — リスト群 11→10、li 37→37。
- `content/record/DAY075_day75/article.md` — リスト群 6→4、li 10→10。
- `content/record/DAY039_day39/article.md` — リスト群 35→21、li 79→79。
- `content/record/DAY025_day25/article.md` — リスト群 15→14、li 36→36。
- `content/record/DAY006_day6/article.md` — リスト群 3→2、li 7→7。
- `content/record/DAY032_day32/article.md` — リスト群 6→4、li 12→12。
- `content/record/DAY002_day2/article.md` — リスト群 6→5、li 12→12。
- `content/record/DAY079_day79/article.md` — リスト群 31→27、li 69→68、空li省略あり。
- `content/record/DAY028_day28/article.md` — リスト群 11→10、li 24→24。
- `content/record/DAY168_day168/article.md` — リスト群 12→9、li 27→27。
- `content/record/DAY068_day68/article.md` — リスト群 14→9、li 36→36。
- `content/record/DAY023_day23/article.md` — リスト群 12→11、li 27→27。

「生の**が見えるページ0」は文字どおりには成立しない。`content/record/DAY079_day79/article.md` に2出現、`content/record/DAY080_day80/article.md` に4出現あるが、どちらもCMS原文の段落内に同じ記号がある。今回の変換による新規露出は0。原文に忠実に残した結果なので、0を達成するために原文を勝手に変えず、主張を「変換由来の露出0/原文記号を保持した2ページ」に修正する。

## B5. ✅ OK 本文リンク

元a[href]176出現をMDリンクのhrefと多重集合比較、不足0。エスケープでリンクラベル/URLが壊れていない。`verify_semantic.py`:source_anchors=176、B5=[]。

## B6. ⚠️ 要注意 39ページの表示・ビューア互換性

8シリーズ・年代・最古/最新/最長/表最多/コード最多/動画、前回指摘10ページ、DAY13/76/79/80を含む39ページを表示。各代表箇所でコードの枠、表の表示、画像、リンクを確認。画像切れ0、前回の表の欠落/列ずれと変換由来の強調記号露出は解消。HTML表(DAY018/038)も表として表示。[visual_results.json](work/recheck2/visual_results.json)・[ui_checks.json](work/recheck2/ui_checks.json)、全39スクリーンショットは `work/recheck2/previews/ui-01.png`〜`ui-39.png`。GFM系2レンダラーは全表・全コード一致。一方、Python-Markdownでは3ページに互換性差があるので、閲覧環境をGFM/HTML対応と明記するのがよい。GitHub/VS Code/Obsidianの実アプリごとの全機能テストは行っていない。

- `content/record/DAY016_day16/article.md` — Python-Markdownで表セルの解釈差。DAY294はコードスパンの `\|`、DAY206は `\<` がそのまま露出、DAY016は空セルの数/行構成が異なる。GFM2系統では一致。
- `content/record/DAY294_handover-lost-the-incremental-loop/article.md` — Python-Markdownで表セルの解釈差。DAY294はコードスパンの `\|`、DAY206は `\<` がそのまま露出、DAY016は空セルの数/行構成が異なる。GFM2系統では一致。
- `content/record/DAY206_pixels-as-perception-data/article.md` — Python-Markdownで表セルの解釈差。DAY294はコードスパンの `\|`、DAY206は `\<` がそのまま露出、DAY016は空セルの数/行構成が異なる。GFM2系統では一致。

## C1. ✅ OK メタデータ

533ページ×指定7項目=3,731比較で差0。DAY080、english ep47/ep54は実際に `description: ""`、YAML nullではない。公開/更新日時の差も0。`verify_semantic.py`:C1=[]。

## C2. ✅ OK YAML

全content MD550件(CMS533+固定/テンプレート16+common1)をPyYAMLで読み、構文エラー0。`verify_local.py`:yaml_errors=[]。

## C3. ✅ OK pages.csvと各CSVのパス

pages.csv533行を全MDへ対応、type/day/series/lang/title/slug/url/description/published/updated、画像数、embeds数、folderが一致。charsは本文変換結果の先頭区切り改行を除き、終端LF1つを含む定義で533/533一致(初期処理の終端LF除外による1文字差を補正)。マンガday=label/series=character、langはJP/ENの種類対応。さらに全data CSVの実ファイル参照3,829出現を検査、不存在0。`verify_local.py`+`verify_aux.py`:CSV chars以外の初期差0、aux.csv_chars.issues=[]、csv_paths=[]。

## D1. ✅ OK CMS/固定設計の画像と動画

CMS・デコードembed・固定studio_designからStudio資産URLを再収集して、ページのimages/を照合。不足0。前回の `content/static/top/images/s-2048x2048_5af0bc9f-8d23-4bdb-85e4-ada51bfd7bbd.webp` も実在。新設共通ヘッダーの未収録画像はCMS/固定設計の外なのでI2に別記。`verify_semantic.py`:D1=[]。

## D2. ✅ OK 画像/動画・50点SHA-256

全ラスタ画像985件をPillow verify、破損0(images/982+commonのPNG3)。全mp4 6件をPyAVで全動画フレーム28,208枚デコード、エラー0。SVGロゴは別の共通資産として元データのSHAを照合。独立抽出URLからseed=20261012で50点を無作為選択して再GETし、50/50 SHA-256一致。共通のロゴ/ファビコン/OGP4資産も追加で4/4元URLのSHA一致。証拠:local.image_verify/video_verify、[media_hash_sample.json](work/recheck2/media_hash_sample.json)、aux.common.asset_hashes。全ラスタ画像の元URLハッシュを取得したという意味ではない。

## D3. ✅ OK 相対画像/動画リンク

550 content MDの相対参照3,008出現を解決、不存在0。`{{cover}}`等の前回18件は普通の画像リンクでなくCMS画像注記となり、破損リンクから解消。index/READMEの2,534相対参照も不存在0。`verify_local.py`:broken_links=[]。HTMLスナップショットに残る外部URLはI2に別記。

## D4. ✅ OK YouTube

17埋め込み出現のIDが全件MDリンクとして存在、不足0。カスタムiframe14+YouTube型3ともHTML保存も確認。`verify_semantic.py`:youtube_occurrences=17、D4=[]。再生可否までは検証していない。

## E1. ✅ OK 埋め込み件数

元HTML custom300+youtube型3=303ブロックと、embeds/303 HTMLが全ページで1対1。図解286、YouTube17で区分も一致。`verify_semantic.py`:source_embeds=303、E1=[]。

## E2. ✅ OK 埋め込みHTML/置換記録

UIDで全303件を対応。302件はURLデコード元と完全一致、DAY111の1件だけ画像URL5箇所を `../images/<同名>` に置換し、それ以外の差0。303行のembeds.csvについてファイル参照とlocal_image_rewrites列を独立照合、差0。`verify_semantic.py`:embed_exact_or_permitted=303、embed_csv_errors=[]。唯一の置換:`content/record/DAY111_day111/embeds/01_ZXumKnYG.html`。元/先URL5組はsemantic.E2に列挙。

## E3. ✅ OK 動くサムネイル

CMS Qi0bIZEy.titleを持つ46記事とthumbnail.html46件を照合、全件文字列一致、余分/不足0。`verify_semantic.py`:source_thumbnail=46、E3=[]。

## F1. ✅ OK raw本文と現在のサイト

raw/cmsのページ原本533件を新規GET本文と文字列/SHA-256比較、533/533一致。更新時刻差0、更新による本文差0。raw/cms/urls.jsonは別のURL目録。`verify_semantic.py`:F1=[]、date_updated_changes=[]、page_sha256にMD/CMS/rawのハッシュあり。

## F2. ✅ OK 固定設計の文字列

固定/テンプレート16設計の文字列167件を対応MDで検査、装飾だけの `*` 3件を除いた164件で有意味な文字列の抜け0。commonは既存pageViewMapからではないので別項目。`verify_semantic.py`:static_literals=167、F2=[]。

## G1. ⚠️ 要注意 件数・索引の再生成

339/99/95、series8区分、図解286/YouTube17/総embed303、記事mp4 4/YouTube17/計21、リンク176、元画像URL972/ページ別画像973/固定images含む982は実データと一致。READMEはさらにcommon4資産を別記しており、全ラスタ985+SVG1という数とも整合。スクリプト180本は再帰的な全py数(直下96+配下84)で一致。index07の次の2行はなお当前の実数と不一致。再現:`verify_aux.py`のG.folder_counts。修正:現在の件数と集計範囲を更新し、動画の変更時刻を付記。

- `index/07_作業ファイルとコード.md` → `work_files/デジタルツイン学習R2R2R/動画`:記載 290、実ファイル数は直下21/配下合計300(.DS_Store除外)。
- `index/07_作業ファイルとコード.md` → `code/r2r2r-content`:記載 9、実ファイル数は直下10/配下合計878(.DS_Store除外)。

## G2. ✅ OK README/索引のリンク

README1+index10 MDの相対パス2,534出現を日本語URLデコード後に解決し、リンク切れ0。DAYxxx旧名による参照切れも0。全data CSVの参照3,829も0(C3)。`verify_local.py`。外部サイトの稼働・文書内アンカーは本判定に含めない。

## G3. ✅ OK シリーズ集計

8シリーズの記載数・リンク数・YAML集計が全一致、合計339。R2R2R185/考察63/HRI54/画像認識11/デザイン9/研究室8/Consideration7/UV-C2。`verify_aux.py`:G.series。

## G4. ✅ OK 探し方

READMEのgrep相当を実行し、LIBEROは5ファイル、π0.5は114行(headなら先頭10行)、R2R2R絞り込み185ファイル、すべてexit0。DAY327のopen用グロブは既存1ファイルへ解決。既定アプリ起動やSpotlightのインデックスまでは検査していない。`verify_aux.py`:G.commands/DAY327_glob。

## H1. ❌ NG 作業コピーと目録の現在の整合

除外指定+__pycache__を適用し、サイズ・SHA-256で比較。サムネイル3/3、ハコブくん956/956は全一致。デジタルツインは元508/コピー677、共通490のうち481一致・9不一致。9件中1件は宣言済みのAWS伏せ字、残る8件は未申告の内容差。元側からの欠落18件は14:58以降に作られた新しい台本/事実確認文書で、14:36同期後の追加。コピーのみ187件に対し目録178件、未記載9件。追加同期の主張が14:36時点で誤りだったとは断定しないが、「現時点で伏せ字1件以外は元と同じ/目録が現状を表す」条件は満たさない。コピー側8件のmtimeは14:42〜15:05で、元の同名ファイルはそれより古い。修正:差を上書きで消す前に由来を確認し、コピー側で別作業したものなら派生ファイルとして記録する。欠落18件を追加同期するか基準時刻を固定し、目録9件を追記。コマンド:`verify_local.py`・`verify_aux.py`、[local_results.json](work/recheck2/local_results.json) copiesとmanifest、[aux_results.json](work/recheck2/aux_results.json) copy_drift。

未申告内容差の全8件:

- `work_files/デジタルツイン学習R2R2R/動画/AIエージェントの取り違え/narration.py`
- `work_files/デジタルツイン学習R2R2R/動画/AIエージェントの取り違え/scenes.py`
- `work_files/デジタルツイン学習R2R2R/動画/_制作ベース/assemble.py`
- `work_files/デジタルツイン学習R2R2R/動画/_制作ベース/tts_eleven.py`
- `work_files/デジタルツイン学習R2R2R/動画/_制作ベース/video_rules.md`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/narration.py`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/scenes.py`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/ハコブ/設定.json`

元にあるがコピーに無い18件(すべて同期後の追加):
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/01_自動運転の暴走.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/02_ロボットが怖い.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/03_ロボットの乗っ取り.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/04_3Dの世界を作るAI.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/05_紙1枚でAIをだます.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/06_人型に足は要るのか.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/07_卵を割るロボット.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/08_家事ロボット56%.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/09_iPhoneで練習場.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/10_協働ロボットはなぜ遅い.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/11_黙って失敗する.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/12_事故の責任.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/13_2万件は2万台ではない.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/14_導入はいくら.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/15_買い替えたら動きは.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/_事実確認/factcheck_01-05.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/_事実確認/factcheck_06-10.md`
- `work_files/デジタルツイン学習R2R2R/動画/台本_15本_20261012/_事実確認/factcheck_11-15.md`

目録への追記が必要なコピーのみ9件:
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し.txt`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_01.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_02.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_03.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_04.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_05.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_06.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_07.mp3`
- `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/voice_eleven/試し_エイイチ/試し_08.mp3`

## H2. ✅ OK KIOXIA

利用ファイルをNFCへ正規化。README/videos/lab対象62ファイルとコピー62件が全サイズ/SHA-256一致、不一致0・実データ不足0、比較167,097,976 bytes。前回49件から追加された13件も存在。元側のほかの18件はすべて`._*` AppleDouble補助ファイルで、動画/字幕/PNGとは別物。初期ローカル結果80→62の18不足はこれで説明できる。`verify_local.py`+`verify_aux.py`:copies.H2_KIOXIA matched=62、copy_drift.H2_KIOXIA.missing_user_files=[]。

## H3. ✅ OK コードコピー

指定py/md/json/csv/shの元768/コピー768、欠落0・余分0。767件はサイズ/SHA-256一致。残るcalibration_reference.mdは宣言済み伏せ字で、79行目だけが変わり、他の行は一致。これは期待される1件差として合格。`verify_local.py`+`verify_aux.py`:copies.H3_scripts、redactions.password.changed_lines=[79]。

## H4. ✅ OK 伏せ字と残存秘密候補

最後の全文検査はcode/work_filesの3,433ファイルを `rg -a -l --hidden --no-ignore -i` で走査し、26候補パスを追加確認。sk-ant-/sk-proj-/ghp_/github_pat_/AKIAの長さを満たす実キー候補、PRIVATE KEYブロックは0。passwordの具体値はcalibration_reference.md79行で伏せ字。保存HTMLは470行目だけが変化し、AWS署名パラメータ293文字の範囲が11文字へ置換され、それ以外の前後文字列は一致。AWS識別子とX-Amz-Signatureも残っていない。JSの変数名や環境変数参照などの一致は秘密値とは扱わない。候補の有効性や認証は試していない。値は報告・スキャン結果に出力していない。証拠:[final_results.json](work/recheck2/final_results.json) final_secret_scan、aux.redactions、[redaction_detail.json](work/recheck2/redaction_detail.json)。

## H5. ⚠️ 要注意 ゴミ/空フォルダ

空のcontent/record 2・manga 2・english 2は不存在、コピー途中ファイル(.名前.XXXXXX/.tmp/.part/.swp)は0。一方 `work_files/デジタルツイン学習R2R2R/動画/フィジカルAIの現在地/__pycache__/narration.cpython-312.pyc` が1件再び存在する。「__pycache__は除外して削除済み」という恒常状態にはならない。修正:配布用成果物を作る最終工程で除外し、作業実行先と保存コピーの関係を明記。これを実行するために本検証で削除はしていない。`verify_local.py`:garbage1、empty_content_dirs=[]。

## I1. ✅ OK 移行メモ

schemaはUXChiPMZ339/s0yH29ky99/qulWgwEq95で一致。DAY数字331、DAY数字EN7、DA13 1の全339件を確認。thumbnail slug大文字DAY33/小文字等13の46件も記載どおり。series8分類339件も一致。index09にはこれらの例外、day_number、空description、300customと3YouTube型を明記。`verify_aux.py`:I1。

## I2. ⚠️ 要注意 共通パーツと移行データ

追加のraw/html546件は前回の独立採取HTML546件とファイル名によらずSHA-256多重集合で546/546完全一致。採取時刻は12:19:35〜12:21:17 JSTで、記載どおり(今回の新規採取とは別の時点)。redirects.csv28行・fonts.json21件はraw/studio/productだけでなく、今回GETしたトップのNuxt公開product設定とも一致。共通PNG3+SVG1は実在し、4/4元URLハッシュ一致。追加自体は確認できた。ただし次が残る。再現:`verify_aux.py`・`verify_final.py`。

- `content/static/_common/header.html` のマンガ画像 `s-500x700_f2c5ae27-2ebe-4d15-8da4-05853d4973ef.webp` はアーカイブ内に存在しない。元URLは追加GETでHTTP 200、33,088 bytes。保存して対応表へ追加する。
- 同header.htmlのimg2本は外部URLのまま。ロゴ自体はローカルにあるが、単体HTMLをオフライン表示する参照にはなっていない。移行用にローカルURL置換の対応を明記する。
- `content/static/_common/assets.json` の保存先4行が `common/assets/...` で、実ディレクトリは `_common/assets/...`。content/staticを基準とする実パス解決では4/4不存在。未来の公開パスを表すならその仕様を明記し、実保存パス列も付ける。
- 新規GETのトップHTMLはclient側描画前でheader要素が無いため、整理済header.htmlが現在の描画DOMと完全同一かまでは確認できない。Studioのsymbol定義は依然0で、共通パーツは再構築の見本として扱う。
- head_tags.htmlはある1ページのhead見本で、各ページのSEO/JSON-LDはdated raw/html側にある。フォント21件は登録情報で、フォント本体ファイルは未収録。redirect28件は設定の一致を確認したもので、28全URLの実HTTP転送挙動を試したわけではない。

## Claudeに渡す追加修正依頼

- 本文533件、コード2,106、表658の今回の一致は維持してください。現在のGFM表とHTML表を不必要に作り直さず、ここを修正する場合は同じ2レンダラーで再照合してください。
- work_filesの未申告内容差8件を確認し、コピー側で別作業・修正したものなら原本との差分/由来/編集時刻を目録へ記載してください。上書き同期でコピー側の仕事を消さないでください。
- 14:58以降に元へ追加された18台本/事実確認文書を同期するか、14:36時点のスナップショットとして範囲を固定してください。目録178件と現在コピーのみ187件の差9件を追記してください。
- index07の動画フォルダ290→現在300、r2r2r-content直下9→10(.gitignore込み)の集計を更新するか、隠しファイル等の除外単位を明示してください。更新中の作業コピーは集計時刻も記載してください。
- 共通ヘッダーの500×700マンガ画像を保存し、header.htmlの外部画像URLとの対応を追記してください。assets.jsonのcommon/_common表記は、実保存パスと将来の公開パスを区別して直してください。
- リストの隣接グループ併合33ページと空li省略2件は仕様として明記し、構造まで同一が必要ならHTMLで保持してください。インラインコード4ページ6スパンの末尾空白/NBSP省略も必要なら保持してください。
- 「生の**は0」の主張を「新たな変換由来の露出は0、原文の記号を保持したDAY79/80は2ページ」に修正してください。0にするためにCMS原文を勝手に改変しないでください。
- 閲覧条件をGFM+HTML対応と明記してください。Python-MarkdownではDAY016/294/206に解釈差があり、どのビューアでも同じという保証はしないでください。
- work_filesに再生成されたpyc1件は、最終的な配布/保存コピーを作る工程で除外してください。動く作業場所と固定したアーカイブの区別を明示してください。
- 公開サイトのai-agent 404は既知事項として残し、取得原本は変更せず、サイト側のリンク修正を別途検討してください。伏せ字2ファイル以外に認証情報を追記しないでください。

本報告は再検証結果であり、これらの修正自体は実施していない。記録した比較時点から別作業で変化したファイルについては、最新状態まで保証しない。