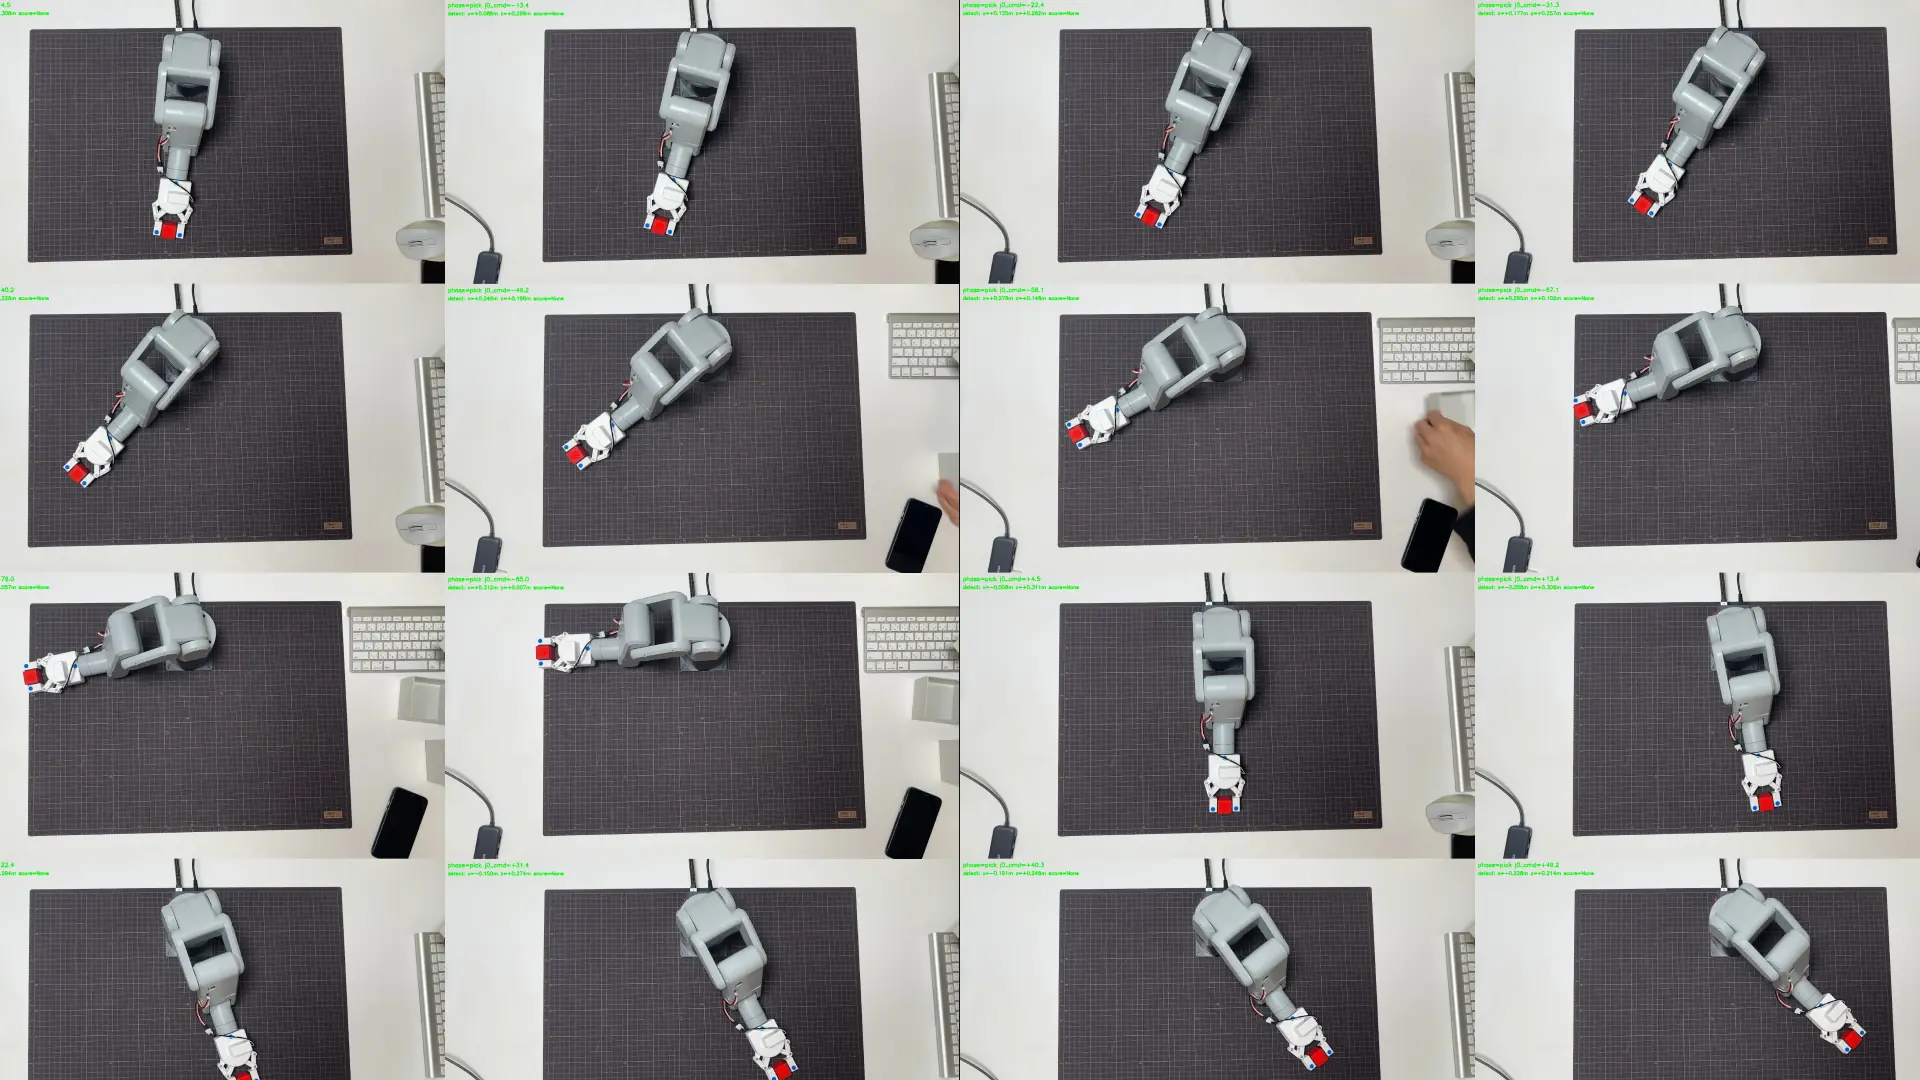
mechArm 270 Pi 動的追従シリーズ Log#30 | 手で教えた軌道を実機で忠実再生し、上カメラで取った対象物位置を紐づける。位置入りサンプルの最初の一本まで
前回、手でアームを動かして教える経路(ドラッグティーチング)を実機で成立させ、その軌道に工程・グリッパー・位置の意味を与えるv2スクリプトを設計・実装した。teach(記録)に工程ラベルとグリッパー印、対象物位置の枠を持たせ、play-A(意味づき忠実再生)まで実装したが、実機検証だけが残っていた。
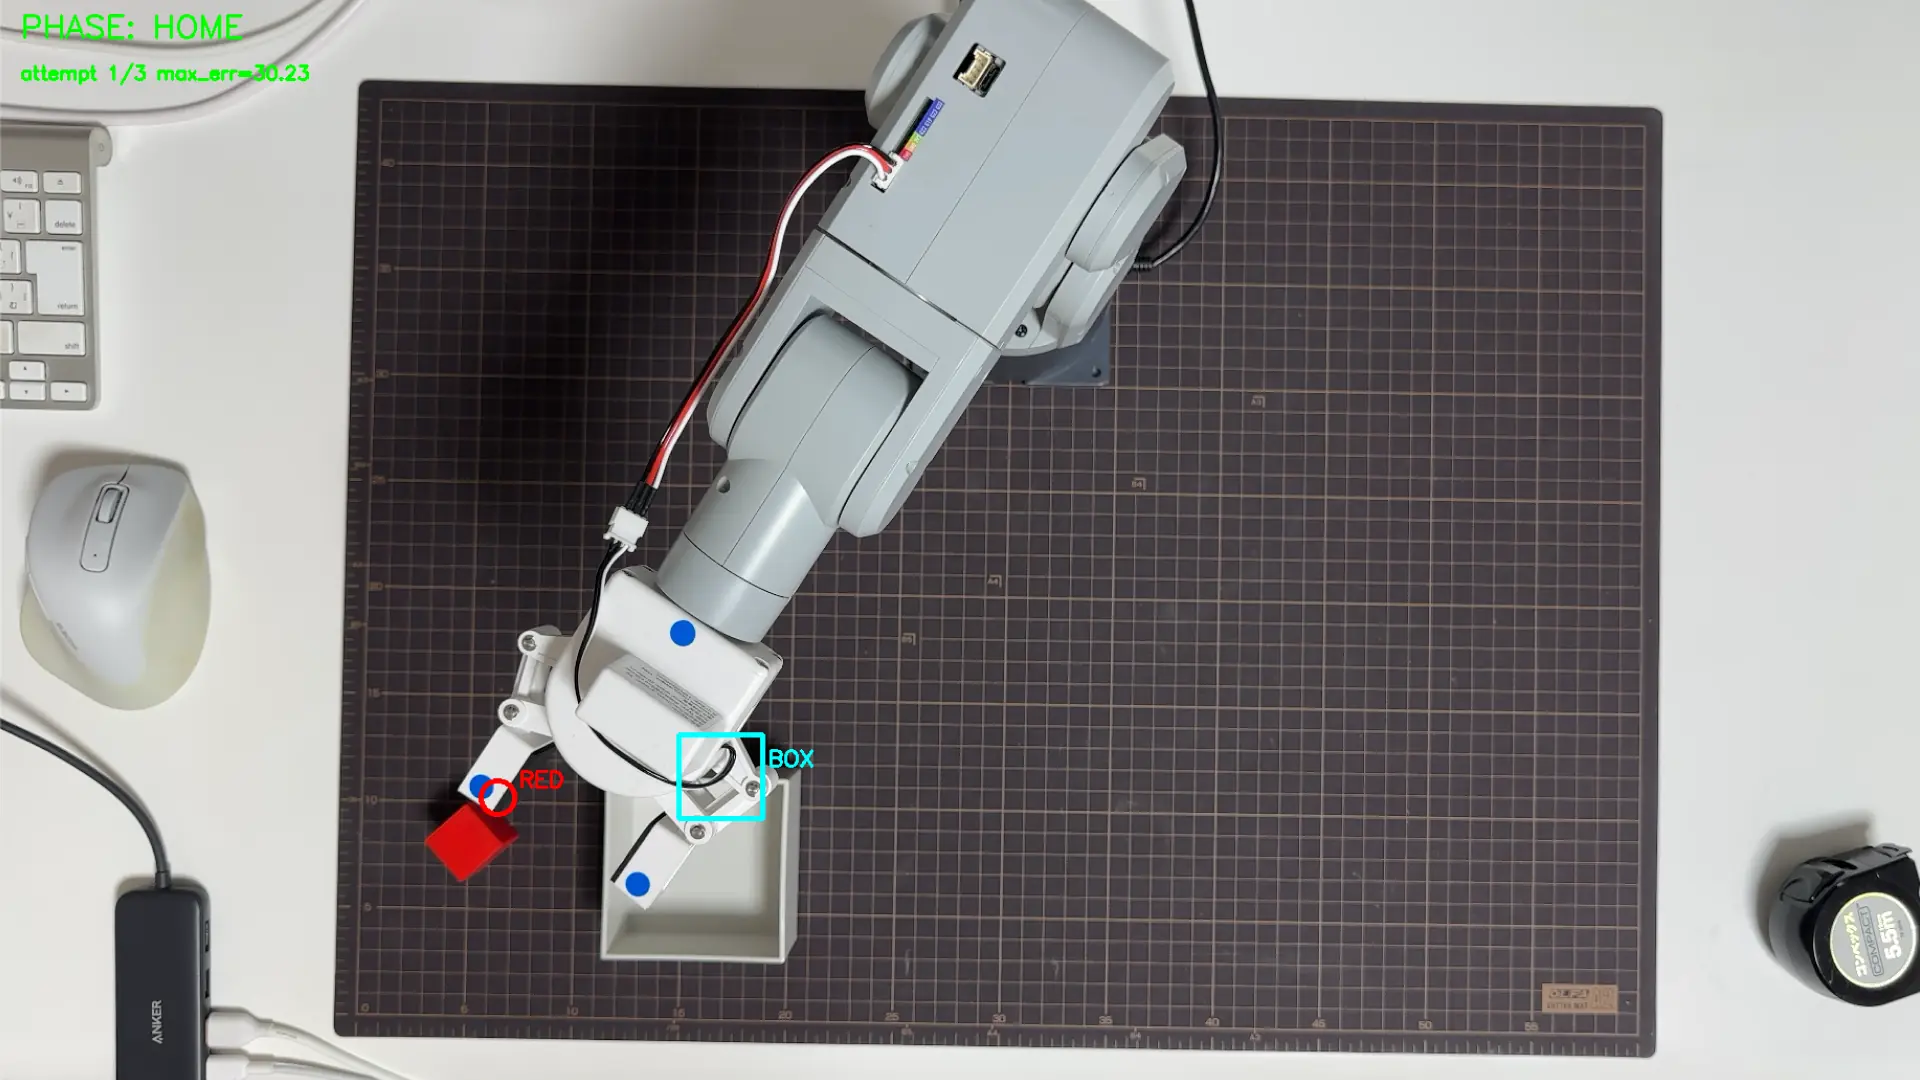
今回はそのv2を実機で動かす。手で教えた軌道が、工程の境界とグリッパーの開閉まで含めて再生されるかを確かめる。その上で、これまで保留していた「対象物の位置を取りながら教える」を一歩進める。上カメラで赤ブロックと白箱のUnity座標を取得する小さなスクリプトを実装し、手で教えた軌道にその位置を紐づけた、最初の一本を作るところまでを記録する。
コードとログは省かずに残す。検出スクリプトは初出なので全文を載せる。v2スクリプトは前回の記録に全文を載せたので、今回は検証で焦点になった部分だけを引用する。
v2はPiに無かった。転送から始める
v2は前回Mac側で完成させたが、Piには転送していなかった。実機検証はPi直結で動かすので、まずファイルの所在を確認する。daemonを止めてから(同じ /dev/ttyAMA0 を奪い合うため)、Piで存在を確かめると、無かった。
ubuntu@ubuntu:~$ ls -l ~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching/drag_teach_v2.py
ls: cannot access '/home/ubuntu/r2r2r-scripts/dynamic_tracking_limits/drag_teaching/drag_teach_v2.py': No such file or directory
Mac正本は同じパス構成にある。サイズは35,497バイト。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % ls -l ~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching/drag_teach_v2.py
-rw-r--r--  1 shimazueiichi  staff  35497  6月  7 19:37 .../drag_teach_v2.py
scpでPiへ送り、サイズを照合した。
ubuntu@ubuntu:~$ ls -l ~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching/drag_teach_v2.py
-rw-r--r-- 1 ubuntu ubuntu 35497 Oct 13 14:39 .../drag_teach_v2.py
35,497バイトで一致。タイムスタンプが Oct 13 なのは、PiのRTCが2022年のままで実時刻とずれているため。サイズが正本と同じなので中身は揃っている。
実機前の確認 ― phase検査の呼び出しとカメラ解決
v2を実機で動かす前に、2点を読み取りだけで確認した。ひとつはplay-Aのphase昇順検査が実際に呼ばれているか。検査関数を定義しただけで呼び出していなければ、phaseが昇順でなくても警告が出ない。
ubuntu@ubuntu:~$ grep -n "_check_phases_monotonic" .../drag_teach_v2.py
326:def _check_phases_monotonic(phases):
484:    non_monotonic = _check_phases_monotonic(phases)
326行が定義、484行が呼び出し。2箇所出たので、phaseが昇順でないときに検査が走る。ここは問題ない。
もうひとつは、teachが起動時に呼ぶ位置検出(camera_resolver で上カメラを解決する処理)がPiで動くか。
ubuntu@ubuntu:~$ cd ~/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/
-bash: cd: .../place/place_modules/: No such file or directory
ubuntu@ubuntu:~$ python3 -c "import camera_resolver as cr; print(cr.resolve_cameras(require_top=True, require_side=False, verbose=True))"
Traceback (most recent call last):
  File "<string>", line 1, in <module>
ModuleNotFoundError: No module named 'camera_resolver'
place_modules/ はPiに無く、camera_resolver も解決できない。理由は2つ重なっている。検出に必要なモジュール群がPiに転送されていないことと、上カメラ(Continuity Camera)が macOS 固有でPiから掴めないこと。位置取得のパイプライン(iPhone → AVFoundation → camera_resolver → 検出)は、まるごとMac側の資産だった。
teach自身がカメラ無しで止まらない作りかは、v2のソースで確認できる。_detect_positions() は camera_resolver の import を try で囲み、例外なら null を返して続行する。teachは起動時にこれを1回呼び、戻り値をJSONの positions に書くだけで、アーム制御には関与しない。つまりカメラが無くても、軌道の記録は通常どおり進む。位置は後からMac側で取って差し込む方針にした。
teach→play-A を実機で通す
teachを起動した。検出フェーズはPiでは例外になり、設計どおり null で続行した。OpenCVのローダがPi環境の設定ファイルを見つけられず例外を投げているが、握り潰して先へ進む。
ubuntu@ubuntu:~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching$ python3 drag_teach_v2.py teach
[V2.TEACH] mechArm(MyCobot)へ接続します
[V2.TEACH] 検出フェーズ: block / box の Unity 座標を取得します
[V2.DETECT] 検出全体で例外: OpenCV loader: missing configuration file: ['config-3.6.py', 'config-3.py']. Check OpenCV installation.(positions=null で続行)
============================================================
[V2.TEACH] 操作: 1 文字+Enter で1コマンド。空 Enter で停止。
  '1' = APPROACH_PICK 開始 / '2' = PICK 開始
  '3' = APPROACH_PLACE 開始 / '4' = PLACE 開始
  'c' = グリッパー閉印(実 API は呼ばない)
  'o' = グリッパー開印(実 API は呼ばない)
  空 Enter = 記録停止
============================================================
[V2.TEACH] アームを手で支えてください。支えた状態で Enter を押すと脱力します(damping mode)。

[V2.TEACH] release_all_servos() を呼びます(damping mode・引数なし)
[V2.TEACH]   release_all_servos result=None(戻り値はログのみ)
[V2.TEACH] 記録開始。アームを手で動かしてください。終わったら 空Enter で停止
1
[V2.TEACH] PHASE mark: APPROACH_PICK idx=167 rt=19.72s
2
[V2.TEACH] PHASE mark: PICK idx=225 rt=26.72s
c
[V2.TEACH] GRIPPER close mark idx=299 rt=35.58s(API は呼ばない)
3
[V2.TEACH] PHASE mark: APPROACH_PLACE idx=602 rt=70.26s
4
[V2.TEACH] PHASE mark: PLACE idx=740 rt=85.93s
o
[V2.TEACH] GRIPPER open mark idx=876 rt=101.46s(API は呼ばない)

[V2.TEACH] 空Enter 検出 → 記録停止
[V2.TEACH] power_on() 完了 result=None
[V2.TEACH] 記録停止。939 姿勢 / 経過 108.69s
[V2.TEACH] 保存: drag_v2_20221013_144730.json
工程が記録された順序を並べる。
工程 | idx | rt(秒) |
|---|---|---|
APPROACH_PICK | 167 | 19.72 |
PICK | 225 | 26.72 |
グリッパー閉印 | 299 | 35.58 |
APPROACH_PLACE | 602 | 70.26 |
PLACE | 740 | 85.93 |
グリッパー開印 | 876 | 101.46 |
phaseのidxが昇順(167→225→602→740)で並び、閉印はPICKの後、開印はPLACEの後にある。939姿勢で経過108.69秒、サンプル間隔は平均で約0.116秒。前回、滑らかに録れたサンプルと同じ間隔で、ゆっくり一定速度で録れている。teach停止後の power_on() も result=None で正常復帰した。teachでグリッパーは「印」だけを記録し、実APIは呼ばない。
この軌道をplay-Aで再生する。
ubuntu@ubuntu:~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching$ python3 drag_teach_v2.py play --in drag_v2_20221013_144730.json
[V2.PLAY] mechArm(MyCobot)へ接続します(939 姿勢 / 間隔 0.1s)
[V2.PLAY] [SAFETY] 再生中はグリッパーが実機で開閉します。爪に指を挟まないこと。
[V2.PLAY] power_on() 完了 result=None
[V2.PLAY] sample 想定位置:
  block_xz_m = None  score=None
  box_xz_m   = None  score=None
[V2.PLAY] 現在姿勢を取得します(最大 12 回・0.2s 間隔リトライ)
[V2.PLAY] 現在姿勢との差分: per-axis=[81.37, 42.98, 66.35, 2.38, 27.68, 0.88]  max=81.37°
[V2.PLAY] 先頭姿勢: [-40.42, 108.89, -59.41, -0.87, -51.59, -28.82](speed=20)
[V2.PLAY] 周囲に手・物が無いか確認してください。OK なら Enter で確認します

[V2.PLAY] [WARN] 先頭姿勢との最大軸差 81.37° > 30.0°。急加速の可能性があります
[V2.PLAY] 続行するには 'yes' と入力してください(それ以外は中止)
yes
[V2.PLAY] set_fresh_mode(1)(最新コマンド優先)
[V2.PLAY] グリッパー初期化: 開(set_gripper_state(0, 50)) ※実機確認対象
[V2.PLAY] 先頭姿勢 send_angles result=None
[V2.PLAY] 3.0s 待ちます
[V2.PLAY] rel_time_sec を使ってサンプル間差分でスリープします
[V2.PLAY] 再生開始。止めたいときは Ctrl-C
[V2.PLAY] === PHASE: APPROACH_PICK === (idx=167)
[V2.PLAY] === PHASE: PICK === (idx=225)
[V2.PLAY] gripper close → set_gripper_state(1, 50) at idx=299
[V2.PLAY] gripper dwell 0.5s
[V2.PLAY] === PHASE: APPROACH_PLACE === (idx=602)
[V2.PLAY] === PHASE: PLACE === (idx=740)
[V2.PLAY] gripper open → set_gripper_state(0, 50) at idx=876
[V2.PLAY] gripper dwell 0.5s
[V2.PLAY] 完了。939 姿勢を流しました
[V2.PLAY] set_fresh_mode(0) 完了
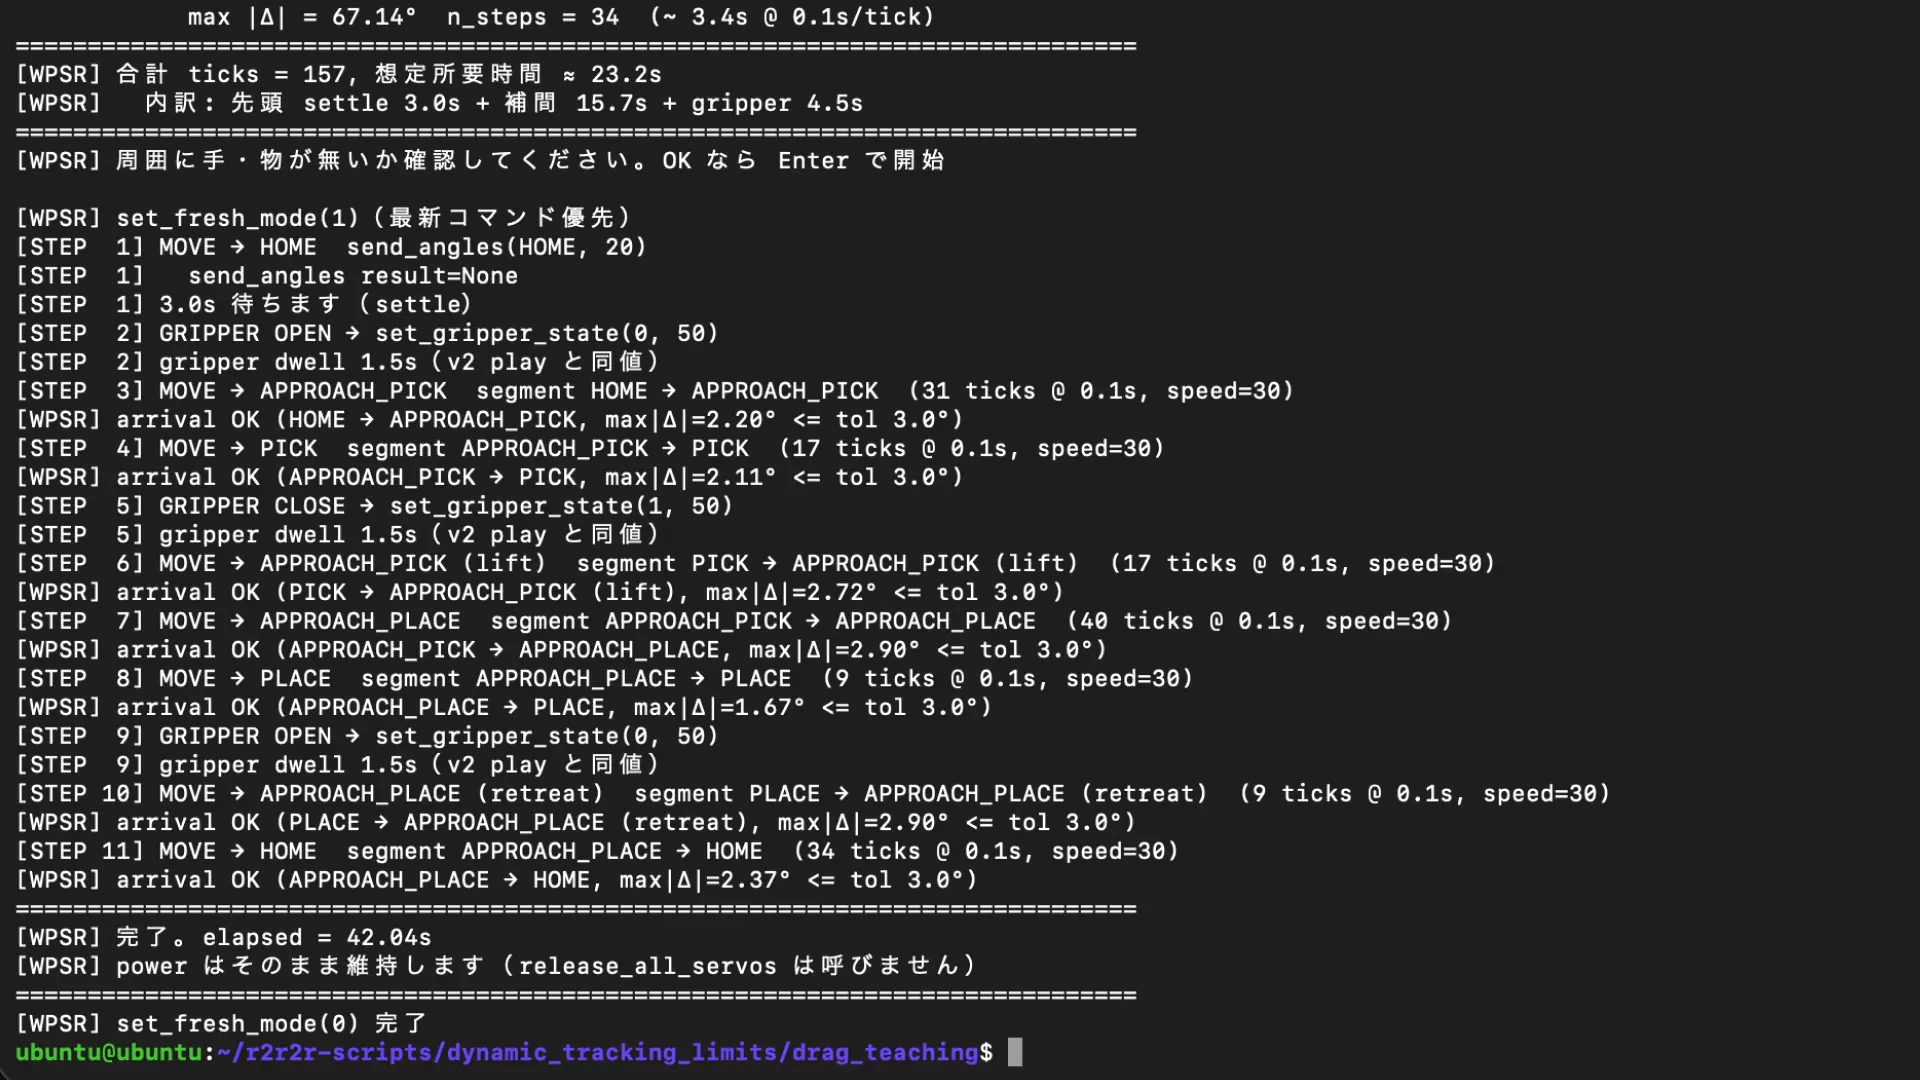
設計した要素が一通り動いた。再生中にグリッパーが実機で開閉する旨の安全表示が出る。先頭姿勢との最大軸差が81.37°で、teach終了姿勢(開印を打った箱の上あたり)から録り始めの先頭姿勢まで遠いため、30°のしきい値を超えて yes の明示入力を要求した。急加速を防ぐための確認で、設計どおりに働いた。
phase境界はAPPROACH_PICK、PICK、APPROACH_PLACE、PLACEの順でログに出て、記録した意味が再生でそのまま再現された。閉印のidx=299で実際に閉、開印のidx=876で実際に開を送り、それぞれ0.5秒のdwellを置いた。teachでは「印」だけ、playでは実API、という非対称が実機で通った。939姿勢を rel_time_sec の差分スリープで流し切り、set_fresh_modeを(1)から(0)へ戻して終えた。teachは空荷で録ったので、掴む対象が無いままグリッパーが閉じる動きになったが、検証の主眼は「軌道・工程・グリッパー印が意味づきで忠実再生されるか」なので、ここは成立を確認できた。
上カメラで位置を取りたい ― 構成上の判断
play-Aが通ったところで、これまで保留していた方向に進む。teachで手の動きを教えるとき、上カメラで赤ブロックと白箱の位置も取り、軌道に紐づけたい。手で教えた一本に「どの配置だったか」が付けば、後でその配置を変えたときに動作を流用できるか(位置への汎化)を試す素材になる。
ただ、ここで構成上の選択が必要になった。今回teachで確かめたとおり、位置検出はPiでは動かず、Mac側でしか動かない。検出のパイプラインがmacOS固有のカメラと、Mac側に置かれたモジュール群に依存している。
そこで「アーム制御の経路をdaemon経由に変えて、Mac側でteachとカメラを同時に動かす」案を検討した。Mac側で動かすには、Pi直結を前提に書いたv2を、daemon(TCP)経由でアームを動かす形に変えることになる。これは関節制御・脱力・グリッパー制御がTCP越しに走る、物理リスクのある構成変更にあたる。
daemonが何を中継できるかを実物で確認した。
ubuntu@ubuntu:~$ grep -n "mc\.\|def \|elif\|== \|recv\|json\|gripper\|release\|angles\|power_on\|fresh" ~/r2r2r-scripts/mecharm_daemon.py
(抜粋)
62:    if cmd == "ping":
65:    elif cmd == "send_angles":
75:            result = _mc.send_angles(angles, speed)
90:    elif cmd == "send_angle":
116:    elif cmd == "get_angles":
126:    elif cmd == "set_fresh_mode":
138:    elif cmd == "set_gripper":
144:        result = _mc.set_gripper_state(state, speed)
daemonが中継できるのは ping / send_angles / send_angle / get_angles / set_fresh_mode / set_gripper の6つ。teachの核である release_all_servos(脱力)が無い。power_on(通電復帰)も stop も無い。teachをdaemon経由でやるには、daemon本体にこの3つを足すことになる。
これは採らないと判断した。理由は三つある。ひとつ、daemonは全自律パイプラインが乗る土台で、ここに脱力コマンドを足すと、すべてのスクリプトからTCP越しに脱力を呼べる口が開く。ふたつ、恒久ルールで release_all_servos は自律モーションスクリプトでは永久禁止としており、daemonはまさにその自律パイプラインの中核にあたる。ルールが「ここに脱力を入れるな」と言っている当の場所に脱力の口を開けることになる。みっつ、位置への汎化に必要なのは「教えている最中の連続位置取得」ではなく「PICK時・PLACE時の1〜2回の捕捉」で、そのために土台を改修してルールに穴を開けるのは、得るものに対してリスクが大きすぎる。
代わりに、土台もルールも触らない経路を選んだ。teachは今回成立したPi直結版をそのまま使い、上カメラの位置取得だけMac側で別に走らせる。カメラはシリアルを使わないのでdaemonとの奪い合いも起きない。teachのJSONは positions の枠が空いているので、そこを後から埋める。
ここで考えが一つ変わった。最初は「教えながら位置も取る」=同時に動かす必要があると思っていた。だから一本化の案も出た。だが必要だったのは、教えている最中の連続取得ではなく、同じ配置で位置を1回取ることだった。ブロックと箱を動かさなければ、位置はteachの前でも後でも同じ値を指す。同時実行で解こうとしていた問題は、順序を決めるだけで解けた。daemonを改修してルールに穴を開ける重い経路を避けられたのは、問題を別の構造で捉え直したからだ。
位置取得スクリプトを作る ― 検出ロジックは流用する
Mac側で位置を取るスクリプトを新しく書く。やることは、上カメラから赤ブロックと白箱のUnity座標を1回(または複数回の中央値)取得し、JSONで標準出力に出すだけ。アーム制御は一切しない。
実装にあたって、既存資産の所在を確認した。検出に使うモジュールが2つの階層に分かれている。
---- visual_servo_pick の所在 ----
/Users/shimazueiichi/r2r2r-scripts/visual_servo_pick.py
---- camera_resolver / 06f の所在 ----
/Users/shimazueiichi/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/camera_resolver.py
/Users/shimazueiichi/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/06f_top_white_box_detect_v7.py
camera_resolver と白箱検出(06f)は place_modules/ の中、visual_servo_pick は r2r2r-scripts/ ルート直下にある。v2の _detect_positions() が両方をimportできていたのは、起動時にこの2つのパスをsys.pathに足していたからだった。位置取得スクリプトも同じく両方を通す必要がある。
homographyのセットアップが対話を含むか(マット四隅のクリック待ちなど)を確認した。含むなら「1回撮るだけ」のスクリプトと相性が悪い。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % sed -n '260,290p' ~/r2r2r-scripts/visual_servo_pick.py
def setup_homography_and_mat_range(cap):
    global _homography, _mat_px_range
    print(f"[Mac] マット四隅検出中... ({MAT_CORNER_NUM_FRAMES}フレーム)")
    frames = capture_frames(cap, MAT_CORNER_NUM_FRAMES,
                            MAT_CORNER_WARMUP_FRAMES, MAT_CORNER_FRAME_INTERVAL)
    all_corners = [c for c in (detect_corners(f) for f in frames) if c is not None]
    if not all_corners:
        print("[Mac] ✗ マット四隅検出失敗")
        return False
    corners = remove_outliers_and_average(all_corners)
    print(f"[Mac] ✓ マット四隅検出: {len(all_corners)}/{MAT_CORNER_NUM_FRAMES} フレーム成功")

    src = np.array(corners, dtype=np.float32)
    dst_mm = np.array([
        [+310, -89],   # UL
        [-310, -89],   # UR
        [-310, +361],  # LR
        [+310, +361],  # LL
    ], dtype=np.float32)
    _homography = cv2.getPerspectiveTransform(src, dst_mm)
    print(f"[Mac] ✓ 動的homography計算完了")
マット四隅をフレームから自動検出(数フレーム撮影 → 外れ値除去 → 平均)してhomographyを計算するだけで、input() も setMouseCallback も呼んでいない。完全に非対話だった。dst_mm の四隅(UL +310/-89、LR -310/+361)はマット実寸の定義(X方向620mm = ±310、Z上端89mm・下端361mm、原点はアームベース真下)と一致している。pixel_to_unity がmm→Unity m(×0.001)まで返すので、teachのJSONの block_xz_m / box_xz_m と同じ単位・同じ座標系になる。
これで設計が固まった。検出スクリプトは、v2の _detect_positions() の検出ロジックを土台にし、再実装しない。差分は、標準出力をJSONのみにすること、複数回撮って中央値を取れること、人間向けログを標準エラーに回すこと。実装したスクリプトの全文を載せる。
"""
detect_positions_once.py

上カメラ(Continuity / iPhone14ProMax = top)から赤ブロックと白箱の Unity 座標を
1 回(または --repeat N 回の中央値)取得し、JSON で標準出力に出す。
出力は drag_teach_v2.py の teach JSON の positions スキーマにそのまま差し込める形。

絶対禁止(コード上で守る):
- アーム制御を一切しない。pymycobot / MyCobot を import すらしない。
- daemon に接続しない。TCP を開かない。
- camera_resolver.py / 06f_top_white_box_detect_v7.py / visual_servo_pick.py /
  FK テーブルを書き換えない(import で呼ぶだけ)。
- send_coords / send_angles / release_all_servos 等のアーム API を呼ばない。

実装方針:
- drag_teach_v2.py の _detect_positions() の検出ロジックを土台にしたまま、本ファイル用に
  「stdout は JSON のみ」「--repeat / --interval」「camera_resolver 出力の stderr リダイレクト」
  だけ差分追加。
- 中核の chain は変えない:
    camera_resolver で top 解決 → cv2.VideoCapture → warm-up 30 フレーム →
    setup_homography_and_mat_range → 06f で box → visual_servo_pick で block → cap.release
- 失敗・例外・SystemExit は None で握り潰して続行する構造を維持する。

ログ方針:
- 検出経過・カメラ解決・homography 成否などの人間向けログは **全て stderr**。
- **stdout は最終 JSON のみ**(パーサーが安全に受け取れるように)。

CLI:
    python3 detect_positions_once.py                  # 1 回検出
    python3 detect_positions_once.py --repeat 5       # 5 回検出して各軸の中央値
    python3 detect_positions_once.py --repeat 5 --interval 0.3
"""

import argparse
import contextlib
import json
import sys
import time
from pathlib import Path

# パス追加: place_modules(自身が居る)と r2r2r-scripts ルート(visual_servo_pick が居る)
# 自身が ~/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/ にあるため
# parents[3] が r2r2r-scripts。__file__ 基準で解決し、ハードコード絶対パスを使わない。
_THIS_FILE = Path(__file__).resolve()
_PLACE_MODULES_DIR = _THIS_FILE.parent
_SCRIPTS_ROOT = _THIS_FILE.parents[3]
sys.path.insert(0, str(_SCRIPTS_ROOT))
sys.path.insert(0, str(_PLACE_MODULES_DIR))


def _err(msg):
    """人間向けログは全て stderr へ。"""
    print(msg, file=sys.stderr)


def _median(values):
    """None でない値だけ集めて中央値(偶数個は中央 2 つの平均)。空なら None。"""
    vs = [v for v in values if v is not None]
    if not vs:
        return None
    vs_sorted = sorted(vs)
    n = len(vs_sorted)
    mid = n // 2
    if n % 2 == 1:
        return vs_sorted[mid]
    return (vs_sorted[mid - 1] + vs_sorted[mid]) / 2.0


def _empty_result(repeat, top_idx):
    return {
        "block_xz_m": None,
        "box_xz_m": None,
        "detect_score": {"block": None, "box": None},
        "n_captures": repeat,
        "resolved_top_index": top_idx,
    }


def detect_positions(repeat=1, interval=0.5):
    """検出本体。drag_teach_v2.py の _detect_positions() の chain をそのまま使い、
    検出ペア(box → block)を repeat 回繰り返して中央値で集約する。

    戻り値: dict {
        "block_xz_m": [x, z] or None,
        "box_xz_m":   [x, z] or None,
        "detect_score": {"block": None, "box": float|None},
        "n_captures": repeat,
        "resolved_top_index": int or None,
    }
    """
    block_xs = []
    block_zs = []
    box_xs = []
    box_zs = []
    box_scores = []
    resolved_top_index = None
    cap = None

    try:
        import importlib
        cv2 = importlib.import_module("cv2")

        # camera_resolver: verbose=True で呼び、resolver の print(stdout)を stderr へ
        # まるごと逃がす。stdout は最終 JSON のためだけに空けておく。
        try:
            cr = importlib.import_module("camera_resolver")
            with contextlib.redirect_stdout(sys.stderr):
                cams = cr.resolve_cameras(
                    require_top=True, require_side=False, verbose=True,
                )
            resolved_top_index = cams.get("top") if cams else None
            _err("[DETECT] resolved top index: {}".format(resolved_top_index))
        except (Exception, SystemExit) as e:
            if isinstance(e, SystemExit):
                _err("[DETECT] camera_resolver が exit を試みた(positions=null で終了)")
            else:
                _err("[DETECT] camera_resolver で例外: {}(positions=null)".format(e))
            return _empty_result(repeat, None)

        if resolved_top_index is None:
            _err("[DETECT] top カメラ未解決。positions=null")
            return _empty_result(repeat, None)

        cap = cv2.VideoCapture(resolved_top_index)
        if not cap.isOpened():
            _err("[DETECT] top カメラ open 失敗 (index={})".format(resolved_top_index))
            return _empty_result(repeat, resolved_top_index)

        # warm-up 30 フレーム
        for _ in range(30):
            cap.read()

        # homography
        try:
            vsp = importlib.import_module("visual_servo_pick")
            if not vsp.setup_homography_and_mat_range(cap):
                _err("[DETECT] homography セットアップ失敗。positions=null")
                return _empty_result(repeat, resolved_top_index)
        except (Exception, SystemExit) as e:
            if isinstance(e, SystemExit):
                _err("[DETECT] homography セットアップが exit を試みた(positions=null)")
            else:
                _err("[DETECT] homography セットアップ例外: {}".format(e))
            return _empty_result(repeat, resolved_top_index)

        # 06f テンプレロード(テンプレ欠落で sys.exit を投げることがある → 捕捉して
        # box は全 null で続行。block 検出は別経路なので継続できる)
        m06f = None
        templates = None
        try:
            m06f = importlib.import_module("06f_top_white_box_detect_v7")
            templates = m06f._load_white_box_templates()
        except (Exception, SystemExit) as e:
            if isinstance(e, SystemExit):
                _err("[DETECT] テンプレ欠落等で 06f が exit を試みた(box は全 null で続行)")
            else:
                _err("[DETECT] 06f テンプレロードで例外: {}".format(e))
            m06f = None
            templates = None

        # 検出ループ
        for i in range(repeat):
            tag = "[DETECT][{}/{}]".format(i + 1, repeat)

            # box(06f)
            if m06f is not None and templates is not None:
                try:
                    det = m06f.detect_white_box_once(cap, templates)
                    if det is not None and not det.get("below_threshold", False):
                        bcx, bcy = det["center"]
                        ux, uz = vsp.pixel_to_unity(bcx, bcy)
                        box_xs.append(float(ux))
                        box_zs.append(float(uz))
                        score = det.get("score")
                        if isinstance(score, (int, float)):
                            box_scores.append(float(score))
                        _err("{} box Unity=({:+.3f},{:+.3f}) score={}".format(
                            tag, ux, uz, score,
                        ))
                    else:
                        if det is None:
                            _err("{} box 未検出".format(tag))
                        else:
                            _err("{} box 検出スコアしきい値未満(box=null)".format(tag))
                except (Exception, SystemExit) as e:
                    if isinstance(e, SystemExit):
                        _err("{} box 検出で exit(box=null で続行)".format(tag))
                    else:
                        _err("{} box 検出で例外: {}(box=null で続行)".format(tag, e))

            # block: visual_servo_pick.detect_red_block_unity
            try:
                blk = vsp.detect_red_block_unity(cap)
                if blk is not None:
                    bx, bz = blk
                    block_xs.append(float(bx))
                    block_zs.append(float(bz))
                    _err("{} block Unity=({:+.3f},{:+.3f}) score=null".format(
                        tag, bx, bz,
                    ))
                else:
                    _err("{} block 未検出".format(tag))
            except (Exception, SystemExit) as e:
                if isinstance(e, SystemExit):
                    _err("{} block 検出で exit(block=null で続行)".format(tag))
                else:
                    _err("{} block 検出で例外: {}(block=null で続行)".format(tag, e))

            if i < repeat - 1:
                time.sleep(interval)
    except (Exception, SystemExit) as e:
        if isinstance(e, SystemExit):
            _err("[DETECT] 全体で exit を試みた(positions=null)")
        else:
            _err("[DETECT] 全体で例外: {}(positions=null)".format(e))
    finally:
        if cap is not None:
            try:
                cap.release()
            except Exception:
                pass

    # 中央値で集約(各軸独立。Noneでない取得のみ)
    block_x = _median(block_xs)
    block_z = _median(block_zs)
    box_x = _median(box_xs)
    box_z = _median(box_zs)
    box_score = _median(box_scores)

    block_xz = [block_x, block_z] if (block_x is not None and block_z is not None) else None
    box_xz = [box_x, box_z] if (box_x is not None and box_z is not None) else None

    return {
        "block_xz_m": block_xz,
        "box_xz_m": box_xz,
        # 仕様: block は score 非提供のため常に null。box は中央値(取れなければ null)。
        "detect_score": {"block": None, "box": box_score},
        "n_captures": repeat,
        "resolved_top_index": resolved_top_index,
    }


def main():
    parser = argparse.ArgumentParser(
        description=(
            "上カメラから赤ブロック/白箱の Unity 座標を 1 回(または --repeat 回の中央値)"
            "取得して JSON で stdout に出す。アーム制御・daemon 接続は一切行わない。"
        )
    )
    parser.add_argument(
        "--repeat", type=int, default=1,
        help="検出回数(>=1, default=1)。複数回時は各軸の中央値で集約。",
    )
    parser.add_argument(
        "--interval", type=float, default=0.5,
        help="--repeat 時の撮影間隔(秒、default=0.5)。",
    )
    args = parser.parse_args()

    repeat = args.repeat if args.repeat >= 1 else 1
    interval = args.interval if args.interval >= 0.0 else 0.0
    if args.repeat != repeat:
        _err("[DETECT] --repeat={} は不正、{} に補正".format(args.repeat, repeat))

    result = detect_positions(repeat=repeat, interval=interval)

    # stdout は JSON のみ(差し込みスクリプトがパースしやすいように)
    print(json.dumps(result, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
このスクリプトはアームAPIを一切呼ばず、daemonにも接続しないので、物理リスクは無い。パス追加は __file__ 基準で解決し、ハードコードの絶対パスを使わない。parents[3] が r2r2r-scripts ルート(visual_servo_pick がここ)、親ディレクトリが place_modules(camera_resolver と 06f がここ)になる。
Mac単体で検出が通った ― block も box も
Piでは落ちた検出が、Macで通るか。これがこの経路の確かめどころだった。引数なしで1回実行する。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % python3 ~/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/detect_positions_once.py
[CAM] 接続中カメラ一覧:
index=0 name=FaceTime HDカメラ
index=1 name=Iriun Camera
index=2 name=iPhone14 Pro MAXのカメラ
[CAM] 上カメラ(iPhone) index=2
[CAM] 横カメラ(Iriun) index=1
[DETECT] resolved top index: 2
[Mac] マット四隅検出中... (10フレーム)
[Mac] ✓ マット四隅検出: 10/10 フレーム成功
[Mac] ✓ 動的homography計算完了
[Mac] ✓ マット範囲: X=[438, 1694] Y=[131, 1043]
[06f] TEMPLATES_DIR overridden to: /Users/shimazueiichi/r2r2r-scripts/dynamic_tracking_limits/place/templates
[06f] ROTATION_ANGLES_DEG overridden to: [0, 15, 30, 45, 60, 75]
[06f] SCALES overridden to: [0.85, 1.0, 1.15]
[テンプレ] 計 8 枚 (day165=8, auto=0)
[06f] DETECT: overall_best=None (eval 4.99s) ※胴体ROIで除外した最高スコア候補あり: score=0.743 center=(1111,254) name=white_box_20260520_163929_013.png
[DETECT][1/1] box 未検出
赤ブロック pixel=(676, 793) → Unity=(0.1947, 0.2392)
[DETECT][1/1] block Unity=(+0.195,+0.239) score=null
{
"block_xz_m": [
0.19465298461914063,
0.23923968505859375
],
"box_xz_m": null,
"detect_score": {
"block": null,
"box": null
},
"n_captures": 1,
"resolved_top_index": 2
}camera_resolverが上カメラをindex=2(iPhone14 Pro MAX、Continuity)に解決し、FaceTimeを除外している。homographyのマット四隅検出が10/10フレーム成功し、変換が確立した。クリック待ちもウィンドウも出ず、完全に非対話で通った。赤ブロックがUnity(0.195, 0.239)で取れ、標準出力のJSONに入った。標準出力にはJSONだけが出て、検出ログはすべて標準エラーに分かれている。
このときの白箱はnullになった。理由はログに出ている。
[06f] DETECT: overall_best=None ※胴体ROIで除外した最高スコア候補あり: score=0.743 center=(1111,254)白箱は見えていた(score=0.743の候補があった)が、検出側の「胴体ROIで除外」フィルタに引っかかって弾かれた。テンプレートが無いからではなく、検出ロジックの判定による。スコア自体は前回見えていた0.63〜0.68と同程度かそれ以上で、テンプレートは機能している。
配置を調整してもう一度、今度は --repeat 5 で取った。複数回撮って中央値を取るのは、白箱の検出スコアが揺れる既知の問題への保険になる。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % python3 ~/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/detect_positions_once.py --repeat 5 > ~/r2r2r-scripts/positions_now.json
[CAM] 接続中カメラ一覧:
index=0 name=FaceTime HDカメラ
index=1 name=Iriun Camera
index=2 name=iPhone14 Pro MAXのカメラ
[CAM] 上カメラ(iPhone) index=2
[CAM] 横カメラ(Iriun) index=1
[DETECT] resolved top index: 2
[DETECT][1/5] box Unity=(-0.010,+0.108) score=0.6477543711662292
[DETECT][1/5] block Unity=(+0.197,+0.242) score=null
[DETECT][2/5] box Unity=(-0.010,+0.108) score=0.6483950018882751
[DETECT][2/5] block Unity=(+0.197,+0.242) score=null
[DETECT][3/5] box Unity=(-0.010,+0.108) score=0.6478163599967957
[DETECT][3/5] block Unity=(+0.197,+0.242) score=null
[DETECT][4/5] box Unity=(-0.010,+0.108) score=0.6473678350448608
[DETECT][4/5] block Unity=(+0.197,+0.243) score=null
[DETECT][5/5] box Unity=(-0.010,+0.108) score=0.6469134092330933
[DETECT][5/5] block Unity=(+0.197,+0.242) score=null
[Mac] マット四隅検出中... (10フレーム)
[Mac] ✓ マット四隅検出: 10/10 フレーム成功
[Mac] ✓ 動的homography計算完了
[Mac] ✓ マット範囲: X=[439, 1693] Y=[130, 1043]
[06f] TEMPLATES_DIR overridden to: /Users/shimazueiichi/r2r2r-scripts/dynamic_tracking_limits/place/templates
[06f] ROTATION_ANGLES_DEG overridden to: [0, 15, 30, 45, 60, 75]
[06f] SCALES overridden to: [0.85, 1.0, 1.15]
[テンプレ] 計 8 枚 (day165=8, auto=0)
[06f] DETECT: center=(1085,524) score=0.648 angle=30° scale=0.85 size=(161x158) template=white_box_20260520_163912_010.png (eval 5.13s)
赤ブロック pixel=(671, 799) → Unity=(0.1975, 0.2421)
[06f] DETECT: center=(1085,524) score=0.648 angle=30° scale=0.85 size=(161x158) template=white_box_20260520_163912_010.png (eval 5.09s)
赤ブロック pixel=(671, 799) → Unity=(0.1975, 0.2421)
[06f] DETECT: center=(1085,524) score=0.648 angle=30° scale=0.85 size=(161x158) template=white_box_20260520_163912_010.png (eval 4.95s)
赤ブロック pixel=(671, 799) → Unity=(0.1975, 0.2421)
[06f] DETECT: center=(1085,524) score=0.647 angle=30° scale=0.85 size=(180x167) template=white_box_20260520_163929_013.png (eval 5.04s)
赤ブロック pixel=(671, 800) → Unity=(0.1975, 0.2426)
[06f] DETECT: center=(1085,524) score=0.647 angle=30° scale=0.85 size=(180x167) template=white_box_20260520_163929_013.png (eval 5.00s)
赤ブロック pixel=(671, 799) → Unity=(0.1975, 0.2421)ファイルに入ったJSONは次のとおり。
{
  "block_xz_m": [
    0.19748918151855469,
    0.24208134460449218
  ],
  "box_xz_m": [
    -0.010342815399169923,
    0.10760498046875
  ],
  "detect_score": {
    "block": null,
    "box": 0.6477543711662292
  },
  "n_captures": 5,
  "resolved_top_index": 2
}
今度は白箱も取れた。配置が変わって胴体ROIの除外領域から外れたためで、5回ともUnity(-0.010, +0.108)で完全に安定し、スコアは0.6469〜0.6483の範囲に収まった。ブロックも5回ほぼ一致して中央値が(0.1975, 0.2421)。白箱のスコア0.648は目標の0.80には届かないが、位置としては5回の再現性が高く、紐づけに使うには十分だった。テンプレート撮り直しは検出の確からしさを上げる課題として残る。
標準出力にログが混ざっていた
ここで取れたファイルをteachのJSONに差し込もうとしたら、JSONのパースで落ちた。
json.decoder.JSONDecodeError: Expecting value: line 1 column 2 (char 1)ファイルの先頭を見ると、JSONではなくログが入っていた。
==== positions_now.json の先頭3行 ====
[Mac] マット四隅検出中... (10フレーム)
[Mac] ✓ マット四隅検出: 10/10 フレーム成功
[Mac] ✓ 動的homography計算完了
detect_positions_once.py は標準出力をJSONだけにする設計だが、setup_homography_and_mat_range の中の print()(先頭の [Mac]... の行)は標準出力に出る。camera_resolverの出力は標準エラーに逃がしていたが、homographyセットアップのprintは逃がしていなかった。そのため > のリダイレクトでログがJSONと一緒にファイルへ入った。スクリプト側の取りこぼしで、homographyセットアップの呼び出しも標準エラーへ回すべきだった。次の機会に直す。
ファイルの末尾には正しいJSONブロックが残っていたので、再実行はせず、{ から最後の } までを取り出して別ファイルに保存した。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % python3 -c "
import re
raw = open('/Users/shimazueiichi/r2r2r-scripts/positions_now.json').read()
start = raw.index('{')
end = raw.rindex('}') + 1
import json
obj = json.loads(raw[start:end])
json.dump(obj, open('/Users/shimazueiichi/r2r2r-scripts/positions_clean.json','w'), ensure_ascii=False, indent=2)
print('cleaned:', json.dumps(obj, ensure_ascii=False, indent=2))
"
cleaned: {
  "block_xz_m": [
    0.19748918151855469,
    0.24208134460449218
  ],
  "box_xz_m": [
    -0.010342815399169923,
    0.10760498046875
  ],
  "detect_score": {
    "block": null,
    "box": 0.6477543711662292
  },
  "n_captures": 5,
  "resolved_top_index": 2
}
軌道に位置を紐づける ― 最初の一本
位置が取れたので、同じ配置のままPiでteachを録った。ブロックと白箱は動かさない。この位置の値を、これから録る軌道に紐づけるためだ。
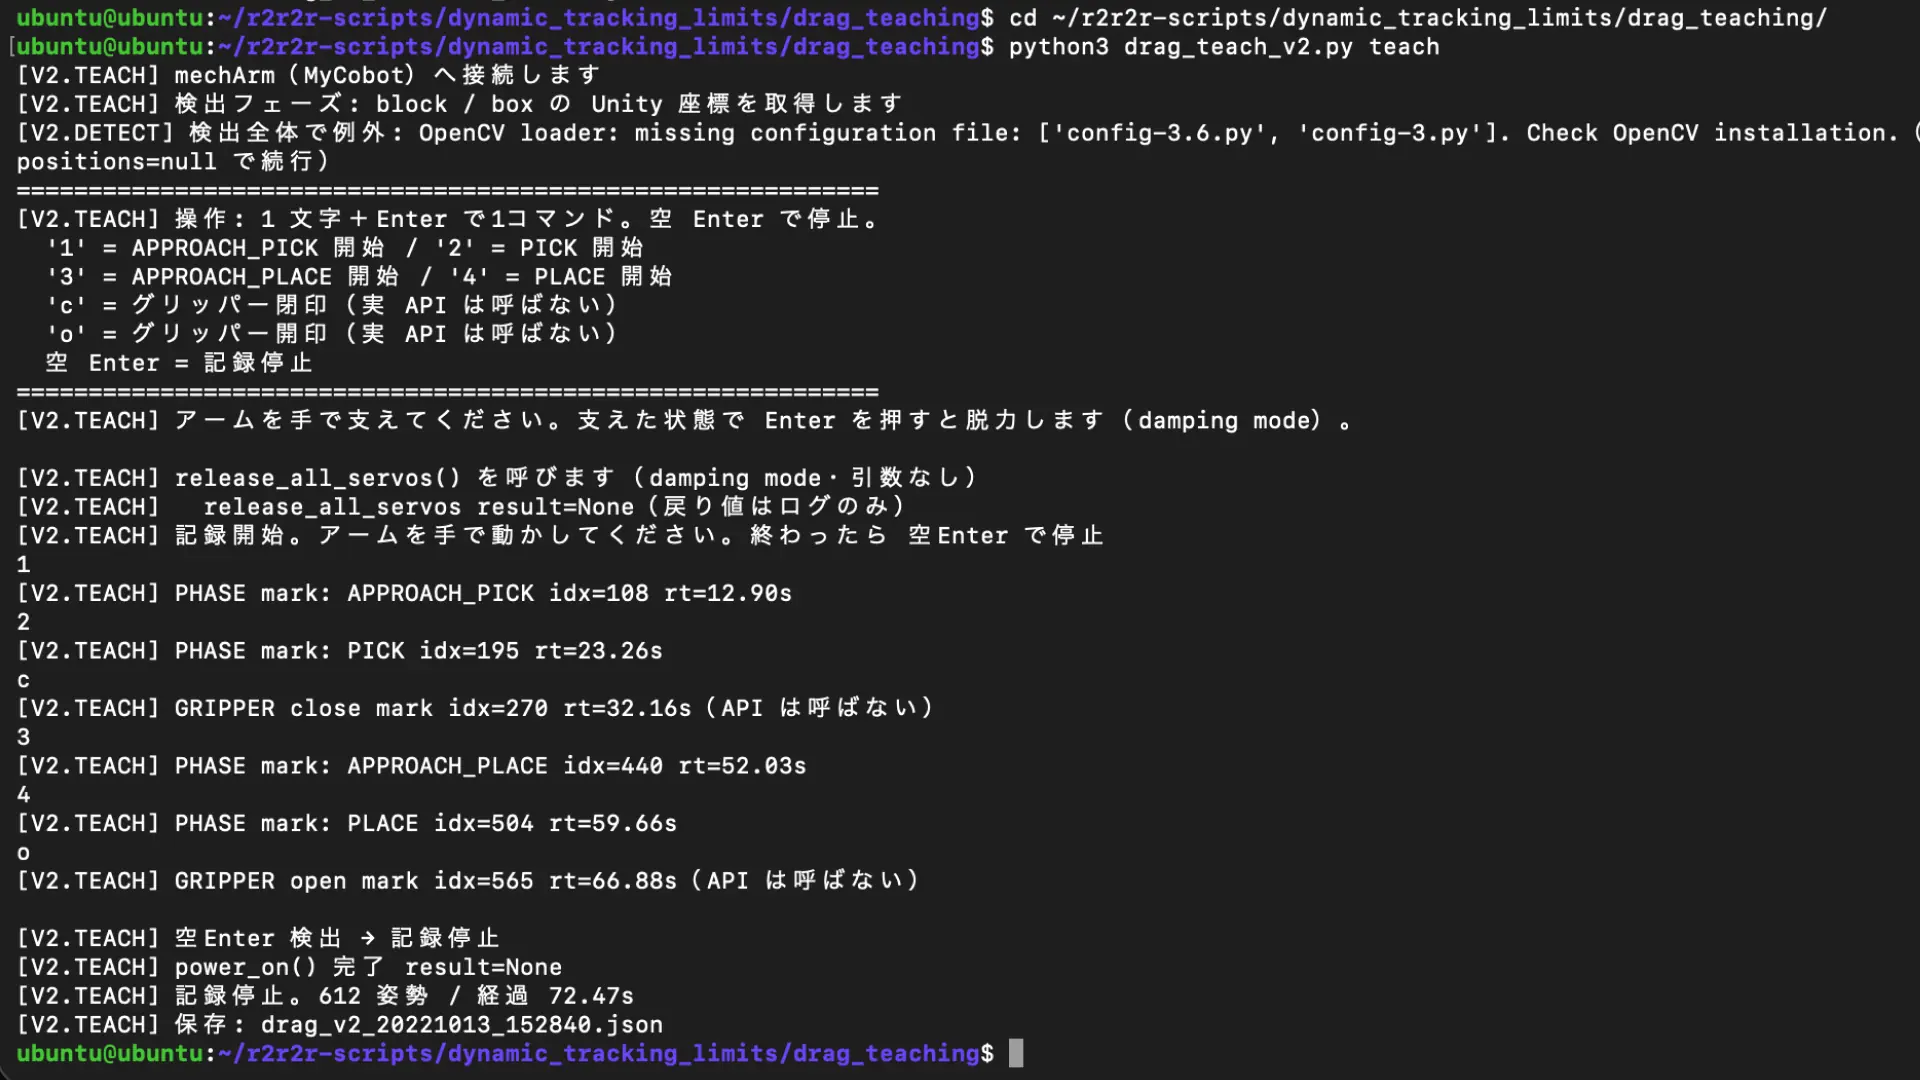
ubuntu@ubuntu:~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching$ python3 drag_teach_v2.py teach
[V2.TEACH] mechArm(MyCobot)へ接続します
[V2.TEACH] 検出フェーズ: block / box の Unity 座標を取得します
[V2.DETECT] 検出全体で例外: OpenCV loader: missing configuration file: ['config-3.6.py', 'config-3.py']. Check OpenCV installation.(positions=null で続行)
============================================================
[V2.TEACH] 操作: 1 文字+Enter で1コマンド。空 Enter で停止。
  '1' = APPROACH_PICK 開始 / '2' = PICK 開始
  '3' = APPROACH_PLACE 開始 / '4' = PLACE 開始
  'c' = グリッパー閉印(実 API は呼ばない)
  'o' = グリッパー開印(実 API は呼ばない)
  空 Enter = 記録停止
============================================================
[V2.TEACH] アームを手で支えてください。支えた状態で Enter を押すと脱力します(damping mode)。

[V2.TEACH] release_all_servos() を呼びます(damping mode・引数なし)
[V2.TEACH]   release_all_servos result=None(戻り値はログのみ)
[V2.TEACH] 記録開始。アームを手で動かしてください。終わったら 空Enter で停止
1
[V2.TEACH] PHASE mark: APPROACH_PICK idx=108 rt=12.90s
2
[V2.TEACH] PHASE mark: PICK idx=195 rt=23.26s
c
[V2.TEACH] GRIPPER close mark idx=270 rt=32.16s(API は呼ばない)
3
[V2.TEACH] PHASE mark: APPROACH_PLACE idx=440 rt=52.03s
4
[V2.TEACH] PHASE mark: PLACE idx=504 rt=59.66s
o
[V2.TEACH] GRIPPER open mark idx=565 rt=66.88s(API は呼ばない)

[V2.TEACH] 空Enter 検出 → 記録停止
[V2.TEACH] power_on() 完了 result=None
[V2.TEACH] 記録停止。612 姿勢 / 経過 72.47s
[V2.TEACH] 保存: drag_v2_20221013_152840.json
工程の順序は次のとおり。
工程 | idx | rt(秒) |
|---|---|---|
APPROACH_PICK | 108 | 12.90 |
PICK | 195 | 23.26 |
グリッパー閉印 | 270 | 32.16 |
APPROACH_PLACE | 440 | 52.03 |
PLACE | 504 | 59.66 |
グリッパー開印 | 565 | 66.88 |
phaseが昇順、閉印がPICKの後、開印がPLACEの後。612姿勢で経過72.47秒、サンプル間隔は平均で約0.118秒。一本目と同じく均一に録れた。
このteachのJSONはPiにあり、位置のJSONはMacにある。差し込みはMac側でやることにして、teachのJSONをPiからMacへ転送した。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % scp -i ~/.ssh/id_rsa_pi \
  ubuntu@192.168.2.1:~/.../drag_v2_20221013_152840.json \
  ~/r2r2r-scripts/dynamic_tracking_limits/drag_teaching/drag_v2_20221013_152840.json
drag_v2_20221013_152840.json 100% 70KB 12.7MB/s 00:00クリーンにした位置JSON(positions_clean.json)の値を、teachのJSONの positions に差し込む。元ファイルは壊さず、_with_pos.json という別名で保存する。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro % python3 -c "
import json, os

teach_path = os.path.expanduser('~/.../drag_v2_20221013_152840.json')
pos_path   = os.path.expanduser('~/r2r2r-scripts/positions_clean.json')

with open(teach_path) as f: teach = json.load(f)
with open(pos_path) as f: pos = json.load(f)

teach.setdefault('positions', {})
teach['positions']['block_xz_m']  = pos.get('block_xz_m')
teach['positions']['box_xz_m']    = pos.get('box_xz_m')
teach['positions']['detect_score']= pos.get('detect_score')
teach['positions']['source'] = {
    'from': 'detect_positions_once.py',
    'n_captures': pos.get('n_captures'),
    'resolved_top_index': pos.get('resolved_top_index'),
}

out_path = teach_path.replace('.json', '_with_pos.json')
with open(out_path, 'w') as f:
    json.dump(teach, f, ensure_ascii=False, indent=2)

print('saved:', out_path)
print('positions:', json.dumps(teach['positions'], ensure_ascii=False, indent=2))
"
saved: .../drag_v2_20221013_152840_with_pos.json
positions: {
  "block_xz_m": [
    0.19748918151855469,
    0.24208134460449218
  ],
  "box_xz_m": [
    -0.010342815399169923,
    0.10760498046875
  ],
  "detect_score": {
    "block": null,
    "box": 0.6477543711662292
  },
  "coord_note": "Unity座標系・マット原点基準",
  "source": {
    "from": "detect_positions_once.py",
    "n_captures": 5,
    "resolved_top_index": 2
  }
}
手で教えた軌道(612姿勢・4工程・グリッパー印)と、その配置の対象物位置(ブロック(0.1975, 0.2421)・白箱(-0.0103, 0.1076))が、ひとつのJSONに紐づいた。位置の由来も記録に残してある(detect_positions_once.pyで5回中央値、上カメラindex 2)。出力に残った coord_note はteachのJSON側にもとからあった枠のキーで、差し込みで上書きしていないだけだが、座標系の注記として残っているのは後で読むときにかえって役立つ。
この一本が足場になる
手で教えた軌道に、その時の対象物位置が紐づいた。これがこの経路の最小単位になる。前回の記録の終わりに「手で教えた一本の軌道は、意味を与えられて初めて、増やせる素材になる」と書いた。工程とグリッパーの意味は前回付き、今回さらに位置の意味が付いた。
位置の値は、上カメラのUnity座標。teachのanglesは、アームが実際に取った関節角。この二つが同じ配置を指していることが、後で「位置から動作を作る」ための前提になる。今回はブロックと白箱を動かさずに、Macで撮ってからPiで教えたので、同じ配置を指している。位置を撮った配置と教えた配置が同一であることだけ守れば、サンプルとして正しい。
次は、別の配置でもう一本を作り、二本のサンプルを補間して中間の位置に置けるかを実機で測る。決め打ちの汎化アルゴリズムは作らず、まず二本で測るところから始める。ここで初めて「位置から動作を作る」が試せる。サンプルを増やして任意の位置に対応させる構想全体の成否は、この段で分かれる。
残った課題は本文に出たとおり。白箱検出の「胴体ROIで除外」は配置依存で、検出スクリプトの標準出力にログが混ざる取りこぼしもある。どちらも次の機会に回す。
手で教えた軌道に位置が結びついて、増やして測れる素材の一本目になった。