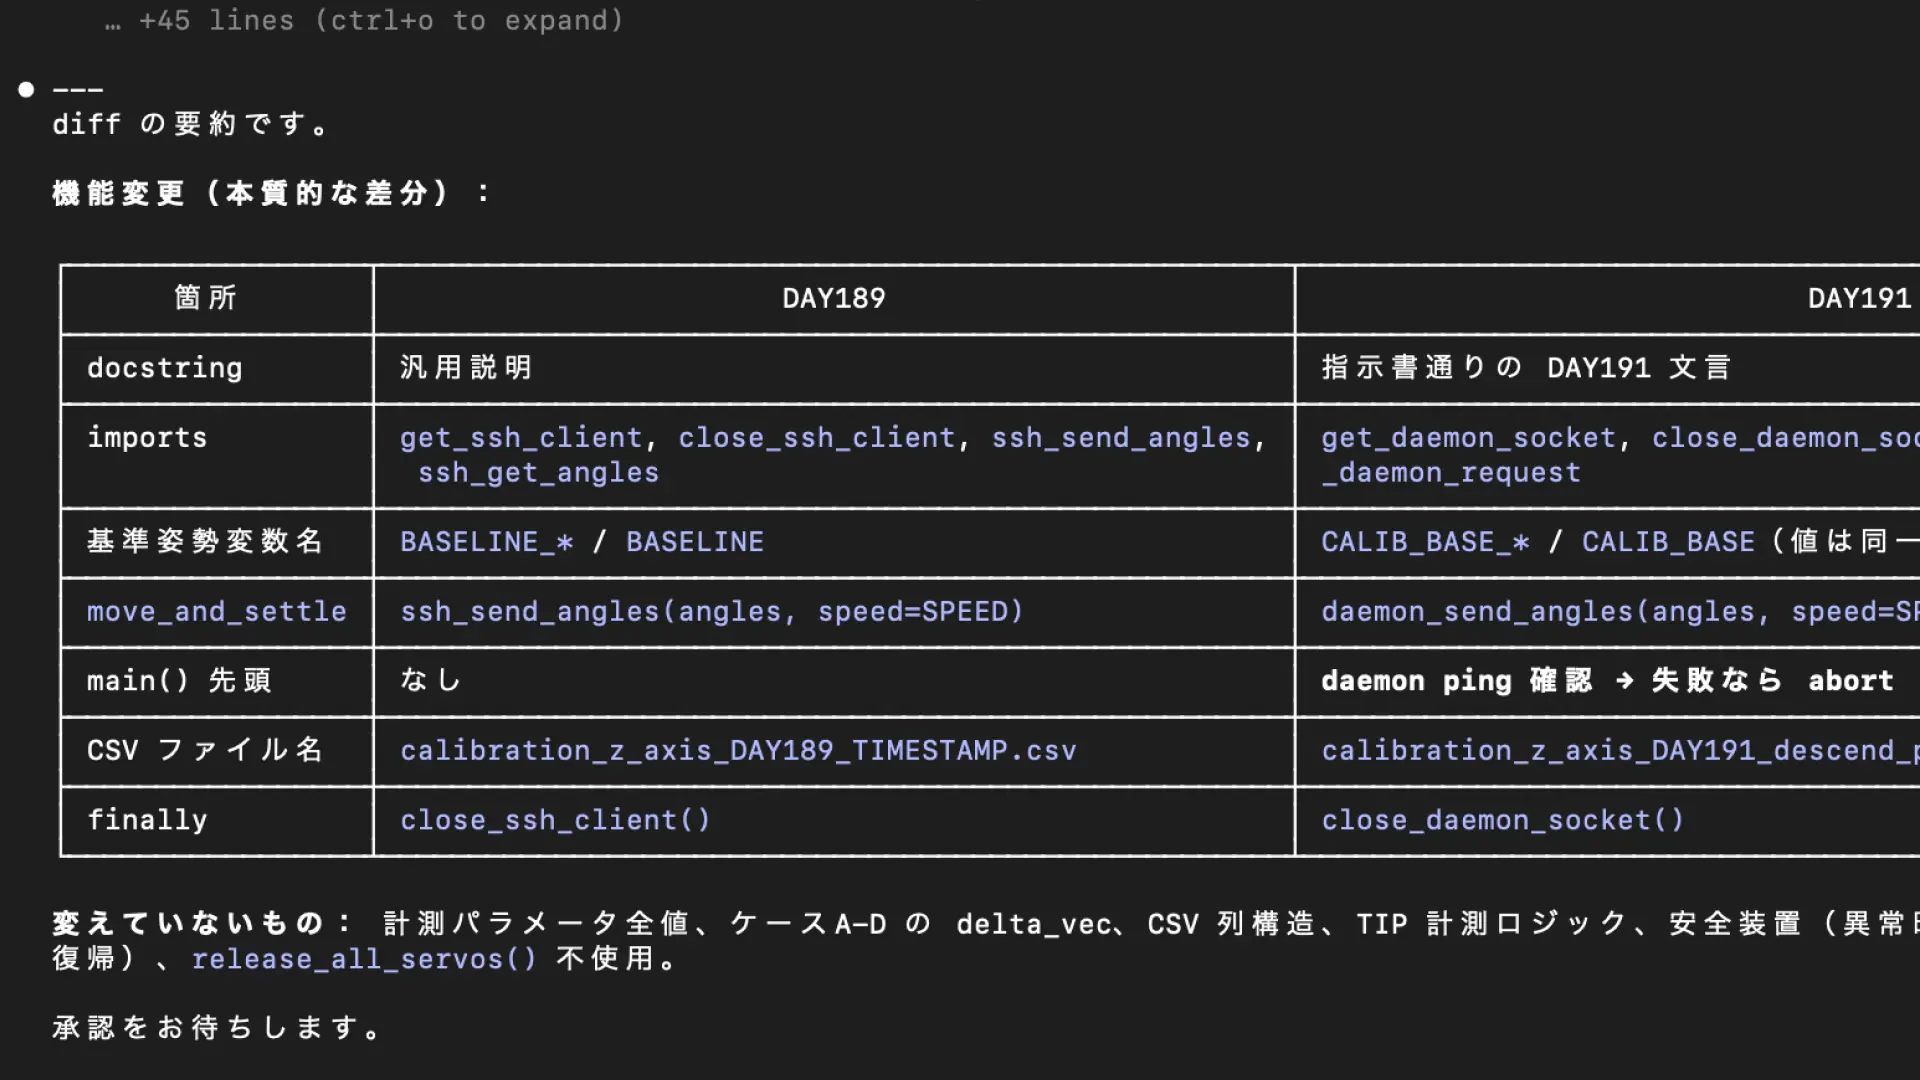
mechArm 270 Pi 動的追従の限界を探る Log#11 | 横カメラを統合する 検出パイプラインを上向きと前向きに分割した
デザイナーがロボットを触ると、見えてくるものがある。LOG196で見えたのはこれ。
Log#10 で iPhone 11 を三脚で爪の正面に立てた。Log#11 はそれをパイプラインに組み込む作業だ。やってみて最初に殴られたのは「TIP の幾何検出を1つの関数で済ませようとしていた前提」だった。上から見たときと前から見たときでは、同じ爪の同じシールが、見えたり見えなかったりする。1つの関数では成立しない。検出パイプラインを「上向き」と「前向き」の2系統に分割するところから始めなおすことになった。
そして、もう一つの壁が macOS のカメラ index だった。MacBook 内蔵 FaceTime、iPhone 14 Pro Max(Continuity Camera)、iPhone 11(Iriun)の3台が混在する環境で、OpenCV の VideoCapture index は起動毎に変わる。決定的にいえば「2番が上カメラだ」と書けない。デバイス名取得もindex順とは対応しない。これも結局、起動時にフレーム内容で識別するしかなかった。
💡 Key Takeaway
横カメラを動的追従ループに組み込むため、検出パイプラインを「上向き(青3点幾何)」と「前向き(緑2点)」の2系統に分割した。Z方向収束が止まる根本原因は、上カメラからの単一ピクセル空間ではZの分解能が不足していたことで、横カメラはその欠落軸を埋めるためだった。実装にあたっては、macOS の OpenCV VideoCapture index が起動毎に変動するという既知の問題に加えて、横カメラ視野では爪の wrist 側の青シールが本体に隠れて2点しか見えないという物理制約があり、既存の青3点幾何検出関数(detect_tip_from_frame)は構造的に流用不可能と確定した。最終的に TIP の定義は「緑シール2点(爪前面)の中点」に到達し、実機での tip_pixel.Y が緑Y平均と完全一致して掴み高さに整合した。
発生した問題 | 現場判断 | 結果 |
|---|---|---|
MacBook内蔵・iPhone 14 Pro Max・iPhone 11 の3台のカメラからどれが横カメラかを起動時に識別する手段がない。OpenCV index は非決定的、AVFoundation のデバイス名取得は index 順と対応しないと判明 | 物理側にマーカーを足して「映っている色のパターン」でカメラを識別する設計に切り替えた。爪上面に青シール、爪前面に緑シールを貼り、起動時の最初のフレームで色を数える | auto_detect_cameras.py を実装。blue≥2 かつ green==0 → 上カメラ、blue≥2 かつ green≥2 → 横カメラと判定 |
横カメラの単体テストで既存の青3点幾何検出関数 detect_tip_from_frame を流用しようとしたが、横カメラ視野では wrist 側の青シールが爪本体に隠れて2点しか映らず、関数は (None, None, None) を返した | 既存関数は構造的に流用不可と確定。横カメラ用の独立した検出関数を新規実装する方針に切り替えた | side_camera_utils.py に detect_tip_side() を新規実装。auto_detect_cameras 側の HSV 閾値・モルフォロジー処理・bottom-2 ピックを import で共有し、検出ロジックの重複ゼロを維持した |
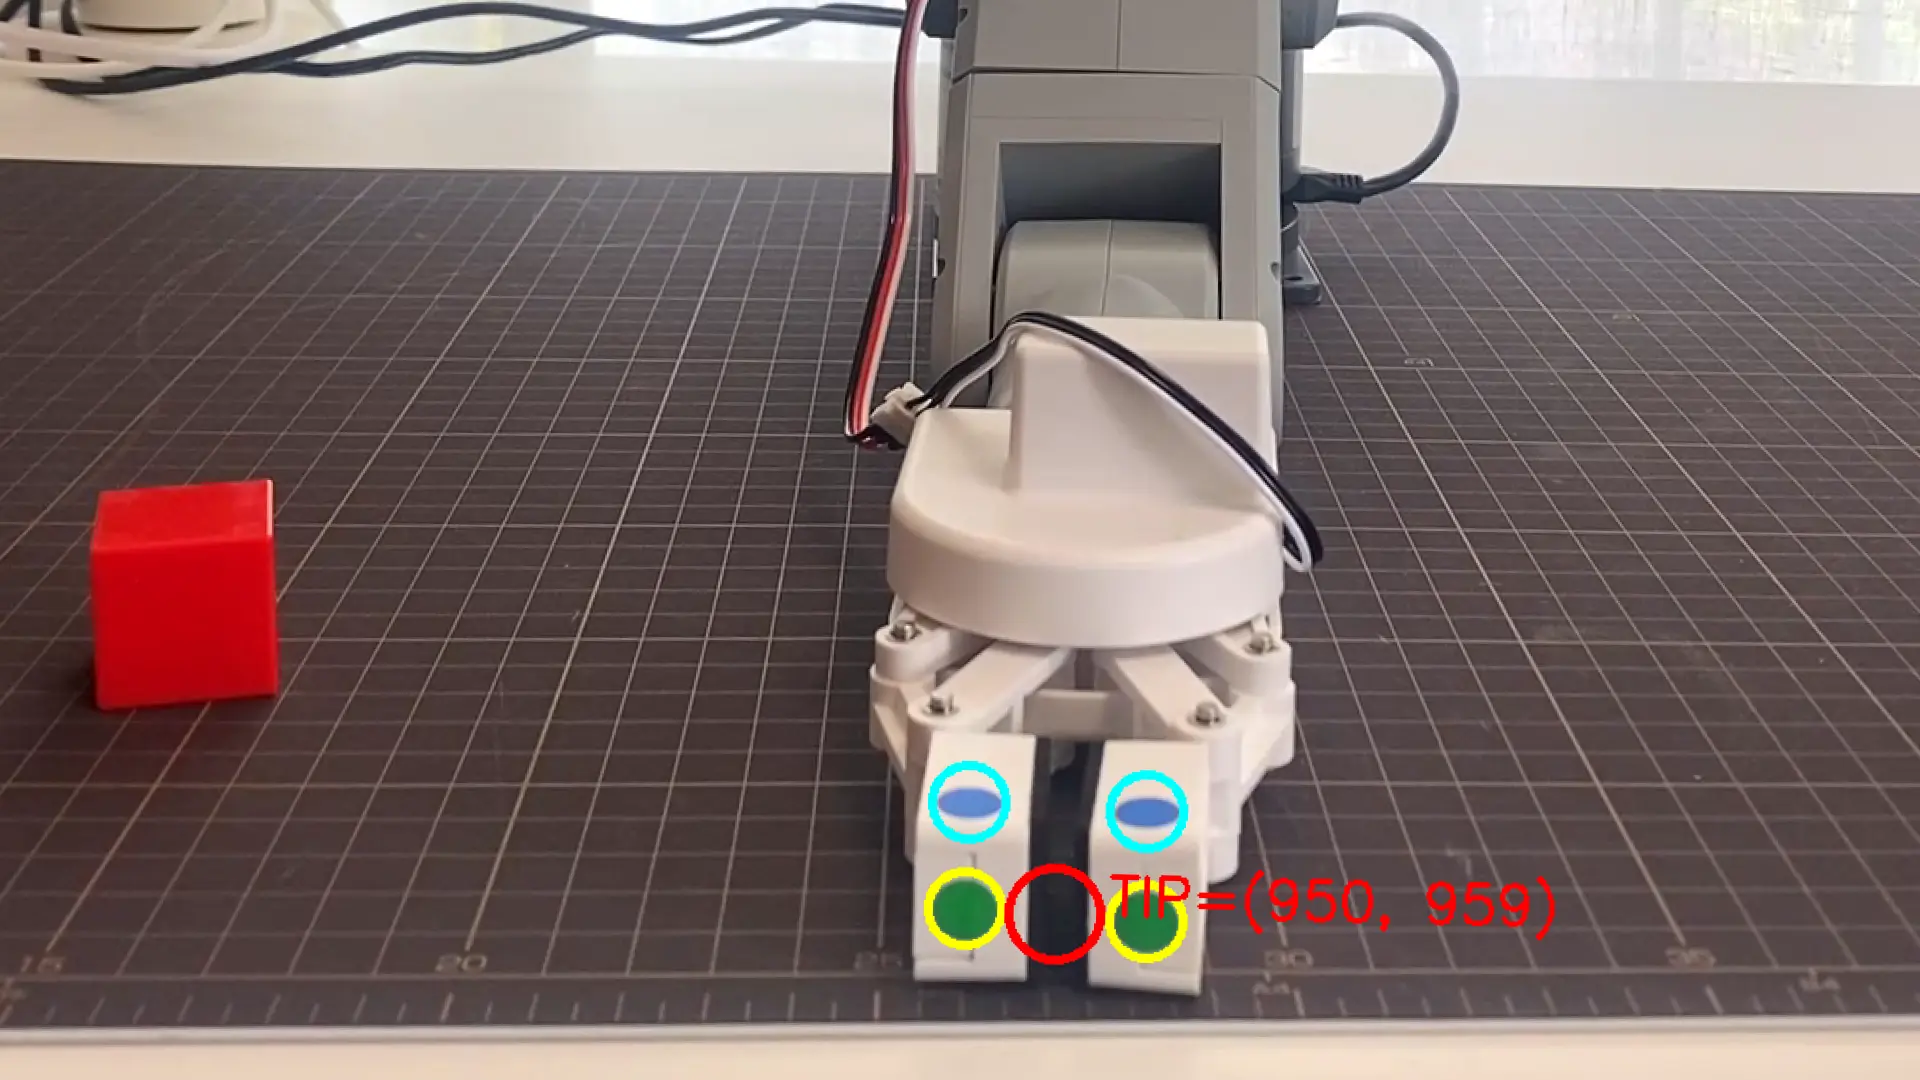
TIP の Y 位置を「左爪と右爪それぞれの青と緑の縦中点、のさらに中点」と定義したところ、実機 PNG では TIP が爪の上下中央にプロットされ、ブロックを実際に掴む高さ(爪先端寄り)と一致していなかった | 緑シールが爪の下端寄り(=掴み高さ)に貼ってあるという物理配置を基準に、TIP の定義を「緑2点の中点」だけに切り替えた。青2点検出は妥当性チェックとして残し、両方検出できたフレームでのみ TIP を返す | tip_pixel = (950, 959)。Y=959 は緑Y平均と完全一致。実機 PNG で TIP が緑シールの中点(爪先端寄り)にプロットされ、掴み高さに整合した |
なぜ横カメラを足すのか
動的追従が止まる場所を、もう一度確認する。
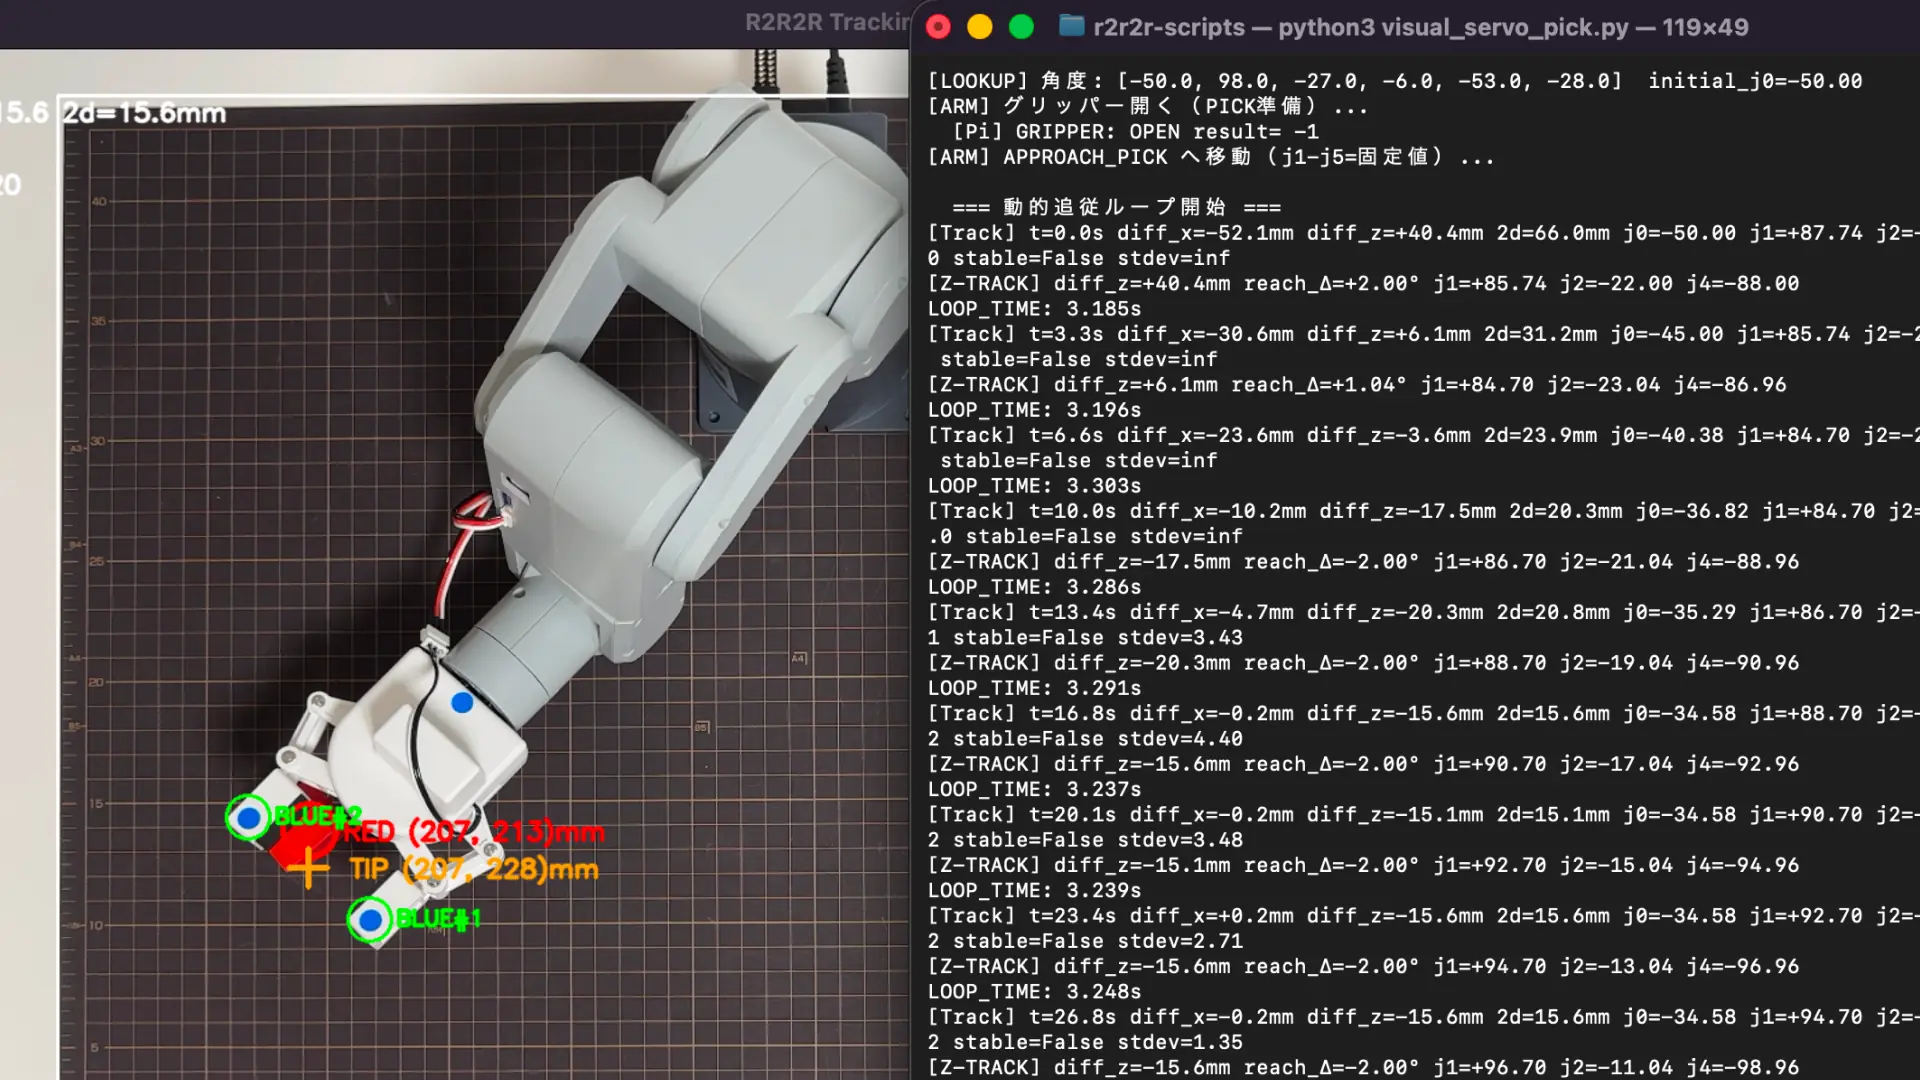
Log#6 で動的追従ループが初めて収束したとき、Z方向は j1+j2+j4 の同方向3関節連動で動かしていた。Z符号反転を入れて、Pi 側に常駐デーモンを建てて、TCP socket で送る構造にして、ようやく 2D 距離 2.9mm で止まった。あれは「止まる動き」を初めて作れた瞬間だった。
ただ、よく見るとX方向とZ方向で挙動が違っていた。Xはピタッと止まる。Zは止まる位置がブロック毎に少しずつズレる。差分の絶対値は小さいが、傾向としては「収束した」とは言いにくい揺らぎが残っていた。
原因の仮説は2つあった。
1つ目は3関節連動の機構的非対称性。Log#6 のキャリブで sign=+1 と sign=-1 で 12.64mm と 10.82mm という 17% の非対称があった。バックラッシュかヒステリシスの可能性。
2つ目はカメラ側のZ分解能不足。上カメラ1台で「赤ブロックの Unity 座標 (x, z)」を出す現在の構造では、画像上の y 軸方向への変位がそのまま Z+ 方向の物理距離になる。homography は Z=0 平面(マット面)を仮定しているので、爪が浮いている分だけ視差が乗る。具体的に言うと、爪が空中にあるとき、その爪の TIP を「マット面に投影した位置」として読んでいる。物理的には爪はマット面より上にあるので、上カメラから見たTIP の見かけ位置は、本当の爪先端より少し奥側(カメラから遠い側)にズレる。動的追従のループはこのズレ込みの値を「現在のTIP位置」だと思って動かしているので、Z方向は構造的に少しずつ嘘の差分に向かって動いていることになる。
仮説2が当たっていれば、上カメラを増やしてもZ方向の収束精度は上がらない。必要なのは「Zを独立に観測できるカメラ」、つまり横カメラだ。横から見れば、爪が浮いている高さ Y は y 座標として直接読める。homography の制約を受けない。
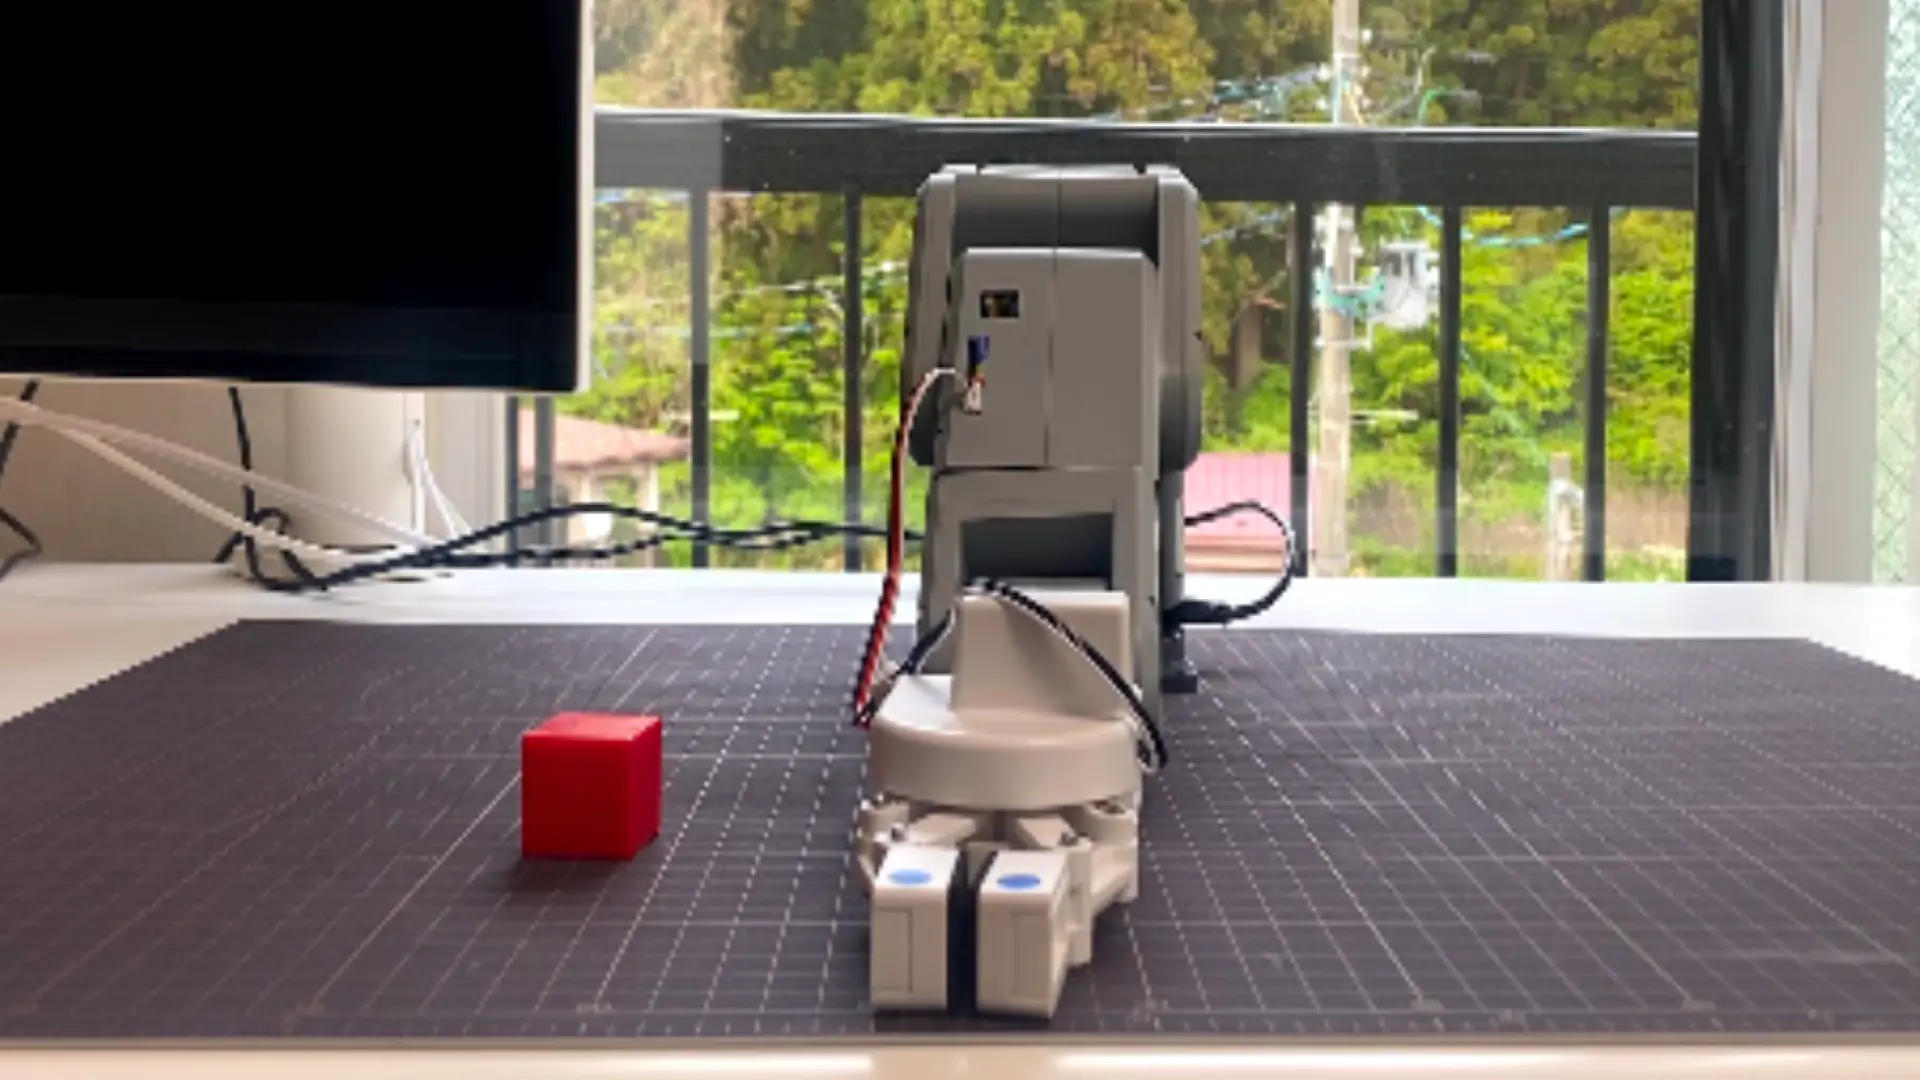
Log#10 でその横カメラを物理的に立てた。iPhone 11 を三脚に固定し、レンズが爪の正面を向くように調整し、Iriun Webcam で macOS の OpenCV から読める状態まで持ち込んだ。机のレベルの取り直し、机が揺れる対策、爪との距離出し、ピント、すべて手作業の物理側の仕事で、ソフトには触れずに終えた。
Log#11 はそこからスタートする。物理は立っている。あとは検出パイプラインに組み込めばいい——と思っていたところに、最初の壁があった。
3台のカメラから「どれが何か」を起動時に決める
物理側のセットアップが終わった段階で、macOS の OpenCV からはこういう状態になっている。
MacBook内蔵 FaceTime HD カメラ
iPhone 14 Pro Max(Continuity Camera)  ← 上カメラ
iPhone 11(Iriun Webcam)              ← 横カメラ
3台。これを cv2.VideoCapture(0) cv2.VideoCapture(1) cv2.VideoCapture(2) で開いていく。問題は、どの index がどのカメラかが起動毎に変わることだ。
過去にも Log#7 系の作業で「index が 1 から 2 に変わっていた」というケースに当たった(LOG168 と LOG188)。あのときは「ブライトネスで Iriun を判定する」というロジックを書いて切り抜けた。Iriun は明るく写る、Mac内蔵は暗く写る、という特性差を使った。
ただ今回は3台あり、しかも「上カメラ」と「横カメラ」を区別する必要がある。両方とも iPhone のカメラなので、ブライトネスではほぼ同じ。シャープネスや色温度で差はあるかもしれないが、起動毎に確実な判別ロジックを書けるほどの一貫した差はない。
最初は AVFoundation のデバイス名取得を試した。
# 確認スクリプト:AVFoundation のデバイス名を直接取れるか
import subprocess
result = subprocess.run(
    ["ffmpeg", "-f", "avfoundation", "-list_devices", "true", "-i", ""],
    capture_output=True, text=True
)
print(result.stderr)
実行すると ffmpeg のデバイス列挙は取れた。が、得られる順序が cv2.VideoCapture(i) の i 順と対応しない。AVFoundation のデバイス順序付けは内部仕様で、cv2 側がそれをどうマッピングしているかが公開されていない。試しに名前ベースでマッピングを書いても、起動毎にずれた。確定情報として、AVFoundation のデバイス順と OpenCV の index 順は対応しないと判明した。
解像度判定も試した。
cap = cv2.VideoCapture(i)
ret, frame = cap.read()
if ret:
    print(f"index={i} shape={frame.shape}")
3台とも 1920x1080 になり得る。MacBook 内蔵は本来 1280x720 のはずだが、OpenCV側で 1920x1080 にスケーリングされて返ることがある。これも判定軸として使えない。
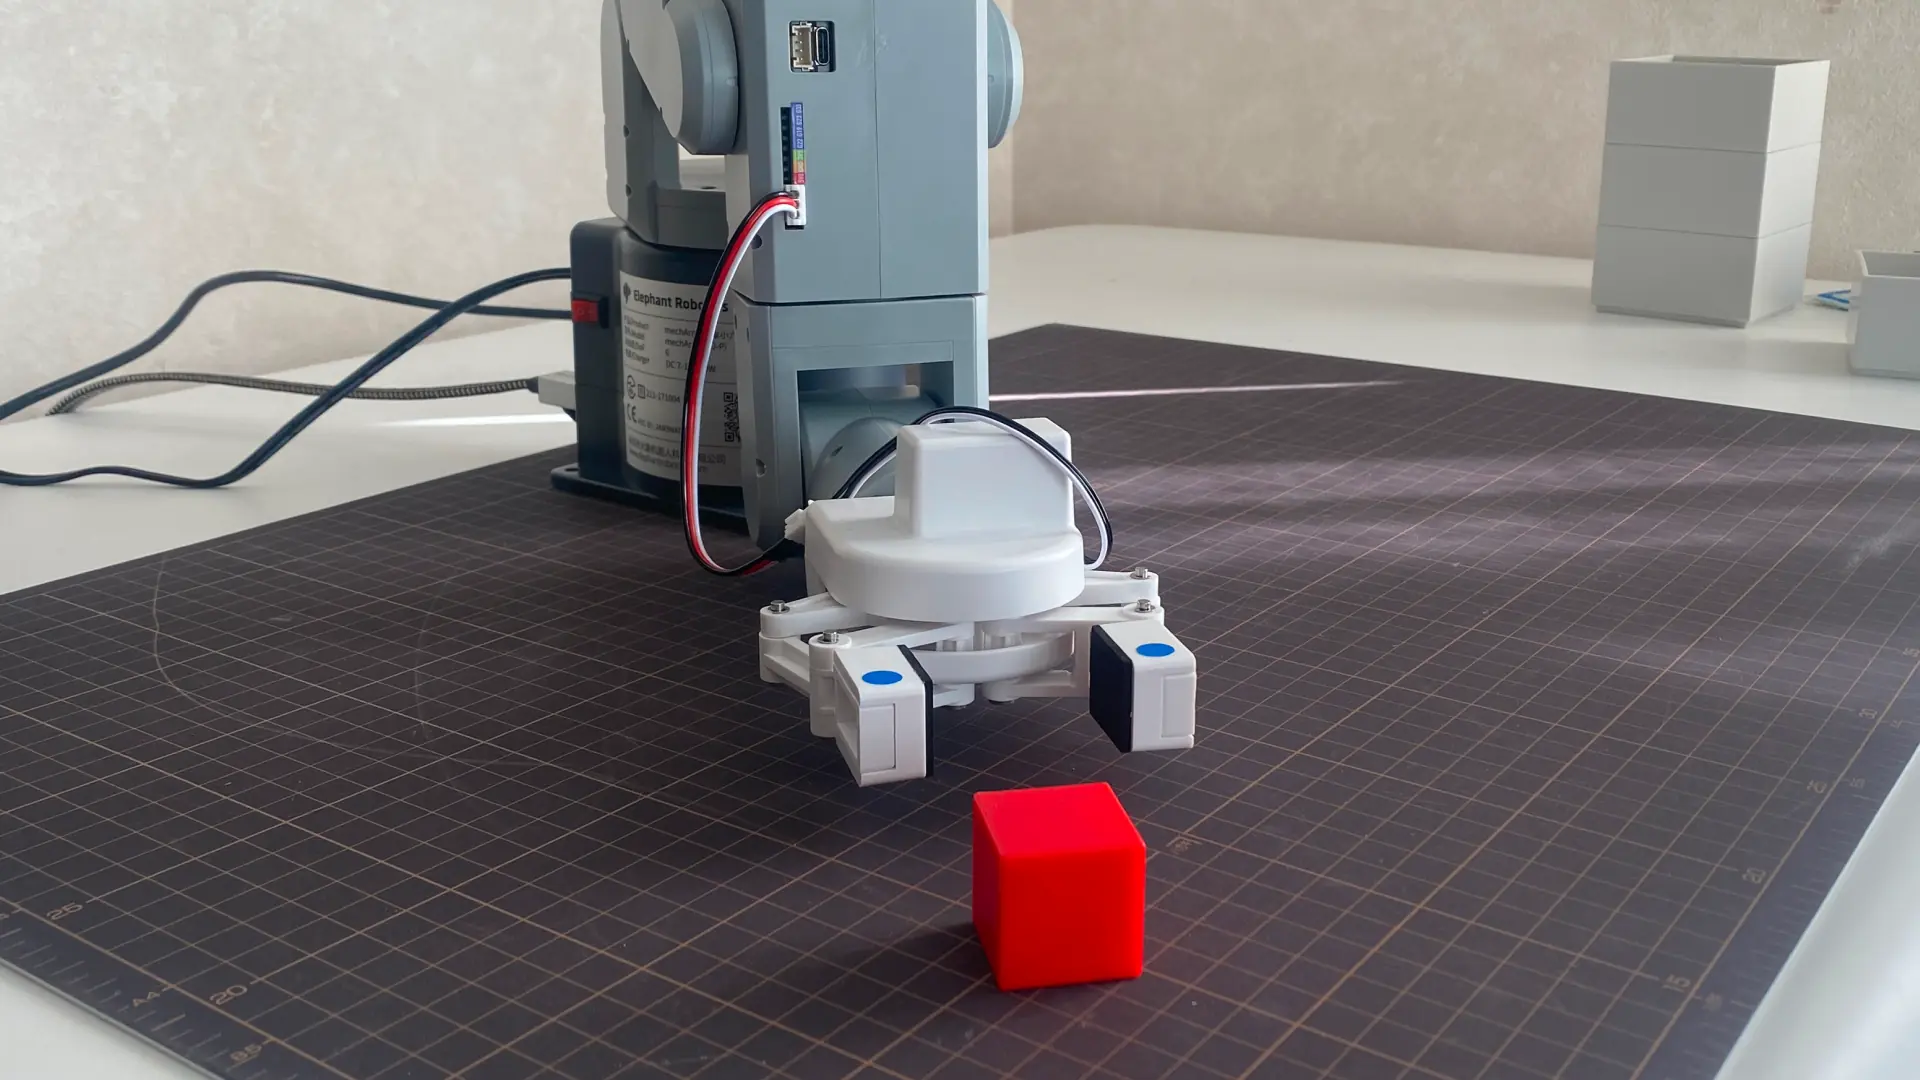
ここで方針を切り替えた。ソフトの判定ロジックに固執するのをやめて、シールを貼る。物理で解決する。爪の上面に青シール、爪の前面に緑シールを貼る。すると:
上カメラ:爪を真上から見るので青シール(上面)が3点見える。緑シール(前面)は画角に入らない
横カメラ:爪を前から見るので緑シール(前面)が2点見える。青シール(上面)は claw_a と claw_b の2点が見える(wrist 側の3点目は爪本体に隠れる)
MacBook内蔵:そもそも爪を映していないので、青も緑も検出されない
色のパターンでカメラを識別する設計に切り替えた。これなら「映っているものが何か」という最も信頼性の高い情報で判別できる。
auto_detect_cameras.py の実装
新規ファイル auto_detect_cameras.py を作る。Claude Code に依頼して、HSV閾値・モルフォロジー処理・面積フィルタ・bottom-2 ピックまでを含む193行のスクリプトを生成した。フルコードは下記。
#!/usr/bin/env python3
"""
auto_detect_cameras.py — DAY196

3台のカメラ(MacBook内蔵、iPhone 14 Pro Max / Continuity、iPhone 11 / Iriun)から
上カメラと横カメラの OpenCV index を起動時に判定する。

判定ロジック:
  - 青シール(爪上面)と緑シール(爪前面)の検出個数で識別
  - blue >= 2 かつ green == 0  → 上カメラ
  - blue >= 2 かつ green >= 2  → 横カメラ
  - その他                     → 除外
"""

import cv2
import numpy as np
import os
import time

# ---- 設定 -----------------------------------------------------------------
MAX_CAMERA_INDEX = 5            # 0〜4 まで探索
WARMUP_FRAMES = 30              # カメラの自動露出が安定するまでの空読み
MIN_AREA = 80                   # シール検出の最小面積(px²)
MAX_AREA = 8000                 # シール検出の最大面積(px²)

# HSV閾値(OpenCV: H=0〜179, S/V=0〜255)
BLUE_HSV_LOW  = np.array([100, 100,  50])
BLUE_HSV_HIGH = np.array([130, 255, 255])
GREEN_HSV_LOW  = np.array([35,  80,  60])
GREEN_HSV_HIGH = np.array([85, 255, 255])

# モルフォロジー
MORPH_KERNEL = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (5, 5))

# デバッグ出力
DEBUG_DIR = os.path.join(
    os.path.dirname(os.path.abspath(__file__)),
    "logs", "debug_frames",
)


def _morph_mask(mask):
    """openで小ノイズを消し、closeでシールの穴を埋める。"""
    mask = cv2.morphologyEx(mask, cv2.MORPH_OPEN, MORPH_KERNEL)
    mask = cv2.morphologyEx(mask, cv2.MORPH_CLOSE, MORPH_KERNEL)
    return mask


def _centers_from_mask(mask):
    """マスク内の連結成分を面積でフィルタし、中心(x, y)のリストを返す。"""
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    centers = []
    for cnt in contours:
        area = cv2.contourArea(cnt)
        if area < MIN_AREA or area > MAX_AREA:
            continue
        M = cv2.moments(cnt)
        if M["m00"] == 0:
            continue
        cx = int(M["m10"] / M["m00"])
        cy = int(M["m01"] / M["m00"])
        centers.append((cx, cy))
    return centers


def _count_blue_markers(frame):
    hsv = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
    mask = cv2.inRange(hsv, BLUE_HSV_LOW, BLUE_HSV_HIGH)
    mask = _morph_mask(mask)
    return _centers_from_mask(mask)


def _count_green_markers(frame):
    hsv = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
    mask = cv2.inRange(hsv, GREEN_HSV_LOW, GREEN_HSV_HIGH)
    mask = _morph_mask(mask)
    return _centers_from_mask(mask)


def _annotate(frame, blue_centers, green_centers):
    """検出結果を画像上に円で描画する。"""
    out = frame.copy()
    for (x, y) in blue_centers:
        cv2.circle(out, (x, y), 18, (255, 200, 0), 2)    # 水色
    for (x, y) in green_centers:
        cv2.circle(out, (x, y), 18, (0, 255, 255), 2)    # 黄色
    return out


def _save_debug_frames(idx, frame, blue_centers, green_centers):
    os.makedirs(DEBUG_DIR, exist_ok=True)
    raw_path = os.path.join(DEBUG_DIR, f"auto_detect_cam{idx}.png")
    ann_path = os.path.join(DEBUG_DIR, f"auto_detect_cam{idx}_annotated.png")
    cv2.imwrite(raw_path, frame)
    annotated = _annotate(frame, blue_centers, green_centers)
    cv2.imwrite(ann_path, annotated)


def auto_detect_cameras(save_debug_frames=True):
    """
    起動時に index 0〜4 を順に開き、青/緑シールのパターンでカメラを識別する。

    Returns:
        dict: {"top_camera": int or None, "side_camera": int or None}

    Raises:
        RuntimeError: 上カメラまたは横カメラがいずれも見つからなかったとき
    """
    top_index = None
    side_index = None

    for idx in range(MAX_CAMERA_INDEX):
        cap = cv2.VideoCapture(idx)
        if not cap.isOpened():
            cap.release()
            continue

        # warmup: 自動露出が安定するまで空読み
        for _ in range(WARMUP_FRAMES):
            cap.read()

        ret, frame = cap.read()
        if not ret or frame is None:
            cap.release()
            continue

        blue_centers = _count_blue_markers(frame)
        green_centers = _count_green_markers(frame)
        cap.release()

        if save_debug_frames:
            _save_debug_frames(idx, frame, blue_centers, green_centers)

        n_blue = len(blue_centers)
        n_green = len(green_centers)
        print(
            f"[CAMERA] index={idx}: blue={n_blue}, green={n_green}",
            end=" → ",
        )

        if n_blue >= 2 and n_green == 0:
            if top_index is None:
                top_index = idx
                print("上カメラと判定")
            else:
                print("青のみだが上カメラは既に確定済み、除外")
        elif n_blue >= 2 and n_green >= 2:
            if side_index is None:
                side_index = idx
                print("横カメラと判定")
            else:
                print("青+緑だが横カメラは既に確定済み、除外")
        else:
            print("除外")

        # 両方確定したら早期終了
        if top_index is not None and side_index is not None:
            break

    if top_index is None:
        raise RuntimeError(
            "上カメラが見つかりません(青ありのカメラがゼロ)"
        )
    if side_index is None:
        raise RuntimeError(
            "横カメラが見つかりません(青あり・緑ありのカメラがゼロ)"
        )

    return {"top_camera": top_index, "side_camera": side_index}


if __name__ == "__main__":
    print("=" * 60)
    print("auto_detect_cameras 単体テスト")
    print("=" * 60)
    result = auto_detect_cameras(save_debug_frames=True)
    print()
    print(f"上カメラ index: {result['top_camera']}")
    print(f"横カメラ index: {result['side_camera']}")
設計でこだわった点は3つ。
① warmup_frames=30
Iriun は WiFi 経由でフレームを送ってくる構造上、cv2.VideoCapture を開いた直後の数フレームは真っ黒だったり、自動露出が暗い値から始まったりする。30フレーム空読みすれば、おおむね安定する。
② open → close の順序
HSV のモルフォロジー処理は open → close の順で入れた。open(収縮→膨張)でノイズを消してから、close(膨張→収縮)でシールの穴を埋める。逆だと、ノイズが拡大されたあとに穴埋めをすることになり、誤検出が増える。
③ 面積フィルタ MIN_AREA=80, MAX_AREA=8000
1920x1080 のフレームで、約 9〜90px 四方の領域だけを通す。爪のシール(直径 10〜15mm 程度)が爪との距離 200〜400mm から見えるサイズ感に合わせた。
そして判定ロジックの非対称性が一つある。blue >= 2 は上カメラの「青3点見えるはず」よりも緩い条件にしている。これは「青3点目が稀に検出失敗したフレーム」でも上カメラとして識別できるようにするため。逆に上カメラを「青3点ジャスト」で判定すると、wrist のシールが手ブレで一瞬隠れただけで識別が落ちる。横カメラ側は逆で、「緑2点ジャスト」も「緑3点」(誤検出含む)も両方を受ける。ここでも「両方が同時に検出される」というのが本質的な弁別条件で、個数のジャストネスではない。
既存の青3点幾何検出は流用できない
カメラの index 判定がついた。次は「横カメラからの TIP 検出」を組む段階。
ここで一旦、設計の確認をした。Log#6 までの動的追従は、上カメラからのTIP検出関数 detect_tip_from_frame(frame) を使っている。実装は visual_servo_pick.py の line 467 にある。中身は青シール3点の幾何配置から TIP を計算する。具体的には:
claw_a(左爪の青シール)
claw_b(右爪の青シール)
wrist(手首側の青シール、3点目)
この3点の幾何関係から、爪の中央点と向きを推定し、Unity 座標上での TIP を返す。stdev は 0.08mm という非常に高い精度。再実装するのは無駄なので、横カメラ側でも同じ関数を流用できないかを最初に確認した。
確認用に、関数の挙動を観察するだけの仕様確認スクリプトを書いた。実行と検出だけして、結果を表示・保存する。
#!/usr/bin/env python3
"""
test_side_camera_tip_detection.py — DAY196

既存の detect_tip_from_frame(frame) を横カメラのフレームに適用したときの
返り値を観察するだけの仕様確認スクリプト。
visual_servo_pick.py は変更しない。
"""

import cv2
import os
import sys

# auto_detect_cameras から横カメラ index を取得
from auto_detect_cameras import auto_detect_cameras

# visual_servo_pick.py から既存関数だけ import
sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))
from visual_servo_pick import detect_tip_from_frame

OUT_PATH = os.path.join(
    os.path.dirname(os.path.abspath(__file__)),
    "logs", "debug_frames", "test_side_camera_tip_frame.png",
)


def main():
    print("[1] auto_detect_cameras で横カメラ index を取得...")
    result = auto_detect_cameras(save_debug_frames=False)
    side_index = result["side_camera"]
    print(f"   横カメラ index: {side_index}")

    print(f"[2] index {side_index} から1フレーム取得...")
    cap = cv2.VideoCapture(side_index)
    # warmup
    for _ in range(15):
        cap.read()
    ret, frame = cap.read()
    cap.release()
    if not ret or frame is None:
        print("[NG] フレーム取得失敗")
        return
    print(f"   フレーム取得成功: shape={frame.shape}")

    print("[3] detect_tip_from_frame(frame) に渡す...")
    try:
        result = detect_tip_from_frame(frame)
        print("   [OK] 関数が完走しました")
        print(f"   戻り値: {result}")
        print(f"   戻り値の型: {type(result).__name__}")
        tip_pixel, blue_markers, tip_unity = result
        n_blue = len(blue_markers) if blue_markers is not None else None
        print(f"     tip_pixel = {tip_pixel}")
        print(f"     blue_markers = {blue_markers} (len={n_blue})")
        print(f"     tip_unity   = {tip_unity}")
        if tip_pixel is None:
            print("   → 青3点未満で TIP 未確定(None 返却の想定挙動)")
    except Exception as e:
        print(f"   [NG] 例外: {type(e).__name__}: {e}")

    print(f"[4] フレーム保存: {OUT_PATH}")
    os.makedirs(os.path.dirname(OUT_PATH), exist_ok=True)
    cv2.imwrite(OUT_PATH, frame)


if __name__ == "__main__":
    main()
実行結果は次のようになった。
[1] auto_detect_cameras で横カメラ index を取得...
   横カメラ index: 1
[2] index 1 から1フレーム取得...
   フレーム取得成功: shape=(1080, 1920, 3)
[3] detect_tip_from_frame(frame) に渡す...
   [OK] 関数が完走しました
   戻り値: (None, None, None)
   戻り値の型: tuple
     tip_pixel = None
     blue_markers = None (len=None)
     tip_unity   = None
   → 青3点未満で TIP 未確定(None 返却の想定挙動)
[4] フレーム保存: /Users/shimazueiichi/r2r2r-scripts/logs/debug_frames/test_side_camera_tip_frame.png
確定情報が3つ出た。
1つ目、detect_tip_from_frame は青3点未満のとき例外を投げず (None, None, None) を静かに返す。これは関数の仕様として正しい挙動だが、流用の文脈では「呼んでも何も返ってこない関数」になる。
2つ目、横カメラのフレームでは青2点しか検出されない。これは事前に物理側で確認していた通り。wrist 側の青シールは、横から見ると爪本体(claw_a と claw_b の間にあるグリッパー本体)の影に隠れる。視野角の問題ではなく、爪の物理的な構造による隠蔽。
3つ目、関数名の食い違いを発見した。記憶では detect_tip_blue_geometry だったが、実装上は detect_tip_from_frame(visual_servo_pick.py line 467)。これは過去のメモリ更新で名前が変わったか、最初から記憶ベースの呼称だったかのどちらか。今後の参照では detect_tip_from_frame に統一する。
結局、横カメラ用には新規関数を書く。既存の青3点幾何は構造的に流用できない。
視覚的には最初からわかっていた。青シールが2点しか写ってない PNG を見れば、3点幾何の関数が機能しないのは目で見える。でも、戻り値で残す。「(None, None, None) が返った」と紙に書く。修正や設定変更を一度もせずに関数を呼んで、結果を見て、それを記録する。これが Log#6 から繰り返している「測れる手段を持つことが推論より先にくる」という P008 の運用形だ。
side_camera_utils.py の実装
横カメラ用の TIP 検出関数 detect_tip_side(frame) を書く。新規ファイル side_camera_utils.py を作り、auto_detect_cameras 側のヘルパー関数(青検出・緑検出・モルフォロジー処理)を import で共有する。HSV 閾値を複数ファイルにコピペすると、後で片方だけ調整したときに分岐が生じる。流用できるものは全部流用する。
最初の実装では、TIP の定義を「左爪と右爪それぞれの青と緑の縦中点、のさらに中点」とした。下記がその初期版。
# 初期版(v2)— 左右爪中点ロジック
def detect_tip_side(frame):
    blue_centers = _count_blue_markers(frame)
    green_centers = _count_green_markers(frame)

    if len(blue_centers) < 2:
        return None, None, None
    if len(green_centers) < 2:
        return None, blue_centers, None

    # X座標昇順で左右を識別
    blue_sorted = sorted(blue_centers, key=lambda p: p[0])
    green_sorted = sorted(green_centers, key=lambda p: p[0])

    blue_left, blue_right = blue_sorted[0], blue_sorted[1]
    green_left, green_right = green_sorted[0], green_sorted[1]

    # 左爪の中点(青と緑の縦中点)
    left_mid_x = (blue_left[0] + green_left[0]) // 2
    left_mid_y = (blue_left[1] + green_left[1]) // 2
    # 右爪の中点
    right_mid_x = (blue_right[0] + green_right[0]) // 2
    right_mid_y = (blue_right[1] + green_right[1]) // 2

    # 左右爪中点のさらに中点
    tip_x = (left_mid_x + right_mid_x) // 2
    tip_y = (left_mid_y + right_mid_y) // 2

    return (tip_x, tip_y), blue_centers, None
これで実行した。結果:
tip_pixel:     (950, 929)
blue_markers: [(999, 902), (903, 898)]
  → 検出点数: 2
green_centers: [(1000, 962), (901, 957)]
  → 緑検出点数: 2
検出は成功している。Y=929 という値が出た。
可視化 PNG を見ると、赤い円(TIP)が爪の上下ちょうど中央にプロットされていた。直感的にはこれが「爪の中央点」だが、ブロックを実際に掴む高さとは違う。爪の先端は緑シールの位置(Y=959 付近)。爪の上面の青シール位置(Y=900 付近)は、実は爪の上面の高さで、ブロックには接触しない領域だ。
TIP を「爪の上下中央」と定義すると、動的追従ループでは「爪の中央点をブロック位置に合わせる」動きになる。一方、ブロックを実際に掴む高さは爪の下端寄り(緑シールの位置)。両者は機械的に約 30px ずれている。1920x1080 のピクセル空間で 30px は、Z 方向への投影に直すと約 5〜8mm のズレに相当する。動的追従の収束を 5mm 以内に持っていきたいときに、この 5〜8mm のオフセットは無視できない。
TIP の定義を変更する。
バージョン | TIP定義 | Y値 | 問題 |
|---|---|---|---|
v1 | 青2点中点 | ≈ 900 | 爪の上面で、掴み高さに届かない |
v2 | 左爪(青+緑/2) と 右爪(青+緑/2) の中点 | ≈ 929 | 爪の上下中央。まだ青寄り |
v3 | 緑2点の中点 | ≈ 959 | 爪先端寄りの掴み高さ |
v3 に切り替える。青2点検出はそのまま残し、「両方検出できたフレームでのみ TIP を返す」という妥当性チェックの役割を担わせる。これで「青も緑も検出できている、つまり横カメラが正しく爪を捉えている」という条件を維持しつつ、TIP の位置だけを緑寄りにできる。
最終版の side_camera_utils.py フルコード:
#!/usr/bin/env python3
"""
side_camera_utils.py — DAY196

横カメラ(iPhone 11 / Iriun)用の TIP 検出ユーティリティ。

TIP は緑シール2点(爪前面)の中点として返す。
青シール(爪上面)2点は検出妥当性チェックとして使う。
青2点・緑2点どちらか欠けた場合は TIP 未確定として
(None, blue_markers, None) を返す。

HSVマスク・モルフォロジー・面積フィルタは auto_detect_cameras から import して共有。
"""

import cv2
import os

# HSV閾値・モルフォロジー処理・bottom-2 ピックを auto_detect_cameras から流用
from auto_detect_cameras import (
    _count_blue_markers,
    _count_green_markers,
    auto_detect_cameras,
)

DEBUG_DIR = os.path.join(
    os.path.dirname(os.path.abspath(__file__)),
    "logs", "debug_frames",
)
DEBUG_PATH = os.path.join(DEBUG_DIR, "test_detect_tip_side.png")


def _pick_bottom_two(points):
    """
    Y座標が大きい2点を選んで返す(横カメラの爪の下端寄りを優先)。
    点が2点未満ならそのまま返す。
    """
    if len(points) <= 2:
        return list(points)
    return sorted(points, key=lambda p: p[1], reverse=True)[:2]


def detect_tip_side(frame):
    """
    横カメラのフレームから TIP(爪先)の pixel 位置を計算する。

    TIP は緑シール2点(爪前面)の中点として返す。
    青シール(爪上面)2点は検出妥当性チェックとして使う。
    青2点・緑2点どちらか欠けた場合は TIP 未確定として
    (None, blue_markers, None) を返す。

    Args:
        frame: BGR フォーマットの ndarray (H, W, 3)

    Returns:
        tuple (tip_pixel, blue_markers, tip_yz_mm)
          tip_pixel:    (x, y) の int タプル。未確定時 None
          blue_markers: 検出された青シール中心の list[(x, y)]。未検出時 None
          tip_yz_mm:    座標系変換は別タスク。常に None
    """
    blue_centers_all = _count_blue_markers(frame)
    green_centers_all = _count_green_markers(frame)

    # 青検出は妥当性チェック
    if len(blue_centers_all) < 2:
        return None, None, None

    # Y座標下端寄りの2点を採用(爪先端寄りの青)
    blue_centers = _pick_bottom_two(blue_centers_all)

    # 緑検出は TIP の本体
    if len(green_centers_all) < 2:
        return None, blue_centers, None

    green_centers = _pick_bottom_two(green_centers_all)

    # X座標昇順で左右を識別
    green_sorted = sorted(green_centers, key=lambda p: p[0])
    green_left, green_right = green_sorted[0], green_sorted[1]

    # TIP = 緑2点の中点
    tip_x = (green_left[0] + green_right[0]) // 2
    tip_y = (green_left[1] + green_right[1]) // 2

    return (tip_x, tip_y), blue_centers, None


def _annotate_test(frame, tip_pixel, blue_centers, green_centers):
    """単体テスト用の可視化。青=水色、緑=黄色、TIP=赤。"""
    out = frame.copy()
    if blue_centers is not None:
        for (x, y) in blue_centers:
            cv2.circle(out, (x, y), 22, (255, 200, 0), 2)
    if green_centers is not None:
        for (x, y) in green_centers:
            cv2.circle(out, (x, y), 22, (0, 255, 255), 2)
    if tip_pixel is not None:
        tx, ty = tip_pixel
        cv2.circle(out, (tx, ty), 26, (0, 0, 255), 3)
        cv2.putText(
            out,
            f"TIP=({tx}, {ty})",
            (tx + 30, ty + 8),
            cv2.FONT_HERSHEY_SIMPLEX,
            1.2,
            (0, 0, 255),
            2,
            cv2.LINE_AA,
        )
    return out


if __name__ == "__main__":
    print("=" * 60)
    print("detect_tip_side 単体テスト")
    print("=" * 60)

    cams = auto_detect_cameras(save_debug_frames=False)
    side_index = cams["side_camera"]
    print(f"横カメラ index: {side_index}")

    cap = cv2.VideoCapture(side_index)
    # warmup
    for _ in range(15):
        cap.read()
    ret, frame = cap.read()
    cap.release()

    if not ret or frame is None:
        print("[NG] フレーム取得失敗")
        raise SystemExit(1)

    print(f"フレーム取得: shape={frame.shape}")
    print()

    tip_pixel, blue_markers, tip_yz_mm = detect_tip_side(frame)

    print(f"tip_pixel:    {tip_pixel}")
    print(f"blue_markers: {blue_markers}")
    if blue_markers is not None:
        print(f"  → 検出点数: {len(blue_markers)}")

    # 緑も観察用に表示
    green_centers_all = _count_green_markers(frame)
    green_centers = _pick_bottom_two(green_centers_all)
    print(f"green_centers: {green_centers}")
    print(f"  → 緑検出点数: {len(green_centers)}")

    print(f"tip_yz_mm:    {tip_yz_mm}  (座標系変換は別タスクのため常に None)")
    print()

    os.makedirs(DEBUG_DIR, exist_ok=True)
    annotated = _annotate_test(frame, tip_pixel, blue_markers, green_centers)
    cv2.imwrite(DEBUG_PATH, annotated)
    print(f"可視化 PNG 保存: {DEBUG_PATH}")
実装でこだわったのはこの2点。
1つ目、_pick_bottom_two を青にも緑にも適用した。横カメラの視野では、爪の下端寄りに貼ったシールが「Y座標が大きい」位置に映る。3点以上検出されたとき(誤検出や反射など)、Y座標が大きい2点を選ぶことで「爪先端寄りの確実な2点」を採用できる。これは万一のフェイルセーフで、通常は2点ジャストで返る。
2つ目、tip_yz_mm を常に None で返している。pixel から実空間 mm への変換(横カメラ用の homography 相当)は別タスク。今のセッションでは pixel ベースで TIP の検出ができることだけを確認する。Z軸 mm への変換式は、Log#12 以降でキャリブレーションを取って作る。先に変換式を入れると、検出ロジックの不具合とキャリブの不具合が混ざる。検出だけを単独で確証してから、変換を上に積む。
実機検証
最終版 side_camera_utils.py を実行した。連続実行で何度か RuntimeError: 横カメラが見つかりません で落ちたあと(後述)、明るい状態で安定して取れた回のターミナル出力は次のとおり。
============================================================
detect_tip_side 単体テスト
============================================================
横カメラ index: 1
フレーム取得: shape=(1080, 1920, 3)

tip_pixel:    (950, 959)
blue_markers: [(999, 902), (902, 899)]
  → 検出点数: 2
green_centers: [(1000, 962), (901, 957)]
  → 緑検出点数: 2
tip_yz_mm:    None  (座標系変換は別タスクのため常に None)

可視化 PNG 保存: /Users/shimazueiichi/r2r2r-scripts/logs/debug_frames/test_detect_tip_side.png
数値の整合:
緑2点の X 平均 = (1000 + 901) / 2 = 950.5 → 整数化で 950
緑2点の Y 平均 = (962 + 957) / 2 = 959.5 → 整数化で 959
tip_pixel = (950, 959) は完全に緑2点の中点と一致している。
可視化 PNG を開くと、赤い円(TIP)が緑2点の黄色い円のちょうど中点にプロットされ、それは爪先端寄りの位置だった。期待通り。
ちなみに、最初の v2(左右爪中点)で出ていた数値は tip_pixel=(950, 929) で、Y=929 は青Y平均=(902+898)/2=900 と緑Y平均=959.5 のさらに中点=(900+959.5)/2≈929.75 と整合していた。ロジックそのものは正しく動いていて、ただ「TIP の定義」が物理的な掴み位置とズレていただけ。検出関数の中身は変わっていない。
連続実行の不安定性
実機検証で1つだけ持ち越しの問題が出た。python3 side_camera_utils.py を連続で実行すると、約2/3の頻度で RuntimeError: 横カメラが見つかりません(青あり・緑ありのカメラがゼロ) で落ちる。
落ちたときのデバッグ PNG を見ると、横カメラ index のフレームが全体的に暗かった。露出が低い状態で warmup を抜けてしまっていて、青も緑も HSV 閾値の Value 下限(青=50、緑=60)を割り込んで、マスクから外れていた。
仮説は2つ立てた。
1つ目は Iriun + macOS の自動露出が、起動毎にリセットされて低い値から始まる、というもの。Iriun は WiFi 経由で iPhone のカメラ画像を流してくるが、cv2.VideoCapture を再オープンするたびにセッションがリセットされ、iPhone 側のカメラの自動露出も初期化される。warmup 30フレームでは追いつかないケースがある。
2つ目は物理側の照明条件。爪の正面方向にカーテン越しの窓があり、背景がかなり明るい。自動露出が背景の明るさに引っ張られて、爪を暗く写してしまう。室内灯を点けて背景との明度差を縮めると改善する。実機で確認すると、確かに室内灯ありの状態では成功率が大きく上がった。
仮説1への対策は warmup_frames を 30 → 60 か 120 に増やすこと、および cap.release() 後にスリープを 0.5〜1秒入れること。物理側だけで成功率を上げきれない場合は、コード側にも入れる。
仮説2への対策はカーテンを閉めるか、爪手前から弱い補助光を当てる。今回のセッションでは室内灯を点けるだけで安定して取れたので、撮影プロトコルを「実機検証時は室内灯ON」と明文化して持ち越した。
連続実行の不安定性は、Log#11 のスコープ(カメラ自動判定・横カメラ TIP 検出)には含まない。Log#12 の検証フェーズで実機を回し続ける段階で、再現性ベースで対策を入れる。
上カメラ側の誤検出の観察
auto_detect_cameras の debug frames を確認していて、もう一つ気づいたことがある。上カメラの index で blue >= 2 の判定はクリアしているが、デバッグ PNG を拡大すると、青検出が4点になるケースがあった。
爪の上面の青シール3点(claw_a, claw_b, wrist)に加えて、フレームの端のキーボード上の何か(マウスかクリップか、青みのある反射物)が4点目として検出されていた。
判定ロジック上は blue >= 2 を満たすので「上カメラ」として識別される。問題はその後だ。Log#6 までのループでは、上カメラから取ったフレームを detect_tip_from_frame に渡し、その関数が内部で青3点幾何を計算する。もし4点目(キーボード上のノイズ)が混ざると、3点幾何の計算が不安定になる可能性がある。
これは Log#12 で動的追従ループに横カメラを統合するときに、再度確認する。detect_tip_from_frame 側に「4点以上検出されたとき、爪領域(マット範囲内)でフィルタする」という処理を入れるか、検出後の点の分布を見て外れ値を除外するか。今のセッションでは観察のみ。修正しない。
流用と分割の使い分け
Log#11 で確定した設計上の判断は、もう一つある。「流用と分割の使い分け」だ。
横カメラ用の検出関数を書くにあたって、初期は「detect_tip_from_frame を拡張して、視野方向(top / side)を引数で受ける」案も考えた。1つの関数の中で if view == 'top': 青3点幾何 else: 緑2点中点 のような分岐を作る形。
採用しなかった。理由は2つある。
1つ目、検出ロジックの性質が違いすぎる。上カメラは青3点の幾何配置から TIP の向きまで推定できる関数で、戻り値が pixel + Unity座標 + 向き情報。横カメラは緑2点の中点だけを返す関数で、戻り値は pixel のみ(向き情報は出ない)。1つの関数の戻り値の形を統一しようとすると、片方は不要な None を毎回返すか、引数で形を切り替えるかになる。設計が複雑になる。
2つ目、Log#6 までの動的追従ループに既に組み込まれている detect_tip_from_frame を触ると、副作用が広がる。Log#11 のスコープを「横カメラを足す」だけに絞るには、既存関数に手を入れない方が安全。新規ファイル side_camera_utils.py に新規関数 detect_tip_side() を置くことで、既存ループを一切壊さずに「並列に検出パイプラインを増やす」構造にできる。
一方で、HSV閾値やモルフォロジー処理のような「環境依存のチューニング値」は import で共有する。これが分岐したら、後で片方だけ調整したときに整合性が壊れる。
分割するもの:検出ロジック全体(青3点幾何 vs 緑2点中点)
共有するもの:環境依存パラメータ(HSV閾値、面積フィルタ、モルフォロジー)
この使い分けが、Log#11 で生まれた構造的な判断として残った。Log#12 以降で動的追従ループに横カメラを統合するときも、同じ原則で「既存ループに横カメラの検出を並列に増やす」だけにする。既存ループのコードはほぼ触らずに、新しい分岐を上から足す。
このセッションが示したこと
Log#10 で物理側のセットアップを終え、Log#11 で検出パイプラインを2系統に分割した。具体的な成果は3つ。
1つ目、auto_detect_cameras.py によるカメラ役割の自動判定。macOS の OpenCV index が非決定的に変動する環境で、「映っている色のパターン」だけを根拠にカメラを識別する設計。3台のカメラから2台を正しく拾い、1台を除外する。
2つ目、既存の青3点幾何検出関数が横カメラに流用できないという確定。これは「やってみてダメだった」という観察で、推論ではない。修正や設定変更を一度もせず、関数を呼んで結果を見るだけで判定した。仕様確認スクリプト test_side_camera_tip_detection.py を残置することで、後で同じ確認をやり直す必要がない。
3つ目、横カメラ用の独立した TIP 検出関数 detect_tip_side()。緑2点(爪前面)の中点を TIP として返し、青2点(爪上面)は妥当性チェックとして残す。tip_pixel.Y が緑Y平均と完全一致して、掴み高さに整合した。
今回残った教訓は2つだ。
A. 検出ロジックは分割する、環境パラメータは共有する。HSV閾値・モルフォロジー・面積フィルタは1ヶ所で定義し、検出ロジックは視野方向ごとに独立した関数を置く。
B. 流用判定は数字で残す。関数を呼んで結果を見て、戻り値を文字で記録する。仕様確認スクリプトはコミットして残置する。視覚的に「ダメだろう」とわかっても、確証は数字で残す。
Log#12 では、ここで作ったパイプラインを動的追従ループに統合する。横カメラ pixel から (z, y) mm への変換式の作成と、両カメラ統合での収束精度の再測定が中心になる。Log#6 で動的追従が初めて収束した瞬間に「動きの質が変わった」と書いたが、その質を一段上げるための土俵が、ここで完成した。