mechArm 270 Pi 実機データを土台にデジタルツインを作る Log#09 | 実機を動かす前に data_manifest_rules.md を新設した。保持を測る受け皿を先に作る
前回、descend を 6 関節で引くようにして、爪先の Z 方向のズレが縮むようになった。位置の山は越えた。残ったのは保持の山 ── 位置には届くのに、掴んだブロックを LIFT までに落とすことがある、という問題だった。
このセッションは、その保持の山に実機で登るつもりだった。だが登り口で止めた。理由は単純で、保持の成否を記録する場所が無かったからだ。正確には、台帳はあるのに、その台帳が「位置には届いたが保持できなかった」という結果を書けなかった。
掴めたかどうかを測りたいのに、測った結果を入れる欄が無い。それなら欄を先に作る。このセッションは実機を一度も動かさず、台帳のルールを data_manifest_rules.md として新設し、codex の二度のレビューを通して固めるところまでで区切った。
pick 欄が空のまま終わる試行
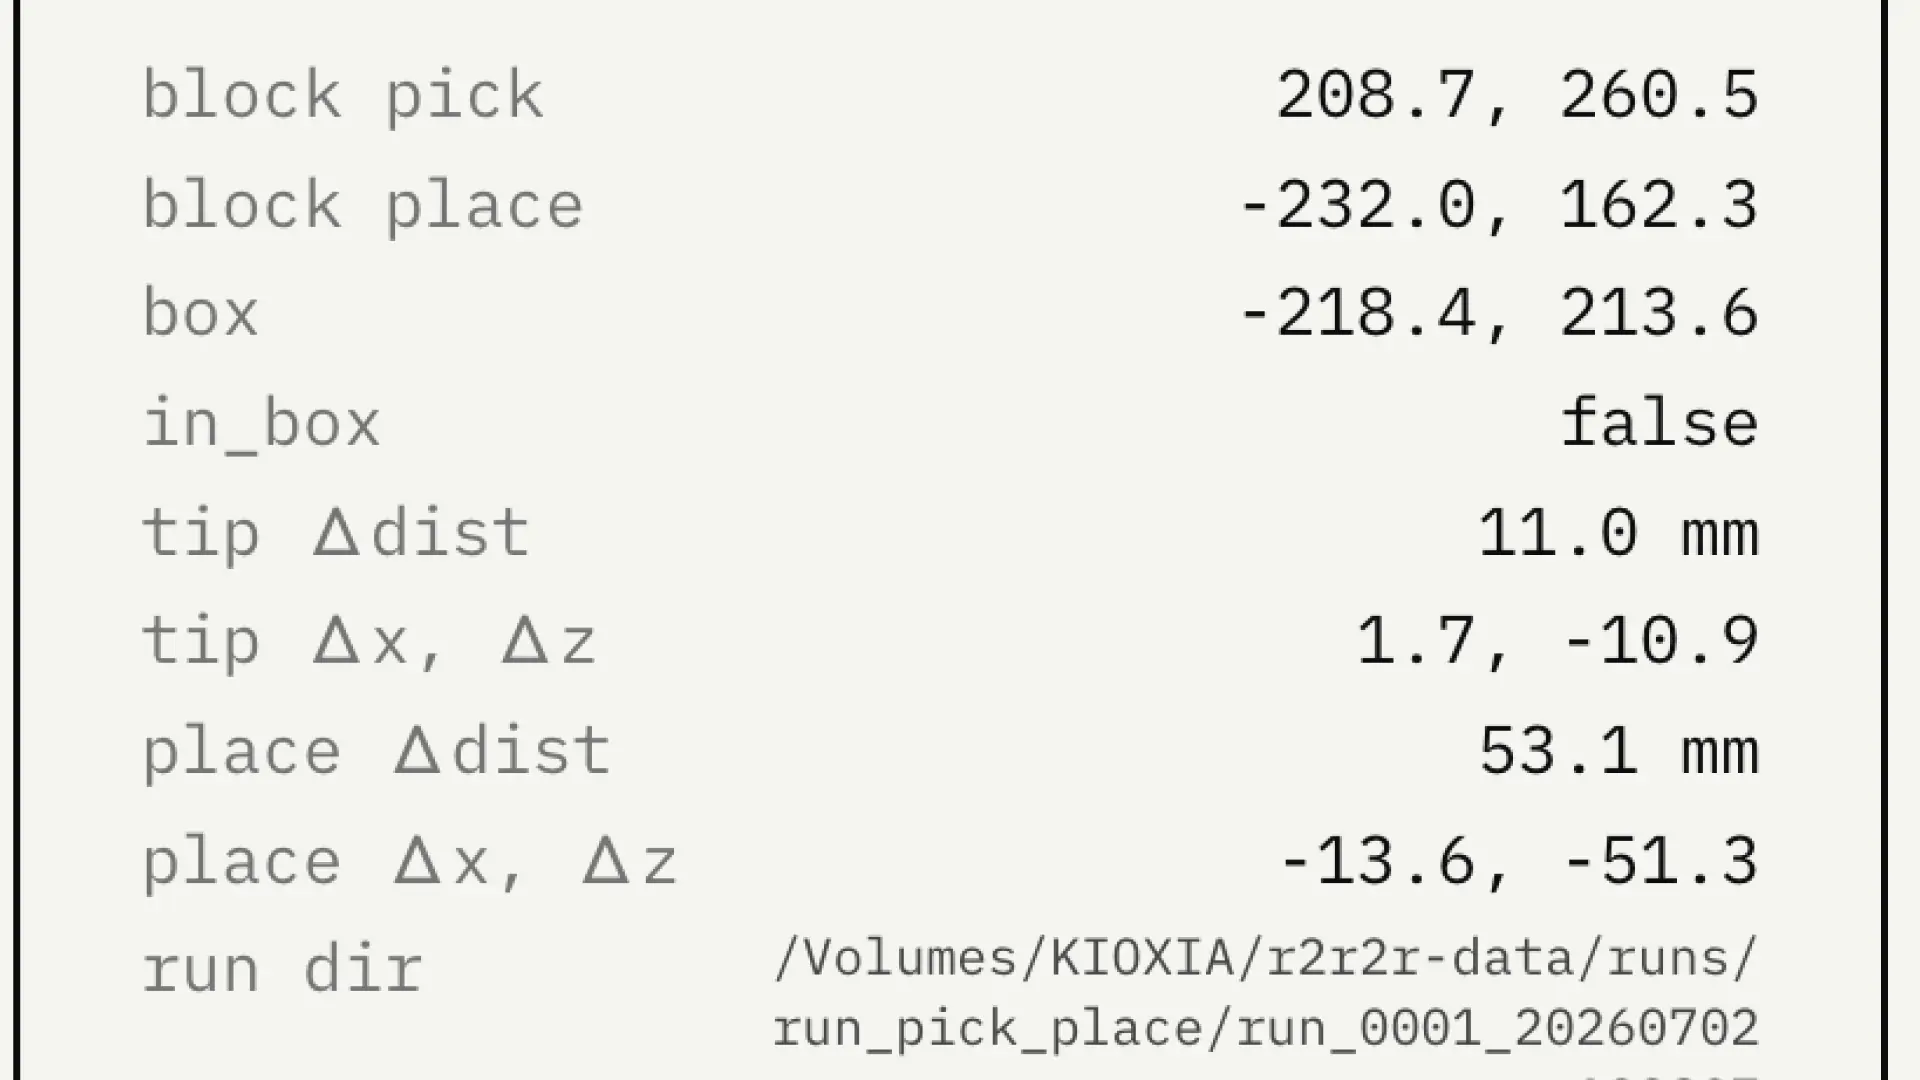
前回の台帳に、こういう行があった。ブロックの (x, z) を狙って descend し、爪先とブロックの距離が tip_block_dist_mm = 9.7mm まで届いている。掴める距離だ。にもかかわらず、その行の pick 判定は空欄のまま終わっていた。
この空欄が読めない。位置に届かなかったから空なのか、届いたが掴めなかったから空なのか、掴んだが LIFT で落としたから空なのか ── どれも同じ「空」になる。保持の山を測りたいのに、その山に入る手前で結果が一つの箱に潰れている。
掴めたか落としたかを測定可能にするには、試行の結果を「段階の状態」として持つ必要がある。これはこのプロジェクトで何度も効いてきた原則で、測れる手段を持ってから推論する、というものだ。状態を表す列が無いまま実機を回しても、保持の山は数えられない。だから実機より先に、台帳の中身を決めることにした。
MASTER は場所、新ファイルは中身
台帳まわりのルールは、これまで MASTER のデータ保管セクションが持っていた。ただしそこが決めているのは「どのデータをどこに置くか(種類 → 場所)」で、「台帳の中に何をどう書くか(列の意味・状態語・追記の仕方)」は決めていない。
そこで役割を分けた。MASTER は引き続き場所を決める。台帳の中身は新ファイル data_manifest_rules.md を唯一の正とする。両者は重ならない。場所のルールと中身のルールを一つの文書に混ぜると、どちらを直すべきか分からなくなる ── これは過去に記事ルールが MASTER・day_log・handoff に分散して事故になった反省と同じ構図で、最初から分けておく。
この新ファイルに入れるものは、台帳の列定義、試行結果の状態語、pose_id による live / twin / real の連携、そして追記義務。実機を動かす受け皿として、まずこの四つを固める。
状態語を二層に分ける
最初のドラフトで一番考えたのは、状態語の設計だった。
試行の結果を一段階の状態として持たせる。位置に届かなかった、届いた、掴んだ、保持した、中断した ── このように段階を分ければ、pick 欄の空欄問題は解ける。「届いたが保持できなかった」は「届いた」という状態で残り、空欄に潰れない。
ここで一つ、混ぜてはいけないものがあった。このプロジェクトには既にもう一種類の「状態」がある。姿勢素材のラベリングに使う adopted / superseded / aborted / test の四語だ。これは「この姿勢データを採用したか棄てたか」という、素材の採用状態を表す。試行の結果状態とはまったく別のレイヤーにある。
二つを同じ列に混ぜると、aborted がどちらの意味か分からなくなる。だから状態は二層あると明記し、列名で分けることにした。試行結果の状態と、姿勢素材の採用状態。同じ綴りを別の意味で使わない。
ここまでをドラフトにして、codex のレビューに出した。実機の関節制御コードではなく仕様文書のレビューなので、安全チェックではなく「この仕様が後でコードに落ちたとき破綻しないか」を見てもらう依頼にした。
codex 一度目 ── 推測で焼いた箇所が刺さった
返ってきた指摘は的確で、こちらがドラフトに推測で焼き込んでいた箇所をことごとく突いてきた。この文書自身が「パスを推測で焼かない」と書いているのに、台帳の中身の方は推測で書いていた。
主要な指摘は三つの ❌ から始まった。
一つ、台帳の列数を「50」と書いていたが、現行コード run_pick_place.py の LEDGER_COLS は 57 列だった。二つ、pose_id を単一列で形式 {phase}_{YYYYMMDD}_{HHMMSS} と書いていたが、現行台帳は pick_pose_id / place_pose_id に分かれており、fk_lookup 由来の姿勢は fk_row_{行番号} を返していた。三つ、デジタルツインの FK テーブルを「runtime では読まない」と書いていたが、前回 descend を fk_lookup に移した結果、実行時に FK テーブルを読むようになっていた。前回の自分の変更を、台帳ルールの方に反映し忘れていた。
状態語の設計についても、方向は良いが詰めが甘いという判定だった。レイヤーAとレイヤーBの分離は妥当だが、両方に aborted があるので列名での分離を必須にせよ。grasped(掴んだが LIFT までに落とした)の境界が現状のセンサーからは一意に取れない ── いまは GRIP 直後の保持確認ではなく LIFT 後の画像で pick 成否を見ているので、「掴んで落とした」を切り分けられない。線形の段階だけだと弱いので、pick_stage 一列に加えて根拠フラグを別列で持て。
codex の一度目の判定全文を残す。
**主要な指摘**

❌ data_manifest_rules.md:81
`twin | runtime では読まない` は現行コードと逆です。DAY257後は fk_lookup が descend/pick で実行時に FK テーブルを読みます。
修正案: `descend(pick) で fk_lookup が runtime に読む。approach は live(j0_lookup)。`

❌ data_manifest_rules.md:18
`列数: 50` は現行コードと合いません。run_pick_place.py の LEDGER_COLS は現在 57 列です。
修正案: `列数: 57(2026-06-27時点の LEDGER_COLS / 実体ヘッダで確定)`。ただし実測ヘッダ確認前なら、列数も書かず `未確定` に倒す方が安全です。

❌ data_manifest_rules.md:36
`pose_id` 単一列・形式 `{phase}_{YYYYMMDD}_{HHMMSS}` は現行台帳と合いません。現行は pick_pose_id / place_pose_id があり、fk_lookup は fk_row_{row_index} を返しています。
修正案: `台帳は phase 別に pick_pose_id / place_pose_id を持つ。j0_lookup 由来は採用JSONの pose_id、fk_lookup 由来は FKテーブル行ID fk_row_{selected_idx} を暫定 pose_id とする。`

**A. 状態語設計**

A1 ⚠️ 要注意
レイヤーA/B分離は妥当です。ただし A にも B にも aborted があるので、「列名で分離する」ことを必須にしてください。例: pick_stage と asset_status。

A2 ⚠️ 要注意
not_reached / reached / held は実装しやすいですが、grasped の境界が現状センサーから一意に取れません。現在は GRIP 直後の保持確認ではなく、LIFT 後画像で pick 成否を見ています。
grasped = 掴んだがLIFTまでに落とした を判定するには、GRIP直後・LIFT前の保持確認が必要です。

A3 ⚠️ 要注意
同名 aborted は混乱します。改名推奨です。
修正案: レイヤーAは interrupted または run_aborted、レイヤーBは既存どおり aborted。

A4 ⚠️ 要注意
線形モデルだけだと弱いです。pick_stage 1列に加えて、根拠フラグを別列化する方が後で壊れません。
例: reached_bool, grip_commanded, held_after_lift, abort_reason, evidence_source。

**B. 既存ルールとの整合**

B1 ⚠️ 要注意
「MASTERは場所、この文書は中身」は良い整理です。ただし 6-7行 でこの文書が追記義務も唯一の正と言っており、MASTER側に追記義務が残るなら優先順位を明記すべきです。
修正案: `場所はMASTER優先。台帳列・状態語・追記条件は本ファイル優先。矛盾時はMASTERの場所規約を侵さない範囲で本ファイルを優先。`

B2 ❌ NG
列定義を保留したまま運用に入るのは危険です。現行コードはヘッダ不一致時に追記スキップするので、仕様が未確定だと「台帳が増えない」事故になります。
進む前に LEDGER_COLS と実体ヘッダを突合し、少なくとも列名・順序・追加予定列を確定してください。

**C. 実装可能性**

C1 ⚠️ 要注意
held は現状の VLM-as-Reward で判定可能です。LIFT後画像で「持ち上がったか」を見ているためです。
ただし grasped は現状だけでは不足。GRIP直後の確認画像または別センサーが必要です。

C2 ⚠️ 要注意
未確定のままでは照合が壊れます。ただし現行コードはすでに fk_row_{selected_idx} を返しているので、暫定方針はあります。
文書には選択肢ではなく、まず暫定正として fk_row_{selected_idx} を明記するのがよいです。

**D. 将来の穴**

D1 ⚠️ 要注意
状態語はバージョニング必須です。
修正案: state_schema_version または ledger_schema_version を列に持つ。列追加が重いなら文書に「DAY258以降は語彙v1」と明記。

D2 ⚠️ 要注意
「唯一の正」がMASTERと衝突しやすいです。参照の向きを明記してください。
おすすめは、MASTERには `台帳中身は data_manifest_rules.md を参照` とだけ残す運用です。

**末尾判定**

この枠、つまり「状態語をレイヤーA/Bに分ける」方針は進めてOKです。けれど、このまま確定してMac実測へ進むのはまだ早いです。

優先度高で直すべき点は3つです。
1. P0: twin runtimeでは読まない を修正。
2. P0: 列数50・単一 pose_id を現行57列、pick_pose_id/place_pose_id/fk_row_* に合わせる。
3. P1: grasped を現状センサーで判定不能な語として扱い、根拠フラグ列または保留扱いにする。
ここを直せば、列定義の実測確定に進んでよいです。
一度目の修正 ── grasped を保留にした
指摘を反映した。実コードに由来する事実(57 列、pick_pose_id / place_pose_id、fk_row_*、twin を runtime で読むこと)は正として取り込み、自分の推測で焼いた数値は撤回した。
状態語は pick_stage(試行結果)と asset_status(姿勢素材)で列名を分け、レイヤーAの中断語は aborted と衝突しないよう interrupted に改名した。線形段階だけに頼らず、根拠フラグ列 reached_bool / grip_commanded / held_after_lift / abort_reason / evidence_source を併設した。
一番考えたのは grasped の扱いだった。codex の言う通り、いまのセンシングは LIFT 後の画像でしか保持を見ていない。GRIP 直後・LIFT 前の確認が無い以上、「掴んで落とした」を「そもそも掴めなかった」から切り分けられない。無理に判定語を置くと、判定手段の無い状態語ができてしまう。
だから grasped は保留にした。当面は reached(位置は到達)+ held_after_lift = false で表し、grasped を有効化する条件を「GRIP 直後の確認画像を導入したとき」と明記した。今のセンサーで判定できる状態だけを正式に使う。
優先順位(場所は MASTER、中身は本ファイル)と、状態語のバージョン管理(ledger_schema_version、本語彙を v1 とする)も足した。そして修正版を、もう一度 codex に出した。
codex 二度目 ── 修正が新しい穴を開けていた
二度目のレビューで、前回の P0 はおおむね解消したと出た。だが新しい問題が二つ、設計ブロッカーとして残っていた。これは自分の修正が開けた穴だった。
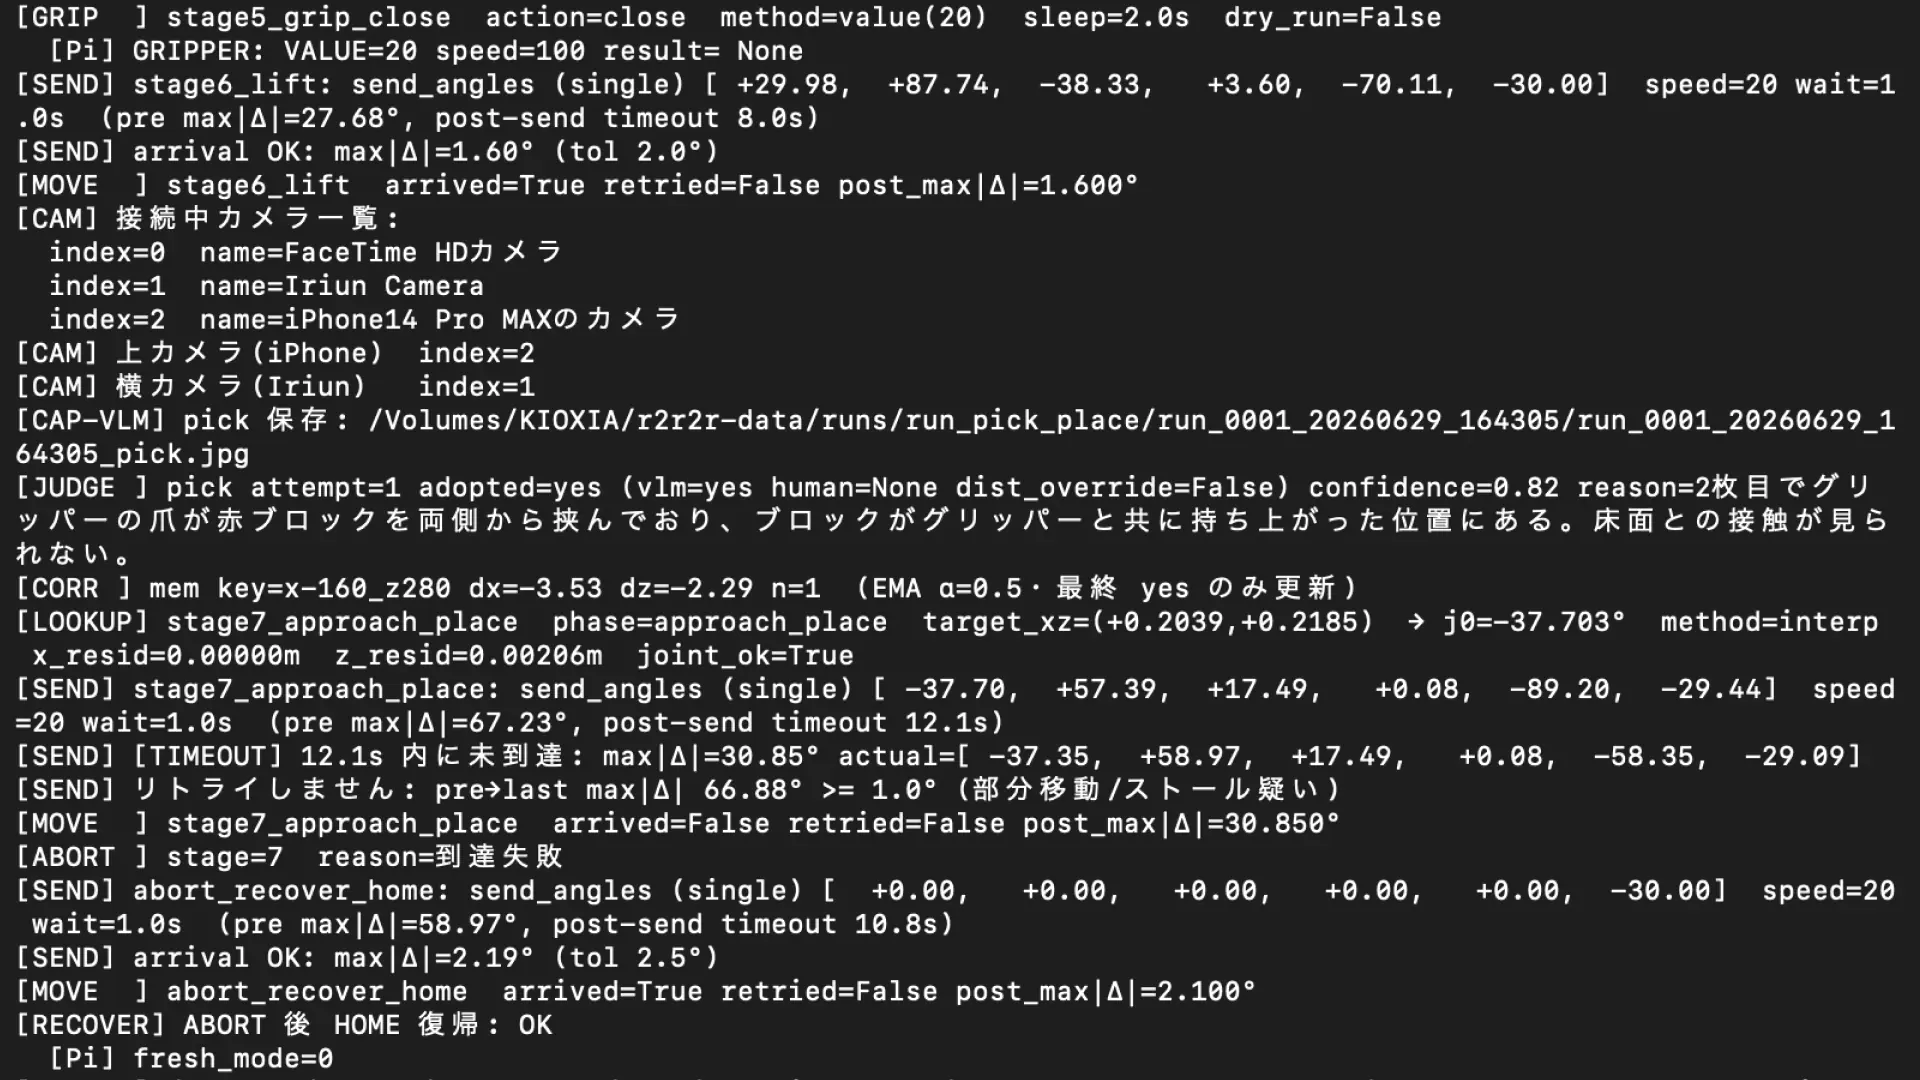
一つ目。状態語を整えるために列を何本も増やした ── pick_stage、根拠フラグ五列、ledger_schema_version。これらは現行の 57 列に存在しない。つまり、この文書どおりに実装すると台帳のヘッダが変わる。そして現行コードは、ヘッダが LEDGER_COLS と一致しないとき追記をスキップする。状態語を足したくて列を増やしたのに、その追加そのものが「台帳が増えなくなる」事故を引き起こす。B2 で警告された罠を、修正の側で踏みかけていた。
codex の推奨は、新列を足すなら別ファイルの v4 を切ること。既存 57 列に無理に詰めると、pick_verdict の yes/no/unknown 系と状態語の意味が混ざる、という理由だった。この推奨をどう扱うかは、後の判断に持ち越した。
二つ目。fk_lookup 由来の pose_id を fk_row_{行番号} にしたが、行番号単独では識別子として弱い、という指摘だった。FK テーブルは再生成・マージ・ソートで同じ行番号が別の姿勢を指しうる。実際このテーブルは 512,087 → 710,704 → 852,729 と拡張してきた。だから行番号だけを永続 ID にせず、テーブルの版かハッシュとセットにする。fk:{テーブル名}:{ハッシュ}:{行番号} のような形にして初めて安定した識別子になる。
codex 二度目の判定全文を残す。
再レビュー結果です。前回 P0/P1 はかなり入っていますが、N1 と N2 はまだ設計ブロッカー寄りです。

R1 ✅ OK
descend(pick) で fk_lookup が runtime に読む は現行コードと一致します。approach=live/j0_lookup の切り分けも概ねOK。

R2 ✅ OK
50 固定を撤回し、現行 LEDGER_COLS=57 と実体ヘッダ突合にしたのは正しいです。

R3 ⚠️ 要注意
pick_pose_id / place_pose_id への分離、fk_row_{selected_idx} が現行コードの返り値と一致する点はOKです。
ただし「j0_lookup由来(approach)」は少し狭いです。place_withblock も j0_lookup 由来なので、
`j0_lookup 由来(approach / place_withblock)は採用 JSON の pose_id を使う` に直すと安全です。

R4 ✅ OK
interrupted への改名は良いです。衝突は解消しています。

R5 ⚠️ 要注意
grasped 保留は正しいです。
ただし reached + held_after_lift=false は「掴んで落とした」と「そもそも掴めなかった」を同じ箱に入れます。これは現状センサーでは避けられないので、文書に
`この組み合わせは grasp failure / dropped before lift を区別しない暫定表現` と足すと誤解が減ります。

R6 ⚠️ 要注意
根拠フラグの設計自体は良いです。ただしそれらは現行57列には存在しません。N1の移行問題に直結します。

R7 ✅ OK
優先順位と版管理の方向は十分です。ただし ledger_schema_version も現行57列には存在しないため、これもN1側の追加列扱いです。

N1: 列追加 vs 既存57列
❌ ブロッカー
新しく定義された以下は、現行 LEDGER_COLS 57列に存在しません。
pick_stage, reached_bool, grip_commanded, held_after_lift, abort_reason, evidence_source, ledger_schema_version, asset_status
つまり、この文書どおりに実装すると v3 のヘッダ不一致を起こし、現行コードは追記をスキップします。
推奨は 新列を足すなら v4 を切る です。既存57列に無理に詰めるのはおすすめしません。pick_verdict に held/reached を入れると、既存の yes/no/unknown 系と意味が混ざります。
修正案を文書に追加してください。
`状態語v1の実装は pick_place_ledger_v4.csv で行う。v3 は現行57列の履歴として温存する。v4 は v3 の57列を先頭に維持し、末尾に pick_stage / reached_bool / grip_commanded / held_after_lift / abort_reason / evidence_source / ledger_schema_version を追加する。v3 既存行を移行する場合は追加列を空欄または unknown で欠損埋めし、元CSVは変更しない。`

N2: fk_row_{selected_idx} の安定性
⚠️ 要注意
fk_row_{selected_idx} は現在のコードとは一致しますが、識別子としては弱いです。FK CSV が再生成・マージ・ソート変更されると、同じ index が別姿勢を指す可能性があります。
推奨: fk_pose_id = fk:{table_basename}:{table_hash}:{selected_idx}
さらに照合用に fk_joint_key = j0,j1,j2,j3,j4,j5 の丸め値を持つと強いです。
最低限の修正案: fk_row_{selected_idx} は FK テーブル版またはハッシュとセットでのみ安定識別子として扱う。行 index 単独では永続IDにしない。

**末尾判定**
前回 P0/P1 のうち、R1/R2/R4/R7 は解消。R3/R5/R6 は方向OKだが文言補強が必要です。
Mac 実測へは 進んでよい です。ただし目的を分けてください。
- 進んでよい: v3 現行57列の実体ヘッダ確定
- まだ進めない: 新状態語を v3 に直接実装
残ブロッカーは2つです。
1. P0: 状態語新列は v4 化するか、移行手順を文書に明記する。
2. P1: fk_row_{selected_idx} を FKテーブル hash/version とセットにする。
この2点を書き足せば、仕様としてかなり安定します。
二度目の修正 ── 台帳は一本のまま、退避して作り直す
二度目の指摘を反映するとき、一つだけ codex の推奨に従わなかった。codex は新列を足すなら別ファイルの v4 を切れと言った。だが台帳をバージョン番号で枝分かれさせると、どれが正本か後で迷う。ファイル名は pick_place_ledger_v3.csv の一本で通すことにした。リネームもしない。
その代わり、列を増やすときの手順を決めた。運用中の v3 にその場で列を足すと追記ガードに弾かれるので、まず旧 v3 を archive/ にコピー退避する。状態語を入れる前の過去試行は archive 側に残る。そのうえで、同じパスの pick_place_ledger_v3.csv を、57 列の後ろに新列を加えたヘッダで新規の空台帳として作り直す。過去行は引き継がず 0 行から始める。run_pick_place.py の LEDGER_COLS を新ヘッダに合わせ、ファイル名は変えない。
別ファイルに分けるか、一本のまま作り直すか ── どちらも「列を足すと追記が止まる」問題は避けられる。違うのは正本の数で、台帳は一本という方を採った。
fk_row_{行番号} は行番号単独で永続 ID にしないと規定し、テーブルの版かハッシュとセットにする推奨形を書いた。reached+held_after_lift=false が二つの失敗(掴めなかった/掴んで落とした)を区別しない暫定表現であることも明記した。
ここで codex の末尾判定は、目的を分けるなら Mac 実測へ進んでよい、というものだった。進めるのは v3 現行 57 列の実体ヘッダ確定。進めないのは、運用中の v3 にその場で状態語の列を足すこと。v3 の運用は止めず、状態語は退避して作り直す手順で別に検証する。
v3 の実体ヘッダを取る
文書のルールは「列名・列順の実体は Mac 上の台帳ヘッダを正とする」と決めている。推測で列を焼かない。だから列定義は、ドラフトの段階では空欄のプレースホルダにしてあった。codex が進めてよいと言ったので、ここで実体ヘッダを取った。
実行したのは参照系のコマンドだけで、台帳を読むだけ。書き込みも実機も無い。
LEDGER=/Volumes/KIOXIA/r2r2r-data/runs/pick_place_ledger_v3.csv

echo "===== 1. KIOXIA マウント確認 ====="
ls -l "$LEDGER" 2>/dev/null || echo "未マウント"

echo; echo "===== 2. 実体ヘッダ(番号付き・列数確認)====="
head -1 "$LEDGER" | tr ',' '\n' | nl

echo; echo "===== 3. サンプル2行 ====="
sed -n '2,3p' "$LEDGER"

echo; echo "===== 4. コード側 LEDGER_COLS 定義 ====="
RPP=$(find "$HOME/r2r2r-scripts" -name run_pick_place.py 2>/dev/null | head -1)
echo "file: $RPP"
grep -n "LEDGER_COLS" "$RPP"
出力は次の通り。
===== 1. KIOXIA マウント確認 =====
-rwx------  1 shimazueiichi  staff  89398  6月 26 23:27 /Volumes/KIOXIA/r2r2r-data/runs/pick_place_ledger_v3.csv

===== 2. 実体ヘッダ(番号付き・列数確認)=====
     1 timestamp
     2 run_stem
     3 trial_no
     4 pick_verdict
     5 pick_reason
     6 pick_confidence
     7 place_verdict
     8 place_reason
     9 place_confidence
    10 block_pick_x
    11 block_pick_z
    12 block_place_x
    13 block_place_z
    14 box_x
    15 box_z
    16 in_box_geom
    17 in_box_dist_mm
    18 final_j1
    19 final_j2
    20 final_j3
    21 final_j4
    22 final_j5
    23 final_j6
    24 gripper
    25 place_capture_path
    26 tip_pick_x
    27 tip_pick_z
    28 tip_block_dx_mm
    29 tip_block_dz_mm
    30 tip_block_dist_mm
    31 run_dir
    32 tip_capture_path
    33 pick_capture_path
    34 align_j0_final
    35 align_red_x_mm
    36 align_converged
    37 pick_pose_id
    38 pick_used_j0
    39 pick_used_j1
    40 pick_used_j2
    41 pick_used_j3
    42 pick_used_j4
    43 pick_used_j5
    44 place_pose_id
    45 place_used_j0
    46 place_used_j1
    47 place_used_j2
    48 place_used_j3
    49 place_used_j4
    50 place_used_j5
    51 corr_cell_key
    52 corr_applied_dx
    53 corr_applied_dz
    54 target_before
    55 target_after
    56 vlm_pick_verdict
    57 pick_dist_override

===== 3. サンプル2行 =====
2026-06-18T00:00:00,run_0042_test,42,yes,x,0.5,yes,y,0.6,50.0,300.0,-90.0,170.0,-100.0,180.0,True,14.1,1.00,2.00,3.00,4.00,5.00,6.00,1,/foo/bar.jpg,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,
2026-06-18T14:24:36.082720,run_0001_20260618_142436,1,yes,dry_run,0.0,yes,dry_run,0.0,50.0,300.0,,,-100.0,180.0,,,,,,,,,0,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,,

===== 4. コード側 LEDGER_COLS 定義 =====
file: /Users/shimazueiichi/r2r2r-scripts/dynamic_tracking_limits/place/place_modules/run_pick_place.py
167:LEDGER_COLS = [
758:        # codex 指摘ガード: 既存ヘッダと LEDGER_COLS が不一致なら追記しない。
769:            if existing_header != LEDGER_COLS:
770:                print("[LEDGER] [ABORT-APPEND] 既存ヘッダ ({} 列) と LEDGER_COLS "
773:                          len(LEDGER_COLS)))
775:                    diff_extra = set(existing_header) - set(LEDGER_COLS)
776:                    diff_missing = set(LEDGER_COLS) - set(existing_header)
780:                        print("[LEDGER] LEDGER_COLS にのみ存在: {}".format(sorted(diff_missing)))
783:            w = csv.DictWriter(f, fieldnames=LEDGER_COLS)
これで三つ確定した。一つ、実体ヘッダは 57 列で、ドラフトで推測撤回後に置いた 57 と一致した。二つ、pick_pose_id(37 列目)と place_pose_id(44 列目)は実在し、状態語の pick_stage 系は予想通り存在しない ── だから運用中の v3 にその場では足せない。三つ、existing_header != LEDGER_COLS で [ABORT-APPEND] する追記ガードは、既にコードに実装されていた(758〜783 行)。
三つ目が効いた。運用中の v3 に新列を足すと、このガードが確実に弾く。「列を増やすと台帳が増えなくなる」という codex の警告は、仕様の上の話ではなく、既に動いているガードの話だった。退避して作り直す手順を踏む必要があることが、推測ではなくコードの実体で裏付けられた。
確定した 57 列で、文書の列定義表を埋めた。これで data_manifest_rules.md は、列定義(v3・57 列)と状態語(台帳一本のまま、退避して作り直す手順)と pose_id 連携の三つが揃った確定版になった。
設置して、MASTER から参照を向けた
確定版を、既存のルール文書と同じ場所に置いた。arm_kinematics.md や article_rules.md がある ~/r2r2r-content/methodology/ に data_manifest_rules.md を置き、Claude のプロジェクトナレッジにも追加した。セッション冒頭から自動でコンテキストに入る扱いにする。
MASTER には、データ保管セクションの冒頭に参照を一行入れた。
台帳(pick_place_ledger_v3.csv)の列・状態語・pose_id 連携・追記条件の詳細は data_manifest_rules.md を唯一の正とする。本セクションは保存先(種類→場所)を定め、台帳の中身は data_manifest_rules.md を参照する。
MASTER は場所、新ファイルは中身。参照の向きが一方向になり、二重定義が消えた。data_manifest_rules.md を git にコミットして、設置を閉じた。
[main 0bc0eec] [DAY258][docs] 台帳管理ルール data_manifest_rules.md を新設(v3実体57列確定・状態語は台帳一本/退避作り直し方式・codex二次レビュー反映)
 1 file changed
 create mode 100644 methodology/data_manifest_rules.md
受け皿を先に作った
実機を一度も動かさずに区切った。やったのは、保持の山に登る前に、保持を測る受け皿を作ったことだ。
最初は実機で保持を測るつもりだった。だが、測った結果を入れる欄が無いことに気づいて、欄の設計に戻った。設計を codex に二度通すと、自分が推測で焼いた箇所と、修正が新しく開けた穴(列を増やすと追記が止まる)が見つかった。codex は別ファイルに分けることを推したが、台帳は一本のまま、列を増やすときは退避して作り直す手順にした。v3 は 57 列の実体で確定した。
掴めたかどうかを数えたいなら、その状態を書ける台帳が先に要る。測れる形を作ってから山に登る。保持の山そのものは、次に残っている。