
フィジカルAI研究室を作る Log#7 | Physical Intelligence の π0.5 を倍学習しても、爪は奥へずれた
この記事の素材(コード・ログ・データ 3ファイル・まとめてダウンロードあり)arrow_downwardAIで読む ChatGPT・Claude などで、この記事に質問できます expand_more
Physical Intelligence の π0.5 の学習を2,000ステップから4,000ステップへ倍にしても、mechArm 270 が手を伸ばす先は変わらず、爪は2回ともブロックの奥で空を閉じました。学習の誤差(loss)は0.0030まで下がっていました。
AI にロボットアームの動かし方を覚えさせるとき、「もっと長く学習させれば、もっとうまくなる」と考えたくなります。机の上の小さなアームで、それを試しました。学習の量を2倍にしても、アームが手を伸ばす先は変わりませんでした。
使っているのは、米国の Physical Intelligence 社が公開しているロボット用の AI モデル π0.5(パイレイテンゴ)です。上のカメラの画像と関節の角度を受け取って、次の1秒の動きを返します。これを、手元の mechArm 270(関節6つの小型アーム)が赤いブロックをつかんで白い箱に入れるお手本19本で、追加で学習させています。
前の回で、2,000ステップ(ステップは学習で中身を1回直すこと。お手本のデータを約11周する量)学習したモデルを実機で動かすと、アームはブロックの真上まで来て、手前の爪がブロックの上に乗って止まりました。爪1本分、狙いがずれていたのです。学習の誤差(loss)はまだ下がり続けていたので、続きから学習を足しました。
4,000ステップで loss は 0.0057 前後から 0.0030 まで下がりました。そのモデルで2回試すと、アームは2回とも、今度はブロックの奥まで手を伸ばし、何もない所でグリッパーを閉じました。記録を並べると、2,000ステップでも4,000ステップでも、つかむ瞬間の土台(j0)と肩(j1)の角度はほとんど同じで、どちらもお手本19本の範囲の外でした。 学習を足して変わったのは、手首を下ろしきれるようになったことだけで、腕を伸ばす先は同じ場所のままです。
お手本19本は、ブロックをほぼ同じ場所に置いて集めたものです。AI が画像から「ブロックがどこにあるか」を読んで手を伸ばす先を変えることを覚えるには、ブロックの位置が違うお手本が要ります。位置がほぼ同じお手本ばかりだと、画像を細かく見なくても「いつもの場所へ手を伸ばす」だけで loss は下がります。足りないのは学習の回数ではなく、ブロックの位置が違うお手本です。
やったことの全体は次のとおりです。
| やったこと | なぜ | 結果 |
|---|---|---|
2,000ステップの続きから学習を回した | 2,000ステップでは爪がブロックに乗ってずれていたため | 約3時間50分で4,050ステップまで。loss は 0.0030〜0.0035 |
5,000ステップまで待たず、4,000ステップで止めた | 終わるのが23時55分になり、寝る時間を過ぎるため | 4,000ステップのモデルが保存されてから止めた |
4,000ステップのモデルで実機を2回動かした | 学習の量で爪の位置が変わるかを見るため | 2回とも、ブロックの奥でグリッパーを閉じた |
つかむ瞬間の関節角を、2,000ステップの回とお手本と比べた | ずれ方が学習で変わったかを確かめるため | 土台と肩はほぼ同じ角度で、お手本の範囲の外。手首と肘は範囲の近くまで下りた |
モデル(約6.3GB)を手元に持ち帰り、借りた GPU を削除した | 借りた GPU は、置いておくだけで1時間約0.6ドル(約95円)かかるため | 1回目の持ち帰りのコマンドが途中で止まり、作り直した |
| 次のお手本の集め方を決めた | 位置の違うお手本を、今のアームで作るため | 要所の姿勢を手で教え、それをアームに再生させて記録する |
GPU は前の回と同じく、Runpod というサービスで NVIDIA A40(48GB)を1時間約0.6ドル(約95円)で借りています。Runpod では、借りた1台分の GPU マシンを Pod と呼びます。この回の作業も Claude と一緒に進めました。手順とコマンド、記録の分析は Claude が出し、アームの操作、目視の判定、動画の撮影、Runpod の画面操作はこちらで行っています。ここから下は、使ったコマンド・コード・出力を全量で載せた作業ログです。ログの中の Pod の IP アドレスとポート番号は <POD_IP> と <SSH_PORT> に、手元の回線の IP アドレスは <HOME_IP> に置き換えています。費用の円は 1ドル=158円 で計算しています。
GPU を買うか借りるかの判断は、Runpod で実際に借りて学習させた費用をもとに、別のページにまとめています。
導入比較ガイドロボットAIの学習用GPU、買うか借りるか実際に借りて学習させた費用と、損益分岐の計算機で決められますarrow_forward作業ログ ― 2,000ステップの続きから、1ステップ約6.6秒で学習が進んだ
学習は、前の回の18時21分に、2,000ステップの続きから 5,000ステップを目標に始めています(手順は Log#6 に全量を載せました)。19時44分に、進み具合を Claude に聞きました。Claude からは Mac の外付け SSD(KIOXIA)は見えますが、Pod にログインするための SSH 鍵(Mac の ~/.ssh)には触れられないので、Pod の中はこちらで見ています。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % ssh root@<POD_IP> -p <SSH_PORT> -i ~/.ssh/id_ed25519
tail -n 3 /workspace/logs/train_resume.log
Welcome to Ubuntu 24.04.3 LTS (GNU/Linux 6.8.0-139-generic x86_64)

 * Documentation:  https://help.ubuntu.com
 * Management:     https://landscape.canonical.com
 * Support:        https://ubuntu.com/pro

This system has been minimized by removing packages and content that are
not required on a system that users do not log into.

To restore this content, you can run the 'unminimize' command.
Last login: Sat Oct 17 09:07:20 2026 from <HOME_IP>
 _____                             _
|  __ \                           | |
| |__) |   _ _ __  _ __   ___   __| |
|  _  / | | | '_ \| '_ \ / _ \ / _` |
| | \ \ |_| | | | | |_) | (_) | (_| |
|_|  \_\__,_|_| |_| .__/ \___/ \__,_|
                  | |
                  |_|
For detailed documentation and guides, please visit:
https://docs.runpod.io/ and https://blog.runpod.io/


root@b07c796f894c:/#
2行を続けて貼ったので、2行目はログインが終わる前に送られて実行されていません。ログインしてから、学習のログの最後と、GPU の使い方を見ました。
root@b07c796f894c:/# tail -n 5 /workspace/logs/train_resume.log; nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv
10:43:33.194 [I] Progress on: 2.71kit/5.00kit rate:6.5s/it remaining:4:09:00 elapsed:1:21:56 postfix:- (16124:tqdm_logging.py:145)
10:43:46.307 [I] Progress on: 2.71kit/5.00kit rate:6.5s/it remaining:4:09:33 elapsed:1:22:09 postfix:- (16124:tqdm_logging.py:145)
10:43:59.418 [I] Progress on: 2.71kit/5.00kit rate:6.6s/it remaining:4:09:41 elapsed:1:22:22 postfix:- (16124:tqdm_logging.py:145)
10:44:12.546 [I] Progress on: 2.72kit/5.00kit rate:6.6s/it remaining:4:09:48 elapsed:1:22:35 postfix:- (16124:tqdm_logging.py:145)
10:44:25.642 [I] Progress on: 2.72kit/5.00kit rate:6.6s/it remaining:4:09:22 elapsed:1:22:48 postfix:- (16124:tqdm_logging.py:145)
utilization.gpu [%], memory.used [MiB]
100 %, 44028 MiB
root@b07c796f894c:/#
時刻は Pod の時計(UTC)で、日本時間は9時間足した19時44分です。2,720ステップまで進み、1ステップ約6.6秒。残り約4時間10分で、終わるのは23時55分ごろの見込みでした。GPU は使用率100%、メモリは A40 の48GBのうち 44,028MiB を使っています。
20時20分にもう一度見ました。
root@b07c796f894c:/# tail -n 5 /workspace/logs/train_resume.log; nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv
11:19:01.732 [I] Progress on: 3.03kit/5.00kit rate:6.6s/it remaining:3:35:11 elapsed:1:57:25 postfix:- (16124:tqdm_logging.py:145)
11:19:14.854 [I] Progress on: 3.03kit/5.00kit rate:6.6s/it remaining:3:34:57 elapsed:1:57:38 postfix:- (16124:tqdm_logging.py:145)
11:19:27.975 [I] Progress on: 3.04kit/5.00kit rate:6.6s/it remaining:3:34:43 elapsed:1:57:51 postfix:- (16124:tqdm_logging.py:145)
11:19:41.122 [I] Progress on: 3.04kit/5.00kit rate:6.6s/it remaining:3:34:45 elapsed:1:58:04 postfix:- (16124:tqdm_logging.py:145)
11:19:54.261 [I] Progress on: 3.04kit/5.00kit rate:6.6s/it remaining:3:34:37 elapsed:1:58:17 postfix:- (16124:tqdm_logging.py:145)
utilization.gpu [%], memory.used [MiB]
100 %, 44028 MiB
root@b07c796f894c:/#
35分で320ステップ。速さは変わっていません。
「朝まで回せば良くなるか」― 回数を足しても、狙う先は変わりにくいと見立てた
21時34分に、Claude にこう聞きました。
これって明日の朝まで学習させたら、動きが良くなったりするの?
Claude の答えの要点は3つでした。
- 学習は 5,000ステップで自動で止まる設定なので、朝まで回すには、もう一度目標を延ばして再開する必要がある
- お手本は19本で、2,000ステップの時点で loss は 0.0054 まで下がっている。爪がブロックに乗ったのは、覚え方が足りないというより、つかむ位置を決める手がかり(ブロックの位置が違うお手本)が足りないためである可能性が高い。回しすぎると、お手本を丸暗記してブロックの位置を見なくなること(過学習)もある
- 学習が終わったあとに Pod を置いておくと、1時間約0.6ドル(約95円)かかり続ける。この Pod は永続ストレージを付けていないので、「停止」するとモデルも消える
そのうえで、「5,000ステップのモデルを試して、2,000ステップと比べる。爪の位置が変わらなければ、次の一手は回数ではなく、位置を変えたお手本」という順を出しました。
いつも11時くらいに寝るから12時前に終わらせたいけど
5,000ステップまで待つと23時55分です。学習は1,000ステップごとにモデルを保存しているので、Claude は4,000ステップで止める案を出しました。4,000に届くのは22時5分ごろの計算です。2,000ステップより回数を増やして爪の位置が変わるかは、4,000でも確かめられます。止めたあとは、同じ Pod で4,000ステップのモデルのサーバーを起動して実機で試し、モデルを持ち帰ってから Pod を削除する、という順にしました。サーバーは、Pod の上で π0.5 を動かし、Mac から送られたカメラの画像と関節の角度を受け取って、次の動きを返すプログラムです。このように、学習したモデルに次の動きを出させることを推論と呼びます。サーバーには、Physical Intelligence が公開している openpi(π0.5 を学習・推論するためのコード)の仕組みを使っています。モデルを送り直さずに済むので、翌日の手間がいちばん少ない方法です。
21時41分の時点です。
12:38:02.723 [I] Progress on: 3.75kit/5.00kit rate:6.3s/it remaining:2:10:41 elapsed:3:16:26 postfix:- (16124:tqdm_logging.py:145)
12:38:15.855 [I] Progress on: 3.76kit/5.00kit rate:6.4s/it remaining:2:13:22 elapsed:3:16:39 postfix:- (16124:tqdm_logging.py:145)
12:38:28.982 [I] Progress on: 3.76kit/5.00kit rate:6.5s/it remaining:2:14:32 elapsed:3:16:52 postfix:- (16124:tqdm_logging.py:145)
12:38:42.681 [I] Progress on: 3.76kit/5.00kit rate:6.7s/it remaining:2:18:32 elapsed:3:17:06 postfix:- (16124:tqdm_logging.py:145)
12:38:55.246 [I] Progress on: 3.76kit/5.00kit rate:6.5s/it remaining:2:14:26 elapsed:3:17:18 postfix:- (16124:tqdm_logging.py:145)
12:39:08.381 [I] Progress on: 3.76kit/5.00kit rate:6.5s/it remaining:2:14:45 elapsed:3:17:31 postfix:- (16124:tqdm_logging.py:145)
12:39:21.502 [I] Progress on: 3.77kit/5.00kit rate:6.6s/it remaining:2:14:44 elapsed:3:17:44 postfix:- (16124:tqdm_logging.py:145)
12:39:34.636 [I] Progress on: 3.77kit/5.00kit rate:6.6s/it remaining:2:14:41 elapsed:3:17:57 postfix:- (16124:tqdm_logging.py:145)
12:39:47.768 [I] Progress on: 3.77kit/5.00kit rate:6.6s/it remaining:2:14:31 elapsed:3:18:11 postfix:- (16124:tqdm_logging.py:145)
12:40:00.905 [I] Progress on: 3.77kit/5.00kit rate:6.6s/it remaining:2:14:23 elapsed:3:18:24 postfix:- (16124:tqdm_logging.py:145)
12:40:14.031 [I] Progress on: 3.77kit/5.00kit rate:6.6s/it remaining:2:14:08 elapsed:3:18:37 postfix:- (16124:tqdm_logging.py:145)
12:40:27.153 [I] Progress on: 3.78kit/5.00kit rate:6.6s/it remaining:2:13:52 elapsed:3:18:50 postfix:- (16124:tqdm_logging.py:145)
12:40:40.285 [I] Progress on: 3.78kit/5.00kit rate:6.6s/it remaining:2:13:40 elapsed:3:19:03 postfix:- (16124:tqdm_logging.py:145)
12:40:53.416 [I] Progress on: 3.78kit/5.00kit rate:6.6s/it remaining:2:13:28 elapsed:3:19:16 postfix:- (16124:tqdm_logging.py:145)
12:41:06.540 [I] Progress on: 3.78kit/5.00kit rate:6.6s/it remaining:2:13:12 elapsed:3:19:29 postfix:- (16124:tqdm_logging.py:145)
12:41:19.676 [I] Progress on: 3.78kit/5.00kit rate:6.6s/it remaining:2:13:02 elapsed:3:19:42 postfix:- (16124:tqdm_logging.py:145)
12:41:32.804 [I] Progress on: 3.79kit/5.00kit rate:6.6s/it remaining:2:12:48 elapsed:3:19:56 postfix:- (16124:tqdm_logging.py:145)
保存の名前は 3999 ではなく 4000 で、3000 も消えずに残った
この記事のコード・ログ・データは、1ファイルずつ下に置いています。全文はリンク先にあります。
ファイルの一覧(3本)
01_sec03.txt ― 保存の名前は 3999 ではなく 4000 で、3000 も消えずに残った・4,649字
02_sec09.txt ― 実機の2回目も、同じ場所でグリッパーを閉じた・4,742字
03_sec10.txt ― つかむ瞬間の土台と肩の角度は、2,000ステップの回とほぼ同じだった・5,150字
Claude は、2,000ステップのときに 1999 という名前で保存されたのと同じ形で、4,000ステップは 3999 になると見立てていました。21時59分に保存先を見ると、違っていました。
root@b07c796f894c:/# ls /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/
3000
root@b07c796f894c:/#
前の回の 1999 は学習の最後に保存したもので、途中の保存は 1,000 ちょうどの名前になります。1999 は消えていました(KIOXIA にコピーがあるので問題はありません)。22時6分です。
root@b07c796f894c:/# ls /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/
3000  4000
root@b07c796f894c:/#
Claude は「3000 が消えて 4000 だけになるまで保存中」と案内しましたが、4分たっても変わりません。
root@b07c796f894c:/# ls /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/
3000  4000
root@b07c796f894c:/# ls /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/
3000  4000
root@b07c796f894c:/#
そこで、3000 が消えるのを待つのをやめ、4000 の中身と大きさ、学習が4,000を過ぎて進んでいるかを直接見ました。
root@b07c796f894c:/# ls /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000; du -sh /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/*; tail -n 2 /workspace/logs/train_resume.log
_CHECKPOINT_METADATA  assets  params  train_state
8.9G /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/3000
8.9G /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000
Step 4050: grad_norm=0.0384, loss=0.0034, param_norm=1804.1687
13:10:42.957 [I] Progress on: 4.05kit/5.00kit rate:6.6s/it remaining:1:43:58 elapsed:3:49:06 postfix:- (16124:tqdm_logging.py:145)
root@b07c796f894c:/#
中身は4つともそろい、大きさは 3000 と同じ 8.9GB、学習は 4,050ステップまで進んでいます。ここで学習を止めました(22時11分ごろ。tmux の画面で Ctrl+C)。tmux は、Mac との接続が切れても Pod の中でプログラムを動かし続けるための道具で、学習はその中で動かしています。
3000 が残った理由は、記事を書くときに学習のログを読み直して分かりました。学習を始めたときの保存の設定です。
09:21:09.788 [I] [process=0][thread=MainThread] CheckpointManager created, primary_host=0, CheckpointManagerOptions=CheckpointManagerOptions(save_interval_steps=1, max_to_keep=1, keep_time_interval=None, keep_period=1000, should_keep_fn=None, best_fn=None, best_mode='max', keep_checkpoints_without_metrics=True, step_prefix=None, step_format_fixed_length=None, step_name_format=None, create=False, cleanup_tmp_directories=False, save_on_steps=frozenset(), single_host_load_and_broadcast=False, todelete_subdir=None, enable_background_delete=False, read_only=False, enable_async_checkpointing=True, async_options=AsyncOptions(timeout_secs=7200, barrier_sync_fn=None, post_finalization_callback=None, create_directories_asynchronously=True), multiprocessing_options=MultiprocessingOptions(primary_host=0, active_processes=None, barrier_sync_key_prefix=None), should_save_fn=None, file_options=FileOptions(path_permission_mode=None), save_root_metadata=True, temporary_path_class=None, save_decision_policy=None, prevent_write_metrics=False), root_directory=/workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1: <orbax.checkpoint.checkpoint_manager.CheckpointManager object at 0x7b9fe88b1550> (16124:checkpoint_manager.py:801)
max_to_keep=1(最新の1つだけ残す)に加えて、keep_period=1000(1,000の倍数のステップは消さずに残す)になっています。1999 は1,000の倍数ではないので、3,000ステップを保存したときに消されました。
11:08:16.464 [I] Progress on: 2.94kit/5.00kit rate:6.6s/it remaining:3:45:52 elapsed:1:46:39 postfix:- (16124:tqdm_logging.py:145)
11:12:12.754 [I] Progress on: 2.97kit/5.00kit rate:6.6s/it remaining:3:41:37 elapsed:1:50:36 postfix:- (16124:tqdm_logging.py:145)
3000 と 4000 は1,000の倍数なので、どちらも消えません。保存中かどうかは、名前の後ろに .orbax-checkpoint-tmp- が付いているかで見るのが確実です。4,000ステップの保存の記録です。名前を付け替えて保存を終えたのは 13:05:19(日本時間22時5分19秒)で、ls で見た22時6分には終わっていました。
12:46:21.633 [I] Progress on: 3.83kit/5.00kit rate:6.6s/it remaining:2:07:51 elapsed:3:24:44 postfix:- (16124:tqdm_logging.py:145)
12:46:34.781 [I] Progress on: 3.83kit/5.00kit rate:6.6s/it remaining:2:07:47 elapsed:3:24:58 postfix:- (16124:tqdm_logging.py:145)
12:46:47.890 [I] Progress on: 3.83kit/5.00kit rate:6.6s/it remaining:2:07:29 elapsed:3:25:11 postfix:- (16124:tqdm_logging.py:145)
12:47:01.008 [I] Progress on: 3.84kit/5.00kit rate:6.6s/it remaining:2:07:15 elapsed:3:25:24 postfix:- (16124:tqdm_logging.py:145)
12:47:14.130 [I] Progress on: 3.84kit/5.00kit rate:6.6s/it remaining:2:07:02 elapsed:3:25:37 postfix:- (16124:tqdm_logging.py:145)
12:47:27.246 [I] Progress on: 3.84kit/5.00kit rate:6.6s/it remaining:2:06:46 elapsed:3:25:50 postfix:- (16124:tqdm_logging.py:145)
12:47:40.390 [I] Progress on: 3.84kit/5.00kit rate:6.6s/it remaining:2:06:40 elapsed:3:26:03 postfix:- (16124:tqdm_logging.py:145)
12:47:53.517 [I] Progress on: 3.84kit/5.00kit rate:6.6s/it remaining:2:06:27 elapsed:3:26:16 postfix:- (16124:tqdm_logging.py:145)4,000ステップまでの loss は 0.0030〜0.0035 で、下がり方はゆるやかになった
学習を止めるまでのログから、50ステップごとの loss を全部抜き出しました。学習のログ(train_resume.log・1,274行)の残りは、約13秒ごとの進み具合の表示と、上に載せた保存の記録です。ログ全体は KIOXIA の lab/Log07/ に置いています。
grep "Step [0-9]*:" /workspace/logs/train_resume.log
Step 2000: grad_norm=0.0497, loss=0.0066, param_norm=1804.0771
Step 2050: grad_norm=0.0437, loss=0.0052, param_norm=1804.0790
Step 2100: grad_norm=0.0499, loss=0.0054, param_norm=1804.0842
Step 2150: grad_norm=0.0426, loss=0.0050, param_norm=1804.0894
Step 2200: grad_norm=0.0465, loss=0.0053, param_norm=1804.0938
Step 2250: grad_norm=0.0450, loss=0.0047, param_norm=1804.0984
Step 2300: grad_norm=0.0417, loss=0.0046, param_norm=1804.1028
Step 2350: grad_norm=0.0431, loss=0.0050, param_norm=1804.1074
Step 2400: grad_norm=0.0412, loss=0.0048, param_norm=1804.1106
Step 2450: grad_norm=0.0360, loss=0.0038, param_norm=1804.1140
Step 2500: grad_norm=0.0459, loss=0.0048, param_norm=1804.1178
Step 2550: grad_norm=0.0425, loss=0.0042, param_norm=1804.1206
Step 2600: grad_norm=0.0400, loss=0.0045, param_norm=1804.1237
Step 2650: grad_norm=0.0447, loss=0.0050, param_norm=1804.1274
Step 2700: grad_norm=0.0432, loss=0.0042, param_norm=1804.1302
Step 2750: grad_norm=0.0394, loss=0.0040, param_norm=1804.1334
Step 2800: grad_norm=0.0407, loss=0.0039, param_norm=1804.1359
Step 2850: grad_norm=0.0460, loss=0.0047, param_norm=1804.1381
Step 2900: grad_norm=0.0421, loss=0.0041, param_norm=1804.1406
Step 2950: grad_norm=0.0410, loss=0.0037, param_norm=1804.1428
Step 3000: grad_norm=0.0443, loss=0.0047, param_norm=1804.1448
Step 3050: grad_norm=0.0479, loss=0.0038, param_norm=1804.1469
Step 3100: grad_norm=0.0362, loss=0.0034, param_norm=1804.1487
Step 3150: grad_norm=0.0400, loss=0.0036, param_norm=1804.1503
Step 3200: grad_norm=0.0404, loss=0.0037, param_norm=1804.1520
Step 3250: grad_norm=0.0470, loss=0.0049, param_norm=1804.1534
Step 3300: grad_norm=0.0348, loss=0.0031, param_norm=1804.1553
Step 3350: grad_norm=0.0385, loss=0.0034, param_norm=1804.1562
Step 3400: grad_norm=0.0424, loss=0.0038, param_norm=1804.1575
Step 3450: grad_norm=0.0411, loss=0.0036, param_norm=1804.1584
Step 3500: grad_norm=0.0385, loss=0.0034, param_norm=1804.1599
Step 3550: grad_norm=0.0407, loss=0.0037, param_norm=1804.1610
Step 3600: grad_norm=0.0393, loss=0.0036, param_norm=1804.1619
Step 3650: grad_norm=0.0378, loss=0.0030, param_norm=1804.1631
Step 3700: grad_norm=0.0392, loss=0.0033, param_norm=1804.1641
Step 3750: grad_norm=0.0424, loss=0.0037, param_norm=1804.1647
Step 3800: grad_norm=0.0366, loss=0.0031, param_norm=1804.1655
Step 3850: grad_norm=0.0374, loss=0.0031, param_norm=1804.1663
Step 3900: grad_norm=0.0355, loss=0.0031, param_norm=1804.1669
Step 3950: grad_norm=0.0444, loss=0.0035, param_norm=1804.1675
Step 4000: grad_norm=0.0367, loss=0.0030, param_norm=1804.1680
Step 4050: grad_norm=0.0384, loss=0.0034, param_norm=1804.1687
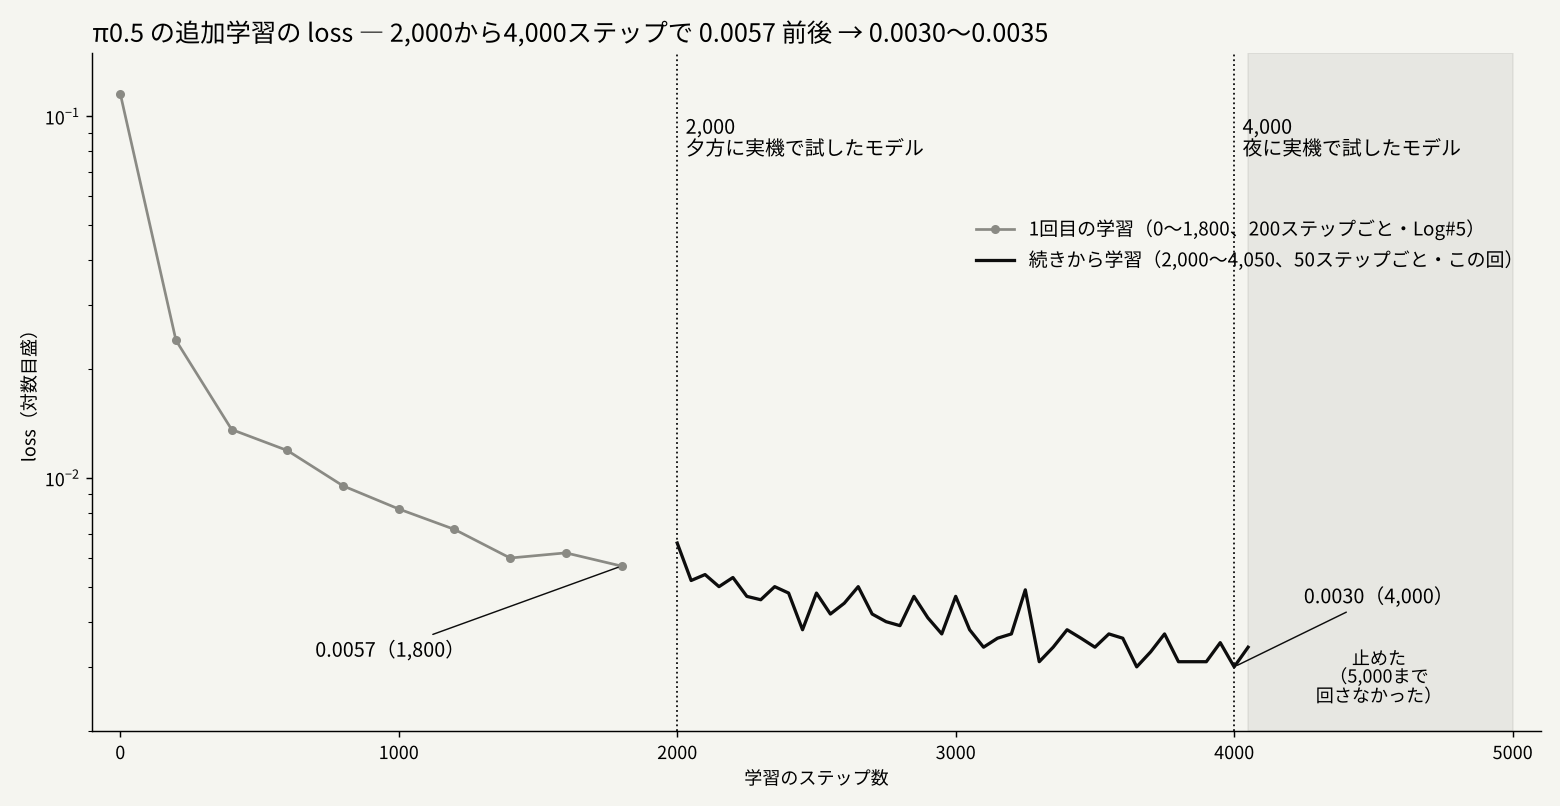
1,800ステップの 0.0057 から、4,000ステップでは 0.0030 まで下がっています。ただ、2,000から4,000の2,000ステップで下がったのは、0から2,000で下がった量に比べるとわずかで、50ステップごとの値も 0.0030〜0.0049 の間で上下しています。loss は、学習に使ったお手本の動きをどれだけ言い当てられるかの値です。お手本と同じ場面では当たるようになっていても、それが実機の別の場面でも当たるかは、loss からは分かりません。
アームの中の Raspberry Pi に、最初は届かなかった
サーバーを 4000 で起動し(この起動の記録は、あとで起動し直したときに上書きされて残っていません)、Mac でアーム側の待ち受け(デーモン)を確かめると、つながりませんでした。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % ssh -i ~/.ssh/id_rsa_pi ubuntu@192.168.2.1 'ss -ltn | grep 5555'
ssh: connect to host 192.168.2.1 port 22: Operation timed out
(base) shimazueiichi@shimadzueiichinoMacBook-Pro ~ % cd ~/r2r2r-scripts && python3 pi05/run_policy_client.py --max-chunks 5
[SAFE  ] 安全範囲 (学習 20 本 ±10°): j0[-52,+96]  j1[-9,+99]  j2[-52,+30]  j3[-24,+32]  j4[-90,+60]  j5[-51,-19]
[MODE  ] DRY-RUN (アームには送らない)  steps/chunk=5  max_move=20.0°  log=/Volumes/KIOXIA/r2r2r-data/runs/pi05_policy/pi05_20261017_221438
Traceback (most recent call last):
  File "/Users/shimazueiichi/r2r2r-scripts/pi05/run_policy_client.py", line 286, in <module>
    main()
  File "/Users/shimazueiichi/r2r2r-scripts/pi05/run_policy_client.py", line 193, in main
    get_daemon_socket()
  File "/Users/shimazueiichi/r2r2r-scripts/visual_servo_pick.py", line 528, in get_daemon_socket
    s.connect((DAEMON_HOST, DAEMON_PORT))
ConnectionRefusedError: [Errno 61] Connection refused
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts %
Operation timed out は、mechArm 270 の中の Raspberry Pi(アームを動かす小さなコンピュータ)が電源オフか、まだ起動中のときに出ます。アームの電源と線を確かめて、届くかを見ると、返事がありました。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts % ping -c 3 192.168.2.1
PING 192.168.2.1 (192.168.2.1): 56 data bytes
64 bytes from 192.168.2.1: icmp_seq=0 ttl=64 time=2.246 ms
64 bytes from 192.168.2.1: icmp_seq=1 ttl=64 time=1.316 ms
64 bytes from 192.168.2.1: icmp_seq=2 ttl=64 time=1.806 ms

--- 192.168.2.1 ping statistics ---
3 packets transmitted, 3 packets received, 0.0% packet loss
round-trip min/avg/max/stddev = 1.316/1.789/2.246/0.380 ms
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts %
Raspberry Pi の起動が終わったところでした。続けて、アームを HOME(たたまずに立てた待機姿勢)に戻したいと伝え、Claude は次のコマンドを出しました。デーモンが待ち受けていないときの起動のコマンドは Log#6 と同じです。
cd ~/r2r2r-scripts && python3 -c "
import visual_servo_pick as vsp, time
vsp.get_daemon_socket()
vsp.daemon_send_angles([0, 0, 0, 0, 0, -30], speed=20, wait=1)
time.sleep(5)
m = vsp.daemon_get_angles()
print('now:', [round(a, 1) for a in m] if m else None)
vsp.close_daemon_socket()
"
このあとのドライラン(予測を画面に出すだけで、アームには送らない試し)の記録では、アームは HOME(j0〜j4 がほぼ 0°、j5 が −30°)にありました。
4,000ステップのドライランは、動き出しが 2,000ステップより小さかった
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts % cd ~/r2r2r-scripts && python3 pi05/run_policy_client.py --max-chunks 5
[SAFE  ] 安全範囲 (学習 20 本 ±10°): j0[-52,+96]  j1[-9,+99]  j2[-52,+30]  j3[-24,+32]  j4[-90,+60]  j5[-51,-19]
[MODE  ] DRY-RUN (アームには送らない)  steps/chunk=5  max_move=20.0°  log=/Volumes/KIOXIA/r2r2r-data/runs/pi05_policy/pi05_20261017_221710
[POLICY] 接続 ws://localhost:8000  metadata={}
[000] 推論 565ms  5ステップ先  Δ= -4.8 +13.5  -5.5  +0.1 -10.5  -0.3
[001] 推論 786ms  5ステップ先  Δ= -3.4  +7.6  -2.4  +0.4  -5.8  -0.2
[002] 推論 1503ms  5ステップ先  Δ= -2.2  +6.0  -1.9  +0.3  -3.6  -0.2
[003] 推論 631ms  5ステップ先  Δ= -3.6  +8.2  -3.1  -0.0  -6.4  -0.0
[004] 推論 732ms  5ステップ先  Δ= +0.3  +0.0  +0.1  -0.0  +0.2  +0.0
[DONE  ] 記録: /Volumes/KIOXIA/r2r2r-data/runs/pi05_policy/pi05_20261017_221710
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts %
Δ は、今の関節角から 0.5秒先(5ステップ先)までに動かす量です(左から j0 ベース・j1 肩・j2 肘・j3・j4 手首・j5)。夕方の 2,000ステップのドライランの1回目は Δ= -6.0 +16.1 -7.8 -0.0 -13.0 -0.0 でした。同じ HOME からの動き出しが、少し小さくなっています。どちらも、お手本の「HOME から腕を伸ばし始める」動きと同じ向きです。
1つ、分からないことが残っています。新しく起動したサーバーの最初の推論は、準備の計算が入るので、夕方は55秒かかりました。この回の1回目は 565ms です。Claude は、本当に4,000ステップのモデルが動いているかを確かめるために、サーバーの記録を grep するよう案内しました。そのコマンドを打った画面が、サーバーを動かしている tmux の画面でした。
closed
INFO:websockets.server:connection open
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 56702) opened
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 56702) closed
^C
root@b07c796f894c:/workspace/openpi# grep -o "'step': [0-9]*, 'event_type': 'restore'" /workspace/logs/serve_4000.log
root@b07c796f894c:/workspace/openpi#
Ctrl+C でサーバーが止まり、grep は何も見つけませんでした。サーバーの記録には、学習のログのような 'step': …, 'event_type': 'restore' の行は出ない形でした。案内した側の取り違えです。
サーバーを起動し直すと、読み込んだのは 4000 の重みだと記録に出た
同じ画面で、サーバーを起動し直しました。
uv run scripts/serve_policy.py policy:checkpoint --policy.config=pi05_mecharm_lora --policy.dir=checkpoints/pi05_mecharm_lora/mecharm_v1/4000 2>&1 | tee /workspace/logs/serve_4000.log
この起動の記録(serve_4000.log)の全体です。最後の4行は、このあとの実機の2回がつないだ記録です。
INFO:root:Loading model...
INFO:2026-10-17 13:19:08,019:jax._src.xla_bridge:925: Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:jax._src.xla_bridge:Unable to initialize backend 'rocm': module 'jaxlib.xla_extension' has no attribute 'GpuAllocatorConfig'
INFO:2026-10-17 13:19:08,020:jax._src.xla_bridge:925: Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:jax._src.xla_bridge:Unable to initialize backend 'tpu': INTERNAL: Failed to open libtpu.so: libtpu.so: cannot open shared object file: No such file or directory
INFO:absl:orbax-checkpoint version: 0.11.13
INFO:absl:Created BasePyTreeCheckpointHandler: use_ocdbt=True, use_zarr3=False, pytree_metadata_options=PyTreeMetadataOptions(support_rich_types=False), array_metadata_store=<orbax.checkpoint._src.metadata.array_metadata_store.Store object at 0x7088bbd9b550>
INFO:absl:Restoring checkpoint from /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/params.
INFO:absl:[thread=MainThread] Failed to get flag value for EXPERIMENTAL_ORBAX_USE_DISTRIBUTED_PROCESS_ID.
INFO:absl:[process=0] /jax/checkpoint/read/bytes_per_sec: 948.6 MiB/s (total bytes: 6.3 GiB) (time elapsed: 6 seconds) (per-host)
INFO:absl:Finished restoring checkpoint in 6.84 seconds from /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/params.
INFO:root:Loaded norm stats from /workspace/openpi/assets/pi05_mecharm_lora/local/mecharm_redblock_box_v1
INFO:root:Loaded norm stats from /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/assets/local/mecharm_redblock_box_v1
INFO:root:Creating server (host: b07c796f894c, ip: 172.27.0.2)
INFO:websockets.server:server listening on 0.0.0.0:8000
INFO:websockets.server:connection open
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 35848) opened
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 35848) closed
INFO:websockets.server:connection open
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 46748) opened
INFO:openpi.serving.websocket_policy_server:Connection from ('127.0.0.1', 46748) closed
Restoring checkpoint from /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/params. と、4000 の重み(6.3GiB)を読み込んでいます。このあとの実機の1回目は、最初の推論に 51.5秒かかりました(記録の latency_s)。ドライランのときの 565ms がなぜ速かったのかは、最初の起動の記録が上書きされて残っていないため、確かめられていません。
実機の1回目は、ブロックの奥でグリッパーを閉じた
ブロックを夕方と同じ位置に置き、アームを HOME にして、横から動画を撮りながら1秒先(10ステップ)ずつ送りました(22時20分)。
cd ~/r2r2r-scripts && python3 pi05/run_policy_client.py --execute --steps-per-chunk 10
この回の画面の表示は残していません。記録(log.jsonl)から、chunk ごとの関節角を並べました。chunk は、π0.5 が1回の推論で返す動きのまとまりで、この回は1回に10ステップ(1秒分)ずつアームに送っています。この記録の読み方は次の節に載せたスクリプトで、2回目と、夕方の 2,000ステップの回も同じ形で出しています。
横から撮った動画のコマです。最初の約100秒、アームは HOME のまま動いていません。サーバーを起動し直したあとの最初の推論に 51.5秒かかったのと、その前後の待ちです。
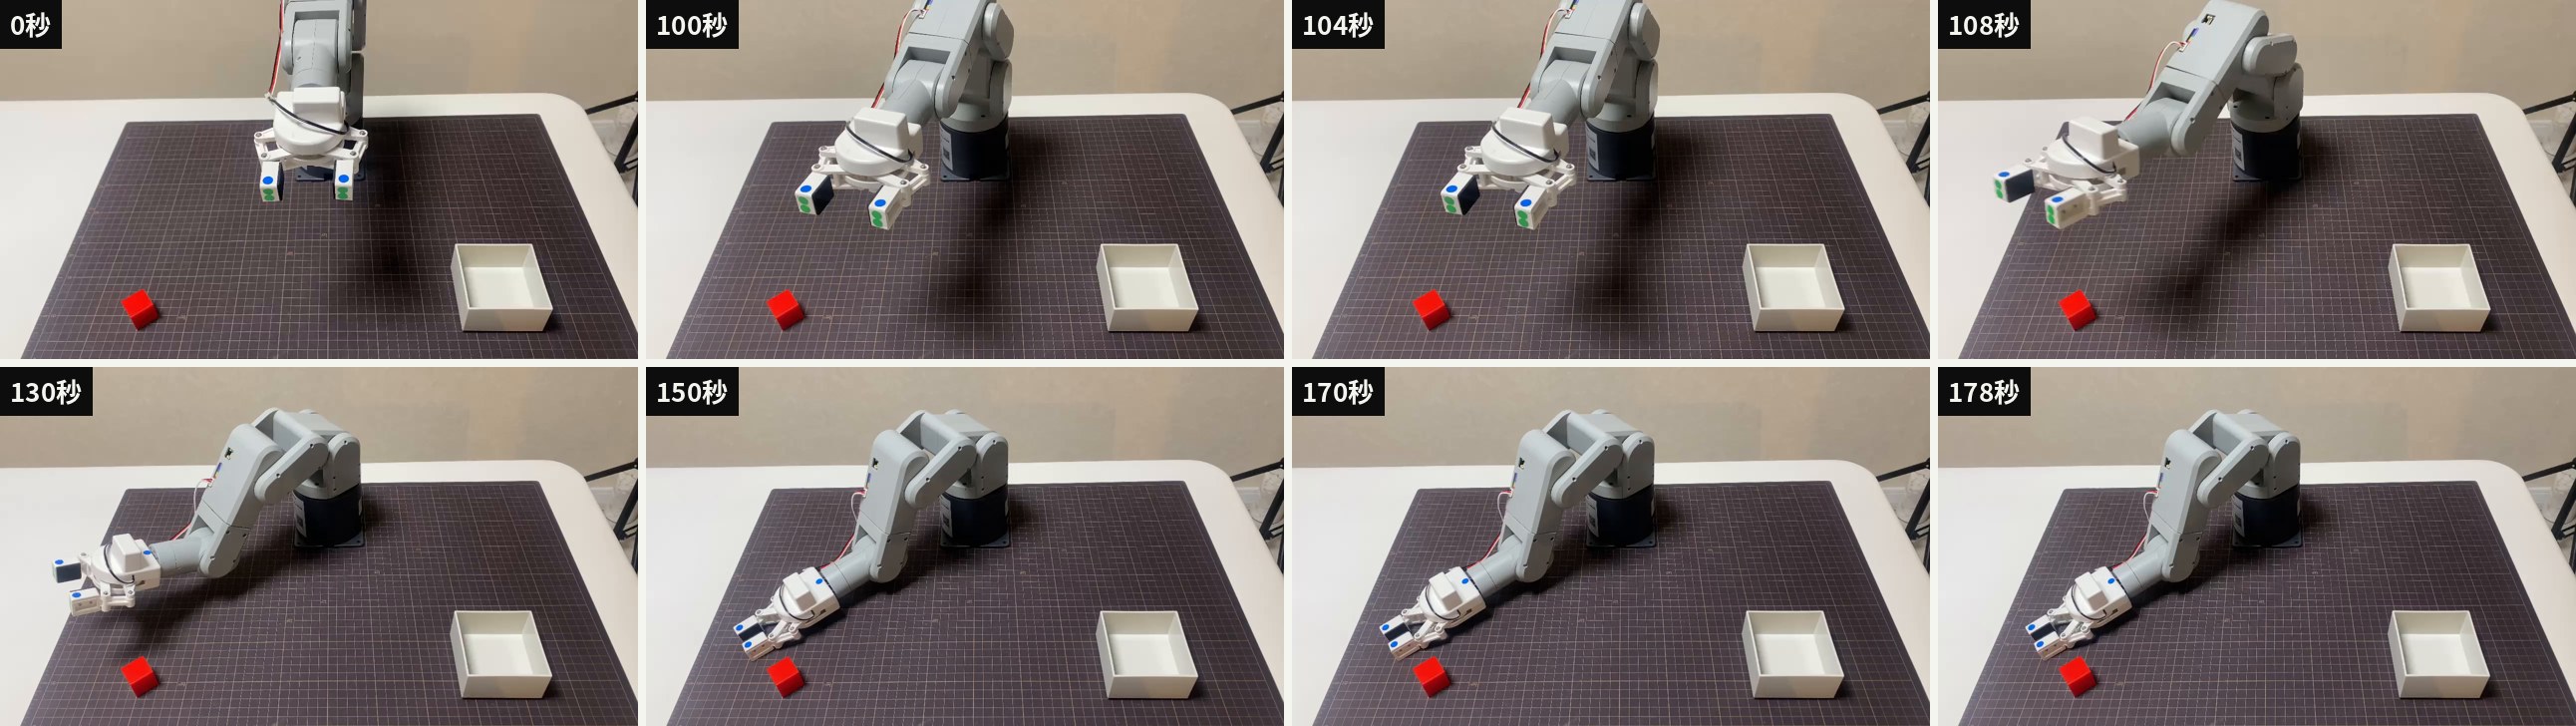
グリッパーのあたりを拡大しました。150秒以降、2本の爪はブロックの奥(カメラから見て向こう側)に下り、ブロックをはさまずに閉じています。
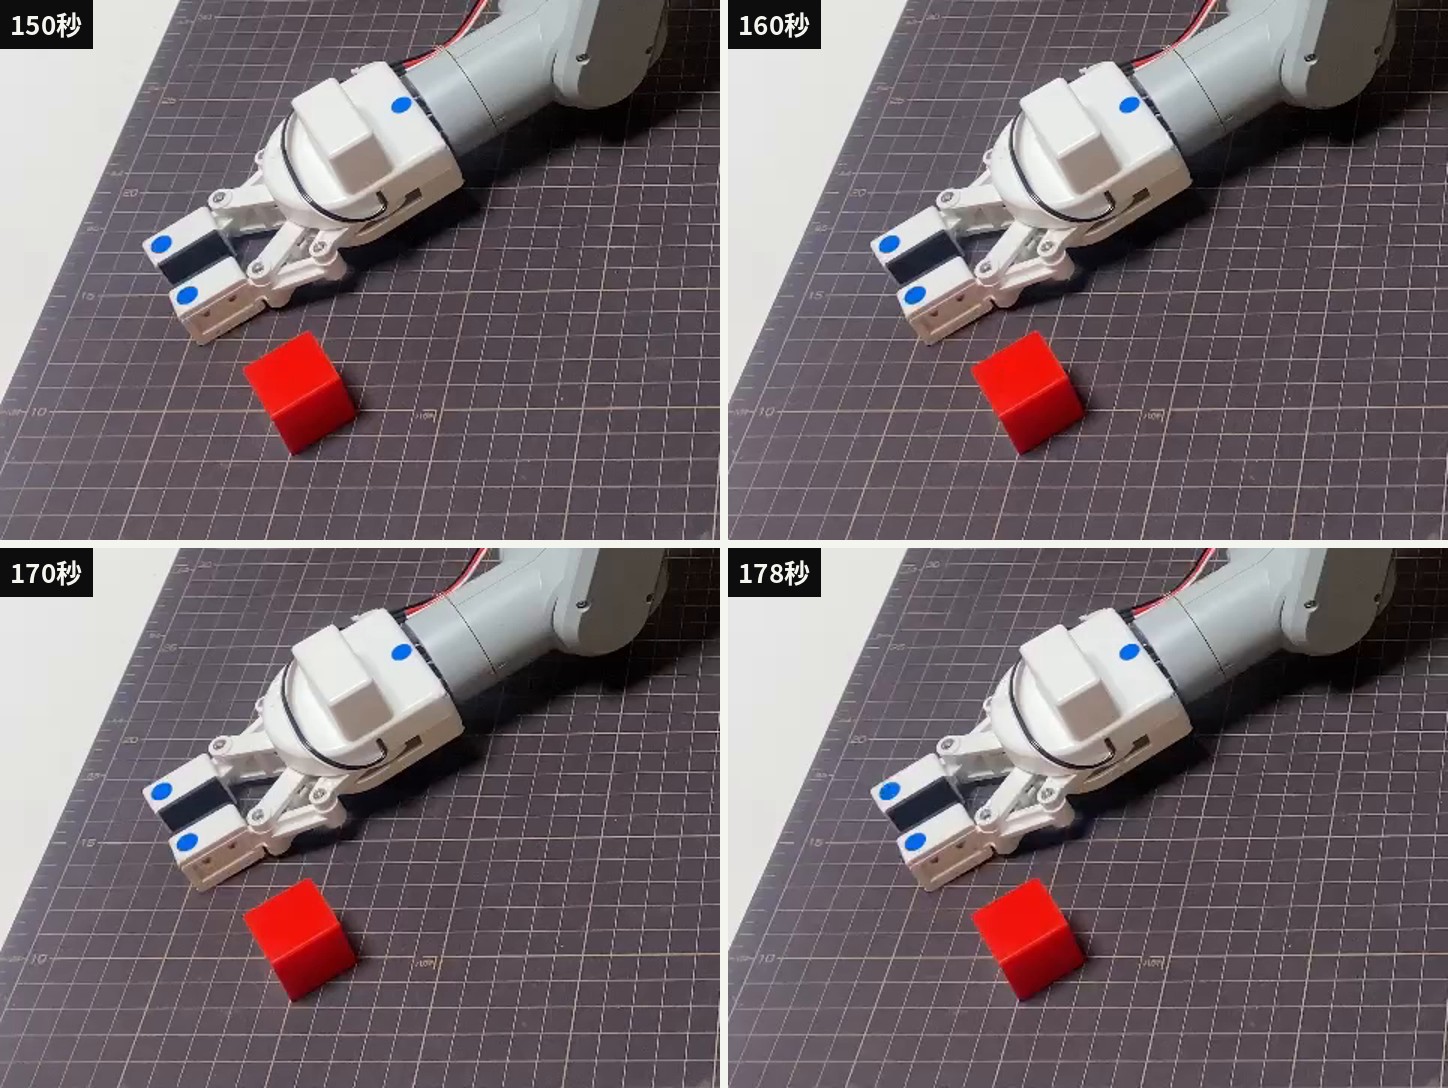
見た印象はこうでした。
爪はかなり奥に離れていました。高さとかは良さそうです。あとは爪の位置ですね。
実機の2回目も、同じ場所でグリッパーを閉じた
ブロックの位置は動かさず、続けてもう1回送りました(22時27分)。今度は画面の表示を全部残しています。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts % cd ~/r2r2r-scripts && python3 pi05/run_policy_client.py --execute --steps-per-chunk 10
[SAFE  ] 安全範囲 (学習 20 本 ±10°): j0[-52,+96]  j1[-9,+99]  j2[-52,+30]  j3[-24,+32]  j4[-90,+60]  j5[-51,-19]
[MODE  ] EXECUTE  steps/chunk=10  max_move=20.0°  log=/Volumes/KIOXIA/r2r2r-data/runs/pi05_policy/pi05_20261017_222723
[POLICY] 接続 ws://localhost:8000  metadata={}
[GRIP  ] 開始時にグリッパーを開く
  [Pi] GRIPPER: OPEN result= -1
[000] 推論 817ms  10ステップ先  Δ= -3.5  +7.9  -3.5  -0.4  -6.0  -0.1
Enter=実行 / s=送らず次へ / h=HOMEに戻して終了 / q=終了 > chunk1〜3 の3回で、1回の指令の上限(±20°)いっぱいに腕を伸ばし、chunk4 でブロックの上に来ました。chunk5〜8 では、j2(肘)と j4(手首)を少しずつ動かして、グリッパーの先を下ろしています。chunk9 で π0.5 が「グリッパー→閉」を出し、指令はすべて届きました(arrival OK)。夕方の 2,000ステップの回のように、手首が途中で止まる 未到達 は一度も出ていません。グリッパーを閉じたのは、1回目と同じくブロックの奥でした。
つかむ瞬間の土台と肩の角度は、2,000ステップの回とほぼ同じだった
3回の記録(夕方の 2,000ステップ・夜の 4,000ステップ2回)から、chunk ごとの関節角と、グリッパーを閉じたときの姿勢を、お手本19本がグリッパーを閉じた瞬間の範囲(Log#6 で出した値)と並べました。KIOXIA の記録を Claude の作業環境に写して動かしています。
"""LOG348: 2,000 ステップと 4,000 ステップの実機の記録(log.jsonl)から、
chunk ごとの関節角と、グリッパーを閉じたときの姿勢を並べる。"""
import json, sys
from pathlib import Path

runs = {
    "2000 (17:46)": "pi05_20261017_174600",
    "4000 1回目 (22:20)": "pi05_20261017_222053",
    "4000 2回目 (22:27)": "pi05_20261017_222723",
}
root = Path(sys.argv[1]) / "runs/pi05_policy"
J = [0, 1, 2, 4]  # j0 ベース, j1 肩, j2 肘, j4 手首
demo = {0: (-42.3, -28.3, -36.0), 1: (86.0, 89.1, 88.3), 2: (-33.4, -28.0, -31.2), 4: (-57.4, -47.8, -51.5)}

for name, d in runs.items():
    rows = [json.loads(l) for l in open(root / d / "log.jsonl")]
    print(f"== {name}  {d}  chunk数={len(rows)}")
    print("chunk  latency  state(j0 j1 j2 j4 grip)                 target(j0 j1 j2 j4)          executed arrived grip_cmd")
    for r in rows:
        s = r["state"]; t = r.get("target")
        ts = " ".join(f"{t[j]:+7.1f}" for j in J) if t else "   -"
        print(f"{r['chunk']:>5}  {r['latency_s']:>6.2f}s  " + " ".join(f"{s[j]:+7.1f}" for j in J) + f"  {s[6]:.0f}   {ts}   {str(r.get('executed')):>5} {str(r.get('arrived')):>5} {r.get('grip_cmd')}")
    closed = [r for r in rows if r["state"][6] > 0.5]
    last = closed[0] if closed else rows[-1]
    tag = "グリッパーを閉じた直後" if closed else "最後の chunk(閉じていない)"
    print(f"  {tag}: chunk {last['chunk']}  " + "  ".join(f"j{j}={last['state'][j]:+.1f}" for j in J))
    for j in J:
        lo, hi, mean = demo[j]; v = last["state"][j]
        where = "範囲内" if lo <= v <= hi else (f"範囲の外 {v-hi:+.1f}" if v > hi else f"範囲の外 {v-lo:+.1f}")
        print(f"    j{j}: {v:+6.1f}  お手本 {lo:+.1f}〜{hi:+.1f}(平均 {mean:+.1f})  {where}")
python3 grasp_compare.py r2r2r-data
== 2000 (17:46)  pi05_20261017_174600  chunk数=10
chunk  latency  state(j0 j1 j2 j4 grip)                 target(j0 j1 j2 j4)          executed arrived grip_cmd
    0    0.83s     -0.2    +1.3    +0.9    -0.3  0      -1.2    +4.4    -0.2    -2.5    True  True None
    1    0.59s     -1.5    +5.4    +0.9    -1.2  0      -3.6    +8.6    -1.3    -4.5    True  True None
    2    0.56s     -4.0    +9.5    +0.8    -4.2  0     -15.0   +29.5   -10.8   -24.2    True  True None
    3    0.71s    -14.9   +30.6    -9.0   -23.9  0     -28.7   +50.6   -23.0   -43.9    True  True None
    4    1.57s    -28.4   +51.8   -21.4   -43.4  0     -40.0   +71.8   -34.8   -63.4    True  True None
    5    0.60s    -39.7   +72.9   -33.3   -63.2  0     -46.1   +88.5   -39.4   -69.5    True  True None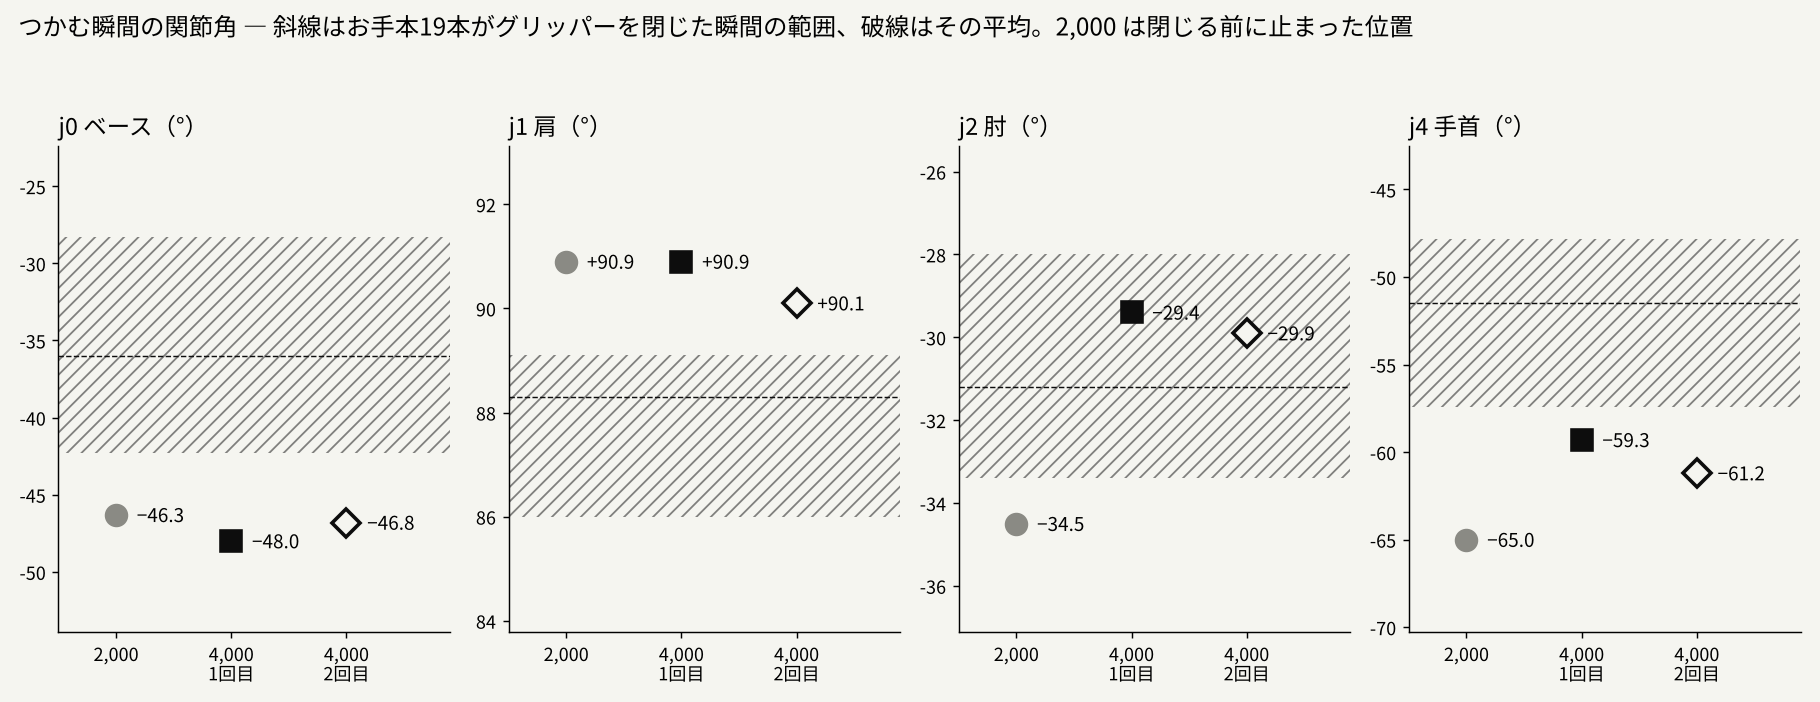
| 関節 | 2,000(夕方・止まった位置) | 4,000 1回目(閉じた直後) | 4,000 2回目(閉じた直後) | お手本19本がつかんだ瞬間 |
|---|---|---|---|---|
| j0 ベース | −46.3° | −48.0° | −46.8° | −42.3〜−28.3°(平均 −36.0°) |
| j1 肩 | +90.9° | +90.9° | +90.1° | +86.0〜+89.1°(平均 +88.3°) |
| j2 肘 | −34.5° | −29.4° | −29.9° | −33.4〜−28.0°(平均 −31.2°) |
| j4 手首 | −65.0° | −59.3° | −61.2° | −57.4〜−47.8°(平均 −51.5°) |
分かったのは次の3つです。
- 土台(j0)と肩(j1)は、3回ともほぼ同じ角度。 j0 は −46.3〜−48.0°、j1 は +90.1〜+90.9° で、どちらもお手本のどの回よりも外です。j0 はお手本の端より 4〜6° 余計に回り、j1 はお手本の端より 1〜2° 前に倒れています。腕を伸ばす先は、学習の量を2倍にしても変わっていません
- 肘(j2)と手首(j4)は、4,000ステップでお手本の範囲の近くまで下りた。 2,000ステップの回は、手前の爪がブロックの上に乗って、手首が −65° で止まりました。4,000ステップの2回は、爪がブロックに当たらずに下りきり、
未到達も出ていません - ブロックの上に来てから、肩(j1)が1 chunk に約 +1° ずつ前に出続けた。 1回目は chunk4 の +80.1° から chunk11 の +90.9° まで、2回目は chunk4 の +73.5° から chunk10 の +90.1° まで、止まらずに進んでいます。お手本の平均では、ブロックの上に来てからつかむまでの約4秒で、j1 は +83.3° から +84.9° までしか動いていません
上のカメラの画像(π0.5 に送った入力そのもの)を、3回で並べました。
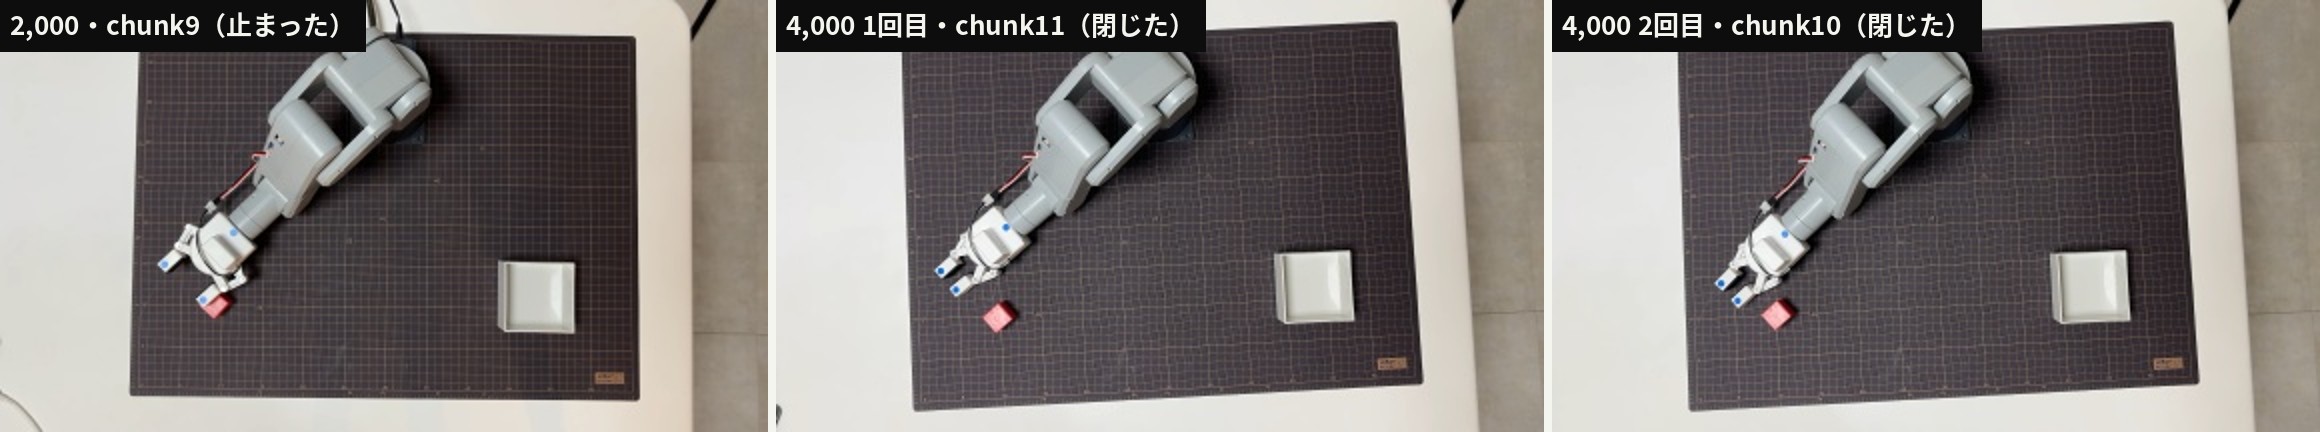
2,000ステップの回で爪がブロックに乗り、4,000ステップの回でブロックの奥に下りた違いは、学習の違いだけでは言えません。夕方と夜の HOME の画像を並べると、ブロックの置き場所とカメラの写り方は、画像の上でわずかにずれています。
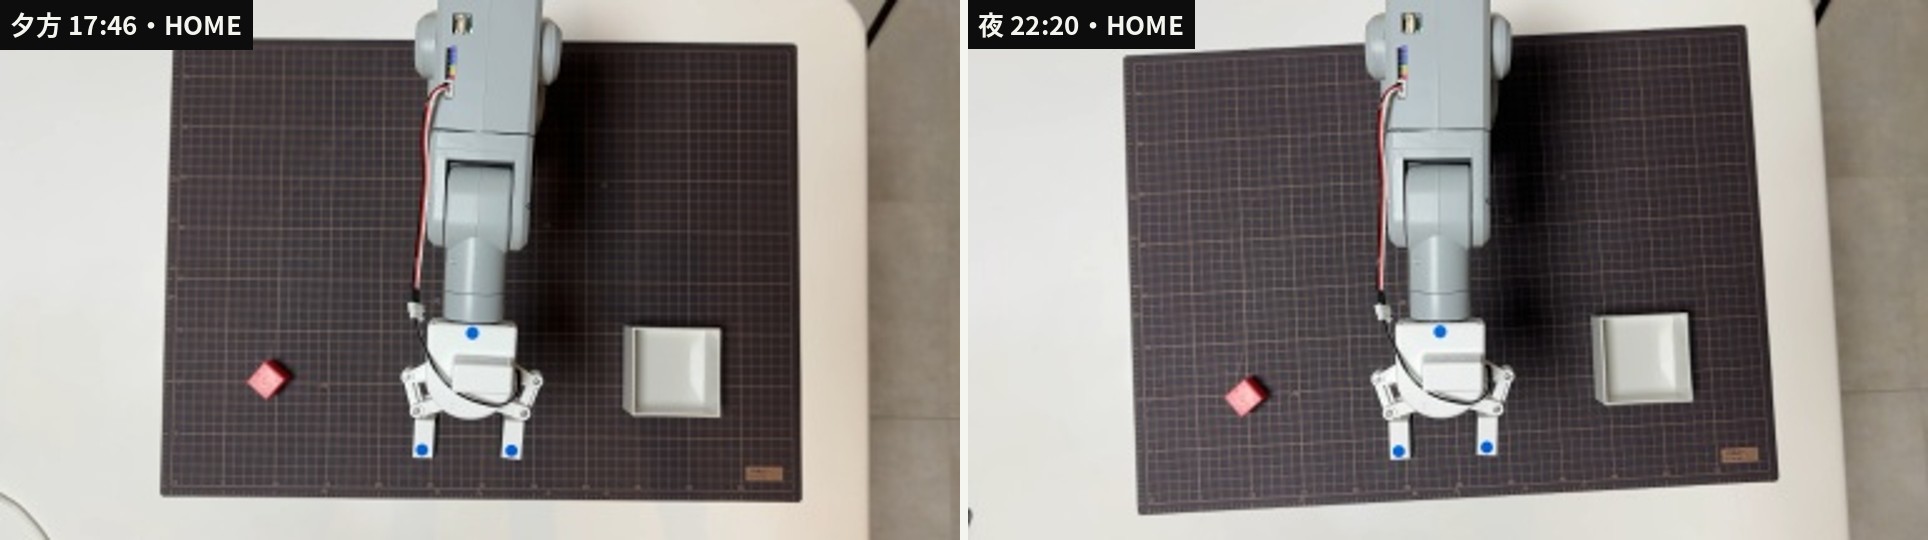
狙う先の関節角がほぼ同じで、ブロックの位置がわずかに違えば、爪がブロックに乗るか、ブロックをかすめて奥に下りるかは変わります。どちらの回も、2本の爪の間にブロックは入っていません。
位置の違うお手本を、今のアームでどう作るか
結果を見ながら、Claude と次の手を話しました。
アームのブロック掴む位置がいろんな位置があった方がほうとうは学習としてはよいってことですか?
π0.5 はカメラの画像を見て次の動きを決めますが、「画像のこのあたりに赤い物があるときは、ここへ手を伸ばす」という対応を覚えられるのは、お手本の中でブロックの位置が変わり、位置ごとに動きが違うときだけです。今のお手本19本は、スクリプト(カメラで色と輪郭からブロックの座標を計算して動かす、これまでのプログラム)で集めたもので、成功率を上げるために置く範囲を狭くしていました。
なるほどね。mecharmだとこれ以上難しいかなー。やはりリーダーアームのあるso101とかじゃないと何回も成功させるのは難しいね。
やはりリーダーアームがないと膨大な量の試行をやらないとダメそうだね。
Claude は最初、「お手本の数はリーダーアーム(人が手で動かす操作用のアームで、その動きをもう1台にまねさせる仕組み)でも数十本で変わらない。mechArm で詰まるのは手首の熱」と答えました。これは取り違えでした。
いやmecharmはブロックの位置にアームがいかないから困ってんでしょ。熱の問題なんてあんまり関係ないって。、
スクリプトで集める限り、ブロックを置ける範囲は、スクリプトが正確に届く狭い範囲までです。外側に置くと、スクリプトがつかめないので、成功したお手本が集まりません。ここが mechArm の詰まりで、手首の熱は副次的な問題です。リーダーアームなら、人が見ながら位置を合わせるので、スクリプトの精度が足りない所でもお手本が作れます。
mechArm で残っている手として、Claude はサーボの力を抜いて手で動かし、関節角を記録する方法(ダイレクトティーチング)を出しました。
ダイレクトティーチングはカメラに人の手が映るから学習系ではダメだねー。実際動かす時には腕は映ってないわけだし。
そこで、手で教えた動きを、手を離してアームに再生させ、その再生のほうを記録する形にしました。
- ブロックの位置をマットに印で決める
- サーボの力を抜き、手でアームを動かしてつかませ、関節角だけを記録する(このときの画像は使わない)
- ブロックを印の位置に戻す
- 記録した関節角を、サーボの力を入れて再生し、そのときの上のカメラの画像と関節角をお手本にする
これでうまくできるならそれでもいいよね。
記録するのはブロックを掴む位置だけでいいの?
学習に入れるのは HOME から箱に置いて戻るまでの動き全部ですが、手で教えるのはブロックごとに変わる2つの姿勢(ブロックの真上と、つかむ位置)だけにし、残り(HOME・持ち上げ・箱の上・箱に置く姿勢)は今のスクリプトの姿勢を使い回して、再生のときになめらかにつなぐ案(A)と、動き全部を手で動かして記録する案(B)を比べました。B は、手で動かした速さのむらや揺れを再生でそのままなぞるので、mechArm では届かない角度が出やすくなります。
まぁaかな。
次は A で進めます。注意点は2つです。
- 学習に入れる関節角は、手で教えた角度ではなく、再生のときに実際に届いた角度にする。画像と合うのはこちら
- 再生した動きが、手で動かしたときと同じ位置に届くかは分からない。最初に1か所で3回再生して、3回ともつかめるかを確かめる。外れるなら、再生の精度が足りないということで、SO-101(リーダーアームのあるアーム)に進む判断の材料になる
関節を動かすコードなので、Claude が設計を書き、Claude Code が作り、codex か gemini のレビューを通してから実機で試します。
モデルを持ち帰るコマンドは、Mac の xargs の長さの上限で止まった
4,000ステップのモデルを KIOXIA に持ち帰るために、実機の試しと同時に、6本同時に送るコマンドを動かしていました。
cd /Volumes/KIOXIA/r2r2r-data/checkpoints/pi05_mecharm_lora_v1 && ssh -p <SSH_PORT> -i ~/.ssh/id_ed25519 root@<POD_IP> "cd /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000 && find . -type f" | xargs -P 6 -I{} sh -c 'mkdir -p "4000/$(dirname "{}")" && scp -q -P <SSH_PORT> -i ~/.ssh/id_ed25519 "root@<POD_IP>:/workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/{}" "4000/{}"' && echo DONE
Pod 側のファイルの数と合計の大きさです。
root@b07c796f894c:/# cd /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000 && find . -type f | wc -l && find . -type f -printf '%s\n' | awk '{s+=$1} END {print s}'
37
9516832417
Claude が KIOXIA 側を数えると、22時12分に始めてから18分たっても、届いていたのは最初の小さいファイル1つでした。
cd $HOME/mnt/KIOXIA/r2r2r-data/checkpoints/pi05_mecharm_lora_v1/4000 2>/dev/null && find . -type f | wc -l && find . -type f -printf '%s\n' | awk '{s+=$1} END {print s}'
1
426
原因は Claude が出したコマンドです。Mac の xargs -I{} は、{} を埋め込んだあとの1つの引数を 255バイトまでしか作れません。sh -c '…' の中に {} を3回埋め込んだので、_CHECKPOINT_METADATA のような短い名前は通り、params/ocdbt.process_0/d/… のような長い名前で引数が長すぎて止まっていました。埋め込みをやめ、ファイル名を sh -c の引数($1)で渡す形に直しました。
時間に合わせて、train_state(3GB)は持ち帰らないことにしました。学習を途中から続けるためだけのもので、次はお手本を足して学習し直すので使いません。推論に使う params・assets・_CHECKPOINT_METADATA だけを送ります。
root@b07c796f894c:/workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000# cd /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000 && find . -type f -not -path './train_state/*' | wc -l && find . -type f -not -path './train_state/*' -printf '%s\n' | awk '{s+=$1} END {print s}'
23
6335823878
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts % cd /Volumes/KIOXIA/r2r2r-data/checkpoints/pi05_mecharm_lora_v1 && ssh -p <SSH_PORT> -i ~/.ssh/id_ed25519 root@<POD_IP> "cd /workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000 && find . -type f -not -path './train_state/*'" | xargs -P 6 -n 1 sh -c 'mkdir -p "4000/$(dirname "$1")" && scp -q -P <SSH_PORT> -i ~/.ssh/id_ed25519 "root@<POD_IP>:/workspace/openpi/checkpoints/pi05_mecharm_lora/mecharm_v1/4000/$1" "4000/$1"' _ ; echo DONE
DONE
(base) shimazueiichi@shimadzueiichinoMacBook-Pro pi05_mecharm_lora_v1 %
22時31分に始めて、22時45分に DONE が出ました。KIOXIA 側を数え直すと、Pod と同じでした。
cd $HOME/mnt/KIOXIA/r2r2r-data/checkpoints/pi05_mecharm_lora_v1/4000 && find . -type f | wc -l && find . -type f -printf '%s\n' | awk '{s+=$1} END {print s}'; ls
23
6335823878
_CHECKPOINT_METADATA
assets
params
学習と推論のログも、Pod から KIOXIA に持ち帰りました。
(base) shimazueiichi@shimadzueiichinoMacBook-Pro r2r2r-scripts % scp -P <SSH_PORT> -i ~/.ssh/id_ed25519 "root@<POD_IP>:/workspace/logs/*.log" /Volumes/KIOXIA/r2r2r-data/lab/Log06/
serve.log                                     100% 4541    11.7KB/s   00:00
serve_4000.log                                100% 2246     5.1KB/s   00:00
train_resume.log                              100%  169KB 167.9KB/s   00:01
このときは Log#6 のフォルダに入れていたので、記事を書くときに Claude が lab/Log07/ にコピーしました。そのあと、Runpod の画面で Pod を Stop → Terminate で削除しました。
A40 を借りた時間と費用
| 項目 | 値 |
|---|---|
| Pod | NVIDIA A40(48GB)× 1、Runpod On-Demand、ディスク 80GB 指定、1時間約0.6ドル(約95円) |
| 作成 | 2026-10-17 7時56分ごろ(日本時間・Log#6) |
| 学習の再開 | 18時21分(2,000ステップの続きから) |
| 4,000ステップの保存 | 22時5分19秒 |
| 学習を止めた | 22時11分ごろ(4,050ステップ) |
| 実機テスト | 22時17分〜22時29分(ドライラン1回、実機2回) |
| モデルの持ち帰り | 22時31分〜22時45分(6.3GB) |
| 削除 | 22時45分すぎ |
| この回の分(18時21分〜) | 約4時間30分、約2.8ドル(約442円)(時間から計算した値。請求の画面では確かめていない) |
Pod 1台の合計(7時56分〜) | 約15時間、約9ドル(約1,422円)(同上) |
1台の合計の約9ドル(約1,422円)のうち、約5ドル(約790円)は、朝にモデルを送ってから夕方まで何もせずに置いていた時間の分です(Log#6)。学習そのものに使ったのは、この回の約4時間です。
保存先と、次にやること
| データ | 場所(KIOXIA の r2r2r-data/ 以下) |
|---|---|
学習したモデル(4,000ステップ・推論に使う分) | checkpoints/pi05_mecharm_lora_v1/4000/(params・assets・_CHECKPOINT_METADATA。train_state は持ち帰っていない) |
学習したモデル(2,000ステップ) | checkpoints/pi05_mecharm_lora_v1/1999/ |
| 学習と推論のログ | lab/Log07/(train_resume.log・serve_4000.log) |
| 横から撮った動画のコマ | lab/Log07/20261017_pi05_4000_frames.jpg |
| 実機・ドライランの記録 | runs/pi05_policy/pi05_20261017_221438/・221710/・222053/・222723/ |
次にやるのは、位置の違うお手本を作る仕組みです。
- 手で教える2つの姿勢(ブロックの真上・つかむ位置)の記録、再生、再生中の記録、LeRobot 形式(Hugging Face が公開しているロボット学習のライブラリ LeRobot のデータの形。openpi の学習もこの形で読み込む)への変換までの設計を書く
- Claude Code が作り、codex か gemini のレビューを通す
- ブロックを1か所に置き、手で1回教えて3回再生する。3回ともつかめるかを見る
- つかめれば、ブロックを置く場所を9か所(3×3)に広げ、1か所につき3〜5本、合わせて30〜45本を集めて学習し直す。試すときは、お手本にない位置にもブロックを置き、そこで爪の位置が合うかで、モデルが画像からブロックの位置を読んでいるかを確かめる