Pixelsの起源が二つに増える | ブロック認識とマット撤廃が同じ問いに収束した話
ブロックの色マスク(HSV)と、黒マットによる座標固定。入力側のこの二つの地層を同時に書き換える道が見えてきた。
R2R2Rの視覚パイプラインは今、HSV色マスクで赤ブロックを検出し、机に敷いた黒マットの四隅から座標系を決めている。動作の発展は進んでいるが、入力側の地層は一度も書き換えていない。
ある対話の中で、二つの別々の問いが出てきた。「ブロックの色じゃなくて、ブロックそのものをAIに認識させるにはどうするか」と、「マットを使わずに位置を割り出すにはどうするか」。
最初は別々の話だった。深掘っていくと、同じ場所で交わった。両方とも、Pixels to MotorsのPixelsの起源を増やすアプローチに他ならない。この記事はその思考の道筋を残す。
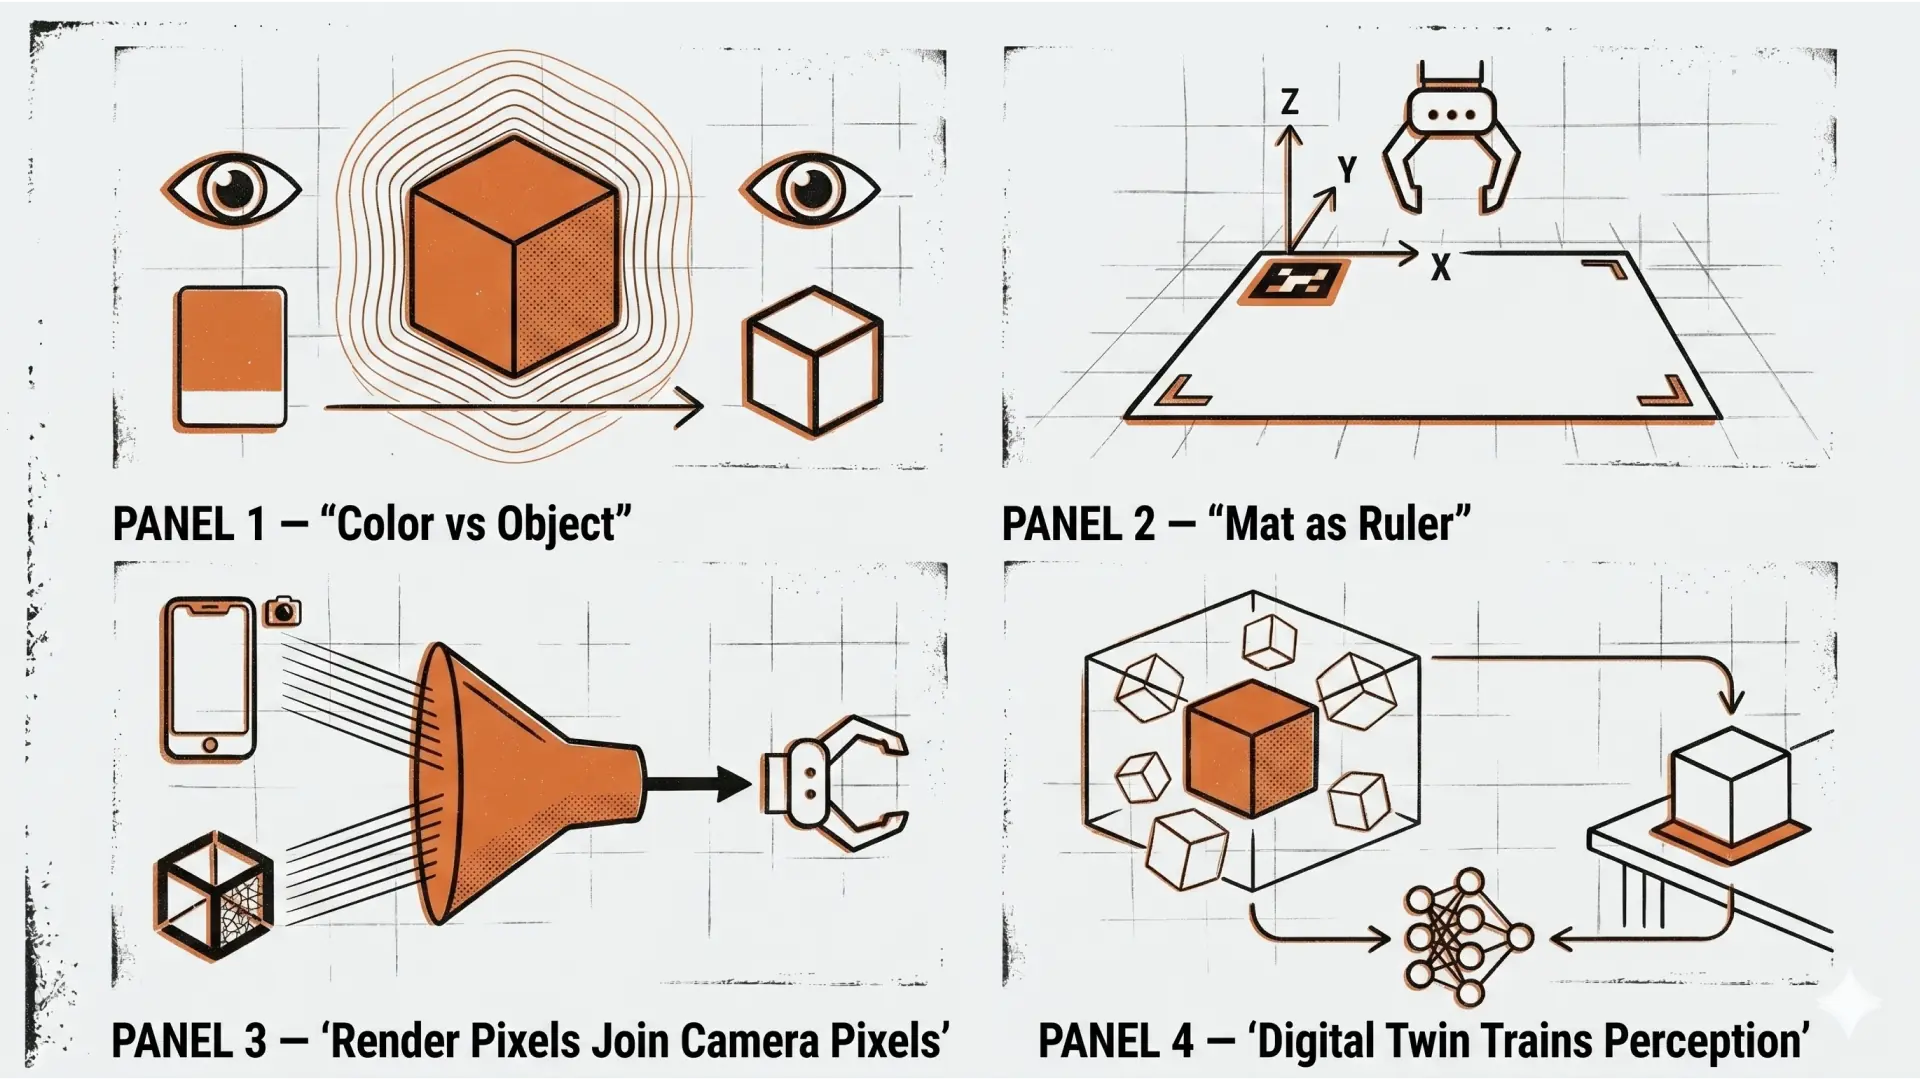
色を見るのと、物を見るのは違う
— 今のブロック検出は、何を見ている?
「HSVで赤い領域の重心を取ってる。これは色を見てるだけで、ブロックを見てるわけじゃない。赤いマットや赤い影、赤い服が映ったら壊れる」
ここが出発点。視覚サーボの動的追従シリーズの中で、「色」と「物」の違いを意識する場面は来ていなかった。いま使っているのは、色マスク + 輪郭抽出 + 重心計算 という古典CVのスタック。動いている。ただし、動いているのは「赤いピクセルがそこにあるから」であって、「ブロックがそこにあるから」ではない。
この差は今は問題にならない。マットの内側だけを探索しているし、机の上に赤いものは他にない。問題にならないことと、見えていないことは違う。
ブロックそのものを認識させるアプローチを並べると、四つの層に分かれる。
層 | 手法 | 学習 | レイテンシ | コスト |
|---|---|---|---|---|
1 | 古典CV強化(形状フィルタ + テンプレート) | なし | <50ms | 0 |
2 | YOLOv8ファインチューニング | あり(小規模) | 30-100ms | 数百円 |
3 | VLM呼び出し(Claude / GPT-4o) | なし | 1-3秒 | API課金 |
4 | SAM2 / Grounding DINO(オープンボキャブラリ) | なし | 1-3秒 | GPU推奨 |
リアルタイム制御で使えるのは1と2。3はR2R2Rの報酬モデル側で既に方針が立っている用途——「掴めたか」「置けたか」の意味判定。4は重い。
R2R2Rのブランド方針「学習済みモデルをもらって、動きの品質と体験を作る」を踏まえると、自前学習のYOLOv8は微妙な位置にいる。でもブロック認識という具体的なタスクに対して、最もストレートに答えるのは2。「iPhoneで撮ったブロック数十枚で、ロボットがブロックを見分けられるようになった」というストーリーは、コアメッセージと同じ構造を持っている。
ここで一旦、ブロック認識の話は保留した。もう一つの問いを並べたかった。
マットは「世界に置いた物差し」だった
— 今は黒マットを認識して、それを基準にx, zを割り出している。マットなしで位置を取るにはどうする?
「マットを完全になくす方向と、シール一枚で済ます中間ステップが両方ある気がする」
マットがやっている仕事は二つある。カメラのピクセルとロボット座標の対応を決めること。そして机の平面をZ=0として固定すること。マットを外すというのは、この二つの仕事を別の方法に引き継ぐということ。
アプローチを並べると、こうなる。
手法 | マット | ハード追加 | 精度 |
|---|---|---|---|
1. カメラキャリブ + 平面仮定 | 不要 | なし | mm単位 |
2. ArUcoマーカー1枚で原点 | 不要(シール1枚) | なし | mm単位 |
3. Hand-Eye Calibration | 不要 | なし | mm単位 |
4. LiDAR / 深度センサで平面検出 | 不要 | iPhone Pro必須 | cm単位 |
5. VLM空間推論 | 不要 | なし | cm単位 |
すぐにできる現実解は、3のHand-Eye Calibration。LOG184で確立した「グリッパーに貼った青シール3点をカメラで追跡する」ロジックが、そのまま流用できる。グリッパーを既知の姿勢に動かして、その時のカメラ検出位置と順運動学計算位置を対応させれば、カメラとロボットの幾何関係が自動で求まる。マットの第一の仕事「座標の対応」はこれで終わる。
第二の仕事「机の平面」は、平面仮定で済ます道と、深度で測る道がある。iPhone 14 ProにはLiDARがある。Record3D経由でRGB+深度をMacに送れる。これで「机の平面を測る」が実装に乗る。
ここまで整理して気づいたのは、マット撤廃の話とブロック認識の話が、深度センサとカメラという同じ入力を共有しているということだった。
最先端は、もう座標を出していない
— 現状の最先端のロボットアームには、マットもマーカーも見当たらない。どうやって位置を出している?
「Tesla Optimus、Figure 02、1X NEOあたり。普通に部屋で動いてる」
ここで研究と製品の地層を一段下げて見ると、技術スタックの分布が思った以上に分かれていることが見える。
系譜 | 必要なもの | 代表 |
|---|---|---|
End-to-End VLA | 大量テレオペデータ + GPU | RT-2 / OpenVLA / π0 / Figure Helix / Optimusポリシー |
6D Pose Foundation | GPU + 深度 + CAD/参照画像 | NVIDIA FoundationPose / BundleSDF |
Markerless Visual Servoing | 数学的に重い研究実装 | 自己校正型VS |
3D Scene Reconstruction | カメラ複数視点 + 計算資源 | NeRF / Gaussian Splatting |
Tactile補完 | 触覚センサ | GelSight統合 |
End-to-End VLAは位置を明示的に計算していない。カメラ画像と言語指示と関節角を入力して、次の関節角を出力する。位置は内部表現として暗黙的に持っているだけ。Figure 02のHelixも、Optimusのポリシーもこの系譜。学習データは数千〜数万時間の遠隔操作デモ。
NVIDIAのFoundationPoseは、未学習物体でもCADか数枚の参照画像があれば、6自由度の姿勢が取れる基盤モデル。マットの代わりに、カメラの内部パラメータと深度センサで世界を測る。
ここで見えてくる構造がある。最先端は「世界を明示的に座標化しない」方向に進んでいる。
マット → 世界に物差しを置く(古典)
マーカー → 物に物差しを貼る(中間)
6D Pose Foundation → 物の形を覚えて世界から逆引きする
End-to-End VLA → そもそも座標を出さず、画像から直接動きを出す
「精度より体験の成立を優先する。精度はあとからお金で解決できる」という哲学からすると、6D Pose Foundationをもらってくるのが筋に見えた。Unityで持っているブロックのジオメトリをそのままFoundationPoseに渡せば、マットなしで位置が出る。R2R2Rのデジタルツインと完全に噛み合う。
Unityのデジタルツインが、実機の物体認識の学習データになる。R2R2RのRがもう一段、知覚側にも伸びる。
ここまで来て、「これは深掘る価値がある」となった。
現実は、もう少し厳しかった
FoundationPoseを実装可能性まで詰めようとして、最初のページで壁にぶつかった。
CUDA前提。NVIDIA GPU必須。C++/CUDA拡張のビルドが必要。
Macでは動かない。M1のMPSバックエンドは関係ない。NVIDIA Quadro RTX 6000で初期姿勢推定が2秒、姿勢更新が60-70ms。MegaPose(FoundationPoseの兄)も同じくGPU必須。
選択肢は四つあった。
A: クラウドGPUに投げる(RunPod / Modal、$0.3-0.7/時間)
B: ローカルにGPU PCを用意(中古RTX 3060で数万円)
C: 軽量代替手法でCPU完結(Perceptual Hashing + Template Matching、精度は落ちる)
D: そもそも別系統の技術に切り替える
「iPhoneとUnityだけで」のブランドメッセージが、ここで試された。GPU専用PCを足した瞬間に、コアメッセージの一行が崩れる。
しばらく考えて、根本的な問いに戻った。6DoFはR2R2Rに本当に必要か?
ブロックは矩形で対称性が高い。Pick動作は上から掴むだけ。必要なのは位置(x, y, z)とyaw(鉛直軸まわりの回転)だけ。FoundationPoseの「任意物体・6自由度」はオーバースペックだった。
ここから話の重心が大きく動いた。
YOLOv8 × Unity合成データ × iPhone LiDAR
オーバースペックを外した先で残るスタックは、こうなる。
iPhone 14 Pro(RGB + LiDAR深度)
  → M1 Mac
    ├ YOLOv8n: ブロック検出(bbox + クラス4色)
    ├ LiDAR深度: 検出領域の3D位置
    └ Hand-Eye Calib: カメラ↔ロボット変換(一度きり)
  → Unity / mechArm
このスタックの手柄は、すべてM1 Macの上で完結することだ。学習だけ外に出す。
YOLOv8nはM1のMPSバックエンドで20-30msで動く実測がある。リアルタイム制御に十分。学習は1000枚のファインチューニングならクラウドGPUに投げて30-60分、コストは数十円から数百円。ここは「もらってくる」側に閉じ込める。
R2R2Rのブランド方針は「学習済みモデルをもらって、動きの品質と体験を作る」だった。ファインチューニングは「学習」か「もらってくる」か。境界の問いが立つ。
僕の整理はこう。基盤モデル(YOLOv8、FoundationPose、SAM2)を作るのは大手の領域。基盤モデルを特定タスクにファインチューニングするのは個人開発の領域。GPT-4oをカスタマイズしたり、Stable DiffusionにLoRAをかけたりするのと同じレイヤー。「学習データを大規模に自前で集める」のは大手の仕事で、Unityで合成して1000枚作るのは「合成」であって「収集」じゃない。
この整理を踏まえると、Unityには新しい役割が割り当てられる。
Unity デジタルツイン
  ├ 動作の検証(既存用途)
  └ 物体認識の学習データ生成(新用途)
       └→ ブロック4色をランダム姿勢・照明・背景でレンダリング
           → YOLOv8nのファインチューニング素材
Unityは、動作だけでなく知覚もシミュレーションし始めた。
デジタルツインが、知覚モデルの学習データを作る
ここがR2R2R的にいちばん面白い部分。
「Real to Render to Real」の論理を、もう一度書き出してみる。今までは動作側の話だった。実機をスキャンしてUnityに持ち込み、Unityで動作を作って実機に流す。
知覚側にも、同じ構造を作れる。
Real(実機ブロック撮影、少量)
  → Render(Unityで姿勢・照明・背景をランダム化、大量生成)
  → 学習(クラウドGPUでファインチューニング)
→ Real(実機での物体検出)新色のブロックを足したくなったら、Unityで色を変えてレンダリングするだけ。実物を100枚撮り直す必要はない。新形状を足したくなったら、Unity内でメッシュを作ってレンダリングすればいい。学習データを「合成する」アーキテクチャになる。
これは「Unityのデジタルツインが動作と知覚の両方を支える」という構造で、R2R2Rの中心概念を一段拡張する。
Pixelsの起源が二つに増える
ここで、ブランド名の意味そのものが厚くなる。
今までのPixels:
カメラのピクセル
実機センシングが起点
今後のPixels:
カメラのピクセル
Unityでレンダリングされたピクセル
実機センシングと合成データ生成の両方が起点
Camera Pixels ─┐
               ├→ 知覚モデル → 6DoF → Motors
Render Pixels ─┘
        (Unity デジタルツイン)
Pixels to MotorsのMotorsへの経路が、一本から二本に増える。小さな実装の話が、ブランドの中心概念にまで届いた。
実装可能性の最終結論
ここまでの議論を踏まえて、実装プランを置く。M1 + iPhone 14 Proで全部動く。学習だけクラウドに投げる。
Phase | 内容 | 期間 |
|---|---|---|
1 | YOLOv8で「色」ではなく「ブロック」を見る(マット併用、実写学習) | 3-4日 |
2 | Unity合成データで強化(Sim2Real性能を実機検証) | 2-3日 |
3 | マット撤廃 + LiDAR深度統合(Record3D + ArUco原点) | 3-4日 |
4 | Hand-Eye Calibration(LOG184青シール3点流用、ArUco撤廃) | 2日 |
合計、約2週間。LOG200番台の数本分。
最初の3日で実装可能性の判定が出る。
Day 1: iPhone実写30枚、Roboflowアノテーション、Colab/Roboflow Trainでファインチューニング
Day 2: M1にweights転送、MPS推論テスト、既存HSV並走、レイテンシ計測
Day 3: iPhone Record3D接続、LiDAR深度取得、実用精度確認
Day 3には負債が一個積んである。Record3DはWi-Fi経由のストリーミングが基本で、YOLOv8(20-30ms)と深度を同期させたとき、ネットワーク遅延でフレーム整合が崩れる可能性がある。LOG131でUSB-C Ethernetを入れて「有線の価値」に気づいた前例がある。Wi-Fiで実用精度が出るか、出なければ有線USB接続(Record3DのUSB Streamingモード)に切り替えるか、Day 3でそこを叩き割る。
ここでYOLOv8がM1でリアルタイム動くこと、Record3Dで深度が取れること、この二つが確認できれば、Phase 2以降の投資判断ができる。
マットを外すと、新しい問いが現れる
最後に、整理しておきたいことがある。
マットを外す道は、技術的には複数ある。Hand-Eye Calibrationでも、ArUcoマーカーでも、LiDARの平面検出でも、いずれかでマットの仕事は引き継げる。マットを外せること自体は驚きではない。
驚きは別のところにあった。ブロック認識の話とマット撤廃の話を別々に詰めていったら、両方ともUnityのデジタルツインを「学習データの生成装置」として使う方向に着地した。入力(カメラ画像)と認識(モデル)の両方に、Unityの合成ピクセルが流れ込む構造になった。
この構造が見えると、これまで書いてきた記事の意味も少し変わって見える。マットを認識するためのコーナー検出、ホモグラフィでのmm変換、HSV色マスク——これらは全部「世界に物差しを置いて、実画像だけで頑張る」系譜だった。Unityは別世界の話だった。
ここで二つの世界が混ざる。Unityで合成したピクセルが、実画像の解釈を助ける。実画像で動かしたロボットの結果が、Unityで動作生成を更新する。Real to Render to Real が、知覚と動作の両方で同じ形をしている。
マットを外すことは、物理的な物差しへの依存を止め、Unityの合成ピクセルと実画像を混ぜる思想への移行を意味する。