コードが消えても、設計は残る | ニューラルネットワークがロボットを動かす40年と、その先
Figureが手書きのC++コードを10万行以上削除した。ロボットの動きが「書かれるもの」から「学習されるもの」へ移るとき、29年デザインに携わってきた人間に何が残るのか——ニューラルネットワーク制御の40年をたどりながら、AIとの対話でその輪郭を探した。
「C++ではなくニューラルネットワークで」という問い
ロボットを「C++ではなくニューラルネットワークで動かす」。この言い方は直感的だが、技術的に正確にすると、対立しているのはプログラミング言語ではない。人間が数式で設計した制御則と、データから学習された方策——この2つの対立だ。C++はあくまで実装言語で、本質ではない。
従来の制御は、逆運動学やPID、モデルベース制御といった「ルール」を人間が書き下し、コードに落とす。エンジニアが「こう来たらこう動け」を一つずつ記述する。学習ベースの制御は、その「ルールを人間が書く」工程を、「観測から行動への対応関係をデータから学ばせる」に置き換える。ルールを書く人がいなくなり、データを与える人が現れる。
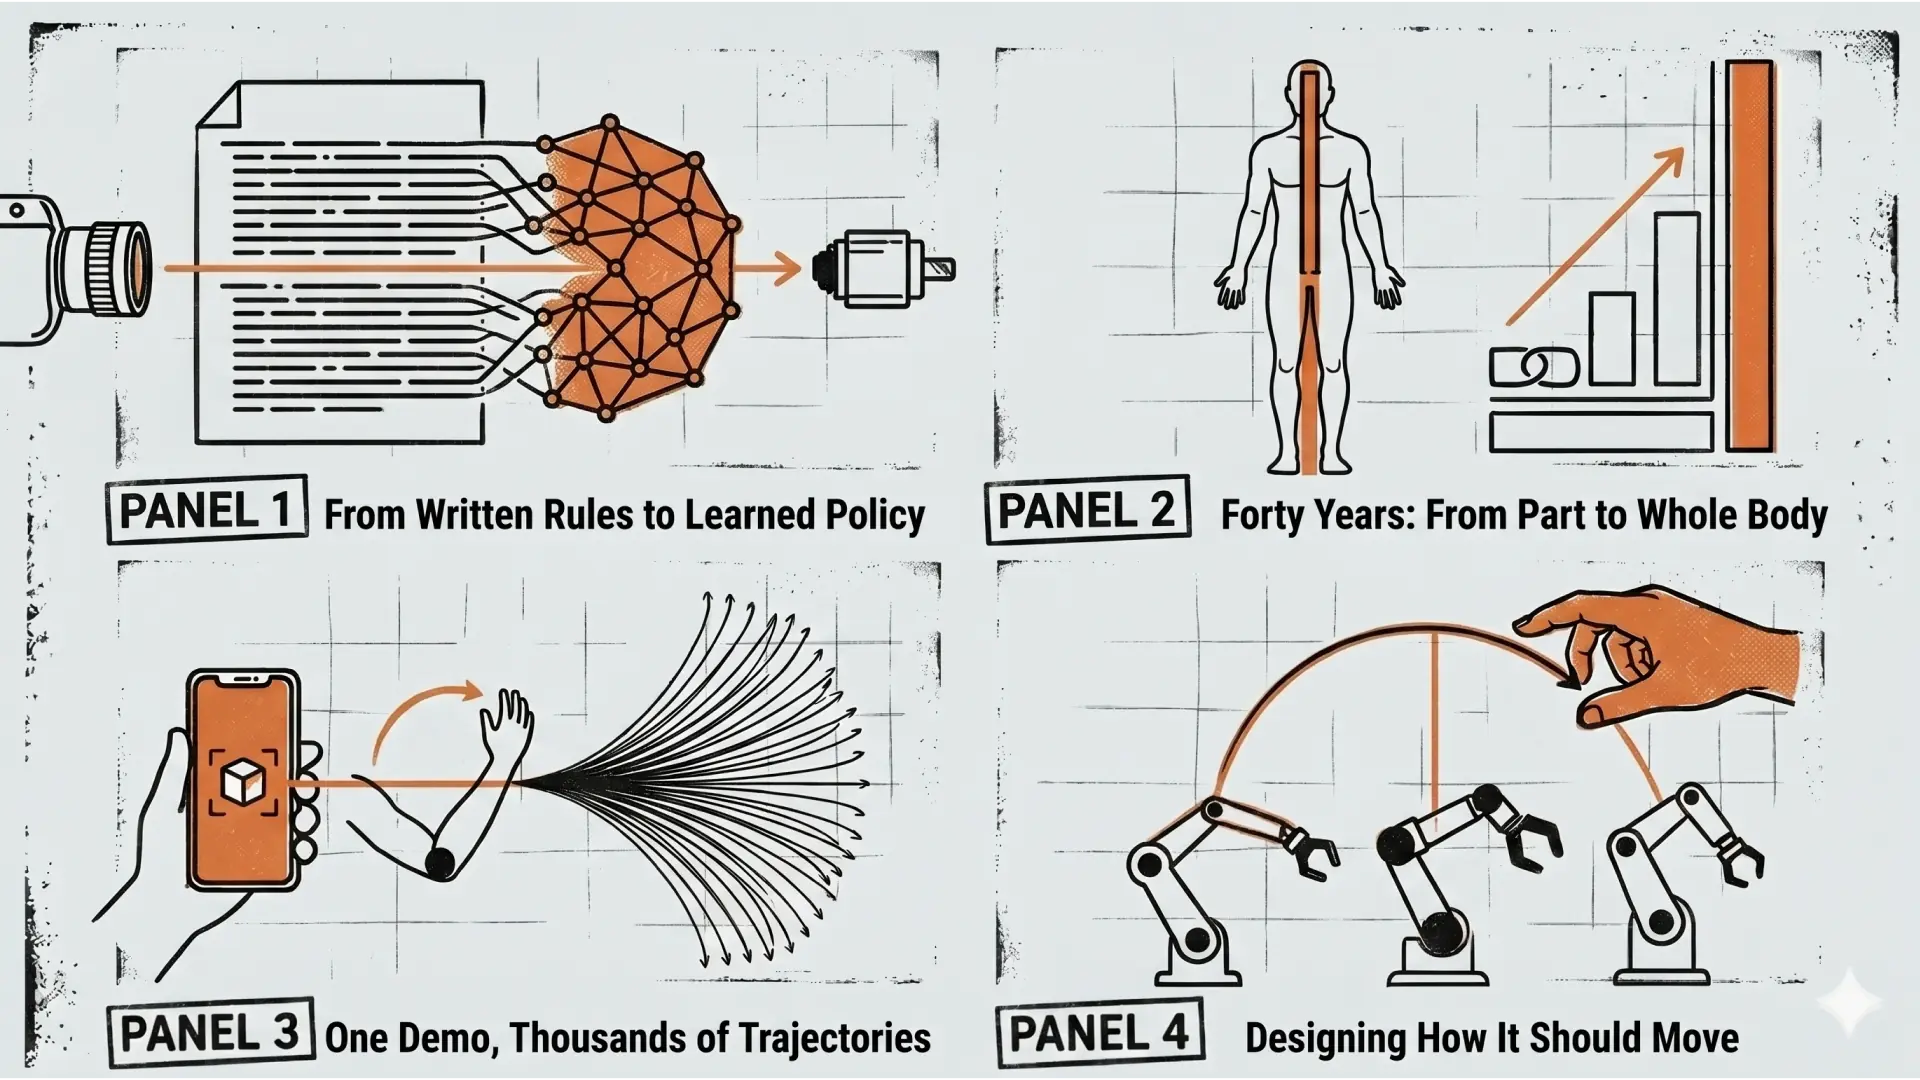
ただし「ニューラルネットワークで動かす」は一枚岩の技術ではない。ニューラルネットが制御スタックの「どこ」を担うかは、時代ごとにまったく違う。約40年かけて、その担当範囲が——制御ループの中の小さな部品から、全身を貫く一本の写像へと——段階的に広がってきた。まず、その40年を追う。
部品から全身へ — ニューラルネット制御の40年
最初期、1980年代から2000年代にかけて、ニューラルネットは制御の主役ではなかった。ロボットアームの逆運動学や動力学は数式で書けるが、摩擦・たわみ・経年変化といった「モデル化しきれない誤差」が必ず残る。ここにNNを差し込む。コネクショニズム(人工ニューラルネット)による定式化は、明示的なプログラミングなしに訓練できるため、逆運動学や動力学の計算にとって魅力的とされた。当時の典型的な構成は、PD的なコントローラにNNコントローラを足したもの——制御の骨格は人間が設計し、NNは誤差を吸収する補償器として働いた。NNベースの適応制御は従来の適応制御より高い軌道追従精度を示したが、計算資源と小さなネットワークの制約で、実用というより研究の段階にとどまっていた。この時期のNNの役割は「部品」だ。
転機は2012年。AlexNetを起点とするディープラーニングの爆発が、まずロボットの「目」を変えた。物体認識・姿勢推定・セグメンテーションが一気に実用化し、ロボットは初めて、乱雑なシーンで何がどこにあるかをまともに見られるようになった。そして次の発想の飛躍が「視覚運動方策(visuomotor policy)」——カメラ画像を入力し、モーター指令を直接出力する一つのネットワークを、端から端まで(end-to-end)学習させる、というもの。それまで「知覚」「プランニング」「制御」と分かれていたモジュールを、一本のネットワークに溶かす。Figureが言う「pixels-to-torque」の思想的な出発点はここにある。役割は「知覚」、そして知覚と制御をつなぐ一本の写像へと広がった。
2016年から2020年は、深層強化学習(Deep RL)の時代だ。人間が正解を教えるのではなく、ロボット自身が試行錯誤で報酬を最大化する。象徴がOpenAIのDactyl(2018年)。人間のような形のロボットハンドに、前例のない器用さで物体を操作させた。完全にシミュレーション内で訓練し、ドメインランダム化という手法で現実の物理に適応させ、その知識を実機へ転移させた。Shadow Dexterous Handは典型的なアームの7自由度に対し24自由度を持つ難物で、これを純粋なend-to-endの深層RLで動かしたのは初めてのことだった。ただし代償は莫大で、OpenAIはこのタスクに6,000以上のCPUコアを使い、20回連続成功まで約30時間の訓練を要した。脚歩行では大きな成功を収めた一方、Deep RLの華々しい成果の多くはシミュレーションやゲームの中のもので、シミュレーションと現実の差——Sim-to-Realギャップ——がこの時期の中心課題になった。役割は「試行錯誤で獲得する制御方策」へ。
そして2021年から2023年、ロボット学習は分水嶺を越える。RLの「報酬設計が難しい・試行回数が膨大」という弱点を避け、人間のデモを真似る模倣学習(Imitation Learning)が一気に実用化した。技術的なブレイクスルーが2つ、2023年に集中する。ひとつがACT(Action Chunking Transformer)、StanfordのALOHAプロジェクトから。模倣学習には「誤差が時間とともに累積し、訓練データの分布から外れていく」という宿痾があった。ACTの解法はシンプルで、1ステップずつではなく次の100ステップ分の関節位置をまとめて予測する。タスクの実効的な時間長を縮め、累積誤差を抑える。結果、半透明の調味料カップを開ける、電池をスロットに差し込むといった難タスクを、わずか10分のデモで80〜90%の成功率で学習した。標準的な手法が20〜50%だったところを、だ。設計の狙いは、低コストで不正確なハードウェアでも繊細な操作を可能にすることだった——安価なアームでも動く、という方向性は、このプロジェクトの足場と地続きだ。もうひとつがDiffusion Policyで、行動の系列を拡散モデル(画像生成と同じ生成プロセス)として生成する。この2つが、ロボットの器用な操作にとっての分水嶺になった。
同じ2023年、言語が制御に入ってきた。GoogleのRT-1がTransformerベースのロボット方策を示し、続くRT-2は、大規模な視覚言語モデル(VLM)を、ロボットの行動を自然言語トークンとして出力するよう共同ファインチューンした。これがVLA(Vision-Language-Action)の誕生だ。ここで、ロボットは初めて「言葉」で動き始めた。「青いブロックを赤い皿の『近く』に」と「『上』に」で動きが変わる——言語理解が、制御に直結した。仕上げが2023年10月のOpen X-Embodiment。世界の研究機関が持ち寄った60のデータセット、22種のロボット、527の操作スキル、100万を超える軌道を統合し、「NLPや画像認識のように、ロボティクスにも事前学習済みのバックボーンを置けるか」という問いに踏み込んだ。
<!-- 図をここに埋め込み(DAY214_figure.html / embedタグ) -->
下の図は、この40年を「NNが制御スタックに占める範囲」という一本の軸で並べたものだ。バーが伸びるほど、人間が書いていた部分をニューラルネットワークが引き受けていく。
いま、10万行のコードが消えた
2024年以降、VLAは研究から「製品」へ移った。2024年10月のπ0(Physical Intelligence)は、汎用ロボット制御のための視覚言語行動フローモデル。同年のOctoは、Open X-Embodimentの80万のデモで訓練されたオープンソースの汎用方策で、わずか93Mのパラメータながら巨大モデルと同等の性能を出した。2025年2月のFigure Helixは、指を含むヒューマノイドの上半身全体を連続制御した最初のVLAで、単一のニューラルネット重みで2台のロボットを同時に動かした。3月のNVIDIA GR00T N1は、視覚言語バックボーンとフローマッチングの行動方策を組み合わせ、実ロボットの軌道・人間の動画・合成データという3層のデータで訓練された総計2.2Bパラメータのモデル。4月のπ0.5は、訓練時に見ていない全く新しい環境で動く「オープンワールド汎化」に踏み込み、6月のSmolVLAは、誰でも手元で動かせる軽量・オープンソースのVLAとして公開された。
そして2026年1月、最も劇的なことが起きる。ヒューマノイドを開発するFigureが、新アーキテクチャHelix 02の土台「System 0」を導入し、手書きのC++コードを109,504行、コードベースから削除した。下半身のバランス制御まで含めて、全身を一つのニューラルネットワークが担う。System 0は1,000時間を超える人間のモーションデータで訓練され、1kHzで動作する。同社はこれを「pixels-to-torque」——カメラのピクセルから関節トルクまで一気通貫——と呼ぶ。パッケージ仕分けの無編集ライブ配信では、67時間の連続自律稼働を記録した。
いま、主要なモデルは似た構造へ収束しつつある。VLAの中身は、人間でいえば「考える脳」と「反射する脳」を分けたようなものだ。「System 2」は大きな視覚言語モデル——考える脳にあたる。画像と言語指示を受け取り、ゆっくり「何をすべきか」を決める。「System 1」は拡散モデルやフローマッチングの行動ヘッド——反射する脳にあたる。それを毎秒30〜1000回の関節指令へ、速く変換する。GR00T N1もFigure Helixも、この二重構造を共有している。そして第3期にACTが持ち込んだ「行動をまとめて予測する」考え方は、いまやほぼ全てのモデルの標準装備だ。2023年の発明が、2026年の基盤モデルの土台部品として生き続けている。
— Figureが手書きのC++コードを10万行以上削除した。実機を毎日触る立場として、どこまで頷けるか。
コードを少なくするというのは賛成だね。コードで制御することが多いと、修正や構築が大変になる。それはロボットに限らず、どんな場所でも見受けられる現象のひとつだと思う。
ここで頷いているのは、ニューラルネットの優位性ではなく、コードという制御手段が抱える構造的なコストへの賛同だ。手書きの制御コードは、状況が一つ変わるたびに分岐が増え、修正が修正を呼ぶ。Webでもアプリでも、コードで状態を抱え込みすぎた現場が動けなくなる光景は、29年のデザイナー経験の中で繰り返し見てきたものだろう。Figureの「10万行を捨てた」は、その一般的な現象が、ロボット制御という最も硬い領域で起きた、ということだ。
ただし、現実的な留保もつく。Figureのデモには、ロボティクスの専門家から「本格展開できるものというより科学プロジェクトに近い」という指摘も出ている。配置の精度——速く動けても、荷物が必要な場所に正確に着地しなければ商業的な意味は薄れる——が論点だ。学習ベースの制御は、連続性や適応力と引き換えに、精度のばらつきを抱える。デモと実装は別物、という視点は、このあと何度も効いてくる。
データはどこから来るのか
学習ベースの制御には弱点がある。学習にはデータが要る。そして言語モデルが数兆トークンのテキストで学ぶのに対し、ロボットには「インターネット規模の動作データ」が存在しない。第3期のOpen X-Embodimentですら100万軌道——桁が違う。これが今、分野全体の最大のボトルネックだと言われている。
— Pixels to Motors の別名に R2R2R を選んだとき、この概念に何を託したのか。
ロボットの動作データはネット上には通常ない。そう考えたとき、人の動きを真似て動作データを作るほうが、コードを作るより圧倒的に早いし、データの品質も高いだろうな、と直感的に判断したのがある。「学習の最大のボトルネックを破る側」とまで思っていたわけじゃないけどね。
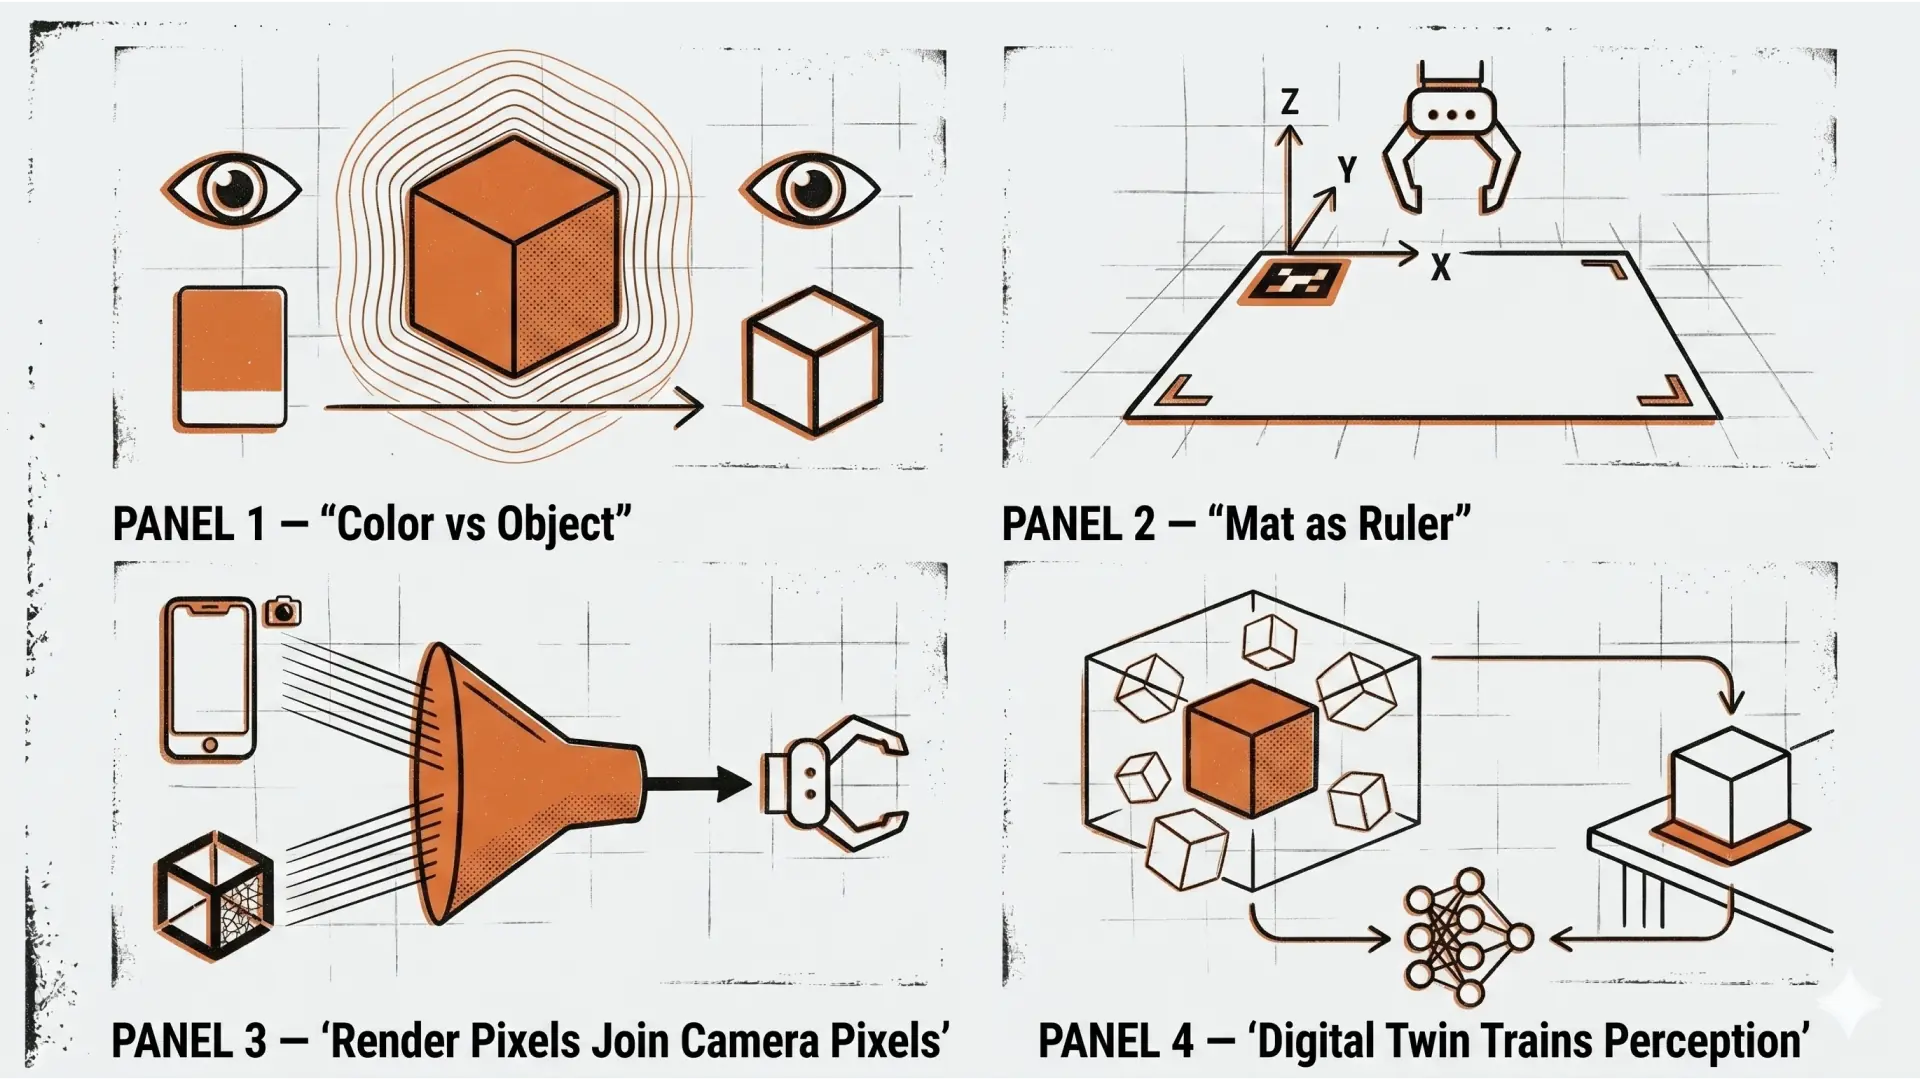
R2R2R——Real2Render2Real。UC BerkeleyとToyota Research Instituteの研究で、スマートフォンで撮った物体スキャンと、たった1本の人間のデモ動画を入力に、数千のロボット非依存のデモを生成する手法だ。物理シミュレーションも実機の遠隔操作も使わず、3D Gaussian Splattingで物体の形状を再構成し、6自由度の運動を追跡する。実験では、1本の人間のデモから生成したデータで訓練したモデルが、150回の遠隔操作デモで訓練したモデルと同等の性能に達した。生成速度はRTX 4090一枚で毎分51デモ、人間の遠隔操作の27倍速い。
データ調達の道は、大きく3つに整理できる。
調達経路 | やり方 | 採用例 | コスト構造 |
|---|---|---|---|
遠隔操作の大量化 | 人がロボットを操作してデモを集める | Figure(約500〜1,000時間) | 人手に線形比例。高価 |
人間動画から学習 | アクションのない人間の映像を擬似ラベル化 | GR00T N1 | 既存映像が使える。ラベル精度が課題 |
合成・Real-to-Sim生成 | 物体スキャンと1本の動画から大量生成 | R2R2R系 | 初期構築後はほぼ計算コストのみ |
3つ目がR2R2Rの位置だ。順序が逆なのだ。この概念が論文として証明される前に、「人の動きを真似て作るほうが速く、品質も高い」という同じ判断に、直感で先回りしていた。プロジェクト名は、いま分野が「最大のボトルネックの有力な解」と見なし始めた概念から取られていた。
人の手作業はこれからもあるだろうとは思う。でもそれは、ロボットが詰まったときに人が指し示す程度のことになる。大体の動作はAIやロボットが自分で学んでいくはず。ただ限界は常にあって、その限界を越えるために人が教えることは必要だと思う。
今アームと2台のiPhoneで一回ずつ動作を取っている作業を、過渡期のものとして見ている、ということでもある。人が教えるのは「大半」ではなく「限界を越える一点」へ——役割が縮んでいく前提で、手を動かしている。
スケールする側と、しない側
データの次は計算だ。言語モデルの進歩を支えたのは「データと計算を増やせば性能が予測どおり上がる」というスケール則だった。これがロボットにも成立するか——ここ半年で、成立を示す報告が出始めている。Generalist AIの基盤モデルGEN-0が「ロボティクスにスケール則が存在する」ことを初めて示し、後継のGEN-1は複数のタスクで99%超の成功率、それまでの最先端の最大3倍の速度、予期しない状況からの回復という創発的な振る舞いを示した。成立するなら、ロボティクスはLLMの軌道をなぞる——「ChatGPTモーメント」は来るか否かでなく「いつ」の問題になる。
— スケール則が本物なら、最も多くの計算とデータを積める側が有利になる。その世界で、個人が研究を公開し続けることに勝ち筋はあるのか。
スケールする側が勝つ場面はほとんどだろうけど、個人が勝つ場面も結構あると思う。そこは棲み分けだし、個人の発想や発見はどんなときも必要になる。明確な勝ち筋を今描けているわけじゃないし、ずっと個人でやると決めているわけでもない。そこはケースバイケースだね。
勝ち筋を断定しないのは、スケール則が効く領域と効かない領域を分けて見ているからだ。データと計算で殴り合う中心は大手のものだ。だが「何を問題に選ぶか」「何に気づくか」は、計算量からは出てこない。なお、スケール則そのものにも天井はある。LLM側は学習に使える公開テキストが2028年頃に枯渇すると見られている。ロボットのスケール則が機能し続けるかは、結局のところ前節のデータ問題が解けるかに依存する。
「精度はあとから金で解決できる」は当面は通用すると思う。ただ、今後10年でロボットがどう進化するかを正確に予測するのは難しいから、変わる可能性は大きい。それでも、ほとんどのことはお金で解決できるほうが多いはず。特にロボットは——そもそものコストが高いからね。
Pixels to Motors のコア哲学「精度より体験の成立を優先する。精度はあとから金で解決できる」は、当面有効。ただし10年の射程では読み替えがありうる、という留保がついた。哲学を不変の教義にせず、賞味期限つきの作業仮説として持つ。この距離感こそが、build in public を持続させる。
見えないものを、見えるようにする
学習ベースの制御には、もう一つの弱点がある。学習された方策は「なぜそう動いたのか」を外から説明しにくい。安全が問われる現場では、これは重い制約になる。
— 学習された制御は「なぜそう動いたか」が外から見えにくい。実機を一行ずつ切り分けてきた経験から、何が必要だと考えるか。
学習ベースの制御が外から見えにくいなら、その問題を、今までとは違う方法でわかりやすくするしかない。Webの世界だって、誰がアクセスしているかもわからないままページを作っていた時代があった。可視化が必要なのは、同じことだよ。
この一文は、技術の問題を技術の外に開いている。学習制御の不透明さを、新技術に固有の宿命としてではなく、「どの分野も一度は通る道」として並べ直している。Webにはアクセス解析が生まれた。コードにデバッガがあるように、学習された方策にも、その挙動を人間が読める形にする「計器」がいずれ要る。「計測手段を持つことが先、推論はその後」——プロジェクトの方法論として掲げてきた原則と、完全に同じ向きの話だ。
可視化が必要になる理由は、もう一つある。汎化の限界だ。全く新しいロボットの体(形状やカメラ配置)へのゼロショット汎化はまだ限定的で、事前学習済みモデルでも新しいロボットには体ごとのファインチューニングを要する。「1つのモデルが全てのロボットを動かす」は方向としては本物だが、まだ着地していない。規制が自律的判断の説明可能性やキルスイッチを要求する方向に動けば、純粋なend-to-endより、ニューラルネットに古典制御の安全層を組み合わせたハイブリッドが、想定より長く残る可能性がある。「C++は死んだ」は半分正しく、半分は急ぎすぎの物語だ。
広まる速さと、立つ場所
学習ベースのロボットを誰でも作れるようにする動きも進んでいる。SmolVLA、そしてその土台であるLeRobot——数百ドルの自作アームでも模倣学習を試せるオープンなエコシステム。オープン重みの基盤モデルも増えた。モデル層は一部、コモディティ化しつつある。
— SmolVLAやLeRobotのようなオープン化は、個人にとって追い風か、向かい風か。
オープン化は、自分の中では「ある技術をあっという間に世の中へ広める、効果の高い手法」だと捉えている。それによって競合が増えすぎると、まだ確立されていない地位が脅かされる。あまりにも早すぎる広まりは、デザイナーとしてのポジショニングを確立したいという思惑とは対立する。AIエージェントの登場がまさにそれだった。同じようなことが、あまりにも早いタイミングで起こるのは困る。
ここで語られている懸念は、技術の優劣ではなく時間だ。オープン化は技術を一気に拡散させ、競合を増やす。まだ旗を立てきっていないカテゴリでは、その速さが、立つ場所を確保するための時間を圧縮する。AIエージェントが、概念の提唱から飽和までを猛烈な速度で駆け抜けたように。
ただし、この向かい風は読み替えられる余地もある。オープン化が消すのは「モデルを持っていること」の優位だ。Pixels to Motors は最初からモデル層にいない——「学習済みモデルをもらって、動きの品質と体験を作る」というポジションだ。料理人にとって良い食材が安く手に入るようになっても、料理の差別化は消えない。早すぎる拡散が脅かすのは「カテゴリの言葉を最初に置く時間」であって、出力側の設計力そのものではない。脅威の正体が「速さ」であるなら、こちらが取るべきはポジションの微修正だ。
動きの質だけでは足りない
では、モデルもデータも誰でも手に入る世界で、最後に残る希少なものは何か。
— 動きが「デモから学習されるもの」になると、Motion UX とは何を指す仕事になるのか。
Motion UXに「実演を設計する技術」という側面は、ひとつあるだろうね。でも他にも必要な要素がたくさんあって、それをロボットに関わる他の人たちにわかりやすく説明し、なぜ必要なのか、もしくは必要ないのかを明確にする仕事も同時に要る。
動きが人間のデモから学習されるものになると、動きの品質は手調整の軌道ではなく、「何を、どう実演するか」というデモとデータの設計で決まる。実演を設計する技術——これがMotion UXの一面だ。だが、それだけではない。
今は、ロボットの動きがどんな影響を与えるかを誰もわからないまま、ロボットを作り、制御している。でもこれから、異種のロボットの同時活用や人との協業というレベルになってくると、動きに対して決めるべきルールや決まり事、お互いの認識のすり合わせが増えてくる。そのとき、動きそのものの質が高いというだけでは、さまざまな課題をクリアできないと思う。
ここから、仕事は2つの線に分かれて見えてくる。ひとつは動作設計——動きそのものを作り、デモを設計し、質を仕上げる仕事。もうひとつは、この答えの言葉から名づけるなら動作規範設計——動きが何を意味し、なぜそうあるべきかを言語化し、関係者の認識を揃え、決まりごとに落とす仕事だ。
順序の仮説はこうなる。先に需要があるのは動作設計だ。システムインテグレーターはすでに「動作設計の工数」に困っている。動作規範設計が必要になるのは、異種ロボットや人との協業が現実になってから——もう少し先だ。だが後者こそ、オープン化でコピーされない陣地になる。モデルにもデータにも宿らず、人と組織の間に立って動きの意味を翻訳し規範化する仕事だからだ。
未来の輪郭を整理するなら、3つの層に分かれる。
確度の高い流れ ── データ生成の自動化、スケール則の活用、モデル層の一部オープン化。この3つはほぼ既定路線として進む。
大きく分岐する論点 ── 純粋な学習制御が総取りするのか、安全層に従来制御を残すハイブリッドが残るのか。「ChatGPTモーメント」が来る時期。規制の強度。
Motion UX に開く問い ── 動きの質を設計し、その意味を翻訳し、規範に落とす仕事が、独立した職能として立ち上がるかどうか。
まだ見えないから、動かす
ここまで未来の可能性を並べてきた。だが、決定的な留保がある。学習ベースのロボットが実際にどう動くか、まだ誰も正しくは見えていない。
— まだ学習ベースのロボットがどう動くか正しくは見えていない。それでも実機を動かし続けるのはなぜか。
Xでのいろんな情報や動画を見れば、研究者たちが技術的に相当先にいっているのはよくわかる。でも一方で、現実の現場に実装するにはまだ多くの課題とコストの問題があるだろうな、とも想像がつく。ロボットアームを触るのは、触りながらロボットの問題を一から一つずつ理解して、まだまだあるはずの社会実装の課題を見つけ出し、クリアしたい——そういうところだね。
研究の最前線と、現場への実装の間には、まだ広い隔たりがある。論文と動画は技術の到達点を見せてくれるが、その技術が現実の現場でいくらかかり、何につまずくかは見せてくれない。その隔たりを、一つずつ実機で潰していく。予測を断定するより、計器を持って確かめにいく——それがこのプロジェクトの立ち位置だ。
部品から全身へ。C++からニューラルネットワークへ。40年かけて、ロボットの動きは人間が書くものから、学習されるものへ移った。その先で問われるのは、もう「どう書くか」ではない。
ロボットが動きを学ぶ時代に、人に残るのは「どう動くべきか」を設計する仕事だ。