巨大ラボπはロボットの「動き方」をデータとして使う。こちらは、その動き方をMotion UXとして設計する
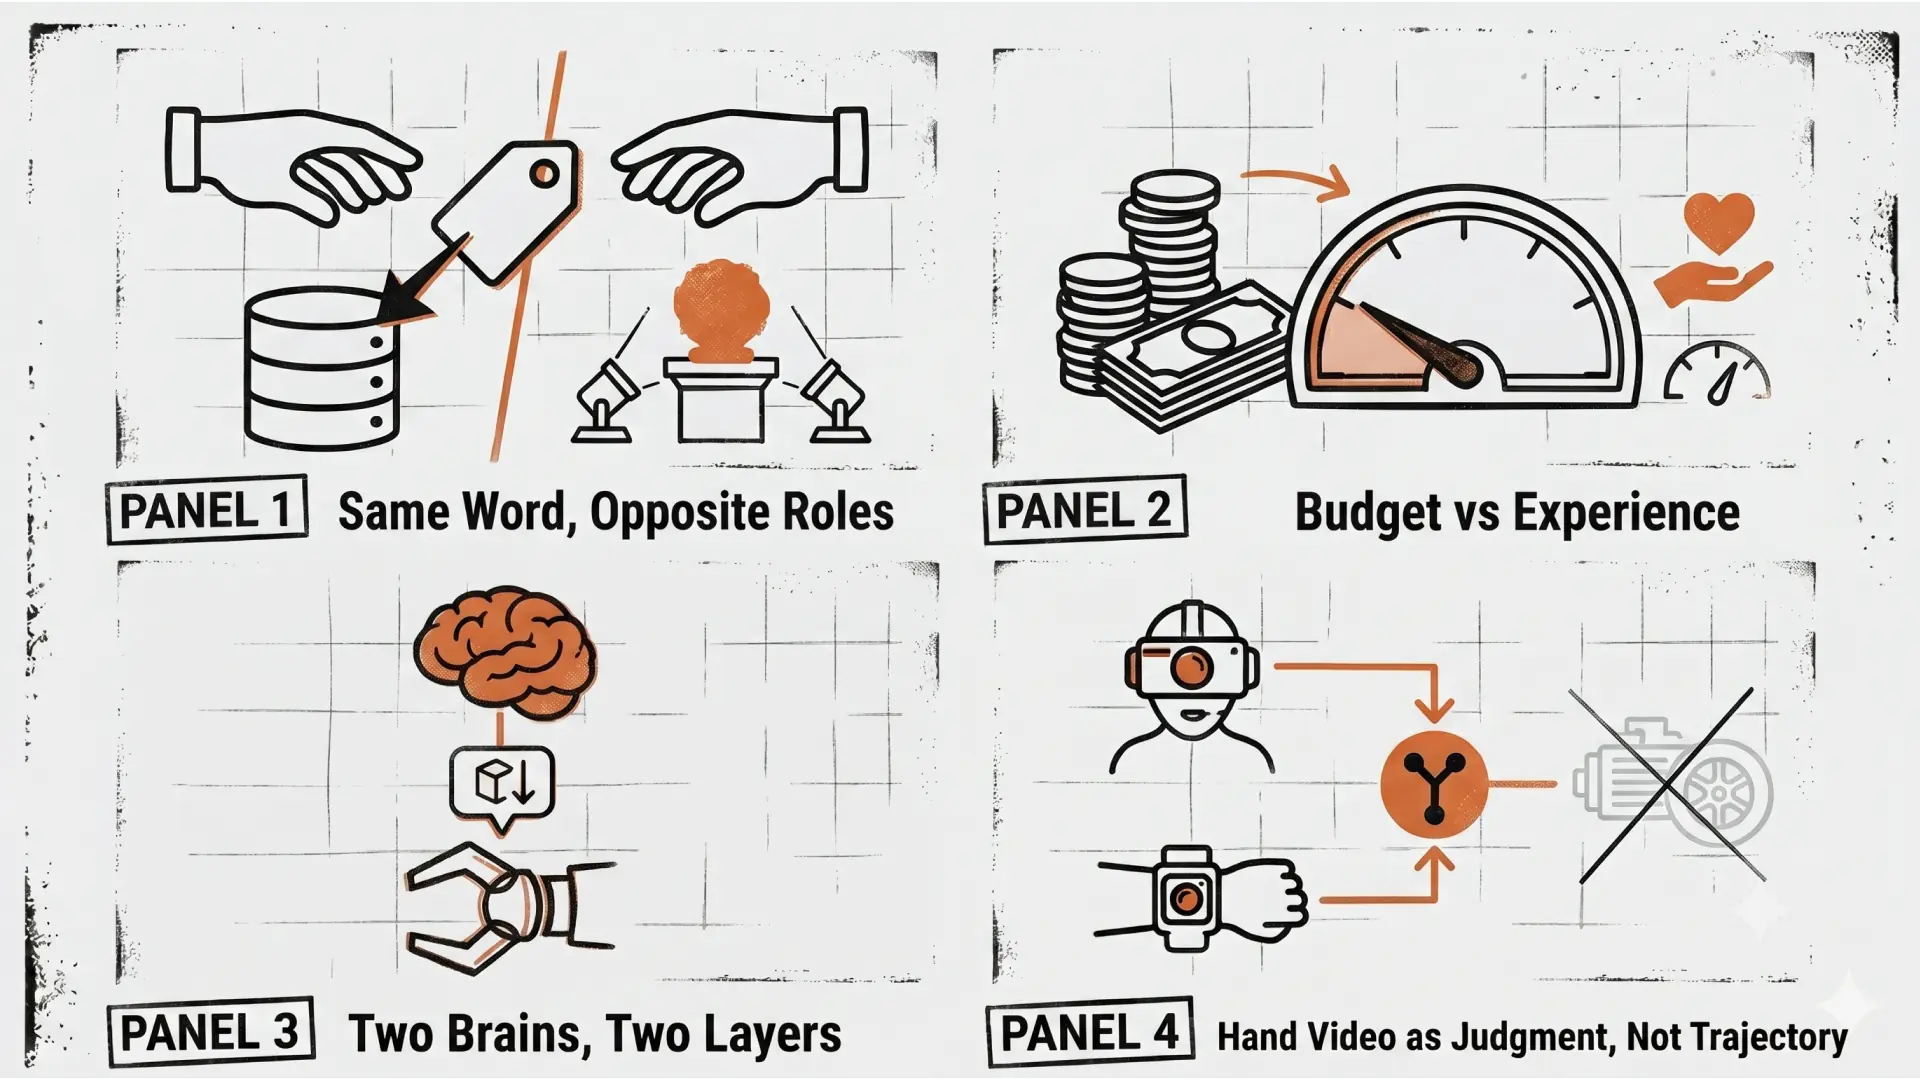
巨大ラボの研究は、自分のやっていることの「高レベル版」に見えた。その見方こそが罠だった。向こうは精度を資金でスケールさせ、こちらは体験を低コスト側から設計する。同じ what を見て、同じ how という語を使いながら、その役割は正反対になる。
「高レベル版」という見方を疑う
VLA(視覚・言語・行動)モデルの最前線として、Physical Intelligence の研究を読んでいた。π0 から π0.5、π0.6、π0.7 へと続くモデル群と、その周辺技術。読み進めるうちに、ある感覚が湧いた。
自分がやっていることの相当レベル高い版だね。
— その見方は、自分を安売りする罠になる。
構造的な対応は、確かにある。iPhone で撮った写真を Claude や GPT-4o に送って成否を判定させる報酬ループは、向こうの価値関数とアドバンテージ条件付けの超軽量版そのものだ。LOG83 で固めた「人間が安全を確保してから AI に渡す」という運用は、彼らが human-in-the-loop で挟む correction(修正)や intervention(介入)と、同じ場所を突いている。
同じ問題圏を見ているのは確かだ。しかし「高レベル版」という解釈は、自分を「資金さえあれば Physical Intelligence になれたはずの人間」という狭い枠に押し込める。解いている問題のレイヤーが違う。
同じ π*0.6 の3タスク ── エスプレッソ・洗濯・箱組み立て ── を見ても、読み取る問いが違う。
観点 | 向こうの読み | こちらの読み |
|---|---|---|
問いの立て方 | 失敗からの回復を、RL でどう自動化するか | 150g の可搬制約で、体験として何を捨て何を残すか |
測る対象 | スループット(時間あたり成功数) | 動きの質、人が受け取る感覚 |
勝負する場所 | データ・計算・台数 | 設計・体験の逆算 |
向こうは精度を物量 ── データと計算とロボット台数 ── で押し上げる側、こちらは低コストで体験の成立を問う側。立っている場所が違う。
1,600億円という桁
精度を、莫大なデータと計算とロボット台数で殴って上げる。どのくらいお金をかけてる?
桁が別世界だ。Physical Intelligence は累計で約11億ドル ── 日本円で約1,600億円を調達し、評価額1兆円超でさらなる調達を交渉中だと報じられている。商用化の時期は定めず、売上を立てる前から計算資源とロボット台数に注ぎ込んでいる。精度を予算で解決する側だ。
問題はその先にある。ハブ記事で原則の1番目に「精度より体験の成立を優先する。精度はあとから予算で解決できる」と置いた。Physical Intelligence は、その「予算で解決」を人類最高水準でやっている実例になる。だとすれば、自分はどちら側を実行しているのか。この問いが、残りの話の補助線になる。
what と how ── 同じ語を逆に使う
π0.7 の記事に、正直な記述がある。多様なデータをただ混ぜても性能は上がらなかった、と。彼らが見つけた鍵は、プロンプトに「何をするか(what)」だけでなく「どうするか(how)」を加えることだった。速度や品質、関節制御かエンドエフェクタ制御かという制御モダリティ、各サブステップ完了時の見た目を示す視覚的サブゴール画像。これらを注釈として足す。
効果は具体的だ。本来なら捨てるしかない出来の悪い自律データすら、「これは低品質」「これは低速」とラベルを貼ることで訓練に使えるようになる。つまり向こうにとって how は、バラバラなデータを一つのモデルに同居させ、データをスケールさせるための道具だ。
— 向こうの how は道具だ。こちらの how は主役だ。
Motion UX にとって how は、体験が宿る場所そのものだ。同じ「掴む」でも、丁寧にもてきぱきにも感じられる。その速度や減速の仕方や接近角度こそが、人がロボットをどう受け取るかを決める。向こうがスループットを上げるための注釈として扱うものを、こちらは設計の主題として扱う。
同じ what を見て、同じ how という語を使いながら、役割が正反対になる。この非対称が、技術者には書きにくく、29年デザインをやってきた視点からは書ける一点になる。
π0.7 の how | Motion UX の how | |
|---|---|---|
位置づけ | データをスケールさせる注釈 | 体験を設計する主題 |
目的 | throughput(時間あたり成功数)を上げる | 人が安心して機械を理解できる動きをつくる |
低品質データの扱い | 「低品質」と注釈して訓練に再利用 | 「なぜ雑に見えるか」を設計判断の材料にする |
誰が強いか | 莫大なデータと計算を持つ側 | 動きの質を言語化できる側 |
二つの脳 ── System 1 と System 2
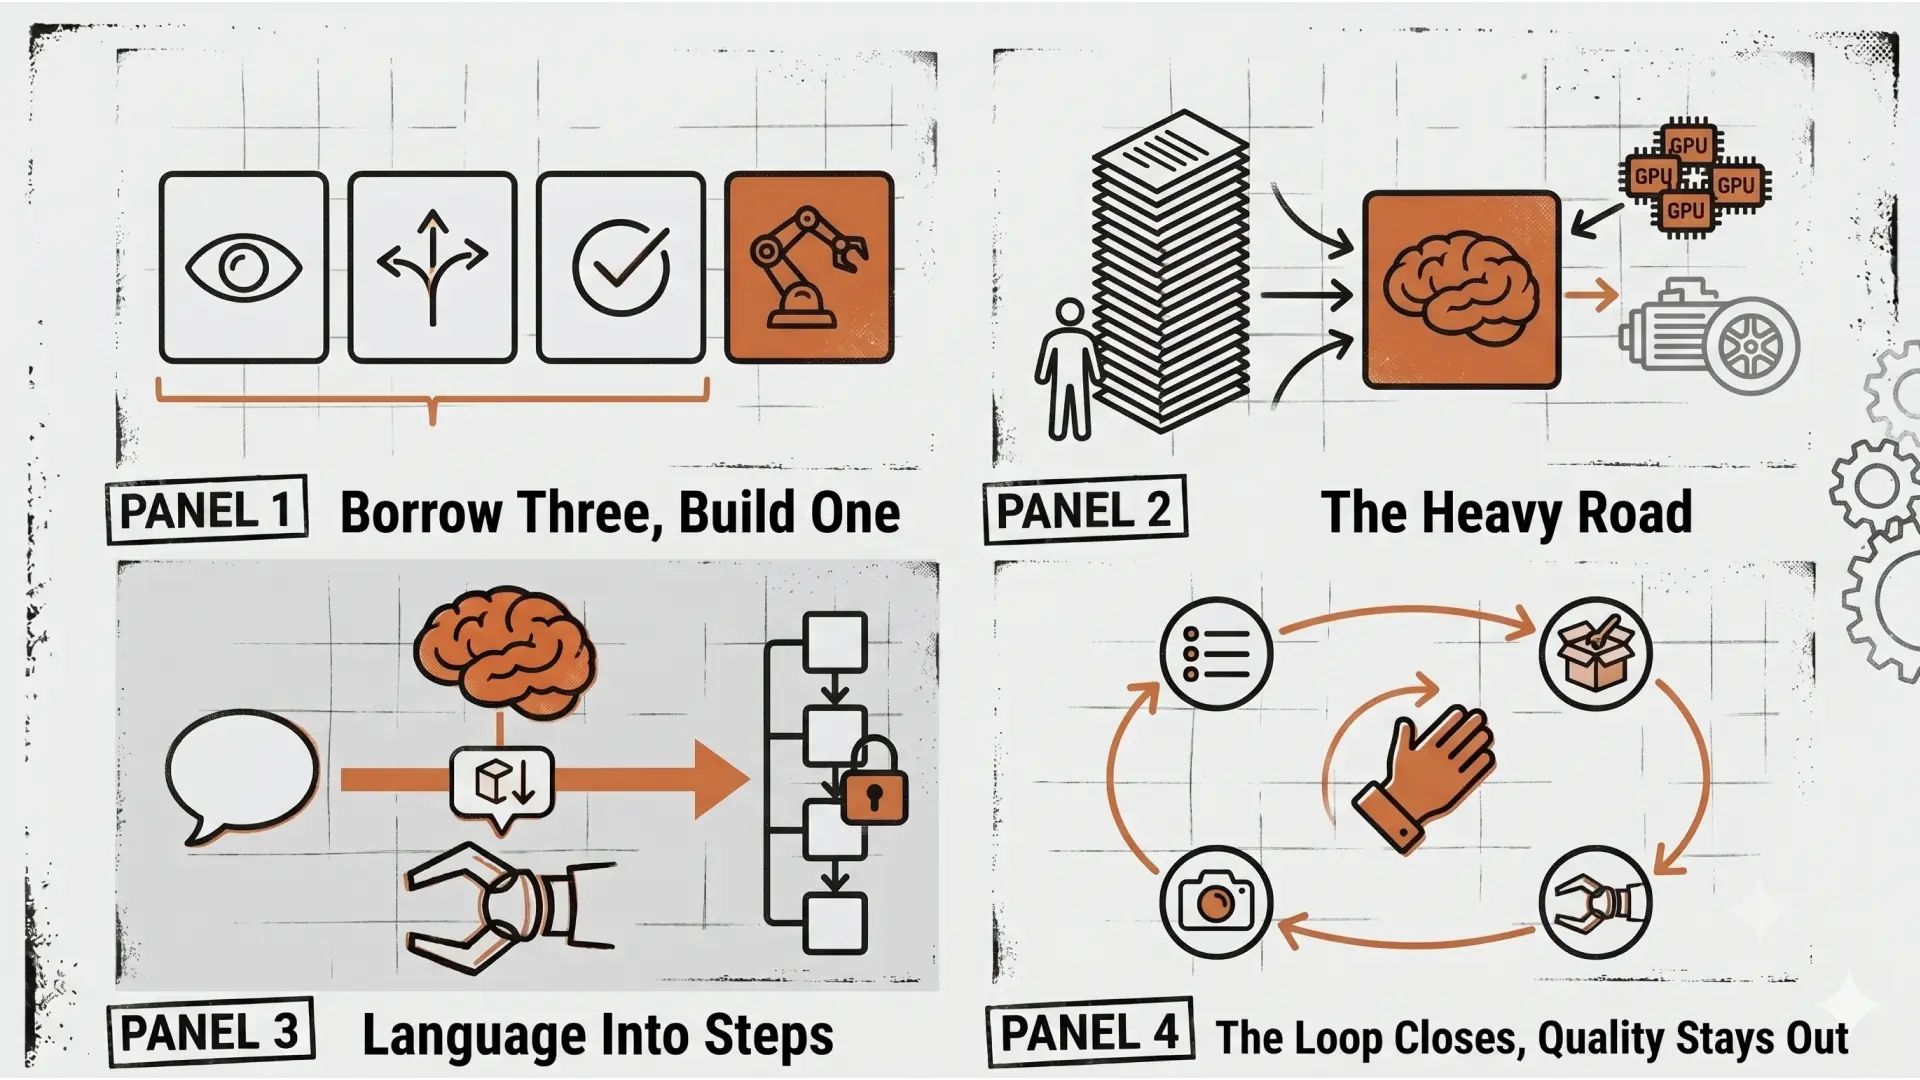
ここから先は、取り入れる側の話だ。考える脳と、手を動かす脳を分ける。Hi Robot という研究が、その分け方をそのまま見せてくれる。人が「ローストビーフとチーズのサンドイッチをください」と頼むと、上位の VLM が「パンから始めて、次にローストビーフとチーズ」と段取りを立て、自分に「全粒粉パンを一枚取る」と囁き、下位の π0 がそれを実際のモーター指令に変える。片付けの最中に「それはゴミじゃない」と口を挟まれれば、その「それ」が今掴んでいる物だと理解して振る舞いを変える。
考える脳(System 2)と手を動かす脳(System 1)を分ける ── これは UX が長くやってきた「意図の層」と「操作の層」を分けて設計する、あのレイヤリングそのものだ。そして自分のスケールで実装できる。既存の iPhone → API ループを、成否の「評価役」から段取りの「計画役」へ拡張するだけでいい。
System 1(手):LOG83 で作った距離ベースの Pick & Place を「位置 X で掴む/位置 Y に置く」のように引数で呼べる動作プリミティブとして固定する
System 2(脳):Claude/GPT-4o を高レベルプランナーに据え、ゴールとシーン写真から「赤いブロックを掴む」「右の箱に置く」というサブステップ列を出力させる
接続の肝:VLM の出力を「掴む/置く/待機」の固定語彙に縛り、その語彙を動作プリミティブと一対一で対応させる。これで計画と実行が確実に噛み合う
この二層が決まると、次の問いが立つ。人の手の動画は、どちらの層に入れるべきか。
人の手の動画は、軌道ではなく判断を記録する
このiPhoneを自分のヘッドに置くのと手首にカメラをつけて、人視点の画像、動画データを元にロボットに覚えさせる手法はオレでもできそうでね。テレオペレーションより筋が良さそうに感じるけどどう思う。
Physical Intelligence は、頭の iPhone と手首のカメラで撮った人間の一人称動画を、ロボットデータと混ぜて共同学習させている。人間の手の 3D 位置を、ロボットのエンドエフェクタの動きと同じ「行動」として読み替える発想だ。人間のビデオを微調整に含めるだけで、人間データにのみ存在する4つの汎化シナリオで性能が約2倍になった、と報告している。収集の速さと自然さで、これはテレオペより明確に筋がいい。
— 単独ではロボットを動かせない。だが「判断の層」になら効く。
落とし穴は、人間動画がそれ単独ではロボットを動かさないことだ。人間の手と mechArm のグリッパは、見た目も自由度も違う。そのドメインギャップを埋めているのが、彼らの場合は大規模ロボットデータで事前学習した土台モデルで、私はそれを持たない。頭に iPhone を載せて大量に撮っても、そのまま運動層に流し込めば動かない。
だから挿す層を変える。人間動画を、運動の層(System 1)ではなく判断の層(System 2)に入れる。自分が色ブロックを仕分ける動画を撮り、モーター指令に変換しようとするのではなく、Claude/GPT に見せて「どの順番で、どう判断して手を動かしたか」をサブゴールの系列として抜き出させる。動画が記録するのは手の 3D 軌道ではなく、判断の流れだ。前のセクションで手で打っていたコーチング指示を、自分の手の動きから自動生成することになる。
「ミックスがいいのか」という問いには、こう答える。混ぜるのではなく、層で役割を分ける。両方を同じ行動データとして混ぜるのは土台モデルを持つ側の戦い方で、こちらは層を分けたほうが確実に動く。
データの使い方 | 役割 | 自分のスケールで |
|---|---|---|
テレオペ(手動配置+距離ベース実行) | 下位の運動を確定させる | 可能。LOG83 で確立済み |
人間動画を「行動」として使う | モーター指令を直接学ばせる | 不可。土台モデルが前提 |
人間動画を「判断」として使う | System 2 の段取りを学ばせる | 可能。グリッパとの見た目差は問題にならない |
締め
6本の π の記事を低コスト側から読み通して、見えたことは一つだ。向こうは how をスケールの道具として扱い、Motion UX は how を設計の主題として扱う。FAST(行動トークナイザ)も Knowledge Insulation(VLM 訓練の手法)も、自前の VLA を学習する世界の話で、いまの自分のパイプラインには出番がない。それに釣られて時間を使わないことも、低コスト側の規律のうちだ。
取り入れるのは、二層構造と、how の読み替えと、人間動画を判断の層に置くこと。どれも「学習済みモデルをもらって、動きの品質と体験をつくる」というポジションに素直に接続する。本家がスケールの道具として作ったものを、設計の語彙として読み替える ── その翻訳作業そのものが、巨大資本には書けない一本になる。
Motion UX が設計するのは、ロボットの what ではない。how だ。Physical AI がスケールのために記号化した how を、こちらは体験そのものとして扱う。