世界はVLA、こちらは計画と評価 | ロボットを動かすVLMの、二つの使い方
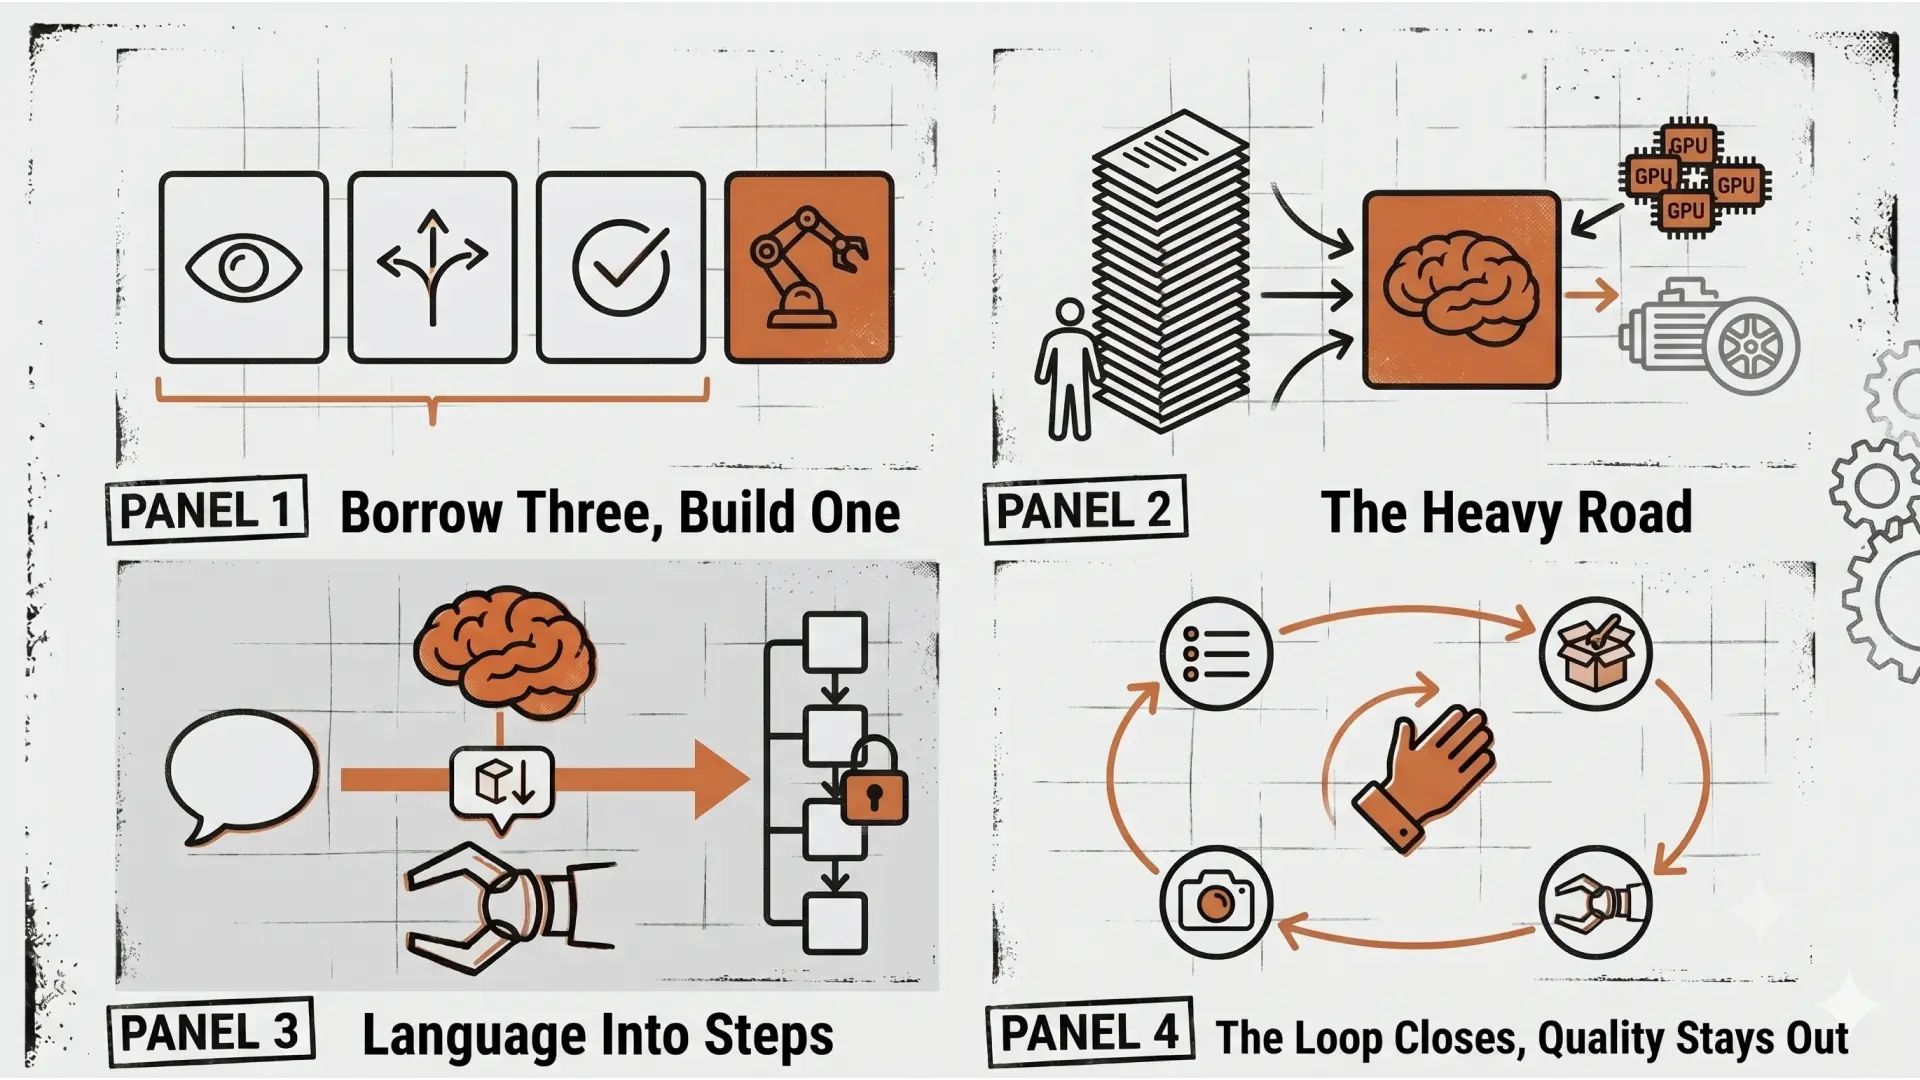
VLMでロボットを動かす、と聞くと多くの人がVLAを思い浮かべる。モデルを鍛えて動作そのものを出させる、あの重い道だ。だがそれは選択肢の一つにすぎない。役割を分けて見たとき、借りられるものが三つ、自分で作るものが一つだけ残った。
「VLMを使う=VLAを作る」ではない
VLMは、画像とテキストを受け取ってテキストを返す。LLMに目を足したものだ。「この箱の上にブロックは載っているか」のような言葉で書かれた問いに、世界知識と推論で答える。タスクごとの作り込みがいらない、というのがLLM由来の強みだ。
問題は、この「理解する機械」をどうやってロボットの動作に変えるか。ここで多くの人が、答えは一つだと思い込む。VLAだ、と。
—— VLMを使うなら、VLAを作るしかないのか?
そうではない。VLMはロボットの中で、複数の異なる仕事を担える。そこを分けないまま「VLMでロボット」と言うから、話がVLAに一本化されてしまう。
重い道 ── VLAは何を賭けているか
VLAは、VLMをファインチューニングして「テキストの代わりに動作を出す」ようにしたものだ。世界の主流はここにある。
代表例を並べると地形が見える。Physical Intelligenceのπ0は、約3BのVLMに拡散モデルのアクションエキスパートを足して、高頻度でモーター指令を出す。NVIDIAのGR00T N1やFigureのHelixは、人間の「速い思考・遅い思考」を真似たデュアルシステムだ。遅いVLMが状況を解釈し、速い動作モジュールがリアルタイムで動きを作る。実機で回すには遅延が許されないので、どのモデルも2B前後の小さなLLMに絞り込まれている。OpenVLAは7Bのオープンソースで、約97万エピソードの実機データで学習している。
動作の出し方は二通りだ。離散化型は動作を区切ってトークンにして、テキストと同じ要領で予測する。連続値型は拡散モデルで滑らかな軌跡を生成する。どちらにせよ、大量のロボットデータ、GPU、微調整が前提になる。動作の質を、モデルそのものに学習させて取りにいく。データ収集とモデル学習が主戦場だ。
—— 個人でこの道を追えるか?
資本の桁が違う。データもGPUも、個人が私費で張り合える規模ではない。
VLAは強いよ。でも、ここで張り合っても仕方ない。賭けるものが違いすぎる。
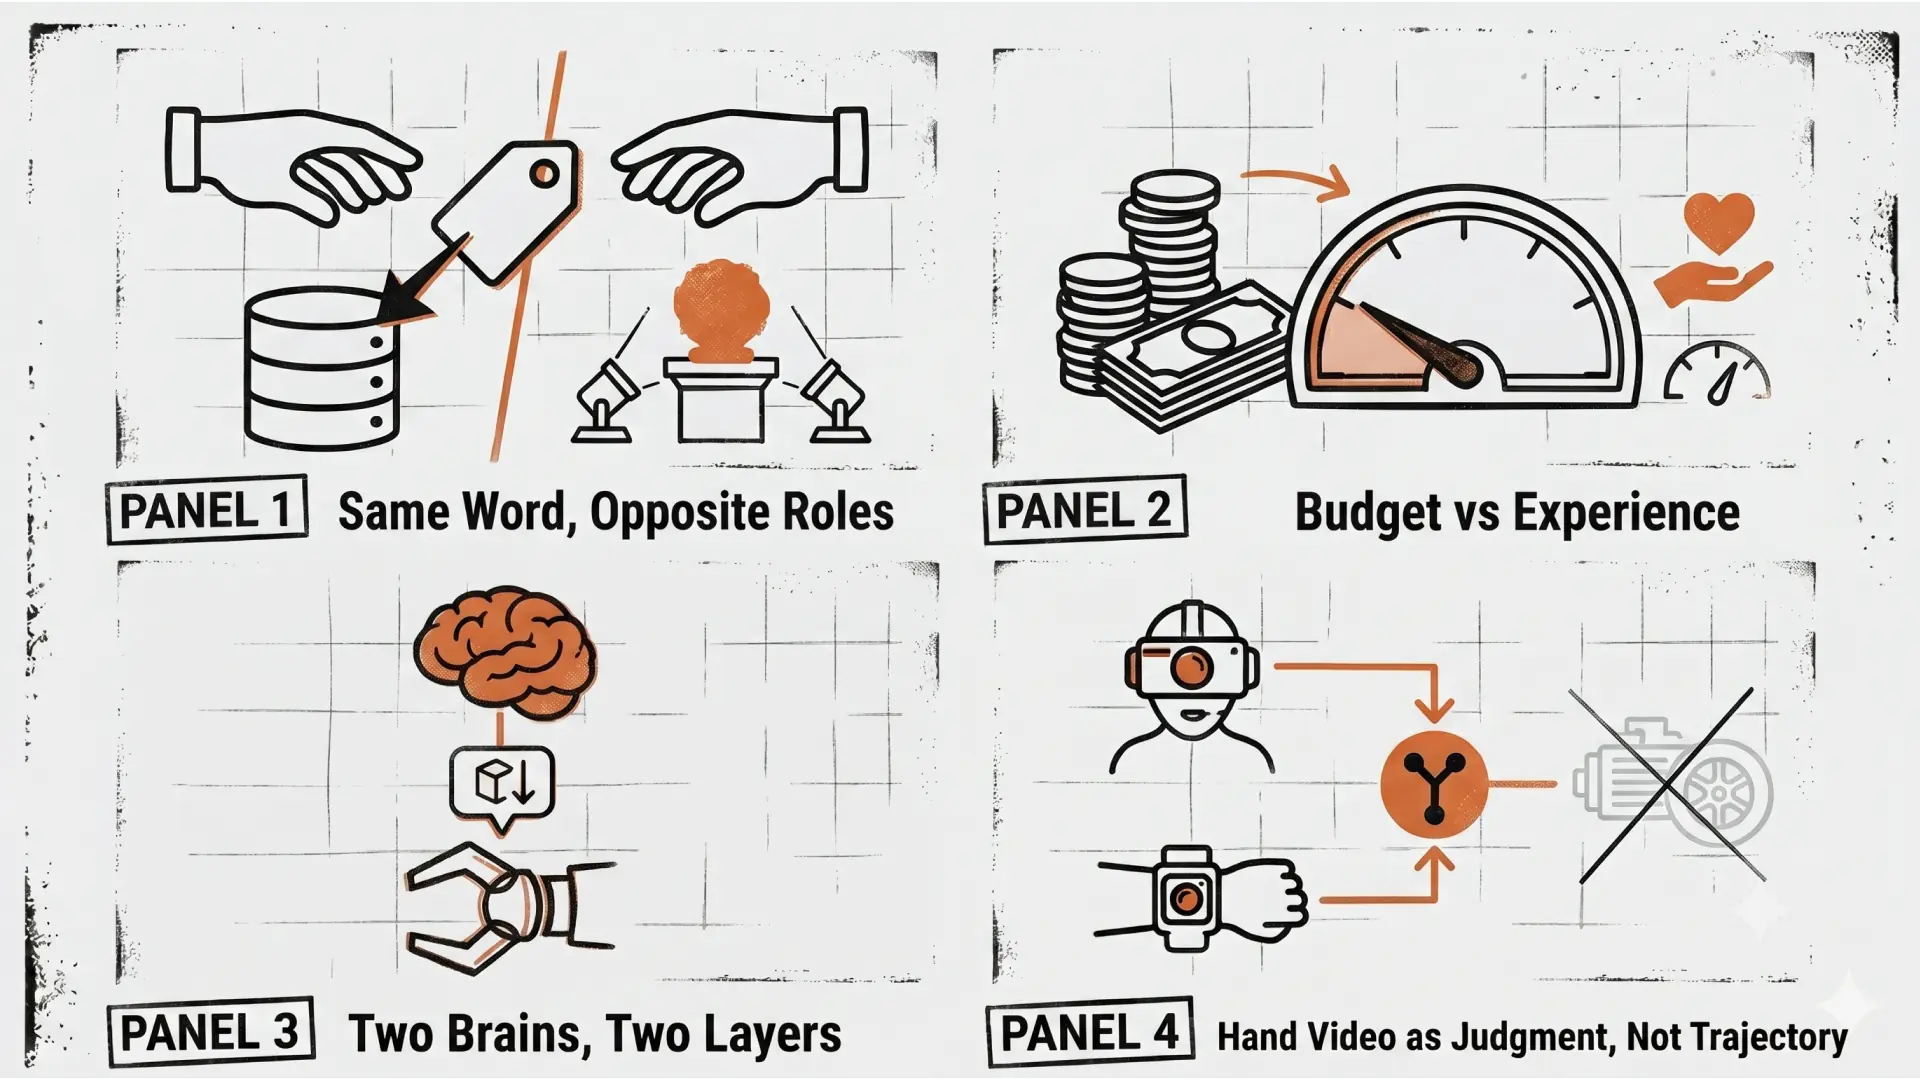
同じVLMに、四つの顔がある
VLAだけがVLMの使い方ではない。一つのVLMという資産は、ロボットの中で四つの役割を担える。
役割 | 何をするか | 重さ |
|---|---|---|
①知覚・理解 | シーンを言語化する | 借りられる |
②高レベル計画 | 曖昧な指示を手順に分解する | 借りられる |
③ポリシー(VLA) | 動作を直接出力する | 自分で作る・重い |
④報酬・評価 | 成否を判定する | 借りられる |
③だけが「モデルを鍛える」重い道だ。残りの①②④は、市販のVLMの判断力をそのまま借りればいい。Pixels to MotorsがすでにやっているVLM-as-Reward ── iPhoneで結果を撮ってClaudeやGPT-4oに「掴めたか」を判定させ、報酬にする方式 ── は、まさに④だ。データもGPUもいらない。
そうか、全部を作らなくていいのか。③だけ自分で持てば成立する。
なぜ三つは借りられて、一つは作るしかないのか
境界線は、はっきりしている。①知覚、②計画、④評価は、どれも「見て、言葉にして、考える」仕事だ。インターネット規模で事前学習したVLMの世界知識と推論が、そのまま効く。コップが倒れているか、次に何をすべきか、掴めたかどうか ── こういう問いは、世界の側にすでに答えの形がある。だから借りられる。
③だけが違う。あるアームを、ある速度で、ある角度から動かしたときに何が起きるか ── これはその身体に固有で、ネット上のテキストや画像には載っていない。だから学習で身体に教え込むしかない。これがVLAの重さの正体であり、③だけが「作る」側に立つ理由だ。
従来のロボティクスは、知覚 → 計画 → 動作 という縦の流れで語られる。だがVLMを役割で見ると、別の地図が立ち上がる。
役割 | 担い手 |
|---|---|
①知覚 | 市販VLM(借りる) |
②計画 | 市販VLM(借りる) |
③動作 | 自分(作る) |
④評価 | 市販VLM(借りる) |
借りる、借りる、作る、借りる。これがPixels to Motorsの組み方だ。本当の発見は「計画層が足りない」ではない。「①②④は借りられる」だった。
計画層は、具体的に何をするのか
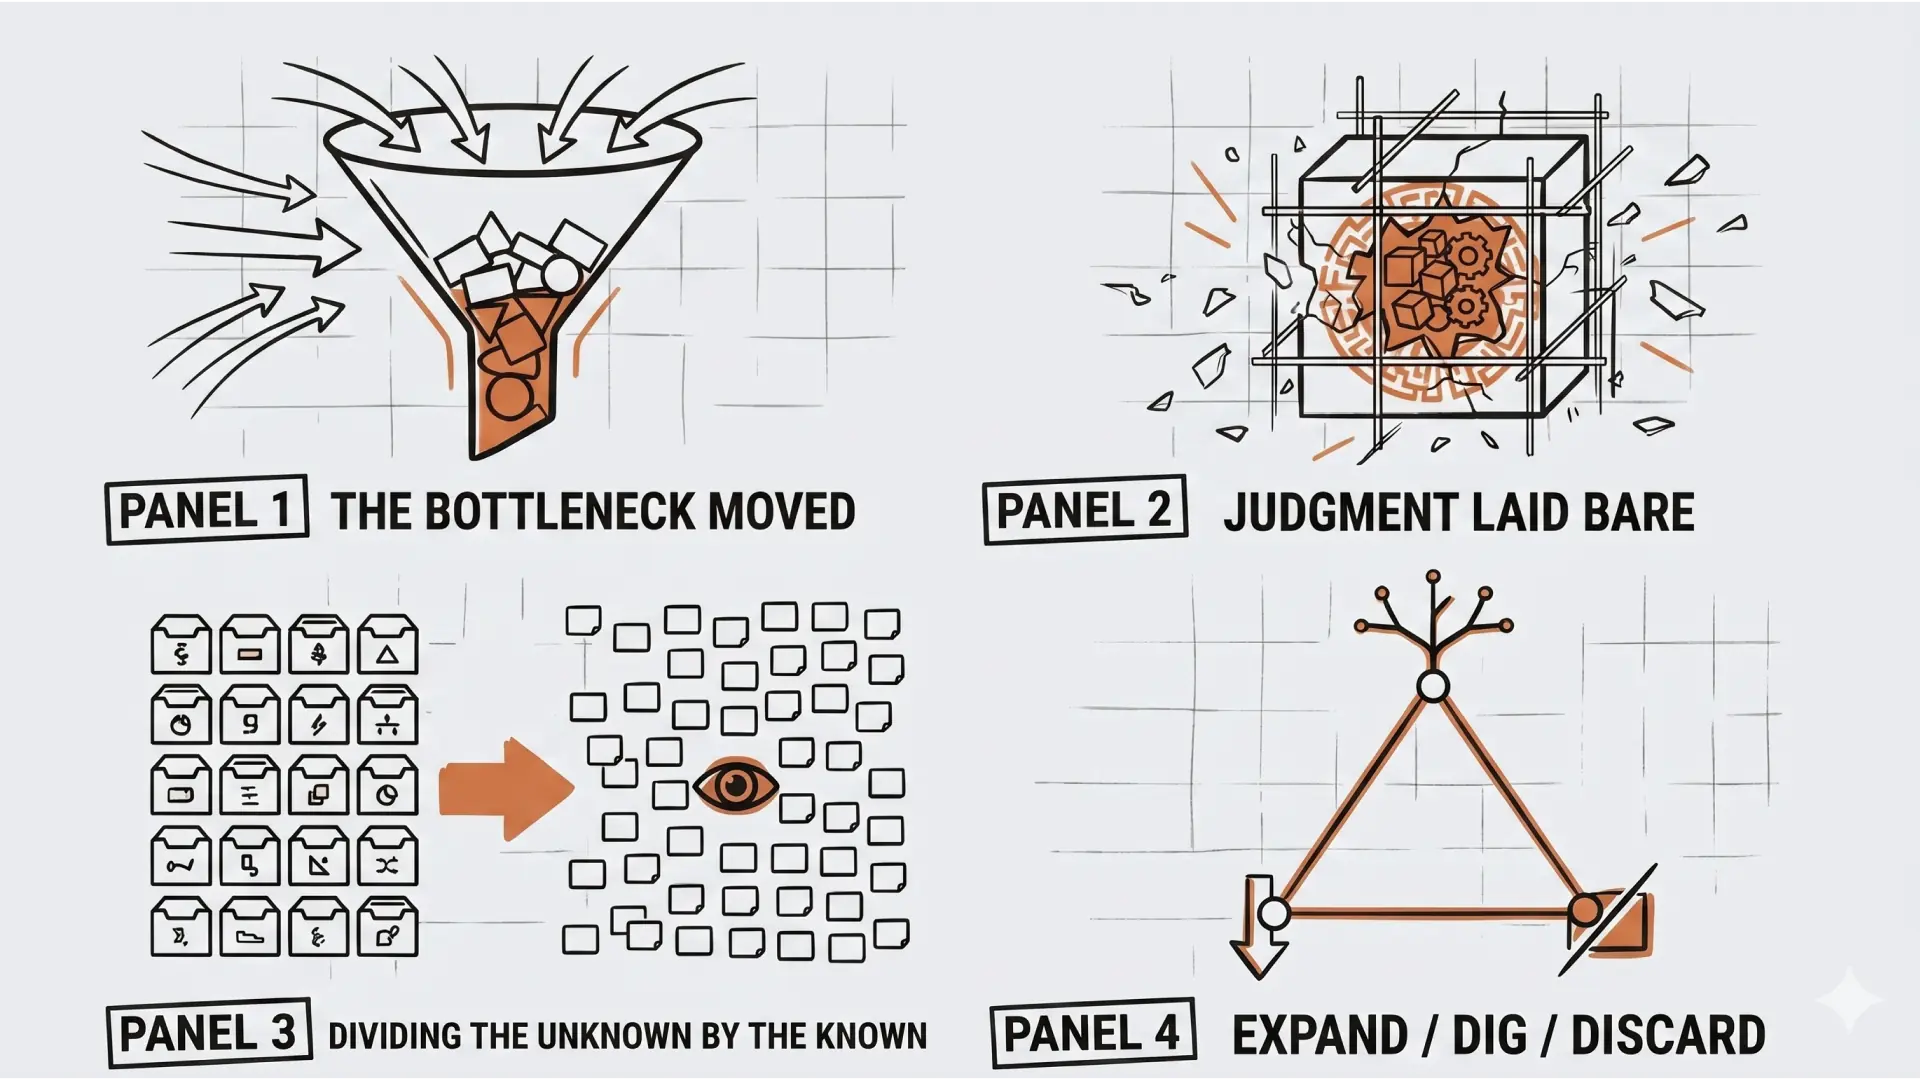
ここが主題だ。計画層の仕事は、言語を「計画のインターフェース」にすること。「青いブロックを白い箱に入れて」という指示は、ロボットがそのまま実行できる粒度ではない。これを「箱の上空へ移動 → 掴む → 箱へ運ぶ → 離す」という実行可能な手順の列に翻訳する。曖昧な目標から具体的な手順への変換を、タスクごとの作り込みなしにやる。それが計画層だ。
やり方は、研究の蓄積から四つに整理できる。
① タスク分解。 目標とカメラ画像をVLMに渡し、達成までの手順を順番に挙げさせる。出力は手順の列。ここまでは素のVLMでもできる。
② スキルへの接地(グラウンディング)。 ここが最難所だ。VLMは「箱を持ち上げて振る」のような、物理的に不可能な手順を平気で出す。GoogleのSayCanの発想がこれを防ぐ ── 「役に立つ度(VLM側)」と「実行可能度(実機側)」を掛け合わせ、両方が高い行動だけを選ぶ。実装は単純で、呼べるスキルのリストを先に渡し、その中からしか選ばせない。PICK・PLACE・APPROACH・HOME という確定済みのプリミティブが、そのまま「許可された語彙」になる。
③ コードとして出す(Code as Policies)。 自然言語の手順ではなく、スキルAPIを呼ぶPythonコードをVLMに直接書かせる。曖昧さが消え、条件分岐やループも書ける。armを引数に取る設計なら、双腕へ広げてもプランナが呼ぶ形は変わらない。
④ 視覚フィードバックで再計画(Inner Monologue)。 一手実行するたびにiPhoneで撮り直し、VLMに「掴めたか」を確認させ、失敗していれば手順を組み直す。この「成否を判定する」部分は、すでに持っているVLM-as-Rewardそのものだ。
②の計画と④の評価、別々に見てたけど、繋ぐと一周するんだな。
そういうことだ。プランナ(②)と評価器(④)を繋いだ瞬間、閉ループの自律計画が立ち上がる。
自分のループで、空いていたのはどこか
閉ループとして並べ替えると、手元に何が揃っていて、何が空いているかがはっきりする。
役割で並べ直すと、こうなる。スキル群(place_modules の PICK・PLACE・APPROACH)がスキルライブラリ、確定済みの定数(HOME、j5=-30°、到達許容2.5°、send_angles限定)が安全ガードレール、VLM-as-Rewardがフィードバック。この三つはもう実機で動いている。足りないのは、これらを束ねて手順を決めるプランナVLMの一段だけだ。
—— 計画層が埋まれば、ループは閉じるのか?
閉じる。「青ブロックを白箱へ」という指示と上カメラの画像をVLMに渡し、公開したスキルAPIの範囲でコードを書かせる。実行のたびに評価器で確認し、ズレていれば組み直す。この一周が回った瞬間、「指示するだけでアームが片付ける」という体験が成立する。データ収集もモデル学習もせず、市販VLMの判断だけで。
計画層が吐くのは、自然言語の手順ではなくコードにできる。曖昧さが消えて、そのまま実行へ渡せる。
approach()    # 箱の上空へ
pick()        # ブロックを掴む
move_to()     # 箱へ運ぶ
release()     # 離す
home()        # ホームへ戻る
実装ではarmを引数に取る形にして、双腕へ広げるときの書き直しを減らす。計画層はこのAPIを組み合わせて呼ぶだけで、モーターには触らない。
置き方の鉄則は三つある。
遅いプランナと速いスキルを分ける ── 計画はクラウドの大きなVLMでもいい代わりに、タスクの区切りでしか回さない。実際の動作はローカルのsend_anglesとFKルックアップが高速・確実に担う。VLMの遅延や不安定さを実機の安全性に触れさせない。
スキルを強制する ── 許可されたAPIの中からしか選ばせず、不可能な手順を物理的に締め出す。グラウンディングを怠ると、VLMは平然と無茶な手順を出す。
判定を二重化する ── VLMの評価は完璧ではない。鵜呑みにせず、到達許容2.5°や白箱の高さ45mmといった確定済みの幾何と照合する。
計画層を足しても、動きの質は外に残る
ここがいちばん大事な線引きだ。計画層は「順番」を決める。青ブロックを掴んで白箱に入れる、その手順を組む。だが、青ブロックをどう掴むかには触らない。
同じ「掴む」でも、接近の角度、減速の曲線、止め方ひとつで、人が受け取る印象は変わる。半分だけ自然な動きは、完全に機械的な動きよりかえって不安にさせる ── 動きの不気味の谷だ(LOG212)。これは順番の問題ではない。各動作の質の問題であり、Motion UXの領域だ。
つまり、計画層を足してもMotion UXは外側に残る。世界がVLAで「動くこと」を取りにいっている横で、動きの質を設計する余白はそのまま手元に残る。
VLAという重い道を追わない判断は、逃げではない。逃げに見えないのは、精度の輪郭を測ってきたからだ。send_coords()の逆運動学はRZが位置によって暴れるから封じ、512,087点のFKルックアップとsend_angles()だけで動かす選択に至った。到達許容は2.5°、白箱は45mm。この輪郭を知っているから、「ここは精度を諦めて体験で吸収する」と判断できる。輪郭を測らずに体験優先と言えば、ただの逃げになる。
締め
世界はVLAで「動くこと」を取りにいっている。こちらは①知覚、②計画、④評価を借り、③だけを作る。だから要るのは巨大な学習環境ではなく、計画層ひとつだった。
動作を学習させる競争には入らない。その代わり、動きの質だけは手放さない。次は計画層のプロトタイプに入る。
借りられるものは借りる。作るのは、動きの質ひとつだ。