

画像認識と物体検出を学び直す Log#11 | Decisions API は爪の間のブロックを0%か100%で見分けたが、持ち上がったかは判定できなかった ― 把持判定テストと実機640試行の失敗分類
Log#10 では Meta の SAM 3 に生成画像を渡し、言葉で物を切り出せるかを見た。この回は、OpenAI が2026年10月6日に全開発者へ公開した Decisions API を、このプロジェクトの実機の写真で試す。Log#10 の終わりで予告した「画像F の誤検出」と「Gemini Robotics ER 2」は次の回以降に回し、IoU・Precision・Recall・mAP の回はさらにその後になる。
このプロジェクトでは、ロボットアーム(mechArm 270 Pi)が赤いブロックを掴んで白い箱へ置く動作を繰り返している。掴めたか・置けたかは、真上のカメラで撮った写真を画像を読める AI に渡して判定させている(VLM-as-Reward と呼んでいる方式)。Decisions API は「決めておいた選択肢の中から答えを選ぶ」ことに絞った API で、この判定の置き換え候補になる。
試した結果、Decisions API は「爪の先の間に赤いブロックがあるか」をほぼ0%か100%で答え分けた。一方で「ブロックが床から持ち上がったか」は、聞き方を3通り変え、写真を2枚比べさせても判定できなかった。真上のカメラからは高さが写らないためで、モデルの性能ではなく入力の情報不足だった。
そこから話が進み、実機の実行ログ640試行を読み直して、実際に起きた失敗を種類ごとに数えた。画像で見分けるべき失敗は全体の約4割で、残りは関節が目標に届かない・安全チェックで止まるといった、画像判定では解決しない失敗だった。最後に、画像判定に渡す選択肢の最初の案を作った。
OpenAI の Decisions API は、決めておいた選択肢から答えを選ぶ専用の窓口
Decisions API は、2026年9月29日の OpenAI DevDay で限定公開され、10月6日に全開発者向けのパブリックベータになった。使えるモデルは gpt-6-luna だけで、送り先は POST /v1/decisions という専用の住所になる。
普通の対話用 API(Responses API)は文章を生成して返す。Decisions API は文章を書かず、決まった形の答えだけを返す。OpenAI は、同じ gpt-6-luna を Responses API で呼ぶより約10倍速いと説明している。
1回の問い合わせは3つの部品でできている。
部品 | 中身 |
|---|---|
| 判定するモデル。現時点では |
| 判定の材料。文字列、または文字と画像を並べたメッセージ |
| 何を判定するか。質問の種類・指示文・選択肢を書く |
質問の種類は3つある。
種類 | 何を聞くか | 返ってくるもの |
|---|---|---|
| ある文が正しいか(例: 爪がブロックを挟んでいる) | 0〜1 の確率 |
| 決めた選択肢のどれに当たるか(例: 掴んでいる/空/掴み損ね) | 選ばれた値と、選択肢ごとの確率 |
| 順序のある段階のどこか(例: 損傷なし・軽微・重大) | 段階の番号を確率で重み付けした平均 |
画像は base64(画像のデータを文字の列に変換したもの)で問い合わせの中に直接埋め込む。画像の URL を渡す方式は受け付けない。料金は入力100万トークンあたり0.10ドルで、出力には課金されない。
OpenAI の管理画面(platform.openai.com)の左メニューに「Decisions」があり、そこからコードを書かずに試せる Playground(お試し画面)が開く。
【画像】DAY325_01_platform_home.png
OpenAI Platform のホーム画面。左メニューに Decisions と Agents が New 付きで並ぶ
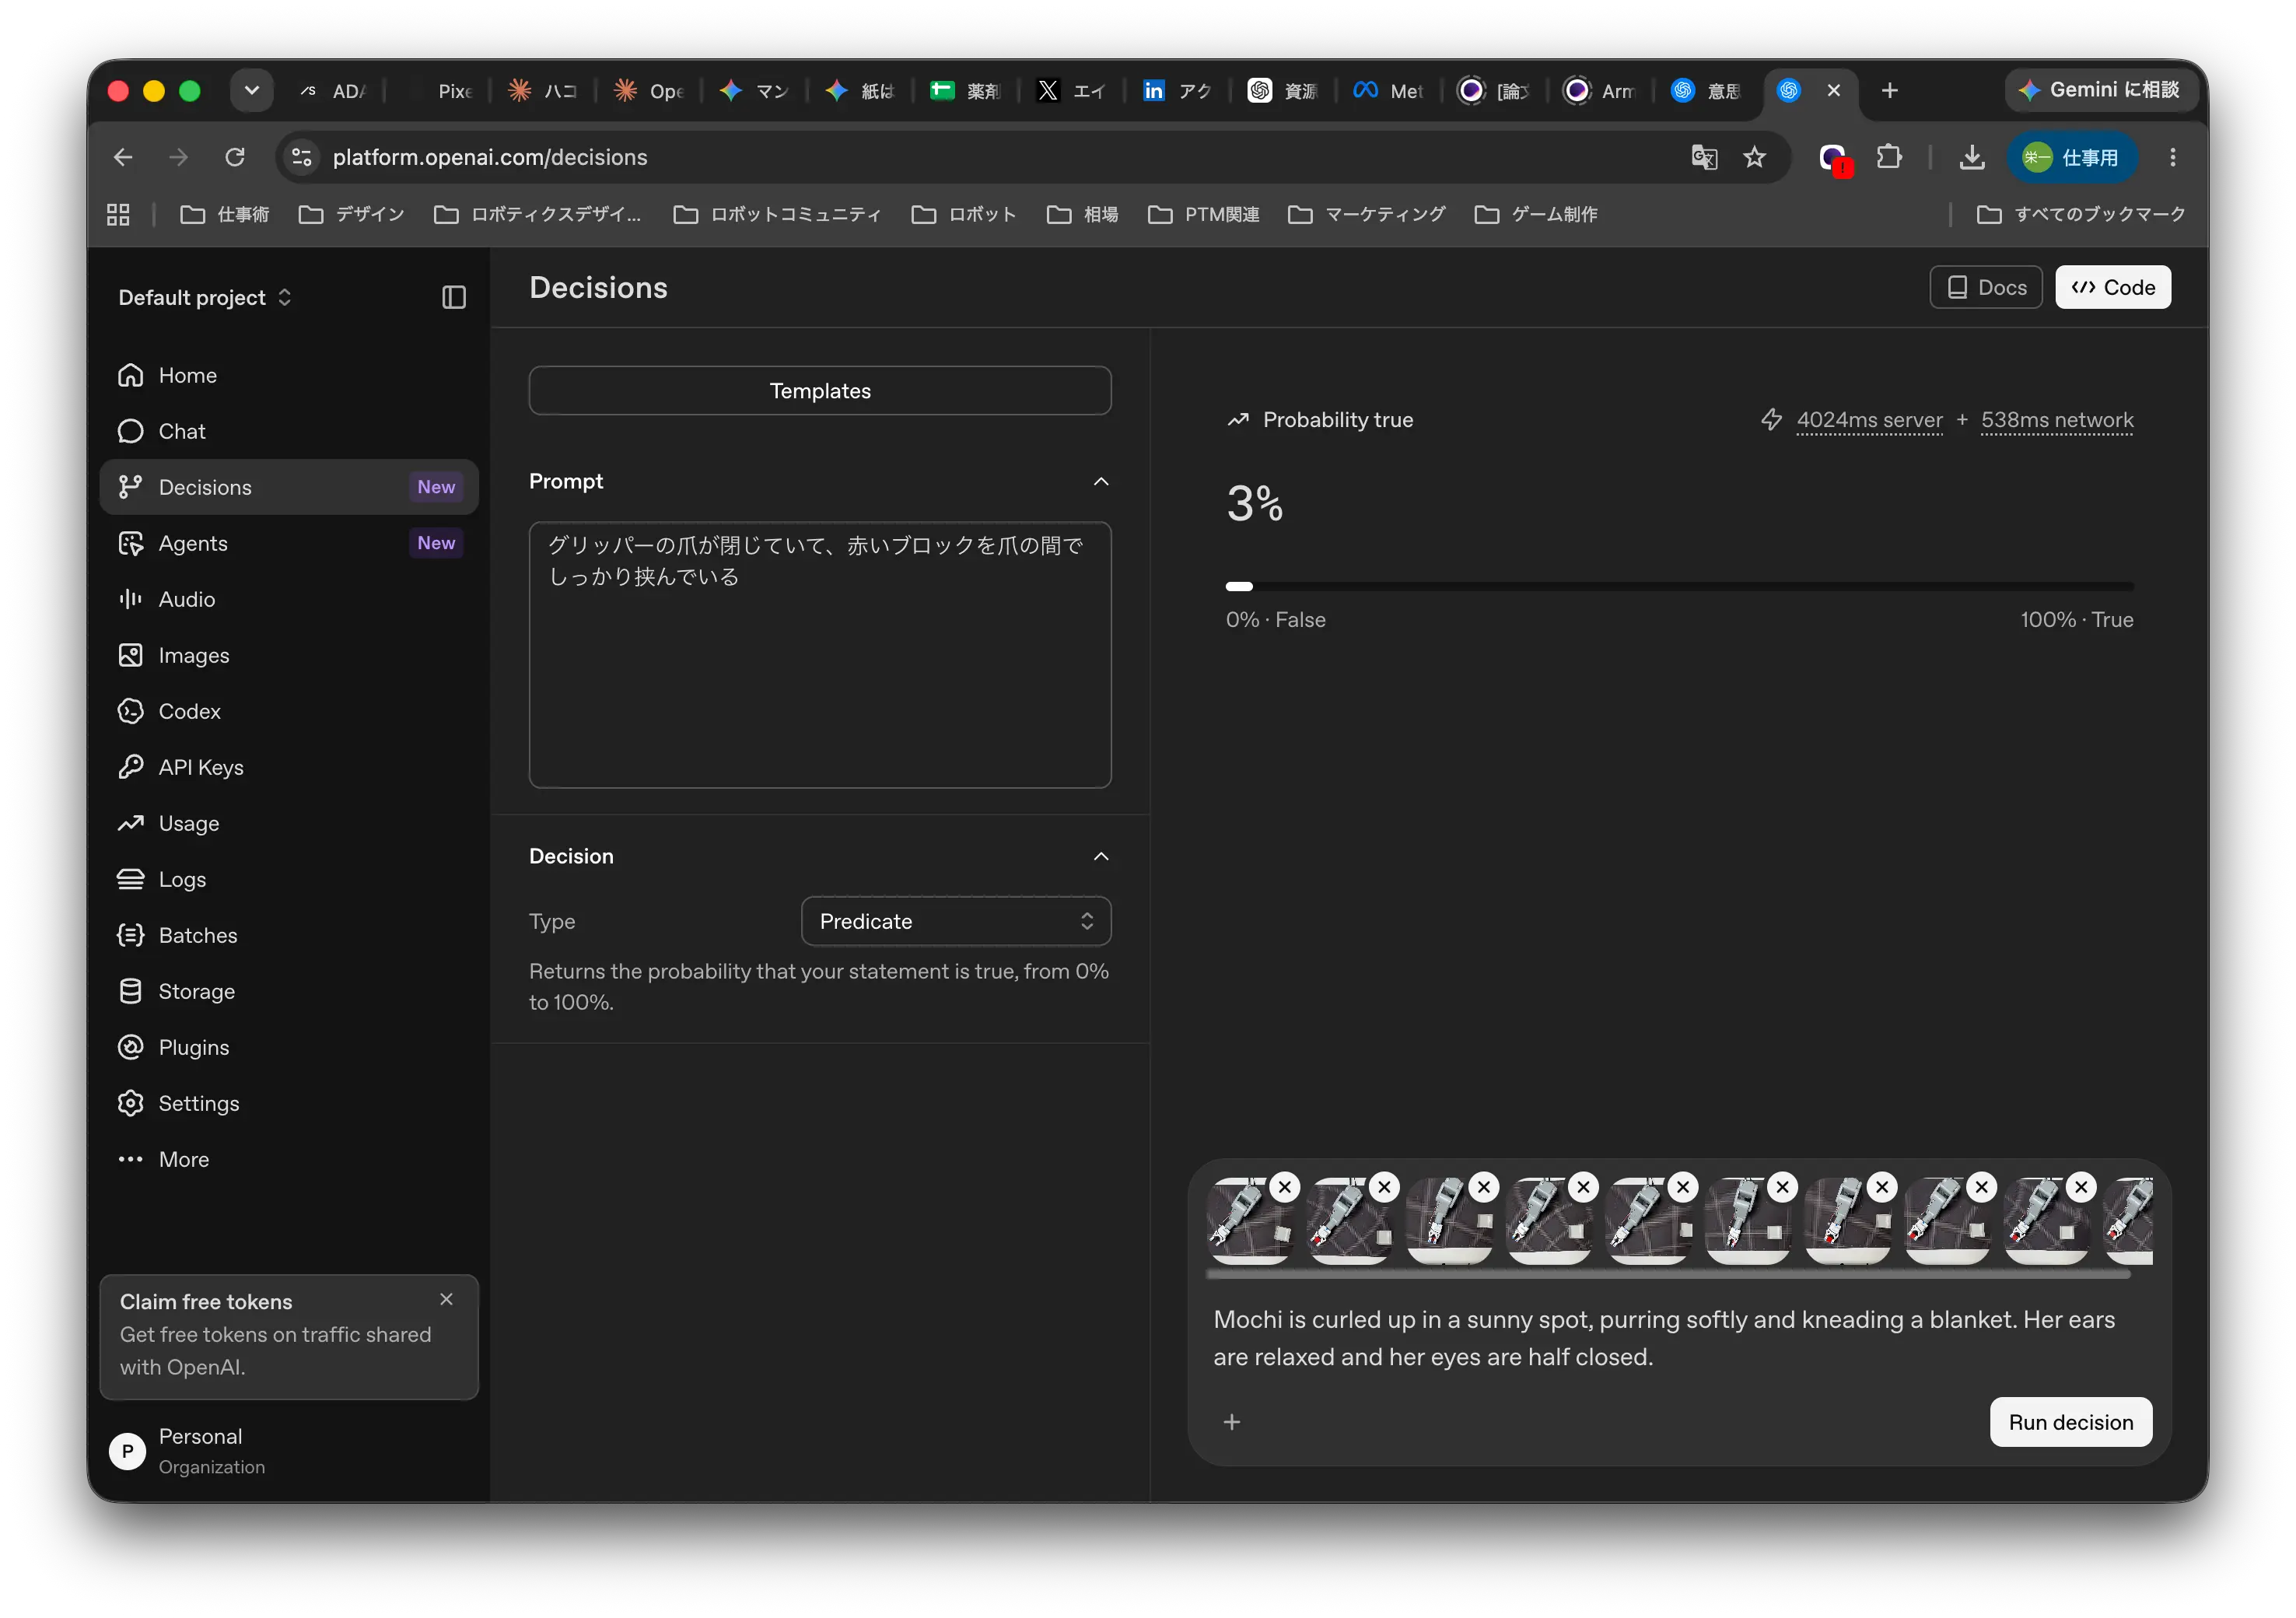
Decisions の Playground。左に指示文と質問の種類、右下に判定させる入力欄がある
Playground には「Mochi the Cat(猫のモチがくつろいでいるか)」などのテンプレートが4つ用意されている。左の Prompt 欄に判定させたい文を書き、右下の入力欄に文章や画像を入れて「Run decision」を押すと、右上に確率が出る。
Playground で画像10枚と猫の文章を一度に送ると、10枚まとめて1問として判定された
最初は Playground で試した。質問の種類は predicate、指示文は日本語で「グリッパーの爪が閉じていて、赤いブロックを爪の間でしっかり挟んでいる」とした。グリッパーはアームの先端にある、2本の爪で物を挟む部品のこと。
テスト用の画像10枚(選び方は次の節に書く)を入力欄に一度に添付して実行すると、結果は3%だった。
画像10枚を一度に添付し、テンプレートの猫の文章も残ったまま実行した画面。結果は3%、サーバー処理4024ミリ秒
この画面には問題が2つあった。1つは、10枚を一度に入れると「10枚全体を見て、爪がブロックを挟んでいるか」という1つの質問になること。失敗した画像も混ざっているので、低い数字が出るのは当然だった。もう1つは、テンプレートの猫の文章(Mochi is curled up in a sunny spot...)が入力欄に残ったままで、判定材料に一緒に送られていたこと。処理時間も、画像10枚分で4024ミリ秒かかっている。
猫の文章を消し、画像を1枚ずつに分けて判定し直した。掴めている画像 ok_01 は2%、同じく掴めている ok_02 は85%になった。1枚だけにすると、処理時間は477〜810ミリ秒まで縮んだ。
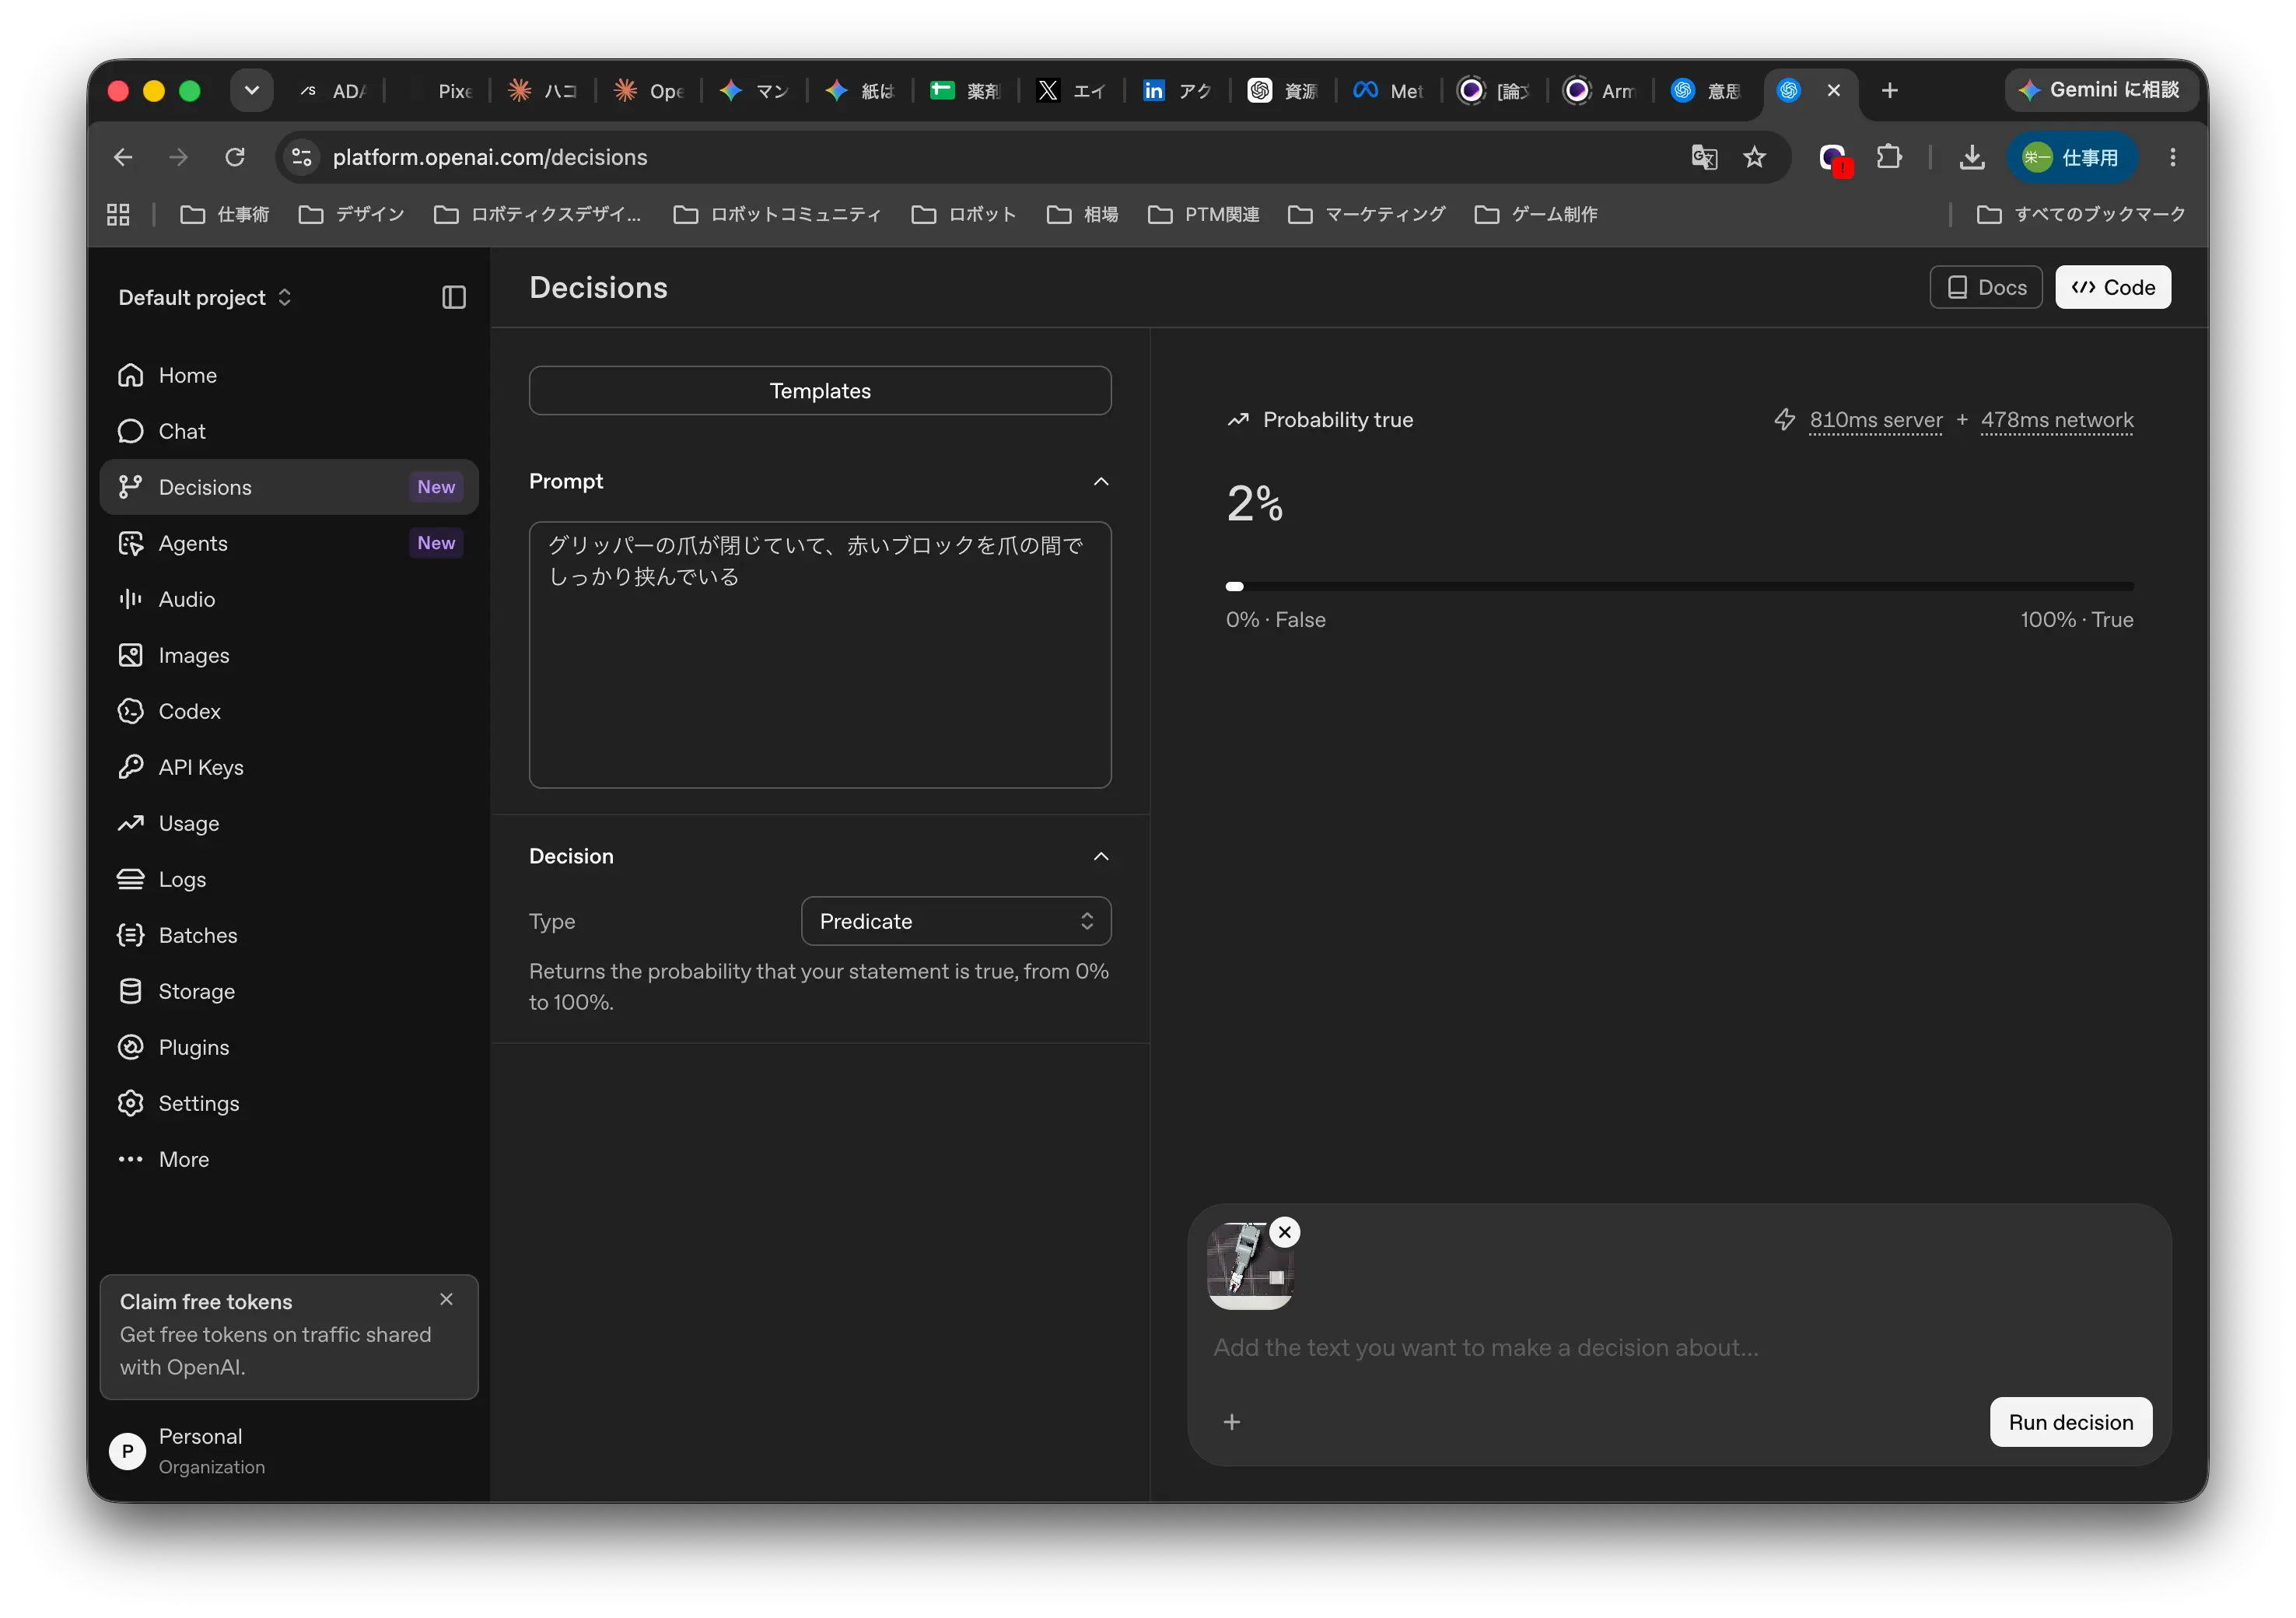
掴めている画像 ok_01 を1枚だけ判定した画面。結果は2%
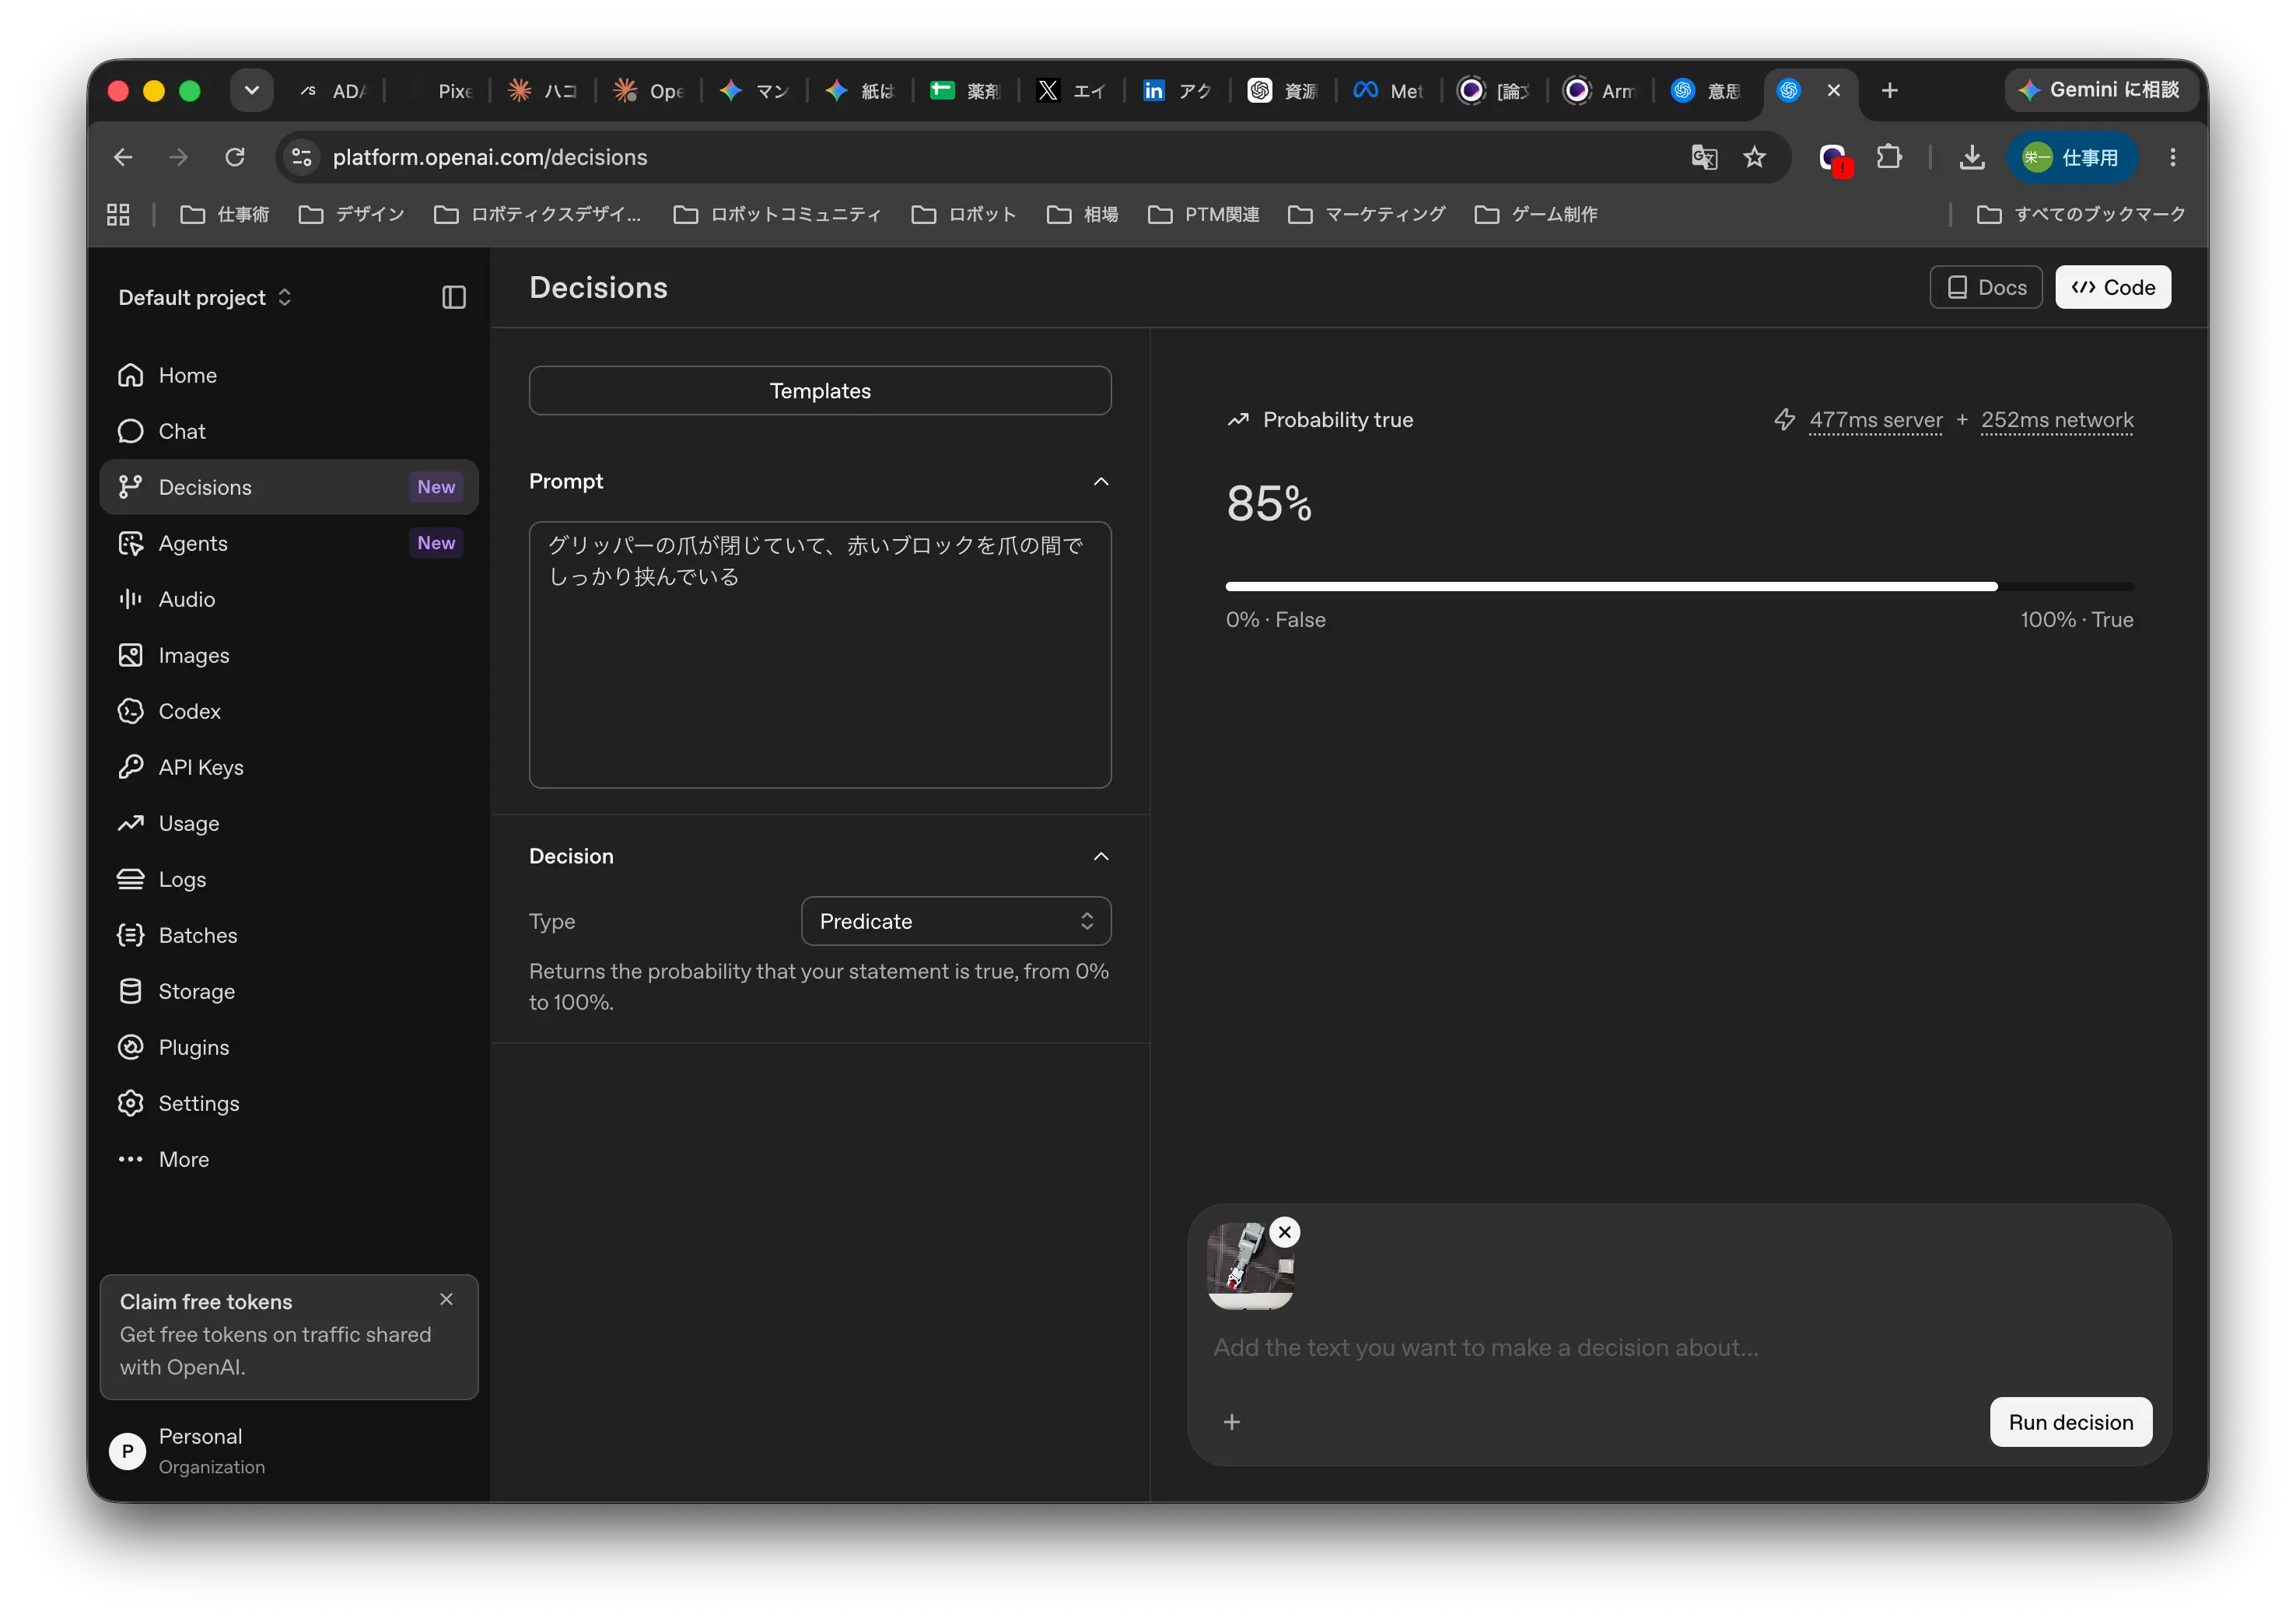
掴めている画像 ok_02 を1枚だけ判定した画面。結果は85%、サーバー処理477ミリ秒
同じ「掴めている」写真なのに、2%と85%に分かれた。ok_01 の写真を見ると、赤いブロックが爪の下に隠れて、赤い部分がほんの少ししか写っていない。真上のカメラからは、人の目で見ても掴めているかどうか判断しにくい写真だった。ここから先は、10枚を自動で順番に判定するスクリプトに切り替えた。
テスト画像は KIOXIA の実行ログから、掴めた5枚と1回目に失敗した5枚を選んだ
実機の写真は、外付けSSD(KIOXIA)の r2r2r-data/runs/run_pick_place/ に、1試行ごとのフォルダで残っている。1つのフォルダには、試行の記録(run_xxxx.json)、段階ごとの状態を1行ずつ書いたログ(telemetry.jsonl)、それぞれの段階で撮った写真が入っている。
写真の種類は次のとおり。
ファイル名の末尾 | いつ撮ったか |
|---|---|
| 爪がブロックの位置まで下りた直後(爪はまだ開いている) |
| 爪を閉じて持ち上げた後 |
| 掴み直しの2回目・3回目の、持ち上げた後 |
| 箱の上で、横から撮った写真 |
| 箱に置いて腕を戻した後、真上から撮った写真 |
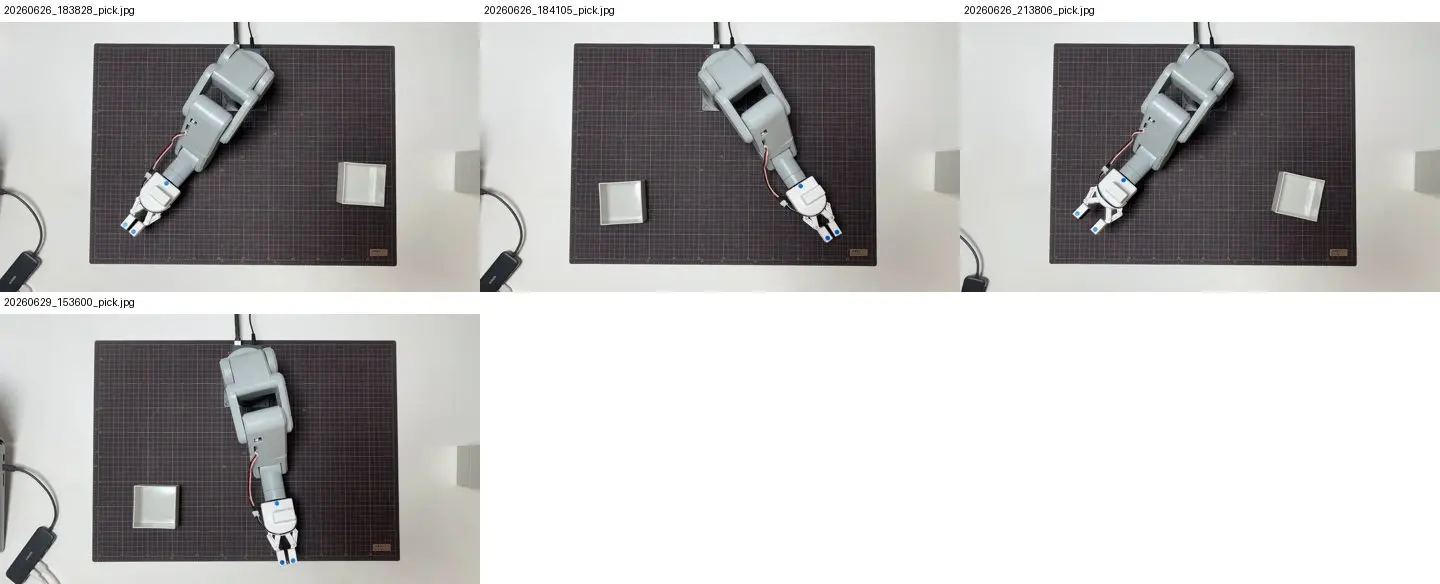
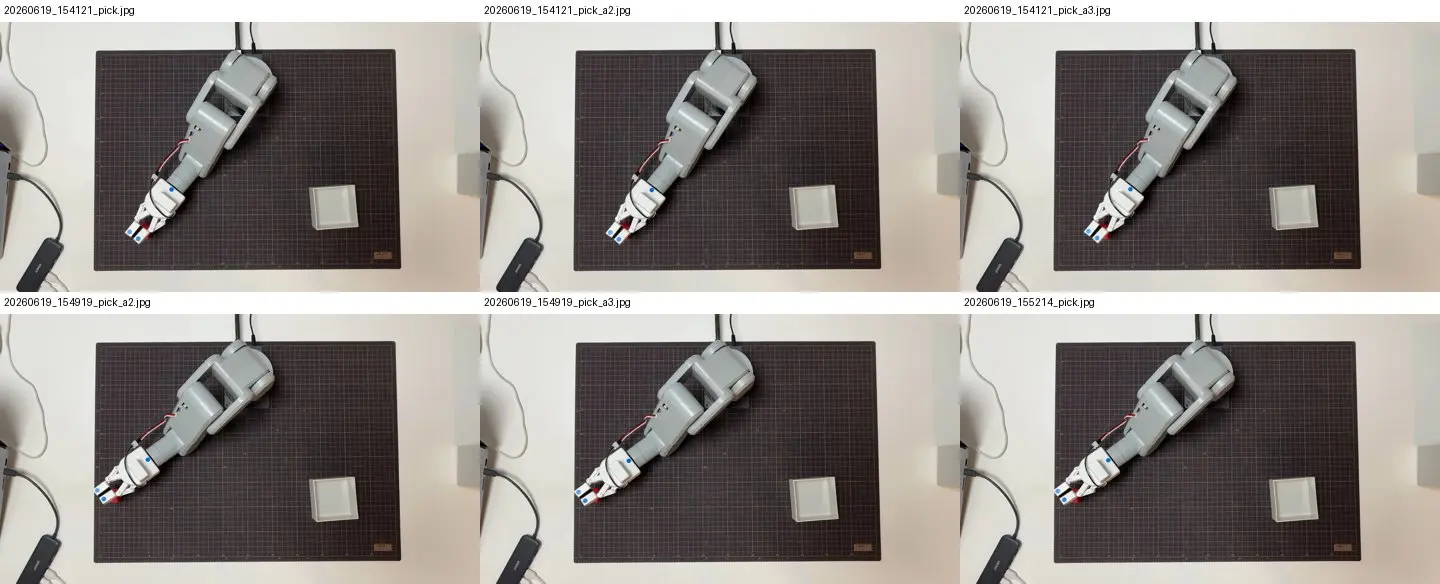
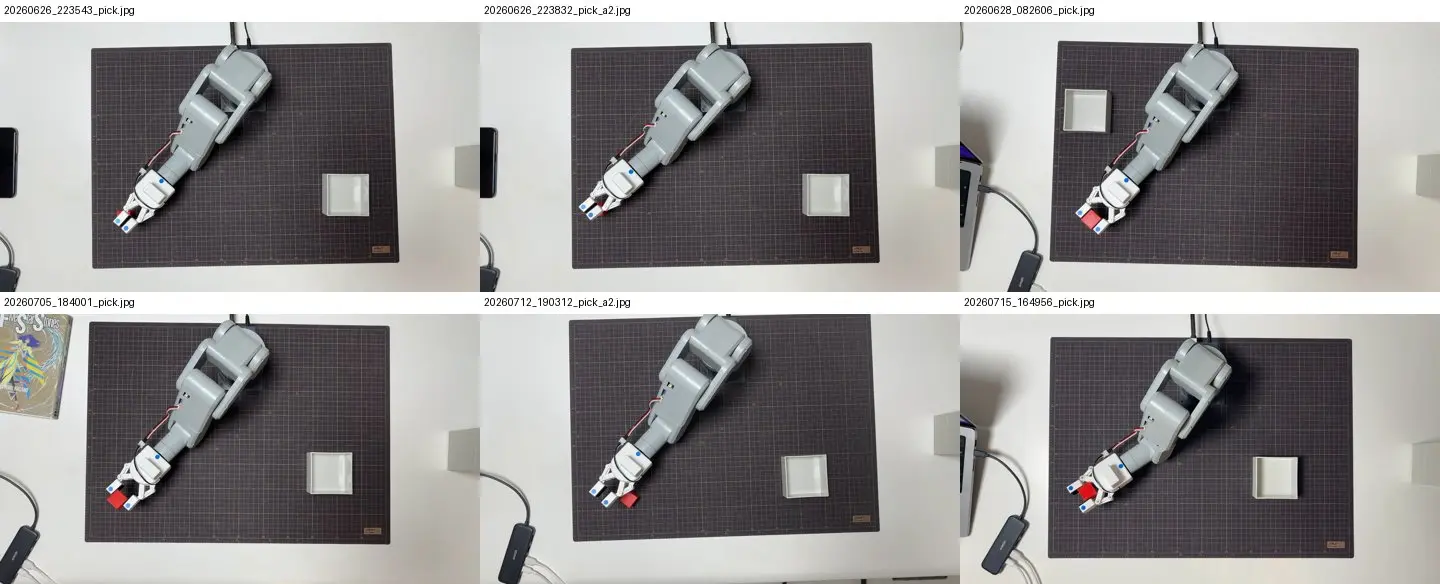
正解を決めるために、掴み直し(_pick_a2.jpg)が記録されている試行に目を付けた。掴み直しが起きたということは、1回目は失敗と判定されている。その試行の1回目の _pick.jpg を「失敗」の画像とした。成功の画像は、最終的に箱へ置けた試行の _pick.jpg から選んだ。
名前 | 元の試行 | 中身 |
|---|---|---|
ok_01 | run_0001_20260710_204830 | 掴めている。ブロックが爪の下に隠れ、赤がわずかしか見えない |
ok_02 | run_0001_20260713_101053 | 掴めている |
ok_03 | run_0001_20260712_115432 | 掴めている |
ok_04 | run_0001_20260713_170039 | 掴めている |
ok_05 | run_0001_20260711_190901 | 掴めている |
ng_01 | run_0001_20260626_213806 | 爪の間が空っぽ |
ng_02 | run_0001_20260628_075611 | 爪が開いたまま、ブロックが爪の間に写っている |
ng_03 | run_0001_20260713_103746 | 爪が開いたまま、ブロックが爪の間に写っている |
ng_04 | run_0001_20260711_121325 | 爪の間に赤がわずかに見える |
ng_05 | run_0001_20260626_183828 | 爪の間が空っぽ |
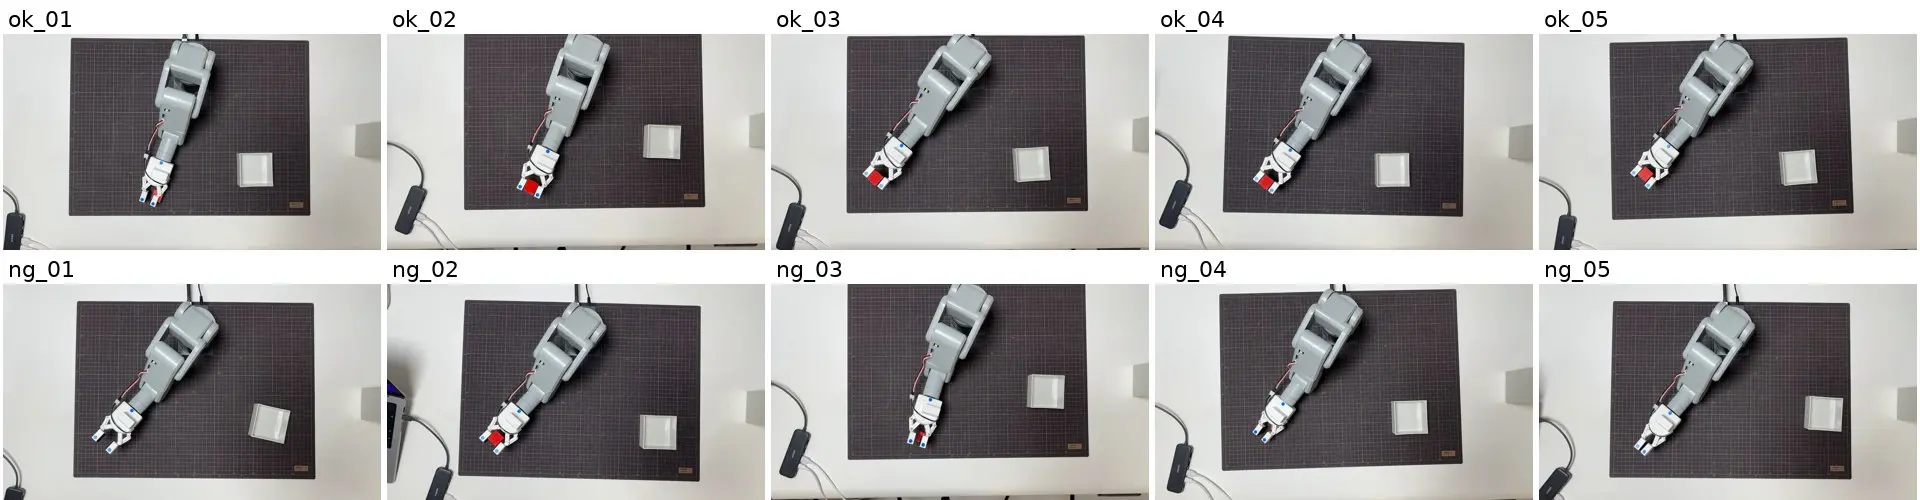
テスト画像10枚。上段が掴めた5枚(ok_01〜05)、下段が1回目に失敗した5枚(ng_01〜05)
元の写真は1920×1080画素で、グリッパーは画面のごく一部にしか写っていない。そこで、爪の先と手首に貼ってある青い丸シールを目印に、グリッパーの周りだけを切り抜いた版も作った(切り抜きのコードは後の「コード(全量)」の節に載せた)。
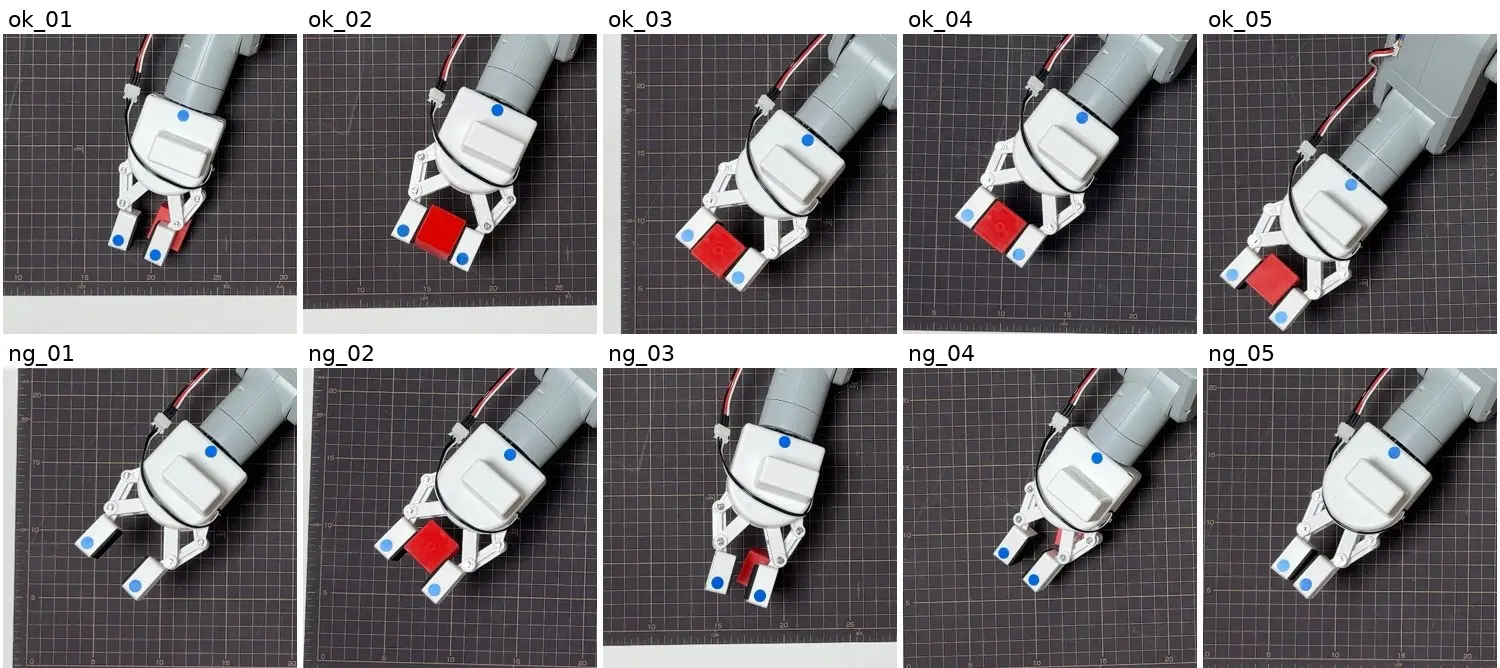
グリッパー周辺を切り抜いた10枚。上段が ok、下段が ng
既存の判定ログには、理由文と結果が食い違う記録が8件中7件あった
テスト画像を選ぶ途中で、既存の判定の記録を読んだ。telemetry.jsonl の verdict.pick には、画像を読む AI(記録上は claude-sonnet-4-6)が出した「掴めたか」の結果、理由文、確信度(0.82 など)が残っている。
ところが、結果が「失敗」の記録8件のうち7件は、理由文に「グリッパーの爪の間に赤ブロックが挟まれており」と、掴めている内容が書かれていた。run_0001_20260712_190312 の写真を開くと、実際に掴めている。
後で全件を読んで分かったが、これは判定 AI の誤りではなかった。AI が「掴めた」と答えた後に、ブロックとグリッパーの距離を計算する別のチェックが結果を「失敗」に書き換えていた(記録上は dist_override: True)。このため、既存の「失敗」ラベルをそのまま正解として使うと、正解自体がずれる。テスト画像は、写真を目で見て中身を確かめたうえで選んだ。
v1:日本語の「しっかり挟んでいる」は、掴めている画像にも低い確率を返した
10枚を自動で判定するスクリプト(v1)を書き、Mac のターミナルで実行した。判定はクラウド上で行われるので、API キー(OpenAI のサービスを呼ぶための鍵)を環境変数に入れてから動かす。指示文は Playground と同じ日本語、質問の種類は predicate、確率が50%以上なら「掴めている」と数えた。
画像 | 正解 | 元画像の確率 | 元画像の処理時間 | 切り抜きの確率 | 切り抜きの処理時間 |
|---|---|---|---|---|---|
ng_01 | 失敗 | 0% | 2944ms | 0% | 369ms |
ng_02 | 失敗 | 2% | 938ms | 34% | 542ms |
ng_03 | 失敗 | 20% | 1398ms | 11% | 507ms |
ng_04 | 失敗 | 0% | 691ms | 1% | 387ms |
ng_05 | 失敗 | 0% | 870ms | 0% | 444ms |
ok_01 | 成功 | 2% | 692ms | 15% | 445ms |
ok_02 | 成功 | 85% | 715ms | 27% | 861ms |
ok_03 | 成功 | 10% | 908ms | 20% | 455ms |
ok_04 | 成功 | 39% | 647ms | 53% | 369ms |
ok_05 | 成功 | 3% | 664ms | 9% | 425ms |
正解数は元画像・切り抜きともに10枚中6枚だった。ただしこの6枚は、失敗の5枚を全部当てて、成功の5枚をほとんど外した結果になる。見分けられているのではなく、ほぼ全部に「いいえ」と答えている。
原因は、指示文の「しっかり挟んでいる」にあると考えた。真上からの写真では挟み具合(力の入り方)は写らない。写っていないことを聞かれたモデルが、慎重に「いいえ」寄りに答えていた。
処理時間は、切り抜き(平均480ms)のほうが元画像(平均1,047ms)より短かった。小さい画像のほうが速い。元画像の最初の1枚(ng_01)だけが2,944msと長く、残りは1,398ms以下だった。
v2:英語で「指先の間に赤いブロックが見えるか」と聞くと0%か100%に分かれた
v2 では、1回の問い合わせに3つの質問を並べた。Decisions API は1回で複数の質問を受け付けるので、同じ画像に対する聞き方の違いを1回の実行で比べられる。
質問 | 種類 | 指示文の要点 |
|---|---|---|
A | predicate | v1 と同じ日本語(比べるための基準) |
B | predicate | 英語。青い丸シールの付いた2つの指先の間に、赤いブロックが見えるか(爪で一部隠れていてもよい)。腕の赤い配線は無視する |
C | choice | 英語の3択。holding(指先の間で掴んでいる)/empty(指先の間に何もない)/missed(ブロックは近くにあるが、爪が開いている・触れていない) |
B は「しっかり」を外し、写真に写っていることだけを聞いた。腕には赤い配線が通っていて、既存の判定でも配線をブロックと見間違えた記録があったので、無視するよう書き添えた。C は、2択だと「いいえ」に偏るなら、3つから選ばせれば偏りが減るかを見るための質問になる。
画像 | 正解 | 元画像 A | 元画像 B | 元画像 C(holding の確率) | 元画像 C の選択 | 切り抜き A | 切り抜き B | 切り抜き C(holding) | 切り抜き C の選択 |
|---|---|---|---|---|---|---|---|---|---|
ng_01 | 失敗 | 0% | 0% | 0% | empty | 0% | 0% | 0% | empty |
ng_02 | 失敗 | 2% | 100% | 96% | holding | 34% | 100% | 95% | holding |
ng_03 | 失敗 | 20% | 100% | 96% | holding | 11% | 100% | 90% | holding |
ng_04 | 失敗 | 0% | 0% | 0% | empty | 1% | 0% | 0% | empty |
ng_05 | 失敗 | 0% | 0% | 0% | empty | 0% | 0% | 0% | empty |
ok_01 | 成功 | 2% | 97% | 39% | empty | 15% | 100% | 95% | holding |
ok_02 | 成功 | 85% | 100% | 100% | holding | 27% | 100% | 96% | holding |
ok_03 | 成功 | 10% | 100% | 91% | holding | 20% | 100% | 99% | holding |
ok_04 | 成功 | 39% | 100% | 99% | holding | 53% | 100% | 96% | holding |
ok_05 | 成功 | 3% | 100% | 100% | holding | 9% | 100% | 76% | holding |
質問 | 元画像の正解数 | 切り抜きの正解数 | |||||||
A(日本語・しっかり) | 6/10 | 6/10 | |||||||
B(英語・見えるか) | 8/10 | 8/10 | |||||||
C(3択) | 7/10 | 8/10 |
B は、ブロックが指先の間にある画像に97〜100%、ない画像に0%を返した。中間の値がほとんど出ていない。「指先の間に赤いブロックがあるか」という、写真に写っていることについては、はっきり答えている。
外れたのは ng_02 と ng_03 の2枚で、B でも C でも同じように外れた。どちらも、爪は開いたままなのに、ブロックが爪と爪の間に写っている写真になる。真上から見ると、爪の間にブロックがあるという点では成功の写真と同じに見える。違いは、ブロックが爪と一緒に持ち上がったか、床に残ったかで、それは真上からの写真には写らない。
C に用意した missed(掴み損ね)は、20回の判定で一度も選ばれなかった。
v3:掴む直前と持ち上げ後の2枚を比べても、ng_02 と ng_03 は見分けられなかった
既存の判定は、1枚目(爪がブロックまで下りた直後の _stage4_pick_tip.jpg)と2枚目(持ち上げた後の _pick.jpg)を並べて渡し、「ブロックが爪と一緒に動いたか」を見ていた。高さが写らないなら、2枚の位置の変化で補えるかもしれない。v3 では同じ2枚を Decisions API に渡した。
テスト10件それぞれについて、2枚の組を images/pairs/ に用意した。
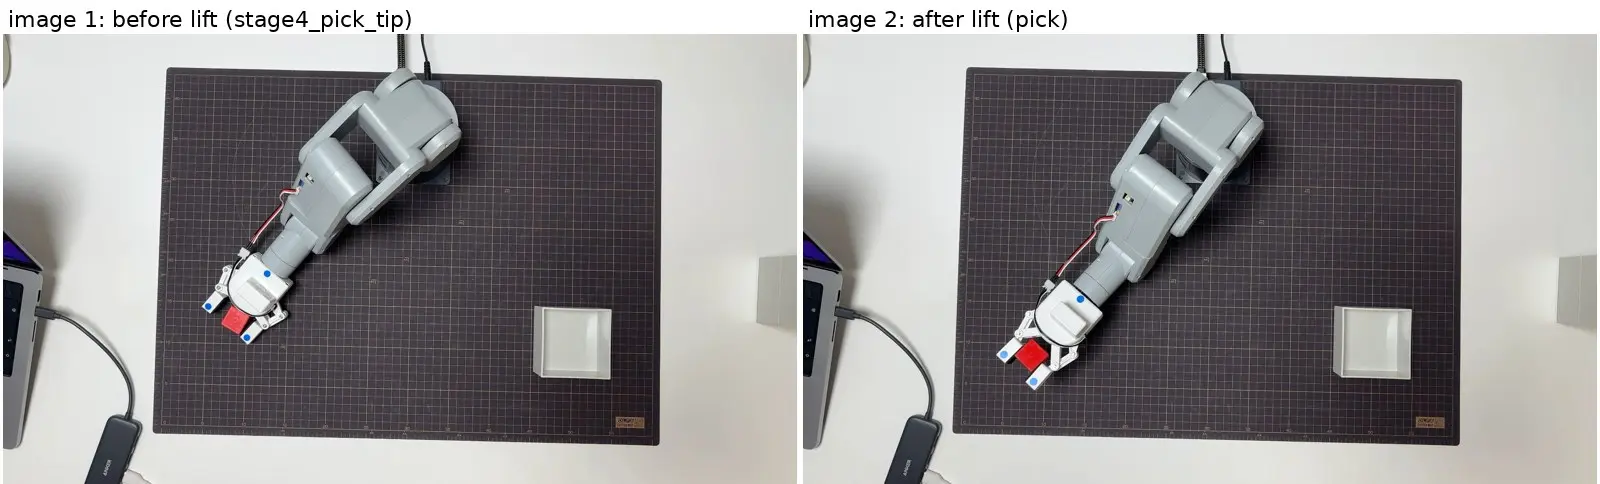
ng_02 の2枚。左が持ち上げる前、右が持ち上げた後。真上からはほとんど同じに見える
組 | 正解 | D(ブロックが爪と一緒に動いたか) | E(picked の確率) | E の選択 | 処理時間 |
|---|---|---|---|---|---|
ng_01 | 失敗 | 0% | 1% | left_behind | 808ms |
ng_02 | 失敗 | 94% | 95% | picked | 752ms |
ng_03 | 失敗 | 94% | 99% | picked | 853ms |
ng_04 | 失敗 | 8% | 44% | picked | 788ms |
ng_05 | 失敗 | 6% | 7% | left_behind | 1051ms |
ok_01 | 成功 | 82% | 77% | picked | 930ms |
ok_02 | 成功 | 95% | 100% | picked | 1344ms |
ok_03 | 成功 | 95% | 99% | picked | 1592ms |
ok_04 | 成功 | 95% | 100% | picked | 1003ms |
ok_05 | 成功 | 95% | 99% | picked | 786ms |
D・E ともに正解は10組中8組で、外れたのはまた ng_02 と ng_03 だった。v1 で2%しか出なかった ok_01 は、2枚比較では82%まで上がった。
ng_03 の telemetry.jsonl で撮影の時刻を確かめた。爪を閉じる指令が10:38:24、持ち上げが10:38:25、_pick.jpg の撮影が10:38:26で、写真は持ち上げた後に撮られている。撮るタイミングは正しい。持ち上げる高さが小さいので、真上から見ると1枚目と2枚目でブロックの位置がほとんど変わらず、「爪と一緒に動いた」と判定されていた。
ng_02・ng_03 は、指示文を3通りに変えても、写真を2枚にしても、同じように外れた。指示文の工夫で届く範囲はここまでで、写真に情報が入っていないことは判定できない、という結論になった。
telemetry の gripper は開度の実測ではなく、開け閉めの指令値だった
v2 の結果を見た時点では、「爪が閉じきったか、ブロックに当たって止まったか」はグリッパーの開度のセンサー値で補えると提案していた。v3 の後で telemetry.jsonl を確認すると、gripper の欄は 0(開け)と 1(閉じろ)の指令値で、実際に爪がどこまで閉じたかを測った値ではなかった。今のログからは、センサー値で補うことはできない。
mechArm には、グリッパーの実際の開度を読み出す get_gripper_value() という関数がある。空振りなら爪は閉じきり、掴めていればブロックの幅で止まるはずなので、これを記録するように変えれば、写真を使わずに判別できる可能性がある。
図解は、v1〜v3 の各質問について、10枚の確率を成功(ok)と失敗(ng)に分けて並べたもの。質問を切り替えると並びが変わり、しきい値(何%以上を「掴めている」とするか)を動かすと、何枚が正解になるかが変わる。B と C と v3 では、どこにしきい値を置いても ng_02 と ng_03 が成功の側に残る。
Decisions API はロボットの制御には使えず、区切りごとの判断に使える
テストの範囲で分かったことを、速度と精度に分けて書く。
項目 | 結果 |
|---|---|
1回の判定にかかる時間 | 画像1枚で0.36〜1.4秒(スクリプトの最初の1回だけ2.9秒)。画像2枚の比較は0.75〜1.6秒。Playground の表示では、これに通信で0.25〜0.54秒が加わる |
写っていることの判定 | 指先の間にブロックがあるか、をほぼ0%か100%で答え分けた |
写っていないことの判定 | 床から持ち上がったか、はどの聞き方でも判定できなかった |
指示文による差 | 同じ ok_01 の写真で、v1 は2%、v2 の B は97%になった |
費用 | 料金表から計算すると、画像20枚の判定で1円未満 |
アームを動かす処理は、何層かに分けて考えると、どこに使えるかがはっきりする。
層 | 必要な速さ | Decisions API | 担い手 |
|---|---|---|---|
制御(関節やモーターを動かす) | 数ミリ秒ごと、カメラの1コマごと | 使えない | 手元のコード(現在のビジュアルサーボ=カメラ映像で位置を合わせながら動かす仕組み) |
認識(物の位置を追う) | 数十ミリ秒 | 向かない | 手元の画像処理(OpenCV の色検出、YOLO などの検出器) |
判断(成功したか、次に何をするか) | 区切りごとに1秒以内 | 使える | Decisions API |
計画・対話(作業の指示、音声) | 数秒以上 | 使える | Responses API、音声の Live API |
毎コマの制御に入れると、1回ごとに1秒近く止まり、その待ち時間も毎回ばらつくので、動きが成り立たない。使えるのは「掴む → 確かめる → 置く」の、確かめるところになる。
使うときの注意点も残しておく。通信が切れると判断が止まるので、つながらないときは「止まって人を呼ぶ」側に倒す作りが前提になる。確率は外れることがある前提で、しきい値を決め、自信が低いときは人に回す。料金は安いが、パブリックベータなので仕様が変わる可能性はある。
AI はテスト済みの動作関数から選ぶだけにして、動きはコードで正確に出す
ここで、設計の方向について問いかけがあった。
ロボットの制御そのままでは使えないので、画像からどのような判断が必要なのかに使って、実際の動作コードを作成してもらい、アームの動きそのものはコードで正確に動かすといった設計が現実的かな?
方向は同じだが、「AI に動作コードを作ってもらう」は、いつ作るかで分けたほうが安全だと返した。開発するときに AI がコードを書き、人が確かめ、実機でテストしてから使うのは、現在の Claude Code での作り方そのままで問題ない。一方、動いている最中に AI がその場でコードを書いて実行すると、毎回違うコードが動くことになり、事前に確かめようがない。LOG83 で、AI に任せたスクリプトがデータを壊した経験がある。
動いている最中の AI の役割は、選ぶことだけにする。
カメラ → Decisions API「今どの状態か?」
          ↓ choice(選択肢は人が事前に決めておく)
   [掴めた] → place()        ← テスト済みの関数
   [空振り] → retry_pick()   ← テスト済みの関数
   [不明]   → stop_and_call_human()
          ↓
   コードが関節の可動範囲と安全チェックを確認して正確に動かす
AI はテスト済みの動作関数から1つを選ぶだけで、動きそのものは作らない。関節の角度が安全な範囲かは、コード側の仕組み(実行ログにある joint_limit_ok や guard_pass)が確かめる。自信が低いときは、必ず「止まって人を呼ぶ」を選ぶ。Decisions API の choice は、この「事前に決めた選択肢から1つ選ぶ」ための機能なので、この作りにそのまま合う。
事前に選択肢を決めておくのは必須そうですね(いろんなパターンを作成するにはデジタル学習などが必要だけど)
選択肢は最初から全部そろえる必要はない、と返した。最初は3〜4個と「その他(人を呼ぶ)」で始め、「その他」に落ちた写真を全部残しておく。たまったら人が見て分け、多いものだけを新しい選択肢にし、そのときに対応する動作関数も作ってテストする。こうすると、選択肢が増える順番が、そのまま本番で実際に起きた失敗の順番になる。
デジタルツイン(実機と同じ配置をシミュレーターの中に作ったもの)が役に立つのは、実機では集めにくい失敗、たとえば落下や衝突、ブロックが倒れる場面を、安全に大量に作るときになる。ただし、シミュレーターの画像と実機の写真は見た目が違うので、判定の最終確認は実機の写真で行う。
そして、素材はすでにある。run_pick_place には、写真と記録付きの試行が残っている。デジタルツインの前に、このログを分けるだけで、実際にどんな失敗が起きていたかの選択肢の最初の案が作れる。それを実際にやった結果が次の節になる。
実機640試行の失敗を20の種類に分けると、画像で見分けるべきものは約4割だった
run_pick_place の記録を全部読んだ。対象は、2026年6月19日から7月20日までに実機で動かした640試行(run_xxxx.json の588件と、初期の pick_then_place_auto の52件)になる。動かさずに計画だけを確かめた dry-run の記録は除いた。
1試行ごとに、どこで何が起きて終わったかを、20の種類(成功2・失敗18)に振り分けた。手がかりにしたのは3つ。試行が止まった理由(abort の段階と理由文)、既存の判定 AI の結果(judgments と pick_attempts)、それに真上のカメラの写真を測った結果になる。手で止めた29試行は数から外し、611試行で集計した。
グループ | 試行数 | 割合 | 中身 |
|---|---|---|---|
成功 | 233 | 38% | 1回目で成功 230、掴み直しで回復 3 |
動かす(目標の姿勢に届かない) | 106 | 17% | 持ち上げ 38、置いた後の退避 23、置き位置 20、把持位置 17、HOME 8 |
置く(箱の外に落ちた) | 98 | 16% | 箱の近くまで運んだが外 59、運ばれず把持位置の近くに残った 39 |
計画(送信前の安全チェックで停止) | 89 | 15% | 届かない位置・関節の可動範囲の外 |
システム | 29 | 5% | 判定 AI の呼び出しエラー 25、制御プログラムに接続できない 4 |
掴む(掴み損ね) | 27 | 4% | 位置ずれ 13、距離チェックで却下 9、判別困難 4、爪の間 1 |
見る(ブロックが見つからない) | 24 | 4% | 開始時に赤ブロックを検出できない |
ハード | 5 | 1% | グリッパーの開け閉めに失敗 |
画像で見分けるべき失敗は「見る・掴む・置く」の149件で、失敗378件の約4割になる。残りの6割は、関節が目標の角度に届かない、届かない位置を安全チェックが止めた、判定 AI の呼び出しが失敗した、といったもので、画像判定を入れても解決しない。関節の角度(エンコーダの値)、動きの計画、運用の問題になる。
赤ブロックと青マーカーの位置を画像から測って、掴み損ねを4種類に分けた
掴み損ねの中身を分けるのに、最初は既存の判定 AI の理由文の言葉で振り分けた。「離れ」「外側」なら位置ずれ、「残」「留ま」なら爪の位置は合っているが床に残った、という分け方になる。ところが「床に残った」に入った写真を並べると、大半はブロックが爪の横にはっきり写っていた。理由文の言葉と写真の中身が合っていなかった。
そこで写真から直接測ることにした。赤い画素がまとまった一番大きな塊を赤ブロック、グリッパーに貼った3つの青い丸シールをグリッパーの位置とし、2つの位置関係で分ける。
赤い判定は、R(赤)が110より大きく、R が G(緑)より60以上、B(青)より40以上大きい画素とした。1画素ずつではなく8画素四方のマス目で数え、マスの4割以上が赤いときだけ赤いマスとする。腕に沿って通っている細い赤い配線は、マスを埋めきれないので数に入らない
青い丸シールも同じように4画素四方のマス目で数え、丸シールくらいの大きさの塊だけを残す。マットの左外に置いてあった本の表紙の青を拾ったことがあったので、画面の左右300画素は除いた
赤ブロックが3つの丸シールの外接矩形の近くにあれば「爪の間」、離れていれば「爪の外」、赤いマスが12個未満で矩形の中にあれば「赤がわずかに見えるだけ」、赤い塊がなければ「写っていない」とした
分け直した結果、掴み1回ごとに数えると、511回の掴みのうち、成功405、位置ずれ(ブロックが爪の外に見える)34、爪の間に赤がわずかに見えるだけ11、爪の間にブロックが見える5、ブロックが写っていない4、判定 AI は成功と答えたが距離チェックで却下27、判定 AI の呼び出しエラー25になった。掴み損ねで一番多いのは、ブロックの横に爪が下りる位置ずれだった。
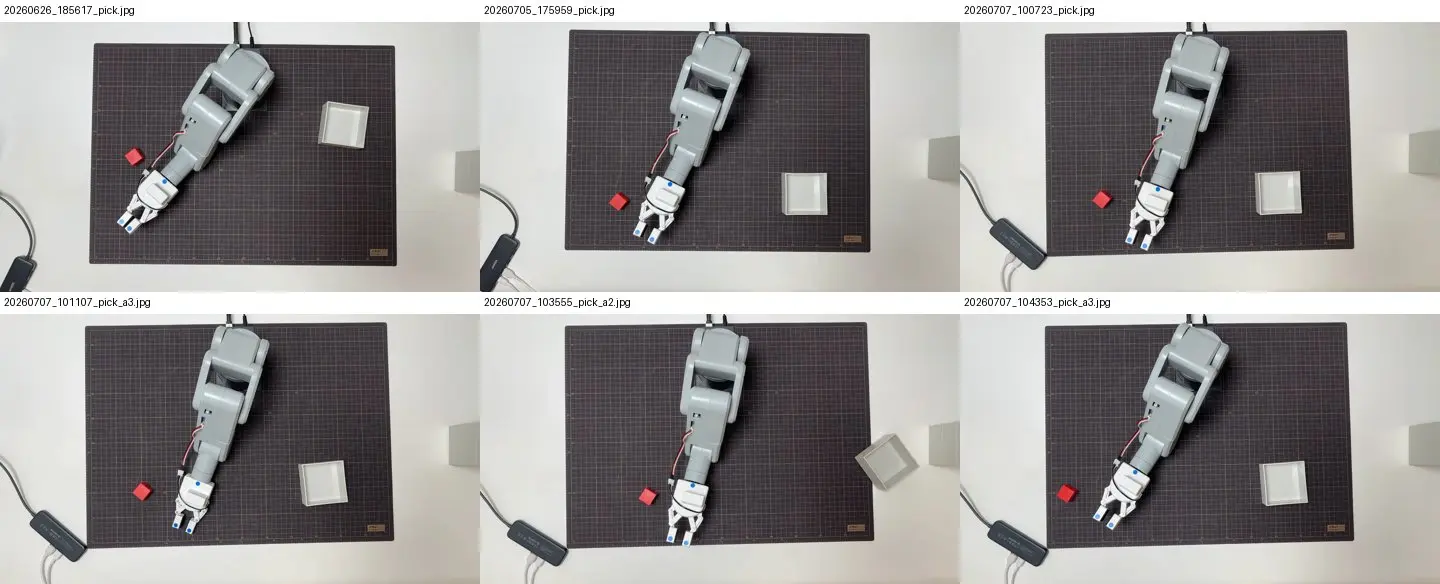
位置ずれ:ブロックが爪の外(横)に写っている
ブロックが写っていない:爪の間が空で、ブロックも見えない
判別困難:爪の間に赤がわずかに見えるだけ
距離チェックで却下された27回の写真は、見る限り爪の間にブロックがあるものが多い。判定 AI の「掴めた」が正しく、距離チェックのしきい値のほうが厳しすぎる可能性がある。
判定 AI は成功、距離チェックで却下された掴み。写真では爪の間にブロックが見えるものが多い
置き失敗98件のうち39件は、ブロックが運ばれていなかった
置き失敗の98件は、どれも「ブロックが箱の外にある」と判定された試行になる。その中身を分けるため、爪がブロックまで下りた直後の写真(_stage4_pick_tip.jpg)と、置いた後の写真(_place.jpg)で、赤ブロックの位置が何画素動いたかを測った。300画素未満なら「運ばれていない」、それ以上なら「運ばれたが箱の外に落ちた」とした。
59件は、箱のすぐそばまで運ばれてから外に落ちていた。置く位置のずれになる。
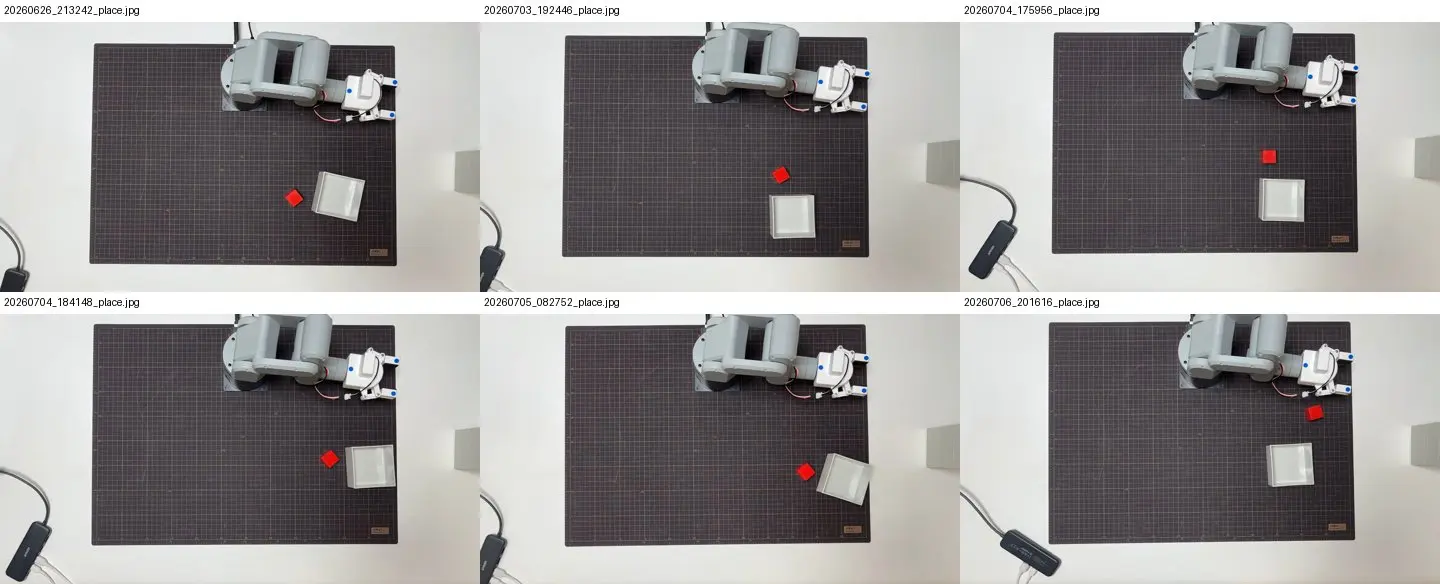
箱の近くまで運ばれたが、外に落ちたブロック
残りの39件は、ブロックがほとんど動いていなかった。掴みの判定は「成功」だったのに、ブロックは掴もうとした場所の近くに残ったまま、アームだけが箱まで行って戻っていた。
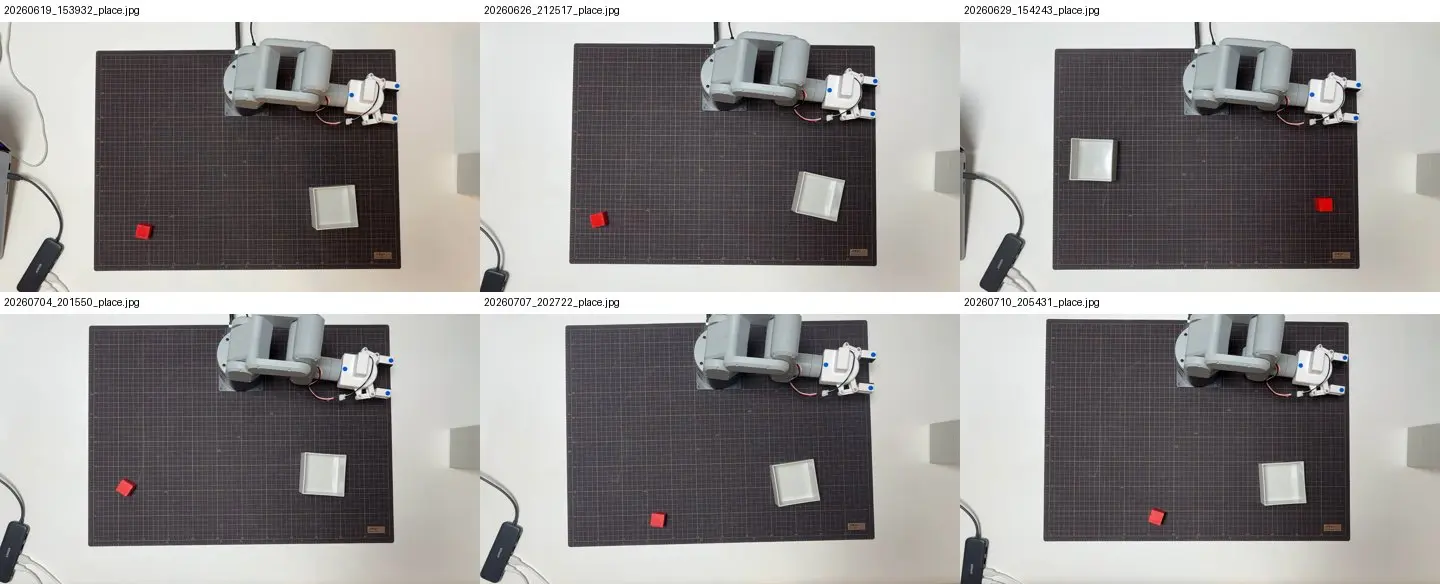
掴めた判定のまま、ブロックが把持位置の近くに残っていた例
これは、v2・v3 で ng_02・ng_03 を見分けられなかったのと同じ問題になる。真上のカメラでは持ち上がったかが写らないので、判定 AI が「掴めた」と答え、実際には持ち上がっていなかった。テストで見つけた弱点が、本番の運用でも39回起きていた。
この39件の中には、人がブロックを手で戻している写真も1枚あった。動かした量の計算だけでは、こうした場面も「運ばれていない」に入る。
横カメラの「失敗」86件は、離す前に撮っていたことによる食い違いだった
集計の途中で、真上のカメラの判定は「箱に入った」なのに、横のカメラの判定は「入っていない」という食い違いが86件あった。86件のうちの1件、run_0001_20260706_080956 の2枚を並べた。
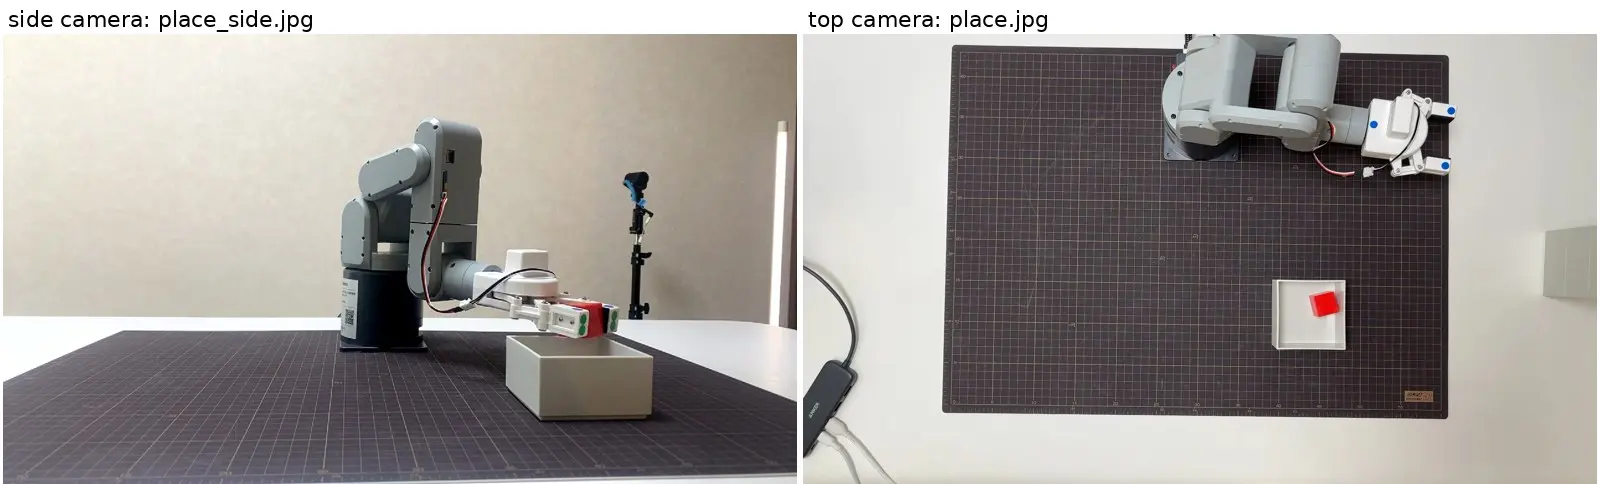
左:横カメラの place_side.jpg。ブロックはまだ爪に挟まれて、箱の縁より上にある。右:真上カメラの place.jpg。ブロックは箱の中にある
横の写真は、ブロックを離す前、爪で挟んだまま箱の上にいる瞬間に撮られていた。横の判定 AI は、写っているとおりに「まだ箱に入っていない」と答えていただけで、失敗ではない。撮るタイミングを離した後に変えれば、この食い違いはなくなる。
同時に、この写真は横のカメラにはブロックの高さがはっきり写ることも示している。爪に挟まれたブロックが、箱の縁より上にあることが一目で分かる。持ち上げた後に横のカメラで1枚撮れば、39件の「運ばれていない」を、その場で見分けられる。
画像判定の選択肢は、開始時・持ち上げ後・置いた後の3か所に置く
640試行の分類をもとに、画像判定に渡す選択肢の最初の案を作った。区切りごとに choice の質問を1つ置き、どれにも当てはまらないときや自信が低いときは、止まって人を呼ぶ。
① 開始時(真上カメラ) — 根拠:見る 24件
選択肢 | 中身 | 次の動き |
|---|---|---|
| 赤ブロックがマットの上に見える | 掴みに行く |
| 見えない | 人を呼ぶ |
② 持ち上げた後(横カメラを推奨、現状は真上カメラ) — 根拠:掴む 27件、運ばれていない 39件
選択肢 | 中身 | 次の動き |
|---|---|---|
| ブロックが爪に挟まれ、マットから浮いている | 置きに行く |
| ブロックが爪の外(横)に見える | 位置を直して掴み直す |
| 爪が空で、ブロックも見えない | 人を呼ぶ |
| 爪の間に何かあるが、判別できない | 人を呼ぶ |
③ 置いた後(真上カメラ) — 根拠:置く 98件
選択肢 | 中身 | 次の動き |
|---|---|---|
| 箱の中 | 次の試行へ |
| 箱のすぐ外 | 置く位置の補正値を記録する |
| 掴もうとした場所の近くに残っている | ②の判定の誤りとして記録する |
件数は少ないが、作業エリアに人の手が入っている写真が2枚あった(掴み損ねの1枚と、運ばれていないの1枚)。選択肢の候補として記録しておく。
分類は自動で行ったので、境目の場面では揺れがある。たとえば、ブロックが爪の先に触れているくらいの位置だと、「爪の間」と「爪の外」のどちらに入るかが写真ごとに変わる。種類ごとの一覧画像で中身を目で確かめたが、正確な正解ラベルではなく、選択肢を決めるための目安として使う。
テストと分類のコード(全量)
実行したコードを、データを作った順に載せる。テストのスクリプトは、最初はフォルダの直下に置いて python3 run_decisions.py で実行し、すべての判定が終わった後にフォルダを整理して scripts/ へ移した。載せているのは、移した後の場所に合わせて読み込み先と保存先を直した版になる。判定の処理そのものは、実行したときと同じ。
切り抜き画像を作るコード(青い丸シールを目印にグリッパー周辺を切り出す)
python
from PIL import Image
import numpy as np, glob, os
for f in sorted(glob.glob('*.jpg')):
    im=Image.open(f).convert('RGB'); a=np.asarray(im).astype(int)
    r,g,b=a[...,0],a[...,1],a[...,2]
    m=(b>170)&(r<90)&(g>60)&(g<170)&(b-r>110)
    ys,xs=np.nonzero(m)
    if len(xs)<50: print(f,'no markers'); continue
    cx,cy=(xs.min()+xs.max())//2,(ys.min()+ys.max())//2
    half=max(xs.max()-xs.min(),ys.max()-ys.min())//2+90
    half=max(half,220)
    box=(max(cx-half,0),max(cy-half,0),min(cx+half,im.width),min(cy+half,im.height))
    im.crop(box).save('crop/'+f, quality=95)
    print(f,box)
2枚比較用の画像の組を作るコマンド
bash
cd "$HOME/mnt/r2r2r-data/runs" && out=experiments/decisions_test/pairs && mkdir -p $out && for f in experiments/decisions_test/*.jpg; do n=$(basename $f .jpg); r=${n#*_*_}; d=run_pick_place/run_0001_$r; cp $d/run_0001_${r}_stage4_pick_tip.jpg $out/${n}_1before.jpg && cp $d/run_0001_${r}_pick.jpg $out/${n}_2after.jpg || echo "missing $r"; done; ls $out | head -30scripts/run_decisions_v1.py(日本語の指示文1つで判定)
python
#!/usr/bin/env python3
"""Decisions API で decisions_test の画像を一括判定する。
使い方: export OPENAI_API_KEY=sk-... のあと  python3 scripts/run_decisions_v1.py
元画像と crop/ の両方を判定し、結果を results/results_v1.csv に保存する。"""
import base64, csv, json, os, sys, time, urllib.request
from pathlib import Path

PROMPT = "グリッパーの爪が閉じていて、赤いブロックを爪の間でしっかり挟んでいる"
KEY = os.environ.get("OPENAI_API_KEY")
if not KEY:
    sys.exit("OPENAI_API_KEY が未設定です: export OPENAI_API_KEY=sk-...")
HERE = Path(__file__).resolve().parent.parent
IMG = HERE / "images"
OUT = HERE / "results"

def decide(img: Path):
    b64 = base64.b64encode(img.read_bytes()).decode()
    body = {
        "model": "gpt-6-luna",
        "input": [{"role": "user", "content": [
            {"type": "input_image", "image_url": f"data:image/jpeg;base64,{b64}"}]}],
        "questions": [{"type": "predicate", "name": "held", "instructions": PROMPT}],
    }
    req = urllib.request.Request("https://api.openai.com/v1/decisions",
        data=json.dumps(body).encode(),
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
    t = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        res = json.load(r)
    ms = int((time.time() - t) * 1000)
    a = res["answers"][0]
    return (a.get("probability") if a["type"] == "predicate" else None), ms

rows = []
for sub in ["full", "crop"]:
    for img in sorted((IMG / sub).glob("*.jpg")):
        if img.name.startswith("._"):
            continue
        try:
            p, ms = decide(img)
        except Exception as e:
            p, ms = None, 0
            print(f"ERROR {img.name}: {e}")
        label = "ok" if img.name.startswith("ok") else "ng"
        ver = sub
        hit = None if p is None else ((p >= 0.5) == (label == "ok"))
        rows.append([ver, img.name, label, p, ms, hit])
        print(f"{ver:4} {img.name:28} 正解={label}  確率={'-' if p is None else f'{p:.0%}':>4}  "
              f"{ms}ms  {'○' if hit else '×' if hit is not None else '-'}")

with open(OUT / "results_v1.csv", "w", newline="") as f:
    w = csv.writer(f); w.writerow(["version", "file", "label", "probability", "ms", "correct"]); w.writerows(rows)
for ver in ["full", "crop"]:
    r = [x for x in rows if x[0] == ver and x[5] is not None]
    if r: print(f"{ver}: 正解 {sum(x[5] for x in r)}/{len(r)}")
print("results/results_v1.csv に保存しました")
scripts/run_decisions_v2.py(指示文3つを1回の問い合わせで比べる)
python
#!/usr/bin/env python3
"""Decisions API: 指示文3パターンを1リクエストで同時に比較する(v2)。
使い方: export OPENAI_API_KEY=sk-... のあと python3 scripts/run_decisions_v2.py
元画像と crop/ を判定し results/results_v2.csv に保存。v1(最初の版)は run_decisions_v1.py。"""
import base64, csv, json, os, sys, time, urllib.request
from pathlib import Path

KEY = os.environ.get("OPENAI_API_KEY") or sys.exit("export OPENAI_API_KEY=sk-... を先に実行してください")
HERE = Path(__file__).resolve().parent.parent
IMG = HERE / "images"
OUT = HERE / "results"

QUESTIONS = [
    # A: 最初の日本語(比較用)
    {"type": "predicate", "name": "A_ja_strict",
     "instructions": "グリッパーの爪が閉じていて、赤いブロックを爪の間でしっかり挟んでいる"},
    # B: 英語・見えるものだけを聞く(「しっかり」を外す、青マーカーを目印に)
    {"type": "predicate", "name": "B_en_visible",
     "instructions": ("Top-down photo of a robot gripper. The two fingertips are marked with blue dots. "
                      "Is a red block visible between the two fingertips (even partly hidden by the fingers)? "
                      "Ignore any red wires on the arm.")},
    # C: 3択で相対比較(「いいえ」への偏りを避ける)
    {"type": "choice", "name": "C_choice",
     "instructions": ("Top-down photo of a robot gripper whose fingertips are marked with blue dots. "
                      "What is the state of the gripper? Ignore red wires on the arm."),
     "choices": [
         {"value": "holding", "description": "A red block is between the fingertips, gripped by the fingers."},
         {"value": "empty", "description": "Nothing is between the fingertips."},
         {"value": "missed", "description": "A red block is near the gripper but the fingers are open around it or not touching it."},
     ]},
]

def decide(img: Path):
    b64 = base64.b64encode(img.read_bytes()).decode()
    body = {"model": "gpt-6-luna",
            "input": [{"role": "user", "content": [
                {"type": "input_image", "image_url": f"data:image/jpeg;base64,{b64}"}]}],
            "questions": QUESTIONS}
    req = urllib.request.Request("https://api.openai.com/v1/decisions", data=json.dumps(body).encode(),
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
    t = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        res = json.load(r)
    ms = int((time.time() - t) * 1000)
    out = {}
    for a in res["answers"]:
        if a["type"] == "predicate":
            out[a["name"]] = a["probability"]
        elif a["type"] == "choice":
            probs = {p["value"]: p["probability"] for p in a.get("probabilities", [])}
            out[a["name"]] = probs.get("holding")
            out["C_pick"] = a["choice"]
        else:
            out[a.get("name", "?")] = None
    return out, ms

names = ["A_ja_strict", "B_en_visible", "C_choice"]
rows = []
print(f"{'ver':4} {'file':28} 正解  {'A':>5} {'B':>5} {'C(hold)':>8} C選択     ms")
for sub in ["full", "crop"]:
    for img in sorted((IMG / sub).glob("*.jpg")):
        if img.name.startswith("._"):
            continue
        label = "ok" if img.name.startswith("ok") else "ng"
        ver = sub
        try:
            o, ms = decide(img)
        except Exception as e:
            print(f"ERROR {img.name}: {e}"); continue
        f = lambda v: "-" if v is None else f"{v:.0%}"
        print(f"{ver:4} {img.name:28} {label}   {f(o.get('A_ja_strict')):>5} {f(o.get('B_en_visible')):>5} "
              f"{f(o.get('C_choice')):>8} {o.get('C_pick',''):8} {ms}")
        rows.append([ver, img.name, label] + [o.get(n) for n in names] + [o.get("C_pick"), ms])

with open(OUT / "results_v2.csv", "w", newline="") as fh:
    w = csv.writer(fh); w.writerow(["version", "file", "label"] + names + ["C_pick", "ms"]); w.writerows(rows)

print("\n--- 閾値50%での正解数 / ok・ngが分離できているか(okの最小値 > ngの最大値なら完全分離) ---")
for ver in ["full", "crop"]:
    for i, n in enumerate(names):
        r = [x for x in rows if x[0] == ver and x[3 + i] is not None]
        if not r: continue
        hit = sum((x[3 + i] >= 0.5) == (x[2] == "ok") for x in r)
        okmin = min(x[3 + i] for x in r if x[2] == "ok"); ngmax = max(x[3 + i] for x in r if x[2] == "ng")
        print(f"{ver:4} {n:13} 正解 {hit}/{len(r)}   ok最小 {okmin:.0%} / ng最大 {ngmax:.0%}  {'完全分離' if okmin > ngmax else '重なりあり'}")
print("results/results_v2.csv に保存しました")
scripts/run_decisions_v3.py(掴む直前と持ち上げ後の2枚を比べる)
python
#!/usr/bin/env python3
"""Decisions API v3: 掴む直前(1枚目)と持ち上げ後(2枚目)の2枚を1リクエストで比較する。
使い方: export OPENAI_API_KEY=sk-... のあと python3 scripts/run_decisions_v3.py
pairs/ の画像を使い results/results_v3.csv に保存。"""
import base64, csv, json, os, sys, time, urllib.request
from pathlib import Path

KEY = os.environ.get("OPENAI_API_KEY") or sys.exit("export OPENAI_API_KEY=sk-... を先に実行してください")
HERE = Path(__file__).resolve().parent.parent
OUT = HERE / "results"
PAIRS = HERE / "images" / "pairs"

CTX = ("Two top-down photos of the same robot arm. Image 1: the gripper has just reached the red block. "
       "Image 2: the arm has tried to lift the block. The gripper fingertips are marked with blue dots. "
       "From the top you cannot see height, so compare the two images. Ignore red wires on the arm.")

QUESTIONS = [
    {"type": "predicate", "name": "D_moved_with",
     "instructions": ("Between image 1 and image 2, did the red block move together with the gripper, "
                      "staying in the same place relative to the fingertips, while the fingers closed on it?")},
    {"type": "choice", "name": "E_outcome",
     "instructions": "What happened in image 2 compared with image 1?",
     "choices": [
         {"value": "picked", "description": "The fingers closed on the red block and it moved with the gripper."},
         {"value": "left_behind", "description": "The red block stayed where it was on the mat; the gripper moved without it or the fingers stayed open."},
         {"value": "no_block", "description": "There is no red block between the fingertips in image 2."},
     ]},
]

def img_part(p: Path):
    return {"type": "input_image", "image_url": "data:image/jpeg;base64," + base64.b64encode(p.read_bytes()).decode()}

def decide(before: Path, after: Path):
    body = {"model": "gpt-6-luna",
            "input": [{"role": "user", "content": [
                {"type": "input_text", "text": CTX},
                {"type": "input_text", "text": "Image 1 (before lift):"}, img_part(before),
                {"type": "input_text", "text": "Image 2 (after lift):"}, img_part(after)]}],
            "questions": QUESTIONS}
    req = urllib.request.Request("https://api.openai.com/v1/decisions", data=json.dumps(body).encode(),
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
    t = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        res = json.load(r)
    ms = int((time.time() - t) * 1000)
    out = {}
    for a in res["answers"]:
        if a["type"] == "predicate":
            out["D"] = a["probability"]
        elif a["type"] == "choice":
            out["E"] = {p["value"]: p["probability"] for p in a.get("probabilities", [])}.get("picked")
            out["E_pick"] = a["choice"]
    return out, ms

rows = []
print(f"{'pair':24} 正解  {'D':>5} {'E(picked)':>9} E選択        ms")
for before in sorted(PAIRS.glob("*_1before.jpg")):
    if before.name.startswith("._"): continue
    after = before.with_name(before.name.replace("_1before", "_2after"))
    name = before.name.replace("_1before.jpg", "")
    label = "ok" if name.startswith("ok") else "ng"
    try:
        o, ms = decide(before, after)
    except Exception as e:
        print(f"ERROR {name}: {e}"); continue
    f = lambda v: "-" if v is None else f"{v:.0%}"
    print(f"{name:24} {label}   {f(o.get('D')):>5} {f(o.get('E')):>9} {o.get('E_pick',''):12} {ms}")
    rows.append([name, label, o.get("D"), o.get("E"), o.get("E_pick"), ms])

with open(OUT / "results_v3.csv", "w", newline="") as fh:
    w = csv.writer(fh); w.writerow(["pair", "label", "D_moved_with", "E_picked", "E_pick", "ms"]); w.writerows(rows)

print("\n--- 閾値50%での正解数 / 分離 ---")
for i, n in [(2, "D_moved_with"), (3, "E_picked")]:
    r = [x for x in rows if x[i] is not None]
    if not r: continue
    hit = sum((x[i] >= 0.5) == (x[1] == "ok") for x in r)
    okmin = min(x[i] for x in r if x[1] == "ok"); ngmax = max(x[i] for x in r if x[1] == "ng")
    print(f"{n:13} 正解 {hit}/{len(r)}   ok最小 {okmin:.0%} / ng最大 {ngmax:.0%}  {'完全分離' if okmin > ngmax else '重なりあり'}")
print("results/results_v3.csv に保存しました")
scripts/image_features.py(赤ブロックと青い丸シールの位置を写真から測る)
python
"""上カメラ画像から赤ブロックと青マーカー(グリッパー)の位置を測る。numpy と Pillow のみ使用。"""
import numpy as np
from PIL import Image

CELL = 8  # 8px 単位のマス目で判定(細い赤配線を除外するため)

def _clusters(grid):
    h, w = grid.shape; seen = np.zeros_like(grid, bool); out = []
    for y, x in zip(*np.nonzero(grid)):
        if seen[y, x]: continue
        stack = [(y, x)]; seen[y, x] = True; pts = []
        while stack:
            cy, cx = stack.pop(); pts.append((cy, cx))
            for ny, nx in ((cy+1,cx),(cy-1,cx),(cy,cx+1),(cy,cx-1)):
                if 0 <= ny < h and 0 <= nx < w and grid[ny, nx] and not seen[ny, nx]:
                    seen[ny, nx] = True; stack.append((ny, nx))
        out.append(pts)
    return out

def _load(path):
    a = np.asarray(Image.open(path).convert("RGB")).astype(np.int16)
    return a[..., 0], a[..., 1], a[..., 2]

def red_block(path):
    """最大の赤い塊の中心 (x, y) とマス数(8px単位)。見つからなければ None。"""
    r, g, b = _load(path)
    m = (r > 110) & (r - g > 60) & (r - b > 40)
    H, W = m.shape; h, w = H // CELL, W // CELL
    dens = m[:h*CELL, :w*CELL].reshape(h, CELL, w, CELL).mean(axis=(1, 3))
    cl = _clusters(dens > 0.4)
    if not cl: return None
    big = max(cl, key=len)
    if len(big) < 4: return None
    ys, xs = zip(*big)
    return (float(np.mean(xs) * CELL + CELL / 2), float(np.mean(ys) * CELL + CELL / 2), len(big))

def blue_markers_box(path):
    """グリッパー上の青マーカー(丸シール3つ)の外接矩形 (x0, y0, x1, y1)。見つからなければ None。"""
    r, g, b = _load(path)
    m = (b > 150) & (b - r > 90) & (b - g > 30)
    C = 4; H, W = m.shape; h, w = H // C, W // C
    dens = m[:h*C, :w*C].reshape(h, C, w, C).mean(axis=(1, 3))
    dots = []
    for c in _clusters(dens > 0.4):
        if 3 <= len(c) <= 60:                      # 丸シール程度の大きさだけ残す
            ys, xs = zip(*c); x, y = np.mean(xs) * C, np.mean(ys) * C
            if 300 <= x <= W - 300:                # マット外(左右端の本や小物)を除外
                dots.append((x, y))
    if not dots: return None
    if len(dots) > 3:                              # グリッパーらしい3点(間隔80〜400px)で最もまとまった組
        import itertools
        def spread(t): return max(((a[0]-b[0])**2 + (a[1]-b[1])**2) ** 0.5 for a, b in itertools.combinations(t, 2))
        cands = [t for t in itertools.combinations(dots, 3) if 80 <= spread(t) <= 400]
        if not cands: return None
        dots = list(min(cands, key=spread))
    xs = [d[0] for d in dots]; ys = [d[1] for d in dots]
    return (int(min(xs)), int(min(ys)), int(max(xs)), int(max(ys)))

def block_vs_gripper(path):
    """赤ブロックとグリッパーの位置関係: 'between'(爪の間)/ 'outside'(爪の外)/ 'not_visible'(写っていない)/ 'no_gripper'"""
    rb = red_block(path); bb = blue_markers_box(path)
    if bb is None: return "no_gripper", rb, bb
    if rb is None: return "not_visible", rb, bb
    size = max(bb[2] - bb[0], bb[3] - bb[1], 120)
    cx, cy = (bb[0] + bb[2]) / 2, (bb[1] + bb[3]) / 2
    # グリッパー中心から赤ブロックまでの距離(マーカー群の大きさで正規化)
    d = ((rb[0] - cx) ** 2 + (rb[1] - cy) ** 2) ** 0.5 / size
    inside = bb[0] - 0.15*size <= rb[0] <= bb[2] + 0.15*size and bb[1] - 0.15*size <= rb[1] <= bb[3] + 0.15*size
    if rb[2] < 12:
        return ("partial" if inside else "not_visible"), rb, bb
    return ("between" if inside and d < 0.75 else "outside"), rb, bb

def block_shift_px(path_before, path_after):
    """2枚の上カメラ画像で赤ブロックが何px動いたか。判定不能なら None。"""
    a, b = red_block(path_before), red_block(path_after)
    if not a or not b or a[2] < 12 or b[2] < 12: return None
    return ((a[0]-b[0])**2 + (a[1]-b[1])**2) ** 0.5
scripts/classify_runs.py(640試行を失敗の種類に分ける)
python
#!/usr/bin/env python3
"""run_pick_place の実行ログを読み、試行ごとの結果を「失敗の種類」に分類する。
元データは読むだけで変更しない。
使い方: failure_taxonomy フォルダで  python3 scripts/classify_runs.py
出力: data/trials.csv(試行ごと), data/pick_attempts.csv(掴み1回ごと), data/summary.json,
      samples/<種類>/ に代表画像のコピーと一覧画像 _overview.jpg
分類の根拠: 停止理由(abort)・旧判定AIの結果(judgments / pick_attempts)・上カメラ画像の実測
           (赤ブロックと青マーカーの位置関係、置き前後のブロック移動量)。
"""
import csv, glob, json, shutil, collections, sys
sys.dont_write_bytecode = True
from pathlib import Path
sys.path.insert(0, str(Path(__file__).resolve().parent))
import image_features as F

HERE = Path(__file__).resolve().parent.parent
SRC = HERE.parent.parent / "run_pick_place"
DATA = HERE / "data"; SAMPLES = HERE / "samples"
N_SAMPLES = 6

# id: (名前, 検知の担当, グループ)
CATS = {
    "OK":          ("成功(1回目で掴んで箱に置けた)", "-", "成功"),
    "OK_RETRY":    ("成功(掴み直しで回復)", "-", "成功"),
    "V1_NODETECT": ("赤ブロック未検出(開始時)", "画像判定", "見る"),
    "P1_OUTSIDE":  ("掴み損ね:ブロックが爪の外に見える(位置ずれ)", "画像判定", "掴む"),
    "P2_BETWEEN":  ("掴み損ね判定:ブロックは爪の間に見える(持ち上がらず/判定ミス)", "画像判定+横カメラ/開度", "掴む"),
    "P3_PARTIAL":  ("掴み損ね判定:爪の間に赤がわずかに見えるだけ(判別困難)", "画像判定+横カメラ/開度", "掴む"),
    "P4_NOTVISIBLE": ("掴み損ね:ブロックが写っていない(弾いた・画面外)", "画像判定", "掴む"),
    "P5_DISTNG":   ("判定AIは成功、距離チェックで却下", "幾何チェック", "掴む"),
    "L1_NOT_CARRIED": ("掴めた判定だったが、ブロックは運ばれず把持位置の近くに残った", "画像判定(2枚比較)", "置く"),
    "L3_MISS_BOX": ("箱の近くまで運んだが外に落ちた", "画像判定", "置く"),
    "L0_OUTSIDE":  ("箱の外(位置を測れず)", "画像判定", "置く"),
    "M1_HOME":     ("HOME姿勢への到達失敗", "動作(エンコーダ)", "動かす"),
    "M2_REACH_PICK": ("把持位置への到達失敗", "動作(エンコーダ)", "動かす"),
    "M3_LIFT":     ("持ち上げ姿勢への到達失敗", "動作(エンコーダ)", "動かす"),
    "M4_REACH_PLACE": ("置き位置への到達失敗", "動作(エンコーダ)", "動かす"),
    "M5_RETREAT":  ("置いた後の退避失敗", "動作(エンコーダ)", "動かす"),
    "G1_GUARD":    ("送信前ガードで停止(届かない位置・関節リミット)", "計画ガード", "計画"),
    "H1_GRIPPER":  ("グリッパー開閉失敗", "ハード", "ハード"),
    "S1_JUDGE_ERR": ("判定AIの呼び出し失敗(API エラー等)", "システム", "システム"),
    "S2_DAEMON":   ("ロボット制御デーモンに接続できない", "システム", "システム"),
    "X_MANUAL":    ("手動中断(集計対象外)", "-", "対象外"),
    "U_UNKNOWN":   ("分類不能", "-", "対象外"),
}
PICK_MISS = {"outside": "P1_OUTSIDE", "between": "P2_BETWEEN", "partial": "P3_PARTIAL", "not_visible": "P4_NOTVISIBLE"}

def img(d, stem, kind, k=1):
    p = d / (f"{stem}_{kind}.jpg" if k == 1 else f"{stem}_{kind}_a{k}.jpg")
    return p if p.exists() else None

def text_pick_type(reason):
    r = reason or ""
    if any(k in r for k in ["存在しない", "見当たらない", "何も掴んで"]): return "P4_NOTVISIBLE"
    if any(k in r for k in ["離れ", "外側", "単独", "隣", "横に"]): return "P1_OUTSIDE"
    return "P2_BETWEEN"

def pick_attempt_type(a, image):
    v = a.get("verdict")
    if v == "yes": return "OK", ""
    if v == "unknown": return "S1_JUDGE_ERR", ""
    if a.get("vlm_verdict") == "yes": return "P5_DISTNG", (F.block_vs_gripper(image)[0] if image else "")
    if image:
        rel = F.block_vs_gripper(image)[0]
        if rel in PICK_MISS: return PICK_MISS[rel], rel
    return text_pick_type(a.get("reason")), "text"

def classify_run(j, d, stem, att_types):
    ab = j.get("abort") or {}; ast, ar = str(ab.get("stage", "")), str(ab.get("reason", ""))
    att = j.get("pick_attempts") or []; jud = j.get("judgments") or {}; place = jud.get("place") or {}
    flags, image, extra = [], None, ""
    for s in j.get("stage_failures") or []:
        if s.get("kind") == "not_reached": flags.append(f"非致命の到達誤差:{s.get('label')}")
    if place.get("verdict") == "yes" and (jud.get("place_side") or {}).get("verdict") == "no":
        flags.append("上カメラ成功・横カメラ失敗の食い違い")

    if "daemon ping" in ar: return "S2_DAEMON", flags, None, ""
    if "KeyboardInterrupt" in ar: return "X_MANUAL", flags, None, ""
    if ast == "1" or "HOME 到達失敗" in ar: return "M1_HOME", flags, None, ""
    if ast == "2" and "未検出" in ar: return "V1_NODETECT", flags, None, ""
    if "ガード" in ar and ast in ("3", "4"): return "G1_GUARD", flags, None, ""
    if "到達失敗" in ar and ast in ("3", "4"): return "M2_REACH_PICK", flags, None, ""
    if "グリッパー" in ar or any(s.get("kind") == "gripper_close_fail" for s in j.get("stage_failures") or []):
        return "H1_GRIPPER", flags, None, ""
    if att and not any(a.get("verdict") == "yes" for a in att):
        k = len(att); t, extra = att_types[-1]
        return t, flags, img(d, stem, "pick", k), extra
    kok = next((i for i, a in enumerate(att, 1) if a.get("verdict") == "yes"), 1)
    if ast == "6" or "LIFT" in ar: return "M3_LIFT", flags, img(d, stem, "pick", kok), ""
    if "ガード" in ar and ast in ("7", "8"): return "G1_GUARD", flags, None, ""
    if "到達失敗" in ar and ast in ("7", "8"): return "M4_REACH_PLACE", flags, None, ""
    pv = place.get("verdict"); pimg = img(d, stem, "place")
    if pv == "no":
        tip = img(d, stem, "stage4_pick_tip", kok)
        shift = F.block_shift_px(tip, pimg) if (tip and pimg) else None
        if shift is None: return "L0_OUTSIDE", flags, pimg, ""
        extra = f"ブロック移動量 {shift:.0f}px"
        if shift < 300: return "L1_NOT_CARRIED", flags, pimg, extra
        return "L3_MISS_BOX", flags, pimg, extra
    if pv == "unknown":
        return ("M5_RETREAT" if "swept_retreat" in str(place.get("reason")) else "S1_JUDGE_ERR"), flags, None, ""
    if pv == "yes":
        if ast == "10": flags.append("置いた後の戻り到達失敗")
        return ("OK_RETRY" if kok > 1 else "OK"), flags, pimg, ""
    if j.get("result") == "pick_failed": return "S1_JUDGE_ERR", flags, None, ""
    return "U_UNKNOWN", flags, None, ""

def classify_ptp(j):
    at, reason, note = j.get("aborted_at"), j.get("abort_reason"), j.get("note")
    if reason == "KeyboardInterrupt": return "X_MANUAL"
    if at == "lift": return "M3_LIFT"
    if at == "relay_pre_place": return "M4_REACH_PLACE"
    if at == "home_pre": return "M1_HOME"
    if at == "auto_select": return "G1_GUARD"
    if note == "full_cycle_done":
        pj = j.get("place_judgment") or {}
        return "L0_OUTSIDE" if isinstance(pj, dict) and pj.get("verdict") == "no" else "OK"
    return "U_UNKNOWN"

trials, attempts = [], []
for f in sorted(glob.glob(str(SRC / "run_*/run_*.json"))):
    try: j = json.load(open(f))
    except Exception: continue
    if j.get("dry_run"): continue
    d, stem = Path(f).parent, Path(f).stem
    att = j.get("pick_attempts") or []; att_types = []
    for i, a in enumerate(att, 1):
        im = img(d, stem, "pick", i); t, how = pick_attempt_type(a, im); att_types.append((t, how))
        note = "赤い配線の誤認の可能性" if a.get("verdict") == "no" and any(w in (a.get("reason") or "") for w in ["ワイヤー", "配線"]) else ""
        attempts.append(dict(trial=stem, attempt=i, verdict=a.get("verdict"), vlm_verdict=a.get("vlm_verdict"),
                             type=t, name=CATS[t][0], image_relation=how, note=note,
                             reason=a.get("reason", ""), image=str(im) if im else ""))
    cat, flags, image, extra = classify_run(j, d, stem, att_types)
    trials.append(dict(source="run_pick_place", trial=stem, started=j.get("started_at", "")[:19], category=cat,
                       group=CATS[cat][2], name=CATS[cat][0], detector=CATS[cat][1], n_pick_attempts=len(att),
                       abort=f"{(j.get('abort') or {}).get('stage','')}:{(j.get('abort') or {}).get('reason','')}".strip(":"),
                       detail=extra, flags=" / ".join(flags), image=str(image) if image else ""))
for f in sorted(glob.glob(str(SRC / "pick_then_place_auto_*/*.json"))):
    try: j = json.load(open(f))
    except Exception: continue
    if j.get("dry_run"): continue
    cat = classify_ptp(j)
    trials.append(dict(source="pick_then_place_auto", trial=f"{Path(f).parent.name}/{Path(f).stem}",
                       started=str(j.get("timestamp", ""))[:19], category=cat, group=CATS[cat][2], name=CATS[cat][0],
                       detector=CATS[cat][1], n_pick_attempts="",
                       abort=f"{j.get('aborted_at') or ''}:{j.get('abort_reason') or ''}".strip(":"),
                       detail="", flags="", image=""))

DATA.mkdir(exist_ok=True)
for name, rows in [("trials.csv", trials), ("pick_attempts.csv", attempts)]:
    with open(DATA / name, "w", newline="", encoding="utf-8-sig") as fh:
        w = csv.DictWriter(fh, fieldnames=list(rows[0].keys())); w.writeheader(); w.writerows(rows)

cnt = collections.Counter(t["category"] for t in trials)
acnt = collections.Counter(a["type"] for a in attempts)
fl = collections.Counter(x for t in trials for x in t["flags"].split(" / ") if x)
json.dump({"trials_total": len(trials), "excluded_manual": cnt.get("X_MANUAL", 0),
           "by_category": {k: {"name": v[0], "detector": v[1], "group": v[2], "trials": cnt.get(k, 0),
                               "pick_attempts": acnt.get(k, 0)} for k, v in CATS.items()},
           "flags": dict(fl.most_common())},
          open(DATA / "summary.json", "w"), ensure_ascii=False, indent=2)

# 代表画像: 画像で見分ける種類だけ。掴み系は「掴み1回ごと」から選ぶ
SAMPLES.mkdir(exist_ok=True)
from PIL import Image, ImageDraw
for k in ["OK", "P1_OUTSIDE", "P2_BETWEEN", "P3_PARTIAL", "P4_NOTVISIBLE", "P5_DISTNG", "L1_NOT_CARRIED", "L3_MISS_BOX"]:
    src = [a for a in attempts if a["type"] == k and a["image"]] if k.startswith("P") else \
          [t for t in trials if t["category"] == k and t["image"]]
    if not src: continue
    out = SAMPLES / k; out.mkdir(exist_ok=True)
    step = max(1, len(src) // N_SAMPLES); chosen = src[::step][:N_SAMPLES]
    for r in chosen: shutil.copy2(r["image"], out / Path(r["image"]).name)
    W, H, cols = 480, 270, 3; rows_ = (len(chosen) + cols - 1) // cols
    sheet = Image.new("RGB", (W * cols, (H + 22) * rows_), "white"); dr = ImageDraw.Draw(sheet)
    for i, r in enumerate(chosen):
        x, y = (i % cols) * W, (i // cols) * (H + 22)
        sheet.paste(Image.open(r["image"]).convert("RGB").resize((W, H)), (x, y + 22))
        dr.text((x + 4, y + 4), Path(r["image"]).name.replace("run_0001_", ""), fill="black")
    sheet.save(out / "_overview.jpg", quality=85)

for k, v in CATS.items():
    print(f"{k:15} 試行 {cnt.get(k,0):4}  掴み回 {acnt.get(k,0):4}  {v[0]}")
print("flags:", dict(fl.most_common(6)))
実行ログ(全量)
切り抜き画像を作ったときの出力(切り抜いた範囲の座標)
ng_01_20260626_213806.jpg (np.int64(343), np.int64(510), np.int64(783), np.int64(950))
ng_02_20260628_075611.jpg (np.int64(361), np.int64(509), np.int64(801), np.int64(949))
ng_03_20260713_103746.jpg (np.int64(538), np.int64(470), np.int64(978), np.int64(910))
ng_04_20260711_121325.jpg (np.int64(360), np.int64(468), np.int64(800), np.int64(908))
ng_05_20260626_183828.jpg (np.int64(380), np.int64(521), np.int64(820), np.int64(961))
ok_01_20260710_204830.jpg (np.int64(534), np.int64(525), np.int64(974), np.int64(965))
ok_02_20260713_101053.jpg (np.int64(526), np.int64(475), np.int64(966), np.int64(915))
ok_03_20260712_115432.jpg (np.int64(357), np.int64(402), np.int64(797), np.int64(842))
ok_04_20260713_170039.jpg (np.int64(419), np.int64(458), np.int64(859), np.int64(898))
ok_05_20260711_190901.jpg (np.int64(437), np.int64(341), np.int64(877), np.int64(781))
v1 の実行結果
python3 run_decisions.py
full ng_01_20260626_213806.jpg    正解=ng  確率=  0%  2944ms  ○
full ng_02_20260628_075611.jpg    正解=ng  確率=  2%  938ms  ○
full ng_03_20260713_103746.jpg    正解=ng  確率= 20%  1398ms  ○
full ng_04_20260711_121325.jpg    正解=ng  確率=  0%  691ms  ○
full ng_05_20260626_183828.jpg    正解=ng  確率=  0%  870ms  ○
full ok_01_20260710_204830.jpg    正解=ok  確率=  2%  692ms  ×
full ok_02_20260713_101053.jpg    正解=ok  確率= 85%  715ms  ○
full ok_03_20260712_115432.jpg    正解=ok  確率= 10%  908ms  ×
full ok_04_20260713_170039.jpg    正解=ok  確率= 39%  647ms  ×
full ok_05_20260711_190901.jpg    正解=ok  確率=  3%  664ms  ×
crop ng_01_20260626_213806.jpg    正解=ng  確率=  0%  369ms  ○
crop ng_02_20260628_075611.jpg    正解=ng  確率= 34%  542ms  ○
crop ng_03_20260713_103746.jpg    正解=ng  確率= 11%  507ms  ○
crop ng_04_20260711_121325.jpg    正解=ng  確率=  1%  387ms  ○
crop ng_05_20260626_183828.jpg    正解=ng  確率=  0%  444ms  ○
crop ok_01_20260710_204830.jpg    正解=ok  確率= 15%  445ms  ×
crop ok_02_20260713_101053.jpg    正解=ok  確率= 27%  861ms  ×
crop ok_03_20260712_115432.jpg    正解=ok  確率= 20%  455ms  ×
crop ok_04_20260713_170039.jpg    正解=ok  確率= 53%  369ms  ○
crop ok_05_20260711_190901.jpg    正解=ok  確率=  9%  425ms  ×
full: 正解 6/10
crop: 正解 6/10
results.csv に保存しました
(base) shimazueiichi@shimadzueiichinoMacBook-Pro decisions_test %
v2 の実行結果
python3 run_decisions.py
ver  file                         正解      A     B  C(hold) C選択     ms
full ng_01_20260626_213806.jpg    ng      0%    0%       0% empty    782
full ng_02_20260628_075611.jpg    ng      2%  100%      96% holding  985
full ng_03_20260713_103746.jpg    ng     20%  100%      96% holding  597
full ng_04_20260711_121325.jpg    ng      0%    0%       0% empty    747
full ng_05_20260626_183828.jpg    ng      0%    0%       0% empty    551
full ok_01_20260710_204830.jpg    ok      2%   97%      39% empty    590
full ok_02_20260713_101053.jpg    ok     85%  100%     100% holding  558
full ok_03_20260712_115432.jpg    ok     10%  100%      91% holding  570
full ok_04_20260713_170039.jpg    ok     39%  100%      99% holding  596
full ok_05_20260711_190901.jpg    ok      3%  100%     100% holding  751
crop ng_01_20260626_213806.jpg    ng      0%    0%       0% empty    535
crop ng_02_20260628_075611.jpg    ng     34%  100%      95% holding  619
crop ng_03_20260713_103746.jpg    ng     11%  100%      90% holding  404
crop ng_04_20260711_121325.jpg    ng      1%    0%       0% empty    363
crop ng_05_20260626_183828.jpg    ng      0%    0%       0% empty    439
crop ok_01_20260710_204830.jpg    ok     15%  100%      95% holding  358
crop ok_02_20260713_101053.jpg    ok     27%  100%      96% holding  397
crop ok_03_20260712_115432.jpg    ok     20%  100%      99% holding  360
crop ok_04_20260713_170039.jpg    ok     53%  100%      96% holding  697
crop ok_05_20260711_190901.jpg    ok      9%  100%      76% holding  507

--- 閾値50%での正解数 / ok・ngが分離できているか(okの最小値 > ngの最大値なら完全分離) ---
full A_ja_strict   正解 6/10   ok最小 2% / ng最大 20%  重なりあり
full B_en_visible  正解 8/10   ok最小 97% / ng最大 100%  重なりあり
full C_choice      正解 7/10   ok最小 39% / ng最大 96%  重なりあり
crop A_ja_strict   正解 6/10   ok最小 9% / ng最大 34%  重なりあり
crop B_en_visible  正解 8/10   ok最小 100% / ng最大 100%  重なりあり
crop C_choice      正解 8/10   ok最小 76% / ng最大 95%  重なりあり
results_v2.csv に保存しました
(base) shimazueiichi@shimadzueiichinoMacBook-Pro decisions_test %
v3 の実行結果
pair                     正解      D E(picked) E選択        ms
ng_01_20260626_213806    ng      0%        1% left_behind  808
ng_02_20260628_075611    ng     94%       95% picked       752
ng_03_20260713_103746    ng     94%       99% picked       853
ng_04_20260711_121325    ng      8%       44% picked       788
ng_05_20260626_183828    ng      6%        7% left_behind  1051
ok_01_20260710_204830    ok     82%       77% picked       930
ok_02_20260713_101053    ok     95%      100% picked       1344
ok_03_20260712_115432    ok     95%       99% picked       1592
ok_04_20260713_170039    ok     95%      100% picked       1003
ok_05_20260711_190901    ok     95%       99% picked       786

--- 閾値50%での正解数 / 分離 ---
D_moved_with  正解 8/10   ok最小 82% / ng最大 94%  重なりあり
E_picked      正解 8/10   ok最小 77% / ng最大 99%  重なりあり
results_v3.csv に保存しました
(base) shimazueiichi@shimadzueiichinoMacBook-Pro decisions_test %
ng_03(run_0001_20260713_103746)の段階ごとの時刻と gripper の値
01:37:47 stage1 gripper= None
01:38:13 stage2 gripper= 0
01:38:19 stage3_approach_pick gripper= 0
01:38:20 stage4_pick gripper= 0
01:38:22 stage4_pick gripper= 0
01:38:24 stage5 gripper= 1
01:38:25 stage6 gripper= 1
01:38:26 stage6 gripper= 1
01:39:00 stage2_redetect gripper= 0
01:39:04 stage3_approach_pick_a2 gripper= 0
01:39:06 stage4_pick_a2 gripper= 0
01:39:07 stage4_pick_a2 gripper= 0
01:39:09 stage5_a2 gripper= 1
01:39:14 stage6_a2 gripper= 1
01:39:16 stage6_a2 gripper= 1
01:39:49 stage2_redetect_a2 gripper= 0
01:39:53 stage3_approach_pick_a3 gripper= 0
01:39:54 stage4_pick_a3 gripper= 0
01:39:55 stage4_pick_a3 gripper= 0
01:39:57 stage5_a3 gripper= 1
01:40:02 stage6_a3 gripper= 1
01:40:03 stage6_a3 gripper= 1
01:40:10 stage7_approach_place gripper= 1
01:40:10 stage7_approach_place gripper= 1
01:40:11 stage8_place gripper= 1
01:40:29 stage8_5_replace_align gripper= 1
01:40:35 stage8_5_replace_align gripper= 1
01:40:49 stage9 gripper= 0
01:40:50 stage9b_judge_place gripper= 0
01:40:52 stage9b_judge_place gripper= 0
01:41:01 stage10 gripper= 0
時刻は作業環境の時計(UTC)で表示されている。日本時間では9時間足した10:37:47〜10:41:01 になる。写真のファイルの更新時刻は、_stage4_pick_tip.jpg が 01:38:22、_pick.jpg が 01:38:26 だった。
640試行の分類の出力
OK              試行  230  掴み回  405  成功(1回目で掴んで箱に置けた)
OK_RETRY        試行    3  掴み回    0  成功(掴み直しで回復)
V1_NODETECT     試行   24  掴み回    0  赤ブロック未検出(開始時)
P1_OUTSIDE      試行   13  掴み回   34  掴み損ね:ブロックが爪の外に見える(位置ずれ)
P2_BETWEEN      試行    1  掴み回    5  掴み損ね判定:ブロックは爪の間に見える(持ち上がらず/判定ミス)
P3_PARTIAL      試行    4  掴み回   11  掴み損ね判定:爪の間に赤がわずかに見えるだけ(判別困難)
P4_NOTVISIBLE   試行    0  掴み回    4  掴み損ね:ブロックが写っていない(弾いた・画面外)
P5_DISTNG       試行    9  掴み回   27  判定AIは成功、距離チェックで却下
L1_NOT_CARRIED  試行   39  掴み回    0  掴めた判定だったが、ブロックは運ばれず把持位置の近くに残った
L3_MISS_BOX     試行   59  掴み回    0  箱の近くまで運んだが外に落ちた
L0_OUTSIDE      試行    0  掴み回    0  箱の外(位置を測れず)
M1_HOME         試行    8  掴み回    0  HOME姿勢への到達失敗
M2_REACH_PICK   試行   17  掴み回    0  把持位置への到達失敗
M3_LIFT         試行   38  掴み回    0  持ち上げ姿勢への到達失敗
M4_REACH_PLACE  試行   20  掴み回    0  置き位置への到達失敗
M5_RETREAT      試行   23  掴み回    0  置いた後の退避失敗
G1_GUARD        試行   89  掴み回    0  送信前ガードで停止(届かない位置・関節リミット)
H1_GRIPPER      試行    5  掴み回    0  グリッパー開閉失敗
S1_JUDGE_ERR    試行   25  掴み回   25  判定AIの呼び出し失敗(API エラー等)
S2_DAEMON       試行    4  掴み回    0  ロボット制御デーモンに接続できない
X_MANUAL        試行   29  掴み回    0  手動中断(集計対象外)
U_UNKNOWN       試行    0  掴み回    0  分類不能
flags: {'非致命の到達誤差:stage6_lift': 97, '上カメラ成功・横カメラ失敗の食い違い': 86, '非致命の到達誤差:stage10_lift_back': 79, '非致命の到達誤差:stage7_approach_place': 44, '非致命の到達誤差:stage4_pick': 31, '非致命の到達誤差:stage10_to_home': 22}
flags は、試行を止めはしなかったが記録に残っていた出来事の数になる。「非致命の到達誤差」は、関節が許容範囲までは届かなかったが、試行は続けた回数。
試行ごとの分類(640行)は data/trials.csv、掴み1回ごとの分類(511行)は data/pick_attempts.csv に残した。同じフォルダで python3 scripts/classify_runs.py を実行すると、同じ結果が作り直される。
実行条件
項目 | 内容 |
|---|---|
実行日 | 2026-10-10 |
API | OpenAI Decisions API(パブリックベータ)、 |
モデル | gpt-6-luna |
実行環境 | Mac のターミナル、Python 標準ライブラリの urllib(OpenAI の SDK は使っていない) |
画像 | 真上カメラの写真 1920×1080画素、JPEG。切り抜き版は約440×440画素 |
しきい値 | 50%以上を「掴めている」として正解数を数えた |
分類の対象 |
|
保存先は、MASTER の保存先テーブルで「実機の単体実験」の置き場所になっている runs/experiments/ の下にした。
/Volumes/KIOXIA/r2r2r-data/runs/experiments/decisions_test/
├── README.md
├── images/
│   ├── full/      元画像10枚
│   ├── crop/      切り抜き10枚
│   └── pairs/     持ち上げ前後の組10組
├── scripts/       run_decisions_v1.py, v2.py, v3.py
└── results/       results_v1.csv, v2.csv, v3.csv

/Volumes/KIOXIA/r2r2r-data/runs/experiments/failure_taxonomy/
├── README.md
├── data/          trials.csv, pick_attempts.csv, summary.json
├── samples/       種類ごとの代表画像と _overview.jpg
└── scripts/       classify_runs.py, image_features.py
参照した資料
OpenAI launches Decisions API with up to 10x faster responses(ProPakistani)
OpenAI answers TypeSafe's Jev with a Decision API built on Luna(The New Stack)
この回で分かったこと
論点 | 分かったこと |
|---|---|
Decisions API の形 | 決めた選択肢から答えを選ぶ専用の API。predicate・choice・score の3種類。画像は base64 で埋め込む |
写っていることの判定 | 「指先の間に赤いブロックがあるか」は、ほぼ0%か100%で答え分けた |
写っていないことの判定 | 「床から持ち上がったか」は、聞き方を3通り変えても、2枚比較でも判定できなかった |
指示文の影響 | 同じ ok_01 の写真で、日本語の「しっかり挟んでいる」は2%、英語の「見えるか」は97% |
速度 | 画像1枚で0.36〜1.4秒(最初の1回は2.9秒)。切り抜いた小さい画像のほうが速い。毎コマの制御には使えない |
使いどころ | 「掴む → 確かめる → 置く」の確かめるところ。AI はテスト済みの関数から選ぶだけにする |
実機640試行の失敗 | 画像で見分けるべき失敗は約4割。残りは到達失敗・安全チェック・システムの問題 |
運ばれていない39件 | 掴めた判定のまま、ブロックが掴もうとした場所に残っていた。テストで見つけた弱点と同じ |
横カメラの食い違い86件 | 離す前に撮っていたための食い違いで、失敗ではない |
既存の判定ログ | 判定 AI の「掴めた」を距離チェックが「失敗」に書き換えた記録が27回ある |
結論の範囲 | テストは10枚、分類は自動。選択肢を決めるための目安として使う |
次は持ち上げ後と離した後に横カメラで撮り、同じスクリプトで判定し直す
次に実機を動かすときに変えることは2つある。
1つ目は、横のカメラで撮るタイミング。いまは箱の上でブロックを挟んだまま撮っているので、ブロックを離した後に変える。あわせて、持ち上げた直後(stage6)にも横から1枚撮る。横からなら、ブロックがマットから浮いているかが写る。真上からは判定できなかった ng_02・ng_03 のような場面を、写っていることを聞く質問に変えられる。
2つ目は、get_gripper_value() でグリッパーの実際の開度を記録すること。空振りなら爪は閉じきり、掴めていればブロックの幅で止まるはずなので、写真を使わずに判別できるかを確かめる。
横カメラの写真が10件ほど集まったら、同じ decisions_test のスクリプトで判定し直す。そこで「持ち上げた後」の選択肢が成り立てば、640試行の分類から作った選択肢の案を、そのまま実機の判定に組み込める。