

画像認識と物体検出を学び直す Log#10 | SAM 3 は透明なガラス瓶とペットボトルを同じ物として切り出した ― 言葉で指定する最新モデルを分別ラインの画像で試す
このシリーズは Log#8 まで、OpenCV の関数と自分で撮った写真だけで進んできた。色で拾う、形を測る、斜めの平面を真上に直す。学習させたモデルは1つも使っていない。Log#9 では、その先に出てくる用語(バックボーン、ゼロショット、オープン語彙、mAP など)の意味を、実装なしで整理した。
この回は、その用語の先にある最新モデルを実際に触る。当初の予定では Log#10 に IoU・Precision・Recall・mAP(検出結果の当たり外れを数字にする指標)を置いていたが、それは Log#11 に送り、ここには「最新モデルに画像を渡すと何が返ってくるか」を見る回を1本差し込んだ。数字での採点はせず、返ってきた画面をそのまま記録する。
触ったのは Meta の SAM 3 1つだけになる。ロボットアームで資源ごみや商品を仕分ける場面を想定して、生成AIに作らせた画像2枚に、9つの言葉を渡した。結果として、缶・ボトル・紙パックといった物の名前では正しく選び分けたが、「ガラス」「プラスチック」「アルミ」「潰れた」といった素材や状態の言葉では選び分けられなかった。透明なガラス瓶と透明なペットボトルは、どちらの言葉で聞いても同じ4本が選ばれた。
最新の画像認識モデルは、何を出力するかで6つに分かれる
触る前に、2026年9月時点でどんなモデルがあるかを調べた。Log#9 で名前を挙げたモデルの多くは、この数か月で更新されている。何を出力するかで分けると、次の6つになる。
出力の種類 | 代表モデル | 何ができるか | 注意点 |
|---|---|---|---|
言葉で指定した物を全部切り出す | SAM 3 / SAM 3.1(Meta) | 「red block」と書くと、該当する物すべてに輪郭(マスク)を付ける | 3.1 は速くした版。精度の変化はベンチマークによって上下がある |
決まった物を速く見つける | YOLO26(Ultralytics)、RF-DETR(Roboflow) | 1枚あたり数ミリ秒で検出する | 自分の物を探させるには学習用データが要る |
言葉で指定して速く見つける | YOLOE-26 | YOLO26 の速さのまま、任意の言葉で検出できる | 細かい区別は苦手 |
画像を見て考えて答える | GPT・Claude・Gemini・Qwen などの汎用 VLM | 枠の座標を返し、状況の説明もできる | 1枚に数秒〜数十秒かかり、1枚ごとに課金される |
ロボットの判断役 | Gemini Robotics ER 2(Google) | 指差し(座標点)、軌跡、作業の成否判定 | 関節を動かす指令は出さない |
写真1枚から距離や3D形状を出す | Depth Anything 3(ByteDance)、SAM 3D(Meta) | メートル単位の深度、物体の3D形状 | メートルに直すにはカメラの焦点距離が要る |
VLM(Vision Language Model)は、画像を見て言葉で答えるモデルのこと。このプロジェクトでは、アームの PICK・PLACE が成功したかどうかを写真から判定させる役(VLM-as-Reward)で既に使っている。
モデルごとの補足を書いておく。
SAM 3 は2025年11月に Meta が公開した。SAM は Segment Anything Model の略で、パラメータ数は約8億4,800万。前の世代の SAM 1・2 は「画面上でクリックした1個」を切り出すものだったが、SAM 3 は短い名詞を言葉で渡すと、画像の中の該当する物を全部見つけて、1個ずつ輪郭を付けて返す。2026年3月27日には、動画で多数の物を追跡するときに速くなる更新版 SAM 3.1 が出た。1台の H100 GPU で128個の物を追跡したときに約7倍速くなったと Meta は報告している。ただし精度は全体が上がったわけではなく、言葉で指定して動画を処理するタスクでは、上がったベンチマークと下がったベンチマークが混在していると公式に書かれている。
Gemini Robotics ER 2 は2026年7月30日に公開プレビューになった。Gemini 3.5 Flash をベースに、空間の推論、動画の中から特定の場面を探す機能、作業の進み具合の判定、複数ロボットの調整が強化されている。旧版の 1.6 は8月31日で提供が終わった。
YOLOE-26 は、YOLO26 を任意の言葉で検出できるように拡張したもの。YOLO26 は COCO(80種類の物を集めた検出の標準データセット)で mAP 40.9〜57.5、1枚あたり 1.7〜11.8 ミリ秒。YOLOE-26 の最大サイズは、1,000種類以上の物を含むデータセット LVIS で AP 40.6 だった。
RF-DETR は、COCO で初めて mAP 60 を超えたリアルタイムモデルとされ、Apache 2.0(商用利用も改変も自由なライセンス)で公開されている。YOLO26 は AGPL-3.0(ネットワーク越しに提供すると自分のコードの公開義務が生じうるライセンス)なので、このライセンスの差が選ぶときの分かれ目になる。
最新モデルを試せるサービスは、ブラウザで済むものと Python で呼ぶものに分かれる
サービス | 触れるモデル | 特徴 |
|---|---|---|
Segment Anything Playground | SAM 3、SAM 3D | Meta 公式のブラウザ画面。画像を上げて言葉を入れるだけ。無料 |
Roboflow Playground | 汎用 VLM と検出器、あわせて81種 | 自分の画像を上げて、複数モデルの結果を並べて比べられる。無料 |
Meta Model API | SAM 3.1 | 2026年9月18日に提供開始。コードから呼べる |
Google AI Studio | Gemini Robotics ER 2 | ブラウザで画像を投げて、指差しや枠を試せる |
Ultralytics(pip) | YOLO26、YOLOE-26、SAM 3 | Python から数行で呼べる |
Moondream Photon | Moondream 3、Qwen 3.5 など | Apple Silicon の Mac でローカル実行できる |
Replicate / fal | Depth Anything 3、SAM 3D など | 1回ごとの従量課金で試せる |
Meta Model API の SAM 3.1 は、2026年9月20日時点で画像1,000枚あたり2.50ドル。いまは言葉での指定しか受け付けず、動画では1フレームあたり16個までしか追跡しない。
手元の Mac で動かす場合には制約がある。SAM 3 を Meta 本家のコードで動かすには、NVIDIA の GPU と CUDA(NVIDIA 製 GPU で計算するための仕組み)が必須になる。Mac では API を使うか、Ultralytics 経由で動かすことになる。
この回は、コードも GPU も要らない Segment Anything Playground だけを使った。
汎用 VLM の検出成績は、採点基準を厳しくすると 82.1% が 59.1% に下がる
「どんな結果をもたらすのか」を知るために、Roboflow が公開している検出ベンチマークも読んだ。汎用 VLM に「この画像の物を全部、枠の座標で答えて」と頼み、正解の枠との重なりで採点したもので、59モデルが並んでいる。そのうち4モデルを取り出したのが次の表になる。数値は推論の深さを低く設定した条件(low)での値で、2026年9月22日更新時点のもの。
モデル | mAP@50 | mAP@75 | mAP@50:95 | 1枚の処理時間 | 1枚の費用 |
|---|---|---|---|---|---|
GPT-6 Astra | 82.1% | 63.8% | 59.1% | 10.96秒 | $0.050 |
Claude Opus 5.5 | 74.4% | 60.2% | 57.2% | 17.55秒 | $0.022 |
Gemini 3.8 Flash | 68.1% | 57.3% | 54.5% | 17.01秒 | $0.0041 |
Claude Opus 4.8 | 38.6% | 13.3% | 16.8% | 8.34秒 | $0.026 |
列の読み方は次のとおり。
mAP@50:予測した枠が正解の枠と半分以上重なれば当たりとする基準
mAP@75:4分の3以上重なれば当たりとする、より厳しい基準
mAP@50:95:重なりの基準を50%から95%まで動かして平均したもの
この表から読めることは3つある。
1つ目。見出しに出ている「82.1%」は、枠が正解と半分重なれば当たりとする基準での値になる。同じ出力を最も厳しい基準で採点し直すと 59.1% になる。Log#9 の最後に「同じ検出結果が、採点基準によって別のスコアになる」と書いたことが、実在の成績表でそのまま起きている。
2つ目。Claude Opus 4.8 は、半分重なれば当たりの基準で 38.6%、4分の3の基準では 13.3% まで落ちる。物のだいたいの場所は分かっていても、枠がゆるいということになる。基準を厳しくしたときの落ち幅を見れば、「場所が分かる」と「枠が正確」を分けて測れる。
3つ目。汎用 VLM は1枚の処理に8〜30秒かかる。YOLO26 は数ミリ秒で終わる。汎用 VLM は、視覚サーボ(カメラで見ながらアームを少しずつ動かす制御)の繰り返しの中には入れられない。PICK・PLACE の成否判定のように、1回の試行につき1回だけ呼ぶ位置が合っている。Roboflow 自身も、まず汎用 VLM や言葉指定の検出器で試して最初の正解データを作り、対象が固まって量が増えたら専用の検出器を学習させる流れが多いと書いている。
Log#10 は採点をせず、SAM 3 が何を返すかを記録する回にした
調べた結果を踏まえて、Log#10 の範囲を次のように決めた。
項目 | 決めたこと |
|---|---|
目的 | 最新モデルに画像を渡し、返ってきたものをそのまま記録する。数値の採点はしない |
触るモデル | SAM 3(Segment Anything Playground) |
渡す画像 | ロボットアームで資源ごみを仕分ける場面を想定し、生成AIに作らせた画像 |
渡す言葉 | SAM 3 の入力は英語の短い名詞が前提なので、英語で入れる。1回に1種類だけ |
記録するもの | 画面のスクリーンショット、正解との照合、所感 |
IoU・Precision・Recall・mAP | Log#11 以降に1本ずらす |
当初の案では、Log#6 の図形シートや Log#3 のブロックの写真を渡すつもりだった。途中で「実際の現場を想定した画像で試したい」という方向に変わり、仕分けの場面を生成AIに描かせることにした。
SAM 3 は英語の短い名詞を渡すと、該当する物を1個ずつ別の色で塗る
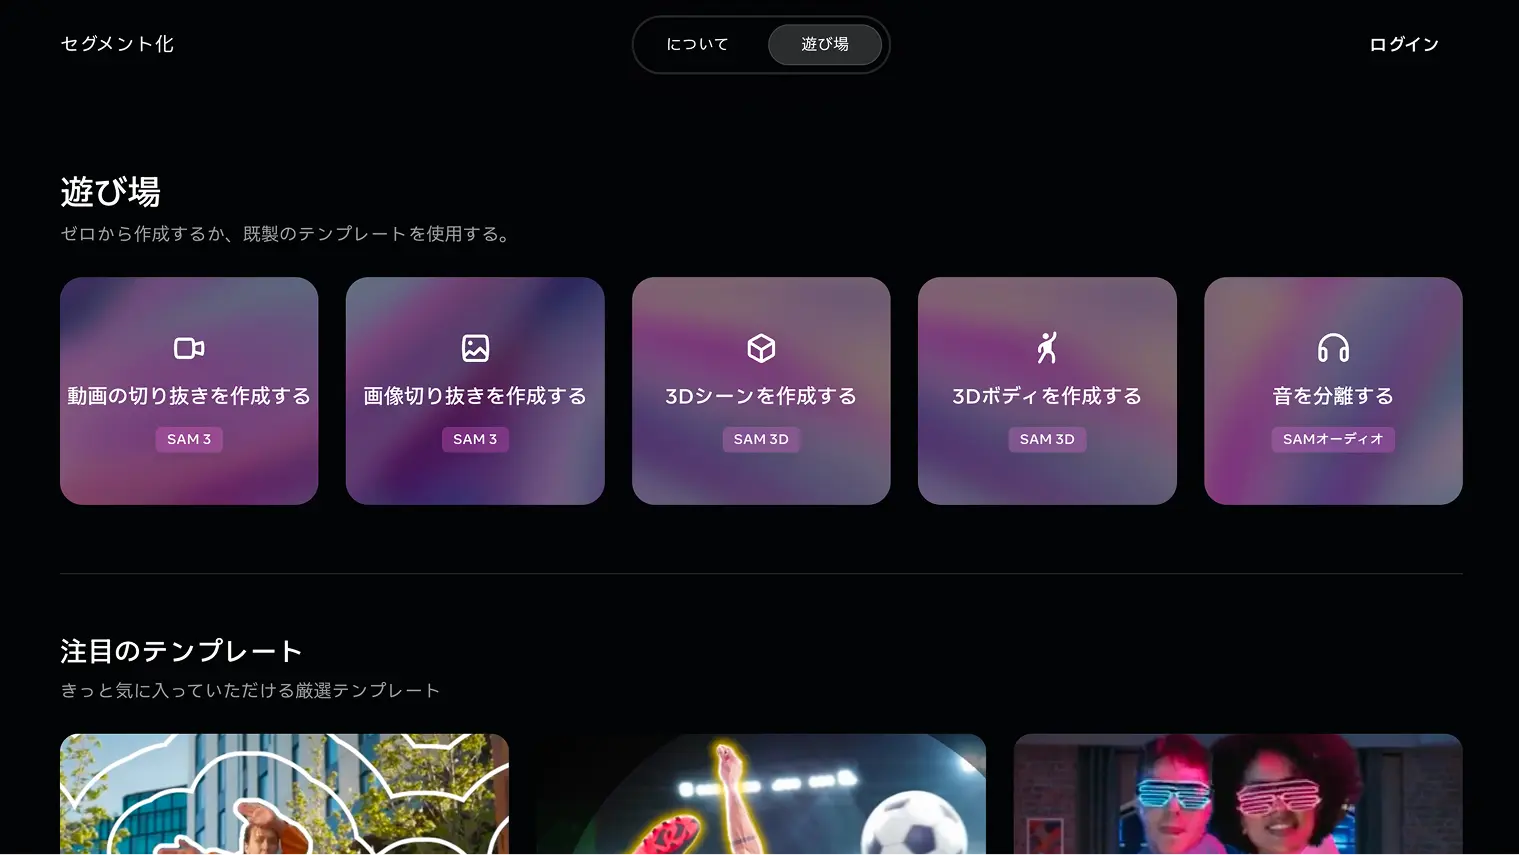
Segment Anything Playground は、Meta が SAM 3 を試すために用意しているブラウザの画面になる。トップには「動画の切り抜きを作成する」「画像切り抜きを作成する」「3Dシーンを作成する」「3Dボディを作成する」「音を分離する」の5枚のカードが並び、使うモデルとして SAM 3、SAM 3D、SAM オーディオと書かれている。Playground が内部でどの版の重みを使っているかは、画面には表示されない。
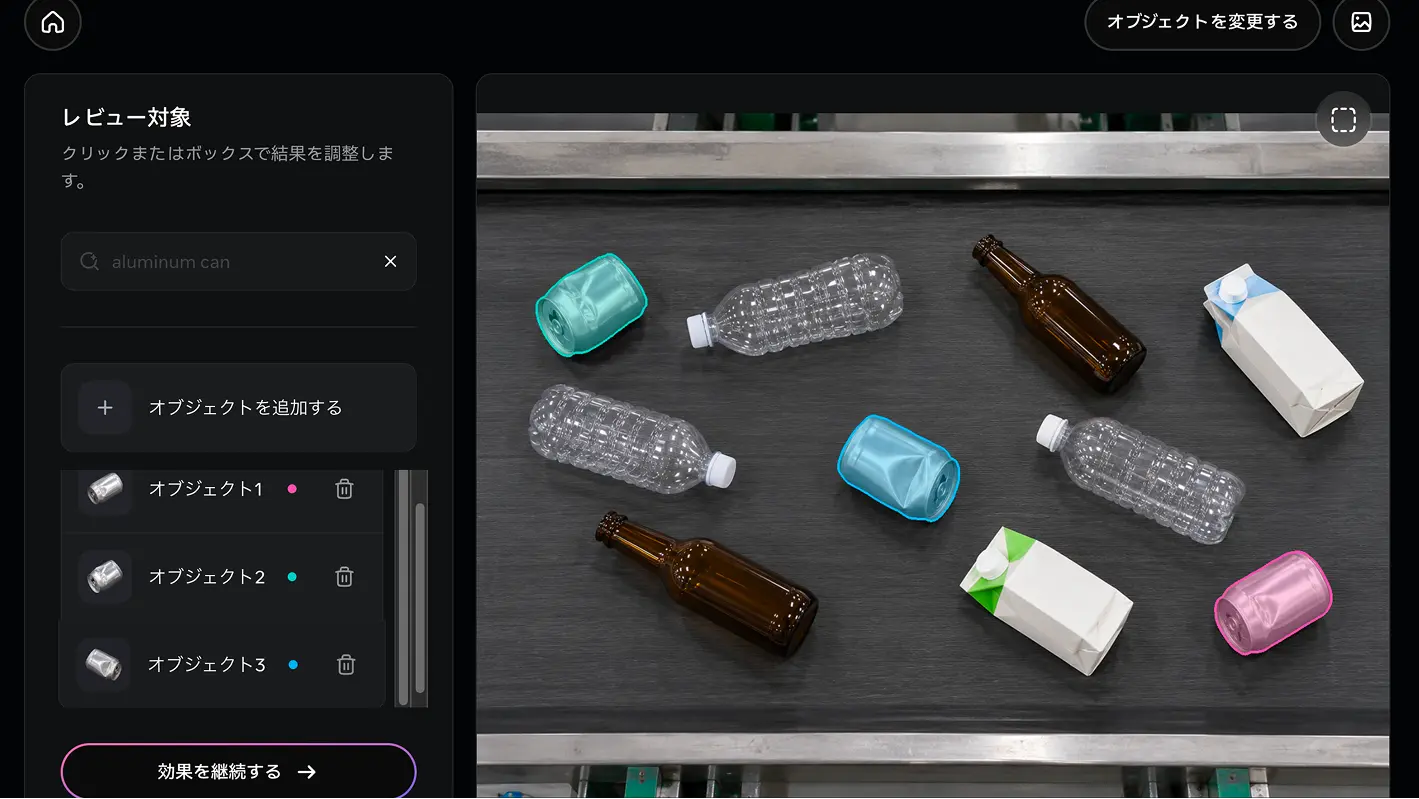
画像を上げて入力欄に言葉を入れると、該当する物に色が付き、左に「Object 1」「Object 2」…と一覧が並ぶ。物ごとに色が違うのは、SAM 3 が見つけた物に1個ずつ番号を振り、番号ごとに色を変えて表示しているため。Log#9 で整理した言葉でいうと、個体を1つずつ数える「インスタンスセグメンテーション」の出力になる。
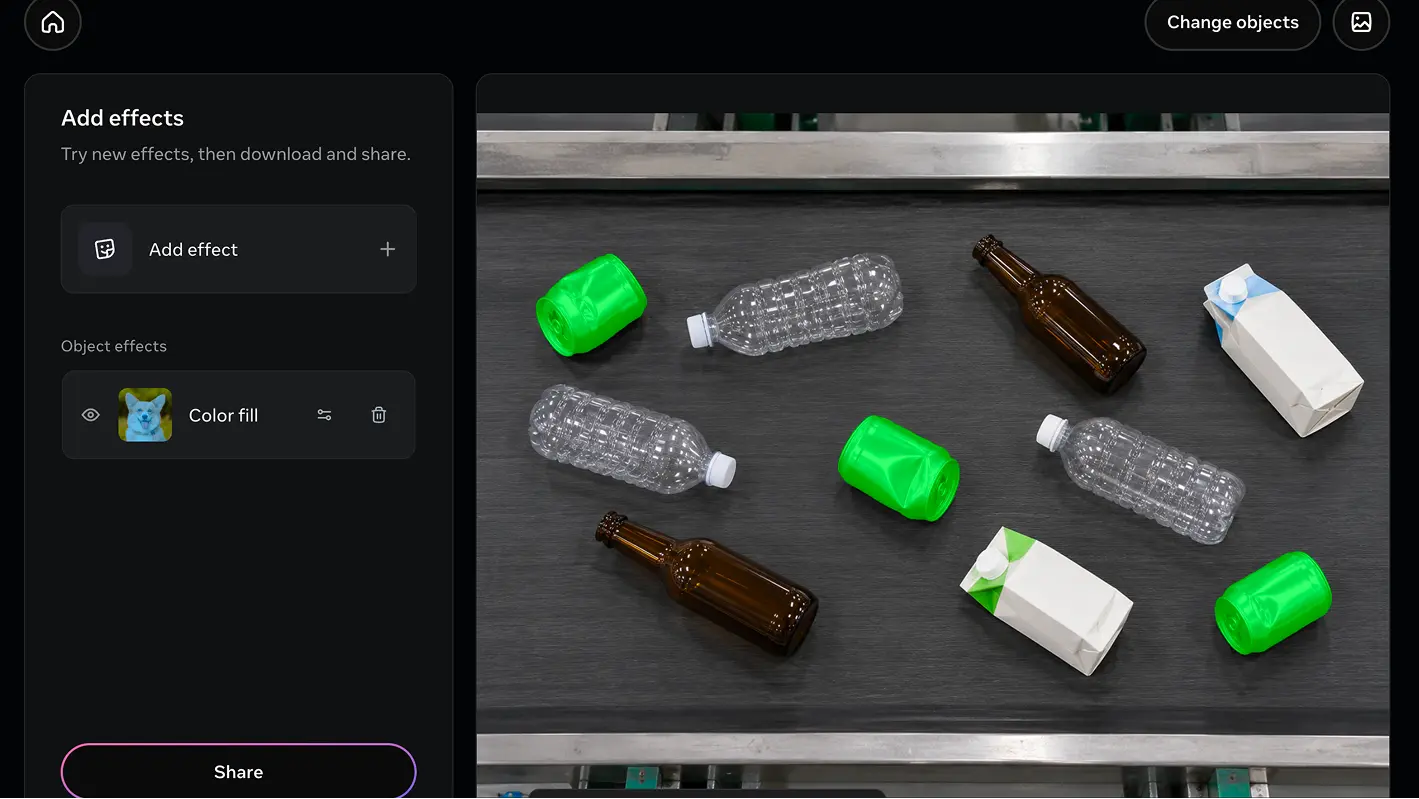
次の画面で「Color fill(色で塗りつぶす)」という効果を選ぶと、見つけた物すべてを同じ色で塗れる。見た目は1色になっても、中では3個を別々の物として持ったままで、変わるのは塗り方だけになる。この回の結果画像はすべて、この1色塗りの状態で記録した。
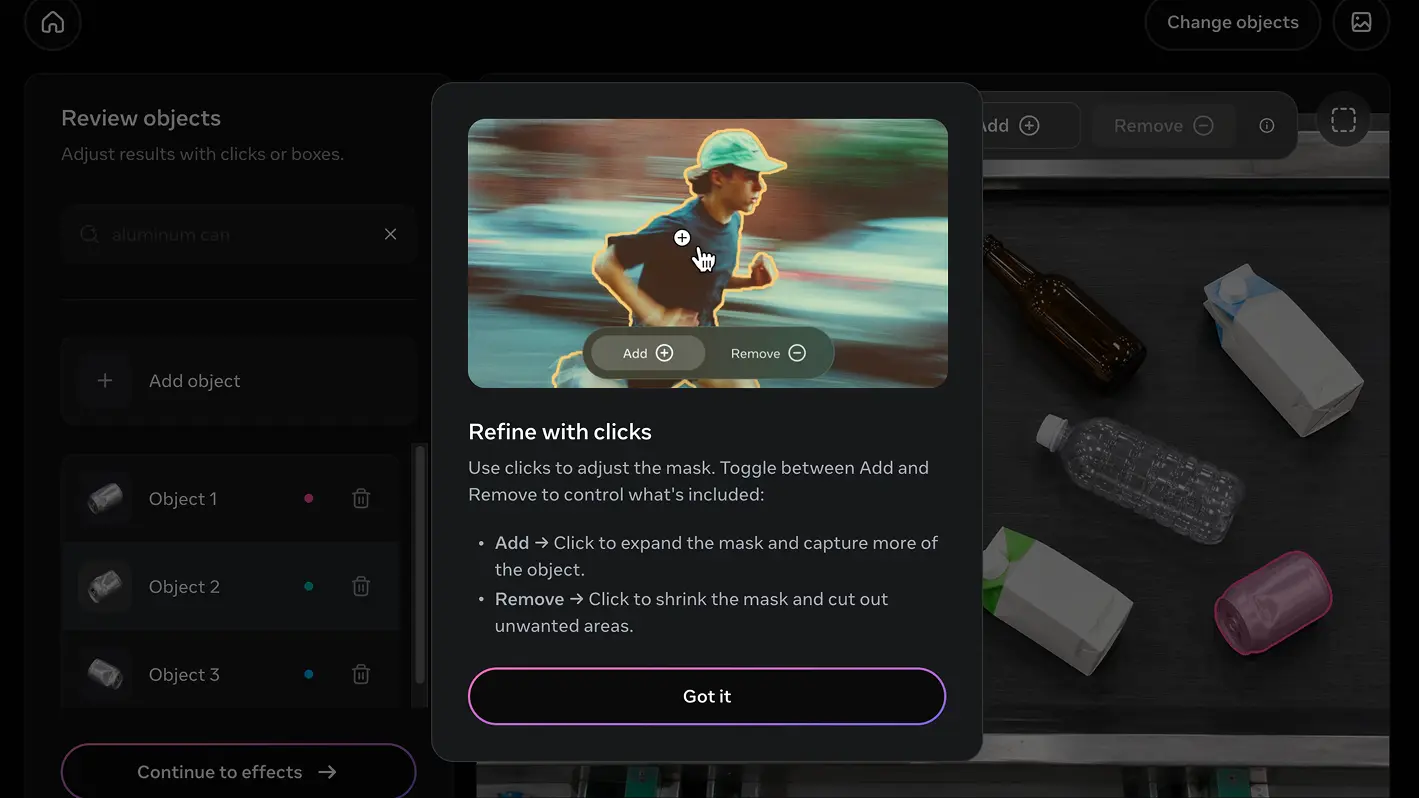
途中で「Refine with clicks(クリックで輪郭を直す)」という案内が出た。物の上をクリックすると輪郭が広がり(Add)、不要な部分をクリックすると輪郭が縮む(Remove)機能で、言葉で指定する前の世代(SAM 1・2)の使い方がそのまま残っている形になる。この回では使っていない。手で直すと、モデルが出した結果と人が直した分が混ざってしまうためだ。
Playground の画面には、1個ずつの信頼度(モデルがどれくらい自信を持っているかの数字)が表示されない。ある物が「ぎりぎりで選ばれた」のか「自信を持って選ばれた」のかは、この画面からは分からない。
分別ラインを想定した画像は、生成AIに作らせて先に中身を数えた
画像は6枚分の案を作り、そのうち2枚を使った。案の全体は次のとおり。
画像 | 場面 | 見たいこと | この回で使ったか |
|---|---|---|---|
A | ベルトコンベアの上に資源ごみが重ならずに並ぶ | 一番やさしい場面で、種類ごとに全部拾えるか | 使った |
B | 見た目が似ているもの同士(缶の種類、透明な瓶とボトル) | 画像だけでは分けられないものがあるか | 使った |
C | コンテナの中で山積みになり、重なっている | 半分隠れた物がどう扱われるか | 未使用 |
D | レジ袋、ラップ、アルミホイル、空のペットボトル | 透明・反射・形が決まっていない素材 | 未使用 |
E | 倉庫の仕分けトレイ(青い箱1個と茶色い箱2個など) | 同じ種類の中から色で1つだけ選べるか | 未使用 |
F | 探す物(缶)が1つも写っていない | 写っていない物を検出してしまうか | 未使用 |
作るときに決めたことが3つある。
1つ目。生成したら、SAM 3 にかける前に中身を目で数えて書き留める。画像生成AIは「缶を3個」と指示しても4個描くことがよくあるので、指示した数ではなく、生成された画像を数えた数を正解にする。SAM 3 の結果を見てから数えると、判断が結果に引っ張られる。
2つ目。照明の違いは、この組では試さない。Log#3 で、生成画像では光の色を変えても実際のカメラのような色の動き方にならないことを確かめている。照明は後で実写で試す。
3つ目。構図はアームの上カメラと同じ、真上から見下ろす向きにする。
全画像の指示文の最後に、次の共通文を付けた。
写実的な写真。真上から見下ろした構図。縦横比4:3。影が強く出ない均一な照明。実在するブランドのロゴや商品名の文字は入れない。人の手は写さない。画像A は Gemini に、次の指示文(共通文の前の部分)で作らせた。
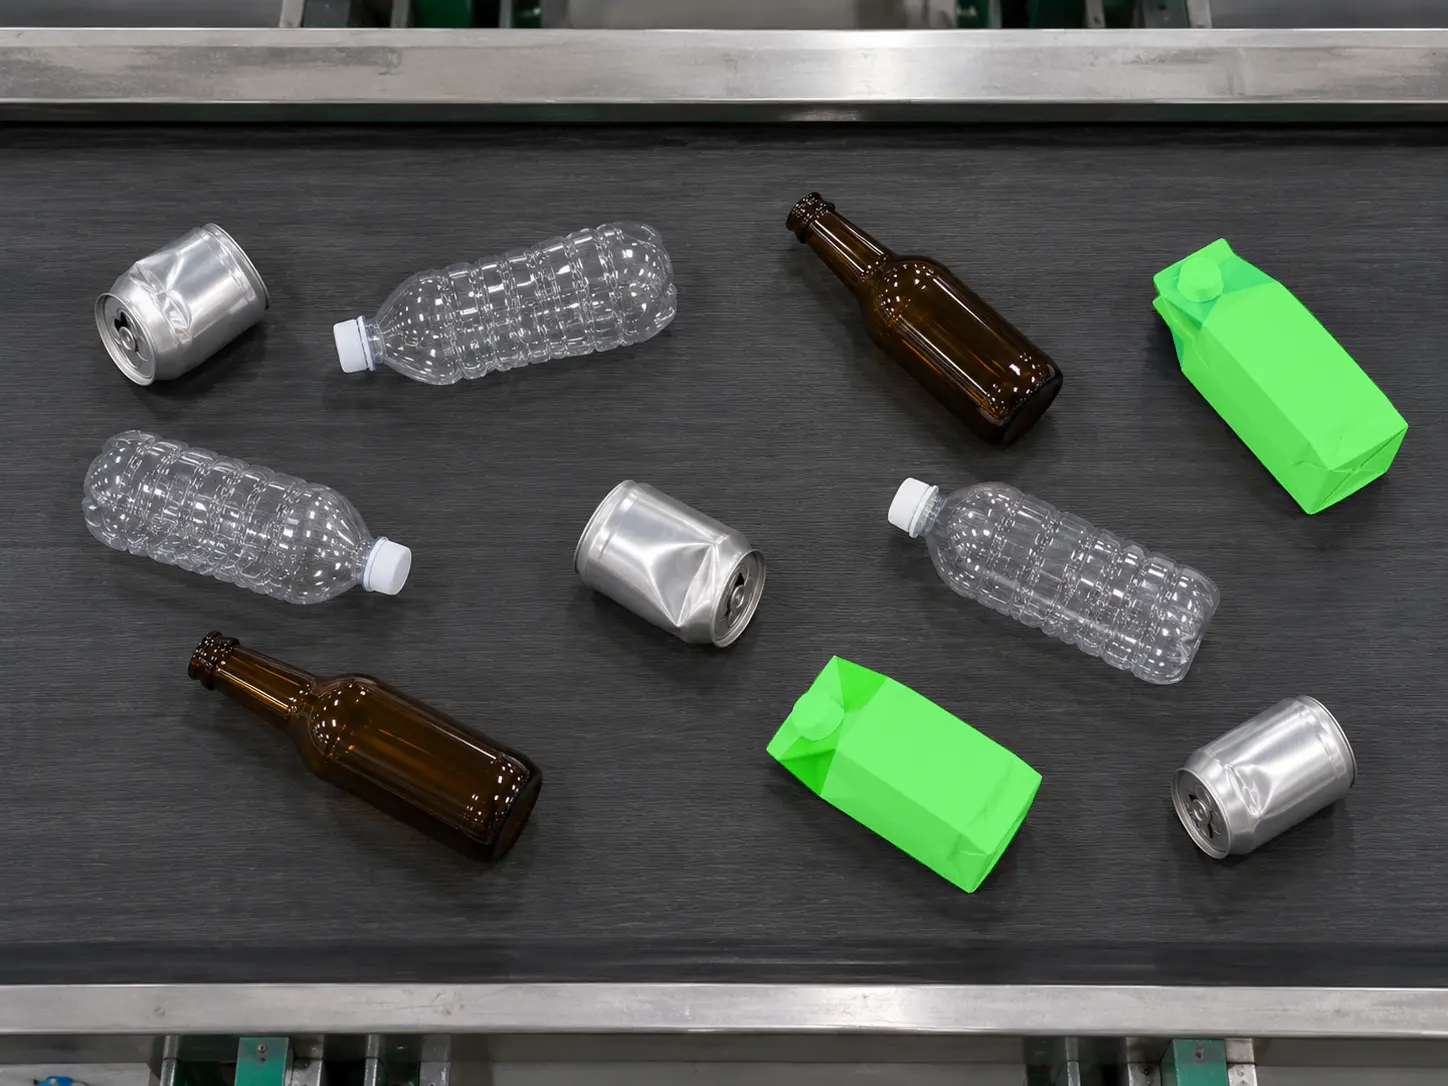
工場の分別ラインのベルトコンベアの上に、資源ごみが重ならずにばらばらに置かれている。アルミ缶3個、透明なペットボトル3本、茶色のガラス瓶2本、紙パック2個。ベルトは濃いグレー。生成された画像を数えた結果は、アルミ缶3個・透明なペットボトル3本・茶色のガラス瓶2本・紙パック2個で、指示どおりの10個だった。
画像B は、最初の案では「アルミ缶とスチール缶を混ぜ、透明なガラス瓶1本とペットボトル1本を添える」だった。画像A の結果を見て、透明なガラス瓶と透明なペットボトルをはっきり並べる必要が出たので、次のように書き直して ChatGPT に作らせた。
灰色のトレイの上に、次の物が重ならずに置かれている。飲料用のアルミ缶2個、スチール缶2個(どちらも1個ずつ潰れている)、無色透明のガラス瓶2本、無色透明のペットボトル2本。ガラス瓶は厚みのあるガラスで、ペットボトルは薄くて凹凸のある樹脂。写実的な写真。真上から見下ろした構図。縦横比4:3。影が強く出ない均一な照明。実在するブランドのロゴや商品名の文字は入れない。人の手は写さない。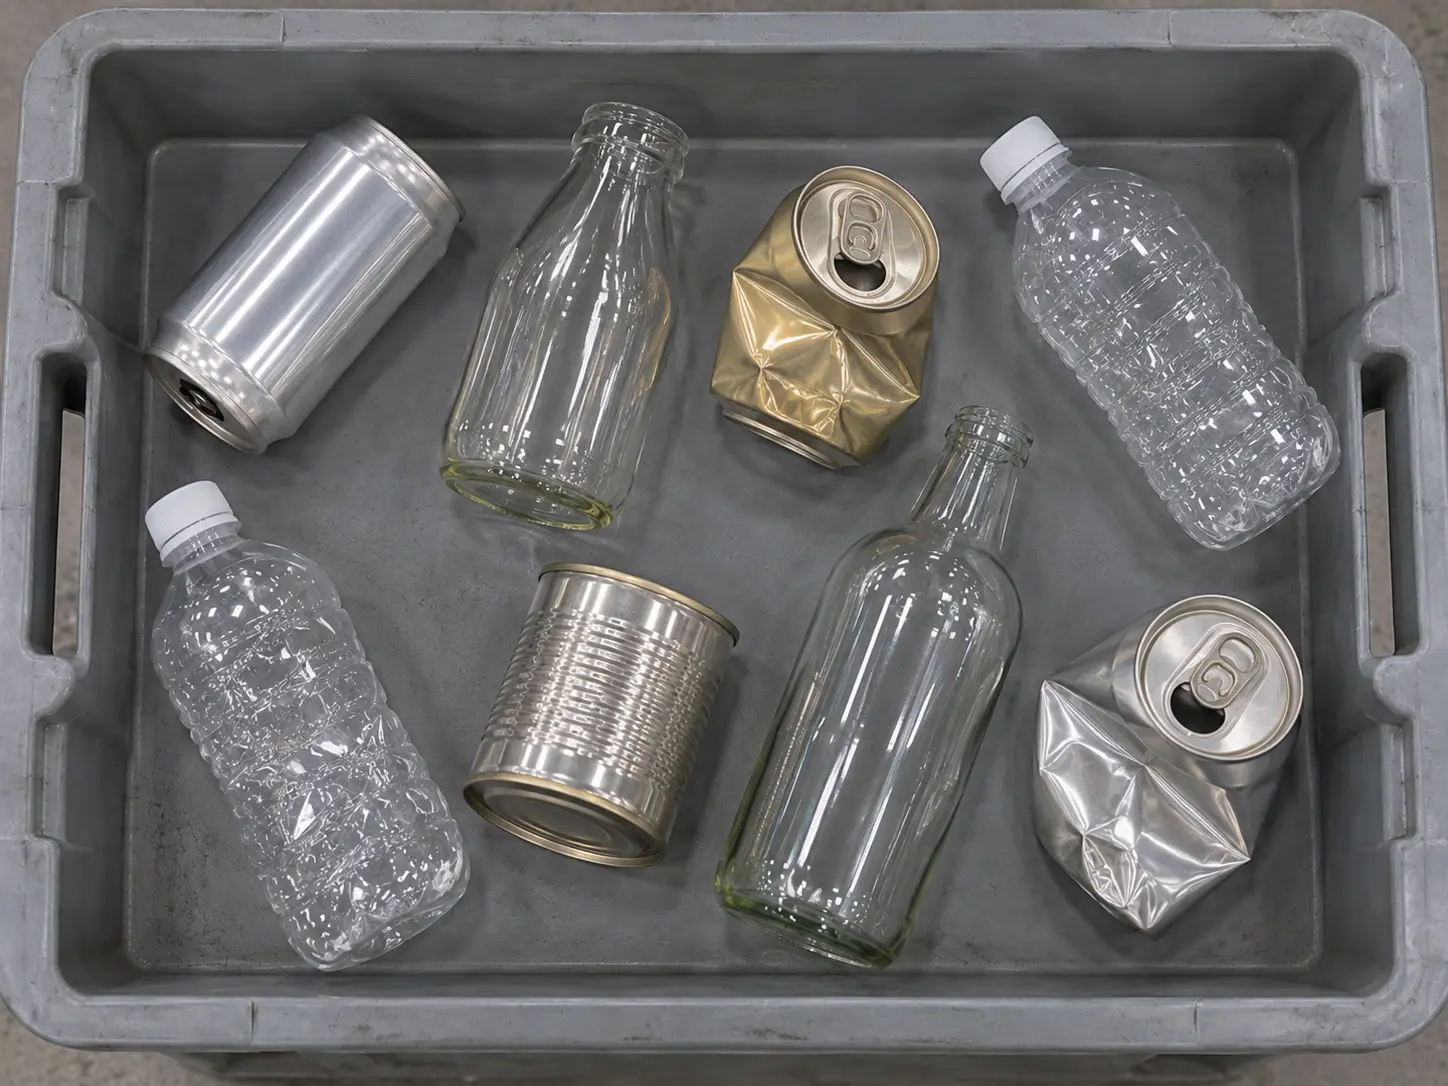
画像B を数えた結果は次のとおり。
種類 | 数 | 見分け方 |
|---|---|---|
透明なペットボトル | 2本(右上・左下) | 白いキャップ付き、胴に凹凸 |
透明なガラス瓶 | 2本(上中央・下中央右) | キャップなし、底と口のガラスが厚い |
缶 | 4個 | 左上の銀色(潰れていない)、上中央右の金色(潰れている)、下中央の筋の入った缶詰(潰れていない)、右下の銀色(潰れている) |
指示文と違う点が3つあった。トレイではなく、取っ手の付いた灰色のプラスチック容器になった。キャップはペットボトルにだけ付いていて、ガラス瓶には付いていない。缶4個のうちどれをアルミ、どれをスチールのつもりで描いたかは、見た目からは判断できない。下中央の筋の入った缶詰は一般にスチール製だが、残り3個は写真だけでは分からない。人が写真だけでは缶の素材を分けられない、ということ自体が画像B で確かめたかったことなので、そのまま使った。
画像A:ベルトコンベアの上の10個に5つの言葉を渡した
画像A には5つの言葉を順に渡した。結果の一覧が次の表になる。
入力した言葉 | 意味 | 選ばれた物 | 正解 | 判定 |
|---|---|---|---|---|
aluminum can | アルミ缶 | 缶3個 | 缶3個 | 一致 |
plastic bottle | ペットボトル | ペットボトル3本+茶色のガラス瓶2本 | ペットボトル3本 | ガラス瓶2本を取り違え |
clear plastic bottle | 透明なペットボトル | ペットボトル3本 | ペットボトル3本 | 一致 |
glass bottle | ガラス瓶 | 茶色のガラス瓶2本 | 茶色のガラス瓶2本 | 一致 |
milk carton | 紙パック | 紙パック2個 | 紙パック2個 | 一致 |
5回のうち、缶・ボトル・紙パックが互いに混ざったことは一度もない。取り違えが起きたのは「plastic bottle」の1回だけだった。
aluminum can は、画像A の缶3個だけを選んだ
「aluminum can」では缶3個がすべて選ばれ、ペットボトル・ガラス瓶・紙パックは1つも選ばれなかった。潰れた缶も含めて、輪郭は缶の形に沿っている。結果の画面は、前の節で色の分かれた画面と1色塗りの画面として載せたものになる。
plastic bottle は、茶色のガラス瓶2本もペットボトルとして選んだ
「plastic bottle」では5本が選ばれた。ペットボトル3本は全部拾えていて取りこぼしはないが、茶色のガラス瓶2本まで一緒に選ばれている。
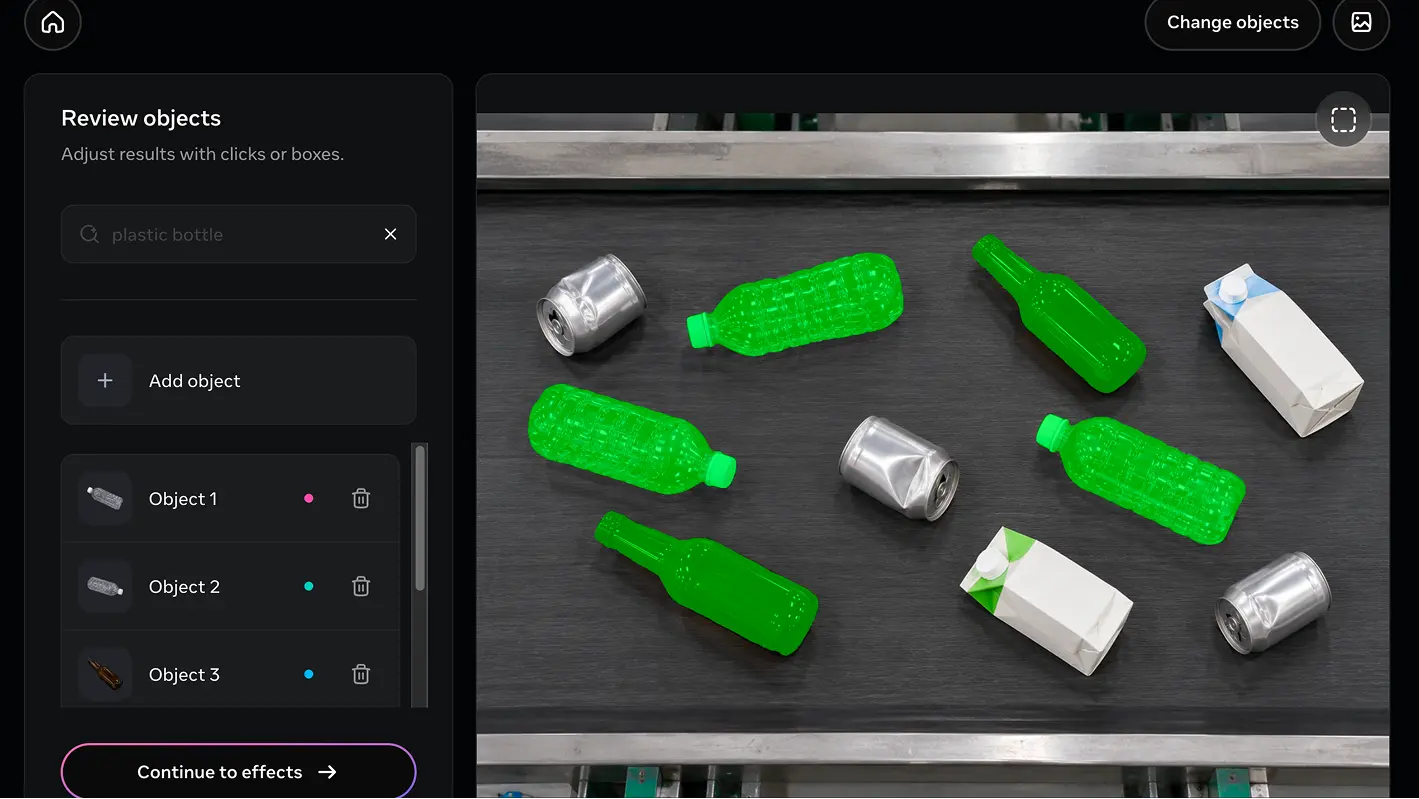
アームで仕分けるなら、ガラス瓶がペットボトルの箱に入ることになる。SAM 3 は「ボトルの形をしているか」で選んでいて、「プラスチック製かどうか」はほとんど効いていないように見えた。形は画像に写っているが、素材は写っていない。
clear を足すと、茶色のガラス瓶2本が外れた
入力を「clear plastic bottle(透明なペットボトル)」に変えると、茶色のガラス瓶2本が外れ、ペットボトル3本だけが選ばれた。
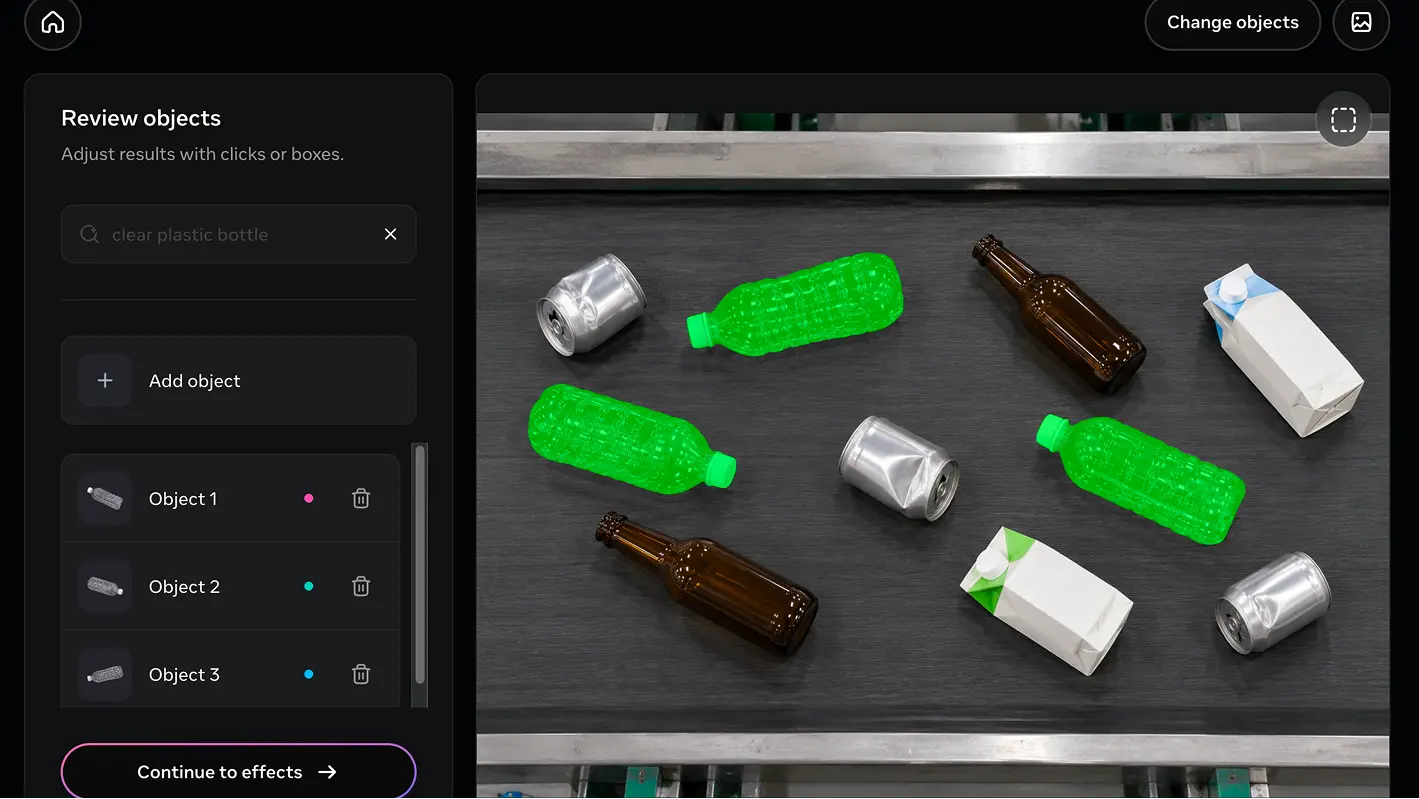
「plastic(プラスチック)」は素材の言葉で、写真には写らない。「clear(透明)」は見た目の言葉で、写真に写っている。写真に写る特徴を表す言葉を足したときに絞り込めた、という結果になる。Log#4 では色の閾値の数字1つで判定が変わったが、ここでは入力する言葉1つで結果が変わった。
ただし、画像A だけでは結論を出せなかった。ガラス瓶が外れた理由が「透明ではない」からなのか、単に「茶色だった」からなのかを区別できないためだ。これを確かめるために、画像B を作った。
glass bottle と milk carton は、画像A では正解どおりだった
「glass bottle」では茶色のガラス瓶2本だけが選ばれ、ペットボトルは1本も選ばれなかった。「plastic bottle」ではガラス瓶まで選んだのに、逆向きに聞くと混ざらない。取り違えは片方向だけだった。茶色い瓶はガラスらしく見えるが、透明で凹凸のあるペットボトルはガラスらしく見えない、ということだと考えた。この読みは、次の画像B で外れる。
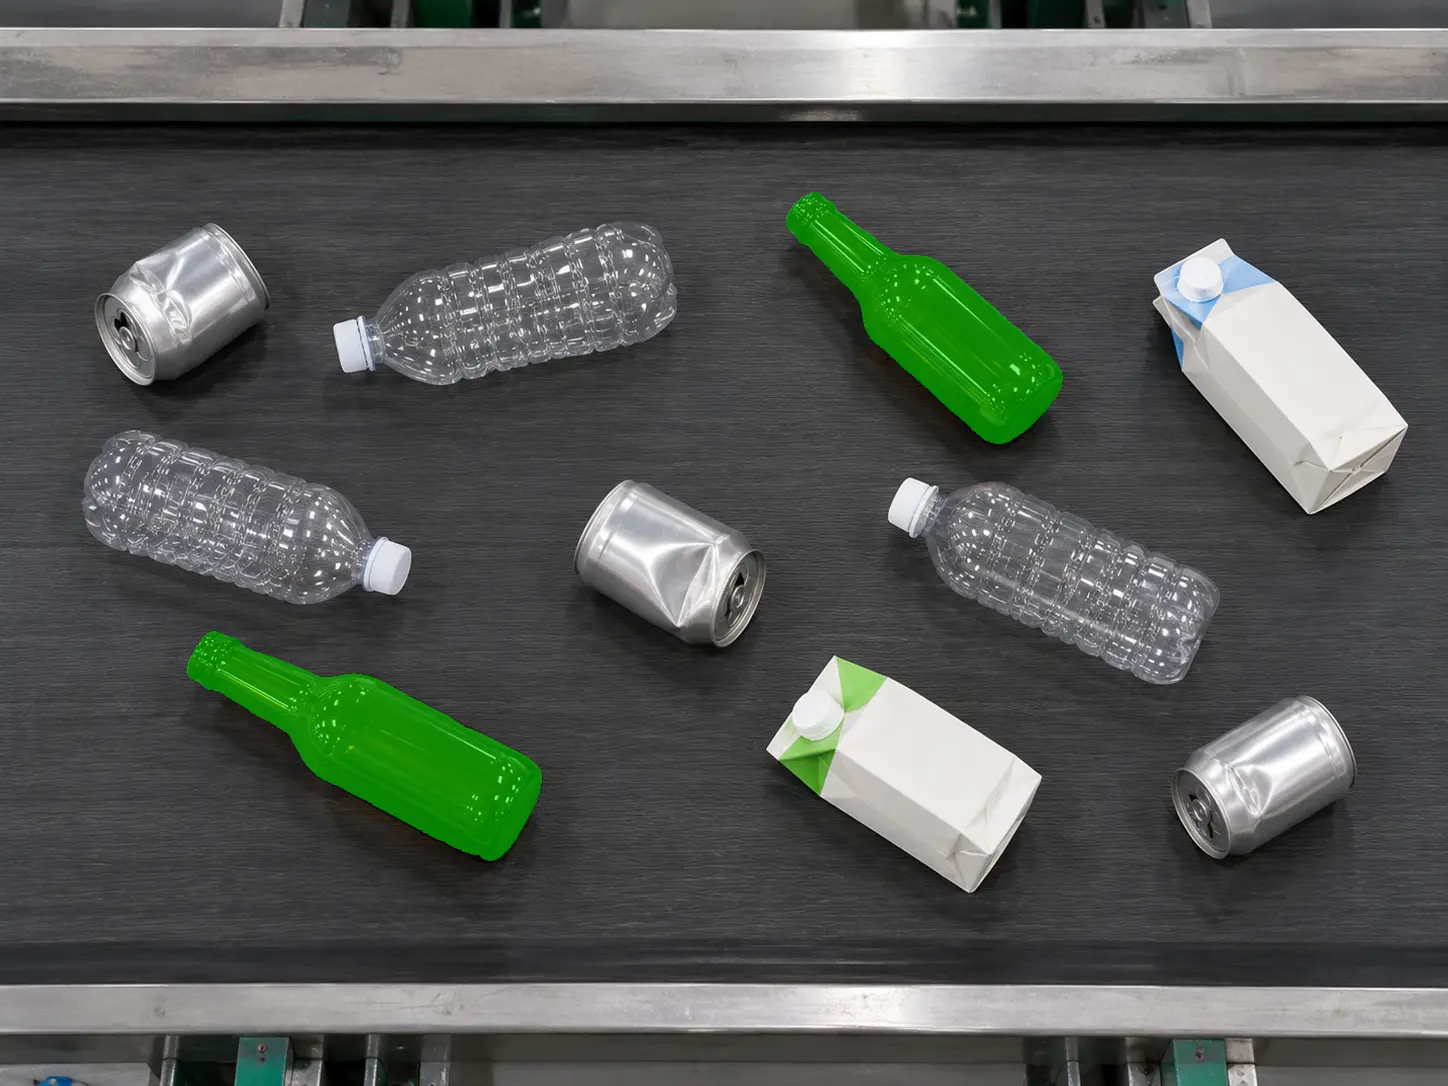
「milk carton」では紙パック2個だけが選ばれた。輪郭は、ペットボトルのキャップや紙パックの注ぎ口まで、物の一部として含めて塗られている。
画像B:透明な2種類を並べると、clear plastic bottle でも glass bottle でも同じ4本が選ばれた
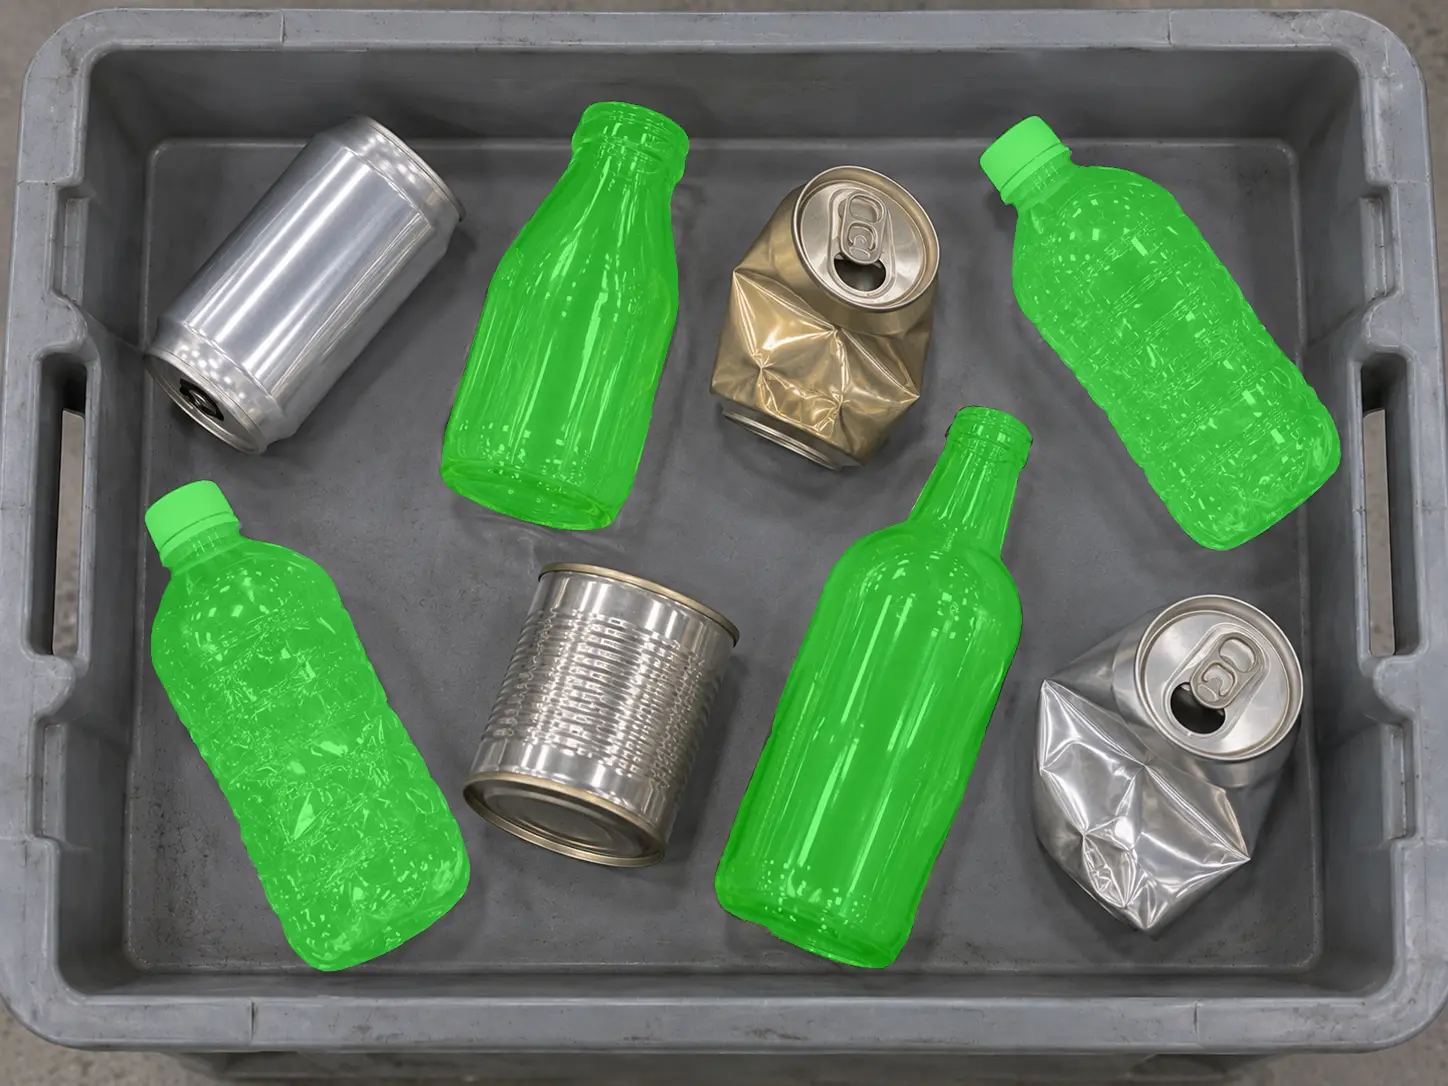
画像B に「clear plastic bottle」を渡すと、ペットボトル2本に加えて、透明なガラス瓶2本まで選ばれた。合計4本になる。
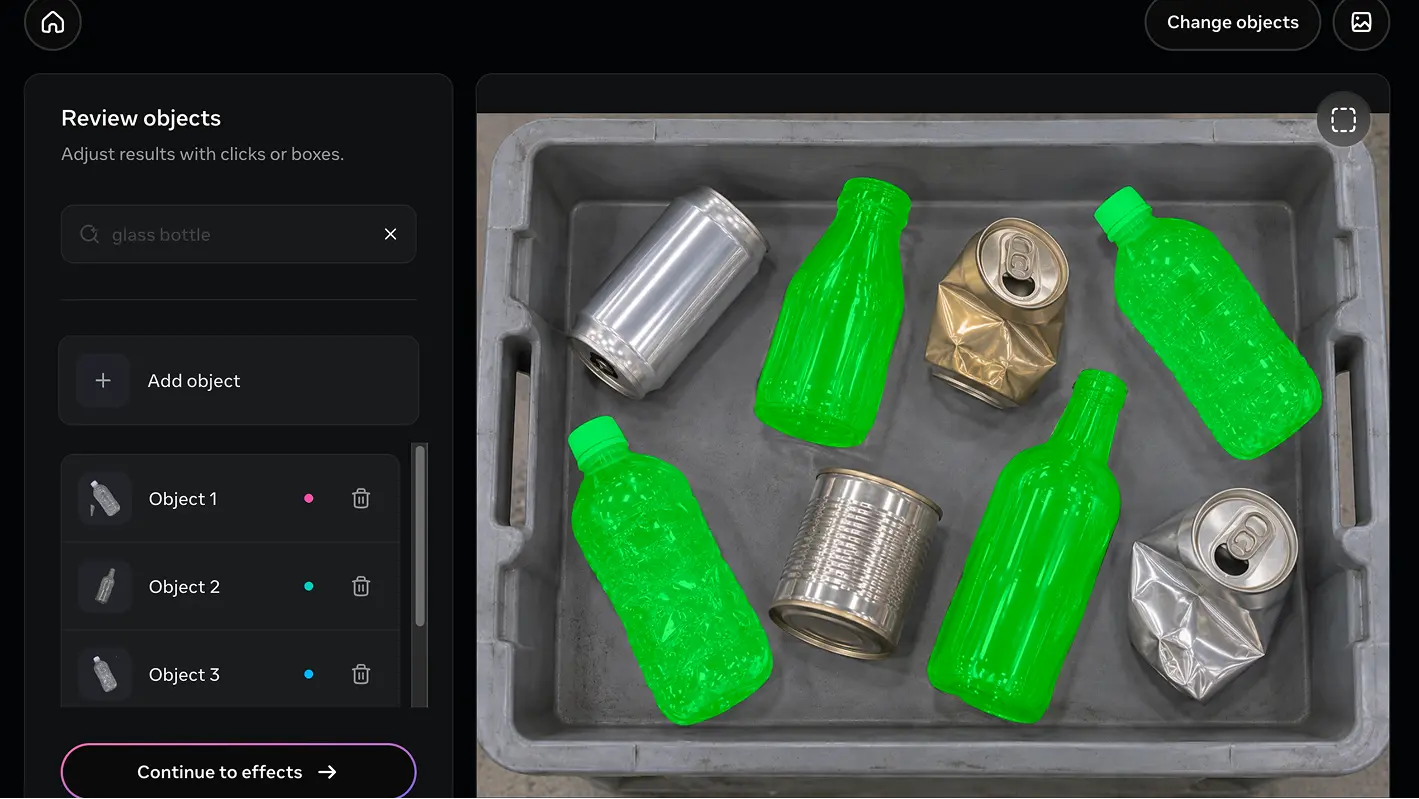
次に「glass bottle」を渡すと、同じ4本が選ばれた。左の一覧を見ると、Object 1 がペットボトル、Object 2 がガラス瓶、Object 3 がペットボトルと、2種類が区別されずに同じ一覧に並んでいる。
画像A と画像B の結果を並べると、次のようになる。
画像 | 入力した言葉 | ペットボトル | ガラス瓶 |
|---|---|---|---|
A | plastic bottle | 3本とも選んだ | 茶色の2本も選んだ |
A | clear plastic bottle | 3本とも選んだ | 茶色の2本は選ばなかった |
A | glass bottle | 1本も選ばなかった | 茶色の2本を選んだ |
B | clear plastic bottle | 2本とも選んだ | 透明の2本も選んだ |
B | glass bottle | 透明の2本も選んだ | 透明の2本を選んだ |
画像A でガラス瓶が外れたのは、SAM 3 が素材を見分けたからではなく、瓶が茶色だったからということになる。色が同じ透明になると、「glass」と「plastic」のどちらの言葉を入れても、選ばれる4本は変わらない。
キャップの有無で分けている可能性も、この結果で消えた。画像B のペットボトルにだけキャップが付いていたので、もし「clear plastic bottle」でペットボトルだけが選ばれていたら、素材ではなくキャップで分けた可能性が残っていた。実際にはキャップのないガラス瓶まで選ばれている。
仕分けの現場に置き換えると、透明なガラス瓶と透明なペットボトルは、カメラの写真と言葉の指定だけでは分けられなかった、ということになる。実際の資源ごみの選別では、重さを量る、近赤外線(目に見えない波長の光を当てて素材の違いを見る方法。Log#9 で扱った)を当てる、といった別の測り方と組み合わせている。
画面上では2回の結果が同じに見えたので、保存した画像を画素ごとに比べた。1448×1086画素(1,572,528画素)のうち、差があったのは3,353画素(全体の約0.2%)で、選ばれた物は4本とも同じだった。
画像B:aluminum can も crushed can も、缶4個すべてを選んだ
「aluminum can」では、缶4個がすべて選ばれ、ボトルは1本も混ざらなかった。潰れた缶も、筋の入った缶詰も、輪郭はきれいに取れている。
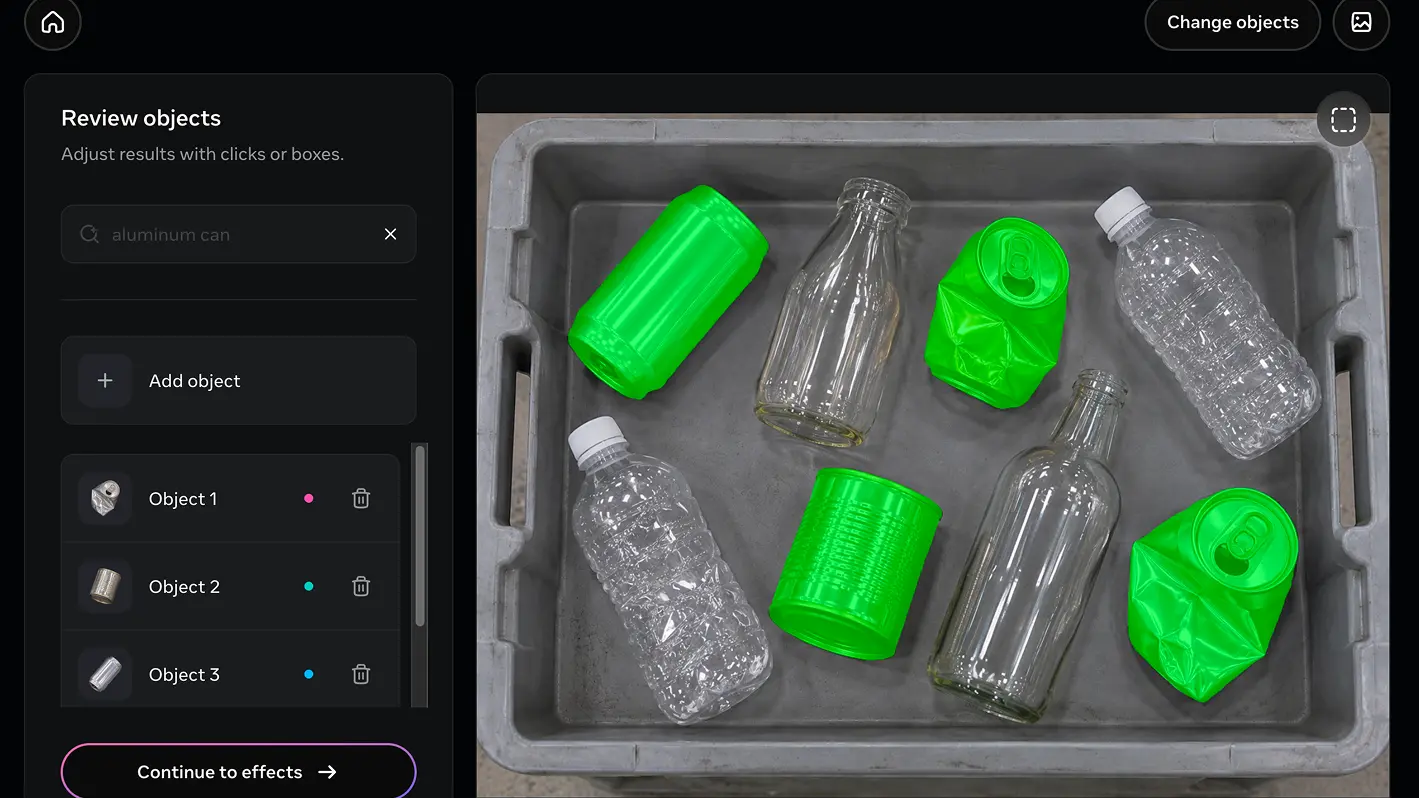
ただし、「アルミ缶を選べた」とは言えない。下中央の筋の入った缶詰まで選ばれているからだ。缶詰は一般にスチール製なので、SAM 3 は「アルミかどうか」ではなく「缶かどうか」で選んでいる可能性が高い。ボトルのときと同じで、素材の言葉が効いていない形になる。この画像の正解は目で判定できないので、判定は「確定できない」として記録した。
「crushed can(潰れた缶)」でも、缶4個すべてが選ばれた。潰れていない2個(左上の銀色の缶と、下中央の缶詰)まで入っている。
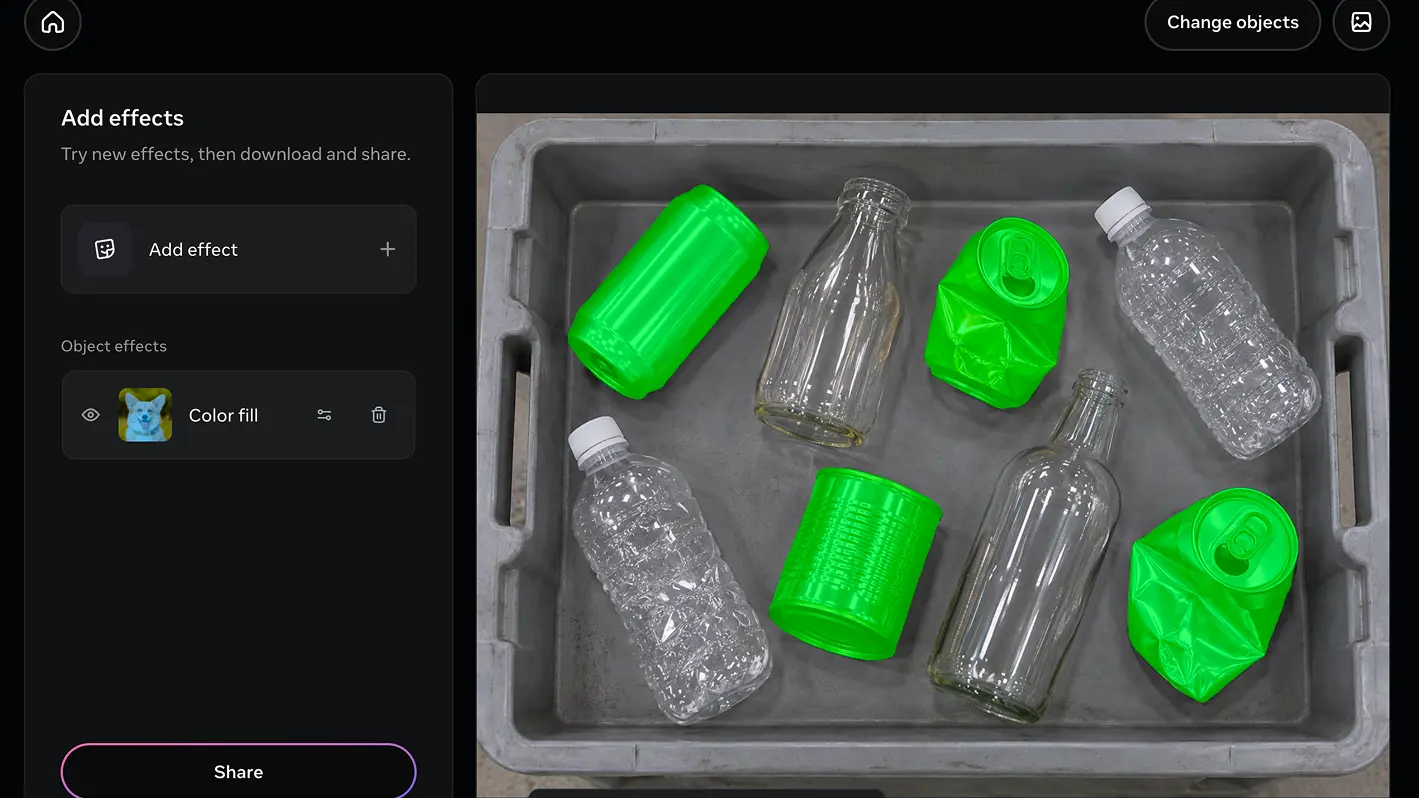
「crushed」は写真に写る見た目の言葉なので、潰れた2個だけに絞れると予想していた。この予想は外れた。2枚の結果を画素ごとに比べると、差があったのは1,845画素(全体の約0.1%)で、選ばれた物は4個とも同じだった。
効いた言葉は物の名前と色、効かなかった言葉は素材と状態
画像A・B で試した言葉を、言葉の種類で分けると次のようになる。
言葉の種類 | 例 | 絞り込めたか |
|---|---|---|
物の名前 | can、bottle、milk carton | 効いた(缶とボトルと紙パックは一度も混ざっていない) |
色・透け方 | clear | 効いた(茶色の瓶を外し、透明なガラス瓶は含めた) |
素材 | plastic、glass、aluminum | 効かなかった |
状態 | crushed | 効かなかった |
「clear」が効いたように見えたのも、透明なガラス瓶は実際に透明なので、言葉どおりに選んだ結果になる。外れていたのは「plastic」の方だった。
途中で「写真に写る見た目の言葉なら絞り込める」と見立てたが、「crushed」で外れたので、見立てを「物の名前と色なら絞り込める」に狭めた。
この結論が言えるのは、生成画像2枚、言葉9つの範囲に限られる。実際のカメラで撮った写真、別の言い回し(例えば「dented can」「PET bottle」)、別の対象では、結果が変わる可能性がある。
アームに組み込む前提で考えると、SAM 3 は「缶」「ボトル」「紙パック」のような物の種類で分けるところまでは使える。素材で分ける工程は、SAM 3 の後ろに別の判定(重さ、近赤外線、あるいは物を持ち上げたときの手応え)を置く必要がある。
無料の Playground は、アクセスが集中すると止まる
画像B を上げた直後に、「We're at capacity right now(いまアクセスが集中しているので、数分後にもう一度試してください)」という画面が出た。画像や入力の問題ではない。数分おいて試し直すと動いた。
Playground は試すためのデモ画面なので、混雑すると使えなくなる。アームの動作の中に組み込むなら、有料の API を使うか、自分の手元の計算機で動かす必要がある。
試行の記録(全量)
# | 画像 | 入力した言葉 | 選ばれた物 | 正解 | 判定 | 記事内の画像 |
|---|---|---|---|---|---|---|
A-01 | A | aluminum can | アルミ缶3 | アルミ缶3 | 一致 | A_01_aluminum-can_screen.png、A_01_aluminum-can_colorfill.png |
A-02 | A | plastic bottle | ペットボトル3+ガラス瓶2 | ペットボトル3 | ガラス瓶2本を取り違え | A_02_plastic-bottle_screen.png |
A-03 | A | clear plastic bottle | ペットボトル3 | ペットボトル3 | 一致 | A_03_clear-plastic-bottle_screen.png |
A-04 | A | glass bottle | ガラス瓶2 | ガラス瓶2 | 一致 | A_04_glass-bottle.png |
A-05 | A | milk carton | 紙パック2 | 紙パック2 | 一致 | A_05_milk-carton.png |
B-01 | B | clear plastic bottle | ペットボトル2+ガラス瓶2 | ペットボトル2 | ガラス瓶2本を取り違え | B_01_clear-plastic-bottle.png |
B-02 | B | glass bottle | ガラス瓶2+ペットボトル2 | ガラス瓶2 | ペットボトル2本を取り違え | B_02_glass-bottle_screen.png |
B-03 | B | aluminum can | 缶4 | 確定できない | 缶詰(スチールの可能性が高い)も選択 | B_03_aluminum-can_screen.png |
B-04 | B | crushed can | 缶4 | 潰れた缶2 | 潰れていない缶2個も選択 | B_04_crushed-can_screen.png |
実行条件は次のとおり。
項目 | 内容 |
|---|---|
実行日 | 2026-09-25 |
モデル | SAM 3(Segment Anything Playground のブラウザ画面。内部の版は画面に表示されない) |
画像A | Gemini で生成。1448×1086画素 |
画像B | ChatGPT で生成。1448×1086画素 |
入力 | 英語の名詞句を1回に1つ。クリックによる輪郭の手直しはしていない |
信頼度 | 画面に表示されないため不明 |
所要時間 | 記録していない |
画像B の同じ結果に見えた2組を、保存した画像で画素ごとに比べた結果は次のとおり。差の判定は、RGB の差の合計が30を超えた画素を数えている。
比べた2枚 | 画像全体の画素数 | 差があった画素数 | 割合 |
|---|---|---|---|
B-01 clear plastic bottle と B-02 glass bottle | 1,572,528 | 3,353 | 約0.21% |
B-03 aluminum can と B-04 crushed can | 1,572,528 | 1,845 | 約0.12% |
保存先は MASTER の保存先テーブルに従う。生成画像と指示文は vision/generated/Log10/、結果の画像と画面記録は vision/measurements/Log10/ に置く。
参照した資料
この回の対話ログ
モデルを触った回だが、コードは書いていない。そのかわりに、調べた内容と、画面を見ながら判断が動いた過程をそのまま残す。外れた予想も消していない。
最新モデルの調査から始まった
最初の依頼はこれだった。
画像認識と物体検出を学び直す Log#10を進めたいです。既存の画像認識ではなく、最新のモデルについて実際に触ってみるというのを差し込みたいです。最新モデルはどんなことができて、そのようなサービスがあり、どんな結果をもたらすのかをまずは調査してください。
Log#1〜9 の記事を読み直してシリーズの流れを確認したうえで、SAM 3・Gemini Robotics ER・YOLO26・RF-DETR・Depth Anything 3・SAM 3D、Mac で動く VLM、汎用 VLM の検出ベンチマークを調べた。返した内容は、この記事の最初の3つの節(モデルの一覧、サービスの一覧、Roboflow のベンチマーク)とほぼ同じになる。
最後に、Log#10 の組み方として「自分の写真で最新モデルを触り、その結果を IoU・Precision・Recall・mAP で自分の手で採点する回」を提案した。Log#6 の図形シートと上カメラのブロック写真で正解の枠を作る、Log#4 のオレンジ光の写真をそのまま SAM 3 にかける、ブロックが写っていない写真も混ぜて誤検出を見る、使うモデルは SAM 3・YOLOE-26・Claude・Gemini Robotics ER 2 の4つ、という内容だった。そのうえで、採点まで1本にまとめるか、触るだけの回を差し込んで mAP を Log#11 に送るかを聞いた。
英語が混ざっていて読めないという指摘
最初の返答は、調べた資料の英文をそのまま本文に貼り付けていた。
英語が混ざっていてよくわからないよ
英文の引用をすべて外し、日本語だけで書き直して出し直した。表の列の読み方(mAP@50・mAP@75・mAP@50:95 の違い)も、このときに足した。
触るだけの軽い回にすることが決まった
Log#10は「最新モデルを触る」単独の回でまずは軽くはじめたい。
このメッセージには設計案が添えられていた。採点はせず所感までにとどめる、SAM 3(Segment Anything Playground)と Gemini Robotics ER 2(Google AI Studio)をブラウザで触る、Log#6 の図形シート・Log#3 のブロック写真・上カメラの赤ブロック写真を再利用する、2つのモデルに「red block」「circle」「all objects」を同じように渡す、Gemini にだけ「赤ブロックのどこを掴めばいいか指し示して」と追加で聞く、というもの。IoU・Precision・Recall の回は Log#11 以降に1つずれる。
この案に対して、4点を返した。1つ目、SAM 3 は短い名詞で形のある対象を指す前提なので、「all objects」は何も返らないか画面全体を返す可能性が高い。外さずに残し、SAM 3 と Gemini で「何を物として数えるか」の答え方の違いを見る。2つ目、図形シートにも「red block」を渡し、紙に印刷された平らな赤い四角をブロックとして拾うかで、色だけで判断しているかを見る。3つ目、Gemini は座標を「縦横それぞれ1000に割った目盛り」で縦を先にして返すので、画素の位置に直す計算が要る。4つ目、スクリーンショットの置き場所が MASTER の保存先テーブルにないので、「測定出力(CSV・JSON)」の行を「測定出力(CSV・JSON・モデル出力の画面記録)」に書き換えてから置く。
現場を想定した画像に切り替えた
SAM3から触ってみます。実際の現場を想定した画像を用意して試したいです。ロボットアームで商品やゴミを仕分けることを想定しているので、どのような画像を作るか指示を考えてください(geminiかchatGPTに作らせます)
ここで、渡す画像が既存の写真から生成画像に変わった。6枚の組(A〜F)の指示文と、共通で付け足す文、SAM 3 に入れる言葉の一覧を出した。うまくいく場面と失敗しそうな場面の両方を用意し、どこで崩れるかを見るという組み立てにした。生成したら SAM 3 にかける前に中身を数えて書き留めること、照明の違いはこの組では試さないこと、指示文を画像と同じ名前のテキストで残すことも決めた。
物ごとに色が分かれる理由
画像A に「aluminum can」を入れた最初の結果は、3個の缶が水色・青・ピンクに塗り分けられていた。
オブジェクトの色が別れているけど、一緒の色にはできない?
色が分かれているのは、SAM 3 が3個を別々の物として数えた印だと説明した。個体を1つずつ数えるインスタンスの出力で、全部を同じ色で塗るのはセマンティック(種類ごとにまとめて塗る)の見せ方になる。記録としては色が分かれたままの方が「何個として数えたか」が分かるので、両方残すことにした。
次に、クリックで輪郭を直す機能の案内が出た。
こんなのが出るね
Add は物の上をクリックして輪郭を広げる、Remove は不要な部分をクリックして輪郭を縮める機能だと説明した。手で直すとモデルの結果と人の修正が混ざるので、この回では使わないことにした。使うなら「何回クリックすれば正しい輪郭になったか」を数えると、アノテーション(人が正解を書き込む作業)の下書き役としてどれだけ手間が減るかを測れる、という点も添えた。この時点で、Playground の画面表示は日本語から英語に切り替わっていた。
1色にできたね。
「Color fill」の効果を3個すべてに同じ色でかけた状態で、中では3個を別々に持ったままだと説明した。
plastic bottle で最初の取り違えが出た
plastic bottleでビンも選択されているね。
ペットボトル3本は全部拾えていて、茶色のガラス瓶2本まで選ばれていた。SAM 3 はボトルの形で選び、プラスチック製かどうかはほとんど効いていないように見えると返した。原因を切り分けるために、「glass bottle」「clear plastic bottle」「brown bottle」の3つを試す案を出した。
clear plastic bottle にしたらペットボトルだけ認識したね。
「clear」を足しただけでガラス瓶2本が外れた。写真に写る見た目の言葉で指定したときに絞り込めた、と読んだ。ただし、ガラス瓶が外れたのが「透明ではないから」なのか「茶色だったから」なのかは、この画像では区別できないので、透明なガラス瓶と透明なペットボトルを並べた画像B で確かめることにした。
次は?
画像A に「glass bottle」と「milk carton」を試して締め、画像B を作る流れを出した。画像B の指示文は、透明なガラス瓶がはっきり写るように書き直した。人の目でガラス瓶とペットボトルが見分けられない画像なら作り直す、という条件も付けた。
画像A の5回分がそろった
「glass bottle」は茶色の2本だけ、「milk carton」は紙パック2個だけで、どちらも正解どおりだった。取り違えが片方向だけだったことから、「茶色い瓶はガラスらしく見えるが、透明で凹凸のあるペットボトルはガラスらしく見えない」と考えた。この読みは画像B で外れることになる。
保存と名前の付け直しは Claude Code に任せることになり、MASTER の保存先テーブルを1行書き換える手順と、画像を KIOXIA に整理保存する指示文を用意した。結果の画像は、緑に塗られている物の組み合わせで、どの入力の結果かを判定させる形にした。
画像B を作った
新しく画像作りました。
正解を数えて書き留めた。透明なガラス瓶と透明なペットボトルは人の目で見分けられる画像になっていた。気をつける点として2つ挙げた。缶4個のアルミとスチールの別が見た目で判断できないので、「aluminum can」は正解と照合できず観察の扱いになること。キャップがペットボトルにだけ付いているので、「clear plastic bottle」でペットボトルだけが選ばれた場合に、素材で分けたのかキャップで分けたのかを区別できないこと。
画像を上げた直後に、Playground が混雑のお知らせを出した。数分おいて試し直すことにした。
画像B で、素材の言葉が効いていないことが分かった
clear plastic bottleだとこういう認識
透明なガラス瓶2本まで選ばれ、合計4本になった。画像A でガラス瓶が外れたのは素材を見分けたからではなく、瓶が茶色だったからだと分かった。キャップのないガラス瓶まで選ばれたので、キャップで分けている可能性も消えた。
glass bottleでもペットボトル選んじゃってるね。
両方向で同じ4本になった。SAM 3 にとって、この透明なボトル4本は同じ物になる。この画像と前の画像は塗られ方がまったく同じに見えたので、保存するときには入力欄まで写した画面で残すか、すぐ名前を付け直すように伝えた。次に届いた「glass bottle」の画面には入力欄が写っていて、左の一覧にペットボトルとガラス瓶が区別されずに並んでいた。
aluminum canはいいね。
缶4個をすべて選び、ボトルは1本も混ざっていなかった。ただ、筋の入った缶詰(一般にスチール製)まで選んでいるので、「アルミ缶を選べた」とは言えないと返した。確かめる方法として「steel can」を提案し、そのあとに「crushed can」を試す流れにした。「crushed」は写真に写る見た目の言葉なので、潰れた2個だけに絞れるかで、素材の言葉と見た目の言葉の差がもう一度確かめられると考えていた。
crushed can で見立てを直した
crushed canでも区分けできないね。
潰れていない2個まで含めて、4個すべてが選ばれた。前の返信で「写真に写る見た目の言葉なら絞り込める」と書いた見立ては、ここで外れた。試した言葉を「物の名前」「色・透け方」「素材」「状態」に分け、効いたのは物の名前と色、効かなかったのは素材と状態、と整理し直した。画像2枚・言葉9つの範囲の結果なので、記録には「この条件では」と添えることにした。
この先の進め方として、SAM 3 は画像F(缶が写っていない画像)に「aluminum can」を入れる1枚で区切り、次に Gemini Robotics ER 2 に画像B をそのまま渡す案を出した。SAM 3 が分けられなかった透明なガラス瓶とペットボトルを、画像を見て考えてから答える Gemini なら底の厚みやキャップを手がかりに分けられるのか、を見るためだった。
ファイル名の変更はcluade codeにやらせて
画像A・B の整理を1本にまとめた Claude Code 向けの指示文を出した。画像B の結果は2枚ずつ同じ塗られ方に見えるので、中身ではなく保存した時刻の順で名前を付ける形にした。
記事に写真を掲載するのですが、この時点で結構なボリュームなので、ここで区切って記事化を進めてください。
画像F と Gemini Robotics ER 2 は次の回に回し、ここまでを Log#10 として記事にすることになった。
この回で分かったこと
論点 | 分かったこと |
|---|---|
SAM 3 の出力 | 見つけた物に1個ずつ番号を振って返す(インスタンス)。Playground では信頼度が表示されない |
物の名前での指定 | 缶・ボトル・紙パックは、9回の試行で一度も互いに混ざらなかった |
色での指定 | 「clear」で茶色の瓶を外せた。透明なガラス瓶は含めた |
素材での指定 | 「plastic」「glass」「aluminum」は、同じ形の物の中から素材で選び分けられなかった |
状態での指定 | 「crushed」は、潰れていない缶も選んだ |
透明なガラス瓶とペットボトル | 「clear plastic bottle」でも「glass bottle」でも同じ4本が選ばれた |
仕分けへの当てはめ | 物の種類で分ける工程には使える。素材で分ける工程には、別の測り方を後ろに置く必要がある |
無料の Playground | 混雑すると止まる。アームに組み込むには API か手元の計算機が要る |
結論の範囲 | 生成画像2枚・言葉9つでの結果。実写・別の言い回しでは変わりうる |
次は画像F の誤検出と、Gemini Robotics ER 2 に画像B を渡した結果を見る
次の回で試すことは2つある。
1つ目は、缶が1つも写っていない画像F に「aluminum can」を入れること。何も返ってこなければ正常で、紙くずや段ボール片を缶と呼べば、それが誤検出の実例になる。Log#7 では、本が写っていない写真でも特徴点が867件「合った」と判定された。同じことが SAM 3 で起きるかを見る。
2つ目は、Gemini Robotics ER 2 に画像B をそのまま渡すこと。SAM 3 は透明なガラス瓶とペットボトルを分けられなかった。画像を見て考えてから答える Gemini が、底の厚みやキャップの有無を手がかりに分けるのか、SAM 3 と同じように4本をまとめるのか。同じ画像で比べると、2つのモデルの違いがそのまま見える。
IoU・Precision・Recall・mAP の回は、その後の Log#11 以降になる。Log#1 に載せた全19本の構成表は、Log#9 が用語の回になった時点から実際の進み方とずれているので、第4部以降を組み直すときに合わせて更新する。