ロボットの目は、鏡像も「ある」と見る ― SAM 3で器具を切り出して気づいたこと。
ロボットに物を掴ませる前に、まず「どれを掴むか」を見分けさせないといけない。その入口になるのが画像認識だ。Metaが公開しているSAM 3(テキストやクリックで対象を指定し、マスクを切り出せるセグメンテーションモデル)を触りながら、いま画像認識が実際にどこまでできて、どこでつまずくのかを確かめてみた。イチゴから始めて、手術器具を並べた滅菌キッティングの映像に進む。見えてきたのは「認識できるか」ではなく、「認識が見ているもの」と「ロボットが掴めるもの」のあいだにある、思ったより深い溝だった。
赤いイチゴだけ、と頼んでみる
赤く熟したイチゴだけ認識したい
ハウス栽培のイチゴが並んだ映像で、まず素直に頼んでみた。SAM 3はテキストで概念を指定すると、画面内で一致するものを全部マスクしてくれる。red strawberry と入れると、たしかに赤い実が次々に切り出されていく。
— ただ、どこからを「赤」とみなすかは、こちらで決められない。
実際に出てきたマスクを見ると、真っ赤な実だけでなく、7割くらい色づいた中間の実まで拾っていた。人間なら「これはまだ早い」と一目で外すグラデーションの途中を、モデルは内部の基準で勝手に線引きする。その閾値はパラメータとして表に出てこない。ripe(熟した)と足しても、印象は変わるが「ここから収穫」という境界を自分の手で動かせるわけではない。認識は「赤いものの集合」を返してくれる。でも「収穫していい赤」を返してくれるわけではなかった。
認識と判断を、分ける
7割くらいのイチゴも認識しているっぽいね
この「拾いすぎ」をどう扱うかで、設計の方針が分かれる。
— 認識に熟度の判断まで兼ねさせると、毎回ブレる。全部取って、後段で仕分ける。
セグメンテーションに「完熟だけ」まで判定させようとすると、モデルの気分次第の境界に振り回される。そうではなく、認識には strawberry で全部の実を取らせてしまう。取りこぼしを最小にすることに振り切る。そのうえで熟度は別の工程に渡し、マスクごとの赤色比率(赤いピクセル数をマスク面積で割る)で閾値を切る。こうすると「どこからが完熟か」を自分の数字で握れる。認識と判断を一つの箱に詰め込まない——このあとも何度も顔を出す考え方だ。
器具を、1本ずつ切り出す
イチゴの次に、毛色の違う素材を試したくなった。病院の滅菌キッティング作業——ステンレスのトレイに手術器具を並べて準備する映像だ。
1本ずつ分けたい
ピック&プレースを前提にするなら、器具がひとかたまりではなく「1本=1オブジェクト」で分かれていてほしい。
— 種類ごとにテキストを入れて、繋がったらクリックで確定する。
イチゴより一段難しい。器具もトレイも同じステンレスで色や明るさの差が小さく、しかもトレイは鏡面で映り込みがある。器具同士も隣接して重なる。手が被るフレームも多い。だから攻め方を素材で変える。金属器具は種類ごとに具体的な英語名で指定し、繋がってしまったらクリックやボックスで1本ずつ確定していく。曖昧な instruments ではなく、こう分ける。
対象 | 入れたテキスト |
|---|---|
ピンセット | tweezers |
剪刀(はさみ) | surgical scissors |
止血鉗子 | hemostat |
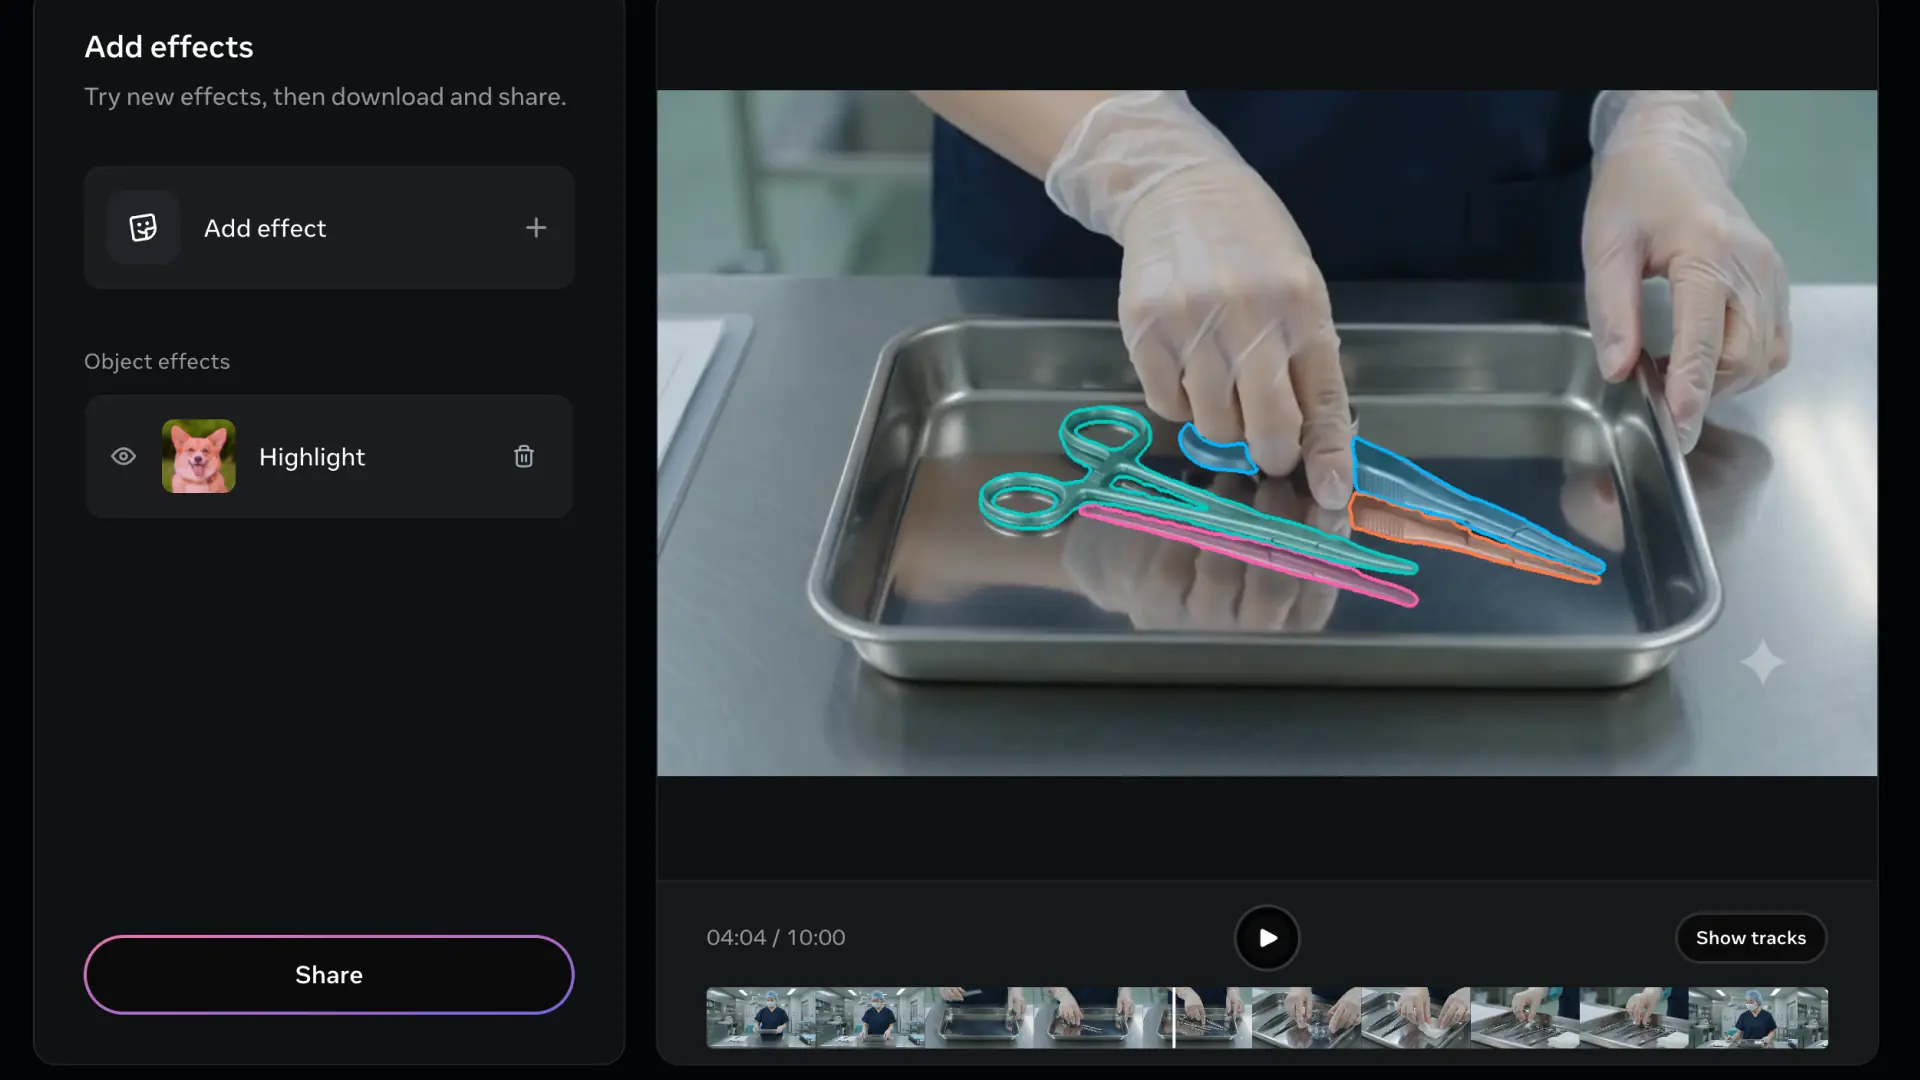
実際にやってみると、鉗子・ピンセット・剪刀が、それぞれ別の色のマスクとして分かれて出てきた。「全部まとめて1個」ではなく、1本ずつ追える状態になる。ここまでは、想像していたより素直に動いた。途中でセッションのタイムアウトや「プロンプトを追加できなかった」というエラーも挟んだが、フレームを選び直して張り直せば動く。デモの作法の範囲だ。
鏡に映った道具も、認識は「ある」と見る
ところが、トレイをよく見ると妙なことが起きていた。
ステンレスのトレイに映るハサミやピンセットまでマスクしてしまう
鏡面のトレイに映り込んだ器具の像——実体のない、ただの反射——にまで、マスクが伸びていた。
— 人は無視できる。でも認識は、そこに「もう1本」を見ている。
私たちは鏡像を一瞬で「これは映り込みだ」と切り捨てる。でもセグメンテーションは、実体と反射を区別しない。器具の「形」がそこにあれば、形として拾う。問題はこれが見た目の粗ではなく、掴む側にとっての実害になることだ。マスクが「ここに器具がある」と言えば、ロボットはそこへ手を伸ばす。映り込みを掴みに行けば、当然なにも掴めない。失敗の原因は、モデルの精度が低いことではない。「物のように見える」と「掴める物である」が、認識の中で同じものとして扱われていることにある。金属の上に金属を置き、鏡面で囲うという、現場ではごく当たり前の環境が、認識にとってはいちばん厄介な舞台になる。
認識は「形」を返す。実体があるかは、別の感覚が要る
ここで効いてくるのが、画像認識の外側の感覚だ。
認識が教えてくれるのは「どこに、どんな形があるか」までだ。そこに質量があるか、硬いか柔らかいか、握って本当に保持できたか——それは形からはわからない。反射には形はあるが手ごたえがない。触覚なら、伸ばした指が空を切った瞬間に「ここには何もない」と即座に返ってくる。
認識が苦手なところを、触覚が埋める。
認識:形・位置・種類を提案する。ただし実体の有無までは保証しない
触覚:接触の有無・硬さ・保持の成否を確認する
視覚が候補を出し、触覚が裏を取る。この二段構えで、はじめて「掴めた」が確定する
これからのロボットにとって、画像認識と触覚は対立する技術ではなく、補い合う感覚になる。視覚が「たぶんここ」を出し、触覚が「本当にあった」を返す。そして、それぞれの精度が上がるほど、組み合わせでできることは足し算ではなく掛け算で増えていく。鏡像に手を伸ばさないロボットは、認識だけを磨いても作れない。逆に言えば、認識と触覚が噛み合った瞬間に、ロボットが任せられる仕事は一気に広がっていく。
認識が返すのは「形」だ。そこに「実体」があるかどうかは、まだ別の感覚が確かめるしかない。