

画像認識と物体検出を学び直す Log#2 | 画素の数字は、読むと・保存すると・撮ると変わる
Log#1 で、画像は数字の格子であると書いた。縦と横に並んだマスがあって、1つのマスに色を表す数字が入っている。第1回はそれを言葉で言っただけだった。この回では、その数字を自分の手で取り出して、書いた通りに読めるのか、保存すると変わるのか、撮った写真ではどうなるのかを、実際に測る。
先に結論を書く。画素の数字は、3つの場所で変わる。読むソフトで変わる。保存で変わる。撮ると変わる。この3つを知らずに「赤いブロックの色は(255,0,0)だ」と思って進むと、後で必ずつまずく。だから最初にここを固めておく。
この回は理屈の話ではない。全部、自分で作った画像と自分で撮った写真から測った数字で話す。
その前に:画像とは何か
画像は、数字が縦横に並んだ格子だ。方眼紙のマス目を思い浮かべてほしい。1つのマスが1画素で、そこに色を表す数字が入っている。
カラー画像なら、1画素につき数字が3つある。赤・緑・青の強さで、それぞれ0から255まで。この3つの組み合わせで色が決まる。
(255, 0, 0) は赤(赤が最大、緑と青がゼロ)
(0, 255, 0) は緑
(0, 0, 255) は青
(255, 255, 255) は白(全部最大)
(0, 0, 0) は黒(全部ゼロ)
なぜ255までなのか。コンピュータは1画素の1色を8ビットで持つ。8ビットで表せる段階は2の8乗で256通り。だから0から255までの256段階になる。
もう1つ、座標の約束がある。画像の原点(左上の角)は、数学のグラフと違って左上にある。そして縦方向のyは下向きに増える。上に行くほどyが小さく、下に行くほどyが大きい。学校で習ったグラフと上下が逆なので、ここは最初に頭を切り替えておく必要がある。
Pillow と OpenCV ── 画像を扱う2つのライブラリ
画像を扱うために、この連載では2つのライブラリ(画像処理の機能をまとめたプログラムの部品集)を使う。どちらもPythonのライブラリだ。
Pillow は、画像を開く・保存する・切り抜くといった基本の処理に使う。使い方が素直で、昔からある定番だ。色を RGB(赤・緑・青の順)で並べる。人が普通に思う順番。
OpenCV は、物体検出や輪郭抽出といった「画像から情報を取り出す」処理に使う。処理が速く、機能が桁違いに多い。このシリーズの後半で主役になる。ただし1つ癖がある。色を BGR(青・緑・赤の順)で並べる。Pillowと逆だ。
なぜ逆なのか。OpenCVが作られた頃、当時のカメラや画像フォーマットがBGRの順で色を並べていた。OpenCVはそれに合わせた。どちらが正しいという話ではなく、歴史的な経緯で違う。ただ、この違いを知らないと事故る。それを最初の実験で見る。
この回で確かめること
理解してほしいのは、次の3つだ。
同じ画像ファイルでも、読むソフトで数字が変わる
画像を保存すると数字が変わる(形式によっては変わらない)
同じ物を撮っても数字は一定にならない
この3つを納得してもらうために、5つの実験をした。前半の3つ(実験A・B・C)は、自分で作った画像を使う。作った画像なら、書いた数字が正解だと最初から分かっているので、読んだ結果が正しいかを検算できる。後半の2つ(実験D・E)は、自分で撮った写真を使う。現実の写真で何が起きるかを見る。
まず、実験に使う画像を自分で作った。
実験に使う画像を作る
撮った写真には正解がない。白い机を撮って画素が150と出ても、それが正しいかを判定する基準がどこにもない。照明もセンサーも保存も全部かかった後の値だからだ。
作った画像なら違う。「ここに(255,0,0)を書く」と自分で決めて書くので、正解は(255,0,0)だと最初から分かっている。読み直して(255,0,0)が出れば正しい。出なければどこかで変わっている。この検算ができる。
512×512の画像を1枚作った。中に4種類の要素を並べてある。
色パッチ7色(既知のRGB値の四角)
いろいろな境界(色の境目・グレーの境目・斜めの境目)
細い線と小さい四角
黒から白へのグラデーション
これを作るスクリプトの全文を載せる。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""gen_base_image.py

測定用のベース画像を1枚生成する。実験A・B・C はすべてこの1枚を使う。

生成画像を使う理由は、書いた値が正解として分かっていること。
撮影画像には正解が存在しないため、読み取りが正しいかを判定できない。

出力:
  base_image.png       512x512 の PNG(可逆・これが正本)
  base_image_spec.json 何をどこに書いたかの記録(測定側はこれを読む)

構造(横帯に分割・帯の境界はすべて8の倍数):
  y   0- 96  色パッチ7色
  y  96-160  グレー同士の縦の境界(x=256・8の倍数)
  y 160-224  グレー同士の縦の境界(x=259・8の倍数ではない)
  y 224-288  赤と青の縦の境界(x=256)
  y 288-352  赤と青の斜めの境界(45度)
  y 352-416  細い線と小さい四角(黒・白背景)
  y 416-480  横方向のグラデーション 0-255
  y 480-512  単色の平らな面(内部の誤差測定用)

帯の境界を8の倍数に揃えているのは、JPEG が 8x8 画素のブロックで処理するため。
帯の境界そのものが誤差を出すと、帯の中に置いた境界の誤差と混ざる。
"""
from __future__ import annotations

import argparse
import hashlib
import json
import sys
from pathlib import Path

import numpy as np
from PIL import Image

SIZE = 512
DEFAULT_OUT = Path("/Volumes/KIOXIA/r2r2r-data/vision/generated/Log02")

# 色パッチ 7色(既知の RGB 値)
PATCH_COLORS = [
    ("red", (255, 0, 0)),
    ("green", (0, 255, 0)),
    ("blue", (0, 0, 255)),
    ("white", (255, 255, 255)),
    ("black", (0, 0, 0)),
    ("grey128", (128, 128, 128)),
    ("brown", (200, 120, 60)),
]
PATCH_BG = (90, 90, 90)      # パッチ帯の背景。白・黒・灰128 のいずれとも重ならない値
PATCH_Y0, PATCH_Y1 = 16, 80
PATCH_W = 64
PATCH_X_STEP = 72
PATCH_X_START = 8

GREY_DARK = (40, 40, 40)
GREY_LIGHT = (215, 215, 215)
EDGE_RED = (200, 30, 30)
EDGE_BLUE = (30, 80, 200)
FLAT_COLOR = (200, 120, 60)

BANDS = [
    ("patches", 0, 96),
    ("grey_edge_aligned", 96, 160),
    ("grey_edge_offgrid", 160, 224),
    ("color_edge_vertical", 224, 288),
    ("color_edge_diagonal", 288, 352),
    ("lines_and_squares", 352, 416),
    ("gradient", 416, 480),
    ("flat", 480, 512),
]

GREY_EDGE_X_ALIGNED = 256    # 8 で割り切れる
GREY_EDGE_X_OFFGRID = 259    # 8 で割り切れない
COLOR_EDGE_X = 256
DIAG_OFFSET = 320            # 斜め境界: (x + (y - band_y0)) < DIAG_OFFSET

H_LINES = [("h_1px", 1, 356), ("h_2px", 2, 364), ("h_3px", 3, 372), ("h_5px", 5, 382)]
H_LINE_X0, H_LINE_X1 = 16, 200
V_LINES = [("v_1px", 1, 220), ("v_2px", 2, 230), ("v_3px", 3, 242), ("v_5px", 5, 256)]
V_LINE_Y0, V_LINE_Y1 = 356, 412
SQUARES = [("sq_2px", 2, 300, 372), ("sq_4px", 4, 312, 372),
           ("sq_8px", 8, 326, 372), ("sq_16px", 16, 346, 372)]
DIAG_LINE = ("diag_1px", 1, 400, 356, 456, 412)   # x0,y0,x1,y1


def build() -> tuple[np.ndarray, dict]:
    img = np.zeros((SIZE, SIZE, 3), dtype=np.uint8)
    spec: dict = {
        "size": [SIZE, SIZE],
        "note": "座標は [x0, y0, x1, y1] の半開区間。x1・y1 は含まない。原点は左上、y は下向き",
        "bands": [],
        "patches": [],
        "edges": [],
        "lines": [],
        "squares": [],
        "gradient": {},
        "flat": {},
    }
    for name, y0, y1 in BANDS:
        spec["bands"].append({"name": name, "y0": y0, "y1": y1})

    yy, xx = np.mgrid[0:SIZE, 0:SIZE]

    # --- 帯1: 色パッチ ---------------------------------------------------
    b0, b1 = 0, 96
    img[b0:b1, :] = PATCH_BG
    for i, (cname, rgb) in enumerate(PATCH_COLORS):
        x0 = PATCH_X_START + i * PATCH_X_STEP
        x1 = x0 + PATCH_W
        img[PATCH_Y0:PATCH_Y1, x0:x1] = rgb
        spec["patches"].append({
            "name": cname, "rgb": list(rgb),
            "x0": x0, "y0": PATCH_Y0, "x1": x1, "y1": PATCH_Y1,
        })
    spec["patch_background_rgb"] = list(PATCH_BG)

    # --- 帯2: グレー縦境界(8の倍数) -------------------------------------
    b0, b1 = 96, 160
    img[b0:b1, :GREY_EDGE_X_ALIGNED] = GREY_DARK
    img[b0:b1, GREY_EDGE_X_ALIGNED:] = GREY_LIGHT
    spec["edges"].append({
        "name": "grey_edge_aligned", "type": "vertical", "x": GREY_EDGE_X_ALIGNED,
        "x_mod_8": GREY_EDGE_X_ALIGNED % 8,
        "band_y0": b0, "band_y1": b1,
        "left_rgb": list(GREY_DARK), "right_rgb": list(GREY_LIGHT),
    })

    # --- 帯3: グレー縦境界(8の倍数ではない) ------------------------------
    b0, b1 = 160, 224
    img[b0:b1, :GREY_EDGE_X_OFFGRID] = GREY_DARK
    img[b0:b1, GREY_EDGE_X_OFFGRID:] = GREY_LIGHT
    spec["edges"].append({
        "name": "grey_edge_offgrid", "type": "vertical", "x": GREY_EDGE_X_OFFGRID,
        "x_mod_8": GREY_EDGE_X_OFFGRID % 8,
        "band_y0": b0, "band_y1": b1,
        "left_rgb": list(GREY_DARK), "right_rgb": list(GREY_LIGHT),
    })

    # --- 帯4: 色の縦境界 --------------------------------------------------
    b0, b1 = 224, 288
    img[b0:b1, :COLOR_EDGE_X] = EDGE_RED
    img[b0:b1, COLOR_EDGE_X:] = EDGE_BLUE
    spec["edges"].append({
        "name": "color_edge_vertical", "type": "vertical", "x": COLOR_EDGE_X,
        "x_mod_8": COLOR_EDGE_X % 8,
        "band_y0": b0, "band_y1": b1,
        "left_rgb": list(EDGE_RED), "right_rgb": list(EDGE_BLUE),
    })

    # --- 帯5: 色の斜め境界 ------------------------------------------------
    b0, b1 = 288, 352
    sub_y = yy[b0:b1] - b0
    sub_x = xx[b0:b1]
    mask = (sub_x + sub_y) < DIAG_OFFSET
    band = np.where(mask[..., None], np.array(EDGE_RED), np.array(EDGE_BLUE))
    img[b0:b1] = band.astype(np.uint8)
    spec["edges"].append({
        "name": "color_edge_diagonal", "type": "diagonal_45",
        "condition": f"(x + (y - {b0})) < {DIAG_OFFSET}",
        "band_y0": b0, "band_y1": b1,
        "inside_rgb": list(EDGE_RED), "outside_rgb": list(EDGE_BLUE),
    })

    # --- 帯6: 細い線と小さい四角(黒・白背景) ------------------------------
    b0, b1 = 352, 416
    img[b0:b1, :] = (255, 255, 255)
    for name, w, y in H_LINES:
        img[y:y + w, H_LINE_X0:H_LINE_X1] = (0, 0, 0)
        spec["lines"].append({"name": name, "orientation": "horizontal", "width_px": w,
                              "x0": H_LINE_X0, "y0": y, "x1": H_LINE_X1, "y1": y + w})
    for name, w, x in V_LINES:
        img[V_LINE_Y0:V_LINE_Y1, x:x + w] = (0, 0, 0)
        spec["lines"].append({"name": name, "orientation": "vertical", "width_px": w,
                              "x0": x, "y0": V_LINE_Y0, "x1": x + w, "y1": V_LINE_Y1})
    dname, dw, dx0, dy0, dx1, dy1 = DIAG_LINE
    n = max(dx1 - dx0, dy1 - dy0)
    for t in range(n):
        px = dx0 + (dx1 - dx0) * t // n
        py = dy0 + (dy1 - dy0) * t // n
        img[py:py + dw, px:px + dw] = (0, 0, 0)
    spec["lines"].append({"name": dname, "orientation": "diagonal_45", "width_px": dw,
                          "x0": dx0, "y0": dy0, "x1": dx1, "y1": dy1})
    for name, s, x, y in SQUARES:
        img[y:y + s, x:x + s] = (0, 0, 0)
        spec["squares"].append({"name": name, "size_px": s,
                                "x0": x, "y0": y, "x1": x + s, "y1": y + s})
    spec["lines_background_rgb"] = [255, 255, 255]
    spec["lines_foreground_rgb"] = [0, 0, 0]

    # --- 帯7: 横方向グラデーション ----------------------------------------
    b0, b1 = 416, 480
    ramp = np.round(np.linspace(0, 255, SIZE)).astype(np.uint8)
    img[b0:b1, :] = ramp[None, :, None]
    spec["gradient"] = {"name": "gradient_horizontal", "direction": "horizontal",
                        "band_y0": b0, "band_y1": b1, "x0": 0, "x1": SIZE,
                        "value_from": 0, "value_to": 255,
                        "formula": "round(linspace(0, 255, 512))[x] を R=G=B に入れる"}

    # --- 帯8: 単色の平らな面 ----------------------------------------------
    b0, b1 = 480, 512
    img[b0:b1, :] = FLAT_COLOR
    spec["flat"] = {"name": "flat_area", "rgb": list(FLAT_COLOR),
                    "x0": 0, "y0": b0, "x1": SIZE, "y1": b1}

    return img, spec


def md5_of(path: Path) -> str:
    h = hashlib.md5()
    with path.open("rb") as f:
        for chunk in iter(lambda: f.read(1024 * 1024), b""):
            h.update(chunk)
    return h.hexdigest()


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--out", default=str(DEFAULT_OUT),
                    help="出力ディレクトリ(既定は KIOXIA の generated/Log02)")
    args = ap.parse_args()
    out_dir = Path(args.out)

    if str(out_dir).startswith("/Volumes/KIOXIA"):
        if not Path("/Volumes/KIOXIA/r2r2r-data").exists():
            print("[ABORT] KIOXIA 未マウント。ローカル fallback しない。", file=sys.stderr)
            sys.exit(1)

    out_png = out_dir / "base_image.png"
    out_spec = out_dir / "base_image_spec.json"
    out_dir.mkdir(parents=True, exist_ok=True)
    for p in (out_png, out_spec):
        if p.exists():
            print(f"[ABORT] 既存ファイルあり(上書き禁止): {p}", file=sys.stderr)
            sys.exit(1)

    img, spec = build()
    Image.fromarray(img, mode="RGB").save(out_png, format="PNG", optimize=False)

    # 画像の同一性は画素配列のハッシュで判定する。
    # PNG のファイル md5 は zlib の実装・バージョンで変わるため、
    # 画素が完全に同一でも環境が違えば別の値になる(DAY299 実測で確認)。
    # file_md5 は「そのファイルが転送中に壊れていないか」の確認にのみ使う。
    spec["output_png"] = out_png.name
    spec["pixel_sha256"] = hashlib.sha256(img.tobytes()).hexdigest()
    spec["pixel_shape"] = list(img.shape)
    spec["pixel_dtype"] = str(img.dtype)
    spec["png_file_md5"] = md5_of(out_png)
    spec["png_file_md5_note"] = (
        "ファイルのバイト列に対する md5。zlib の差で環境ごとに変わるため、"
        "画像の同一性判定には使わない。同一性は pixel_sha256 で判定する"
    )
    spec["png_size_bytes"] = out_png.stat().st_size
    out_spec.write_text(json.dumps(spec, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"{out_png}  {img.shape[1]}x{img.shape[0]}")
    print(f"  pixel_sha256={spec['pixel_sha256']}")
    print(f"  png_file_md5={spec['png_file_md5']}  ({spec['png_size_bytes']} bytes)")
    print(f"{out_spec}  patches={len(spec['patches'])} edges={len(spec['edges'])} "
          f"lines={len(spec['lines'])} squares={len(spec['squares'])}")


if __name__ == "__main__":
    main()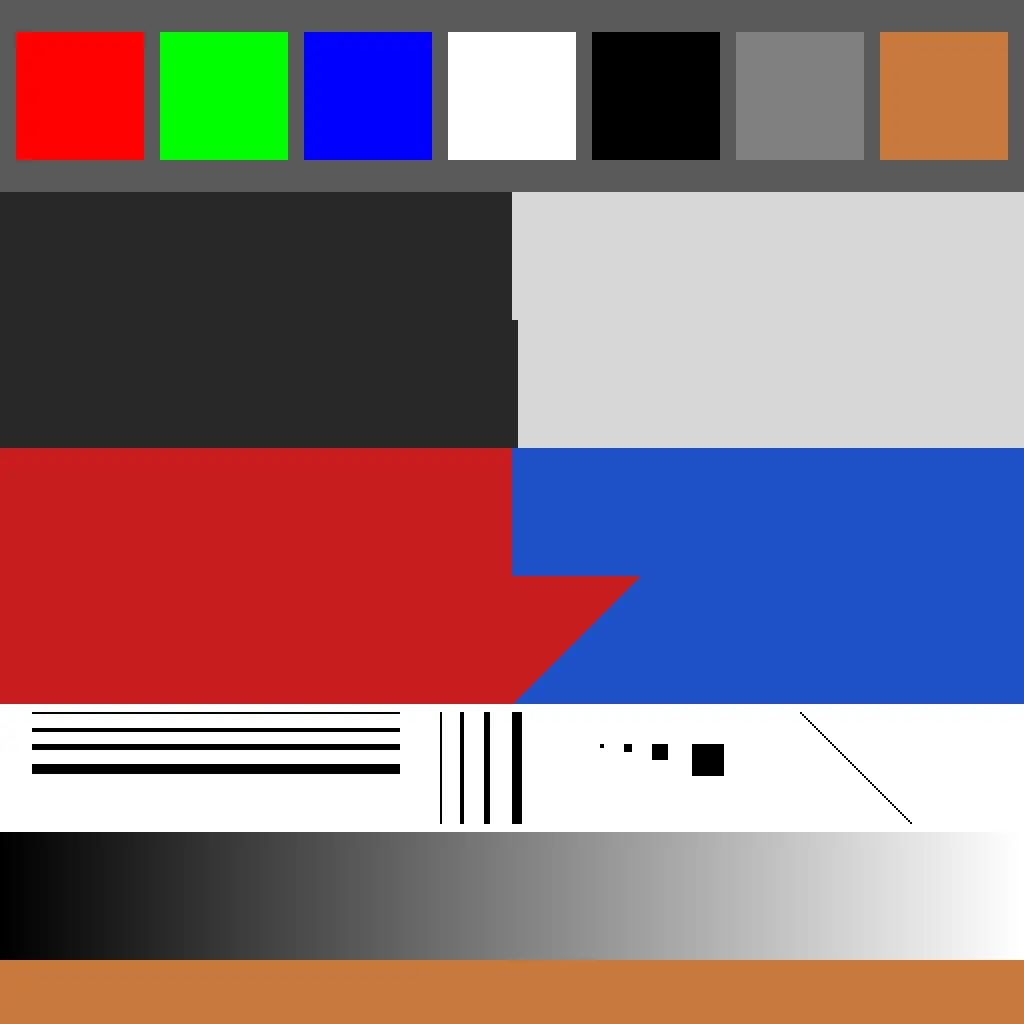
自分で作った512×512のベース画像。上から順に、色パッチ7色/グレーの縦境界2種/赤と青の縦境界/赤と青の斜め境界/細い線と小さい四角/グラデーション/単色の帯。
このスクリプトは画像そのもの(base_image.png)に加えて、何をどこに書いたかの記録(base_image_spec.json)を出す。「redのパッチは座標(40,48)にあり、値は(255,0,0)のはず」という情報だ。測定するとき、この記録を読んで「書いたはずの値」と「読んだ値」を突き合わせる。
実験A:書いた値は、そのまま読めるのか
一番最初に確かめるのはここだ。自分が(255,0,0)と書いた赤が、読み直したときにちゃんと(255,0,0)で返ってくるか。ここが合わないと、この先の実験すべてが疑わしくなる。
7色のパッチを、PillowとOpenCVの両方で読んで、書いた値と比べた。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""measure_generated.py

自分で生成したベース画像 (base_image.png + base_image_spec.json) を対象に
以下 3 実験の測定結果を出す。

  実験A: 書いた値がそのまま読めるか (Pillow / OpenCV の RGB vs BGR).
  実験B: 保存形式 (PNG / JPEG q95/75/50) で値がどれだけ変わるか.
  実験C: 縮小 (1/2, 1/4, 1/8) × 補間 (NEAREST/BILINEAR/AREA) で
         線・矩形の黒画素がどう変化するか.

色変換はしない (Display P3 のまま扱う・ImageCms 不使用). OpenCV cvtColor も不使用.
sRGB 変換は本スクリプトの責務ではない.

Inputs:
  /Volumes/KIOXIA/r2r2r-data/vision/generated/Log02/base_image.png
  /Volumes/KIOXIA/r2r2r-data/vision/generated/Log02/base_image_spec.json

Outputs (既存ファイルがあれば ABORT):
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/exp_a_patch_values.csv
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/exp_b_compression.csv
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/exp_c_resolution.csv
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/run_meta_generated.json
"""
from __future__ import annotations

import csv
import hashlib
import io
import json
import sys
from datetime import datetime
from pathlib import Path

import numpy as np
from PIL import Image

try:
    import cv2
    _OPENCV_VERSION = cv2.__version__
except Exception:
    cv2 = None
    _OPENCV_VERSION = None


# ---- 定数 --------------------------------------------------------------------
KIOXIA_ROOT = Path("/Volumes/KIOXIA/r2r2r-data")
INPUT_DIR = KIOXIA_ROOT / "vision" / "generated" / "Log02"
OUTPUT_DIR = KIOXIA_ROOT / "vision" / "measurements" / "Log02"
INPUT_PNG = INPUT_DIR / "base_image.png"
INPUT_SPEC = INPUT_DIR / "base_image_spec.json"

# 継ぎ目 8px を避ける規約 (DAY299 実測: JPEG で誤差が 20 倍に跳ねる).
EDGE_MARGIN_PX = 8
# 縦境界の左右幅.
V_EDGE_HALF = 16
# 黒判定閾値 (RGB 合計 < 200).
BLACK_SUM_THRESHOLD = 200

# 実験 B の測定領域名 (この順序で書く).
EXP_B_REGIONS = [
    "grey_edge_aligned",
    "grey_edge_offgrid",
    "color_edge_vertical",
    "color_edge_diagonal",
    "flat_interior",
    "gradient",
]

# 実験 B の保存形式 (この順序で書く).
EXP_B_FORMATS = [
    ("PNG", None),
    ("JPEG", 95),
    ("JPEG", 75),
    ("JPEG", 50),
]

# 実験 C の縮小率と補間.
EXP_C_SCALES = [("1/2", 2), ("1/4", 4), ("1/8", 8)]
EXP_C_INTERPS = [
    ("NEAREST", Image.NEAREST),
    ("BILINEAR", Image.BILINEAR),
    ("AREA", Image.BOX),   # BOX が面積平均 (AREA 相当)
]

EXP_A_COLS = [
    "patch", "center_x", "center_y",
    "written_r", "written_g", "written_b",
    "pillow_r", "pillow_g", "pillow_b",
    "opencv_r", "opencv_g", "opencv_b",
    "pillow_match", "opencv_match",
]
EXP_B_COLS = [
    "region", "format", "quality",
    "max_diff", "mean_diff",
    "nonzero_pixels", "nonzero_ratio_pct",
    "file_bytes",
]
EXP_C_COLS = [
    "object", "object_type",
    "orig_black_pixels", "scale", "interp",
    "black_pixels_after", "black_ratio_pct",
    "max_diff", "mean_diff",
]


def _abort(msg: str, code: int = 1) -> None:
    print(msg, file=sys.stderr)
    sys.exit(code)


def _edge_by_name(edges: list, name: str) -> dict:
    for e in edges:
        if e.get("name") == name:
            return e
    _abort(f"[ABORT] spec.edges に '{name}' が無い")
    return {}


def _region_slice_vertical_edge(edge: dict, W: int) -> tuple:
    """縦境界: (y0, y1, x0, x1) を返す. x は境界 ±V_EDGE_HALF (画像端でクランプ)."""
    x = int(edge["x"])
    band_y0 = int(edge["band_y0"])
    band_y1 = int(edge["band_y1"])
    y0 = band_y0 + EDGE_MARGIN_PX
    y1 = band_y1 - EDGE_MARGIN_PX
    x0 = max(0, x - V_EDGE_HALF)
    x1 = min(W, x + V_EDGE_HALF)
    return y0, y1, x0, x1


def _region_slice_full_band(band_y0: int, band_y1: int,
                            x0_raw: int, x1_raw: int) -> tuple:
    y0 = band_y0 + EDGE_MARGIN_PX
    y1 = band_y1 - EDGE_MARGIN_PX
    return y0, y1, x0_raw, x1_raw


def _build_exp_b_regions(spec: dict, W: int) -> dict:
    """region_name -> (y0, y1, x0, x1) の dict を返す."""
    edges = spec["edges"]
    flat = spec["flat"]
    grad = spec["gradient"]

    color_diag = _edge_by_name(edges, "color_edge_diagonal")

    return {
        "grey_edge_aligned":
            _region_slice_vertical_edge(_edge_by_name(edges, "grey_edge_aligned"), W),
        "grey_edge_offgrid":
            _region_slice_vertical_edge(_edge_by_name(edges, "grey_edge_offgrid"), W),
        "color_edge_vertical":
            _region_slice_vertical_edge(_edge_by_name(edges, "color_edge_vertical"), W),
        # diagonal は帯全幅 (画像左端〜右端).
        "color_edge_diagonal":
            _region_slice_full_band(
                int(color_diag["band_y0"]), int(color_diag["band_y1"]),
                0, W),
        "flat_interior":
            _region_slice_full_band(
                int(flat["y0"]), int(flat["y1"]),
                int(flat["x0"]), int(flat["x1"])),
        "gradient":
            _region_slice_full_band(
                int(grad["band_y0"]), int(grad["band_y1"]),
                int(grad["x0"]), int(grad["x1"])),
    }


def _diff_stats(a: np.ndarray, b: np.ndarray) -> tuple:
    """(max_diff:int, mean_diff:float, nonzero_pixels:int, total_pixels:int).
    a,b は同形状 (H,W,3) uint8. diff は絶対値.
    nonzero_pixels は「3 ch のどれかが 0 でない画素数」.
    """
    d = np.abs(a.astype(np.int16) - b.astype(np.int16))  # (H,W,3), 0..255
    max_diff = int(d.max()) if d.size else 0
    mean_diff = float(d.mean()) if d.size else 0.0
    any_nonzero = (d != 0).any(axis=2)
    nonzero_pixels = int(any_nonzero.sum())
    total_pixels = int(a.shape[0] * a.shape[1])
    return max_diff, mean_diff, nonzero_pixels, total_pixels


def _save_bytes(im: Image.Image, fmt: str, quality) -> bytes:
    buf = io.BytesIO()
    if fmt == "PNG":
        im.save(buf, format="PNG")
    elif fmt == "JPEG":
        im.save(buf, format="JPEG", quality=int(quality))
    else:
        raise ValueError(f"unsupported fmt: {fmt}")
    return buf.getvalue()


def _read_bytes_as_rgb(data: bytes) -> np.ndarray:
    with Image.open(io.BytesIO(data)) as im:
        return np.asarray(im.convert("RGB"))


def main() -> None:
    # ---- KIOXIA マウント確認 (ローカル fallback 禁止) ------------------------
    if not KIOXIA_ROOT.exists():
        _abort(f"[ABORT] KIOXIA 未マウント: {KIOXIA_ROOT} が存在しない。"
               "ローカル fallback しない。")
    if not INPUT_PNG.is_file():
        _abort(f"[ABORT] 入力画像なし: {INPUT_PNG}")
    if not INPUT_SPEC.is_file():
        _abort(f"[ABORT] spec なし: {INPUT_SPEC}")
    if cv2 is None:
        _abort("[ABORT] cv2 (opencv-python) が import できない。"
               "実験 A で cv2.imread が必要。")

    # ---- 出力先準備 & 既存ファイル検査 ------------------------------------
    out_a = OUTPUT_DIR / "exp_a_patch_values.csv"
    out_b = OUTPUT_DIR / "exp_b_compression.csv"
    out_c = OUTPUT_DIR / "exp_c_resolution.csv"
    out_meta = OUTPUT_DIR / "run_meta_generated.json"
    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    for p in (out_a, out_b, out_c, out_meta):
        if p.exists():
            _abort(f"[ABORT] 既存ファイルあり (上書き禁止): {p}")

    # ---- spec 読み込み ----------------------------------------------------
    spec = json.loads(INPUT_SPEC.read_text(encoding="utf-8"))
    size = spec["size"]
    W, H = int(size[0]), int(size[1])

    # ---- 画像読み込み (Pillow が基準・OpenCV は実験 A のみ) ---------------
    with Image.open(INPUT_PNG) as im_raw:
        base_pil = np.asarray(im_raw.convert("RGB"))  # (H, W, 3) uint8 RGB
    if base_pil.shape[:2] != (H, W):
        _abort(f"[ABORT] 画像サイズ不一致 pil={base_pil.shape[:2]} spec=({H},{W})")
    input_png_pixel_sha256 = hashlib.sha256(base_pil.tobytes()).hexdigest()
    spec_pixel_sha256 = spec.get("pixel_sha256", "")
    pixel_sha256_match = (input_png_pixel_sha256 == spec_pixel_sha256)

    base_cv = cv2.imread(str(INPUT_PNG))  # (H, W, 3) uint8 BGR (変換しない)
    if base_cv is None:
        _abort(f"[ABORT] cv2.imread 失敗: {INPUT_PNG}")

    # =====================================================================
    # 実験 A
    # =====================================================================
    exp_a_rows = []
    for patch in spec["patches"]:
        name = patch["name"]
        wr, wg, wb = [int(v) for v in patch["rgb"]]
        x0 = int(patch["x0"]); y0 = int(patch["y0"])
        x1 = int(patch["x1"]); y1 = int(patch["y1"])
        cx = (x0 + x1) // 2
        cy = (y0 + y1) // 2
        pr, pg, pb = [int(v) for v in base_pil[cy, cx]]
        # OpenCV は BGR のまま出す (変換しない・実験 A の主眼).
        or_, og_, ob_ = [int(v) for v in base_cv[cy, cx]]
        exp_a_rows.append({
            "patch": name,
            "center_x": cx,
            "center_y": cy,
            "written_r": wr, "written_g": wg, "written_b": wb,
            "pillow_r": pr, "pillow_g": pg, "pillow_b": pb,
            "opencv_r": or_, "opencv_g": og_, "opencv_b": ob_,
            "pillow_match": ((wr, wg, wb) == (pr, pg, pb)),
            "opencv_match": ((wr, wg, wb) == (or_, og_, ob_)),
        })

    with out_a.open("w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=EXP_A_COLS)
        w.writeheader()
        for row in exp_a_rows:
            w.writerow(row)

    # =====================================================================
    # 実験 B
    # =====================================================================
    regions = _build_exp_b_regions(spec, W)

    # 各フォーマットで 1 回だけ保存 → 再読込みして 6 領域で切り出す.
    reread_by_fmt: dict = {}   # key: (fmt, quality) -> (arr, file_bytes)
    for fmt, quality in EXP_B_FORMATS:
        # PNG 用に Pillow Image を毎回作る (副作用を避ける).
        im_for_save = Image.fromarray(base_pil, mode="RGB")
        data = _save_bytes(im_for_save, fmt, quality)
        rr = _read_bytes_as_rgb(data)
        reread_by_fmt[(fmt, quality)] = (rr, len(data))

    exp_b_rows = []
    for region_name in EXP_B_REGIONS:
        y0, y1, x0, x1 = regions[region_name]
        base_slice = base_pil[y0:y1, x0:x1, :]
        for fmt, quality in EXP_B_FORMATS:
            rr, file_bytes = reread_by_fmt[(fmt, quality)]
            rr_slice = rr[y0:y1, x0:x1, :]
            max_d, mean_d, nz, total = _diff_stats(base_slice, rr_slice)
            ratio_pct = (nz / total * 100.0) if total > 0 else 0.0
            exp_b_rows.append({
                "region": region_name,
                "format": fmt,
                "quality": "" if quality is None else int(quality),
                "max_diff": max_d,
                "mean_diff": f"{mean_d:.3f}",
                "nonzero_pixels": nz,
                "nonzero_ratio_pct": f"{ratio_pct:.1f}",
                "file_bytes": file_bytes,
            })

    with out_b.open("w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=EXP_B_COLS)
        w.writeheader()
        for row in exp_b_rows:
            w.writerow(row)

    # =====================================================================
    # 実験 C
    # =====================================================================
    # 物体リスト: 9 lines + 4 squares. name / x0..y1 / type.
    objects = []
    for ln in spec["lines"]:
        objects.append({
            "name": ln["name"], "type": "line",
            "x0": int(ln["x0"]), "y0": int(ln["y0"]),
            "x1": int(ln["x1"]), "y1": int(ln["y1"]),
        })
    for sq in spec["squares"]:
        objects.append({
            "name": sq["name"], "type": "square",
            "x0": int(sq["x0"]), "y0": int(sq["y0"]),
            "x1": int(sq["x1"]), "y1": int(sq["y1"]),
        })

    # 元画像での「黒画素数」を物体ごとに 1 度だけ計算 (全 scale/interp で共通).
    orig_black_by_obj: dict = {}
    for obj in objects:
        s = base_pil[obj["y0"]:obj["y1"], obj["x0"]:obj["x1"], :]
        sums = s.astype(np.int32).sum(axis=2)
        orig_black_by_obj[obj["name"]] = int((sums < BLACK_SUM_THRESHOLD).sum())

    im_base_pil = Image.fromarray(base_pil, mode="RGB")

    exp_c_rows = []
    for scale_str, f_div in EXP_C_SCALES:
        new_w = W // f_div
        new_h = H // f_div
        for interp_name, interp_flag in EXP_C_INTERPS:
            small = im_base_pil.resize((new_w, new_h), resample=interp_flag)
            # 元サイズへは NEAREST で戻す (比較のためだけの復元).
            restored = small.resize((W, H), resample=Image.NEAREST)
            restored_arr = np.asarray(restored.convert("RGB"))
            for obj in objects:
                y0, y1 = obj["y0"], obj["y1"]
                x0, x1 = obj["x0"], obj["x1"]
                base_slice = base_pil[y0:y1, x0:x1, :]
                rest_slice = restored_arr[y0:y1, x0:x1, :]
                sums_r = rest_slice.astype(np.int32).sum(axis=2)
                black_after = int((sums_r < BLACK_SUM_THRESHOLD).sum())
                orig_black = orig_black_by_obj[obj["name"]]
                if orig_black > 0:
                    ratio_pct_str = f"{(black_after / orig_black * 100.0):.1f}"
                else:
                    ratio_pct_str = ""
                max_d, mean_d, _, _ = _diff_stats(base_slice, rest_slice)
                exp_c_rows.append({
                    "object": obj["name"],
                    "object_type": obj["type"],
                    "orig_black_pixels": orig_black,
                    "scale": scale_str,
                    "interp": interp_name,
                    "black_pixels_after": black_after,
                    "black_ratio_pct": ratio_pct_str,
                    "max_diff": max_d,
                    "mean_diff": f"{mean_d:.3f}",
                })

    with out_c.open("w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=EXP_C_COLS)
        w.writeheader()
        for row in exp_c_rows:
            w.writerow(row)

    # =====================================================================
    # run_meta.json
    # =====================================================================
    meta = {
        "executed_at": datetime.now().astimezone().isoformat(),
        "script_path": str(Path(__file__).resolve()),
        "python_version": sys.version,
        "library_versions": {
            "numpy": np.__version__,
            "Pillow": Image.__version__,
            "opencv": _OPENCV_VERSION,
        },
        "input_png": str(INPUT_PNG),
        "input_png_pixel_sha256": input_png_pixel_sha256,
        "spec_pixel_sha256": spec_pixel_sha256,
        "pixel_sha256_match": pixel_sha256_match,
        "outputs": [
            "exp_a_patch_values.csv",
            "exp_b_compression.csv",
            "exp_c_resolution.csv",
            "run_meta_generated.json",
        ],
    }
    with out_meta.open("w", encoding="utf-8") as f:
        json.dump(meta, f, ensure_ascii=False, indent=2)

    # ---- 標準出力: 実験 A/B/C の行数 (合否コメントなし) --------------------
    print(f"exp_a rows={len(exp_a_rows)}")
    print(f"exp_b rows={len(exp_b_rows)}")
    print(f"exp_c rows={len(exp_c_rows)}")


if __name__ == "__main__":
    main()
結果はこうなった。
patch,center_x,center_y,written_r,written_g,written_b,pillow_r,pillow_g,pillow_b,opencv_r,opencv_g,opencv_b,pillow_match,opencv_match
red,40,48,255,0,0,255,0,0,0,0,255,True,False
green,112,48,0,255,0,0,255,0,0,255,0,True,True
blue,184,48,0,0,255,0,0,255,255,0,0,True,False
white,256,48,255,255,255,255,255,255,255,255,255,True,True
black,328,48,0,0,0,0,0,0,0,0,0,True,True
grey128,400,48,128,128,128,128,128,128,128,128,128,True,True
brown,472,48,200,120,60,200,120,60,60,120,200,True,False
読み方はこうだ。
Pillowの列(pillow_r,g,b)を見ると、7色すべてが書いた値と一致している。赤は(255,0,0)、緑は(0,255,0)。書いた通りに読めている。pillow_matchの列が全部Trueなのがその証拠だ。
問題はOpenCVの列(opencv_r,g,b)だ。赤を見てほしい。書いた値は(255,0,0)なのに、OpenCVは(0,0,255)を返している。青は逆に、書いた(0,0,255)が(255,0,0)になっている。茶色(200,120,60)は(60,120,200)だ。
これがBGRの並びだ。OpenCVは赤・緑・青を、青・緑・赤の順で返す。だから両端の赤と青が入れ替わり、真ん中の緑はそのまま。緑・白・黒・灰が一致しているように見えるのは、これらが左右対称(RとBが同じ値)だから、入れ替わっても気づけないだけだ。
同じ1つのファイルを読んでいる。 中身は何も変わっていない。それでも、読むソフトが違うと数字が入れ替わって出てくる。
だからこのシリーズでは、これ以降どのコードでも「この数字はPillowで読んだのか、OpenCVで読んだのか」を必ず意識する。これを間違えると、赤い物を青と判定して、後の処理が全部ずれる。
実験B:保存すると、数字は変わるのか
次は保存の話だ。画像をファイルに保存して、また開く。このとき数字は変わるのか。
保存形式には種類がある。今回はPNGとJPEGを比べた。
PNG は画質を落とさずに保存する。そのかわりファイルが大きくなる
JPEG はファイルを小さくするために、画質を少し捨てる。写真でよく使う形式
JPEGがどうやってファイルを小さくするかというと、画像を8×8画素の小さなマスに区切って、マスごとに「だいたいこんな色」とざっくり記録する。細かい部分を捨てるから軽くなる。つまり、保存して開き直すと、元の数字と少し違う数字になるはずだ。それを測る。
同じベース画像を、PNG・JPEG(品質95)・JPEG(品質75)・JPEG(品質50)の4つで保存し、開き直して、元の数字とどれだけ違うかを場所ごとに測った。測定に使ったのは実験Aと同じ measure_generated.py だ。
region,format,quality,max_diff,mean_diff,nonzero_pixels,nonzero_ratio_pct,file_bytes
grey_edge_aligned,PNG,,0,0.000,0,0.0,2525
grey_edge_aligned,JPEG,95,0,0.000,0,0.0,12029
grey_edge_aligned,JPEG,75,0,0.000,0,0.0,9376
grey_edge_aligned,JPEG,50,1,0.500,768,50.0,8486
grey_edge_offgrid,PNG,,0,0.000,0,0.0,2525
grey_edge_offgrid,JPEG,95,1,0.031,48,3.1,12029
grey_edge_offgrid,JPEG,75,4,0.281,240,15.6,9376
grey_edge_offgrid,JPEG,50,7,0.781,816,53.1,8486
color_edge_vertical,PNG,,0,0.000,0,0.0,2525
color_edge_vertical,JPEG,95,43,2.344,816,53.1,12029
color_edge_vertical,JPEG,75,43,2.635,1536,100.0,9376
color_edge_vertical,JPEG,50,44,3.125,1536,100.0,8486
color_edge_diagonal,PNG,,0,0.000,0,0.0,2525
color_edge_diagonal,JPEG,95,72,0.584,11172,45.5,12029
color_edge_diagonal,JPEG,75,86,1.073,24576,100.0,9376
color_edge_diagonal,JPEG,50,80,1.730,24576,100.0,8486
flat_interior,PNG,,0,0.000,0,0.0,2525
flat_interior,JPEG,95,1,0.333,8192,100.0,12029
flat_interior,JPEG,75,1,0.333,8192,100.0,9376
flat_interior,JPEG,50,4,1.667,8192,100.0,8486
gradient,PNG,,0,0.000,0,0.0,2525
gradient,JPEG,95,0,0.000,0,0.0,12029
gradient,JPEG,75,1,0.500,12288,50.0,9376
gradient,JPEG,50,1,0.496,12192,49.6,8486
max_diffの列が、元の数字とのズレの最大値だ。順番に見ていく。
まずPNG。どの場所もmax_diffが0だ。PNGは画質を捨てないので、保存して開いても数字が1つも変わらない。PNGは値を変えない。 これが基準になる。
次にJPEG。ここで場所によって大きく差が出る。
平らな面(flat_interior)を見ると、品質95で最大1、品質50でも最大4。あまり変わらない。色が一定の場所では、JPEGでもほとんど捨てる情報がない。
ところが色の境目(color_edge_vertical、赤と青が接している所)を見ると、品質95で最大43。斜めの境目(color_edge_diagonal)はもっと悪くて、品質75で最大86だ。0から255の数字で86ずれるのは大きい。
なぜ境目が悪いのか。JPEGは色が急に変わる場所が苦手で、そこで一番情報を捨てるからだ。特に斜めの境目は、8×8のマスの多くを斜めに横切るので、境目が入るマスが増える。
もう1つ面白い結果がある。グレー同士の境目を2つ用意した。1つは境目を8で割り切れる位置(256画素目)に、もう1つは割り切れない位置(259画素目)に置いた。8で割り切れる方(grey_edge_aligned)は品質95でも誤差0、品質50でようやく1。割り切れない方(grey_edge_offgrid)は品質75で4ずれる。
JPEGのマスは8×8だから、境目がちょうどマスの継ぎ目に乗ると、各マスの中が単色になって捨てるものがない。境目を3画素ずらすだけで、結果が変わる。
ここから結論が出る。測定に使う画像はPNGで保存する。 JPEGを使うと、後で色を測っても、それが本当の色かJPEGがずらした色か分からなくなる。PNGなら値が変わらないので、測った数字を信用できる。これは以降の全部のLogの前提にする。
実験C:縮小すると、何が消えるのか
3つ目は解像度の話だ。画像を小さくすると、細かいものは消える。どこまで細いと消えるのかを測る。
ベース画像に、太さの違う線(線幅1・2・3・5画素)と、大きさの違う四角(一辺2・4・8・16画素)を入れてある。これを1/2・1/4・1/8に縮小して、また元のサイズに戻し、線や四角が残っているか(黒い画素が残っているか)を数えた。
縮小のやり方には種類がある。今回は3つ試した。
NEAREST … 単純に画素を間引く。速いが乱暴
BILINEAR … 近くの画素を混ぜて滑らかにする
AREA … 範囲の平均を取る。縮小に向いている
同じ縮小率でも、やり方によって結果が変わる。117行の測定結果のうち、線幅1画素の横線と、小さい四角の部分を抜き出して見る。
object,object_type,orig_black_pixels,scale,interp,black_pixels_after,black_ratio_pct,max_diff,mean_diff
h_1px,line,184,1/2,NEAREST,0,0.0,255,255.000
h_2px,line,368,1/2,NEAREST,368,100.0,0,0.000
h_3px,line,552,1/2,NEAREST,368,66.7,255,85.000
h_5px,line,920,1/2,NEAREST,736,80.0,255,51.000
v_1px,line,56,1/2,NEAREST,0,0.0,255,255.000
v_2px,line,112,1/2,NEAREST,112,100.0,0,0.000
v_3px,line,168,1/2,NEAREST,112,66.7,255,85.000
v_5px,line,280,1/2,NEAREST,224,80.0,255,51.000
diag_1px,line,56,1/2,NEAREST,112,200.0,255,4.554
sq_2px,square,4,1/2,NEAREST,4,100.0,0,0.000
sq_4px,square,16,1/2,NEAREST,16,100.0,0,0.000
sq_8px,square,64,1/2,NEAREST,64,100.0,0,0.000
sq_16px,square,256,1/2,NEAREST,256,100.0,0,0.000
h_1px,line,184,1/2,BILINEAR,0,0.0,171,159.261
h_2px,line,368,1/2,BILINEAR,360,97.8,88,64.522
h_3px,line,552,1/2,BILINEAR,368,66.7,144,64.522
h_5px,line,920,1/2,BILINEAR,736,80.0,144,38.991
v_1px,line,56,1/2,BILINEAR,0,0.0,171,159.857
v_2px,line,112,1/2,BILINEAR,104,92.9,88,65.714
v_3px,line,168,1/2,BILINEAR,112,66.7,144,65.714
v_5px,line,280,1/2,BILINEAR,224,80.0,144,40.343
diag_1px,line,56,1/2,BILINEAR,0,0.0,179,6.207
sq_2px,square,4,1/2,BILINEAR,0,0.0,112,112.000
sq_4px,square,16,1/2,BILINEAR,16,100.0,60,60.000
sq_8px,square,64,1/2,BILINEAR,64,100.0,60,31.000
sq_16px,square,256,1/2,BILINEAR,256,100.0,60,15.750
h_1px,line,184,1/2,AREA,0,0.0,128,128.000
h_2px,line,368,1/2,AREA,368,100.0,0,0.000
h_3px,line,552,1/2,AREA,368,66.7,128,42.667
h_5px,line,920,1/2,AREA,736,80.0,128,25.600
v_1px,line,56,1/2,AREA,0,0.0,128,128.000
v_2px,line,112,1/2,AREA,112,100.0,0,0.000
v_3px,line,168,1/2,AREA,112,66.7,128,42.667
v_5px,line,280,1/2,AREA,224,80.0,128,25.600
diag_1px,line,56,1/2,AREA,0,0.0,128,4.554
sq_2px,square,4,1/2,AREA,4,100.0,0,0.000
sq_4px,square,16,1/2,AREA,16,100.0,0,0.000
sq_8px,square,64,1/2,AREA,64,100.0,0,0.000
sq_16px,square,256,1/2,AREA,256,100.0,0,0.000
h_1px,line,184,1/4,NEAREST,0,0.0,255,255.000
h_2px,line,368,1/4,NEAREST,0,0.0,255,255.000
h_3px,line,552,1/4,NEAREST,552,100.0,0,0.000
h_5px,line,920,1/4,NEAREST,920,100.0,0,0.000
v_1px,line,56,1/4,NEAREST,0,0.0,255,255.000
v_2px,line,112,1/4,NEAREST,112,100.0,0,0.000
v_3px,line,168,1/4,NEAREST,112,66.7,255,85.000
v_5px,line,280,1/4,NEAREST,224,80.0,255,51.000
diag_1px,line,56,1/4,NEAREST,224,400.0,255,13.661
sq_2px,square,4,1/4,NEAREST,0,0.0,255,255.000
sq_4px,square,16,1/4,NEAREST,16,100.0,0,0.000
sq_8px,square,64,1/4,NEAREST,48,75.0,255,63.750
sq_16px,square,256,1/4,NEAREST,224,87.5,255,31.875
h_1px,line,184,1/4,BILINEAR,0,0.0,220,215.217
h_2px,line,368,1/4,BILINEAR,0,0.0,171,159.522
h_3px,line,552,1/4,BILINEAR,0,0.0,123,104.826
h_5px,line,920,1/4,BILINEAR,0,0.0,144,95.278
v_1px,line,56,1/4,BILINEAR,0,0.0,220,215.714
v_2px,line,112,1/4,BILINEAR,0,0.0,171,160.714
v_3px,line,168,1/4,BILINEAR,0,0.0,192,152.857
v_5px,line,280,1/4,BILINEAR,192,68.6,192,71.943
diag_1px,line,56,1/4,BILINEAR,0,0.0,216,7.497
sq_2px,square,4,1/4,BILINEAR,0,0.0,219,219.000
sq_4px,square,16,1/4,BILINEAR,0,0.0,112,112.000
sq_8px,square,64,1/4,BILINEAR,32,50.0,144,88.000
sq_16px,square,256,1/4,BILINEAR,192,75.0,144,46.000
h_1px,line,184,1/4,AREA,0,0.0,191,191.000
h_2px,line,368,1/4,AREA,0,0.0,128,128.000
h_3px,line,552,1/4,AREA,552,100.0,64,64.000
h_5px,line,920,1/4,AREA,552,60.0,128,89.600
v_1px,line,56,1/4,AREA,0,0.0,191,191.000
v_2px,line,112,1/4,AREA,0,0.0,128,128.000
v_3px,line,168,1/4,AREA,0,0.0,191,149.000
v_5px,line,280,1/4,AREA,224,80.0,191,38.200
diag_1px,line,56,1/4,AREA,0,0.0,191,6.839
sq_2px,square,4,1/4,AREA,0,0.0,192,192.000
sq_4px,square,16,1/4,AREA,16,100.0,0,0.000
sq_8px,square,64,1/4,AREA,32,50.0,128,64.000
sq_16px,square,256,1/4,AREA,192,75.0,128,32.000
h_1px,line,184,1/8,NEAREST,184,100.0,0,0.000
h_2px,line,368,1/8,NEAREST,368,100.0,0,0.000
h_3px,line,552,1/8,NEAREST,552,100.0,0,0.000
h_5px,line,920,1/8,NEAREST,0,0.0,255,255.000
v_1px,line,56,1/8,NEAREST,52,92.9,255,18.214
v_2px,line,112,1/8,NEAREST,0,0.0,255,255.000
v_3px,line,168,1/8,NEAREST,156,92.9,255,18.214
v_5px,line,280,1/8,NEAREST,260,92.9,255,18.214
diag_1px,line,56,1/8,NEAREST,0,0.0,255,4.554
sq_2px,square,4,1/8,NEAREST,4,100.0,0,0.000
sq_4px,square,16,1/8,NEAREST,0,0.0,255,255.000
sq_8px,square,64,1/8,NEAREST,24,37.5,255,159.375
sq_16px,square,256,1/8,NEAREST,168,65.6,255,87.656
h_1px,line,184,1/8,BILINEAR,0,0.0,222,204.348
h_2px,line,368,1/8,BILINEAR,0,0.0,204,197.609
h_3px,line,552,1/8,BILINEAR,0,0.0,180,169.957
h_5px,line,920,1/8,BILINEAR,0,0.0,178,166.809
v_1px,line,56,1/8,BILINEAR,0,0.0,233,224.357
v_2px,line,112,1/8,BILINEAR,0,0.0,227,213.214
v_3px,line,168,1/8,BILINEAR,0,0.0,205,172.429
v_5px,line,280,1/8,BILINEAR,0,0.0,179,135.452
diag_1px,line,56,1/8,BILINEAR,0,0.0,240,9.852
sq_2px,square,4,1/8,BILINEAR,0,0.0,243,243.000
sq_4px,square,16,1/8,BILINEAR,0,0.0,219,219.000
sq_8px,square,64,1/8,BILINEAR,0,0.0,219,180.750
sq_16px,square,256,1/8,BILINEAR,64,25.0,219,104.375
h_1px,line,184,1/8,AREA,0,0.0,223,223.000
h_2px,line,368,1/8,AREA,0,0.0,191,191.000
h_3px,line,552,1/8,AREA,0,0.0,159,159.000
h_5px,line,920,1/8,AREA,0,0.0,191,171.800
v_1px,line,56,1/8,AREA,0,0.0,239,225.286
v_2px,line,112,1/8,AREA,0,0.0,223,195.571
v_3px,line,168,1/8,AREA,0,0.0,207,165.857
v_5px,line,280,1/8,AREA,0,0.0,176,107.429
diag_1px,line,56,1/8,AREA,0,0.0,239,8.227
sq_2px,square,4,1/8,AREA,0,0.0,239,239.000
sq_4px,square,16,1/8,AREA,0,0.0,192,192.000
sq_8px,square,64,1/8,AREA,0,0.0,223,175.750
sq_16px,square,256,1/8,AREA,112,43.8,223,99.875
線幅1画素の横線(h_1px、元の黒画素は184)を見てほしい。
1/2に縮小しただけで、NEARESTでもAREAでも黒画素が0になる。線幅1画素の線は、半分に縮小しただけで消える。
面白いのは1/8のときだ。NEARESTだと黒画素が184のまま残っているのに、AREAだと0になる。同じ1/8縮小なのに、やり方で結果が正反対だ。
なぜか。NEARESTは画素を間引くので、たまたま線の上を拾えば線がそのまま残る。AREAは範囲を平均するので、細い黒線は周りの白に薄められて、黒と判定されなくなる。
つまり「縮小すると消える」は単純な話ではない。どう縮小するかで、何が残るかが変わる。 小さい四角(sq_2px、元の黒画素4)も同じで、1/8のNEARESTでは残り、AREAでは消える。
この結果は後で効いてくる。カメラの画像を小さくして処理を軽くすることはよくあるが、そのとき細い線や小さい物が消える。消えたものは検出できない。縮小のやり方まで含めて、何が残るかを把握しておく必要がある。
ここまでの中間まとめ
自分で作った画像で、3つのことが分かった。
実験A:同じファイルでも、Pillowは書いた値を返し、OpenCVは赤と青を入れ替えて返す
実験B:JPEGは色の境目で最大86ずれる。PNGは0。測定にはPNGを使う
実験C:線幅1画素は半分の縮小で消える。縮小のやり方で結果が変わる
ここまでは、正解が分かっている画像の話だった。書いた値があるから、ズレを正確に測れた。
ここから後半は、正解のない世界に入る。実際にカメラで撮った写真だ。
実験の後半で使う写真
青いブロックと赤いブロックを机に置き、白いコピー用紙を横に添えて、iPhoneで撮影した。照明はシーリングライト(天井の照明)で、調光(明るさ)と調色(色)ができる機種だ。
撮影は2つのセットに分けた。
セット1:カメラの露出を自動にして撮影
セット2:カメラの露出を固定(AE/AFロック)して撮影
各セットで、照明を明るい状態と暗い状態の2枚ずつ撮った。露出を固定した理由は後で説明する。
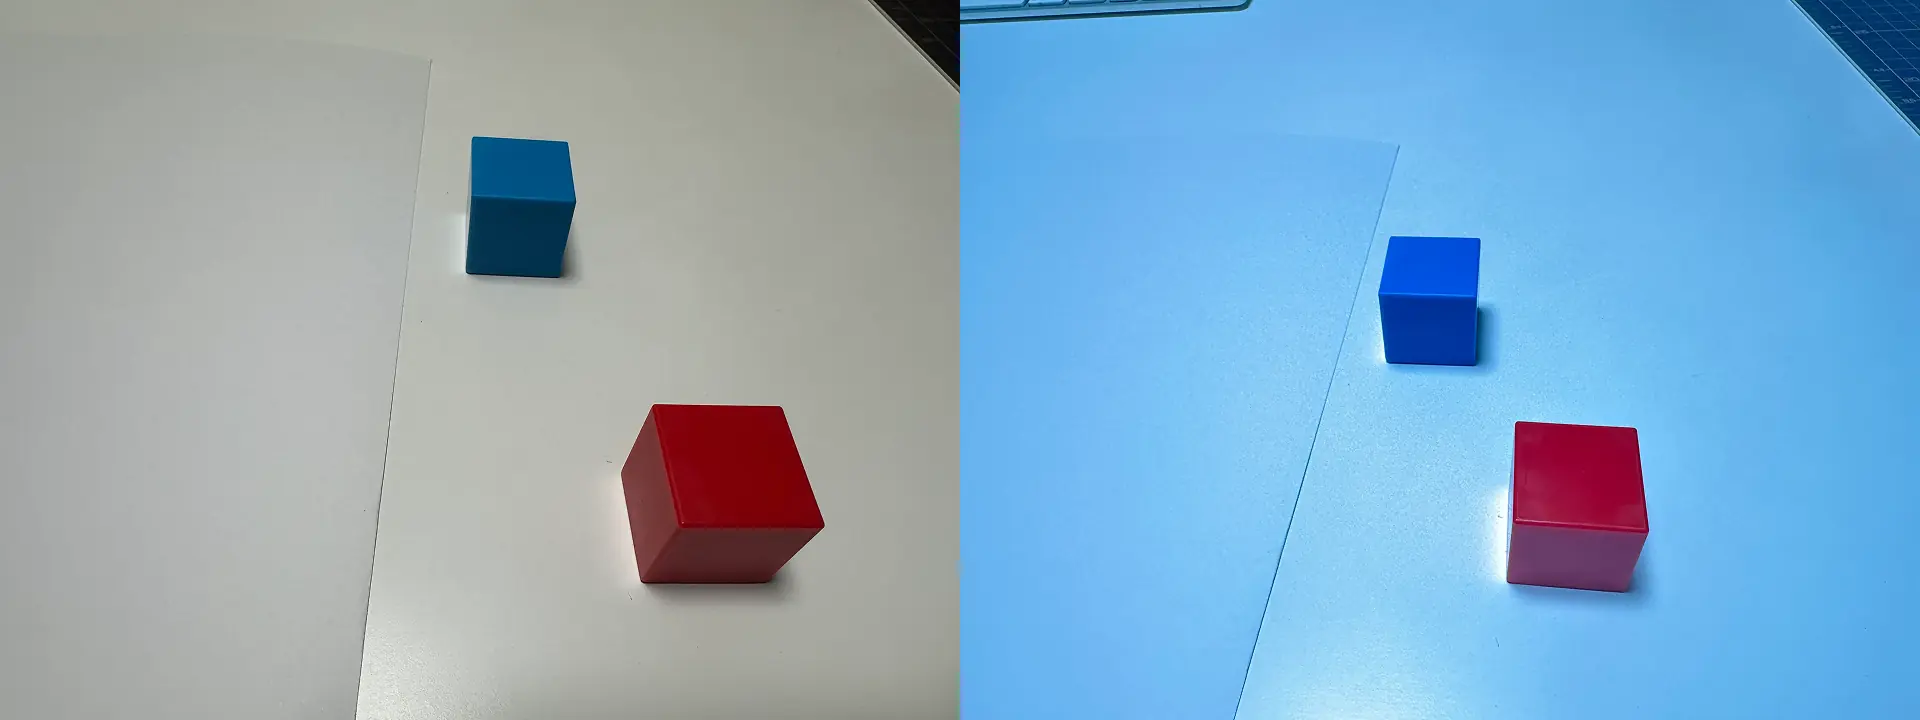
左=セット1の明るい方(自動露出)、右=セット2の照明を変えた方(露出固定)。同じブロックだが、右は全体が青く写っている。
写真の色を測るとき、写真のどの点を読むかを座標で指定する。だが「その座標が本当に青ブロックの上面を指しているか」は、座標の数字を見ても分からない。机の上かもしれないし、角の影かもしれない。
そこで、指定した座標に枠を描いて、狙った場所に乗っているかを目で確かめた。
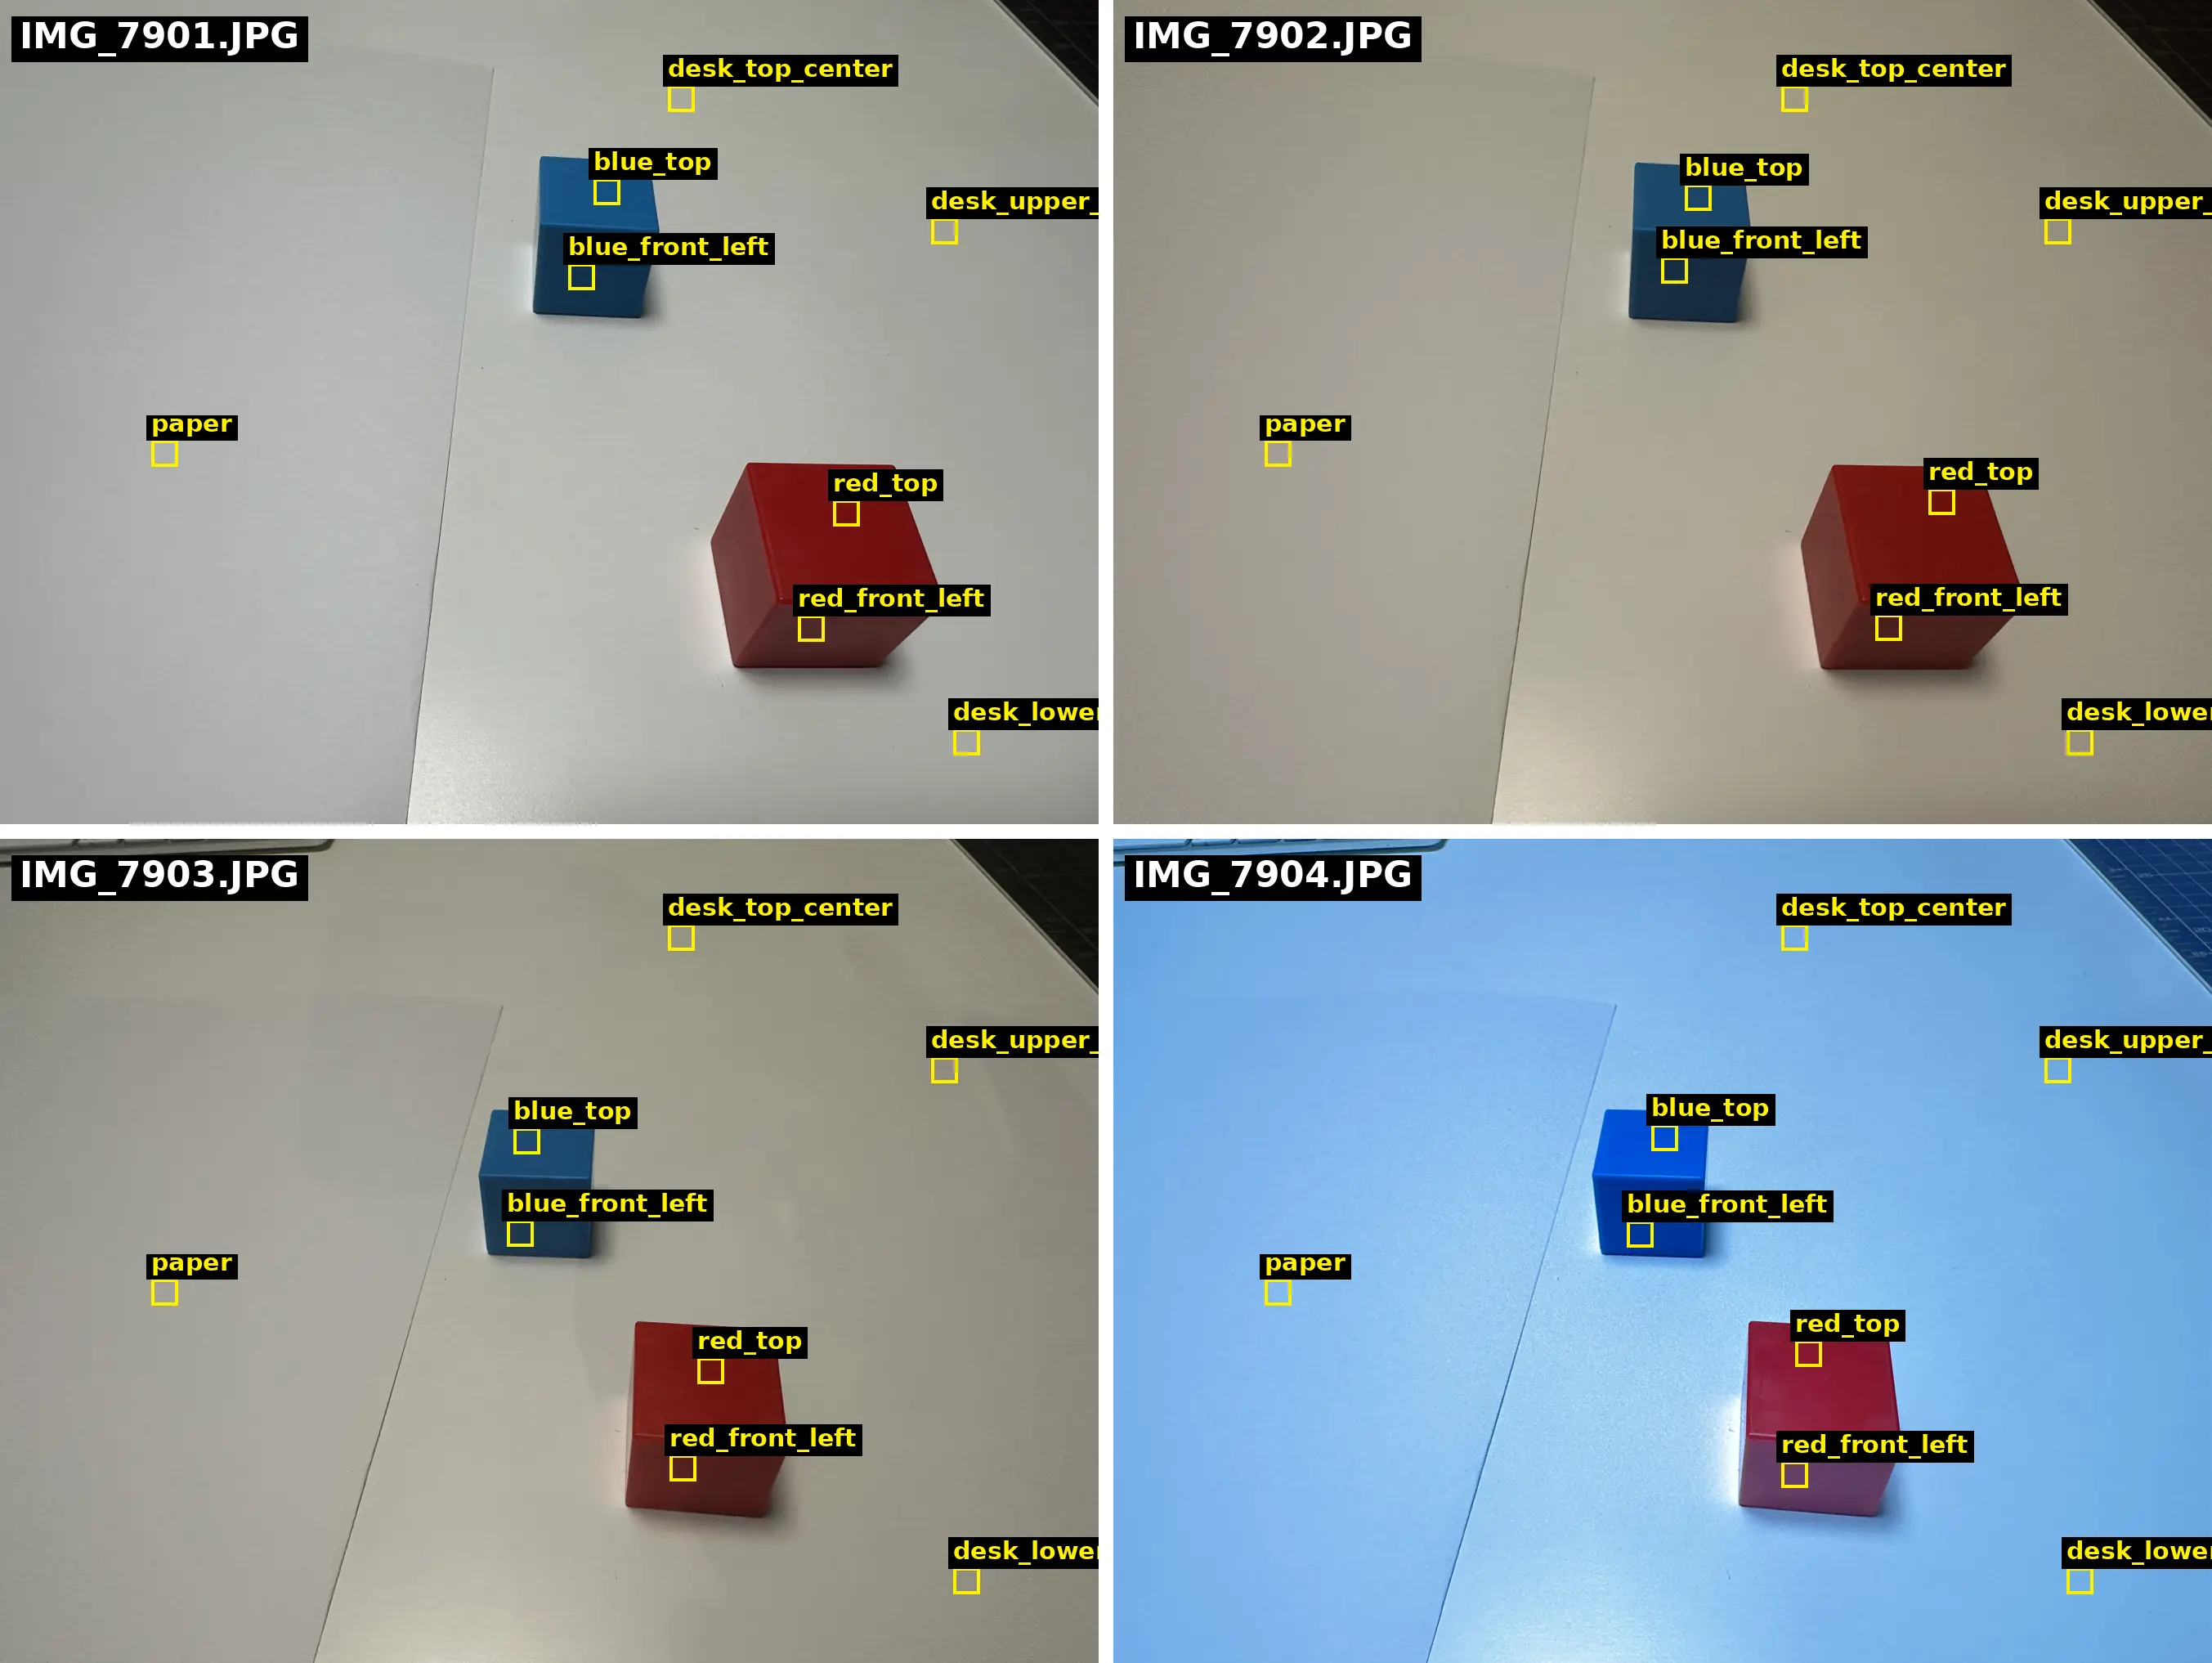
測定する8箇所に黄色い枠を描いて、面の内側に乗っているかを確認した。この確認で、最初は赤ブロックの枠が面の境界にはみ出していたことに気づき、位置を直した。
この確認は省けない。枠を描かずに座標だけで進めていたら、境界をまたいだ場所を「ブロックの面の色」として測っていた。測る前に、正しい場所を見ているかを確かめる。この順番が大事だ。
実験D:白い机は、本当に白いのか
まず、目で見て一様に見える面が、画素としてどれだけばらつくかを見る。白いコピー用紙、机、ブロックの面、それぞれ100×100画素の範囲の色を測った。使ったのは撮影画像用の別スクリプトだ。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""measure_captured.py

iPhone で撮影した 4 枚の写真の指定 8 領域について RGB 統計と EXIF を出す。
「目で見て一様に見える面が画素値としてどれだけばらつくか」を数字にすることが目的。

色変換はしない (Display P3 のまま). sRGB 変換は別スクリプトの担当。

Inputs:
  /Volumes/KIOXIA/r2r2r-data/vision/captured/Log02/IMG_7901.JPG
  /Volumes/KIOXIA/r2r2r-data/vision/captured/Log02/IMG_7902.JPG
  /Volumes/KIOXIA/r2r2r-data/vision/captured/Log02/IMG_7903.JPG
  /Volumes/KIOXIA/r2r2r-data/vision/captured/Log02/IMG_7904.JPG
  /Volumes/KIOXIA/r2r2r-data/vision/captured/Log02/measure_regions.json

Outputs (既存ファイルがあれば ABORT・上書きしない):
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/region_stats.csv
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/exif_summary.csv
  /Volumes/KIOXIA/r2r2r-data/vision/measurements/Log02/run_meta.json
"""
from __future__ import annotations

import csv
import hashlib
import io
import json
import sys
from datetime import datetime
from pathlib import Path

import numpy as np
from PIL import Image, ImageCms

try:
    import cv2  # noqa: F401
    _OPENCV_VERSION = cv2.__version__
except Exception:
    _OPENCV_VERSION = None


# ---- 定数 --------------------------------------------------------------------
KIOXIA_ROOT = Path("/Volumes/KIOXIA/r2r2r-data")
INPUT_DIR = KIOXIA_ROOT / "vision" / "captured" / "Log02"
OUTPUT_DIR = KIOXIA_ROOT / "vision" / "measurements" / "Log02"
REGIONS_JSON = INPUT_DIR / "measure_regions.json"

IMAGE_NAMES = ["IMG_7901.JPG", "IMG_7902.JPG", "IMG_7903.JPG", "IMG_7904.JPG"]

# セット番号 (スクリプト内ハードコード可・仕様 4 節)
SET_NO_BY_IMAGE = {
    "IMG_7901.JPG": 1,
    "IMG_7902.JPG": 1,
    "IMG_7903.JPG": 2,
    "IMG_7904.JPG": 2,
}

REGION_STATS_COLS = [
    "image", "set_no", "region",
    "center_x_frac", "center_y_frac", "patch_px",
    "mean_r", "mean_g", "mean_b",
    "std_r", "std_g", "std_b",
    "min_r", "min_g", "min_b",
    "max_r", "max_g", "max_b",
    "n_pixels",
]

EXIF_SUMMARY_COLS = [
    "image", "set_no",
    "exposure_time", "iso", "f_number",
    "brightness_value", "exposure_mode", "white_balance",
    "focal_length", "digital_zoom_ratio",
    "width", "height", "format", "n_frames",
    "icc_profile_name", "exif_colorspace", "datetime_original",
]

# EXIF タグ ID (PIL.ExifTags と一致).
_TAG_EXIF_IFD = 0x8769           # ExifOffset (Exif IFD へのポインタ)
_TAG_EXPOSURE_TIME = 0x829A
_TAG_F_NUMBER = 0x829D
_TAG_ISO = 0x8827                # ISOSpeedRatings
_TAG_DATETIME_ORIGINAL = 0x9003
_TAG_BRIGHTNESS_VALUE = 0x9203
_TAG_FOCAL_LENGTH = 0x920A
_TAG_COLOR_SPACE = 0xA001
_TAG_EXPOSURE_MODE = 0xA402
_TAG_WHITE_BALANCE = 0xA403
_TAG_DIGITAL_ZOOM_RATIO = 0xA404


def _abort(msg: str, code: int = 1) -> None:
    print(msg, file=sys.stderr)
    sys.exit(code)


def _md5(path: Path) -> str:
    h = hashlib.md5()
    with path.open("rb") as f:
        for chunk in iter(lambda: f.read(1024 * 1024), b""):
            h.update(chunk)
    return h.hexdigest()


def _rational_to_float(v):
    """EXIF の Rational / IFDRational / tuple / 数値を float 化. 変換不能なら生値."""
    if v is None:
        return None
    try:
        return float(v)
    except (TypeError, ValueError):
        pass
    if isinstance(v, tuple) and len(v) == 2:
        try:
            return float(v[0]) / float(v[1])
        except (TypeError, ValueError, ZeroDivisionError):
            return v
    return v


def _read_exif(im: Image.Image) -> dict:
    """0-th IFD と Exif IFD (0x8769) の両方から必要タグを集めて dict で返す."""
    tags: dict = {}
    try:
        exif = im.getexif()
    except Exception:
        exif = None
    if exif is not None:
        for k, v in exif.items():
            tags[k] = v
        try:
            sub = exif.get_ifd(_TAG_EXIF_IFD)
        except Exception:
            sub = None
        if sub:
            for k, v in sub.items():
                tags[k] = v
    return tags


def _icc_profile_name(im: Image.Image) -> str:
    """ICC プロファイル記述子を取得. UTF-16 に対応するため ImageCms を使う."""
    icc = im.info.get("icc_profile")
    if not icc:
        return ""
    try:
        prof = ImageCms.ImageCmsProfile(io.BytesIO(icc))
        return ImageCms.getProfileDescription(prof).strip()
    except Exception:
        return ""


def _crop_patch(arr: np.ndarray, x_frac: float, y_frac: float,
                patch: int, region: str, image_name: str) -> np.ndarray:
    """中心 (int(x*W), int(y*H)) ± patch/2 の RGB パッチを返す.
    はみ出しは中断 (静かに縮小しない・n_pixels がずれるため)."""
    h, w = arr.shape[:2]
    cx = int(x_frac * w)
    cy = int(y_frac * h)
    half = patch // 2
    # patch が奇数のときは右下側を +1 して patch × patch を確保.
    x0 = cx - half
    y0 = cy - half
    x1 = x0 + patch
    y1 = y0 + patch
    if x0 < 0 or y0 < 0 or x1 > w or y1 > h:
        _abort(
            f"[ABORT] patch が画像範囲外: image={image_name} region={region} "
            f"center=({cx},{cy}) patch={patch} image_size=({w},{h}) "
            f"x=[{x0},{x1}) y=[{y0},{y1})")
    return arr[y0:y1, x0:x1, :]


def main() -> None:
    # ---- KIOXIA マウント確認 (ローカル fallback 禁止) ------------------------
    if not KIOXIA_ROOT.exists():
        _abort(f"[ABORT] KIOXIA 未マウント: {KIOXIA_ROOT} が存在しない。"
               "ローカル fallback しない。")

    if not INPUT_DIR.is_dir():
        _abort(f"[ABORT] 入力ディレクトリなし: {INPUT_DIR}")
    if not REGIONS_JSON.is_file():
        _abort(f"[ABORT] regions JSON なし: {REGIONS_JSON}")

    # ---- 出力ディレクトリ準備 & 既存ファイル検査 (上書き禁止) --------------
    out_region = OUTPUT_DIR / "region_stats.csv"
    out_exif = OUTPUT_DIR / "exif_summary.csv"
    out_meta = OUTPUT_DIR / "run_meta.json"
    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    for p in (out_region, out_exif, out_meta):
        if p.exists():
            _abort(f"[ABORT] 既存ファイルあり (上書き禁止): {p}")

    # ---- regions JSON ------------------------------------------------------
    regions_doc = json.loads(REGIONS_JSON.read_text(encoding="utf-8"))
    patch_px = int(regions_doc.get("patch_size_px"))
    regions_by_image = regions_doc.get("regions", {})
    for name in IMAGE_NAMES:
        if name not in regions_by_image:
            _abort(f"[ABORT] regions JSON に '{name}' の領域が無い")

    # ---- 入力ファイル存在確認 ---------------------------------------------
    image_paths = []
    for name in IMAGE_NAMES:
        p = INPUT_DIR / name
        if not p.is_file():
            _abort(f"[ABORT] 画像が無い: {p}")
        image_paths.append(p)

    # ---- 画像走査 ---------------------------------------------------------
    region_rows: list[dict] = []
    exif_rows: list[dict] = []
    total_region_count = 0

    for img_path in image_paths:
        image_name = img_path.name
        set_no = SET_NO_BY_IMAGE[image_name]

        with Image.open(img_path) as im_raw:
            # モード統一のためだけの convert. ICC 変換はしない.
            im = im_raw.convert("RGB")
            arr = np.asarray(im)  # uint8 (H, W, 3), RGB
            width, height = im_raw.size
            fmt = im_raw.format or ""
            n_frames = int(getattr(im_raw, "n_frames", 1))
            exif_tags = _read_exif(im_raw)
            icc_name = _icc_profile_name(im_raw)

        # region loop (JSON 記載順を保つ)
        image_regions = regions_by_image[image_name]
        for region_name, spec in image_regions.items():
            x_frac = float(spec["x"])
            y_frac = float(spec["y"])
            patch = _crop_patch(arr, x_frac, y_frac, patch_px,
                                region_name, image_name)
            n_pix = int(patch.shape[0] * patch.shape[1])
            # (H, W, 3) → 統計は 2D で計算.
            flat = patch.reshape(-1, 3).astype(np.float64)
            mean = flat.mean(axis=0)
            std = flat.std(axis=0)
            mn = patch.reshape(-1, 3).min(axis=0)
            mx = patch.reshape(-1, 3).max(axis=0)
            region_rows.append({
                "image": image_name,
                "set_no": set_no,
                "region": region_name,
                "center_x_frac": x_frac,
                "center_y_frac": y_frac,
                "patch_px": patch_px,
                "mean_r": f"{mean[0]:.3f}",
                "mean_g": f"{mean[1]:.3f}",
                "mean_b": f"{mean[2]:.3f}",
                "std_r": f"{std[0]:.3f}",
                "std_g": f"{std[1]:.3f}",
                "std_b": f"{std[2]:.3f}",
                "min_r": int(mn[0]),
                "min_g": int(mn[1]),
                "min_b": int(mn[2]),
                "max_r": int(mx[0]),
                "max_g": int(mx[1]),
                "max_b": int(mx[2]),
                "n_pixels": n_pix,
            })
            total_region_count += 1

        # EXIF 行
        brightness = _rational_to_float(exif_tags.get(_TAG_BRIGHTNESS_VALUE))
        if isinstance(brightness, float):
            brightness_out = f"{brightness:.3f}"
        else:
            brightness_out = "" if brightness is None else str(brightness)

        def _str(v):
            return "" if v is None else str(v)

        exif_rows.append({
            "image": image_name,
            "set_no": set_no,
            "exposure_time": _str(exif_tags.get(_TAG_EXPOSURE_TIME)),
            "iso": _str(exif_tags.get(_TAG_ISO)),
            "f_number": _str(exif_tags.get(_TAG_F_NUMBER)),
            "brightness_value": brightness_out,
            "exposure_mode": _str(exif_tags.get(_TAG_EXPOSURE_MODE)),
            "white_balance": _str(exif_tags.get(_TAG_WHITE_BALANCE)),
            "focal_length": _str(exif_tags.get(_TAG_FOCAL_LENGTH)),
            "digital_zoom_ratio": _str(exif_tags.get(_TAG_DIGITAL_ZOOM_RATIO)),
            "width": width,
            "height": height,
            "format": fmt,
            "n_frames": n_frames,
            "icc_profile_name": icc_name,
            "exif_colorspace": _str(exif_tags.get(_TAG_COLOR_SPACE)),
            "datetime_original": _str(exif_tags.get(_TAG_DATETIME_ORIGINAL)),
        })

        print(f"{image_name}  regions={len(image_regions)}")

    # ---- 出力: region_stats.csv --------------------------------------------
    with out_region.open("w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=REGION_STATS_COLS)
        w.writeheader()
        for row in region_rows:
            w.writerow(row)

    # ---- 出力: exif_summary.csv --------------------------------------------
    with out_exif.open("w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=EXIF_SUMMARY_COLS)
        w.writeheader()
        for row in exif_rows:
            w.writerow(row)

    # ---- 出力: run_meta.json -----------------------------------------------
    input_files = []
    for p in image_paths + [REGIONS_JSON]:
        input_files.append({
            "path": str(p),
            "md5": _md5(p),
            "size_bytes": p.stat().st_size,
        })

    meta = {
        "executed_at": datetime.now().astimezone().isoformat(),
        "script_path": str(Path(__file__).resolve()),
        "python_version": sys.version,
        "library_versions": {
            "numpy": np.__version__,
            "Pillow": Image.__version__,
            "opencv": _OPENCV_VERSION,
        },
        "image_reader": "Pillow",
        "color_conversion": "none",
        "input_files": input_files,
        "output_files": ["region_stats.csv", "exif_summary.csv", "run_meta.json"],
        "region_count": total_region_count,
    }
    with out_meta.open("w", encoding="utf-8") as f:
        json.dump(meta, f, ensure_ascii=False, indent=2)


if __name__ == "__main__":
    main()
image,set_no,region,center_x_frac,center_y_frac,patch_px,mean_r,mean_g,mean_b,std_r,std_g,std_b,min_r,min_g,min_b,max_r,max_g,max_b,n_pixels
IMG_7901.JPG,1,paper,0.15,0.55,100,175.923,177.950,176.934,1.914,1.896,1.904,168,170,169,183,185,184,10000
IMG_7901.JPG,1,desk_top_center,0.62,0.12,100,168.059,170.056,159.066,1.726,1.729,1.726,160,162,151,176,178,167,10000
IMG_7901.JPG,1,desk_upper_right,0.86,0.28,100,159.597,160.597,152.597,1.299,1.299,1.299,155,156,148,164,165,157,10000
IMG_7901.JPG,1,desk_lower_right,0.88,0.9,100,164.461,165.461,159.334,1.008,1.008,1.130,161,162,155,168,169,163,10000
IMG_7901.JPG,1,blue_top,0.5523,0.2325,100,21.854,79.353,127.540,1.369,1.164,1.194,15,73,121,28,84,133,10000
IMG_7901.JPG,1,blue_front_left,0.5295,0.336,100,17.823,48.617,74.220,1.222,1.172,1.091,13,43,69,23,53,79,10000
IMG_7901.JPG,1,red_top,0.7703,0.6227,100,115.857,15.857,15.893,1.258,1.258,1.272,110,10,10,121,21,22,10000
IMG_7901.JPG,1,red_front_left,0.7383,0.7622,100,76.236,40.207,40.217,1.235,1.230,1.222,71,35,35,81,45,45,10000
IMG_7902.JPG,1,paper,0.15,0.55,100,162.570,158.574,147.567,1.273,1.278,1.263,157,153,142,168,164,153,10000
IMG_7902.JPG,1,desk_top_center,0.62,0.12,100,158.124,153.124,133.124,1.049,1.049,1.049,153,148,128,163,158,138,10000
IMG_7902.JPG,1,desk_upper_right,0.86,0.28,100,148.907,141.915,125.788,1.403,1.399,1.363,142,135,119,156,149,133,10000
IMG_7902.JPG,1,desk_lower_right,0.88,0.9,100,148.503,141.536,125.420,2.628,2.651,2.608,133,126,110,161,156,139,10000
IMG_7902.JPG,1,blue_top,0.5327,0.2391,100,26.335,69.393,103.415,1.079,1.047,1.080,22,65,99,31,74,108,10000
IMG_7902.JPG,1,blue_front_left,0.5107,0.328,100,22.008,44.495,64.565,1.435,1.343,1.548,16,39,59,29,51,72,10000
IMG_7902.JPG,1,red_top,0.754,0.6085,100,108.870,17.585,12.541,1.303,1.031,1.045,104,13,8,114,21,16,10000
IMG_7902.JPG,1,red_front_left,0.7059,0.7616,100,72.263,32.825,27.718,1.243,1.361,1.409,67,28,22,78,39,34,10000
IMG_7903.JPG,2,paper,0.15,0.55,100,162.295,161.790,153.958,1.481,1.276,1.240,157,157,149,168,166,158,10000
IMG_7903.JPG,2,desk_top_center,0.62,0.12,100,151.137,148.419,133.401,1.335,1.298,1.321,146,144,127,157,154,139,10000
IMG_7903.JPG,2,desk_upper_right,0.86,0.28,100,143.295,139.699,126.520,1.905,1.872,2.315,136,133,118,149,146,133,10000
IMG_7903.JPG,2,desk_lower_right,0.88,0.9,100,143.337,141.337,129.337,1.408,1.408,1.408,137,135,123,149,147,135,10000
IMG_7903.JPG,2,blue_top,0.4797,0.3664,100,29.921,73.923,112.730,1.468,1.465,1.542,23,67,106,35,79,118,10000
IMG_7903.JPG,2,blue_front_left,0.4737,0.4782,100,28.014,55.026,76.026,1.377,1.370,1.370,23,50,71,34,61,82,10000
IMG_7903.JPG,2,red_top,0.6466,0.6452,100,110.000,21.654,17.654,1.277,1.250,1.250,104,15,11,116,27,23,10000
IMG_7903.JPG,2,red_front_left,0.6218,0.7636,100,84.591,33.497,29.546,1.374,1.212,1.169,79,27,25,91,40,36,10000
IMG_7904.JPG,2,paper,0.15,0.55,100,132.688,185.864,238.580,2.267,2.097,1.979,123,178,231,141,194,248,10000
IMG_7904.JPG,2,desk_top_center,0.62,0.12,100,117.633,172.609,227.341,1.371,1.364,1.224,113,168,224,123,178,233,10000
IMG_7904.JPG,2,desk_upper_right,0.86,0.28,100,110.163,168.851,223.089,1.895,1.513,1.487,106,163,218,114,172,226,10000
IMG_7904.JPG,2,desk_lower_right,0.88,0.9,100,114.461,175.461,230.456,0.805,0.805,0.798,112,173,228,118,179,234,10000
IMG_7904.JPG,2,blue_top,0.502,0.3624,100,0.063,76.970,214.179,0.287,1.392,1.179,0,72,209,6,91,225,10000
IMG_7904.JPG,2,blue_front_left,0.4794,0.4795,100,0.130,53.373,153.452,0.377,1.126,1.034,0,49,149,3,57,157,10000
IMG_7904.JPG,2,red_top,0.6329,0.6243,100,135.046,22.845,49.675,1.867,1.318,1.883,128,18,45,140,28,55,10000
IMG_7904.JPG,2,red_front_left,0.6198,0.7715,100,99.478,62.351,103.349,0.644,0.636,0.634,97,60,101,102,65,106,10000セット1の明るい写真(IMG_7901)で、机の色を場所ごとに見る。
中央寄り(desk_top_center):168, 170, 159
右上(desk_upper_right):160, 161, 153
同じ机、同じ1枚の写真だ。それでも場所によって数字が違う。照明のムラや、机の傾きによる光の当たり方の違いで、一様に見える机も場所ごとに明るさが変わる。
もう1つ、100×100画素の範囲の中でのばらつき(標準偏差、std_rの列)を見ると、机で1.3〜1.7くらい。これは範囲内のばらつきだ。一方で、場所を変えたときの差は数字にして10前後ある。範囲内のばらつきと、場所による差は、大きさの桁が違う。 後で色の判定をするとき、この2つを混同すると失敗する。
白いコピー用紙(paper)も見ておく。IMG_7901で175, 178, 177。教科書なら白は(255,255,255)だが、撮った白い紙は175前後だ。撮った写真の白は、255ではない。
実験E:照明を変えると、色はどう動くのか
最後に、照明を変えて同じ物を撮り、色がどう動くかを見る。ここで露出を固定した理由が出てくる。
まずセット1(自動露出)の2枚を比べる。照明を明るい状態から暗い状態に変えた。ところがカメラが露出を自動で調整して、暗さを打ち消してしまった。EXIF(撮影情報)を見ると分かる。
image,set_no,exposure_time,iso,f_number,brightness_value,exposure_mode,white_balance,focal_length,digital_zoom_ratio,width,height,format,n_frames,icc_profile_name,exif_colorspace,datetime_original
IMG_7901.JPG,1,0.01,100,2.2,4.816,0,0,2.22,1.775643408931301,4032,3024,MPO,2,Display P3,65535,2026:07:28 16:40:42
IMG_7902.JPG,1,0.02,500,2.2,1.413,0,0,2.22,1.775643408931301,4032,3024,MPO,2,Display P3,65535,2026:07:28 16:42:22
IMG_7903.JPG,2,0.02,500,2.2,1.275,0,0,2.22,1.775643408931301,4032,3024,MPO,2,Display P3,65535,2026:07:28 16:45:38
IMG_7904.JPG,2,0.02,500,2.2,3.523,0,0,2.22,1.775643408931301,4032,3024,MPO,2,Display P3,65535,2026:07:28 16:45:49
IMG_7901とIMG_7902を比べると、シャッター速度が1/100秒から1/50秒(2倍)、ISO感度が100から500(5倍)に変わっている。合計で10倍、カメラが明るく撮ろうとした。照明を暗くしたのに、カメラがそれを打ち消したので、写真の見た目はあまり変わらない。これでは「照明を変えると色がどう動くか」が見えない。
そこでセット2では、カメラの露出を固定(AE/AFロック)して撮り直した。IMG_7903とIMG_7904を見ると、シャッター速度もISOも同じ値のままだ。カメラが調整していない。照明の変化がそのまま写真に出る。
固定した状態で、照明の調色と調光を変えた。青いブロックの上面(blue_top)の色を見る。
IMG_7903(電球色寄り):R=30, G=74, B=113
IMG_7904(青白い光):R=0, G=77, B=214
Rの値に注目してほしい。30から0になった。0はこれ以上下がれない下限だ。青白い光で青いブロックを撮ると、赤の成分が完全に消えた。手前左の面(blue_front_left)でもRは0だ。
これは大きい。片方の照明では「Rが30ある青」として測れたものが、もう片方では「Rが0の青」になる。同じブロック、同じカメラ、同じ露出設定で、照明を変えただけだ。
しかもRだけでなく、GもBも動いている。白い紙(paper)で見ると、IMG_7903が162, 162, 154、IMG_7904が133, 186, 239。Rは下がり、Gは上がり、Bは大きく上がっている。照明を変えると、赤緑青の3つが、それぞれ別の量、別の向きに動く。
(今回はセットごとに調色と調光を同時に変えたので、色の変化のうちどれが調色でどれが調光の影響かは分けられない。それは次のLogで、片方だけ変えて確かめる)
だから色で物を見分けようとするとき(Log#4以降)、1つの決まった数字では切れない。「青はB>150」のような固定した条件を書くと、照明が変わった瞬間に外れる。幅を持たせるか、照明に強い別の表し方(次回のHSV)を使う必要がある。その根拠が、今回測ったこの数字だ。
この回で分かったこと
画素の数字は、3つの場所で変わる。全部、自分で測って確かめた。
読むソフトで変わる:同じ赤が、Pillowでは(255,0,0)、OpenCVでは(0,0,255)。以降どのコードでも、どちらで読んだかを意識する
保存で変わる:JPEGは色の境目で最大86ずれる。PNGは0。測定にはPNGを使う
撮ると変わる:白い机も場所で数字が違う。照明を変えると青ブロックのRが0に張り付く。色の判定は固定した数字では切れない
Log#1で「画像は数字の格子だ」と書いた。この回で、その数字が思ったほど素直ではないことが分かった。同じ物を指しているつもりでも、読み方・保存・撮影のそれぞれで数字が変わる。
だから、これから色や形で物を見分けていくとき、まず「その数字は信用できるのか」を問う癖をつける。測定に使う画像はPNGで保存する。読んだ数字がRGBかBGRかを書く。撮った写真の色は幅を持って扱う。この3つを、以降のすべてのLogの前提にする。
次のLog#3では、色を「明るさ」と「色味」に分ける表し方(HSV)を扱う。今回、照明を変えると赤緑青の3つが全部動くことを見た。この動きを、明るさの変化と色味の変化に分けられるのか。そこを確かめる。