

AIに任せたSEO対策 ― 公開したサイトは「Googleに載せない」設定のままだった。説明のない画像1万枚まで直した記録
サイトを新しくして公開した翌朝、AI に「サイトの SEO 対策がちゃんとできているか、全部確認して」と頼みました。SEO は、Google などの検索結果に自分のページが出やすくなるようにする手入れのことです。
最初に返ってきた報告はこうでした。全ページの頭に「このページを検索エンジンに載せないでください」という1行が入っている。 サイトを作っている途中、まだ人に見せない段階で入れておいた1行が、公開したあとも残っていました。この状態では、どれだけ記事を書いても、Google の検索結果には1ページも出ません。
ほかにも見つかりました。サイトの画像はおよそ1万2千枚。そのうち1万枚以上に、何が写っているかの説明(alt。画像を見られない人の読み上げや、検索エンジンが読む文字)が入っていませんでした。英語のページなのに「日本語のページ」と名乗っているものが95ページ。X や LinkedIn で記事のリンクを貼ると、どの記事でも同じ画像が出てしまう記事が56本。プライバシーポリシーには、使っていない「Google アナリティクス」と「Google 広告」を使っていると書いてありました。
どれも、見た目では分かりません。ページは普通に表示され、人が読む分には何も困らない。困るのは、検索エンジン・SNS・読み上げ機能のように、人の目以外でページを読む側です。
AI がやったのは、公開中のページを実際に取ってきて数えること、原因になっているコードを探して直すこと、直したあとにもう一度数えて確かめることです。全557ページを機械で点検し、直す前と後の数を比べています。
| 見つかったこと | やったこと | 結果 |
|---|---|---|
| 全ページに「検索に載せない」設定 | 1行を書き換えた | 557ページが検索の対象に |
| サイトの地図(サイトマップ)がない | 自動で作る仕組みを足した | 556ページを Google に送った |
| 説明のない画像 10,773枚 | 記事タイトルと直前の見出しから説明を入れた | 0枚 |
| 検索結果向けの構造化データがない(ほぼ全ページ) | 記事・マンガ・一覧・トップに足した | 553ページ(お問い合わせなど4ページを除く) |
| 英語なのに日本語と名乗るページ 95 | 言語の設定と、日本語版・英語版の対応づけ | 202ページで日英を対応 |
| SNS でどれも同じ画像が出る記事 56本 | サムネイルを画像に書き出した | 記事ごとの画像に |
| 実態と違うプライバシーポリシー | 書き直した | Cookie を使わない解析だけと明記 |
検索まわりの手入れのあと、記事ページから同じシリーズの前後の記事へ進めるリンクを足し、Cookie を使わないアクセス解析を入れ、Google Search Console(検索結果で何回表示され、何回押されたかが分かる Google の道具)に登録しました。記事の英語版を作る話も出ましたが、効果があるか分からないので、数字がたまるまで保留にしています。
人がやったのは、Google と Cloudflare の管理画面でボタンを押すところだけです。登録やサービスの有効化は持ち主のアカウントでしかできないので、AI が手順を案内し、送られてきた画面写真を見ながら進めました。その途中、サイトマップの住所の最後の1文字が抜けていたことにも、AI が画面写真から気づいています。
ここから下は作業ログです。使ったコマンドとその出力、書き換えたファイルの全文を、作業した順に載せています。
作業ログ ― 公開中のトップページを取得して、robots・title・h1・画像の alt を数えた
最初は公開中のページをそのまま取ってきて調べました。旧住所(adaptdesign.jp/pixelstomotors)は 301 で新しいドメインへ転送されるので、pixelstomotors.com を直接取りに行っています。
$ curl -sS -m 15 -o /tmp/top.html -w "%{http_code}\n" https://adaptdesign.jp/pixelstomotors
301
$ curl -sS -m 20 -L -o top.html -w "HTTP:%{http_code} URL:%{url_effective}\n" https://pixelstomotors.com/
HTTP:200 URL:https://pixelstomotors.com/
$ wc -c top.html
267724 top.html
$ curl -sS -m 20 -L -o sitemap.xml -w "HTTP:%{http_code}\n" https://pixelstomotors.com/sitemap.xml
HTTP:404
サイトマップは 404 でした。返ってきた 404 ページの中身に、この時点の全ページ共通の head がそのまま入っています。
$ cat sitemap.xml
<!DOCTYPE html><html lang="ja"> <head><meta charset="utf-8"><meta name="viewport" content="width=device-width, initial-scale=1"><title>ページが見つかりません</title><meta name="description" content><link rel="canonical" href="https://pixelstomotors.com/404"><meta property="og:site_name" content="Pixels to Motors"><meta property="og:title" content="ページが見つかりません"><meta property="og:description" content><meta property="og:type" content="website"><meta property="og:url" content="https://pixelstomotors.com/404"><meta name="twitter:card" content="summary_large_image"><!-- 試作のあいだは検索エンジンに載せない --><meta name="robots" content="noindex, nofollow"><link rel="icon" type="image/png" href="/site/9cad887a-242b-4953-bd36-7b368c27d1b9.png"><link rel="preconnect" href="https://fonts.googleapis.com"><link rel="preconnect" href="https://fonts.gstatic.com" crossorigin><link href="https://fonts.googleapis.com/css2?family=Inter:wght@300;400;500;600;700&family=Noto+Sans+JP:wght@300;400;500;700&display=swap" rel="stylesheet"><link rel="stylesheet" href="https://fonts.googleapis.com/css2?family=Material+Symbols+Outlined:opsz,wght,FILL,GRAD@20..48,400,0,0&display=block"><style>:root{--ink: #242424;--ink-2: #555;--ink-3: #888;--line: #f2f2f2;--bg: #f7f7f7;--panel: #fff;--dark: #242424;--sans: Inter, "Noto Sans JP", sans-serif;--mono: Menlo, Monaco, "Courier New", monospace}*{box-sizing:border-box}html{-webkit-text-size-adjust:100%}body{margin:0;background:var(--bg);color:var(--ink);font-family:var(--sans);-webkit-font-smoothing:antialiased;-moz-osx-font-smoothing:grayscale}a{color:inherit;text-decoration:none}img{max-width:100%;display:block}.ms{font-family:Material Symbols Outlined;font-style:normal;font-size:16px;line-height:1}.site-header{position:fixed;inset:0 0 auto;z-index:50;height:48px;padding:6px 40px;background:#ffffff1a;backdrop-filter:blur(10px);-webkit-backdrop-filter:blur(10px);box-shadow:0 4px 4px #0000001a}.hd-inner{max-width:1280px;margin:0 auto;height:36px;display:flex;align-items:center;justify-content:space-between;gap:40px}.logo{display:flex;align-items:center}.logo-img{height:17.3px;width:auto}.logo span{font-family:Noto Sans JP,sans-serif;font-weight:500;font-size:20px;letter-spacing:-.4px;color:var(--ink)}.hd-center{display:flex;align-items:center;gap:8px}.hd-manga img{height:28px;width:auto}.btn-dark{display:inline-flex;align-items:center;gap:8px;height:31px;padding:4px 16px;border-radius:4px;background:var(--dark);border:1px solid var(--dark);color:#fff;font:500 14px/21px Noto Sans JP,sans-serif;white-space:nowrap}.site-footer{background:var(--dark);padding:24px 40px}.ft-inner{max-width:1280px;margin:0 auto;display:flex;gap:40px}.ft-inner a,.ft-inner span{color:#888;font:300 14px/21px var(--sans)}.ft-inner a:hover{color:#fff}.tag{display:inline-block;padding:2px 6px;border-radius:4px;background:#f0f0f0;color:#888;font:400 11px/16px var(--sans)}.date{color:#aaa;font:400 11px/16px var(--sans)}.panel{max-width:1280px;margin:0 auto;background:#fff;border-radius:16px;padding:32px}.related,.sec{padding:40px 80px}.sec-h{margin:0 0 32px;font:600 24px/36px var(--sans)}.grid3{display:grid;grid-template-columns:repeat(3,minmax(0,1fr));gap:32px}@media(max-width:1023px){.grid3{grid-template-columns:repeat(2,minmax(0,1fr))}.related,.sec{padding:40px 24px}}@media(max-width:599px){.grid3{grid-template-columns:1fr;gap:24px}.related,.sec{padding:32px 12px}.panel{padding:24px 16px}}@media(max-width:767px){.site-header{padding:6px 16px}.hd-inner{gap:8px}.logo-img{height:14.8px}.hd-center .btn-dark{display:none}.hd-manga img{height:32px}.btn-dark{padding:4px 10px;font-size:12px;gap:4px}.site-footer{padding:24px 16px}}
.nf[data-astro-cid-zetdm5md]{max-width:620px;margin:0 auto;padding:160px 24px 200px;font:400 16px/1.8 var(--sans)}.nf-h[data-astro-cid-zetdm5md]{font:600 24px/1.5 var(--sans)}
</style></head> <body> <header class="site-header"> <div class="hd-inner"> <a class="logo" href="/"> <img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20"> </a> <div class="hd-center"> <a class="hd-manga" href="/manga-archive"><img src="/site/s-500x700_f2c5ae27-2ebe-4d15-8da4-05853d4973ef.webp" alt=""></a> <a class="btn-dark" href="/manga-archive">4コママンガ<i class="ms">arrow_forward</i></a> <a class="btn-dark" href="/manga-archive-en">English 4-Koma<i class="ms">arrow_forward</i></a> </div> <a class="btn-dark hd-msg" href="/message">メッセージ<i class="ms">arrow_forward</i></a> </div> </header> <main> <section class="nf" data-astro-cid-zetdm5md> <p class="nf-h" data-astro-cid-zetdm5md>このページは見つかりませんでした</p> <p data-astro-cid-zetdm5md>住所が変わったか、ページがなくなった可能性があります。</p> <p data-astro-cid-zetdm5md><a class="btn-dark" href="/" data-astro-cid-zetdm5md>トップへ<i class="ms" data-astro-cid-zetdm5md>arrow_forward</i></a></p> </section> </main> <footer class="site-footer"> <div class="ft-inner"> <span>© ADAPT DESIGN 2026</span> <a href="/privacypolicy">Privacy policy</a> </div> </footer> <script type="module">window.addEventListener("message",t=>{const e=t.data&&t.data.p2mHeight;if(!(typeof e!="number"||!isFinite(e)||e<=0)){for(const i of document.querySelectorAll("iframe[data-embed]"))if(i.contentWindow===t.source){i.style.height=Math.min(Math.ceil(e),2e4)+"px";break}}});</script> </body> </html>
トップページの robots・title・description・h1 です。
$ grep -o '<meta name="robots"[^>]*>' top.html; grep -o '<title>[^<]*</title>' top.html; grep -o '<meta name="description"[^>]*>' top.html; grep -oE '<h1[^>]*>.*</h1>' top.html
<meta name="robots" content="noindex, nofollow">
<title>Pixels to Motors | 人とロボットの関わりを、シミュレーションでデザインする</title>
<meta name="description" content="29年のデザイナー経験を、いまロボティクスに応用しています。テーマはHRIシミュレーション——人がロボットをどう感じ、どう関わるかを、実機の前にデジタル上で設計すること。">
<h1 data-astro-cid-j7pv25f6>Pixels to Motors | 人とロボットの関わりをシミュレーションでデザインする</h1>
noindex, nofollow が入っています。「このページを検索結果に載せない・このページのリンクをたどらない」という指示です。コメントには「試作のあいだは検索エンジンに載せない」とありました。試作は終わって公開済みなので、外し忘れです。
robots.txt は、Cloudflare が自動で出している、AI の利用についての宣言(content signals)だけでした。検索エンジンへの指示(User-agent・Sitemap の行)はありません。
$ curl -sS -m 15 https://pixelstomotors.com/robots.txt
# As a condition of accessing this website, you agree to abide by the following
# content signals:

# (a)  If a content-signal = yes, you may collect content for the corresponding
#      use.
# (b)  If a content-signal = no, you may not collect content for the
#      corresponding use.
# (c)  If the website operator does not include a content signal for a
#      corresponding use, the website operator neither grants nor restricts
#      permission via content signal with respect to the corresponding use.

# The content signals and their meanings are:

# search:   building a search index and providing search results (e.g., returning
#           hyperlinks and short excerpts from your website's contents). Search does not
#           include providing AI-generated search summaries.
# ai-input: inputting content into one or more AI models (e.g., retrieval
#           augmented generation, grounding, or other real-time taking of content for
#           generative AI search answers).
# ai-train: training or fine-tuning AI models.

# ANY RESTRICTIONS EXPRESSED VIA CONTENT SIGNALS ARE EXPRESS RESERVATIONS OF
# RIGHTS UNDER ARTICLE 4 OF THE EUROPEAN UNION DIRECTIVE 2019/790 ON COPYRIGHT
# AND RELATED RIGHTS IN THE DIGITAL SINGLE MARKET.
トップページの画像は305枚。alt の属性がない画像は0枚でしたが、alt が空(alt="")の画像が304枚ありました。中身のある alt はロゴの1枚だけです。
$ echo "imgs:"; grep -oE '<img[^>]*>' top.html | wc -l; echo "alt 属性なし:"; grep -oE '<img[^>]*>' top.html | grep -vc 'alt='; echo "alt 空:"; grep -oE '<img[^>]*alt=""[^>]*>' top.html | wc -l; echo "h2:"; grep -oE '<h2[^>]*>[^<]*</h2>' top.html
imgs:
305
alt 属性なし:
0
alt 空:
304
h2:
<h2 class="sec-h" data-astro-cid-j7pv25f6>Archive | 4コママンガ</h2>
<h2 class="sec-h" data-astro-cid-j7pv25f6>Series | シリーズ</h2>
<h2 class="sec-h" data-astro-cid-j7pv25f6>Record | 記録</h2>
<h2 class="sec-h" data-astro-cid-j7pv25f6>Sole Prop | 事業所について</h2>
トップページから出ているサイト内リンクの全量です(記事・シリーズ・4コマ・固定ページ)。
$ grep -oE 'href="/[^"#]*"' top.html | sort -u | grep -v '^href="/site/' | grep -v '^href="/media/'
href="/"
href="/manga-archive"
href="/manga-archive-en"
href="/manga/ep102"
href="/manga/ep103"
href="/manga/ep120"
href="/manga/ep122"
href="/message"
href="/privacypolicy"
href="/record/DesFKiCf"
href="/record/ai-visual-inspection-lighting"
href="/record/ai-writes-code-not-motions"
href="/record/akita-data-center-robotics-perspective"
href="/record/alphanist-binary-reward-assembly"
href="/record/approach-move-passes"
href="/record/arcs-without-area"
href="/record/arm-posture-vs-payload"
href="/record/autodesk-fusion-mcp-setup"
href="/record/avatar-gitai"
href="/record/avatar-gitai-pikari"
href="/record/beyond-the-arc-taught-grasp"
href="/record/box-collision-misdiagnosed-three-times"
href="/record/build-in-public-double-structure"
href="/record/build-robot-arm-telemetry-dashboard"
href="/record/building-a-physical-ai-lab-at-home"
href="/record/calibration-arm-not-moving"
href="/record/category-strategy-motion-ux-robotics-ux"
href="/record/category-strategy-motion-ux-robotics-ux-en"
href="/record/claude-instructions-hit-a-wall"
href="/record/code-skeleton-agent-judgment"
href="/record/correction-blocked-by-table-gap"
href="/record/dashboard-reads-the-failure"
href="/record/data-map-before-real-run"
href="/record/day1"
href="/record/day10"
href="/record/day100"
href="/record/day101"
href="/record/day102"
href="/record/day103"
href="/record/day104"
href="/record/day105"
href="/record/day106"
href="/record/day107"
href="/record/day108"
href="/record/day109"
href="/record/day11"
href="/record/day110"
href="/record/day111"
href="/record/day112"
href="/record/day113"
href="/record/day114"
href="/record/day115"
href="/record/day116"
href="/record/day117"
href="/record/day118"
href="/record/day119"
href="/record/day12"
href="/record/day120"
href="/record/day121"
href="/record/day122"
href="/record/day123"
href="/record/day124"
href="/record/day125"
href="/record/day126"
href="/record/day127"
href="/record/day128"
href="/record/day129"
href="/record/day13"
href="/record/day130"
href="/record/day131"
href="/record/day132"
href="/record/day133"
href="/record/day134"
href="/record/day135"
href="/record/day136"
href="/record/day137"
href="/record/day138"
href="/record/day139"
href="/record/day14"
href="/record/day140"
href="/record/day141"
href="/record/day142"
href="/record/day143"
href="/record/day144"
href="/record/day145"
href="/record/day146"
href="/record/day147"
href="/record/day148"
href="/record/day149"
href="/record/day15"
href="/record/day150"
href="/record/day151"
href="/record/day152"
href="/record/day153"
href="/record/day154"
href="/record/day155"
href="/record/day156"
href="/record/day157"
href="/record/day158"
href="/record/day159"
href="/record/day16"
href="/record/day160"
href="/record/day161"
href="/record/day162"
href="/record/day163"
href="/record/day164"
href="/record/day165"
href="/record/day166"
href="/record/day167"
href="/record/day168"
href="/record/day169"
href="/record/day17"
href="/record/day170"
href="/record/day171"
href="/record/day172"
href="/record/day18"
href="/record/day19"
href="/record/day2"
href="/record/day20"
href="/record/day21"
href="/record/day22"
href="/record/day23"
href="/record/day24"
href="/record/day25"
href="/record/day26"
href="/record/day27"
href="/record/day28"
href="/record/day29"
href="/record/day3"
href="/record/day30"
href="/record/day31"
href="/record/day32"
href="/record/day33"
href="/record/day34"
href="/record/day35"
href="/record/day36"
href="/record/day37"
href="/record/day38"
href="/record/day39"
href="/record/day4"
href="/record/day40"
href="/record/day41"
href="/record/day42"
href="/record/day43"
href="/record/day44"
href="/record/day45"
href="/record/day46"
href="/record/day47"
href="/record/day48"
href="/record/day49"
href="/record/day5"
href="/record/day50"
href="/record/day51"
href="/record/day52"
href="/record/day53"
href="/record/day54"
href="/record/day55"
href="/record/day56"
href="/record/day57"
href="/record/day58"
href="/record/day59"
href="/record/day6"
href="/record/day60"
href="/record/day61"
href="/record/day62"
href="/record/day63"
href="/record/day64"
href="/record/day65"
href="/record/day66"
href="/record/day67"
href="/record/day68"
href="/record/day69"
href="/record/day7"
href="/record/day70"
href="/record/day71"
href="/record/day72"
href="/record/day73"
href="/record/day74"
href="/record/day75"
href="/record/day76"
href="/record/day77"
href="/record/day78"
href="/record/day79"
href="/record/day8"
href="/record/day80"
href="/record/day81"
href="/record/day82"
href="/record/day83"
href="/record/day84"
href="/record/day85"
href="/record/day86"
href="/record/day87"
href="/record/day88"
href="/record/day89"
href="/record/day9"
href="/record/day90"
href="/record/day91"
href="/record/day92"
href="/record/day93"
href="/record/day94"
href="/record/day95"
href="/record/day96"
href="/record/day97"
href="/record/day98"
href="/record/day99"
href="/record/decisions-api-grasp-check"
href="/record/descend-passed-but-placement-drifts"
href="/record/design-implementation-split"
href="/record/digital-twin-place-surface"
href="/record/does-a-delivery-robot-help-nurses"
href="/record/dont-trust-logs-trust-the-arm"
href="/record/drag-teach-v2-replay-and-position-binding"
href="/record/drag-teaching-records-and-replays"
href="/record/dual-camera-detection-design"
href="/record/dynamic-tracking-z-axis-sign-inversion"
href="/record/dynamic_tracking_v2_design"
href="/record/explainer-video-character-narration"
href="/record/exposed-judgment"
href="/record/figma-design-token-consolidation"
href="/record/fill-the-hole-not-loosen-the-guard"
href="/record/find-tasks-where-nobody-comes"
href="/record/first-grasp-by-loosening-z-threshold"
href="/record/first-video-end-to-end"
href="/record/fk-place-one-fix-reveals-next"
href="/record/fk-vs-real-machine-camera-loop"
href="/record/flying-car-naming-and-motion-ux"
href="/record/four-layers-of-robot-softness"
href="/record/from-cleanup-to-traceability"
href="/record/from-drawing-to-solid"
href="/record/grip-hold-position-vs-pressure"
href="/record/handover-control-code-complete"
href="/record/handover-lost-the-incremental-loop"
href="/record/handover-present-pose-from-probe-scan"
href="/record/handover-series-concept"
href="/record/handover-step1-design"
href="/record/hd-map-how-thin"
href="/record/hospital-operations-digital-twin-system-design"
href="/record/how-as-metadata-vs-subject"
href="/record/hue-holds-color-breaks"
href="/record/identify-camera-by-name-not-index"
href="/record/image-recognition-object-detection-overview"
href="/record/j0-position-table-place-approach"
href="/record/j0-sweep-reachability-map"
href="/record/j1-command-rejection-found"
href="/record/japan-robot-leader-physical-ai-gap"
href="/record/japan-robot-leader-physical-ai-gap-en"
href="/record/joint-guard-that-stopped-normal-motion"
href="/record/making-explainer-video-with-ai"
href="/record/measure-holding-needs-ledger"
href="/record/measure-the-hole-before-filling-it"
href="/record/measure-what-the-gripper-missed"
href="/record/measuring-the-stuck-joint"
href="/record/mecharm-continuous-recording-pipeline"
href="/record/mecharm-control-frequency-benchmark-fresh-mode"
href="/record/mecharm-descend-phase-eliminated"
href="/record/mecharm-descend-tip-shift-two-stage-tracking"
href="/record/mecharm-dynamic-tracking-stable-grasp"
href="/record/mecharm-not-done-yet"
href="/record/mecharm-onto-ros2-moveit"
href="/record/mecharm-reach-control-ssh-overhead-analysis"
href="/record/mecharm-ssh-overhead-40x-speedup"
href="/record/mecharm-static-to-dynamic"
href="/record/mecharm270-joint-range-posture-dependency"
href="/record/microfactory-fairino-fr3"
href="/record/microfactory-loop-model-fix-the-variance"
href="/record/microfactory-vs-large-scale-pretraining"
href="/record/morphology-kernel-fits-or-vanishes"
href="/record/motion-uncanny-valley"
href="/record/motion-ux-definitive"
href="/record/motion-ux-three-phase-model"
href="/record/motion-ux-three-phase-model-en"
href="/record/no-such-thing-as-free-ai"
href="/record/no-such-thing-as-free-ai-en"
href="/record/not-chasing-humanoids"
href="/record/openpi-remote-inference-first-run"
href="/record/parallax-and-pose-constrained-motion"
href="/record/persistent-loop-interrupt-auto-home"
href="/record/physical-ai-beyond-industrial-robots"
href="/record/physical-tracking-limit-vs-software-speed"
href="/record/pi-brain-not-muscle-local-first"
href="/record/pi05-libero-benchmark-first-run"
href="/record/pi05-mecharm-demo-to-inference"
href="/record/pick-success-place-stuck"
href="/record/pipeline-timeline-visualization"
href="/record/pivot-to-probe-control-and-external-review"
href="/record/pixels-as-perception-data"
href="/record/pixelstomotors-com-domain"
href="/record/pixelstomotors-site-archive"
href="/record/place-descend-and-camera-stability"
href="/record/place-design-and-first-move"
href="/record/place-lookup-three-filters-blocking-reach"
href="/record/place-release-trial-log"
href="/record/place-servo-never-fired-import-bug"
href="/record/place-test-not-moving"
href="/record/precision-is-not-learning-so101"
href="/record/precision-lives-in-the-input-not-the-model"
href="/record/predicted-vs-actual-correction-loop"
href="/record/push-hold-stops-the-drop"
href="/record/reachy-mini-motion-ux-timing"
href="/record/real-data-first-digital-twin"
href="/record/revamping-the-observe-view"
href="/record/rgb-hsv-threshold-lighting-failure"
href="/record/road-marking-job-post-and-physical-ai"
href="/record/robot-car-kit-autonomy-breakdown"
href="/record/robot-handoff-design"
href="/record/robot-ideas-from-pain-not-robots"
href="/record/robotics-ux-designer-as-a-profession"
href="/record/robotics-ux-designer-as-a-profession-en"
href="/record/safety-controls-were-hiding-the-truth"
href="/record/sam3-first-look-sorting-line"
href="/record/sam3-mirror-reflection-grasp-problem"
href="/record/same-place-different-object"
href="/record/setting-up-the-side-camera"
href="/record/shoot-one-frame-before-building-detection"
href="/record/side-camera-watches-descend"
href="/record/slugwhere-the-bug-actually-lives"
href="/record/so101-imitation-learning-papers"
href="/record/speak-to-relearn-robotics"
href="/record/stage2-not-moving-isolation"
href="/record/stop-designing-to-stop"
href="/record/studio-shutdown-cloudflare-redirect"
href="/record/studio-to-astro-cloudflare"
href="/record/symmetric-reach-mirror"
href="/record/telemetry-dashboard-sidebar-goes-live"
href="/record/telemetry-idle-stage-history-place-verdict"
href="/record/template-match-center-was-the-corner"
href="/record/the-wall-was-a-dropped-command"
href="/record/three-ai-content-pipeline"
href="/record/three-ai-content-pipeline-en"
href="/record/tilted-plane-to-flat"
href="/record/tip-block-offset-measurement"
href="/record/toward-dual-arm-coffee"
href="/record/toward-dual-arm-coffee-en"
href="/record/two-layers-of-motion"
href="/record/unity-fk-vs-real-machine-calibration"
href="/record/video-patterns-and-try-it"
href="/record/video-progress-board"
href="/record/visual-article-builder"
href="/record/visual-servo-debug-tip-detection"
href="/record/visual-servo-design"
href="/record/visual-servo-y-axis-design"
href="/record/visualizing-correction-memory"
href="/record/vlm-planning-layer"
href="/record/vocabulary-of-modern-vision"
href="/record/wB1BUDZj"
href="/record/waypoint-replay-eight-takes"
href="/record/what-circularity-actually-measures"
href="/record/what-to-hand-to-robots"
href="/record/when-robot-motion-is-learned"
href="/record/where-learning-data-lives"
href="/record/where-pixel-values-change"
href="/record/which-file-the-live-pick-reads"
href="/record/who-is-responsible-robot-identity-design"
href="/record/why-arm-stopped-grasping-root-cause-apick"
href="/record/why-robot-arms-stop-at-one"
href="/record/why-z-correction-failed-twin-poses"
href="/record/youtube-channel-identity"
href="/record/youtube-script-curation"
href="/series1"
href="/series2"
href="/series4"
href="/series5"
href="/series6"
href="/series7"
ページの種類ごとに1〜2ページずつ取り、同じことを数えました。
$ for p in record/day1 record/motion-ux-definitive series1 manga/ep102 manga-archive message privacypolicy; do
    slug=$(echo $p | tr '/' '_')
    curl -sS -m 20 -L -o "$slug.html" -w "  HTTP:%{http_code}  $p\n" "https://pixelstomotors.com/$p"
  done
  HTTP:200  record/day1
  HTTP:200  record/motion-ux-definitive
  HTTP:200  series1
  HTTP:200  manga/ep102
  HTTP:200  manga-archive
  HTTP:200  message
  HTTP:200  privacypolicy
$ for f in record_day1.html record_motion-ux-definitive.html series1.html manga_ep102.html manga-archive.html message.html privacypolicy.html; do echo "--$f--"; grep -o '<meta name="robots"[^>]*>' "$f"; grep -o '<title>[^<]*</title>' "$f"; grep -o '<meta name="description"[^>]*>' "$f" | head -c 300; echo; done
--record_day1.html--
<meta name="robots" content="noindex, nofollow">
<title>Record | 記録 「愛されるロボット」はUIデザイナーが作る。HRI(Human-Robot Interaction)デザインの最前線</title>
<meta name="description" content="Web/UIデザイナーの知見をロボティクスへ。現場で「愛されるロボット」を作るHRIデザインの役割を解説。理解・透明性・リカバリビリティの3要素から、デザイナーが現実世界の不確実性にどう向き�
--record_motion-ux-definitive.html--
<meta name="robots" content="noindex, nofollow">
<title>Record | 記録 Motion UX とは何か  | ロボットの動きを体験として設計する</title>
<meta name="description" content="ロボットの動きを体験として設計する職能、Motion UX。学習済みモデルをもらって、動きの品質と体験を作る ── Pixels to Motors の立つ空白を、29 年デザイナーが定義する。">

--series1.html--
<meta name="robots" content="noindex, nofollow">
<title>Series1 | 薬剤搬送ロボット</title>
<meta name="description" content="Drug Delivery Robot | 薬剤搬送ロボットハコブくん の記録一覧">

--manga_ep102.html--
<meta name="robots" content="noindex, nofollow">
<title>Manga | 4コママンガ 最初の角は人が探す</title>
<meta name="description" content="深夜のリネン工場。ツカムくん2台がシーツの別々の所を引っぱり、シーツは1本のロープにねじれてしまう。夜勤スタッフが隣り合う角を2つ探して渡すと、シーツは一瞬で広がった。柔らかい物の�
--manga-archive.html--
<meta name="robots" content="noindex, nofollow">
<title>Archive | 4コママンガアーカイブ</title>
<meta name="description" content="4コママンガ「薬剤搬送ロボットハコブくん」の一覧。">

--message.html--
<meta name="robots" content="noindex, nofollow">
<title>Message | メッセージ</title>
<meta name="description" content="Pixels to Motors へのお問い合わせ。仕事のご依頼やご相談をお聞かせください。">

--privacypolicy.html--
<meta name="robots" content="noindex, nofollow">
<title>Privacy policy | プライバシーポリシー</title>
<meta name="description" content="Pixels to Motors のプライバシーポリシー。">
$ for f in record_day1.html record_motion-ux-definitive.html series1.html manga_ep102.html manga-archive.html message.html privacypolicy.html; do echo "==== $f ===="; echo "h1 count:"; grep -oE '<h1[^>]*>' "$f" | wc -l; grep -oE '<h1[^>]*>[^<]*' "$f"; echo "h2 count:"; grep -oE '<h2[^>]*>' "$f" | wc -l; echo "img total / alt-empty / no-alt-attr:"; total=$(grep -oE '<img[^>]*>' "$f" | wc -l); empty=$(grep -oE '<img[^>]*alt=""[^>]*>' "$f" | wc -l); noattr=$(grep -oE '<img[^>]*>' "$f" | grep -vc 'alt='); echo "total=$total empty=$empty noattr=$noattr"; echo "non-empty alt examples:"; grep -oE '<img[^>]*alt="[^"]+[^>]*>' "$f" | grep -v 'alt=""' | head -5; echo; done
==== record_day1.html ====
h1 count:
1
<h1 class="title">「愛されるロボット」はUIデザイナーが作る。HRI(Human-Robot Interaction)デザインの最前線
h2 count:
5
img total / alt-empty / no-alt-attr:
total=3 empty=2 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">

==== record_motion-ux-definitive.html ====
h1 count:
1
<h1 class="title">Motion UX とは何か  | ロボットの動きを体験として設計する
h2 count:
6
img total / alt-empty / no-alt-attr:
total=3 empty=2 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">

==== series1.html ====
h1 count:
1
<h1 class="sec-h s-title" data-astro-cid-kbb4royl>Drug Delivery Robot | 薬剤搬送ロボットハコブくん
h2 count:
1
img total / alt-empty / no-alt-attr:
total=48 empty=47 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">

==== manga_ep102.html ====
h1 count:
1
<h1 class="mtitle" data-astro-cid-7akjajeh>最初の角は人が探す
h2 count:
1
img total / alt-empty / no-alt-attr:
total=50 empty=47 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">
<img class="mcover" src="/media/s-1080x1350_v-fms_webp_d27d79b8-c385-495d-bc85-016330717340.png" alt="MANGA EP102 表紙" data-astro-cid-7akjajeh>
<img class="mcomic" src="/media/s-1080x1350_v-fms_webp_d5284e66-7712-4be7-be72-c2247aee2db0.png" alt="MANGA EP102 本編" data-astro-cid-7akjajeh>

==== manga-archive.html ====
h1 count:
1
<h1 class="sec-h ma-title" data-astro-cid-ukuvy75l>Archive | 4コママンガ
h2 count:
0
img total / alt-empty / no-alt-attr:
total=101 empty=100 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">

==== message.html ====
h1 count:
1
<h1 class="msg-h" data-astro-cid-o6t6v3xu>Message | メッセージ
h2 count:
0
img total / alt-empty / no-alt-attr:
total=2 empty=1 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">

==== privacypolicy.html ====
h1 count:
1
<h1 class="pp-h" data-astro-cid-qrgg6lin>Privacy policy | プライバシーポリシー
h2 count:
7
img total / alt-empty / no-alt-attr:
total=2 empty=1 noattr=0
non-empty alt examples:
<img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20">
まとめるとこうなります。
| ページ | 画像 | alt が空 | title・description | h1 |
|---|---|---|---|---|
| トップ | 305 | 304 | ページごとにあり | 1 |
| series1 | 48 | 47 | あり | 1 |
| manga-archive | 101 | 100 | あり | 1 |
| manga/ep102 | 50 | 47 | あり | 1 |
| record/day1 | 3 | 2 | あり | 1 |
title・description・h1 は整っていて、問題は「全ページが検索に載らない設定」と「画像の説明がほぼ空」の2つでした。
全ページの noindex, nofollow は src/layouts/Base.astro の1行から出ていた
サイトのコードは GitHub の PixelstoMotors/p2m-site にあり、push すると Cloudflare が作り直して公開します。どこで入っているかを探しました。
$ grep -rn "noindex" --include="*.astro" --include="*.ts" --include="*.js" . | grep -v node_modules
./src/layouts/Base.astro:25:  <meta name="robots" content="noindex, nofollow" />
全ページ共通の枠(Base.astro)の1か所だけです。直す前の該当部分です。
  <meta name="twitter:card" content="summary_large_image" />
  <!-- 試作のあいだは検索エンジンに載せない -->
  <meta name="robots" content="noindex, nofollow" />
コメントの行ごと消し、index, follow にしました。canonical(このページの正しい住所)と og 系のタグは、すでに正しい住所を使っていたので、この1行だけで公開できる状態になります。
$ grep -rn "noindex\|robots" --include="*.astro" . | grep -v node_modules
./src/layouts/Base.astro:24:  <meta name="robots" content="index, follow" />
$ npm run build
…
06:13:55 [build] 557 page(s) built in 6.18s
06:13:55 [build] Complete!
$ grep -o '<meta name="robots"[^>]*>' dist/index.html
<meta name="robots" content="index, follow">
$ git diff --stat
 src/layouts/Base.astro | 3 +--
 1 file changed, 1 insertion(+), 2 deletions(-)
$ git commit -m "fix: remove noindex,nofollow — site is now public, not a prototype"
[main a4a0292] fix: remove noindex,nofollow — site is now public, not a prototype
 1 file changed, 1 insertion(+), 2 deletions(-)
$ git push origin HEAD
   51c0267..a4a0292  HEAD -> main
sitemap.xml と robots.txt を足した ― @astrojs/sitemap で556ページ分
サイトマップは、サイトにどんなページがあるかを検索エンジンに渡す一覧です。Astro には公式の作り方(@astrojs/sitemap)があり、astro.config.mjs に site がすでに入っていたので、そのまま使えました。ほかの依存と同じく版を固定しています。
$ npm install @astrojs/sitemap --save --no-audit --no-fund
added 8 packages in 2s
$ sed -i 's/"@astrojs\/sitemap": "\^3.7.4"/"@astrojs\/sitemap": "3.7.4"/' package.json
公式の作り方が出すのは /sitemap-index.xml(目次)と /sitemap-0.xml(本体)です。「sitemap.xml」で探しに来る道具もあるので、同じ目次を /sitemap.xml でも返すようにしました。robots.txt は repo に無く、Cloudflare の自動のものが出ていたので、サイトマップの場所を書いたものを置きました。ファイルの全文は記事の最後にまとめています(astro.config.mjs・src/pages/sitemap.xml.ts・public/robots.txt)。
$ npm run build
…
06:16:08 λ src/pages/sitemap.xml.ts
06:16:08   └─ /sitemap.xml (+1ms)
06:16:08 ✓ Completed in 1.40s.
06:16:08 [@astrojs/sitemap] `sitemap-index.xml` created at `dist`
06:16:08 [build] 557 page(s) built in 5.36s
06:16:08 [build] Complete!
--- files ---
-rw-r--r-- 1 root root    78 Oct 17 06:16 dist/robots.txt
-rw-r--r-- 1 root root 39118 Oct 17 06:16 dist/sitemap-0.xml
-rw-r--r-- 1 root root   189 Oct 17 06:16 dist/sitemap-index.xml
-rw-r--r-- 1 root root   195 Oct 17 06:16 dist/sitemap.xml
--- index ---
<?xml version="1.0" encoding="UTF-8"?><sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><sitemap><loc>https://pixelstomotors.com/sitemap-0.xml</loc></sitemap></sitemapindex>
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap><loc>https://pixelstomotors.com/sitemap-0.xml</loc></sitemap>
</sitemapindex>
--- url count ---
556
--- sample ---
<loc>https://pixelstomotors.com/</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep01</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep02</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep03</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep04</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep07</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep09</loc>
<loc>https://pixelstomotors.com/english-4-koma/ep10</loc>
--- 404 present? ---
0
--- html page count in dist ---
557
557ページのうち 404 ページを除いた556ページが載りました。サイトマップの住所は、ページの canonical と同じ「末尾の / なし」の形です。
$ grep -o '<link rel="canonical"[^>]*>' dist/record/day1.html
<link rel="canonical" href="https://pixelstomotors.com/record/day1">
$ grep -c 'pixelstomotors.com/record/day1</loc>' dist/sitemap-0.xml
1
$ git commit -m "feat: add sitemap.xml and robots.txt for search engines"
[main 873898e] feat: add sitemap.xml and robots.txt for search engines
 5 files changed, 97 insertions(+)
 create mode 100644 public/robots.txt
 create mode 100644 src/pages/sitemap.xml.ts
$ git push origin HEAD
   a4a0292..873898e  HEAD -> main
557ページを機械で点検した ― 直す前は alt が空の画像 10,773枚・構造化データなし 556ページ
「他の SEO 対策も確認して全部やっておいて」と頼まれたので、1ページずつ見るのをやめ、ビルドした全ページを数えるスクリプト(audit.py)を書きました。全文は記事の最後に載せています。調べたのは、description の空・長さ、title の長さ、og:image(SNS に出る画像)の有無、h1 の数、構造化データの有無、英語ページの言語設定、画像の alt と大きさの指定、title・description の重複です。
$ python3 -I audit.py dist
pages 557
img width/heightなし(延べ): 11309  例 []
構造化データなし: 556  例 ['/series5.html', '/privacypolicy.html', '/404.html', '/index.html']
title>60字: 191  例 ['/english-4-koma/ep104.html', '/english-4-koma/ep82.html', '/english-4-koma/ep89.html', '/english-4-koma/ep108.html']
英語ページなのにlang=ja: 95  例 ['/english-4-koma/ep09.html', '/english-4-koma/ep19.html', '/english-4-koma/ep22.html', '/english-4-koma/ep104.html']
og:imageなし: 66  例 ['/series5.html', '/privacypolicy.html', '/404.html', '/series6.html']
description>160字: 59  例 ['/english-4-koma/ep09.html', '/english-4-koma/ep19.html', '/english-4-koma/ep22.html', '/english-4-koma/ep85.html']
description<50字: 11  例 ['/series5.html', '/privacypolicy.html', '/series6.html', '/series4.html']
description空: 4  例 ['/404.html', '/english-4-koma/ep47.html', '/english-4-koma/ep54.html', '/record/day80.html']
h1数=0: 2  例 ['/404.html', '/mecharm_data_blueprint.html']
h1数=2: 1  例 ['/record/day83.html']
duplicate titles: 1 [('Archive | 4コママンガアーカイブ', ['/manga-archive.html', '/manga-archive-en.html'])]
duplicate descs: 16 [('4コママンガ「薬剤搬送ロボットハコブくん」の一覧。', ['/manga-archive.html', '/manga-archive-en.html']), ('薬剤管理の厳格化を目指し、ハコブくんに高度な顔認証システムを導入した結果、思わぬ', ['/english-4-koma/ep19.html', '/manga/ep19.html']), ('高機能であることが常に正解とは限らない。あえて機能を絞り、周囲の環境や人間と補完', ['/english-4-koma/ep15.html', '/manga/ep15.html']), ('ツカムくんがコーヒーカップを掴もうとする。フルフル、フルフル。カップは動かない。', ['/english-4-koma/ep35.html', '/manga/ep35.html']), ('人間特有の「忖度」という曖昧な概念を、ロボットはどう扱うべきか。4コママンガとデ', ['/english-4-koma/ep14.html', '/manga/ep14.html'])]
imgs 11867 alt空 10773 [('(no', 10480), ('hero-img', 293)]
alt が空の画像が、どの部品から出ているかを分けました。直前にある class で数えています。
[('rthumb', 9503), ('hd-manga', 557), ('rec', 293), ('?', 215), ('mcard', 198), ('scard', 6), ('richText', 1)]
| 出どころ | 枚数 | 中身 |
|---|---|---|
| rthumb | 9,503 | 記事一覧のカードの画像(RecordCard) |
| hd-manga | 557 | ヘッダーの4コマのアイコン。画像だけのリンクなので、説明が空だと「名前のないリンク」になる |
| rec | 293 | 記事ページの一番上の画像(hero-img) |
| ? | 215 | 記事本文の中の画像(figure の中) |
| mcard | 198 | 4コマ一覧のカード |
| scard | 6 | トップのシリーズのカード |
英語の4コマは、本文とタイトルは英語なのに、説明文(description)が Studio から移したときの日本語のままでした。英語版の ep19 と日本語版の ep19 の中身です(各項目の頭だけ)。
{'slug': 'ep19', 'title': 'Excessive Security and Operational Friction', 'label': 'MANGA EP19EN', 'character': 'ハコブくん', 'description': '薬剤管理の厳格化を目指し、ハコブくんに高度な顔認証システムを導入した結果、思わぬ現場の混乱を招くエピソードです。「前髪の分け目が2度ズレている」という過剰な論理的厳密さが、多忙な看護師たちの業務を停止させる障害へと変貌。論理上の正解が現場の', 'published': '2026-04-11T02:45:00.000Z', 'cover': '/media/s-1080x1350_428c321c-aa1e-4710-ae01-01d6be4f23a0.webp', 'comic': '/media/s-1080x1350_8d0500ba-c578-404f-80c8-c47297684d6e.webp', 'cover_alt': '「第19話 過剰なセキュリティ」というタイトル。焦った表情で腕時計を確認する女性看護師の大城さんと、その後ろに並ぶ困惑した表情の看護師たちの行列。手前には顔認証待機中のロボット「ハコブくん」が配置されている。', 'comic_alt': 'ハコブくんの顔認証エラーに直面する看護師たちの漫画。1コマ目:大城さんが薬を要求。2コマ目:「前髪の分け目が2度ズレている」というエラー。3コマ目:大城さんが前髪を直し、行列が苛立つ。4コマ目:別の看護師がカードで強制解錠し、ハコブくんが「', 'body': '<p>■ Precision vs. "Physicality"<br>Identity verification is crucial, but the physical world is messy—hair moves, and co'}
{'slug': 'ep19', 'title': '過剰なセキュリティと運用の摩擦', 'label': 'MANGA EP19', 'character': 'ハコブくん', 'description': '薬剤管理の厳格化を目指し、ハコブくんに高度な顔認証システムを導入した結果、思わぬ現場の混乱を招くエピソードです。「前髪の分け目が2度ズレている」という過剰な論理', 'published': '2026-02-04T13:25:25.000Z', 'cover': '/media/s-1080x1350_6e9ee150-777b-495c-89ac-c6d2fcc0e6b7.webp', 'comic': '/media/s-1080x1350_9d4e9a4b-8bda-46b5-add8-fcef1aafbfe2.webp', 'cover_alt': '「第19話 過剰なセキュリティ」というタイトル。焦った表情で腕時計を確認する女性看護師の大城さんと、その後ろに並ぶ困惑した表情の看護師たちの行列。手前には顔認証', 'comic_alt': 'ハコブくんの顔認証エラーに直面する看護師たちの漫画。1コマ目:大城さんが薬を要求。2コマ目:「前髪の分け目が2度ズレている」というエラー。3コマ目:大城さんが前', 'body': '<p>■ Precision vs. "Physicality"<br>Identity verification is crucial, but the physical world is messy—hair moves, and co'}
Studio から移した記事は341本で、英語の記事が7本ありました。日本語記事の本文は、コードとログを含めて約600万字です。
studio records 341 Counter({'JP': 334, 'EN': 7})
['three-ai-content-pipeline-en', 'japan-robot-leader-physical-ai-gap-en', 'toward-dual-arm-coffee-en', 'category-strategy-motion-ux-robotics-ux-en', 'motion-ux-three-phase-model-en', 'robotics-ux-designer-as-a-profession-en', 'no-such-thing-as-free-ai-en']
JP chars total 5971201
画像の alt は「記事タイトル|直前の見出し」で埋め、本文中の h1 は h2 に下げた
本文の画像に、1枚ずつ人の目で説明を書くのは現実的ではありません。そこで、画像の直前にある見出しを使いました。記事の中の画像は、たいていその節の内容を写しているからです。たとえば「何本も並行する動画づくりを見える化する」の記事の2枚目は、こうなります。
<img src="/media/DAY339_02_pc_capture_0645.png" alt="何本も並行する動画づくりを見える化する ― 段階の自動判定と、PCは一覧・iPhoneはハコブくんという役わけ|進み具合のページは、データベースつきの手作りのページにした" loading="lazy">
部品ごとの入れ方です。
| 場所 | 入れた alt |
|---|---|
| 記事一覧・4コマ一覧のカード | 記事(話)のタイトル |
| ヘッダーの4コマのアイコン | 「4コママンガ」 |
| 記事の一番上の画像 | 記事タイトル |
| 記事本文の画像(Studio から移した記事) | 記事タイトル|直前の見出し(見出しがなければ「記事タイトル(図n)」) |
| 記事本文の画像(Markdown の記事) | 「【画像】ファイル名 説明」と書けばその説明。なければ記事タイトル|直前の見出し |
| トップのシリーズのカード | 英語名|日本語名 |
| シリーズページの資料画像 | シリーズ名 |
Studio から移した記事は、本文が HTML のまま入っているので、表示の直前に書き換える関数(src/lib/seo.ts の fixBody)を作りました。同じ関数で、本文の中にあった h1 を h2 に下げています(ページの h1 は記事タイトルの1つだけにするため。day83 で h1 が2つになっていました)。ファイル名に入っている画像の大きさ(s-1604x1518_…)から width と height も入れました。読み込む前に場所を確保して、表示のずれを防ぐためです。
Markdown で書いた記事は、本文を組み立てる段階(remark のプラグイン src/lib/remark-markers.mjs)で同じことをします。ここで1つつまずきました。プラグインを書き換えてビルドしても、Markdown の記事の alt が空のままでした。
$ grep -oE '<img[^>]{0,200}' dist/record/video-progress-board.html | grep -v 'alt="[^"]' | head -3
<img src="/media/DAY339_01_pc_dashboard.png" alt="" loading="lazy"
<img src="/media/DAY339_02_pc_capture_0645.png" alt="" loading="lazy"
<img src="/media/DAY339_03_iphone_cards.png" alt="" loading="lazy"
プラグインに、環境変数が立っているときだけ記事の項目名を表示する行を一時的に足して動かすと、何も表示されませんでした。プラグイン自体が動いていません。原因は Astro の記事の一時保存(node_modules/.astro と .astro)で、記事の Markdown が変わっていないと、前回組み立てた結果をそのまま使います。プラグインの中身が変わったことは見てくれません。
$ sed -i "s|    let lastHeading = '';|    let lastHeading = ''; if (process.env.P2M_DEBUG) console.log('[remark]', JSON.stringify(Object.keys(file.data?.astro?.frontmatter \|\| {})), title);|" src/lib/remark-markers.mjs
$ P2M_DEBUG=1 npx astro build 2>&1 | grep "\[remark\]" | head -5
(何も出ない)
$ ls -a node_modules/.astro .astro
.astro:
.
..
collections
content-assets.mjs
content-modules.mjs
content.d.ts
types.d.ts

node_modules/.astro:
$ rm -rf node_modules/.astro .astro
$ P2M_DEBUG=1 npx astro build 2>&1 | grep "\[remark\]" | head -3
[remark] ["title","slug","date","day","meta_description","tags","series"] サイトを Studio の外へ持ち出せる形で残す ― 533ページを1フォルダにまとめ、codex に2回検証させた
[remark] ["title","slug","date","day","meta_description","tags","series"] 解説動画の台本15本 ― ネタ25本から絞った基準と、事実確認で直した29か所
[remark] ["title","slug","date","day","meta_description","tags","series"] NVIDIAのAlphaNISTは二つ爪のグリッパーで組立を覚えた ― 成功か失敗かだけの報酬が生んだ滑らかな動きと、ソフト側の立ち位置
一時保存を消すと動きました。確かめたあと、表示の行は消しています。公開側(Cloudflare)はビルドのたびに一から作るので、この一時保存は残りません。
記事の作業フォルダからサイトへ記事を入れる tools/add_article.py も、「【画像】ファイル名 説明」の形を読めるように直しました(それまでは、ファイル名のあとに文字があると画像の確認から外れていました)。
構造化データ・hreflang・lang を入れた ― BlogPosting・Article・BreadcrumbList・CollectionPage
構造化データは、ページの中身を検索エンジン向けに整理して渡す書き方です(JSON-LD。schema.org の決まった型で書く)。記事なら「見出し・公開日・書いた人・画像」、一覧なら「中に入っている記事」を渡します。入れた型です。
| ページ | 型 |
|---|---|
| 記事 | BlogPosting(見出し・説明・公開日・更新日・画像・シリーズ・タグ・著者・発行元)と BreadcrumbList(トップ › シリーズ › 記事) |
| 4コマ | Article(日英それぞれ・表紙と本編の画像) |
| シリーズ・4コマ一覧 | CollectionPage(中の記事の一覧) |
| トップ | WebSite・Organization(YouTube・GitHub・X)・Person(島津 栄一) |
英語のページは <html lang="en"> にし、日本語版と英語版が両方あるページには、互いを指す hreflang を入れました。対応は機械的に決まります(/record/○○ と /record/○○-en、/manga/epNN と /english-4-koma/epNN、/manga-archive と /manga-archive-en)。
あわせて、og:image が無いページにサイト共通の画像を出し、記事・4コマは og:type を article にしました。全ページに共通の処理は Base.astro に寄せ、ページ側からは言語・構造化データ・対応する別言語のページを渡すだけにしています。
ビルド後、全ページの構造化データが JSON として読めるか、hreflang が互いを指しているかを確かめました。
$ python3 - <<'EOF'
import re,os,json
bad=0; hre={}; n=0
for dp,dn,fn in os.walk('dist'):
  if '/embeds' in dp or '/thumbs' in dp: continue
  for f in fn:
    if not f.endswith('.html'):continue
    p=os.path.join(dp,f); s=open(p).read()
    for m in re.findall(r'<script type="application/ld\+json">(.*?)</script>',s,re.S):
      try: json.loads(m); n+=1
      except Exception as e: bad+=1; print('BAD',p,e)
    can=re.search(r'rel="canonical" href="([^"]+)"',s).group(1)
    hre[can]=dict(re.findall(r'rel="alternate" hreflang="([a-z]+)" href="([^"]+)"',s))
print('jsonld ok',n,'bad',bad)
pairs=[(c,h) for c,h in hre.items() if h]
broken=[c for c,h in pairs if any(u not in hre or not hre[u] for u in h.values())]
print('hreflang pages',len(pairs),'broken',broken[:5])
EOF
jsonld ok 553 bad 0
hreflang pages 202 broken []
title は「記事名 | Pixels to Motors」の順にし、空の説明文は本文の書き出しから作った
Studio のころの形で、記事の title は「Record | 記録 ○○」、4コマは「Manga | 4コママンガ ○○」でした。検索結果では title の先頭から表示され、長いと後ろが切れます。先頭に毎回同じ文字があると、記事名が見えにくくなるので、「記事名 | Pixels to Motors」の順にしました。シリーズのページは「薬剤搬送ロボットハコブくん(Drug Delivery Robot)| Pixels to Motors」の形です。
description(検索結果で title の下に出る説明)は次のように直しました。
- 空だったページ(record/day80、英語の4コマ ep47・ep54)は、本文の書き出し120字から作る
- 英語の4コマは、日本語のまま残っていた説明文をやめ、英語の本文の書き出しから作る
- シリーズのページは「○○の記録一覧」だけだったので、何のページかが分かる文に書き足す
- 4コマ一覧の日本語版と英語版で同じだった説明とタイトルを、それぞれの言語で書き分ける
- 160字を超えるものは、meta の中だけ160字で切る(本文の説明文はそのまま)
404 ページは h1 を入れて noindex に、h1 がなかった mechArm のデータ全体図のページには、画面には出さない h1 を入れました。
埋め込み用の部品(サムネイル・図解)は X-Robots-Tag で単独では検索に出さない
記事一覧のサムネイルと記事の図解は、それぞれ独立した HTML(/thumbs/・/embeds/)を iframe で埋め込んでいます。単独のページとして検索結果に出ると、文脈のない図だけが表示されてしまいます。public/_headers に、この2つの場所の HTML を「単独では載せない・埋め込まれた記事の一部としては読む」(noindex, indexifembedded)とする指示を書きました。
直す前と後で、全ページを数え直した
$ python3 -I audit.py dist
pages 557
title>60字: 326  例 ['/series7.html', '/series2.html', '/english-4-koma/ep09.html', '/english-4-koma/ep19.html']
img width/heightなし(延べ): 68  例 []
description>160字: 12  例 ['/manga-archive-en.html', '/manga/ep19.html', '/record/day71.html', '/record/motion-ux-three-phase-model-en.html']
構造化データなし: 4  例 ['/privacypolicy.html', '/404.html', '/mecharm_data_blueprint.html', '/message.html']
description<50字: 3  例 ['/404.html', '/record/day113.html', '/record/day161.html']
duplicate titles: 0 []
duplicate descs: 0 []
imgs 11867 alt空 0 []
(この出力の「英語ページなのに lang=ja」の行は、hreflang=“ja” の文字にも反応する数え方だったので外して見ています。英語のページが lang=“en” になっていることは、ページを開いて確かめました。)
$ grep -o '<html lang="[a-z]*"' dist/english-4-koma/ep19.html dist/manga-archive-en.html dist/record/motion-ux-three-phase-model-en.html dist/manga/ep19.html
dist/english-4-koma/ep19.html:<html lang="en"
dist/manga-archive-en.html:<html lang="en"
dist/record/motion-ux-three-phase-model-en.html:<html lang="en"
dist/manga/ep19.html:<html lang="ja"
| 項目 | 直す前 | 直した後 |
|---|---|---|
| alt が空の画像 | 10,773 | 0 |
| 構造化データなし | 556 | 4(お問い合わせ・プライバシーポリシー・404・データ全体図) |
| og:image なし | 66 | 0 |
| 説明文が空 | 4 | 0 |
| 重複した title | 1 | 0 |
| 重複した description | 16 | 0 |
| width/height なしの画像(延べ) | 11,309 | 68 |
| title が60字超 | 191 | 326 |
title の60字超えは増えています。記事名の後ろに「| Pixels to Motors」を足したためです。日本語のタイトルは検索結果で30字前後から切れるので、記事名を先頭に出すことを優先しました。説明文が50字未満の3ページ(404・day113・day161)は、もとの説明文が短い記事です。
width と height を入れると、カードの画像が縦に伸びるところだった
画像に width と height を入れると、CSS で高さを決めていない場所では、その高さ(1350px など)がそのまま使われます。4コマのカード(.mcard img)と記事の一番上の画像(.rec .hero-img)がそれにあたり、カードの縦横比の指定(aspect-ratio)が効かなくなるところでした。2か所に height: auto を足しています。
変更の前後で、表示が変わっていないかを数字で確かめました。公開中のサイト(直す前)と、手元でビルドしたサイト(直した後)を同じブラウザで開き、画像の表示サイズを並べています(画像の読み込みは止めて、枠の大きさだけを比べる)。スクリプト(boxes.py)の全文は最後に載せています。
1280 / live ['164x17', '20x28', '246x308', '246x308', '246x308', '246x308', '512x341', '512x341']
1280 / new  ['164x17', '20x28', '246x308', '246x308', '246x308', '246x308', '512x341', '512x341']
1280 /manga/ep102 live ['164x17', '20x28', '620x25', '620x25', '0x0', '0x0', '0x0', '0x0']
1280 /manga/ep102 new  ['164x17', '20x28', '620x775', '620x775', '0x0', '0x0', '0x0', '0x0']
1280 /record/day1 live ['164x17', '20x28', '620x349']
1280 /record/day1 new  ['164x17', '20x28', '620x349']
1280 /series1 live ['164x17', '20x28', '331x186', '331x186', '331x186', '331x186', '0x0', '0x0']
1280 /series1 new  ['164x17', '20x28', '331x186', '331x186', '331x186', '331x186', '0x0', '0x0']
1280 /manga-archive live ['164x17', '20x28', '331x413', '331x413', '331x413', '331x413', '331x413', '331x413']
1280 /manga-archive new  ['164x17', '20x28', '331x413', '331x413', '331x413', '331x413', '331x413', '331x413']
1280 /record/video-progress-board live ['164x17', '20x28', '620x0', '620x0', '620x0', '620x0', '620x0', '620x0']
1280 /record/video-progress-board new  ['164x17', '20x28', '620x0', '620x0', '620x0', '620x0', '620x0', '620x0']
390 / live ['137x15', '22x32', '159x199', '159x199', '159x199', '159x199', '334x223', '334x223']
390 / new  ['137x15', '22x32', '159x199', '159x199', '159x199', '159x199', '334x223', '334x223']
390 /manga/ep102 live ['140x15', '23x32', '342x24', '342x24', '0x0', '0x0', '0x0', '0x0']
390 /manga/ep102 new  ['138x15', '23x32', '342x428', '342x428', '0x0', '0x0', '0x0', '0x0']
390 /record/day1 live ['138x15', '23x32', '342x192']
390 /record/day1 new  ['140x15', '23x32', '342x192']
390 /series1 live ['137x15', '22x32', '334x188', '334x188', '334x188', '334x188', '0x0', '0x0']
390 /series1 new  ['140x15', '23x32', '334x188', '334x188', '334x188', '334x188', '0x0', '0x0']
390 /manga-archive live ['138x15', '23x32', '334x418', '334x418', '334x418', '334x418', '334x418', '334x418']
390 /manga-archive new  ['138x15', '23x32', '334x418', '334x418', '334x418', '334x418', '334x418', '334x418']
390 /record/video-progress-board live ['137x15', '22x32', '342x0', '342x0', '342x0', '342x0', '342x0', '342x0']
390 /record/video-progress-board new  ['137x15', '22x32', '342x0', '342x0', '342x0', '342x0', '342x0', '342x0']
違うのは4コマのページの表紙と本編だけで、読み込む前から 620×775 の場所を確保するようになりました(画像は 1080×1350 なので、読み込んだあとの大きさと同じです)。読み込みを止めた直す前の側は、代わりの文字の高さ(25px)しかなかったので、読み込みが終わった瞬間にページ全体が下へずれていました。
$ git commit -m "seo: alt text, structured data, hreflang/lang, titles and descriptions"
[main ef68534] seo: alt text, structured data, hreflang/lang, titles and descriptions
$ git push origin HEAD
公開されたあと、本番で確かめました。
sitemap.xml 200 application/xml
sitemap-index.xml 200 application/xml
sitemap-0.xml 200 application/xml
robots.txt 200 text/plain
556
User-agent: *
Allow: /
Sitemap: https://pixelstomotors.com/sitemap-index.xml
<title>何本も並行する動画づくりを見える化する ― 段階の自動判定と、PCは一覧・iPhoneはハコブくんという役わけ | Pixels to Motors
<meta name="robots" content="index, follow, max-image-preview:large">
application/ld+json
<img src="/media/DAY339_02_pc_capture_0645.png" alt="何本も並行する動画づくりを見える化する ― 段階の自動判定と、PCは一覧・iPhoneはハコブくんという役わけ|進み具合のページは、データベースつきの手作りのページにした" loading="lazy">
<html lang="en" hreflang="en" hreflang="ja"
x-robots-tag: noindex, indexifembedded
プライバシーポリシーに、使っていない Google アナリティクスと Google 広告が書いてあった
点検の途中で、プライバシーポリシーの Cookie の節にこう書いてあることに気づきました。
当サイトでは、第三者配信事業者である「Google広告」を利用しておりますが、Cookieを使用することにより、お客様の過去のアクセス情報に基づいて、適切な広告を配信する場合があります。また、当サイトは、Googleが提供するアクセス解析ツール「Googleアナリティクス」を利用しています。
新しいサイトには、どちらも入っていません。公開中のページと、サイトのコードの両方を探しました。
$ curl -sS -m 15 https://pixelstomotors.com/ | grep -oE 'cloudflareinsights|gtag\(|googletagmanager' | sort -u
(何も出ない)
実際に使っているものを、コードから拾いました。メッセージフォームは、名前・メール・相談内容・送信日時・ブラウザの種類(ユーザーエージェント)を Cloudflare R2 に保存し、Cloudflare Email Routing で通知メールを送っています。外部のサービスは、Cloudflare(配信・画像と動画・フォームの保存)、Google Fonts(文字)、YouTube(動画の埋め込み。17か所、うち5か所は youtube-nocookie)です。
$ grep -nE "MESSAGES\.put|ip|CF-Connecting|user-agent|send|turnstile|fields|name|email" worker/index.js | head -30
6:import { EmailMessage } from 'cloudflare:email';
12:    if (url.pathname === '/pixelstomotors' || url.pathname.startsWith('/pixelstomotors/')) {
13:      const to = new URL(url.pathname.slice('/pixelstomotors'.length) || '/', url);
17:    if (url.pathname.startsWith('/media/')) return media(request, env, url);
18:    if (url.pathname === '/api/message') return message(request, env);
25:  const key = decodeURIComponent(url.pathname.slice('/media/'.length));
60:  const name = String(d.name || '').trim().slice(0, 200);
61:  const email = String(d.email || '').trim().slice(0, 300);
63:  if (!name || !email || !body || !/^[^\s@]+@[^\s@]+\.[^\s@]+$/.test(email) || d.agree !== true) {
68:  await env.MESSAGES.put(key, JSON.stringify({ at, name, email, body, ua: request.headers.get('user-agent') || '' }, null, 1),
72:    await notify(env, { at, name, email, body, key });
85:  const subject = `[Pixels to Motors] メッセージ: ${m.name}`;
87:    `名前: ${m.name}`,
88:    `メール: ${m.email}`,
97:    `Reply-To: ${encodeWord(m.name)} <${m.email}>`,
107:  await env.MAIL.send(new EmailMessage(from, to, raw));
$ grep -rhoE 'youtube(-nocookie)?\.com/embed' public/embeds src/data src/content | sort | uniq -c
      5 youtube-nocookie.com/embed
     14 youtube.com/embed
Cookie の節を実態に合わせて書き直し、「メッセージフォームでお預かりする情報」と「外部サービスの利用について」の2節を足しました。運営者名、照会の窓口(メッセージフォーム)、最終改定日も入れています。このあとアクセス解析を入れたので、Cookie の節はもう一度書き換えました(後述)。プライバシーポリシーの全文は最後に載せています。
記事の英語版は、URL を /en/ にする案まで決めて保留にした
ここで「記事の英語版を作って全部載せたい。まずは URL と、効果があるかを考えてほしい(まだ作らない)」と頼まれました。
URL は、日本語版の住所を一つも変えず、/en/ の下に同じ並びで置く案にしました(/record/{slug} → /en/record/{slug})。同じドメインの中に置けば今のサイトの評価をそのまま使え、slug が同じなので日英の対応づけを機械的に作れます。サブドメインや別ドメインは評価がほぼゼロから始まり、今の「末尾に -en」の形は記事以外を英語にできません。今ある英語ページ(記事7本・英語4コマ95話)は、新しい住所へ 301 で転送します。
効果については、両方の面を出しました。英語で探す人は日本語より桁違いに多く、手順を読める人が増えるのは Mission(誰でも同じ環境から始められる状態を増やす)に合います。一方で、大量の自動翻訳は「大量に作られた価値の薄いページ」として評価を下げるおそれがあり、英語の中身を確かめる人がいません。記事ルールの SNS の節には「機械翻訳を使わない」ともあります。
なるほど。イマイチ効果があるかわからないですね。少し考えるのでこのプランを記録しておいてください。
プランは、プロジェクトの資料(claude/english_version_plan.md)に残しました。判断の材料にするため、先に Search Console とアクセス解析を入れて、海外からの表示と訪問の数をためることにしています。
Google Search Console に登録した ― サイトマップの住所が「sitemap.xm」になっていた
Search Console は、Google の検索結果での表示回数・押された回数・探された言葉が分かる道具です。登録は持ち主の Google アカウントでしかできないので、手順を案内して進めてもらいました。
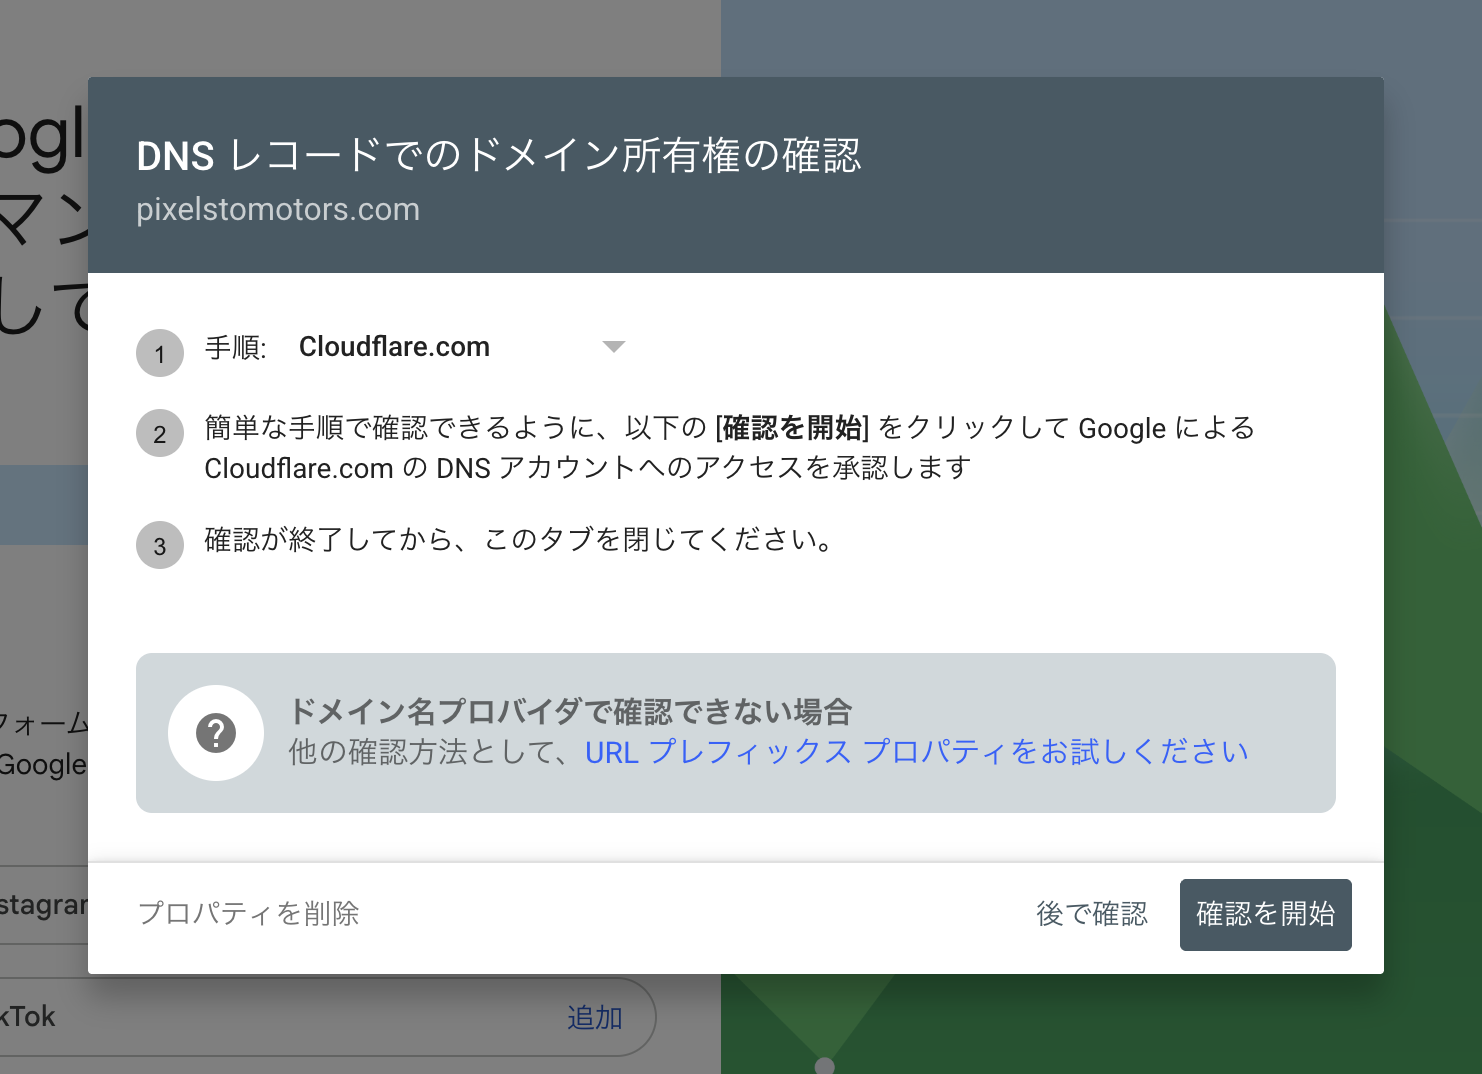
ドメイン全体をまとめて登録する形(ドメイン プロパティ)を選ぶと、Cloudflare の DNS に確認用の記録を自動で入れる画面が出ます。「確認を開始」で進めてよいかを聞かれ、サイトの表示やメールには影響しないこと、確認のあとにサイトマップを送ることを伝えました。
登録が済んで送られてきたサイトマップの画面では、住所が「…/site map.xm」と折り返して表示され、状態が「取得できませんでした」になっていました。
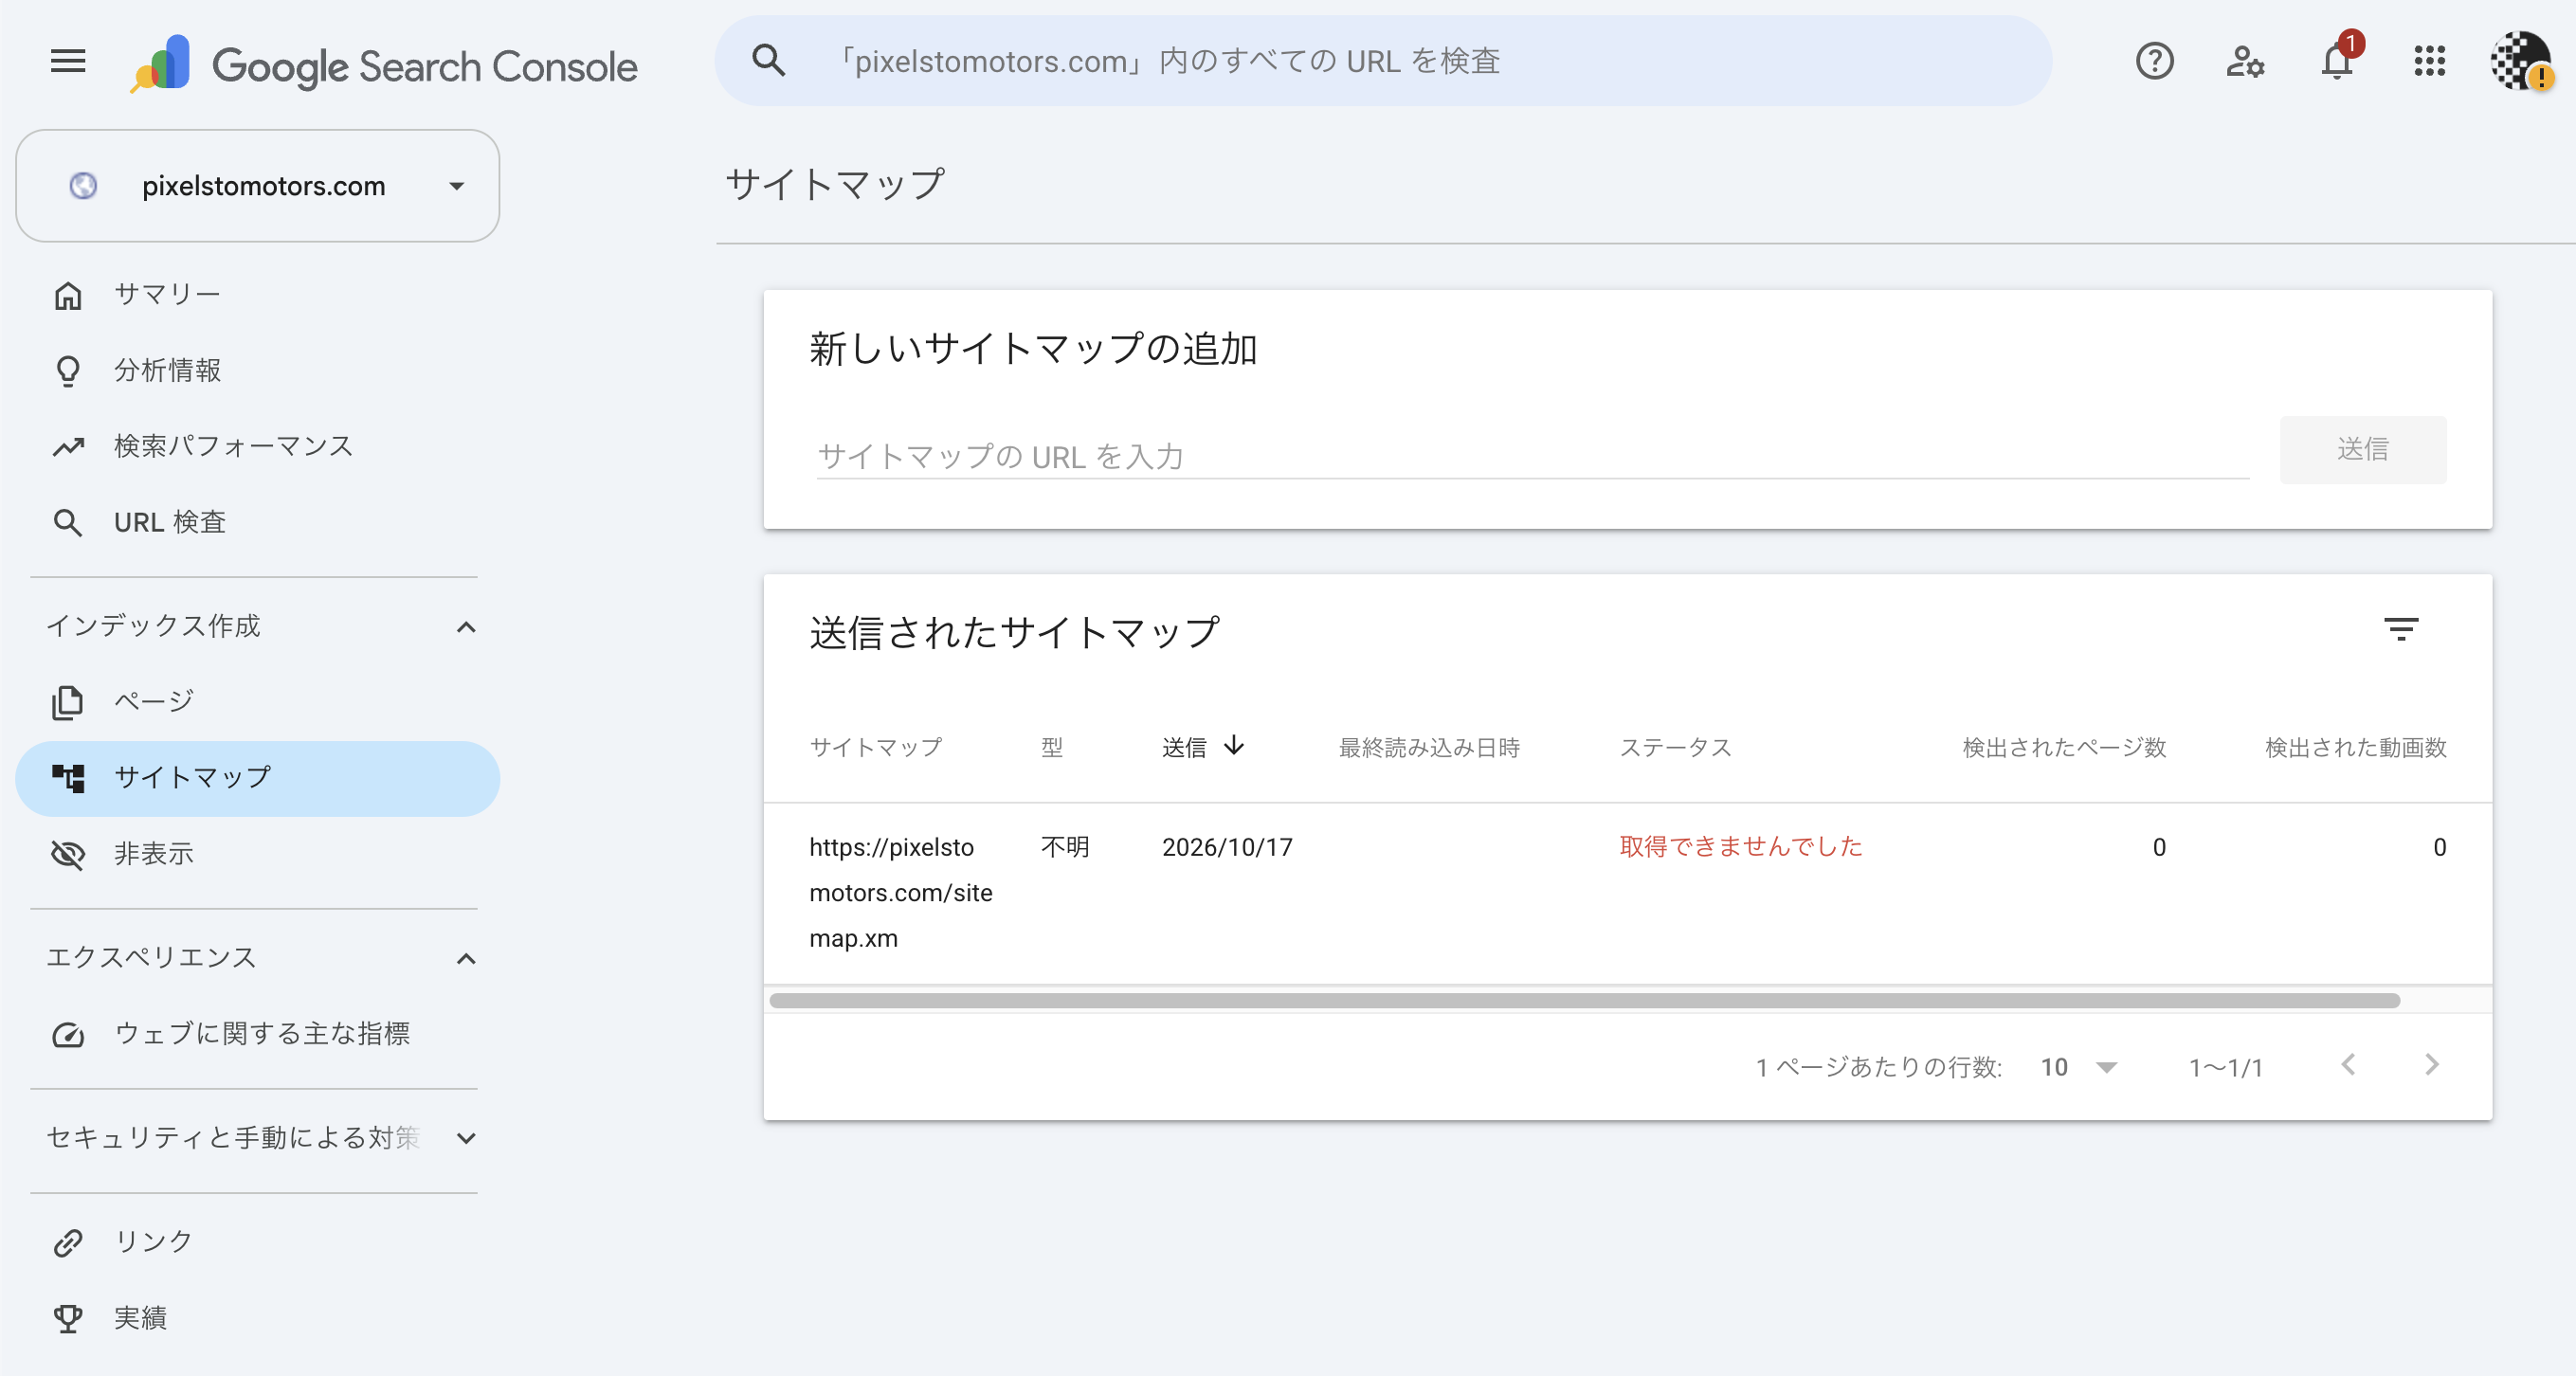
画面の折り返しで読みにくいので、実際に住所を叩いて確かめました。
$ for u in sitemap.xm sitemap.xml sitemap-index.xml; do curl -sS -m 15 -o /dev/null -w "$u %{http_code} %{content_type}\n" "https://pixelstomotors.com/$u"; done
sitemap.xm 404 text/html
sitemap.xml 200 application/xml
sitemap-index.xml 200 application/xml
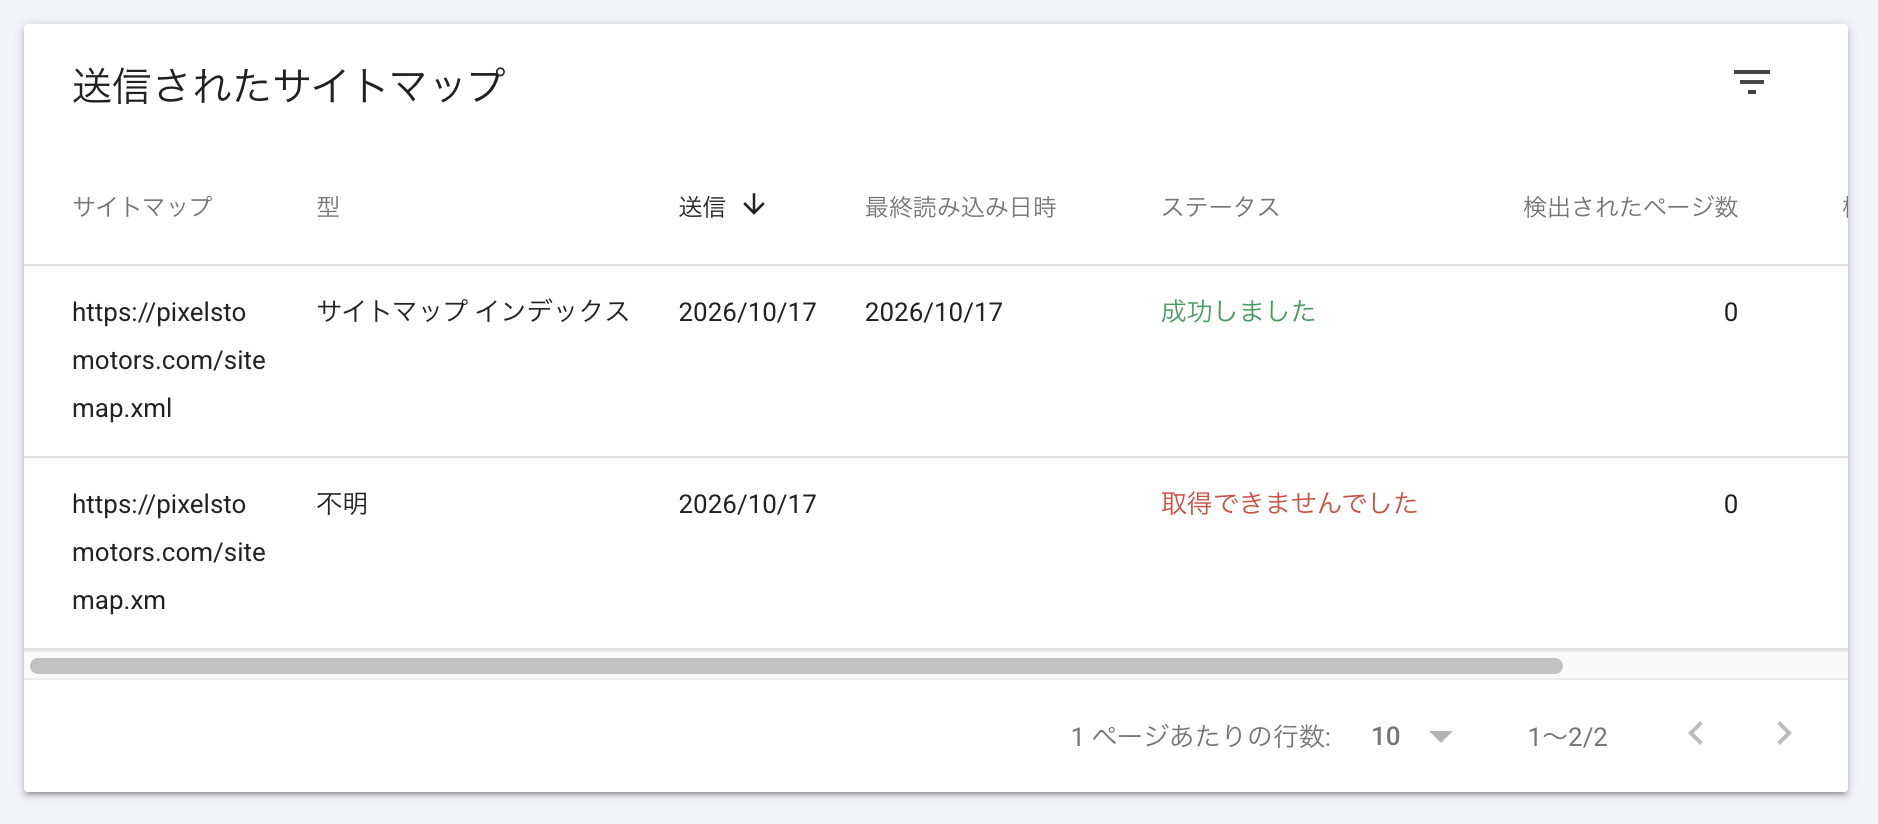
最後の「l」が抜けていました。正しい住所で送り直してもらうと「成功しました」になり、型は「サイトマップ インデックス」と読まれています。検出されたページ数が0なのは、まだ目次しか読んでいないためで、本体(556ページ分)はこのあと読まれます。
Search Console のデータを Claude から直接読む接続先(コネクタ)は、探した範囲では見つかりませんでした。当面は、画面から書き出した CSV を渡してもらって読む形にします。
新しいサイトで書いた記事は、どれを SNS に貼っても同じ画像が出ていた
新しいサイトで書いた記事(LOG334 以降)のサムネイルは、HTML で作っています(動きのある図にするため)。SNS に出る画像(og:image)は画像ファイルでしか指定できないので、これらの記事には共通の画像が出ていました。数えると56本です。
$ python3 - <<'EOF'
import re,os
n=0;lst=[]
for f in os.listdir('dist/record'):
  s=open('dist/record/'+f).read()
  if 'ffb300c2' in (re.search(r'og:image" content="([^"]+)',s).group(1)):
    th=re.search(r'class="hero"><iframe src="([^"]+)',s)
    lst.append((f, th.group(1) if th else None))
print(len(lst)); print([x for x in lst if not x[1]][:5]); print(lst[:5])
EOF
56
[]
[('which-file-the-live-pick-reads.html', '/thumbs/r-which-file-the-live-pick-reads.html'), ('what-circularity-actually-measures.html', '/thumbs/r-what-circularity-actually-measures.html'), ('avatar-gitai.html', '/thumbs/r-avatar-gitai.html'), ('morphology-kernel-fits-or-vanishes.html', '/thumbs/r-morphology-kernel-fits-or-vanishes.html'), ('from-cleanup-to-traceability.html', '/thumbs/r-from-cleanup-to-traceability.html')]
サムネイルの HTML をブラウザ(Playwright)で開き、1200×675 の画像に書き出すスクリプト(tools/render_og.py)を作りました。Google が大きな画像として扱う幅1200以上にそろえています。動くサムネイルは、読み込んでから2.5秒待って撮ります。まず3枚で試して、文字のフォントが正しく出ることを確かめてから、79枚すべてを書き出しました。
$ python3 tools/render_og.py LOG343 r-avatar-gitai LOG327
書き出し 3 件 → public/og/
$ ls -la public/og/
-rw-r--r-- 1 root root 76749 Oct 17 06:38 LOG327.jpg
-rw-r--r-- 1 root root 97869 Oct 17 06:38 LOG343.jpg
-rw-r--r-- 1 root root 93790 Oct 17 06:38 r-avatar-gitai.jpg
$ python3 tools/render_og.py
書き出し 76 件 → public/og/
$ ls public/og | wc -l
79
$ du -sh public/og
7.1M	public/og
79枚を並べて、崩れているものがないかを目で確かめました。
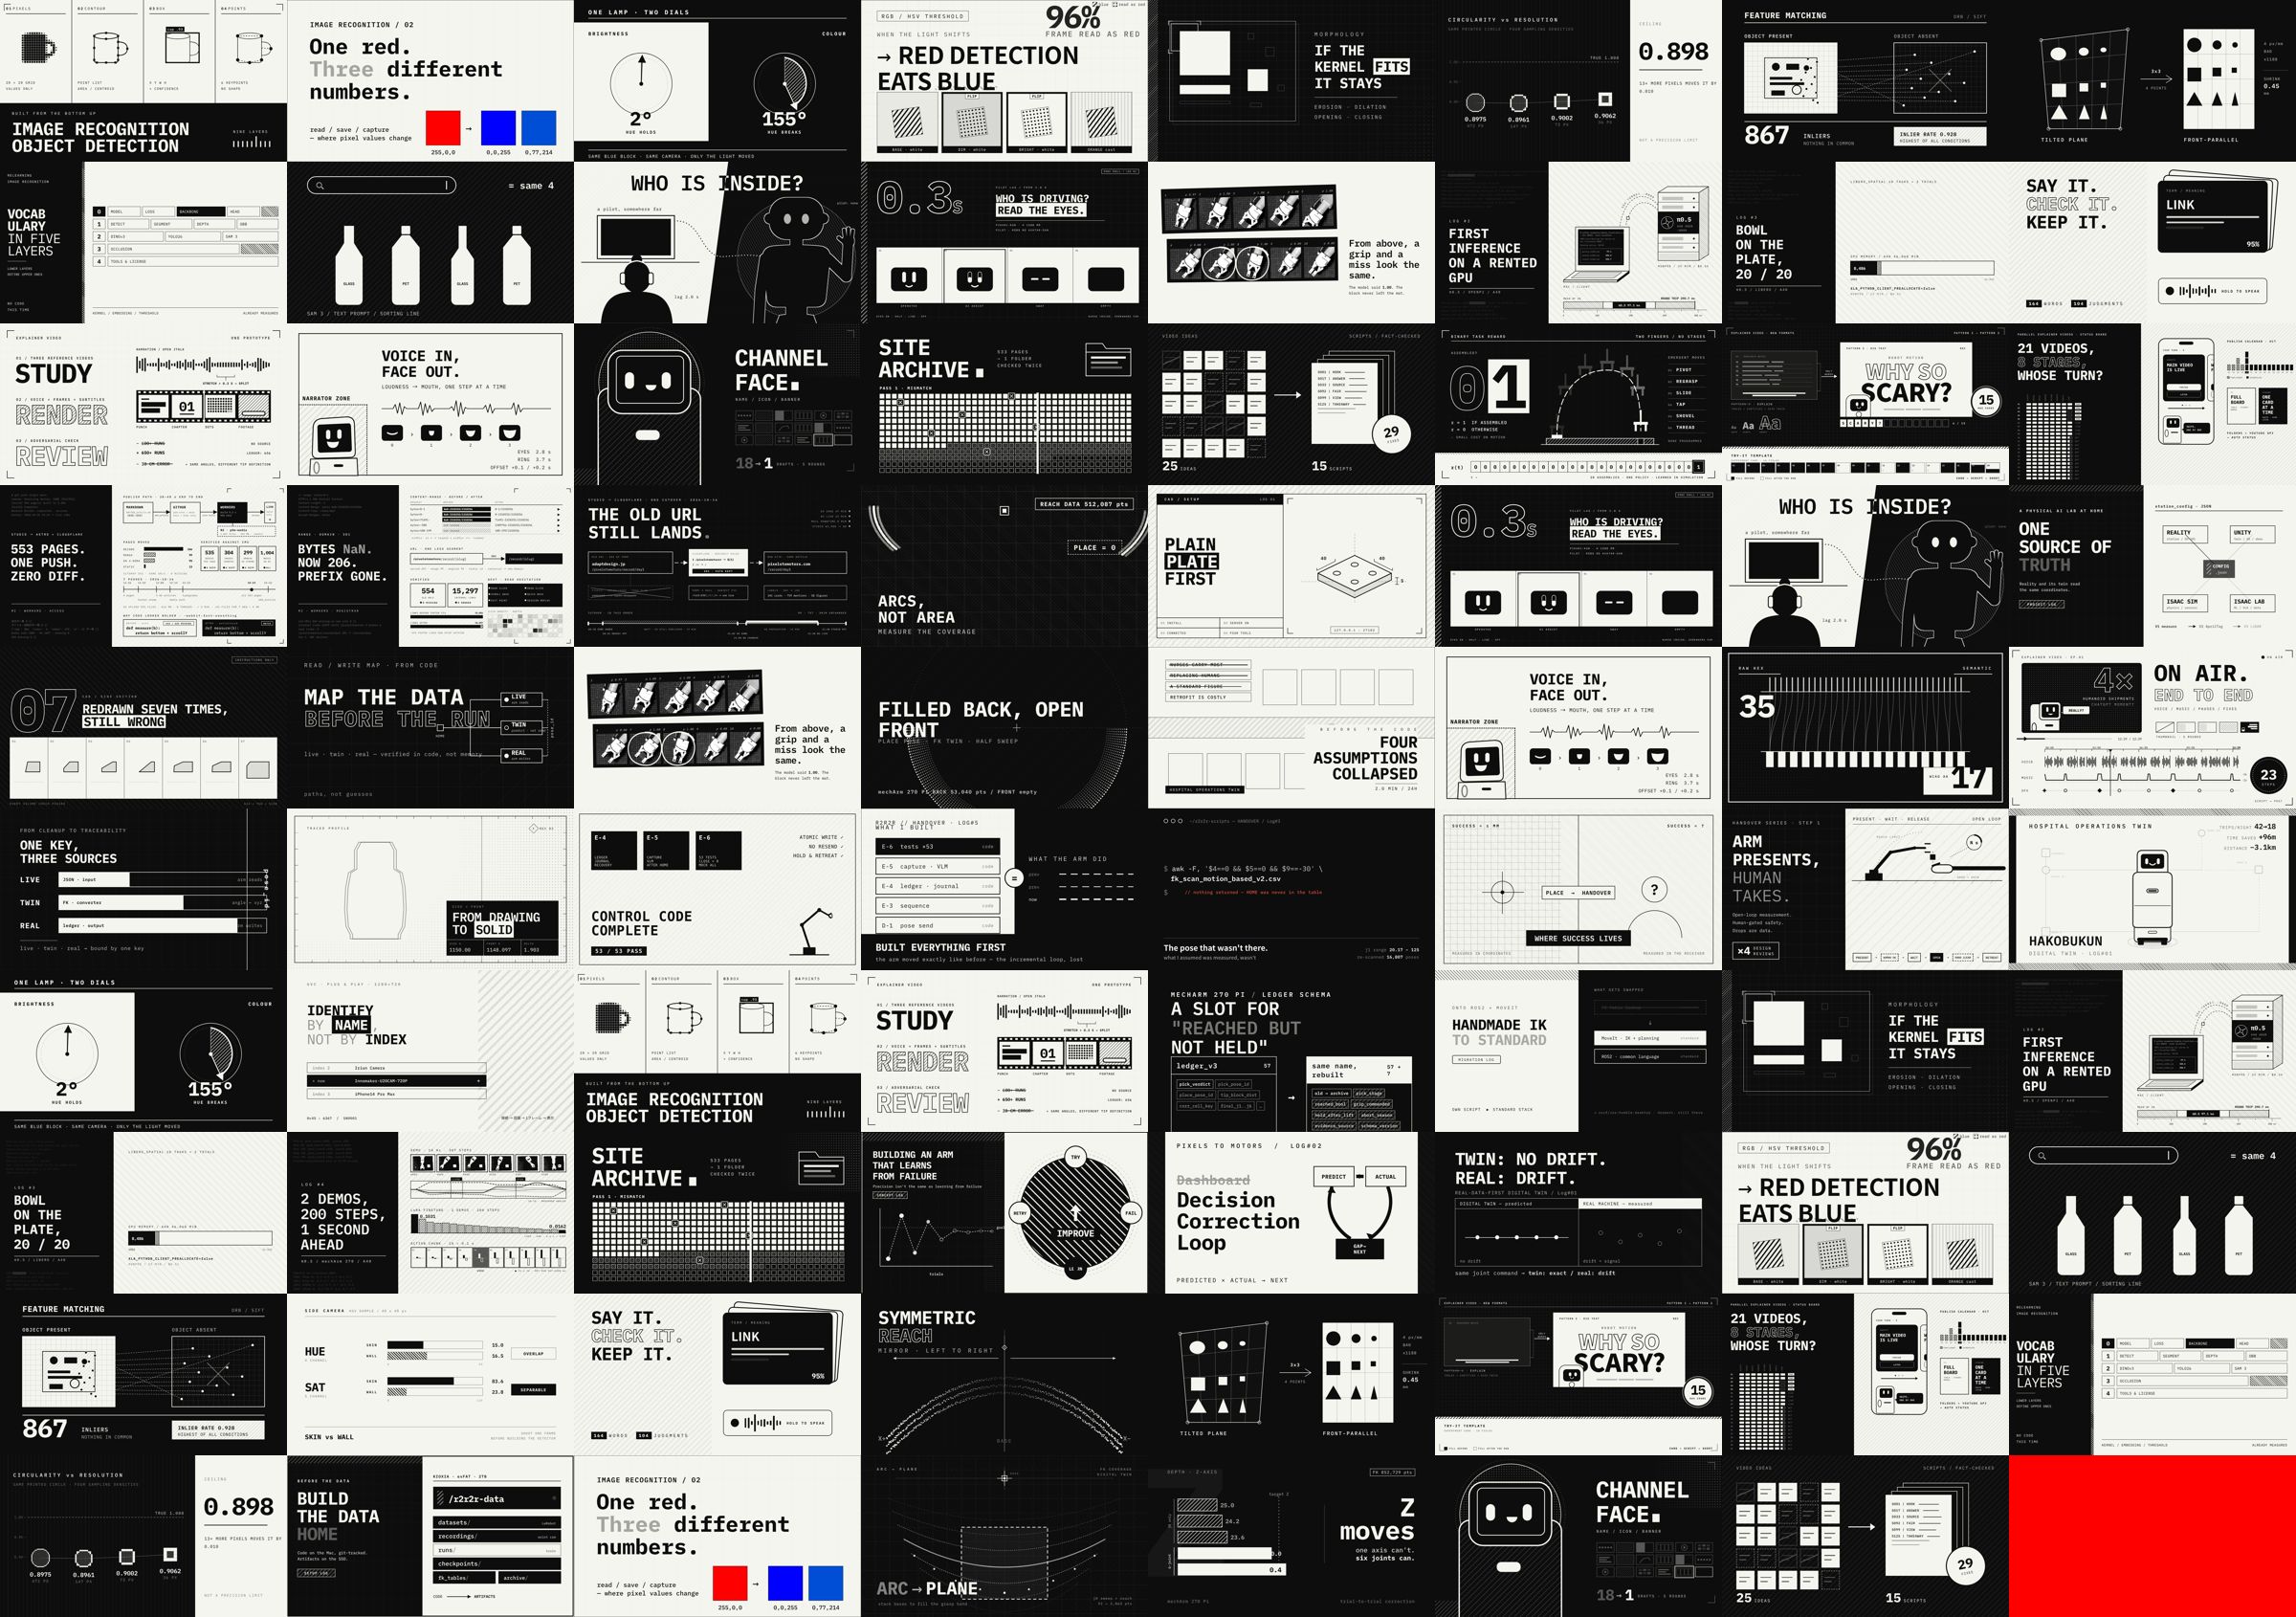
記事ページは、表紙の画像があればそれを、なければ書き出した画像を、どちらもなければ共通の画像を og:image にします。書き出した画像は、すでに GitHub にあるサムネイルの HTML から作ったものなので、例外として GitHub に入れました(記事に載せる写真は GitHub に入れない決まりです)。
$ grep -o '<meta property="og:image"[^>]*>' dist/record/video-progress-board.html dist/record/avatar-gitai.html dist/record/day1.html
dist/record/video-progress-board.html:<meta property="og:image" content="https://pixelstomotors.com/og/LOG339.jpg">
dist/record/avatar-gitai.html:<meta property="og:image" content="https://pixelstomotors.com/og/r-avatar-gitai.jpg">
dist/record/day1.html:<meta property="og:image" content="https://pixelstomotors.com/media/s-1920x1080_8be2d009-6246-461b-918c-83305563b159.webp">
default og remaining 0
$ git commit -m "Per-article share images rendered from thumbnails"
[main b6566be] Per-article share images rendered from thumbnails
$ curl -sS -m 15 "https://pixelstomotors.com/record/video-progress-board" | grep -o '<meta property="og:image"[^>]*>'
<meta property="og:image" content="https://pixelstomotors.com/og/LOG339.jpg">
og/LOG339.jpg 200 image/jpeg 131544
push のあと、作業中にできた Python の一時ファイル(tools/__pycache__/)が残っていると知らせが出たので、消して .gitignore に足しました。
記事ページの上に現在地、下に同じシリーズの前後の記事と近い6本を置いた
これまでの記事ページは、本文で終わっていて、ほかの記事へのリンクがありませんでした。検索から1本だけ開いた人は、そこで帰るしかありません。次の3つを足しました。
- 記事の上に「Pixels to Motors › シリーズ名」の現在地。日付の横のシリーズ名の札も、シリーズのページへのリンクにした
- 本文の終わりに、同じシリーズの「前の記事」「次の記事」(LOG 番号とタイトル)
- その下に、同じシリーズでこの記事に近い6本と、「シリーズ名の記録をすべて見る(○本)」のボタン
見た目が変わるので、公開する前に画面写真で見てもらいました。
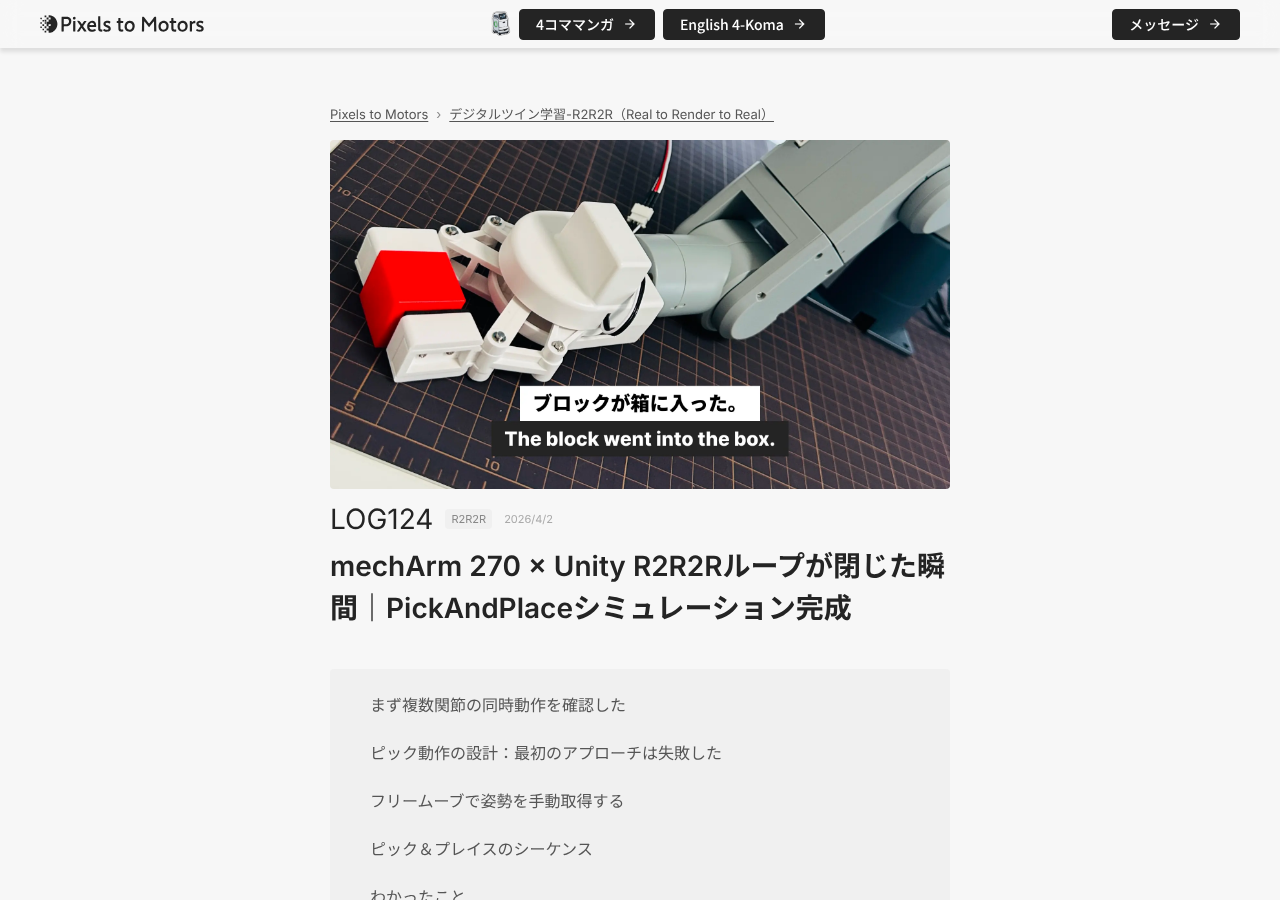
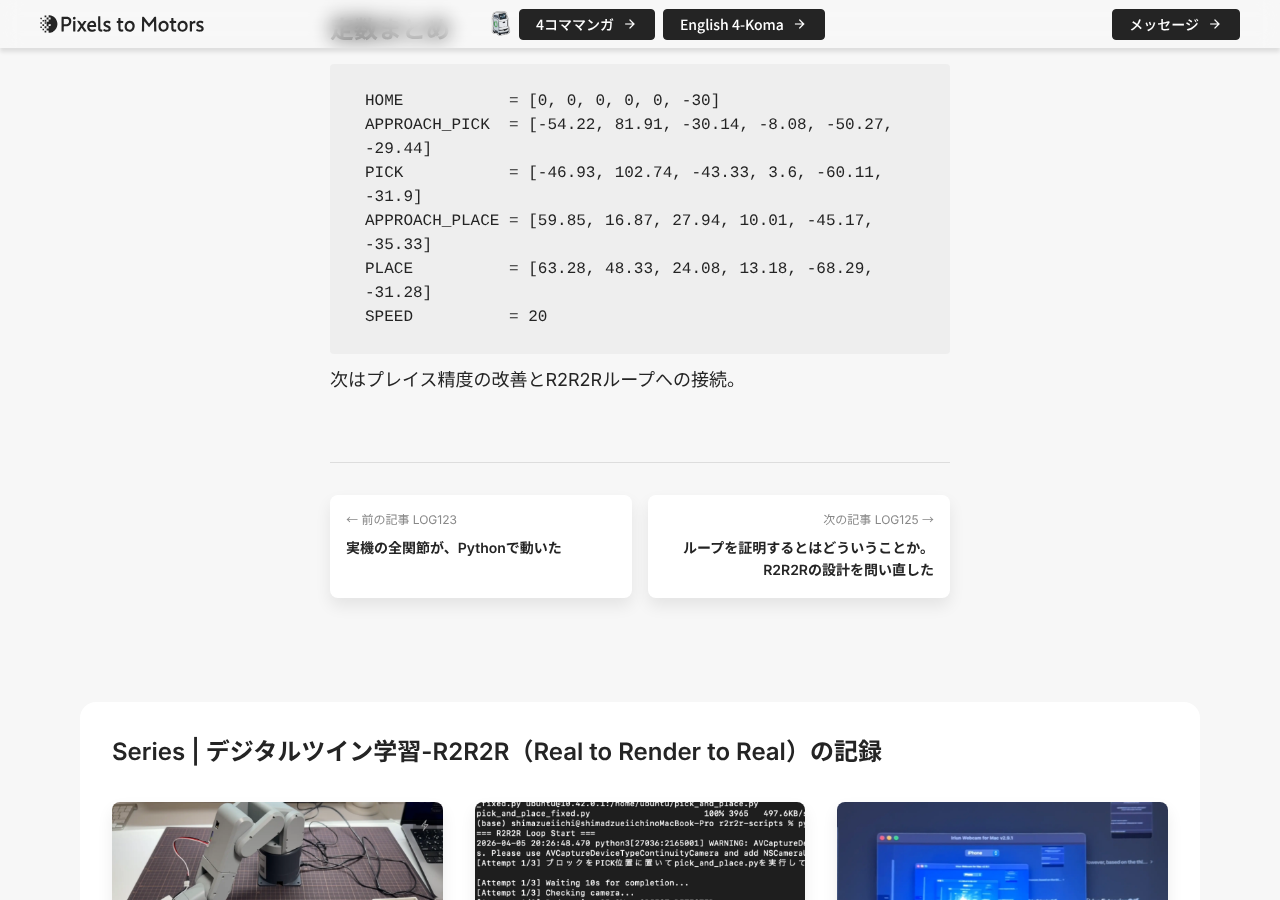
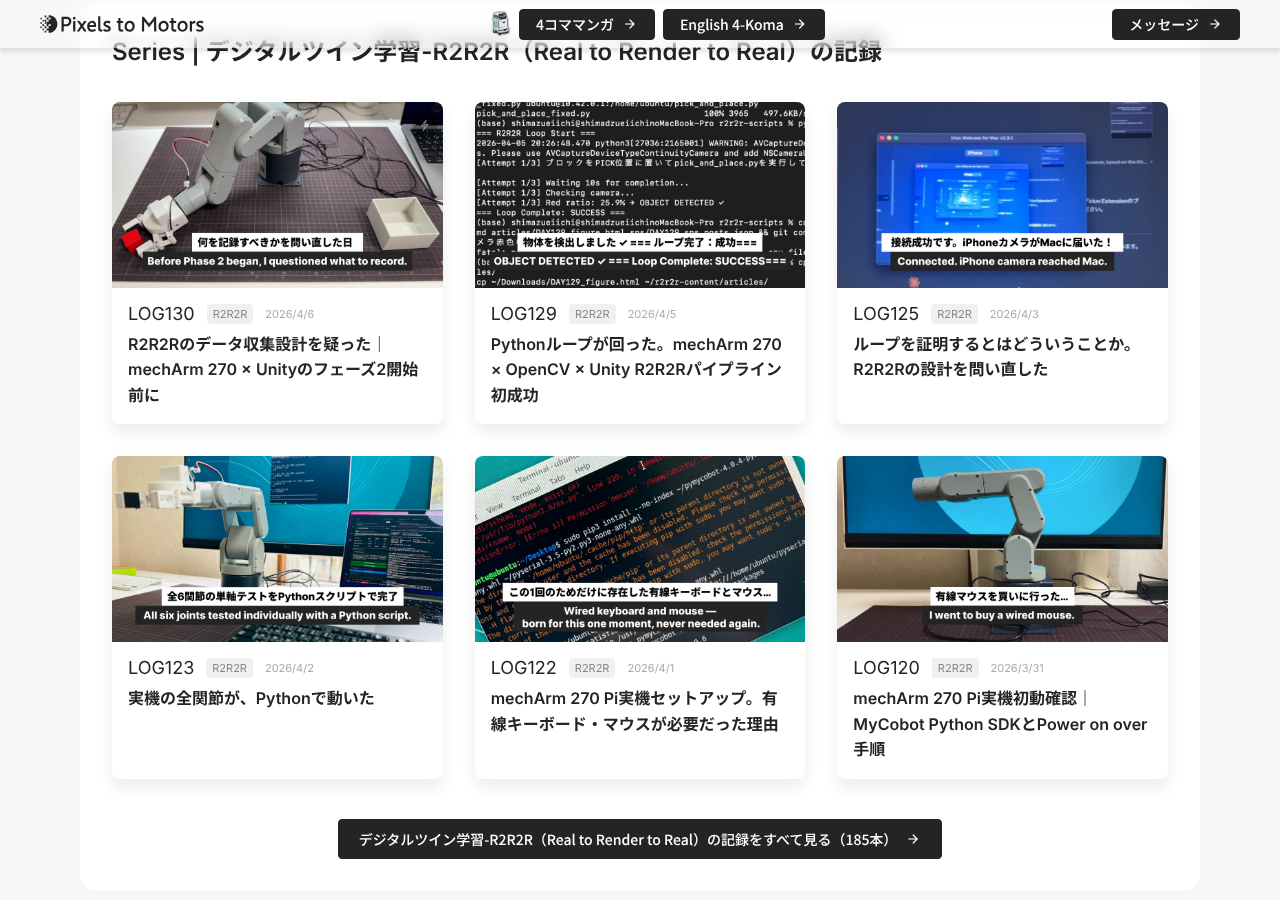
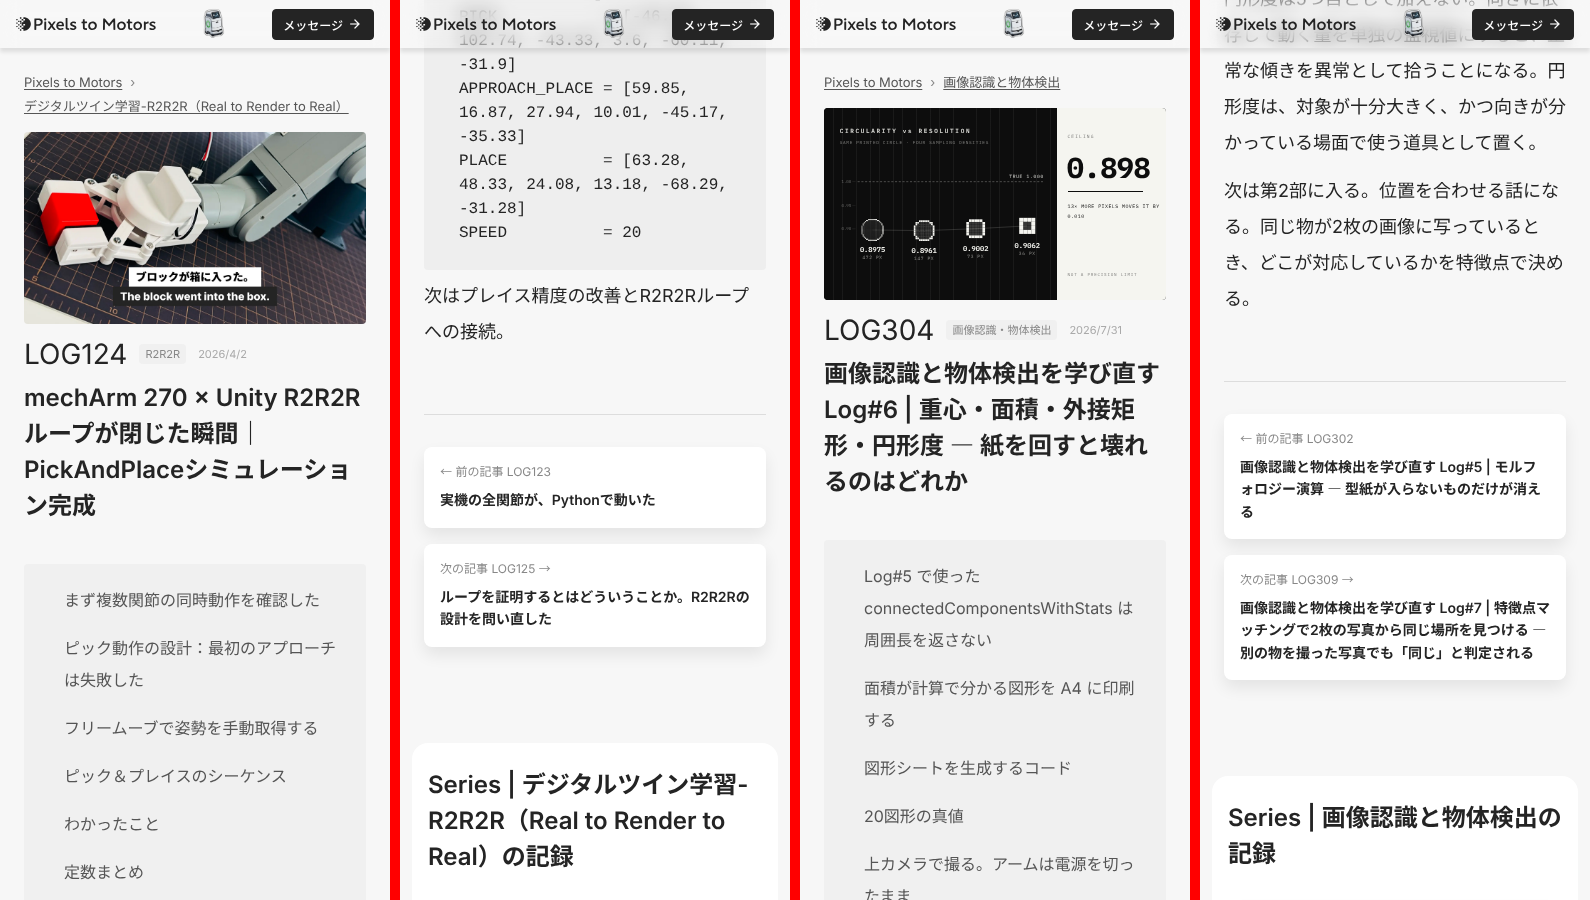
全349本の記事ページに3つとも入っていることを数えました。
$ python3 - <<'EOF'
import os
no_crumb=no_pager=no_rel=0
for f in os.listdir('dist/record'):
  s=open('dist/record/'+f).read()
  no_crumb+= 'class="crumbs"' not in s; no_pager+= 'class="pager"' not in s; no_rel+='class="related"' not in s
print(len(os.listdir('dist/record')),no_crumb,no_pager,no_rel)
EOF
349 0 0 0
確認を待つあいだは、本番(main)に入れるとすぐ公開されてしまうので、別のブランチに置きました。OK をもらってから main に入れています。
$ git checkout -b article-series-nav
$ git commit -m "Article pages: breadcrumb, prev/next in series, nearby series records"
[article-series-nav e30932f] Article pages: breadcrumb, prev/next in series, nearby series records
$ git push -u origin article-series-nav
$ git checkout main && git merge --ff-only article-series-nav && git push origin main
e30932f Article pages: breadcrumb, prev/next in series, nearby series records
$ git push origin --delete article-series-nav
error: RPC failed; HTTP 403 curl 22 The requested URL returned error: 403
$ curl -sS "https://pixelstomotors.com/record/day124" | grep -oE 'class="(crumbs|pager|related)"' | sort -u
class="crumbs"
class="pager"
class="related"
作業環境からはブランチの削除が許可されていなかったので、article-series-nav は GitHub に残っています(中身は main と同じです)。
Cloudflare Web Analytics を入れた ― 自動設定で全ページに計測が入り、プライバシーポリシーを書き換えた
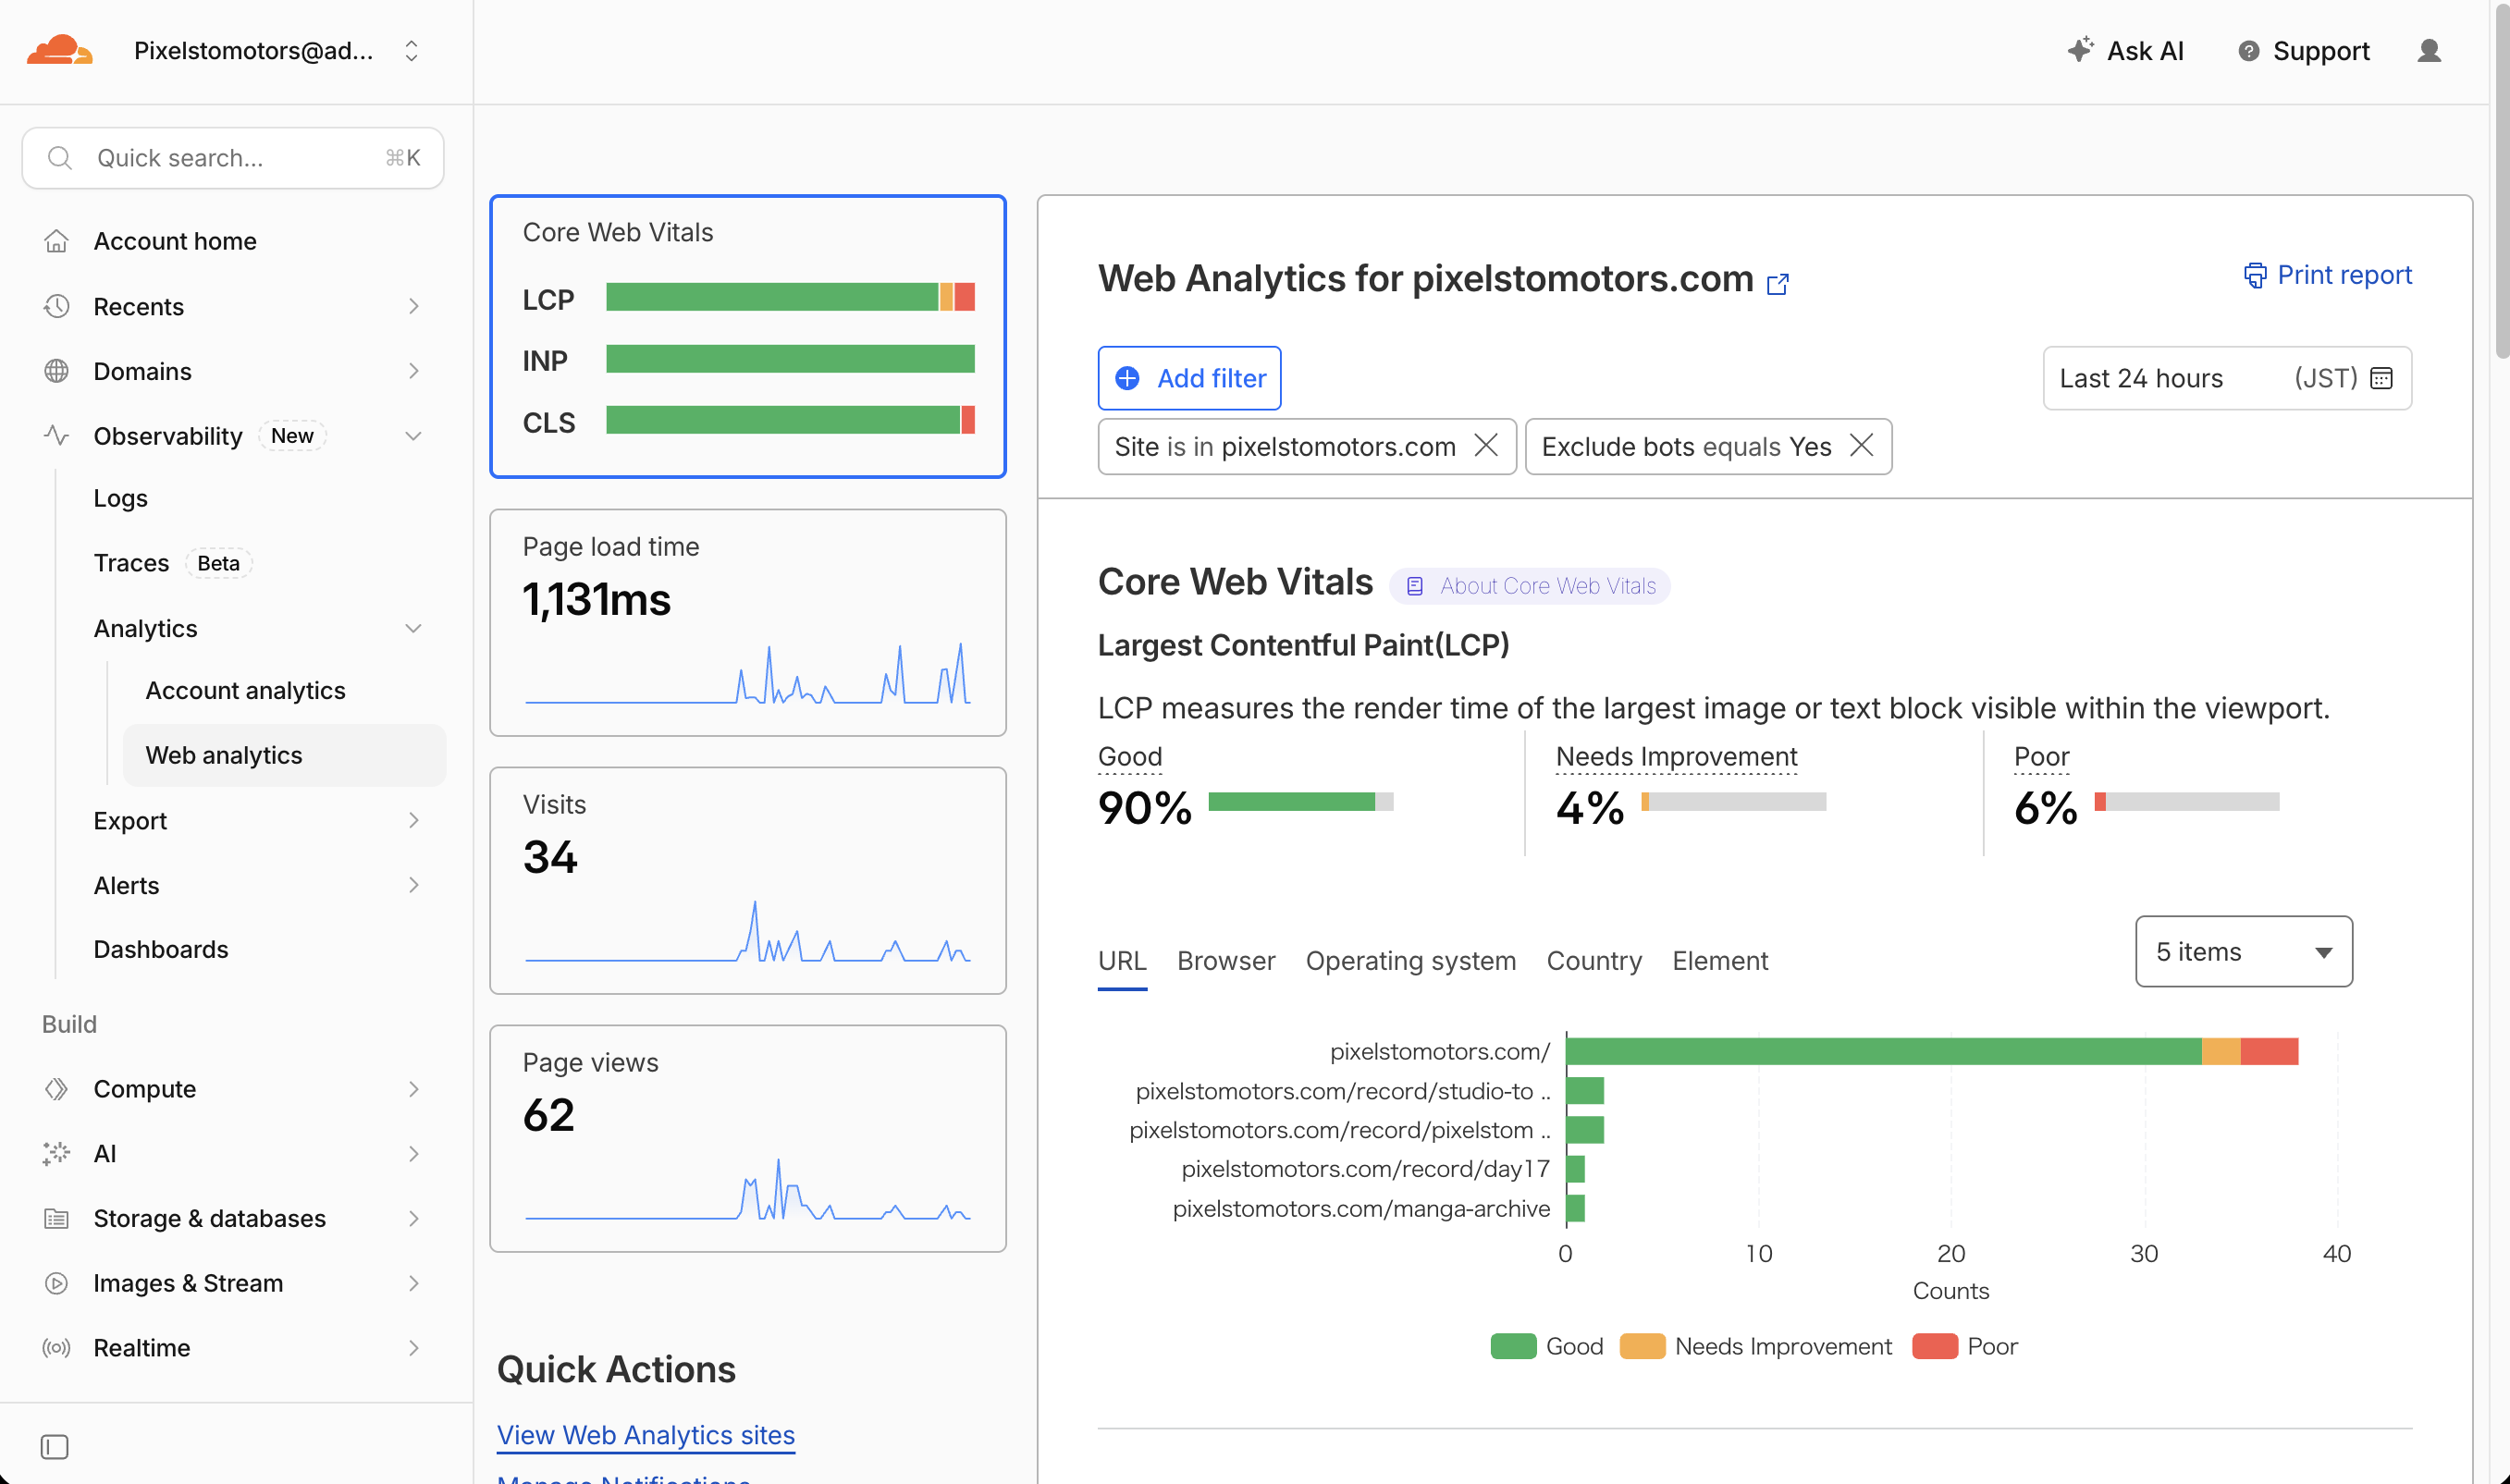
Search Console は「検索結果でどう見えたか」しか分かりません。どのページが読まれ、どの国から、どこを経由して来たかを見るため、Cookie を使わないアクセス解析(Cloudflare Web Analytics)を入れました。
最初は、管理画面のメニュー名を古い画面のまま案内してしまい、「Analytics & Logs どこ?」と画面写真が届きました。新しい画面では、左上の検索で「Web Analytics」と入れるか、「Observability」の中にあります。
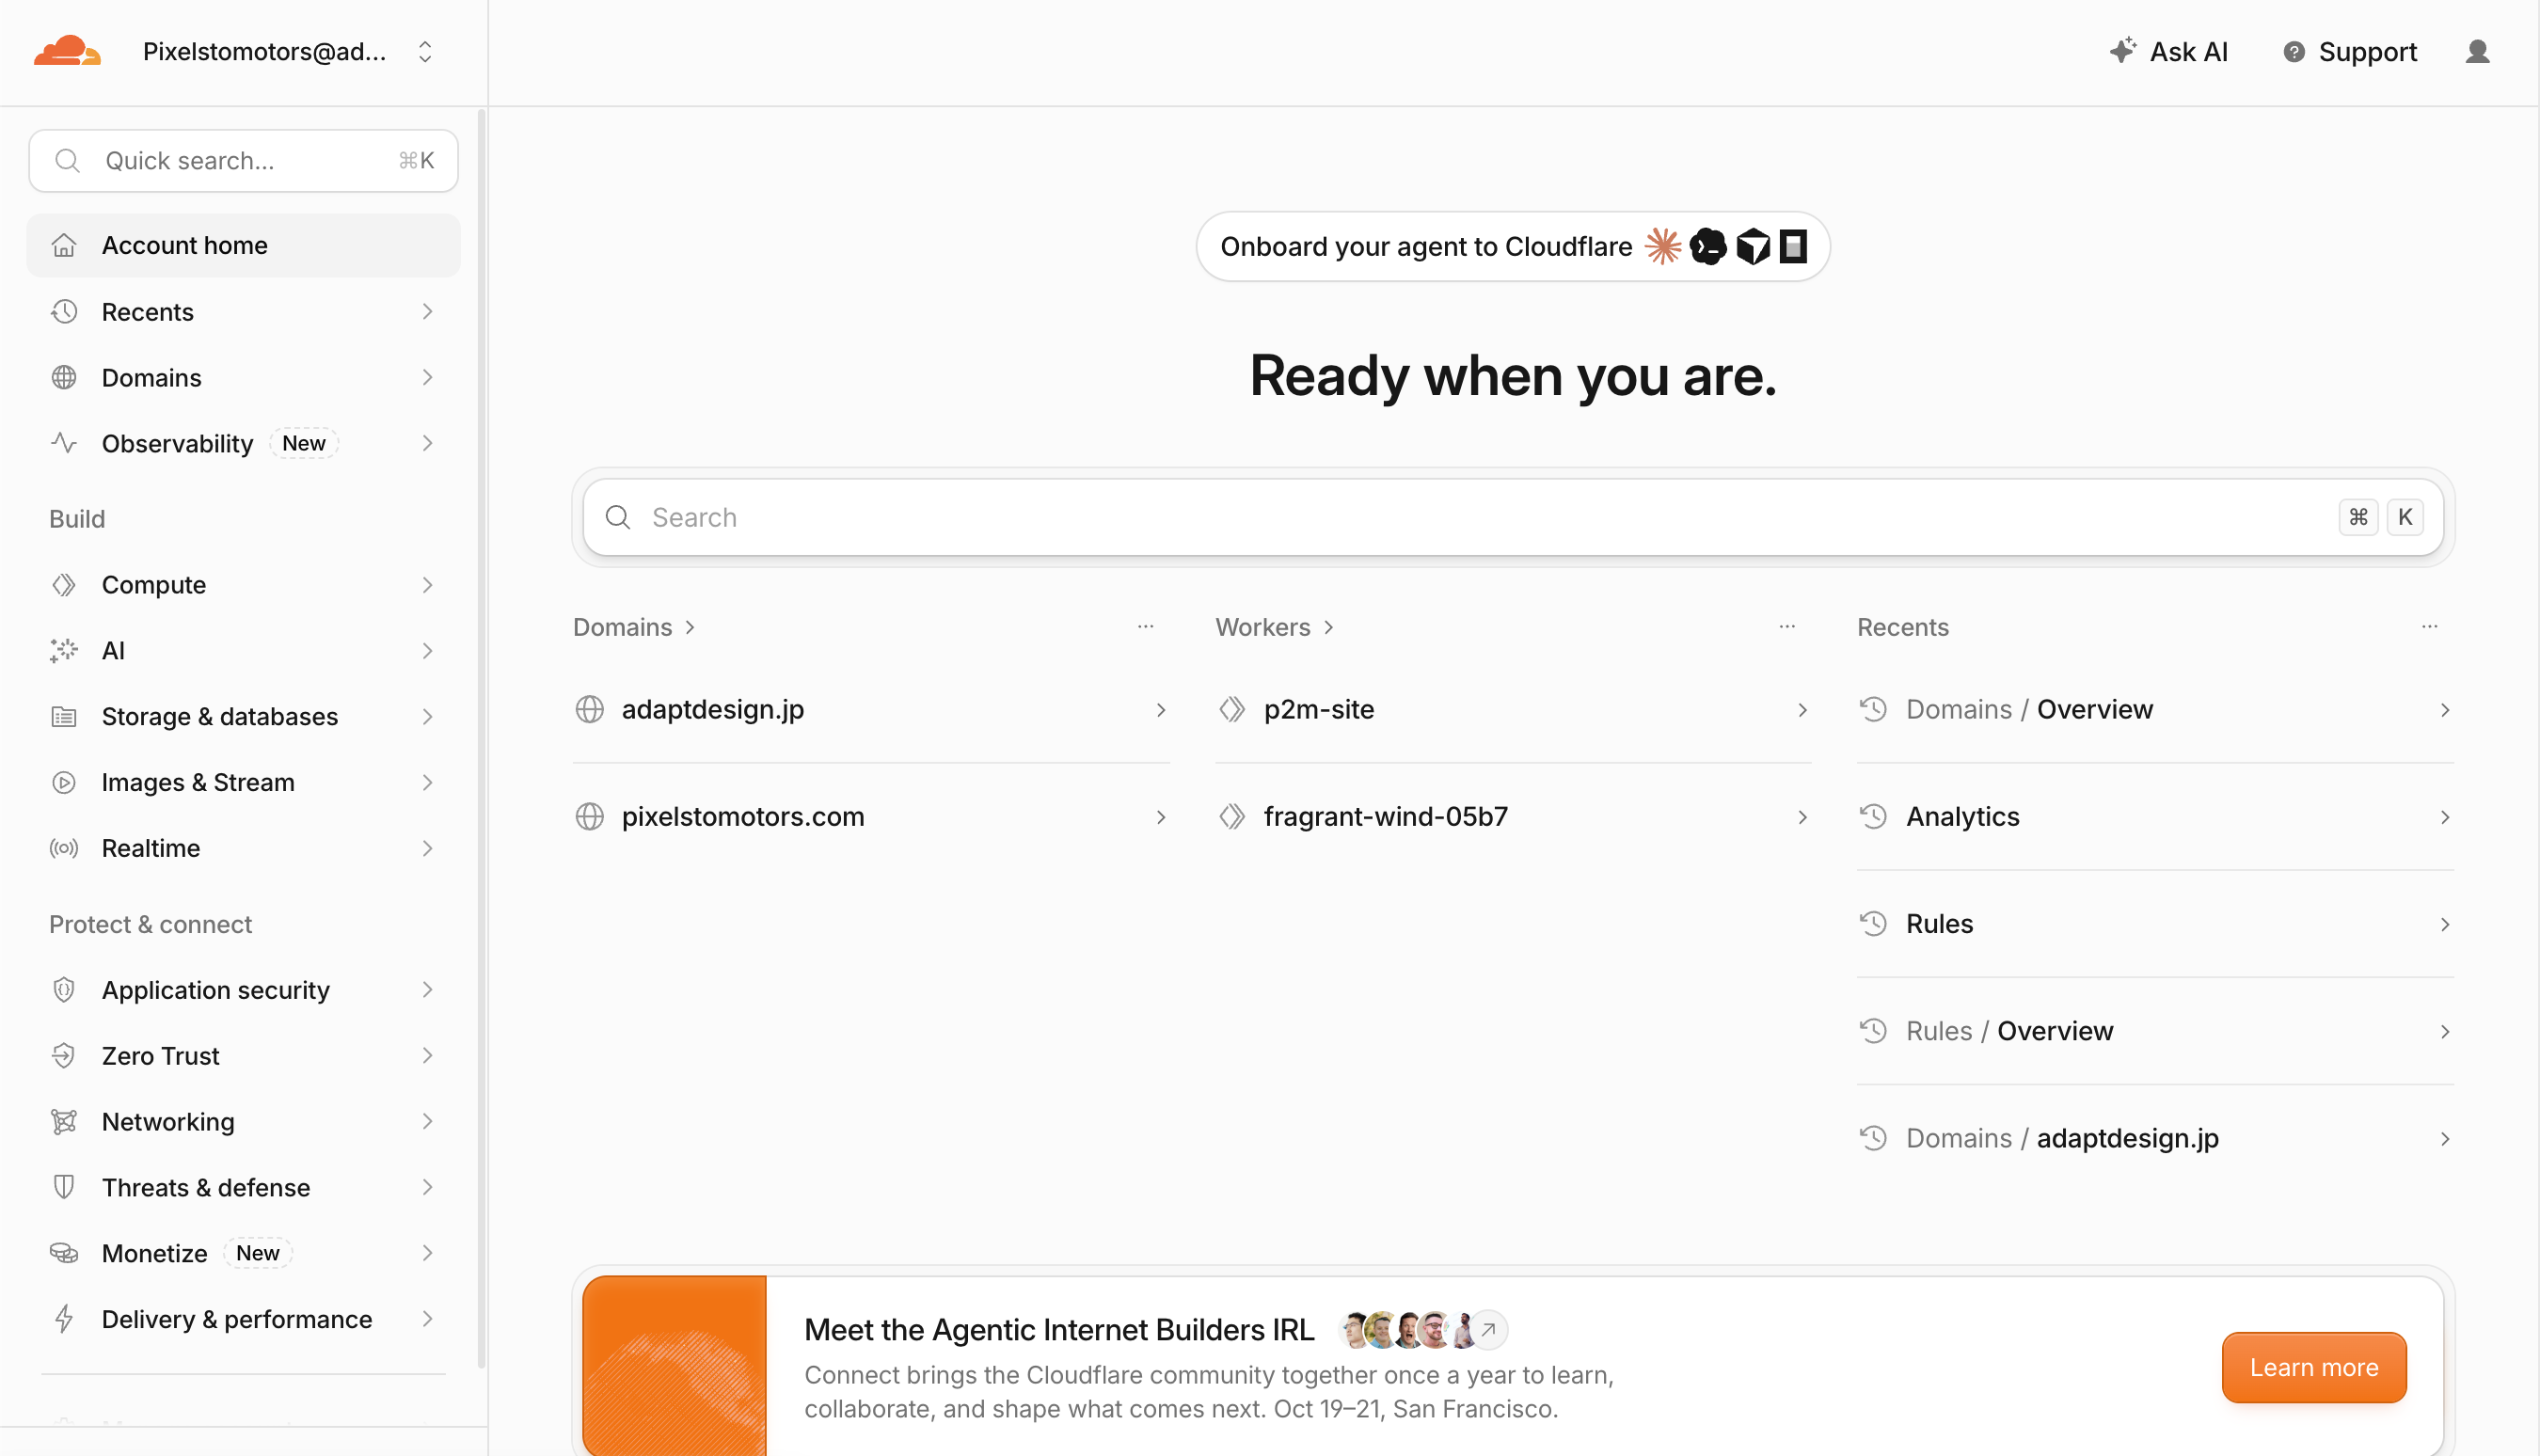
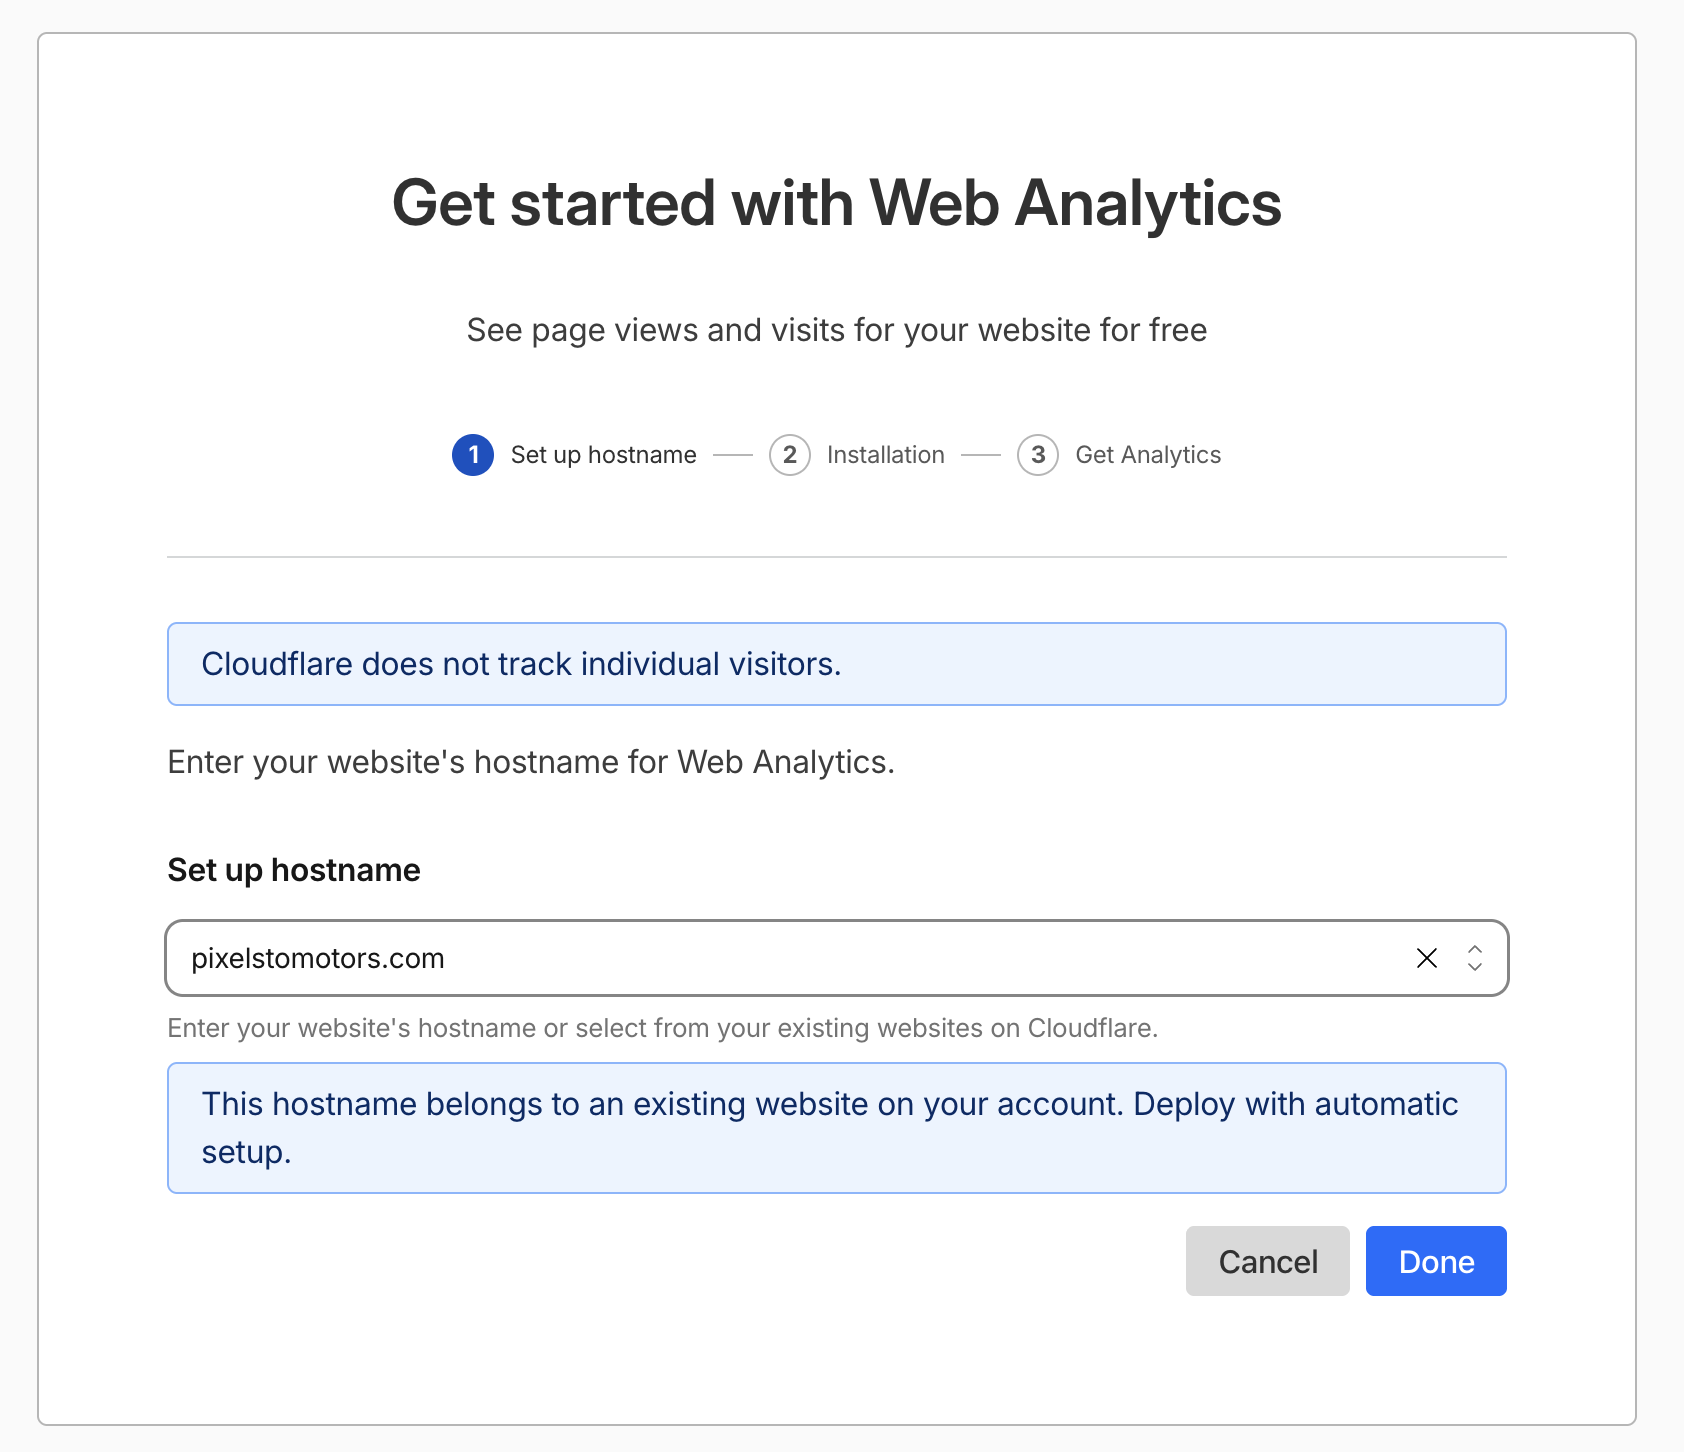
サイトを追加すると、pixelstomotors.com はすでに Cloudflare で管理しているため、計測用のコードを自動で差し込む方式(automatic setup)を勧められました。トークンを貼って手でコードを入れる方式を案内していましたが、自動で入るならそのほうが手間がないので、「Done」で進めてもらい、本当に入ったかをこちらで確かめることにしました。
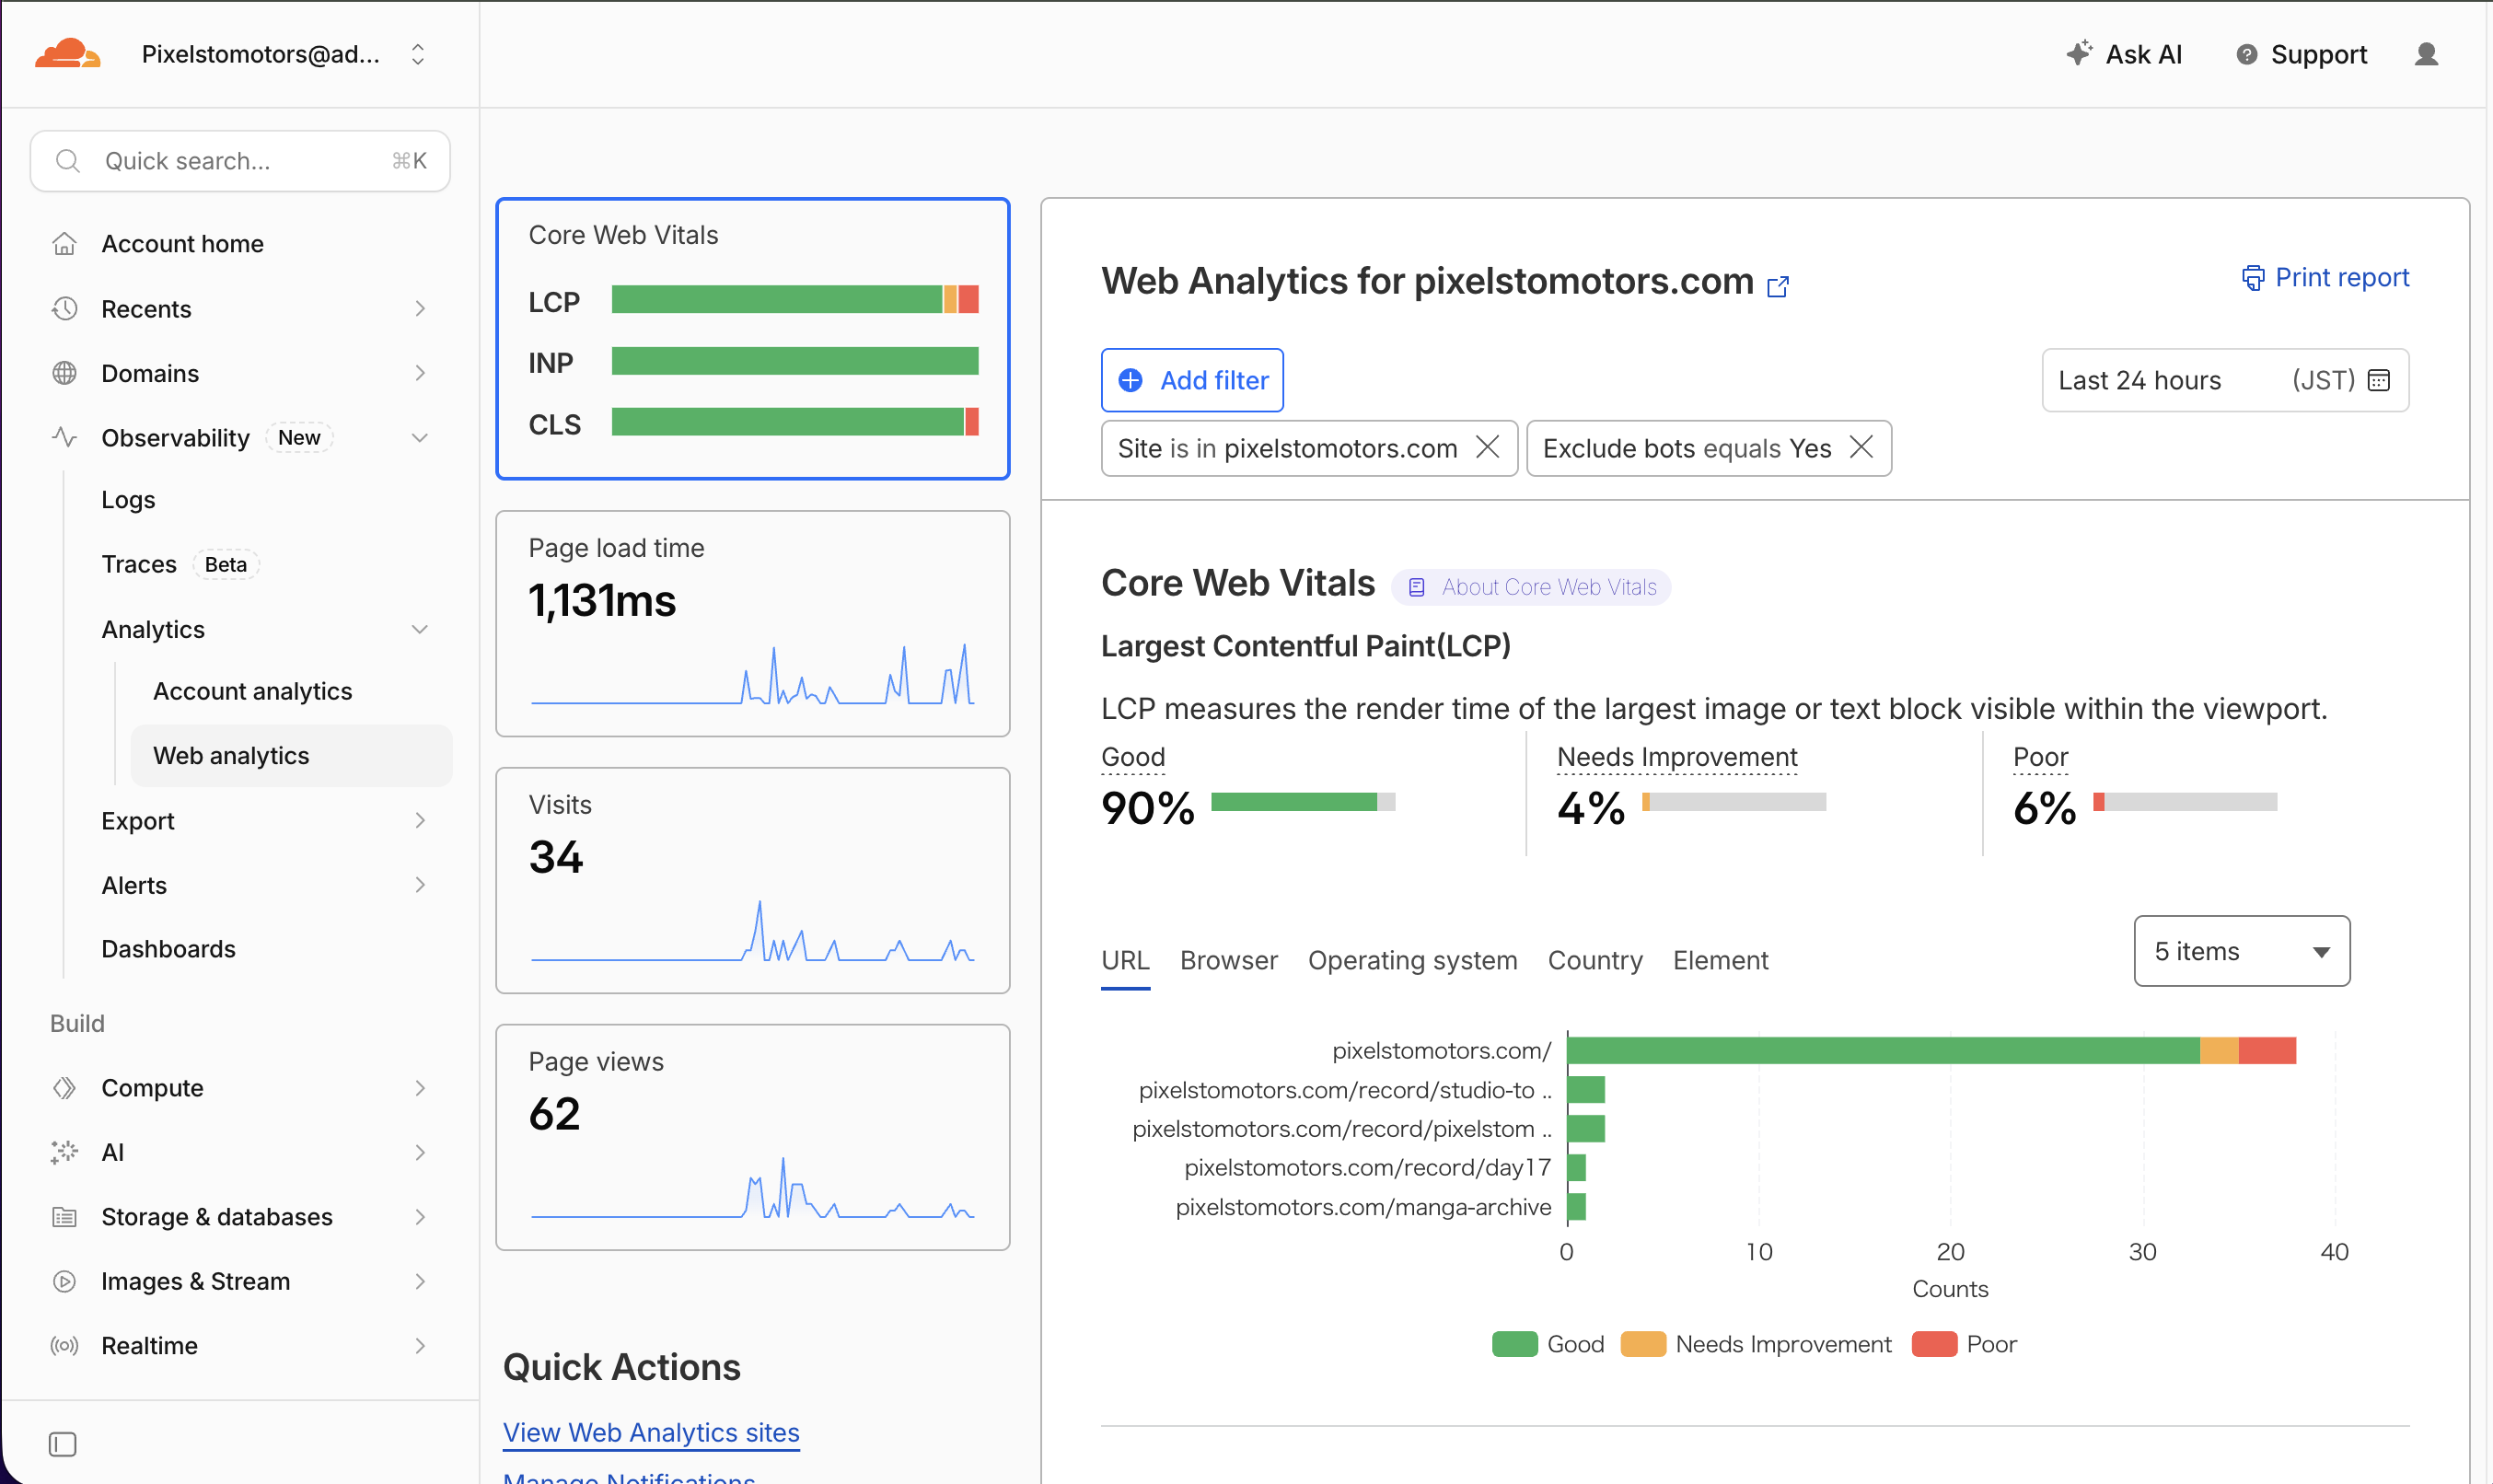
数分後には、訪問34件・ページビュー62件が出ていました。
公開中のページを取ってきて、計測用のコードが入っているかを確かめました。最初はコードが見つかりませんでした。
$ curl -sS -m 15 "https://pixelstomotors.com/record/day1" | grep -oE 'static\.cloudflareinsights\.com[^"]*|data-cf-beacon' | sort -u
(何も出ない)
自動設定は、ブラウザからの読み込みにだけコードを差し込みます。ブラウザと同じ形で取りに行くと入っていました。
$ curl -sS -m 15 -H 'Accept: text/html,application/xhtml+xml' -H 'User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0 Safari/537.36' "https://pixelstomotors.com/record/day1" | grep -oE '.{0,40}cloudflareinsights.{0,120}' | head -3
cript type="module" src="https://static.cloudflareinsights.com/beacon.min.js/v4bc70e2c01a94c73b74392e4234840661791215815920" integrity="sha512-L0ha0OXavK/8okipN9F8BtP84dg9DUhPERb
サイトのコードには手を入れていません。プライバシーポリシーの Cookie の節を、「Cookie を使わない Cloudflare Web Analytics で、閲覧数・表示速度・参照元・おおよその国・ブラウザや OS の種類を、個人を識別しない形で集計している」という内容に書き換えました。
$ npm run build
…
07:05:40 [build] 557 page(s) built in 7.41s
$ grep -o 'アクセス解析(Cloudflare Web Analytics)[^<]*' dist/privacypolicy.html | head -1
アクセス解析(Cloudflare Web Analytics)を利用しています。このアクセス解析は Cookie を使わず、ページの閲覧数・表示速度・参照元・おおよその国・ブラウザやOSの種類などを、個人を識別しない形で集計します。
$ git commit -m "privacy policy: describe Cloudflare Web Analytics (cookieless)"
[main c5418a4] privacy policy: describe Cloudflare Web Analytics (cookieless)
画面写真は、ウィンドウごと撮れば Claude がタブとアドレスバーを切り落とす
記事に載せる画面写真は、これまでエイイチが範囲を選んで撮り、ブラウザのタブやアドレスバーが入らないようにしていました。
画面をスクショしたときにメニューバーを切ってスクショするのが面倒(範囲を自分で決めてスクショするから)なので、メニューバーがあるスクショはトリミングして記事に掲載するようにルール化して欲しいけどできますか?
ウィンドウごと撮った画像から、枠と影、タブ・アドレスバー・ブックマークバーを切り落とすスクリプト(tools/crop_screenshot.py)を作り、記事の公開手順の最初に入れました。アドレスバーやタブには、アカウントの番号やメールの件名も写るので、それを載せない意味もあります。
送られてきたウィンドウごとの画面写真です(記事に載せるため、タブとアドレスバーの文字はぼかしています)。
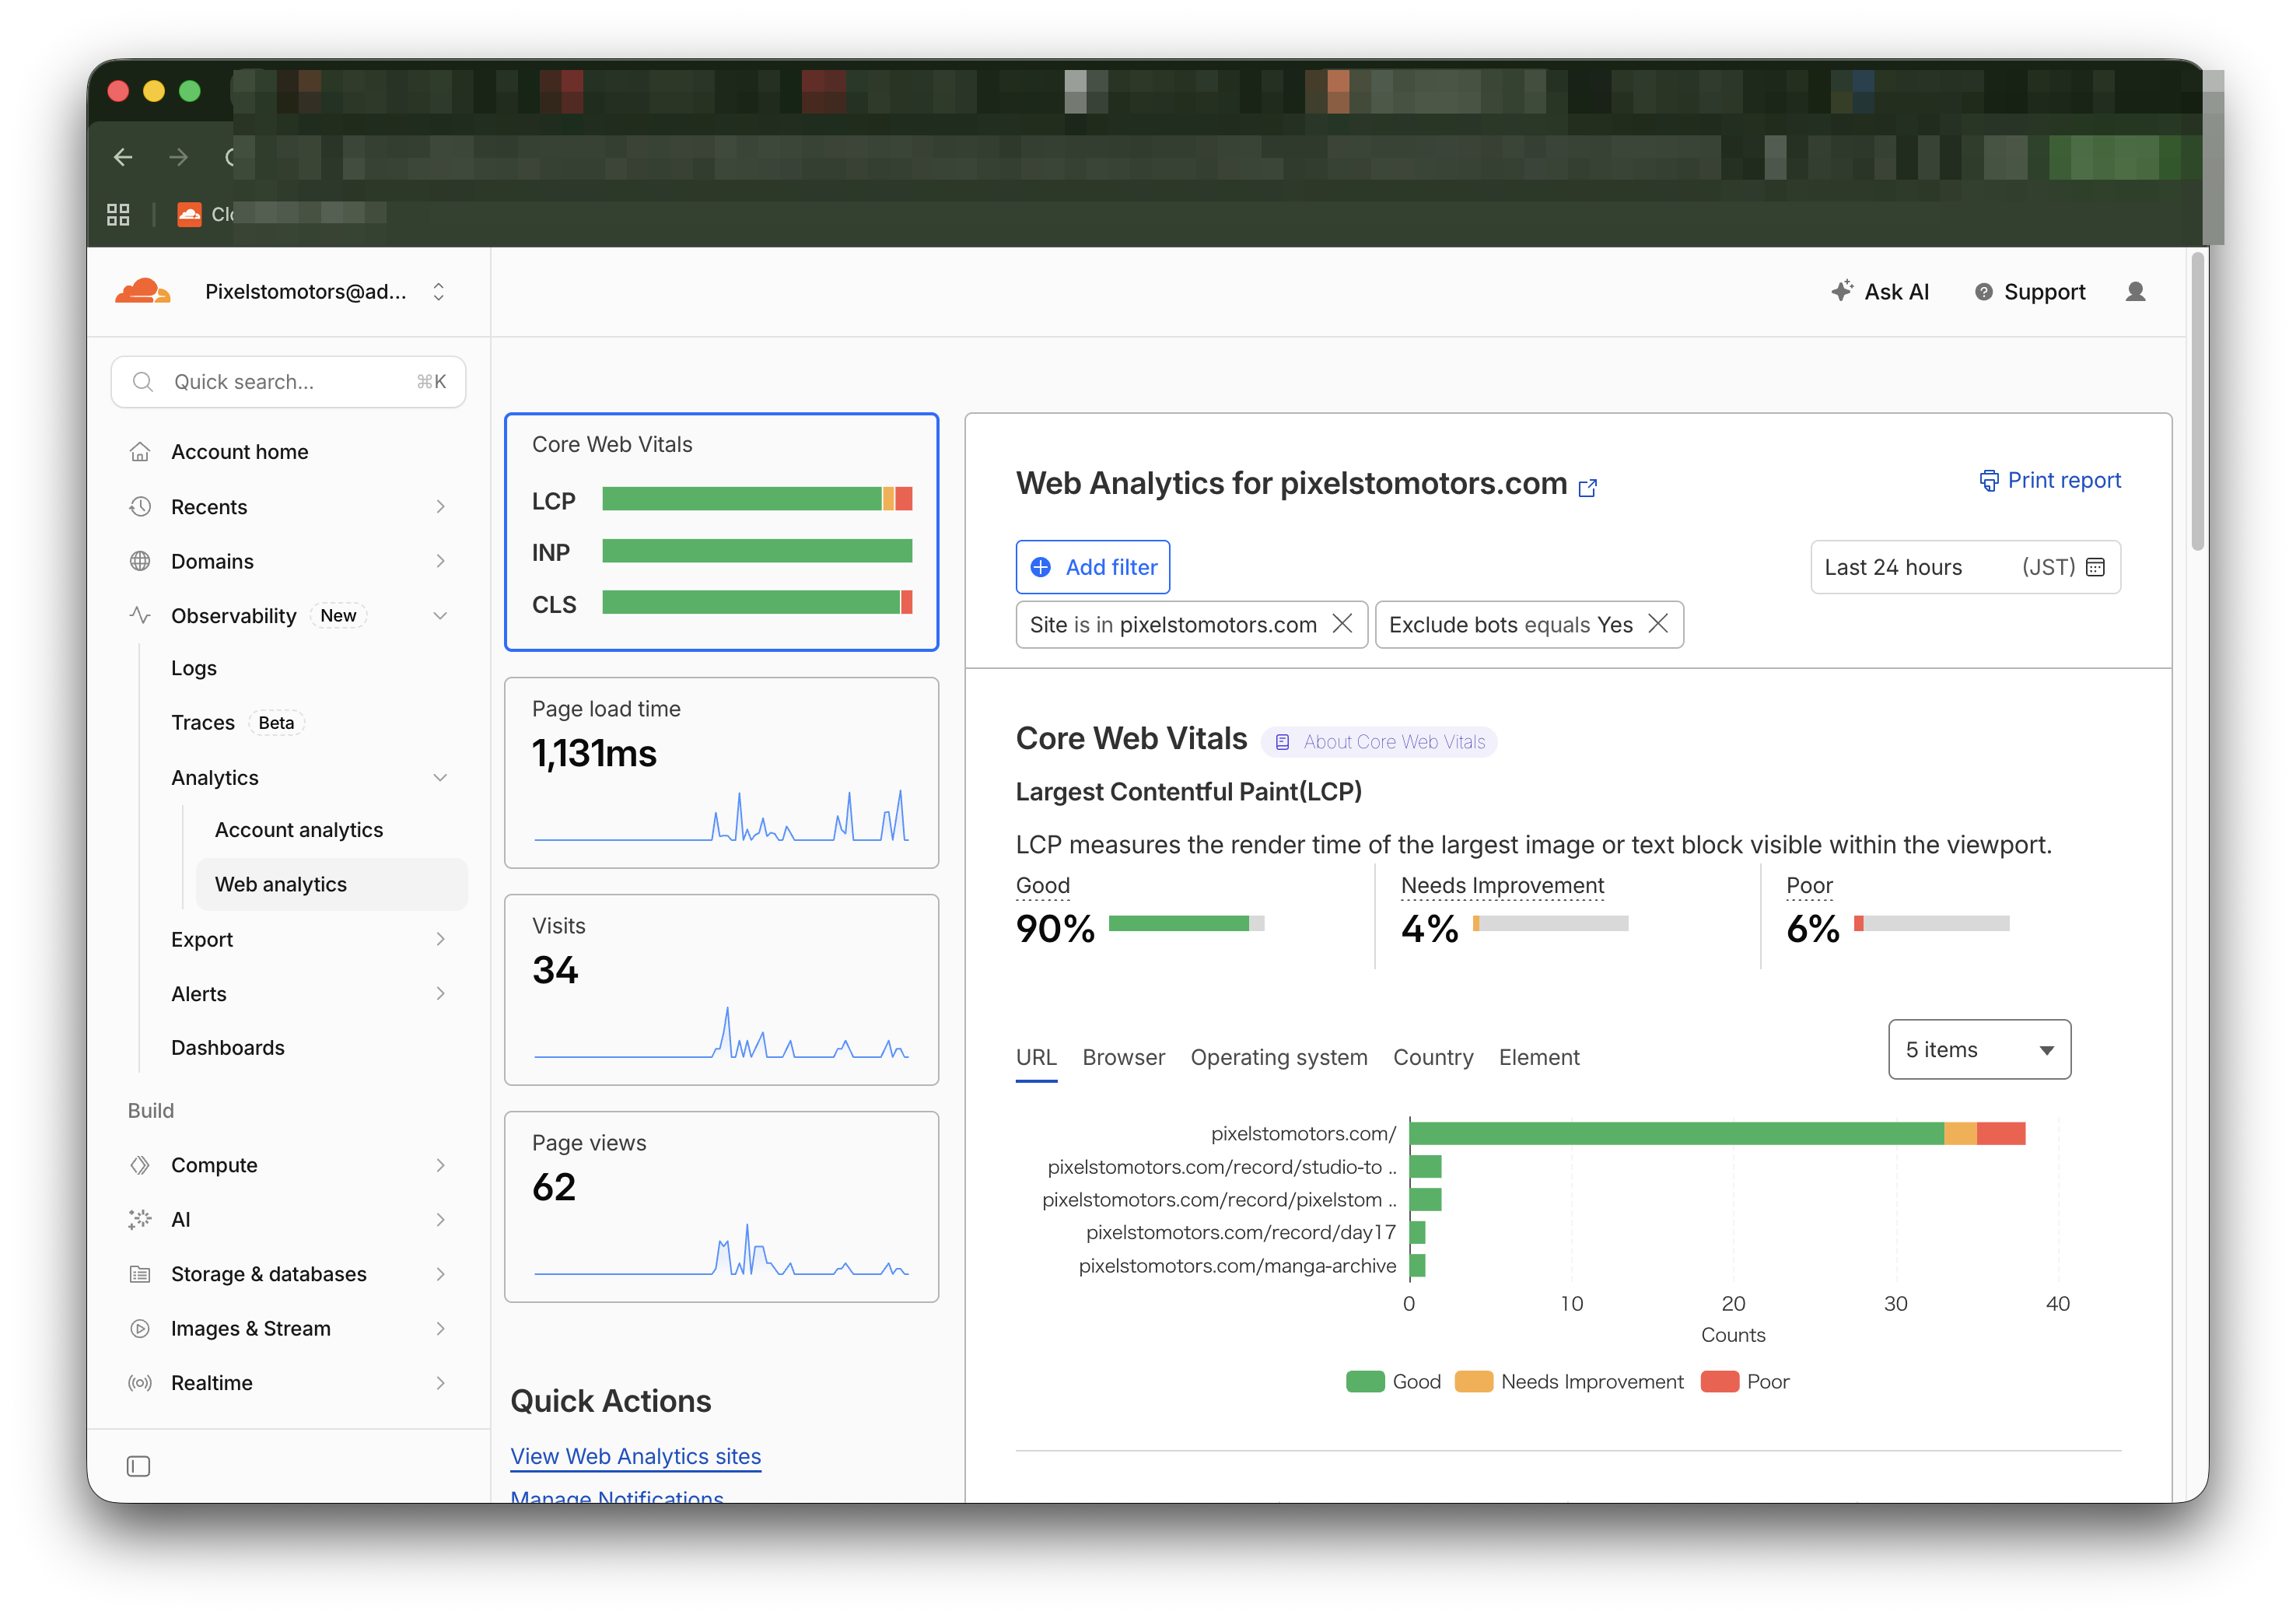
最初の版は、上から3割の範囲で「横幅いっぱいに色が切り替わる一番下の線」を探して、そこから下を残す作りでした。試すと、2枚とも切りすぎました。
$ python3 tools/crop_screenshot.py sample.png already_clean.png
sample.png: (2952, 2080) → (2714, 1489)(枠を除いて (2714, 1842)、上から 353px を切る)
already_clean.png: (2708, 1612) → (2696, 1486)(枠を除いて (2696, 1600)、上から 114px を切る)
ブラウザの帯の下にある、Cloudflare のページ自身のヘッダーまで切っていました。already_clean.png(エイイチが範囲を選んで撮った、もともと帯のない画像)も、ページのヘッダーを切られています。直したのは2点です。
- 自動で切るのは、ウィンドウごと撮った画像(外側が透明な影になっているもの)だけにする。範囲を選んで撮った画像は切らない
- ブラウザの帯の高さは、ウィンドウの大きさによらずほぼ一定(タブ+アドレスバー+ブックマークバーで約120pt)なので、探す範囲を上から130pt(Retina では2倍)までにする
$ python3 tools/crop_screenshot.py sample.png already_clean.png
sample.png: (2952, 2080) → (2714, 1605)(枠を除いて (2714, 1842)、上から 237px を切る)
already_clean.png: ウィンドウを撮った画像ではないので切らない(必要なら --box で指定)
切ったあとの画像です。エイイチが範囲を選んで撮った画像と同じ範囲になりました。
元の画像は、同じフォルダの _original/ に残します。画像を R2 に上げる tools/upload_media.py は、フォルダの下を深さを問わず読み、同じ名前のファイルがあると扱いが曖昧になるので、_original/ を読まないようにしました。
$ sed -n 69,72p tools/upload_media.py
    for root in roots:
        for dirpath, dirnames, filenames in os.walk(root):
            # _original/ は crop_screenshot.py が残した切る前の画像なので上げない
            dirnames[:] = [d for d in dirnames if not d.endswith(' 2') and not d.startswith('.') and d != '_original']
画面全体を撮った画像(画面上端の Mac のメニューバー入り)は自動では切りません。Claude が画像を見て、範囲を数字で指定して切ります。切ったあとは、毎回画像を開いて、中身が欠けていないか・枠が残っていないかを確かめます。この記事の Cloudflare のホームの画面写真(LOG344_04)は、下端にリンク先の住所(アカウントの番号入り)が出ていたので、下を50px切っています。
記事ルールに足した3つの決まり
この日の作業で、記事のルール(article_rules.md)に3つ足しました。
| 決まり | 中身 |
|---|---|
| SNS・検索結果用の画像 | 公開手順に tools/render_og.py で書き出す段を入れ、公開後に og:image を確かめる。サムネイルは読み込み後2.5秒の1コマが撮られるので、その時点で見出しと図がそろうように作る |
| 画像の説明(alt) | 「【画像】ファイル名 説明」と書けば、その説明が alt になる。書かなければ「記事タイトル|直前の見出し」 |
| 画面写真のトリミング | ウィンドウごと撮ってよい。Claude が枠・タブ・アドレスバー・ブックマークバー・メニューバーを切ってから載せる。元は _original/ に残す |
この記事を書く前にもう1つ、記事の最初の約1,500字は「このプロジェクトも分野も初めての人が読んで分かり、続きを読みたくなる書き出し」にし、その後ろを作業ログとして全量で載せる、という決まりを足しました。この記事がその最初の1本です。
記事の目次を、冒頭の書き出しのあとへ移した
この記事をサイトに入れて表示を確かめると、記事タイトルのすぐ下に、目次(この記事では25項目)が来ていました。Markdown の記事は、目次を本文の一番上に置く作りだったためです。初めて開いた人が最初に見るのが見出しの一覧になり、冒頭の書き出しが目次の下に押し出されます。
目次を、本文の最初の H2 見出しの直前に入れるように変えました(src/pages/record/[slug].astro)。冒頭の書き出しを読んだあとに目次が来て、そこから作業ログが始まります。Studio から移した記事は、もともと本文の中に目次の位置の印(<!--TOC-->)があるので変えていません。
$ for f in site-seo-by-ai studio-shutdown-cloudflare-redirect video-progress-board; do …(richText の中で、最初の段落・目次・最初の H2 の位置を数える)
site-seo-by-ai toc 1894 first p 17 first h2 4064 imgs 13 alt empty 12
studio-shutdown-cloudflare-redirect toc 545 first p 17 first h2 1796 imgs 17 alt empty 8
video-progress-board toc 940 first p 17 first h2 2284 imgs 9 alt empty 0
$ for f in site-seo-by-ai studio-shutdown-cloudflare-redirect; do echo "$f: $(grep -oE '<img[^>]*alt=""[^>]*>' dist/record/$f.html | wc -l) real empty-alt imgs"; done
site-seo-by-ai: 0 real empty-alt imgs
studio-shutdown-cloudflare-redirect: 0 real empty-alt imgs
3本とも、最初の段落(17文字目)→ 目次 → 最初の H2 の順になりました。1行目の「alt empty」の数は、コードの欄に書かれた alt="" の文字まで数えていたもので、実際の画像のタグで数え直すと0枚です。Markdown の記事8本すべてで、目次の位置が同じように変わります。
この日の commit
$ git log --stat --format='%n%h %s' 51c0267..HEAD

abd0f9d Markdown articles: place the table of contents before the first h2

 src/pages/record/[slug].astro | 8 +++++++-
 1 file changed, 7 insertions(+), 1 deletion(-)

1b4522a upload_media: skip _original/ left by crop_screenshot.py

 tools/upload_media.py | 3 ++-
 1 file changed, 2 insertions(+), 1 deletion(-)

e24fdb1 tools/crop_screenshot.py: strip window frame and browser bars from screenshots

 README.md                |   1 +
 tools/crop_screenshot.py | 113 +++++++++++++++++++++++++++++++++++++++++++++++
 2 files changed, 114 insertions(+)

c5418a4 privacy policy: describe Cloudflare Web Analytics (cookieless)

 src/pages/privacypolicy.astro | 6 +++---
 1 file changed, 3 insertions(+), 3 deletions(-)

e30932f Article pages: breadcrumb, prev/next in series, nearby series records

 src/pages/record/[slug].astro | 52 +++++++++++++++++++++++++++++++++++++++----
 1 file changed, 48 insertions(+), 4 deletions(-)

26143b2 Ignore Python cache directories

 .gitignore | 1 +
 1 file changed, 1 insertion(+)

b6566be Per-article share images rendered from thumbnails

 README.md                                          |   3 +-
 public/og/LOG298.jpg                               | Bin 0 -> 70854 bytes
 public/og/LOG299.jpg                               | Bin 0 -> 76319 bytes
 public/og/LOG300.jpg                               | Bin 0 -> 55329 bytes
 public/og/LOG301.jpg                               | Bin 0 -> 117460 bytes
 public/og/LOG302.jpg                               | Bin 0 -> 86994 bytes
 public/og/LOG304.jpg                               | Bin 0 -> 68306 bytes
 public/og/LOG309.jpg                               | Bin 0 -> 93441 bytes
 public/og/LOG310.jpg                               | Bin 0 -> 58033 bytes
 public/og/LOG313.jpg                               | Bin 0 -> 71760 bytes
 public/og/LOG317.jpg                               | Bin 0 -> 88027 bytes
 public/og/LOG321.jpg                               | Bin 0 -> 93894 bytes
 public/og/LOG322.jpg                               | Bin 0 -> 82309 bytes
 public/og/LOG325.jpg                               | Bin 0 -> 103323 bytes
 public/og/LOG326.jpg                               | Bin 0 -> 109596 bytes
 public/og/LOG327.jpg                               | Bin 0 -> 76749 bytes
 public/og/LOG328.jpg                               | Bin 0 -> 88022 bytes
 public/og/LOG330.jpg                               | Bin 0 -> 117705 bytes
 public/og/LOG331.jpg                               | Bin 0 -> 58300 bytes
 public/og/LOG332.jpg                               | Bin 0 -> 97077 bytes
 public/og/LOG334.jpg                               | Bin 0 -> 140793 bytes
 public/og/LOG335.jpg                               | Bin 0 -> 105638 bytes
 public/og/LOG336.jpg                               | Bin 0 -> 96243 bytes
 public/og/LOG338.jpg                               | Bin 0 -> 121824 bytes
 public/og/LOG339.jpg                               | Bin 0 -> 131544 bytes
 public/og/LOG340.jpg                               | Bin 0 -> 136300 bytes
 public/og/LOG342.jpg                               | Bin 0 -> 131626 bytes
 public/og/LOG343.jpg                               | Bin 0 -> 97869 bytes
 public/og/r-arcs-without-area.jpg                  | Bin 0 -> 174948 bytes
 public/og/r-autodesk-fusion-mcp-setup.jpg          | Bin 0 -> 70756 bytes
 public/og/r-avatar-gitai-pikari.jpg                | Bin 0 -> 82309 bytes
 public/og/r-avatar-gitai.jpg                       | Bin 0 -> 93790 bytes
 public/og/r-building-a-physical-ai-lab-at-home.jpg | Bin 0 -> 67987 bytes
 public/og/r-claude-instructions-hit-a-wall.jpg     | Bin 0 -> 97556 bytes
 public/og/r-data-map-before-real-run.jpg           | Bin 0 -> 68926 bytes
 public/og/r-decisions-api-grasp-check.jpg          | Bin 0 -> 103323 bytes
 public/og/r-digital-twin-place-surface.jpg         | Bin 0 -> 96262 bytes
 public/og/r-does-a-delivery-robot-help-nurses.jpg  | Bin 0 -> 75472 bytes
 .../og/r-explainer-video-character-narration.jpg   | Bin 0 -> 58317 bytes
 public/og/r-figma-design-token-consolidation.jpg   | Bin 0 -> 106218 bytes
 public/og/r-first-video-end-to-end.jpg             | Bin 0 -> 126781 bytes
 public/og/r-from-cleanup-to-traceability.jpg       | Bin 0 -> 62416 bytes
 public/og/r-from-drawing-to-solid.jpg              | Bin 0 -> 91056 bytes
 public/og/r-handover-control-code-complete.jpg     | Bin 0 -> 101545 bytes
 public/og/r-handover-lost-the-incremental-loop.jpg | Bin 0 -> 67874 bytes
 .../og/r-handover-present-pose-from-probe-scan.jpg | Bin 0 -> 42154 bytes
 public/og/r-handover-series-concept.jpg            | Bin 0 -> 176575 bytes
 public/og/r-handover-step1-design.jpg              | Bin 0 -> 88410 bytes
 ...pital-operations-digital-twin-system-design.jpg | Bin 0 -> 95615 bytes
 public/og/r-hue-holds-color-breaks.jpg             | Bin 0 -> 55329 bytes
 public/og/r-identify-camera-by-name-not-index.jpg  | Bin 0 -> 68944 bytes
 ...image-recognition-object-detection-overview.jpg | Bin 0 -> 70854 bytes
 public/og/r-making-explainer-video-with-ai.jpg     | Bin 0 -> 117705 bytes
 public/og/r-measure-holding-needs-ledger.jpg       | Bin 0 -> 77662 bytes
 public/og/r-mecharm-onto-ros2-moveit.jpg           | Bin 0 -> 58336 bytes
 public/og/r-morphology-kernel-fits-or-vanishes.jpg | Bin 0 -> 86994 bytes
 public/og/r-openpi-remote-inference-first-run.jpg  | Bin 0 -> 109651 bytes
 public/og/r-pi05-libero-benchmark-first-run.jpg    | Bin 0 -> 76749 bytes
 public/og/r-pi05-mecharm-demo-to-inference.jpg     | Bin 0 -> 137687 bytes
 public/og/r-pixelstomotors-site-archive.jpg        | Bin 0 -> 141373 bytes
 public/og/r-precision-is-not-learning-so101.jpg    | Bin 0 -> 131419 bytes
 .../og/r-predicted-vs-actual-correction-loop.jpg   | Bin 0 -> 74717 bytes
 public/og/r-real-data-first-digital-twin.jpg       | Bin 0 -> 65265 bytes
 public/og/r-rgb-hsv-threshold-lighting-failure.jpg | Bin 0 -> 117460 bytes
 public/og/r-sam3-first-look-sorting-line.jpg       | Bin 0 -> 88027 bytes
 public/og/r-same-place-different-object.jpg        | Bin 0 -> 93441 bytes
 ...r-shoot-one-frame-before-building-detection.jpg | Bin 0 -> 42532 bytes
 public/og/r-speak-to-relearn-robotics.jpg          | Bin 0 -> 88001 bytes
 public/og/r-symmetric-reach-mirror.jpg             | Bin 0 -> 61381 bytes
 public/og/r-tilted-plane-to-flat.jpg               | Bin 0 -> 58033 bytes
 public/og/r-video-patterns-and-try-it.jpg          | Bin 0 -> 98202 bytes
 public/og/r-video-progress-board.jpg               | Bin 0 -> 131544 bytes
 public/og/r-vocabulary-of-modern-vision.jpg        | Bin 0 -> 71760 bytes
 public/og/r-what-circularity-actually-measures.jpg | Bin 0 -> 68306 bytes
 public/og/r-where-learning-data-lives.jpg          | Bin 0 -> 79341 bytes
 public/og/r-where-pixel-values-change.jpg          | Bin 0 -> 76319 bytes
 public/og/r-which-file-the-live-pick-reads.jpg     | Bin 0 -> 94085 bytes
 public/og/r-why-z-correction-failed-twin-poses.jpg | Bin 0 -> 54633 bytes
 public/og/r-youtube-channel-identity.jpg           | Bin 0 -> 97077 bytes
 public/og/r-youtube-script-curation.jpg            | Bin 0 -> 105638 bytes
 src/pages/record/[slug].astro                      |   8 ++-
 tools/add_article.py                               |   6 ++-
 tools/render_og.py                                 |  55 +++++++++++++++++++++
 83 files changed, 68 insertions(+), 4 deletions(-)

2415138 privacy policy: match what the site actually does

 src/pages/privacypolicy.astro | 13 +++++++++----
 1 file changed, 9 insertions(+), 4 deletions(-)

ef68534 seo: alt text, structured data, hreflang/lang, titles and descriptions

 public/_headers                        |  6 ++++
 src/components/MangaArchive.astro      | 14 +++++++-
 src/components/MangaCard.astro         |  4 +--
 src/components/MangaPage.astro         | 24 ++++++++++---
 src/components/RecordCard.astro        |  4 +--
 src/layouts/Base.astro                 | 41 ++++++++++++++-------
 src/lib/remark-markers.mjs             | 15 ++++++--
 src/lib/seo.ts                         | 65 ++++++++++++++++++++++++++++++++++
 src/pages/404.astro                    |  4 +--
 src/pages/[series].astro               | 12 +++++--
 src/pages/index.astro                  | 11 ++++--
 src/pages/mecharm_data_blueprint.astro |  4 ++-
 src/pages/message.astro                |  2 +-
 src/pages/privacypolicy.astro          |  2 +-
 src/pages/record/[slug].astro          | 46 +++++++++++++++++++++---
 15 files changed, 215 insertions(+), 39 deletions(-)

873898e feat: add sitemap.xml and robots.txt for search engines

 astro.config.mjs         |  5 ++++
 package-lock.json        | 78 ++++++++++++++++++++++++++++++++++++++++++++++++
 package.json             |  1 +
 public/robots.txt        |  4 +++
 src/pages/sitemap.xml.ts |  9 ++++++
 5 files changed, 97 insertions(+)

a4a0292 fix: remove noindex,nofollow — site is now public, not a prototype

 src/layouts/Base.astro | 3 +--
 1 file changed, 1 insertion(+), 2 deletions(-)
コード全文
この日に作った・書き換えたファイルの、作業を終えた時点の全文です。
src/layouts/Base.astro
---
// 全ページ共通の枠(head・ヘッダー・フッター)
// lang: ページの言語(英語のページは 'en')/ ogType: 記事は 'article'
// alternates: 日本語版・英語版の対応(hreflang)/ jsonLd: 構造化データ(schema.org)
import { SITE, SITE_NAME, DEFAULT_OG, abs } from '../lib/seo';
interface Props {
  title: string; description?: string; ogImage?: string; path: string;
  lang?: 'ja' | 'en'; ogType?: 'website' | 'article'; noindex?: boolean;
  alternates?: { lang: string; path: string }[]; jsonLd?: object | object[];
  published?: string; modified?: string;
}
const { title, description = '', ogImage, path, lang = 'ja', ogType = 'website', noindex = false,
  alternates = [], jsonLd, published, modified } = Astro.props;
const canonical = SITE + path;
const image = abs(ogImage || DEFAULT_OG);
const desc = description.length > 160 ? description.slice(0, 159) + '…' : description;
const ld = jsonLd ? JSON.stringify(jsonLd).replace(/</g, '\\u003c') : null;
---
<!doctype html>
<html lang={lang}>
<head>
  <meta charset="utf-8" />
  <meta name="viewport" content="width=device-width, initial-scale=1" />
  <title>{title}</title>
  <meta name="description" content={desc} />
  <link rel="canonical" href={canonical} />
  {alternates.length > 0 && [{ lang, path }, ...alternates].map((a) => <link rel="alternate" hreflang={a.lang} href={SITE + a.path} />)}
  <meta property="og:site_name" content={SITE_NAME} />
  <meta property="og:locale" content={lang === 'en' ? 'en_US' : 'ja_JP'} />
  <meta property="og:title" content={title} />
  <meta property="og:description" content={desc} />
  <meta property="og:type" content={ogType} />
  <meta property="og:url" content={canonical} />
  <meta property="og:image" content={image} />
  {ogType === 'article' && published && <meta property="article:published_time" content={published} />}
  {ogType === 'article' && modified && <meta property="article:modified_time" content={modified} />}
  <meta name="twitter:card" content="summary_large_image" />
  <meta name="robots" content={noindex ? 'noindex, follow' : 'index, follow, max-image-preview:large'} />
  {ld && <script type="application/ld+json" set:html={ld} />}
  <link rel="icon" type="image/png" href="/site/9cad887a-242b-4953-bd36-7b368c27d1b9.png" />
  <link rel="preconnect" href="https://fonts.googleapis.com" />
  <link rel="preconnect" href="https://fonts.gstatic.com" crossorigin />
  <link href="https://fonts.googleapis.com/css2?family=Inter:wght@300;400;500;600;700&family=Noto+Sans+JP:wght@300;400;500;700&display=swap" rel="stylesheet" />
  <link rel="stylesheet" href="https://fonts.googleapis.com/css2?family=Material+Symbols+Outlined:opsz,wght,FILL,GRAD@20..48,400,0,0&display=block" />
  <slot name="head" />
</head>
<body>
  <header class="site-header">
    <div class="hd-inner">
      <a class="logo" href="/">
        <img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20" />
      </a>
      <div class="hd-center">
        <a class="hd-manga" href="/manga-archive"><img src="/site/s-500x700_f2c5ae27-2ebe-4d15-8da4-05853d4973ef.webp" alt="4コママンガ" width="500" height="700" /></a>
        <a class="btn-dark" href="/manga-archive">4コママンガ<i class="ms">arrow_forward</i></a>
        <a class="btn-dark" href="/manga-archive-en">English 4-Koma<i class="ms">arrow_forward</i></a>
      </div>
      <a class="btn-dark hd-msg" href="/message">メッセージ<i class="ms">arrow_forward</i></a>
    </div>
  </header>
  <main><slot /></main>
  <footer class="site-footer">
    <div class="ft-inner">
      <span>© ADAPT DESIGN 2026</span>
      <a href="/privacypolicy">Privacy policy</a>
    </div>
  </footer>
  <script>
    // 図解(隔離した枠)から届いた高さで、枠の高さを合わせる
    window.addEventListener('message', (e) => {
      const h = e.data && e.data.p2mHeight;
      if (typeof h !== 'number' || !isFinite(h) || h <= 0) return;
      for (const f of document.querySelectorAll('iframe[data-embed]')) {
        if (f.contentWindow === e.source) { f.style.height = Math.min(Math.ceil(h), 20000) + 'px'; break; }
      }
    });
  </script>
</body>
</html>

<style is:global>
  :root {
    --ink: #242424; --ink-2: #555; --ink-3: #888; --line: #f2f2f2;
    --bg: #f7f7f7; --panel: #fff; --dark: #242424;
    --sans: Inter, 'Noto Sans JP', sans-serif;
    --mono: Menlo, Monaco, 'Courier New', monospace;
  }
  * { box-sizing: border-box; }
  html { -webkit-text-size-adjust: 100%; }
  /* Studio と同じく、Mac で文字を細めに描く指定(ないと太く濃く見える) */
  body { margin: 0; background: var(--bg); color: var(--ink); font-family: var(--sans);
    -webkit-font-smoothing: antialiased; -moz-osx-font-smoothing: grayscale; }
  a { color: inherit; text-decoration: none; }
  img { max-width: 100%; display: block; }
  .ms { font-family: 'Material Symbols Outlined'; font-style: normal; font-size: 16px; line-height: 1; }

  .site-header { position: fixed; inset: 0 0 auto 0; z-index: 50; height: 48px; padding: 6px 40px;
    background: rgba(255,255,255,.1); backdrop-filter: blur(10px); -webkit-backdrop-filter: blur(10px);
    box-shadow: 0 4px 4px rgba(0,0,0,.1); }
  .hd-inner { max-width: 1280px; margin: 0 auto; height: 36px; display: flex; align-items: center; justify-content: space-between; gap: 40px; }
  .logo { display: flex; align-items: center; }
  .logo-img { height: 17.3px; width: auto; }
  /* 元は Studio 付属の有料フォント「A1ゴシック M」。移行先では使えないため代用中 */
  .logo span { font-family: 'Noto Sans JP', sans-serif; font-weight: 500; font-size: 20px; letter-spacing: -0.4px; color: var(--ink); }
  .hd-center { display: flex; align-items: center; gap: 8px; }
  .hd-manga img { height: 28px; width: auto; }
  .btn-dark { display: inline-flex; align-items: center; gap: 8px; height: 31px; padding: 4px 16px; border-radius: 4px;
    background: var(--dark); border: 1px solid var(--dark); color: #fff; font: 500 14px/21px 'Noto Sans JP', sans-serif; white-space: nowrap; }
  .site-footer { background: var(--dark); padding: 24px 40px; }
  .ft-inner { max-width: 1280px; margin: 0 auto; display: flex; gap: 40px; }
  .ft-inner a, .ft-inner span { color: #888; font: 300 14px/21px var(--sans); }
  .ft-inner a:hover { color: #fff; }

  /* シリーズ名の札・日付 */
  .tag { display: inline-block; padding: 2px 6px; border-radius: 4px; background: #f0f0f0; color: #888; font: 400 11px/16px var(--sans); }
  .date { color: #aaa; font: 400 11px/16px var(--sans); }
  /* 一覧ページ共通の枠 */
  .panel { max-width: 1280px; margin: 0 auto; background: #fff; border-radius: 16px; padding: 32px; }
  .related, .sec { padding: 40px 80px; }
  .sec-h { margin: 0 0 32px; font: 600 24px/36px var(--sans); }
  .grid3 { display: grid; grid-template-columns: repeat(3, minmax(0, 1fr)); gap: 32px; }
  @media (max-width: 1023px) { .grid3 { grid-template-columns: repeat(2, minmax(0, 1fr)); } .related, .sec { padding: 40px 24px; } }
  @media (max-width: 599px) { .grid3 { grid-template-columns: 1fr; gap: 24px; } .related, .sec { padding: 32px 12px; } .panel { padding: 24px 16px; } }

  @media (max-width: 767px) {
    .site-header { padding: 6px 16px; }
    .hd-inner { gap: 8px; }
    .logo-img { height: 14.8px; }
    .hd-center .btn-dark { display: none; }
    .hd-manga img { height: 32px; }
    .btn-dark { padding: 4px 10px; font-size: 12px; gap: 4px; }
    .site-footer { padding: 24px 16px; }
  }
</style>
src/lib/seo.ts
// 検索エンジン向けの共通処理(説明文の補い・本文の画像の alt と大きさ・構造化データ)
export const SITE = 'https://pixelstomotors.com';
export const SITE_NAME = 'Pixels to Motors';
export const DEFAULT_OG = '/site/ffb300c2-1071-4714-978c-87d386d5dfd3.png';
export const AUTHOR = {
'@type': 'Person',
name: '島津 栄一',
alternateName: 'Eiichi Shimazu',
url: SITE + '/',
jobTitle: 'Designer / Director',
worksFor: { '@type': 'Organization', name: 'ADAPT DESIGN' },
};
export const PUBLISHER = {
'@type': 'Organization',
name: SITE_NAME,
url: SITE + '/',
logo: { '@type': 'ImageObject', url: SITE + '/site/9cad887a-242b-4953-bd36-7b368c27d1b9.png' },
};
const decode = (s: string) => s
.replace(/ /g, ' ').replace(/</g, '<').replace(/>/g, '>').replace(/"/g, '"')
.replace(/'/g, "'").replace(/&/g, '&');
// HTML から本文の文字だけを取り出して、n 文字までにまとめる(説明文が空のときの補い)
export function textOf(html: string | null | undefined, n = 120): string {
if (!html) return '';
const t = decode(html
.replace(/<pre[\s\S]*?<\/pre>/g, ' ')
.replace(/<(script|style)[\s\S]*?<\/\1>/g, ' ')
.replace(/<!--[\s\S]*?-->/g, ' ')
.replace(/<[^>]+>/g, ' '))
.replace(/■/g, ' ').replace(/\s+/g, ' ').trim();
return t.length > n ? t.slice(0, n - 1) + '…' : t;
}
const attr = (s: string) => s.replace(/&/g, '&').replace(/"/g, '"').replace(/</g, '<');
// 本文 HTML を整える
// - 本文の中の h1 は h2 にする(ページの h1 は記事タイトルの1つだけにする)
// - alt が空の画像に、記事タイトルと直前の見出しから alt を入れる
// - ファイル名(s-1604x1518_…)から width / height を入れる(表示前に場所を確保して、ずれを防ぐ)
export function fixBody(html: string, title: string): string {
let heading = '';
let n = 0;
return html
.replace(/<h1(\s|>)/g, '<h2$1').replace(/<\/h1>/g, '</h2>')
.replace(/<h[23][^>]*>([\s\S]*?)<\/h[23]>|<img\b[^>]*>/g, (tag, inner) => {
if (inner !== undefined) { heading = textOf(inner, 60); return tag; }
let out = tag;
if (/\balt=""/.test(out) || !/\balt=/.test(out)) {
n += 1;
const alt = heading ? `${title}|${heading}` : `${title}(図${n})`;
out = /\balt=""/.test(out) ? out.replace(/\balt=""/, `alt="${attr(alt)}"`) : out.replace(/<img\b/, `<img alt="${attr(alt)}"`);
}
if (!/\bwidth=/.test(out)) {
const m = /\/s-(\d{2,5})x(\d{2,5})[_.]/.exec(out);
if (m) out = out.replace(/<img\b/, `<img width="${m[1]}" height="${m[2]}"`);
}
if (!/\bloading=/.test(out)) out = out.replace(/<img\b/, '<img loading="lazy"');
return out;
});
}
export const abs = (p: string | null | undefined) => (!p ? undefined : /^https?:/.test(p) ? p : SITE + p);
src/pages/record/[slug].astro
---
import Base from '../../layouts/Base.astro';
import { ymd } from '../../lib/format';
import { mediaHtml } from '../../lib/media';
import { fixBody, textOf, abs, AUTHOR, PUBLISHER, SITE, SITE_NAME } from '../../lib/seo';
import { SERIES_PAGES, allCards } from '../../lib/records';
import RecordCard from '../../components/RecordCard.astro';
import { getCollection, render } from 'astro:content';
import { existsSync } from 'node:fs';
// 記事ページは2種類から作る
// - Studio から移した記事:CMS の本文 HTML(src/data/records/。tools/import_all.py で作る)
// - これから Claude が書く記事:Markdown(src/content/records/)
export async function getStaticPaths() {
const studio = Object.values(import.meta.glob('../../data/records/*.json', { eager: true, import: 'default' })) as any[];
const md = await getCollection('records');
return [
...studio.map((r) => ({ params: { slug: r.slug }, props: { kind: 'studio', rec: r } })),
...md.map((e) => ({ params: { slug: e.data.slug }, props: { kind: 'md', entry: e } })),
];
}
const { kind, entry, rec } = Astro.props;
const esc = (s) => s.replace(/&/g, '&').replace(/</g, '<');
const tocOf = (items) => items.length ? `<nav class="toc"><ul>${items.map((t) => `<li><a href="#${t.id}">${esc(t.text)}</a></li>`).join('')}</ul></nav>` : '';
let r, body = '', Content = null, toc = '';
if (kind === 'studio') {
r = rec;
body = fixBody(mediaHtml(rec.body.replace('<!--TOC-->', tocOf(rec.toc))), rec.title);
} else {
const d = entry.data;
r = { title: d.title, description: d.meta_description || '', slug: d.slug, day: `LOG${d.day}`, series: d.series,
published: d.date.toISOString(), thumb: `/thumbs/LOG${d.day}.html`, tags: d.tags || [] };
const rendered = await render(entry);
Content = rendered.Content;
toc = tocOf(rendered.headings.filter((h) => h.depth === 2).map((h) => ({ id: h.slug, text: h.text })));
// 目次は最初の見出しの直前に置く(冒頭の書き出しを先に読んでもらうため。article_rules.md「冒頭の書き出し」)
const html = entry.rendered?.html;
if (html && toc) {
const at = html.search(/<h2[\s>]/);
body = at >= 0 ? html.slice(0, at) + toc + html.slice(at) : toc + html;
}
}
// 検索エンジン向けの情報
// SNS・検索結果に出す画像:表紙の画像 → サムネイルを書き出した画像(public/og/。tools/render_og.py)→ サイト共通の画像
const ogFromThumb = r.thumb ? r.thumb.replace(/^\/thumbs\//, '/og/').replace(/\.html$/, '.jpg') : null;
const ogImage = r.cover || (ogFromThumb && existsSync(`public${ogFromThumb}`) ? ogFromThumb : undefined);
const isEn = rec?.lang === 'EN' || /-en$/.test(r.slug);
const description = r.description || textOf(kind === 'studio' ? rec.body : entry.body, 120);
const allSlugs = new Set([
...Object.values(import.meta.glob('../../data/records/*.json', { eager: true, import: 'default' })).map((x: any) => x.slug),
...(await getCollection('records')).map((e) => e.data.slug),
]);
const pair = isEn ? r.slug.replace(/-en$/, '') : `${r.slug}-en`;
const alternates = allSlugs.has(pair) ? [{ lang: isEn ? 'ja' : 'en', path: `/record/${pair}` }] : [];
// 英語の考察記事(Consideration)は、考察記事のシリーズページ(series5)につなぐ
const seriesKey = r.series === 'Consideration' ? '考察記事' : r.series;
const seriesPage = Object.entries(SERIES_PAGES).find(([, c]) => c.series === seriesKey);
const seriesName = seriesPage ? seriesPage[1].title.split(' | ').pop() : r.series;
// 同じシリーズの記事(一覧と同じく LOG 番号の大きい順)。前後の記事と、この記事の近くの6本
const sameSeries = (await allCards()).filter((c) => c.series === r.series);
const pos = sameSeries.findIndex((c) => c.slug === r.slug);
const newer = pos > 0 ? sameSeries[pos - 1] : null;
const older = pos >= 0 && pos < sameSeries.length - 1 ? sameSeries[pos + 1] : null;
const others = sameSeries.filter((c) => c.slug !== r.slug);
const start = Math.max(0, Math.min((pos < 0 ? 0 : pos) - 3, others.length - 6));
const nearby = others.slice(start, start + 6);
const url = `${SITE}/record/${r.slug}`;
const jsonLd = [
{
'@context': 'https://schema.org', '@type': 'BlogPosting',
headline: r.title, description, url, mainEntityOfPage: url,
inLanguage: isEn ? 'en' : 'ja',
datePublished: r.published, dateModified: rec?.updated || r.published,
image: ogImage ? [abs(ogImage)] : undefined,
articleSection: r.series, keywords: r.tags?.length ? r.tags.join(', ') : undefined,
author: AUTHOR, publisher: PUBLISHER,
isPartOf: { '@type': 'Blog', name: SITE_NAME, url: SITE + '/' },
},
{
'@context': 'https://schema.org', '@type': 'BreadcrumbList',
itemListElement: [
{ '@type': 'ListItem', position: 1, name: SITE_NAME, item: SITE + '/' },
...(seriesPage ? [{ '@type': 'ListItem', position: 2, name: seriesPage[1].title, item: `${SITE}/${seriesPage[0]}` }] : []),
{ '@type': 'ListItem', position: seriesPage ? 3 : 2, name: r.title, item: url },
],
},
];
---
<Base title={`${r.title} | ${SITE_NAME}`} description={description} ogImage={ogImage} path={`/record/${r.slug}`}
lang={isEn ? 'en' : 'ja'} ogType="article" published={r.published} modified={rec?.updated || r.published}
alternates={alternates} jsonLd={jsonLd}>
<article class="rec">
<nav class="crumbs" aria-label="現在地">
<a href="/">{SITE_NAME}</a><span aria-hidden="true">›</span>{seriesPage ? <a href={`/${seriesPage[0]}`}>{seriesName}</a> : <span>{seriesName}</span>}
</nav>
{r.thumb ? <div class="hero"><iframe src={r.thumb} sandbox="allow-scripts" title={r.title} scrolling="no" tabindex="-1"></iframe></div> : r.cover && <img class="hero-img" src={r.cover} alt={r.title} width="1920" height="1080" />}
<div class="meta"><span class="day">{r.day}</span>{seriesPage ? <a class="tag" href={`/${seriesPage[0]}`}>{r.series}</a> : <span class="tag">{r.series}</span>}<span class="date">{ymd(r.published)}</span></div>
<h1 class="title">{r.title}</h1>
{kind === 'studio'
? <div class="richText" set:html={body} />
: body ? <div class="richText" set:html={body} /> : <div class="richText"><Fragment set:html={toc} /><Content /></div>}
{(newer || older) && (
<nav class="pager" aria-label="同じシリーズの前後の記事">
{older ? <a class="pg pg-prev" href={`/record/${older.slug}`}><span class="pg-k">← 前の記事 {older.day}</span><span class="pg-t">{older.title}</span></a> : <span />}
{newer ? <a class="pg pg-next" href={`/record/${newer.slug}`}><span class="pg-k">次の記事 {newer.day} →</span><span class="pg-t">{newer.title}</span></a> : <span />}
</nav>
)}
</article>
{nearby.length > 0 && (
<section class="related">
<div class="panel">
<h2 class="sec-h">Series | {seriesName}の記録</h2>
<div class="grid3">{nearby.map((c) => <RecordCard item={c} />)}</div>
{seriesPage && <div class="rel-more"><a class="btn-dark" href={`/${seriesPage[0]}`}>{seriesName}の記録をすべて見る({sameSeries.length}本)<i class="ms">arrow_forward</i></a></div>}
</div>
</section>
)}
</Base>
<style is:global>
.rec { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 64px; }
.rec .hero { aspect-ratio: 16 / 9; position: relative; border-radius: 4px; overflow: hidden; background: #0d0d0d; }
.rec .hero iframe { position: absolute; inset: 0; width: 100%; height: 100%; border: 0; pointer-events: none; }
.rec .hero-img { width: 100%; height: auto; aspect-ratio: 16 / 9; object-fit: cover; border-radius: 4px; display: block; }
.rec .crumbs { display: flex; flex-wrap: wrap; align-items: center; gap: 4px 8px; margin: 0 0 16px; font: 400 13px/20px var(--sans); color: var(--ink-3); }
.rec .crumbs a { color: var(--ink-2); text-decoration: underline; text-underline-offset: 2px; }
.rec .crumbs a:hover { color: var(--ink); }
.rec a.tag:hover { background: #e4e4e4; color: var(--ink-2); }
.pager { display: grid; grid-template-columns: 1fr 1fr; gap: 16px; margin: 64px 0 0; padding-top: 32px; border-top: 1px solid #ddd; }
.pg { display: flex; flex-direction: column; gap: 8px; padding: 16px; border-radius: 8px; background: #fff; box-shadow: 0 8px 16px rgba(0,0,0,.08); }
.pg:hover .pg-t { text-decoration: underline; }
.pg-next { text-align: right; }
.pg-k { font: 400 12px/18px var(--sans); color: var(--ink-3); }
.pg-t { font: 600 14px/1.6 var(--sans); color: var(--ink); overflow-wrap: anywhere; }
.rel-more { display: flex; justify-content: center; margin-top: 40px; }
.rel-more .btn-dark { height: auto; min-height: 40px; padding: 8px 20px; white-space: normal; text-align: center; }
@media (max-width: 599px) { .pager { grid-template-columns: 1fr; } .pg-next { text-align: left; } }
.rec .meta { display: flex; align-items: center; gap: 12px; margin-top: 16px; }
.rec .day { font: 400 28px/28px var(--sans); }
.rec .title { margin: 12px 0 40px; font: 600 28px/42px var(--sans); overflow-wrap: anywhere; }
.richText { color: var(--ink); font-family: var(--sans); }
.richText p { font-size: 18px; line-height: 36px; margin: 8px 0 12px; overflow-wrap: anywhere; }
.richText h2 { font-size: 24px; line-height: 36px; font-weight: 600; margin: 40px 0 16px; }
.richText h3 { font-size: 20px; line-height: 30px; font-weight: 600; margin: 36px 0 16px; padding-left: 12px; border-left: 2px solid var(--ink); }
.richText h4 { font-size: 18px; line-height: 30px; font-weight: 600; margin: 24px 0 8px; }
.richText h5 { font-size: 14px; line-height: 1.8; font-weight: 400; color: #555; margin: 48px 0 0; }
.richText hr { border: 0; border-top: 1px solid #ddd; margin: 10px 0; }
.richText strong { font-weight: 600; }
.richText a { color: inherit; text-decoration: underline; }
.richText pre { background: #eee; border-radius: 4px; padding: 25px 35px; margin: 4px 0; overflow-x: auto;
font: 400 16px/24px var(--mono); white-space: pre-wrap; overflow-wrap: anywhere; }
.richText pre code { font: inherit; }
.richText :not(pre) > code { background: #eee; padding: 0 5px; margin: 2px; border: 1px solid rgba(0,0,0,.1); border-radius: 6px; font: 400 18px/36px var(--sans); overflow-wrap: anywhere; }
.richText blockquote { margin: 10px 0; padding: 10px 15px; border-left: 3px solid rgba(0,0,0,.15); color: #333; }
.richText blockquote p { font: 400 16px/28.8px 'Noto Sans JP', sans-serif; margin: 10px 0; }
.richText figure { margin: 16px 0; }
.richText figure img { width: 100%; height: auto; }
.richText figcaption:empty { display: none; }
.richText ul, .richText ol { padding-left: 1.5em; }
.richText li { font-size: 18px; line-height: 36px; margin: 10px 0; }
.richText .table { margin: 10px 0; overflow-x: auto; }
.richText table { border-collapse: collapse; width: 100%; font-size: 14px; }
.richText th, .richText td { border: 1px solid var(--line); vertical-align: top; text-align: left; }
.richText th { background: rgba(240,240,240,.6); padding: 24px; font: 400 16px/24px var(--sans); }
.richText td { padding: 16px; font: 400 18px/27px var(--sans); }
.richText th p, .richText td p { margin: 0; font: inherit; }
.richText .embed { margin: 16px 0; }
.richText .embed iframe { display: block; width: 100%; height: 150px; border: 0; }
.richText .video { margin: 16px 0; }
.richText .video video { display: block; width: 100%; height: auto; }
.richText .yt { aspect-ratio: 16 / 9; margin: 16px 0; }
.richText .yt iframe { width: 100%; height: 100%; border: 0; }
.toc { background: #f0f0f0; border-radius: 4px; padding: 20px 20px 8px 8px; margin: 0 0 24px; }
.toc ul { list-style: none; margin: 0; padding: 0; }
.toc li { position: relative; padding-left: 32px; margin: 0 0 16px; font: 400 16px/32px var(--sans); color: var(--ink-2); }
.toc a { text-decoration: none; color: inherit; }
/* 本文より広いもの(表・画像)が画面の幅を押し広げないようにする */
.richText { max-width: 100%; min-width: 0; }
.richText a, .richText code, .richText li, .richText td, .richText th, .richText blockquote, .richText h2, .richText h3 { overflow-wrap: anywhere; word-break: break-word; }
.richText pre code { white-space: pre-wrap; }
.richText img { max-width: 100%; height: auto; }
@media (max-width: 767px) {
.rec { max-width: calc(100% - 48px); padding-top: 72px; }
.rec .title { font-size: 24px; line-height: 36px; }
/* Markdown の表は囲みがないので、スマホでは表そのものを横スクロールにする(PC は通常の table のまま。LOG233 と同じ) */
.richText table { display: block; overflow-x: auto; -webkit-overflow-scrolling: touch; }
.richText .table > table { display: table; }
}
</style>
src/lib/remark-markers.mjs
// 記事 Markdown を、サイトに出す形に整える。
// 1. 「【画像】ファイル名」「【図解】ファイル名」の行を、画像と図解の枠に置き換える
// (article_rules.md の書き方をそのまま使う。行の頭からその行の終わりまでが1つの指定)
// 2. R2R2R の注記(##### ※ プロジェクト名「R2R2R」は…)は、R2R2R シリーズの記事にだけ残す
// (Studio でも、該当しない記事では手で消していた)
// 3. 旧サイト(adaptdesign.jp/pixelstomotors/…)へのリンクは、このサイトの中のリンク(/…)に直す
// (記事の Markdown 自体は書き換えない)
import { visit, SKIP } from 'unist-util-visit';
import { toString } from 'mdast-util-to-string';
import { MEDIA_BASE } from './media-base.mjs';
const R2R2R_NOTE = /^※\s*プロジェクト名「R2R2R」/;
const OLD_SITE = /^https?:\/\/(?:www\.)?adaptdesign\.jp\/pixelstomotors(\/[^?#]*)?([?#].*)?$/;
export default function remarkMarkers() {
const base = MEDIA_BASE.replace(/\/$/, '');
return (tree, file) => {
const series = file.data?.astro?.frontmatter?.series;
if (series !== 'R2R2R') {
visit(tree, 'heading', (node, index, parent) => {
if (parent && node.depth === 5 && R2R2R_NOTE.test(toString(node).trim())) {
parent.children.splice(index, 1);
return [SKIP, index];
}
});
}
visit(tree, 'link', (node) => {
const m = OLD_SITE.exec(node.url || '');
if (m) node.url = (m[1] && m[1] !== '/' ? m[1] : '/') + (m[2] || '');
});
// 画像の alt:「【画像】ファイル名 説明」と書けばその説明、なければ記事タイトル|直前の見出し
const title = file.data?.astro?.frontmatter?.title || '';
const esc = (s) => String(s).replace(/&/g, '&').replace(/"/g, '"').replace(/</g, '<');
let lastHeading = '';
visit(tree, (node, index, parent) => {
if (node.type === 'heading' && (node.depth === 2 || node.depth === 3)) { lastHeading = toString(node).trim(); return; }
if (node.type !== 'paragraph') return;
if (!parent || node.children.length !== 1 || node.children[0].type !== 'text') return;
const text = node.children[0].value.trim();
let m = text.match(/^【画像】\s*(\S+)(?:\s+(.+))?$/);
if (m) {
const alt = m[2] ? m[2].trim() : [title, lastHeading].filter(Boolean).join('|');
const size = /^s-(\d{2,5})x(\d{2,5})[_.]/.exec(m[1]);
const wh = size ? ` width="${size[1]}" height="${size[2]}"` : '';
parent.children[index] = { type: 'html', value:
`<figure><img src="${base}/${encodeURIComponent(m[1])}" alt="${esc(alt)}"${wh} loading="lazy"></figure>` };
return;
}
m = text.match(/^【図解】\s*(\S+\.html)$/);
if (m) {
parent.children[index] = { type: 'html', value:
`<div class="embed"><iframe src="/embeds/${encodeURIComponent(m[1])}" sandbox="allow-scripts allow-popups" loading="lazy" title="図解" data-embed></iframe></div>` };
}
});
};
}
src/components/MangaPage.astro
---
// 4コマのページ(日本語・英語版で共通)。下に関連する記録(Studio と同じく HRI の新しい6件+Load more)
import Base from '../layouts/Base.astro';
import RecordCard from './RecordCard.astro';
import LoadMore from './LoadMore.astro';
import { ymd } from '../lib/format';
import { media, mediaHtml } from '../lib/media';
import { seriesCards, allManga, allEnglish } from '../lib/records';
import { textOf, abs, AUTHOR, PUBLISHER, SITE, SITE_NAME } from '../lib/seo';
interface Props { m: any; path: string }
const { m, path } = Astro.props;
const related = await seriesCards('HRI');
// 英語版は本文が英語なので、説明文も英語の本文から作る(Studio から移した説明文は日本語のままのため)
const isEn = path.startsWith('/english-4-koma');
const description = (isEn ? textOf(m.body, 150) : m.description) || textOf(m.body, 120);
const pairList = isEn ? allManga : allEnglish;
const alternates = pairList.some((x) => x.slug === m.slug)
  ? [{ lang: isEn ? 'ja' : 'en', path: `${isEn ? '/manga' : '/english-4-koma'}/${m.slug}` }] : [];
const title = isEn ? `${m.title} | 4-Koma Manga | ${SITE_NAME}` : `${m.title} | 4コママンガ | ${SITE_NAME}`;
const jsonLd = {
  '@context': 'https://schema.org', '@type': 'Article',
  headline: m.title, description, url: SITE + path, mainEntityOfPage: SITE + path,
  inLanguage: isEn ? 'en' : 'ja', datePublished: m.published, dateModified: m.published,
  image: [abs(media(m.comic)), abs(media(m.cover))].filter(Boolean),
  genre: isEn ? '4-panel comic' : '4コママンガ', author: AUTHOR, publisher: PUBLISHER,
};
---
<Base title={title} description={description} ogImage={media(m.cover) || undefined} path={path}
  lang={isEn ? 'en' : 'ja'} ogType="article" published={m.published} alternates={alternates} jsonLd={jsonLd}>
  <article class="manga">
    <div class="mmeta"><span class="mlabel">{m.label}</span><span class="tag">{m.character}</span><span class="date">{ymd(m.published)}</span></div>
    {m.cover && <img class="mcover" src={media(m.cover)} alt={m.cover_alt || `${m.title}(${m.label} 表紙)`} width="1080" height="1350" />}
    {m.comic && <img class="mcomic" src={media(m.comic)} alt={m.comic_alt || `${m.title}(${m.label} 本編)`} width="1080" height="1350" loading="lazy" />}
    <h1 class="mtitle">{m.title}</h1>
    <div class="mbody" set:html={mediaHtml(m.body)} />
  </article>
  <section class="related">
    <div class="panel">
      <h2 class="sec-h">Related Records | マンガの背景にある記録</h2>
      <LoadMore limit={6} total={related.length}>{related.map((c) => <RecordCard item={c} />)}</LoadMore>
    </div>
  </section>
</Base>
<style>
  .manga { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 80px; }
  .mmeta { display: flex; align-items: center; gap: 12px; margin-bottom: 16px; }
  .mlabel { font: 400 28px/28px var(--sans); }
  .mcover, .mcomic { width: 100%; height: auto; }
  .mtitle { margin: 24px 0 12px; font: 600 20px/30px var(--sans); }
  .mbody :global(p) { font: 400 16px/2 'Noto Sans JP', sans-serif; margin: 0 0 16px; color: #333; }
</style>
src/components/MangaArchive.astro
---
// 4コマの一覧(日本語・英語版で共通)。Studio と同じく公開日の新しい順に18件ずつ
import Base from '../layouts/Base.astro';
import MangaCard from './MangaCard.astro';
import LoadMore from './LoadMore.astro';
import { SITE, SITE_NAME } from '../lib/seo';
interface Props { items: any[]; heading: string; other: { href: string; label: string }; base: string; path: string }
const { items, heading, other, base, path } = Astro.props;
const isEn = path.endsWith('-en');
const title = isEn ? `English 4-Koma Manga Archive | ${SITE_NAME}` : `4コママンガ アーカイブ | ${SITE_NAME}`;
const description = isEn
  ? 'All episodes of the English 4-panel manga about Hakobu, a hospital drug-delivery robot, and other robots — everyday scenes that show how people and robots get along (or don\'t), with design notes.'
  : '病院の薬剤搬送ロボット「ハコブくん」たちが登場する4コママンガの一覧。人とロボットの関わりで起きるすれ違いを、デザインの視点の解説と一緒に描いています。';
const jsonLd = {
  '@context': 'https://schema.org', '@type': 'CollectionPage', name: title, description, url: SITE + path,
  inLanguage: isEn ? 'en' : 'ja',
  hasPart: items.slice(0, 50).map((m) => ({ '@type': 'Article', headline: m.title, url: `${SITE}${base}/${m.slug}` })),
};
---
<Base title={title} description={description} path={path} lang={isEn ? 'en' : 'ja'}
  alternates={[{ lang: isEn ? 'ja' : 'en', path: isEn ? '/manga-archive' : '/manga-archive-en' }]} jsonLd={jsonLd}>
  <section class="ma"><div class="panel">
    <div class="ma-head">
      <h1 class="sec-h ma-title">{heading}</h1>
      <a class="btn-dark" href={other.href}>{other.label}<i class="ms">arrow_forward</i></a>
    </div>
    <LoadMore limit={18} total={items.length}>{items.map((m) => <MangaCard item={m} base={base} />)}</LoadMore>
  </div></section>
</Base>
<style>
  .ma { padding: 88px 80px 40px; }
  .ma-head { display: flex; align-items: center; justify-content: space-between; gap: 16px; margin-bottom: 32px; }
  .ma-title { margin: 0; }
  @media (max-width: 1023px) { .ma { padding: 72px 24px 40px; } }
  @media (max-width: 599px) { .ma { padding: 64px 12px 32px; } .ma-head { flex-direction: column; align-items: flex-start; } }
</style>
src/components/MangaCard.astro
---
import { ymd } from '../lib/format';
import { media } from '../lib/media';
interface Props { item: { slug: string; title: string; label: string; character: string; published: string; cover: string }; base?: string }
const { item, base = '/manga' } = Astro.props;
---
<a class="mcard" href={`${base}/${item.slug}`}>
  <img src={media(item.cover)} alt={item.title} width="1080" height="1350" loading="lazy" />
  <div class="mc-meta">
    <div class="rline"><span class="mc-label">{item.label}</span><span class="tag">{item.character}</span><span class="date">{ymd(item.published)}</span></div>
    <p class="mc-title">{item.title}</p>
  </div>
</a>
<style is:global>
  .mcard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
  .mcard img { width: 100%; height: auto; aspect-ratio: 4 / 5; object-fit: cover; }
  .mc-meta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
  .mc-label { font: 400 16px/16px var(--sans); }
  .mc-title { margin: 0; font: 500 14px/1.6 var(--sans); }
  .rline { display: flex; align-items: center; gap: 4px 12px; flex-wrap: wrap; }
</style>
src/components/RecordCard.astro
---
import { ymd } from '../lib/format';
import { media } from '../lib/media';
const { item } = Astro.props;
---
<a class="rcard" href={`/record/${item.slug}`}>
  <div class="rthumb">
    {item.thumb
      ? <iframe src={item.thumb} sandbox="allow-scripts" loading="lazy" tabindex="-1" title={item.title} scrolling="no"></iframe>
      : item.cover ? <img src={media(item.cover)} alt={item.title} width="1920" height="1080" loading="lazy" /> : null}
  </div>
  <div class="rmeta">
    <div class="rline"><span class="rday">{item.day}</span><span class="tag">{item.series}</span><span class="date">{ymd(item.published)}</span></div>
    <p class="rtitle">{item.title}</p>
  </div>
</a>
<style>
  .rcard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
  .rthumb { aspect-ratio: 16 / 9; background: #fff; position: relative; overflow: hidden; }
  .rthumb iframe { position: absolute; inset: 0; width: 100%; height: 100%; border: 0; pointer-events: none; }
  .rthumb img { width: 100%; height: 100%; object-fit: cover; }
  .rmeta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
  .rline { display: flex; align-items: center; gap: 12px; flex-wrap: wrap; }
  .rday { font: 400 18px/18px var(--sans); }
  .rtitle { margin: 0; font: 600 16px/1.6 var(--sans); }
</style>
src/pages/[series].astro
---
// シリーズのページ(/series1〜7)。上に Studio で置いていた資料(Figma・スプレッドシートなど)、下にそのシリーズの記録
import Base from '../layouts/Base.astro';
import RecordCard from '../components/RecordCard.astro';
import LoadMore from '../components/LoadMore.astro';
import { seriesCards, SERIES_PAGES } from '../lib/records';
import { media } from '../lib/media';
import staticPages from '../data/static.json';
import { SITE, SITE_NAME } from '../lib/seo';

export function getStaticPaths() {
  return Object.keys(SERIES_PAGES).map((series) => ({ params: { series } }));
}
const { series } = Astro.params;
const conf = SERIES_PAGES[series];
const blocks = (staticPages[series]?.blocks || []).slice(1); // 先頭はページの見出し
const items = await seriesCards(conf.series);
const [enName, jaName] = conf.title.split(' | ');
const description = `${SITE_NAME} のシリーズ「${jaName || conf.title}」(${enName})の記録一覧。ロボットとフィジカルAIを、29年のデザイナー経験から実機とシミュレーションで試した過程を、失敗も含めて公開しています。`;
const jsonLd = {
  '@context': 'https://schema.org', '@type': 'CollectionPage', name: conf.title, description, url: `${SITE}/${series}`,
  inLanguage: 'ja',
  hasPart: items.slice(0, 50).map((c) => ({ '@type': 'BlogPosting', headline: c.title, url: `${SITE}/record/${c.slug}` })),
};
---
<Base title={`${jaName || conf.title}(${enName})| ${SITE_NAME}`} description={description} path={`/${series}`} jsonLd={jsonLd}>
  <section class="s-hero"><div class="panel">
    <h1 class="sec-h s-title">{conf.title}</h1>
    {blocks.map((b) => (
      b.type === 'text' ? (b.link ? <a class="s-label" href={b.link} target="_blank" rel="noopener" set:html={b.html} /> : <p class="s-label" set:html={b.html} />)
      : b.type === 'iframe' ? <div class="s-frame" style={`height:${b.height}px`} set:html={b.html} />
      : b.type === 'embed' ? <div class="s-embed" set:html={b.html} />
      : b.type === 'img' ? (b.link ? <a class="s-img" href={b.link} target="_blank" rel="noopener"><img src={media(b.src)} alt={b.alt || conf.title} loading="lazy" /></a> : <div class="s-img"><img src={media(b.src)} alt={b.alt || conf.title} loading="lazy" /></div>)
      : null
    ))}
  </div></section>
  <section class="sec"><div class="panel">
    <h2 class="sec-h">Record | 記録</h2>
    <LoadMore limit={conf.limit} total={items.length}>{items.map((c) => <RecordCard item={c} />)}</LoadMore>
  </div></section>
</Base>
<style>
  .s-hero { padding: 88px 80px 0; }
  .s-title { margin: 0; }
  .s-label { display: block; margin: 40px 0 16px; font: 500 16px/24px var(--sans); color: var(--ink); }
  .s-title + .s-label { margin-top: 8px; }
  a.s-label:hover { text-decoration: underline; }
  .s-frame { width: 100%; }
  .s-frame :global(iframe) { display: block; width: 100% !important; height: 100% !important; }
  .s-embed :global(.embed iframe) { display: block; width: 100%; height: 150px; border: 0; }
  .s-img img { width: 100%; height: auto; display: block; }
  @media (max-width: 1023px) { .s-hero { padding: 72px 24px 0; } }
  @media (max-width: 599px) { .s-hero { padding: 64px 12px 0; } }
</style>
src/pages/index.astro
---
import Base from '../layouts/Base.astro';
import RecordCard from '../components/RecordCard.astro';
import { ymd } from '../lib/format';
import { media } from '../lib/media';
// SNS アイコン(Font Awesome Free 6.7.2・CC BY 4.0。ライセンス表記は各 SVG の中に残している)
import icGithub from '../icons/github.svg?raw';
import icLinkedin from '../icons/linkedin.svg?raw';
import icX from '../icons/square-x-twitter.svg?raw';
import icYoutube from '../icons/youtube.svg?raw';
import { allCards } from '../lib/records';
import MangaCard from '../components/MangaCard.astro';
import LoadMore from '../components/LoadMore.astro';
import { allManga } from '../lib/records';
// Studio のトップと同じく、4コマは新しい4話
const mangaCards = allManga.slice(0, 4);
const series = [
{ href: '/series1', img: 's-1920x1318_v-frms_4cd7792b-68a1-4239-ad08-0785c4e538c5.webp', en: 'Drug Delivery Robot', ja: '薬剤搬送ロボットハコブくん',
desc: 'A multidisciplinary documentation of Hakobu — a hospital drug-delivery robot — covering HRI design, UI, autonomous navigation in Unity, and daily development logs, told alongside 4-panel manga.' },
{ href: '/series6', img: 's-1672x941_76620d86-fa7b-491f-b554-99c2f8981d8d.webp', en: 'Physical AI Lab', ja: 'フィジカルAI研究室',
desc: 'Building a Physical AI research environment at home, from zero — reproducible by anyone. The first build: an arm that learns from failure.' },
{ href: '/series7', img: 's-1800x1200_v-frms_82af05c4-20df-4ea1-b88d-355ed8fabd63.webp', en: 'Image recognition and Object detection', ja: '画像認識と物体検出',
desc: 'Relearning image recognition from the bottom up, one measurable step at a time — pixels, colour spaces, thresholds, morphology, contours, and the metrics that judge them. Nothing is assumed: every step is measured on real photographs first.' },
{ href: '/series5', img: 's-2528x1694_7a2b46a9-02c8-49d6-92c4-2e7994843726.webp', en: 'Deep Dive', ja: '考察記事',
desc: 'Essays that go beyond the build log — examining why things work, what they mean, and where the field is heading.' },
{ href: '/series2', img: 's-1920x1318_v-frms_0d775000-730b-4ac2-90b5-d814a9f53fc6.webp', en: 'R2R2R', ja: 'デジタルツイン学習-R2R2R(Real to Render to Real)',
desc: 'A hands-on project proving that robot arm motion can be designed without a robotics background — using only an iPhone for 3D scanning and Unity for simulation.' },
{ href: '/series4', img: 's-4480x3680_2e3487ec-2968-4b89-8bca-7062b48f6093.webp', en: 'Robotics Design Workflow', ja: 'ロボティクスデザイン実務フロー', desc: '' },
];
const records = await allCards();
import { SITE, SITE_NAME, AUTHOR, PUBLISHER } from '../lib/seo';
const jsonLd = [
{ '@context': 'https://schema.org', '@type': 'WebSite', name: SITE_NAME, url: SITE + '/', inLanguage: 'ja', publisher: PUBLISHER },
{ '@context': 'https://schema.org', ...PUBLISHER, founder: AUTHOR,
sameAs: ['https://www.youtube.com/@PixelstoMotors', 'https://github.com/PixelstoMotors', 'https://x.com/adaptdesignjp'] },
{ '@context': 'https://schema.org', ...AUTHOR, sameAs: ['https://www.linkedin.com/in/eiichi-shimazu/', 'https://x.com/adaptdesignjp'], description: '29年のデザイナー経験を持つデザイナー/ディレクター。Pixels to Motors で人とロボットの関わり(HRI)とフィジカルAIを研究・発信している。' },
];
---
<Base title="Pixels to Motors | 人とロボットの関わりを、シミュレーションでデザインする"
description="29年のデザイナー経験を、いまロボティクスに応用しています。テーマはHRIシミュレーション——人がロボットをどう感じ、どう関わるかを、実機の前にデジタル上で設計すること。"
ogImage="/site/ffb300c2-1071-4714-978c-87d386d5dfd3.png" path="/" jsonLd={jsonLd}>
<section class="hero">
<div class="hero-text">
<h1>Pixels to Motors | 人とロボットの関わりをシミュレーションでデザインする</h1>
<p>29年のデザイナー経験を、いまロボティクスに応用しています。テーマはHRIシミュレーション——人がロボットをどう感じ、どう関わるかを、実機の前にデジタル上で設計すること。Unityで空間もシナリオもゼロから組み、人の間を動いて運び・手渡すサービスロボットの振る舞いを、成否の基準を物理精度ではなく人の体験に置いてつくります。実機はその先。過程の失敗も含めて公開しています。</p>
</div>
<video class="hero-video" src={media("/media/s-848x1056_e5500e41-e73b-4177-914e-b09a2d11f83c.mp4") + "#t=0.01"} controls muted autoplay loop playsinline></video>
</section>
<!-- 解説動画:YouTube の新着を GitHub の videos.json から読む埋め込み(Studio で使っていたものをそのまま) -->
<section class="sec"><div class="panel">
<div class="embed-wide"><iframe src="/embeds/top-video.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="解説動画" data-embed style="height:450px"></iframe></div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Archive | 4コママンガ</h2>
<div class="grid4">{mangaCards.map((m) => <MangaCard item={m} />)}</div>
<div class="center"><a class="btn-more" href="/manga-archive">もっと見る<i class="ms">arrow_forward</i></a></div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Series | シリーズ</h2>
<div class="grid2">
{series.map((s) => (
<a class="scard" href={s.href}>
<img src={media(`/media/${s.img}`)} alt={`${s.en}|${s.ja}`} loading="lazy" />
<div class="sc-meta">
<div class="sc-line"><span class="sc-en">{s.en}</span><span class="sc-ja">{s.ja}</span></div>
{s.desc && <p class="sc-desc">{s.desc}</p>}
</div>
</a>
))}
</div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Record | 記録</h2>
<LoadMore limit={12} total={records.length}>{records.map((c) => <RecordCard item={c} />)}</LoadMore>
<div class="embed-banner"><iframe src="/embeds/top-banner.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="お知らせ" data-embed style="height:240px"></iframe></div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Sole Prop | 事業所について</h2>
<div class="prop">
<div class="prop-person">
<video class="prop-photo" src={media("/media/s-1280x720_ff64009f-cd40-4e7d-8ba3-350ff0d6c3ad.mp4")} poster={media("/media/s-2048x2048_5af0bc9f-8d23-4bdb-85e4-ada51bfd7bbd.webp")} muted autoplay loop playsinline></video>
<p class="prop-role">Robotics UX & HRI Designer</p>
<p class="prop-name">島津 栄一</p>
</div>
<div class="prop-body">
<p class="prop-lead">画面(Pixels)のデザインから、動き(Motors)のデザインへ</p>
<p class="prop-text">29年にわたるデザイナーとしての知見を土台に、人とロボットの関わり(HRI)をシミュレーションで設計するデザイン事務所です。Unityなどのツールで空間もシナリオもゼロから組み、AIエージェント(Claude Code)を設計と実装の相棒に、人がロボットをどう感じ・どう関わるかを実機の前にデザインします。基準は物理精度ではなく体験の成立。画面上の「Pixels(デジタル)」の設計を、やがて現実の「Motors(モーター)」へ——その前半、体験を確かめるフェーズを公開しています。</p>
<dl class="prop-facts">
<div><dt>事業所名</dt><dd>ADAPT DESIGN</dd></div>
<div><dt>設立</dt><dd>2021年10月</dd></div>
<div class="wide"><dt>研究・実践分野</dt><dd>HRIシミュレーション / ロボティクスUX設計 / デジタルツイン / Unity / Physical AI / R2R2R</dd></div>
<div><dt>SNS</dt><dd class="sns">
<a href="https://github.com/PixelstoMotors/r2r2r-content" aria-label="GitHub" set:html={icGithub} />
<a href="https://www.linkedin.com/in/eiichi-shimazu/" aria-label="LinkedIn" set:html={icLinkedin} />
<a href="https://x.com/adaptdesignjp" aria-label="X" set:html={icX} />
<a href="https://www.youtube.com/@PixelstoMotors" aria-label="YouTube" set:html={icYoutube} />
</dd></div>
</dl>
</div>
</div>
</div></section>
</Base>
<style>
.hero { max-width: 964px; margin: 0 auto; padding: 104px 0 40px; display: flex; gap: 40px; align-items: flex-start; }
.hero-text { flex: 1 1 588px; min-width: 0; }
.hero h1 { margin: 0 0 16px; font: 600 29px/40.6px var(--sans); }
.hero p { margin: 0; font: 400 19px/1.6 'Noto Sans JP', sans-serif; color: #333; }
.hero-video { flex: 0 0 336px; width: 336px; height: 320px; background: #111; border-radius: 4px; object-fit: cover; }
.embed-wide { margin: 0 -16px; } /* 埋め込み側の左右 16px の余白ぶん外へ出し、カードの端をほかの節と揃える */
.embed-wide iframe, .embed-banner iframe { display: block; width: 100%; border: 0; }
.embed-banner { max-width: 964px; margin: 48px auto 0; }
.grid4 { display: grid; grid-template-columns: repeat(4, minmax(0, 1fr)); gap: 24px; }
.grid2 { display: grid; grid-template-columns: repeat(2, minmax(0, 1fr)); gap: 32px; }
.scard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
.scard img { width: 100%; aspect-ratio: 3 / 2; object-fit: cover; }
.sc-meta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
.sc-line { display: flex; align-items: baseline; gap: 8px 12px; flex-wrap: wrap; }
.sc-en { font: 600 24px/24px var(--sans); }
.sc-ja { font: 500 14px/16.8px var(--sans); }
.sc-desc { margin: 0; font: 400 13px/1.6 var(--sans); color: #555; }
.center { display: flex; justify-content: center; margin-top: 40px; }
.btn-more { display: inline-flex; align-items: center; gap: 16px; padding: 8px 24px; border-radius: 4px; background: var(--dark); color: #fff; font: 500 20px/30px var(--sans); }
.prop { display: flex; gap: 40px; }
.prop-person { flex: 0 0 160px; text-align: center; }
.prop-photo { width: 160px; height: 160px; border-radius: 50%; object-fit: cover; display: block; }
.prop-role { margin: 12px 0 4px; font: 300 12px/1.3 var(--sans); color: #888; }
.prop-name { margin: 0; font: 500 20px/20px var(--sans); }
.prop-body { flex: 1; min-width: 0; display: flex; flex-direction: column; gap: 12px; }
.prop-lead { margin: 0; padding: 10px 8px; background: #f7f7f7; font: 600 18px/1.4 var(--sans); }
.prop-text { margin: 0; font: 400 14px/1.5 var(--sans); color: #333; }
.prop-facts { margin: 8px 0 0; display: flex; flex-wrap: wrap; gap: 16px 40px; }
.prop-facts dt { font: 300 12px/15.6px var(--sans); color: #888; }
.prop-facts dd { margin: 4px 0 0; font: 400 14px/1.5 var(--sans); }
.sns { display: flex; gap: 12px; }
.sns a { display: inline-flex; color: #242424; }
.sns a :global(svg) { height: 18px; width: auto; display: block; }
.sns a:hover { color: #666; }
@media (max-width: 1023px) {
.hero { padding: 88px 24px 32px; flex-direction: column; gap: 24px; }
/* 縦並びでは flex-basis の 588px が高さとして効き、文章と動画の間が大きく空いていた */
.hero-text { flex: none; }
.hero-video { width: 100%; flex-basis: auto; }
.grid4 { grid-template-columns: repeat(2, minmax(0, 1fr)); }
}
@media (max-width: 599px) {
.hero { padding: 72px 24px 24px; }
.hero h1 { font-size: 24px; line-height: 1.5; }
.hero p { font-size: 16px; line-height: 1.75; }
.grid2 { grid-template-columns: 1fr; gap: 24px; }
.grid4 { gap: 16px; }
.prop { flex-direction: column; align-items: center; gap: 24px; }
}
</style>
src/pages/404.astro
---
import Base from '../layouts/Base.astro';
---
<Base title="ページが見つかりません | Pixels to Motors" description="お探しのページは見つかりませんでした。" path="/404" noindex>
  <section class="nf">
    <h1 class="nf-h">このページは見つかりませんでした</h1>
    <p>住所が変わったか、ページがなくなった可能性があります。</p>
    <p><a class="btn-dark" href="/">トップへ<i class="ms">arrow_forward</i></a></p>
  </section>
</Base>
<style>
  .nf { max-width: 620px; margin: 0 auto; padding: 160px 24px 200px; font: 400 16px/1.8 var(--sans); }
  .nf-h { font: 600 24px/1.5 var(--sans); }
</style>
src/pages/mecharm_data_blueprint.astro
---
import Base from '../layouts/Base.astro';
---
<Base title="mechArm に使っているデータの全体図 | Pixels to Motors" description="mechArm 270 Pi に使っているデータ(live / twin / real と pose_id)の全体図。" path="/mecharm_data_blueprint">
  <section class="bp">
    <h1 class="bp-h">mechArm に使っているデータの全体図</h1>
    <div class="embed"><iframe src="/embeds/mecharm_data_blueprint.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="mechArm に使っているデータの全体図" data-embed style="height:1200px"></iframe></div>
  </section>
</Base>
<style>
  .bp { padding: 48px 0 0; }
  .bp-h { position: absolute; width: 1px; height: 1px; overflow: hidden; clip: rect(0 0 0 0); white-space: nowrap; }
  .bp .embed iframe { display: block; width: 100%; border: 0; }
</style>
src/pages/message.astro
---
import Base from '../layouts/Base.astro';
---
<Base title="お問い合わせ(メッセージ) | Pixels to Motors" description="Pixels to Motors へのお問い合わせ。ロボットやフィジカルAIの体験設計、HRI デザインなど、仕事のご依頼やご相談をお聞かせください。1〜2営業日以内にお返事します。" path="/message">
  <section class="msg">
    <div class="msg-lead">
      <h1 class="msg-h">Message | メッセージ</h1>
      <p>Pixels to Motorsにご興味を持っていただきありがとうございます。仕事のご依頼や、ご相談内容をお聞かせください。1〜2営業日以内にお返事いたします。</p>
    </div>
    <form class="msg-form" id="msgForm" novalidate>
      <label>お名前<span class="req">*</span><input name="name" type="text" placeholder="氏名" required autocomplete="name" /></label>
      <label>メールアドレス<span class="req">*</span><input name="email" type="email" placeholder="XXXXXXXX@compay.com" required autocomplete="email" /></label>
      <label>ご相談内容<span class="req">*</span><textarea name="body" rows="9" placeholder="現在〇〇の現場でロボット導入を検討中ですが、シミュレーションでどこまで検証できるか知りたいです」「URDFデータはありますが、Isaac Simへの移行で困っています。" required></textarea></label>
      <label class="agree"><input name="agree" type="checkbox" required />送信をもって<a href="/privacypolicy">プライバシーポリシー</a>に同意いただいたものとみなします。</label>
      <button class="send" type="submit"><span class="send-ic"><i class="ms">send</i></span><span class="send-t">送信する</span></button>
      <p class="msg-note" id="msgNote" hidden></p>
    </form>
  </section>
</Base>
<script>
  const form = document.getElementById('msgForm') as HTMLFormElement;
  const note = document.getElementById('msgNote') as HTMLParagraphElement;
  const say = (t: string) => { note.textContent = t; note.hidden = false; };
  form.addEventListener('submit', async (e) => {
    e.preventDefault();
    if (!form.reportValidity()) return;
    const f = new FormData(form);
    const btn = form.querySelector('button')!; btn.disabled = true;
    try {
      const r = await fetch('/api/message', { method: 'POST', headers: { 'content-type': 'application/json' },
        body: JSON.stringify({ name: f.get('name'), email: f.get('email'), body: f.get('body'), agree: f.get('agree') === 'on' }) });
      const d = await r.json();
      if (d.ok) { form.reset(); say('送信しました。1〜2営業日以内にお返事いたします。'); }
      else say(d.error || '送信できませんでした。時間をおいてもう一度お試しください。');
    } catch { say('送信できませんでした。時間をおいてもう一度お試しください。'); }
    btn.disabled = false;
  });
</script>
<style>
  .msg { max-width: 1080px; margin: 0 auto; padding: 104px 24px 104px; display: grid; grid-template-columns: 451px 565px; justify-content: space-between; gap: 40px; }
  .msg-h { margin: 0 0 24px; font: 600 24px/36px var(--sans); }
  .msg-lead p { margin: 0; font: 400 16px/24px var(--sans); }
  .msg-form { display: flex; flex-direction: column; }
  .msg-form label { display: block; margin-bottom: 16px; font: 500 16px/24px var(--sans); }
  .req { color: #ff4000; margin-left: 4px; font: 700 15px/21px var(--sans); }
  .msg-form input[type=text], .msg-form input[type=email], .msg-form textarea { display: block; width: 100%; margin-top: 8px; padding: 8px 12px;
    background: #fdfdfd; border: 1px solid #aeadab; border-radius: 4px; font: 400 14px/21px var(--sans); color: #333; }
  .msg-form textarea { resize: vertical; min-height: 240px; }
  .agree { font: 500 14px/21px var(--sans) !important; display: flex !important; gap: 10px; align-items: flex-start; }
  .agree input { margin-top: 4px; }
  .agree a { color: #097ac1; font-weight: 700; }
  .send { display: flex; align-items: center; justify-content: center; gap: 16px; height: 120px; border: 0; background: transparent; cursor: pointer; }
  .send-ic { width: 60px; height: 60px; border-radius: 50%; background: var(--dark); color: #fdfdfd; display: inline-flex; align-items: center; justify-content: center; }
  .send-ic .ms { font-size: 28px; }
  .send-t { font: 500 14px/22.4px var(--sans); color: var(--ink); }
  .send:disabled { opacity: .5; }
  .msg-note { margin: 0; font: 500 14px/21px var(--sans); color: var(--ink); text-align: center; }
  @media (max-width: 1100px) { .msg { grid-template-columns: 1fr; padding-top: 88px; } }
</style>
src/pages/privacypolicy.astro
---
import Base from '../layouts/Base.astro';
const sections = [
  ['個人情報の管理', '当方は、お客さまの個人情報を正確かつ最新の状態に保ち、個人情報への不正アクセス・紛失・破損・改ざん・漏洩などを防止するため、セキュリティシステムの維持・管理体制の整備徹底等の必要な措置を講じ、安全対策を実施し個人情報の厳重な管理を行ないます。'],
  ['個人情報の利用目的', 'お客さまからお預かりした個人情報は、当方からのご連絡や業務のご案内やご質問に対する回答として、電子メールや資料のご送付に利用いたします。\nまた、お預かりした各種技術データ(CAD、URDF等)は、本サービスの提供およびシミュレーション精度向上のためにのみ使用し、第三者への開示は一切行いません。'],
  ['個人情報の第三者への開示・提供の禁止', '当方は、お客さまよりお預かりした個人情報を適切に管理し、次のいずれかに該当する場合を除き、個人情報を第三者に開示いたしません。\n・お客さまの同意がある場合\n・お客さまが希望されるサービスを行なうために当方が業務を委託する業者に対して開示する場合\n・法令に基づき開示することが必要である場合'],
  ['メッセージフォームでお預かりする情報', 'メッセージフォームから送信いただいた内容(お名前・メールアドレス・ご相談内容)と、送信日時・ご利用のブラウザの種類(ユーザーエージェント)を保存します。これらはお問い合わせへのご返信とご相談への対応のためにのみ使用します。\n保存には Cloudflare, Inc. のサービス(Cloudflare R2)を、当方への通知メールの送信には Cloudflare Email Routing を利用しています。'],
  ['Cookie とアクセス解析について', '当サイトは、サイトの改善のために Cloudflare, Inc. のアクセス解析(Cloudflare Web Analytics)を利用しています。このアクセス解析は Cookie を使わず、ページの閲覧数・表示速度・参照元・おおよその国・ブラウザやOSの種類などを、個人を識別しない形で集計します。<br>当サイトは広告配信サービスを利用しておらず、当方がお客さまを識別するための Cookie を設定することはありません。'],
  ['外部サービスの利用について', '当サイトでは、表示や機能のために次の外部サービスを利用しています。これらのサービスの提供元は、お客さまのブラウザから送られる情報(IP アドレス、ブラウザの種類など)を、それぞれのプライバシーポリシーに基づいて取得することがあります。\n・Cloudflare(サイトの配信・画像と動画の配信・メッセージの保存・アクセス解析):<a href="https://www.cloudflare.com/ja-jp/privacypolicy/" target="_blank" rel="noopener">Cloudflare のプライバシーポリシー</a>\n・Google Fonts(文字の表示)/YouTube(動画の埋め込み):<a href="https://policies.google.com/privacy?hl=ja" target="_blank" rel="noopener">Google プライバシーポリシー</a>\nYouTube の動画を再生した場合、YouTube が Cookie を設定することがあります。'],
  ['個人情報の安全対策', '当方は、個人情報の正確性及び安全性確保のために、セキュリティに万全の対策を講じています。'],
  ['ご本人の照会', 'お客さまがご本人の個人情報の照会・修正・削除などをご希望される場合には、<a href="/message">メッセージフォーム</a>からご連絡ください。ご本人であることを確認の上、対応させていただきます。'],
  ['法令、規範の遵守と見直し', '当方は、保有する個人情報に関して適用される日本の法令、その他規範を遵守するとともに、本ポリシーの内容を適宜見直し、その改善に努めます。'],
];
const nl = (s: string) => s.replace(/\n/g, '<br>');
const revised = '2026年10月17日';
---
<Base title="プライバシーポリシー | Pixels to Motors" description="Pixels to Motors(ADAPT DESIGN)のプライバシーポリシー。お預かりする個人情報と技術データの扱い、メッセージフォームの情報の保存、Cookie を使わないアクセス解析、利用している外部サービスについて説明しています。" path="/privacypolicy">
  <article class="pp">
    <h1 class="pp-h">Privacy policy | プライバシーポリシー</h1>
    <p class="pp-p">Pixels to Motors(運営:ADAPT DESIGN 島津 栄一。以下「当方」といいます。)は、当方の提供するサービス(以下「本サービス」といいます。)における、ユーザーについての個人情報を含む利用者情報の取扱いについて、以下のとおりプライバシーポリシー(以下「本ポリシー」といいます。)を定めます。</p>
    {sections.map(([h, b]) => (<><h2 class="pp-h2">{h}</h2><p class="pp-p" set:html={nl(b)} /></>))}
    <p class="pp-p pp-date">最終改定日:{revised}</p>
  </article>
</Base>
<style>
  .pp { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 104px; }
  .pp-h { margin: 0 0 40px; font: 600 24px/36px var(--sans); }
  .pp-h2 { margin: 40px 0 16px; font: 500 18px/27px var(--sans); }
  .pp-p { margin: 0; font: 400 16px/1.6 var(--sans); }
  .pp-date { margin-top: 40px; color: var(--ink-2); }
  .pp-p :global(a) { color: #097ac1; text-decoration: underline; }
  @media (max-width: 767px) { .pp { padding-top: 72px; } }
</style>
src/pages/sitemap.xml.ts
// /sitemap.xml でも一覧にたどり着けるようにする(本体は @astrojs/sitemap が作る /sitemap-0.xml)
export function GET() {
  const body = `<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <sitemap><loc>https://pixelstomotors.com/sitemap-0.xml</loc></sitemap>
</sitemapindex>
`;
  return new Response(body, { headers: { 'Content-Type': 'application/xml; charset=utf-8' } });
}
astro.config.mjs
import { defineConfig } from 'astro/config';
import sitemap from '@astrojs/sitemap';
import remarkMarkers from './src/lib/remark-markers.mjs';

// URL は今の Studio と同じ「末尾の / なし」にそろえる(/series7 → series7.html)
export default defineConfig({
  site: 'https://pixelstomotors.com',
  trailingSlash: 'ignore',
  build: { format: 'file' },
  // 検索エンジン向けの全ページ一覧(/sitemap-index.xml と /sitemap-0.xml を作る)。404 ページは載せない
  integrations: [
    sitemap({ filter: (page) => !page.endsWith('/404') && !page.endsWith('/404/') }),
  ],
  markdown: {
    // コードは今のサイトと同じく色を付けずに出す
    syntaxHighlight: false,
    remarkPlugins: [remarkMarkers],
  },
});
package.json
{
  "name": "p2m-site",
  "type": "module",
  "private": true,
  "scripts": {
    "build": "astro build",
    "dev": "astro dev",
    "preview": "astro preview"
  },
  "dependencies": {
    "@astrojs/sitemap": "3.7.4",
    "astro": "5.13.5",
    "mdast-util-to-string": "4.0.0",
    "unist-util-visit": "5.0.0"
  }
}
public/robots.txt
User-agent: *
Allow: /

Sitemap: https://pixelstomotors.com/sitemap-index.xml
public/_headers
# 記事の中に埋め込んで見せる部品(サムネイル・図解)は、単独のページとして検索結果に出さない
# (indexifembedded:埋め込んだ記事の一部としては読まれる)
/embeds/*
  X-Robots-Tag: noindex, indexifembedded
/thumbs/*
  X-Robots-Tag: noindex, indexifembedded
.gitignore
node_modules/
dist/
.astro/
.wrangler/
# 記事・4コマの画像と動画は GitHub に入れない(MASTER のルール)。置き場所は Cloudflare R2(p2m-media)
public/media/
__pycache__/
tools/render_og.py
"""記事のサムネイル(public/thumbs/*.html)を、SNS・検索結果に出す画像(public/og/*.jpg)に書き出す。

XやLinkedInで記事のリンクを貼ったときに出る画像は、HTMLでは出せないため、画像にしておく。
記事ページは、この画像があれば og:image に使い、なければサイト共通の画像を使う。

使い方(Chromium と Playwright のある Claude のクラウドの作業環境で動かす。Mac には Playwright がない):
  python3 tools/render_og.py            # まだ画像がないサムネイルだけ書き出す
  python3 tools/render_og.py LOG344     # 指定したものだけ書き出し直す(ファイル名から .html を除いた名前)
  python3 tools/render_og.py --all      # 全部書き出し直す

大きさは 1200×675(16:9)。Google が大きな画像として扱う幅 1200 以上にそろえる。
"""
import os
import sys
from pathlib import Path

from playwright.sync_api import sync_playwright

W, H = 1200, 675
site = Path(__file__).resolve().parent.parent
thumbs = site / "public/thumbs"
out_dir = site / "public/og"
out_dir.mkdir(parents=True, exist_ok=True)

args = sys.argv[1:]
names = sorted(p.stem for p in thumbs.glob("*.html"))
if "--all" in args:
    targets = names
elif args:
    targets = [a.removesuffix(".html") for a in args]
else:
    targets = [n for n in names if not (out_dir / f"{n}.jpg").exists()]

exe = os.environ.get("CHROMIUM_PATH") or next(
    (str(p) for p in Path("/opt/pw-browsers").glob("chromium-*/chrome-linux/chrome")), None)

done = []
with sync_playwright() as pw:
    browser = pw.chromium.launch(executable_path=exe) if exe else pw.chromium.launch()
    page = browser.new_page(viewport={"width": W, "height": H}, device_scale_factor=1)
    for name in targets:
        src = thumbs / f"{name}.html"
        if not src.exists():
            print(f"見つからない: {src}")
            continue
        page.goto(src.as_uri(), wait_until="networkidle")
        page.evaluate("document.fonts.ready")
        # 動くサムネイルは、動きが落ち着いたところで撮る
        page.wait_for_timeout(2500)
        page.screenshot(path=str(out_dir / f"{name}.jpg"), type="jpeg", quality=85,
                        clip={"x": 0, "y": 0, "width": W, "height": H})
        done.append(name)
    browser.close()

print(f"書き出し {len(done)} 件 → public/og/")
tools/crop_screenshot.py
"""画面のスクリーンショットから、ウィンドウの枠・影とブラウザのタブ・アドレスバー・ブックマークバーを切り落とす。

記事に載せる画面写真は、ページの中身だけにする(article_rules.md「画像と図解の置き方」)。
アドレスバーやタブには、アカウントの番号・メールの件名など載せたくない情報が写ることもある。

使い方(Pillow があればどこでも動く):
  python3 tools/crop_screenshot.py <画像> [<画像> ...]          # 自動で切って、元の画像を上書きする
  python3 tools/crop_screenshot.py <画像> --box 左 上 右 下       # 切る範囲を数字で指定する(自動がずれたとき)
  python3 tools/crop_screenshot.py <画像> --dry-run              # 切る範囲を表示するだけ

元の画像は、同じフォルダの _original/ に写してから上書きする(_original/ に同名があれば写さない)。
切ったあとは、必ず画像を開いて、ページの中身が欠けていないか・枠が残っていないかを目で確かめる。

自動で切る手順:
  自動で切るのは、macOS でウィンドウを撮った画像(外側が透明な影)だけ。範囲を選んで撮った画像は切らない
  1. 透明な影と、外側の一色の余白を落とす
  2. ウィンドウの上から約 130pt の範囲で、横幅いっぱいに色が切り替わる最も下の線を探す
     (タブ・アドレスバー・ブックマークバーと、ページの境目)。その線から下を残す
  見つからなければ 2 は行わない(ブラウザ以外のアプリの画面はそのまま)
  画面全体を撮った画像(メニューバー入り)や、自動がずれたときは、画像を見て --box で範囲を指定する
"""
import shutil
import sys
from pathlib import Path

from PIL import Image, ImageChops


def has_window_shadow(im: Image.Image) -> bool:
    """macOS でウィンドウを撮った画像か(外側が透明な影になっている)"""
    if im.mode not in ("RGBA", "LA"):
        return False
    return im.getchannel("A").getpixel((0, 0)) < 128


def trim_outer(im: Image.Image) -> Image.Image:
    # 透明な影を落とす
    if im.mode in ("RGBA", "LA"):
        alpha = im.getchannel("A").point(lambda a: 255 if a > 200 else 0)
        box = alpha.getbbox()
        if box:
            im = im.crop(box)
    im = im.convert("RGB")
    # 外側の一色の余白(角の色と同じ色)を落とす
    bg = Image.new("RGB", im.size, im.getpixel((0, 0)))
    diff = ImageChops.difference(im, bg).convert("L").point(lambda v: 255 if v > 12 else 0)
    box = diff.getbbox()
    if box and (box[2] - box[0]) > im.width * 0.5 and (box[3] - box[1]) > im.height * 0.5:
        im = im.crop(box)
    # ウィンドウの角の丸みと縁の線を避けるため、四辺を少し内側へ
    inset = max(2, round(min(im.size) * 0.004))
    return im.crop((inset, inset, im.width - inset, im.height - inset))


def chrome_bottom(im: Image.Image) -> int:
    """ブラウザの上の帯(タブ・アドレスバー・ブックマークバー)とページの境目の y。なければ 0"""
    g = im.convert("L")
    w, h = g.size
    # ブラウザの上の帯の高さは、ウィンドウの大きさによらず一定(タブ+アドレスバー+ブックマークバーで約 120pt)。
    # それより下まで探すと、ページ自身のヘッダーの境目を拾ってしまう。Retina(幅 2000px 以上)は 2 倍で数える
    scale = 2 if w >= 2000 else 1
    limit = min(int(h * 0.30), 130 * scale)
    px = g.load()
    xs = range(int(w * 0.02), int(w * 0.98), max(1, w // 400))
    best = 0
    prev = [px[x, 0] for x in xs]
    for y in range(1, limit):
        row = [px[x, y] for x in xs]
        changed = sum(1 for a, b in zip(prev, row) if abs(a - b) > 10) / len(row)
        if changed > 0.85:
            best = y
        prev = row
    # 境目の線(1〜2px)を含めない
    return best + 2 if best else 0


def main() -> None:
    args = sys.argv[1:]
    dry = "--dry-run" in args
    box = None
    if "--box" in args:
        i = args.index("--box")
        box = tuple(int(v) for v in args[i + 1 : i + 5])
        args = args[:i] + args[i + 5 :]
    files = [Path(a) for a in args if not a.startswith("--")]
    for f in files:
        src = Image.open(f)
        if box:
            out = src.convert("RGB").crop(box)
            how = f"指定 {box}"
        elif not has_window_shadow(src):
            out = src.convert("RGB")
            how = "ウィンドウを撮った画像ではないので切らない(必要なら --box で指定)"
            print(f"{f.name}: {how}")
            continue
        else:
            win = trim_outer(src)
            top = chrome_bottom(win)
            out = win.crop((0, top, win.width, win.height))
            how = f"枠を除いて {win.size}、上から {top}px を切る"
        print(f"{f.name}: {src.size} → {out.size}({how})")
        if dry:
            continue
        keep = f.parent / "_original" / f.name
        if not keep.exists():
            keep.parent.mkdir(exist_ok=True)
            shutil.copy2(f, keep)
        fmt = "PNG" if f.suffix.lower() == ".png" else None
        out.save(f, fmt) if fmt else out.save(f, quality=90)


if __name__ == "__main__":
    main()
tools/add_article.py
"""記事の作業フォルダ(iCloud)から、記事1本をサイトに入れる。

使い方:
  python3 tools/add_article.py <作業フォルダ> <LOG番号> <シリーズ名>

やること:
- LOG{N}_article.md      → src/content/records/LOG{N}.md(先頭の項目に series を足す)
- LOG{N}_thumbnail.html  → public/thumbs/LOG{N}.html
- 本文の【図解】の HTML  → public/embeds/(図解の高さを親ページに知らせる仕組みを足す)
- 本文の【画像】の画像    → あるかを確かめるだけ。画像は GitHub に入れず、Mac で tools/upload_media.py を使って R2 に入れる

このあと、Claude のクラウドの作業環境で tools/render_og.py LOG{N} を動かし、
サムネイルを SNS・検索結果用の画像(public/og/LOG{N}.jpg)に書き出す(Mac には Playwright がないため)
"""
import re, shutil, sys
from pathlib import Path

work, day, series = Path(sys.argv[1]), sys.argv[2], sys.argv[3]
site = Path(__file__).resolve().parent.parent
md_src = work / f"LOG{day}_article.md"
text = md_src.read_text(encoding="utf-8")

# 先頭の項目(---で囲まれた部分)に series を入れる
fm_end = text.index("\n---", 3)
fm, body = text[:fm_end], text[fm_end:]
if re.search(r"^series:", fm, flags=re.M):
    fm = re.sub(r"^series:.*$", f'series: "{series}"', fm, flags=re.M)
else:
    fm += f'\nseries: "{series}"'
out = site / "src/content/records" / f"LOG{day}.md"
out.parent.mkdir(parents=True, exist_ok=True)
out.write_text(fm + body, encoding="utf-8")

reporter = re.search(r'HEIGHT_REPORTER = """(.*?)"""',
                     (site / "tools/import_all.py").read_text(encoding="utf-8"), re.S).group(1)

thumb = work / f"LOG{day}_thumbnail.html"
if thumb.exists():
    (site / "public/thumbs").mkdir(parents=True, exist_ok=True)
    shutil.copy2(thumb, site / "public/thumbs" / f"LOG{day}.html")

for name in re.findall(r"^【図解】\s*(\S+\.html)\s*$", body, flags=re.M):
    doc = (work / name).read_text(encoding="utf-8")
    doc = doc.replace("</body>", reporter + "</body>", 1) if "</body>" in doc else doc + reporter
    (site / "public/embeds" / name).write_text(doc, encoding="utf-8")

missing = []
for name in re.findall(r"^【画像】\s*(\S+)(?:\s+.*)?$", body, flags=re.M):  # 「【画像】ファイル名 説明」の説明は alt になる
    src = work / f"LOG{day}_images" / name
    if not src.exists():
        missing.append(name)

print(f"次に: python3 tools/render_og.py LOG{day}(SNS・検索結果用の画像を書き出す)")
print(f"LOG{day}: 記事 {out.name}, シリーズ {series}" + (f", 見つからない画像 {missing}" if missing else ""))
if missing:
    sys.exit(1)
tools/upload_media.py
"""記事・4コマの画像と動画を、Cloudflare R2(p2m-media)へ入れる。

Mac 上で動かす(画像は Mac の iCloud にあり、GitHub には入れないため)。
鍵は KIOXIA の p2m_cloudflare_token.txt から読む(画面にもログにも出さない)。

使い方:
  python3 upload_media.py <フォルダ> [<フォルダ> ...]
    フォルダの下(深さは問わない)の画像・動画を、ファイル名をそのまま住所にして入れる。
    すでに同じ名前・同じ大きさのものが入っていれば飛ばす。
    同じ名前で中身が違うものが見つかったら、入れずに知らせる(上書きしない)。
  オプション --dry-run : 入れずに、入れる予定のものだけ数える

名前の末尾が「 2」のフォルダ(iCloud が作る重複コピー)は読まない。
"""
import json
import mimetypes
import os
import sys
import time
import urllib.parse
import urllib.request
from pathlib import Path

ACCOUNT = '21d7aed1b193796b89287df10913f2dc'
BUCKET = 'p2m-media'
API = f'https://api.cloudflare.com/client/v4/accounts/{ACCOUNT}/r2/buckets/{BUCKET}/objects'
EXTS = {'.png', '.jpg', '.jpeg', '.webp', '.gif', '.svg', '.mp4', '.webm', '.mov', '.avif'}
TOKEN_FILE = Path.home() / 'mnt/KIOXIA/p2m_cloudflare_token.txt'
if not TOKEN_FILE.exists():
    TOKEN_FILE = Path('/Volumes/KIOXIA/p2m_cloudflare_token.txt')


def token():
    return TOKEN_FILE.read_text(encoding='utf-8').strip().split()[0]


def req(method, url, data=None, ctype=None):
    r = urllib.request.Request(url, data=data, method=method)
    r.add_header('Authorization', 'Bearer ' + token())
    if ctype:
        r.add_header('Content-Type', ctype)
    for attempt in range(4):
        try:
            with urllib.request.urlopen(r, timeout=300) as res:
                return json.loads(res.read() or b'{}')
        except Exception as e:  # 一時的な失敗は待ってやり直す
            if attempt == 3:
                raise
            time.sleep(3 * (attempt + 1))


def existing():
    """入っているものの一覧(名前 → 大きさ)"""
    out, cursor = {}, None
    while True:
        q = {'per_page': 1000}
        if cursor:
            q['cursor'] = cursor
        d = req('GET', API + '?' + urllib.parse.urlencode(q))
        for o in d.get('result', []):
            out[o['key']] = int(o['size'])
        cursor = (d.get('result_info') or {}).get('cursor')
        if not (d.get('result_info') or {}).get('is_truncated'):
            return out


def files(roots):
    found = {}
    for root in roots:
        for dirpath, dirnames, filenames in os.walk(root):
            # _original/ は crop_screenshot.py が残した切る前の画像なので上げない
            dirnames[:] = [d for d in dirnames if not d.endswith(' 2') and not d.startswith('.') and d != '_original']
            for n in filenames:
                p = Path(dirpath) / n
                if p.suffix.lower() in EXTS and not n.startswith('.'):
                    found.setdefault(n, []).append(p)
    return found


def main():
    args = [a for a in sys.argv[1:] if not a.startswith('--')]
    dry = '--dry-run' in sys.argv
    have = existing()
    todo, clash, skip = [], [], 0
    for name, paths in sorted(files(args).items()):
        sizes = {p.stat().st_size for p in paths}
        if len(sizes) > 1:
            clash.append((name, [str(p) for p in paths]))
            continue
        size = sizes.pop()
        if name in have:
            if have[name] == size:
                skip += 1
            else:
                clash.append((name, ['入っているものと大きさが違う', str(paths[0])]))
            continue
        todo.append((name, paths[0], size))
    print(f'入れる {len(todo)}・入っている {skip}・名前の重なり {len(clash)}・合計 {sum(s for _, _, s in todo)/1e6:.1f}MB', flush=True)
    for c in clash:
        print('  重なり:', c, flush=True)
    if dry:
        return
    # 同時に8つずつ入れる。途中で止まっても、次に動かせば残りから続く
    from concurrent.futures import ThreadPoolExecutor

    def put(item):
        name, p, size = item
        ctype = mimetypes.guess_type(name)[0] or 'application/octet-stream'
        d = req('PUT', API + '/' + urllib.parse.quote(name), p.read_bytes(), ctype)
        return name, d.get('success'), d.get('errors')

    with ThreadPoolExecutor(8) as ex:
        for i, (name, ok, err) in enumerate(ex.map(put, todo), 1):
            if not ok:
                print('  失敗:', name, err, flush=True)
            if i % 50 == 0 or i == len(todo):
                print(f'  {i}/{len(todo)}', flush=True)
    print('おわり', flush=True)


if __name__ == '__main__':
    main()
README.md
# p2m-site

Pixels to Motors のサイト(pixelstomotors.com)。adaptdesign.jp/pixelstomotors を Studio から移したもの。Astro で静的ページを作り、Cloudflare Workers で配信する。URL は旧サイトから /pixelstomotors を外した形(例: /record/{slug})。旧い形の URL で来たら worker/index.js が 301 で転送する。
GitHub の main に push すると、Cloudflare が自動で作り直して公開する(約40秒)。

- `npm run build` → `dist/` に全ページができる
- `tools/fetch_live.py <出力>`:今の Studio サイトから記事・4コマの CMS データを取り直す(移行時だけ使う)
- `tools/import_all.py <cms> <site_archive/content/static> .`:CMS データと固定ページから `src/data/` と `public/embeds,thumbs` を作る(移行時だけ使う)
- `tools/add_article.py <作業フォルダ> <LOG番号> <シリーズ名>`:Claude が書いた記事1本(Markdown)を入れる
- `tools/render_og.py [LOG番号]`:サムネイル(`public/thumbs/*.html`)を SNS・検索結果用の画像(`public/og/*.jpg`、1200×675)に書き出す。Chromium のある Claude のクラウドの作業環境で動かす(Mac には Playwright がない)。引数なしなら、まだ画像がないものだけ
- `tools/crop_screenshot.py <画像>...`:記事に載せる画面写真から、ウィンドウの枠・影とブラウザのタブ・アドレスバー・ブックマークバーを切り落とす(元の画像は同じフォルダの `_original/` に残す)。upload_media.py の前に動かす
- `tools/upload_media.py <フォルダ>...`:Mac で動かし、画像と動画を R2(p2m-media)へ入れる。鍵は KIOXIA の `p2m_cloudflare_token.txt`

記事・4コマの画像と動画は GitHub に入れない。ただし `public/og/` の画像は、GitHub にあるサムネイルの HTML から書き出したものなので GitHub に入れる。サイトの `/media/ファイル名` を `worker/index.js` が R2 から返す。
メッセージフォームの送信は R2(p2m-messages)に保存する。
点検に使ったスクリプト: audit.py(ビルドした全ページの SEO 項目を数える)
import sys, os, re, collections, html
root = sys.argv[1]
pages = []
for dp, dn, fn in os.walk(root):
    if '/embeds' in dp or '/thumbs' in dp: continue
    for f in fn:
        if f.endswith('.html'): pages.append(os.path.join(dp, f))
def g(p, s):
    m = re.search(p, s, re.S); return html.unescape(m.group(1)) if m else None
titles = collections.defaultdict(list); descs = collections.defaultdict(list)
issues = collections.Counter(); ex = collections.defaultdict(list)
imgs_total = imgs_empty = 0; empty_by_class = collections.Counter()
for p in pages:
    s = open(p, encoding='utf-8').read(); rel = p[len(root):]
    t = g(r'<title>(.*?)</title>', s) or ''; d = g(r'<meta name="description" content="(.*?)"', s)
    titles[t].append(rel); descs[d].append(rel)
    def add(k):
        issues[k] += 1
        if len(ex[k]) < 4: ex[k].append(rel)
    if not d: add('description空')
    elif len(d) > 160: add('description>160字')
    elif len(d) < 50: add('description<50字')
    if len(t) > 60: add('title>60字')
    if 'og:image' not in s: add('og:imageなし')
    h1 = len(re.findall(r'<h1[\s>]', s))
    if h1 != 1: add(f'h1数={h1}')
    if 'application/ld+json' not in s: add('構造化データなし')
    if re.search(r'-en$|english', rel) and 'lang="ja"' in s: add('英語ページなのにlang=ja')
    for im in re.findall(r'<img[^>]*>', s):
        imgs_total += 1
        if 'alt=""' in im:
            imgs_empty += 1
            c = g(r'class="([^"]*)"', im) or '(no class)'; empty_by_class[c.split()[0]] += 1
        if 'width=' not in im: issues['img width/heightなし(延べ)'] += 1
print('pages', len(pages))
for k, v in issues.most_common(): print(f'{k}: {v}  例 {ex.get(k, [])}')
print('duplicate titles:', sum(1 for t, v in titles.items() if len(v) > 1), [ (t, v[:3]) for t, v in titles.items() if len(v) > 1][:5])
print('duplicate descs:', sum(1 for t, v in descs.items() if len(v) > 1 and t), [ (t[:40], v[:3]) for t, v in descs.items() if len(v) > 1 and t][:5])
print('imgs', imgs_total, 'alt空', imgs_empty, empty_by_class.most_common(15))
点検に使ったスクリプト: boxes.py(直す前後で画像の表示サイズを比べる)
import sys
from playwright.sync_api import sync_playwright
pages=['/','/manga/ep102','/record/day1','/series1','/manga-archive','/record/video-progress-board']
sel='header img, .mcard img, .rcard img, .scard img, .hero-img, .mcover, .mcomic, .richText img, .s-img img'
with sync_playwright() as p:
    b=p.chromium.launch(executable_path='/opt/pw-browsers/chromium-1194/chrome-linux/chrome')
    for w in (1280,390):
        pg=b.new_page(viewport={'width':w,'height':900})
        pg.route('**/media/**', lambda r: r.abort())
        for path in pages:
            out=[]
            for base in ('https://pixelstomotors.com','http://localhost:4329'):
                pg.goto(base+path, wait_until='domcontentloaded')
                out.append(pg.eval_on_selector_all(sel,"els=>els.slice(0,8).map(e=>{const r=e.getBoundingClientRect();return Math.round(r.width)+'x'+Math.round(r.height)})"))
            print(w,path,'live',out[0]); print(w,path,'new ',out[1])
    b.close()
点検に使ったスクリプト: shots.py(記事ページの画面写真を撮る)
import sys
from playwright.sync_api import sync_playwright
out='/tmp/claude-0/-home-claude/b575a70c-52d4-50f0-95a4-716e917a5b67/scratchpad/'
def media(route):
    u=route.request.url.replace('http://localhost:4329','https://pixelstomotors.com')
    try: route.fulfill(response=route.fetch(url=u))
    except Exception: route.abort()
with sync_playwright() as p:
    b=p.chromium.launch(executable_path='/opt/pw-browsers/chromium-1194/chrome-linux/chrome')
    for w,tag in ((1280,'pc'),(390,'sp')):
        pg=b.new_page(viewport={'width':w,'height':900})
        pg.route('**/media/**', media)
        for path,name in (('/record/day124','mid'),('/record/what-circularity-actually-measures','md')):
            pg.goto('http://localhost:4329'+path, wait_until='networkidle'); pg.wait_for_timeout(800)
            pg.screenshot(path=f'{out}{tag}_{name}_top.png')
            el=pg.query_selector('.pager') or pg.query_selector('.related')
            el.scroll_into_view_if_needed(); pg.evaluate('window.scrollBy(0,-80)'); pg.wait_for_timeout(800)
            pg.screenshot(path=f'{out}{tag}_{name}_bottom.png', full_page=False)
            if w==1280:
                pg.evaluate('window.scrollBy(0,700)'); pg.wait_for_timeout(600); pg.screenshot(path=f'{out}{tag}_{name}_bottom2.png')
    b.close()