Studio を出て、GitHub に push すると公開されるサイトへ ― 553ページを Astro と Cloudflare に移し、画像は R2 へ
このサイト(adaptdesign.jp/pixelstomotors)は、Studio というノーコードの Web 制作サービスで作っています。記事は Claude が Markdown で書き、それを Studio の編集画面に貼り付け、画像を1枚ずつ入れ、図解の HTML を埋め込みブロックに貼って公開していました。1本あたり数十分の手作業です。前回(LOG334)でサイトの中身を Studio の外へ持ち出せる形にまとめたので、次はその手作業そのものをなくす番でした。
やったことを先に書きます。記事を GitHub に push すると、Cloudflare が約40秒でサイトを作り直して公開する仕組みを組み、今のサイトにある 553 ページ全部をそこへ載せました。本文・タイトル・説明文・画像の数・図解の数を、今のサイトと機械で照合して、一致することを確かめました。画像と動画 1,004 点は Cloudflare の保管場所 R2 に置き、GitHub には入れていません。できたサイトはまだ仮の住所で、ログインした本人しか見られない鍵をかけてあります。ドメインを新しくするときに本番へ切り替えます。
この記事は、その1日の記録です。使ったコードは記事の後半にすべて全文で載せています。朝の時点で別の AI(codex)に出させた検証報告も、全文を載せています。
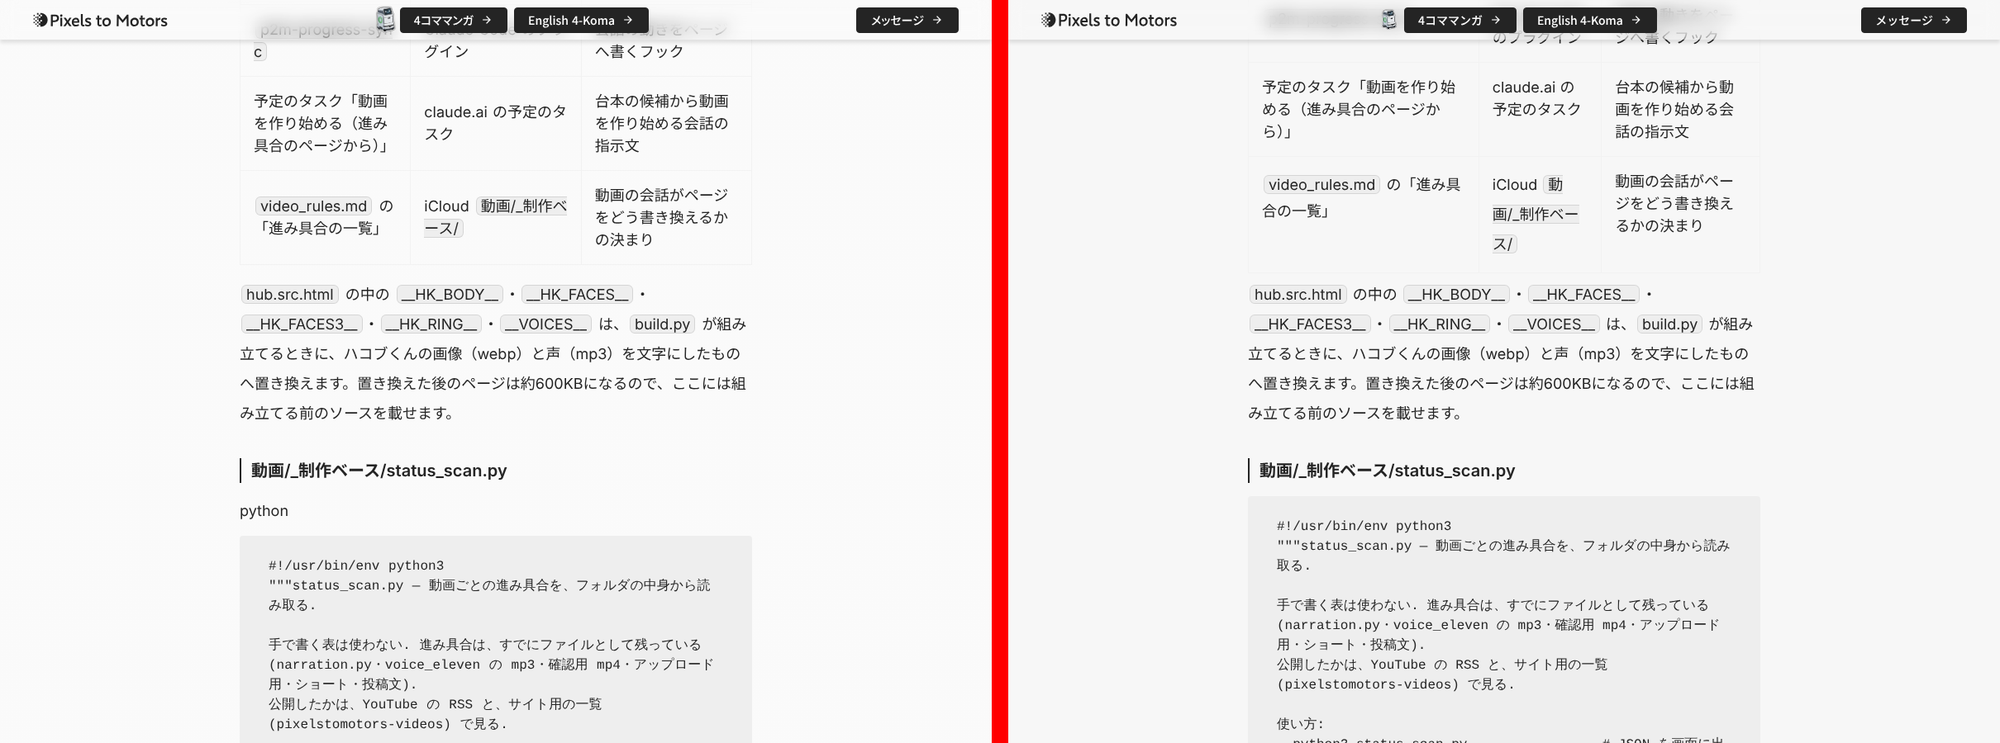
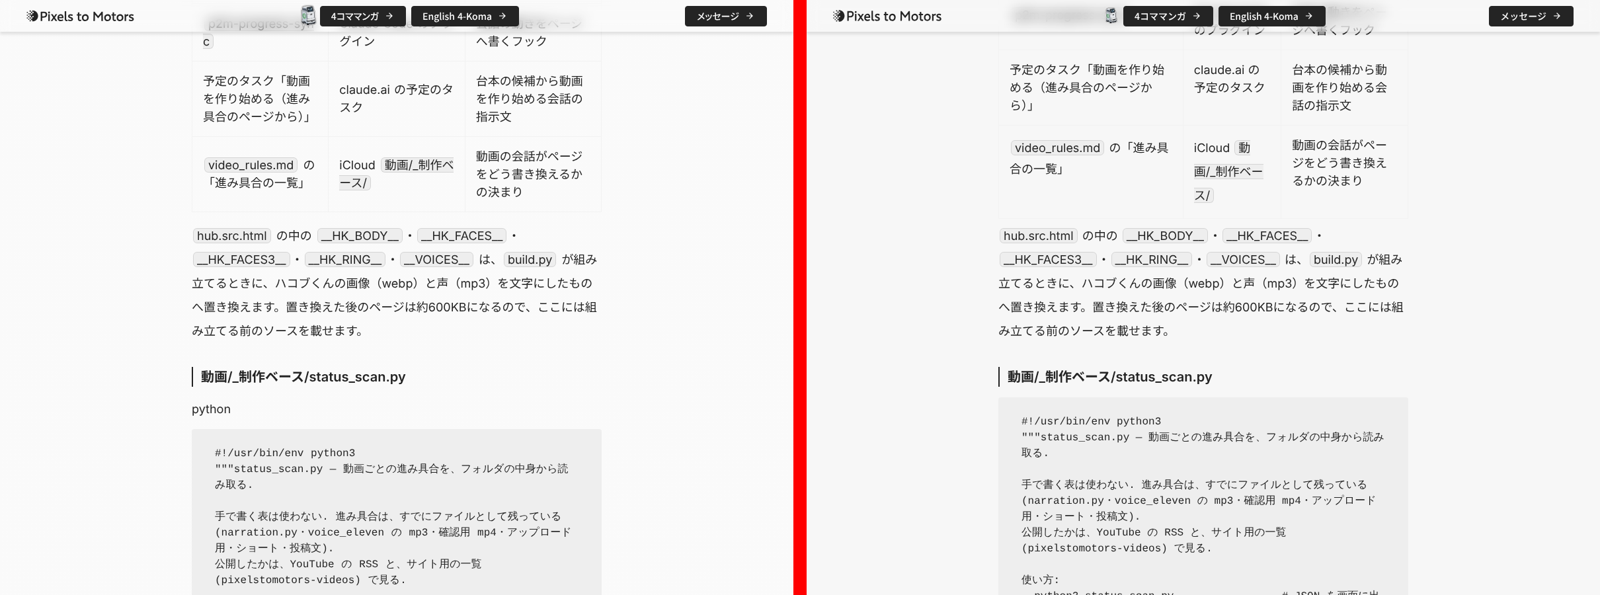
今のサイト(左)と、作り直したサイト(右)の同じ記事を並べたところです。見出しの左の縦線とコードの枠まで同じになっています。
移る先を決める前に、codex に「この計画は間違っている」という前提で検証させた
朝の調査で、移る先の案を6つ並べました。
| 案 | 中身 | 判断 |
|---|---|---|
| 案1 | Studio のまま、貼り付け作業を続ける | 作業をなくしたいという目的に合わない |
| 案2 | Studio の上位プラン(Plus)に上げて、外部データを読む API で本文を流し込む | 月額が上がる。コードや図解を含む本文が崩れずに出る保証がない |
| 案3 | Studio が発表した新サービス Drop(AI から記事を更新できると謳う) | まだ招待制で、価格も提供時期も分からない |
| 案4 | 静的サイト生成(Astro)+ Cloudflare Workers。GitHub から自動で作り直す | 採用。更新は push だけになる |
| 案5 | 記事部分だけ外へ出し、残りは Studio に置く | 住所が2つに分かれ、転送の設定が大量に要る |
| 案6 | Studio の Custom Proxy(有料)で段階的に移す | 最低でも月5万円近くかかる |
案4に決めたあと、計画書を codex に渡して「計画のどこが間違っているか」だけを探させました。報告の総合判定は「案4は条件付きで支持。ただし今の計画のままの切替は NG」でした。見つかった抜けは4つです。
- ドメインに DNSSEC(DNS の改ざん防止の署名)が付いている。 計画はこれを落としていました。DNS の管理先を変えるとき、署名の鍵(DS レコード)を先に外さないと、サイトもメールも名前が引けなくなります。
- Studio の旧 IP(35.194.122.208)には、ドメインの接続を一度外すと戻せない。 戻すときは新 IP(34.111.141.225)で接続し直しになり、証明書の再発行で最大 72 時間かかる可能性があります。「DNS を戻せばすぐ復旧」とは言えません。
- ページ数は 546 ではなく 553。 アーカイブを作った 10/12 以降に記事が 7 本増えていました。切替の直前に取り直す必要があります。
- Studio に登録してある転送 28 件のうち、22 件は転送先がすでに 404。 そのまま写しても壊れたままになります。
この報告は、朝の時点でサイトの設定を何も変えずに、公開ページの取得と DNS の照会だけで書かれています。全文は記事の最後に載せています。
DNSSEC と旧 IP の件は、ドメインを切り替えるときの手順に入れました。この記事の範囲は「切り替える前に、新しいサイトを仮の住所で完成させるところまで」です。
試作4ページで、今のサイトの見た目を数値で写し取った
いきなり 553 ページを移さず、まず 4 ページ(トップ・シリーズ7の一覧・記事 LOG309・4コマ第122話)だけを作って、今のサイトと並べて比べました。
見た目は目で合わせず、今のサイトの各要素の CSS の計算結果(文字の大きさ・太さ・行間・色・余白・影)を Playwright(ブラウザを自動で動かす道具)で読み取って、同じ値を新しいサイトの CSS に書きました。読み取った主な値は次のとおりです。
| 要素 | 今のサイトの値 |
|---|---|
| 記事の本文の幅 | 620px |
| 本文の文字 | Inter + Noto Sans JP、18px、行間 36px、色 #242424 |
| 見出し h2 | 24px、行間 36px、太さ 600、余白 上4px 下16px |
| 見出し h3 | 20px、行間 30px、太さ 600、左に 2px の縦線、左の余白 12px |
| コードの枠(pre) | 背景 #eee、余白 25px 35px、Menlo 16px、行間 24px、角 4px |
| 文中のコード | 本文と同じ書体 18px、背景 #eee、1px の薄い枠、角 6px |
| 目次 | 背景 #f0f0f0、項目 16px、行間 32px、色 #555 |
| 表 | 見出しセルは背景 rgba(240,240,240,.6)・余白 24px、本文セルは 18px・行間 27px・余白 16px、罫線 1px #f2f2f2 |
| ヘッダー | 固定、高さ 48px、背景 rgba(255,255,255,.1) にぼかし 10px、影 0 4px 4px rgba(0,0,0,.1) |
| 記事カード | 角 8px、影 0 8px 16px rgba(0,0,0,.08) |
| 一覧の白い板 | 角 16px、内側の余白 32px |
| ページの背景 | #f7f7f7 |
ヘッダーのロゴだけは写せませんでした。今のサイトのロゴは Studio に付いてくる有料フォント「A1ゴシック」で組まれていて、Studio の外では使えません。ロゴを描き直した PNG を用意してもらい、それを potracer(画像の輪郭を線データに変換するライブラリ)で SVG にして置きました。最初の変換は白黒が反転して出てきたので、しきい値の向きを直しています。
図解(記事の中の動く HTML)は、Studio と同じく隔離した枠(iframe の sandbox)で開きます。隔離した枠の中からは外のページを触れないので、枠の高さが中身に合いません。そこで図解の HTML の末尾に小さなスクリプトを足し、中身の高さを親ページへ送って枠を伸ばすようにしました。最初は中身の高さを scrollHeight(スクロールできる全体の高さ)で測っていたため、枠が伸びると中身も伸びてまた枠が伸びる、という繰り返しが起きました。body の直下にある要素の下端で測るように変えて止まりました。
GitHub に push すると、約40秒後にサイトが入れ替わる
Cloudflare の Workers Builds に GitHub のリポジトリ(PixelstoMotors/p2m-site)をつなぎました。main に push すると、Cloudflare が npm run build を走らせ、できた dist/ を配信します。フッターに作った日時を出しておき、push から表示が変わるまでの時間を測ると、38 秒から 40 秒でした。
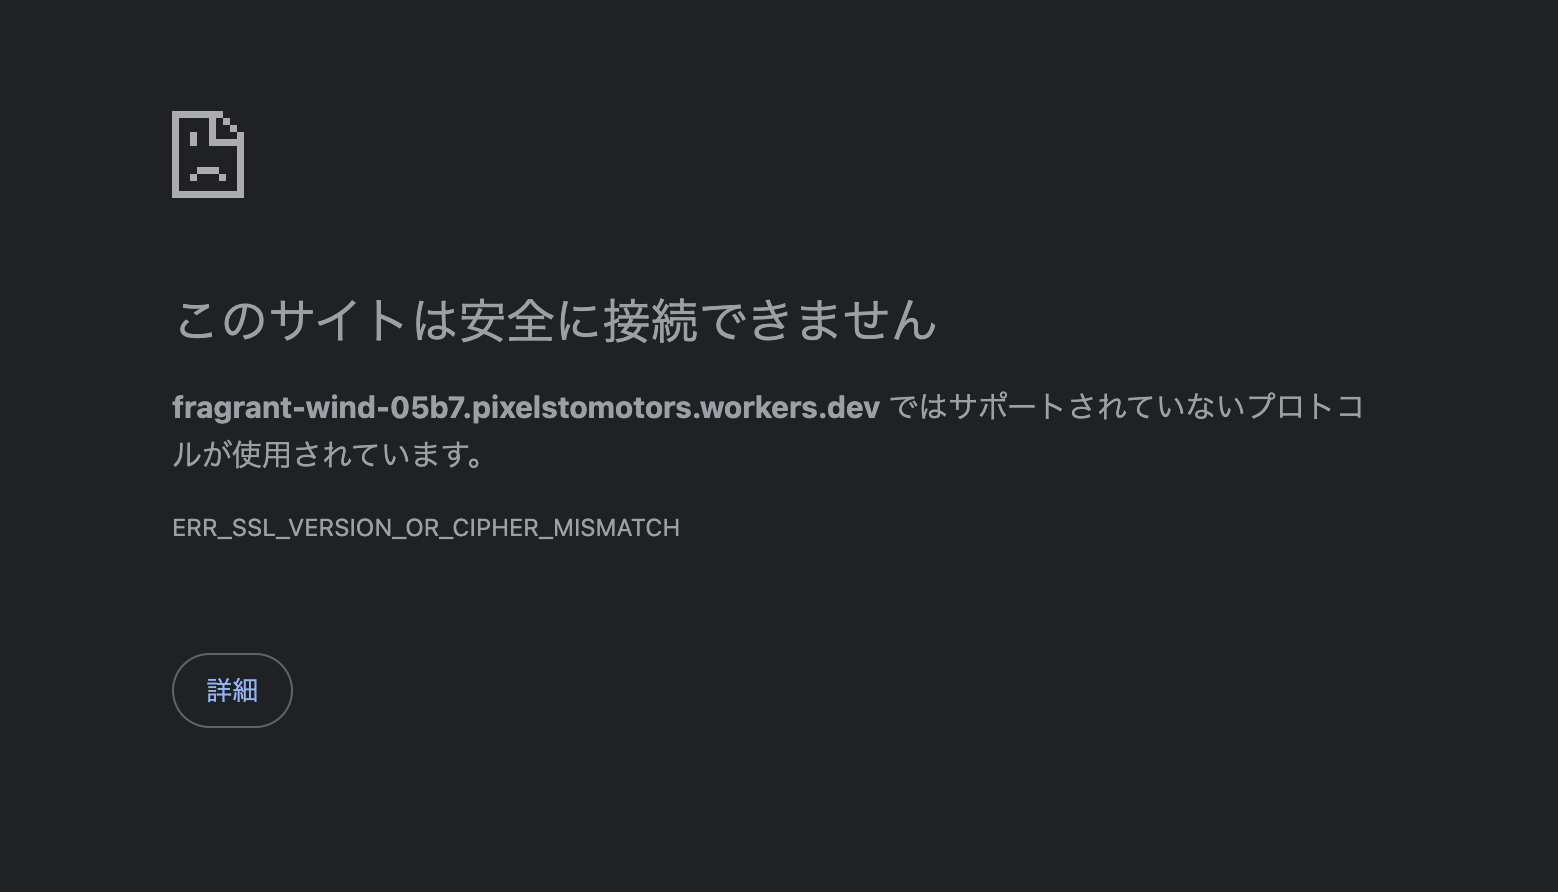
最初に開いたときは、仮の住所(workers.dev)の証明書がまだ発行されておらず、ブラウザが SSL のエラーを出しました。数分待って開き直すと表示されました。
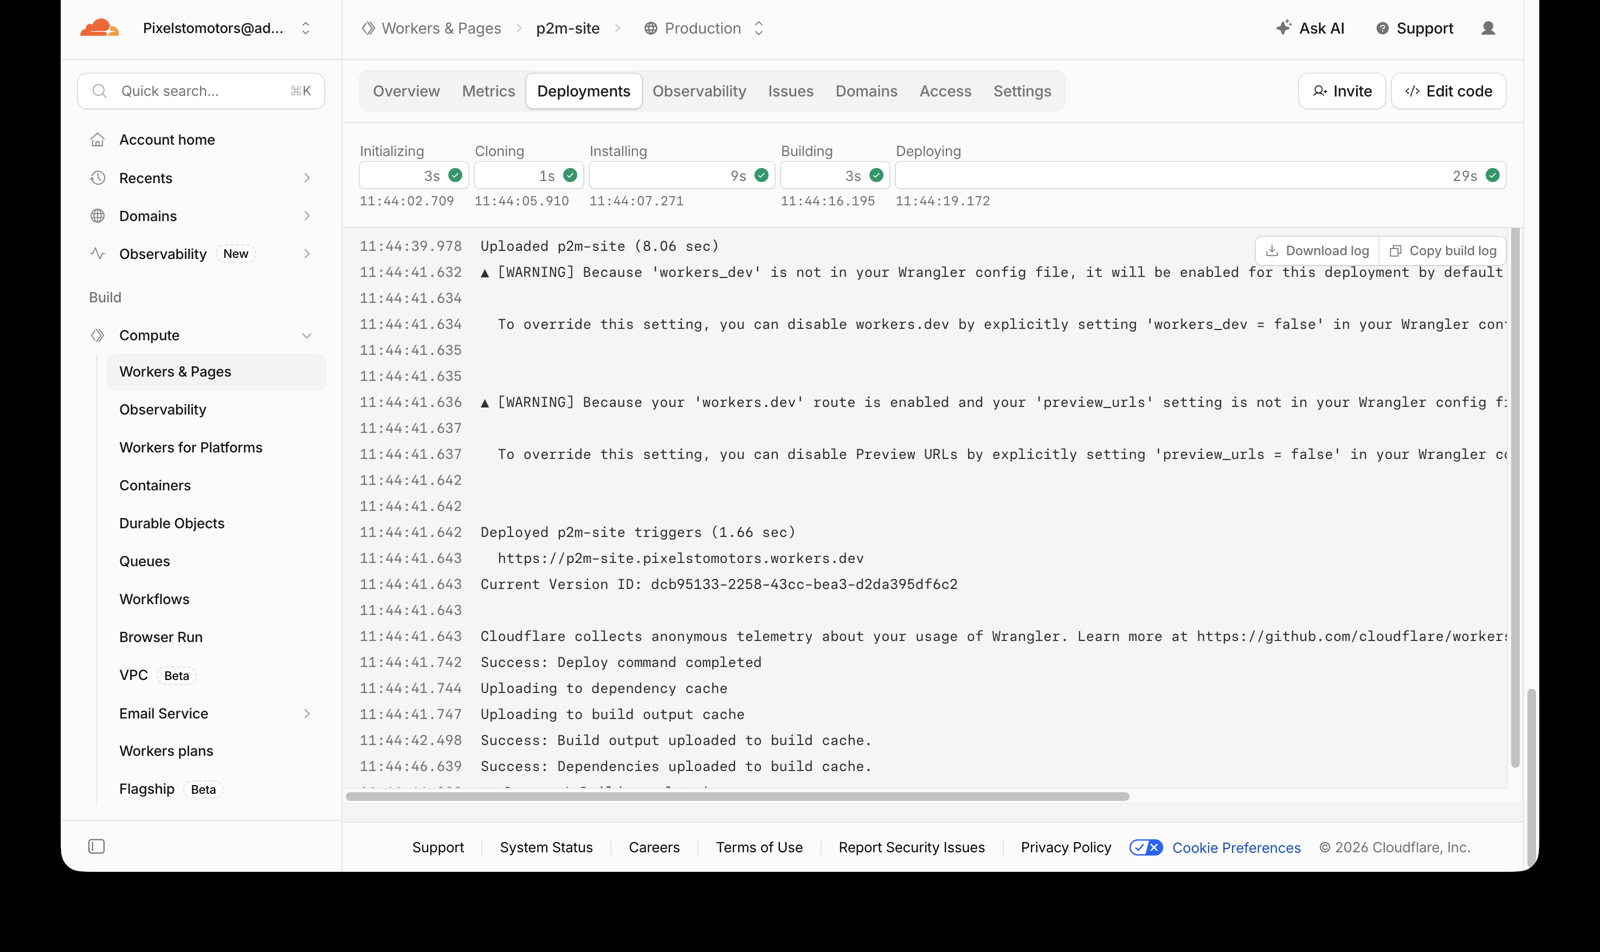
この日の push は 7 回です。
| 時刻 | 内容 |
|---|---|
| 11:36 | 試作の 4 ページ |
| 11:53 | フッターに最終更新日時(自動公開の確認用) |
| 12:06 | Markdown の記事 5 本(LOG334・335・336・338・339) |
| 12:14 | 画像置き場の住所を直す |
| 12:23 | 文字の描き方と見出し・コードの見た目を今のサイトに合わせる。R2R2R の注記はシリーズで出し分け |
| 15:23 | 今のサイトの全ページを移す。画像と動画は R2 から返す |
| 15:42 | 記事を1本入れる道具(add_article.py)を R2 前提に直す |
記事を1本出すときに、何がどこを通って公開されるかを図にしました。
Markdown の【画像】【図解】の行を、そのまま画像と図解の枠に変える
記事の Markdown には、記事制作のルール(article_rules.md)で決めた書き方があります。画像を置く位置に 【画像】DAY339_03_iphone_cards.png と1行書き、図解を置く位置に 【図解】DAY339_stage_judge.html と1行書きます。Studio ではこの行を見て手で差し替えていました。
新しいサイトでは、Markdown を HTML に変える段階(remark というライブラリの処理)に小さな変換を足しました。段落の中身がこの形の1行だけなら、画像は <figure><img> に、図解は隔離した枠に置き換えます。Markdown 側は何も変えなくてよい形です。
記事 5 本(LOG334・335・336・338・339)を、iCloud の作業フォルダにある Markdown をそのまま入れて作り、今のサイトの同じ記事と本文を 1 文字単位で比べました。違いは 3 種類ありました。
- LOG334・336・338:記事末尾の R2R2R の注記(h5 見出し)が、今のサイトにはない。Studio に貼るときに手で消していた
- LOG339:今のサイトに「python」「json」といった段落が 15 か所ある。コードの枠を貼るときに、言語名の行が普通の段落として残っていた
- LOG335:iCloud の Markdown のほうが新しい版で、今のサイトには
【画像】DAY335_01_watermark_frames.pngの行が文字のまま出ている
どれも Studio への貼り付けで起きていたことで、新しいサイトでは起きません。R2R2R の注記は、ルールを改めました。注記は「シリーズが R2R2R の記事にだけ入れる」と article_rules.md に書き、サイト側でも、記事のシリーズが R2R2R でなければ注記の見出しを出さないようにしました。今のサイトの記事を数えると、注記があるのは R2R2R シリーズの 185 本のうち 129 本と、それ以外のシリーズに散った 18 本で、ほとんどが R2R2R でした。
文字が太く見えた原因は、Mac で細く描く指定の有無だった
試作ページをスクリーンショットで見比べると、新しいサイトのコードの文字が太く濃く見えました。文字の大きさも太さの値も同じなのに、見え方が違います。
要素ごとに CSS の計算結果を読み直すと、今のサイトは記事ページの文字のある 622 要素のうち 613 要素に -webkit-font-smoothing: antialiased(Mac のブラウザで文字を細めに描く指定)が付いていて、新しいサイトには付いていませんでした。Mac では、この指定がないと同じ太さでも一段太く見えます。サイト全体に同じ指定を足しました。
同時に、h3 の左の縦線、太字の太さ(700 → 600)、文中のコードの枠(本文と同じ書体で 1px の枠付き)、箇条書きの行間(32px → 36px)、引用の罫線(3px の薄い灰色)も、読み取った値に合わせました。合わせたあとにもう一度、要素ごとの計算結果を今のサイトと突き合わせると、幅の 2〜4px の差(スクロールバーの分)を除いて一致しました。
試作サイトには、本人のメールでログインしたときだけ見られる鍵をかけた
仮の住所(p2m-site.pixelstomotors.workers.dev)は、URL を知っていれば誰でも開ける状態でした。中身は公開している記事と同じなので見られて困るものはありませんが、検索に載らないようにする指定だけでは、リンクが外へ出れば開けてしまいます。
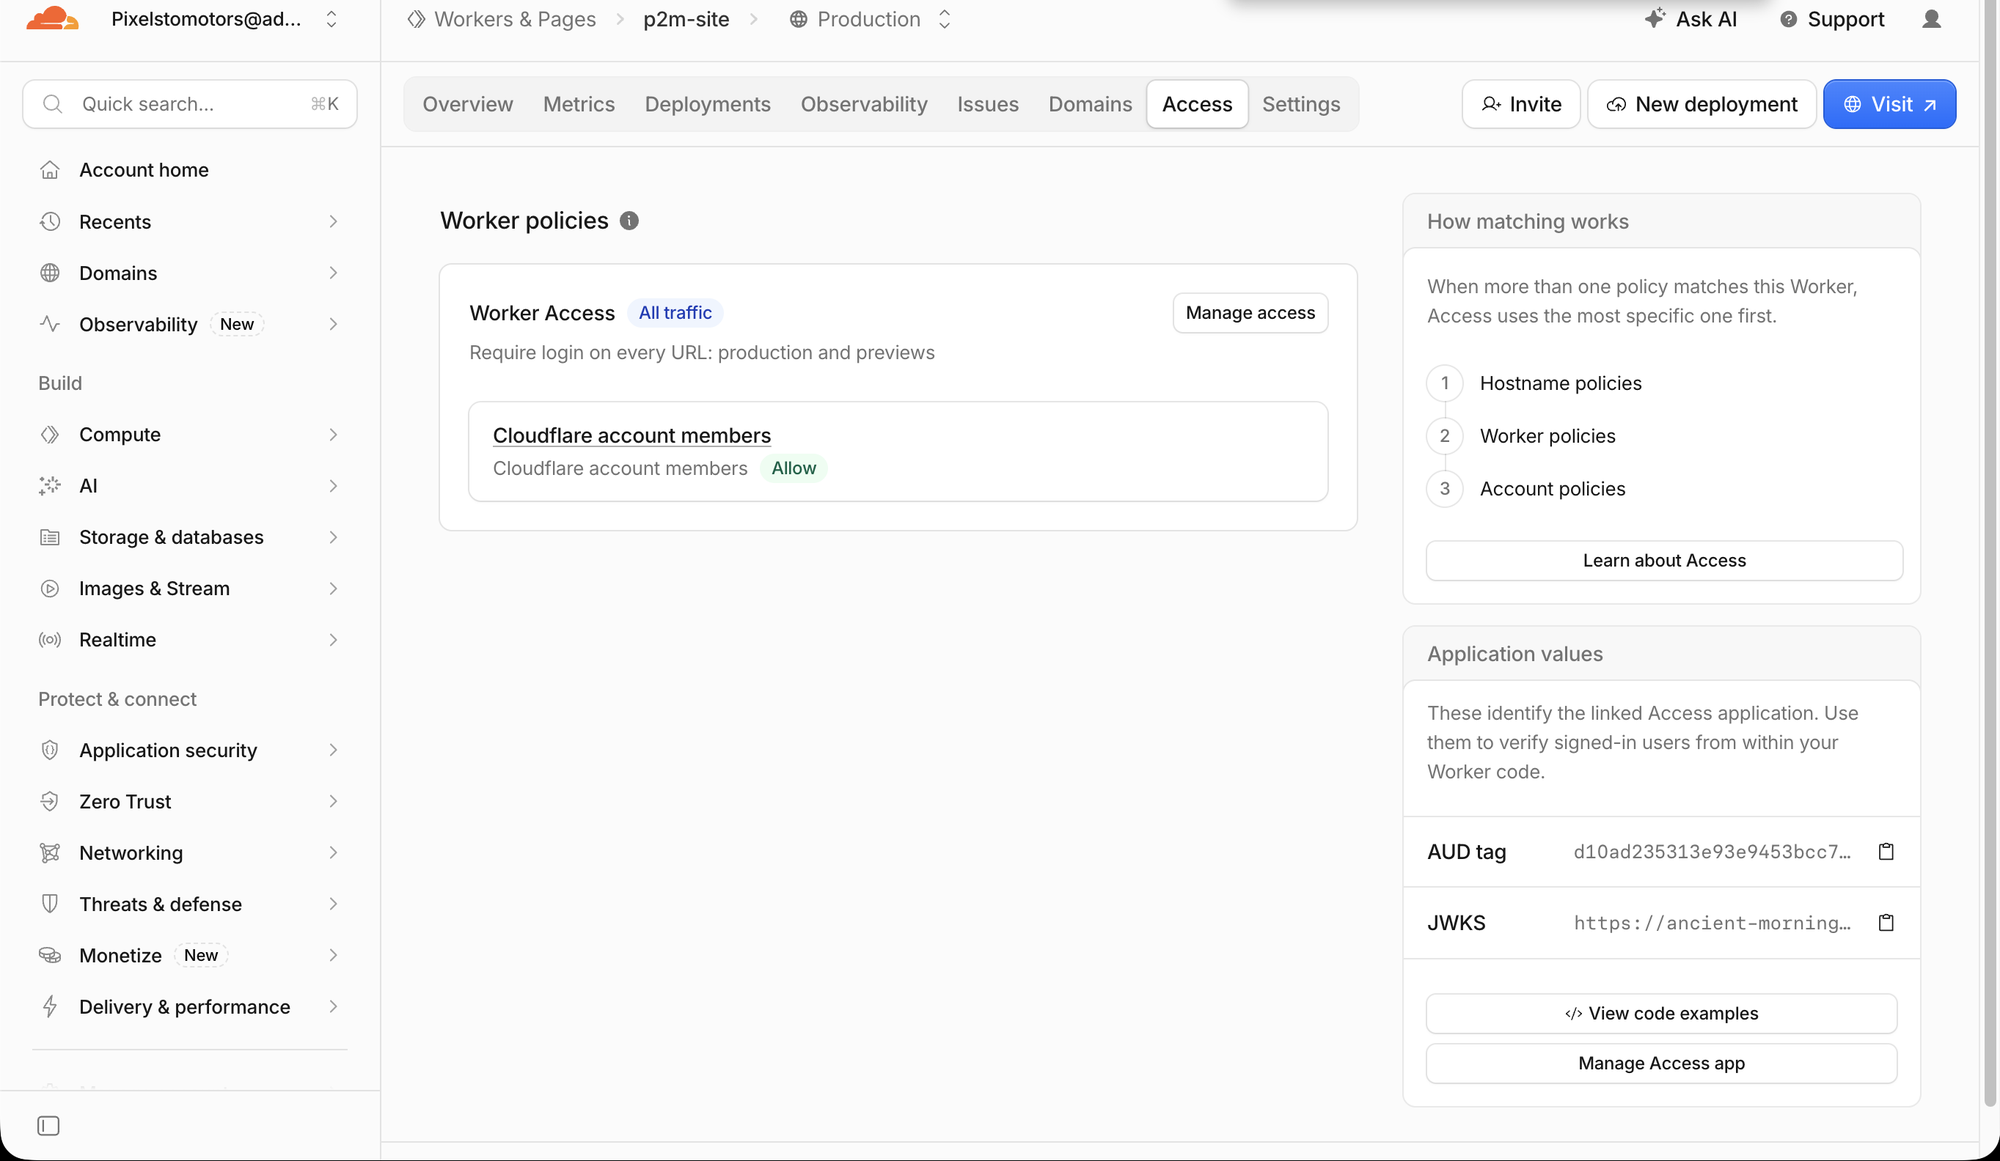
Cloudflare Access(Cloudflare の入口でログインを求める仕組み)を試作サイトに付けました。見られるのは、この Cloudflare アカウントのメンバー(pixelstomotors@adaptdesign.jp)だけです。外から開くと Cloudflare のログイン画面へ回され、ページは返りません。curl で確かめると、トップも記事も画像も 302(ログイン画面への転送)になりました。
/pixelstomotors 302
/media/s-1080x1350_v-fms_webp_72ffa290-8ff8-45cf-9bfb-d3b602843ce0.png 302
/api/message 302
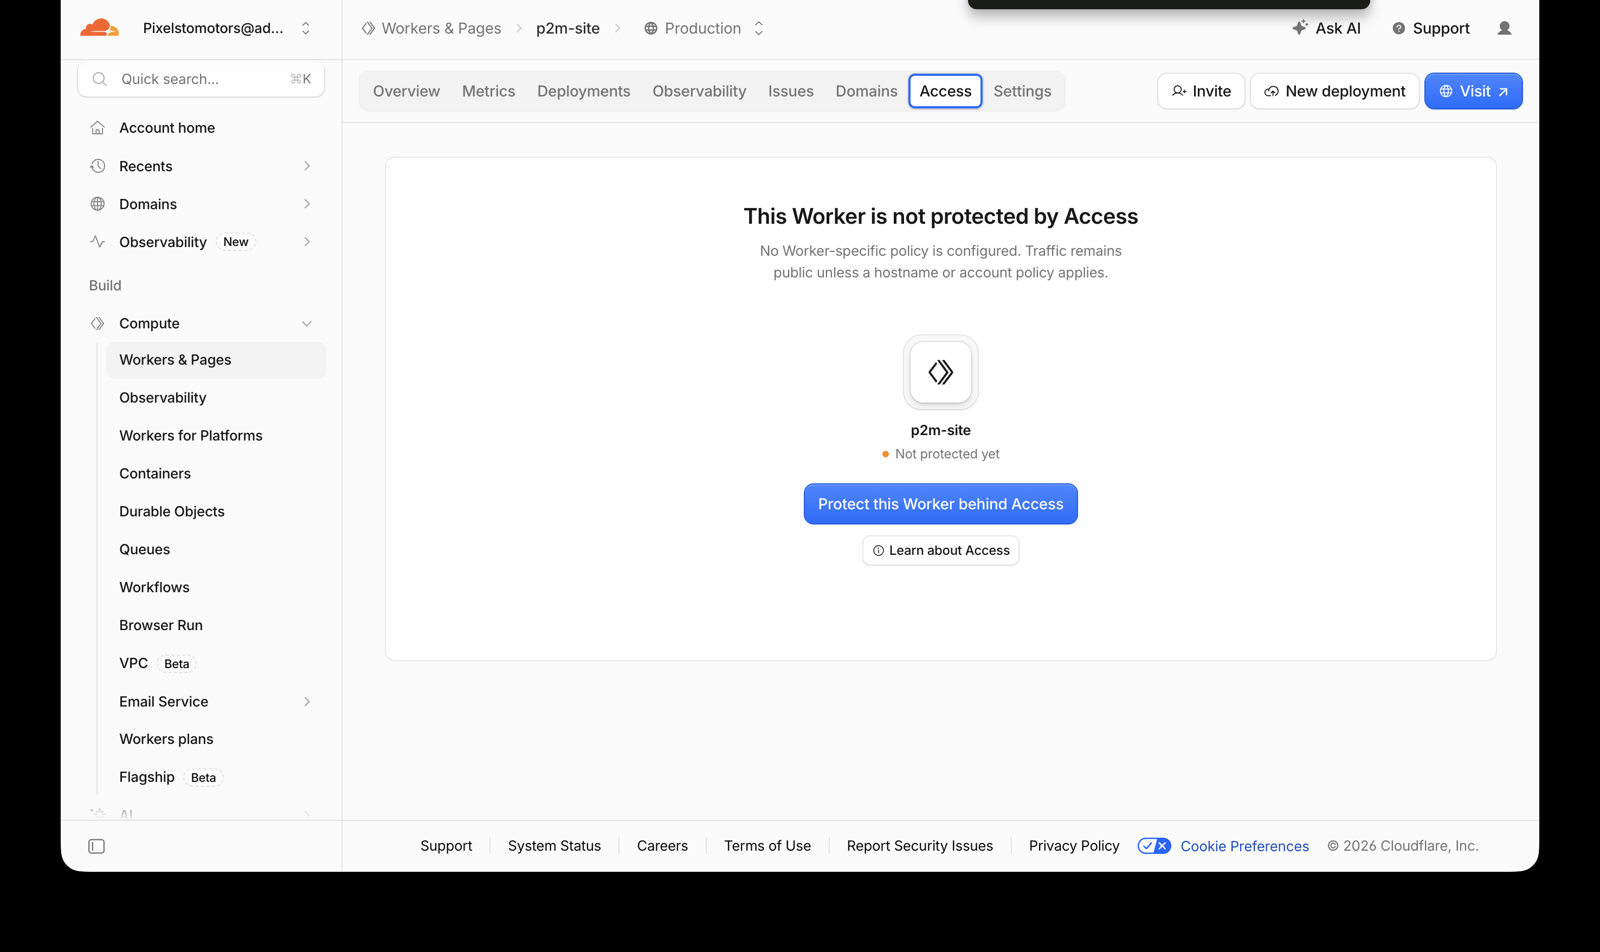
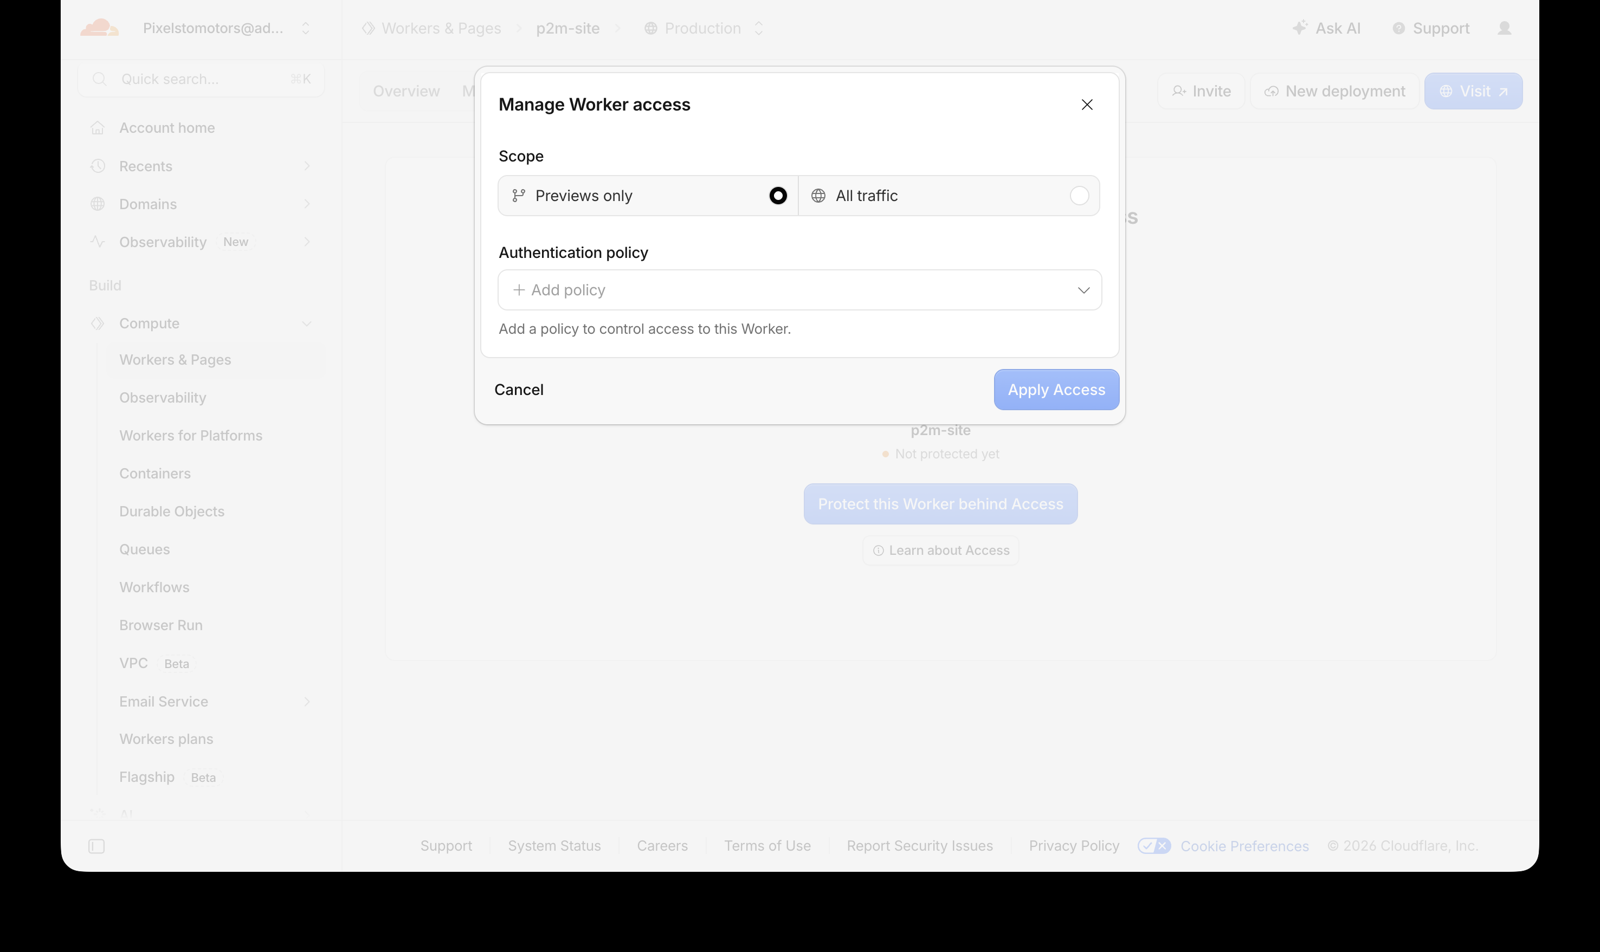
この仕組みを使うには Cloudflare Zero Trust の初回登録が必要で、無料プランでもカードの登録を求められます(請求は $0)。登録のあと、Workers の画面の「Access」から「Protect this Worker behind Access」を押し、範囲を「All traffic」、許可する人を「Cloudflare account members」にしました。
画像と動画 1,004 点は R2 に置き、サイトの /media/ から返す
記事に載せる画像は GitHub に入れない、というルール(MASTER の保存先テーブル)があります。試作では Cloudflare にドラッグ&ドロップで置いた仮の置き場を使っていましたが、フォルダの階層が勝手に外れて画像が 404 になるなど、手で置く場所としては不安定でした。
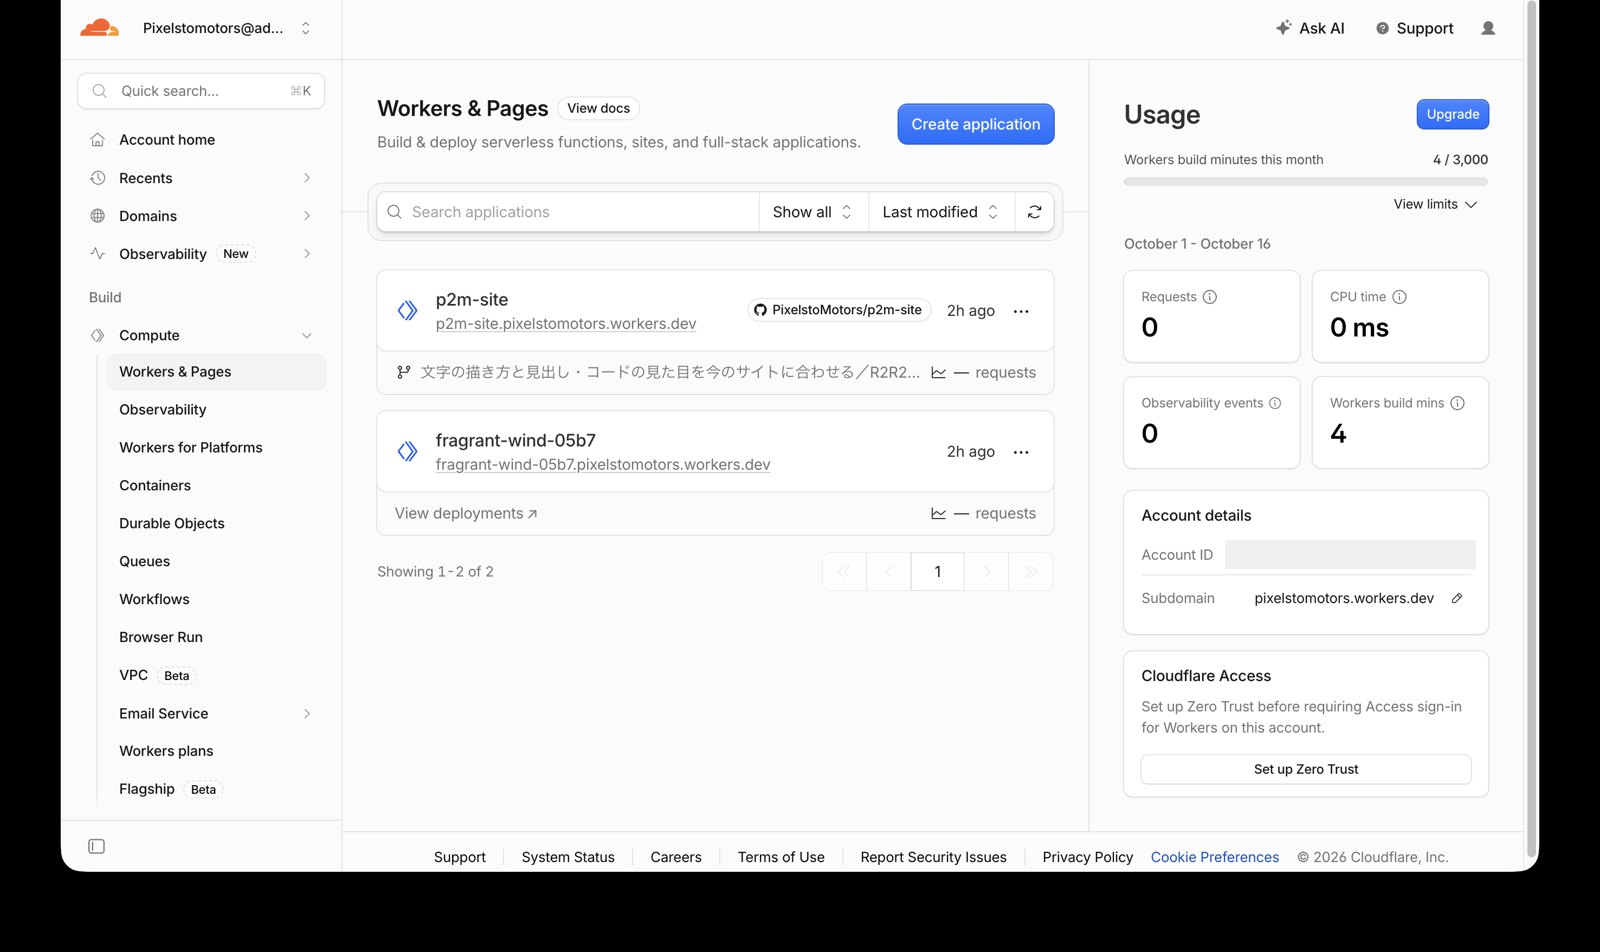
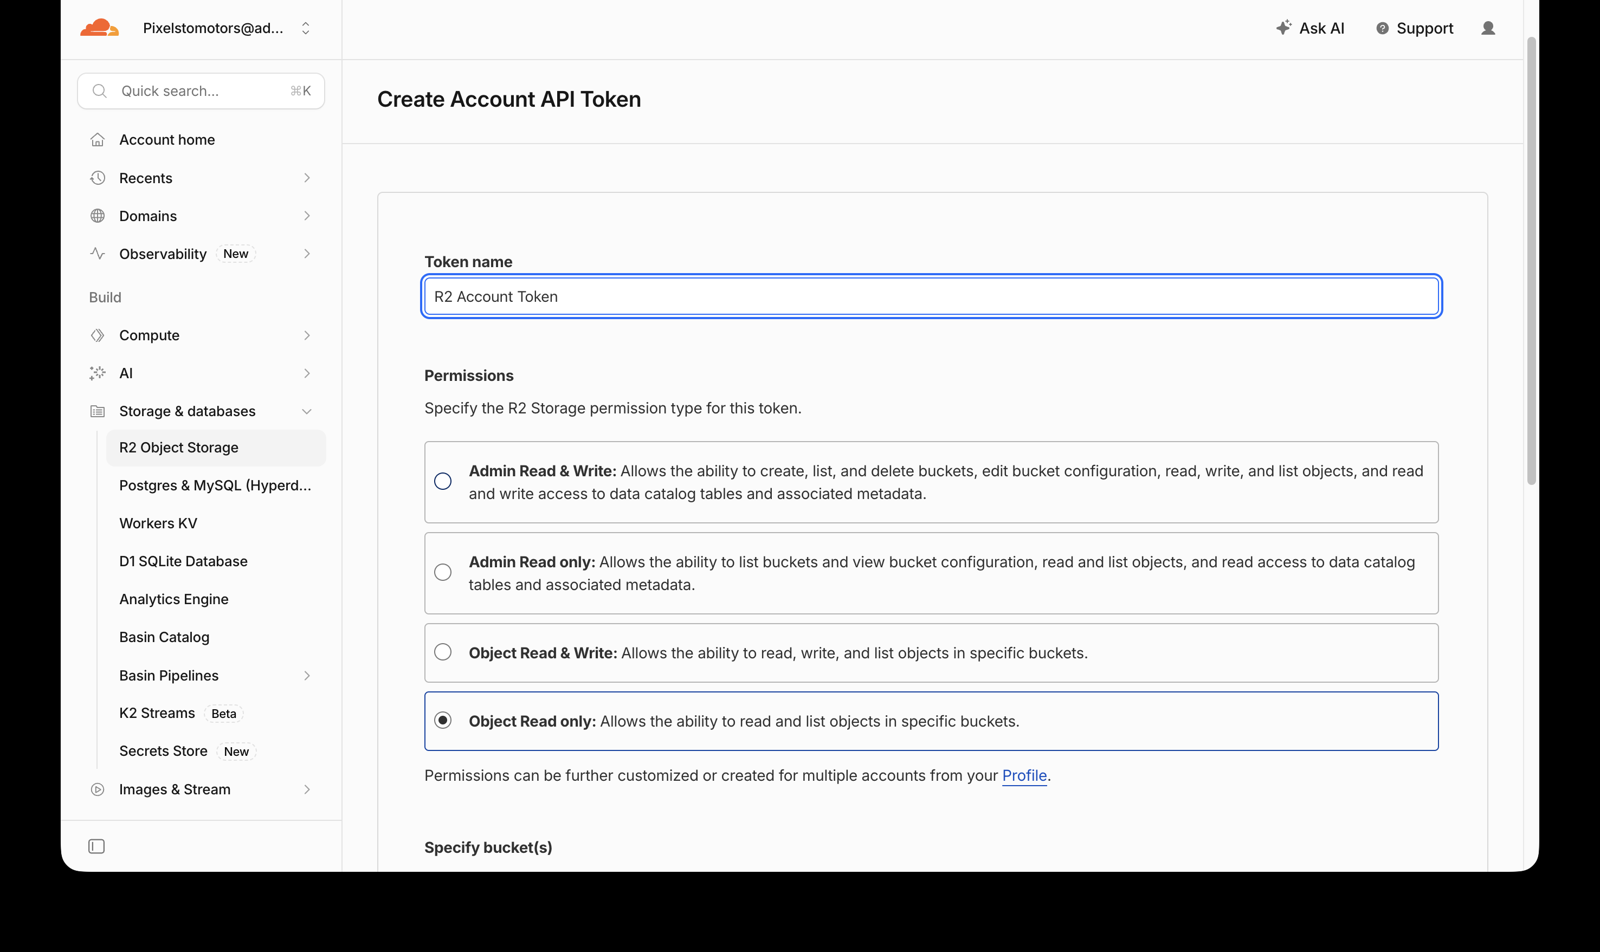
本番向けに、Cloudflare の R2(S3 互換の保管場所。無料枠は 10GB・月 1,000 万回の読み出し)にバケット p2m-media を作りました。画像を入れる鍵(API トークン)は Mac の外付け SSD(KIOXIA)に p2m_cloudflare_token.txt として置き、チャットにもリポジトリにも出しません。Mac で動かすスクリプト(upload_media.py)がこの鍵を読んで、フォルダの下の画像と動画をファイル名そのままで R2 に入れます。
まず前回のアーカイブ(site_archive/content)から 992 ファイル・414.0MB を入れました。8 本並列で 3 分かかりませんでした。次に、アーカイブより後に公開した記事 7 本の画像 37 ファイルを今のサイトから取り直し、新しい記事 5 本の画像 18 ファイルと合わせて 55 ファイル・28.7MB を入れました。
入れる 992・入っている 0・名前の重なり 0・合計 414.0MB
  850/988
  900/988
  950/988
  988/988
おわり
入れる 55・入っている 2・名前の重なり 0・合計 28.7MB
  50/55
  55/55
おわり
サイト側は、/media/ファイル名 への要求だけを小さな Worker(worker/index.js)が受け取り、R2 から返します。動画の途中から再生する要求(Range)にも答えます。それ以外の URL は作っておいた静的ファイルをそのまま返します。
できあがった全ページが参照する画像と動画の名前を集めると 1,004 件で、すべて R2 にあることを確かめました。「ない」と出た 2 件は、記事の本文に書かれた外部リンク(URL に /media/ を含むもの)で、サイトの画像ではありませんでした。
553 ページを、今のサイトの CMS データから取り直して作った
アーカイブは 10/12 時点のもので、記事が 7 本足りません。切替の直前にもう一度取り直す前提なので、今のサイトから直接データを取る道具(fetch_live.py)を作りました。
Studio の公開ページの HTML には、CMS の記事データ(タイトル・本文 HTML・公開日・シリーズなど)が __NUXT_DATA__ という JSON で丸ごと入っています。この JSON は値を配列の番号で参照する形(devalue 形式)になっているので、番号をたどって普通の値に戻し、その中から自分の slug を持つ記事を探します。サイトマップにある 553 件の URL のうち、記事 346・4コマ 99・英語版 95 の 540 ページをこれで取り、残り 13 の固定ページはアーカイブにあるデザイン構造(studio_design.json)から作りました。
取り直した本文を 10/12 のアーカイブと比べると、既存の 533 件は 1 文字も変わっておらず、増えていたのは記事 7 本だけでした。
取ったデータをサイトの形にする道具(import_all.py)は、次のことをします。
- Studio の画像の住所(storage.googleapis.com/…)を
/media/ファイル名に書き換える - 埋め込み HTML(URL エンコードされた状態で本文に入っている)を 1 件ずつファイルに戻し、高さを知らせるスクリプトを足して、隔離した枠で開く形にする。YouTube のブロックだけは youtube-nocookie の枠にする
- 自動目次のブロックを、h2 見出しから作った目次に置き換える
- 記事内のリンク先
https://adaptdesign.jp/pixelstomotors/...を、サイト内の相対の住所に直す。本文の文字として書かれた URL は変えない - Studio が付ける作業用の属性(data-uid・data-time)を外す
- 動くサムネイル(記事ごとの HTML)を切り出す
シリーズのページ(series1〜7)は、Studio のデザイン構造から「見出し・Figma の枠・Google スプレッドシートの枠・画像」の並びと、それぞれの枠の高さ(800px・1280px・640px など)を読み取って再現しました。一覧の絞り込み条件(シリーズ名で記事を選ぶ・12 件ずつ・新しい順)も同じ構造から読んでいます。「Load more」で 12 件ずつ増える動きも同じにしました。
最初に取り込んだとき、リンクの書き換えが本文の文字にまで及んでいました。YouTube の説明文をコードの枠に貼った記事(first-video-end-to-end)で、https://adaptdesign.jp という文字が 4 か所消えていました。書き換えを href="..." の中だけに限って直しました。
ビルドすると 555 ページ(サイトマップの 553 + 404 ページ + トップへの転送)が 5.2 秒でできます。
15:22:42 [build] 555 page(s) built in 5.20s
15:22:42 [build] Complete!
本文・画像・図解の数を、今のサイトの全ページと照合した
できたページが今のサイトと同じかを、目ではなく機械で確かめました。
本文。 今のサイトの CMS データの本文 HTML と、新しいページの本文部分の HTML から、タグを外して文字だけにし、空白を全部取って比べました。記事 341 本(Markdown から作った 5 本を除く)・4コマ 99 話・英語版 95 話の 535 ページで、不一致は 0 です。
本文不一致 0 []
タイトル・説明の不一致 0 []
画像・動画・図解・YouTube の数。 記事ごとに、CMS の本文にある <img>・<video>・埋め込み・YouTube の数と、新しいページにある数を比べました。合計は画像 304・動画 4・図解 299・YouTube 3 で、不一致は 0 です。
{'img': 304, 'video': 4, 'embed': 299, 'yt': 3} 不一致 []
media refs 1004
サイトマップ。 今のサイトのサイトマップにある 553 件の URL が、すべて新しいサイトに同じ住所で存在します。
553 missing 0 []
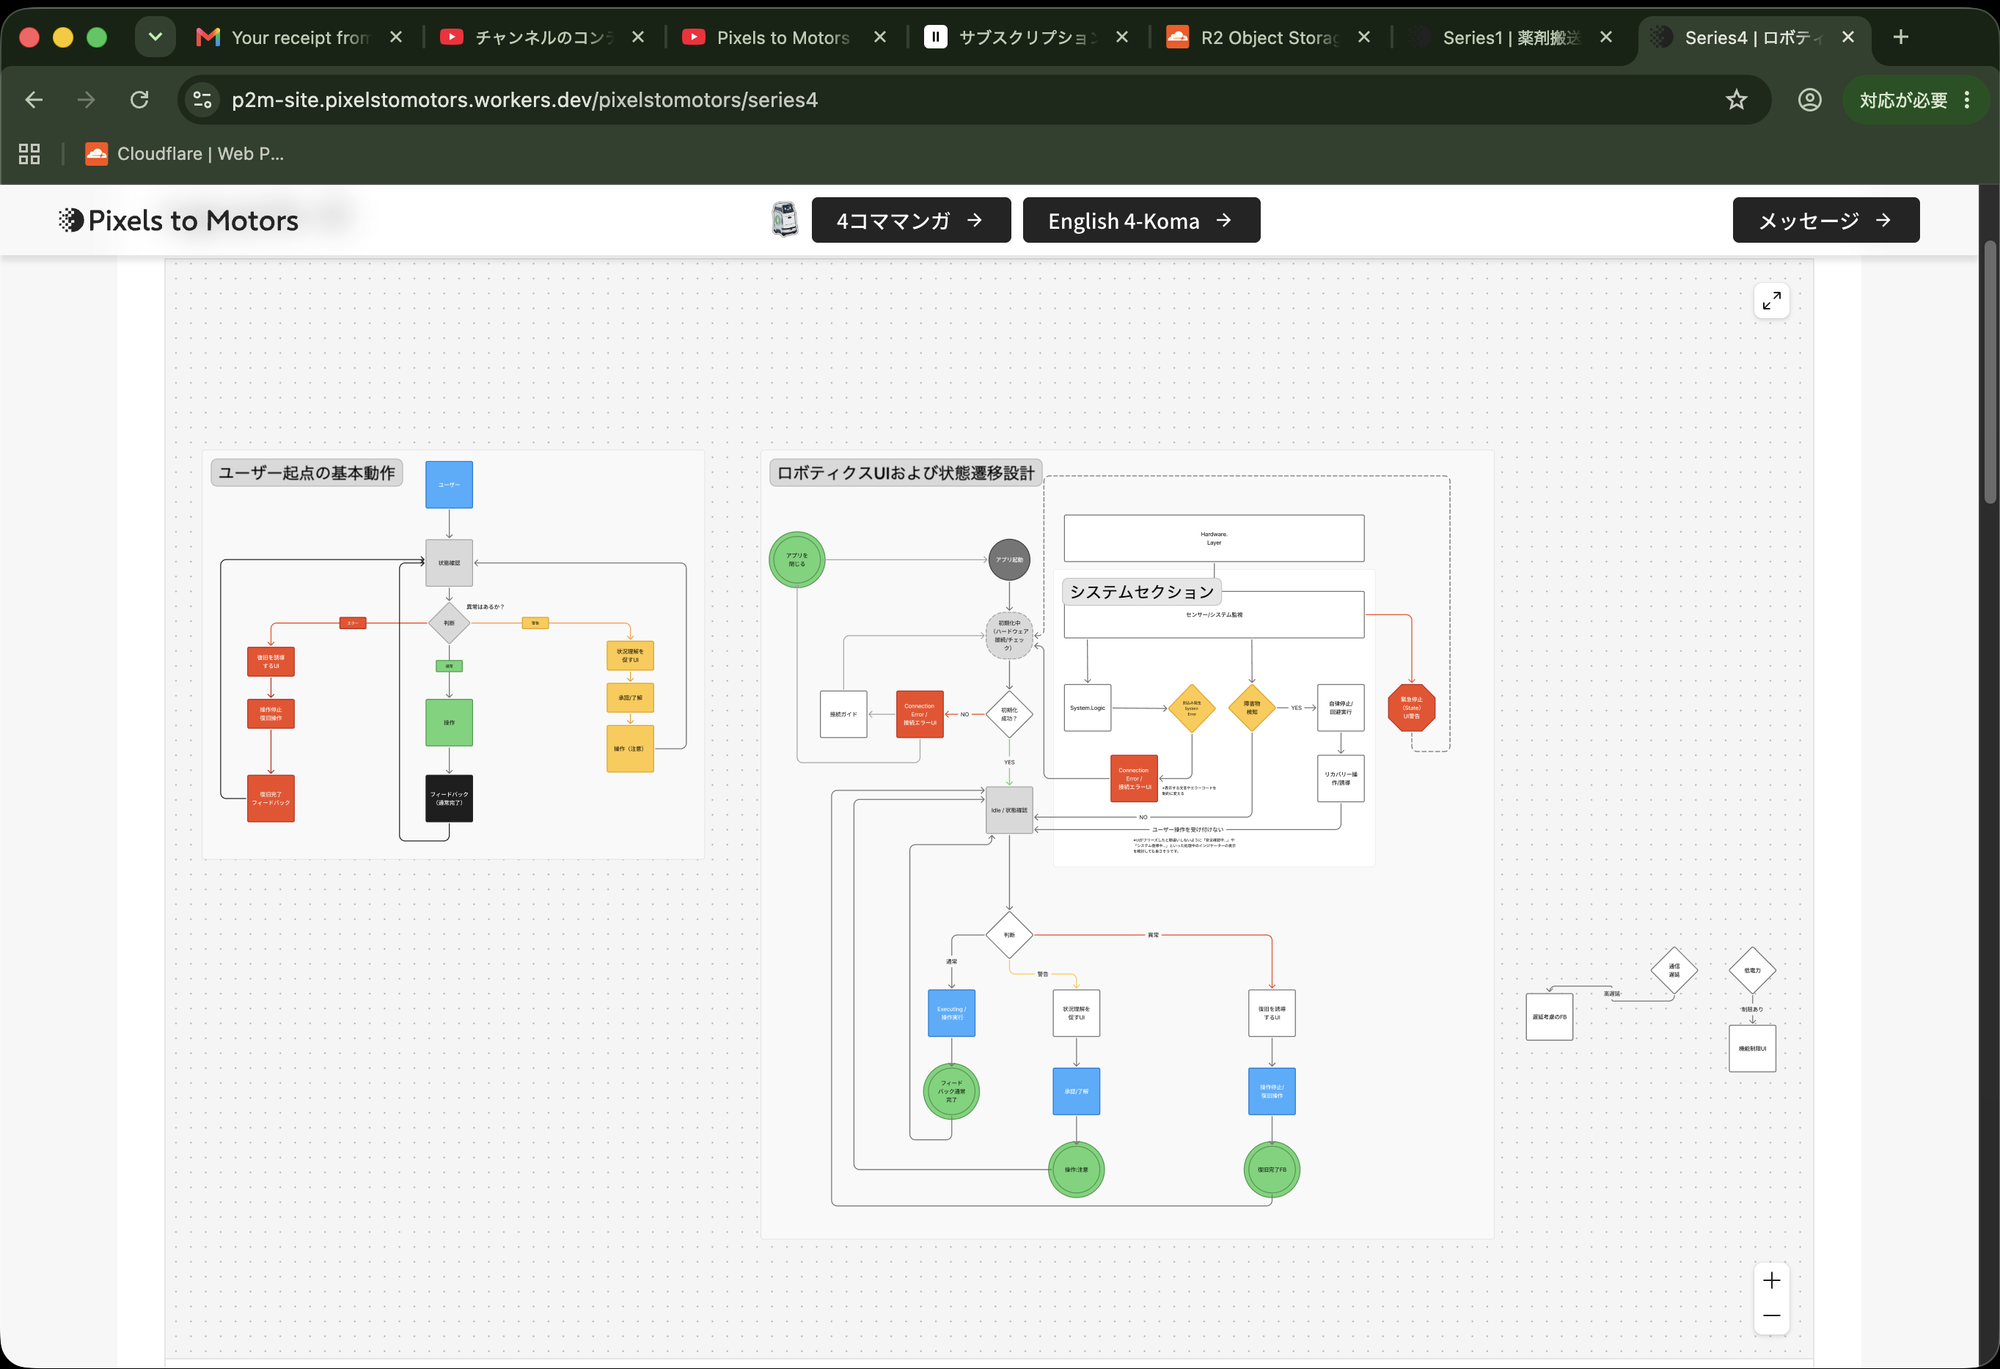
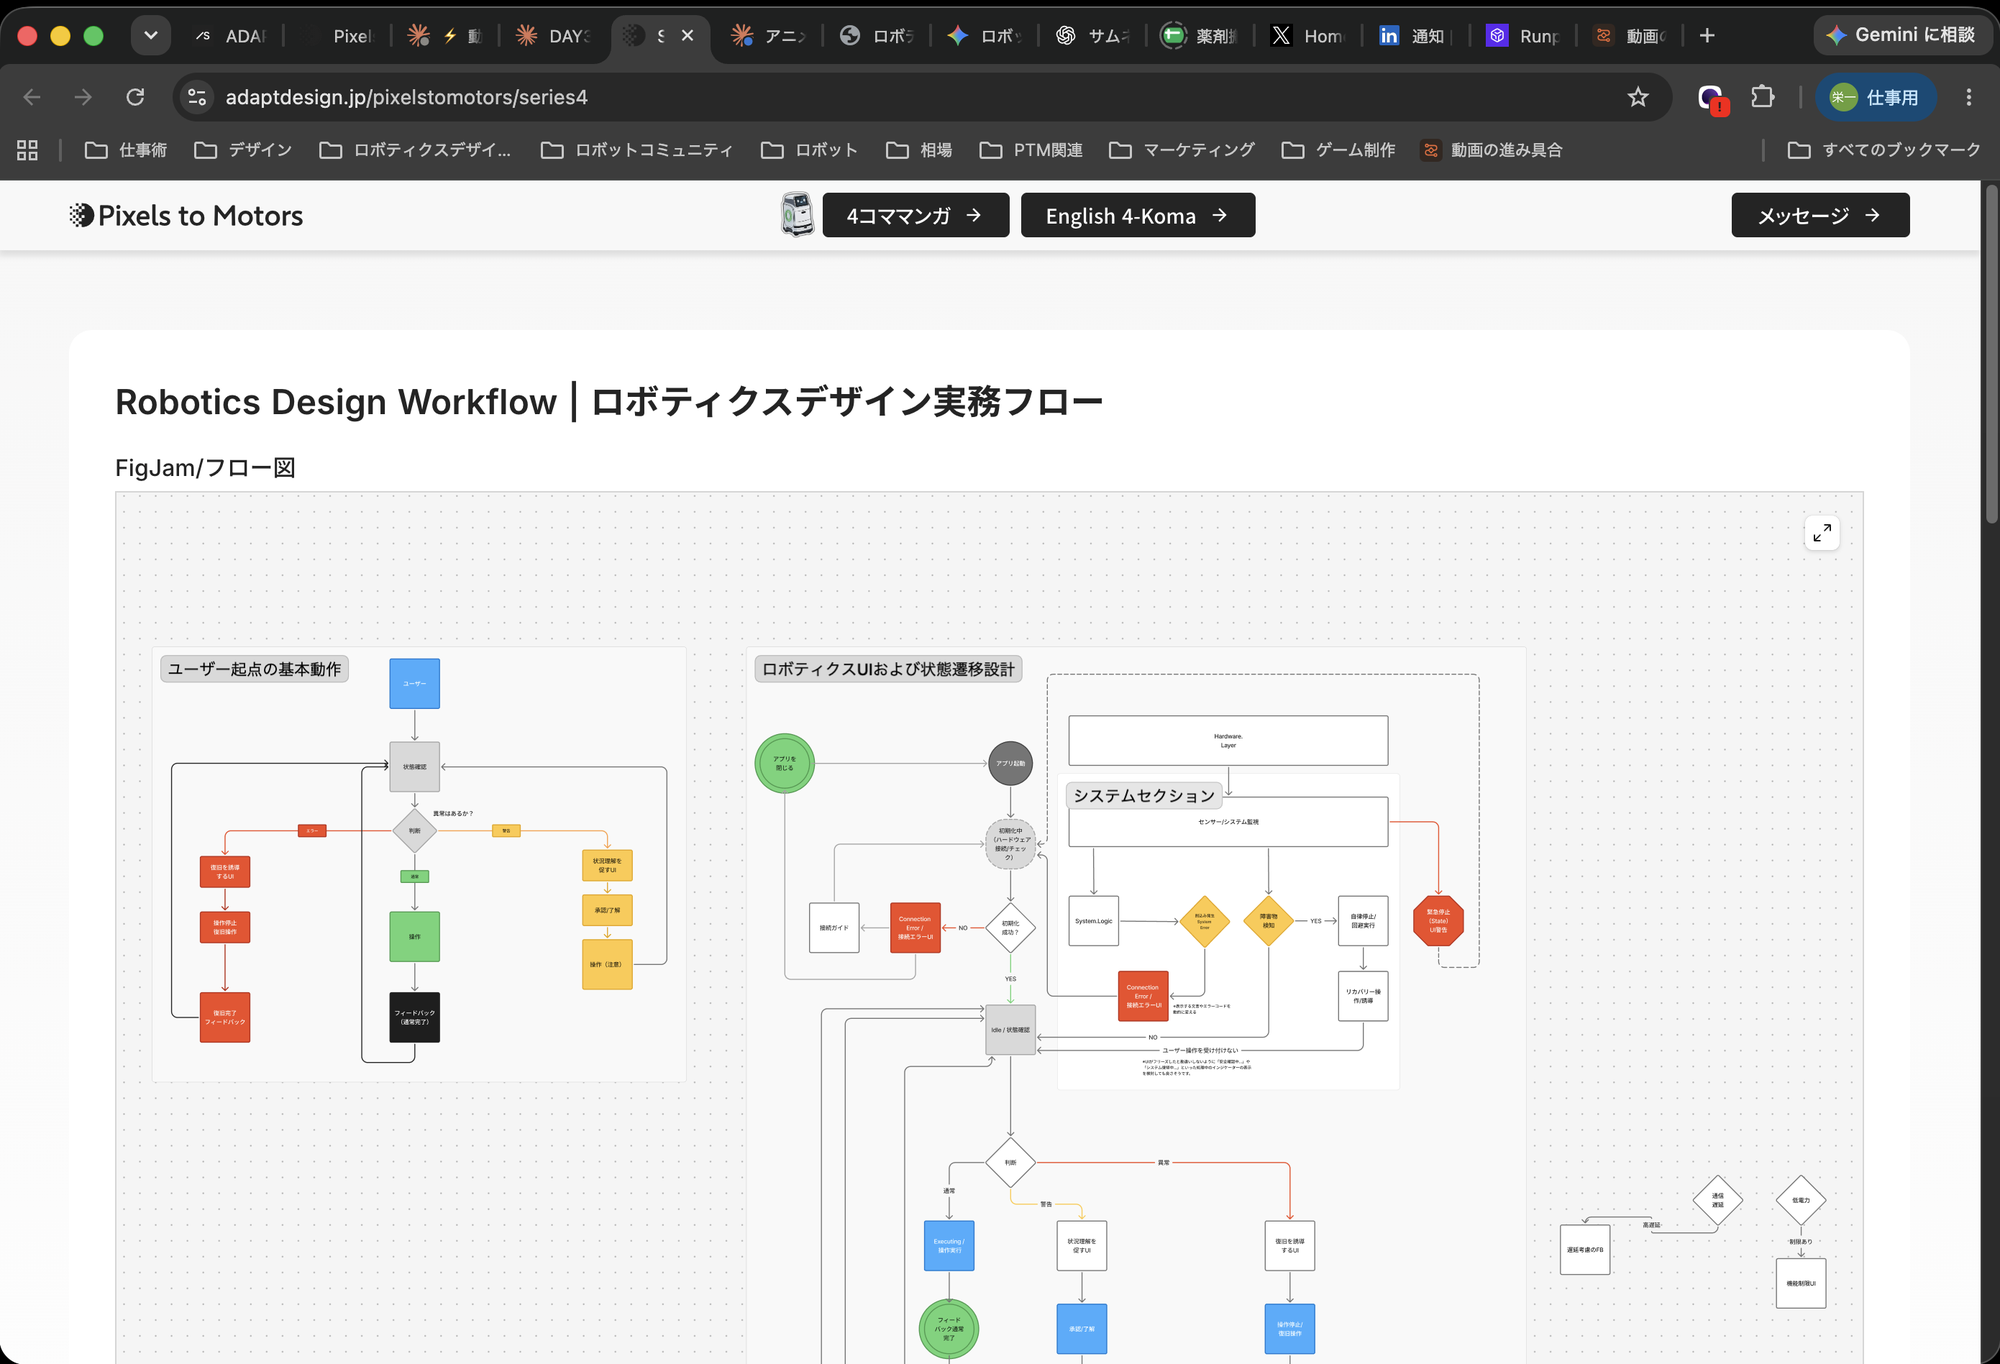
そのうえで、鍵をかけた試作サイトにログインして、シリーズ1(Figma とスプレッドシートの枠)・4コマの一覧(表紙の画像)・記事 day60(本文の画像)を目で見てもらい、表示されることを確かめました。シリーズ4の FigJam の枠は、Claude の自動操作のブラウザでは今のサイトでも 403 が出ていましたが、本人のブラウザでは今のサイトでも新しいサイトでも表示されました。Figma が自動操作のブラウザを弾いていただけでした。
メッセージフォームは、送信内容を R2 に保存する形で作り直した
Studio のフォーム(お名前・メールアドレス・ご相談内容・プライバシーポリシーへの同意)は Studio の仕組みで送られていたので、そのままは移せません。同じ見た目のフォームを作り、送信は /api/message へ JSON で送って、Worker が R2 のバケット p2m-messages に 1 件 1 ファイルで保存します。名前・メール・本文が空のときと、メールの形でないとき、同意のチェックがないときは受け付けません。
Studio にあった「送信されたらメールで知らせる」はまだありません。必要になったら足します。
ドメインの自動更新は ON で、10月30日に更新される
ドメイン adaptdesign.jp は 2026 年 11 月 30 日が期限で、自動更新が有効かを確かめていませんでした。JPRS の登録情報では、去年は期限の翌日(2025/12/01)に更新されていて、自動更新が効いていそうでしたが、管理画面で確かめました。
登録先は Squarespace(Google Domains の移管先)で、自動更新は ON、次の更新は 2026 年 10 月 30 日・¥4,600 でした。期限より 1 か月早く更新されます。
JPRS の公開情報には、登録者の住所・電話番号・メールが載っています。.jp ドメインではよくある状態ですが、気になる場合は公開をやめる手続きを調べます。
できたものと、残っていること
できたもの。
- GitHub(PixelstoMotors/p2m-site)の main に push すると、約 40 秒で公開される Astro + Cloudflare Workers のサイト
- 今のサイトの全 553 ページ(記事 346・4コマ 99・英語版 95・固定ページ 13)が、同じ URL で入っている
- 画像と動画 1,047 点を R2(p2m-media)に置き、サイトの
/media/から返す - Markdown の
【画像】・【図解】の行がそのまま画像と図解になる - R2R2R の注記は、シリーズが R2R2R の記事にだけ出る
- 試作サイトには本人だけが見られる鍵(Cloudflare Access)
- メッセージフォームの送信は R2(p2m-messages)に溜まる
- 記事を 1 本足す道具(add_article.py)と、画像を R2 へ入れる道具(upload_media.py)
残っていること。
- 新しいドメインを決めて、取得から転送の設定まで。DNSSEC の DS を先に外す手順と、Studio の旧 IP には戻れない前提の復旧表は、codex の報告に沿って作る
- Studio に登録してある転送 28 件のうち、404 になっている 22 件をどうするか(残す・同等の記事へ送る・404 にする)を 1 件ずつ決める
- メッセージフォームのメール通知
- 記事制作ルール(article_rules.md)の必須出力セットに、新しいサイトへの反映(add_article.py・upload_media.py)を書き足す。MASTER の保存先テーブルに R2 の行を足す
- Studio の解約。切り替えて安定するまでは残す
使ったコードの全文
リポジトリは GitHub の PixelstoMotors/p2m-site(非公開)です。ここに載せるのは、この日に書いたか直したファイルの全文です。
tools/fetch_live.py — 今のサイトから CMS データを取り直す
"""今の Studio サイトから、記事・4コマ・英語版4コマの CMS データを取り直す。

site_archive(2026-10-12 時点)以降の追加・修正も拾うため、公開ページに埋め込まれた
CMS データ(__NUXT_DATA__)をそのまま読む。

使い方: python3 fetch_live.py <出力フォルダ>
出力:  <出力フォルダ>/{record,manga,english}/{slug}.json  ({"url":..., "item": {...}})
"""
import json
import re
import sys
import urllib.request
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

OUT = Path(sys.argv[1])
SITE = 'https://adaptdesign.jp'
MAPS = {
    'record': '/sitemap-dynamic/sitemap-dynamic-cGl4ZWxzdG9tb3RvcnMvcmVjb3JkLzpzbHVn.xml',
    'manga': '/sitemap-dynamic/sitemap-dynamic-cGl4ZWxzdG9tb3RvcnMvbWFuZ2EvOnNsdWc.xml',
    'english': '/sitemap-dynamic/sitemap-dynamic-cGl4ZWxzdG9tb3RvcnMvZW5nbGlzaC00LWtvbWEvOnNsdWc.xml',
}
WRAP = {'Reactive', 'ShallowReactive', 'Ref', 'ShallowRef'}


def get(url):
    req = urllib.request.Request(url, headers={'User-Agent': 'p2m-migration'})
    with urllib.request.urlopen(req, timeout=60) as r:
        return r.read().decode('utf-8')


def decode(a):
    """Nuxt の payload(devalue 形式)を普通の値に戻す"""
    sys.setrecursionlimit(100000)
    memo = {}

    def d(i):
        if i in memo:
            return memo[i]
        v = a[i]
        if isinstance(v, list):
            if v and isinstance(v[0], str) and v[0] in WRAP:
                memo[i] = d(v[1]); return memo[i]
            if v and isinstance(v[0], str) and v[0] == 'Date':
                memo[i] = v[1]; return v[1]
            if v and isinstance(v[0], str) and v[0] in ('Set', 'Map', 'EmptyRef', 'EmptyShallowRef', 'Error', 'RegExp', 'NuxtError', 'Island'):
                memo[i] = None; return None
            out = []; memo[i] = out
            out.extend(d(x) if isinstance(x, int) else x for x in v)
            return out
        if isinstance(v, dict):
            out = {}; memo[i] = out
            for k, x in v.items():
                out[k] = d(x) if isinstance(x, int) else x
            return out
        return v
    return d(0)


def find(o, slug):
    if isinstance(o, dict):
        if o.get('slug') == slug and 'body' in o and 'title' in o:
            return o
        o = list(o.values())
    if isinstance(o, list):
        for v in o:
            r = find(v, slug)
            if r:
                return r
    return None


def one(kind, url):
    slug = url.rstrip('/').split('/')[-1]
    h = get(url)
    m = re.search(r'<script[^>]*id="__NUXT_DATA__"[^>]*>(.*?)</script>', h, re.S)
    it = find(decode(json.loads(m.group(1))), slug) if m else None
    if not it:
        return kind, slug, False
    (OUT / kind).mkdir(parents=True, exist_ok=True)
    (OUT / kind / f'{slug}.json').write_text(json.dumps({'url': url, 'item': it}, ensure_ascii=False), encoding='utf-8')
    return kind, slug, True


def main():
    jobs = []
    for kind, path in MAPS.items():
        for u in re.findall(r'<loc>([^<]+)</loc>', get(SITE + path)):
            jobs.append((kind, u))
    print('ページ', len(jobs), flush=True)
    bad = []
    with ThreadPoolExecutor(6) as ex:
        for i, (kind, slug, ok) in enumerate(ex.map(lambda j: one(*j), jobs), 1):
            if not ok:
                bad.append((kind, slug))
            if i % 100 == 0:
                print(' ', i, flush=True)
    print('取れなかった', bad, flush=True)


if __name__ == '__main__':
    main()
tools/import_all.py — CMS データと固定ページからサイトのデータを作る
"""Studio の CMS データ(fetch_live.py で取り直したもの)と site_archive の固定ページから、
新しいサイトのデータと素材を作る。

使い方:
  python3 import_all.py <cmsフォルダ> <site_archive の content/static> <サイトのフォルダ>

出力:
  src/data/records/{slug}.json   記事(Studio から移したもの。Markdown で書いた記事は除く)
  src/data/cards.json            記事の一覧用(全記事)
  src/data/manga/{slug}.json     4コマ(日本語)
  src/data/english/{slug}.json   4コマ(英語版)
  src/data/mangaCards.json / englishCards.json  一覧用
  src/data/static.json           固定ページ(シリーズのページ・プライバシーポリシーなど)
  public/embeds/                 図解などの埋め込み(隔離した枠で開く)
  public/thumbs/                 動くサムネイル

画像と動画は R2(/media/ファイル名)に置く。ここではファイル名だけを書き換える。
"""
import html
import json
import re
import shutil
import sys
import urllib.parse
from pathlib import Path

CMS = Path(sys.argv[1])
STATIC = Path(sys.argv[2])
SITE = Path(sys.argv[3])
DATA = SITE / 'src' / 'data'
PUB = SITE / 'public'

STUDIO_MEDIA = re.compile(r'https://storage\.googleapis\.com/studio-(?:design-asset-files|cms-assets)/projects/[^/]+/([A-Za-z0-9_.\-]+)')
# リンク先だけをサイト内の住所に直す(本文に書かれた URL の文字はそのまま)
SITE_LINK = re.compile(r'href="https?://adaptdesign\.jp(/pixelstomotors[^"]*)"')

# 図解の中から、自分の高さを親ページに知らせる小さな仕組み(隔離した枠の中では高さだけを送る)
HEIGHT_REPORTER = """<script>(function(){var last=0;
function measure(){var b=document.body;if(!b)return 0;var cs=getComputedStyle(b);var bottom=0;
for(var i=0;i<b.children.length;i++){var el=b.children[i];var s=getComputedStyle(el);if(s.position==='fixed'||s.display==='none'||el.tagName==='SCRIPT'||el.tagName==='STYLE')continue;
var r=el.getBoundingClientRect();var mb=parseFloat(s.marginBottom)||0;if(r.bottom+mb>bottom)bottom=r.bottom+mb;}
return Math.ceil(bottom+window.scrollY+(parseFloat(cs.paddingBottom)||0)+(parseFloat(cs.marginBottom)||0));}
function send(){var h=measure();if(h>0&&Math.abs(h-last)>1){last=h;parent.postMessage({p2mHeight:h},'*');}}
window.addEventListener('load',send);window.addEventListener('resize',send);
if(window.ResizeObserver&&document.body){new ResizeObserver(send).observe(document.body);}setInterval(send,1000);send();})();</script>"""


def media(s):
    """Studio の画像・動画の住所を、新しいサイトの /media/ に置き換える"""
    return STUDIO_MEDIA.sub(lambda m: '/media/' + m.group(1), s)


def links(s):
    return SITE_LINK.sub(lambda m: 'href="' + m.group(1) + '"', s)


def with_reporter(doc):
    if '</body>' in doc:
        return doc.replace('</body>', HEIGHT_REPORTER + '</body>', 1)
    return doc + HEIGHT_REPORTER


def clean_attrs(s):
    s = re.sub(r'\s(?:data-uid|data-time|data-thread|data-margin-left|data-margin-right)="[^"]*"', '', s)
    s = re.sub(r'\sstyle=""', '', s)
    s = re.sub(r'\s(?:width|height|poster)=""', '', s)
    return s


def sandbox_for(code):
    # 中に外部の iframe(YouTube・Google ドキュメントなど)があるときは、その iframe が動けるよう同じ扱いにする
    if re.search(r'<iframe[^>]+src="https?://', code):
        return 'allow-scripts allow-same-origin allow-popups allow-popups-to-escape-sandbox allow-presentation'
    return 'allow-scripts allow-popups allow-popups-to-escape-sandbox'


def write_embed(name, code):
    (PUB / 'embeds' / name).write_text(with_reporter(code), encoding='utf-8')
    return (f'<div class="embed"><iframe src="/embeds/{name}" sandbox="{sandbox_for(code)}" '
            f'loading="lazy" title="図解" data-embed allowfullscreen></iframe></div>')


def youtube(vid):
    return (f'<div class="yt"><iframe src="https://www.youtube-nocookie.com/embed/{vid}" title="YouTube" loading="lazy" '
            'allowfullscreen allow="accelerometer; encrypted-media; gyroscope; picture-in-picture"></iframe></div>')


def convert_body(body, slug):
    def embed(m):
        attrs, inner = m.group(1), m.group(2)
        uid = re.search(r'data-uid="([^"]+)"', attrs).group(1)
        kind = re.search(r'data-embed-code-type="([^"]+)"', attrs)
        code = urllib.parse.unquote(inner.strip())
        if not code.strip():
            return ''  # 中身が空の埋め込み(Studio でも空の枠だった)
        if kind and kind.group(1) == 'youtube':
            vid = re.search(r'(?:youtu\.be/|v=|embed/)([\w-]{11})', code)
            if vid:
                return youtube(vid.group(1))
        return write_embed(f'{slug}-{uid}.html', media(code))

    body = re.sub(r'<div data-type="embed_code"([^>]*)>(.*?)</div>', embed, body, flags=re.S)
    # 動画(mp4)
    body = re.sub(r'<div data-type="video_block"[^>]*>(<video[^>]*>)</video></div>',
                  lambda m: '<div class="video">' + re.sub(r'\scontrols(="")?', '', m.group(1)).replace('<video', '<video controls playsinline preload="metadata"') + '</video></div>',
                  body)
    body = media(links(body))
    heads = re.findall(r'<h2[^>]*id="([^"]+)"[^>]*>(.*?)</h2>', body, flags=re.S)
    toc = [{'id': i, 'text': html.unescape(re.sub(r'<[^>]+>', '', t))} for i, t in heads if re.sub(r'<[^>]+>', '', t).strip()]
    has_toc = 'data-type="table_of_contents"' in body
    body = re.sub(r'<div data-type="table_of_contents"[^>]*></div>', '<!--TOC-->', body)
    body = re.sub(r'<div data-type="table"[^>]*>', '<div class="table">', body)
    body = re.sub(r'<video([^>]*)\sdata-natural-width="\d+"\sdata-natural-height="\d+"', r'<video\1', body)
    return clean_attrs(body), (toc if has_toc else [])


def ref(v):
    return v if isinstance(v, dict) else {}


def load(kind):
    out = []
    for f in sorted((CMS / kind).glob('*.json')):
        out.append(json.loads(f.read_text(encoding='utf-8'))['item'])
    return out


def main():
    for d in ('records', 'manga', 'english'):
        p = DATA / d
        if p.exists():
            shutil.rmtree(p)
        p.mkdir(parents=True)
    for d in ('embeds', 'thumbs'):
        (PUB / d).mkdir(parents=True, exist_ok=True)

    md_slugs = set()
    for f in (SITE / 'src' / 'content' / 'records').glob('*.md'):
        m = re.search(r'^slug:\s*"?([^"\n]+)"?\s*$', f.read_text(encoding='utf-8'), re.M)
        if m:
            md_slugs.add(m.group(1).strip())

    # 記事
    cards = []
    for it in load('record'):
        slug = it['slug']
        thumb = None
        q = ref(it.get('Qi0bIZEy'))
        if q.get('title'):
            thumb = f'/thumbs/r-{slug}.html'
            (PUB / 'thumbs' / f'r-{slug}.html').write_text(media(q['title']), encoding='utf-8')
        cover = media(it['cover']) if it.get('cover') else None
        card = {'day': it.get('bPskK658') or '', 'series': ref(it.get('HOUwyFeo')).get('title', ''),
                'published': it['_meta']['publishedAt'], 'title': it['title'], 'slug': slug,
                'cover': cover, 'thumb': thumb}
        if slug in md_slugs:
            continue  # Markdown で書いた記事は、Markdown の方を使う(一覧には Markdown 側から入る)
        cards.append(card)
        body, toc = convert_body(it['body'], slug)
        rec = dict(card, lang=ref(it.get('O7HA0yM1')).get('title', ''), description=it.get('WtD0MT_q') or '',
                   updated=it['_meta'].get('updatedAt'), body=body, toc=toc)
        (DATA / 'records' / f'{slug}.json').write_text(json.dumps(rec, ensure_ascii=False), encoding='utf-8')
    (DATA / 'cards.json').write_text(json.dumps(cards, ensure_ascii=False, indent=0), encoding='utf-8')

    # 4コマ(日本語・英語版)
    for kind, listname in (('manga', 'mangaCards'), ('english', 'englishCards')):
        lst = []
        for it in load(kind):
            m = {'slug': it['slug'], 'title': it['title'], 'label': it.get('XLiEhio_') or '',
                 'character': ref(it.get('jy4DazWj')).get('title', ''), 'description': it.get('LRhqVKVx') or '',
                 'published': it['_meta']['publishedAt'], 'cover': media(it.get('cover') or ''),
                 'comic': media(it.get('UeFRSlTz') or ''), 'cover_alt': it.get('JZ09W1er') or '',
                 'comic_alt': it.get('j670Jo5w') or ''}
            body = clean_attrs(media(links(it.get('body') or '')))
            (DATA / kind / f"{it['slug']}.json").write_text(json.dumps(dict(m, body=body), ensure_ascii=False), encoding='utf-8')
            lst.append(m)
        lst.sort(key=lambda x: x['published'], reverse=True)
        (DATA / f'{listname}.json').write_text(json.dumps(lst, ensure_ascii=False, indent=0), encoding='utf-8')

    # 固定ページ(シリーズのページの中身)
    static = {}
    for p in sorted(STATIC.glob('series*')):
        if p.name.endswith(' 2'):
            continue
        d = json.loads((p / 'studio_design.json').read_text(encoding='utf-8'))
        blocks, link = [], None

        def px(node):
            st = node.get('style') if isinstance(node.get('style'), dict) else {}
            h = str(st.get('height', ''))
            m = re.fullmatch(r'(\d+)px', h)
            return int(m.group(1)) if m else ('100%' if h == '100%' else None)

        def walk(n, link=None, hs=()):
            if isinstance(n, list):
                for v in n:
                    walk(v, link, hs)
                return
            if not isinstance(n, dict):
                return
            t = n.get('type')
            if t == 'list':
                return
            lk = n.get('link')
            if isinstance(lk, dict) and isinstance(lk.get('path'), str) and lk['path']:
                link = lk['path']  # この要素の中身全体がリンクになっている
            data = n.get('data') if isinstance(n.get('data'), str) else None
            # 枠の高さ:すぐ外側の箱の高さ、なければその外のまとまりの高さ(Studio の設定のまま)
            near = hs[-1] if hs else None
            height = near if isinstance(near, int) else (next((h for h in reversed(hs[-3:]) if isinstance(h, int)), None) if near == '100%' else None)
            if t == 'text' and data is not None:
                blocks.append({'type': 'text', 'html': re.sub(r'(<br>)+$', '', data), 'link': link})
            elif t == 'iframe' and data:
                if height:  # 高さの決まっていない iframe は Studio でも表示されていなかった
                    blocks.append({'type': 'iframe', 'html': data, 'height': height})
            elif t == 'sandbox' and data:
                name = f'{p.name}-{sum(1 for b in blocks if b["type"] == "embed") + 1}.html'
                blocks.append({'type': 'embed', 'html': write_embed(name, media(data)), 'height': near if isinstance(near, int) else None})
            elif t == 'img' and isinstance(n.get('src'), str) and 'storage.googleapis' in n['src']:
                blocks.append({'type': 'img', 'src': media(n['src']), 'link': link})
            for k, v in n.items():
                if isinstance(v, (list, dict)) and k not in ('style',):
                    walk(v, link, hs + (px(n),))
        walk(d)
        # 最後の「Record | 記録」以降は一覧なので要らない
        cut = next((i for i, b in enumerate(blocks) if b['type'] == 'text' and 'Record' in b['html']), len(blocks))
        static[p.name] = {'blocks': blocks[:cut]}
    (DATA / 'static.json').write_text(json.dumps(static, ensure_ascii=False, indent=1), encoding='utf-8')
    print('記事', len(cards), '4コマ', len(load('manga')), '英語版', len(load('english')), 'シリーズ', list(static))


if __name__ == '__main__':
    main()
tools/upload_media.py — Mac から画像と動画を R2 へ入れる
"""記事・4コマの画像と動画を、Cloudflare R2(p2m-media)へ入れる。

Mac 上で動かす(画像は Mac の iCloud にあり、GitHub には入れないため)。
鍵は KIOXIA の p2m_cloudflare_token.txt から読む(画面にもログにも出さない)。

使い方:
  python3 upload_media.py <フォルダ> [<フォルダ> ...]
    フォルダの下(深さは問わない)の画像・動画を、ファイル名をそのまま住所にして入れる。
    すでに同じ名前・同じ大きさのものが入っていれば飛ばす。
    同じ名前で中身が違うものが見つかったら、入れずに知らせる(上書きしない)。
  オプション --dry-run : 入れずに、入れる予定のものだけ数える

名前の末尾が「 2」のフォルダ(iCloud が作る重複コピー)は読まない。
"""
import json
import mimetypes
import os
import sys
import time
import urllib.parse
import urllib.request
from pathlib import Path

ACCOUNT = '21d7aed1b193796b89287df10913f2dc'
BUCKET = 'p2m-media'
API = f'https://api.cloudflare.com/client/v4/accounts/{ACCOUNT}/r2/buckets/{BUCKET}/objects'
EXTS = {'.png', '.jpg', '.jpeg', '.webp', '.gif', '.svg', '.mp4', '.webm', '.mov', '.avif'}
TOKEN_FILE = Path.home() / 'mnt/KIOXIA/p2m_cloudflare_token.txt'
if not TOKEN_FILE.exists():
    TOKEN_FILE = Path('/Volumes/KIOXIA/p2m_cloudflare_token.txt')


def token():
    return TOKEN_FILE.read_text(encoding='utf-8').strip().split()[0]


def req(method, url, data=None, ctype=None):
    r = urllib.request.Request(url, data=data, method=method)
    r.add_header('Authorization', 'Bearer ' + token())
    if ctype:
        r.add_header('Content-Type', ctype)
    for attempt in range(4):
        try:
            with urllib.request.urlopen(r, timeout=300) as res:
                return json.loads(res.read() or b'{}')
        except Exception as e:  # 一時的な失敗は待ってやり直す
            if attempt == 3:
                raise
            time.sleep(3 * (attempt + 1))


def existing():
    """入っているものの一覧(名前 → 大きさ)"""
    out, cursor = {}, None
    while True:
        q = {'per_page': 1000}
        if cursor:
            q['cursor'] = cursor
        d = req('GET', API + '?' + urllib.parse.urlencode(q))
        for o in d.get('result', []):
            out[o['key']] = int(o['size'])
        cursor = (d.get('result_info') or {}).get('cursor')
        if not (d.get('result_info') or {}).get('is_truncated'):
            return out


def files(roots):
    found = {}
    for root in roots:
        for dirpath, dirnames, filenames in os.walk(root):
            dirnames[:] = [d for d in dirnames if not d.endswith(' 2') and not d.startswith('.')]
            for n in filenames:
                p = Path(dirpath) / n
                if p.suffix.lower() in EXTS and not n.startswith('.'):
                    found.setdefault(n, []).append(p)
    return found


def main():
    args = [a for a in sys.argv[1:] if not a.startswith('--')]
    dry = '--dry-run' in sys.argv
    have = existing()
    todo, clash, skip = [], [], 0
    for name, paths in sorted(files(args).items()):
        sizes = {p.stat().st_size for p in paths}
        if len(sizes) > 1:
            clash.append((name, [str(p) for p in paths]))
            continue
        size = sizes.pop()
        if name in have:
            if have[name] == size:
                skip += 1
            else:
                clash.append((name, ['入っているものと大きさが違う', str(paths[0])]))
            continue
        todo.append((name, paths[0], size))
    print(f'入れる {len(todo)}・入っている {skip}・名前の重なり {len(clash)}・合計 {sum(s for _, _, s in todo)/1e6:.1f}MB', flush=True)
    for c in clash:
        print('  重なり:', c, flush=True)
    if dry:
        return
    # 同時に8つずつ入れる。途中で止まっても、次に動かせば残りから続く
    from concurrent.futures import ThreadPoolExecutor

    def put(item):
        name, p, size = item
        ctype = mimetypes.guess_type(name)[0] or 'application/octet-stream'
        d = req('PUT', API + '/' + urllib.parse.quote(name), p.read_bytes(), ctype)
        return name, d.get('success'), d.get('errors')

    with ThreadPoolExecutor(8) as ex:
        for i, (name, ok, err) in enumerate(ex.map(put, todo), 1):
            if not ok:
                print('  失敗:', name, err, flush=True)
            if i % 50 == 0 or i == len(todo):
                print(f'  {i}/{len(todo)}', flush=True)
    print('おわり', flush=True)


if __name__ == '__main__':
    main()
tools/add_article.py — Markdown の記事を 1 本入れる
"""記事の作業フォルダ(iCloud)から、記事1本をサイトに入れる。

使い方:
  python3 tools/add_article.py <作業フォルダ> <DAY番号> <シリーズ名>

やること:
- DAY{N}_article.md      → src/content/records/DAY{N}.md(先頭の項目に series を足す)
- DAY{N}_thumbnail.html  → public/thumbs/DAY{N}.html
- 本文の【図解】の HTML  → public/embeds/(図解の高さを親ページに知らせる仕組みを足す)
- 本文の【画像】の画像    → あるかを確かめるだけ。画像は GitHub に入れず、Mac で tools/upload_media.py を使って R2 に入れる
"""
import re, shutil, sys
from pathlib import Path

work, day, series = Path(sys.argv[1]), sys.argv[2], sys.argv[3]
site = Path(__file__).resolve().parent.parent
md_src = work / f"DAY{day}_article.md"
text = md_src.read_text(encoding="utf-8")

# 先頭の項目(---で囲まれた部分)に series を入れる
fm_end = text.index("\n---", 3)
fm, body = text[:fm_end], text[fm_end:]
if re.search(r"^series:", fm, flags=re.M):
    fm = re.sub(r"^series:.*$", f'series: "{series}"', fm, flags=re.M)
else:
    fm += f'\nseries: "{series}"'
out = site / "src/content/records" / f"DAY{day}.md"
out.parent.mkdir(parents=True, exist_ok=True)
out.write_text(fm + body, encoding="utf-8")

reporter = re.search(r'HEIGHT_REPORTER = """(.*?)"""',
                     (site / "tools/import_all.py").read_text(encoding="utf-8"), re.S).group(1)

thumb = work / f"DAY{day}_thumbnail.html"
if thumb.exists():
    (site / "public/thumbs").mkdir(parents=True, exist_ok=True)
    shutil.copy2(thumb, site / "public/thumbs" / f"DAY{day}.html")

for name in re.findall(r"^【図解】\s*(\S+\.html)\s*$", body, flags=re.M):
    doc = (work / name).read_text(encoding="utf-8")
    doc = doc.replace("</body>", reporter + "</body>", 1) if "</body>" in doc else doc + reporter
    (site / "public/embeds" / name).write_text(doc, encoding="utf-8")

missing = []
for name in re.findall(r"^【画像】\s*(\S+)\s*$", body, flags=re.M):
    src = work / f"DAY{day}_images" / name
    if not src.exists():
        missing.append(name)

print(f"DAY{day}: 記事 {out.name}, シリーズ {series}" + (f", 見つからない画像 {missing}" if missing else ""))
if missing:
    sys.exit(1)
worker/index.js — /media/ を R2 から返し、メッセージを R2 に保存する
// サイトの入口。ほとんどのページは作っておいた静的ファイル(dist/)をそのまま返す。
// ここで処理するのは2つだけ:
// - /media/{ファイル名}  記事・4コマの画像と動画を R2(p2m-media)から返す(GitHub には入れないため)
// - /api/message         メッセージフォームの送信を R2(p2m-messages)に保存する
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname.startsWith('/media/')) return media(request, env, url);
    if (url.pathname === '/api/message') return message(request, env);
    return env.ASSETS.fetch(request);
  },
};

async function media(request, env, url) {
  if (request.method !== 'GET' && request.method !== 'HEAD') return new Response('Method Not Allowed', { status: 405 });
  const key = decodeURIComponent(url.pathname.slice('/media/'.length));
  if (!key || key.includes('/') || key.startsWith('.')) return new Response('Not Found', { status: 404 });
  // 動画の途中から再生できるよう、Range(一部だけの取得)にも答える
  const obj = await env.MEDIA.get(key, { range: request.headers, onlyIf: request.headers });
  if (obj === null) return new Response('Not Found', { status: 404 });
  const headers = new Headers();
  obj.writeHttpMetadata(headers);
  headers.set('etag', obj.httpEtag);
  headers.set('accept-ranges', 'bytes');
  headers.set('cache-control', 'public, max-age=86400');
  if (!('body' in obj) || !obj.body) return new Response(null, { status: 304, headers });
  let status = 200;
  if (obj.range && request.headers.has('range')) {
    const r = obj.range;
    const start = 'suffix' in r ? obj.size - r.suffix : (r.offset ?? 0);
    const end = 'suffix' in r ? obj.size - 1 : (r.length !== undefined ? start + r.length - 1 : obj.size - 1);
    headers.set('content-range', `bytes ${start}-${end}/${obj.size}`);
    headers.set('content-length', String(end - start + 1));
    status = 206;
  }
  return new Response(request.method === 'HEAD' ? null : obj.body, { status, headers });
}

async function message(request, env) {
  if (request.method !== 'POST') return new Response('Method Not Allowed', { status: 405 });
  let d;
  try { d = await request.json(); } catch { return json({ ok: false, error: '送信の形が正しくありません' }, 400); }
  const name = String(d.name || '').trim().slice(0, 200);
  const email = String(d.email || '').trim().slice(0, 300);
  const body = String(d.body || '').trim().slice(0, 10000);
  if (!name || !email || !body || !/^[^\s@]+@[^\s@]+\.[^\s@]+$/.test(email) || d.agree !== true) {
    return json({ ok: false, error: '入力を確かめてください' }, 400);
  }
  const at = new Date().toISOString();
  const key = `${at.replace(/[:.]/g, '-')}-${crypto.randomUUID().slice(0, 8)}.json`;
  await env.MESSAGES.put(key, JSON.stringify({ at, name, email, body, ua: request.headers.get('user-agent') || '' }, null, 1),
    { httpMetadata: { contentType: 'application/json' } });
  return json({ ok: true });
}

function json(o, status = 200) {
  return new Response(JSON.stringify(o), { status, headers: { 'content-type': 'application/json; charset=utf-8' } });
}
wrangler.jsonc — Cloudflare Workers の設定
{
  // Cloudflare Workers の設定。
  // ページは作っておいた静的ファイル(dist/)。画像と動画・メッセージフォームだけ worker/index.js が受け持つ
  "name": "p2m-site",
  "main": "./worker/index.js",
  "compatibility_date": "2026-10-01",
  "assets": {
    "directory": "./dist",
    "binding": "ASSETS",
    "not_found_handling": "404-page",
    "html_handling": "auto-trailing-slash",
    // /media/ と /api/ は静的ファイルより先に worker/index.js へ回す
    "run_worker_first": ["/media/*", "/api/*"]
  },
  "r2_buckets": [
    // 記事・4コマの画像と動画(GitHub には入れない。tools/upload_media.py で Mac から入れる)
    { "binding": "MEDIA", "bucket_name": "p2m-media" },
    // メッセージフォームで送られた内容
    { "binding": "MESSAGES", "bucket_name": "p2m-messages" }
  ]
}
astro.config.mjs
import { defineConfig } from 'astro/config';
import remarkMarkers from './src/lib/remark-markers.mjs';

// URL は今の Studio と同じ「末尾の / なし」にそろえる(/pixelstomotors/series7 → series7.html)
export default defineConfig({
  site: 'https://adaptdesign.jp',
  trailingSlash: 'ignore',
  build: { format: 'file' },
  markdown: {
    // コードは今のサイトと同じく色を付けずに出す
    syntaxHighlight: false,
    remarkPlugins: [remarkMarkers],
  },
});
src/lib/remark-markers.mjs — 【画像】【図解】の行を変換し、R2R2R の注記を出し分ける
// 記事 Markdown を、サイトに出す形に整える。
// 1. 「【画像】ファイル名」「【図解】ファイル名」の行を、画像と図解の枠に置き換える
//    (article_rules.md の書き方をそのまま使う。行の頭からその行の終わりまでが1つの指定)
// 2. R2R2R の注記(##### ※ プロジェクト名「R2R2R」は…)は、R2R2R シリーズの記事にだけ残す
//    (Studio でも、該当しない記事では手で消していた)
import { visit, SKIP } from 'unist-util-visit';
import { toString } from 'mdast-util-to-string';
import { MEDIA_BASE } from './media-base.mjs';

const R2R2R_NOTE = /^※\s*プロジェクト名「R2R2R」/;

export default function remarkMarkers() {
  const base = MEDIA_BASE.replace(/\/$/, '');
  return (tree, file) => {
    const series = file.data?.astro?.frontmatter?.series;
    if (series !== 'R2R2R') {
      visit(tree, 'heading', (node, index, parent) => {
        if (parent && node.depth === 5 && R2R2R_NOTE.test(toString(node).trim())) {
          parent.children.splice(index, 1);
          return [SKIP, index];
        }
      });
    }
    visit(tree, 'paragraph', (node, index, parent) => {
      if (!parent || node.children.length !== 1 || node.children[0].type !== 'text') return;
      const text = node.children[0].value.trim();
      let m = text.match(/^【画像】\s*(\S+)$/);
      if (m) {
        parent.children[index] = { type: 'html', value:
          `<figure><img src="${base}/${encodeURIComponent(m[1])}" alt="" loading="lazy"></figure>` };
        return;
      }
      m = text.match(/^【図解】\s*(\S+\.html)$/);
      if (m) {
        parent.children[index] = { type: 'html', value:
          `<div class="embed"><iframe src="/embeds/${encodeURIComponent(m[1])}" sandbox="allow-scripts allow-popups" loading="lazy" title="図解" data-embed></iframe></div>` };
      }
    });
  };
}
src/lib/media-base.mjs
// 記事・4コマの画像と動画の置き場所。
// 実体は Cloudflare R2(p2m-media)にあり、このサイトの /media/ から worker/index.js が返す。
// MASTER のルールで、記事に載せる画像は GitHub に入れない。
export const MEDIA_BASE = '/media';
src/lib/media.ts
// 記事・4コマの画像と動画の住所を、置き場所(media-base.mjs)に向ける。
import { MEDIA_BASE } from './media-base.mjs';
const BASE = MEDIA_BASE.replace(/\/$/, '');
export function media(path: string | null | undefined): string | null {
  if (!path) return null;
  return path.startsWith('/media/') ? BASE + '/' + path.slice('/media/'.length) : path;
}
export function mediaHtml(html: string): string {
  return BASE === '/media' ? html : html.replace(/(["'(])\/media\//g, `$1${BASE}/`);
}
src/lib/records.ts — 一覧の並びとシリーズの対応
import { getCollection } from 'astro:content';
import cards from '../data/cards.json';
import mangaCards from '../data/mangaCards.json';
import englishCards from '../data/englishCards.json';

export type Card = { day: string; series: string; published: string; title: string; slug: string; cover: string | null; thumb: string | null };
export type MangaCard = { slug: string; title: string; label: string; character: string; description: string; published: string; cover: string; comic: string; cover_alt: string; comic_alt: string };

// 一覧に並べる記事:Claude が書いた Markdown の記事 + Studio から移した記事(Studio と同じく公開日の新しい順)
export async function allCards(): Promise<Card[]> {
  const md = (await getCollection('records')).map((e) => ({
    day: `DAY${e.data.day}`, series: e.data.series, published: e.data.date.toISOString(),
    title: e.data.title, slug: e.data.slug, cover: null, thumb: `/thumbs/DAY${e.data.day}.html`,
  }));
  const seen = new Set(md.map((c) => c.slug));
  const studio = (cards as Card[]).filter((c) => !seen.has(c.slug));
  return [...md, ...studio].sort((a, b) => b.published.localeCompare(a.published));
}

export async function seriesCards(series: string): Promise<Card[]> {
  return (await allCards()).filter((c) => c.series === series);
}

export const allManga = mangaCards as MangaCard[];
export const allEnglish = englishCards as MangaCard[];

// シリーズのページ(URL → 記事のシリーズ名)。Studio の一覧の絞り込み条件と同じ
export const SERIES_PAGES: Record<string, { series: string; title: string; pageTitle: string; limit: number }> = {
  series1: { series: 'HRI', title: 'Drug Delivery Robot | 薬剤搬送ロボットハコブくん', pageTitle: 'Series1 | 薬剤搬送ロボット', limit: 12 },
  series2: { series: 'R2R2R', title: 'R2R2R | デジタルツイン学習-R2R2R(Real to Render to Real)', pageTitle: 'Series2 | R2R2R', limit: 12 },
  series3: { series: 'UV-C農業ロボット', title: 'UV-C Agricultural Robot | UV-C農業ロボット', pageTitle: 'Series3 | UV-C農業ロボット', limit: 20 },
  series4: { series: 'ロボティクスデザイン', title: 'Robotics Design Workflow | ロボティクスデザイン実務フロー', pageTitle: 'Series4 | ロボティクスデザイン実務フロー', limit: 12 },
  series5: { series: '考察記事', title: 'Deep Dive | 考察記事', pageTitle: 'Series5 | 考察記事', limit: 12 },
  series6: { series: 'フィジカルAI研究室', title: 'Physical AI Lab | フィジカルAI研究室', pageTitle: 'Series6 | フィジカルAI研究室', limit: 12 },
  series7: { series: '画像認識・物体検出', title: 'Image recognition and Object detection | 画像認識と物体検出', pageTitle: 'Series7 | 画像認識と物体検出', limit: 12 },
};
src/lib/format.ts
// Studio と同じ「2026/8/2」形式(日本時間)
export function ymd(iso: string): string {
  const d = new Date(new Date(iso).getTime() + 9 * 3600 * 1000);
  return `${d.getUTCFullYear()}/${d.getUTCMonth() + 1}/${d.getUTCDate()}`;
}
src/content.config.ts — Markdown の記事の先頭項目
import { defineCollection, z } from 'astro:content';
import { glob } from 'astro/loaders';

// Claude が書いた記事(Markdown)。先頭の項目は article_rules.md の形のまま
const records = defineCollection({
  loader: glob({ pattern: '*.md', base: './src/content/records' }),
  schema: z.object({
    title: z.string(),
    slug: z.string(),
    date: z.coerce.date(),
    day: z.number(),
    series: z.string(),
    meta_description: z.string().optional(),
    tags: z.array(z.string()).optional(),
  }),
});
export const collections = { records };
src/layouts/Base.astro — 全ページ共通の枠
---
// 全ページ共通の枠(head・ヘッダー・フッター)
interface Props { title: string; description?: string; ogImage?: string; path: string; }
const { title, description = '', ogImage, path } = Astro.props;
const site = 'https://adaptdesign.jp';
const canonical = site + path;
// 試作の確認用:このページが作られた日時(日本時間)
const built = new Date(Date.now() + 9 * 3600 * 1000).toISOString().replace('T', ' ').slice(0, 16);
---
<!doctype html>
<html lang="ja">
<head>
  <meta charset="utf-8" />
  <meta name="viewport" content="width=device-width, initial-scale=1" />
  <title>{title}</title>
  <meta name="description" content={description} />
  <link rel="canonical" href={canonical} />
  <meta property="og:site_name" content="ADAPT DESIGN" />
  <meta property="og:title" content={title} />
  <meta property="og:description" content={description} />
  <meta property="og:type" content="website" />
  <meta property="og:url" content={canonical} />
  {ogImage && <meta property="og:image" content={site + ogImage} />}
  <meta name="twitter:card" content="summary_large_image" />
  <!-- 試作のあいだは検索エンジンに載せない -->
  <meta name="robots" content="noindex, nofollow" />
  <link rel="icon" type="image/png" href="/site/9cad887a-242b-4953-bd36-7b368c27d1b9.png" />
  <link rel="preconnect" href="https://fonts.googleapis.com" />
  <link rel="preconnect" href="https://fonts.gstatic.com" crossorigin />
  <link href="https://fonts.googleapis.com/css2?family=Inter:wght@300;400;500;600;700&family=Noto+Sans+JP:wght@300;400;500;700&display=swap" rel="stylesheet" />
  <link rel="stylesheet" href="https://fonts.googleapis.com/css2?family=Material+Symbols+Outlined:opsz,wght,FILL,GRAD@20..48,400,0,0&display=block" />
  <slot name="head" />
</head>
<body>
  <header class="site-header">
    <div class="hd-inner">
      <a class="logo" href="/pixelstomotors">
        <img class="logo-img" src="/site/pixelstomotors-logo.svg" alt="Pixels to Motors" width="189" height="20" />
      </a>
      <div class="hd-center">
        <a class="hd-manga" href="/pixelstomotors/manga-archive"><img src="/site/s-500x700_f2c5ae27-2ebe-4d15-8da4-05853d4973ef.webp" alt="" /></a>
        <a class="btn-dark" href="/pixelstomotors/manga-archive">4コママンガ<i class="ms">arrow_forward</i></a>
        <a class="btn-dark" href="/pixelstomotors/manga-archive-en">English 4-Koma<i class="ms">arrow_forward</i></a>
      </div>
      <a class="btn-dark hd-msg" href="/pixelstomotors/message">メッセージ<i class="ms">arrow_forward</i></a>
    </div>
  </header>
  <main><slot /></main>
  <footer class="site-footer">
    <div class="ft-inner">
      <a href="/web_production_list">© ADAPT DESIGN 2025</a>
      <a href="/pixelstomotors/privacypolicy">Privacy policy</a>
      <span class="ft-built">試作版・最終更新 {built}</span>
    </div>
  </footer>
  <script>
    // 図解(隔離した枠)から届いた高さで、枠の高さを合わせる
    window.addEventListener('message', (e) => {
      const h = e.data && e.data.p2mHeight;
      if (typeof h !== 'number' || !isFinite(h) || h <= 0) return;
      for (const f of document.querySelectorAll('iframe[data-embed]')) {
        if (f.contentWindow === e.source) { f.style.height = Math.min(Math.ceil(h), 20000) + 'px'; break; }
      }
    });
  </script>
</body>
</html>

<style is:global>
  :root {
    --ink: #242424; --ink-2: #555; --ink-3: #888; --line: #f2f2f2;
    --bg: #f7f7f7; --panel: #fff; --dark: #242424;
    --sans: Inter, 'Noto Sans JP', sans-serif;
    --mono: Menlo, Monaco, 'Courier New', monospace;
  }
  * { box-sizing: border-box; }
  html { -webkit-text-size-adjust: 100%; }
  /* Studio と同じく、Mac で文字を細めに描く指定(ないと太く濃く見える) */
  body { margin: 0; background: var(--bg); color: var(--ink); font-family: var(--sans);
    -webkit-font-smoothing: antialiased; -moz-osx-font-smoothing: grayscale; }
  a { color: inherit; text-decoration: none; }
  img { max-width: 100%; display: block; }
  .ms { font-family: 'Material Symbols Outlined'; font-style: normal; font-size: 16px; line-height: 1; }

  .site-header { position: fixed; inset: 0 0 auto 0; z-index: 50; height: 48px; padding: 6px 40px;
    background: rgba(255,255,255,.1); backdrop-filter: blur(10px); -webkit-backdrop-filter: blur(10px);
    box-shadow: 0 4px 4px rgba(0,0,0,.1); }
  .hd-inner { max-width: 1280px; margin: 0 auto; height: 36px; display: flex; align-items: center; justify-content: space-between; gap: 40px; }
  .logo { display: flex; align-items: center; }
  .logo-img { height: 17.3px; width: auto; }
  /* 元は Studio 付属の有料フォント「A1ゴシック M」。移行先では使えないため代用中 */
  .logo span { font-family: 'Noto Sans JP', sans-serif; font-weight: 500; font-size: 20px; letter-spacing: -0.4px; color: var(--ink); }
  .hd-center { display: flex; align-items: center; gap: 8px; }
  .hd-manga img { height: 28px; width: auto; }
  .btn-dark { display: inline-flex; align-items: center; gap: 8px; height: 31px; padding: 4px 16px; border-radius: 4px;
    background: var(--dark); border: 1px solid var(--dark); color: #fff; font: 500 14px/21px 'Noto Sans JP', sans-serif; white-space: nowrap; }
  .site-footer { background: var(--dark); padding: 24px 40px; }
  .ft-inner { max-width: 1280px; margin: 0 auto; display: flex; gap: 40px; }
  .ft-inner a { color: #888; font: 300 14px/21px var(--sans); }
  .ft-inner a:hover { color: #fff; }
  .ft-built { margin-left: auto; color: #666; font: 300 12px/21px var(--sans); }

  /* シリーズ名の札・日付 */
  .tag { display: inline-block; padding: 2px 6px; border-radius: 4px; background: #f0f0f0; color: #888; font: 400 11px/16px var(--sans); }
  .date { color: #aaa; font: 400 11px/16px var(--sans); }
  /* 一覧ページ共通の枠 */
  .panel { max-width: 1280px; margin: 0 auto; background: #fff; border-radius: 16px; padding: 32px; }
  .related, .sec { padding: 40px 80px; }
  .sec-h { margin: 0 0 32px; font: 600 24px/36px var(--sans); }
  .grid3 { display: grid; grid-template-columns: repeat(3, minmax(0, 1fr)); gap: 32px; }
  @media (max-width: 1023px) { .grid3 { grid-template-columns: repeat(2, minmax(0, 1fr)); } .related, .sec { padding: 40px 24px; } }
  @media (max-width: 599px) { .grid3 { grid-template-columns: 1fr; gap: 24px; } .related, .sec { padding: 32px 12px; } .panel { padding: 24px 16px; } }

  @media (max-width: 767px) {
    .site-header { padding: 6px 16px; }
    .hd-inner { gap: 8px; }
    .logo-img { height: 14.8px; }
    .hd-center .btn-dark { display: none; }
    .hd-manga img { height: 32px; }
    .btn-dark { padding: 4px 10px; font-size: 12px; gap: 4px; }
    .site-footer { padding: 24px 16px; }
  }
</style>
src/components/RecordCard.astro
---
import { ymd } from '../lib/format';
import { media } from '../lib/media';
const { item } = Astro.props;
---
<a class="rcard" href={`/pixelstomotors/record/${item.slug}`}>
  <div class="rthumb">
    {item.thumb
      ? <iframe src={item.thumb} sandbox="allow-scripts" loading="lazy" tabindex="-1" title="" scrolling="no"></iframe>
      : item.cover ? <img src={media(item.cover)} alt="" loading="lazy" /> : null}
  </div>
  <div class="rmeta">
    <div class="rline"><span class="rday">{item.day}</span><span class="tag">{item.series}</span><span class="date">{ymd(item.published)}</span></div>
    <p class="rtitle">{item.title}</p>
  </div>
</a>
<style>
  .rcard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
  .rthumb { aspect-ratio: 16 / 9; background: #fff; position: relative; overflow: hidden; }
  .rthumb iframe { position: absolute; inset: 0; width: 100%; height: 100%; border: 0; pointer-events: none; }
  .rthumb img { width: 100%; height: 100%; object-fit: cover; }
  .rmeta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
  .rline { display: flex; align-items: center; gap: 12px; flex-wrap: wrap; }
  .rday { font: 400 18px/18px var(--sans); }
  .rtitle { margin: 0; font: 600 16px/1.6 var(--sans); }
</style>
src/components/MangaCard.astro
---
import { ymd } from '../lib/format';
import { media } from '../lib/media';
interface Props { item: { slug: string; title: string; label: string; character: string; published: string; cover: string }; base?: string }
const { item, base = '/pixelstomotors/manga' } = Astro.props;
---
<a class="mcard" href={`${base}/${item.slug}`}>
  <img src={media(item.cover)} alt="" loading="lazy" />
  <div class="mc-meta">
    <div class="rline"><span class="mc-label">{item.label}</span><span class="tag">{item.character}</span><span class="date">{ymd(item.published)}</span></div>
    <p class="mc-title">{item.title}</p>
  </div>
</a>
<style is:global>
  .mcard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
  .mcard img { width: 100%; aspect-ratio: 4 / 5; object-fit: cover; }
  .mc-meta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
  .mc-label { font: 400 16px/16px var(--sans); }
  .mc-title { margin: 0; font: 500 14px/1.6 var(--sans); }
  .rline { display: flex; align-items: center; gap: 4px 12px; flex-wrap: wrap; }
</style>
src/components/LoadMore.astro — 12 件ずつ見せる
---
// Studio の一覧と同じ「最初は limit 件だけ見せて、Load more で limit 件ずつ足す」並び。
// 中身(カード)は全部出力しておき、見せる数だけを切り替える。
interface Props { limit: number; total: number; cls?: string; label?: string }
const { limit, total, cls = 'grid3', label = 'Load more' } = Astro.props;
---
<div class="lm" data-limit={limit}>
  <div class={`lm-list ${cls}`}><slot /></div>
  {total > limit && <div class="lm-more"><button class="btn-load" type="button">{label}</button></div>}
</div>
<script>
  for (const box of document.querySelectorAll<HTMLElement>('.lm')) {
    const step = Number(box.dataset.limit) || 12;
    const items = [...box.querySelector('.lm-list')!.children] as HTMLElement[];
    let shown = step;
    const apply = () => items.forEach((el, i) => { el.hidden = i >= shown; });
    apply();
    const btn = box.querySelector<HTMLButtonElement>('.btn-load');
    btn?.addEventListener('click', () => { shown += step; apply(); if (shown >= items.length) btn.parentElement!.remove(); });
  }
</script>
<style is:global>
  .lm-more { display: flex; justify-content: center; margin-top: 40px; }
  .btn-load { width: 282px; height: 48px; border: 0; border-radius: 4px; background: var(--dark); color: #fff; font: 500 20px/30px var(--sans); cursor: pointer; }
  .lm-list > [hidden] { display: none !important; }
</style>
src/components/MangaPage.astro
---
// 4コマのページ(日本語・英語版で共通)。下に関連する記録(Studio と同じく HRI の新しい6件+Load more)
import Base from '../layouts/Base.astro';
import RecordCard from './RecordCard.astro';
import LoadMore from './LoadMore.astro';
import { ymd } from '../lib/format';
import { media, mediaHtml } from '../lib/media';
import { seriesCards } from '../lib/records';
interface Props { m: any; path: string }
const { m, path } = Astro.props;
const related = await seriesCards('HRI');
---
<Base title={`Manga | 4コママンガ ${m.title}`} description={m.description} ogImage={media(m.cover) || undefined} path={path}>
  <article class="manga">
    <div class="mmeta"><span class="mlabel">{m.label}</span><span class="tag">{m.character}</span><span class="date">{ymd(m.published)}</span></div>
    {m.cover && <img class="mcover" src={media(m.cover)} alt={m.cover_alt || `${m.label} 表紙`} />}
    {m.comic && <img class="mcomic" src={media(m.comic)} alt={m.comic_alt || `${m.label} 本編`} />}
    <h1 class="mtitle">{m.title}</h1>
    <div class="mbody" set:html={mediaHtml(m.body)} />
  </article>
  <section class="related">
    <div class="panel">
      <h2 class="sec-h">Related Records | マンガの背景にある記録</h2>
      <LoadMore limit={6} total={related.length}>{related.map((c) => <RecordCard item={c} />)}</LoadMore>
    </div>
  </section>
</Base>
<style>
  .manga { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 80px; }
  .mmeta { display: flex; align-items: center; gap: 12px; margin-bottom: 16px; }
  .mlabel { font: 400 28px/28px var(--sans); }
  .mcover, .mcomic { width: 100%; height: auto; }
  .mtitle { margin: 24px 0 12px; font: 600 20px/30px var(--sans); }
  .mbody :global(p) { font: 400 16px/2 'Noto Sans JP', sans-serif; margin: 0 0 16px; color: #333; }
</style>
src/components/MangaArchive.astro
---
// 4コマの一覧(日本語・英語版で共通)。Studio と同じく公開日の新しい順に18件ずつ
import Base from '../layouts/Base.astro';
import MangaCard from './MangaCard.astro';
import LoadMore from './LoadMore.astro';
interface Props { items: any[]; heading: string; other: { href: string; label: string }; base: string; path: string }
const { items, heading, other, base, path } = Astro.props;
---
<Base title="Archive | 4コママンガアーカイブ" description="4コママンガ「薬剤搬送ロボットハコブくん」の一覧。" path={path}>
  <section class="ma"><div class="panel">
    <div class="ma-head">
      <h1 class="sec-h ma-title">{heading}</h1>
      <a class="btn-dark" href={other.href}>{other.label}<i class="ms">arrow_forward</i></a>
    </div>
    <LoadMore limit={18} total={items.length}>{items.map((m) => <MangaCard item={m} base={base} />)}</LoadMore>
  </div></section>
</Base>
<style>
  .ma { padding: 88px 80px 40px; }
  .ma-head { display: flex; align-items: center; justify-content: space-between; gap: 16px; margin-bottom: 32px; }
  .ma-title { margin: 0; }
  @media (max-width: 1023px) { .ma { padding: 72px 24px 40px; } }
  @media (max-width: 599px) { .ma { padding: 64px 12px 32px; } .ma-head { flex-direction: column; align-items: flex-start; } }
</style>
src/pages/index.astro
---
// 試作の入口:/ からトップへ(本番の / の扱いは別に決める)
return Astro.redirect('/pixelstomotors');
---
src/pages/404.astro
---
import Base from '../layouts/Base.astro';
---
<Base title="ページが見つかりません" path="/404">
  <section class="nf">
    <p class="nf-h">このページは見つかりませんでした</p>
    <p>住所が変わったか、ページがなくなった可能性があります。</p>
    <p><a class="btn-dark" href="/pixelstomotors">トップへ<i class="ms">arrow_forward</i></a></p>
  </section>
</Base>
<style>
  .nf { max-width: 620px; margin: 0 auto; padding: 160px 24px 200px; font: 400 16px/1.8 var(--sans); }
  .nf-h { font: 600 24px/1.5 var(--sans); }
</style>
src/pages/pixelstomotors/index.astro — トップ
---
import Base from '../../layouts/Base.astro';
import RecordCard from '../../components/RecordCard.astro';
import { ymd } from '../../lib/format';
import { media } from '../../lib/media';
// SNS アイコン(Font Awesome Free 6.7.2・CC BY 4.0。ライセンス表記は各 SVG の中に残している)
import icGithub from '../../icons/github.svg?raw';
import icLinkedin from '../../icons/linkedin.svg?raw';
import icX from '../../icons/square-x-twitter.svg?raw';
import icYoutube from '../../icons/youtube.svg?raw';
import { allCards } from '../../lib/records';
import MangaCard from '../../components/MangaCard.astro';
import LoadMore from '../../components/LoadMore.astro';
import { allManga } from '../../lib/records';
// Studio のトップと同じく、4コマは新しい4話
const mangaCards = allManga.slice(0, 4);
const series = [
{ href: '/pixelstomotors/series1', img: 's-1920x1318_v-frms_4cd7792b-68a1-4239-ad08-0785c4e538c5.webp', en: 'Drug Delivery Robot', ja: '薬剤搬送ロボットハコブくん',
desc: 'A multidisciplinary documentation of Hakobu — a hospital drug-delivery robot — covering HRI design, UI, autonomous navigation in Unity, and daily development logs, told alongside 4-panel manga.' },
{ href: '/pixelstomotors/series6', img: 's-1672x941_76620d86-fa7b-491f-b554-99c2f8981d8d.webp', en: 'Physical AI Lab', ja: 'フィジカルAI研究室',
desc: 'Building a Physical AI research environment at home, from zero — reproducible by anyone. The first build: an arm that learns from failure.' },
{ href: '/pixelstomotors/series7', img: 's-1800x1200_v-frms_82af05c4-20df-4ea1-b88d-355ed8fabd63.webp', en: 'Image recognition and Object detection', ja: '画像認識と物体検出',
desc: 'Relearning image recognition from the bottom up, one measurable step at a time — pixels, colour spaces, thresholds, morphology, contours, and the metrics that judge them. Nothing is assumed: every step is measured on real photographs first.' },
{ href: '/pixelstomotors/series5', img: 's-2528x1694_7a2b46a9-02c8-49d6-92c4-2e7994843726.webp', en: 'Deep Dive', ja: '考察記事',
desc: 'Essays that go beyond the build log — examining why things work, what they mean, and where the field is heading.' },
{ href: '/pixelstomotors/series2', img: 's-1920x1318_v-frms_0d775000-730b-4ac2-90b5-d814a9f53fc6.webp', en: 'R2R2R', ja: 'デジタルツイン学習-R2R2R(Real to Render to Real)',
desc: 'A hands-on project proving that robot arm motion can be designed without a robotics background — using only an iPhone for 3D scanning and Unity for simulation.' },
{ href: '/pixelstomotors/series4', img: 's-4480x3680_2e3487ec-2968-4b89-8bca-7062b48f6093.webp', en: 'Robotics Design Workflow', ja: 'ロボティクスデザイン実務フロー', desc: '' },
];
const records = await allCards();
---
<Base title="Pixels to Motors | 人とロボットの関わりを、シミュレーションでデザインする"
description="29年のデザイナー経験を、いまロボティクスに応用しています。テーマはHRIシミュレーション——人がロボットをどう感じ、どう関わるかを、実機の前にデジタル上で設計すること。"
ogImage="/site/ffb300c2-1071-4714-978c-87d386d5dfd3.png" path="/pixelstomotors">
<section class="hero">
<div class="hero-text">
<h1>Pixels to Motors | 人とロボットの関わりをシミュレーションでデザインする</h1>
<p>29年のデザイナー経験を、いまロボティクスに応用しています。テーマはHRIシミュレーション——人がロボットをどう感じ、どう関わるかを、実機の前にデジタル上で設計すること。Unityで空間もシナリオもゼロから組み、人の間を動いて運び・手渡すサービスロボットの振る舞いを、成否の基準を物理精度ではなく人の体験に置いてつくります。実機はその先。過程の失敗も含めて公開しています。</p>
</div>
<video class="hero-video" src={media("/media/s-848x1056_e5500e41-e73b-4177-914e-b09a2d11f83c.mp4")} controls muted playsinline preload="metadata"></video>
</section>
<!-- 解説動画:YouTube の新着を GitHub の videos.json から読む埋め込み(Studio で使っていたものをそのまま) -->
<section class="video-sec">
<div class="embed-wide"><iframe src="/embeds/top-video.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="解説動画" data-embed style="height:450px"></iframe></div>
</section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Archive | 4コママンガ</h2>
<div class="grid4">{mangaCards.map((m) => <MangaCard item={m} />)}</div>
<div class="center"><a class="btn-more" href="/pixelstomotors/manga-archive">もっと見る<i class="ms">arrow_forward</i></a></div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Series | シリーズ</h2>
<div class="grid2">
{series.map((s) => (
<a class="scard" href={s.href}>
<img src={media(`/media/${s.img}`)} alt="" loading="lazy" />
<div class="sc-meta">
<div class="sc-line"><span class="sc-en">{s.en}</span><span class="sc-ja">{s.ja}</span></div>
{s.desc && <p class="sc-desc">{s.desc}</p>}
</div>
</a>
))}
</div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Record | 記録</h2>
<LoadMore limit={12} total={records.length}>{records.map((c) => <RecordCard item={c} />)}</LoadMore>
<div class="embed-banner"><iframe src="/embeds/top-banner.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="お知らせ" data-embed style="height:240px"></iframe></div>
</div></section>
<section class="sec"><div class="panel">
<h2 class="sec-h">Sole Prop | 事業所について</h2>
<div class="prop">
<div class="prop-person">
<video class="prop-photo" src={media("/media/s-1280x720_ff64009f-cd40-4e7d-8ba3-350ff0d6c3ad.mp4")} poster={media("/media/s-2048x2048_5af0bc9f-8d23-4bdb-85e4-ada51bfd7bbd.webp")} muted autoplay loop playsinline></video>
<p class="prop-role">Robotics UX & HRI Designer</p>
<p class="prop-name">島津 栄一</p>
</div>
<div class="prop-body">
<p class="prop-lead">画面(Pixels)のデザインから、動き(Motors)のデザインへ</p>
<p class="prop-text">29年にわたるデザイナーとしての知見を土台に、人とロボットの関わり(HRI)をシミュレーションで設計するデザイン事務所です。Unityなどのツールで空間もシナリオもゼロから組み、AIエージェント(Claude Code)を設計と実装の相棒に、人がロボットをどう感じ・どう関わるかを実機の前にデザインします。基準は物理精度ではなく体験の成立。画面上の「Pixels(デジタル)」の設計を、やがて現実の「Motors(モーター)」へ——その前半、体験を確かめるフェーズを公開しています。</p>
<dl class="prop-facts">
<div><dt>事業所名</dt><dd>ADAPT DESIGN</dd></div>
<div><dt>設立</dt><dd>2021年10月</dd></div>
<div class="wide"><dt>研究・実践分野</dt><dd>HRIシミュレーション / ロボティクスUX設計 / デジタルツイン / Unity / Physical AI / R2R2R</dd></div>
<div><dt>SNS</dt><dd class="sns">
<a href="https://github.com/PixelstoMotors/r2r2r-content" aria-label="GitHub" set:html={icGithub} />
<a href="https://www.linkedin.com/in/eiichi-shimazu/" aria-label="LinkedIn" set:html={icLinkedin} />
<a href="https://x.com/adaptdesignjp" aria-label="X" set:html={icX} />
<a href="https://www.youtube.com/@PixelstoMotors" aria-label="YouTube" set:html={icYoutube} />
</dd></div>
</dl>
</div>
</div>
</div></section>
</Base>
<style>
.hero { max-width: 964px; margin: 0 auto; padding: 104px 0 40px; display: flex; gap: 40px; align-items: flex-start; }
.hero-text { flex: 1 1 588px; min-width: 0; }
.hero h1 { margin: 0 0 16px; font: 600 29px/40.6px var(--sans); }
.hero p { margin: 0; font: 400 19px/1.6 'Noto Sans JP', sans-serif; color: #333; }
.hero-video { flex: 0 0 336px; width: 336px; height: 320px; background: #111; border-radius: 4px; object-fit: cover; }
.video-sec { max-width: 1280px; margin: 0 auto; padding: 0 32px; }
.embed-wide iframe, .embed-banner iframe { display: block; width: 100%; border: 0; }
.embed-banner { max-width: 964px; margin: 48px auto 0; }
.grid4 { display: grid; grid-template-columns: repeat(4, minmax(0, 1fr)); gap: 24px; }
.grid2 { display: grid; grid-template-columns: repeat(2, minmax(0, 1fr)); gap: 32px; }
.scard { display: block; background: #fff; border-radius: 8px; box-shadow: 0 8px 16px rgba(0,0,0,.08); overflow: hidden; }
.scard img { width: 100%; aspect-ratio: 3 / 2; object-fit: cover; }
.sc-meta { padding: 16px; display: flex; flex-direction: column; gap: 8px; }
.sc-line { display: flex; align-items: baseline; gap: 8px 12px; flex-wrap: wrap; }
.sc-en { font: 600 24px/24px var(--sans); }
.sc-ja { font: 500 14px/16.8px var(--sans); }
.sc-desc { margin: 0; font: 400 13px/1.6 var(--sans); color: #555; }
.center { display: flex; justify-content: center; margin-top: 40px; }
.btn-more { display: inline-flex; align-items: center; gap: 16px; padding: 8px 24px; border-radius: 4px; background: var(--dark); color: #fff; font: 500 20px/30px var(--sans); }
.prop { display: flex; gap: 40px; }
.prop-person { flex: 0 0 160px; text-align: center; }
.prop-photo { width: 160px; height: 160px; border-radius: 50%; object-fit: cover; display: block; }
.prop-role { margin: 12px 0 4px; font: 300 12px/1.3 var(--sans); color: #888; }
.prop-name { margin: 0; font: 500 20px/20px var(--sans); }
.prop-body { flex: 1; min-width: 0; display: flex; flex-direction: column; gap: 12px; }
.prop-lead { margin: 0; padding: 10px 8px; background: #f7f7f7; font: 600 18px/1.4 var(--sans); }
.prop-text { margin: 0; font: 400 14px/1.5 var(--sans); color: #333; }
.prop-facts { margin: 8px 0 0; display: flex; flex-wrap: wrap; gap: 16px 40px; }
.prop-facts dt { font: 300 12px/15.6px var(--sans); color: #888; }
.prop-facts dd { margin: 4px 0 0; font: 400 14px/1.5 var(--sans); }
.sns { display: flex; gap: 12px; }
.sns a { display: inline-flex; color: #242424; }
.sns a :global(svg) { height: 18px; width: auto; display: block; }
.sns a:hover { color: #666; }
@media (max-width: 1023px) {
.hero { padding: 88px 24px 32px; flex-direction: column; }
.hero-video { width: 100%; flex-basis: auto; }
.grid4 { grid-template-columns: repeat(2, minmax(0, 1fr)); }
.video-sec { padding: 0 24px; }
}
@media (max-width: 599px) {
.hero { padding: 72px 24px 24px; }
.hero h1 { font-size: 24px; line-height: 1.5; }
.hero p { font-size: 16px; line-height: 1.75; }
.grid2 { grid-template-columns: 1fr; gap: 24px; }
.grid4 { gap: 16px; }
.prop { flex-direction: column; align-items: center; gap: 24px; }
.video-sec { padding: 0 12px; }
}
</style>
src/pages/pixelstomotors/[series].astro — シリーズ 1〜7
---
// シリーズのページ(/pixelstomotors/series1〜7)。上に Studio で置いていた資料(Figma・スプレッドシートなど)、下にそのシリーズの記録
import Base from '../../layouts/Base.astro';
import RecordCard from '../../components/RecordCard.astro';
import LoadMore from '../../components/LoadMore.astro';
import { seriesCards, SERIES_PAGES } from '../../lib/records';
import { media } from '../../lib/media';
import staticPages from '../../data/static.json';

export function getStaticPaths() {
  return Object.keys(SERIES_PAGES).map((series) => ({ params: { series } }));
}
const { series } = Astro.params;
const conf = SERIES_PAGES[series];
const blocks = (staticPages[series]?.blocks || []).slice(1); // 先頭はページの見出し
const items = await seriesCards(conf.series);
---
<Base title={conf.pageTitle} description={`${conf.title} の記録一覧`} path={`/pixelstomotors/${series}`}>
  <section class="s-hero"><div class="panel">
    <h1 class="sec-h s-title">{conf.title}</h1>
    {blocks.map((b) => (
      b.type === 'text' ? (b.link ? <a class="s-label" href={b.link} target="_blank" rel="noopener" set:html={b.html} /> : <p class="s-label" set:html={b.html} />)
      : b.type === 'iframe' ? <div class="s-frame" style={`height:${b.height}px`} set:html={b.html} />
      : b.type === 'embed' ? <div class="s-embed" set:html={b.html} />
      : b.type === 'img' ? (b.link ? <a class="s-img" href={b.link} target="_blank" rel="noopener"><img src={media(b.src)} alt="" loading="lazy" /></a> : <div class="s-img"><img src={media(b.src)} alt="" loading="lazy" /></div>)
      : null
    ))}
  </div></section>
  <section class="sec"><div class="panel">
    <h2 class="sec-h">Record | 記録</h2>
    <LoadMore limit={conf.limit} total={items.length}>{items.map((c) => <RecordCard item={c} />)}</LoadMore>
  </div></section>
</Base>
<style>
  .s-hero { padding: 88px 80px 0; }
  .s-title { margin: 0; }
  .s-label { display: block; margin: 40px 0 16px; font: 500 16px/24px var(--sans); color: var(--ink); }
  .s-title + .s-label { margin-top: 8px; }
  a.s-label:hover { text-decoration: underline; }
  .s-frame { width: 100%; }
  .s-frame :global(iframe) { display: block; width: 100% !important; height: 100% !important; }
  .s-embed :global(.embed iframe) { display: block; width: 100%; height: 150px; border: 0; }
  .s-img img { width: 100%; height: auto; display: block; }
  @media (max-width: 1023px) { .s-hero { padding: 72px 24px 0; } }
  @media (max-width: 599px) { .s-hero { padding: 64px 12px 0; } }
</style>
src/pages/pixelstomotors/record/[slug].astro — 記事
---
import Base from '../../../layouts/Base.astro';
import { ymd } from '../../../lib/format';
import { mediaHtml } from '../../../lib/media';
import { getCollection, render } from 'astro:content';
// 記事ページは2種類から作る
// - Studio から移した記事:CMS の本文 HTML(src/data/records/。tools/import_all.py で作る)
// - これから Claude が書く記事:Markdown(src/content/records/)
export async function getStaticPaths() {
const studio = Object.values(import.meta.glob('../../../data/records/*.json', { eager: true, import: 'default' })) as any[];
const md = await getCollection('records');
return [
...studio.map((r) => ({ params: { slug: r.slug }, props: { kind: 'studio', rec: r } })),
...md.map((e) => ({ params: { slug: e.data.slug }, props: { kind: 'md', entry: e } })),
];
}
const { kind, entry, rec } = Astro.props;
const esc = (s) => s.replace(/&/g, '&').replace(/</g, '<');
const tocOf = (items) => items.length ? `<nav class="toc"><ul>${items.map((t) => `<li><a href="#${t.id}">${esc(t.text)}</a></li>`).join('')}</ul></nav>` : '';
let r, body = '', Content = null, toc = '';
if (kind === 'studio') {
r = rec;
body = mediaHtml(rec.body.replace('<!--TOC-->', tocOf(rec.toc)));
} else {
const d = entry.data;
r = { title: d.title, description: d.meta_description || '', slug: d.slug, day: `DAY${d.day}`, series: d.series,
published: d.date.toISOString(), thumb: `/thumbs/DAY${d.day}.html` };
const rendered = await render(entry);
Content = rendered.Content;
toc = tocOf(rendered.headings.filter((h) => h.depth === 2).map((h) => ({ id: h.slug, text: h.text })));
}
---
<Base title={`Record | 記録 ${r.title}`} description={r.description} ogImage={r.cover || undefined} path={`/pixelstomotors/record/${r.slug}`}>
<article class="rec">
{r.thumb ? <div class="hero"><iframe src={r.thumb} sandbox="allow-scripts" title="" scrolling="no" tabindex="-1"></iframe></div> : r.cover && <img class="hero-img" src={r.cover} alt="" />}
<div class="meta"><span class="day">{r.day}</span><span class="tag">{r.series}</span><span class="date">{ymd(r.published)}</span></div>
<h1 class="title">{r.title}</h1>
{kind === 'studio'
? <div class="richText" set:html={body} />
: <div class="richText"><Fragment set:html={toc} /><Content /></div>}
</article>
</Base>
<style is:global>
.rec { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 120px; }
.rec .hero { aspect-ratio: 16 / 9; position: relative; border-radius: 4px; overflow: hidden; background: #0d0d0d; }
.rec .hero iframe { position: absolute; inset: 0; width: 100%; height: 100%; border: 0; pointer-events: none; }
.rec .hero-img { width: 100%; aspect-ratio: 16 / 9; object-fit: cover; border-radius: 4px; display: block; }
.rec .meta { display: flex; align-items: center; gap: 12px; margin-top: 16px; }
.rec .day { font: 400 28px/28px var(--sans); }
.rec .title { margin: 12px 0 40px; font: 600 28px/42px var(--sans); }
.richText { color: var(--ink); font-family: var(--sans); }
.richText p { font-size: 18px; line-height: 36px; margin: 8px 0 12px; overflow-wrap: anywhere; }
.richText h2 { font-size: 24px; line-height: 36px; font-weight: 600; margin: 40px 0 16px; }
.richText h3 { font-size: 20px; line-height: 30px; font-weight: 600; margin: 36px 0 16px; padding-left: 12px; border-left: 2px solid var(--ink); }
.richText h4 { font-size: 18px; line-height: 30px; font-weight: 600; margin: 24px 0 8px; }
.richText h5 { font-size: 14px; line-height: 1.8; font-weight: 400; color: #555; margin: 48px 0 0; }
.richText hr { border: 0; border-top: 1px solid #ddd; margin: 10px 0; }
.richText strong { font-weight: 600; }
.richText a { color: inherit; text-decoration: underline; }
.richText pre { background: #eee; border-radius: 4px; padding: 25px 35px; margin: 4px 0; overflow-x: auto;
font: 400 16px/24px var(--mono); white-space: pre-wrap; overflow-wrap: anywhere; }
.richText pre code { font: inherit; }
.richText :not(pre) > code { background: #eee; padding: 0 5px; margin: 2px; border: 1px solid rgba(0,0,0,.1); border-radius: 6px; font: 400 18px/36px var(--sans); }
.richText blockquote { margin: 10px 0; padding: 10px 15px; border-left: 3px solid rgba(0,0,0,.15); color: #333; }
.richText blockquote p { font: 400 16px/28.8px 'Noto Sans JP', sans-serif; margin: 10px 0; }
.richText figure { margin: 16px 0; }
.richText figure img { width: 100%; height: auto; }
.richText figcaption:empty { display: none; }
.richText ul, .richText ol { padding-left: 1.5em; }
.richText li { font-size: 18px; line-height: 36px; margin: 10px 0; }
.richText .table { margin: 10px 0; overflow-x: auto; }
.richText table { border-collapse: collapse; width: 100%; font-size: 14px; }
.richText th, .richText td { border: 1px solid var(--line); vertical-align: top; text-align: left; }
.richText th { background: rgba(240,240,240,.6); padding: 24px; font: 400 16px/24px var(--sans); }
.richText td { padding: 16px; font: 400 18px/27px var(--sans); }
.richText th p, .richText td p { margin: 0; font: inherit; }
.richText .embed { margin: 16px 0; }
.richText .embed iframe { display: block; width: 100%; height: 150px; border: 0; }
.richText .video { margin: 16px 0; }
.richText .video video { display: block; width: 100%; height: auto; }
.richText .yt { aspect-ratio: 16 / 9; margin: 16px 0; }
.richText .yt iframe { width: 100%; height: 100%; border: 0; }
.toc { background: #f0f0f0; border-radius: 4px; padding: 20px 20px 8px 8px; margin: 0 0 24px; }
.toc ul { list-style: none; margin: 0; padding: 0; }
.toc li { position: relative; padding-left: 32px; margin: 0 0 16px; font: 400 16px/32px var(--sans); color: var(--ink-2); }
.toc a { text-decoration: none; color: inherit; }
@media (max-width: 767px) {
.rec { max-width: calc(100% - 48px); padding-top: 72px; }
.rec .title { font-size: 24px; line-height: 36px; }
}
</style>
src/pages/pixelstomotors/manga/[slug].astro
---
import MangaPage from '../../../components/MangaPage.astro';
export function getStaticPaths() {
  const all = Object.values(import.meta.glob('../../../data/manga/*.json', { eager: true, import: 'default' })) as any[];
  return all.map((m) => ({ params: { slug: m.slug }, props: { m } }));
}
const { m } = Astro.props;
---
<MangaPage m={m} path={`/pixelstomotors/manga/${m.slug}`} />
src/pages/pixelstomotors/english-4-koma/[slug].astro
---
import MangaPage from '../../../components/MangaPage.astro';
export function getStaticPaths() {
  const all = Object.values(import.meta.glob('../../../data/english/*.json', { eager: true, import: 'default' })) as any[];
  return all.map((m) => ({ params: { slug: m.slug }, props: { m } }));
}
const { m } = Astro.props;
---
<MangaPage m={m} path={`/pixelstomotors/english-4-koma/${m.slug}`} />
src/pages/pixelstomotors/manga-archive.astro
---
import MangaArchive from '../../components/MangaArchive.astro';
import { allManga } from '../../lib/records';
---
<MangaArchive items={allManga} heading="Archive | 4コママンガ" other={{ href: '/pixelstomotors/manga-archive-en', label: 'English 4-Koma' }}
  base="/pixelstomotors/manga" path="/pixelstomotors/manga-archive" />
src/pages/pixelstomotors/manga-archive-en.astro
---
import MangaArchive from '../../components/MangaArchive.astro';
import { allEnglish } from '../../lib/records';
---
<MangaArchive items={allEnglish} heading="Archive | English 4-Koma" other={{ href: '/pixelstomotors/manga-archive', label: '4コママンガ' }}
  base="/pixelstomotors/english-4-koma" path="/pixelstomotors/manga-archive-en" />
src/pages/pixelstomotors/message.astro — メッセージフォーム
---
import Base from '../../layouts/Base.astro';
---
<Base title="Message | メッセージ" description="Pixels to Motors へのお問い合わせ。仕事のご依頼やご相談をお聞かせください。" path="/pixelstomotors/message">
  <section class="msg">
    <div class="msg-lead">
      <h1 class="msg-h">Message | メッセージ</h1>
      <p>Pixels to Motorsにご興味を持っていただきありがとうございます。仕事のご依頼や、ご相談内容をお聞かせください。1〜2営業日以内にお返事いたします。</p>
    </div>
    <form class="msg-form" id="msgForm" novalidate>
      <label>お名前<span class="req">*</span><input name="name" type="text" placeholder="氏名" required autocomplete="name" /></label>
      <label>メールアドレス<span class="req">*</span><input name="email" type="email" placeholder="XXXXXXXX@compay.com" required autocomplete="email" /></label>
      <label>ご相談内容<span class="req">*</span><textarea name="body" rows="9" placeholder="現在〇〇の現場でロボット導入を検討中ですが、シミュレーションでどこまで検証できるか知りたいです」「URDFデータはありますが、Isaac Simへの移行で困っています。" required></textarea></label>
      <label class="agree"><input name="agree" type="checkbox" required />送信をもって<a href="/pixelstomotors/privacypolicy">プライバシーポリシー</a>に同意いただいたものとみなします。</label>
      <button class="send" type="submit"><span class="send-ic"><i class="ms">send</i></span><span class="send-t">送信する</span></button>
      <p class="msg-note" id="msgNote" hidden></p>
    </form>
  </section>
</Base>
<script>
  const form = document.getElementById('msgForm') as HTMLFormElement;
  const note = document.getElementById('msgNote') as HTMLParagraphElement;
  const say = (t: string) => { note.textContent = t; note.hidden = false; };
  form.addEventListener('submit', async (e) => {
    e.preventDefault();
    if (!form.reportValidity()) return;
    const f = new FormData(form);
    const btn = form.querySelector('button')!; btn.disabled = true;
    try {
      const r = await fetch('/api/message', { method: 'POST', headers: { 'content-type': 'application/json' },
        body: JSON.stringify({ name: f.get('name'), email: f.get('email'), body: f.get('body'), agree: f.get('agree') === 'on' }) });
      const d = await r.json();
      if (d.ok) { form.reset(); say('送信しました。1〜2営業日以内にお返事いたします。'); }
      else say(d.error || '送信できませんでした。時間をおいてもう一度お試しください。');
    } catch { say('送信できませんでした。時間をおいてもう一度お試しください。'); }
    btn.disabled = false;
  });
</script>
<style>
  .msg { max-width: 1080px; margin: 0 auto; padding: 104px 24px 104px; display: grid; grid-template-columns: 451px 565px; justify-content: space-between; gap: 40px; }
  .msg-h { margin: 0 0 24px; font: 600 24px/36px var(--sans); }
  .msg-lead p { margin: 0; font: 400 16px/24px var(--sans); }
  .msg-form { display: flex; flex-direction: column; }
  .msg-form label { display: block; margin-bottom: 16px; font: 500 16px/24px var(--sans); }
  .req { color: #ff4000; margin-left: 4px; font: 700 15px/21px var(--sans); }
  .msg-form input[type=text], .msg-form input[type=email], .msg-form textarea { display: block; width: 100%; margin-top: 8px; padding: 8px 12px;
    background: #fdfdfd; border: 1px solid #aeadab; border-radius: 4px; font: 400 14px/21px var(--sans); color: #333; }
  .msg-form textarea { resize: vertical; min-height: 240px; }
  .agree { font: 500 14px/21px var(--sans) !important; display: flex !important; gap: 10px; align-items: flex-start; }
  .agree input { margin-top: 4px; }
  .agree a { color: #097ac1; font-weight: 700; }
  .send { display: flex; align-items: center; justify-content: center; gap: 16px; height: 120px; border: 0; background: transparent; cursor: pointer; }
  .send-ic { width: 60px; height: 60px; border-radius: 50%; background: var(--dark); color: #fdfdfd; display: inline-flex; align-items: center; justify-content: center; }
  .send-ic .ms { font-size: 28px; }
  .send-t { font: 500 14px/22.4px var(--sans); color: var(--ink); }
  .send:disabled { opacity: .5; }
  .msg-note { margin: 0; font: 500 14px/21px var(--sans); color: var(--ink); text-align: center; }
  @media (max-width: 1100px) { .msg { grid-template-columns: 1fr; padding-top: 88px; } }
</style>
src/pages/pixelstomotors/privacypolicy.astro
---
import Base from '../../layouts/Base.astro';
const sections = [
  ['個人情報の管理', '当方は、お客さまの個人情報を正確かつ最新の状態に保ち、個人情報への不正アクセス・紛失・破損・改ざん・漏洩などを防止するため、セキュリティシステムの維持・管理体制の整備徹底等の必要な措置を講じ、安全対策を実施し個人情報の厳重な管理を行ないます。'],
  ['個人情報の利用目的', 'お客さまからお預かりした個人情報は、当方からのご連絡や業務のご案内やご質問に対する回答として、電子メールや資料のご送付に利用いたします。\nまた、お預かりした各種技術データ(CAD、URDF等)は、本サービスの提供およびシミュレーション精度向上のためにのみ使用し、第三者への開示は一切行いません。'],
  ['個人情報の第三者への開示・提供の禁止', '当方は、お客さまよりお預かりした個人情報を適切に管理し、次のいずれかに該当する場合を除き、個人情報を第三者に開示いたしません。\n・お客さまの同意がある場合\n・お客さまが希望されるサービスを行なうために当方が業務を委託する業者に対して開示する場合\n・法令に基づき開示することが必要である場合'],
  ['Cookieについて', 'Cookie(クッキー)とは、お客様のサイト閲覧履歴を、お客様のコンピュータにデータとして保存しておく仕組みです。当サイトでは、第三者配信事業者である「Google広告」を利用しておりますが、Cookieを使用することにより、お客様の過去のアクセス情報に基づいて、適切な広告を配信する場合があります。また、当サイトは、Googleが提供するアクセス解析ツール「Googleアナリティクス」を利用しています。Googleアナリティクスは、Cookieを使用することでお客様のトラフィックデータを収集しています。お客様はブラウザの設定でCookieを無効にすることで、トラフィックデータの収集を拒否することができます。なお、トラフィックデータからお客様個人を特定することはできません。詳しくは<a href="https://marketingplatform.google.com/about/analytics/terms/jp/" target="_blank" rel="noopener">Googleアナリティクス利用規約</a>をご確認ください。'],
  ['個人情報の安全対策', '当方は、個人情報の正確性及び安全性確保のために、セキュリティに万全の対策を講じています。'],
  ['ご本人の照会', 'お客さまがご本人の個人情報の照会・修正・削除などをご希望される場合には、ご本人であることを確認の上、対応させていただきます。'],
  ['法令、規範の遵守と見直し', '当方は、保有する個人情報に関して適用される日本の法令、その他規範を遵守するとともに、本ポリシーの内容を適宜見直し、その改善に努めます。'],
];
const nl = (s: string) => s.replace(/\n/g, '<br>');
---
<Base title="Privacy policy | プライバシーポリシー" description="Pixels to Motors のプライバシーポリシー。" path="/pixelstomotors/privacypolicy">
  <article class="pp">
    <h1 class="pp-h">Privacy policy | プライバシーポリシー</h1>
    <p class="pp-p">Pixels to Motors(以下「当方」といいます。)は、当方の提供するサービス(以下「本サービス」といいます。)における、ユーザーについての個人情報を含む利用者情報の取扱いについて、以下のとおりプライバシーポリシー(以下「本ポリシー」といいます。)を定めます。</p>
    {sections.map(([h, b]) => (<><h2 class="pp-h2">{h}</h2><p class="pp-p" set:html={nl(b)} /></>))}
  </article>
</Base>
<style>
  .pp { width: 620px; max-width: calc(100% - 48px); margin: 0 auto; padding: 104px 0 104px; }
  .pp-h { margin: 0 0 40px; font: 600 24px/36px var(--sans); }
  .pp-h2 { margin: 40px 0 16px; font: 500 18px/27px var(--sans); }
  .pp-p { margin: 0; font: 400 16px/1.6 var(--sans); }
  .pp-p :global(a) { color: #097ac1; text-decoration: underline; }
  @media (max-width: 767px) { .pp { padding-top: 72px; } }
</style>
src/pages/pixelstomotors/mecharm_data_blueprint.astro
---
import Base from '../../layouts/Base.astro';
---
<Base title="Pixels to Motors | mechArm に使っているデータの全体図" description="mechArm 270 Pi に使っているデータ(live / twin / real と pose_id)の全体図。" path="/pixelstomotors/mecharm_data_blueprint">
  <section class="bp">
    <div class="embed"><iframe src="/embeds/mecharm_data_blueprint.html" sandbox="allow-scripts allow-popups allow-popups-to-escape-sandbox" title="mechArm に使っているデータの全体図" data-embed style="height:1200px"></iframe></div>
  </section>
</Base>
<style>
  .bp { padding: 48px 0 0; }
  .bp .embed iframe { display: block; width: 100%; border: 0; }
</style>
見た目と中身を今のサイトと比べるのに使ったスクリプトの全文
Claude の作業環境(Linux)で Playwright を使って動かしました。今のサイトと、手元で作ったページ(127.0.0.1:4321)を同じ条件で開いて読み取ります。
serve.py — 作ったページを手元で開くための小さなサーバー
import http.server, os, sys
root=sys.argv[1]
class H(http.server.SimpleHTTPRequestHandler):
    def __init__(s,*a,**k): super().__init__(*a,directory=root,**k)
    def translate_path(s,path):
        p=super().translate_path(path)
        if os.path.exists(p.rstrip('/')+'.html') and not os.path.isfile(p): return p.rstrip('/')+'.html'
        return p
    def log_message(s,*a): pass
http.server.ThreadingHTTPServer(('127.0.0.1',4321),H).serve_forever()
stylecmp.py — 要素ごとに CSS の計算結果を今のサイトと比べる
import asyncio, json, sys
from playwright.async_api import async_playwright
slug=sys.argv[1]; width=int(sys.argv[2]) if len(sys.argv)>2 else 1440
JS=r"""()=>{const r=document.querySelector('.richText'); const P=['fontFamily','fontSize','fontWeight','lineHeight','color','backgroundColor','marginTop','marginBottom','paddingTop','paddingLeft','borderLeft','borderBottom','letterSpacing','textDecorationLine'];
 const sel={p:'p',h2:'h2',h3:'h3',h4:'h4',h5:'h5',li:'li',ul:'ul',ol:'ol',strong:'p strong',a:'p a',code_inline:'p code',pre:'pre',pre_code:'pre code',table:'table',th:'th',td:'td',blockquote:'blockquote',bq_p:'blockquote p',hr:'hr',figure:'figure',img:'figure img',figcaption:'figcaption',embed:'iframe'};
 const out={}; for(const [k,s] of Object.entries(sel)){ const el=[...r.querySelectorAll(s)].find(e=>!e.closest('nav')&&!e.closest('.toc')&&!e.closest('[data-type=table_of_contents]')); if(!el){out[k]=null;continue}
   const cs=getComputedStyle(el); const o={}; for(const p of P) o[p]=cs[p]; o.w=Math.round(el.getBoundingClientRect().width); out[k]=o;}
 const title=[...document.querySelectorAll('h1,p,div')].find(e=>e.children.length===0&&e.innerText&&e.innerText.startsWith('何本も並行する')); if(title){const cs=getComputedStyle(title); out.title={fontFamily:cs.fontFamily,fontSize:cs.fontSize,fontWeight:cs.fontWeight,lineHeight:cs.lineHeight,color:cs.color}}
 const toc=document.querySelector('.toc a'); if(toc){const cs=getComputedStyle(toc); out.toc_a={fontSize:cs.fontSize,fontWeight:cs.fontWeight,color:cs.color,lineHeight:cs.lineHeight}}
 return out;}"""
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); res={}
        for k,base in (('今','https://adaptdesign.jp'),('新','http://127.0.0.1:4321')):
            pg=await (await b.new_context(viewport={"width":width,"height":900})).new_page()
            await pg.goto(f"{base}/pixelstomotors/record/{slug}",wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(3000)
            res[k]=await pg.evaluate(JS)
        await b.close()
    for key in res['今']:
        a,bb=res['今'].get(key),res['新'].get(key)
        if a is None and bb is None: continue
        if a is None or bb is None: print(f"[{key}] 今:{'あり' if a else 'なし'} 新:{'あり' if bb else 'なし'}"); continue
        diffs={p:(a[p],bb.get(p)) for p in a if a[p]!=bb.get(p)}
        if diffs: print(f"[{key}]", json.dumps(diffs,ensure_ascii=False))
        else: print(f"[{key}] 一致")
asyncio.run(main())
detail.py — 文字のコード・太字・見出し・箇条書きの詳しい値を読む
import asyncio, json, sys
from playwright.async_api import async_playwright
slug=sys.argv[1]
JS=r"""()=>{const r=document.querySelector('.richText');const g=(el,ps)=>{if(!el)return null;const cs=getComputedStyle(el);const o={};for(const p of ps)o[p]=cs[p];return o};
const P=['fontFamily','fontSize','fontWeight','color','backgroundColor','borderRadius','padding','margin','border','webkitFontSmoothing','lineHeight','textDecoration','listStyleType'];
return {body:g(document.body,['webkitFontSmoothing','textRendering','fontFeatureSettings']), rich:g(r,['webkitFontSmoothing','fontWeight','color']),
 code:g(r.querySelector('p code'),P), pre_code:g(r.querySelector('pre code'),P), strong:g(r.querySelector('strong'),P), a:g(r.querySelector('p a'),P),
 h3:g(r.querySelector('h3'),P), li:g(r.querySelector('li'),P), lip:g(r.querySelector('li p'),P), ulli:g(r.querySelector('ul > li'),P), olli:g(r.querySelector('ol > li'),P),
 hr:g(r.querySelector('hr'),P), figcap:g(r.querySelector('figcaption'),P), fig:g(r.querySelector('figure'),P), img:g(r.querySelector('figure img'),P)}}"""
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch()
        for k,base in (('今','https://adaptdesign.jp'),('新','http://127.0.0.1:4321')):
            pg=await (await b.new_context(viewport={"width":1440,"height":900})).new_page()
            await pg.goto(f"{base}/pixelstomotors/record/{slug}",wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(3000)
            print(k, json.dumps(await pg.evaluate(JS),ensure_ascii=False,indent=0))
        await b.close()
asyncio.run(main())
smooth.py — -webkit-font-smoothing の付き方を数える
import asyncio
from playwright.async_api import async_playwright
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await b.new_page()
        for u in ("https://adaptdesign.jp/pixelstomotors","https://adaptdesign.jp/pixelstomotors/record/video-progress-board"):
            await pg.goto(u,wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(2500)
            r=await pg.evaluate("""()=>{const c={};for(const e of document.querySelectorAll('body *')){if(!e.childNodes.length||![...e.childNodes].some(n=>n.nodeType===3&&n.textContent.trim()))continue;const v=getComputedStyle(e).webkitFontSmoothing;c[v]=(c[v]||0)+1}return c}""")
            print(u,r)
        await b.close()
asyncio.run(main())
measure_series.py — シリーズのページの枠の位置と高さを読む
import asyncio, sys, json
from playwright.async_api import async_playwright
JS=r"""()=>{const out=[];
for(const f of document.querySelectorAll('iframe')){const r=f.getBoundingClientRect();out.push({k:'iframe',y:Math.round(r.top+scrollY),x:Math.round(r.left),w:Math.round(r.width),h:Math.round(r.height),src:(f.src||'').slice(0,70)})}
for(const e of document.querySelectorAll('h1,h2,h3,p,span,div')){ if(e.children.length) continue; const t=(e.innerText||'').trim(); if(!t||t.length>80) continue; const r=e.getBoundingClientRect(); if(r.top+scrollY>2600) continue; const cs=getComputedStyle(e); out.push({k:'text',y:Math.round(r.top+scrollY),x:Math.round(r.left),w:Math.round(r.width),t:t.slice(0,40),f:cs.fontSize+' '+cs.fontWeight+' '+cs.lineHeight+' '+cs.color})}
for(const e of document.querySelectorAll('img')){const r=e.getBoundingClientRect(); if(r.top+scrollY>2600||r.width<200) continue; out.push({k:'img',y:Math.round(r.top+scrollY),x:Math.round(r.left),w:Math.round(r.width),h:Math.round(r.height)})}
out.sort((a,b)=>a.y-b.y); return out}"""
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await (await b.new_context(viewport={"width":1440,"height":900})).new_page()
        for path in sys.argv[1:]:
            await pg.goto("https://adaptdesign.jp"+path,wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(3500)
            print('=====',path)
            for o in await pg.evaluate(JS):
                if o['y']<60: continue
                print(o)
        await b.close()
asyncio.run(main())
textblocks.py — プライバシーポリシーとメッセージのページの文字の値を読む
import asyncio, sys, json
from playwright.async_api import async_playwright
JS=r"""()=>{const out=[];
for(const e of document.querySelectorAll('body *')){ if(e.closest('header')||e.closest('footer')) continue;
 const own=[...e.childNodes].some(n=>n.nodeType===3&&n.textContent.trim()); if(!own && !['INPUT','TEXTAREA','BUTTON','IMG','IFRAME'].includes(e.tagName)) continue;
 const r=e.getBoundingClientRect(); if(r.width===0) continue; const cs=getComputedStyle(e);
 out.push({tag:e.tagName,y:Math.round(r.top+scrollY),x:Math.round(r.left),w:Math.round(r.width),h:Math.round(r.height),f:cs.fontFamily.slice(0,20)+' '+cs.fontSize+' '+cs.fontWeight+' '+cs.lineHeight+' '+cs.color,bg:cs.backgroundColor,bd:cs.border.slice(0,40),rad:cs.borderRadius,pad:cs.padding,ph:e.placeholder||'',href:e.href||'',t:(e.innerText||e.value||'').trim().slice(0,60)})}
out.sort((a,b)=>a.y-b.y||a.x-b.x); return out}"""
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await (await b.new_context(viewport={"width":1440,"height":900})).new_page()
        for path in sys.argv[1:]:
            await pg.goto("https://adaptdesign.jp"+path,wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(3500)
            print('=====',path)
            for o in await pg.evaluate(JS):
                if o['y']<50: continue
                print(json.dumps(o,ensure_ascii=False))
        await b.close()
asyncio.run(main())
livefull.py — 今のサイトのページ全体のスクリーンショット
import asyncio, sys
from playwright.async_api import async_playwright
paths=sys.argv[1:]
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch()
        ctx=await b.new_context(viewport={"width":1280,"height":900})
        for path in paths:
            pg=await ctx.new_page()
            await pg.goto("https://adaptdesign.jp"+path,wait_until="domcontentloaded",timeout=90000)
            await pg.wait_for_timeout(4000)
            h=await pg.evaluate("document.documentElement.scrollHeight")
            for y in range(0,h,800):
                await pg.evaluate(f"window.scrollTo(0,{y})"); await pg.wait_for_timeout(250)
            await pg.evaluate("window.scrollTo(0,0)"); await pg.wait_for_timeout(1000)
            name=path.strip('/').replace('/','_') or 'root'
            await pg.screenshot(path=f"shots/live_{name}.png",full_page=True)
            print(name,h)
            await pg.close()
        await b.close()
asyncio.run(main())
newshots2.py — 作ったページのスクリーンショット
import asyncio
from playwright.async_api import async_playwright
paths=['/pixelstomotors','/pixelstomotors/series1','/pixelstomotors/series2','/pixelstomotors/series4','/pixelstomotors/manga-archive','/pixelstomotors/manga/ep122','/pixelstomotors/english-4-koma/ep01','/pixelstomotors/message','/pixelstomotors/privacypolicy','/pixelstomotors/mecharm_data_blueprint','/pixelstomotors/record/day60','/pixelstomotors/record/pi05-mecharm-demo-to-inference']
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); ctx=await b.new_context(viewport={"width":1280,"height":900})
        for path in paths:
            pg=await ctx.new_page(); errs=[]
            pg.on('console', lambda m: errs.append(m.text) if m.type=='error' else None)
            await pg.goto("http://127.0.0.1:4321"+path,wait_until="domcontentloaded",timeout=60000); await pg.wait_for_timeout(2500)
            h=await pg.evaluate("document.documentElement.scrollHeight")
            for y in range(0,min(h,12000),800):
                await pg.evaluate(f"window.scrollTo(0,{y})"); await pg.wait_for_timeout(120)
            await pg.evaluate("window.scrollTo(0,0)"); await pg.wait_for_timeout(600)
            name=path.strip('/').replace('/','_')
            await pg.screenshot(path=f"shots/new_{name}.png",full_page=True)
            errs=[e for e in errs if '/media/' not in e and 'favicon' not in e]
            print(name,h,errs[:3]); await pg.close()
        await b.close()
asyncio.run(main())
chk_embed.py — 枠の中の読み込みとコンソールの出力を見る
import asyncio
from playwright.async_api import async_playwright
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await b.new_page(viewport={"width":1280,"height":900})
        msgs=[]
        pg.on('console', lambda m: msgs.append((m.type,m.text[:160])))
        pg.on('requestfailed', lambda r: msgs.append(('reqfail',r.url[:120]+' '+str(r.failure))))
        await pg.goto("http://127.0.0.1:4321/pixelstomotors/series4",wait_until="load",timeout=60000); await pg.wait_for_timeout(6000)
        for f in pg.frames: print('frame',f.url[:100])
        for m in msgs:
            if '/media/' in m[1]: continue
            print(m)
        await b.close()
asyncio.run(main())
cmp_text.py — 試作の記事 5 本の本文を 1 文字単位で比べる
import asyncio, re, json, unicodedata
from playwright.async_api import async_playwright
import sys
slugs=sys.argv[1:]
JS="""()=>{const r=document.querySelector('.richText')||[...document.querySelectorAll('.richText')][0];
 if(!r) return null; const c=r.cloneNode(true); c.querySelectorAll('nav.toc,[data-type=table_of_contents],.toc').forEach(e=>e.remove());
 return {text:c.innerText, pre:[...r.querySelectorAll('pre')].map(p=>p.innerText), tables:r.querySelectorAll('table').length, h2:[...r.querySelectorAll('h2')].map(h=>h.innerText.trim()), imgs:r.querySelectorAll('img').length, iframes:r.querySelectorAll('iframe').length}}"""
def norm(s): return re.sub(r'\s+','',unicodedata.normalize('NFKC',s or ''))
async def main():
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await (await b.new_context()).new_page()
        for s in slugs:
            out={}
            for k,base in (('old','https://adaptdesign.jp'),('new','http://127.0.0.1:4321')):
                await pg.goto(f"{base}/pixelstomotors/record/{s}",wait_until="networkidle",timeout=90000)
                out[k]=await pg.evaluate(JS)
            o,n=out['old'],out['new']
            import difflib
            lo=[norm(x) for x in o['text'].split('\n') if norm(x)]; ln=[norm(x) for x in n['text'].split('\n') if norm(x)]
            to,tn=''.join(lo),''.join(ln)
            diffs=[l[:70] for l in difflib.unified_diff(lo,ln,lineterm='',n=0) if l[:1] in '+-' and not l.startswith(('+++','---'))]
            pre_ok=sum(1 for a,bb in zip(o['pre'],n['pre']) if a.rstrip()==bb.rstrip())
            print(f"== {s}: 文字数 今{len(to)} 新{len(tn)} 差分{len(diffs)}箇所 / コード {pre_ok}/{len(o['pre'])}一致(新{len(n['pre'])}) / 表 今{o['tables']} 新{n['tables']} / 見出し 今{len(o['h2'])} 新{len(n['h2'])} / 画像 今{o['imgs']} 新{n['imgs']} / 枠 今{o['iframes']} 新{n['iframes']}")
            for d in diffs[:6]: print("   ",d)
            for i,(a,bb) in enumerate(zip(o['pre'],n['pre'])):
                if a.rstrip()!=bb.rstrip():
                    dd=[l[:80] for l in difflib.unified_diff(a.split('\n'),bb.split('\n'),lineterm='',n=0) if l[:1] in '+-' and not l.startswith(('+++','---'))]
                    print('    code',i,len(a),len(bb),dd[:3])
        await b.close()
asyncio.run(main())
cmp2.py — 長い本文の差分(diff-match-patch)
import asyncio, re, sys, unicodedata
from diff_match_patch import diff_match_patch
from playwright.async_api import async_playwright
JS="""()=>{const r=document.querySelector('.richText'); if(!r) return null; const c=r.cloneNode(true);
 c.querySelectorAll('nav.toc,[data-type=table_of_contents],.toc').forEach(e=>e.remove()); return c.innerText}"""
def norm(s): return re.sub(r'\s+','',unicodedata.normalize('NFKC',s or ''))
async def main():
    dmp=diff_match_patch(); dmp.Diff_Timeout=20
    async with async_playwright() as p:
        b=await p.chromium.launch(); pg=await (await b.new_context()).new_page()
        for s in sys.argv[1:]:
            t={}
            for k,base in (('old','https://adaptdesign.jp'),('new','http://127.0.0.1:4321')):
                await pg.goto(f"{base}/pixelstomotors/record/{s}",wait_until="domcontentloaded",timeout=90000); await pg.wait_for_timeout(2500)
                t[k]=norm(await pg.evaluate(JS))
            d=dmp.diff_main(t['old'],t['new']); dmp.diff_cleanupSemantic(d)
            ch=[(op,x) for op,x in d if op!=0]
            print(f"== {s}: 今{len(t['old'])}字 新{len(t['new'])}字 違い{len(ch)}箇所")
            for op,x in ch[:12]: print('   ', '今だけ' if op<0 else '新だけ', x[:90])
        await b.close()
asyncio.run(main())
照合に使った短いスクリプト(そのまま実行したもの)
サイトマップの 553 件が全部あるかを確かめたものです。
import re,os
s=open('sm_all.xml').read()
urls=[u for u in re.findall(r'<loc>([^<]+)</loc>',s) if '/pixelstomotors' in u]
miss=[]
for u in urls:
    p=u.replace('https://adaptdesign.jp','')
    f='dist'+p+'.html'
    if not os.path.exists(f): miss.append(p)
print(len(urls),'missing',len(miss),miss[:10])
本文・タイトル・説明文の照合です。
import re,html,glob,json,os
def text_of(h):
h=re.sub(r'<script.*?</script>|<style.*?</style>','',h,flags=re.S)
t=html.unescape(re.sub(r'<[^>]+>','',h))
return re.sub(r'\s','',t)
bad=[]
for kind,sub in (('record','record'),('manga','manga'),('english','english-4-koma')):
for f in glob.glob(f'/home/claude/live/cms/{kind}/*.json'):
it=json.load(open(f))['item']; slug=it['slug']
if kind=='record' and not os.path.exists(f'src/data/records/{slug}.json'): continue
live=text_of(re.sub(r'<div data-type="embed_code".*?</div>','',it['body'] or '',flags=re.S))
new_html=open(f'dist/pixelstomotors/{sub}/{slug}.html',encoding='utf-8').read()
cls='richText' if kind=='record' else 'mbody'
m=re.search(rf'<div class="{cls}"[^>]*>(.*?)</article>',new_html,re.S)
new=text_of(re.sub(r'<nav class="toc">.*?</nav>','',m.group(1),flags=re.S))
if live!=new: bad.append((kind,slug,len(live),len(new)))
print('本文不一致',len(bad),bad[:10])
bad2=[]
for kind,sub in (('record','record'),('manga','manga'),('english','english-4-koma')):
for f in glob.glob(f'/home/claude/live/cms/{kind}/*.json'):
it=json.load(open(f))['item']; slug=it['slug']
h=open(f'dist/pixelstomotors/{sub}/{slug}.html',encoding='utf-8').read()
if html.escape(it['title'],quote=False).replace('"','"') not in h and it['title'] not in html.unescape(h): bad2.append((kind,slug,'title'))
desc=it.get('WtD0MT_q') or it.get('LRhqVKVx') or ''
if desc and desc not in html.unescape(h): bad2.append((kind,slug,'desc'))
print('タイトル・説明の不一致',len(bad2),bad2[:10])
画像・動画・図解・YouTube の数の照合と、参照している画像の一覧です。
import re,glob,json,os,urllib.parse
bad=[];tot={'img':0,'video':0,'embed':0,'yt':0}
for f in glob.glob('/home/claude/live/cms/record/*.json'):
    it=json.load(open(f))['item']; slug=it['slug']
    if not os.path.exists(f'src/data/records/{slug}.json'): continue
    b=it['body']
    nimg=len(re.findall(r'<img ',b)); nvid=len(re.findall(r'<video ',b))
    embeds=re.findall(r'<div data-type="embed_code"([^>]*)>(.*?)</div>',b,re.S)
    ne=0;ny=0
    for a,inner in embeds:
        code=urllib.parse.unquote(inner.strip())
        if not code.strip(): continue
        if 'data-embed-code-type="youtube"' in a and re.search(r'(?:youtu\.be/|v=|embed/)([\w-]{11})',code): ny+=1
        else: ne+=1
    h=open(f'dist/pixelstomotors/record/{slug}.html',encoding='utf-8').read()
    m=re.search(r'<div class="richText"[^>]*>(.*?)</article>',h,re.S).group(1)
    got=(len(re.findall(r'<img ',m)),len(re.findall(r'<video ',m)),len(re.findall(r'src="/embeds/',m)),len(re.findall(r'youtube-nocookie',m)))
    exp=(nimg,nvid,ne,ny)
    if got!=exp: bad.append((slug,exp,got))
    for k,v in zip(tot,exp): tot[k]+=v
print(tot,'不一致',bad)
refs=set()
for f in glob.glob('dist/**/*.html',recursive=True):
    refs|=set(re.findall(r'/media/([^"\'\s)]+)',open(f,encoding='utf-8').read()))
for f in glob.glob('public/embeds/*.html')+glob.glob('public/thumbs/*.html'):
    refs|=set(re.findall(r'/media/([^"\'\s)]+)',open(f,encoding='utf-8').read()))
print('media refs',len(refs))
open('media_refs.txt','w').write('\n'.join(sorted(urllib.parse.unquote(r) for r in refs)))
R2 に入っているものと、参照の一覧を突き合わせます(Mac で実行。鍵は KIOXIA から読みます)。
T=$(tr -d ' \r\n' < "$HOME/mnt/KIOXIA/p2m_cloudflare_token.txt"); A=21d7aed1b193796b89287df10913f2dc
curl -s -H "Authorization: Bearer $T" "https://api.cloudflare.com/client/v4/accounts/$A/r2/buckets/p2m-media/objects?per_page=1000" > /tmp/r2a.json
curl -s -H "Authorization: Bearer $T" "https://api.cloudflare.com/client/v4/accounts/$A/r2/buckets/p2m-media/objects?per_page=1000&cursor=$(python3 -c "import json;print(json.load(open('/tmp/r2a.json')).get('result_info',{}).get('cursor',''))")" > /tmp/r2b.json
python3 - <<'PY'
import json,os
keys=set()
for f in ('/tmp/r2a.json','/tmp/r2b.json'):
    d=json.load(open(f)); keys|={o['key'] for o in d.get('result',[])}
refs=set(open(os.path.expanduser('~/mnt/KIOXIA/_p2m_transfer/media_refs.txt')).read().split('\n'))-{''}
print('R2',len(keys),'refs',len(refs),'missing',sorted(refs-keys))
PY
出力です。
R2 1047 refs 1004 missing ['GOFE-Can-Close-the-100000-Year-Robot-Data-Gap-Science-Robotics-Aug-2025-scirobotics.aea7390.pdf', 'column/mcs_blog/20260316.html']
鍵をかけたあとの確認です。
for p in /pixelstomotors /media/s-1080x1350_v-fms_webp_72ffa290-8ff8-45cf-9bfb-d3b602843ce0.png /api/message; do curl -s -o /dev/null -w "$p %{http_code}\n" https://p2m-site.pixelstomotors.workers.dev$p; done
R2 のバケットを作ったときのコマンドです(Mac で実行)。
T=$(tr -d ' \r\n' < "$HOME/mnt/KIOXIA/p2m_cloudflare_token.txt"); A=21d7aed1b193796b89287df10913f2dc
curl -s -X POST -H "Authorization: Bearer $T" -H 'Content-Type: application/json' -d '{"name":"p2m-media","locationHint":"apac"}' https://api.cloudflare.com/client/v4/accounts/$A/r2/buckets
curl -s -X POST -H "Authorization: Bearer $T" -H 'Content-Type: application/json' -d '{"name":"p2m-messages","locationHint":"apac"}' https://api.cloudflare.com/client/v4/accounts/$A/r2/buckets
{"success":true,"errors":[],"messages":[],"result":{"name":"p2m-media","creation_date":"2026-10-16T06:01:57.430Z","location":"APAC","storage_class":"Standard","jurisdiction":"default"}}
{"success":true,"errors":[],"messages":[],"result":{"name":"p2m-messages","creation_date":"2026-10-16T06:17:29.709Z","location":"APAC","storage_class":"Standard","jurisdiction":"default"}}
文字の太さと色を比べた実測の出力
stylecmp.py の出力です(直す前・記事 video-progress-board・幅 1440px)。左が今のサイト、右が新しいサイトです。一致した要素は「一致」とだけ出ます。
[p] {"fontFamily": ["Inter, \"Noto Sans JP\"", "Inter, \"Noto Sans JP\", sans-serif"]}
[h2] {"fontFamily": [...], "marginTop": ["4px", "40px"]}
[h3] {"lineHeight": ["30px", "32px"], "marginTop": ["36px", "32px"], "marginBottom": ["16px", "12px"], "paddingLeft": ["12px", "0px"], "borderLeft": ["2px solid rgb(36, 36, 36)", "0px none rgb(36, 36, 36)"]}
[li] {"lineHeight": ["36px", "32px"], "marginTop": ["10px", "0px"], "marginBottom": ["10px", "0px"], "w": [600, 596]}
[strong] 今:あり 新:なし
[code_inline] {"fontFamily": ["Inter, \"Noto Sans JP\"", "Menlo, Monaco, \"Courier New\", monospace"], "fontSize": ["18px", "16.2px"], "lineHeight": ["36px", "normal"], "marginTop": ["2px", "0px"], "marginBottom": ["2px", "0px"], "paddingTop": ["0px", "1px"], "paddingLeft": ["5px", "4px"], "borderLeft": ["1px solid rgba(0, 0, 0, 0.1)", "0px none rgb(36, 36, 36)"], "borderBottom": ["1px solid rgba(0, 0, 0, 0.1)", "0px none rgb(36, 36, 36)"], "w": [611, 596]}
[pre] 一致
[pre_code] {"w": [548, 544]}
[blockquote] {"fontFamily": ["\"Noto Sans JP\"", "Inter, \"Noto Sans JP\", sans-serif"], "lineHeight": ["28.8px", "normal"], "borderLeft": ["3px solid rgba(0, 0, 0, 0.15)", "4px solid rgb(221, 221, 221)"]}
[bq_p] {"fontFamily": ["\"Noto Sans JP\"", "Inter, \"Noto Sans JP\", sans-serif"], "marginTop": ["10px", "0px"], "marginBottom": ["10px", "0px"], "w": [587, 586]}
[toc_a] 一致
smooth.py の出力です。文字のある要素のうち、細めに描く指定(antialiased)が付いているものの数です。
https://adaptdesign.jp/pixelstomotors {'auto': 9, 'antialiased': 56}
https://adaptdesign.jp/pixelstomotors/record/video-progress-board {'auto': 9, 'antialiased': 613}
直したあとの stylecmp.py の出力です。残っているのは幅の数 px の差(スクロールバーの分)と、h2 の上の余白だけです。
[p] {}
[h2] {"marginTop": ["4px", "40px"]}
[h3] {"borderBottom": ["0px solid rgb(36, 36, 36)", "0px none rgb(36, 36, 36)"]}
[li] {"w": [600, 596]}
[strong] 今:あり 新:なし
[code_inline] {"w": [607, 602]}
[pre] 一致
[pre_code] {"w": [548, 544]}
[th] {"w": [105, 108]}
[td] {"w": [105, 108]}
[blockquote] {"fontFamily": ["\"Noto Sans JP\"", "Inter, \"Noto Sans JP\", sans-serif"], "lineHeight": ["28.8px", "normal"]}
[title] {}
[toc_a] 一致
([strong] 今:あり 新:なし は、比べた位置の段落に太字がなかったという意味で、見た目の差ではありません。h2 の上の余白は、今のサイトでは目次の直後の h2 を測っていて、新しいサイトでは本文の途中の h2 を測っていたため値が違います。)
シリーズ 1 のページの枠の位置と高さです(measure_series.py の出力の一部)。この高さをそのままシリーズのページに使いました。
===== /pixelstomotors/series1
{'k': 'text', 'y': 136, 'x': 112, 'w': 569, 't': 'Drug Delivery Robot |\xa0薬剤搬送ロボットハコブくん', 'f': '24px 600 36px rgb(36, 36, 36)'}
{'k': 'iframe', 'y': 216, 'x': 112, 'w': 1216, 'h': 800, 'src': 'https://embed.figma.com/design/gDAJCTN8VCdVUwJHrQ5N7z/...'}
{'k': 'iframe', 'y': 1060, 'x': 112, 'w': 1216, 'h': 1280, 'src': 'https://embed.figma.com/design/gDAJCTN8VCdVUwJHrQ5N7z/...'}
{'k': 'text', 'y': 2380, 'x': 112, 'w': 1216, 't': 'スプレッドシート/進捗管理', 'f': '16px 500 24px rgb(36, 36, 36)'}
{'k': 'iframe', 'y': 2420, 'x': 112, 'w': 1216, 'h': 640, 'src': 'https://docs.google.com/spreadsheets/d/e/2PACX-1vQnqeo6YmdjAz9VQiH8-PY'}
{'k': 'iframe', 'y': 3140, 'x': 112, 'w': 1216, 'h': 480, 'src': 'https://p6aoj4vyqr.studioiframesandbox.com/'}
{'k': 'iframe', 'y': 3700, 'x': 112, 'w': 1216, 'h': 1280, 'src': 'https://p6aoj4vyqr.studioiframesandbox.com/'}
{'k': 'iframe', 'y': 5020, 'x': 112, 'w': 1216, 'h': 1280, 'src': 'https://p6aoj4vyqr.studioiframesandbox.com/'}
codex の検証報告の全文(2026-10-16 朝・計画書に対する敵対的検証)
計画書 research_site_migration_plan_20261016.md を渡し、「計画のどこが間違っているか」だけを探させたときの報告です。設定は何も変えず、公開ページの取得と DNS の照会だけで書かれています。見出しの階層は記事に合わせて 2 段下げています。
13443 codex_request_site_migration_20261016.md
120161 total
総合判定:案4「adaptdesign.jp全体を静的サイトへ移す」は、長期候補として条件付きで支持する。現計画のままの切替は❌ NG。
DNSSEC、旧IPへの復旧、最新記事の取込み、公開承認・画像アップロードの順序を修正すること。案1との総作業時間比較前に「一番手間が少ない」とは決められない。
外部設定は変更していない。GETとローカル読取りで検証し、ブラウザ試験は /tmp のローカル環境だけで行った。
adaptdesign.jp 移行計画の敵対的検証
検証日:2026-10-16(JST)。対象:research_site_migration_plan_20261016.md。計画書・依頼書・MASTER・article_rules・アーカイブを読んだ。計画書やアーカイブの集計表を証拠として再利用するだけでなく、サイトマップXMLの再帰走査、公開HTMLの再取得、ディレクトリの独立走査、CMS本文文字列の照合を行った。
ネットワークは使用可能。ただしcrt.shはタイムアウト、汎用RDAPは404、Cloudflare側DoHの補助照会は400だった。これらを成功扱いしない。CTはCert Spotterの公開GETで補完した。JPRSはGETで照会結果を取得できた。契約画面・DNS管理画面・CMS編集画面・GitHubの非公開設定には入っていない。メール送受信、Studioへの下書き作成、Cloudflareデプロイは「変更禁止」に従い未実施。
主要な実測結果
実行:/Users/shimazueiichi/.cache/codex-runtimes/codex-primary-runtime/dependencies/python/bin/python3 /tmp/site_migration_audit.py、続けて付録の phase2・followup・local・semantics・delta・finalchecks を実行。初回の集計がサイトマップ索引6本だったことを確認し、索引をページ数に数えず、子XMLを再帰取得して訂正した。アーカイブのHTMLも直下ではなく再帰で数えた。以下は訂正後の確定値。
| 検査 | 実測 |
|---|---|
| サイトマップ | 索引1本+子XML6本、URL重複なしの578件 |
| Pixels to Motors | 553件=記事346+日本語4コマ99+英語4コマ95+固定13 |
| それ以外 | 25件=実績15+タグ8+/2+実績一覧1 |
| HTTP応答 | 578/578が200。初回5件の通信失敗は再GETで200を確認 |
| アーカイブ原HTML | 再帰で546ファイル |
| 既存CMS本文 | raw/cms内533件すべてについて、元のbody文字列が現在の該当ページのNuxtデータ配列に存在。本文文字列に差分なし。ただしタイトル・設定・画像まで一致する検査ではない |
| 10/12からの増分 | 新記事7件。日本語・英語4コマの件数は同じ |
| 転送 | 28件すべて初段301(/blog/06のみ通信失敗後に再確認)。最終到達先200は6件、404は22件 |
| 図解等 | 記事内303 HTML、うちscriptあり239。固定ページ内にも別に9 HTML、うちscriptあり1。サイト全体では312/240 |
| サムネイル | thumbnail.htmlは46件 |
| content配下の画像・動画 | 988ファイル、414,010,781 bytes。記事・マンガ部分は977ファイル=画像973+動画4。固定部分は11=画像9+動画2。_common直下など images/ 外のファイルはこの数に含めない |
| 最大ファイル | LOG330動画29,768,676 bytes。25 MiB(26,214,400 bytes)を超える |
| 空フォルダ | 548個、すべて末尾「 2」。削除していない |
| 構造化データ | 現公開HTMLで543ページにJSON-LD。アーカイブでは536。新記事7件増と整合 |
| 原HTML内のcanonical/hreflang | 両方0件。ただしcanonicalはStudio公式がブラウザ描画時挿入と明記。未設定と断定しない |
| 英語4コマのhtml lang | 95/95が初期応答ではja。新サイトで機械的にコピーするべき値ではない |
| 記事置場の「516本」 | アーカイブのarticles/は516ファイル=MD200+HTML293+画像23。「516記事」ではない。現在Mac側の同フォルダは501ファイル。GitHubの現在の正本件数は未確認 |
DNSの再照会結果
GET例:https://dns.google/resolve?name=adaptdesign.jp&type=DS&do=true。付録スクリプトはNS/A/AAAA/MX/TXT/CAA/DS/SOA/HTTPS、www、DKIM、DMARC、MTA-STS、TLS-RPT、mediaを個別照会した。DNSの値は公開情報だが、検証TXTの値とDKIM公開鍵の全文は不要なため掲載しない。
| 対象 | 結果 |
|---|---|
| NS | ns-cloud-c1〜c4.googledomains.com、観測TTL21600秒 |
| A | 35.194.122.208、TTL14400秒 |
| AAAA・CAA・HTTPS | NOERROR/該当Answerなし |
| MX | Googleの5件(優先1/5/5/10/10)。観測時の残存TTL2412秒。署名に記載の元TTLは14400秒 |
| TXT | SPF v=spf1 include:_spf.google.com ~all、Google確認1、Brave確認1。TXT計3件 |
| google._domainkey | DKIM1/RSA公開鍵あり、TTL14400秒 |
| _dmarc・www・_mta-sts・_smtp._tls・media | NXDOMAIN。照会したレコードの範囲でなし |
| DS | 存在。key tag10579、algorithm8、digest type2、TTL7200秒。応答AD=true |
| SOA | serial7、refresh21600、retry3600、expire259200、negative TTL300 |
TTLはキャッシュ残存時間を含む観測値であり、親JPゾーンの委任NS TTLやレジストラの処理時間を確定したものではない。「6時間待てば必ず切替完了」とは言えない。
A. 公式仕様の再確認
A1 ❌ NG:外部書込み手段が「一切ない」は誤り。継続APIとは分ける
証拠:WordPressからStudioへCMSデータをインポート、2026-06-16。公式にXMLインポートがある。「インポートごとに新しいモデル」「既存モデルを指定できない」「下書き」「埋め込み全般などは反映されない」と説明される。CSVや一般の他サービス形式は未対応。これは日々の既存記事upsert APIと同じではない。
Studio.Assistantはヒアリングからサイト生成・エディタへの書き出し。2026年9月更新まとめとCMS/APIの公式説明も確認したが、既存Studio CMSへ外部Claudeが継続的に作成・更新できる汎用の公式REST API/MCP/Zapier書込み連携は、読んだ範囲では発見できなかった。「存在しない」の網羅証明ではない。
修正:「WordPress用インポートはあるが、既存モデルに日々入稿する公式APIは確認できていない」とする。WordPress形式への変換で自動入稿できると飛躍もしない。埋め込み欠落・モデル増加・手作業の公開があり、現要件への代替には未検証。
A2 ⚠️ 要注意:転送機能の大枠は正しいが、CMS転送元は未証明
証拠:公式リダイレクトはBusiness以上/旧全プラン、具体的なパスごとの作成、使用中パスとの重複不可。ワイルドカードに使う * や : も新規パスの禁止記号。公式FAQには複数ページをまとめる一括設定はできないと明記される。CMSテンプレートのタイプ変更による一括転送や、既存の各CMSスラッグを重ねて転送ページにできるという公式保証は確認できなかった。Studio標準でのCSV一括登録も未確認。
修正:静的ページ転送と動的なCMSルーティングを分ける。「CMSの転送元を作れる」前提にしない。ただし後述C3の外部HTTP振り分けまで不可能としない。
A3 ⚠️ 要注意:APIプラン制限は一致。本文の完全再現は未確認
証拠:Data Connect API、2026-09-03。Businessは一覧1つ・詳細不可、Plus以上は両方無制限。JSON本文body/contentをリッチテキストボックスに結ぶ説明がある。一般の外部本文を全く表示できないという判定は誤り。ただし任意のscript・iframe・コード・結合表を一切変換せず再現する保証はない。設定保存で公開サイトに即時反映される点も、承認前の更新に注意。
修正:コード・表・YouTube・インタラクティブHTMLを含む代表3記事の別環境試験を採用条件にする。GitHubのraw MDはそのままJSON詳細APIではなく、変換・slug一覧・公開日時・画像URL・キャッシュ更新の仕組みが必要。既存旧Beta APIを下位プランで新規利用できるとは扱わない。
A4 ✅ OK:段階2のDNS-onlyは公式と一致。プロキシには別契約
証拠:指定されたCloudflareヘルプは「Studio指定IPをAに直接設定」「DNS only」が標準要件。Proxy有効だと検証・TLS発行更新失敗の可能性。Custom ProxyはBusiness Plus以上の追加契約で月39,800円税込。無契約でCDN/リバースプロキシを前段に置く配信はサポート対象外。
判定の範囲:DNSの権威サーバーをCloudflareにすること自体と、HTTPをCloudflareで中継することは別。段階2を「DNSのみ」にする方針に衝突は見つからない。ただしDNSSECや他のDNS誤設定が安全になるという意味ではない。A値は既存接続を保つ範囲と、再接続時の新IP要件を分ける(F2)。
A5 ⚠️ 要注意:Dropは候補から完全除外するほど弱い発表ではない
証拠:公式発表は2026年8月発表、9月1日クローズドβ事前登録開始。製品サイトにはURLから既存サイトを移す説明と、Claude/CodexのMCPで記事更新できる説明がある。計画書の「既存サイトから移れるか不明」は、少なくとも移行を謳っている事実を落としている。
修正:発表/実使用を区別し、候補表に残す。現在も招待の段階であり、価格、利用開始可能日、全553ページ・CMS・旧URL・図解・デザインの忠実度を保証する仕様は未確認。アカウント作成・登録はしていない。確定スケジュールの依存先にはできないが、案1試験と並行して提供条件を確認する価値がある。
A6 ⚠️ 要注意:現サイトは旧基盤と判定できる。2027年に強制移行とは言えない
証拠:取得HTMLのgeneratorは Studio.Design、__NUXT_DATA__ とNuxt配信がある。新基盤の公式確認方法は Studio.Design.HRC で、現在のHTMLにはない。基盤切替の公式ヘルプと、旧IPでは新基盤を保存できないとする旧IPヘルプも整合する。旧IPの事実だけで基盤を同一視せず、両方を根拠にした。
修正:第三者記事の[確認済み]を公式へ差し替える。旧基盤の強制切替は現時点でない。2027年1月末は旧基盤へ戻せる期間の目安としても出てくるため、「その日までに外へ移らなければならない」と結論づけない。
A7 ⚠️ 要注意:数値は概ね一致。Workers・Pages・R2の制約を混ぜない
証拠:
- Workers Builds:Free3000分/月、同時1、20分/回。
- Workers制限:Free2万静的ファイル/版、1個25MiB。Paidはファイル数10万。最大動画29,768,676 bytesは静的配置に入らない。
- 静的配信:静的アセットへのリクエストは無料・無制限。Workerコードの実行は別で、Free10万/日。
run_worker_firstの設定次第で静的ページもコードを通る。 - プレビューとブランチビルド:FreeでWorker当たり100プレビュー、各100デプロイ、ブランチ別URLあり。2026-09/10の更新で、計画書の未確認事項を公式仕様として解消できる。ただし自分のアカウントでの構築試験は未実施。
- R2料金:Standard10GB-month、Class A月100万、Class B月1000万。転送料無料とGET無制限は違う。
- Pagesのapex接続はCloudflare NSを要する。サブドメインなら外部DNSからCNAME可。Workers Custom DomainはactiveなCloudflare zoneが必要。無料の通常フルセットアップを前提とし、有料partial DNSの例外まで「絶対に不可能」とは言わない。
修正:新規の第一候補はAstroのSSG+Workers Static Assets。SSRや常時Worker実行は導入しない。PagesもFree500ビルド/月で日次更新には足りる候補であり不適格ではない。既存運用知識・保守負担で選ぶ。どちらでも最初に試作の実出力ファイル数、ビルド時間、プレビュー運用を測る。
A8 ⚠️ 要注意:Vercelの除外は妥当。他社を比較しても「Cloudflareだけ」とはならない
証拠:Vercel Hobby/公式料金は個人・非商用。ADAPT DESIGNの事業サイト全体には採用しない。GitHub Pages利用制限にはオンラインビジネス等への無料ホスティング制限があり、事業サイト用途の判断を省けない。研究資料公開自体を一律に商用禁止とはしない。
Netlify新料金ではFree300 credits/月、本番成功デプロイ15 credits、プレビューは無料。日次30回の本番公開だけで450 creditsになり、現行Freeのまま毎日公開する比較ではCloudflareを覆さない。旧契約条件は別。
修正:比較表にPagesとNetlifyを入れ、Cloudflareの優位を「今回の更新頻度・静的配信条件」に限定する。DNS移行を避けるため有料ホスティングを選ぶ案も、初期移行リスクと合わせて判断する。
B. 現状の実測と不足
B1 ❌ NG:DNSSECを落としている。公開DNSだけで全レコードを保証できない
証拠:上のDoH表でDSを検出。NS/MX/SPF/DKIM等は計画と概ね一致。DNSSEC有効なのでDSを残したNS変更は検証失敗の原因になる。Cloudflare DNSSECは旧DS TTL失効前の変更でSERVFAILになると説明する。
CTは https://crt.sh/?q=%25.adaptdesign.jp&output=json がタイムアウト。代わりに https://api.certspotter.com/v1/issuances?domain=adaptdesign.jp&include_subdomains=true&expand=dns_names をGETし3証明書、SANはすべてapexだけだった。現在の未失効証明書検索の結果であり、全履歴・証明書を使わないサブドメインを網羅しない。
修正:段階0にDS/DNSKEY/CDSと親ゾーンの確認、全ゾーンエクスポート、委任NS、ワイルドカード、メール用別selector・SRVなどを追加。通常の公開DNS照会で「計画にないレコードは一切ない」と証明しない。今回NXDOMAINだった名前を新たに作る必要もない。
B2 ⚠️ 要注意:登録事業者は未確認。期限とDNSSECは確認できた
証拠:JPRSの https://whois.jprs.jp/?type=DOM&key=adaptdesign.jp をGET。Active、有効期限2026/11/30、Signing Key10579・algorithm8、Google系NS。公開された結果から管理指定事業者・請求先までは確定できなかった。Google系NSだからSquarespaceだとは断定しない。JPRSはレジストリであり、購入先の証明でもない。
修正:管理画面で指定事業者、NS編集・DS編集の可否、更新日、自動更新・支払状態を確認するまで段階2に進まない。ドメイン移管はDNS変更の必須条件ではない。2026/11/30の更新と移行を重ねる必要はない。
B3 ❌ NG:546ではなく553。全サイト578を基準に取り直す
証拠:子サイトマップ6本をXMLの名前空間を解釈して数え、578 URLをGETして200。内訳は冒頭表。7件の新規URLは後掲。/2 は公開中だが、サイトマップにも存在しており「サイトマップ外の発見」とは扱わない。旧転送URLはサイトマップ外にある。
修正:固定の546を合格基準にせず、切替直前のURL台帳を凍結して比較する。サイトマップ外URLの全探索は未完了(初期HTMLにはJS描画後のリンクが揃わない)。公開サイト内のリンク、Search Consoleの既存URL、アクセスログ、旧転送を別集合にする。
B4 ⚠️ 要注意:大小文字は同じ扱いではない。canonicalは描画後に確認する必要
証拠:初段GETで /pixelstomotors・同/付き・?audit=1は200、大文字 /PIXELSTOMOTORS は404。HTTPはHTTPSへ301、/ は実績一覧へ301。初期HTMLのcanonicalは0だが、Studio公式はブラウザでのレンダリング時挿入と説明。今回のGET限定検査では現在の描画後canonicalの実値は未確認。ソース0件を「canonicalなし」と誤判定しない。
修正:新サイトは既存の大小文字を維持し、通常ページは末尾なしcanonicalを初期HTMLへ生成、/のみ末尾あり。末尾ありを301/308でなしへ統一するなら「全URLが200」という判定を「正規URL200、別表記は期待する1回転送」に変更する。クエリの計測値を壊さずcanonicalからは除外する。Astroの trailingSlash とCloudflareのHTML handlingを両方明示する。
B5 ❌ NG:28件の転送先のうち22件は現在404
証拠:28元URLの初段を、リダイレクトを追わないGETで測定。全件301(1件再試行)。/blog/merit_and_demerit → /usefulinformationlist/merit_and_demerit →404、/usefulinformationlist/Sticky → /usefulinformationlist/sticky →404など。6件は最終200。全件表を後掲。
修正:28行をそのまま複製するのではなく、元記事が残っているか、同等の移行先があるかをURL別に判断する。対応記事へ301、廃止確定なら404/410。無関係なトップへの一括転送で誤魔化さない。移行後は元URL・ステータス・最終URL・本文の一致を試験する。
B6 ⚠️ 要注意:IDのコピーだけで計測・外部機能は再現できない
証拠:公開HTMLのNuxtデータにgoogle-analytics、google-tag-manager、search-console、custom-code、TypeSquareの登録がある。登録にはTypeSquareの unused もあり、文字列の存在は実通信/実使用の証拠ではない。図解HTMLから外部フォント参照228件、root-relative script1件を独立検出。初期HTMLのformタグが0でも、JS描画後もフォームなしとは証明しない。
修正:GTMのSPA用履歴変更トリガーとGA直貼りの二重送信を点検し、静的遷移でpage_viewが1回になることを別途試験する。サイト内絞込み、もっと見る、目次、ソーシャルリンク、動画、埋め込み、フォントは機能台帳にする。外部呼出先のURL検出と実行時通信の棚卸しを区別する。GET限定のため実サイトの解析ビーコンは送信していない。
B7 ⚠️ 要注意:外部参照は実在。Google所有URLの転送権は引き継げない
証拠:アーカイブの code/r2r2r-content/articles/DAY111_state_machine.html にStudioストレージ参照がある。Mac側 /Users/shimazueiichi/r2r2r-content/articles/DAY111_state_machine.html も276・322・326・330・334・338・354・363・372・381・390行に参照を検出。本文用MDだけを調べると図解の参照を落とす。共通head・assets・header・デザインJSONにも参照が残る。
修正:新サイト内・図解・OGPの参照を書換え、Google旧URL→自分の新URLの対応表を作る。ただしGoogleストレージの旧URL自体をR2側から301にはできない。SNS・YouTubeの過去説明文など全外部参照は未確認。プラン解約で旧画像が直ちに消える公式根拠も、永久に残る保証も確認できない。解約・非公開・削除を分け、外部参照の扱いが決まるまで資産を消さない。
C. 不採用案を採用側から再評価
C1 ⚠️ 要注意:案1の短期総工数が小さい可能性は残る
証拠:StudioのMarkdownヘルプと本文編集に見出し・コード・表・埋め込みの編集機能がある。入力時の記法変換と、長文Markdown/クリップボードHTMLを一括貼付けして全ブロックを保存する機能は同じでない。CMS書込み禁止のため再入稿の実機試験はしておらず、速度・失敗率は未測定。
修正:コード+表+埋め込みが多い3本を、後日許可された下書きで測る。本文投入・画像・埋め込み・目視修正・公開までの本人時間とAI時間を別々に計る。案4はデザイン再制作・内容照合・DNS・保守も足す。
損益分岐の式は 移行の追加時間M ÷(1記事あたり案1の時間−案4の時間)。時間単位を揃える。たとえば実測でない仮定としてM=40時間、案1=5分、案4=3分なら1200本、案1=20分なら約142本。短期に案4が必ず得という説明は成立しない。案1の実験は「移行が不要」という強い利点があるので先に小さく試す価値がある。
C2 ⚠️ 要注意:案2はデザイン保守を本人が続けたい場合に合理的
証拠:A3の公式仕様はbody/contentのリッチテキスト接続を明記。Plus費用は公式料金で年払い換算月9,980円、月払い12,900円。Businessとの差は年払い換算月6,000円、月払い7,440円。現在の実契約がBusinessとは未確認。
修正:差額の絶対額だけで不採用にせず、「その差額でデザイン再制作と以後のCSS保守を何時間避けられるか」を比較する。API連携でもデータ変換サーバー等の保守は残る。本文完全再現の試験に通るなら、期限が近くデザインの再制作負担が大きい場合は案2を採用できる。
C3 ⚠️ 要注意:546件の手作業は技術的必然ではない。ただし無料の抜け道とも言えない
証拠:DNSはホスト名を解決する仕組みであり、/pixelstomotors/* のパスを見てHTTP301を返せない。一方、Workers _redirectsはワイルドカード1規則や静的2000行の機械生成に対応する。現在は移行対象が553件。
修正:旧apexのHTTP配信を別サービスが受けるなら、記事群を新サブドメインにまとめて転送でき、手作業553件は不要。ただしapexの残りをStudioから配るリバースプロキシにするとA4の契約が問題になる。残り25ページを別サービスへ移すなら結局その部分の移行が必要。無料ProxyでStudioを中継する案をサポート条件無視で推奨しない。
案6の採用理由も残る:同一URL・既存Studioデザインを保った段階移行には価値がある。ただし現料金の最低合計は年払い換算49,780円/月(Plus9,980+Proxy39,800)、月払い52,700円/月。本人時間を高く評価する短期間の移行橋渡し以外は不利。契約せずに検証するには不適切。
C4 ⚠️ 要注意:手入力を続ける案と比較する基準値がない
証拠:現計画には現行1記事の貼付け時間、修正頻度、移行後の月間保守時間の実測がない。1日1本なら、手入力が10分なら約5時間/月、20分なら約10時間/月(いずれも仮定)。案4でも承認・画像・例外修正はゼロではない。
修正:直近3〜7記事で本人の所要時間を計測し、3か月・12か月の総時間で比較する。「手間」が本人時間なのか、AI実行時間も含むのかを定義する。移行は研究の主指標を進める時間を奪うので、公開作業の短縮がその初期負担を上回るかを判断する。
D. 日々の運用負担
D1 ❌ NG:「本人は確認だけ」の成立条件が未実装
証拠:計画4節でクラウドClaudeがiCloudへ保存してMacからR2へ送る。MASTERには「Mac連携が接続されているときだけ」と明記され、Mac起動・スリープ復帰・iCloud同期完了・連携接続が前提。APIの認証なし400は到達の証拠にすぎず、R2書込み権限・バケット・成功通知の証明ではない。
修正:本人の初期アカウント操作、GitHub連携、2FA、障害時再認証、依存更新、Node/Astro/Wrangler互換性、期限付きトークンの更新、費用確認を別表にする。「通常の成功時は確認だけ」と限定し、例外対応担当を決める。最初の3記事だけでなく、Mac停止・画像欠落・ビルド失敗の試験も合格条件に加える。
D2 ❌ NG:ビルド成功と公開内容の正しさを混同している
証拠:SSGは未参照画像、誤URL、画像未アップロード、ゼロ件のデータ、古いデータでもビルドが成功しうる。mainへのpushで本番になる設定では、未承認merge、承認後の追加commit、並行ビルドの順序違いも問題になる。画像アップロードはGitのデプロイと一体でロールバックされない。
修正:必須CI検査(件数下限、既存URL台帳、MD/HTML本文、全参照資産、表・コード、404、メタ)→固定commitのプレビュー→そのcommitへの承認→同じ版の本番昇格→公開後の独立GET検査、の順にする。変更可能なブランチURLの見た目だけを承認対象にしない。ビルド失敗と「最新公開commitが承認済みcommitに追いついていない」を担当者に通知する仕組みを設計する(今回は通知設定しない)。
D3 ⚠️ 要注意:Mac依存を残したまま日常操作ゼロとはならない
証拠:画像正本はiCloud、R2鍵はMacだけ。Mac停止中にクラウドClaudeが新画像をR2へ公開する経路は計画上存在しない。現在の待ち時間や外出頻度は未確認で、発生頻度を数値化できない。
修正:選択肢は①Mac待ちを許容し、承認前に画像公開完了を自動検査、②画像用の限定アップロードサービス/外部ストレージからクラウドCIで送る経路、③公開用に限定した画像コピーをGitで管理するようルール変更。③は新規決定が必要で、今回勝手に変更しない。公開用コピーとiCloudの作業原本を別のデータ種別として定義できるなら、1種類1か所との矛盾は解消できる。画像や動画を無制限にGitへ入れる提案はしない。
D4 ⚠️ 要注意:「鍵はMacだけ」はR2アップロード鍵に限定しないと説明が不正確
証拠:Git連携ビルドにはCloudflare側のGitHubアクセスとデプロイ権限が必要。Mac上だけのR2資格情報で、クラウドの認証が一切不要になるわけではない。既存の鍵の実在・ファイル権限は、認証情報を読み漁らない方針で未確認。
修正:DNS編集・サイトデプロイ・R2のObject Read/Writeを分離。アップローダーは対象バケットだけ、可能なら削除権限なし、MacのKeychain等で保管しリポジトリ・ログへ出さない。認証済みアップロードと内容hash検査が成功したasset manifestだけをクラウドへ渡す。環境変数やビルドログへの秘密出力、AI生成ビルドスクリプトへの過剰な資格情報付与も防ぐ。画像は上書きでなく内容hash付きURLで版を分ける。
E. 移行で壊れるもの
E1 ❌ NG:メールを止めないためのDNSSEC・TTL手順が不足
証拠:DSあり。A/TXT/DKIM元TTL4時間、子NS6時間、DS2時間。NS変更はAだけでなく同じゾーンのMX/TXTにも影響する。メールアプリで1回送信できたことだけではSPF/DKIMの受信側判定を保証しない。
修正手順(実行していない):
- 旧ゾーンを全書出し。新ゾーンにMXの優先度・名前・TXTの連結後の値を完全一致で準備し、メール用ホストにProxyを付けない。自動取込みだけに頼らない。
- 必要ならAなどのTTLを先に300〜600秒へ下げ、少なくとも旧TTLを経過させる。親NS/DS TTLまで同時に下がると誤解しない。
- DNSSECを簡易方式で移すなら、旧DNSの署名を保ったまま親DSを先に削除し、旧DSのTTL失効と複数の検証リゾルバーでの消失を確認。その前にNSを変えない。NS事業者の「DNSSEC無効化」がDS削除と署名停止をどう行うかを確認する。高度なmulti-signer方式は今回の最小手順から外す。
- Cloudflareに全レコードを準備した状態でNS変更。旧DNSゾーンは維持し、新旧どちらに聞いてもメール設定が同じ状態にする。Studio向けはDNS-only。
- 最大の観測・親委任TTLと事業者反映時間を確認し、24〜48時間の監視枠を確保。旧ゾーンは少なくとも72時間、かつ確認した最大キャッシュ期間を超えて維持する。この時間はゼロ停止保証ではない。
- 外部アカウントとの送受信、受信ヘッダーのSPF/DKIM結果、MX/TXTの複数リゾルバー照合をする。安定後にCloudflareのDNSSECと新DSを有効化する。旧DSを丸ごと新DNSにコピーしても解決しない。
DMARC追加は有益な別施策になりうるが、移行と同時に認証ポリシーを変える必須作業にしない。
E2 ❌ NG:URLと200だけでは検索・多言語移行の合格にならない
証拠:現在553件、JSON-LD543件。原HTML内canonical/hreflang0は描画後の値の不在を意味しない。英語4コマ95本は初期html lang=ja。raw/cms/recordの言語プロパティを独立集計するとJP332+EN7で、DAY末尾ENも7件。英語記事7本はRecordに含まれ、日本語339本という数え方だと誤る。旧339本には既に英語記事が含まれている。
修正:URL→言語→タイトル→本文hash→description→公開/更新日→画像/alt→OGP→構造化データ→正規URLのmanifestを作る。英語4コマ95、日本語99、英語Record7を別検査する。対応のある日英のみ相互hreflang、自己参照と必要なx-defaultを設計し、機械的に同番号を対応としない。英語マンガはenへ改善する。切替直前に同期し、プレビューのnoindexを本番へ持ち込まない。URL維持は検索順位の保証ではない。
E3 ❌ NG:<iframe sandbox> と書くだけでは動作しない。実試験で差が出た
実行証拠:付録のGET-onlyローカルHTTPサーバーを起動し、Codex内蔵ブラウザで実アーカイブ5件を読み込んだ。原ファイルは変更せず、URLと同じ相対階層で配信した。
| 試料 | sandbox="allow-scripts"で観測 |
|---|---|
LOG111 01_ZXumKnYG.html | 画像6/6がcompleteかつnaturalWidth>0。HAPPYボタンでCURRENT STATEがHAPPYへ変化 |
LOG278 01_Rer4xGsn.html | 「読み違い」ボタンで説明文が読み違い版へ変化 |
LOG203 01_oF8CDy59.html | Next DesignでXYZ同時追従の設計へ切替 |
LOG331 01_QIb2qI10.html | 再生ボタンが「停止」へ変化。全13.3秒の同期精度まで合格したとは扱わない |
LOG123 01_I9PF_I8l.html | テストフローの表示あり。body高さ959pxに対し親iframeの表示高さ304pxで内部スクロールが必要 |
さらに sandbox="allow-forms"(script未許可)で再読込みすると、LOG278の行内容と説明、LOG203の表本体等が初期化されず欠けた。script無しでは壊れる実例を確認した。クリックの比較を続ける操作はブラウザ側タイムアウトになったので、その操作成功を根拠にしていない。通常のheadless Chrome起動はSIGABRTで失敗し、内蔵ブラウザに切り替えた。
静的走査でも、記事303件のうち239件がscript、固定側を足すと240件。全埋込み312件中228件に外部フォント、3件に親参照、1件にpostMessage、2件にdownloadの語を検出(語の検出は機能の正常動作証明ではない)。LOG278の184〜187行は postMessage を送るだけであり、親側で受信して高さを反映しなければ伸びない。LOG111の画像は ../images/ なので階層を平坦化すると壊れる。LOG123の380行は /cdn-cgi/scripts/.../email-decode.min.js という旧配信環境依存のscript。
修正:まず allow-scripts の最小権限で試験し、DL・YouTube等の必要権限を個別決定。親のmessage処理はsourceと形式・高さ上限を検査する。同一オリジンに allow-scripts allow-same-origin を無条件併用して「隔離」と呼ばない。別オリジン配信の採否、固定高さ/自動高さ、外部フォント、スマホ、画像・動画、DLを仕様化する。全303件+固定9+サムネイル46の受入試験は未実施であり、5件の成功を全件OKに拡張しない。
E4 ⚠️ 要注意:再制作工数が「一番大変」だけで時間・受入条件になっていない
証拠:固定page.mdは17個だが、公開固定13+テンプレート3+共通1で、17公開ページではない。共通symbolの完全な編集設計データがないため、アーカイブ文字列一致だけでは余白、SPメニュー、カード一覧、ホバー、もっと見る、スクロール挙動を再現できない。
修正:ヘッダー/フッター、トップ、Recordテンプレート、マンガ日英、一覧9種、実績/タグをコンポーネント単位で見積もる。代表のPC・SPスクリーンショットとキーボード操作で合格基準を決める。デザイン再制作と本文自動変換を別工数にし、1記事+1一覧+実績1ページの試作で時間を計る。計画には具体的な工数見積が存在しないため「足りている」とは判定できない。
E5 ❌ NG:最終アーカイブの取得が切替後では遅い
証拠:空の「 2」548個は再確認。contentの実ファイルに一時的なドットファイル/末尾2ファイルは今回の走査では検出せず。ただし同一内容のファイル群11組(上限30組の走査内)があり、同じ資産の重複と正規別ページを混同しない。raw/html546件、CMS本文533件は既存分が現在も一致、新規7記事はアーカイブにない。
修正:段階4の解約前だけでなく、段階3の前に最後のStudio同期を行う。切替後のadaptdesign.jpを再取得しても新サイトしか取得できず、旧CMSの最終状態の保存にはならない。読み込みは再帰globで全MDを拾わず、公開URL manifest→対応する本文という許可リストにする。raw、work_files、code、バックアップ、テンプレート、空重複フォルダは生成対象外。二重slug、大小文字、拡張子重複、欠損assetをビルド失敗にする。同期中の編集凍結時刻と増分取込み担当を決める。
E6 ⚠️ 要注意:実績25ページのフォント・挙動は未確認部分が残る
証拠:25 URLは実在200。product.jsonにはTypeSquareのリュウミン・A1ゴシック等の登録がある。これは25ページで使用している証拠でも未使用の証拠でもない。アーカイブの対象外なので、記事側がGoogle Fontsだけであるという評価を25ページへ流用できない。
修正:25ページと共有symbolの実際の適用font-family・外部リンク・フォーム・アニメーションを専用台帳にする。Studio付属Webフォントのファイルを単に抜き出して新サーバーへ配布しない。継続ライセンスか代替Google Fontsを選び、文字幅・折返しも照合する。実績を畳むなら対象URL別の代替・404/410と営業導線を本人が決める。研究サイト移行に便乗して無断で廃止しない。
F. 復旧の現実性
F1 ❌ NG:NSを戻すだけの即時復旧は保証できない
証拠:現DS・TTLはB1/E1。Cloudflareの新DSを既に親へ登録したあとに旧NSへ戻すと、旧ゾーンの鍵と合わずSERVFAILになりうる。NSを変更してもキャッシュが即時統一されるわけではない。
修正:DNS移行中は旧ゾーンと新ゾーンのメール・A値を一致させ、DS変更の段階別復旧表を作る。新DS登録前の復旧と、登録後のDS削除・TTL待ちを別手順にする。名目上300秒のA TTLがNS委任の復旧時間を保証しない。障害時間の確定値は未確認で、ゼロ停止と書かない。DS不一致ならキャッシュ失効・事業者処理の間、Webとメールの両方が影響する可能性がある。
F2 ❌ NG:契約が残っているだけではStudioへ即時復帰できない
証拠:旧IPの公式説明は、旧IPの既存接続継続は可だが、独自ドメイン接続を一度解除すると旧IPへ再接続不可、新IP34.111.141.225が必要と明記する。TLS自動更新は適正なAレコードが更新条件。再公開では証明書再発行・再接続に最大約72時間の可能性。
GET時に実際に提示された証明書の期限は Dec 29 17:28:03 2026 GMT。CTで見つけただけでなく、GET通信のTLS証明書から取得した。現在有効であることは将来の再接続保証ではない。
修正:「Aを35.194.122.208に戻す」を無条件の手順にしない。Cloudflare Workers Custom Domain/Pages custom domainとの結付きを外す操作、関連する自動DNS、AAAAやProxy状態、Studioの接続維持・証明書期限まで含む復旧表を作る。Studio側の接続解除・非公開・基盤切替を並行期間に混ぜない。戻す必要がある時点で、既存接続が存続し証明書が有効かを確認する。解除していた場合は新IP・再発行経路での復旧となる。設定を変えない今回の検査では実際の切戻しは未試験。
F3 ❌ NG:段階4より前にも実質的に戻しにくい操作がある
証拠:旧記事の削除、旧リポジトリを廃止して新しい記事だけ新サイトへ公開、画像上書き、新サイトにしかない7件以降の更新、旧DNSゾーン削除、Studioドメイン解除、承認前の本番公開は、契約が残っていても元の状態へ戻らない。
修正:並行期間は「主執筆先は1つ」としたまま、各公開版のMD・資産manifest・生成物・公開commitを保存。新サイト公開後の増分をStudio復旧時にどう出すかを明示する。データを二重編集せず、復旧時だけ再生成/再入稿する。DNSSEC・ドメイン結付き・コンテンツ復旧・メディア復旧を独立に定義する。
G. 運用ルール
G1 ⚠️ 要注意:新リポジトリ案は可能だが「旧articlesを役目終了」にするだけでは不足
証拠:MASTER「場所を増やすときは保存先テーブルに追記してから置く」「記事・SNSはGitHubのarticles/・sns/」「公開記事が正」。アーカイブ516ファイルは200MD・293HTML・23画像であり、516記事の移動ではない。現在Mac側は501ファイルで、公開GitHubの状態と一致とは限らない。
修正:実装前に正本の意味を定義する。推奨は既存r2r2r-contentの現状をまず確認し、公開内容と照合したcontentとサイトコードの分離を評価すること。新repoが必須とは言えない。新repoを採るなら、本文と図解だけでなくSNSの所在、生成物、アーカイブ、旧URL→元ファイルの対応をルールに記載する。過去記事を消さず読取専用の履歴/移行時snapshotとして区別し、編集中の正本は一つにする。旧articlesを先に削除しない。既存の画像23ファイルは過去の例外として棚卸しし、勝手に削除しない。
G2 ❌ NG:ルールの書換えが段階5では遅い。出力形式も現状では自動ビルドに直結しない
証拠:MASTER 186行はルール更新が実装より先。現article_rules 100〜102行では画像はMarkdown画像記法ではなく 【画像】ファイル名、図解も 【図解】ファイル名。Studio embed、HTMLサムネイル、フルコードも前提にする。また143〜154行の現行必須出力は、⑧SNS、⑨iCloud作業フォルダ保存、⑩ClaudeのGitHub直接反映であり、コピー/gitコマンドは直接pushできない場合だけ。計画書の「⑧コピー・⑨git」という参照も既に古い。このままAstroに渡すと画像指定の文字列が表示されるだけになる経路がある。
修正:段階0〜1の入口へルール変更案の承認を移す。YAMLスキーマ、画像manifest、図解変換、旧MDと公開MDの区別、公開URL、日英対応、承認対象commit、rollback、画像版管理、draft/noindex、失敗通知、誰が更新できるかを記事制作ルールとMASTERの一方に定義し他方は参照にする。複製MASTER・SNS出力・ClaudeのGitHub反映手順も対象。今回これらのファイル自体は変更していない。
H. 費用
H1 ⚠️ 要注意:小規模な静的構成なら無料枠は有力。ただし費用減は未証明
証拠:現Studio契約、ドメイン実支出、Workspace、Claude/Claude Code、GitHubプランは未確認。確認できたStudio公式料金はBusiness年払い換算3,980/月払い5,460、Plus9,980/12,900円。現契約が旧プランならこの表だけでは今の支払いを出せない。年契約は解約申請日から月割で節約できると仮定しない。
| 費用要素 | 計算・リスク |
|---|---|
| Workersの静的配信 | 公式の無料・無制限の対象。SSRや全リクエストの認証Workerを入れると別枠 |
| Workers Builds | 1日1記事、確認2回+本番1回、1回3分という仮定で月270分。10分なら900分。6回×20分×30日なら3600分で超過。ファイル数だけではビルド分数は予測できず、依存install・照合テスト・再試行も加算 |
| Pagesなら | 無料500ビルド/月。1日3回で90回、1日20回なら600回。Workersの3000分と混ぜない |
| R2保管 | contentのimages/だけで約0.414GB。10GB-month未満だが旧版・重複・25実績・新記事を含む容量は未確定。毎日30MB増える仮定なら月0.9GB増、永遠に無料ではない |
| R2操作 | 初回約1000オブジェクトはClass A100万枠より十分小さい。毎回全一覧を列挙する無駄を避ける。月1000万GET枠は、キャッシュミス率と1PVの画像数で評価する |
| R2例 | 月10万PV×10資産×キャッシュミス100%なら100万読出し/月。月100万PVなら1000万。転送料が無料でも操作料は別 |
| Workerコード | Free10万/日。静的assetsだけならこの枠を原則使わず、run_worker_first・API・SSRは使う。未知のアクセス数で課金リスクゼロとは言わない |
| ドメイン・Workspace | 移行しても継続。メールの費用はStudio解約で消えない |
| 追加候補 | フォント、監視、外部画像アップローダー、GitHubのprivate CI枠、バックアップ、AI実行料。採用しなければ必須の新費用ではない |
| 移行・保守 | デザイン再制作、QA、DNS、トークン・依存更新、障害対応の本人/AI時間。計画書には時間・人件費がない |
修正:「静的配信+R2 Standardなら現容量は無料枠に十分小さい」に限定し、現在の請求書と実測ビルド3本で比較表を埋める。R2は本番custom domainを利用し、開発用 r2.dev を本番に固定しない。無料枠を超えた際の停止/従量課金はサービスごとに異なる。予算通知と上限の実効性を分けて確認する。
I. 追加の見落とし
I1 ❌ NG:切替方法と受入条件に矛盾・順序漏れがある
- Cloudflareの向き先は単なるAの置換ではない。 WorkersはCustom Domain結付け、PagesはCustom domain設定+自動DNSが必要。誤ってAを足すだけ、旧Aと競合したまま、あるいはWorker routeが旧Studio復旧を横取りしたまま、という失敗経路がある。製品を一つに決めた後、その製品の設定項目名で切替/復旧手順を書く。Workers Custom Domains、Pages。
- 「全URL200」は不十分で一部矛盾。 不明URLまで200になるSPA fallbackは不合格。旧転送元とスラッシュ別表記に期待301/308、廃止URLに404/410を設定し、正しい本文が出るまで検査する。根拠:実サイトの大小文字・不存在URLは404、ルートは301だった。
- 画像と記事の公開は原子的でない。 Macのアップロード前にcommitを公開すると画像欠落、先に公開用R2へ置くと未公開画像のURLが先行公開される。draft領域、hash URL、asset manifest、アップロード完了を条件にする。プレビュー用R2を分ける場合は本番と同じ資産hashを保証する。
- 段階1のmediaドメイン。 R2のcustom domainは同アカウントのCloudflare zoneが必要。DNS移行前の段階1から
media.adaptdesign.jpが本番同様に使えると仮定しない。R2 public bucketsに従い開発用URLなどで非本番試験し、段階2後に本番mediaへ切替。開発URLは本番利用しない。 - MD変換と実行HTML。 アーカイブMDには生HTML表、コード、相対画像、図解リンクがある。GitHubで読めることとAstroで同じになることは別。自動目次、アンカー、構文強調、
<br>、セル内|、大きいコード、リンク色、長文スクロールを検査する。Astroの通常MarkdownとMDXを混同せず、任意scriptを本文で直実行しない。 - 基盤費用と保守責任の移転。 サーバーレスでもAstro/Node/Wrangler等の依存更新や脆弱性対応は残る。「Studioをやめる=保守不要」ではない。更新担当・回数・失敗時の旧版維持を決める。
- HTTPS以外の資産動作。 R2のContent-Type、キャッシュ期限、動画のRange、図解からの画像CORS、OGP画像の絶対URL、フォントライセンス、CSPのframe/script許可を検査する。特にcontent内動画6本のうち、記事4本だけ数えて固定2本を落とさない。
- 正本とバックアップ。 GitHubで公開記事が一意になっても、R2を消したらGitだけでは復元できない。画像manifestとiCloudの正本から復元可能か、実際に別のローカル出力へ復元する試験を追加する。画像をGitへ入れないルールと、復元不能を同一視しない。
計画書の結論を変えるべき事実
- 案4を直ちに実行できるという結論は取り下げる。 DNSSECのDSあり、復旧先旧IPの再接続制限、段階3前の増分同期不足は実害のある抜けである。
- 「案4が最少手間」の確定推奨を「案1の3記事試験+案4の小規模試作を比較して決める」に変更する。 移行時間も現行入稿時間も測定されていない。長期自動化との相性は案4がよいが、短期の総本人時間で勝つ証拠はない。
- 「公式外部書込み手段なし」を狭く言い直す。 WordPressインポートあり。ただし日々の自動入稿の代替になる証拠はなく、これだけで案4を否定しない。
- 案3は移行・MCPを公式に謳っている。 実提供と価格が未確定なので納期依存は不可だが、候補からの永久除外は不要。
- 案5の553件手入力は必須ではない。 外部HTTP転送なら機械生成・ワイルドカードが可能。ただし残すStudioの中継契約とURL変更コストを無視した安価な代案ではない。
- 546ページと転送28件の無条件維持は基準を更新する。 現在553+25、転送先404が22。既存不具合の再現を合格にしない。
Claudeに渡す修正依頼
- 案4の推奨を条件付きに直してください。案1の代表3記事の下書き入稿と案4の代表ページ試作で、本人時間・AI時間・修正回数を計測する計画を追加してください。この報告の検査中は下書き作成や設定変更をしていません。
- 段階0へ、現在のStudio請求・契約更新日、ドメイン管理会社、2026/11/30の更新状態、全DNSエクスポート、DNSSECのDS/鍵/TTLと編集可否の確認を追加してください。DSありを前提に切替・復旧表を書いてください。
- 段階2のStudioレコードDNS-onlyは維持してください。旧DS削除→TTL失効確認→NS変更→新旧DNSの一致確認→安定後に新DS登録、の順序と担当者・監視時間を書いてください。単に「NSを戻す」と書かないでください。
- Studioの35.194.122.208は既存接続専用で、ドメイン解除後に再接続できないことを反映してください。契約中でも即時復旧を保証せず、証明書・Custom Domain結付き・新旧DNS・最新記事の復旧手順を別々に書いてください。
- 公開サイトマップの現在値553+25で台帳を取り直してください。新規7件を段階3前に同期し、本文だけでなくタイトル・画像・メタ・公開更新日も差分照合してください。段階4の再アーカイブを最終同期の代わりにしないでください。
- 転送28件のうち404となる22件を一覧で判断し、維持・同等記事への転送・404/410を決めてください。全てをトップへ送らず、合格条件に初段コードと到達本文を入れてください。
- WordPressインポート、Data Connect APIのbody接続、Studio.Assistant、Studio.Dropの現状を公式出典で書き直してください。APIなしの表現を継続upsert API未確認に限定してください。
- WorkersかPagesを具体的に選び、無料プレビューと本番昇格を設計してください。固定commitへの承認、CI必須検査、失敗通知、公開commit照合、非本番noindex、本番noindex解除を加えてください。
- R2への画像完了を本番公開の前提にしてください。Mac停止時の代替・鍵の権限・保管・更新担当を決めてください。認証なし400をアップロード成功と扱わないでください。
- サンドボックスはallow-scripts、画像相対パス、postMessage高さ受信、DL・動画・外部フォント・SPを仕様化してください。303記事内HTMLに加え固定9とサムネイル46を検査対象にしてください。
- 日英のURL・言語・canonical・hreflang・JSON-LD・OGP・GA/GTMの受入台帳を作ってください。原HTMLにcanonicalがないことを未設定と決めつけず、描画時挿入の仕様を反映してください。
- 25ページのフォント・デザイン・営業導線を別途棚卸ししてください。Studioフォントの継続使用はライセンス確認か代替フォントで決めてください。
- MASTERとarticle_rulesの改訂を段階5から実装前へ移してください。【画像】【図解】記法、記事/SNSの正本、旧516ファイルの保管、公開用資産manifest、復元方法を定義してください。新repoの採用を前提にせず既存repo案と比較してください。
- 費用表に実契約、ドメイン、Workspace、R2操作・容量、CI、任意のフォント/監視、AI/本人の移行保守時間を追加してください。無料の条件と、課金/停止時の対応を明記してください。
補足の実測表
新規7記事
- https://adaptdesign.jp/pixelstomotors/record/video-progress-board
- https://adaptdesign.jp/pixelstomotors/record/video-patterns-and-try-it
- https://adaptdesign.jp/pixelstomotors/record/pi05-mecharm-demo-to-inference
- https://adaptdesign.jp/pixelstomotors/record/alphanist-binary-reward-assembly
- https://adaptdesign.jp/pixelstomotors/record/youtube-script-curation
- https://adaptdesign.jp/pixelstomotors/record/pixelstomotors-site-archive
- https://adaptdesign.jp/pixelstomotors/record/first-video-end-to-end
転送28件の全件検査
ブラウザ試験の実行記録
ローカルHTTPサーバーは127.0.0.1:8765だけで受け付け、原本はread_bytesで読むだけ。終了時にブラウザタブを閉じ、サーバーを停止。公開サイトはブラウザで開いておらず、GA等のPOSTを避けた。ネットワークの独立検査はurllibのGETを使った。最初の通常Chrome起動は失敗し、図解の操作検証は内蔵ブラウザで実施した。
検証スクリプト全文
以下は実行に使った最終版。出力は/tmp以下のみ。初回の直下ファイル数・サイトマップ索引数は診断値で、確定値にはphase2/localの再帰集計を使う。中間JSONは一時ファイルのため、確定した数と全転送表を本文にも収録した。依存はPython標準ライブラリのみ。ブラウザ試験だけCodexのcua_repl APIを使う。
/tmp/site_migration_audit.py
実行:python3 /tmp/site_migration_audit.py(sandboxは検証中のみ起動)。
from pathlib import Path
from urllib.request import Request,urlopen
from urllib.parse import urlparse,urlencode,urljoin
from html.parser import HTMLParser
from collections import Counter
from concurrent.futures import ThreadPoolExecutor,as_completed
import json,xml.etree.ElementTree as E,hashlib,time,re,ssl
BASE=Path('/Users/shimazueiichi/Library/Mobile Documents/com~apple~CloudDocs/デスクトップ/ADAPT DESIGN/じぶんの/PixelstoMotors')
OUT=Path('/tmp/site_migration_audit');OUT.mkdir(exist_ok=True)
def get(url):
 try:
  with urlopen(Request(url,headers={'User-Agent':'SiteMigrationReadOnlyAudit/1.0'}),timeout=30) as r:return {'url':url,'status':r.status,'final':r.url,'headers':dict(r.headers),'body':r.read().decode('utf-8','replace')}
 except Exception as e:return {'url':url,'error':str(e)}
def save(n,v): (OUT/n).write_text(json.dumps(v,ensure_ascii=False,indent=2))
if __name__=='__main__':
 dns={}
 for name,types in [('adaptdesign.jp',['NS','A','AAAA','MX','TXT','CAA','DS','SOA','HTTPS']),('www.adaptdesign.jp',['A','AAAA','CNAME','TXT']),('google._domainkey.adaptdesign.jp',['TXT']),('_dmarc.adaptdesign.jp',['TXT']),('_mta-sts.adaptdesign.jp',['TXT']),('_smtp._tls.adaptdesign.jp',['TXT']),('media.adaptdesign.jp',['A','CNAME'])]:
  for typ in types:
   v=get('https://dns.google/resolve?'+urlencode({'name':name,'type':typ,'do':'true'}))
   dns[name+'/'+typ]=json.loads(v['body']) if 'body'in v else v
 save('dns.json',dns);print('DNS complete',flush=True)
 for label,url in [('crt','https://crt.sh/?q=%25.adaptdesign.jp&output=json'),('rdap','https://rdap.org/domain/adaptdesign.jp'),('robots','https://adaptdesign.jp/robots.txt'),('sitemap','https://adaptdesign.jp/sitemap.xml')]:
  v=get(url);save(label+'.json',v);print(label,v.get('status',v.get('error')),flush=True)
 sm=json.loads((OUT/'sitemap.json').read_text())
 urls=[]
 if 'body'in sm:
  try:urls=[e.text for e in E.fromstring(sm['body']).iter() if e.tag.endswith('}loc')]
  except Exception:pass
 save('sitemap_urls.json',urls);print('sitemap',len(urls),Counter('/pixelstomotors' in u for u in urls),flush=True)
 extra=['https://adaptdesign.jp/','https://adaptdesign.jp/pixelstomotors/','https://adaptdesign.jp/PIXELSTOMOTORS','https://adaptdesign.jp/pixelstomotors?audit=1','https://adaptdesign.jp/2','https://adaptdesign.jp/audit-nonexistent-20261016','http://adaptdesign.jp/pixelstomotors']
 pages={}
 with ThreadPoolExecutor(max_workers=4) as pool:
  for i,f in enumerate(as_completed([pool.submit(get,u) for u in dict.fromkeys(urls+extra)]),1):
   v=f.result();pages[v['url']]=v
   if i%100==0: print('pages',i,flush=True)
 save('pages.json',pages);print('pages complete',len(pages),flush=True)
 archive=BASE/'site_archive';raw=list((archive/'raw/html').glob('*'));content=archive/'content'
 files=[p for p in content.rglob('*') if p.is_file()];dirs=[p for p in content.rglob('*') if p.is_dir()]
 embeds=[p for p in content.rglob('embeds/*.html')];thumbs=list(content.rglob('thumbnail.html'))
 empties=[str(p.relative_to(content)) for p in dirs if not any(p.iterdir())]
 assets=[p for p in content.rglob('images/*') if p.is_file()]
 counts={'raw_html':len(raw),'content_files':len(files),'empty_dirs':len(empties),'empty_suffix2':sum(s.endswith(' 2') for s in empties),'embeds':len(embeds),'script_embeds':sum(bool(re.search(r'<script\b',p.read_text(errors='replace'),re.I)) for p in embeds),'thumbs':len(thumbs),'assets_count':len(assets),'assets_bytes':sum(p.stat().st_size for p in assets),'max_assets':sorted([(p.stat().st_size,str(p.relative_to(content))) for p in assets],reverse=True)[:8],'suffixes':Counter(p.suffix for p in files),'md_types':Counter(p.name for p in files if p.suffix=='.md')}
 save('archive_counts.json',counts);save('empty_dirs.json',empties)
 external=Counter();forms=[];metas={};links=set();live_embeds=[]
 class Parse(HTMLParser):
  def __init__(self):super().__init__();self.meta=[];self.scripts=[];self.assets=[];self.links=[];self.forms=0
  def handle_starttag(self,tag,attrs):
   d=dict(attrs)
   if tag=='meta':self.meta.append(d)
   if tag=='link':self.meta.append(d)
   if tag=='script' and d.get('src'):self.scripts.append(d['src'])
   if tag=='iframe' and d.get('src'):self.assets.append(d['src'])
   if tag=='a' and d.get('href'):self.links.append(d['href'])
   if tag=='form':self.forms+=1
 for u,v in pages.items():
  if 'body' not in v:continue
  p=Parse();p.feed(v['body']);metas[u]={'status':v['status'],'final':v['final'],'meta':p.meta,'scripts':p.scripts,'iframes':p.assets,'forms':p.forms}
  external.update(p.scripts+p.assets)
  if p.forms:forms.append(u)
  links.update(urljoin(u,a) for a in p.links if a.startswith('/') or a.startswith('https://adaptdesign.jp'))
 save('metas.json',metas);save('external.json',dict(external));save('linked_not_sitemap.json',sorted(links-set(urls)));save('forms.json',forms)
 print('archive',counts,flush=True)
/tmp/site_migration_phase2.py
実行:python3 /tmp/site_migration_phase2.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
import csv
if __name__=='__main__':
 pending=['https://adaptdesign.jp/sitemap.xml'];seen=set();urls=[];maps={}
 while pending:
  u=pending.pop()
  if u in seen:continue
  seen.add(u);v=get(u);maps[u]=v
  if 'body'not in v:continue
  root=E.fromstring(v['body']);locs=[e.text for e in root.iter() if e.tag.endswith('}loc')]
  if root.tag.endswith('sitemapindex'):pending+=locs
  else:urls+=locs
 save('sitemaps_recursive.json',maps);save('sitemap_urls_all.json',urls);print('actual sitemap',len(urls),Counter(urlparse(u).path.split('/')[1] for u in urls),flush=True)
 pages=json.loads((OUT/'pages.json').read_text());need=[u for u in urls if u not in pages]
 with ThreadPoolExecutor(max_workers=4) as pool:
  for i,f in enumerate(as_completed([pool.submit(get,u) for u in need]),1):
   v=f.result();pages[v['url']]=v
   if i%100==0: print('live pages',i,flush=True)
 save('all_pages.json',pages)
 class NoRedirect(__import__('urllib.request',fromlist=['HTTPRedirectHandler']).HTTPRedirectHandler):
  def redirect_request(self,*args,**kwargs):return None
 def first(url):
  try:
   r=__import__('urllib.request',fromlist=['build_opener']).build_opener(NoRedirect()).open(Request(url,headers={'User-Agent':'SiteMigrationReadOnlyAudit/1.0'}),timeout=20)
   return {'url':url,'status':r.status,'location':r.headers.get('Location')}
  except __import__('urllib.error',fromlist=['HTTPError']).HTTPError as e:return {'url':url,'status':e.code,'location':e.headers.get('Location')}
  except Exception as e:return {'url':url,'error':str(e)}
 reds=list(csv.DictReader((BASE/'site_archive/data/redirects.csv').open(encoding='utf-8-sig')));checks=[]
 with ThreadPoolExecutor(max_workers=4) as pool:
  for f in as_completed([pool.submit(first,'https://adaptdesign.jp'+r['from']) for r in reds]):checks.append(f.result())
 for r in checks:
  target=urljoin(r['url'],r.get('location') or r['url']);v=get(target);r['target_status']=v.get('status',v.get('error'));r['target_final']=v.get('final');
 save('redirect_checks.json',checks)
 variants=['https://adaptdesign.jp/pixelstomotors','https://adaptdesign.jp/pixelstomotors/','https://adaptdesign.jp/PIXELSTOMOTORS','https://adaptdesign.jp/pixelstomotors?audit=1','https://adaptdesign.jp/2','https://adaptdesign.jp/','http://adaptdesign.jp/pixelstomotors','https://adaptdesign.jp/audit-nonexistent-20261016']
 save('variant_first.json',[first(u) for u in variants]);print('complete',len(pages),'redirects',len(checks),flush=True)
/tmp/site_migration_local.py
実行:python3 /tmp/site_migration_local.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
from collections import defaultdict

import unicodedata,os
if __name__=='__main__':
 a=BASE/'site_archive';c=a/'content';result={}
 result['raw_html_count']=len(list((a/'raw/html').rglob('*.html')))
 result['embeds_by_section']={s:len(list((c/s).rglob('embeds/*.html'))) for s in ['record','manga','english','static']}
 result['assets_by_section']={s:{'count':len([p for p in (c/s).rglob('images/*') if p.is_file()]),'bytes':sum(p.stat().st_size for p in (c/s).rglob('images/*') if p.is_file())} for s in ['record','manga','english','static']}
 result['embedding_features']=defaultdict(list)
 for p in c.rglob('embeds/*.html'):
  t=p.read_text(errors='replace')
  for key,pat in {'script':r'<script\b','parent_access':r'(?:window\.)?parent\.|window\.top|top\.location','postMessage':r'postMessage','storage':r'localStorage|sessionStorage','fetch':r'\bfetch\(|XMLHttpRequest','module':r'type=[\"\x27]module','relative':r'(?:src|href)=[\"\x27](?:\.\.?/|/)','external_script':r'<script[^>]+src=','external_font':r'fonts\.googleapis|fonts\.gstatic|typesquare','download':r'\bdownload\b','form':r'<form','fixed_height':r'height\s*:\s*\d+(?:px|vh)','resize':r'ResizeObserver|scrollHeight'}.items():
   if re.search(pat,t,re.I):result['embedding_features'][key].append(str(p.relative_to(a)))
 result['assets_studio_references']=[]
 # Scan only content-like files, never print matching values that may contain credentials.
 for sub in ['code/r2r2r-content','content']:
  hits=[]
  for p in (a/sub).rglob('*'):
   if p.is_file() and p.suffix in ['.md','.html','.json','.txt']:
    try:
     if re.search(r'https?://storage\.googleapis\.com/studio-',p.read_text(errors='replace')):hits.append(str(p.relative_to(a)))
    except OSError:pass
  result['assets_studio_references'].append({'scope':sub,'files':len(hits),'examples':hits[:12]})
 result['archive_source_articles']=len(list((a/'code/r2r2r-content/articles').glob('*.md')))
 files=[p for p in c.rglob('*') if p.is_file()];d=defaultdict(list)
 for p in files:d[hashlib.sha256(p.read_bytes()).hexdigest()].append(str(p.relative_to(c)))
 result['identical_file_groups']=[v for v in d.values() if len(v)>1][:30]
 result['extra_files']=[str(p.relative_to(c)) for p in files if p.name.startswith('.') or p.name.endswith(' 2') or '.tmp' in p.name]
 result['raw_meta']={}
 for p in (a/'raw/html').rglob('*.html'):
  class MetaParser(HTMLParser):
   def __init__(self):super().__init__();self.meta={'canonical':[],'hreflang':[],'jsonld':0,'generator':[]}
   def handle_starttag(self,tag,attrs):
    d=dict(attrs)
    if tag=='link' and d.get('rel')=='canonical':self.meta['canonical'].append(d.get('href'))
    if tag=='link' and d.get('hreflang'):self.meta['hreflang'].append(d)
    if tag=='script' and d.get('type')=='application/ld+json':self.meta['jsonld']+=1
    if tag=='meta' and d.get('name')=='generator':self.meta['generator'].append(d.get('content'))
  parser=MetaParser();parser.feed(p.read_text(errors='replace'));result['raw_meta'][str(p.relative_to(a))]=parser.meta

 save('local_analysis.json',result)
 print(json.dumps({k:v if k not in ['raw_meta','embedding_features','identical_file_groups'] else (len(v) if k!='embedding_features' else {a:len(b) for a,b in v.items()}) for k,v in result.items()},ensure_ascii=False,indent=2))
/tmp/site_migration_followup.py
実行:python3 /tmp/site_migration_followup.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
from concurrent.futures import ThreadPoolExecutor
if __name__=='__main__':
 urls={'ct2':'https://api.certspotter.com/v1/issuances?domain=adaptdesign.jp&include_subdomains=true&expand=dns_names','whois_form':'https://whois.jprs.jp/','cf_dns':'https://cloudflare-dns.com/dns-query?name=adaptdesign.jp&type=DS'}
 for key,url in urls.items():
  v=get(url);save(key+'.json',v)
  if key=='whois_form'and 'body'in v:print(re.findall(r'<form.*?</form>',v['body'],re.S)[:2])
  else: print(key,v.get('status',v.get('error')),v.get('body','')[:1500])
 pages=json.loads((OUT/'all_pages.json').read_text());redo=[u for u,v in pages.items() if 'error'in v and u in json.loads((OUT/'sitemap_urls_all.json').read_text())]
 with ThreadPoolExecutor(max_workers=4) as p:
  for v in p.map(get,redo):pages[v['url']]=v;print('retry',v['url'],v.get('status',v.get('error')))
 save('all_pages.json',pages)
/tmp/site_migration_inspect_live.py
実行:python3 /tmp/site_migration_inspect_live.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
from collections import defaultdict
if __name__=='__main__':
 pages=json.loads((OUT/'all_pages.json').read_text());urls=json.loads((OUT/'sitemap_urls_all.json').read_text());data={};domains=Counter();script_patterns=Counter();links=set()
 class P(HTMLParser):
  def __init__(self):super().__init__();self.meta=[];self.ext=[];self.links=[];self.forms=0
  def handle_starttag(self,t,at):
   d=dict(at)
   if t in ['link','meta']:self.meta.append(d)
   if t in ['script','iframe','img','video','source'] and d.get('src'):self.ext.append((t,d['src']))
   if t=='a'and d.get('href'):self.links.append(d['href'])
   if t=='form':self.forms+=1
 for u,v in pages.items():
  if 'body'not in v:data[u]={'error':v.get('error')};continue
  p=P();p.feed(v['body']);data[u]={'status':v['status'],'final':v['final'],'meta':p.meta,'ext':p.ext,'forms':p.forms,'headers':v['headers']}
  for t,s in p.ext:domains[(t,urlparse(s).netloc)]+=1
  links.update(urljoin(u,a) for a in p.links if a.startswith('/')or a.startswith('https://adaptdesign.jp'))
  for pat in ['typesquare','google-analytics','googletagmanager','studioiframesandbox','fonts.googleapis','fonts.gstatic','__NUXT_DATA__','Studio.Design.HRC']:
   if pat in v['body']:script_patterns[pat]+=1
 archive=[]
 for f in (BASE/'site_archive/content').rglob('*.md'):
  match=re.search(r'^url:\s*[\"\x27]?(https?://[^\s\"\x27]+)',f.read_text(errors='replace'),re.M)
  if match:archive.append(match.group(1))
 save('live_analysis.json',{'pages':data,'domains':{str(k):v for k,v in domains.items()},'patterns':script_patterns,'linked_not_sitemap':sorted(links-set(urls)),'new_urls':sorted(set(urls)-set(archive)),'archive_urls':archive})
 print('status',Counter(v.get('status',v.get('error')) for v in pages.values()))
 print('patterns',script_patterns);print('domains',domains.most_common(20));print('meta counts',Counter(k for v in data.values()for m in v.get('meta',[])for k in (['canonical'] if m.get('rel')=='canonical' else ['hreflang'] if m.get('hreflang') else ['generator:'+m['content']] if m.get('name')=='generator'else [])))
 print('variants',json.loads((OUT/'variant_first.json').read_text()));print('redirects',json.loads((OUT/'redirect_checks.json').read_text()))
/tmp/site_migration_semantics.py
実行:python3 /tmp/site_migration_semantics.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
from collections import defaultdict
import html
if __name__=='__main__':
 pages=json.loads((OUT/'all_pages.json').read_text());urls=json.loads((OUT/'sitemap_urls_all.json').read_text());out={'status_counts':Counter(pages[u].get('status',pages[u].get('error')) for u in urls),'groups':Counter(),'external_hosts':Counter(),'new_pixel_urls':[],'static_fonts':{},'jsonld':0,'canonical':0,'hreflang':0,'english_lang':Counter(),'studio_url_strings':0}
 for u in urls:
  path=urlparse(u).path;out['groups'][('/pixelstomotors/record/' if '/record/'in path else '/pixelstomotors/manga/' if '/manga/'in path else '/pixelstomotors/english-4-koma/' if '/english-4-koma/'in path else 'pixel-fixed' if path.startswith('/pixelstomotors')else 'other')]+=1
  t=pages[u].get('body','');out['jsonld']+=int('application/ld+json'in t);out['canonical']+=int(bool(re.search(r'<link[^>]+rel=[\"\x27]canonical',t)));out['hreflang']+=int('hreflang='in t)
  if '/english-4-koma/'in path:
   out['english_lang'][re.search(r'<html\s+lang="([^"]+)',t).group(1)if re.search(r'<html\s+lang="([^"]+)',t)else 'none']+=1
  m=re.search(r'<script[^>]+id="__NUXT_DATA__"[^>]*>(.*?)</script>',t,re.S)
  if m:
   try:
    pool=json.loads(m.group(1));strings=[s for s in pool if isinstance(s,str)]
    for s in strings:
     if s.startswith(('https://','http://')):out['external_hosts'][urlparse(s).netloc]+=1
    out['studio_url_strings']+=sum(s.startswith('https://storage.googleapis.com/studio-')for s in strings)
   except Exception:pass
 archive=json.loads((OUT/'live_analysis.json').read_text())['archive_urls'];out['new_pixel_urls']=[u for u in urls if '/pixelstomotors'in u and u not in archive]
 save('semantic_analysis.json',out);print(json.dumps(out,ensure_ascii=False,indent=2))
 # Full hostname occurrence is not proof a request was issued or a font was used.
 p=json.loads((BASE/'site_archive/raw/studio/product.json').read_text());print('font registration',json.dumps(p.get('fonts'),ensure_ascii=False)[:1800]);print('info keys',list(p.get('info',{})))
/tmp/site_migration_delta.py
実行:python3 /tmp/site_migration_delta.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
if __name__=='__main__':
 pages=json.loads((OUT/'all_pages.json').read_text());changed=[];missing=[];same=0;heads=0
 for p in (BASE/'site_archive/raw/cms').rglob('*.json'):
  d=json.loads(p.read_text());u=d.get('url');item=d.get('item',{});body=item.get('body') if isinstance(item,dict)else None
  if not u or not isinstance(body,str):continue
  t=pages.get(u,{}).get('body','');m=re.search(r'<script[^>]+id="__NUXT_DATA__"[^>]*>(.*?)</script>',t,re.S)
  if not m:missing.append(u);continue
  try:
   pool=json.loads(m.group(1))
   if body in pool:same+=1
   else:changed.append(u)
  except Exception:missing.append(u)
 save('body_delta.json',{'same_body_string':same,'different_or_not_in_pool':changed,'unreadable':missing})
 print('body delta',same,'different',changed,'missing',missing)
 v=get('https://whois.jprs.jp/?type=DOM&key=adaptdesign.jp');save('whois_get.json',v);print('whois GET',v.get('status',v.get('error')),'has domain', 'ADAPTDESIGN.JP'in v.get('body','').upper(),'has registered', '[Registrant]'in v.get('body',''))
 # Resolve the one transient redirect failure again, without altering old observations.
 import urllib.request,urllib.error
 class NoRedirect(urllib.request.HTTPRedirectHandler):
  def redirect_request(self,*a,**k):return None
 try:
  r=urllib.request.build_opener(NoRedirect()).open('https://adaptdesign.jp/blog/06',timeout=20);z={'status':r.status,'location':r.headers.get('Location')}
 except urllib.error.HTTPError as e:z={'status':e.code,'location':e.headers.get('Location')}
 except Exception as e:z={'error':str(e)}
 save('redirect_retry.json',z);print('redirect retry',z)
/tmp/site_migration_finalchecks.py
実行:python3 /tmp/site_migration_finalchecks.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import *
from urllib.request import Request,urlopen
from collections import Counter
if __name__=='__main__':
 try:
  with urlopen(Request('https://adaptdesign.jp/pixelstomotors'),timeout=20) as r:
   cert=r.fp.raw._sock.getpeercert();r.read();save('served_certificate.json',cert);print('served cert',cert.get('notAfter'),cert.get('subjectAltName'))
 except Exception as e:print('cert failed',str(e))
 pages=json.loads((OUT/'all_pages.json').read_text());urls=json.loads((OUT/'sitemap_urls_all.json').read_text())
 print('sitemap_status',Counter(pages[u].get('status',pages[u].get('error'))for u in urls))
 dns=json.loads((OUT/'dns.json').read_text());clean={}
 for k,v in dns.items():
  ans=[]
  for a in v.get('Answer',[]):
   if a['type']==46:continue
   d=a['data']
   if a['type']==16:
    d=('SPF: '+d)if d.startswith('v=spf')else 'DKIM public key (value omitted)'if d.startswith('v=DKIM')else 'verification TXT (value omitted)'
   ans.append({'type':a['type'],'TTL':a['TTL'],'data':d})
  clean[k]={'status':v.get('Status'),'AD':v.get('AD'),'answers':ans}
 save('dns_summary.json',clean);print(json.dumps(clean,ensure_ascii=False,indent=2))
/tmp/site_migration_additional.py
実行:python3 /tmp/site_migration_additional.py(sandboxは検証中のみ起動)。
from pathlib import Path
from collections import Counter
import json,re,html
root=Path('/Users/shimazueiichi/Library/Mobile Documents/com~apple~CloudDocs/デスクトップ/ADAPT DESIGN/じぶんの/PixelstoMotors/site_archive')
for directory in [root/'code/r2r2r-content/articles',Path('/Users/shimazueiichi/r2r2r-content/articles')]:
 files=[p for p in directory.rglob('*')if p.is_file()];print(str(directory),len(files),dict(Counter(p.suffix for p in files)))
hits=[]
for scope in [Path('/Users/shimazueiichi/r2r2r-content/articles'),Path('/Users/shimazueiichi/r2r2r-content/sns')]:
 for p in scope.rglob('*'):
  if p.is_file()and p.suffix.lower()in ['.md','.html','.txt','.json']:
   try:
    nums=[n for n,l in enumerate(p.read_text(errors='replace').splitlines(),1)if re.search(r'storage\.googleapis\.com/studio-',l)]
    if nums:hits.append({'path':str(p),'lines':nums})
   except OSError:pass
Path('/tmp/site_migration_audit/current_repo_asset_refs.json').write_text(json.dumps(hits,ensure_ascii=False,indent=2));print(hits)
for relative in ['content/record/DAY278_precision-lives-in-the-input-not-the-model/embeds/01_Rer4xGsn.html','content/record/DAY203_pipeline-timeline-visualization/embeds/01_oF8CDy59.html','content/record/DAY123_day123/embeds/01_I9PF_I8l.html']:
 p=root/relative
 for n,l in enumerate(p.read_text().splitlines(),1):
  if re.search('postMessage|parent|scrollHeight|download|createObjectURL|resize|cdn-cgi',l):print(relative,n,l[:300])
urls=json.loads(Path('/tmp/site_migration_audit/sitemap_urls_all.json').read_text());print('URLs',len(urls),'unique',len(set(urls)))
v=json.loads(Path('/tmp/site_migration_audit/whois_get.json').read_text());text=html.unescape(re.sub('<[^>]+>','\n',v.get('body','')))
for l in text.splitlines():
 if re.search(r'Name Server|Signing|状態|Status|有効期限',l,re.I):print(l.strip())
languages=Counter();english_days=[]
for p in (root/'raw/cms/record').glob('*.json'):
 d=json.loads(p.read_text())['item'];languages[d.get('O7HA0yM1',{}).get('title','unknown')]+=1
 if str(d.get('bPskK658','')).endswith('EN'):english_days.append(p.stem)
print('archive Record languages',dict(languages),'DAY-EN count',len(english_days))
/tmp/site_migration_sandbox.py
実行:python3 /tmp/site_migration_sandbox.py(sandboxは検証中のみ起動)。
import sys;sys.path.insert(0,'/tmp')
from site_migration_audit import BASE
from http.server import ThreadingHTTPServer,BaseHTTPRequestHandler
from urllib.parse import urlparse,unquote,parse_qs,quote
from pathlib import Path
import html,mimetypes,json
A=BASE/'site_archive'
samples=['content/record/DAY123_day123/embeds/01_I9PF_I8l.html','content/record/DAY111_day111/embeds/01_ZXumKnYG.html','content/record/DAY278_precision-lives-in-the-input-not-the-model/embeds/01_Rer4xGsn.html','content/record/DAY331_explainer-video-character-narration/embeds/01_QIb2qI10.html','content/record/DAY203_pipeline-timeline-visualization/embeds/01_oF8CDy59.html']
class Handler(BaseHTTPRequestHandler):
 def log_message(self,*args):pass
 def do_GET(self):
  u=urlparse(self.path);q=parse_qs(u.query)
  if u.path=='/':
   mode=q.get('mode',['allow-scripts'])[0]
   body='<html><head><title>Migration sandbox read-only audit</title></head><body><h1>Sandbox: '+html.escape(mode)+'</h1>'
   for i,p in enumerate(samples):body+='<h2>'+html.escape(p)+'</h2><iframe title="sample '+str(i)+'" width="720" height="300" sandbox="'+html.escape(mode)+'" src="/archive/'+quote(p)+'"></iframe>'
   data=(body+'</body></html>').encode();typ='text/html; charset=utf-8'
  elif u.path.startswith('/archive/'):
   p=(A/unquote(u.path[9:])).resolve()
   if not p.is_relative_to(A.resolve()) or not p.is_file():self.send_error(404);return
   data=p.read_bytes();typ=mimetypes.guess_type(p)[0] or 'application/octet-stream'
  else:self.send_error(404);return
  self.send_response(200);self.send_header('Content-Type',typ);self.send_header('Content-Length',str(len(data)));self.end_headers();self.wfile.write(data)
ThreadingHTTPServer(('127.0.0.1',8765),Handler).serve_forever()
ブラウザ操作スクリプト(cua_replで順次実行)
let tab = await cua.createBrowserTab("iab", "http://127.0.0.1:8765/", { visible: false });
nodeRepl.write(await tab.dev.logs({levels:["error","warn"],limit:20}));
nodeRepl.write(await tab.playwright.locator('iframe').evaluateAll(es=>es.map(e=>({title:e.title,sandbox:e.getAttribute('sandbox'),height:e.getBoundingClientRect().height}))));
await tab.playwright.frameLocator('iframe[title="sample 1"]').getByRole('button',{name:'happy HAPPY',exact:true}).click();
nodeRepl.write(await tab.playwright.frameLocator('iframe[title="sample 1"]').locator('body').innerText());
nodeRepl.write(await tab.playwright.frameLocator('iframe[title="sample 0"]').locator('body').evaluate(e=>({height:e.scrollHeight,width:e.scrollWidth,svg:e.querySelectorAll('svg').length})));
nodeRepl.write(await tab.playwright.frameLocator('iframe[title="sample 1"]').locator('body').evaluate(e=>({height:e.scrollHeight,images:[...e.querySelectorAll('img')].map(x=>({ok:x.complete&&x.naturalWidth>0}))})));
await tab.playwright.frameLocator('iframe[title="sample 2"]').getByRole('button',{name:'読み違い',exact:true}).click();
nodeRepl.write(await tab.playwright.frameLocator('iframe[title="sample 2"]').locator('#note').innerText());
await tab.playwright.frameLocator('iframe[title="sample 4"]').getByRole('button',{name:'Next Design',exact:true}).click();
nodeRepl.write((await tab.playwright.frameLocator('iframe[title="sample 4"]').locator('body').innerText()).slice(0,550));
await tab.playwright.frameLocator('iframe[title="sample 3"]').getByRole('button',{name:'▶ 再生',exact:true}).click();
nodeRepl.write(await tab.playwright.frameLocator('iframe[title="sample 3"]').getByRole('button').allTextContents({}));
await tab.goto('http://127.0.0.1:8765/?mode=allow-forms');
await tab.getAXState();
// 次のclickはブラウザ側タイムアウト。成功とは扱っていない。
await tab.playwright.frameLocator('iframe[title="sample 1"]').getByRole('button',{name:'happy HAPPY',exact:true}).click();
// 上の例外のため、同呼出しの次行は未実行。
// nodeRepl.write((await tab.playwright.frameLocator('iframe[title="sample 1"]').locator('body').innerText()).slice(0,160));
await tab.close();
失敗した通常Chrome起動の試験
実行:依存ランタイムのNodeで次を実行。SIGABRTで終了し、表示成功の根拠には使っていない。
const {chromium}=require('/Users/shimazueiichi/.cache/codex-runtimes/codex-primary-runtime/dependencies/node/node_modules/playwright');
(async()=>{try{let b=await chromium.launch({headless:true,channel:'chrome'});console.log(await b.version());await b.close()}catch(e){console.log(e.message)}})();
読取りに使った主要シェルコマンド
cat research/codex_request_site_migration_20261016.md
cat research/research_site_migration_plan_20261016.md
cat site_archive/README.md
cat site_archive/index/09_Studio移行メモ.md
cat マスターMD/MASTER.md
sed -n '1,180p' /Users/shimazueiichi/r2r2r-content/methodology/article_rules.md
cat /Users/shimazueiichi/r2r2r-content/methodology/language_rules.md
rg -n '場所を増やす|公開記事|記事・SNS|画像は|GitHub には|【画像】|【図解】|Studio CMS 整形|必須出力|コピーコマンド|git コマンド' マスターMD/MASTER.md /Users/shimazueiichi/r2r2r-content/methodology/article_rules.md
シェルの相対表記はPixelstoMotorsを基準にした再実行用表記。実際の読取りは各絶対パスで実施。gitのcommit/push/clean/pullは実行していない。プロジェクト原本の変更・移動・削除はしていない。報告書の生成そのものは上記の診断コードと分離して行った。