自分の記事を3つのAIで読み比べた日、コンテンツ生産の構造が変わった
自分の文体が均質化していないか、判断できないでいた。クウキデザインの動画を見て、答えが見えた。
「シリコンバレー17年のプロが本気でAIエージェント使い込んだ結果全部見せます」——クウキデザインのその動画を見たのは、ある問題意識を抱えたままだったからだ。
100本を超えたあたりから、自分の記事のクセが気になり始めていた。「〜のは」「重要なのは〜」「結論として」という定型句が増えていないか。文体が均質化していないか。判断できない。書いた本人には見えない種類の問題だ。
動画の中で、元グーグルのUXデザイナーが1000時間AIエージェントを稼働させた運用組織を丸ごと見せていた。4チーム・18体のAIエージェント構成。原稿を書くエージェント、トーン統一エージェント、AIっぽさを検出するエージェント、4段階のレビューエージェント——役割ごとに1つが担当している。
「1機能=1エージェント、レビュー多段化」。Claude Codeで複数スクリプトを用途別に分けている感覚に近かった。この発想をコンテンツ生産ラインに持ち込めると思った。
Claudeに自分の文章をレビューさせない
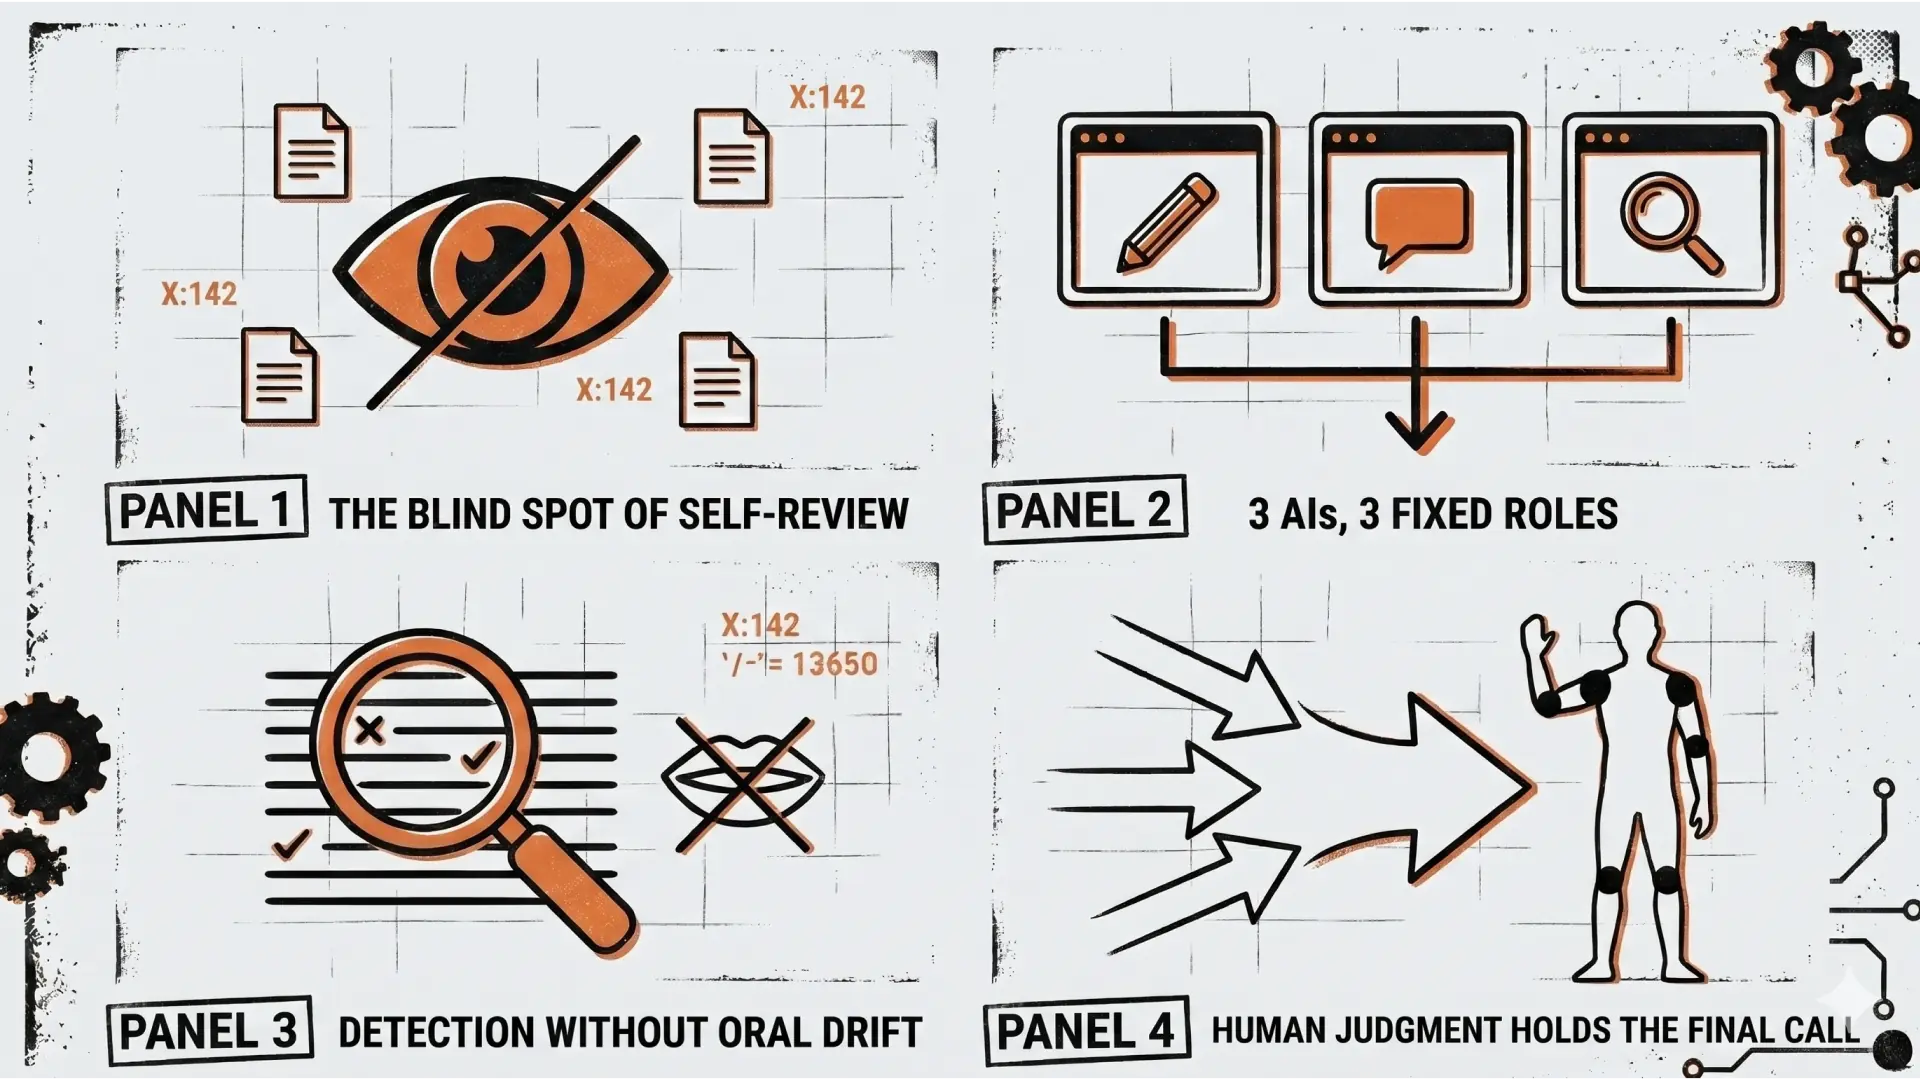
Pixels to Motorsの発信が「AIで量産された感」になったら終わりだと思っていた。そのリスクは常にある。ただ、そのチェックをClaudeにやらせようとすると、構造的な矛盾がある。
——生成した本人に校正させると何が起きる?
自分のクセに無自覚なまま通してしまう。「断定の島」「短く切る」「具体物に着地させる」といった自分の文体の特徴を、生成元のAIは言語化できても、それが今のドラフトに出ているかどうかは判定しにくい。自分が作ったものを自分で評価する構造的な甘さがある。
Geminiなら「自分が生成していないから客観的にAI文体を判定できる」という逆説がある。ChatGPTなら「大量の自然文を見ていて、日本語の引っかかり検出に強い」という特性がある。それぞれに得意専野を1つだけ割り当てる——これが設計の出発点だった。
3AIの役割を固定する
設計はシンプルだ。
AI | 役割 | 武器 |
|---|---|---|
Claude | 生成・総合リライト・戦略判断 | プロジェクトメモリ、長文一貫性、構造設計 |
ChatGPT(Pixels to Motors Business) | 文体一致度チェック | カスタムGPT、長期メモリ、温度感の調整 |
Gemini(有料) | AIっぽさ検出・事実検証 | Gem機能、検索連携、Deep Research、客観性 |
私 | 最終判断 | 29年の目 |
Claudeには、自分の文章をレビューさせない。これが核心だ。
——実際に動くものを作るとどうなる?
ChatGPTのカスタムGPT「文体チェッカー v1」を作った。GeminiのGem「AIっぽさ検出器 v1」も作った。Claude Codeに依頼して過去の記事から文体サンプル5本を自動抽出させた。ALL_SAMPLES.mdというファイルができた。
Claude Codeの選定は見事だった。ジャンル別に5本——失敗談・気づき系、技術解説・思想系、業界観測・批評系、体制論・哲学系、build-in-public日常記録系——を選んで、選定理由を1行ずつ添えてきた。字数も2,924〜3,373字で収まっていて、システムプロンプトに入れる分量としてちょうどいいサイズ感だった。
AIっぽさ検出の設計
Geminiは「AIっぽさ除去=口語化」と誤解する瞬間がある。そこは違う。自分の文体は崩す方向ではなく「切る方向」だからだ。指示文の設計に一番時間をかけた。
検出基準として設定したのはこういうパターンだ。
【検出基準】以下のパターンがあれば該当箇所を引用して指摘してください。

1. 定型表現
   - 「重要なのは〜」「興味深いことに」「〜のような」
   - 「結論として」「まとめると」「3つのポイント」型

2. 抽象化しすぎ
   - 具体名詞・数字・固有名詞なしで進む段落
   - 「様々な」「多くの」「一般的に」が連発される箇所

3. 過剰な丁寧さ・冗長さ
   - 一文で済む内容を二文に分けている

【出力形式】
- 該当箇所を「引用 → 問題種別 → 修正案」の形で列挙
これを1記事につき1回のGemini呼び出しで完結させる。無料枠でも問題ない。
ClaudeやChatGPTのメモリに入っていない最新仕様を、その場で引いてこれる。ここはGeminiが強かった。
ただ、口語化への暴走を止める注記が要った。
【重要な注意】
修正案を提示するとき:
- 「だ・である」調を基本として保ってください
- 「〜なきゃいけない」「〜だよね」など過度の口語の修正は提案しないでください
- ALL_SAMPLES.md の文体サンプルに実在する表現範囲内で修正案を出してください
- 「短く切る」「断定する」「具体物に着地させる」がAIっぽさ排除の方向性であり、口語化ではありません
試運転で確認できたこと
公開済みの記事1本で試運転した。校正済みのお手本なので、チェッカーの精度を検証するサンプルとして使えた。
文体チェッカー v1 は「断定の島」「短く切る」「具体物に着地させる」などの構造的な特徴を言語化してくれた。過去記事のサンプルをファイル名で引用しながら解説できていて、サンプル投入が効いている証拠だった。
AIっぽさ検出器 v1 は修正案を具体的な書き換え例で出してくれた。NGパターン辞書のカテゴリ分類(A/B/C)が機能していた。事実検証も走った——macOS Tahoe、Iriun仕様、mechArm関節仕様を全部チェックして役割分担通りだった。
2つのAIが指摘する場所が違った。ChatGPTは文章全体の温度を見る。Geminiは単語単位で引っかかる。その役割分担が、設計した通りに成立していた。
——これは使えると思ったか?
試運転の段階で、指摘の多くが「該当なし」だった。校正済みのお手本なので、理想的にはそれでいい。ただ「断定の島」という指摘は、自分では気づけなかった言語化だった。ChatGPTが修正案で示した「実機を動かさずに機械設計と物理設置の両方をカバーした一日だった」という例は、実際に採用したいくらい良かった。
追加負荷は1記事あたり10分程度だった。生成フロー自体は既存のまま変えない。Claude生成→両AIへ並行投入(ブラウザ2タブ同時)→Claudeでリライト→私が最終確認、という流れだ。
ChatGPTとGeminiは独立して動かせるので、ドラフトができたら2つのブラウザタブに同時にペーストして、それぞれが動いている間に別作業ができる。時短になる。
このフロー自体が記事になる
セットアップを終えたとき、気づいた。
この運用フロー自体が、Pixels to Motorsの考察記事のテーマになる。「Motion UXを語る人が、自分のコンテンツ生産プロセスをどうMotion UX化するか」という再帰構造だ。
ロボットアームの動作を設計するとき、「アームの軌道が正しいかどうか」は数値では測れない部分がある。29年かけて培った「これは気持ちいい動きか」という感覚が最後の判断基準になる。コンテンツも同じだ。AIが「らしい」と判定した文章が、本当にそうかどうかは、最終的に自分にしか分からない。チェッカーはその判断を補助するためにある。主権は渡さない。
Claudeが生成し、ChatGPTが文体を守り、Geminiが事実とAIっぽさを検証する。この三層構造が今動き始めた。