研究記録サイトの来訪が減った原因を探す ― Google の順位が11/11に急落していた
この記事の素材(コード・ログ・データ 2ファイル・まとめてダウンロードあり)arrow_downwardAIで読む ChatGPT・Claude などで、この記事に質問できます expand_more
ロボットの研究記録サイト pixelstomotors.com の人の表示は、2026年10月26日の週の163回から11月16日の週の37回へ、約4分の1になった。減った分の1つは Google 検索から来る人で、Google の平均掲載順位が11月11日に約17位から23〜71位へ落ちていた。もう1つの、ブックマークや SNS のアプリなど「直接」来る人の減少(週66回→15回)は、原因がまだ分からない。 サイトに自前で入れている計測と、Google Search Console(自分のサイトが Google 検索でどう扱われているかを見る Google の無料の道具)で、Claude と一緒に確かめた。
この確認で、次のことができるようになった。
- 減った分を、原因が分かった分(Google の順位)と、分からない分(直接来る人)に分けられた。順位のほうは、Google の更新が落ち着いてから前後を比べる(12/4 に予約済み)。直接来る人のほうは、どこで知って来ていた人かを調べる必要がある、と次にやることがはっきりした
- 人が実際に読み込んでいる記事が分かった。ロボットアーム mechArm 270 の初期の作業記録(LOG12〜LOG126)と、配膳ロボットの試算。研究の外側の作業を書いた記事(このシリーズ)は、人にはほとんど読み進められていない
- 調べる途中で見つけた、クローラー(検索や AI のために、サイトを自動で読み回るプログラム)の「ページがない」が2種類あり、どちらも直して公開した。1つは週60回ほどの
/null、もう1つは記事に載せたコードの中の文字を住所と見て取りに来る分(64記事分)。減ったかどうかは、来週のクローラーの記録で確かめる(今は見込み) - かかった時間は、依頼(08:27)から2つ目の直しの公開を確かめるまで約55分。前に同じ確認をしたことがないので、比べる時間はない
きっかけは「サイトのアクセス解析」という一言だった。週ごとの数を並べると、人の表示は 163 → 136 → 71 → 37 と減り続けていた。一方で、ChatGPT や Claude が利用者に頼まれてサイトを読みに来た回数は、同じ4週で 55 → 61 → 51 → 100 と増えていた。人は減り、AI の読みは増えている。続けて「人の来訪が減ってる理由はなんですか?」と聞かれ、来た所ごとに分けて Search Console と突き合わせた。
| やったこと | なぜ | 結果 |
|---|---|---|
サイトの計測の3つの数字と人の表示を、4週分並べた | 週の分析の始まり | 人の表示は 163 → 37。AI が依頼で読んだ数は 55 → 100 |
人の表示を、来た所(直接・Google・サイト内・その他)ごとに週で分けた | 何が減ったのかを分けるため | 直接・不明が 66 → 15、Google+Yahoo が 41 → 9 |
Search Console で、Google 検索の日ごとの表示と掲載順位を見た | Google から来る人の減り方を確かめるため | 11/10 に表示が1日21回に落ち、11/11 から順位も23〜71位に |
X の投稿が止まっていないかを、X のプロフィールで見た | 直接来る人の減り方の原因の候補だったため | 1日5〜6本出ていた。止まっていない |
人がよく見たページを4週分まとめた | 何が読まれているかを知るため | 初期の DAY 記録と配膳ロボットの試算がよく読まれ、裏側の記事は読まれていない |
クローラーの「ページがない」(404)の出どころを、サイトのコードで探した | 4週の記録に同じ形の404が並んでいたため | /null はハコブくんのスクリプト、{src} などは記事に載せたコードの中の文字 |
2つを直して公開した(2つ目は Codex のレビューを通した) | クローラーが無駄に取りに来る回数を減らすため | /null を生む文字をなくした。{ } を含む住所に 410 を返すようにした |
下の図で、人の表示がどこから来た人で減ったかと、Google 検索の日ごとの表示・掲載順位を切り替えて見られます。
作業ログ ― サイトの計測の数字を4週分並べた
サイトの計測と、3つの数字の読み方
このサイトの計測は、Cloudflare Workers(サイトの手前で動く小さなプログラム)の上で自前で数えている。Claude からは計測の道具(PTM)を通して数字を読み、数を読む前に、まず読み方(how_to_read)を読む決まりにしている。
いま主に見る数字は3つ。AI の利用者の依頼で読みに来た数(ChatGPT-User・Claude-User・Perplexity-User などがページを取りに来た回数)、AI のサービスのリンクから来た人の数、サイト名で検索して来た人の数。人の表示は、マウス・指・キーの操作があった表示だけを数える(表示の約9割は機械なので)。
4週の3つの数字と人の表示(2026-10-26〜11-22・11/22 は途中の数)
| 週 | 人の表示 | AI が依頼で読んだ数 | 内訳 | AI のリンクから来た人 | サイト名の検索 |
|---|---|---|---|---|---|
| 10/26〜 | 164 | 55 | ChatGPT-User 52・Claude-User 3 | 0 | 0 |
| 11/02〜 | 136 | 61 | ChatGPT-User 45・Claude-User 16 | 3(ChatGPT) | 0 |
| 11/09〜 | 71 | 51 | ChatGPT-User 35・Claude-User 8・Perplexity-User 8 | 3(ChatGPT) | 0 |
| 11/16〜 | 37 | 100 | ChatGPT-User 71・Claude-User 29 | 4(ChatGPT) | 未記録 |
人の表示は、計測の道具の2つの集計(3つの数字の集計と、ページごとの集計)で、10/26 の週だけ 164 と 163 の1件の差がある。以下の来た所の表は、ページごとの集計(163)で数えている。
11/9 の週の Perplexity-User 8件は、LOG527 で調べたとおり設定ファイルを探す機械だった。AI のリンクから来た人は4週で合わせて10人で、すべて ChatGPT から。30人に満たないので、増えたか減ったかの判断はまだできない。
Claude-User の読みと、作業の時刻を突き合わせた
11/16 の週の Claude-User 29件には、こちらの作業が混ざっているかもしれない。Claude-User の1件ずつの時刻を出し、チャットの履歴と並べた。
Claude-User の時刻(日本時間) | 読んだページ | 同じ時間帯の作業 |
|---|---|---|
11/17 09:41〜09:42 | /series4・/record/day17・/record/day18 | 不明 |
| 11/17 13:08 | /record/making-explainer-video-with-ai | 不明 |
11/17 18:04〜18:09 | π0.5 の記録10本(/guide/pi05-mecharm-270 など) | SO-101 の受け入れを整理したチャット(LOG530)の日 |
11/18 20:36〜22:17 | /series5・/record/first-video-end-to-end・/guide・/record/making-explainer-video-with-ai | ガイドのサムネイルを作ったチャット(LOG531)の夜 |
11/19 01:31〜21:49 | /・/tokushoho・/record/youtube-views-to-right-viewers・/serving-robot-one-less-staff | 不明 |
11/20 10:40〜19:30 | /・/issues・/message | 不明 |
| 11/22 07:52 | /・/series4 | 不明 |
作業の日と重なるものはあるが、分単位で時刻が合ったものはない。決まりどおり「試し」とは言わず、未確認として扱う。AI の読みの増え方を見るときは、ChatGPT-User(35 → 71)を中心に見るほうが安全。
作業ログ ― 人の表示を来た所ごとに分けた
週ごとの来た所(人の表示・計測のページごとの集計から)
| 週 | 直接・不明 | Google+Yahoo | サイト内の移動 | その他 | 合計 |
|---|---|---|---|---|---|
| 10/26〜 | 66 | 41(Google 33・Yahoo 8) | 43 | 13 | 163 |
| 11/02〜 | 67 | 39(Google 37・Yahoo 2) | 17 | 13 | 136 |
| 11/09〜 | 20 | 21(Google 21) | 21 | 9 | 71 |
| 11/16〜 | 15 | 9(Google 9) | 7 | 6 | 37 |
その他の内訳は次のとおり。
| 週 | その他の内訳 |
|---|---|
| 10/26〜 | LinkedIn 4・Microsoft Teams 3・X(t.co)3・市のサイト 2・Google アプリ 1 |
| 11/02〜 | LinkedIn 3・LinkedIn アプリ 1・ChatGPT 3・Bing 2・studio.design 2・YouTube 1・X(t.co)1 |
| 11/09〜 | ChatGPT 3・LinkedIn 3・Google Keep 2・自分の試しのリンクの印 1 |
| 11/16〜 | ChatGPT 4・studio.design 1・Bing 1 |
11/16 の週の合計は、11/9 以降の集計(108)から 11/16 以降の集計(37)を引いて 11/9 の週(71)を出している。
減った分の大半は「直接・不明」(66 → 15)と「Google+Yahoo」(41 → 9)だった。 サイト内の移動は、外から入ってくる人が減れば一緒に減るので、原因ではなく結果と見ている。
Google 検索の日ごとの表示・クリック・掲載順位(Search Console・2026-10-19〜11-21)
Search Console の「検索結果のパフォーマンス」を、日ごとの表で開いて読み取った(新しいドメイン sc-domain:pixelstomotors.com)。最初は Claude のデスクトップアプリの中のブラウザで開こうとしたが、Google への再ログインを求められたので、ふだんの Chrome(Claude in Chrome)で開いた。
| 日 | クリック | 表示 | 平均掲載順位 |
|---|---|---|---|
| 10/19 | 6 | 155 | 21.0 |
| 10/20 | 0 | 143 | 19.7 |
| 10/21 | 1 | 146 | 15.8 |
| 10/22 | 1 | 143 | 17.6 |
| 10/23 | 2 | 111 | 19.6 |
| 10/24 | 0 | 100 | 20.2 |
| 10/25 | 3 | 132 | 19.8 |
| 10/26 | 2 | 187 | 20.6 |
| 10/27 | 2 | 131 | 14.2 |
| 10/28 | 3 | 125 | 18.1 |
| 10/29 | 1 | 109 | 14.8 |
| 10/30 | 0 | 100 | 15.4 |
| 10/31 | 2 | 86 | 21.5 |
| 11/01 | 2 | 89 | 18.8 |
| 11/02 | 0 | 87 | 16.2 |
| 11/03 | 2 | 97 | 20.3 |
| 11/04 | 2 | 96 | 17.0 |
| 11/05 | 6 | 133 | 12.2 |
| 11/06 | 5 | 98 | 16.3 |
| 11/07 | 1 | 70 | 13.3 |
| 11/08 | 4 | 95 | 18.3 |
| 11/09 | 6 | 148 | 17.4 |
| 11/10 | 2 | 21 | 17.3 |
| 11/11 | 1 | 9 | 70.7 |
| 11/12 | 0 | 22 | 34.3 |
| 11/13 | 1 | 13 | 50.1 |
| 11/14 | 0 | 17 | 51.4 |
| 11/15 | 0 | 13 | 47.4 |
| 11/16 | 1 | 10 | 23.3 |
| 11/17 | 0 | 10 | 46.0 |
| 11/18 | 0 | 14 | 42.1 |
| 11/19 | 0 | 23 | 56.9 |
| 11/20 | 1 | 22 | 62.8 |
| 11/21 | 0 | 18 | 66.4 |
11/9 までは掲載順位が12〜22位で、表示は1日70〜187回。11/10 に表示が21回へ落ち(順位はまだ17位)、11/11 からは順位も23〜71位に下がった。Google の11月のコアアップデート(検索の順位の付け方の大きな更新)は 11/10 に始まっている(LOG527)。クリックは、11/9 までの週ごとに 12・20 回、11/9 の週は 10 回、11/16 の週は 2 回。サイトの計測で Google から来た人(33・37・21・9)と、増え減りの向きがそろっている。
X の投稿は止まっていなかった
直接・不明の来訪には、X や LinkedIn のアプリの中のブラウザから来た人が入りやすい(アプリは来た所を送らないことが多い)。X の投稿が減っていれば、直接の来訪が減った説明になる。サイトのフッターにある X のアカウント(@adaptdesignjp)を開き、投稿を新しい順に29本読み取った。
| 日(日本時間) | 投稿の数(読み取った分) |
|---|---|
| 11/21 | 2(10:39・03:30) |
| 11/20 | 7(22:30・13:00・12:41・12:42・12:00・11:00・10:30) |
| 11/19 | 5(22:30・13:00・12:00・10:30・03:30) |
| 11/18 | 3 以上(22:30・13:00・12:00) |
11/18〜11/21 も1日5〜7本出ていて、予約投稿は止まっていなかった。X の投稿の数は、直接の来訪の減り方を説明しない。
/message を開いた7回は、外の人だった
減る前の2週の「直接・不明」は、短い時間で何度も開かれたページに偏っていた。10/26 の週は /gpu-buy-or-rent が17回(表示の中央値11秒)、11/2 の週は /issues が11回・/manga-archive が8回・/message が7回。少ない人数が繰り返し開いていた形に見えたので、エイイチ自身の確認が計測を止める印(?p2m-notrack=1)なしで入っていたかもしれない、と Claude は見立てた。
これに対してエイイチから、/message を7回も開いていない、別の人ではないか、と返ってきた。見立ては外れていて、直接来た人の多くは外の人だった。そうなると、直接の来訪が 66 → 15 に減ったのは、実際に見に来る人が減ったと見るのが自然になる。どこで知って来ていた人たちかは、来た所が「不明」なので、今の記録では分からない。
作業ログ ― 人が読んでいるページを4週分まとめた
ページごとの人の表示(2026-10-26〜11-22・表示が3回以上のページ)
表示の中央値は、そのページにいた時間の真ん中の値。「75%まで読んだ」は、ページの4分の3まで下に進んだ表示の割合。
| ページ | 表示 | 中央値(秒) | 25%まで | 50%まで | 75%まで | 最後まで |
|---|---|---|---|---|---|---|
| / (トップ) | 51 | 15 | 69% | 43% | 27% | 20% |
| /issues (課題地図) | 22 | 10 | 9% | 5% | 0% | 0% |
/gpu-buy-or-rent | 21 | 11 | 52% | 52% | 10% | 0% |
| /manga-archive | 14 | 9 | 21% | 7% | 7% | 0% |
| /series8 | 13 | 15 | 15% | 15% | 15% | 8% |
| /record/day18 | 11 | 53 | 91% | 64% | 27% | 9% |
| /message | 11 | 10 | 100% | 100% | 91% | 9% |
| /series6 | 8 | 18 | 63% | 38% | 38% | 25% |
| /record/day17 | 8 | 25 | 75% | 75% | 38% | 0% |
| /record/day12 | 8 | 23 | 100% | 63% | 38% | 25% |
/record/service-robot-last-mile | 7 | 15 | 0% | 0% | 0% | 0% |
/record/large-restaurant-five-serving-robots-longer-wait | 7 | 19 | 29% | 14% | 14% | 0% |
/record/from-sim-series-to-lp | 6 | 69 | 50% | 50% | 17% | 0% |
/record/beyond-imitation-learning | 6 | 19 | 50% | 50% | 50% | 0% |
| /series4 | 5 | 9 | 100% | 40% | 40% | 40% |
/record/building-a-physical-ai-lab-at-home | 5 | 20 | 40% | 20% | 0% | 0% |
| /consult | 5 | 13 | 100% | 60% | 20% | 20% |
/record/alphanist-binary-reward-assembly | 5 | 16 | 80% | 60% | 60% | 40% |
/record/check-serving-robot-sim-with-phone | 5 | 39 | 20% | 20% | 20% | 0% |
/record/youtube-opening-question-first | 5 | 11 | 20% | 0% | 0% | 0% |
| /record/day145 | 4 | 59 | 50% | 25% | 25% | 0% |
/record/serving-robot-cost-subsidy | 4 | 45 | 25% | 25% | 25% | 0% |
/record/so101-imitation-learning-papers | 4 | 15 | 0% | 0% | 0% | 0% |
/record/video-patterns-and-try-it | 4 | 18 | 25% | 25% | 25% | 25% |
/serving-robot-one-less-staff | 4 | 156 | 75% | 50% | 50% | 50% |
/record/serving-robot-video-part2 | 4 | 11 | 25% | 0% | 0% | 0% |
/record/serving-robot-video-ledger | 4 | 12 | 50% | 50% | 0% | 0% |
/record/small-store-second-robot-wait | 3 | 15 | 33% | 33% | 33% | 0% |
/record/one-year-lp-charts | 3 | 14 | 0% | 0% | 0% | 0% |
/record/serving-robot-hidden-waits | 3 | 15 | 33% | 0% | 0% | 0% |
/record/road-marking-job-post-and-physical-ai | 3 | 56 | 67% | 67% | 67% | 0% |
| /manga/ep133 | 3 | 9 | 100% | 0% | 0% | 0% |
/record/claude-project-linked-folders | 3 | 28 | 67% | 33% | 33% | 0% |
| /record/day126 | 3 | 93 | 67% | 67% | 33% | 33% |
読まれ方の種類で分けた
| 種類 | 主なページ | 読まれ方 |
|---|---|---|
mechArm 270 の初期の DAY 記録 | day12・17・18・120・126・145 | 回数が多く、半分以上まで読む人が多い。Google から来ている |
| 配膳ロボットの試算 | /series8・配膳ロボットの LP・大型店に5台・補助金 | 毎週少しずつ。LP は中央値156秒で、動画を何度も再生している(4回の表示で133回) |
| 考察記事 | 日本のロボットの差(中央値449秒)・HD マップ(364秒) | 回数は少ないが、来た人は長く読む |
| 入口のページ | トップ・/issues・/manga-archive | トップは読まれる。/issues とマンガの一覧は、開いてすぐ離れる |
π0.5・研究室の記録、動画の作り方、マンガの裏側 | 記事の数は多い | 1本あたり1〜2回で、ほとんど読み進まれない |
ChatGPT のリンクから来た10人の行き先は、YouTube の冒頭の作り方の記事(2回)・動画づくりの記事・day12・トップなどに散らばっていて、決まった入口はなかった。
作業ログ ― クローラーの「ページがない」(404)の出どころを探した
404 と 410 と、meta-externalagent
404 は、サーバーが「そのページはない」と返す番号。410 は「そのページはもうない(今後もない)」と返す番号で、取りに来る側に、もう来なくてよいと伝える意味を持つ。meta-externalagent は、Meta が AI のためにサイトを読み回るクローラー。
クローラーの記録(11/9 から2週)には、同じ形の404が並んでいた。
| 住所 | 返した番号 | 取りに来た回数 | 取りに来たクローラー |
|---|---|---|---|
| /null | 404 | 26(〜11/18)・11/16 の週は60 | meta-externalagent |
/files/LOG502/{src}・{c}・{o}・{e[0]}・{e[1]}・{m[l]}・{EI[p][0]} | 404 | 各2〜4 | ClaudeBot・GPTBot・Amazonbot |
/files/LOG506/{href}・/files/LOG507/{src}・/files/LOG511/{src} ほか | 404 | 各2〜4 | ClaudeBot・GPTBot・Amazonbot |
/record/{src}・/record/{href}・/record/{URL}・/record/${MSG_URL} ほか | 404 | 各1〜2 | ClaudeBot・GPTBot・Amazonbot |
/files/LOG493/{s.img.startsWith(’/’) | 404 | 4 | GPTBot・ClaudeBot・Amazonbot |
/files/LOG502/{src} は、記事に載せたコードの中の文字だった
p2m-site(このサイトのコードの置き場所)で、public/files/LOG502/ のファイルを探した。
$ grep -c '{src}\|{c}\|{e\[0\]}' public/files/LOG502/*
public/files/LOG502/02_sec12.py.txt:3
public/files/LOG502/01_sec10.py.txt:0
public/files/LOG502/04_sec15.py.txt:0
public/files/LOG502/03_sec13.py.txt:1
public/files/LOG502/05_sec16.py.txt:0
public/files/LOG502/index.json:0
public/files/LOG502/LOG502_full.md:4
$ grep -n 'src="{src}"\|href="{href}"\|{s.img.startsWith' -r public/files/LOG502 public/files/LOG493 public/files/LOG506
public/files/LOG502/LOG502_full.md:696:            f'<img data-a="pop" data-t="0.35" data-d="0.5" src="{src}" style="position:absolute;left:{left}px;top:{top}px;width:{w}px">')
public/files/LOG502/02_sec12.py.txt:203:            f'<img data-a="pop" data-t="0.35" data-d="0.5" src="{src}" style="position:absolute;left:{left}px;top:{top}px;width:{w}px">')
public/files/LOG493/LOG493_full.md:627:          <img src={s.img.startsWith('/') ? s.img : media(`/media/${s.img}`)} alt={`${s.ja}|${s.en}`} loading="lazy" />
public/files/LOG493/03_sec04.txt:144:          <img src={s.img.startsWith('/') ? s.img : media(`/media/${s.img}`)} alt={`${s.ja}|${s.en}`} loading="lazy" />
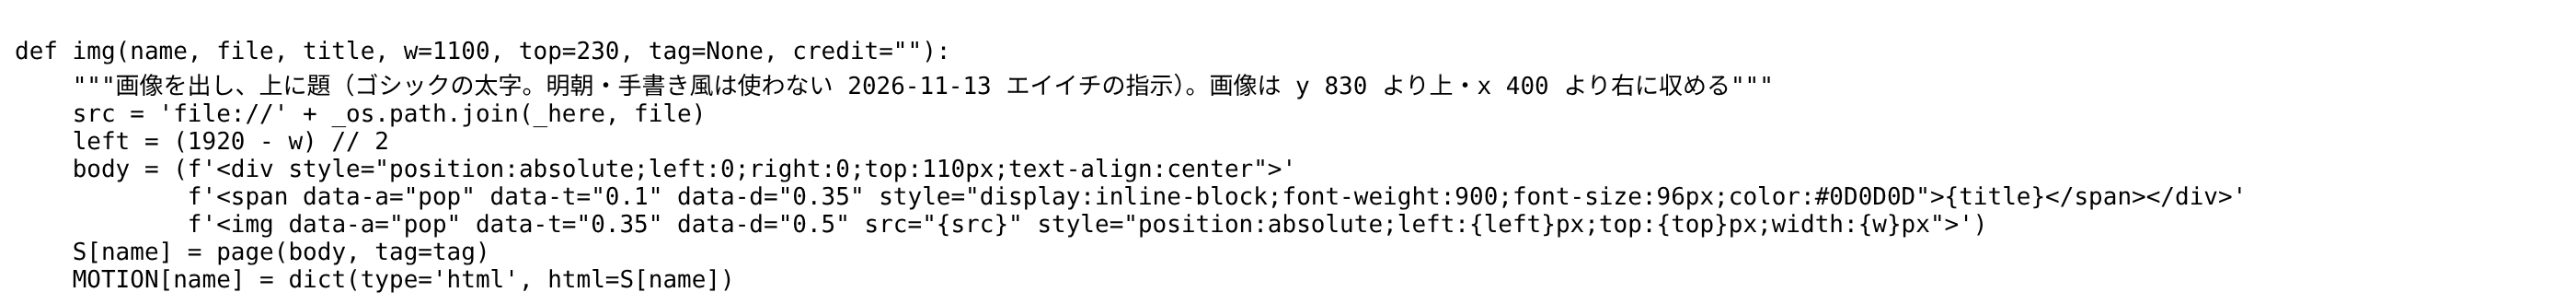
記事に載せた Python のコードには、HTML を組み立てる文字として src="{src}" が入っている。GPTBot・ClaudeBot・Amazonbot は、.txt や .md の中からも src="…" href="…" の形を拾い、そのファイルの置き場所(/files/LOG502/)から見た住所として取りに来ていた。/record/{src} のほうは、記事の Markdown 版(/record/{slug}.md)の中のコードから拾っている。同じ形の文字があるのは、public/files/ の64記事分だった。
$ grep -rlE 'src="\{|href="\{|src=\{|href=\{|\$\{[A-Z_]+\}' public/files | sed -E 's#public/files/(LOG[0-9]+)/.*#\1#' | sort -u | wc -l
64
$ find public src/pages -name '*[{}`]*'
(出力なし)
コードは全文を載せる決まりなので、中身は変えない。サイトに { } ` を名前に含むファイルは1つもないので、そういう住所には 410 を返してよい、と考えた。
/null は、ハコブくんのスクリプトの文字の ‘null’ だった
/null のほうは、ページの中にリンクがなかった。トップ・記事・課題地図・マンガのページの HTML、サイトマップ、llms.txt、更新の一覧 updates.json を探しても、null へのリンクはない。
$ curl -s https://pixelstomotors.com/updates.json | python3 -c "..."
<class 'dict'> ['items']
20
[{'id': 'record:ai-leaves-cleanup-600gb-video-frames-on-external-ssd', 'kind': 'record', 'label': 'LOG546', 'title': 'AIに作業を任せると、片付けは残る ― 外付けSSDの600GBが動画のコマだった', 'url': '/record/ai-leaves-cleanup-600gb-video-frames-on-external-ssd', 'date': '2026-11-22T00:00:00.000Z'}, {'id': 'record:why-microfactory-robots-are-reliable-llm-and-pi05', 'kind': 'record', 'label': 'LOG545', 'title': '小さな会社のロボットはなぜ確実に動くのか ― MicroFactory の LLM と π0.5 の使い分け', 'url': '/record/why-microfactory-robots-are-reliable-llm-and-pi05', 'date': '2026-11-21T00:00:00.000Z'}]
[]
$ for u in / /record/ai-leaves-cleanup-600gb-video-frames-on-external-ssd /issues /manga-archive /series8 /manga/ep147 /record/day18; do ... grep null ...; done
== / 96356
== /record/ai-leaves-cleanup-600gb-video-frames-on-external-ssd 87175
== /issues 120988
== /manga-archive 84609
== /series8 136008
== /manga/ep147 70430
== /record/day18 54308
(どのページにも null へのリンクはなかった)
$ curl -s https://pixelstomotors.com/sitemap.xml | grep -c null
0
次に、実際のブラウザ(Playwright の Chromium)でページを動かし、/null を取りに行く動きがないかを見た。
import asyncio,sys
from playwright.async_api import async_playwright
pages=sys.argv[1:]
async def main():
  async with async_playwright() as p:
    b=await p.chromium.launch()
    for path in pages:
      ctx=await b.new_context(user_agent="Mozilla/5.0 (compatible; probe)")
      pg=await ctx.new_page()
      hits=[]
      pg.on("request",lambda r:hits.append(r.url))
      try:
        await pg.goto("https://pixelstomotors.com"+path+("&" if "?" in path else "?")+"p2m-notrack=1",wait_until="networkidle",timeout=45000)
        await pg.wait_for_timeout(4000)
      except Exception as e: print("ERR",path,e)
      bad=[h for h in hits if "/null" in h or "undefined" in h or "%7B" in h]
      print(path,len(hits),bad)
      await ctx.close()
    await b.close()
asyncio.run(main())
$ python3 /tmp/probe.py / /record/day109 /manga/ep13 /english-4-koma/ep31 /record/ai-leaves-cleanup-600gb-video-frames-on-external-ssd
/ 64 []
/record/day109 31 []
/manga/ep13 34 []
/english-4-koma/ep31 30 []
/record/ai-leaves-cleanup-600gb-video-frames-on-external-ssd 30 []
ブラウザで動かしても /null は出ない。そこで、ページが読み込むスクリプトの中の文字を探した。
$ curl -s https://pixelstomotors.com/_astro/HakobuParade.astro_astro_type_script_index_0_lang.DJ-JM5aE.js | grep -oE ".{60}['\"\`]null['\"\`].{30}"
{})}catch{}}try{const t=JSON.parse(localStorage.getItem(u)||"null");t&&!t.done&&location.pathnam
("click",n);try{const c=JSON.parse(localStorage.getItem(u)||"null");c&&c.id===n.id&&(c.clicked=!
更新を知らせるハコブくんのスクリプトに、"null" という文字が2か所あった。meta-externalagent は同じスクリプトの中の '/updates.json' を、2週で952回取りに来ている。スクリプトの中の文字の並びを住所として拾っていて、"null" も同じように /null として取りに来ていると見た。1件ずつの記録を見ても、/null は特定のページの直後ではなく、ほかのページを読み回る合間に1〜2時間おきに出ていた。
| 時刻(11/22・日本時間) | meta-externalagent が取りに来たもの |
|---|---|
| 04:13:56 | /null(404) |
| 04:14:37 | / |
| 06:09:46 | /null(404) |
| 07:34:12 | /null(404) |
これはブラウザで再現できていないので、「ほぼ確実」までで、確かめきれてはいない。直したあとに /null が減れば、見立てが合っていたことになる。
作業ログ ― /null の元になる文字を、ハコブくんのスクリプトからなくした
この記事のコード・ログ・データは、1ファイルずつ下に置いています。全文はリンク先にあります。
ファイルの一覧(2本)
01_HakobuParade.astro.txt ― 直したあとの HakobuParade.astro(全文)・13,155字
02_worker_index.js.txt ― 直したあとの worker/index.js(全文)・48,385字
HakobuParade.astro の変更(差分)
diff --git a/src/components/HakobuParade.astro b/src/components/HakobuParade.astro
index af81f24..a0a2f0d 100644
--- a/src/components/HakobuParade.astro
+++ b/src/components/HakobuParade.astro
@@ -94,9 +94,11 @@
       }
     } catch { /* 送れなくてもサイトの動きには影響させない */ }
   }
+  // 最後に知らせた更新を読む。なければ null(文字の 'null' を書かない:クローラーが JS の中の文字を住所と見て /null を取りに来ていた。2026-11-22)
+  const readShown = () => { const v = localStorage.getItem(SHOWN_KEY); return v ? JSON.parse(v) : null; };
   // 押さずにあとで見に来たか:最後に知らせた更新のページを、7日以内に開いたら1回だけ送る
   try {
-    const last = JSON.parse(localStorage.getItem(SHOWN_KEY) || 'null');
+    const last = readShown();
     if (last && !last.done && location.pathname === last.url && Date.now() - last.at < 7 * 864e5) {
       if (!last.clicked) report('later', last); // 押して来た分は click で送り済み
       last.done = true; localStorage.setItem(SHOWN_KEY, JSON.stringify(last));
@@ -140,7 +142,7 @@
     say.addEventListener('click', () => {
       if (preview) return;
       report('click', it);
-      try { const last = JSON.parse(localStorage.getItem(SHOWN_KEY) || 'null'); if (last && last.id === it.id) { last.clicked = true; localStorage.setItem(SHOWN_KEY, JSON.stringify(last)); } } catch { /* なし */ }
+      try { const last = readShown(); if (last && last.id === it.id) { last.clicked = true; localStorage.setItem(SHOWN_KEY, JSON.stringify(last)); } } catch { /* なし */ }
     });
     document.body.append(box, say);
     const RUN = reduce ? 4000 : 7500;
- ねらい:クローラーが住所と見て取りに来る
"null"の文字を、スクリプトからなくす - 変わったこと:最後に知らせた更新を読む小さな関数
readShown()を足し、値がないときは文字ではなく null をそのまま返す。動き(あとで見に来たかの記録・押したかの記録)は変えていない - 見込める効果:meta-externalagent の
/nullが週60回ほどから0回へ。来週のクローラーの記録で確かめる
直したあとの HakobuParade.astro(全文)
---
// サイトに新しい更新(記録・4コマ・課題地図の最近の動き)があると、ハコブくんが画面の下を走り回って知らせる。
// 動画の進み具合のページの「動画が公開されたら走るハコブくん」と同じ動き・同じ決まり:
// - 知らせた更新はこのブラウザに覚えておき、同じ更新では2回走らない
// - 初めて来た人には、今日(日本時間)公開された分だけ知らせる
// - タブが見えていないときは走らず、見えたときに走る
// 吹き出しを押すと、その更新のページへ移る
// 5〜20回に1回、走っている途中でコケて、起き上がってまた走る(回数はこのブラウザに覚える。2026-10-24)ビルドと、手元のブラウザでの確かめ
$ npm run build
09:00:39 [@astrojs/sitemap] `sitemap-index.xml` created at `dist`
09:00:39 [build] 944 page(s) built in 39.26s
09:00:39 [build] Complete!
$ grep -c '"null"' dist/_astro/HakobuParade*.js
0
ハコブくんが走ること(?hk=run)と、あとで見に来たときに記録の印(done)が付くことを、作った dist を手元で開いて確かめた。
import asyncio
from playwright.async_api import async_playwright
async def main():
  async with async_playwright() as p:
    b=await p.chromium.launch(); pg=await b.new_page(); logs=[]
    pg.on("console",lambda m:logs.append(m.text)); pg.on("response",lambda r:logs.append(f"{r.status} {r.url}"))
    await pg.goto("http://localhost:8765/record/day18.html?hk=run&p2m-notrack=1"); await pg.wait_for_timeout(3000)
    print("say:",await pg.locator(".hk-say").count(), pg.url)
    print("\n".join(l for l in logs if "Hakobu" in l or "updates" in l or "404" in l[:3] or "rror" in l))
    await b.close()
asyncio.run(main())
$ python3 /tmp/t2.py
say: 1 http://localhost:8765/record/day18.html?hk=run&p2m-notrack=1
404 http://localhost:8765/media/s-1920x1080_0f8a12e5-b434-4d40-8ed2-8306c22de9c9.webp
200 http://localhost:8765/_astro/HakobuParade.astro_astro_type_script_index_0_lang.7zSLlD3_.js
200 http://localhost:8765/updates.json
(/media/ の 404 は、手元のサーバーに R2 の画像がないため。)
import asyncio
from playwright.async_api import async_playwright
async def main():
  async with async_playwright() as p:
    b=await p.chromium.launch(); pg=await b.new_page(); errs=[]; reqs=[]
    pg.on("pageerror",lambda e:errs.append(str(e))); pg.on("request",lambda r:reqs.append(r.url))
    await pg.goto("http://localhost:8765/record/day18.html?p2m-notrack=1")
    await pg.evaluate("localStorage.setItem('p2m-site-announced-last', JSON.stringify({id:'x',kind:'record',url:'/record/day18.html',at:Date.now(),clicked:false,done:false}))")
    await pg.reload(); await pg.wait_for_timeout(1500)
    print(await pg.evaluate("localStorage.getItem('p2m-site-announced-last')"), errs, [r for r in reqs if 'hk-event' in r or r.endswith('/null')])
    await b.close()
asyncio.run(main())
$ python3 /tmp/t3.py
{"id":"x","kind":"record","url":"/record/day18.html","at":1795305814034,"clicked":false,"done":true} [] []
main に入れて公開し(commit c633f94)、約2分半後に公開中のスクリプトが新しい版(7zSLlD3_)に替わり、"null" が0になったことを確かめた。
/_astro/HakobuParade.astro_astro_type_script_index_0_lang.7zSLlD3_.js 0
作業ログ ― コードの中の文字を住所と見て来るクローラーに 410 を返した
worker/index.js の変更(差分)
サイトの入口の worker で、古い住所の転送(movedTo)のあと、静的なファイルを返す前に、住所に { } `(またはそのエンコード %7B %7D %60)を含むものへ 410 を返す。クローラーの記録には 410 として残す。
diff --git a/worker/index.js b/worker/index.js
index 8be2d74..3405a3b 100644
--- a/worker/index.js
+++ b/worker/index.js
@@ -11,6 +11,7 @@
 // - /api/cr-stats        その記録を、どのクローラーが・いつ・どのページを読んだかで数えて見せる(2026-10-25)
 // - /api/kpi-stats       主に見る3つの数字(AI の依頼読み・AI のリンクからの来訪・サイト名の検索)を日ごと・週ごとに見せる(worker/kpi.js。2026-11-06)
 // - /mcp/{鍵}            サイトの計測を Claude につなぐ部品(MCP サーバー。worker/mcp.js。2026-11-06)
+// - { } ` を含む住所   記事のコードの中の文字をクローラーが住所と見て来たもの。410 を返す(2026-11-22)
 // - 5分ごとの scheduled  SNS の予約投稿の時刻が来ていたら GitHub Actions を起こす(worker/sns_cron.js)。前の日の3つの数字がまだなければ集計して残す(worker/kpi.js)
 //
 // 守り(2026-10-23)
@@ -44,6 +45,15 @@ export default {
       } catch { /* 数え損ねても転送はする */ }
       return secured(Response.redirect(to.toString(), 301));
     }
+    // 記事に載せたコードの中の文字(src="{src}"・${MSG_URL} など)を、クローラーが住所と見て取りに来る(2026-11-22。64記事分)。
+    // ページではないので 404 より「もうない」の 410 を返し、取りに来る回数を減らす。{ } ` を含むファイルはサイトにない
+    if (/[{}`]|%7B|%7D|%60/i.test(url.pathname)) {
+      try {
+        const bot = crawlerOf(request, url);
+        if (bot) ctx.waitUntil(crRecord(request, env, url, bot, 410).catch(() => {}));
+      } catch { /* 数え損ねても返す */ }
+      return secured(new Response('Gone', { status: 410, headers: { 'x-robots-tag': 'noindex', 'content-type': 'text/plain; charset=utf-8' } }));
+    }
     let res = await env.ASSETS.fetch(request);
     // 記事の全文ページ(/record/{slug}.md。2026-11-01)は、検索では記事ページを正とする(canonical)。文字コードも付ける
     const full = res.ok && url.pathname.match(/^\/record\/([^/]+)\.md$/);
$ node --check worker/index.js && echo syntax-ok
syntax-ok
$ node -e 'const re=/[{}`]|%7B|%7D|%60/i; for (const p of [...]) console.log(re.test(p)?410:"pass",p)'
410 /files/LOG502/%7Bsrc%7D
410 /record/%24%7BMSG_URL%7D
410 /files/LOG511/%7B%60
pass /record/day18
pass /files/LOG502/02_sec12.py.txt
pass /null
pass /files/LOG502/%27%20%2B%20LOGO%20%2B%20%27
' + LOGO + ' の形(/files/LOG502/%27%20%2B%20LOGO%20%2B%20%27)は { を含まないので対象外のまま。数が少ないので、今回は広げなかった。
- ねらい:コードの中の文字から生まれた住所に、「もうない」とはっきり返す
- 変わったこと:
{}`を含む住所は、404 ではなく 410 を返す。ほかの住所の返し方は変えていない - 見込める効果:GPTBot・ClaudeBot・Amazonbot が同じ住所を取りに来る回数が減る見込み。ただし Google は 404 と 410 をほぼ同じに扱う(下の Codex の指摘)。来週のクローラーの記録で、410 の住所への再訪が減るかを見る
Codex のレビュー(依頼箱の依頼255)
サイトの決まりでは、公開後に戻しにくい変更(住所・転送など)は外のレビューを挟む。変更を枝 crawler-410 に置き、依頼箱(Mac の上で Claude Code に依頼を渡して自動で回す仕組み)から Codex(OpenAI のコードの AI)にレビューを頼んだ。依頼箱の Claude Code は Codex を起動するだけで、レビューそのものはしない。
依頼255(依頼箱に置いた依頼文)
---
作業フォルダ: /Users/shimazueiichi/r2r2r-scripts
上限時間: 60
---
# Codex に、サイトの worker で { } ` を含む住所に 410 を返す変更をレビューしてもらう

あなた(Claude Code)の仕事は **Codex を起動してレビューを任せることだけ**。レビューそのものはしない。r2r2r-scripts を含め、どのファイルも変更しない。

## 手順

1. Codex CLI があるか確かめる:`command -v codex || ls ~/.npm-global/bin/codex`。見つからない・ログインが切れている場合は、何もせずに止めて、報告の「決めてほしいこと」にその旨を書く。
2. 次をそのまま実行する(依頼書の中身をあなたが要約・書き換えしない):

```bash
REVIEW_DIR="$HOME/Library/Mobile Documents/com~apple~CloudDocs/デスクトップ/ADAPT DESIGN/じぶんの/PixelstoMotors/_crawler410_review_20261122"
find "$REVIEW_DIR" -type f -exec brctl download {} \; 2>/dev/null
git clone -q --depth 1 -b crawler-410 https://github.com/PixelstoMotors/p2m-site "$REVIEW_DIR/p2m-site" 2>&1 | tail -3
codex exec --skip-git-repo-check -C "$REVIEW_DIR" -s workspace-write \
  "codex_review_request.md を読んで、その指示どおりにレビューし、報告を codex_report.md としてこのフォルダに書いてください。crawler410.diff と p2m-site/ は読むだけで、書いてよいのはこの報告ファイルだけです。" \
  > "$REVIEW_DIR/_codex_run.log" 2>&1
```

   clone に失敗した場合は、p2m-site なしで codex を動かしてよい(crawler410.diff だけでレビューさせる)。そのことを報告に書く。
3. 終わったら `codex_report.md` ができたか確かめる。
   - できていれば、報告には「できた」とそのパスと、Codex の報告の全文を写す。
   - できていなければ、`_codex_run.log` の末尾 40 行を報告に写す。

## 守ること

- Codex の報告の中身をあなたが評価・手直ししない。
- `-s workspace-write` を外さない・制限を外す指定を足さない。
- 失敗しても自分でレビューを代わりにやらない。

報告の最後は「判定:合格/止めた(決めてほしいことあり)/失敗」のどれか1つで終える。
codex_review_request.md(Codex に渡したレビューの依頼)
# レビュー依頼:worker で { } ` を含む住所に 410 を返す

## 対象
- 差分:`crawler410.diff`(p2m-site の main と枝 crawler-410 の差)
- 全体:`p2m-site/`(枝 crawler-410 を clone したもの。`worker/index.js` の fetch)

## 背景
- 記事に載せたコード(`public/files/LOG{N}/*.txt`・`LOG{N}_full.md`・`/record/{slug}.md`)の中の `src="{src}"`・`${MSG_URL}`・`{s.img.startsWith('/')` などを、GPTBot・ClaudeBot・Amazonbot が住所と見て取りに来て、404 が週に数十種類出ている(64記事分)。
- コードは全文を載せる決まりなので、中身は変えない。代わりに、住所に `{` `}` `` ` ``(またはそのエンコード %7B %7D %60)を含むものへ 410 を返し、取りに来る回数を減らしたい。
- サイトに `{ } `` ` `` を名前に含むファイルはない(`find public src/pages -name '*[{}\`]*'` が空)。

## 見てほしいこと
1. 正しいページ・ファイル・API・転送(`movedTo`・`/pixelstomotors/`・`/api/`・`/media/`・`/mcp/`)を誤って 410 にしてしまう場合がないか。特に、クエリ文字列(?via=… や ?key=…)は `url.pathname` に入らないので対象外のはずだが、確かめてほしい。
2. 置いた位置(movedTo の転送のあと、ASSETS.fetch の前)が正しいか。
3. 410 にするのが 404 より悪くなる点(検索・AI のクローラーの扱い)がないか。
4. クローラーの記録(crRecord)に 410 で残す書き方に問題がないか。

## 報告の形
- 指摘ごとに「重さ(必須/推奨/据え置き)・場所・中身・直し方」
- 最後に「判定:このまま出してよい/直してから出す」
codex_report.md(Codex の報告・全文)
# crawler410 レビュー報告

## 1. 一部の住所は 410 の処理を通らない

- **重さ:推奨**
- **場所:** `p2m-site/wrangler.jsonc` の `assets.run_worker_first`、`worker/index.js:32–57`
- **中身:** `/api/`、`/media/`、`/mcp/` は判定より先にそれぞれの処理へ渡される。`/pixelstomotors/` はまず 301 で接頭辞を外し、その転送先が通常のパスなら次のリクエストで 410 になる。また、`/_astro/`、`/site/`、`/og/`、`/thumbs/`、`/embeds/`、`/sim/`、`/favicon` で始まるパスは `run_worker_first` の除外対象で、静的アセットがない場合も Worker の 410 判定を通らない。したがって「文字を含むすべての住所に 410」ではない。優先処理は既存の API、R2 のファイル、MCP の鍵、旧 URL の転送を壊さないために有益だが、これらの経路に誤認 URL がある場合は今回の対策は届かない。Cloudflare の[ルーティング設定の説明](https://developers.cloudflare.com/workers/static-assets/routing/worker-script/)でも、否定パターンは Worker の先行実行から除外される。
- **直し方:** この範囲を仕様として明記し、実際の 404 記録に除外経路があるか確認する。必要な経路だけ、既存の正常なファイルや API を壊さない方法で別途対応する。無条件に判定を先頭へ移す必要はない。

## 2. 410 の記録はページ・テキストと認識されたものに限られる

- **重さ:推奨**
- **場所:** `worker/index.js:50–54`、`worker/index.js:580–592`
- **中身:** `crRecord` の呼び方、非同期の `ctx.waitUntil`、失敗時に応答を妨げない扱い、ステータス 410 の保存と集計は既存の 301・通常応答と整合している。一方 `crawlerOf` は GET・HEAD、既知の User-Agent、`CR_PAGE` に合うパスに限定する。例えば `/files/LOG410/{src}.png` は 410 を返すが末尾が `.png` なので記録されない。対象外経路も記録されない。よって 410 の記録だけでは対策対象の全アクセス数や削減効果を測れない。パスは従来どおり先頭 160 文字に切られる。
- **直し方:** 全 410 を観測したい場合は、410 専用に User-Agent の判定とパス拡張子の判定を分け、既知のクローラーに限って記録する方法を検討する。現在のページ・テキスト限定で十分なら、その制限を明記して据え置く。

## 3. 410 でクロールが減るとは限らない

- **重さ:据え置き**
- **場所:** `worker/index.js:47–55`
- **中身:** Google は [404 と 410 を同じように扱い](https://developers.google.com/crawling/docs/troubleshooting/http-status-codes)、どちらも対象 URL をインデックスから除外する。したがって Google について 410 が 404 よりクロールを減らすとは言えない。GPTBot・ClaudeBot・Amazonbot がこの変更でどの程度再訪を減らすかも確認できず、効果は保証できない。410 は永続的に利用できないことを表すため、今後この文字を含む正当なパスを作る場合はその URL が除外されるリスクがある。`X-Robots-Tag: noindex` が付いていても 410 自体で取得は失敗する。
- **直し方:** 410 は対象が今後も存在しないという前提で採用し、公開後に対象 URL の応答とアクセス推移を観測する。将来該当文字を含む正規パスを追加するときは判定を見直す。

## 確認結果

- `new URL(request.url)` の `pathname` のみを正規表現で検査するため、正常なパスの `?via={...}`、`?key=%7B...%7D` などのクエリ文字列だけで 410 にはならない。大文字・小文字の異なる `%7B`、`%7D`、`%60` も検出する。
- `movedTo` の後に置くことで、既存の移転先が優先される。特に `/files/` のダッシュ修正は該当文字を含むパスでも先に 301 になる。`ASSETS.fetch` の前なので、Worker が処理する通常経路では対象を 410 にできる。この優先順位による既存の正常なページ、転送、API の誤った 410 は確認できなかった。
- ファイル名に該当文字がないという依頼文の前提と、静的なルートの構成に基づく確認であり、本番 R2 の全キーや実際の Cloudflare 上の応答は検証していない。

**判定:このまま出してよい**
2026-11-22T09:05:53 開始 20261122_255_Codexにサイトのworkerの410をレビューしてもらう.md[列:コード]
2026-11-22T09:09:31 完了 20261122_255_Codexにサイトのworkerの410をレビューしてもらう.md → 結果/20261122_255_Codexにサイトのworkerの410をレビューしてもらう_20261122_0905.md
判定は「このまま出してよい」。指摘の1(/_astro/ や /media/ などはこの判定を通らない)は、今回の404がすべて /files/ と /record/ なので影響しない。指摘の3(Google は 404 と 410 を同じに扱う)は、上の「見込める効果」に書いた。main に入れて公開した(commit b568594)。
直したあとの worker/index.js(全文)
// サイトの入口。ほとんどのページは作っておいた静的ファイル(dist/)をそのまま返す。
// ここで処理するのは3つだけ:
// - /pixelstomotors/…   旧 URL の形。/pixelstomotors を外した URL へ 301 で転送する
// - /media/{ファイル名}  記事・4コマの画像と動画を R2(p2m-media)から返す(GitHub には入れないため)
// - /api/message         メッセージフォームの送信を R2(p2m-messages)に保存し、メールで知らせる
// - /api/hk-event        更新を知らせるハコブくんが「出た・押された・あとで見に来た」を R2(p2m-messages の hk-events/)に1件ずつ残す
// - /api/hk-stats        その記録を日ごと・更新ごとに数えて見せる(数だけ。誰かは分からない)
// - /api/ev サイトの使われ方(1回のページ表示ごとの、読んだ深さ・押したもの・迷い)を R2(p2m-messages の ev/)に残す公開後の確かめ
公開から約2分後に 410 に替わった。正しいページ・ファイル・クエリ付きの住所は、今までどおり 200 を返す。
$ curl -s -o /dev/null -w '%{http_code}' https://pixelstomotors.com/files/LOG502/%7Bsrc%7D
410
410 /record/%24%7BMSG_URL%7D
200 /record/day18
200 /files/LOG502/02_sec12.py.txt
200 /llms.txt?via=%7Bx%7D
200 /
レビュー用の枝 crawler-410 は、GitHub への接続が2回切れて消せていない。中身は main に入っているので、残っていても動きには関わらない。
作業ログ ― これから確かめること
| 確かめること | 何で見るか | いつ |
|---|---|---|
| /null が減ったか | クローラーの記録の /null の回数(11/16 の週は60) | 11/23〜11/29 の週の記録 |
410 にした住所への再訪が減ったか | クローラーの記録の、410 を返した住所の回数 | 同じ週から2週 |
| Google の順位が戻るか | Search Console の日ごとの掲載順位と表示 | 12/4(予約済み) |
直接来る人が、どこで知って来ていた人か | 直接の来訪が多かったページ(/gpu-buy-or-rent・/issues・/message)に、来た所が分かる印を付けたリンクを置くか、考える | 次の週の分析 |
サイト名の検索(11/16 の週) | Search Console | 11/25 以降 |