AIにロボットを直接動かさせない設計 ― MicroFactoryの構成から、Physical AIが学習できる環境までを読む
MicroFactoryの創業者Igor Kulakovが、LinkedInでAIロボティックインテグレーターを紹介した。MicroFactoryは、卓上サイズの箱型セルの中でロボットアームを動かす会社で、紹介されたのはそのセルの立ち上げを最初から最後まで引き受けるAIエージェントだった。投稿の説明では、AstraやOpusといった最新のモデルを使い、治具(作業物を決まった位置と向きに固定する道具)の設計、画像認識のコードの作成、人のオペレーターへの指示までをエージェントが担う。
添付の動画は1分ほどで、ロボットが山積みの試験管を1本ずつ拾い、ラックに差していく場面で終わる。途中には、エージェントの画面やCGの説明図、人が3Dプリントした部品を組み立てる手元が挟まる。
この記事は、その動画のスクリーンショットをClaudeに見せて、何をしているシステムなのかを聞くところから始まり、「Physical AIが学習できる環境」を調べるところまで進んだやりとりの記録である。
MicroFactoryのエージェントが担う作業と、人に残る3つの作業
— MicroFactoryのロボットシステムは、何をしているのか。
動画の中の説明図と画面から読み取れた内容を、エージェントの作業と人の作業に分けると次のようになる。
担当 | 作業 | 動画で確認できたもの |
|---|---|---|
エージェント | 治具を設計する | グリッパーの指先、トレイ、ラックの3Dモデル。硬い樹脂の本体と、柔らかい樹脂の内張りを組み合わせる指定 |
エージェント | 制御コードを書く | 制御の流れを示す図。コードの工程と学習済みモデルの工程が交互に並ぶ |
エージェント | オペレーターに指示する | 説明図の中の「補充して」という吹き出し |
人 | 材料を補充する | 説明図の3枚のカードのうち1枚目 |
人 | ツールを取り付ける | 3Dプリントした指先をグリッパーに差し込む手元の映像 |
人 | 作業を追加・変更する | 「チューブを掴んで、どこかのホルダーに入れたい」という写真付きの依頼文 |
依頼文を受けたエージェントは、まずプロジェクトの決まりごとを書いたファイルを読み、Mac上でコマンドを実行してから、指先・トレイ・ラックを設計していた。画面には、スクリプトはパラメトリック(寸法を数値で与えて形を作る方式)なので、寸法を変えて作り直すのは1分以内で終わる、という説明が出ていた。
ロボットが動く場所は、試験管を差すラックの下に柔らかく動く台座を入れた、机の上の小さなセルだった。CGでは、同じセルを上下左右に積んで台数を増やす構成も示されていた。人の仕事は、材料を入れる、部品を付ける、やりたいことを言葉で伝える、の3つに絞られている。
AIモデルからロボットへの直接指令は、高い・遅い・不安定
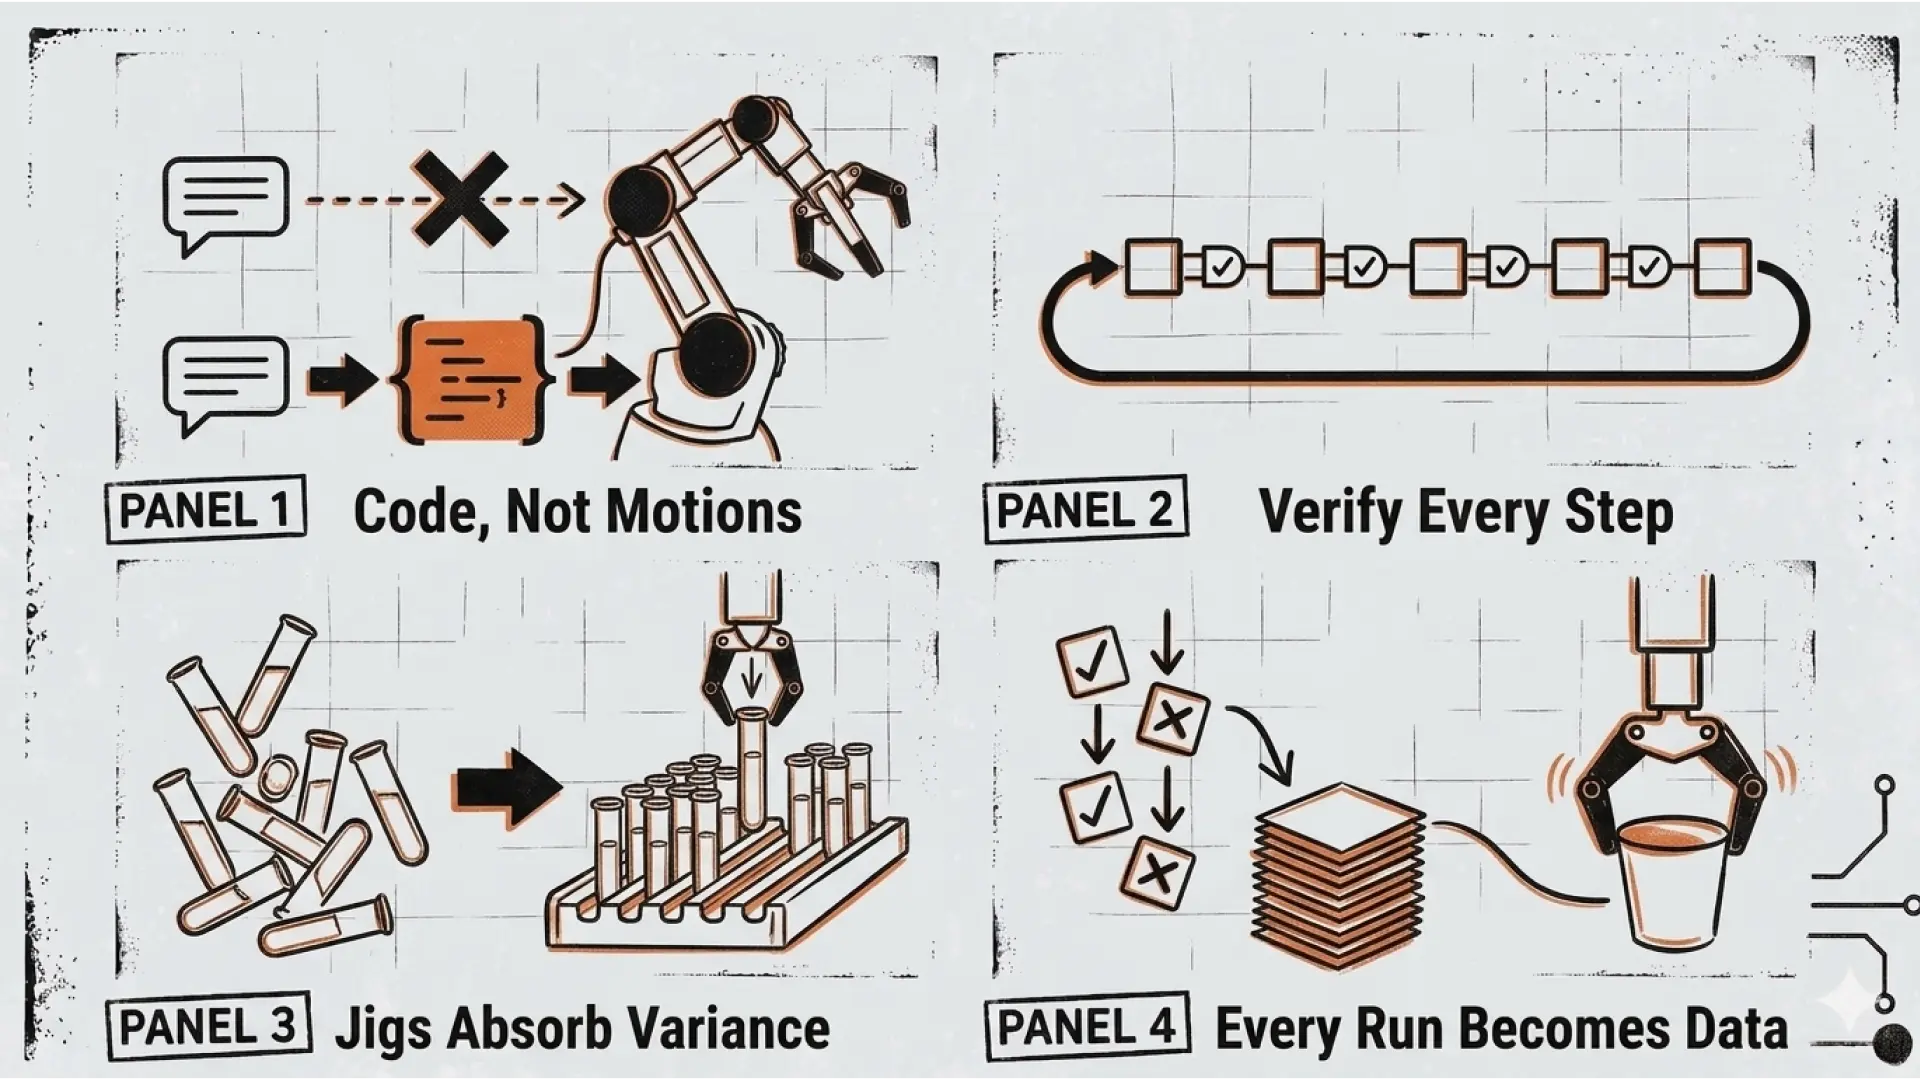
動画の中で一番時間を取って説明されていたのは、AIとロボットのつなぎ方だった。上の段では、AIモデルから直接ロボットへ点線の矢印が引かれ、「高い・遅い・不安定」と書かれている。下の段では、AIモデルはコードを書き換えるだけで、ロボットを動かすのはコードになっている。コードからロボットへの矢印には「速い・確実」、コードの箱には「信頼できる層」とあった。
ここの部分はとても共感できるところだね。かなりネックポイントと感じていたから。
AIがカメラの画像を見て、そのまま関節の動きを毎回出す方式は、デモでは見栄えがする。ただ、1回動かすたびに大きなモデルの推論が走るので、計算の費用がかかり、応答が遅れ、同じ場面でも毎回同じ動きになるとは限らない。工場のラインで同じ作業を何千回も繰り返すには、この3つが壁になる。
MicroFactoryは、AIの知能を使う場所を、ロボットが動いている最中ではなく、動かす前の準備に移した。AIは作業の手順を考えてコードに書き、治具の形を決める。ロボットが動いている間は、そのコードが決まった通りに実行する。判断は上流で済ませ、実行は毎回同じ結果になる仕組みに任せる形だ。
この形は、アパレルの量産で私がやっていた仕事に近い。デザイナーが遠くの工場の縫製ラインに毎回立ち会うことはない。工場の誰が読んでも同じ服が縫える仕様書を書いて渡す。MicroFactoryでは、AIが仕様書を書く側、コードが仕様書、ロボットが工場の側に立っている。
工程の間に置かれたVerifyと、π0.5に任される把持
— 制御の流れの図にある「π0.5」と「Verify」は、何をしているのか。
図の制御の流れは、左から「コード、コード、π0.5、π0.5、Claude」の順に5つの箱が並び、箱と箱の間にはすべて「Verify」の札が付いていた。最後のClaudeの箱からは、先頭へ戻る矢印が引かれている。
π0.5は、米国のPhysical Intelligence社が開発したVLA(Vision-Language-Action、カメラの画像と言葉の指示を受け取り、ロボットの関節の動きを直接出力するモデル)で、重みも公開されている。従来のロボットは、物を見つける、動きを計画する、関節を動かす、の各段階を人がプログラムしていた。VLAはそれを1つのニューラルネットで行う。π0.5は、複数の種類のロボットのデータやWebのデータを混ぜて学習していて、初めて見る部屋や物にもある程度対応できる。向きがばらばらの物や山積みの物のように、決まった動きでは書ききれない相手が得意な一方、成功率は100%にならず、同じ入力でも結果が揺れる。推論にはGPUが要り、時間もかかる。
図から役割を推測すると、次のような分担になる(MicroFactoryが明言しているわけではない)。
コード:ラックの決まった穴に差す、決まった位置まで動く、のように位置が分かっている動き。速く、毎回同じ結果になる
π0.5:山積みの試験管から1本拾うような、毎回状況が違う把持
Claude:失敗したときに原因を判断し、やり直す工程を決め、必要なら人に頼む。先頭へ戻る矢印がこの流れ
Verifyは、前の工程が本当に成功したかを確かめてから次に進むための関門だ。グリッパーの開き具合で物を掴めているかを見る、カメラで試験管が穴に入ったかを見る、といった確認が考えられる。失敗していれば、やり直すか、前の工程に戻すか、Claudeや人に渡す。エージェントの画面にも「手順1と2は承認済み」「手順3の関門」という書き方があり、開発の段階でも工程ごとに承認してから次へ進めていることが分かる。
5工程をつなぐと、各工程95%でも全体は77%になる
Verifyが要る理由は、工程ごとの失敗が掛け算で積み重なるからだ。各工程の成功率が95%でも、5工程を続けて全部成功する確率は、0.95を5回掛けて約77%になる。各工程90%なら約59%まで下がる。
なるほどね。単一のタスクだけの数値に注目すると、全体では成功率大したことないねとなったりするから注意が必要だね。
逆に、Verifyで失敗を見つけて1回だけやり直せるなら、同じ掛け算が味方になる。各工程90%の作業でも、失敗したときにもう1回やれば、その工程で2回とも失敗する確率は0.1×0.1で1%になり、実質の成功率は99%に上がる。5工程つないでも約95%が残る。
各工程の成功率 | 5工程・やり直しなし | 1回やり直したときの各工程 | 5工程・1回やり直し |
|---|---|---|---|
95% | 77.4% | 99.75% | 98.8% |
90% | 59.0% | 99.0% | 95.1% |
80% | 32.8% | 96.0% | 81.5% |
ただし、この計算が成り立つには条件が2つある。1つは、失敗を検知できること。掴めていないのに掴めたと判定すれば、失敗はそのまま後ろの工程へ流れる。もう1つは、やり直せる失敗であること。試験管を落として割った場合は、何回やり直しても元に戻らない。
実際の現場では、工程ごとの失敗が独立していないこともある。物の位置を読み違えていれば、掴む工程も置く工程も同じ原因でそろって失敗する。その場合、全体の成功率は掛け算の値より悪くなる。このプロジェクトのPick&Placeでも、掴む工程と置く工程を別々に判定しているが、見るべきなのは各工程の数字に加えて、最後まで通して成功した割合のほうだ。どの工程が全体を引き下げているかは、並べて初めて分かる。
MicroFactoryは治具で環境側のばらつきを消している
micro factoryのいいところは派手なデモではなく、現実的で、現時点で合理的な技術でタスクを切り出してロボットアームの可能性を少しずつ広げているように思います。
MicroFactoryの構成でもうひとつ目立つのは、ロボットを賢くする前に、ロボットの周りの環境を設計している点だ。エージェントが指先やトレイやラックを作るのは、作業物の位置と向きのばらつきを、物の形で消すためだと読める。トレイの溝で試験管の向きがそろえば、掴む動きはコードで書けるようになる。π0.5のような学習済みモデルは、治具で消しきれなかったばらつきにだけ使えば足りる。
治具でばらつきを消すのは、工場の自動化で昔から使われてきたやり方だ。ただ、これまでは治具の設計と製作に専門家の手間と日数がかかり、それがロボット導入の費用の大きな部分を占めていた。MicroFactoryは、その設計をAIに、製作を3Dプリンタに任せて安くした。使っている技術は新しくないが、導入にかかる費用の前提を変えている。
限界もはっきりしている。机の上のセルの中で、小さな部品を扱う、手順の決まった作業に範囲を絞っているから成り立っている。人の手がセルの中に入ってくる作業、大きな物を扱う作業、置き場所が毎回変わる作業には、この方式はそのままでは広がらない。どこまでを切り出せば今の技術で確実に回るか、その範囲の取り方がうまい会社だと見ている。
派手なデモではなく、何が確実に回るかを見る4つの指標
今はデモが派手なロボット企業の方が注目される傾向があるけど、micro factoryに注目してます。 将来的には今のシステムでいいわけではないだろうけど、自分たちの強みを理解して着実に進むのかなという印象です。
派手なデモは、何ができそうかを見せる。MicroFactoryの動画が見せていたのは、今の時点で何が確実に回るかのほうだ。実際の現場で使われ始めるのは、後者のほうが早いと考えている。
この会社が着実に進んでいるかどうかは、次の4つを追えば外から判断できる。
依頼から稼働までの時間:「試験管をラックへ」のような新しい作業が、依頼から何時間、何日で動くようになるか
扱える作業の種類:部品の整列や試験管の差し込み以外に、どこまで広がるか
連続運転の数字を出すか:デモ動画ではなく、通しでの成功率や稼働時間を公開するか
π0.5が担う範囲の変化:学習済みモデルが良くなったとき、コードからモデルへ移す工程が増えるか
4つ目が、将来この構成がどう変わるかの一番の手がかりになる。今の「コードが中心で、学習済みモデルは一部」という配分が、モデルの進歩に合わせてどう動くかを見れば、技術の変化を取り込みながら自分たちの強みを保てているかが分かる。
治具の形状まで含めて、エージェントの成果物はコードになっている
今のAIで確実に高い性能を出せているはコードの生成だと判断して、それを最大限に生かす構成にしたんだろうね。
そう読むと、MicroFactoryの構成が一貫して見えてくる。エージェントが出すものは、制御の手順も、画像認識も、治具の形も、すべてコードになっている。指先やトレイの形は3D CADのスクリプトとして書かれていて、寸法を変えて実行し直せば、1分以内に新しい形が出てくる。
仕事をコードに寄せる利点は、今のAIがコードを書くのが得意だという点だけではない。
確かめられる:人が読める。テストできる。同じ入力なら同じ結果が出る
直せる:失敗したら、原因になった行を特定して書き直せる。ニューラルネットの失敗は、なぜ失敗したかを追いにくい
ためられる:一度動いたコードは残り、次のセルや次の作業で使い回せる
逆に、今のAIが苦手な、空間を正確に把握して、リアルタイムに体を動かす仕事は、できるだけAIにさせない。得意な仕事にAIを寄せ、苦手な仕事は構造で避けている。
空間の把握と体の制御に足りないのは、モデルの形かデータか
これは今のAIの形だけではむりだろうね。もっと根本的に違うなにかが必要そうに思う。
この点は、研究者の間でも意見が割れている。大きく分けると2つの立場がある。
立場 | 主張 | 根拠として挙がるもの |
|---|---|---|
今の延長で解ける | 今のモデルの形のまま、ロボットの動作データを大量に集めればよい | π0.5のようなVLAで、初めて見る環境への対応が実際に伸びている。言語モデルがWebの文章で伸びたのと同じことが、データさえあれば起きる |
別の仕組みが要る | 次の単語を予測する仕組みでは、物理の世界は理解できない | 「こう動けばこうなる」を頭の中で試せる世界モデルが必要。Meta社のYann LeCunらがこの立場 |
私の見方では、足りないのはモデルの形よりもデータのほうが大きい。言語モデルにはインターネットという膨大な教材があった。物を掴んだときの力の入り方や指先の感触のデータは、世の中にほとんど存在しない。今のロボットは、ほぼ目だけで作業している。
もうひとつの手がかりは人の体の仕組みだ。人はコップを掴むとき、指の力加減をいちいち考えていない。何をするかは脳の上のほうで考え、細かい力加減は小脳や反射が意識せずに処理している。最近のロボットも、ゆっくり考える層と速く動く層を分ける方向に進んでいる。根本的に違う何かは、1つの新しいモデルというより、こうした層の組み合わせと、触覚を含むデータなのかもしれない。
そう考えると、Physical AIが学習できる環境を作ること自体が、この問題の中心に近い仕事になる。
Physical AIが学習できる環境を作る4つの要素
— 「Physical AIが学習できる環境を作る」とは、具体的に何を作ることか。
ここで、この言葉をClaudeに掘り下げて調べてもらった。調べた範囲では、学習できる環境は4つの要素でできている。データを集める手段、学習させる基盤、成功か失敗かを判定する仕組み、その3つを回し続ける仕組みだ。一番足りていないのはデータである。
公開されている実ロボットのデータで最大級のOpen X-Embodimentは約100万軌跡(ロボットが1回の作業で動いた記録)で、世界の34の研究室が集めた60のデータセットを寄せ集めたものだ。一方、言語モデル1つの学習には十数兆の単語単位の文章が使われる。ロボットのデータは、実機を動かすかシミュレーションで作るしかなく、インターネットから集めることができない。
データを作る方法は、大きく4つある。
方法 | 長所 | 短所 | 規模や成果の例 |
|---|---|---|---|
実機を人が遠隔操作する | データの質が最も高い | 費用が人手に比例する | 中国AgiBotは4,000㎡超の収集工場に3,000種以上の実物を置き、100台の双腕ロボットで100万軌跡超・217種類の作業を集めた |
ロボットと同じ形の把持具を人が手で持って記録する | ロボットなしで、場所を選ばず集められる | 人とロボットの体の違いが残る | 手持ちの把持具に頭のカメラを足す研究が続いている |
シミュレーションで生成する | 計算機の能力の分だけ量を出せる | 現実の物理との差が残る。場面や作業を作る手間が大きい | NVIDIAは合成世界の生成と動作のシミュレーションをまとめたCosmos 3を発表した |
スマホ映像から生成する | 実機も遠隔操作も要らない | 物体の動きの物理は計算しない | Real2Render2Realは、デモ1本から作ったデータで、遠隔操作150本と同じ性能を出した |
日本では、AIロボット協会(AIRoA)がトヨタの生活支援ロボットHSRを遠隔操作し、5拠点・44台で5,025時間、成功した作業の記録約118万件を公開している。同時に公開したモデルは、π0.5をもとに学習させたものだ。
最後の行のReal2Render2Realは、このプロジェクトの名前「R2R2R」の元になった研究である。入力は、スマホで撮った物のスキャンと、人がやってみせる動画1本。そこから数千件のロボット用の動作データを描画して作る。生成の速さは1分あたり51件で、遠隔操作の1.7件の約30倍になる。
足りないデータの中でも、特に抜けているのが触覚だ。既存の大規模データセットには、触覚の記録がほとんど入っていない。2026年8月には、カメラの映像と触覚の記録を同期させた3万時間超のデータを作り、そのうち5,000時間を公開する研究が出た。
データがあっても、成功したかどうかを測れなければ学習も改善もできない。報酬(学習させるときに、良い動きかどうかを数値で返す仕組み)については、動画を理解できる既存のAIモデルから、追加で学習させずに作業の進み具合を読み取る手法(TOPReward)が出ている。低価格アームのSO-100/101を含む130以上の実際の作業で、人が付けた進み具合と高い一致を示した。評価については、決まった作業で比べる従来の方式ではなく、各地の評価者が2つのモデルを名前を伏せて比べ、その結果を集計する方式(RoboArena)が提案されている。
最後の要素は、回し続けることだ。AIRoAの東京・平和島の拠点は、データの収集、モデルの学習、実機での検証を同じ場所で行い、検証の結果をすぐ次の収集に反映できる構成になっている。量だけでなく質も効く。AIRoAが開いたロボット基盤モデルのコンペでは、集めたデータの質を自動で評価して選び分ける技術を強みにした、ソフトバンク・産総研・三菱電機の合同チームが、実際の作業の成功率で優勝した。
個人がこの領域で担える位置と、このプロジェクトのMission
データの量では、100台規模の組織に個人は勝てない。ただ、小さな貢献が束になる仕組みはすでに動いている。2026年に発表されたMolmoAct2というモデルは、377人が公開した1,222件のLeRobotのデータセット(合計約184時間)を、低価格アームSO-100/101の学習データとして使った。
調べた結果から、個人が効く場所は次の4つだと考えている。
再現できる手順とデータの形式:他人が同じ形式で集められる状態にして公開する
スマホから始めるデータ生成:Real2Render2Realの延長線上にある方法
判定と評価:AIモデルによる成功・失敗の判定と、失敗の記録
データの質:量ではなく、どんなデータが良いデータなのかの知見
このプロジェクトのMissionの1行目は「Physical AI が学習できる環境を継続的に構築する」で、MicroFactoryの動画から始まった問いは、その1行と同じところに着いた。主な目標にしている「他人が同じ手順で同じ結果にたどり着ける環境の数」は、上の4つのうち1つ目をそのまま数えたものになる。
AIが今できる仕事で回る仕組みと、まだできない仕事のためのデータ
MicroFactoryの構成を見直すと、Verifyの関門は、工程ごとに成功か失敗かを記録し続ける仕組みでもある。コードで確実に回しながら、その中で、どの把持が成功し、どの把持が失敗したかが残っていく。ここは私の読みで、MicroFactoryがそのデータを学習に使っているかどうかは、動画からは分からない。
それでも、AIが今確実にできる仕事で回る仕組みを作ることと、AIがまだできない仕事を学ぶためのデータを残すことは、同じ仕組みの中で両立できる。MicroFactoryに注目している理由は、そこにある。
AIに今できる仕事で確実に回し、その記録を、AIがまだできない仕事を学ぶためのデータとして残していく。
この記事で参照した資料
Real2Render2Real(arXiv): https://arxiv.org/html/2505.09601v1
AgiBot World Colosseo(arXiv): https://arxiv.org/pdf/2503.06669
AIロボット協会、ロボット動作データ5000時間分を一般公開(エクサウィザーズ): https://exawizards.com/column/ai-trend/news-0823-2026/
AIRoA、研究開発と法人機能を平和島拠点へ集約(ASCII): https://ascii.jp/elem/000/004/424/4424679/
AIRoA主催「ロボット基盤モデル開発コンペティション」優勝(ソフトバンク): https://www.softbank.jp/corp/news/info/2026/20260512_01
ロボットのデータ不足について(Axis Robotics): https://axisrobotics.ai/resources/learn/data-scarcity-in-robotics
N0-Foundation(alphaXiv): https://www.alphaxiv.org/abs/2608.29601
TOPReward(arXiv): https://arxiv.org/html/2602.19313
RoboArena(arXiv): https://arxiv.org/html/2506.18123v2
NVIDIA GTC 2026(Robotics 24/7): https://www.robotics247.com/article/nvidia-gtc-2026-nvidia-global-robotics-leaders-look-to-take-physical-ai-to-the-real-world/NVIDIA
MolmoAct2(arXiv): https://arxiv.org/pdf/2605.02881