Boston Dynamicsが示した「身体で考える」ロボットと、問いの本質
今日はロボット制御の最新研究を眺めながら、AIと少し大きな話をしていた。そのやり取りをそのまま記事にしてみました。
世界モデルで実機を動かせるか?
— ワールドモデルで実機ロボットを動かすアプローチについてはどう思う?
世界モデルで実機を動かすのが今後うまくいくかは未知数だね。データが多すぎてハルシネーションが余計酷くなるなどの可能性の方が高そう。
— 不確実性の伝播(uncertainty propagation)を明示的に扱っている研究もあって、「わからない領域では保守的に振る舞う」設計ができれば影響を局所化できる可能性はあるけど。
シミュレーションはシミュレーションでしかないので、どんなに優れたモデルを持ってこようが問題の本質は残ったままの可能性が高そう。もちろんダメだってわけじゃなくて、コントロールが難しそうとは思うね。
「シミュレーションの精度を上げる」アプローチには、根本的な問題がある。どこまで行っても現実の近似でしかないという事実は変わらない。精度を上げるゲームをし続けても、「で、実機は?」という問いが永遠についてまわる。
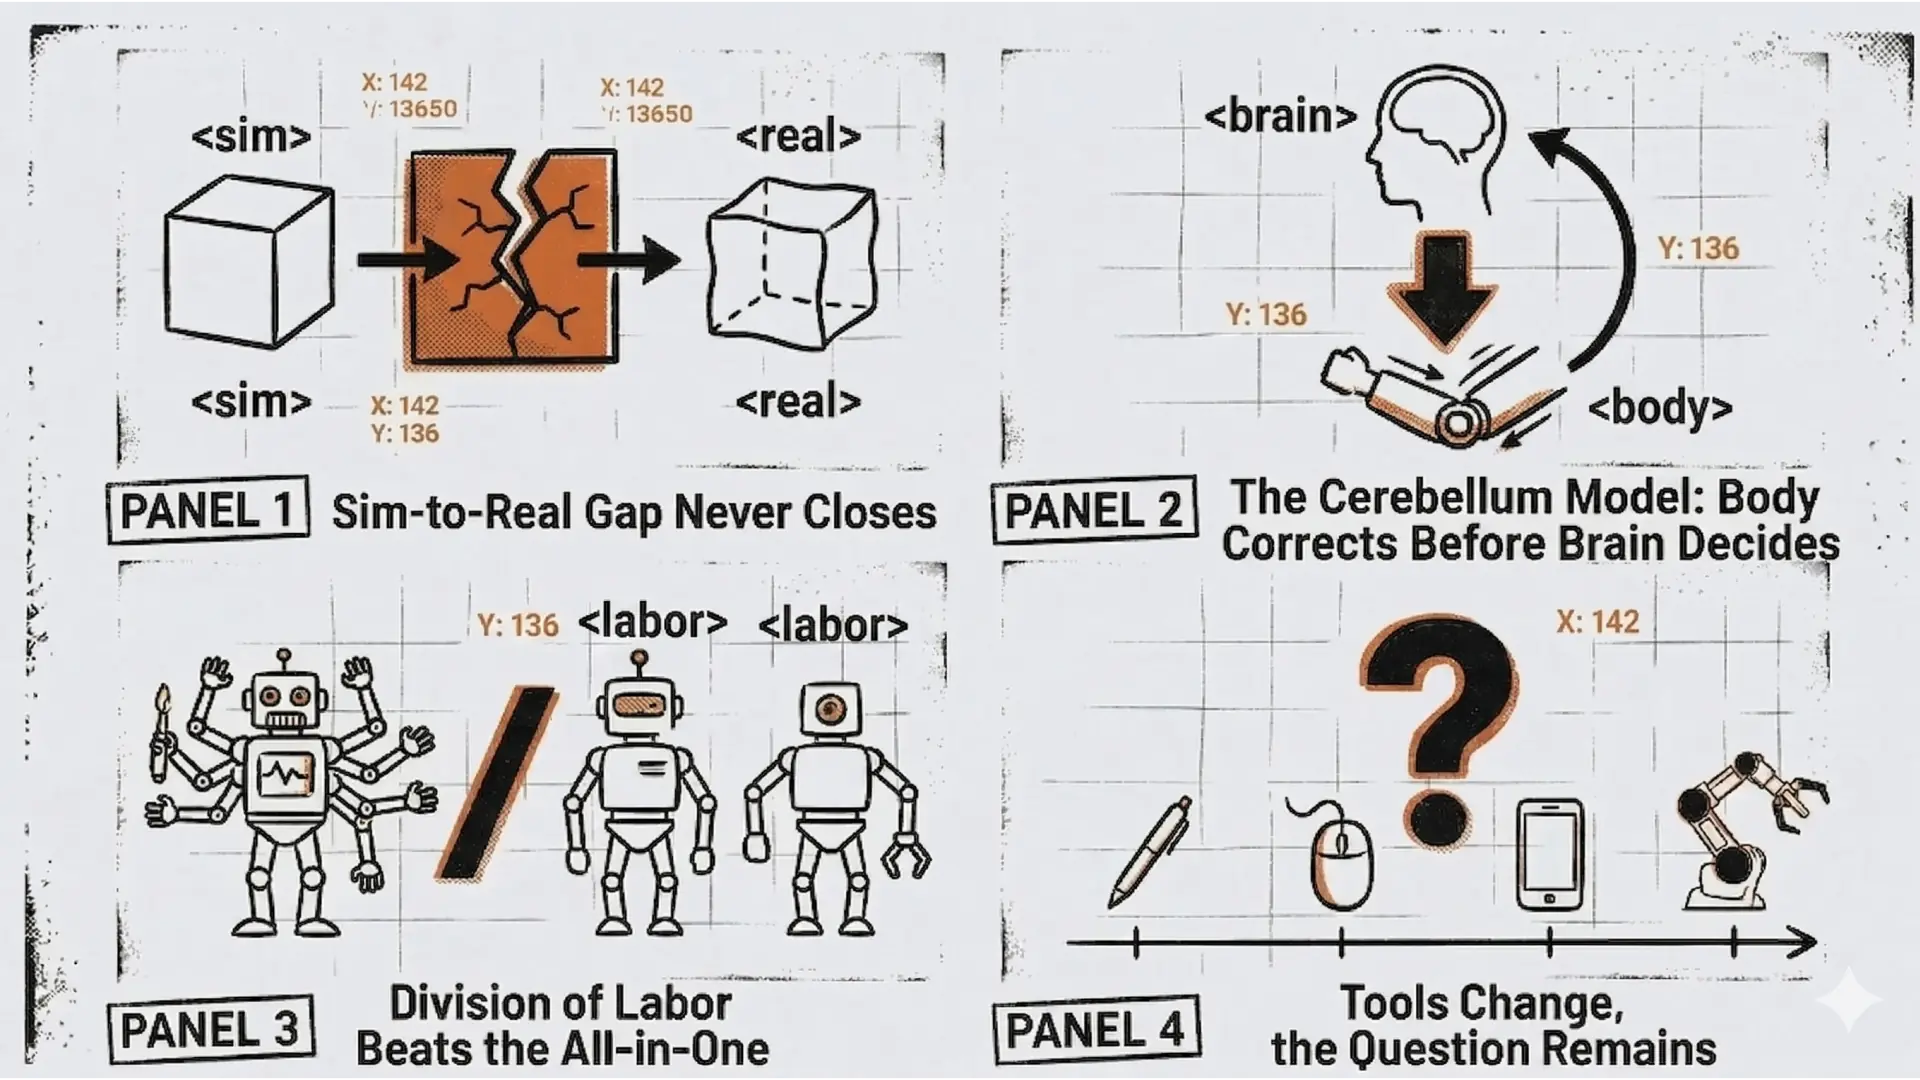
特にロボットの制御では、床の微妙な摩擦の違い、ケーブルのたわみ方、モーターの個体差、空気抵抗、接触面の微細な凹凸——こういった「記述しきれない物理」が制御に直撃する。シミュレーション上では完璧に動いても、実機に移した瞬間に崩れる。これはロボット開発者が何十年も直面してきた「sim-to-real gap」の問題で、世界モデルのアプローチでも本質的には同じ壁にぶつかる。
ハルシネーションについても楽観視できない。データを増やせば解決するというより、モデルが「それらしい動き」を自信満々に生成するようになるだけ、という悪化シナリオの方が現実的だ。不確実性の伝播を明示的に扱う研究は、その問題への自覚があるという意味では一歩進んでいる。しかし「モデルが信頼できる領域かどうかをリアルタイムで判断する仕組み」を別途用意しなければならず、それ自体がまた別の難問になる。
少なくとも今のフェーズでは、実機ベースで地道に積み上げていく方向の方が「体験の成立」には近道だと思っている。精度より体験の成立を優先する——精度はあとからお金で解決できる。
人はどう現実を認識しているのか——小脳という答え
— そもそも人はどう現実を認識して、うまくやっているんだろうね?
人間も「現実をそのまま見ている」わけじゃなくて、脳が作った近似モデルの中で生きている。視覚情報でさえ、網膜に入った光を脳が補完・解釈したもので、「見えている」と思っているものはかなりの部分が予測と補完でできている。
身体が勝手に修正するということだと、小脳の運動モデルの方が重要度が高いってことかな。
ボストンダイナミクスのロボットを見ていると、小脳のAIモデルを使ったアプローチがうまくいったように見えるよね。もちろんこれから別の問題が出るだろうけど。大きな進歩の一つだよね。
これは非常に鋭い視点だと思う。
小脳は「内部フォワードモデル」と呼ばれる仕組みを持っていて、「この命令を出したら身体はこう動くはず」という予測を高速で回し続けている。大脳皮質が「何をするか」を決める前に、小脳がすでに運動の結果を先読みして補正している。転びそうになったとき、人間は「モデルを更新して…」とは考えない。身体が勝手に動く。認知と行動と修正がほぼ同時に起きている。
世界モデルの議論は大脳寄りの認知モデルに偏りがちで、この小脳的な層——身体に埋め込まれた予測と補正——が軽視されている可能性がある。「状況を理解して行動を決める」よりも、「関節レベルで高速にフィードバックを回す小脳的な層」の方が、実機での安定性には本質的かもしれない。
ボストンダイナミクスがAtlasで見せたあの滑らかさと咄嗟の修正能力は、まさにその証明に見える。押されてもバランスを取る、段差に対応する、倒れかけても立て直す——あれは「状況を理解してから動く」のではなく、身体レベルで高速に誤差を吸収している。派手なAIモデルではなく、長年の制御理論ベースの地道な積み上げが結果的に小脳的な層を作り上げた、という側面がある。
もちろんこれから先、「タスクの多様性」という壁にぶつかるはずだ。バランスと移動は小脳的アプローチで素晴らしい成果が出たけど、「道具を使う」「状況を判断して行動を選ぶ」となると大脳的な層との統合が必要になってくる。その統合をどう設計するかが次の大きな問いになる。
汎用人型より、組み合わせが現実的
アトラスのような人型ロボットより、もう少し用途と機能を限定させたロボットを複数組み合わせて作業する方が現実的な気はするけどね。
— どういう流れで組み合わせを設計するのが良さそう?
まずは組み合わせで良い悪いの相性を知ってから問題をハッキリさせて、そのためのシステムを組むみたいな流れが良さそう。
一つのロボットに複数の機能を持たせるようなことより、組み合わせでいろいろ試せる方が将来の可能性も広いように思うけどな。
人の組織もそうだけど、効率化という意味では作業を分業させた方がいいよね。ロボットは効率化の必要性が高いから、現実で成果が出ているモデルをそのまま踏襲する方が良さそう。
コミュニケーションコストはロボットやシステムの方がコスト少なさそうなので上手くいくんじゃないかな?人と違ってモデルが決まれば複製しやすいからコストは下がりやすいと思う。
汎用人型ロボットへの熱量は理解できる。でも「何でもできる」を一台に詰め込むと、制御の複雑さが指数関数的に増える。二足歩行だけであれだけ大変なのに、そこに手先の操作、視覚認識、状況判断を乗せていくのは、問題を自分で増やしていくようなものだ。
用途と機能を絞ったロボットを複数組み合わせる方向の方が、工学的にも事業的にも筋がいい。相性の良い組み合わせとして直感的に思いつくのはこのあたりだ。
移動系 × アーム系:移動ロボットがモノを運んできて、アームが細かい作業をする。倉庫物流ではすでに実用化されている。
センシング系 × アクション系:ドローンが上から全体を把握して、地上のアームに「ここ」と指示を出す。目と手の分業。
粗動作系 × 精動作系:粗い動きが得意なロボットが大まかに位置を合わせて、細かい動きが得意なロボットが仕上げる。人間も両手で粗精度を分けて使う。
保持系 × 操作系:一方がモノを固定・保持している間に、もう一方が作業する。人間が一人でやると難しい作業が一気に解決する。
共通して言えるのは、「苦手を補い合う」より「役割をきっぱり分ける」方が相性が良い、ということだ。万能を目指す組み合わせより、割り切った分業の方がシステムとしてシンプルになる。
「いきなり最適なシステムを設計しない」というのが重要だと思っている。まず組み合わせてみて何が起きるかを観察する。相性の良し悪しを実際に知る。問題の輪郭が見えてから初めてシステムを組む。これはソフトウェアの世界でモノリシックアーキテクチャよりマイクロサービスの方が長期的に柔軟だったことと同じ構造だ。
マルチロボットの協調設計は、研究上は大きく3つのアーキテクチャに分類される。
アーキテクチャ | 特徴 | 向いている環境 | 予算感 |
|---|---|---|---|
中央集権型 | 一つのコントローラーが全体を管理。精度は高いが障害点が集中する | 工場など環境が固定・予測可能な場所 | 大規模・初期コスト高 |
分散型 | 各ロボットが自律的に判断。耐障害性が高く広域に対応できる | 災害救助・農業など変化しやすい環境 | 開発コスト高・スケールに強い |
ハイブリッド型 | 大まかな指示は中央、細かい動きは自律。バランス型 | 物流倉庫など中規模・動的な環境 | 設計が最も複雑だが現実的 |
予算が小さいほど中央集権型の方が最初は安く作れるが、スケールすると一番コストが跳ね上がる逆転現象が起きやすい。スタートは中央集権型でモデルを確立して、相性の良い組み合わせが見えてきたらハイブリッドへ移行する、という流れが現実的だと思っている。
一度モデルが確立すれば複製コストがほぼゼロに近づく。今この段階で「相性の良い組み合わせ」を探っている人が、標準モデルを作った側になれる可能性がある。
トレンドに乗る。でも依存しない。
今はみんなフィジカルAIがトレンドになってそっちの方ばかりに目がいってるけど、違うアプローチも常に用意しておかないとリスクが高くなるよね。
— それは意識的に設計していること?
この辺りは常に意識的にそう設計していますね。みんなが同じ方向向いている時ほどトレンドに乗り続けるのは危ないといつも感じています。もちろんトレンドに乗ることは全く否定しないです。むしろ積極的に使いたい。
今だとWEBデザインやUIデザインが大きなデザイン界のトレンドでしたが、生成AIの登場によってそれが崩れてしまった。しかも相当根幹から崩れたと思っています。
そうだねそれはもう意識と体に染み込んでいるね。何せデザイナーの初期はまだ手作業でしてたんだよ。
今の新しいデザイナーたちもこれからその感覚を経験によって養うんだろうね。波に乗れず目の前の仕事だけに追われていると痛い目を見るよね。
根幹から崩れたというのは表面的な話じゃない。職能の定義が変わり、クライアントの期待値が変わり、需要の構造が変わった。量産型のバナーやLP制作の価値は一気に下がり、何を作るかの判断や体験として成立するかの設計に重心が移った。ツールの習熟度や制作スピードで差別化していた人は直撃を受けた。AIで作れるんじゃないかという前提がクライアント側に入ってきたことで、従来の価格設定や工数の説明が通じにくくなった。
デザイナーとして29年、これだけの地殻変動を経験してきた。
時代 | 地殻変動の内容 | 消えたもの | 残ったもの |
|---|---|---|---|
1990年代前半 | 手作業 → DTP | 版下・写植の職人技 | レイアウトの判断力 |
1990年代後半〜2000年代 | 印刷 → WEB | 紙媒体中心の設計 | 情報設計の思想 |
2010年代 | 静的WEB → スマホ・インタラクション | デスクトップ前提のUI | UXという問いそのもの |
2020年代〜 | WEB・UI → 生成AI | 制作スピードによる差別化 | 「何を作るか」の判断 |
毎回今のスキルが陳腐化するタイミングを早めに察知して動いてきた。その経験則がそのままMotion UXへの移行につながっている。生成AIによってWEBデザイン・UIデザインが崩れたのを「終わり」と捉えるのではなく、「体験として成立するか」という問いを別のフィールド——ロボティクス——に移植した。29年の経験が無駄になったのではなく、別の地盤に移植されたのだ。
乗ると依存するの違いを意識できているかどうか、が分かれ目だと思う。トレンドは追い風として使うもので、それ自体がアイデンティティになると風向きが変わった瞬間に立ち位置を失う。Flash全盛期、フラットデザイン一色の時代、スマホファーストの波——トレンドに完全に乗り切った人より、トレンドを追い風として使いながら自分の軸を持っていた人の方が長く生き残っている。
手作業時代を知っているからこそ、「道具は変わる、問いは残る」という感覚が骨身に染みている。それは単なる適応力じゃない。次の地殻変動を予測して先に動くという判断を何度も繰り返してきた経験から来ている。
今の若いデザイナーたちも、これからその感覚を経験によって養っていくんだと思う。痛い目を見ながら、波に飲まれながら、それでも残るものを見つけながら。誰もが最初は波に乗り遅れるか、乗りすぎるかを経験する。大事なのはそこから何を学ぶかだ。
道具は変わる。問いは残る。
生成AIが「作る」という行為を代替しても、「何を、なぜ作るか」を問い続ける人の価値は消えない。フィジカルAIがどんなアーキテクチャに進化しても、「体験として成立するか」という問いは残り続ける。世界モデルが実機制御を実現しても、マルチロボットが工場を席巻しても、「その動きは人にとって自然に見えるか」「その体験は意味をなすか」を問う人間は必要であり続ける。
トレンドに乗ることと、トレンドに依存することは全く別物だ。
みんなが同じ方向を向いているときほど、別のアプローチを手元に持っておく。追い風は使う。でもその風がなくなったとき、自分がどこに立っているかを常に確認しておく。
それを体で知っているかどうかが、次の地殻変動を生き延びられるかどうかの分かれ目になると思っている。