GoogleのRT-2とFigureが証明した。良い動きはデータ量で決まる
今日はXのタイムラインに流れてきた一つのツイートをきっかけに、モーションデータの収集コスト、Z軸問題の構造、テレオペレーションとティーチングの違いまで、ずいぶん広い話をしていた。その思考の流れをそのまま記事にしてみる。
工場の映像の本質
中国の工場の映像を見たことがある。
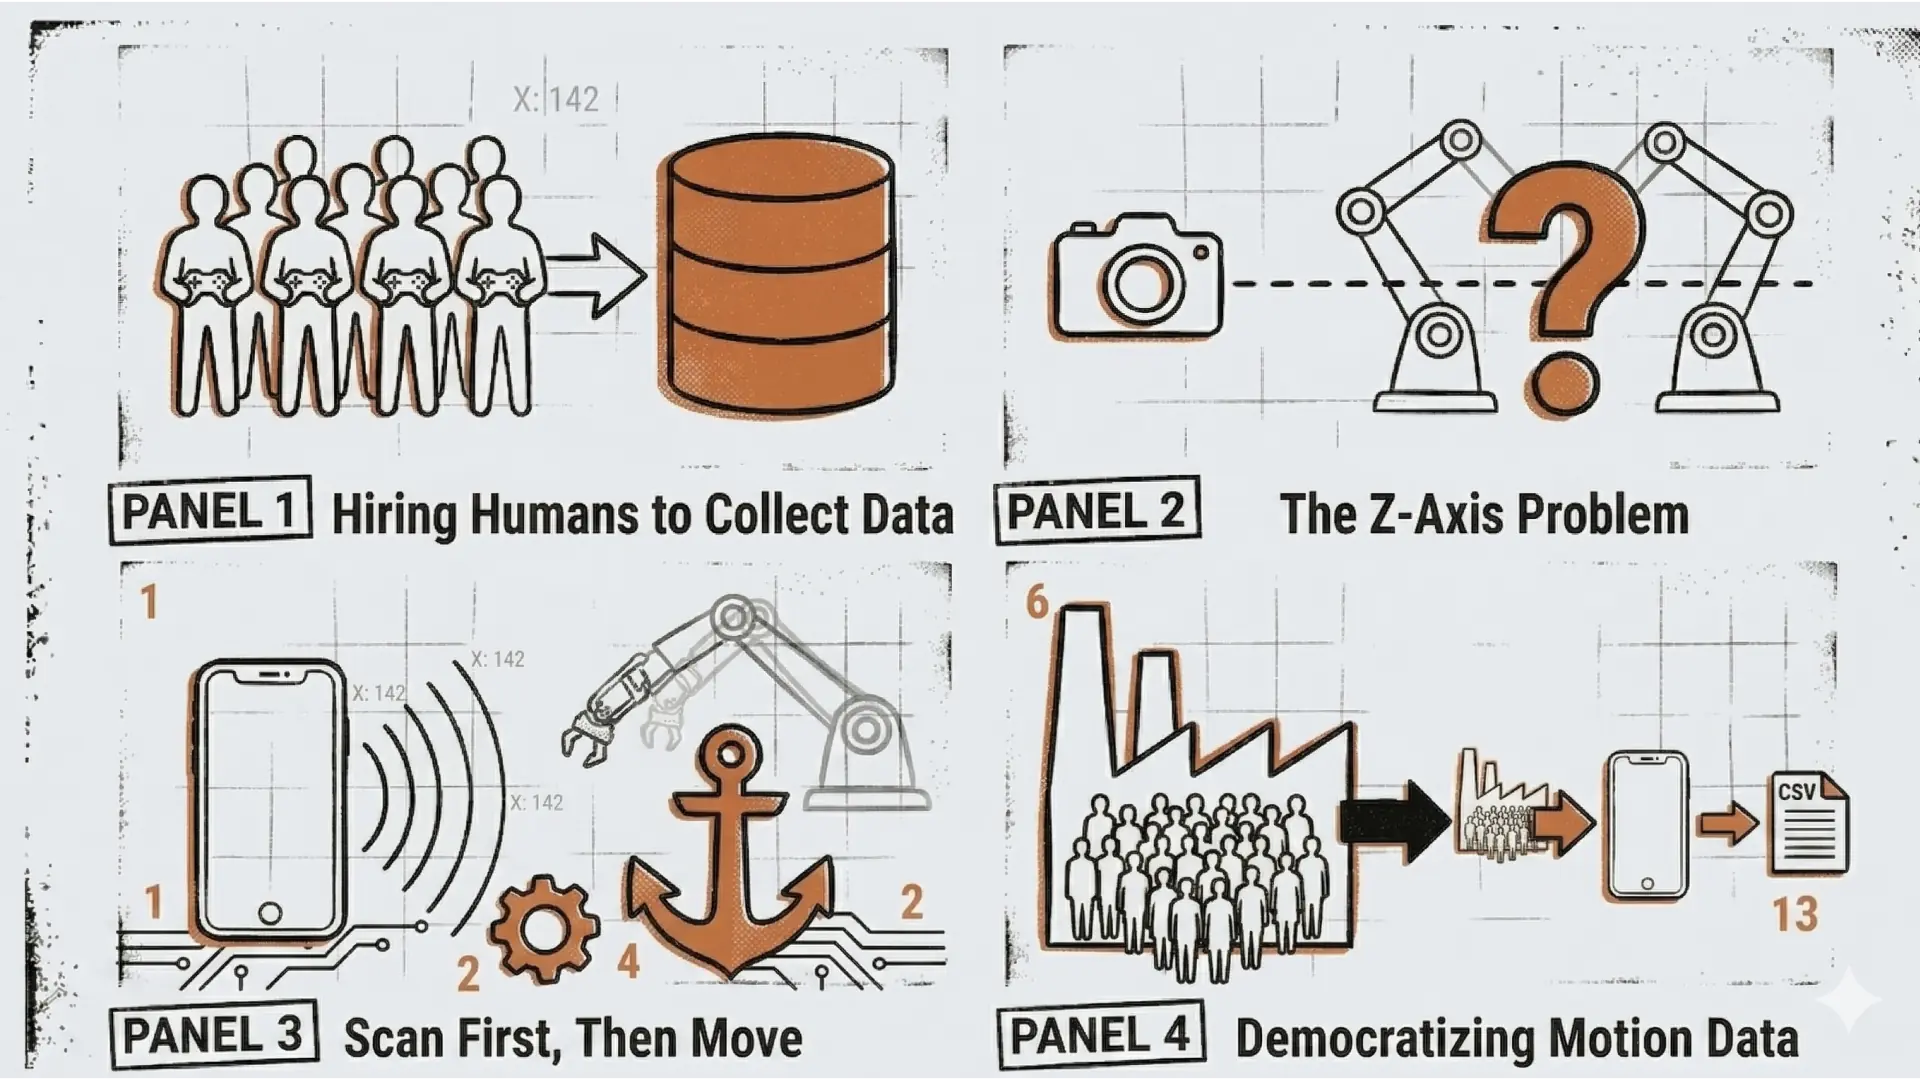
何十人もの人間が並んで、ロボットを遠隔操作しながら服を畳んだり、物を掴んで置いたりしている。整然とした作業台、画面に映る映像、コントローラーを握る手。一見すると未来的な光景に見えるし、「ロボットが作業している」ように見える。
でも少し考えると、あれは何をしているのか。
よく中国の工場とかでテレオペレーションで服を畳んだり、モノをつかんで置いたりして作業している人たちが何十人もでてくるけど、それだけ動きのデータを欲しがってるってことだよね。人と機材使ってでもとにかくデータが欲しい。
ロボットを動かしているのではない。データを集めているのだ。
人を雇って、機材を用意して、何万回も同じ動作を繰り返させる。それだけのコストをかけてでも手に入れたいのは、「良い動きのデータ」だ。ロボットの動作AIはデータ量が精度に直結する。1パターンしか知らないロボットは状況が少し変わるだけで止まる。1万パターンを知っているロボットは、多少ズレても対応できる。GoogleのRT-2やFigureが目指す「汎用的な動き」も、その根底にあるのは膨大なモーションデータだ。
だから今は、人を使ってでもデータを集める。他に手がないから。
Xに流れてきたツイート
きっかけはCYANPUPPETSというアカウントのツイートだった。
UE5.6向けのリアルタイムモーションキャプチャプラグイン。ウェブカメラか動画ファイルだけで動き、10億パラメータのAIモデルが映像をリアルタイムで3Dモーションデータに変換する。MetaHumanへの自動リターゲティングも対応。いいね496、インプレッション3.9万。かなり注目されていた。
技術として見ると、面白いポイントが3つある。マーカーレスであること。10億パラメータという大規模モデルで姿勢推定の精度を担保していること。そして自動リターゲティング——撮影した人間の動きを、MetaHumanキャラクターの骨格に自動で合わせ直してくれること。
でも「ウェブカメラだけでOK」は入力側の話であって、処理側のコストは全然安くない。
— RTX 4080を動かすPCのトータルコストはどのくらいになる?
パーツ | 必要スペック | 目安価格 |
|---|---|---|
GPU(RTX 4080) | ― | 18〜23万円 |
CPU | Core i7-13700以上 | 5〜7万円 |
メモリ | 32GB以上 | 1〜2万円 |
マザーボード・電源等 | PCIe 4.0対応、850W以上 | 4〜6万円 |
トータル | 約30〜40万円 |
まぁやっぱりトータルコストは高いなー。
「ウェブカメラだけ」の入力コストと、それを処理する側のコストは別の話だ。個人がモーションキャプチャのためだけにこれを用意するのは、現実的ではない。
Z軸という根本問題
そしてこれだけ重武装しても、Z軸(奥行き)の推定問題は根本解決できない。
2Dカメラ1台から奥行きを推定するのは、物理的に情報が足りない。腕が体の前にあるのか後ろにあるのか、映像だけでは本質的に曖昧なままだ。AIが「たぶんこう」と補完するから確率的なブレが生じる。高速動作や自己遮蔽(腕が体で隠れる等)でさらに精度が落ちる。
— 今奥行きの判定を簡単にするために他にどんな技術がある?
Z軸判定を楽にする技術は大きく3つの系統がある。
ハードウェアで解決する系は、深度センサーを追加する方向だ。LiDAR(iPhoneのPro以上に搭載)で直接Z軸を計測する、ToFカメラで光の往復時間から距離を計る、ステレオカメラで2台の視差からZ軸を推定する——人間の両目と同じ原理だ。
マルチビューで解決する系は、複数カメラで同時撮影して三角測量でZ軸を確定する。NBAやサッカーの選手トラッキングはこれだ。精度は高いが、カメラ設置と同期処理の問題がある。
AIで補う系は、Depth Anything V2、MiDaS、DUSt3Rといった単眼深度推定モデルを姿勢推定と組み合わせる。ハードウェア追加なしで動くが、精度は限定的だ。
Z軸判定の方法 | 精度 | コスト | 制約 |
|---|---|---|---|
OptiTrack等マーカー式 | ±0.1mm | 数百万円〜 | 設置・着用 |
ステレオカメラ | 高精度 | 中程度 | 同期・設置 |
LiDAR(iPhone Pro) | ±1〜2cm | ほぼゼロ(既所持) | 距離制限あり |
AI単眼推定 | ±数cm | ほぼゼロ | 物理的限界あり |
— カメラ2台でもZ軸の判定ができることがわかったけど、例えばiPhone2台で画像・動画取り込みしたらZ軸判定がしやすくなったりする?
理論的には全然アリだ。2台のiPhoneを固定距離で並べて同期撮影すれば、左右の視差からZ軸を計算できる。人間の両目と同じ原理だ。
ただし現実的な壁がある。2台のシャッターを完全に同期させるのが難しい。キャリブレーション(2台の位置関係を正確に固定・測定)も必要だ。それよりも現実的なのは、iPhone ProのLiDARと補助視点動画を組み合わせることだと思う——すでに手元にあるし、Record3Dで深度データも取れる。
LiDARと補助視点は、今おれがやろうとしていることだね。まずモデリングして、そのあと動画から動作のデータ取ろうと考えてたから近しいよね?
その通りだ。LiDARで空間を先に確定させて、動画で動きを乗せる。「空間」と「動き」を同時に取ろうとしないから、問題がシンプルになる。
動きのデータを取るということとZ軸判定は同義か
ここで一度立ち止まって整理した。
確認だけど、動きのデータを取るということと、Z軸判定を取るということはそもそも同義語だよね?ただしどういうデータを取るか?は違うかもだけど(おれはcsvに吐き出させるけど)
ほぼ同義だ。「動きを取る」=「時系列でXYZ座標を取る」ということだから、Z軸判定は動きデータの中に含まれている。
動きデータ = X(t) + Y(t) + Z(t) + 回転(t)
                         ↑
                   これがZ軸判定
ただし微妙に違う部分がある。
目的 | 取るもの | 形式 |
|---|---|---|
Z軸判定(深度推定) | 空間の奥行きマップ | 深度画像・点群 |
動きデータ(R2R2R) | 関節角度の時系列 | CSV |
Z軸判定は手段、動きデータは目的。 Z軸を正しく判定できて初めて、意味のある動きデータがCSVに吐き出せる。正しい手順はこうだ。
なるほど。確かにZ軸判定が出来て、それから動き判定するのが正しい手順だね。
Z軸判定(空間確定)→ 動き判定(時系列変化)→ CSV出力空間が確定していないのに動きを追っても座標がブレる。当たり前のことだけど、改めて整理するとこのパイプラインの順番が正しいことがわかる。
Pixels to Motorsのパイプラインが持つ意味
今Pixels to Motorsでやっていることを整理すると、こういう構造になっている。
iPhone LiDARで環境を3Dスキャン(空間を先に確定)
          ↓
Unityでデジタルツインを構築(モデルで座標を固定)
          ↓
その環境に合わせた動きを設計・検証
          ↓
CSVとして動作データを出力
          ↓
実機展開
          ↓
実機の動作データを記録・フィードバック
          ↓
シミュレーションと実機のズレを補正 → 設計に戻すシミュレーションと実機の間には必ずズレが生じる。そのズレを記録して設計に戻すループを回すことで、精度は繰り返しのたびに上がっていく。一回で完璧にするのではなく、実機から学び続ける構造を持っていることがこのパイプラインの強みだ。
一般的なモーションキャプチャは「空間」と「動き」を同時に取ろうとするから複雑になる。でも先にスキャンで空間を確定させておけば、「ここにカップがある」というアンカーが最初からある。Z軸を「推定」するのではなく、「最初から知っている」状態で動きの設計に入れる。これはZ軸問題への構造的な回答だ。計算で解くのではなく、設計の順番で回避する。
UXデザイナーとして「体験から逆算する」思考をずっとやってきたけれど、このパイプラインの設計は技術的にも同じ発想だったということに後から気づいた。
テレオペレーションとティーチングの違い
テレオペレーションとティーチングの明確な違いはある?
テレオペレーションとティーチング、似ているようで本質が違う。
テレオペレーション | ティーチング | |
|---|---|---|
誰が動かすか | 人間がリアルタイムで遠隔操作 | 事前にプログラムして登録 |
いつ動かすか | 本番作業中 | 作業前の準備段階 |
データの性質 | 現実の動きをそのまま記録 | 設計された動きを再現 |
向いている用途 | 変化する環境・汎用動作 | 繰り返し・定型作業 |
人間の関与 | 常時必要 | 準備だけ |
テレオペレーションは「動きを記録する」。ティーチングは「動きを登録して再現する」。
動きが決まっているならテレオペレーションで良さそうだよね。
その通りだ。同じ場所で、同じものを、同じ動きで繰り返す作業なら、収集したデータをループ再生するだけで成立する。工場の繰り返し作業はまさにそれだ。
問題が起きるのは、動きが変わる時だ。カップの位置が毎回違う、形状が違うものを掴む、予期しない障害物がある——こうなると固定データでは対応できない。
ロボットの用途 | 向いている手法 |
|---|---|
工場の定型・繰り返し作業 | テレオペレーション or ティーチング |
環境が変わる・個別対応が必要 | スキャン→設計のパイプライン |
汎用動作・未知の環境 | 大規模AIモデル+大量データ |
R2R2Rのパイプラインが目指しているのはさらに別のこと——「動きを設計する」だ。人間の実演なしで、環境をスキャンして、その環境に合わせた動きを作り出す。
データ収集の民主化という問い
テレオペレーション工場の映像を見て感じるのは、「これだけのコストをかけても足りない」という切実さだ。
それでもテレオペレーションで大規模にデータ収集するのは他に手がない(今のところ)からだよね?
そうだ。問題だらけだとわかっていても、現実の動きデータが確実に取れるという点で、今は一番確実な手法だから使い続けている。
だとすれば問いはこうなる。モーションデータの収集コストを、個人レベルまで下げられるか。
アプローチ | 初期コスト | Z軸の扱い | スケール性 | 誰でも使えるか |
|---|---|---|---|---|
テレオペレーション | 人件費(継続) | 実測 | 人数依存 | 人員が必要 |
高性能GPU+AI | 30〜40万円 | AI推定 | 中程度 | 高性能PC必要 |
R2R2R | ほぼゼロ | LiDARで事前確定 | 設計次第 | iPhone1台 |
iPhoneでスキャンして、Unityで動きを設計して、CSVで実機に展開する。このパイプラインが成立すれば、「データを作る」という行為が一部の大企業や研究機関だけのものではなくなる。工場に何十人も並べなくても、誰でも動きを設計してデータを出力できる。
まだ答えは出ていない。実機展開はこれからで、シミュレーションと現実のギャップはどこかで必ず壁になる。
でも問いの立て方は間違っていないと思っている。
精度の問題はあとからお金で解決できる。でも「誰でも動きを作れる」という体験の成立は、お金だけでは解決できない。設計の思想が先にないと、精度を上げる意味さえ生まれない。
わかっていたら誰かがすでにやっている。わかっていないからこそ、誰もいない場所にいる。