TeslaのEnd-to-Endニューラルネットから学ぶ|デモとデータを同時に生む設計
TeslaのEnd-to-Endニューラルネットワークを起点に、R2R2Rのアーキテクチャを問い直した日。辿り着いた結論は「今すぐE2E化ではなく、E2Eに繋げられる設計にしておく」だった。
💡 Key Takeaway
R2R2Rのモジュール型パイプラインは、今は正しい。でも各モジュールの「入力と出力」をログとして残す設計にしておくだけで、デモが動くたびに学習データが生まれる装置になる。デモと、データ収集が、同時に成立する。
考えたこと | 気づいたこと | 判断 |
|---|---|---|
TeslaのE2Eと自分のパイプラインを比較した | 問いの構造は同じで、スケールだけが違う | E2E化の方向は正しい。今ではない |
「いつE2Eに移行するか」を考えた | 移行の臨界点はまだ来ていない | 今はインターフェース設計を整える時期 |
モジュール間のログを残す設計を考えた | デモ実行がそのままデータ生成になる | 「データ収集装置」として設計し直す |
TeslaがEnd-to-Endを選んだ理由
—— 「人間が設計した中間工程」が最適解とは限らない、という宣言だった。
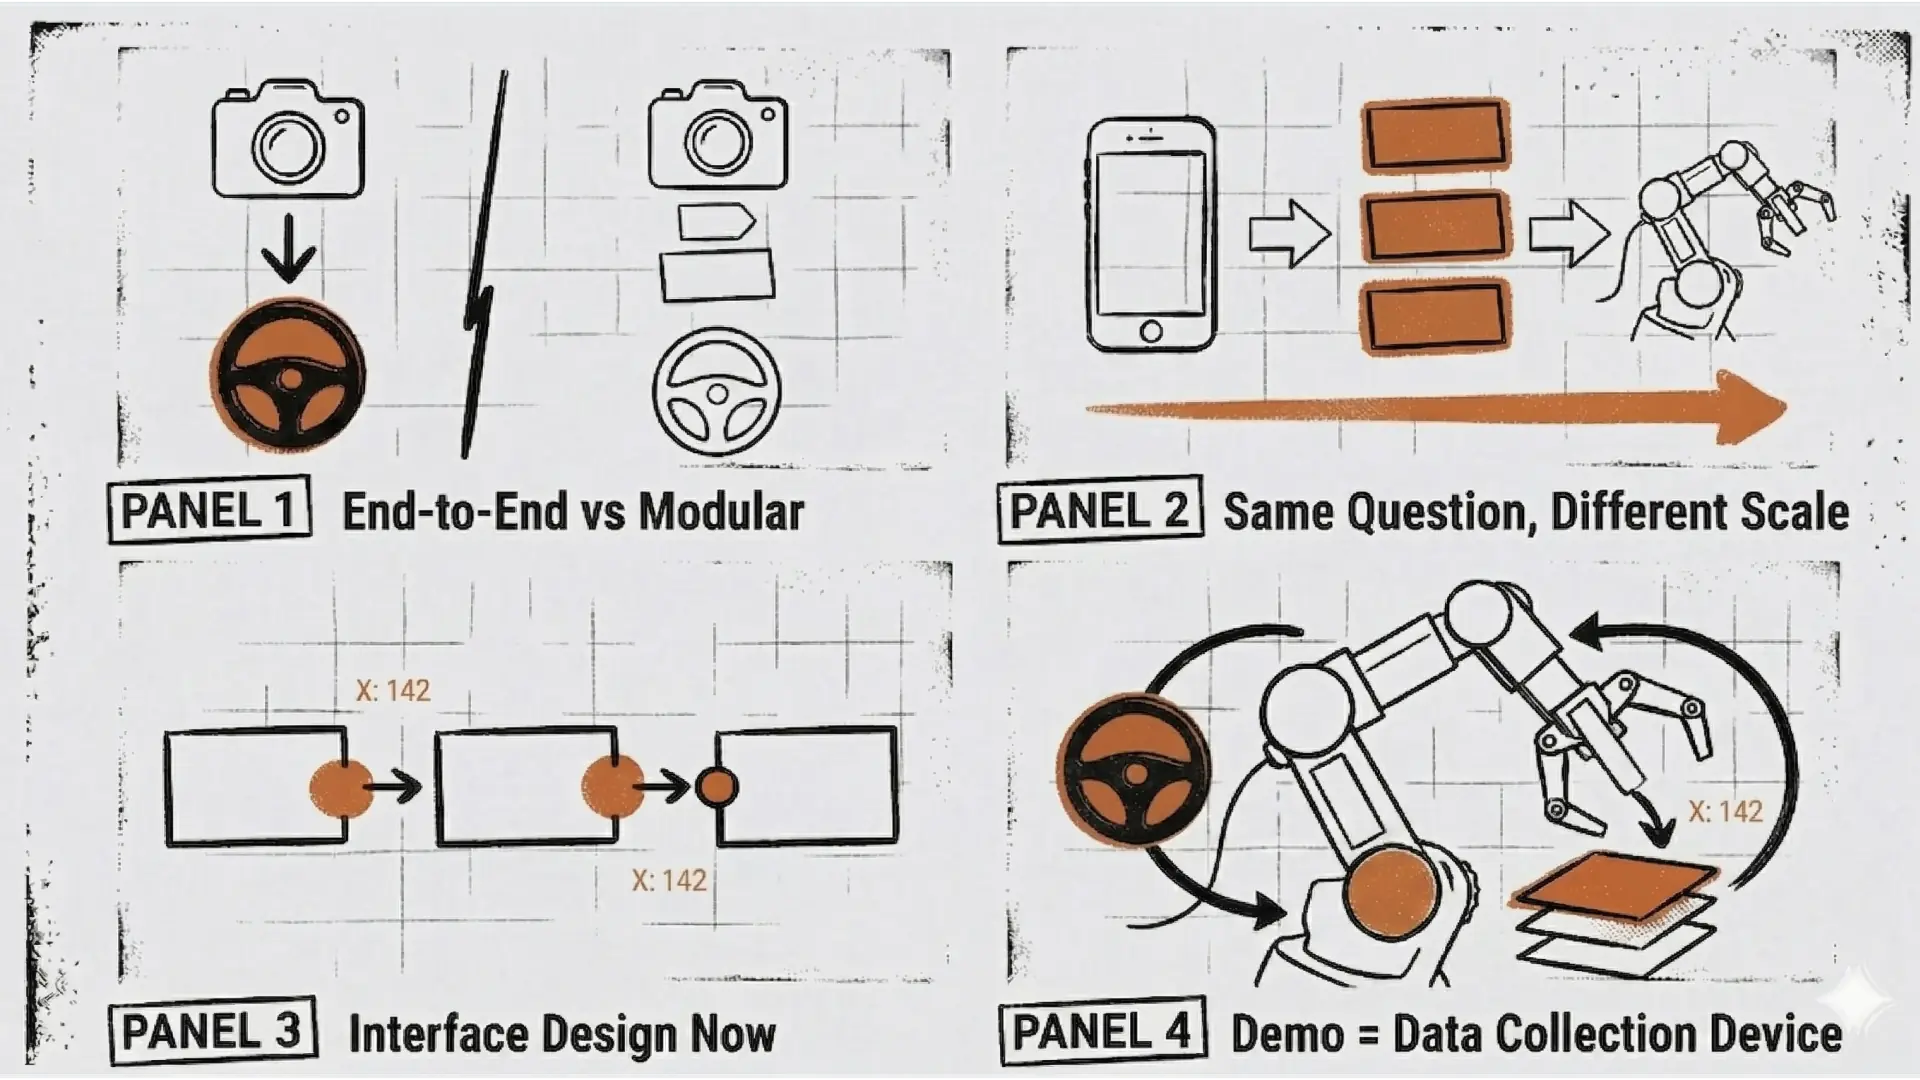
Teslaの自動運転アーキテクチャの核心は、カメラの生映像からステアリング・アクセル・ブレーキの出力まで、単一のニューラルネットワークが処理するという構造だ。
従来のアーキテクチャはこうなっていた。
カメラ映像
    ↓
車線認識(モジュール①)
    ↓
物体検出(モジュール②)
    ↓
経路計画(モジュール③)
    ↓
制御出力この分割は人間の概念だ。ロボティクス・自動運転の文脈で長年使われてきた「知覚→判断→制御」という分解は、人間が理解しやすいように設計されたもので、システムが最適解を見つける観点から言えば必ずしも正しくない。
End-to-Endが選ばれた理由は3つある。モジュール間で誤差が累積しないこと、最終目標に対して直接勾配が流れること、そして大量データの威力を最も活かせる構造であること。
R2R2Rと問いの形が同じだった
—— スケールは桁違い。でも「入力から出力まで何を挟むか」という問いは同じだ。
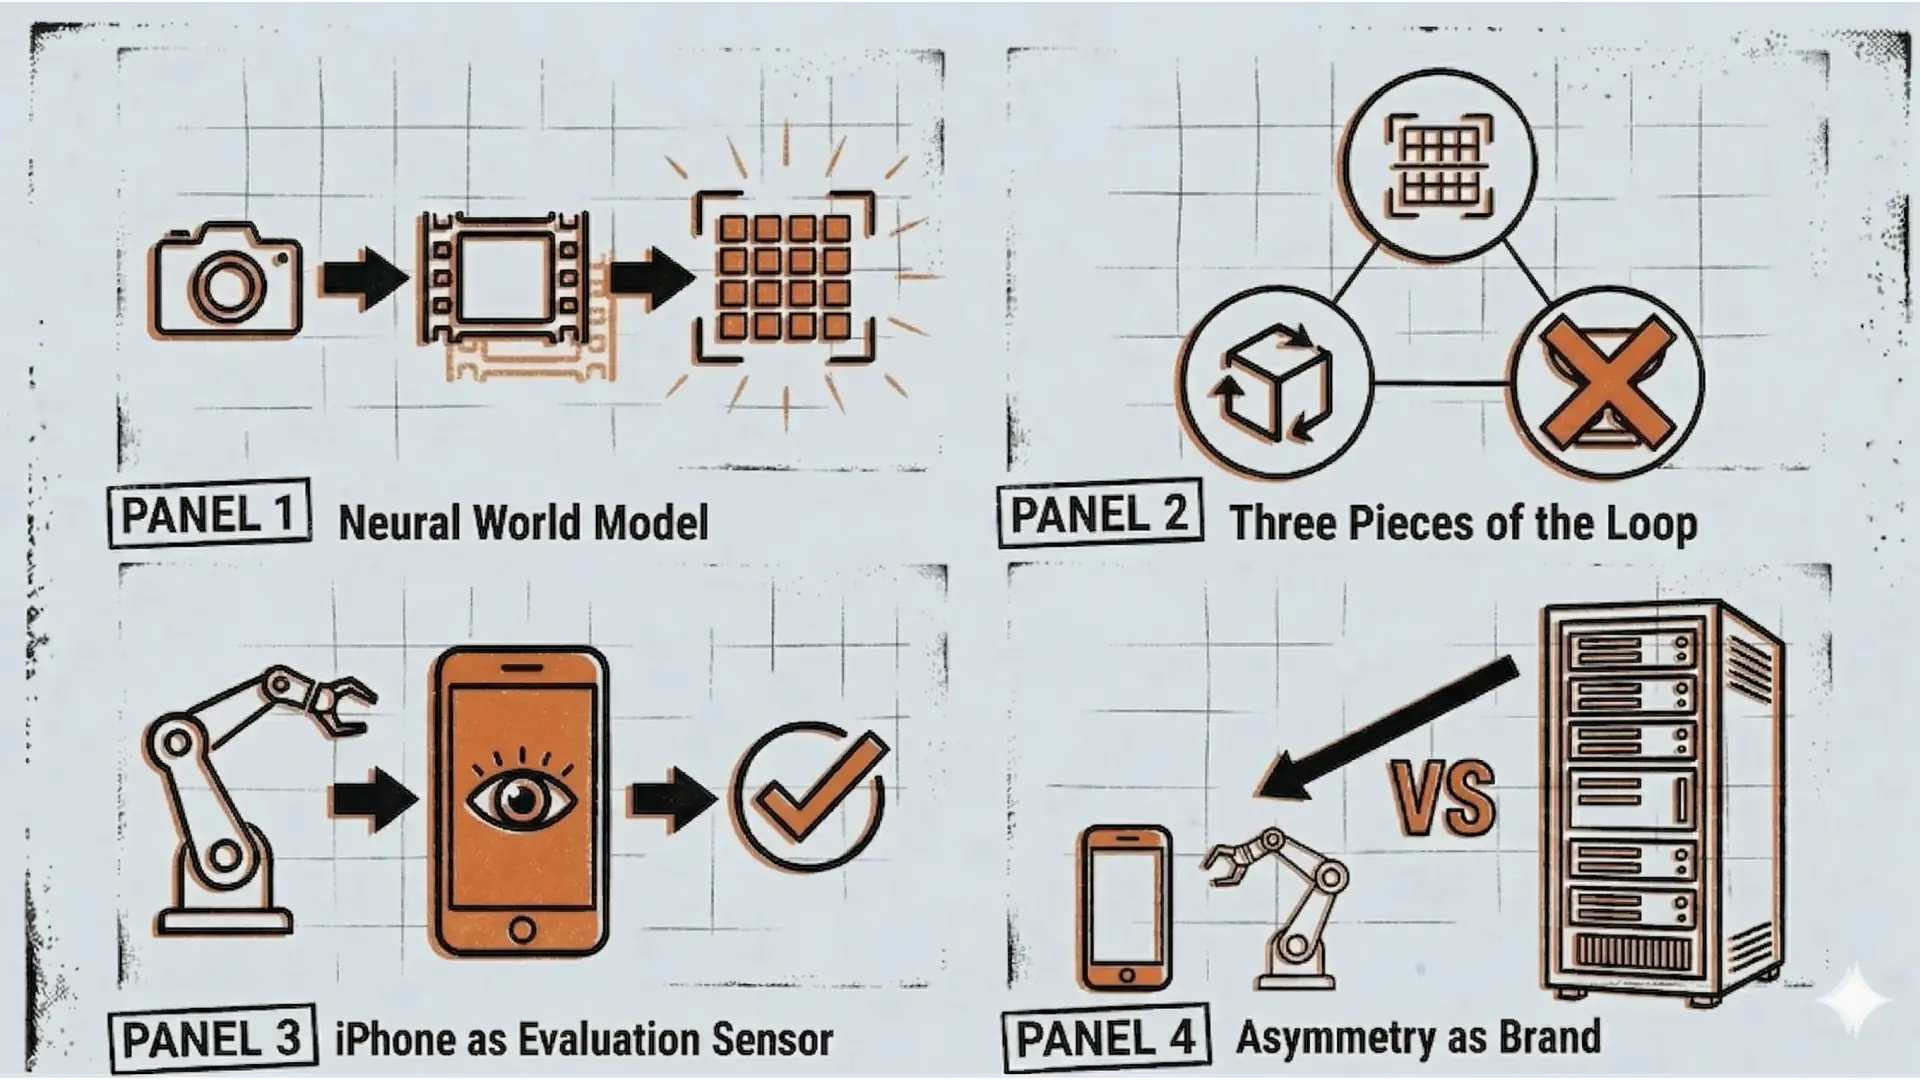
R2R2Rのパイプラインを整理するとこうなっている。
スキャン → Unity判定 → 座標 → 動作
   ↑①          ↑②      ↑③
ここの3箇所のインターフェースが設計対象
Teslaが「カメラ映像 → 運転操作」の間を単一ネットワークで繋いだように、R2R2Rも将来的には「カメラ映像 → 把持動作」の間を直接繋ぐ可能性がある。
Tesla E2E | R2R2R |
|---|---|
カメラ生映像(入力) | iPhoneスキャン映像(入力) |
End-to-End ニューラルネット | スキャン→Unity→座標→動作(モジュール型) |
ステアリング・制御(出力) | mechArmの把持動作(出力) |
問いの形は同じだ。
今すぐE2E化する必要はない
—— E2E移行には前提がある。今はまだそれが揃っていない。
E2Eが有効になる臨界点がある。
タスクが増えて分岐が複雑化する
    → モジュール間の条件分岐が爆発する

複数ロボットが連携する
    → 中間データの受け渡しがボトルネックになる

リアルタイム性が要求される
    → モジュール間レイテンシが致命的になる

環境変化への適応が必要になる
    → 事前設計した境界が崩れる
R2R2Rは今、このどれにも直面していない。
「精度より体験の成立を優先する」という設計哲学で言えば、今は体験を成立させる段階だ。モジュール型は各ステップを人間が検証・修正でき、失敗箇所の特定が容易で、PickAndPlaceデモという明確なゴールに最短で届く。今のモジュール型は正しい選択だ。
でも、インターフェース設計は今から考える
—— 「人間の都合で切った境界線か」を常に問いながら設計する。
E2Eへの移行を意識した設計思想は、今から持つべきだ。具体的にやることはシンプルで、各モジュールの境界を「人間が理解しやすいから」ではなく「将来統合しやすいから」という基準で切ること。
3つのインターフェースそれぞれでやれることがある。
① スキャン → Unity判定
スキャンデータに物体の種類・サイズ・重心推定などのメタ情報を標準フォーマットで付与しておく。将来VisionモデルがここをE2Eで置き換えるとき、同じメタ情報を出力すればシームレスに繋がる。
② Unity判定 → 座標
座標だけでなく「なぜその座標か」の根拠データも一緒に流す。これが将来の学習データのラベルになる。
③ 座標 → 動作
変換ロジックを独立したレイヤーとして明示的に分離しておく。ここが最初にMLで置き換わる可能性が最も高い箇所だ。
デモを「データ収集装置」として設計し直す
—— デモが動くたびに、学習データが生まれる。その設計にしておく。
各モジュールの入力と出力をログとして残す設計にするだけで、状況が変わる。
デモ実行
    ↓
(入力画像, Unity判定結果, 座標, 動作ログ) を自動記録
    ↓
将来の (入力, 正解出力) ペアデータとして蓄積
    ↓
E2Eモデルの学習データセットになる
E2Eモデルは結局、「この入力のときこの出力が正解」というペアデータが命だ。今のモジュール型が動くたびにそのペアを自動生成している状態を作れれば、デモとデータ収集が同時に成立する。
追加コストはほぼゼロ。必要なのは設計の意図だけだ。
これはR2R2Rのポジションの話でもある。
「このデモは動作するたびに学習データを生んでいる」
この一文が言えるだけで、PickAndPlaceデモの意味が根本的に変わる。GR00T N2やIsaac Labとの接続を将来の選択肢として明示できる文脈になる。
次のステップ
Phase 2のCSVログ設計に、この視点を組み込む。
成功率の記録に加えて「各モジュールの入出力ペア」も同時に記録できる構造にしておく。今のr2r2r_loop.pyのログ設計を見直す前に、何をどの粒度で残すべきかを整理する。
意識的に積んでいる技術的負債は、意識があれば返せる。