Claude Codeのマルチエージェント設計がSim-to-Realループと同じ問いを解いていた
「Claude Code マルチエージェント設計|AIの出力品質を劇的に上げるハーネスパターン」を読んでいたら、R2R2Rが次にやるべき実験が見えてきた。
💡 Key Takeaway
生成と評価を分離するという構造は、コード生成だけでなくロボット動作設計にそのまま適用できる。UnityシミュレーションとmechArm実機の間に「評価器」を置くことで、R2R2Rのパイプラインは初めてループとして閉じる。
発生した問題 | 現場判断 | 結果 |
|---|---|---|
Claudeの出力品質が会話後半で落ちる | 原因を構造的に理解する必要があった | コンテキスト不安と自己評価バイアスの2つと特定 |
ハーネス概念をR2R2Rに適用できるか不明だった | 出力物ごとに実装可能性を分析した | 現状は生成と評価の分離がすでに部分的に機能していると判明 |
評価器ループの実装方法が不明だった | 最小構成から始めることを決めた | タスク成否ログ+iPhone実証実験が次のアクションとして確定 |
きっかけはClaudeの品質低下への素朴な疑問だった
— Claudeの出力品質が落ちるのをどう防ぐか、改めて整理したかった。
定期的にチャットを移行したり、まとめを作って引き継いだり、プロジェクトのMDを更新したりしてるけど、これって本当に効いてるのかな。
そこで参照したのが「Claude Code マルチエージェント設計|AIの出力品質を劇的に上げるハーネスパターン」という記事だった。単一エージェントで長時間タスクをこなすことの構造的な限界を、GANの概念——生成器と判別器が対立しながらお互いを高め合う——に着想を得たマルチエージェント構成で解決するというアプローチだ。
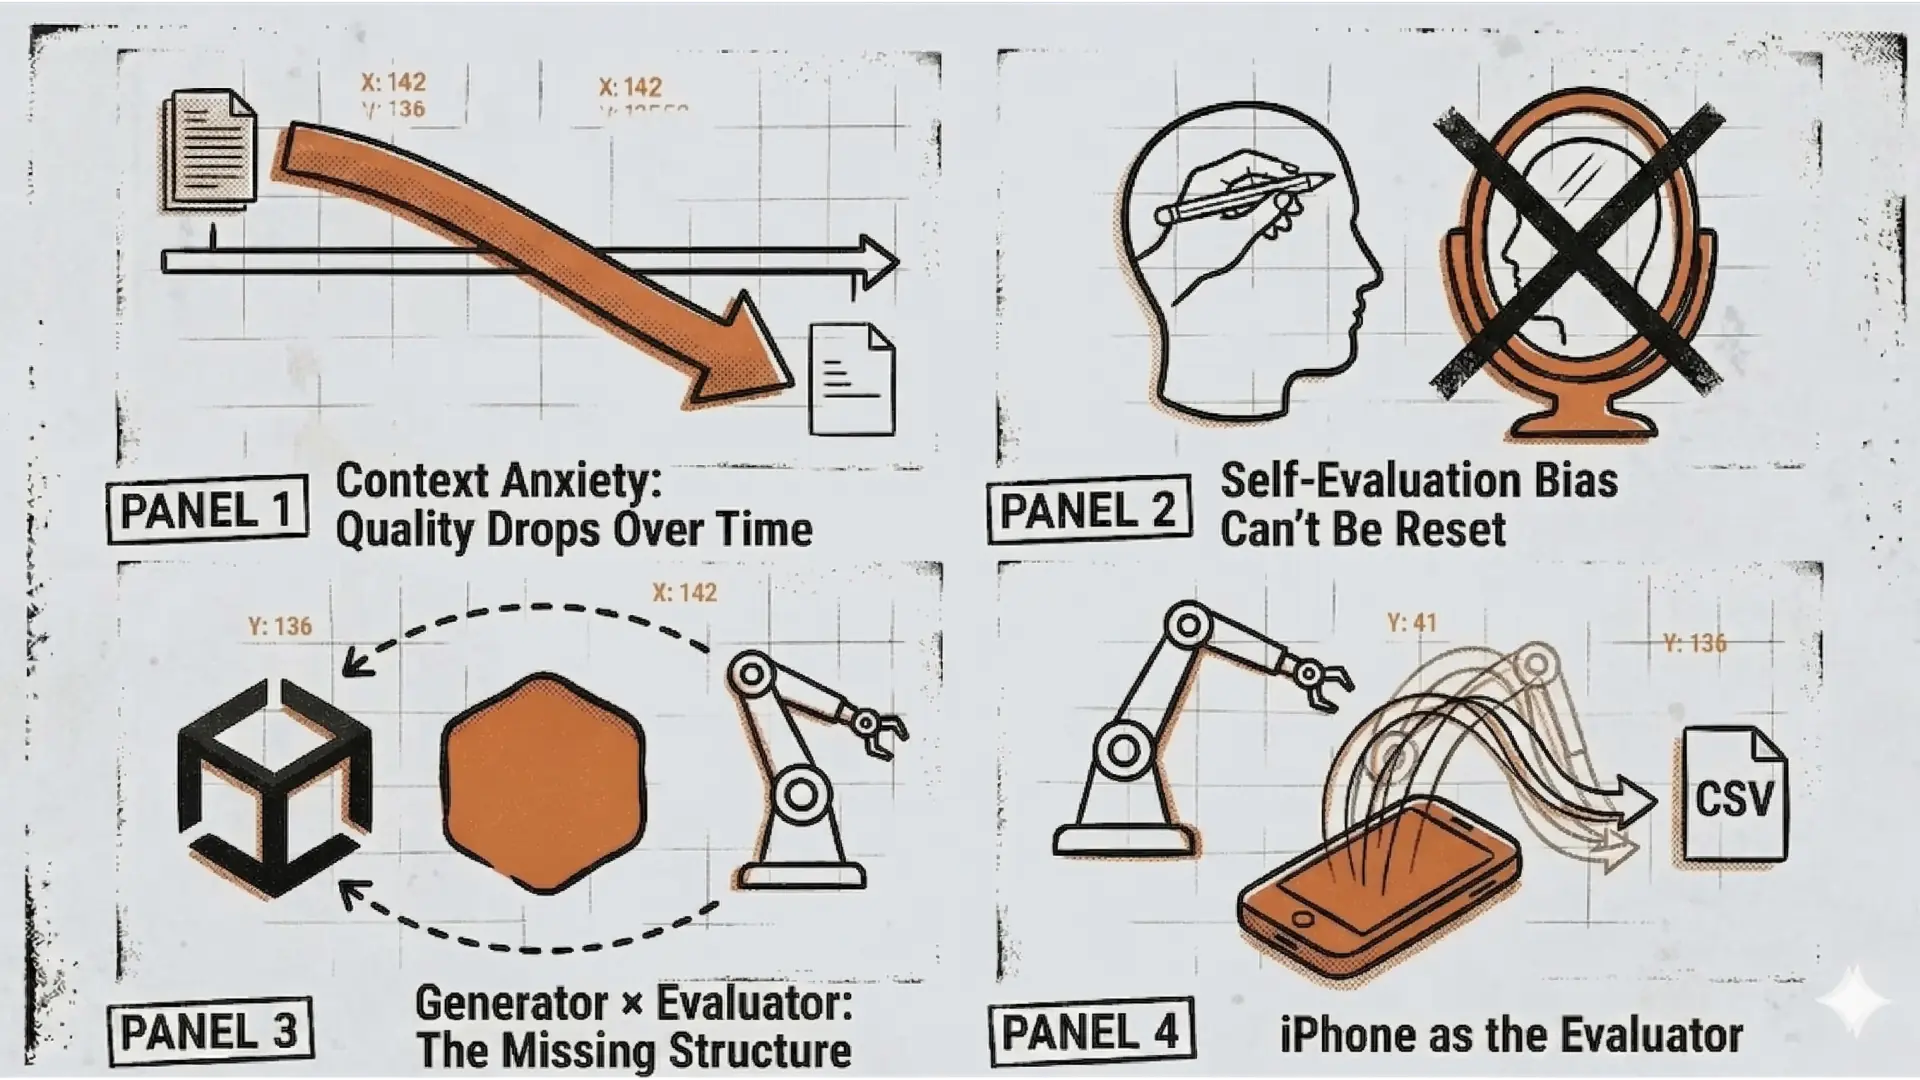
記事が指摘する問題は2つある。コンテキスト不安と自己評価バイアスだ。
コンテキスト不安は、会話が長くなるにつれてモデルが「早く終わらせなければ」という挙動を示し始める現象だ。記述が後半になるほど粗くなる、「詳細は省きますが」という言い訳が増える、という形で現れる。チャットの移行が一定の効果を持つのはこのためだ。
一方、自己評価バイアスはリセットしても消えない。新しい会話を立てても、Claudeが自分の出力を甘く評価する構造は変わらない。「作る側と評価する側が同じである限り、品質の天井は突破できない」——記事のこの指摘は、AIを使う全員に刺さる言葉だ。
今やっていることを厳格に評価した
— 定期的なチャット移行・まとめの引き継ぎ・プロジェクトMDの更新、それぞれの効果を正直に評価してほしかった。
移行時にチャットをまとめてもらって構造化して、新しいチャットに渡してるけど、これは効果ある?厳しく評価して。
結論は「やらないよりマシ、ただし本質的な解決策ではない」だった。まとめを作っているのがClaudeである以上、取捨選択はClaudeの判断に依存する。うまくいかなかった試みや都合の悪い情報が無意識に省かれる可能性があり、「きれいに見えるが重要なコンテキストが抜けたまとめ」を土台に次の会話が始まるリスクがある。
3つの施策を整理するとこうなる。
施策 | 効果 | 限界 |
|---|---|---|
定期的なチャット移行 | コンテキスト不安には効く | 自己評価バイアスは残る |
まとめを構造化して引き継ぎ | やらないよりマシ | 検証されていない・Claudeが作る |
プロジェクトMDの更新 | 現状では最も効果が高い | 床を上げる施策。天井は突破しない |
MDの更新が最も効果が高いのは、すべての会話の起点に同じ制約・基準が入るからだ。ただし「何を出すか」は整備されていても、「何が良い出力か」の定義が弱かった。今回の議論を踏まえて、記事MDの合格条件・NGパターン・SNS投稿の品質基準・失敗ログの4つを追加した。
ハーネス概念をR2R2Rに当てはめた瞬間、話が変わった
— この生成器×評価器の分離をR2R2Rに使えるとすれば、どんな形になるか。
生成されたロボットアームの大量シミュレーションとリアルデータのループで精度・品質向上に役立てたい。
この問いを立てた瞬間、議論の次元が変わった。コード生成の品質管理の話が、R2R2Rのアーキテクチャそのものの話になったからだ。
対応関係を整理するとこうなる。
記事(コード生成) | R2R2R(ロボット動作) |
|---|---|
生成器:コードを書く | 生成器:Unityで動作軌道を生成 |
評価器:Playwrightで動作確認 | 評価器:実機mechArmで軌道を実行・計測 |
フィードバック:バグ報告 | フィードバック:実世界との誤差データ |
再生成:コード修正 | 再生成:Unity軌道の補正 |
これはR2R2Rが最初から目指していたSim-to-Realループそのものだ。
ただし正直に言えば、現状のセットアップではループが閉じていない。
Unity生成 → mechArm実行 → ここで止まっている

本来必要な構造:
mechArm実行 → 誤差計測 → Unityパラメータを補正 → 再生成
mechArm 270にforce/torqueセンサーはなく、実行品質の自動計測手段が存在しない。つまり「評価器」の部分がまだ存在していないのが実態だ。
次にやるべき実験が明確になった
評価器を作るための最小構成として3つのオプションが見えた。
Option A:タスク成否ログ(今すぐ) 実行ごとに指令軌道CSV・成功/失敗・失敗パターンを手動記録する。精度は低いが積み上げると補正の根拠になる。
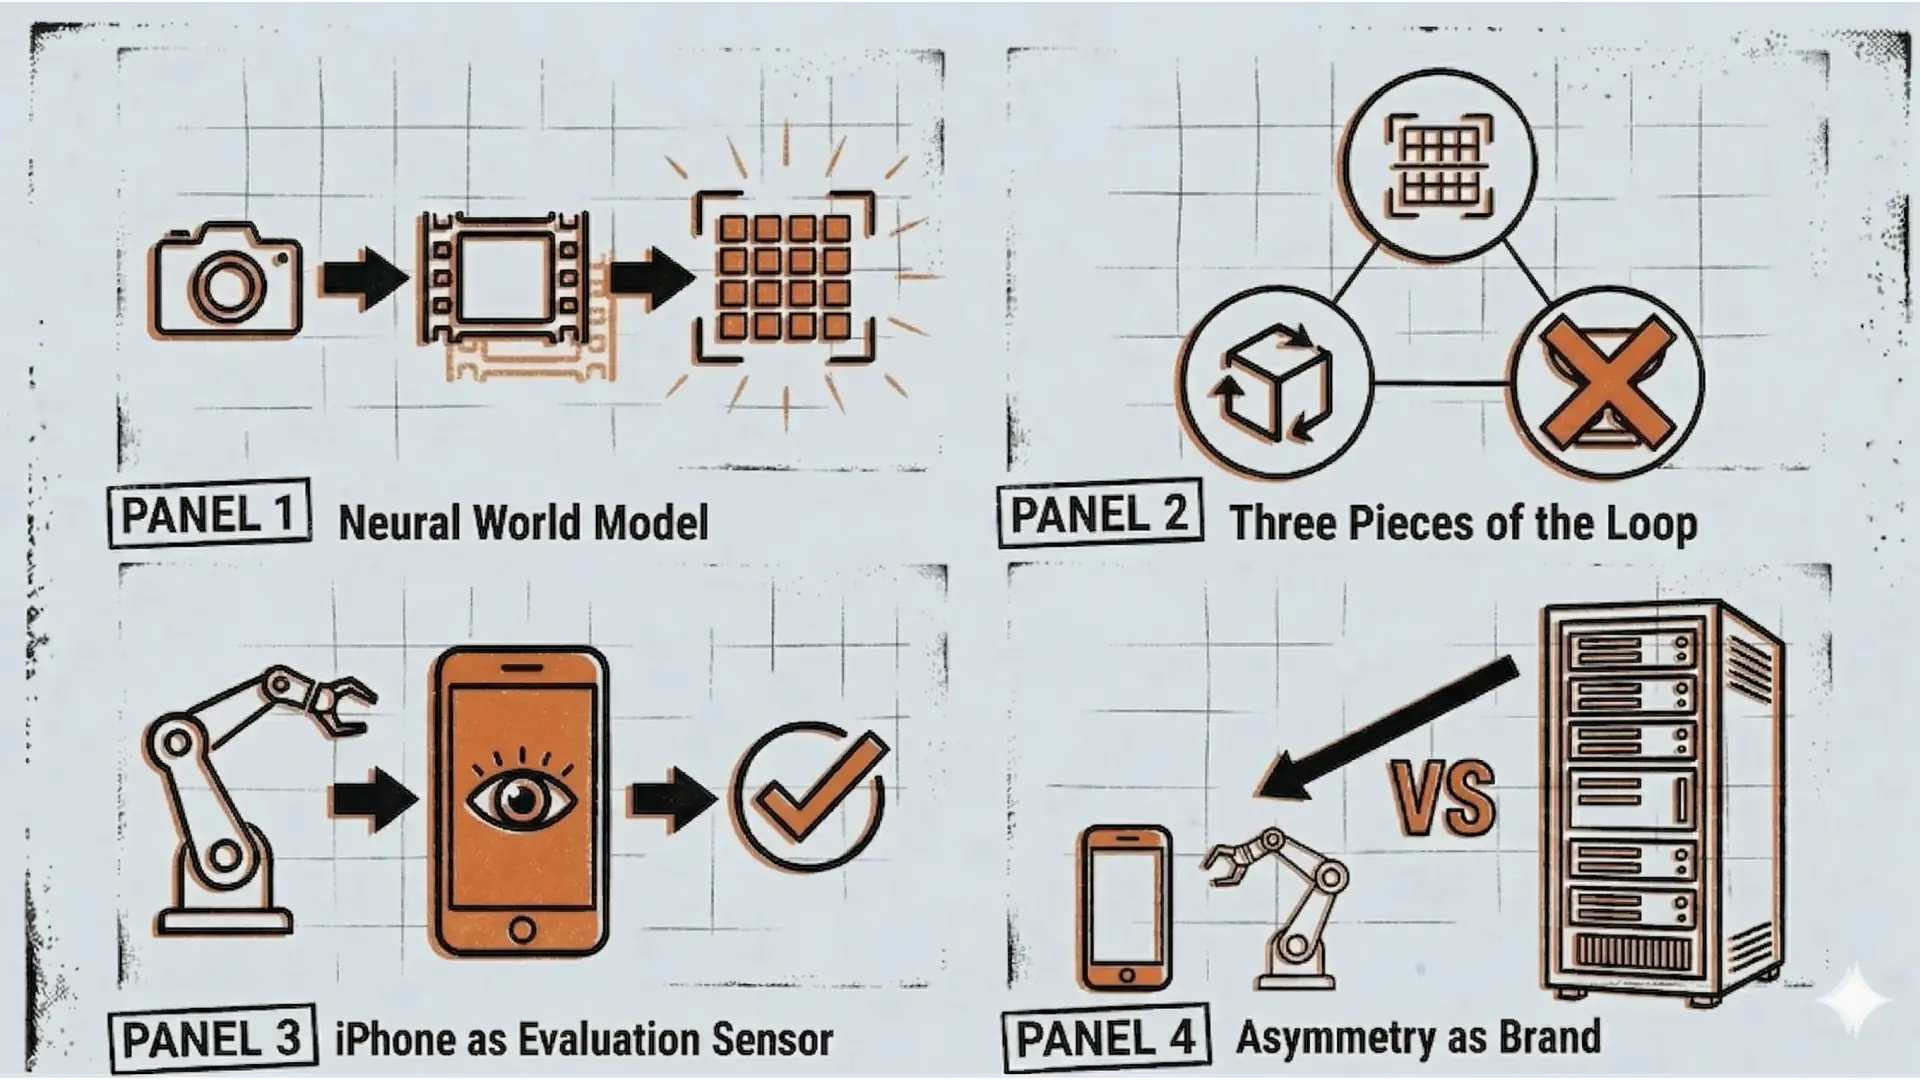
Option B:iPhoneによる軌跡記録(中期) 実行動画またはLiDARで実軌跡を記録し、Unity内の指令軌跡と重ね合わせて誤差を可視化する。これがR2R2Rの「Render→Real」の検証になる。
Option C:エンコーダーデータ取得(中期) pymycobotのget_angles()を高頻度でポーリングして実行中の関節角度を時系列記録し、指令値との差分をCSVで蓄積する。
着手順序はOption Aからだ。ただしOption Aのログを設計する前に、今の機材で実際に何が計測できるかを実証する必要がある。
まずmechArmを動かしながらiPhoneで撮影して、映像から何が読み取れるかを一度やってみる。精度が低くても、どんなデータが取れてそれによって何がもっと必要なのかが詳しくわかればR2R2Rが進む。
この判断は正しい。「精度より体験の成立を優先する。精度はあとからお金で解決できる」というR2R2Rの設計哲学をデータ計測にそのまま適用する形だ。
実証実験で明らかにすべき問いは以下の4つだ。
iPhoneカメラ(通常 or LiDAR)でエンドエフェクタの軌跡を実用精度で追跡できるか
mechArmのget_angles()ポーリングで取れる時系列データは評価に使える品質か
把持成否の判定を映像から自動化できるか、目視に頼るしかないか
取れたデータがUnityの軌道補正に実際につながるか
「何が見えたか」「何が見えなかったか」「何があれば見えるようになるか」の3点を記録するだけでいい。それだけで今の機材の限界と次に必要なものが自然に浮かび上がる。
AIの出力品質を上げるための構造的な問いが、そのままSim-to-Realループの設計問題と同じだったという事実が、R2R2Rの次のフェーズを指し示している。