AGIBOTが100万エピソードでやることを、自分は10エピソードから始める
AGIBOTが発表した世界シミュレーターを分析しながら、R2R2Rパイプラインと構造的に同じ問いを解いていることに気づいた日。
💡 Key Takeaway
GE-Sim 2.0は「現実録画 → 世界モデル化 → 閉ループ学習」という構造で動いている。R2R2Rは「3Dスキャン → Unityデジタルツイン → 実機展開」という構造で動いている。スケールは桁違いに違う。でも問いの形は同じだ。そして、自分に欠けているのは「3番目のピース」だけだという事実に、今辿り着いた。
分析したこと | 気づいたこと | 判断 |
|---|---|---|
GE-Sim 2.0のアーキテクチャを読んだ | R2R2Rと構造が同形であることを確認した | スケールの非対称性をブランドにできる |
クローズドループに必要な3ピースを特定した | 自分には1と2がある、3番目だけ欠けている | VLM-as-Rewardで3番目を埋められる |
mechArmスケールで「完全な報酬モデル」は無理と判断した | 「報酬の代替」ならiPhone+APIで組める | 物理的な追加ゼロでループが成立する |
AGIBOTが発表した「世界シミュレーター」とは何か
—— 単なるシミュレーターではなく、評価機能を内蔵した閉ループ学習基盤だった。
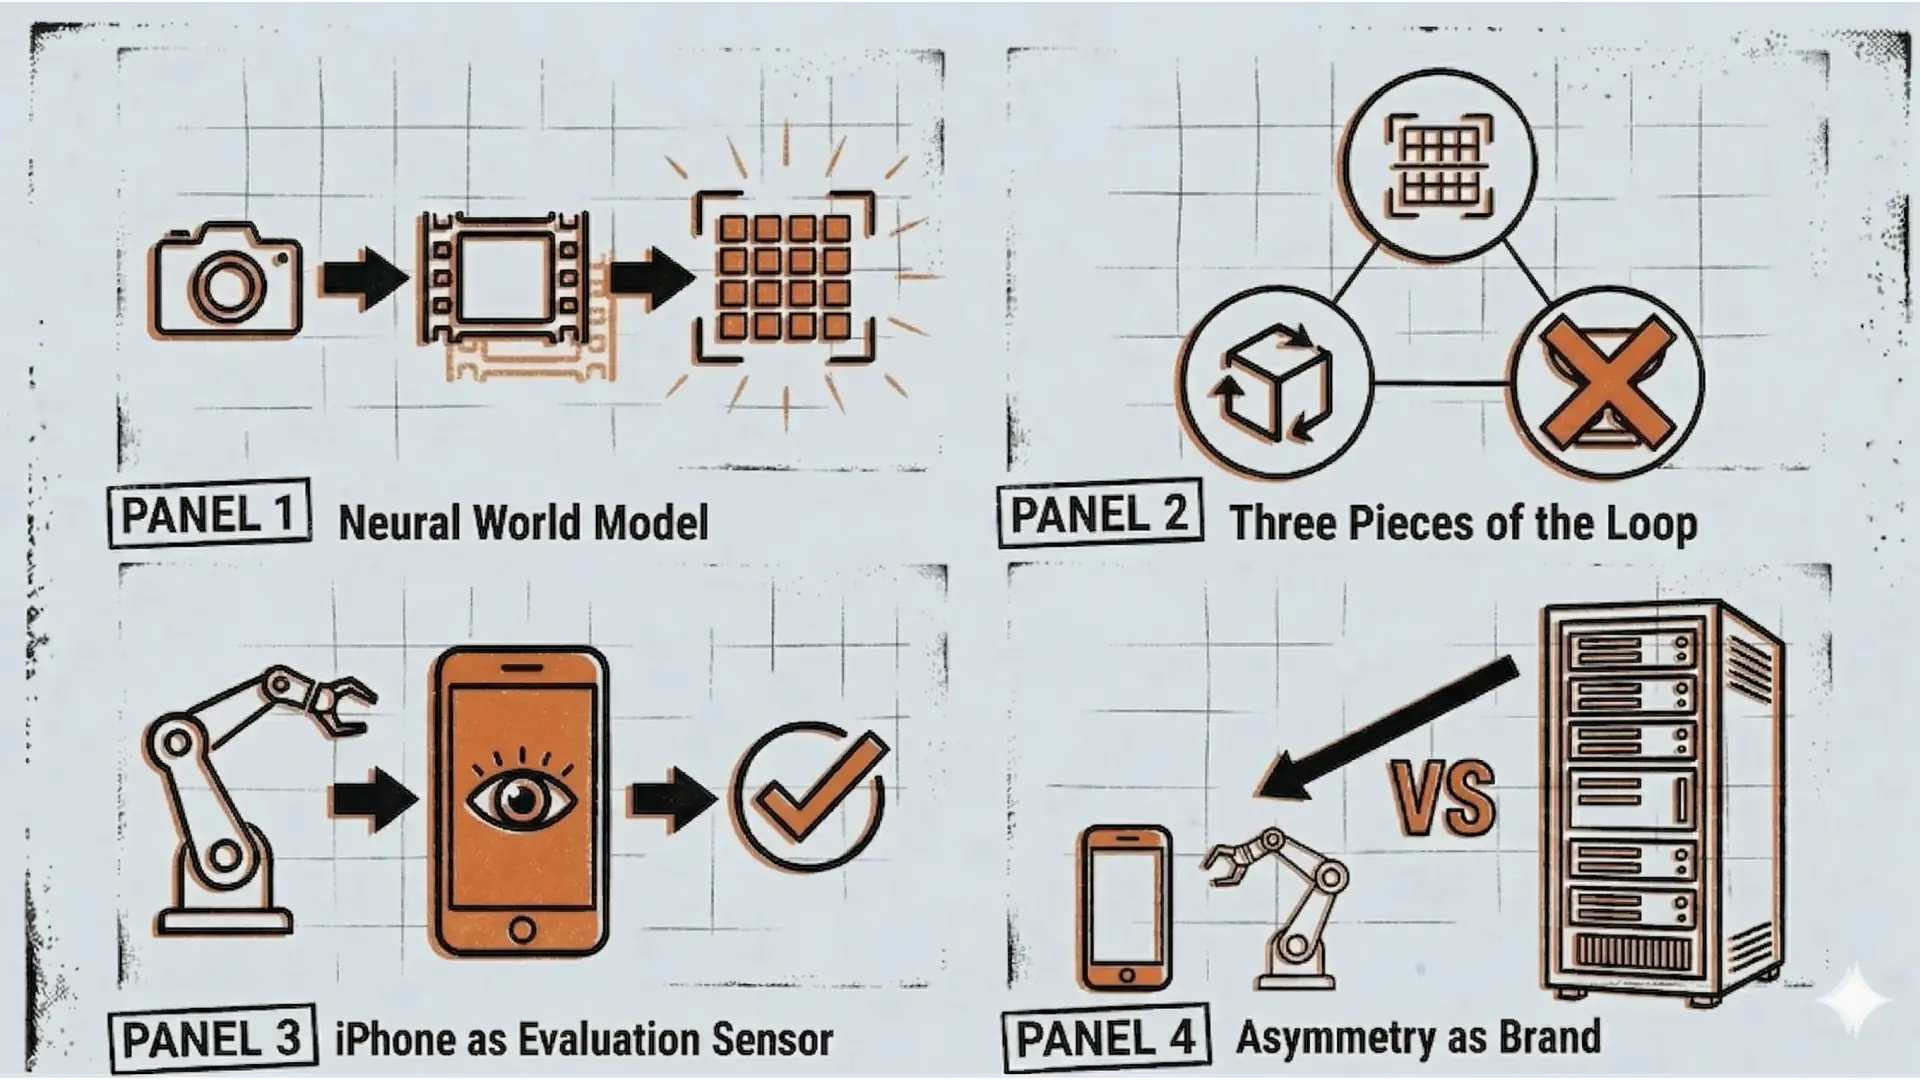
AGIBOTのGE-Sim 2.0(Genie Envisioner World Simulator 2.0)は、ロボットマニピュレーション向けの「身体化ワールドシミュレーター」として発表された。従来の物理エンジンベースのシミュレーターと根本的に異なる点がある。物理エンジンではなく、ニューラルネットが次フレームを「想像」しているという構造だ。
アーキテクチャを読み解くと、3つの技術的柱が見えてくる。
映像生成(Generated Vision State)
固有感覚状態推定(Proprioceptive State Estimation)
報酬ベースのポリシー評価(Reward-Based Policy Assessment)
この3つを統合した閉ループが、GE-Sim 2.0の核心だ。
ワークフローはこうなっている。
Policy Model
    ↓
Action Chunk
    ↓
GE-Sim 2.0(世界モデル)
    ↓
Proprio State + Vision State
    ↓
Reward Model
    ↓
Policy Model へフィードバック
完全なクローズドループだ。
ベースモデルはNVIDIAのCosmos-Predict2-2B-Video2Worldをファインチューニングしたもので、AgiBot-World-Betaデータセット(約100万件のリアル双腕ロボット操作エピソード、総計約3,000時間)で学習されている。学習にはA100×80〜32枚、数週間〜数ヶ月規模の計算が必要だ。
「個人・スタートアップが再現できるか?」という問いへの答えはシンプルだ。学習は完全にアウト。
でも、ここに引っかかる必要はない。
R2R2Rパイプラインと、問いの形が同じだった
—— スケールは桁違い。でも構造の問いは同じだ。
R2R2Rパイプラインを整理すると、こうなっている。
現実録画の標準化  → 3Dpressoスキャン + 実機撮影
アクション条件付き生成 → Unityデジタルツイン
報酬モデルによる評価 → ここだけ手動
GE-Sim 2.0がやっていることとの対応関係は明快だ。
GE-Sim 2.0 | R2R2R / Pixels to Motors |
|---|---|
現実環境を直接録画してワールドモデル化 | 3Dpressoスキャン → Unityデジタルツイン |
Action Conditioned Video Generation | 実機でのピックアンドプレース実行 |
Reward Modelによる自動評価 | ←ここだけ欠けている |
クローズドループが成立するために必要なピースは3つある。1番目は現実の記録と標準化、2番目はアクション条件付きの実行と記録、3番目は評価だ。
R2R2Rには今、1番目と2番目がある。
3番目だけ欠けている。
「完全な報酬モデル」は厳しい。「報酬の代替」なら今日から組める。
—— VLM-as-Reward という手法が、2024年から急速に使われ始めている。
mechArm 270-Pi の制約を整理するとこうなっている。
実効ペイロード 約150g(グリッパー重量引いた後)
単腕・6軸
固定設置
この規模で専用の報酬モデルを学習させることは、現実的ではない。
でも「報酬の代替」なら違う。
VLM-as-Rewardは、VLM(GPT-4oやClaude)に画像を投げて「タスク成功しているか?」を判定させる手法だ。学術的にも2024年から急速に使われ始めている。コーヒーカップのピックアンドプレースなら「カップがターゲット位置にあるか」をVLMに聞くだけでスコアが返ってくる。APIコストはかかるが、GPU追加は不要だ。
今手元にあるものを整理するとこうなっている。
mechArm 270-Pi
iPhone(3Dpresso実績あり・カメラとして使える)
Raspberry Pi(mechArm内蔵)
Claude / GPT-4o(API)これだけでVLM-as-Rewardのループは組める。物理的な追加はゼロだ。
最小構成のイメージ
—— iPhoneがカメラ兼評価センサーになる。
実装ステップはこうなっている。
1. mechArmが動作を実行する
2. iPhoneで結果を撮影(1枚)
3. Claude APIに投げて「成功/失敗/スコア」を返させる
4. そのスコアを次の試行にフィードバックする
物理的な追加はゼロ。iPhoneがカメラ兼評価センサーになる。
これは「報酬モデルを持っている」とは言えない。でも「報酬の代替として機能するループを持っている」とは言える。AGIBOTが専用の報酬モデルを学習させていることと、自分がVLM-as-Rewardでそれを代替していること——この非対称性が、逆にブランドになる。
「AGIBOTは専用報酬モデルを学習させる。
自分はVLM-as-Rewardで代替する。
これが『iPhoneを入り口にした低コスト化』の報酬モデル版だ。」
AGIBOTが100万エピソードでやっていることを、mechArmで10エピソードから始めるという話として語れる。スケールの非対称性を逆手にとる構図だ。
次のステップ
今の優先順位は変わらない。コーヒーカップのピックアンドプレースは、今のmechArm1台ではペイロード的にも構造的にも無理がある。今のターゲットはブロックだ。
まず、iPhoneで撮った静止画をClaude APIに投げて「このブロックは指定位置に置かれているか」を判定できるか試す。mechArmを動かす前に、評価部分だけ先に検証できる。
3番目のピースを、今ある設備で埋められるかどうかを確認する。