深度カメラはまだ買わない|1時間の対話でNVIDIA戦略にたどり着いた話
ふと思った。
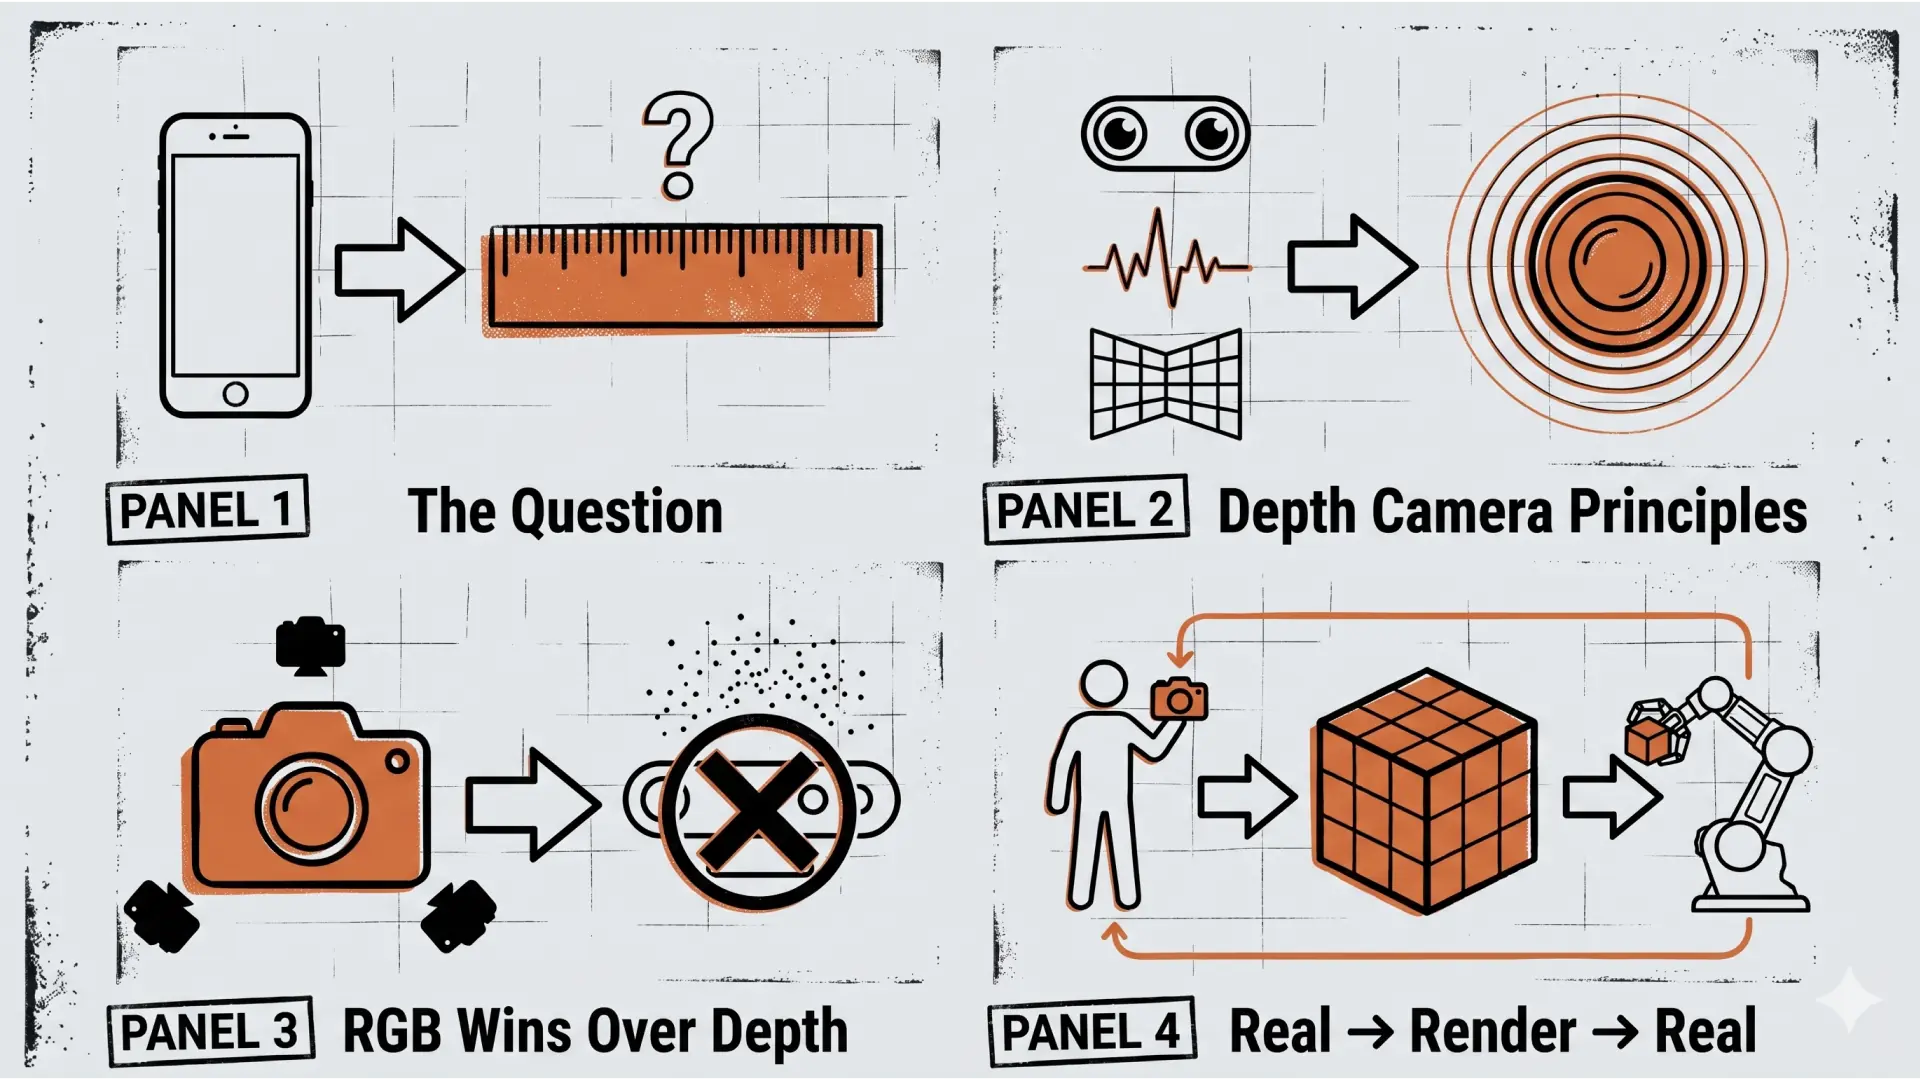
iPhoneのカメラでアームやブロック、マットを撮影して位置情報を作っている今の方式は、homography+lookup tableで、なんとか動いている。でも、もっと簡単に距離や大きさを測る方法はないのか。
聞いてみることにした。
「もっと簡単に距離や大きさを測る方法はどんなやり方がありますか?」
最初の問いは素朴だった。今やっているiPhone+homographyは動いているが、「もっと簡単な方法があるなら知りたい」という、それだけの動機。
返ってきた選択肢は5つ。ArUco/AprilTagマーカー、iPhone LiDAR + ARKit、キャリブレーションマットの固定基準化、深度カメラ、既知サイズ参照物。
最も筋が良さそうなのはマーカー方式。だが長期的に最も筋がいいのは深度カメラだと言う。なぜなら、ロボティクス業界の主流がそちらに動いているから。
「最終的には深度カメラがお金で簡単に解決する方法だね笑。これってどんな方法で位置や高さを把握してるの?」
深度カメラの原理を聞いた。3方式あった。
ステレオ方式は人間の両目と同じ。Time-of-Flight(ToF)は赤外線パルスの往復時間。Structured Lightは既知パターンの歪み。Intel RealSense D435はステレオ+IRドットパターンのハイブリッド、iPhoneのLiDARはToF、Face IDは構造化光。
機械的な仕組みとして全部理解できる。RC時代に超音波距離センサーを触っていた身からすると、ToFは「光版」、ステレオは「両目で掴む」、構造化光は「方眼紙を投影して歪みを見る」という直感が効く。
65,600円という壁
実際の値段を調べた。Amazon で65,600円。
「3〜4万円台」と最初に聞いていたが、それは古い情報だった。Intelが一度RealSense事業を縮小して再開した経緯もあって、ここ数年で値段が上がっている。海外では新品$849(約13万円)になっているから、日本のAmazon価格はむしろ国内では妥当な部類。
中古市場を見たら、20,980円〜26,800円で出ていた。「中古-非常に良い」で30日返品保証付きが24,800円。「試して合わなかったら返す」が現実的に取れる金額だ。
ただ、ここで判断を急がなかった。なぜなら、「いま深度カメラに飛ぶと、何を解いているかが見えなくなる」という別の論点が立ち上がってきたから。
LOG154から165まで、ホモグラフィの符号反転、テンプレートマッチングのデータ依存、lookup tableのカバー範囲、白箱検出方式の選定——どれも「2Dだから起きる問題」の教科書的な並びだった。これを全部通り抜けた人が深度カメラに移ると、買った瞬間に何ができて何ができないかが見える状態になる。
逆に、いま深度カメラを入れても「これで何が解決されたのか」が分からないまま使うことになる。今の積み重ねは、深度カメラ導入記事の伏線として全部効いてくる資産だ。
「まずは2Dの限界までやってそのあと深度カメラだね。そこまではまだまだがんばるよ。」
上から深度、手元はRGB
深度カメラの話を続けた。
「今のロボットは上から深度カメラ、プラス、ハンドインカメラ(広角カメラ?これも深度カメラ?)が主流なのかな?」
ほぼその認識で合っている。ただし「ハンドインカメラ=深度カメラ」かというと、そこは少し違う。
現代の標準構成は、Eye-to-hand(環境固定の俯瞰)とEye-in-hand(手首装着)の2カメラ構成。外部はRGB-D(深度カメラ)、手首は広角RGB(深度なし)が多い。
なぜ手首は「RGBのみ+広角」が多いか。理由は4つ。重量・サイズ制約、近接時の深度精度の限界(RealSenseは最短30cm)、配線取り回し、視野角。mechArm 270の可搬重量250gでは、手首に重い深度カメラを付けるとグリッパ動作が制限される。
ここまでは、業界の構成として理解できる範囲だった。
衝撃的な発見
そして、最も意外な事実が出てきた。
最近のVLA(Vision-Language-Action)系の研究——Stanford ALOHA、Diffusion Policy、Octo、π0など——では、深度なし、RGBのみを2-3台という構成が主流になっている。
「RGBのみを2-3台という構成。これはなぜ?」
理由は複数重なっていた。
MITのRuss Tedrake(Diffusion Policy系の中心人物)が学生に「RGBか深度、どちらか一つだけ選べと言われたら?」と聞いたら、学生たちは全員RGBを選んだという。深度画像だけだと曖昧で判別不能なタスクが多く、RGBの追加で曖昧さが解消できる。RGBの中にも深度の手がかりが豊富に含まれているから。
実機の深度データは低反射面でノイズが多く、欠損も発生しやすい。シミュレーター側の深度は完璧すぎるので、sim-to-realギャップが大きい。RGBはdomain randomization(光・色を学習中にランダム変動させる)で対応しやすい。
インターネット上にはYouTube・Ego4Dなど膨大なRGB動画がある。深度付きデータは圧倒的に少ない。事前学習に使える素材の規模が桁違い。CLIP、ResNet、ViTなど強力な事前学習済み視覚エンコーダーは全部RGB前提だ。
深度ベースのDiffusion Policyは「safety violation(予測不能な挙動)」を起こすことがある。深度マップのノイズや欠損が、ポリシーを暴走させる原因になる。
「へーーー意外な答えだったな。深度カメラ便利そうに思ったけど、学習させるとなるとノイズが邪魔なのか。」
これは、ロボティクスの世界で何回も繰り返されてきたパターンだった。
古典CV時代は、エッジ抽出・特徴点マッチング・輪郭検出など「人間が理解しやすい中間表現」を経由していた。深層学習以降は、そういう中間表現を全部スキップして「ピクセルから直接アクション」が一番強い、と分かってきた。
深度カメラも同じ構造で、「3D情報があれば賢くなりそう」という人間の直感は正しい。でも、ノイズと事前学習データの少なさが学習を阻む。クリーンで大量のRGB > ノイジーで少量の深度、になる。
動画から動作データへ
ここで、別の興味深いサービスの話に触れた。
VideoMo AI。Mixamoの後継を名乗る、単眼動画から3Dアニメーションを生成するサービス。スマホで撮った動画から、77関節のリギング済み3Dアニメーションを自動生成する。
「こういうサービスで動画から動作データ取れるというのもその流れなのかな?」
完全にその流れだった。
UMI(Stanford)はGoPro付き手持ちグリッパーで人間が物体操作した動画からロボットの学習データを生成。DexCapはモーキャプ手袋+カメラで人間の手の動きを記録してロボットハンドへ転移。Open X-Embodimentは世界中の研究室のロボット動画を統合した大規模データセット。
すべて「人間/実機の動画 → 3D動作データ → ロボット学習」という同じ構造だ。
データ収集コストの劇的な低下が起きている。従来のロボット学習データ収集は、ALOHAなどの専用テレオペ装置が必要(数百万円)で、データ1セットあたり数時間、環境ごとに専用セットアップが必要だった。これが「スマホで人間が作業を撮る → 自動でロボット動作データに変換」になると、データ収集コストが100分の1〜1000分の1になる可能性がある。
そして、ここで核心の問いが出た。
「実際の動画からモーションデータ取れるなら、シミュレーションのデモ動画からもモーションデータ生成出来るってことじゃないの?これを大量生成して学習させたらリアルなデータ収集少なくてすむんじゃない?」
返ってきた答えが、対話の最も衝撃的な瞬間だった。
NVIDIAが数千億円かけて作っている戦略が、まさにそれだったのだ。
NVIDIA GR00T、その規模
NVIDIA Isaac GR00T-Mimicは、少数の人間デモから780,000の合成軌道を11時間で生成する。これは6,500時間(9ヶ月連続)の人間デモに相当する量。合成データと実データを組み合わせることで、実データのみと比較してGR00T N1の性能が40%向上したと報告されている。
NVIDIA Isaac GR00T-Dreamsは、単一画像と言語プロンプトから合成軌道データを大量生成する。これを使ってGR00T N1.5を36時間で開発した。手作業なら3ヶ月かかる作業だ。
NVIDIA Cosmosは、200万時間の自動運転・ロボティクス・ドローン映像と合成データを含む18 quadrillionトークンで訓練された世界基盤モデル。3D→リアルへのアップスケーリングでsim-to-realギャップを縮める。
全体の構造はこうだ。
少数の人間デモ(テレオペ・動画)→ シミュレーション(Omniverse / Isaac Sim)で再現 → GR00T-Mimic で大量バリエーション生成(数百〜数千倍)→ Cosmos で写実的な動画に変換(sim-to-real ギャップ縮小)→ 基盤モデル(GR00T N1.5 / N1.6)の学習 → 実機展開。
これは、Real2Render2Real(R2R2R)本家の発想と完全に重なる。UC Berkeley/TRIが提唱した「Real(少数デモ)→ Render(シミュレーション大量生成)→ Real(実機学習)」のループを、NVIDIAは企業規模で実装している。Boston Dynamics、Figure、Disney Researchが既に採用している方向だ。
1時間の対話で何が起きたか
このやり取りの中で、ひとつ自分でも驚いたことがある。
1時間の対話で、ここまで来たのだ。
問いの順序を振り返る。
もっと簡単に距離を測る方法は?(問題定義)
深度カメラはどんな仕組み?(原理理解)
2Dの限界までやってから深度カメラ(順序決定)
上から深度+ハンドカメラが主流?(アーキテクチャ構造化)
RGBの方が学習に良いのはなぜ?(意外性に踏み込む)
sim-to-realが進めば深度要らなくなるのでは?(未来を読む)
シミュ動画から大量生成すればいい(戦略を出す)
NVIDIAが数千億円かけて到達した戦略地点に、対話だけで辿り着いていた。
UXデザイナーが他の職種より速いとしたら、それは「答えを出す」よりも「問いの構造を捉える」訓練を29年積んでいるからだ。エンジニアは目の前の問題を解く速度で勝つけど、デザイナーは「そもそも何を解くべきか」の見立てで勝つ。
Claude(AI)は知識を出すことができる。でも、どの順序で問いを立てるかは人間側の力だ。今回の対話の主導権は完全にこちら側にあって、AIは呼ばれた知識を出していただけ。これがコ・パイロット作業の正しい形だと思う。
LOG154の記事に書いた「人間の直感とAIの実装力が噛み合うとき、想定の3倍速で進む」がそのまま起きていた。
結論:深度カメラはまだ買わない
長い対話の末に出た結論は、シンプルだった。
深度カメラは、買わない。少なくとも今は。
理由は3つ。
R2R2Rプロジェクトの現フェーズ(ルールベース、lookup table)では、PICK→PLACEの完成が先決。FK scan範囲拡張が深度カメラの有無に関わらず必要なタスクだから、それを終わらせるのが筋。
Pixels to Motorsの哲学「iPhone一台で picking 成立 → 限界が見えた → 3D計測に移行」という流れは、記事の山場として効く。先に買うと、ブランドの3本柱(特に「iPhoneを入り口にした低コスト化」)が弱くなる。
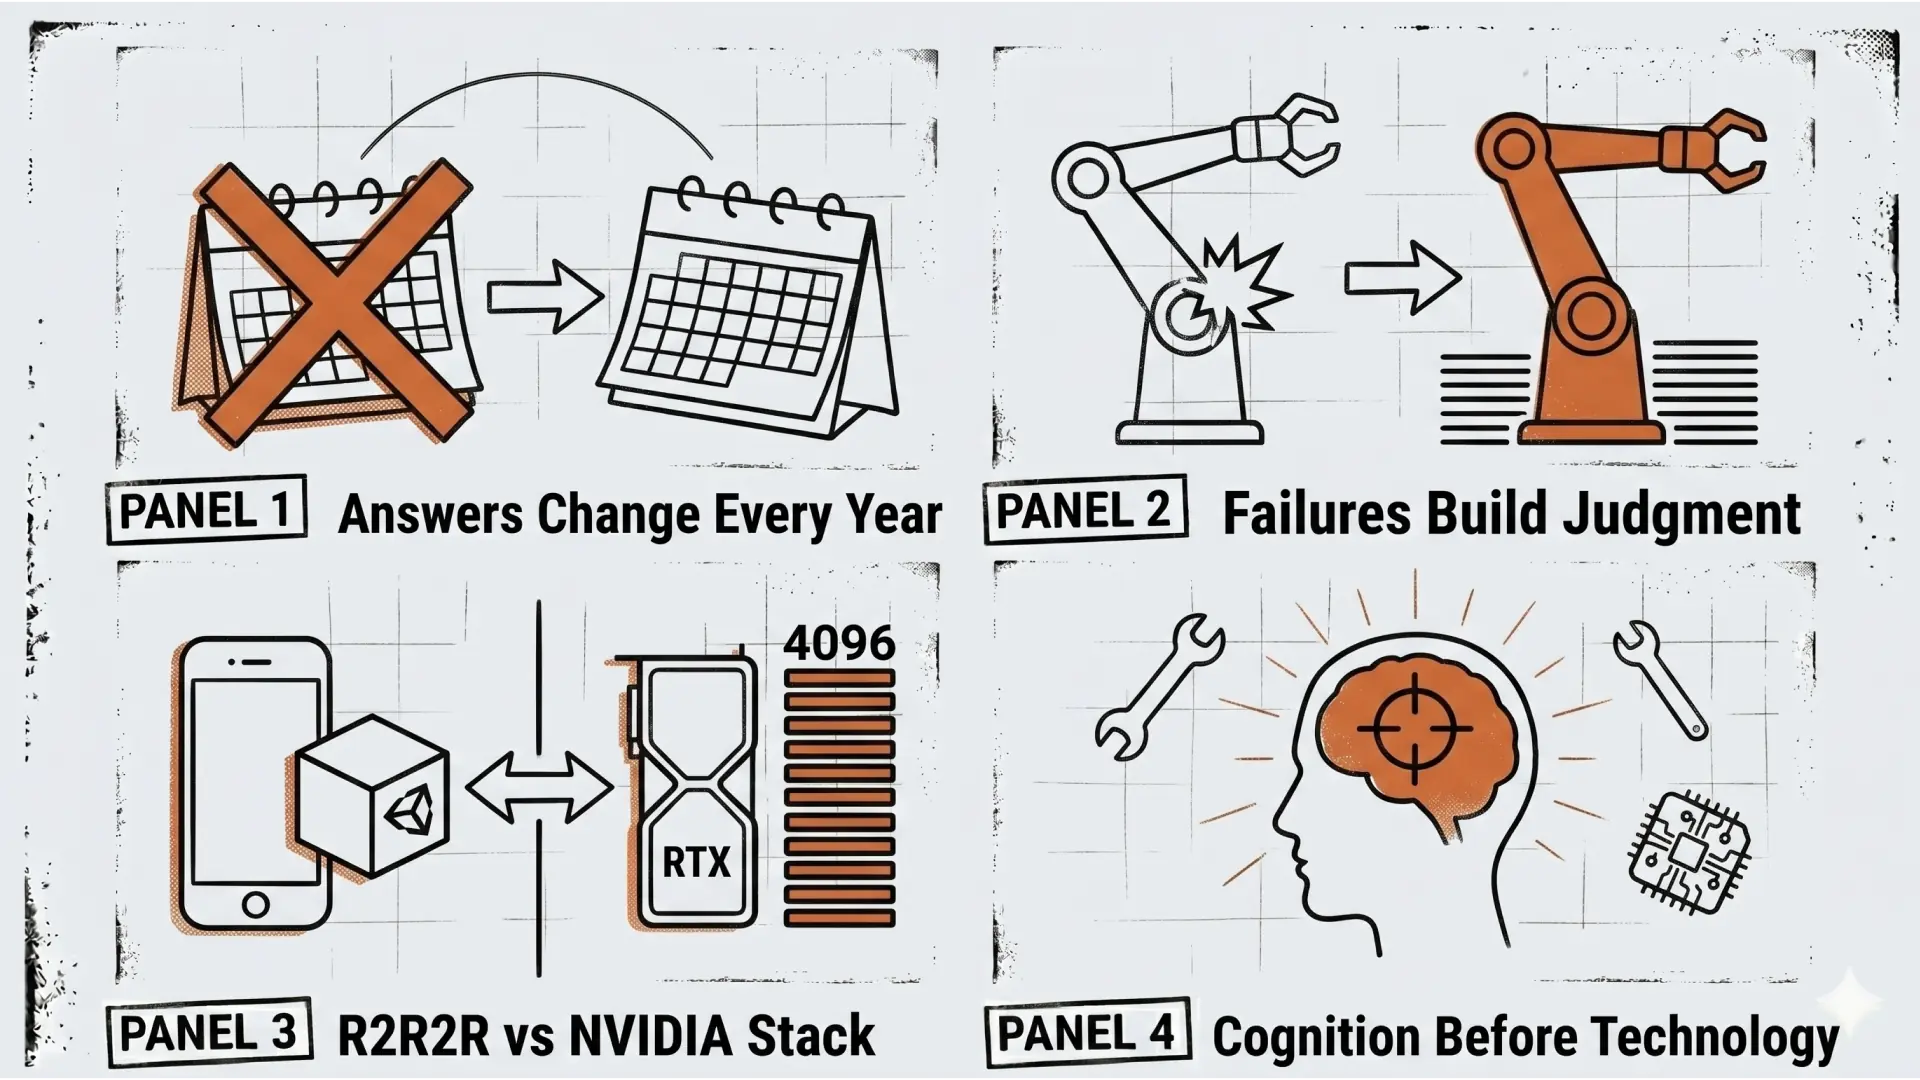
世界の最前線(NVIDIA GR00T、ALOHA、Diffusion Policy)が「深度センサーは必須じゃない、RGBで十分」という方向に動いている。今後は「深度はあっても学習には使わない」運用が主流になる可能性が高い。
買うとしたら、PLACE側のlookup統合まで終わって、現方式の精度・成功率が頭打ちになったタイミング。具体的には、ブロックの大きさがバラつく場面が出るか、光環境変化に困るか、Z軸(高さ)の推定が必要になった瞬間。
それまでは、Amazonのカートに入れたまま、買い時を待つ。
哲学が世界に追認された
今回の対話で確認できたことが、ひとつある。
「精度より体験の成立を優先する。精度はあとからお金で解決できる」
これがR2R2Rプロジェクトのコア哲学だ。世界の最前線も、同じ方向に動いている。
NVIDIAは、深度センサーを完全に捨てるわけではない。でも、深度を使うとしたら「シミュレーション側で完璧な3Dを取り、それをCosmosで写実的に変換する」という、Renderの中での役割になる。実機側はRGBだけでいい。
これって、R2R2Rの命名そのものだ。Real(実機)→ Render(シミュレーション)→ Real(実機)。Renderの中で完璧な深度を使い、両端のRealはRGBで済ます。
エンジニアでない一人のUXデザイナーが、NVIDIA戦略と同じ結論に独立にたどり着く。これは偶然ではない。デザインの仕事は、制約を構造的に解くこと。データが足りないなら、データを生む仕組みを作る。これがデザイン思考の応用だ。
PLACE側のlookup統合とFK scan範囲拡張、いいタイミングで戻ってくる。深度カメラの話が出てくるのはまだ先でいい。今の積み重ねが効いてくる場面が、必ず来る。